首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | vivo 在离线混部探索与实践

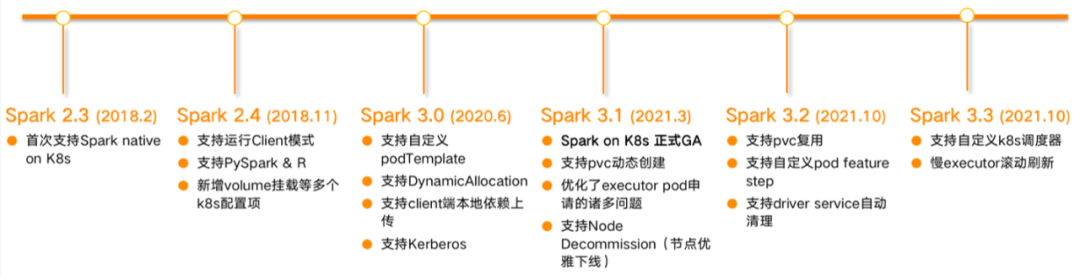
作者:来自 vivo 互联网服务器团队 本文根据甘青、黄荣杰老师在“2023 vivo开发者大会"现场演讲内容整理而成。公众号回复【2023 VDC】获取互联网技术分会场议题相关资料。 伴随 vivo 互联网业务的高速发展,数据中心的规模不断扩大,成本问题日益突出。在离线混部技术可以在保证服务质量的同时,极大的提升数据中心资源利用率,降低成本。混部技术涉及任务调度、资源隔离、运维观测等一系列技术难题,本文将介绍 vivo 在混部技术方面的实践和探索,为读者提供借鉴和参考。 一、在离线混部技术背景 1.1 为什么混部 数据中心运行的服务可以分为在线服务和离线任务两大类,它们具有不同的资源使用特征。 在线服务是指那些长时间运行、对时延非常敏感的服务,如电商、游戏等,在线服务的资源利用率存在明显的波峰波谷现象,平均利用率较低。离线任务是指那些运行周期短,有容错性,对实时性要求低的服务,如数据转换、模型训练等,离线任务在执行过程中资源利用率很高。 在混部之前,在线和离线都是分开独立部署,机器不共享,无法形成有效的资源互补,这导致数据中心整体资源利用率不高,却要不断购买新机器,造成了资源浪费。 1.2 混部技术定义 通过混部技术,我们可以将在线和离线部署到同一台物理机上,形成资源互补,提升物理机的资源利用率,降低成本。混部技术最早由谷歌在2015年提出,经过多年的发展,混部技术已经趋于成熟,目前业内利用混部技术可以将数据中心的CPU利用率提升至40%左右 。 vivo在2020年开始调研混部技术,2023年混部平台投入生产,目前我们已经将部分混部集群的CPU利用率提升至25%(最新已达30%)左右。相较业界标杆这还有一定的差距,但随着混部规模的扩大,我们将挑战更高的目标。 二、在离线混部平台实践 2.1 混部平台产品能力 混部平台必须具备两个产品能力: 第一、强大的调度、隔离能力 第二、完善的监控、运维能力 强大的调度能力解决了,我们如何将离线任务高效、合理的调度到在线服务所在的物理机上。而强大的隔离能力保障了在线服务的质量不受离线任务干扰。完善的监控和运维能力则可以让我们洞悉整个混部平台的运行情况,及时发现潜在风险,帮助运维人员更高效的完成系统和业务的运维工作,保障集群的高稳定性。 2.2 混部差异化资源视图 混部首先要解决的一个问题是离线使用哪一部分资源。 在vivo混部系统中在线和离线看到的资源视图是不同的: 在线可用资源为 整机资源 离线可用资源为 整机资源减去 在线实际使用的资源 同时为了避免整机负载太高影响系统的稳定性,我们设置一个安全水位线,用于调节离线可用资源大小。 2.3 混部QoS等级 为了保障混部系统的slo,我们将服务分为三个等级:高、中,低。 不同等级的服务对物理资源如:CPU、内存 使用时有不同的优先级。高优先级服务支持绑定CPU模式,适用对延时非常敏感的在线服务。一般的在线服务可设置为中优先级。离线任务设置为低优先级,通过这样的等级划分,我们很好的实现在线对离线的资源压制和隔离,保障了在线服务质量。 2.4 混部核心组件架构 我们所有的混部组件都是以插件方式独立运行,对原生K8s无侵入。我们实现了一个混部调度器,在线和离线统一使用这个调度器,避免了多调度器资源账本冲突的问题。 每台物理机上都会部署一个混部agent,它可以实时采集容器资源使用数据,并根据安全水位线对离线任务进行压制、驱逐等操作。 内核层面我们使用了龙蜥OS,它具备强大的资源隔离能力,可以帮助我们更好的隔离在线、离线资源使用,保障在线服务质量。 2.5 混部组件功能 我们把混部组件分为管控组件和单机组件两大类。 管控组件主要负责调度和控制,根据vivo业务使用场景,我们对调度器做了一些增强,提供了numa感知、负载感知,热点打散,批量调度等能力。 混部控制器主要提供了一些配置管理能力:如资源画像统计、node slo配置、node扩展资源变更等。 2.6 混部可视化监控 我们为混部建立一套完整的可视化监控体系。 针对在线服务我们提供了:容器资源使用指标,受离线干扰指标、业务混部收益指标等监控能力。 针对离线任务,我们提供了离线可用资源、任务异常状态等监控能力。 在平台层面上我们提供了节点、内核,核心组件的监控,通过这些监控可及时发现平台潜在的风险。 2.7 混部平台运维 为了简化运维操作,提升运维效率,我们对混部集群搭建和节点扩缩容操作进行了白屏化改造,开发了资源池管理功能,简化了物理机接入流程,运维效率大幅提升。 在运维平台上运维人员可以快速调整混部隔离、水位线等参数,如果发现在线服务受到干扰,运维人员可以一键关闭混部,驱逐离线任务,保障在线服务质量。 2.8 问题与挑战 2.8.1 apiServer拆分 通过混部产品能力的建设,我们很好的实现了容器混部能力,但是在实践中我们还是遇到一些新的挑战:相对于普通K8s集群,混部集群中运行着更多的容器,而且离线任务由于生命周期短,容器创建销毁更为频繁,这对K8s apiServer 产生了很大的压力。 所以我们拆分了apiServer ,离线任务使用独立的apiServer ,保障了集群apiServer 负载一直处于一个安全水平。 2.8.2 监控架构优化 同样混部之后由于采集了更多的监控指标,导致Prometheus内存消耗过多,无法满足平台指标 采集需求。针对这个问题,我们优化了监控架构,将在线和离线监控组件分开部署,离线改用性能更好的vmagent,通过这个优化,监控组件内存消耗减少到原来的十分之一。 2.9 利用率提升 混部初期虽然集群CPU利用率有所提升,但是还是没有达到我们的预期,主要原因有: 一、部分低配置机器资源本身较少。 二、Java 类应用堆会固定占用大量内存,导致可提供给离线使用内存资源不足。 针对这些问题,我们开发了定时调整安全水位线功能,在业务低峰期上调安全水位线,释放更多的资源给离线使用。通过一系列的优化手段,我们将其中一个混部集群的CPU利用率由13%提升到了25%左右,几乎翻倍,混部效果得到了有效的验证。 三、Spark on K8s 弹性调度实践 3.1 方案选型 在大方向的技术选型上,我们选择了 Spark on K8s,在业内,也有一些公司采用了 YARN on K8s的方案。我们也对这两种方案进行过对比。 从业务适用性来说,YARN on K8s 是通用的,可以兼容Hive、Spark、Flink这些引擎,它不需要频繁创建Nodemanager pod,对K8s的压力比较小。这些都是它的优点,但另一方面,Nodemanager ESS服务是对磁盘有容量和读写性能要求的,混部机器磁盘一般难以满足。所以我们要支持不同引擎的remote shuffle service。 如果计算引擎有不同的版本,那么RSS也要支持不同版本,比如Spark2,Spark3。如果你有不同的引擎,不同的版本,很可能一种RSS还满足不了需求。另外Nodemanager需要根据K8s混部节点的剩余资源,动态调整可用的vcore和内存,所以还需要一个额外的组件来做这个事情,这需要较高的改造成本。在资源利用上,NM的资源粒度相对大,自身也会占用一些资源,存在一定的浪费。在资源紧张的情况下,Nodemanager作为整体被驱逐,会影响多个任务。这些是YARN on K8s的劣势。 作为对比,Spark on K8s 劣势有哪些? 首先这个特性在Spark 3.1以上版本才正式可用。Spark on K8s由于会频繁的创建、查询、销毁大量的executor pod,对K8s的调度能力以及master节点会造成比较大的压力。另一方面,它的优势在于只需要能支持spark3.X的RSS,这有较多的开源产品可选择。而且改造成本比较低,不需要额外的组件。资源粒度小,更有利于充分利用集群资源。在资源紧张时,会逐个pod进行驱逐,任务的稳定性会更高。 两方案各有优劣势,为什么我们选择了Spark on K8s?一方面因为Spark3.X是vivo当前及未来2~3年的主流离线引擎,另一方面vivo内部对K8s研发比较深入,能有力支持我们。基于以上原因,我们最终决定使用spark on K8s 3.2 三步走战略 确定了方案选型,那在vivo我们是如何推进spark on K8s大规模的应用落地呢?回顾总结我们走过的路,可以大致归纳为三步走的战略。 第一,是任务跑通跑顺的初期阶段 第二,是任务跑稳、跑稳的中期阶段 最后,是任务跑得智能的成熟阶段 接下来的内容,我们将对每个阶段展开细说。 3.2.1 任务跑通跑顺 在任务跑通、跑顺的第一阶段,我们要解决的是怎么将任务提交K8s集群,同时要求易用性、便利性方面能够达到与on YARN 一致的用户体验。将我们最后采用的方案架构简化一下,就如同这张图所示。 首先,为了降低任务提交的复杂性、避免用户改造任务的成本。我们在任务调度管理平台做到了对原有Spark任务的兼容,通过vivo内部的容器开放API-这个代理层,我们不需要维护额外的K8s client环境,就可以轻松实现任务提交,提交后也能近实时获取任务的状态和日志信息。 另外一个关键点是,我们选用了Spark Operator作为Spark任务容器化的方案。Spark Operator是谷歌基于K8s Operator模式开发的一款的工具,用于通过声明式的方式向K8s集群提交Spark作业。 Spark Operator的方式还有其他优点: Operator方式对K8s更友好,支持更灵活、更全面的配置项 使用上更简单易用 内置Metrics,有利于我们做集中管理 要达到阶段一的目标,让任务跑通、跑顺。我们主要克服了哪些关键问题和挑战? 第一个是日志查看,因为Spark Operator方式并没有提供已结束作业的日志查看方式,包括driver和executor日志。在Driver侧,我们通过定期请求容器开放API,能准实时地获取Driver Pod状态与日志。在Executor侧,我们参考了on yarn的方式,Executor Pod结束后,日志上传HDFS,与YARN日志聚合类似。 另一方面,我们也在Spark HistoryServer做了二次开发工作,增加了on K8s方式的日志查看接口。用户查看已完成的Executor日志时,不再请求JobHistory Server,而是请求Spark HistoryServer接口。在体验上做到了基本与yarn一致。 在混部K8s集群,我们也做了三方面能力的加强。 一是,确保分配能力能支持离线任务频繁建删pod的需求,在优化后我们离线Pod分配能力达到数百pod/秒。 二是,在K8s侧提升了spark内部的Driver优先级,确保了在驱逐时Driver稳定性高于Executor。 最后一个是,发现并修复了spark-operator的一个bug,这个bu是Operator在多副本部署时,slave副本webhook处理有一点概率出现pod 找不到的问题。 3.2.2 任务跑稳跑准 在第二阶段,我们要保障的是任务跑稳,数据跑准,因此,我们有两个关键的举措: 大规模双跑,目的是确保Spark任务迁移到K8s集群后是兼容的,任务成功率有保障;任务执行时长是稳定的,不会明显变慢;数据是准确的,跟on YARN保持一致性。为此,我们需要对任务进行on YARN和on K8s两种模式下的双跑测试,我们分批次总共进行了7轮双跑,覆盖了2万+的线上正式任务。最终也取得了我们想要的结果:我们双跑最终达成的任务成功率超过了99.5%,绝大部分的任务在两种模式下的时长波动在25%以内,数据一致性是100%。 混部集群的压力联调,目的是确保混部集群的承载容量能够支撑大规模的离线任务调度,通过模拟未来1年的任务量来给混部集群做压力测试,充分发现和检测K8s集群可能存在的性能问题。最终,通过我们多轮压测和问题解决,我们在单个K8s集群能够支撑150+同时运行的Spark任务,1万+同时在运行的Pod数量。 在第二阶段,我们主要面临三个方面的问题和挑战。 首先是我们需要为Spark选择一个外部的shuffle服务,经过技术选型和比较,我们最终选择开源的celeborn作为我们的remote shuffle service组件。我们通过对机型和参数的测试调优,使celeborn的性能达到我们的预期需求。在大规模的应用场景中,我们还发现了会存在大任务会阻塞小任务,导致shufle read变慢的问题,我们对这种情况做了参数和代码上的优化,当前社区也针对shuffle read的问题有一些待优化的改进。另外celeborn进行了容器化部署,在提升自动化运维能力的同时,也可以为混部集群提供额外的计算资源。 其次,在任务稳定性方面,我们也解决了一系列的问题。 在双跑的时候,我们发现有不少任务在on K8s模式下很容易OOM,这是因为在on YARN模式下申请的container内存大小,不止是由Spark任务本身的内存参数决定,还会被YARN的资源粒度参数所影响。所以这块要做一些适配对标工作。 在任务量比较大的情况下,Spark operator的吞吐能力会遇到瓶颈,需要我们将并发worker数量、队列的相关参数调大。 CoreDNS因为Spark任务频繁的域名解释请求,导致压力增大,甚至可能影响在线服务。这个可以通过访问ip而不是域名的方式来规避,比如namenode节点、driver和executor。 横向扩展namespace,这样可以避免单namespace的瓶颈,也防止etcd出现问题。 我们K8s apiserver的压力随着任务量增长压力也会逐渐增大,这会影响整个集群的稳定性。我们主要通过优化Spark driver list pod接口、使用hostnetwork方式两个优化手段,有效降低了apiserver的压力。 最后要说的是数据一致性,关键点是要做到行级记录的MD5校验,发现有不一致的Case,我们做到100%的分析覆盖。排除了因为时间戳随机函数等一些预期内的不一致,我们发现并修复两种case会偶发导致不一致的问题: celeborn Bug导致不一致,具体可参考CELEBORN-383解决 Java版本不一致导致的问题 3.2.3 任务跑得智能 在第三阶段,我们需要解决的问题是让任务跑得智能,怎么定义智能,我想用三个词来概括弹性、健壮、业务需求。这是我们弹性调度的架构图,细节我就不讲了,这里我介绍下我们的调度系统重点支持的功能。 在弹性方面,我们需要做到实时根据混部集群资源闲忙,智能提交至混部集群或者Hadoop集群。在前期我们K8s集群的资源相对Hadoop是小头,通过合理的水位线控制,防止大量任务同时调度到K8s导致饿死。 健壮,就是要保证任务的高可用。 我们建设的能力包括: 任务双跑成功后再混部 支持离线任务失败自动回滚到Hadoop集群执行 支持用户自主决定任务是否可调度至K8s集群 初期剔除重要核心任务、剔除不可重试任务 目的是在用户任务迁移时做到让用户无感。 在满足业务需求方面,我们支持优先调度本业务的离线任务, 优先满足业务部门的离线任务资源需求;支持只在指定时间段里调度离线任务,支持在出现异常情况下一键终止调度K8s。这些是为了确保在线服务的高可用性,免除在线业务的后顾之忧。 3.3 混部效果 克服了三步走过程中的磕磕碰碰,我们终于可以将离线任务大规模混布到K8s混部集群了。但是我们很快发现,混部集群的整体利用率并没有达到我们的预期,主要有三方面的原因。 初期的Spark任务不足,这个我们通过加快双跑,迁移低版本的Spark任务,迁移Hive SQL任务来解决。 在混部的时候,我们也观察到,离线任务的pod cpu利用率其实没那么高。比如我们申请一个核,通常只能利用0.6个核,存在浪费的情况。我们上线了CPU资源超分的能力,目前是静态的固定比例超分,通过这个措施,我们能将pod的实际cpu利用率打到80%以上。 另外就是混部集群中的机器配置不均,部分机器cpu资源充足,但是内存不够。我们通过在调度侧控制可调度任务的资源粒度,尽量调度对内存资源需求较小的任务。 通过我们在任务调度侧,以及之前甘青提到过的其他措施。混部集群利用率得到了进一步的提升。 最后,我向大家同步下,当前我们达成的混部效果。 我们目前可供调度的任务接近2万个,这些任务每天调度的次数已经超过了4万次。在凌晨的高峰期,我们通过混部,能为离线任务额外增加2万核、50TB内存的计算资源。这个收益是相当可观的,我们也希望在未来的2到3年,将可调度的任务规模提升到6万个,弹性资源能够为离线计算总资源贡献20%的份额。 通过继续深度推进在离线混部技术,我们期望能够为vivo增效降本工作持续地贡献力量。 以上就是本次分享的全部内容。 END 猜你喜欢 vivo 海量微服务架构最新实践 vivo 智能活动中台-悟空系统建设之路 vivo 海量基础数据计算架构应用实践 vivo 短视频体验与成本优化实践 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | vivo 短视频体验与成本优化实践

作者:来自 vivo 互联网短视频研发团队 本文根据蔡创业、马运杰老师在“2023 vivo开发者大会"现场演讲内容整理而成。公众号回复【2023 VDC】获取互联网技术分会场议题相关资料。 在线点播场景,播放体验提升与成本优化是同等重要的两件事,并在部分场景体验优化与成本优化存在一定的互斥关系。vivo短视频深入分析播放链路的每个环节、并结合大数据统计,探索出了多种的体验优化策略;同时针对成本优化,上线了转码、PCDN、共享闲时带宽等多种策略用于降低带宽成本。基于技术优化和业务发展的要求,vivo短视频还上线了系统性的监控体系,对播放体验、带宽成本进行了多维度的监控。 一、业务介绍 vivo短视频项目的业务架构,从链路上来说,主要包括: 内容生产,主要包括拍摄、导入、剪辑以及作品上传 视频处理,包括画质增强、转码、压缩等 分发 消费,包括预加载、视频播放 除此之外,我们还设计了若干个子系统,其中比较重要的有: 日志收集,主要用于收集用户主动反馈问题。 监控统计,主要用于监控线上核心指标,为后续优化提供方向。 AB测试,主要用于新功能验证。 技术架构的最终目的是为了给用户呈现一个有着良好体验的产品,同时又兼顾到开发、运营成本。通过我们产品内置的意见反馈、大数据统计以及用户调研,我们发现/用户对vivo短视频的反馈主要集中在播放卡顿、不流畅、画质不清晰上面,从成本方面,我们的主要压力来自于CDN。 这些也就是本文的主题,即:如何做到既要播放体验好,又要业务成本低。接下来,将分别介绍一些在播放流畅度以及成本优化相关的探索和实践。 二、体验优化 2.1 播放链路拆解 对于在线点播场景来说,影响用户体验的环节主要在视频开播以及播放过程。首先,在起播阶段,应尽力做到首帧零耗时,当用户观看视频时应直接展示视频画面而不是出现等待过程。 我们对开播过程做了拆解和监控,在无任何优化策略的场景下,网络连接环节耗时占比30%,下载环节占比15%, 解封装、解复用环节占比15%。 其次,在视频播放过程中,应做到流畅播放不卡顿,这就需要合理的预加载策略、码率控制以及下载策略。 通过以上的分析,确定了我们4个重点优化方向: 建连优化,通过连接复用、保活等方式减少在连接环节的耗时 分片下载,通过优化下载架构提升下载速度以及成功率 预渲染,把耗时的解封装、解复用、解码等环节前置 数据预加载,通过预加载减少在下载环节的耗时 在此基础上,我们上线了数据监控体系,对开播性能、优化策略、视频基础信息、画质、带宽利用率等方面进行了详细的监控。 2.2 建连优化 通过以下4个策略来降低建连环节的耗时: 在应用冷启动以及视频播放时,通过连接复用,减少了DNS解析、SSL以及TCP连接环节的耗时。 在视频播放过程中,用户可能因为某些原因暂停视频,比如把应用切到后台,几分钟后再打开 应用,这种情况下可能出现连接被断开,当恢复播放时需要重新建连,从而导致播放卡顿的问题。通过连接保活,可确保再次播放时视频快速下载、快速 开播。 传统的local dns可能会出现解析DNS劫持、解析缓慢等问题,通过http dns,可有效应对DNS劫持以及解析缓慢的问题,为了应对复杂多变的网络环境,我们还通过在线配置的方式,支持多种dns解析以及降级策略。 当DNS解析失败时,通过服务端下发的IP实现直连,从而提升连接成功率。 以上就是我们在网络连接环节的一些优化策略,下面介绍我们在视频下载环节的优化。 2.3 分片下载 为了实现预加载,即在视频播放之前把在线视频提前下载到本地,我们在播放器和CDN直接增加了一个本地代理的服务,播放的网络请求都由本地代理服务响应,本地代理服务再向CDN发起请求。在弱网下测试,我们发现卡顿情况比较严重,主要是存在不必要的网速竞争,并且常规单线程下载效率低于多线程并发下载。为此,我们通过分析协议以及多次实验,最终确定了全新的下载方式,即首个视频起播时使用单线程,后续的视频下载以及预加载都通过多线程分片请求完成。 同时,把播放器 与本地代理之间的socket通信方式修改为直连,避免了socket中不必要的读写缓冲区浪费。通过这样的调整,首帧耗时降低3.8%,播放失败率下降9%;并且还具备了播放过程中实时切换cdn的能力,即在首次开播时使用性能较好的标准cdn,在缓存较充足时切换为低成本的cdn。 2.4 预渲染 通过以下优化策略提升预渲染效果: 应用冷起后,首个视频的开播体验对用户的后续消费有着非常重要的影响,为了提升该的播放体验,在应用启动时预创建H265以及H264对应的codec实例,在开播环节直接使用预创建的解码器,开播耗时可降低50ms左右。 播放器的创建环节涉及到较多的流程,比较耗时;另外,常规的每次播放视频都创建一个播放器对象的方式,容易出现因播放器对象泄漏导致的OOM、ANR甚至播放失败。基于这两个问题,我们创建了全局复用的播放资源池,每次视频播放时都从资源池中直接获取已经创建好的播放器对象,通过该策略,可有效的降低播放器创建耗时,并且彻底解决了播放器实例泄漏问题,对系统稳定性以及播放成功率都有明显的改善。 前面我们介绍了预加载策略,即在视频播放之前提前下载部分数据到本地,视频播放时直接播放本地准备好的缓存,开播速度较优化前有明显的提升;但本地视频开播仍需要嗅探、解封装、解码这些环节,开播耗时仍存在优化空间。因此,我们基于播放器资源池,使用另一个空闲的播放器对象来提前完成下一个即将播放的视频的嗅探、解封装、解码过程,通过这个策略,首帧耗时可降低到50ms以内。 2.5 预加载策略 首先介绍的是固定大小的预加载策略:视频播放时,把后续5个视频添加到缓存待下载队列,每个视频使用固定的预加载大小,当前视频的缓存处于高水位时,开始下载缓存队列中视频,当前视频缓存处于低水位即有可能即将发生卡顿时,停止下载缓存队列中的视频。 这个方案整体实现比较简单,但存在两个问题: 预加载大小是固定的,未能与视频码率、时长关联,当视频码率、时长发生变化时,可能会出现缓存不足或者缓存浪费。 对于一条用户会重度消费的视频,应提升预加载大小,从而提升用户在播放过程中的流畅度。 为了解决以上两个问题,我们上线了动态预加载策略。 动态预加载就是在固定预加载的基础上,做了如下调整: 缓存分级,把固定预加载策略中的单一缓存调整为3个不同优先级的缓存,优先级高的缓存较小,优先下载,优先级较低的缓存较大,下载优先级较低;一级缓存下载结束后开始下载二级缓存,二级缓存下载完成后再下载三级缓存。 缓存大小不再固定,修改为根据视频时长和预加载时长动态计算当用户快速滑动时,一般情况下会命中一级缓存,确保视频可以顺利开播;当用户在列表中重度消费时,后续的视频将有充足的时间完成三级缓存的下载。 动态预加载策略上线后,首帧耗时降低了2.3%,卡顿率降低了19.5%,当然,这个策略也存在的明显的问题,即体验提升了,但带宽成本也提升了。我们需要思考,如何在不增加成本的前提下提升体验。 我们来看一个示例:在一个视频列表中,有些视频用户喜欢观看,完播率较高,有些视频用户不感兴趣,会快速滑过。 也就是说,只有深度消费的视频,才真正的需要二级和三级缓存,快滑的视频能快速开播即可。基于这样的一个普遍性的案例,我们结合视频的观看时长调整了预加载策略。 现在介绍的是智能预加载策略,整体流程如下: 首先,在云端基于视频基础特征比如码率、时长、清晰度,网络以及时段、历史行为等特征,使用深度神经网络创建、训练模型,用于预测一个视频用户会深度消费还是快速滑过。 其次,模型导出、转换之后,部署在客户端,在视频开播之前预测消费深度。 最后,播放器仍保留之前的一级缓存,并作为最高优先级进行下载;所有的一级缓存都下载完成后,根据预测的消费深度调整二级缓存的大小,如果该条视频会重度消费,则开启二级缓存,否则放弃二级缓存。 这个方案目前还在实验中,后续我们也将持续探索机器学习在播放上的其他应用。 体验优化的效果需要被准确、客观的衡量,并且能准确反映用户的真实体验。 在起播环节,我们设计了两个P0指标,即首帧耗时和失败率,同时,我们也设计了若干个p1指标,包括缓存大小、缓存命中率、预渲染命中率,下载速度等,这些指标的波动直接会影响到P0指标。 在视频播放环节,我们设计了卡顿率、卡顿时长以及seek卡顿等P0指标,同时,设计了百秒卡顿时长、百秒卡顿次数、缓存利用率等p1指标作为对P0指标的补充。 基于以上指标以及视频基础信息、预加载预渲染策略信息,我们设计并上线了分层监控系统,自上往下共分为4个层级: P0指标:包括开播耗时、卡顿率等,这些是我们最为关注的核心指标 P1指标:作为对P0指标拆解和补充 策略指标:包括预加载开启率、命中率、预渲染开启率、命中率,这两个策略对播放体验的影响比较明显 最后一层是视频基础信息,包括码率、时长、画质分等,这些指标也会影响到核心性能指标 三、成本优化 前面介绍了我们短视频在播放体验方面所做的一些努力,经过前述的这些优化,目前我们短视频的播放流畅度已经达到行业内的一流水平。而随着业务的不断发展,播放的成本也随之水涨船高,成为业务必须要应对处理的首要问题,接下来将和大家分享下我们在播放成本优化方面的一些思考及实践方案。 3.1 成本拆解 首先,我们先了解下播放成本包含了哪些成本。它主要是由CDN成本、存储成本以及进行转码压缩等所需要的计算成本组成,而这里面CDN成本占了总成本的80%左右,是最大的一个成本来源,所以,接下来我们的分享主要是围绕如何降低CDN成本展开。 要知道怎么进行CDN成本的降低,就需要了解哪些是影响CDN成本的重要因素。如下图所示: 第一层拆解,CDN成本 = 单价x用量,这个相信大家都能很好理解。 第二层的拆解,正常情况下,用量=用户实际播放的视频时长乘以视频的码率,而前面我们也介绍过,为了提升视频播放的起播速度,降低播放过程中的卡顿率,我们会对视频进行预加载及预缓冲,那这部分量可能最后用户并没有产生播放行为,也就造成了流量的浪费。因此我们引出了流量利用率的概念,在后续还会详细介绍。这里我们需要知道的是CDN实际计费的用量=用户播放的时长x码率除以流量利用率。 那现在有4个最基础的因素会影响成本,分别是单价、时长、码率、流量利用率,其中时长是业务追求的增长目标,无法用以降本,因此其他三个因素就成了我们重点优化的方向,它们分别是。 寻找方案降低单价 对视频码率进行极致压缩 对利用率进行治理提升流量利用率 在正式介绍我们的降本方案之前,我们还需要先思考一个问题:成本的降低往往带来的是服务质量的降低,我们需要如何才能在保证播放体验的同时,降低播放成本,也就是大家经常讨论的,如何做到体验与成本的非零和博弈。 3.2 单价降低 本小节将为大家介绍我们的第一个降本方向,CDN单价的降低。 3.2.1 引入PCDN 我们的第一个方案是引入单价更低的PCDN技术,PCDN是目前一种新兴的内容分发网络,其主要是利用路由器、小盒子等廉价的边缘设备代替标准CDN的边缘节点,由于接入设备及接入网络更加廉价,故而成本相对于标准CDN,要低很多。 其网络架构如下图所示,APP通过SDK访问PCDN的边缘节点,如果内容热度值低,PCDN节点中没有该视频的缓存,则返回302状态码给到客户端,客户端再去访问标准CDN获取资源,当视频热度达到一定阈值时,PCDN会去标准CDN上回源获取对应的视频资源向客户端提供服务。 从这里我们可以看到,PCDN的节点性能相比标准CDN更差,而访问时会有一定几率进行302跳转,增加了链路的耗时,所以必然会对视频播放时的起播速度和卡顿率造成较大的影响。 对此,我们制定了多个优化措施,来降低播放体验的受损情况,在成本和体验之间进行平衡。 (1)播放器策略优化 第一个优化点是通过播放缓冲水位去控制是否走PCDN,在视频起播时使用高性能的标准CDN进行分片下载,而只有当前视频的缓冲数据达到阈值后,才使用PCDN进行下载,利用缓冲视频的时长,可以有效抵消PCDN的链路耗时增加。 第二个优化点是,在视频起播阶段发送1字节的探测包到PCDN节点,以此来确定PCDN节点上是否存在对应的视频内容,不存在时则后续分片都从标准CDN拉取,存在的话后续再走PCDN,这样可以大大减少302跳转发生的概率。 经过以上两个优化后,引入PCDN对我们的播放体验已基本不会产生负面影响了。以此,我们达到了保证播放体验的同时,降低了CDN成本的目的。 (2)业务策略优化 由于PCDN节点服务的主要是热点视频,因此我们对热点分发的场景进行了梳理,对这些场景用到的视频提前预热到边缘节点。由于做了预热,PCDN节点提前缓存了相关视频,出现302跳转的概率进一步减少,因此我们可以适当降低缓冲水位的阈值,提前请求到PCDN节点。基于此方案,我们做了相关的A/B实验,实验的结果是,我们在保证QoE不变的情况下,提升了PCDN的分享率,即,会有更多的流量走到PCDN节点上,进一步降低了CDN成本。 当前我们PCDN分享率在46%左右,在探测成功后,只有1%以内的流量会出现302跳转,基本可以忽略不计。通过线上长期实验组的观测,卡顿率和起播耗时上下波动,无显著负向。 以上是我们进行单价降低的第一个方案,接入PCDN,接下来我们看下另外一个方案。 3.2.2 共享闲时带宽 行业内CDN计费的方式有多种,包括流量计费,峰值带宽计费等,对于峰值带宽计费,是以每天的带宽最高点作为计费值的,这种计费方式,对于持续稳定的流量会更加合适。而我们短视频是一个用户实时消费视频的应用,访问热度会有明显的波峰和波谷,比如中午大家休息的时候以及下班的时候会有更多的时间去看视频,而夜里睡觉时,业务的流量则相对较低。正常情况下我们CDN的带宽波形如下图所示,可以看到闲时我们的带宽是很低的,造成了很大的浪费。 针对此种情况,我们和公司内其他业务进行合作,引入了他们的流量进行填谷,共享了我们的闲时带宽。可以看到填谷后,蓝色区域的比重明显增加了很多,其他业务会针对这部分流量进行成本分担,因此相当于降低了我们的成本单价。通过上述的PCDN及共享闲时带宽,CDN的单价得到了大幅的降低,从而有效节省了CDN成本,是我们进行降本的重要手段。 3.3 极致压缩 接下来,是我们降本的第二个方向,对视频进行极致的压缩从而降低视频的码率。 我们当下遇到的问题是:一个视频的清晰度是和码率强相关的,而为了达到相同的清晰度,不同内容场景的视频所需的码率是不一样的。 先前,为了保证用户的播放体验,减少低质视频的出现,我们设置的码率标准较高,导致很多视频没有得到有效的压缩。 在解决这些问题时,我们面临着这样几个困难: 第一是内容库中有千万量级的视频内容,内容量非常大; 第二是这些视频场景非常复杂,千变万化; 第三则是这些原始视频的质量也是参差不齐的。 为了能够在这样的情况下进行成本优化,我们需要根据视频的内容特征,自适应调整编码参数,在保证视频清晰度的前提下,对视频进行极致压缩。 接下来,来看下我们是如何做的。 首先我们基于神经网络,自研了一套内容自适应编码算法。算法模型的训练过程如下:首先第一步我们会根据内容库中的场景标签,从内容库中收集足够大视频数据集作为模型的训练数据。 然后对训练集中的视频进行不同比例的压缩转码作为Ground Truth,再对压缩后的视频提取特征,这些特征包括视频的复杂度特征、码率信息、画质特征、码流特征等;最后利用上述特征,进行神经网络拟合训练,得到视频质量与压缩率的关系模型,该模型可以预测压缩比例和视频压缩质量之间的对应关系曲线。 上图展示的是我们模型的预测效果,白色弧线是视频在经过不同比例压缩后得到的VMAF曲线,是实际的Ground Truth,而蓝色曲线则是我们模型的预测曲线,可以看到预测曲线和Ground Truth非常接近。于是,我们便可以通过预测曲线,在保证清晰度一致的情况下,确定不同视频需要的编码参数,达到内容自适应编码的目的。 最后再来看下我们极致压缩的完整流程: 首先第一步是对视频进行前置增强处理,这一步处理的目的是提升原始视频的画质,从而可以抵消一部分视频编码带来的损伤,另外去除噪声等退化也有利于压缩过程中降低视频的码率。 在经过增强修复后,需要对视频进行场景划分,一个视频可能包含多个场景,这些场景所需要的编码参数也不一样,通常我们称之为Per-title分场景编码,更细粒度的选择不同的编码参数对视频进行压缩。 第三步就是对每一个场景的视频提取视频特征,通过我们的自适应模型决策出最佳的编码参数,进行编码合成,最后得到输出视频。 通过这几步的处理,我们的压缩率相比之前有了大幅度的降低,通过线上的数据统计,我们的平均压缩率从60%降低到了40%,可以看到这个优化效果非常明显,以上就是我们极致压缩的方案,通过进一步压缩码率,降低我们的CDN成本。 3.4 利用率治理 我们的最后一个优化方向是利用率治理。 先解释下什么是流量利用率:在播放过程中,为了提升播放的流畅度,需要提前去缓存当前视频以及预加载后面的视频,同时网络层也会有socket的buffer,用户如果使用不到这些流量,那就会产生流量浪费,这些浪费的流量与用户实际播放的流量相加,就是CDN实际产生的流量,流量利用率就等于实际播放的流量除以CDN实际产生的流量。 由此可见,在整个播放链路上,都存在流量的浪费,而我们希望通过利用率的治理,控制并减少这些浪费的产生。 3.4.1 利用率漏斗建设 我们需要治理的第一个问题是:在版本迭代的过程中,播放的策略也是在不断优化的,比如我们可能为了体验着想,增加了预加载的数量,或者做了多级预加载。但是在做这些优化的时候,我们无法有效的衡量每个优化究竟对CDN成本带来了多大的变化,会不会增加流量的浪费。 对于这个问题,我们的解决方案是,针对每个版本,建立了如下图所示利用率漏斗,并加入到了灰度报告中,严格监控每个版本出现的流量浪费情况,防止播放策略优化导致CDN成本大幅增加。 3.4.2 利用率提升 我们需要治理的第二个问题是:对于预加载或者预缓冲等策略,我们都会设置一个上限阈值,保证体验的同时防止消耗过多流量,但是这个阈值一直都是以我们工程师的经验设置的,无法确切的知道这个阈值是否合理。 针对这个问题,我们的治理方案是,通过前述建立的漏斗数据,针对阈值进行线上A/B实验,通过收集不同阈值下体验和成本的变化数据,找到投产比拐点,从而确定最优阈值。 3.4.3 治理效果 这边展示了我们治理后的效果。 (1)首先在治理前,如下图左侧显示,有两个突刺点,这是因为某些版本优化时,没有识别到成本的增长量级,并且在灰度期间无法明显看出成本的变化,及时止损,最终导致我们的CDN带宽大幅增长。而在治理后,可以看到,我们的带宽变得平稳很多,不再出现突刺点,带宽突增问题得到了有效。 (2)其次,如下图右侧所示,在治理前,我们的流量利用率在60%左右,而在治理后,我们在保证体验不受损的情况下,将利用率提升到了70%,从而节省了相应的CDN成本。 通过对流量利用率的监控和治理,我们可以清晰的掌控播放链路中每个节点可能产生的流量及带宽情况,找到成本优化点,降低我们的CDN成本。 四、总结&展望 如下图所示,可以看到我们的优化结合了大数据、A/B实验、AI技术等,通过对这些技术的应用,我们进行了播放体验和播放成本两个方面的优化。 首先是对播放体验优化,我们依次从网络层、播放层、应用层进行了相关的策略优化,这里面主要包括分片下载、预加载/预渲染、分级缓存等策略。 其次是播放成本的优化,我们分别从单价、码率、利用率等方向进行了降本,这里面主要包括PCDN、极致压缩、利用率治理等方案。 这些优化方案,是我们短视频团队长时间的实践积累,帮助我们在体验和成本之间做到了双赢。 最后是我们未来的一些展望,我们会持续聚焦音视频前沿技术,在压缩编码方面,我们会去研究引入H266技术,进一步压缩视频的码率,而在增强方面,我们会对端侧增强技术进行预研,通过端云协同增强,进一步做到降本增效。 END 猜你喜欢 vivo 海量微服务架构最新实践 vivo 智能活动中台-悟空系统建设之路 vivo 海量基础数据计算架构应用实践 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 得物自研 API 网关实践之路

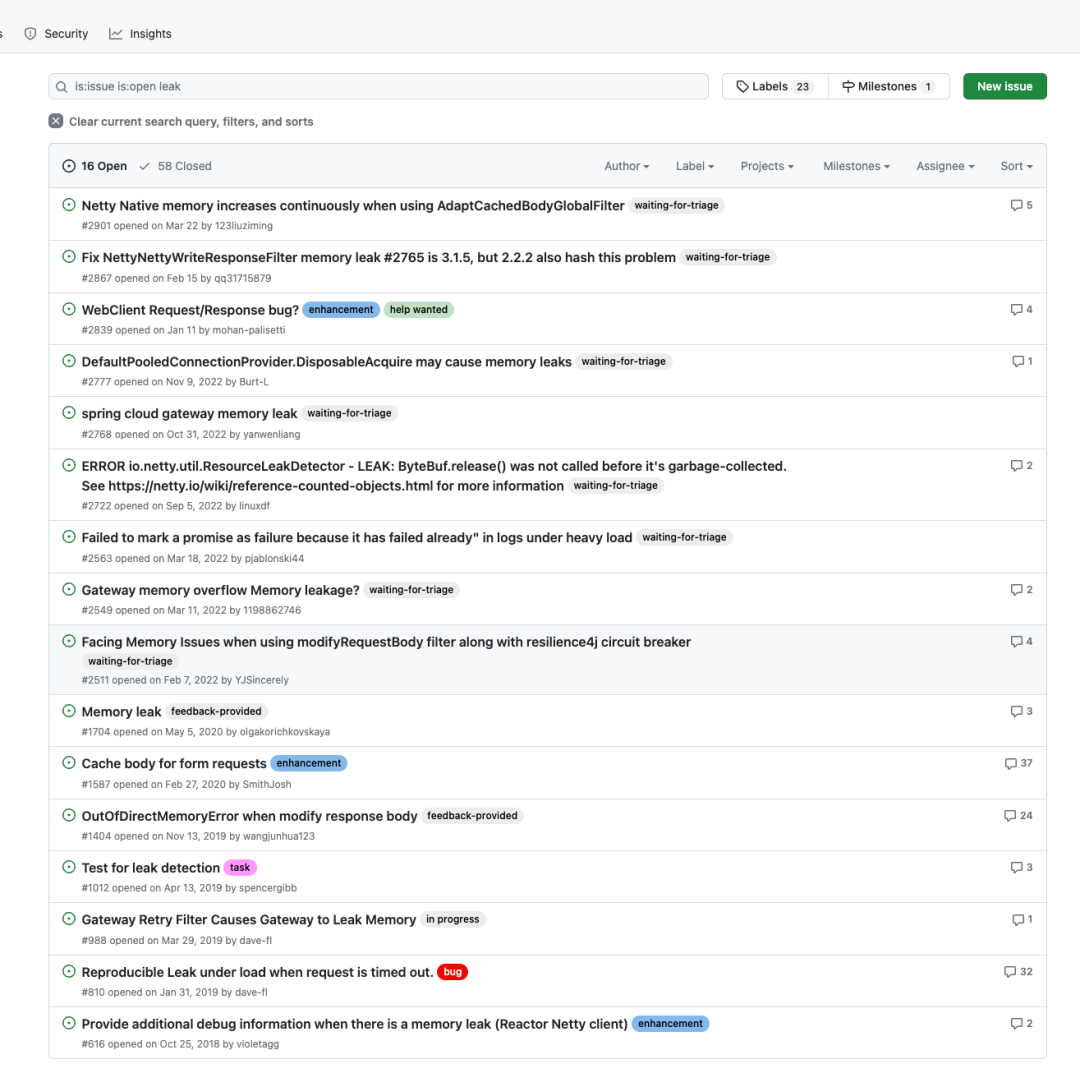
一、业务背景 老网关使用 Spring Cloud Gateway (下称SCG)技术框架搭建,SCG基于webflux 编程范式,webflux是一种响应式编程理念,响应式编程对于提升系统吞吐率和性能有很大帮助; webflux 的底层构建在netty之上性能表现优秀;SCG属于spring生态的产物,具备开箱即用的特点,以较低的使用成本助力得物早期的业务快速发展;但是随着公司业务的快速发展,流量越来越大,网关迭代的业务逻辑越来越多,以及安全审计需求的不断升级和稳定性需求的提高,SCG在以下几个方面逐步暴露了一系列的问题。 网络安全 从网络安全角度来讲,对公网暴露接口无疑是一件风险极高的事情,网关是对外网络流量的重要桥梁,早期的接口暴露采用泛化路由的模式,即通过正则形式( /api/v1/app/order/** )的路由规则开放接口,单个应用服务往往只配置一个泛化路由,后续上线新接口时外部可以直接访问;这带来了极大的安全风险,很多时候业务开发的接口可能仅仅是内部调用,但是一不小心就被泛化路由开放到了公网,甚至很多时候没人讲得清楚某个服务具体有多少接口属于对外,多少对内;另一方面从监控数据来看,黑产势力也在不断对我们的接口做渗透试探。 协同效率 引入了接口注册机制,所有对外暴露接口逐一注册到网关,未注册接口不可访问,安全的问题得到了解决但同时带来了性能问题,SCG采用遍历方式匹配路由规则,接口注册模式推广后路由接口注册数量迅速提升到3W+,路由匹配性能出现严重问题;泛化路由的时代,一个服务只有一个路由配置,变动频率很低,配置工作由网关关开发人员负责,效率尚可,接口注册模式将路由工作转移到了业务开发同学的身上,这就得引入一套完整的路由审核流程,以提升协同效率;由于路由信息早期都存在配置中心,同时这么大的数据量给配置中心也带来极大的压力和稳定性风险。 性能与维护成本 业务迭代的不断增多,也使得API网关堆积了很多的业务逻辑,这些业务逻辑分散在不同的filter中,为了降低开发成本,网关只有一套主线分支,不同集群部署的代码完全相同,但是不同集群的业务属性不同,所需要的filter 逻辑是不一样的;如内网网关集群几乎没什么业务逻辑,但是App集群可能需要几十个filter的逻辑协同工作;这样的一套代码对内网网关而言,存在着大量的性能浪费;如何平衡维护成本和运行效率是个需要思考的问题。 稳定性风险 API网关作为基础服务,承载全站的流量出入,稳定性无疑是第一优先级,但其定位决定了绝不可能是一个简单的代理层,在稳定运行的同时依然需要承接大量业务需求,例如C端用户登录下线能力,App强升能力,B端场景下的鉴权能力等;很难想象较长一段时间以来,网关都保持着双周一次的发版频率;频繁的发版也带来了一些问题,实例启动初期有很多资源需要初始化,此时承接的流量处理时间较长,存在着明显的接口超时现象;早期的每次发版几乎都会导致下游服务的接口短时间内超时率大幅提高,而且往往涉及多个服务一起出现类似情况;为此甚至拉了一个网关发版公告群,提前置顶发版公告,让业务同学和NOC有一个心里预期;在发布升级期间尽可能让业务服务无感知这是个刚需。 定制能力 流量灰度是网关最常见的功能之一,对于新版本迭代,业务服务的某个节点发布新版本后希望引入少部分流量试跑观察,但很遗憾SCG原生并不支持,需要对负载均衡算法进行手动改写才可以,此外基于流量特征的定向节点路由也需要手动开发,在SCG中整个负载均衡算法属于比较核心的模块,不对外直接暴露,存在较高的改造成本。 B端业务和C端业务存在着很大的不同,例如对接口的响应时间的忍受度是不一样的,B端场景下下载一个报表用户可以接受等待10s或者1分钟,但是C端用户现在没有这个耐心。作为代理层针对以上的场景,我们需要针对不同接口定制不同的超时时间,原生的SCG显然也不支持。 诸如此类的定制需求还有很多,我们并不寄希望于开源产品能够开箱即用满足全部需求,但至少定制性拓展性足够好。上手改造成本低。 二、技术痛点 SCG主要使用了webflux技术,webflux的底层构建在reactor-netty之上,而reactor-netty构建于netty之上;SCG能够和spring cloud 的技术栈的各组件,完美适配,做到开箱即用,以较低的使用成本助力得物早期的业务快速发展;但是使用webflux也是需要付出一定成本,首先它会额外增加编码人员的心智负担,需要理解流的概念和常用的操作函数,诸如map, flatmap, defer 等等;其次异步非阻塞的编码形式,充斥着大量的回调函数,会导致顺序性业务逻辑被割裂开来,增加代码阅读理理解成本;此外经过多方面评估我们发现SCG存在以下缺点: 内存泄露问题 SCG存在较多的内存泄漏问题,排查困难,且官方迟迟未能修复,长期运行会导致服务触发OOM并宕机;以下为github上SCG官方开源仓库的待解决的内存泄漏问题,大约有16个之多。 SCG内存泄漏BUG 下图可以看到SCG在长期运行的过程中内存使用一直在增长,当增长到机器内存上限时当前节点将不可用,联系到网关单节点所承接的QPS 在几千,可想而知节点宕机带来的危害有多大;一段时间以来我们需要对SCG网关做定期重启。 SCG生产实例内存增长趋势 响应式编程范式复杂 基于webflux 中的flux 和mono ,在对request和response信息读取修改时,编码复杂度高,代码理解困难,下图是对body信息进行修改时的代码逻辑。 对requestBody 进行修改的方式 多层抽象的性能损耗 尽管相比于传统的阻塞式网关,SCG的性能已经足够优秀,但相比原生的netty仍然比较低下,SCG依赖于webflux编程范式,webflux构建于reactor-netty之上,reactor-netty 构建于netty 之上,多层抽象存在较大的性能损耗。 SCG依赖层级 一般认为程序调用栈越深性能越差;下图为只有一个filter的情况下的调用栈,可以看到存在大量的 webflux 中的 subscribe() 和onNext() 方法调用,这些方法的执行不关联任何业务逻辑,属于纯粹的框架运行层代码,粗略估算下没有引入任何逻辑的情况下SCG的调用栈深度在 90+ ,如果引入多个filter处理不同的业务逻辑,线程栈将进一步加深,当前网关的业务复杂度实际栈深度会达到120左右,也就是差不多有四分之三的非业务栈损耗,这个比例是有点夸张的。 SCG filter 调用栈深度 路由能力不完善 原生的的SCG并不支持动态路由管理,路由的配置信息通过大量的KV配置来做,平均一个路由配置需要三到四条KV配置信息来支撑,这些配置数据一般放在诸如Apollo或者ark 这样的配置中心,即使是添加了新的配置SCG并不能动态识别,需要引入动态刷新路由配置的能力。另一方面路由匹配算法通过遍历所有的路由信息逐一匹配的模式,当接口级别的路由数量急剧膨胀时,性能是个严重问题。 SCG路由匹配算法为On时间复杂度 预热时间长,冷启动RT尖刺大 SCG中LoadBalancerClient 会调用choose方法来选择合适的endpoint 作为本次RPC发起调用的真实地址,由于是懒加载,只有在有真实流量触发时才会加载创建相关资源;在触发底层的NamedContextFactory#getContext 方法时存在一个全局锁导致,woker线程在该锁上大量等待。 NamedContextFactory#getContext方法存在全局锁 SCG发布时超时报错增多 定制性差,数据流控制耦合 SCG在开发运维过程中已经出现了较多的针对源码改造的场景,如动态路由,路由匹配性能优化等;其设计理念老旧,控制流和数据流混合使用,架构不清晰,如对路由管理操作仍然耦合在filter中,即使引入spring mvc方式管理,依然绑定使用webflux编程范式,同时也无法做到控制流端口独立,存在一定安全风险。 filter中对路由进行管理 三、方案调研 理想中的网关 综合业务需求和技术痛点,我们发现理想型的网关应该是这个样子的: 支持海量接口注册,并能够在运行时支持动态添加修改路由信息,具备出色路由匹配性能 编程范式尽可能简单,降低开发人员心智负担,同时最好是开发人员较为熟悉的语言 性能足够好,至少要等同于目前SCG的性能,RT99线和ART较低 稳定性好,无内存泄漏,能够长时间持续稳定运行,发布升级期间要尽可能下游无感 拓展能力强,支持超时定制,多网络协议支持,http,Dubbo等,生态完善 架构设计清晰,数据流与控制流分离,集成UI控制面 开源网关对比 基于以上需求,我们对市面上的常见网关进行了调研,以下几个开源方案对比。 结合当前团队的技术栈,我们倾向于选择Java技术栈的开源产品,唯一可选的只有zuul2 ,但是zuul2路由注册和稳定性方面也不能够满足我们的需求,也没有实现数控分离的架构设计。因此唯有走上自研之路。 四、自研架构 通常而言代理网关分为透明代理与非透明代理,其主要区别在于对于流量是否存在侵入性,这里的侵入性主要是指对请求和响应数据的修改;显然API Gateway的定位决定了必然会对流量进行数据调整,常见的调整主要有 添加或者修改head 信息,加密或者解密 query params head ,以及 requestbody 或者responseBody,可以说http请求的每一个部分数据都存在修改的可能性,这要求代理层必须要完全解析数据包信息,而非简单的做一个路由器转发功能。 传统的服务器架构,以reactor架构为主。boss线程和worker线程的明确分工,boss线程负责连接建立创建;worker线程负责已经建立的连接的读写事件监听处理,同时会将部分复杂业务的处理放到独立的线程池中,进而避免worker线程的执行时间过长影响对网络事件处理的及时性;由于网关是IO密集型服务,相对来说计算内容较少,可以不必引入这样的业务线程池;直接基于netty 原生reactor架构实现。 Reactor多线程架构 为了只求极致性能和降低多线程编码的数据竞争,单个请求从接收到转发后端,再到接收后端服务响应,以及最终的回写给client端,这一系列操作被设计为完全闭合在一个workerEventLoop线程中处理;这需要worker线程中执行的IO类型操作全部实现异步非阻塞化,确保worker线程的高速运转;这样的架构和NGINX很类似;我们称之为 thread-per-core模式。 API网关组件架构 数据流控制流分离 数据面板专注于流量代理,不处理任何admin 类请求,控制流监听独立的端口,接收管理指令。 五、核心设计 请求上下文封装 新的API网关底层仍然基于Netty,其自带的http协议解析handler可以直接使用。基于netty框架的编程范式,需要在初始化时逐一注册用到的 Handler。 Client到Proxy链路Handler 执行顺序 HttpServerCodec 负责HTTP请求的解析;对于体积较大的Http请求,客户端可能会拆成多个小的数据包进行发送,因此在服务端需要适当的封装拼接,避免收到不完整的http请求;HttpObjectAggregator 负责整个请求的拼装组合。 拿到HTTP请求的全部信息后在业务handler 中进行处理;如果请求体积过大直接抛弃;使用ServerWebExchange 对象封装请求上下文信息,其中包含了client2Proxy的channel, 以及负责处理该channel 的eventLoop 线程等信息,考虑到整个请求的处理过程中可能在不同阶段传递一些拓展信息,引入了getAttributes 方法 用于存储需要传递的数据;此外ServerWebExchange 接口的基本遵循了SCG的设计规范,保证了在迁移业务逻辑时的最小化改动;具体到实现类,可以参考如下代码: @Getter public class DefaultServerWebExchange implements ServerWebExchange { private final Channel client2ProxyChannel; private final Channel proxy2ClientChannel; private final EventLoop executor; private ServerHttpRequest request; private ServerHttpResponse response; private final Map<String, Object> attributes; } DefaultServerWebExchange Client2ProxyHttpHandler作为核心的入口handler 负责将接收到的FullHttpRequest 进行封装和构建ServerWebExchange 对象,其核心逻辑如下。可以看到对于数据读取封装的逻辑较为简单,并没有植入常见的业务逻辑,封装完对象后随即调用 Request filter chain。 @Override protected void channelRead0(ChannelHandlerContext ctx, FullHttpRequest fullHttpRequest) { try { Channel client2ProxyChannel = ctx.channel(); DefaultServerHttpRequest serverHttpRequest = new DefaultServerHttpRequest(fullHttpRequest, client2ProxyChannel); ServerWebExchange serverWebExchange = new DefaultServerWebExchange(client2ProxyChannel,(EventLoop) ctx.executor(), serverHttpRequest, null); // request filter chain this.requestFilterChain.filter(serverWebExchange); }catch (Throwable t){ log.error("Exception caused before filters!\n {}",ExceptionUtils.getStackTrace(t)); ByteBufHelper.safeRelease(fullHttpRequest); throw t; } } Client2ProxyHttpHandler 精简后的代码 FilterChain设计 FilterChain可以解决异步请求发送出去后,还没收到响应,但是顺序逻辑已经执行完成的尴尬;例如当我们在上文的。 channelRead0 方法中发起某个鉴权RPC调用时,出于性能考虑只能使用非阻塞的方式,按照netty的非阻塞编码API最终要引入类似如下的 callback 机制,++在业务逻辑上在没有收到RPC的响应之前该请求的处理应该“暂停”,等待收到响应时才能继续后续的逻辑执行++; 也就是下面代码中的下一步执行逻辑并不能执行,正确的做法是将nextBiz() 方法包裹在 callBack() 方法内,由callBack() 触发后续逻辑的执行;这只是发起一次RPC调用的情况,在实际的的日常研发过程中存在着鉴权,风控,集群限流(Redis)等多次RPC调用,这就导致这样的非阻塞代码编写将异常复杂。 ChannelFuture writeFuture = channel.writeAndFlush(asyncRequest.httpRequest); writeFuture.addListener(future -> { if(future.isSuccess()) { callBack(); } } ); nextBiz(); 非阻塞调用下的业务逻辑编排 对于这样的复杂场景,采用filterChain模式可以很好的解决;首先RequestFilterChain().filter(serverWebExchange); 后不存在任何逻辑;发起请求时 ,当前filter执行结束,由于此时没有调用chain.filter(exchange); 所以不会继续执行下一个filter,发送请求到下游的逻辑也不会执行;当前请求的处理流程暂时中止,eventloop 线程将切换到其他请求的处理过程上;当收到RPC响应时,chain.filter(exchange) 被执行,之前中断的流程被重新拉起。 public void filter(ServerWebExchange exchange) { if (this.index < filters.size()) { GatewayFilter filter = filters.get(this.index); DefaultGatewayFilterChain chain = new DefaultGatewayFilterChain(this, this.index + 1); try { filter.filter(exchange, chain); }catch (Throwable e){ log.error("Filter chain unhandle backward exception! Request path {}, FilterClass: {}, exception: {}", exchange.getRequest().getPath(), filter.getClass(), ExceptionUtils.getFullStackTrace(e)); ResponseDecorator.failResponse(exchange,500, "网关内部错误!filter chain exception!"); } } } 基于filterChain的调用模式 对于filter的执行需要定义先后顺序,这里参考了SCG的方案,每个filter返回一个order值。不同的地方在于DAG的设计不允许 order值重复,因为在order重复的情况下,很难界定到底哪个Filter 先执行,存在模糊地带,这不是我们期望看到的;DAG中的Filter 执行顺序为order值从小到大,且不允许order值重复。为了易于理解,这里将Filter拆分为了 requestFilter,和responseFilter;分别代表请求的处理阶段 和拿到下游响应阶段,responseFilter 遵循同样的逻辑执行顺序与不可重复性。 public interface GatewayFilter extends Ordered { void filter(ServerWebExchange exchange, GatewayFilterChain chain); } public interface ResponseFilter extends GatewayFilter { } public interface RequestFilter extends GatewayFilter { } filter接口设计 路由管理与匹配 以SCG网关注册的路由数量为基准,网关节点的需要支撑的路由规则数量是上万级别的,按照得物目前的业务量,上限不超过5W,为了保证匹配性能,路由规则放在分布式缓存中显然是不合适的,需要保存在节点的内存中。类似于在nginx上配置上万条location 规则,手动维护难度可想而知,即使在配置中心管理起来也很麻烦,所以需要引入独立路由管理模块。 在匹配的效率上也需要进一步优化,SCG的路由匹配策略为普通的循环迭代逐一匹配,时间效率为On,在路由规则膨胀到万级别后,性能急剧拉胯,结合得物的接口规范,新网关采用Hash匹配模式,将匹配效率提升到O1;hash的key为接口的path, 需要强调的是在同一个网关集群中,path是唯一的,这里的path并不等价于业务服务的接口path, 绝大多数时候存在一些剪裁,例如在业务服务的编写的/order/detail接口,在网关实际注册的接口可能为/api/v1/app/order/detail;由于使用了path作为key进行hash匹配。常见的restful 接口显然是不支持的,确切的讲基于path传参数模式的接口均不支持;出于某些历史原因,网关保留了类似nginx 的前缀匹配的支持,但是这部分功能不对外开放。 public class Route implements Ordered { private final String id; private final int skipCount; private final URI uri; } route类设计 route的URI字段中包含了,需要路由到的具体服务名,这里也可以称之为host ,route 信息会暂存在 exchange对象的 attributes 属性中, 在后续的loadbalance阶段host信息会被进一步替换为真实的 endpoint。 private Route lookupRoute(ServerWebExchange exchange) { String path = exchange.getRequest().getPath(); CachingRouteLocator locator = (CachingRouteLocator) routeLocator; Route exactRoute = pathRouteMap.getOrDefault(path, null); if (exactRoute != null) { exchange.getAttributes().put(DAGApplicationConfig.GATEWAY_ROUTE_CACHE, route); return exactRoute; } } 路由匹配逻辑 单线程闭环 为了更好地利用CPU,以及减少不必要的数据竞争,++将单个请求的处理全部闭合在一个线程当中++;这意味着这个请求的业务逻辑处理,RPC调用,权限验证,限流token获取都将始终由某个固定线程处理。netty中 网络连接被抽象为channel,channel 与eventloop线程的对应关系为 N对1,一个channel 仅能被一个eventloop 线程所处理,这在处理用户请求时没有问题,但是在接收请求完毕向下游转发请求时,我们碰到了一些挑战,下游的连接往往是连接池在管理,连接池的管理是另一组eventLoop线程在负责,++为了保持闭环需要将连接池的线程设定为处理当前请求的线程++,并且只能是这一个线程;这样一来,默认状态下启动的N个线程(N 与机器核心数相同),分别需要管理一个连接池;thread-per-core 模式的性能已经在nginx开源组件上得到验证。 连接管理优化 为了满足单线程闭环,需要将连接池的管理线程设置为当前的 eventloop 线程,最终我们通过threadlocal 进行线程与连接池的绑定;通常情况下netty自带的连接池 FixedChannelPool 可以满足我们大部分场景下的需求,这样的连接池也是适用于多线程的场景;由于新网关使用thread-per-core模式并将请求处理的全生命周期闭合在单个线程中,所有为了线程安全的额外操作不再必要且存在性能浪费;为此需要对原生连接池做一些优化, 连接的获取和释放简化为对链表结构的简单getFirst , addLast。 对于RPC 而言,无论是HTTP,还是Dubbo,Redis等最终底层都需要用到TCP连接,将构建在TCP连接上的数据解析协议与连接剥离后,我们发现这种纯粹的连接管理是可以复用的,对于连接池而言不需要知道具体连接的用途,只需要维持到特定endpoint的连接稳定即可,那么这里的RPC服务的连接仍然可以放入连接池中进行托管;最终的连接池设计架构图。 AsyncClient设计 对于七层流量而言基本全部都是Http请求,同样在RPC请求中 http协议也占了大多数,考虑到还会存在少量的dubbo, Redis 等协议通信的场景。因此需要抽象出一套异步调用框架来支撑;这样的框架需要具备超时管理,回调执行,错误输出等功能,更重要的是具备协议无关性质, 为了更方便使用需要支持链式调用。 发起一次RPC调用通常可以分为以下几步: 获取目标地址和使用的协议, 目标服务为集群部署时,需要使用loadbalance模块 封装发送的请求,这样的请求在应用层可以具体化为某个Request类,网络层序列化为二进制数据流 出于性能考虑选择非阻塞式发送,发送动作完成后开始计算超时 接收数据响应,由于采用非阻塞模式,这里的发送线程并不会以block的方式等待数据 在超时时间内完成数据处理,或者触发超时导致连接取消或者关闭 AsyncClient 模块内容并不复杂,AsyncClient为抽象类不区分使用的网络协议;ConnectionPool 作为连接的管理者被client所引用,获取连接的key 使用 protocol+ip+port 再适合不过;通常在某个具体的连接初始化阶段就已经确定了该channel 所使用的协议,因此初始化时会直接绑定协议Handler;当协议为HTTP请求时,HttpClientCodec 为HTTP请求的编解码handler;也可以是构建在TCP协议上的 Dubbo, Mysql ,Redis 等协议的handler。 首先对于一个请求的不同执行阶段需要引入状态定位,这里引入了 STATE 枚举: enum STATE{ INIT,SENDING,SEND,SEND_SUCCESS,FAILED,TIMEOUT,RECEIVED } 其次在执行过程中设计了 AsyncContext作为信息存储的载体,内部包含request和response信息,作用类似于上文提到的ServerWebExchange;channel资源从连接池中获取,使用完成后需要自动放回。 public class AsyncContext<Req, Resp> implements Cloneable{ STATE state = STATE.INIT; final Channel usedChannel; final ChannelPool usedChannelPool; final EventExecutor executor; final AsyncClient<Req, Resp> agent; Req request; Resp response; ResponseCallback<Resp> responseCallback; ExceptionCallback exceptionCallback; int timeout; long deadline; long sendTimestamp; Promise<Resp> responsePromise; } AsyncContext AsyncClient 封装了基本的网络通信能力,不拘泥于某个固定的协议,可以是Redis, http,Dubbo 等。当将数据写出去之后,该channel的非阻塞调用立即结束,在没有收到响应之前无法对AsyncContext 封装的数据做进一步处理,如何在收到数据时将接收到的响应和之前的请求管理起来这是需要面对的问题,channel 对象 的attr 方法可以用于临时绑定一些信息,以便于上下文切换时传递数据,可以在发送数据时将AsyncContext对象绑定到该channel的某个固定key上。当channel收到响应信息时,在相关的 AsyncClientHandler 里面取出AsyncContext。 public abstract class AsyncClient<Req, Resp> implements Client { private static final int defaultTimeout = 5000; private final boolean doTryAgain = false; private final ChannelPoolManager channelPoolManager = ChannelPoolManager.getChannelPoolManager(); protected static AttributeKey<AsyncRequest> ASYNC_REQUEST_KEY = AttributeKey.valueOf("ASYNC_REQUEST"); public abstract ApplicationProtocol getProtocol(); public AsyncContext<Req, Resp> newRequest(EventExecutor executor, String endpoint, Req request) { final ChannelPoolKey poolKey = genPoolKey(endpoint); ChannelPool usedChannelPool = channelPoolManager.acquireChannelPool(executor, poolKey); return new AsyncContext<>(this,executor,usedChannelPool,request, defaultTimeout, executor.newPromise()); } public void submitSend(AsyncContext<Req, Resp> asyncContext){ asyncContext.state = AsyncContext.STATE.SENDING; asyncContext.deadline = asyncContext.timeout + System.currentTimeMillis(); ReferenceCountUtil.retain(asyncContext.request); Future<Resp> responseFuture = trySend(asyncContext); responseFuture.addListener((GenericFutureListener<Future<Resp>>) future -> { if(future.isSuccess()){ ReferenceCountUtil.release(asyncContext.request); Resp response = future.getNow(); asyncContext.responseCallback.callback(response); } }); } /** * 尝试从连接池中获取连接并发送请求,若失败返回错误 */ private Promise<Resp> trySend(AsyncContext<Req, Resp> asyncContext){ Future<Channel> acquireFuture = asyncContext.usedChannelPool.acquire(); asyncContext.responsePromise = asyncContext.executor.newPromise(); acquireFuture.addListener(new GenericFutureListener<Future<Channel>>() { @Override public void operationComplete(Future<Channel> channelFuture) throws Exception { sendNow(asyncContext,channelFuture); } }); return asyncContext.responsePromise; } private void sendNow(AsyncContext<Req, Resp> asyncContext, Future<Channel> acquireFuture){ boolean released = false; try { if (acquireFuture.isSuccess()) { NioSocketChannel channel = (NioSocketChannel) acquireFuture.getNow(); released = true; assert channel.attr(ASYNC_REQUEST_KEY).get() == null; asyncContext.usedChannel = channel; asyncContext.state = AsyncContext.STATE.SEND; asyncContext.sendTimestamp = System.currentTimeMillis(); channel.attr(ASYNC_REQUEST_KEY).set(asyncContext); ChannelFuture writeFuture = channel.writeAndFlush(asyncContext.request); channel.eventLoop().schedule(()-> doTimeout(asyncContext), asyncContext.timeout, TimeUnit.MILLISECONDS); } else { asyncContext.responsePromise.setFailure(acquireFuture.cause()); } } catch (Exception e){ throw new Error("Unexpected Exception.............!"); }finally { if(!released) { ReferenceCountUtil.safeRelease(asyncContext.request); } } } } AsyncClient核心源码 public class AsyncClientHandler extends SimpleChannelInboundHandler { @Override protected void channelRead0(ChannelHandlerContext ctx, Object msg) throws Exception { AsyncContext asyncContext = ctx.attr(AsyncClient.ASYNC_REQUEST_KEY).get(); try { asyncContext.state = AsyncContext.STATE.RECEIVED; asyncContext.releaseChannel(); asyncContext.responsePromise.setSuccess(msg); }catch (Throwable t){ log.error("Exception raised when set Success callback. Exception \n: {}", ExceptionUtils.getFullStackTrace(t)); ByteBufHelper.safeRelease(msg); throw t; } } } AsyncClientHandler 通过上面几个类的封装得到了一个易用使用的 AsyncClient,下面的代码为调用权限系统的案例: final FullHttpRequest httpRequest = HttpRequestUtil.getDefaultFullHttpRequest(newAuthReq, serviceInstance, "/auth/newCheckSls"); asyncClient.newRequest(exchange.getExecutor(), endPoint,httpRequest) .timeout(timeout) .onComplete(response -> { String checkResultJson = response.content().toString(CharsetUtil.UTF_8); response.release(); NewAuthResult result = Jsons.parse(checkResultJson,NewAuthResult.class); TokenResult tokenResult = this.buildTokenResult(result); String body = exchange.getAttribute(DAGApplicationConfig.REQUEST_BODY); if (tokenResult.getUserInfoResp() != null) { UserInfoResp userInfo = tokenResult.getUserInfoResp(); headers.set("userid", userInfo.getUserid() == null ? "" : String.valueOf(userInfo.getUserid())); headers.set("username", StringUtils.isEmpty(userInfo.getUsername()) ? "" : userInfo.getUsername()); headers.set("name", StringUtils.isEmpty(userInfo.getName()) ? "" : userInfo.getName()); chain.filter(exchange); } else { log.error("{},heads: {},response: {}", path, headers, tokenResult); int code = tokenResult.getCode() != null ? tokenResult.getCode().intValue() : ResultCode.UNAUTHO.code; ResponseDecorator.failResponse(exchange, code, tokenResult.getMsg()); } }) .onError(throwable -> { log.error("Request service {},occur an exception {}",endPoint, throwable); ResponseDecorator.failResponseWithStatus(exchange,HttpResponseStatus.INTERNAL_SERVER_ERROR,"AuthFilter 验证失败"); }) .sendRequest(); asyncClient的使用 请求超时管理 一个请求的处理时间不能无限期拉长, 超过某个阈值的情况下App的页面会被取消 ,长时间的加载卡顿不如快速报错带来的体验良好;显然网关需要针对接口做超时处理,尤其是在向后端服务发起请求的过程,通常我们会设置一个默认值,例如3秒钟,超过这个时间网关会向请求端回写timeout的失败信息,由于网关下游接入的服务五花八门,可能是RT敏感型的C端业务,也可能是逻辑较重B端服务接口,甚至是存在大量计算的监控大盘接口。这就导致不同接口对超时时间的诉求不一样,因此针对每个接口的超时时间设定应该被独立出来,而不是统一配置成一个值。 asyncClient.newRequest(exchange.getExecutor(), endPoint,httpRequest) .timeout(timeout) .onComplete(response -> { String checkResultJson = response.content().toString(CharsetUtil.UTF_8); //.......... }) .onError(throwable -> { log.error("Request service {},occur an exception {}",endPoint, throwable); ResponseDecorator.failResponseWithStatus(exchange,HttpResponseStatus.INTERNAL_SERVER_ERROR,"AuthFilter 验证失败"); }) .sendRequest(); asyncClient 的链式调用设计了 timeout方法,用于传递超时时间,我们可以通过一个全局Map来配置这样的信息。 Map<String,Integer> 其key为全路径的path 信息,V为设定的超时时间,单位为ms, 至于Map的信息在实际配置过程中如何承载,使用ARK配置或者Mysql 都很容易实现。处于并发安全和性能的极致追求,超时事件的设定和调度最好能够在与当前channel绑定的线程中执行,庆幸的是 EventLoop线程自带schedule 方法。具体来看上文的 AsyncClient 的56行。schedule 方法内部以堆结构的方式实现了对超时时间进行管理,整体性能尚可。 堆外内存管理优化 常见的堆外内存手动管理方式无非是引用计数,不同处理逻辑可能针对 RC (引用计数) 的值做调整,到某个环节的业务逻辑处理后已经不记得当前的引用计数值是多少了,甚至是前面的RC增加了,后面的RC忘记减少了;但换个思路,在数据回写给客户端后我们肯定要把这个请求整个生命周期所申请的堆外内存全部释放掉,堆外内存在回收的时候条件只有一个,就是RC值为0 ,那么在最终的release的时候,我们引入一个safeRelase的思路 , 如果当前的RC>0 就不停的 release ,直至为0;因此只要把这样的逻辑放在netty的最后一个Handler中即可保证内存得到有效释放。 public static void safeRelease(Object msg){ if(msg instanceof ReferenceCounted){ ReferenceCounted ref = (ReferenceCounted) msg; int refCount = ref.refCnt(); for(int i=0; i<refCount; i++){ ref.release(); } } } safeRelease 响应时间尖刺优化 由于DAG 选择了复用spring 的 loadbalance 模块,但这样一来就会和SCG一样存在启动初期的响应时间尖刺问题;为此我们进一步分析RibbonLoadBalancerClient 的构建过程,发现其用到了NamedContextFactory,该类的 contexts 变量保存了每一个serviceName对应的一个独立context,这种使用模式带来大量的性能浪费。 public abstract class NamedContextFactory<C extends NamedContextFactory.Specification>implements DisposableBean, ApplicationContextAware { //1. contexts 保存 key -> ApplicationContext 的map private Map<String, AnnotationConfigApplicationContext> contexts = new ConcurrentHashMap<>(); //........ } 在实际运行中 RibbonLoadBalancerClient 会调用choose方法来选择合适的endpoint 作为本次RPC发起调用的真实地址;choose 方法执行过程中会触发 getLoadBalancer() 方法执行,可以看到该方法的可以按照传入的serviceId 获取专属于这个服务的LoadBalancer,事实上这样的设计有点多此一举。大部分情况下,每个服务的负载均衡算法都一致的,完全可以复用一个LoadBalancer对象;该方法最终是从spring 容器中获取 LoadBalancer。 class RibbonLoadBalancerClient{ //.......... private SpringClientFactory clientFactory; @Override public ServiceInstance choose(String serviceId) { return choose(serviceId, null); } public ServiceInstance choose(String serviceId, Object hint) { Server server = getServer(getLoadBalancer(serviceId), hint); if (server == null) { return null; } return new RibbonServer(serviceId, server, isSecure(server, serviceId), serverIntrospector(serviceId).getMetadata(server)); } protected ILoadBalancer getLoadBalancer(String serviceId) { return this.clientFactory.getLoadBalancer(serviceId); } //......... } RibbonLoadBalancerClient 由于是懒加载,实际流量触发下才会执行,因此第一次执行时,RibbonLoadBalancerClient 对象并不存在,需要初始化创建,创建时大量线程并发调用SpringClientFactory#getContext 方法,锁在同一个对象上,出现大量的RT尖刺。这也解释了为什么SCG网关在发布期间会出现响应时间大幅度抖动的现象。 public class SpringClientFactory extends NamedContextFactory<RibbonClientSpecification>{ //............ protected AnnotationConfigApplicationContext getContext(String name) { if (!this.contexts.containsKey(name)) { synchronized (this.contexts) { if (!this.contexts.containsKey(name)) { this.contexts.put(name, createContext(name)); } } } return this.contexts.get(name); } //......... } SpringClientFactory 在后期的压测过程中,发现 DAG的线程数量远超预期,基于thread-per-core的架构模式下,过多的线程对性能损害比较大,尤其是当负载上升到较高水位时。上文提到默认情况下,每个服务都会创建独立loadBalanceClient , 而在其内部又会启动独立的线程去同步当前关联的serviceName对应的可用serverList,网关的特殊性导致需要接入的服务数量极为庞大,进而导致运行一段时间后DAG的线程数量急剧膨胀,对于同步serverList 这样的动作而言,完全可以采用非阻塞的方式从注册中心拉取相关的serverList , 这种模式下单线程足以满足性能要求。 serverList的更新前后架构对比 通过预先初始化的方式以及全局只使用1个context的方式,可以将这里冷启动尖刺消除,改造后的测试结果符合预期。 通过进一步修改优化spring loadbalance serverList 同步机制,降低90%线程数量的使用。 优化前线程数量(725) 优化后线程数量(72) 集群限流改造优化 首先来看DAG 启动后sentinel相关线程,类似的问题,线程数量非常多,需要针对性优化。 Sentinel 线程数 sentinel线程分析优化: 最终优化后的线程数量为4个 sentinel原生限流源码分析如下,进一步分析SphU#entry方法发现其底调用 FlowRuleCheck#passClusterCheck;在passClusterCheck方法中发现底层网络IO调用为阻塞式,由于该方法的执行线程为workerEventLoop,因此需要使用上文提到的AsyncClient 进行优化。 private void doSentinelFlowControl(ServerWebExchange exchange, GatewayFilterChain chain, String resource){ Entry urlEntry = null; try { if (!StringUtil.isEmpty(resource)) { //1. 检测是否限流 urlEntry = SphU.entry(resource, ResourceTypeConstants.COMMON_WEB, EntryType.IN); } //2. 通过,走业务逻辑 chain.filter(exchange); } catch (BlockException e) { //3. 拦截,直接返回503 ResponseDecorator.failResponseWithStatus(exchange, HttpResponseStatus.SERVICE_UNAVAILABLE, ResultCode.SERVICE_UNAVAILABLE.message); } catch (RuntimeException e2) { Tracer.traceEntry(e2, urlEntry); log.error(ExceptionUtils.getFullStackTrace(e2)); ResponseDecorator.failResponseWithStatus(exchange, HttpResponseStatus.INTERNAL_SERVER_ERROR,HttpResponseStatus.INTERNAL_SERVER_ERROR.reasonPhrase()); } finally { if (urlEntry != null) { urlEntry.exit(); } ContextUtil.exit(); } } SentinelGatewayFilter(sentinel 适配SCG的逻辑) public class RedisTokenService implements InitializingBean { private final RedisAsyncClient client = new RedisAsyncClient(); private final RedisChannelPoolKey connectionKey; public RedisTokenService(String host, int port, String password, int database, boolean ssl){ connectionKey = new RedisChannelPoolKey(String host, int port, String password, int database, boolean ssl); } //请求token public Future<TokenResult> asyncRequestToken(ClusterFlowRule rule){ .... sendMessage(redisReqMsg,this.connectionKey) } private Future<TokenResult> sendMessage(RedisMessage requestMessage, EventExecutor executor, RedisChannelPoolKey poolKey){ AsyncRequest<RedisMessage,RedisMessage> request = client.newRequest(executor, poolKey,requestMessage); DefaultPromise<TokenResult> tokenResultFuture = new DefaultPromise<>(request.getExecutor()); request.timeout(timeout) .onComplete(response -> { ... tokenResultFuture.setSuccess(response); }) .onError(throwable -> { ... tokenResultFuture.setFailure(throwable); }).sendRequest(); return tokenResultFuture; } } RedisTokenService 最终的限流Filter代码如下: public class SentinelGatewayFilter implements RequestFilter { @Resource RedisTokenService tokenService;\ @Override public void filter(ServerWebExchange exchange, GatewayFilterChain chain) { //当前为 netty NioEventloop 线程 ServerHttpRequest request = exchange.getRequest(); String resource = request.getPath() != null ? request.getPath() : ""; //判断是否有集群限流规则 ClusterFlowRule rule = ClusterFlowManager.getClusterFlowRule(resource); if (rule != null) { //异步非阻塞请求token tokenService.asyncRequestToken(rule,exchange.getExecutor()) .addListener(future -> { TokenResult tokenResult; if (future.isSuccess()) { tokenResult = (TokenResult) future.getNow(); } else { tokenResult = RedisTokenService.FAIL; } if(tokenResult == RedisTokenService.FAIL || tokenResult == RedisTokenService.ERROR){ log.error("Request cluster token failed, will back to local flowRule check"); } ClusterFlowManager.setTokenResult(rule.getRuleId(), tokenResult); doSentinelFlowControl(exchange, chain, resource); }); } else { doSentinelFlowControl(exchange, chain, resource); } } } 改造后适配DAG的SentinelGatewayFilter 六、压测性能 DAG高压表现 wrk -t32 -c1000 -d60s -s param-delay1ms.lua --latency http://a.b.c.d:xxxxx DAG网关的QPS、实时RT、错误率、CPU、内存监控图;在CPU占用80% 情况下,能够支撑的QPS在4.5W。 DAG网关的QPS、RT 折线图 DAG在CPU占用80% 情况下,能够支撑的QPS在4.5W,ART 19ms SCG高压表现 wrk -t32 -c1000 -d60s -s param-delay1ms.lua --latency http://a.b.c.d:xxxxx SCG网关的QPS、实时RT、错误率、CPU、内存监控图: SCG网关的QPS、RT 折线图: SCG在CPU占用95% 情况下,能够支撑的QPS在1.1W,ART 54.1ms DAG低压表现 wrk -t5 -c20 -d120s -s param-delay1ms.lua --latency http://a.b.c.d:xxxxx DAG网关的QPS、实时RT、错误率、CPU、内存: DAG网关的QPS、RT 折线图: DAG在QPS 1.1W情况下,CPU占用30%,ART 1.56ms 数据对比 结论 满负载情况下,DAG要比SCG的吞吐量高很多,QPS几乎是4倍,RT反而消耗更低,SCG在CPU被打满后,RT表现出现严重性能劣化。DAG的吞吐控制和SCG一样情况下,CPU和RT损耗下降了更多。DAG在最大压力下,内存消耗比较高,达到了75%左右,不过到峰值后,就不再会有大幅变动了。对比压测结果,结论令人欣喜,SCG作为Java生态当前使用最广泛的网关,其性能属于一线水准,DAG的性能达到其4倍以上也是远超意料,这样的结果给与研发同学极大的鼓舞。 七、投产收益 安全性提升 完善的接口级路由管理 基于接口注册模式的全新路由上线,包含了接口注册的申请人,申请时间,接口场景备注信息等,接口管理更加严谨规范;结合路由组功能可以方便的查询当前服务的所有对外接口信息,某种程度上具备一定的API查询管理能力;同时为了缓解用户需要检索的接口太多的尴尬,引入了一键收藏功能,大部分时候用户只需要切换到已关注列表即可。 注册接口列表 接口收藏 防渗透能力极大增强 早期的泛化路由,给黑产的渗透带来了极大的想象空间和安全隐患,甚至可以在外网直接访问某些业务的配置信息。 黑产接口渗透 接口注册模式启用后,所有未注册的接口均无法访问,防渗透能力提升一个台阶,同时自动推送异常接口访问信息。 404接口访问异常推送 稳定性增强 内存泄漏问题解决 通过一系列手段改进优化和严格的测试,新网关的内存使用更加稳健,内存增长曲线直接拉平,彻底解决了泄漏问题。 老网关内存增长趋势 新网关内存增长趋势 响应时间尖刺消除 通过预先初始化 & context 共用等手段,去除了运行时并发创建多个context 抢占全局锁的开销,冷启动RT尖刺降低99% ;关于spring load balance 模块的更多优化细节可以参考这篇博客:Spring LoadBalance 存在问题与优化。 压测数据对比 实际生产监控 趋势图上略有差异,但是从非200请求的绝对值上看,这种差异可以忽略, 对比发布期间和非发布期间异常请求的数量,发现基本没有区别,这代表着以往的发布期间的响应时间尖刺基本消除,做到了发布期间业务服务彻底无感知。 1月4日发布期间各节点流量变化 1月4日异常请求状态数量监控(发布期间) 1月5日异常请求状态数量监控(无发布) 降本增效 资源占用下降50% + SCG平均CPU占用 DAG资源占用 JDK17升级收益 得益于ZGC的优秀算法,JVM17 在GC暂停时间上取得了出色的成果,网关作为延迟敏感型应用对GC的暂停时间尤为看重,为此我们组织升级了JDK17 版本;下面为同等流量压力情况下的配置不同GC的效果对比,可以看到GC的暂停时间从平均70ms 降低到1ms 内,RT99线得到大幅度提升;吞吐量不再受流量波动而大幅度变化,性能表现更加稳定;同时网关的平均响应时间损耗降低5%。 JDK8-G1 暂停时间表现 JDK17-ZGC暂停时间表现 吞吐量方面,G1伴随流量的变化呈现出一定的波动趋势,均线在99.3%左右。ZGC的吞吐量则比较稳定,维持在无限接近100%的水平。 JDK8-G1 吞吐量 JDK17-ZGC吞吐量 对于实际业务接口的影响,从下图中可以看到平均响应时间有所下降,这里的RT差值表示接口经过网关层的损耗时间;不同接口的RT差值损耗是不同的,这可能和请求响应体的大小,是否经过登录验证,风控验证等业务逻辑有关。 JDK17与JDK8 ART对比 需要指出的是ZGC对于一般的RT敏感型应用有很大提升, 服务的RT 99线得到显著改善。但是如果当前应用大量使用了堆外内存的方式,则提升相对较弱,如大量使用netty框架的应用, 因为这些应用的大部分数据都是通过手动释放的方式进行管理。 八、思考总结 架构演进 API网关的自研并非一蹴而就,而是经历了多次业务迭代循序渐进的过程;从早期的泛化路由引发的安全问题处理,到后面的大量路由注册,带来的匹配性能下降 ,以及最终压垮老网关最后一根稻草的内存泄漏问题;在不同阶段需要使用不同的应对策略,早期业务快速迭代,大量的需求堆积,最快的时候一个功能点的改动需要三四天内上线 ,我们很难有足够的精力去做一些深层次的改造,这个时候需求导向为优先,功能性建设完善优先,是一个快速奔跑的建设期;伴随体量的增长安全和稳定性的重视程度逐步拔高,继而推进了这些方面的大量建设;从拓展SCG的原有功能到改进框架源码,以及最终的自研重写,可以说新的API网关是一个业务推进而演化出来的产物,也只有这样 ”生长“ 出来的架构产品才能更好的契合业务发展的需要。 技术思考 开源的API网关有很多,但是自研的案例并不多,我们能够参考的方案也很有限。除了几个业界知名的产品外,很多开源的项目参考的价值并不大;从自研的目标来看,我们最基本的要求是性能和稳定性要优于现有的开源产品,至少Java的生态是这样;这就要求架构设计和代码质量上必须比现有的开源产品更加优秀,才有可能;为此我们深度借鉴了流量代理界的常青树Nginx,发现基于Linux 多进程模型下的OS,如果要发挥出最大效能,单CPU核心支撑单进程(线程)是效率最高的模式。可以将OS的进程调度开销最小化同时将高速缓存miss降到最低,此外还要尽可能减少或者消除数据竞争,避免锁等待和自旋带来的性能浪费;DAG的整个技术架构可以简化的理解为引入了独立控制流的多线程版的Nginx。 中间件的研发创新存在着较高的难度和复杂性,更何况是在业务不断推进中换引擎。在整个研发过程中,为了尽可能适配老的业务逻辑,对原有的业务逻辑的改动最小化,新网关对老网关的架构层接口做了全面适配;换句话说新引擎的对外暴露的核心接口与老网关保持一致,让老的业务逻辑在0改动或者仅改动少量几行代码后就能在新网关上直接跑,能够极大幅度降低我们的测试回归成本,因为这些代码本身的逻辑正确性,已经在生产环境得到了大量验证。这样的适配器模式同样适用于其他组件和业务开发。 作为底层基础组件的开发人员,要对自己写下的每一行代码都有清晰的认识,不了解的地方一定要多翻资料,多读源码,模棱两可的理解是绝对不够的;常见的开源组件虽然说大部分代码都是资深开发人员写出来的,但是有程序员的地方就有bug ,要带着审慎眼光去看到这些组件,而不是一味地使用盲从,所谓尽信书不如无书;很多中间件的基本原理都是相通的,如常见Raft协议,基于epoll的reactor网络架构,存储领域的零拷贝技术,预写日志,常见的索引技术,hash结构,B+树,LSM树等等。一个成熟的中间件往往会涉及多个方向的技术内容。研发人员并不需要每一个组件都涉猎极深,也不现实,掌握常见的架构思路和技巧以及一些基本的技术点,做到对一两个组件做到熟稔于心。思考和理解到位了,很容易触类旁通。 稳定性把控 自研基础组件是一项浩大的工程,可以预见代码量会极为庞大,如何有效管理新项目的代码质量是个棘手的问题; 原有业务逻辑的改造也需要回归测试;现实的情况是中间件团队没有专职的测试,质量保证完全依赖开发人员;这就对开发人员的代码质量提出了极高的要求,一方面我们通过与老网关适配相同的代理引擎接口,降低迁移成本和业务逻辑出现bug的概率;另一方面还对编码质量提出了高标准,平均每周两到三次的CodeReview;80%的单元测试行覆盖率要求。 网关作为流量入口,承接全司最高流量,对稳定性的要求极为苛刻。最理想的状态是在业务服务没有任何感知的情况下,我们将新网关逐步替换上去;为此我们对新网关上线的过程做了充分的准备,严格控制上线过程;具体来看整个上线流程分为以下几个阶段: 第一阶段 我们在压测环境长时间高负载压测,持续运行时间24小时以上,以检测内存泄漏等稳定性问题。同时利用性能检测工具抓取热点火焰图,做针对性优化。 第二阶段 发布测试环境试跑,采用并行试跑的方式,新老网关同时对外提供服务(流量比例1 :1,初期新网关承接流量可能只有十分之一),一旦用户反馈的问题可能跟新网关有关,或者发现异常case,立即关停新网关的流量。待查明原因并确认修复后,重新引流。 第三阶段 上线预发,小得物环境试跑,由于这些环境流量不大,依然可以并行长时间试跑,发现问题解决问题。 第四阶段 生产引流,单节点从万分之一比例开始灰度,逐步引流放大,每个阶段停留24小时以上,观察修正后再放大,循环此过程;基于单节点承担正常比例流量后,再次抓取火焰图,基于真实流量场景下的性能热点做针对性优化。 团队成长 回顾整个研发历程我们在不间断新业务承接的情况下,几个月时间内完成开发和上线,从节奏上来讲不可谓不快,研发同学的心态也经历了一些变化。从一开始的质疑,认为大家以前从没有做过的东西现在就这点人能搞的出来吗?到中期的这个组件写起来蛮有挑战也很有意思!直到后期初版压测数据出来后的惊讶。就项目结果而言,可以说收获感满满,从后续的针对研发同学的one one 沟通反馈来看,对于整个项目感触最大的是技术上的提升很大,对高并发网络编程领域的认知提升了一个档次, 尤其是异步编程方面,技术信心增强很多;内部也组织了分享会,大家普遍很感兴趣,收获了较大的技术红利。 *文/簌语 本文属得物技术原创,更多精彩文章请看:得物技术官网 未经得物技术许可严禁转载,否则依法追究法律责任!

优秀的个人博客,低调大师

每日一博 | 大模型的规模扩展是否可持续?

作者 |Dwarkesh Patel OneFlow编译 翻译|杨婷、宛子琳 AGI何时会到来? 如果我们能不断扩展LLMs++的规模(并因此取得更好和更通用的性能),就有理由期望到2040年(或更早)出现强人工智能,它能够自动化大部分认知劳动并加速人工智能研究。然而,如果扩展(scaling)不起作用,那么实现AGI的道路则会变得更加漫长、棘手。 为全面探讨有关扩展的正反观点,我构造了两个虚构角色(正方和反方),以辩论的形式讨论问题。 (本文作者Dwarkesh Patel是Lunar Society Podcast主理人。以下内容由OneFlow编译发布,转载请联系授权:https://www.dwarkeshpatel.com/p/will-scaling-work) 1 数据是否会用尽? 反方: 我们将在明年耗尽高质量语言数据(https://epochai.org/blog/will-we-run-out-of-ml-data-evidence-from-projecting-dataset)。 即便我们认真对待那些扩展曲线所暗示的趋势,也意味着我们需要1e35次浮点运算(FLOPs)才能让人工智能足够可靠和聪明,能够撰写科学论文(这是人工智能需要进一步自动化人工智能研究,并在无法扩展时能够继续推进所需的基本能力)[1]。这意味着我们需要的数据要比现有数据多5个数量级[2]。 人们可能对“5个数量级的差距”这一概念有所误解,认为当前的数据量只比我们实际需要的少5倍,所以我们只需在数据效率上取得多次2倍改进,问题就迎刃而解了,毕竟朋友之间差几个数量级也没什么大不了的。 可实际上,5个数量级的差距意味着当前数据量比实际需求少了100,000倍。尽管有一些可以提升数据效率的算法,而且多模态训练可以提供更多数据,另外我们可以在多个轮次上重复利用词元,并使用课程学习(Curriculum learning),但即使我们假设这些技术能够极大地提升数据效率,它们依然无法提供足够多的数据来应对规模扩展所需的指数级计算增长。 有人可能会说,我们可以设法让自我对弈(self-play)或合成数据发挥作用。但自我对弈面临以下两个难题。 评估:人们曾成功地将自我对弈运用于AlphaGo,因为该模型可以根据具体的获胜条件来评判自己的表现(如“我是否赢得了这局围棋?”)。但新颖的推理并没有具体的获胜条件,因此,正如你所期望的那样,LLM迄今无法纠正自己的推理能力。 计算:所有这些数学/编码方法往往会使用各种类型的树搜索,其中每个节点都需要运行LLM。AlphaGo在围棋这个相对狭窄的任务中的计算预算已经相当惊人了,我们可以试想一下,将其应用于搜索所有可能的人类思维空间所需要的计算资源将会有多么庞大。这些额外计算量还不包括已经要求扩展参数规模(计算=参数*数据)增加的巨大计算资源。达到人类水平思考所需的计算量估计约为1e35 FLOP,我们需要额外增加9个数量级的计算,以应对当前最大模型已有的计算量。我承认,通过更好的硬件和更先进的算法可能会有所改进,但我们真的能够实现相当于9个数量级的计算性能提升吗? 正方: 如果你对扩展有效性的主要质疑仅仅是出于担心数据不足,那么你的第一反应就不应该是“看起来我们本可以通过扩展Transformer++来实现通用人工智能,但在此之前我们会先耗尽数据”。 你的反应应该是:“如果互联网规模更大,扩展一个相对简单(仅用几百行Python代码就能编写其基本结构)的模型就可以创造出人类水平的智能,这是一个多么疯狂的世界啊,实现大规模计算智能化竟然如此简单。” LLM表现出“低效”的样本主要来源于不相关的电子商务垃圾[3]。通过利用“预测下一个词元”进行训练,我们加剧了这一缺陷。这种损失函数在很大程度上与我们希望智能体在经济中执行的实际任务无关。尽管模型训练所使用的数据和损失函数与我们实际期望的能力之间的交集微乎其微,但我们只需微软年收入的0.03%,就能通过大规模爬取互联网制造出一个初级AGI(即GPT-4)。 人工智能的发展迄今为止都相对轻松和简单,因此合成数据也有可能奏效,毕竟模型天然具有学习愿望,这没什么好惊讶的。 目前,GPT-4已经问世八个月,其他人工智能实验室才刚刚获得自己的GPT-4级别模型。这意味着,所有研究人员现在才开始让当前一代模型进行自我对弈(看起来他们中的某些人可能已经成功了)。因此,虽然到目前为止,我们还没有公开证据表明合成数据取得了大规模成功,但这并不意味着它不可能成功。 毕竟,当你的基础模型足够强大,至少能在某些情况下得到正确答案时,强化学习才会更加可行(现在在100次尝试中,模型可以完成一次复杂的数学证明所需的思考过程,或者编写500行代码,以完成一个完整的pull request请求,这时候你可以对其进行奖励)。这样一开始1/100的成功率,可能逐渐增加到10/100,然后变成了90/100。成功率提升以后,就可以开始尝试更具挑战性的任务,比如处理1000行PR请求。随着训练的深入,基础模型有时不仅能够成功完成任务,还能够在失败时进行自我评价和纠正等。 事实上,合成数据引导训练在某种程度上与人类进化相似。最初,我们的灵长类祖先几乎没有表现出能够迅速洞察和应用新见解的能力。然而,人类发展出语言后,就迅速出现了基因/文化共进化现象,这与LLM的合成数据/自我对弈循环非常相似。在这个过程中,模型变得更加智能,以更好地理解相似副本的复杂符号输出。 自我对弈并不需要模型完美判断自己的推理过程。比起从头开始推理,它们只需要擅长判断自己的推理过程即可。(这显然已经成为了事实,可参考宪章AI(Constitutional AI)或简单使用GPT几分钟,你就会发现模型似乎更擅长解释用户所写内容的问题,而不擅长独立得出正确答案[4]。 我所接触的大型人工智能实验室的研究人员几乎都对自我对弈充满信心,但由于涉及保密问题,他们不能详细透露具体细节,只是提到在这个领域有很多可尝试的可能性。正如Dario Amodei (Anthropic首席执行官) 在我的播客中提到: Dwarkesh Patel:你提到数据可能不会成为限制因素,为什么? Dario Amodei:原因有很多,出于多方面考虑,我无法在此展开详细讨论,但世界上有多种数据源,生成数据的方法也很多。因此我认为数据不会成为阻碍。 相反,如果数据是瓶颈更好,但它不是。 反方: 宪章AI、RLHF和其他强化学习/自我对弈设置十分擅长挖掘模型的潜在能力(或在能力不足时将其抑制),但目前还没有人证明真正能够通过RL增强模型的基本能力。 如果某种自我对弈或合成数据的方法无法奏效,那就太糟糕了——除了数据瓶颈外别无选择。新架构几乎不太可能解决数据瓶颈问题。要解决当前问题,需要在样本效率上取得巨大突破,这一突破要比从LSTM(长短时记忆网络)到Transformer的跃迁更大。LSTM早在90年代就已经问世,在过去的20多年里,深度学习领域已经攻克了许多相对容易解决的问题,而我们需要在此取得更大的成就。 从那些在情感或利益驱使下希望看到LLM扩展的人那里得到的感觉,并不能代替我们完全缺乏证据表明强化学习能解决数据不足的问题。 进一步来说,语言大模型需要大量数据,但其表现出来的推理能力却十分平庸,这表明语言大模型的泛化能力可能存在问题。如果这些模型无法利用人类在20000年间积累的数据达到接近人类水平的性能表现,那么即使20亿年的数据对它们来说也可能不够。毕竟无论我们往飞机里添加多少喷气燃料,也无法让它到达月球。 2 目前为止,扩展是否依然有效? 正方: 这是毫无疑问的,因为模型在性能基准上的表现已经连续提升了8个数量级。即使在计算资源增加了百万倍的情况下,模型性能的损失也可以精确到小数点后的多位数字。 GPT-4的技术报告指出,他们能从使用相同方法训练的模型中预测出最终的GPT-4模型的性能,这些模型使用的计算资源最多可比GPT-4少10000倍。 我们应该乐观地看待问题,过去连续8个数量级的成功也将在未来8个数量级上持续下去。进一步扩大8个数量级(或者考虑到算法和硬件进步带来的免费性能提升带来的任何相当于8个数量级的性能扩展)所能实现的性能很可能让模型具备足够的能力来加速人工智能研究。 反方: 实际上,我们并不是很关心模型在预测下一个词元上的表现。模型已经在这个损失函数上取得了超越人类的性能表现。我们想要弄清楚的是,这些在下一个词元预测任务上的性能提升是否意味着模型在泛化方面取得了真正的进展。 正方: 随着模型的扩展,在MMLU、BIG-bench和HumanEval等基准测试中,模型在各种任务中表现出了持续可靠的性能提升。 反方: 但查看MMLU和BigBench问题的随机样本,我们会发现这些样本几乎全是谷歌搜索首页的结果,这表明这些任务更像是在考察模型的记忆能力而非智能程度。下面是我从MMLU随机挑选的一些问题(都是多项选择题,模型只需从四个选项中选择正确答案): 问:根据Baier的理论,评估一个行为是否在道德上可接受的第二步是什么? 答:禁止该行为的道德准则是否本身就是一个真正的道德规则。 问:对于自发过程,始终成立的是哪一项? 答:系统与周围环境的总熵增加。 问:比尔·克林顿出生时的美国总统是谁? 答:哈里·杜鲁门 一个在充满各种随机事实的互联网文本上训练的模型偶然记住了许多随机事实,这为什么令人印象深刻?为什么这不能表明模型具有某种程度的智能和创造力? 即使在这些人为设计的、正交的基准测试中,模型的性能提升似乎也开始逐渐趋于平稳。据估计,谷歌新模型Gemini Ultra的计算资源几乎是GPT-4的5倍,但在MMLU、BIG-bench等其他标准基准测试上,Gemini Ultra的性能却几乎与GPT-4相当。 一般来说,常见基准测试并不能很好地评估模型在长期任务上的性能表现(例如,你能在一个月内完成一项任务吗?),而在这方面,通过下一个词元预测训练的语言大模型几乎没有足够的有效数据点进行学习。通过分析它们在SWE-bench上的表现(该基准测试衡量LLM是否能够自主完成pull request),可以看出它们在长期任务上整合复杂信息的能力相当糟糕。具体来说,GPT-4完成了1.7%,Claude 2的表现稍好一些,完成了4.8%。 我们似乎有两种基准测试标准: 第一类测试包括MMLU、BIG-bench和HumanEval,它们主要衡量模型的记忆、召回和插值能力。这类基准测试显示模型已经具备了能够匹敌甚至超越普通人类水平的性能。但这类基准测试并不能很好地测试模型的智能水平,因为目前即使是规模最大的模型也远远不及人类聪明。 第二类基准测试包括SWE-bench和ARC,它们真正衡量了模型在长时间跨度或复杂抽象环境中自主解决问题的能力。然而,这些模型在这类任务中的表现并不出色。 我们应该如何看待这样一个模型呢?这个模型在经过相当于2万年人类输入的训练之后,却仍然无法理解类似于“如果汤姆·克鲁斯的母亲是玛丽·李·菲佛,那么玛丽·李·菲佛的儿子就是汤姆·克鲁斯”等逻辑关系,或者我们应该如何看待一个回答严重依赖提问方式和顺序的模型呢? 因此,我认为讨论扩展是否会继续奏效等问题没有意义,因为我们甚至没有证据可以表明目前的扩展是有效的。 正方: Gemini Ultra的性能发展不会停滞,相反,它会继续取得进展。GPT-4明显已经成功反驳了那些由怀疑者预先提出的关于连接主义和深度学习的批评[5]。相比GPT-4,Gemini的性能表现更可能是谷歌尚未完全赶上OpenAI在算法方面的进展所致。 如果在深度学习和LLM之间存在某种根本的硬性限制,我们难道不应该在它们发展出常识、早期推理和跨抽象思考能力之前就注意到了吗?我们有什么理由认为某些顽固限制只存在于中等推理和高级推理之间呢? 相对于GPT-3,GPT-4的性能扩展了100倍。听起来差距很大,但考虑到我们向这些模型投入的额外扩展,这一性能扩展其实并不大。只需花费不到1%的全球GDP(注:根据去年IMF公布的数据显示,2023年全球GDP总规模预计将达到99.67万亿美元。),我们就可以将GPT-4的规模进一步扩大10000倍(即达到GPT-6的水平)。而这还未考虑到预训练计算效率的提升(如MoE、flash attention等),新的后训练方法(RLAI,对思维链进行微调、自我对弈等),以及硬件改进等因素的影响。根据以往经验,以上每一项都为性能提升贡献了很多倍的量级。如果将这些因素综合起来,你就可能凭借全球1%的GDP构建一个GPT-8级别的模型。 为了解人类社会愿意在新的通用技术上投入多少资金,以下信息可供参考: 1847年是英国铁路投资的巅峰时期,其GDP占比高达7%。 “1996年《电信法案》生效后的五年间,电信公司获得了超5000亿美元(相当于如今的1万亿美元)的投资,用于铺设光纤电缆、添置新交换机以及架设无线网络。” 虽然GPT-8(即性能扩大100,000,000倍的GPT-4)可能只会略优于GPT-4,但这种期望过于悲观,因为我们已经看到模型能够在远小于这一规模的扩展中学会如何思考和理解世界。 接下来的情节就可以预知了:数百万个GPT-8的副本编写kernel改进,以找到更好的超参数,为自己提供大量高质量的反馈进行微调等等。这大大降低了开发GPT-9的成本和难度……最终将这一趋势推向奇点。 3 模型是否真正理解世界? 正方: 微软在其研究论文 Sparks of AGI 中提出了一个惊人发现:他们发现GPT-4能够编写LaTex代码绘制独角兽。对于这样的事情,我们已经司空见惯了,所以不会深思这一现象背后的含义。假设在LaTex中绘制动物图像并不是GPT-4训练语料库的一部分,然而,GPT-4已经建立起了独角兽的内部表征,并能够利用其在LaTex编程上的熟练程度来描绘它仅以语言形式遇到过的概念。显然,如果缺乏世界模型,GPT-4不可能具备这样的能力(如果它不理解独角兽是什么样子,它怎么能知道如何在LaTex中描绘独角兽呢)[6]。 要预测下一个词元,语言大模型必须自学世界的全部规律,以预测下一个词元。例如,预测书籍《自私的基因》(The Selfish Gene)需要理解基因在进化过程中的中心作用,预测短篇小说则需要理解人物心理等等。 通过代码训练LLM,能使其获得更好的语言推理性能。这一事实实在令人惊叹。这表明通过阅读大量代码,模型获得了更深刻的一般性思考能力——这不仅表示语言和代码之间存在一些共享的逻辑结构,还表明无监督梯度下降可以提取这种结构,并利用它更好地进行推理。 梯度下降试图找到最高效的数据压缩方式。最有效的压缩也是最深刻和最强大的。例如,对一本物理教科书的最有效压缩,就是能够帮助你预测书中被截断的论证将如何继续展开,这是一种对基础科学解释的深刻内化理解。 反方: 智能包括(除其他方面外)压缩能力。但压缩本身并不等同于智能。爱因斯坦之所以聪明,是因为他能提出相对论,但在我看来爱因斯坦+相对论并不能构成有意义的更智能的系统,就这相当于说柏拉图是一个笨蛋,因为他不理解现代生物学或物理学,这是毫无意义的。 所以,如果语言大模型只是由另一个过程(随机梯度下降)产生的压缩,那么我不知道这如何能告诉我们关于LLM自身进行压缩的能力(因此,也无法获得关于LLM智能的任何信息)[7]。 正方: 尽管我们没有一个严密的理论解释,说明为什么扩展必然会继续发挥作用,但这并不妨碍扩展将继续发挥作用。蒸汽机发明一个世纪后,我们才形成了对热力学的全面理解。技术史上的常见模式是发明先于理论,在我看来智能也是如此。 并不存在某种物理定律规定摩尔定律必须继续存在。事实上,总会出现新的实际障碍来预示摩尔定律的终结。然而,每隔几年,台积电、英特尔、AMD等的研究人员都能找到解决这些问题的方法,为这几十年摩尔定律的趋势增添新的生机。 你可以进行关于计算和数据瓶颈、智能真实本质以及基准的脆弱性等一系列复杂的思维活动。或者也可以直接看看下图中的曲线。 4 结论 两方的争论就此作罢。以下是我的个人观点。 在过去几年里,如果你相信扩展的作用,那么我们所见的进展会合理的多。有一种说法是,GPT-4的惊人性能可以解释为某种永远无法泛化的术语库或查询表。但这是怀疑者事先没有提到的说法。 举例来说,原本我要为反方提供的有力论据之一是,语言大模型至今未建立任何新连接,也没有得出任何新发现。如果一个人能够记住语言大模型所记住的海量内容,就算他本身很愚蠢,也可以做到这一点。说实话,我认为这是最令人信服的反方观点之一,很多人也这样认为。然而,就在几天前,谷歌宣布其FunSearch系统有了新的数学发现[8]。如果你赞同反方观点,可能已经一次又一次地经历过这种情况。 而对于坚定的信仰者(信仰技术进步)来说,像Ilya、Dario、Gwern等人早在12年前就大致阐述了由于规模扩展而导致的缓慢发展。 一定程度的规模扩展可以带领我们实现变革性的人工智能,这一点似乎相当明确。也就是说,如果你能够在这些规模曲线上实现不可降低的损失,就已经创造了一个足够智能的AI,可以自动化大部分的认知劳动(包括制造更智能的AI所需的劳动)。 但生活中大部分事都比理论更加困难,且许多在理论上可能的事会因为种种原因难以实现(如核聚变能源、飞行汽车、纳米技术等)。如果自我对弈/合成数据行不通,那么模型看起来就很失败,你永远不可能接近那种形而上的不可降低的损失。此外,期望规模扩展继续发挥作用的理论依据很模糊,而规模效应似乎会导致在基准测试中表现更好的性能,这些基准测试的普适性也存在争议。 因此,我个人初步的判断是:通过扩展+算法进步+硬件进步,有70%的可能性是我们将在2040年之前实现通用人工智能(AGI);30%的可能性是怀疑者是对的,语言大模型及其范畴内的任何产物都是失败的。 我可能遗漏了一些重要证据——人工智能实验室并未发布那么多研究,因为任何有关“人工智能科学”的见解都可能会泄露与构建AGI相关的想法。我有一位朋友是其中一个实验室的研究员,他说怀念本科时期阅读一堆论文来放松的习惯。而如今,几乎没有值得阅读的东西发表。因此,我不了解的证据可能会影响这一判断,并缩短上述的时间线。 5 附录 以下是一些补充。对于这些话题,我自认为理解的还不够透彻,没有完全理解它们对扩展的实际影响。 模型是否会具备基于洞察力的学习能力? 正方: 在更大的规模下,模型将自然地发展出更高效的元学习方法——只有在拥有大规模参数化模型的情况下,并且已经训练到对数据严重过拟合的程度,才会产生“领悟(grokking)”能力。领悟似乎与我们学习的方式非常相似。我们通过直觉和心智模型来归类新信息。随着时间的推移和新的观察,这些心智模型本身也会发生变化。在如此丰富多样的数据上进行梯度下降将选择最通用和最具外推能力的线路。因此我们获得了领悟——并最终获得基于洞察力的学习能力。 反方: 神经网络拥有“领悟”能力,但其效率远不及人类实际融合新的解释性见解的方式。比如,当你教一个孩子太阳在太阳系的中心时,会立即改变他对夜空的理解。但是,你不能简单地将哥白尼日心说的一份副本输入到一个未经过天文学数据训练的模型中,然后期望它会立即将这一见解整合到所有相关的未来输出中。令人费解的是,模型必须在许多不同的上下文中多次重复接收信息,才能完全理解基本概念。 不仅模型从未展示过具有洞察力的学习能力,而且我也不明白通过使用梯度下降训练神经网络的方式,这样的学习是否能够实现——我们通过每个示例给予一些微妙的暗示,希望足够多的暗示会慢慢将其引导至正确的方向。基于洞察力的学习就像是瞬间从海平面迅速跃升至珠穆朗玛峰峰顶。 灵长类进化是否证实了规模扩展? 正方: 我相信你可以找到许多在黑猩猩认知中远比逆转诅咒更加令人尴尬的弱点。这并不意味着灵长类大脑存在一些根本限制,这些限制不能通过3倍规模扩展和一些微调来解决。 事实上,正如Suzana Herculano-Houzel所展示的那样,人类大脑拥有与你期望的一个具有人类脑质量的按规模扩展的灵长类大脑一样多的神经元。啮齿动物和昆虫食性动物大脑的规模扩展则差得多。比如在啮齿目和食虫目动物中,大脑更大的物种的神经元数量远远少于仅根据其脑质量所期望的数量。 这表明与其他物种的大脑相比,灵长类动物存在一些真正可扩展的神经结构,类似于Transformer相比LSTM和RNN具有更好的扩展曲线(https://ar5iv.labs.arxiv.org/html/2001.08361)。进化在设计灵长类大脑时学到(或者至少是偶然发现)了苦涩的教训(http://www.incompleteideas.net/IncIdeas/BitterLesson.html),而灵长类动物所竞争的生态位强烈地奖励智力的边际增长(你必须理解来自你的双眼视觉、能使用工具的手,以及其他可以与你交谈的聪明猴子的所有这些数据)。 感谢Chris Painter,James Bradburry,Kipply,Jamie Sevilla,Tamay Besiroglu,Matthew Barnett,Agustin Lebron,Anil Varanasi和Sholto Douglas的评论与讨论。 注释 [1]这似乎是你需要的计算量,以便扩展当前的模型,使其足够优秀,能够生成与人类所写科学论文长度相媲美的输出。 [2]假设采用Chinchilla最优的扩展方式(这大致意味着为了高效地扩展计算,额外计算的一半应来自增加数据,一半应来自增加参数)。你可以尝试以非最优的方式训练Chinchilla,但这只能帮助你弥补轻微的数据不足,而不能弥补5 OOM的不足。这里的“5 OOM”指的是"Five Orders of Magnitude",即五个数量级的差距。 [3]支持者的观点(补充):相对于人类,LLM的样本利用效率确实较低(GPT-4看到的数据远远超过人类从出生到成年的数据量,但它比我们聪明得多)。但我们没有考虑已编码到我们基因组中的知识——这是通过数亿年的进化训练出的微小压缩的提炼,其中包含的数据比GPT-4曾经见过的数据还要多得多。 [4]实际上,对于这种自我对弈循环,评估者也许最好是智力与GPT-4相当的模型。在生成对抗网络(GAN)中,如果鉴别器比生成器强大得多,那么它将停止向生成器提供任何反馈,因为它无法提供有指导意义但不完美的反馈信号。 [5] 例如,Pinker在这里列出了一系列连接主义架构(如神经网络)在试图表示语言规则时必须屈服的限制。乍看之下(我强调仅仅是乍看之下),GPT-4摆脱了所有这些所谓的限制。Pinker也指出了ChatGPT常识的匮乏,而在GPT-4发布后的短短一个月内这一问题就被解决了。 [6]支持者的观点(补充):在我们有能力探究Transformer内部的玩具设置(toy settings)中,实际上可以看到它们开发的世界模型。研究人员训练了一个Transformer来预测名为奥赛罗(Othello)的象棋类棋盘游戏的下一步动作。模型完全没有接收关于游戏规则或棋盘结构的任何指令,只得到一堆游戏记录。所以你所做的就是给一个原始Transformer喂一堆游戏记录序列,比如“E3 D3...”。研究人员发现,通过阅读模型在接受游戏记录后的权重,你可以重构出棋盘的状态。这证明神经网络模型只需阅读一些原始记录,就能得出对该游戏的强大内部表征。 [7]反对者的观点(补充):智能=压缩这一框架似乎也不够细致,无法明显区分随机梯度下降找到语义规律,以及爱因斯坦找到相对论正确方程的差异。我不认为随机梯度下降能够找到后者相对论那样的“压缩”,也不可能以爱因斯坦那样聪明的方式变得聪明。 [8]你可以争辩说,针对数学和编程的FunSearch设置具有严密的反馈循环和具体的获胜条件,而其他领域不太可能享有这些条件,但这更多是我试图指出的复杂的思维活动。 近期,DeepCache为加速扩散模型提供了一种新的免训练、几乎无损的范式。现在,OneDiff引入了一个名为ModuleDeepCacheSpeedup的新ComfyUI Node(已编译的DeepCache模块),让SDXL在RTX 3090上的迭代速度提升3.5倍,在A100上提升3倍。 此外,OneDiff的ModuleDeepCacheSpeedup还支持SVD (Stable Video Diffusion)加速,确保视频质量几乎无损,并在A100上将迭代速度提高了2倍以上。 示例:1. https://github.com/Oneflow-Inc/onediff/pull/426 2.https://github.com/Oneflow-Inc/onediff/pull/438使用指南:https://github.com/Oneflow-Inc/onediff/tree/main/onediff_comfy_nodes#installation-guide 其他人都在看 800+页免费“大模型”电子书 语言大模型的六大趋势 OpenAI首席科学家:直面AGI的可能性 GPT-4.5前瞻:代码解释器,编程新纪元 ChatGPT一周年:开源语言大模型的冲击 迈向100倍加速:全栈Transformer推理优化 OpenAI对齐负责人:“驾驭”超级智能四年计划 试用OneFlow: github.com/Oneflow-Inc/oneflow/ 本文分享自微信公众号 - OneFlow(OneFlowTechnology)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 开发 Java 应用时如何用好 Log

本篇文章,主要介绍应用如何正确使用日志系统,帮助用户从依赖、输出、清理、问题排查、报警等各方面全面掌握。 日志相关的包的种类及使用 ▐日志系统与日志框架 每个应用为了方便排查问题都要输出日志,大家经常使用:log4j、logback等。我们先搞明白日志系统的整套体系是如何运作的。 日志系统 直接负责打印输出日志,提供完整的日志输出能力: JUL java.util.logging.*,java自带的日志系统简称JUL。目前除了Java自身代码很少被生态系统类库使用。 Log4j https://logging.apache.org/ ,目前已经发展到2.x版本(2.x版本有超越logback的趋势),早期的1.x版本非常成功。开创日志系统模型(Logger\Appender\Level等概念)并被各种日志框架采用,且一直沿用至今 log4j可直接使用,也可配合日志框架一起使用 Logback http://logback.qos.ch/ ,Log4j作者的另一个作品,(比Log4j1.x新,Log4j2.x旧)吸取多年经验教训重新设计的一套日志系统,使用更方便、功能更强、性能更好。 logback不能单独使用,需配置日志框架SLF4J一起使用 日志框架 为了克服各种日志系统标准混乱,诞生了日志框架,日志框架不提供日志输出的功能,它定义标准,提供标准接口API,日志框架+日志系统=输出日志。 写代码过程中使用日志框架的好处:编码的时候调用日志框架API,部署的时候可根据不同的环境在多种日志系统中随意切换。 JCL https://commons.apache.org/proper/commons-logging/ ,前几年最流行的日志框架,由Apache社区维护,大量的老牌知名框架版本都在使用,比如Spring(甚至新版本依然在使用)。 SLF4J https://www.slf4j.org/ ,Log4j作者推出,这几年最流行的日志框架,特别是配合Logback使用。 当然也可以配合log4j使用 目前在Java生态趋势主要是使用:SLF4J+Logback组合。 ▐如何正确组合使用日志系统和日志框架 上一节我们介绍了日志框架和日志系统,因为存在多套,所以:如何在系统中正确使用是我们的重点。 日志系统之间互斥 日志框架:JCL和JCL-over-SLF4J桥接包直接互斥 日志系统:logback和slf4j-log4j12互斥,不能共存 我们大概可枚举出如下几种组合: 类型 说明 slf4j+logback 目前最主流的玩法,除了依赖slf4j、logback,还需要考虑把二方库和三方库内部使用的jcl和log4j桥接到slf4j上来,并避免依赖反桥接的包 slf4j+log4j 不推荐。需要把slf4j桥接到log4j,并把jul桥接到slf4j jcl+log4j 不推荐。这需要你直接使用jcl接口来编码,并把把slf4j桥接到log4j log4j 不推荐。直接依赖日志系统 slf4j+logback组合 下面列出一个正确的slf4j+logback依赖,这个环节很重要,很多应用因为依赖搞不清楚经常出现日志丢失问题: <properties> <slf4j.version>${xxxx}</slf4j.version> <logback.version>${yyyyy}</logback.version></properties><dependencyManagement> <dependencies> <dependency> <groupId>commons-logging</groupId> <artifactId>commons-logging</artifactId> <version>999-not-exist</version> </dependency> <dependency> <groupId>com.alibaba.external</groupId> <artifactId>jakarta.commons.logging</artifactId> <version>999-not-exist</version> </dependency> <dependency> <groupId>org.slf4j</groupId> <artifactId>slf4j-log4j12</artifactId> <version>999-not-exist</version> </dependency> <dependency> <groupId>com.alibaba.external</groupId> <artifactId>org.slf4j.slf4j-log4j12</artifactId> <version>999-not-exist</version> </dependency> <dependency> <groupId>org.slf4j</groupId> <artifactId>slf4j-nop</artifactId> <version>999-not-exist</version> </dependency> <dependency> <groupId>org.slf4j</groupId> <artifactId>slf4j-simple</artifactId> <version>999-not-exist</version> </dependency> <dependency> <groupId>com.alibaba.external</groupId> <artifactId>org.slf4j.slf4j-simple</artifactId> <version>999-not-exist</version> </dependency> <dependency> <groupId>log4j</groupId> <artifactId>log4j</artifactId> <version>999-not-exist</version> </dependency> <dependency> <groupId>org.slf4j</groupId> <artifactId>slf4j-api</artifactId> <version>${slf4j.version}</version> </dependency> <dependency> <groupId>org.slf4j</groupId> <artifactId>slf4j-ext</artifactId> <version>${slf4j.version}</version> </dependency> <dependency> <groupId>org.slf4j</groupId> <artifactId>jcl-over-slf4j</artifactId> <version>${slf4j.version}</version> </dependency> <dependency> <groupId>org.slf4j</groupId> <artifactId>jul-to-slf4j</artifactId> <version>${slf4j.version}</version> </dependency> <dependency> <groupId>org.slf4j</groupId> <artifactId>log4j-over-slf4j</artifactId> <version>${slf4j.version}</version> </dependency> <dependency> <groupId>ch.qos.logback</groupId> <artifactId>logback-core</artifactId> <version>${logback.version}</version> </dependency> <dependency> <groupId>ch.qos.logback</groupId> <artifactId>logback-classic</artifactId> <version>${logback.version}</version> </dependency> </dependencies></dependencyManagement><dependencies> <dependency> <groupId>org.slf4j</groupId> <artifactId>slf4j-api</artifactId> </dependency> <dependency> <groupId>org.slf4j</groupId> <artifactId>slf4j-ext</artifactId> </dependency> <dependency> <groupId>org.slf4j</groupId> <artifactId>jcl-over-slf4j</artifactId> </dependency> <dependency> <groupId>org.slf4j</groupId> <artifactId>jul-to-slf4j</artifactId> </dependency> <dependency> <groupId>org.slf4j</groupId> <artifactId>log4j-over-slf4j</artifactId> </dependency> <dependency> <groupId>ch.qos.logback</groupId> <artifactId>logback-core</artifactId> </dependency> <dependency> <groupId>ch.qos.logback</groupId> <artifactId>logback-classic</artifactId> </dependency></dependencies> 先将依赖全部写在<dependencyManagement>节点中,这样可影响间接依赖,如果只当初的使用dependencies节点,只会应用直接依赖 使用999-not-exist这样的版本:欺骗maven,直接依赖一个空包占位,这样Maven就不会再去依赖相同坐标的真实依赖,间接起到排包的作用 ▐logback配置 文件名和位置 应用类型 文件名 文件配置(启动模块) 说明 spring-boot logback-spring.xml src/main/resources/ 支持从spring-boot配置文件中直接读取property 普通java应用 logback.xml src/main/resources/ WAR应用 logback.xml src/main/webapp/WEB-INF/ 需要依赖slf4j-ext,然后在web.xml里使用监听器挂载这个文件 单元测试和集成测试 logback-test.xml src/test/resources/ 配置样例 <?xml version="1.0" encoding="UTF-8"?><configuration> <property name="APP_NAME" value="demo1" /> <property name="LOG_PATH" value="${user.home}/${APP_NAME}/logs" /> <property name="LOG_FILE" value="${LOG_PATH}/application.log" /> <property name="LOG.PATTERN" value="%d %-5level %X{EAGLEEYE_TRACE_ID} %logger{5}[%L] - %msg%n"/> <property name="LOG.CHARSET" value="UTF-8"/> <appender name="APPLICATION" class="ch.qos.logback.core.rolling.RollingFileAppender"> <file>${LOG_FILE}</file> <encoder> <pattern>${LOG.PATTERN}</pattern> <charset>${LOG.CHARSET}</charset> </encoder> <rollingPolicy class="ch.qos.logback.core.rolling.SizeAndTimeBasedRollingPolicy"> <fileNamePattern>${LOG_FILE}.%d{yyyy-MM-dd}.%i.log</fileNamePattern> <maxHistory>7</maxHistory> <maxFileSize>50MB</maxFileSize> <totalSizeCap>20GB</totalSizeCap> </rollingPolicy> </appender> <logger name="org.springframework" additivity="false"> <level value="error"/> <appender-ref ref="APPLICATION"/> </logger> <logger name="com.ibatis" additivity="false"> <level value="error"/> <appender-ref ref="APPLICATION"/> </logger> <logger name="org.mybatis" additivity="false"> <level value="error"/> <appender-ref ref="APPLICATION"/> </logger> <logger name="java.sql" additivity="false"> <level value="error"/> <appender-ref ref="APPLICATION"/> </logger> <logger name="sqlMonitor" additivity="false"> <level value="error"/> <appender-ref ref="APPLICATION"/> </logger> <logger name="com.taobao" additivity="false"> <level value="error"/> <appender-ref ref="APPLICATION"/> </logger> <logger name="com.alibaba" additivity="false"> <level value="error"/> <appender-ref ref="APPLICATION"/> </logger> <logger name="com.alibaba.example.demo" additivity="false"> <level value="info"/> <appender-ref ref="APPLICATION"/> </logger> <root level="error"> <appender-ref ref="APPLICATION" /> </root></configuration> 使用SizeAndTimeBasedRollingPolicy使日志可以根据大小和日期进行滚动 日志编码请使用UTF-8 请正确使用日志级别,不要统统输出error 日志级别根据不同环境可配 如果是Pandora-boot或spring-boot可以直接在配置里使用property读取application.properties,application.properties在不同环境下使用-Dspring.profiles.active进行切换 普通应用和WAR应用:请使用autoconfig-maven-plugin插件 一些实用的日志技巧 ▐动态修改日志级别 场景:应用在运行中,默认日志配置的打印级别是error,但是我现在想针对某个包或者某个类输出下info日志。 使用Arthas:https://arthas.aliyun.com/doc/logger.html,该工具提供了动态修改日志的能力。 ▐追加业务信息到日志中,并格式化输出:追加MDC信息,方便排查问题 这是日志系统的一个扩容能力,可以把一些额外的信息输出到日志里,只需要在MDC上下文中写入kv,https://logback.qos.ch/manual/mdc.html 例如: public static void main(String[] args) { //代码里使用MDC.put写入key为traceId的值 //在logback.xml里就可以使用%X{traceId}进行输出 MDC.put("traceId", UUID.randomUUID().toString().replace("-", ""));} ▐配置定时日志磁盘占用清理 一定要配置合理的日志清理策略,避免磁盘被打爆,可借助日志框架自身能力,或借助可用的日志清理系统(如果有) 在logback.xml配置中,可通过配置带有清理作用的rollingPolicy来完成日志定时清理和滚动,例如:SizeAndTimeBasedRollingPolicy 这段配置的含义是:最多保留7天,单个文件最大50MB,该日志(包括滚动的)最大只能保存20GB。 ▐不要封装一个日志Util,而应该直接使用日志框架进行输出 反例:LogUtil.log("通过封装的日志工具打印日志"); 正例:log.info("直接使用日志框架的api进行日志输出"); 理由:在日志输出的时候,日志系统会打印日志产生的原始位置:比如哪个包的哪个类,以及第几行(如果配置了[%L]),如果你使用LogUtil等自己封装的工具,所有的日志输出打印的位置都是LogUtil的,这样不便于做日志问题定位 系统日志打不出来或者丢日志排查思路 目前没有现成的工具帮你一键做好这个事情,下面给出一个排查思路 先明确该系统到底使用的是什么日志框架+日志系统组合,这个很重要,必须搞清是何种组合才可有针对性的处理后续步骤 如果是slf4j+logback组合,则可根据第一章列出的maven依赖进行排包处理,优先保证依赖的包没有错误,90%的情况下都是包依赖混乱导致的日志丢失 排查自己的logback配置文件是否放在正确的路径下、文件名是否正确,配置文件位置不对也会导致日志输出的不对甚至丢失 检查logback配置文件内部每个logger及其level配置是否正确,避免自己期望打印info,却配置了error 总结 日志系统的正确使用,对于应用的日常维护和问题排查尤为重要,所谓:工欲善其事,必先利其器。本篇文章重点讲解了日志系统的结构和包如何正确依赖,这是很多同学最容易犯的错误,需要格外注意并认真阅读,只有正确理解其中的含义才可以更好的使用日志系统,在日常使用中大家要不断总结经验。 最后希望文章提供的内容能够在日常开发和维护中为大家提供到切实的帮助。 团队介绍 物流技术团队是服务淘天物流部及零售行业的产技团队,一直深耕在物流及供应链的数字化协同与运营领域:为零售业务提供灵活多样的经营模式管理方案及可以快速适配市场变化的经营策略数宇化管理工具;为商家提供高效低成本的物流及供应链解决方案,加快资金效率,提升协同效率;为消费者提供即时便捷的购物体验。 ¤ 拓展阅读 ¤ 3DXR技术| 终端技术| 音视频技术 服务端技术|技术质量|数据算法 本文分享自微信公众号 - 大淘宝技术(AlibabaMTT)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 淘宝购物车扩容与性能优化

为了应对用户规模的增加和交易活动的激增,淘宝购物车近年来进行了一系列技术升级,其中主要集中在扩容与性能优化上。本文将简要介绍这些改进措施,以及它们如何提升购物车的响应速度和用户体验,以实现“又快!又丝滑!”的购物体验。主要包括: 淘宝购物车扩容分析与解决方案 网络包大小与服务端并行化分析与方案 扩容的背景 首先讲一讲购物车的职责。购物车承载着购前环节中促成购买的职责:对于下单犹豫的用户,用营销等手段提升用户决策效率,对于转化确定性较高的用户,精准的推荐让他买的更多;在购中环节提供流畅的交易体验:优惠计算的准确性和过程的清晰度以及各种业务形态商品的凑单合并结算等。作为在购前链路中直面消费者的重要节点,购物车里的体验问题就显得十分重要且敏感。 分析往年的用户原声可以发现,用户对于扩容有强烈诉求。 So 购物车大刀阔斧般的升级可以说是刻不容缓! 针对全量用户做购物车加购商品上限的扩容,由200(现货120+预售80)扩充至380(现货300+预售80)。 扩容的挑战与解法 ▐扩容的挑战 每每提到购物车的容量,在扩容功能上线前都会受到一个灵魂拷问为什么我的购物车上限只有120??? 我们内部在进行多轮讨论后,也意识到购物车的整体扩容在技术上和产品设计上都面临巨大的挑战。聚焦在技术上的挑战主要来源于对数据库的直接冲击与扩容带来的交易全链路计算量放大。 数据库的挑战 存储瓶颈与相关影响 扩容首先带来的就是存储容量的上涨,按扩容到300的预期估算,存储量上涨就大约达到了2倍,在物理机资源有限的情况下存储量的上涨会同时到来BP缓存率的下降,这样就导致其他用户的数据只能去物理磁盘读取,磁盘IO会成为巨大的瓶颈,进而导致数据库各个操作的RT飙升。 扩容后由于 BP 命中率下降,冷数据访问导致大量读盘,数据库磁盘 IO 会成为巨大瓶颈。 实时计算量放大对交易全链路的挑战 现有架构的特点:「分页商品实时计算」 购物车现有的分页设计着实 提高了用户进入购物车的秒开体验 。 但是遇到类似 跨店满减筛选、降价筛选、消费券筛选等强依赖实时计算结果的产品设计,需要针对用户加购品做全量计算并一次性下发给客户端。 购物车筛选的实现 大促跨店满减报名是类目+商家纬度,营销规则又包含了部分类目黑标的逻辑。 但是购物车跨店满减筛选是商品纬度的判断。所以这里有一个从类目+商家到商品纬度的打平计算的过程。 为了判断商品是否报名了跨店满减,需要调用 营销 进行实时计算。 用户纬度的所有加购品经过 营销 计算后,购物车才能筛选出哪些参与了跨店满减。 下发客户端数据体积过大,导致用户体验变差 下发300+个品的数据包预计约为1M左右,在弱网环境下,按 100KB/s计算,需要的传输时间是10s 左右。 购物车已经采用了分页实时计算方案,提高用户秒开体验 由于筛选涉及全量下发,扩容会放大对交易链路的计算量且增加购物车本身的性能压力,从而导致用户体验的降低。 ▐扩容的解法 引入 tairsql 提升购物车读性能 以双十一峰值的购物车监控为例,在峰值期间有明显的脉冲流量,且主要流量集中在查询与勾选这两种依赖读db的操作类型,而涉及写db的流量(加购,删除,更新等)明显偏少。 查询购物车的SQL逻辑基本属于简单语句,SQL这种的查询条件主要是用户id、加购状态等。并且购物车数据是按照用户纬度聚合,单次请求返回的数据体积不会太大。 所以我们总结出购物车的流量特点为: 典型的读多写少, sql返回数据不会太大 有瞬时脉冲 对RT敏感 根据流量特点在调研多种数据库选型后,并结合营销团队在双十一通过 tairsql 解决买家资产查询的经验后,购物车本次选择 云原生内存数据库 tairsql 作为读库提升查询性能 。 读写分离 引入tairsql后,峰值期间的读流量全部走tairsql,写流量仍然会对db与taisql执行双写,同时有数据同步任务(精卫任务)做同步兜底。 使用tairsql与db做读写分离 采用双写+精卫方案保证数据同步 预计算 购物车的首页筛选难点在于依赖全量商品实时计算的结果,购物车扩容后势必对筛选造成性能压力。那么是否存在一种方式,能在调用下游服务进行实时计算之前,根据某些规则结合商品属性(商品标签,营销属性等),进行一次过滤,从而减少实时计算商品数呢? 分析现有的筛选产品功能后,针对营销类筛选(跨店满减筛选、预热态筛选、消费券筛选),考虑前置生成商品染色表,记录加购品特征,在营销计算前,根据筛选规则过滤出可能参加指定活动的商品。 预计算链路图示: 预计算链路中通过监听类目信息,优惠规则结合加购底表数据,生成加购商品特征表。当用户发起筛选请求时,和正常的渲染请求一样还是会在实时加购数据中查询全量加购数据的基础信息,之后会结合特征表和筛选规则,筛选出符合规则的商品,这些通过筛选的商品再与后续下游服务交互做实时计算。 端到端耗时组成 近年来内网用户都在吐槽手淘购物车的性能体验不好,也很罕见的在用户舆情里也看到反馈 “购物车卡顿”。在如此激烈的竞争中,购物车不仅是用户购物体验的直接接口,更是电商运营效率的关键所在。一个优秀的购物车系统,应当能承受巨大的并发请求,同时保持数据的准确性与实时性,为用户提供流畅的购物体验。 从性能数据来看从一次用户在购物车内发起网络请求到客户端产生相应变化,耗时组成大致分为 “网络传输”、“服务端耗时”、“客户端渲染”三大部分 。从服务端的视角结合 快速降低耗时的使命 ,我们针对除客户端逻辑外的优化思路主要有以下几块,具体的细节也会在后文详细展开 网络传输优化: 压缩数据:使用如Gzip这样的数据压缩技术或结合业务逻辑做裁剪减少传输数据的大小。 缓存策略:合理设置缓存策略,减少不必要的网络请求和包大小。 延迟加载:对于购物车非关键资源进行延迟加载,优先加载对用户体验影响最大的内容。 服务端耗时优化: 缓存机制:使用内存缓存如tair等,对频繁访问的数据进行缓存,减少网络传输压力。 并发处理:优化代码,使用异步处理和多线程技术,提高服务端的并发处理能力。 代码优化:精简代码逻辑,移除不必要的中间件和服务 网络包传输 ▐包大小对网络rt影响分析 在当今的网络环境中,上下行带宽往往是不对称的,这种不一致性在移动网络中也很常见,网络运营商为了更有效地利用有限的无线频谱资源,往往会分配更多的带宽给下行链路,以提供更好的媒体消费体验。考虑到这种上下行带宽的不一致性,上行包的优化往往比下行包的优化收益更大。因为下行通常有更多的可用带宽,即使存在一些性能瓶颈,用户也可能不会立即感受到明显的性能下降。而上行链路由于其固有的带宽限制,任何性能的微小提升都能给用户带来明显的体验改善。优化上行数据包,例如通过减少发送的数据量、实现数据包的压缩、优化传输协议以及应用智能队列管理,能够有效降低延迟、提高上传速度,从而在带宽受限的情况下尽量减少阻塞和等待时间。 上行包优化收益略大于下行包优化收益。 ▐购物车状态协议缓存 回到购物车的场景,上行包 最直观的膨胀点 就在于请接口求中params字段: 这一份长长的params里包含了,页面组件,页面状态等多个信息,其中页面组件是客户端渲染强依赖数据,而状态数据是服务端业务逻辑依赖数据。 状态数据同时存在于上下行协议中,且客户端不依赖其做逻辑处理,所以 理论上这份数据可以不作为协议下发 ,并且在服务端的“历史长河”中,由于缺乏对该信息的管控,状态协议数据可以随意的追加,导致了这份大数据包逐渐成为上下行网络包中的一份包袱。 状态协议数据同时存在于上行与下行协议中,且客户端不依赖。 为了达到和客户端解耦的效果,最直观的方法就是将这份数据存到缓存中。然而在结合交易流量和现有计算资源做一个简单估算后,我们发现事情并没有那么简单。结合淘宝购物车的峰值流量来测算,整体产生的带宽量级会达到数十GB,在当前的规格资源下根本不够用。 压缩与缓存 前文也提到了我们的终极目标是把服务端依赖数据放到缓存中,完全与客户端解耦。经过结合业务逻辑的状态协议裁剪,包大小已经有所降低,带宽瓶颈与可用性问题确实得到了缓解。那么在将这份数据存到缓存之前,还有没有可以继续“压榨”的空间呢?答案是当然是有。 base64 和 压缩算法: 在原有的模式下,状态协议通过客户端和服务端直接传输来做保持,故需要通过使用base64编码确保数据能正确地存储和传输,而不是通过原始的二进制格式。这种方式会带来 大约33%的数据膨胀 ,在确定了状态数据往缓存中存储的优化方向后,状态数据可以不再做base64编码,而转为 直接存字节数组 。 Base64编码原理:Base64编码将每组3个字节(共24位)的原始数据划分为4个单元,每个单元6位。由于每6位只能表示64种状态(2^6 = 64),Base64编码选择了一个64字符的集合来表示这些状态。这个字符集通常包括大写和小写英文字母(A-Z, a-z)、数字(0-9)、加号(+)和斜杠(/)。实际编码时,Base64处理器会查找这个字符集,将每个6位的值映射为相应的字符。 数据膨胀:考虑到大多数字符编码(如ASCII,UTF-8)中,一个字符通常占用8位(1字节)。在Base64编码中,每4个字符用来表示原始数据的3个字节。这意味着每个原始字节在编码后占用了8 * 4 / 3 = 10.666...位。换言之,原始数据的大小会增加大约1/3(33%)。 我们同时也测试了原始长度为36KB(未压缩状态数据)在各个压缩算法下的表现,虽然部分算法(例如Brotli)能实现更高的压缩比,但是综合解压和压缩时间来看, gzip仍然是最好的选型 。 购物车状态缓存模式: 经过上述优化后,状态数据的大小在网络传输包能进一步得到缩减,从而减小带宽和存储上的压力。状态数据在客户端与服务端的交互方式也由原先网络传输的模式,改为客户端解耦的服务端 缓存模式 。客户端上行数据中不再持有状态数据,业务状态的计算完全交付服务端,若出现缓存超时或异常则通知客户端降级为网络传输(原有模式)。 ▐流式Api 经过上述的优化后,我们发现有一个遗留的“坑”点,为了能保证 异常情况下用户操作能兜底上传一份状态数据 ,下行包中仍然保留了 全量的状态协议 。此时就需要我们在保证兜底能力的情况下,把下行包中的状态协议也进行剔除。 流式api介绍 参考业界流式API模型,说法各不相同,主要是以下三种: request streaming: 多个上行对应一个下行; response streaming: 一个上行对应多个下行; bidirectional streaming: 端云双向流式服务; 流式API是实现 “response streaming”,即 一个上行多个下行 ,请求模型如下: 引入流式后 通过流式api的引入,下行包拆成了主包与副包,状态协议在副包中,其余数据保留在主包。客户端在收到主包后即可执行渲染逻辑,等效于状态数据在网络传输中的耗时,不再影响用户端到端体验耗时。 服务端接口 ▐接口耗时分析 服务端耗时占比: 从用户的操作数据来看,大部分用户操作商品数量较少,这些情况下服务端的性能表现尚可,这意味着服务端耗时对购物车这部分用户的影响不大。但是随着商品数量的增加,服务端耗时在端到端耗时中占比不断攀升,这意味着 服务端性能对购物车的深度用户影响较大 。 商品数据较少时:服务端优化点在于下发数据量,在网络包优化中已经得到了解决 商品数据较大时:服务端优化点在于降低耗时 ▐并行化改造 购物车的服务端逻辑一大特点是 平均商品数较大 ,其中对于商品数的处理在历史上多使用简单的foreach直接遍历做计算。针对解决过多foreach逻辑最有效的方法自然是做 并行化处理 。购物车的流程基于业务特性将各个独立域活动进行串联,流程简化图如下: 结合业务回头来看整个流程,会发现全串行流程中低效的点: 部分节点之间并没有严格的顺序关系,例如查服务数据在注入商品标签后即可执行,且服务数据当前只在视图层构建有用。 互不依赖的下游服务例如库存查询、营销计算、查服务数据是低效的串行查询。 购物车平均商品数过大的特点,导致和商品数相关的节点内部做foreach循环非常低效,典型的有例如注入商品标签、视图层构建。 找到问题后,我们最终采用基于ForkJoinPool的方式实现购物车并行化改造: ForkJoinPool主要针对那些可以拆分成多个子任务的大任务进行优化。它的核心技术原理是基于“工作窃取”算法,每个工作线程都有自己的任务队列,当线程完成自己队列里的任务后,它可以从其他线程的队列尾部窃取任务来继续工作,这样可以保持所有工作线程的高效运行,避免了线程闲置。ForkJoinPool 通过 ForkJoinTask 的子类如 RecursiveAction 和 RecursiveTask 来支持任务的分割(fork)和结果的合并(join)。 这种面向多子任务且支持并行化的方式,就非常适用于购物车场景中的多商品处理,例如: 并行处理多商品任务:购物车的一大特点就是平均商品数多,每个商品标签注入、单个视图分组构建等操作都可以作为一个子任务独立执行。 任务可拆分性:购物车中的每个商品处理逻辑都是独立的,这使得任务可以很方便地被拆分成小任务并行执行。 提高响应性能:使用 ForkJoinPool 可以在多核处理器上同时执行多个商品的处理任务,从而减少总体的处理时间,提高系统的响应速度。 动态任务调度:"工作窃取"算法能够在运行时动态地重新平衡任务负载,如果某些商品的处理耗时较长,ForkJoinPool 能够确保其他线程不会闲置,而是帮助处理剩余的工作。 结合ForkJoinPool的方式做并行优化后的购物车流程简化图如下: 注入商品标签和视图层构建,从商品维度拆分子任务,使用并行化。 将部分仅视图层且互不依赖的下游数据节点做聚合,内部做并行查询。 团队介绍 看到这里相信诸位能够感受到购物车技术体系的复杂度和深度,笔者所在的团队是淘天集团交易前链路技术团队(购物车&下单),在这里,你能够不断被各种商业模式烧脑,也能够不断被各种新兴技术锤炼,更能收获一群志同道合的战友。值此变革关键时期,也急需有能力和有梦想的你一起参与: 1. 负责淘宝购物车、下单等面向全民用户的C端产品演进和迭代,每一次需求每一行代码都能创造巨大的商业价值。 2. 支撑集团16N组织下形态各异电商的购物车、下单平台应用的维护(buy2 carts2),在这里见证如何针对形态各异的电商进行架构抽象出电商内核,并通过高度灵活的开放扩展机制解决业务的差异性。 3. 操刀完整的端到端协议的设计、演进和优化(奥创),见证移动时代在客户端不发版的情况下,如何既能高效满足产品需求迭代,又能获得native一样优异的消费者体验。 4. 全程保障每一次大促流量洪峰背后的业务安全和稳定性,全力促成持续的平台架构演进,确保用户每一次购物车浏览,每一次下单能够丝滑顺畅。 如果您有兴趣,可以点击下面的链接或者通过邮箱bonan.hbn@alibaba-inc.com与我们联系和交流,期待您的加入。 https://talent.taotian.com/off-campus/position-detail?lang=zh&positionId=1089401 ¤ 拓展阅读 ¤ 3DXR技术| 终端技术| 音视频技术 服务端技术 | 技术质量| 数据算法 本文分享自微信公众号 - 大淘宝技术(AlibabaMTT)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 得物 SRE 视角下的蓝绿发布

一、前言 发布变更是影响稳定性的一个重大因素,为了发布异常时能快速回滚,增加发布期间的稳定性,也为了解决多服务部署时互相依赖而导致的发布时间增长等问题,得物在今年引入一种新的发布模式--蓝绿发布。这种发布模式带来了稳定性和效率的提升,这里我们以SRE的视角来解读下得物的蓝绿发布。 二、常见的发布形式有哪些?分别有什么优势? 全量发布 全量发布是早期企业进行系统升级的一种方式,因为早期的服务大多为大型机,单实例程序为主。并没有形成当下流行的微服务架构,因此当发布时往往需要停机发布。生产环境禁止使用这种方式进行部署! 滚动发布 滚动发布顾名思义,假如生产中16台机器,我们可以分成4批。每批4台机器,每批机器执行更新,从版本V1更新为V2,更新后重新将其投入使用,连续不断的更新其他机器,直到集群中所有的实例都更新为版本B后,结束发布。 这种方式的好处就是更新过程体验影响少,费用开销也少,发布期间无需额外新增机器。但是缺点也同样明显,一旦开始发布后,回滚时长很久,在多个有关联的服务部署时,需要上游服务完全发布后,才能发布下游服务,整体发布时间也很长。 滚动发布流程演示: 蓝绿发布 通常意义上的蓝绿发布一般是将服务分为两组,蓝组和绿组,正常运转的情况下每组承载50%的流量。当准备发布服务时, 将蓝组流量设置为0%,将绿组空闲出来,将服务部署到绿组的机器,然后利用SLB将流量切换到绿组的机器,让绿组来运行业务,没问题的话流量全部导向绿组,把蓝组也进行服务更新。 传统意义上的蓝绿发布优点在于发布策略简单,对于用户几乎无感知,可以实现平滑过度,在发布期间发现问题后也可以快速的回滚。而缺点则是通常需要准备正常业务使资源俩倍以上的服务器,需要投入较大的资源成本。 蓝绿发布流程演示: 切除绿集群流量: 当A组升级完毕,负载均衡重新接入A组,再把B组从负载列表中摘除,进行新版本的部署,A组重新提供服务。 最后,B组也升级完成,负载均衡重新接入B组,此时,AB组版本都已经升级完成,并且都对外提供服务。 灰度发布 灰度发布,也被叫作金丝雀发布。与蓝绿部署、红黑部署不同的是,灰度发布属于增量发布方法。也就是说,服务升级的过程中,新旧版本会同时为用户提供服务。 灰度发布的具体流程是这样的:在集群的一小部分机器上部署新版本,给一部分用户使用,以测试新版本的功能和性能;确认没有问题之后,再对整个集群进行升级。简单地说,灰度发布就是把部署好的服务分批次、逐步暴露给越来越多的用户,直到最终完全上线。 之所以叫作灰度发布,是因为它介于黑与白之间,并不是版本之间的直接切换,而是一个平滑过渡的过程。 AB Test就是一种灰度发布方式,让一部分用户继续用A,一部分用户开始用B,如果用户对B没有什么反对意见,那么逐步扩大范围,把所有用户都迁移到B上面来。灰度发布可以保证整体系统的稳定,在初始灰度的时候就可以发现并调整问题,以保证其影响度,而我们平常所说的金丝雀部署也就是灰度发布的一种方式。 之所以又被叫作金丝雀发布,是因为金丝雀对瓦斯极其敏感,17 世纪时英国矿井工人会携带金丝雀下井,以便及时发现危险。这就与灰色发布过程中,先发布给一部分用户来测试相似,因而得名。 对于灰度发布来说,它的优点在于如果前期出问题影响范围很小,相对用户体验也少;可以做到及时发现、及时调整问题,影响范围可控。但是采取这种模式对自动化以及运维监控能力的要求非常高。 三、得物的蓝绿布是如何实现的? 前面讲了“what”,我们现在来说下“how”。 在平时,我们也会保留蓝绿两个集群,在发布时,引入灰度的流量平滑过度,帮助我们完成整个发布过程,下面以SRE的视角大致讲一下蓝绿发布的架构与流程。 蓝绿发布的流程 在这种架构下,整体的发布流程如下: 日常流量 在未发布时,我们接入蓝绿发布的服务是平均分成蓝绿俩个集群的。平时通过网关均匀切分流量,平均每个集群50%的流量。 开始发布 当进行蓝绿发布时,我们将需要发布的应用创建在一个通道中(这里先说下只有一个通道部署的情况)。 蓝集群(右侧)摘流 此时所有流量将只访问绿集群,如下图所示,当蓝集群摘流完成后, 此时集群没有任何流量,即可进行部署。 蓝集群(右侧)引流 当蓝集群发布完成后,我们需要对蓝集群发布后的服务进行确认。在确认部署成功后,则梯度的将流量引入更新后代码的蓝集群(右侧),最开始我们会切1%的流量,切流量后,我们可以在线上观察蓝服务的流量、错误率等。以此观测发布的版本是否有异常。之后,我们逐渐将流量切回50%。注意,需要确保相关缺陷都在该环节暴露出来,因为这个环节另一半老版本的、稳定的代码还在Standby,可以随时操作流量比例,进行流量迁移。 发布过程中,蓝、绿节点间流量不会互窜(对比上图,蓝绿集群间斜向箭头没有了)。 此阶段需要注意MQ流量,因为MQ当前无法按比例进行切分,因此一旦开始切流,则MQ流量会恢复为50%/50%。 绿集群(左侧)摘流 通过扩大流量比例,流量全部切到蓝集群,这个阶段流量已全部切到新代码,可以让测试同学介入进行新功能验证以及回归测试。 在这个阶段只要绿集群还没发布,发现问题,仍然可以全部切回老代码! 当测试验证完成后,即可进行绿集群发布。发布后则不可以回切了!就算要代码回滚,也得等本次发布结束后,再单独对服务进行回滚。 绿集群(左侧)引流 在发布后则开始进入绿集群引流了,此时可以快速引流,因为已经没有可以回滚的、稳定版本的代码了。同样,还在发布阶段,及时流量均衡,也不会出现互相交叉的流量。 发布完成 发布完成后,则去除通道,蓝绿集群可以继续进行交互。 如上图所示,使用以上发布流程具备以下好处: 整个发布过程是以蓝、绿集群维度并行调度、实施的,通过发布平台统一操作,摘流,无需各业务域各自处理。 通过请求蓝绿粘性,让下游应用的新老版本代码可以同时存在,无需阻塞等待下游应用全部升级到新代码,解除了批次依赖。 发布过程中有灵活的流量控制能力,可以按1%、50%等阶梯流量验证应用。 上述发布流程,可以同时并存若干个,摘流、引流动作互不影响(多发布通道)。 蓝绿发布的架构 应用架构 [1] 1.1 流量规则SDK 在所有需要接入蓝绿发布的程序中,首先需要升级流量规则SDK,流量规则SDK是应用蓝绿发布能力的代码底座,向中间件组件如RPC、MQ、JOB提供了主动查询流量规则和被动接受流量规则变更事件的能力,各中间件组件响应流量规则进行合适的动作,实现各类型流量的动态摘流、动态引流。 1.2 核心能力 依赖配置中心做持久化存储与事件推送。 所有配置读取都是内存操作,只会在启动时读取一次配置中心的配置,后续配置变更都依赖于配置中心的事件推送。 提供了如下的能力: 当前应用所在的发布通道,是否在蓝绿发布中。 指定应用所在的发布通道,是否在蓝绿发布中。 蓝色流量百分比,范围[0, 100]。 提供了如下的事件推送: 发布开始事件onStart。 发布结束事件onFinish。 切流事件onFlowChange,切流事件又细分了以下几个事件。 切流事件,蓝色流量标占比为100,绿色流量标占比为0,onEnterAllBlue。 切流事件,蓝色流量标占比从100改为非100,绿色流量标占比从0改为非0,onExitAllBlue。 切流事件,蓝色标流量占比为0,绿色流量标占比为100,onEnterAllGreen。 切流事件,蓝色标流量占比从0改为非0,绿色流量标占比从100改为非100,onExitAllGreen。 流量控制 得物目前的流量分为内部流量及外部流量,大部分流量情况如下: 外部流量 通过各类Gateway请求 通过k8s Ingress请求(暂不支持蓝绿发布) 内部流量 通过Gateway互联 通过Dubbo/Feign RPC协议互联 通过MQ异步请求 通过kafka异步请求(暂不支持) JOB类任务发起的流量 通过k8s SVC请求(暂不支持蓝绿发布) 其中Gateway也是通过Dubbo或者Feign请求下游服务,因此也可统一为RPC类型,所以得物目前的流量主要包含RPC、MQ、JOB三种。 2.1 RPC 我们RPC流量核心主要依赖注册中心,通过Dubbo的负载均衡策略进行调整。 如何实现RPC流量比例控制 RPC场景下应用的流量比例控制,取决于它的上游应用按照流量规则比例向其发起调用。核心是上游应用感知到下游应用实例权重。 当前应用通过流量规则SDK监听到所在通道的流量规则变更时,修改注册中心上的实例权重。 上游应用通过注册中心透明的感知下游应用的实例权重,通过加权负载均衡策略实现流量比例控制。 Dubbo原生的各类负载均衡策略都支持加权,也就是即便上游没有升级蓝绿依赖,下游应用依然可以通过蓝绿实例权重控制自己蓝绿集群被调用的比例。 Feign原生是不支持的,Fusion框架重写了负载均衡策略。 如何控制流量比例 蓝色流量比例Rate,蓝色集群实例权重WB,绿色集群实例权重WG。 假设Rate从1调整到99,一共有4个节点。 调整前WB=1,WG=99,调整后WB=99,WG=1,可能出现以下情况: -流量规则变更时,只让蓝或绿某一个集群修改自己的权重。 权重值是相对的,只需要保证蓝、绿集群节点权重相对值服从流量比例即可,无需同时修改蓝绿集群所有节点的权重。实例权重初始值设为100,修改权重时,尽可能保证一半集群实例权重保持100不变,只修改另一侧被调整的集群实例的权重。 规则如下: 蓝色流量比例Rate,公式:W/(100+W) = Rate/100。 Rate = 50,蓝色集群实例权重=100,绿色集群实例权重=100。 Rate < 50,蓝色集群实例权重=100 * Rate / (100-Rate),绿色集群实例权重=100。 Rate > 50,蓝色集群实例权重=100,绿色集群实例权重=100 * Rate1 / (100-Rate1),其中Rate1=100 - Rate。 只有一个颜色的集群时,忽略权重。 如何实现完全摘流 Dubbo框架内置的所有负载均衡策略都会识别下游实例的权重进行加权筛选节点,无需上游升级依赖,下游应用实例权重置0后即可实现摘流。 Feign框架默认不识别实例权重,不进行加权负载均衡,为了避免蓝绿发布项目落地时推动发布链路上下游应用升级的困难,应用摘流时,会将自身注册的所有Feign服务反注册,以保证Feign流量能被彻底摘流。 如何实现请求链路蓝绿粘性(一蓝到底或一绿到底) 蓝绿子集群的代码是不一样的,按我们制定的发布流程,蓝集群是新代码,绿集群是老代码,如果不能固定请求链路的颜色,实现请求过程一蓝到底或者一绿到底,那么可能会出现上游新代码调用到下游老代码,出现代码不兼容的异常。 将RPC请求第一次进入每个通道时的蓝绿决策结果以KV形式Append到分布式Trace的baggage中,全链路透传、隔离、复用。 如果Trace中有蓝绿决策结果,则按照蓝绿决策结果筛选节点; 否则按照流量比例筛选节点,并将决策结果(节点集群颜色)Append到Trace。 baggage-key: x-deploy-channel-type。 baggage-value:key=通道标识,value=蓝集群或绿集群标识,多个通道以&分割。 2.2 MQ(RocketMQ) 核心是通过多消费组实现MQ流量隔离和控制。业务上创建的一个业务消费组,会在MQ SDK层面透明的创建2个衍生的颜色消费组。 发送消息时,会在消息头上携带当前节点蓝绿标。3个消费组收到消息时,根据消息颜色和消费组颜色做颜色请和判断,互斥的消费同一个TOPIC上的所有消息。 非摘流状态 摘流状态 应用感知到通道内蓝集群摘流时,蓝集群节点关闭消费组、绿集群节点启动三种颜色消费组。此时,MQ流量完全由绿集群接管。 通道内绿集群摘流时同理。 过程详解 原本一个消费组,拆分成三个消费组。 原始消费组origin-consumer用于消费无(蓝绿)标识的流量。 蓝色消费组blue-consumer用于消费「蓝色」标识流量。 绿色消费组green-consumer用于消费「绿色」标识流量。 2.3 JOB(elasticjob) elasticjob在运行时会在业务应用集群内利用ZK协调产生一个Master节点,由Master节点来按负载均衡策略将任务分配到各个执行器节点上。这个任务分配关系一经分配就会固定并在后续复用,除非是有应用进程上下线、JOB分片数有变更。 改造elasticjob客户端适配流量规则SDK,正在蓝绿发布的应用,在感知到有集群已经摘流时,会修改ZK上的状态标识,将上述记录的分配关系失效。 失效后,后续JOB执行时,会根据流量规则重新进行任务分配,避让已经摘流的节点,以保证已经摘流的节点上不会有JOB执行。 过程详解 蓝绿接入注意事项 因当前技术限制, 服务接入蓝绿需要注意以下事项: 流量无法摘除的服务暂时无法接入 未通过网关进入服务流量:例如,通过域名SLB进入服务、通过Ingress进入服务的流量无法摘除。 消费Kafka的流量无法摘除:由于应用使用的原生kafka客户端并全面铺开、无法对切入提供支持。 未使用统一框架/注册中心:未使用统一框架和注册中心的Java应用、以及非Java类应用当前不支持蓝绿发布。 使用特别提醒 消费消息需幂等:使用消息中间件必须做幂等,这是基本要求,在消费组启停管控中可能产生重复消息。 消费组线程数量:由于会有三个消费组、消费线程也会增加两倍,有业务影响时需调低线程数。 需要好流量评估:蓝绿发布需一半节点承接线上流量、在应用升级蓝绿集群时做好确认。 升级到特定版本:使用蓝绿发布需要应用升级到框架指定版本,详见接入指南。 Feign/HTTP流量:针对使用框架Feign的HTTP流量,需上下游应用全部升级后方可使用。 使用Dubbo流量:使用框架Dubbo的服务只需要自身服务升级版本即可、无需上下游升级。 四、得物SRE团队对蓝绿发布的相关支持 容器集群针对蓝绿的改造 我们容器的workload使用的OpenKruise来进行管理。在进行蓝绿发布之前,我们使用的单个clonesets进行控制。 以下图所示,为我们一个测试非蓝绿集群,这里就是使用单个cloneset进行控制的单实例。 在进行蓝绿改造后,我们将workload分为蓝绿两个clonesets,通过这样,我们可以实现蓝绿发布时候的单边实例发布。同时在我们管理平台界面,任是单个集群界面, 以此来实现单集群下 蓝绿集群的拆分。 蓝绿发布扩容资源优化 前面就说过,蓝绿发布的一大缺点是通常需要准备平常流量2倍的资源,以应对蓝绿发布期间的流量。我们在加入蓝绿发布集群时,也尽量会提醒需要增加资源以应对蓝绿发布。但如果毫无规划的进行扩容,则会带来以下几个问题,比如长期保留扩容资源,则会带来成本的答复增长,而临时的扩容,则代表着对人力的消耗增加,而且临时的扩容也增长了对资源池管理的难度。可能在用户扩容时,出现资源池不足的情况。 为了应对这个问题,我们针对蓝绿发布进行了优化。首先是在发布流程中加入了扩缩容的环节。让平台自动帮助进行服务的扩缩容。其次,在容器层面,我们利用云服务商的弹性实例功能,来弥补常规资源池不足的情况,通过基于Virtual Kubelet技术接入到k8s中,支持秒级启动,按量计费,可快速完成扩缩容,满足业务的实时响应需求。 注意: 在应用加入发布通道时,因蓝绿发布会导致流量减半,请务必对核心服务进行扩容(SRE建议扩容30%以上)。 发布监控 加入灰度的蓝绿发布,因为涉及流量切换过程,因此对监控要求非常高,需要及时观测整个通道中的服务状态,而历史中单应用的监控页面无法满足发布owner有效观测。因此,针对这个问题,我们专门设计了通道级的蓝绿发布大盘,有效的观测流量分布情况,服务的请求情况等。通过该大盘,发布owner能有效掌握本次发布情况,决定是否继续进行切流。 五、蓝绿发布期间可能出现的问题及应急响应策略 资源不足导致的服务异常 发布前扩容 根据蓝绿发布原理可知,我们在发布时,只有50%的实例来支撑原先100%的流量, 因此务必在蓝绿发布前勾选发布前临时扩容。扩容量需要评估以下几个数据: 服务CPU 水位情况 根据历史经验,如日常水位99值在20%以内的服务,无需进行临时扩容,而99值在20%-30以内的服务,建议扩容20%左右。而99值在30-40%之间的服务,应当扩容30%以上。同时也要考虑发布当天的流量情况。 比如我们在七夕大促期间的发布,因大促流量过高,我们许多服务在蓝绿发布时扩容达到了50%以上的情况,通过此方式,保证在切流期间,服务也能正常。 因为我们的服务大多以JAVA为主,内存大多用固定方式分配给了JVM堆,因此内存不是一个核心的参考指标。 服务线程使用情况 除了服务CPU外,服务线程也是一个核心参考指标,特别是Dubbo线程池以及DB/Redis的线程池。比如原先Dubbo线程池,max为 200,10个实例的服务,当日常QPS大于1000的时候,在蓝绿发布时就需要扩容了,否则实例数少了一半,意味着可用线程也少了一半,这个时候就会出现线程拒绝异常了。 发布期间的资源不足 有些时候,我们评估不足会导致在开始发布后因为资源不足导致的错误率上升,此时需要我们紧急处理,但为了发布期间的稳定性,一旦我们开启了蓝绿通道,就不允许进行集群的扩容了。此时需要SRE接入在后台进行处理,处理逻辑如下: 确认待扩容集群未处于发布状态。 手动修改蓝/绿单边集群cloneset的replicas数据。 待发布完毕后,手动还原该cloneset的replicas数据。 因该操作非标准操作,且存在风险,请尽量不要使用以上方式进行。 发布中出现流量不均衡的情况 之前的一次测试中,我们在引流后出现了服务流量不均衡的问题,当时因为Fusion框架升级了Dubbo异步的改造中存在逻辑缺陷,导致流量无法均衡分布。之后,通过回退Fusion框架版本后问题恢复。 这是个比较危险的情况,某些节点会在发布时承担日常400%的流量,很容易造成服务雪崩。因此,在蓝绿发布中,负责人和SRE要加强服务的监控和关注力度,及时发现流量不均衡的情况并介入。 发布中出现流量互窜的情况 流量互窜的问题会有许多种情况:有因为切流前的JOB持续运行,导致双边集群依旧有流量;有的因为链路中间节点没有升级蓝绿能力,导致流量错位;有的因为MQ请求下游导致的流量错位。这里不针对问题进行一一分析,问题的解决仅能依靠框架的升级,这里仅说下问题的影响和排查方法。 在蓝绿发布时,原先我们的预计是老代码连老代码,新代码连新代码,但出现异常请求时,可能出现新代码连老代码,或者老代码连下游新代码的情况,这个时候就会出现因为依赖不匹配,导致的服务异常。要发现此类问题,我们首先要知道,在这种情况下,大多会出现单边集群错误率上升。通过我们的监控页面,我们能很好的发现单边错误率上升的情况。此时,我们就能根据这些错误的情况,在天眼的调用链分析中,查看错误的具体情况。此时需要我们判断链路里是否有出现流量异常的情况,查看节点的Host name,可以判断是蓝或者绿集群节点。 六、历史总结及展望未来 蓝绿发布的效果 自从交易域进行蓝绿发布以来,平均大版本的发布时效较之前得到了较大的提升,同时近期大版本已没有出现故障事件,在升级蓝绿发布后,我们可以提前在切流阶段发现问题,并快速回切进行修复,避免了故障带入生产。因此,现在蓝绿发布相比过去滚动部署,在效率和稳定性上均大有提升。 未来展望 目前我们核心服务都已切换至蓝绿集群,这种为我们的多活打下了优势,已经天然具备了多活的条件。因此,未来我们可以通过这种架构来部署我们的多活,这样,当任何单机房出现异常后,能够快速切换到另外一个机房,我们的抗风险能力也会有巨大的提升。 参考引用:[1] 特别鸣谢,本节蓝绿发布架构及原理部分引用了得物中间件平台 “羊羽”同学的文章。 文/latte 本文属得物技术原创,更多精彩文章请看:得物技术官网 未经得物技术许可严禁转载,否则依法追究法律责任!

优秀的个人博客,低调大师

每日一博 | Spring 七种事务传播性介绍

作者:vivo 互联网服务器团队 - Zhou Shaobin 本文主要介绍了Spring事务传播性的相关知识。 Spring中定义了7种事务传播性: PROPAGATION_REQUIRED PROPAGATION_SUPPORTS PROPAGATION_MANDATORY PROPAGATION_REQUIRES_NEW PROPAGATION_NOT_SUPPORTED PROPAGATION_NEVER PROPAGATION_NESTED 在Spring环境中,含有事务的方法嵌套调用,事务是如何传递的规则,以及每种规则是如何开展工作的。文章还提到每种事务传播性是如何使用的,方便读者依据实际的场景,使用不同的事务规则。 一、什么是Spring事务的传播性 Spring 事务传播性是指, 在Spring的环境中,当多个含有事务的方法嵌套调用时,每个事务方法都处于自己事务的上下文中,其提交或者回滚行为应该如何处理。 通俗讲,就是当一个事务方法调用另外一个事务方法时,事务如何跨上下文传播。 1)当事务方法A调用事务方法B时,事务方法B是合并到事务方法A中,还是开启新事务? 2)当事务方法B抛出异常时 ,在合并事务或者开启新的事务的场景中,事务的回滚是如何处理的 ? 以上事务的处理规则,都取决于事务传播级别的设置。 二、事务的传播性都有哪些行为 事务的传播行为,主要分为三种类型,分别是:支持当前事务、不支持当前事务、嵌套事务。 2.1 支持当前事务 REQUIRED:默认的事务传播级别,表示如果当前方法已在事务内,该方法就在当前事务中执行,否则,开启一个新的事务并在其上下文中执行。 SUPPORTED:当前方法在事务内,则在其上下文中执行该方法,否则,开启一个新的事务。 MANDATORY:必须在事务中执行,否则,将抛出异常。 2.2 不支持当前事务 REQUIRES_NEW:无论当前是否有事务上下文,都会开启一个事务 。如果已经有一个事务在执行 ,则正在执行的事务将被挂起 ,新开启的事务会被执行。 事务之间相互独立,互不干扰。 NOT_SUPPORTED:不支持事务,如果当前存在事务上下文,则挂起当前事务,然后以非事务的方式执行。 NEVER:不能在事务中执行,如果当前存在事务上下文,则抛出异常。 2.3嵌套事务 NESTED:嵌套事务,如果当前已存在一个事务的上下文中,则在嵌套事务中执行,如果抛异常,则回滚嵌套事务,而不影响其他事务的操作。 三、每种事务的传播性如何工作 3.1 REQUIRED 默认的事务传播行为,保证多个嵌套的事务方法在同一个事务内执行,并且同时提交,或者出现异常时,同时回滚。 这个机制可以满足大多数业务场景。 例子 : 1)类TestAService的方法通过声明式事务的方式,加上了事务注解@Transactional ,并设置事务的传播性为REQUIRED。 2)调用者调用TestAService的A方法时,如果调用者没有开启事务,那么A方法会开启一个事务。 A方法的具体执行过程如下 : a. 执行insert,但没有提交; b.调用TestBServcie的B方法,由于B方法也声明了事务,并且传播性是REQUIRED,所以方法B的事务,合并到方法A开启的事务中。 c.方法B执行insert操作,此时也没有提交。 3)由于这两个方法的操作都在同一个事务中执行,当这两个方法所有操作执行成功之后,提交事务。 嵌套调用链路: 当方法B 执行时抛出了 Exception 异常后,事务是如何处理的 ? 1)方法B声明了事务,insert操作会回滚 2)由于方法A和方法B 同属一个事务,方法A也会执行回滚,由此说明该规则保证了事务的原子性。 嵌套调用,异常后的链路: 如果 方法B 抛出异常后,方法A 使用 try-catch 处理了方法B的异常(如下代码),并没有向外抛出,此时事务又如何处理的 ? 方法A也会回滚。 从事务的特性我们可知,事务具有原子性。方法A和方法B同属一个事务,当方法B抛出异常,触发回滚操作后,整个事务的操作都会回滚。 因此,Spring 在处理事务过程中,当事务的传播性设置为REQUIRED,在整个事务的调用链上,任何一个环节抛出的异常都会导致全局回滚。 3.2 REQUIRES_ NEW 每次都开启一 个新的事务。 例子: 上面例子中,方法B的传播性设置为 REQUIRES_NEW,方法A仍然是REQUIRED,当A调用B时,具体调用链路如下: 具体执行过程: 方法A被执行前,如果调用者没有开启事务,方法A开启一个事务1,然后执行insert ,此时没有提交; 方法B的事务传播性设置为REQUIRES_NEW,当被方法A调用时,此时方法A的事务1会被挂起,方法B开启自己的事务2,然后执行insert,此时并没有提交; 当方法B执行完毕后,提交事务2; 恢复事务1,最终提交。 当 方法B 执行时抛出了异常,会发生什么? 方法B的insert操作会被回滚掉,方法A不受影响。但这里有个前提,方法A需要try-catch方法B的异常,使其异常不会往上传递,从而导致方法A接收到异常,导致回滚。 3.3 SUPPORTED 当外层方法A存在事务,方法B加入到当前事务中,以事务的方式执行。 当外层方法A不存在事务,方法B不会创建新的事务,以非事务的方式执行。 例子1: 以上例子,方法A没有加事务注解,方法B的加了事务注解,并且传播为SUPPORTS。 具体执行过程: 方法A以非事务的方式执行insert操作。 方法B被调用,由于其外层事务A没有开启事务,方法B也是以非事务方法执行insert操作。 例子2: 以上例子,方法A和B都加上了事务注解,其中方法A的传播性为REQUIRED,方法B的传播性为SUPPORTS。 具体执行过程: 如果方法A的调用方没有开启事务,则方法A开启事务,并执行insert操作,但没有提交; 方法B被调用,由于其外层方法A开启了事务,因此方法B加入到方法A开启的事务中,并执行insert,但没有提交; 当事务中的所有操作执行成功后,事务提交。 3.4 NOT_SUPPORTED 不支持事务。 如果外层方法存在事务,则挂起外层事务,以非事务方式执行,执行完毕后,恢复外层事务。 例子: 以上例子:方法A和B都加上了事务注解,方法A的传播性为REQUIRED,方法B为NOT_SUPPORTED。 具体执行过程: 如A的调用方没有开启事务,方法A开启事务,并执行insert,但没有提交。 方法A调用方法B时,方法B的传播性为NOT_SUPPORTED,不支持事务,然后挂起外层方法A的事务,方法B以非事务的方式执行insert。 方法B执行完毕后,恢复方法A的事务,最终提交事务。 调用链路过程: 3.5 NEVER 不支持事务 当外层方法A开启了事务,方法B抛出异常 例子: 以上代码,两个方法都打上了事务注解,方法A的传播性是REQUIRED,方法B的传播性是NEVER。 具体执行过程: 方法A开启事务,执行insert,没有提交。 含有事务的方法A调用方法B,方法B的传播性是NEVER,表示不支持事务,因此方法B抛出异常。 方法A的事务执行回滚。 3.6 MANDATORY 必须在事务中执行。 如果外层方法A没有开启事务,方法B抛出异常。 如果外层方法A开启了事务,方法B加入事务,方法A&B在同一事务中执行。 例子: 以上例子,方法A没有加事务注解,方法B 的传播性为 MANDATORY。 具体执行过程: 方法A的调用方如果本身没有开启事务,方法A执行前不会开启事务。 当非事务方法A调用方法B时,由于方法B的传播性为MANDATORY,必须在事务中执行,条件不满足,抛出异常。 3.7 NESTED 嵌套事务 如果外层方法A不存在事务,内层方法B的规则与REQUIRED 一致。 如果外层方法A存在事务,内层方法B做为外层方法A事务的子事务执行,两个方法是一起提交,但子事务是独立回滚。 内层方法B抛出异常,则会回滚方法B的所有操作,但不影响外层事务方法A。(方法A需要try-catch子事务,避免异常传递到父层事务) 外层方法A回滚,则内层方法B也会回滚。 该传播性的特点是可以保存状态点,当回滚时,只会回滚到某一个状态点,保证了子事务之间的独立性,避免嵌套事务的全局回滚。 例子: 以上例子,方法A的传播性为REQUIRED,方法B为NESTED。 具体执行过程: 方法A执行时,如调用方没有开启事务,则开启一个事务。 方法B被外层方法A调用时,因为方法B的传播性为NESTED,方法B在此处建立savepoint,标记insert行为。 当方法B抛出异常,其insert操作会回滚,但只会回滚到savepoint,(前提是方法A要try-catch方法B,使方法B的异常不会往外传递)。 方法B回滚后,方法A的事务提交。 调用链路: 四、总结 本文解释了Spring框架中的事务传播性,即多个业务方法之间调用时事务如何处理的规则。Spring提供了七种传播级别,如 PROPAGATION_REQUIRED、 PROPAGATION_REQUIRES_NEW等。 每种级别都有适用场景和限制,本文提供了一些示例,介绍了声明式事务如何使用,每种事务的规则,产生哪种行为,当方法抛出异常时,事务的提交和回滚是如何被处理的。正确处理事务对于任何企业级应用程序都是必要的,了解Spring事务传播性是构建高效、可靠和可扩展应用程序的关键。 END 猜你喜欢 vivo 数据库备份恢复系统演化 vivo 容器平台资源运营实践 前端 JS 安全对抗原理与实践 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 米哈游大数据云原生实践

作者:米哈游大数据开发 近年来,容器、微服务、Kubernetes 等各项云原生技术的日渐成熟,越来越多的公司开始选择拥抱云原生,并开始将 AI、大数据等类型的企业应用部署运行在云原生之上。以 Spark 为例,在云上运行 Spark 可以充分享有公共云的弹性资源、运维管控和存储服务等,并且业界也涌现了不少 Spark on Kubernetes 的优秀实践。 在刚刚结束的 2023 云栖大会上,米哈游数据平台组大数据技术专家杜安明分享了米哈游大数据架构向云原生化升级过程中的目标、探索和实践,以及如何通过以阿里云容器服务 ACK 为底座的 Spark on K8s 架构,获得在弹性计算、成本节约以及存算分离方面的价值。 背景简介 随着米哈游业务的高速发展,大数据离线数据存储量和计算任务量增长迅速,早期的大数据离线架构已不再满足新场景和需求。 为了解决原有架构缺乏弹性、运维复杂、资源利用率低等问题,2022 年下半年,我们着手调研将大数据基础架构云原生化,并最终在阿里云上落地了Spark on K8s + OSS-HDFS 方案,目前在生产环境上已稳定运行了一年左右的时间,并获得了弹性计算、成本节约以及存算分离这三大收益。 1. 弹性计算 由于游戏业务会进行周期版本更新、开启活动以及新游戏的上线等,对离线计算资源的需求与消耗波动巨大,可能是平时水位的几十上百倍。利用 K8s 集群天然的弹性能力,将 Spark 计算任务调度到 K8s 上运行,可以比较轻松的解决这类场景下资源消耗洪峰问题。 2. 成本节约 依托阿里云容器服务 Kubernetes 版 ACK 集群自身强大的弹性能力,所有计算资源按量申请、用完释放,再加上我们对 Spark 组件的定制改造,以及充分利用 ECI Spot 实例,在承载同等计算任务和资源消耗下,成本节约达 50%。 3. 存算分离 Spark 运行在 K8s 之上,完全使用 K8s 集群的计算资源,而访问的则数据也由 HDFS、OSS 逐步切换到 OSS-HDFS 上,中间 Shuffle 数据的读写采用 Celeborn,整套架构实现了计算和存储的解耦,易于维护和扩展。 Spark on K8s架构演进 众所周知,Spark 引擎可以支持并运行在多种资源管理器之上,比如 Yarn、K8s、Mesos 等。在大数据场景下,目前国内大多公司的 Spark 任务还是运行在 Yarn 集群之上的,Spark 在 2.3 版本首次支持 K8s,并于 2021 年 3 月发布的 Spark3.1 版本才正式 GA。 相较于 Yarn,Spark 在 K8s 上起步较晚,尽管在成熟度、稳定性等方面还存在一定的欠缺,但是 Spark on K8s 能够实现弹性计算以及成本节约等非常突出的收益,所以各大公司也都在不断进行尝试和探索,在此过程中,Spark on K8s 的运行架构也在不断的向前迭代演进。 1. 在离线混部 目前,将 Spark 任务运行在 K8s 上,大多公司采用的方案依旧是在线与离线混合部署的方式。架构设计依据的原理是,不同的业务系统会有不同的业务高峰时间。大数据离线业务系统典型任务高峰期间会是凌晨的0点到 9 点钟,而像是各种应用微服务、Web 提供的 BI 系统等,常见的业务高峰期是白天时间,在这个时间以外的其它时间中,可以将业务系统的机器 Node 加入到 Spark 所使用的 K8s NameSpace 中。如下图所示,将 Spark 与其他在线应用服务等都部署在一套 K8s 集群之上。 该架构的优点是可以通过在离线业务的混合部署和错峰运行,来提升机器资源利用率并降低成本,但是缺点也比较明显,即架构实施起来复杂,维护成本比较高,而且难以做到严格的资源隔离,尤其是网络层面的隔离,业务之间不可避免的会产生一定的相互影响,此外,我们认为该方式也不符合云原生的理念和未来发展趋势。 2. SparkonK8s+OSS-HDFS 考虑到在离线混合部署的弊端,我们设计采用了一种新的、也更加符合云原生的实现架构:底层存储采用 OSS-HDFS(JindoFs),计算集群采用阿里云的容器服务 ACK,Spark 选择功能相对丰富且比较稳定的 3.2.3 版本。 OSS-HDFS 完全兼容了 HDFS 协议,除了具备 OSS 无限容量、支持数据冷热存储等优点以外,还支持了目录原子性、毫秒级 rename 操作,非常适用于离线数仓,可以很好的平替现有 HDFS 和 OSS。 阿里云 ACK 集群提供了高性能、可伸缩的容器应用管理服务,可以支持企业级 Kubernetes 容器化应用的生命周期管理,ECS 是大家所熟知的阿里云服务器,而弹性容器实例 ECI 是一种 Serverless 容器运行服务,可以按量秒级申请与释放。 该架构简单易维护,底层利用 ECI 的弹性能力,Spark 任务可以较为轻松的应对高峰流量,将 Spark 的 Executor 调度在 ECI 节点上运行,可最大程度的实现计算任务弹性与最佳的降本效果,整体架构的示意图如下所示。 云原生架构设计与实现 1. 基本原理 在阐述具体实现之前,先简要介绍一下 Spark 在 K8s 上运行的基本原理。Pod 在 K8s 中是最小的调度单元,Spark 任务的 Driver 和 Executor 都是一个单独 Pod,每个 Pod 都分配了唯一的 IP 地址,Pod 可以包含一个或多个 Container,无论是 Driver 还是 Executor 的 JVM 进程,都是在 Container 中进行启动、运行与销毁的。 一个 Spark 任务被提交到 K8s 集群之后,首先启动的是 Driver Pod,而后 Driver 会向 Apiserver 按需申请 Executor,并由 Executor 去执行具体的 Task,作业完成之后由 Driver 负责清理所有的 Executor Pod,以下是这几者关系的简要示意图。 2. 执行流程 下图展示了完整的作业执行流程,用户在完成 Spark 作业开发后,会将任务发布到调度系统上并进行相关运行参数的配置,调度系统定时将任务提交到自研的 Launcher 中间件,并由中间件来调用 spark-k8s-cli,最终由 Cli 将任务提交至 K8s 集群上。任务提交成功之后,Spark Driver Pod 最先启动,并向集群申请分配 Executor Pod,Executor 在运行具体的 Task 时,会与外部 Hive、Iceberg、OLAP 数据库、OSS-HDFS 等诸多大数据组件进行数据的访问与交互,而 Spark Executor 之间的数据 Shuffle 则由 CeleBorn 来实现。 3. 任务提交 关于如何将 Spark 任务提交到 K8s 集群上,各个公司的做法不尽相同,下面先简要描述下目前比较常规的做法,然后再介绍目前我们线上所使用的任务提交和管理方式。 3.1 使用原生 spark-submit 通过 spark-submit 命令直接提交,Spark 原生就支持这种方式,集成起来比较简单,也符合用户的习惯,但是不方便进行作业状态跟踪和管理,无法自动配置 Spark UI 的 Service 和 Ingress,任务结束后也无法自动清理资源等,在生产环境中并不适合。 3.2 使用 spark-on-k8s-operator 这是目前较常用的一种提交作业方式,K8s 集群需要事先安装 spark-operator,客户端通过 kubectl 提交 yaml 文件来运行 Spark 作业。本质上这是对原生方式的扩展,最终提交作业依然是使用 spark-submit 方式,扩展的功能包括:作业管理,Service/Ingress 创建与清理,任务监控,Pod 增强等。此种方式可在生产环境中使用,但与大数据调度平台集成性不太好,对于不熟悉 K8s 的用户来说,使用起来复杂度和上手门槛相对较高。 3.3 使用 spark-k8s-cli 在生产环境上,我们采用 spark-k8s-cli 的方式进行任务的提交。spark-k8s-cli 本质上是一个可执行的文件,基于阿里云 emr-spark-ack 提交工具我们进行了重构、功能增强和深度的定制。 spark-k8s-cli 融合 spark-submit 和 spark-operator 两种作业提交方式的优点,使得所有作业都能通过 spark-operator 管理,支持运行交互式 spark-shell 和本地依赖的提交,并且在使用方式上与原生 spark-submit 语法完全一致。 在上线使用初期,我们所有任务的 Spark Submit JVM 进程都启动在 Gateway Pod 中,在使用一段时间后,发现该方式稳定性不足,一旦 Gateway Pod 异常,其上的所有正在 Spark 任务都将失败,另外 Spark 任务的日志输出也不好管理。鉴于此种情况,我们将 spark-k8s-cli 改成了每个任务使用单独一个 Submit Pod 的方式,由 Submit Pod 来申请启动任务的 Driver,Submit Pod 和 Driver Pod 一样都运行在固定的 ECS 节点之上,Submit Pod 之间完全独立,任务结束后 Submit Pod 也会自动释放。spark-k8s-cli 的提交和运行原理如下图所示。 关于 spark-k8s-cli,除了上述基本的任务提交以外,我们还做了其他一些增强和定制化的功能。 支持提交任务到同地域多个不同的 K8s 集群上,实现集群之间的负载均衡和故障转移切换 实现类似 Yarn 资源不足时的自动排队等待功能(K8s 如果设置了资源 Quota,当 Quota 达到上限后,任务会直接失败) 增加与 K8s 网络通信等异常处理、创建或启动失败重试等,对偶发的集群抖动、网络异常进行容错 支持按照不同部门或业务线,对大规模补数任务进行限流和管控功能 内嵌任务提交失败、容器创建或启动失败以及运行超时等告警功能 4. 日志采集与展示 K8s 集群本身并没有像 Yarn 那样提供日志自动聚合和展示的功能,Driver 和 Executor 的日志收集需要用户自己来完成。目前比较常见的方案是在各个 K8s Node上部署 Agent,通过 Agent 把日志采集并落在第三方存储上,比如 ES、SLS 等,但这些方式对于习惯了在 Yarn 页面上点击查看日志的用户和开发者来说,使用起来很不方便,用户不得不跳转到第三方系统上捞取查看日志。 为实现 K8s Spark 任务日志的便捷查看,我们对 Spark 代码进行了改造,使 Driver 和 Executor 日志最终都输出到 OSS 上,用户可以在 Spark UI 和 Spark Jobhistory 上,直接点击查看日志文件。 上图所示为日志的收集和展示原理,Spark 任务在启动时,Driver 和 Executor 都会首先注册一个 Shutdown Hook,当任务结束 JVM 退出时,调用 Hook 方法把完整的日志上传到 OSS 上。此外,想要完整查看日志,还需要对 Spark 的 Job History 相关代码做下改造,需要在 History 页面显示 stdout 和 stderr,并在点击日志时,从 OSS 上拉取对应 Driver 或 Executor 的日志文件,最终由浏览器渲染查看。另外,对于正在运行中的任务,我们会提供一个 Spark Running Web UI 给用户,任务提交成功后,spark-operator会自动生成的 Service 和 Ingress 供用户查看运行详情,此时日志的获取通过访问 K8s 的 api 拉取对应 Pod 的运行日志即可。 5. 弹性与降本 基于 ACK 集群提供的弹性伸缩能力,再加上对 ECI 的充分利用,同等规模量级下的Spark 任务,运行在 K8s 的总成本要明显低于在 Yarn 固定集群上,同时也大大提高了资源利用率。 弹性容器实例 ECI 是一种 Serverless 容器运行服务,ECI 和 ECS 最大的不同就在于 ECI 是按量秒级计费的,申请与释放速度也是秒级的,所以 ECI 很适合 Spark 这一类负载峰谷明显的计算场景。 上图示意了 Spark 任务在 ACK 集群上如何申请和使用 ECI,使用前提是在集群中安装 ack-virtual-node 组件,并配置好 Vswitch 等信息,在任务运行时,Executor 被调度到虚拟节点上,并由虚拟节点申请创建和管理 ECI。 ECI 分为普通实例和抢占式实例,抢占式实例是一种低成本竞价型实例,默认有 1 小时的保护期,适用于大部分 Spark 批处理场景,超出保护期后,抢占式实例可能被强制回收。为进一步提升降本效果,充分利用抢占式实例的价格优势,我们对 Spark 进行改造,实现了 ECI 实例类型自动转换的功能。Spark 任务的 Executor Pod 都优先运行在抢占式 ECI 实例上,当发生库存不足或其他原因无法申请创建抢占式实例,则自动切换为使用普通 ECI 实例,保证任务的正常运行。具体实现原理和转换逻辑如下图所示。 6. Celeborn 由于 K8s 节点的磁盘容量很小,而且节点都是用时申请、用完释放的,无法保存大量的 Spark Shuffle 数据。如果对 Executor Pod 挂载云盘,挂载盘的大小难以确定,考虑到数据倾斜等因素,磁盘的使用率也会比较低,使用起来比较复杂。此外,虽然 Spark 社区在 3.2 提供了 Reuse PVC 等功能,但是调研下来觉得功能尚不完备且稳定性不足。 为解决 Spark 在 K8s 上数据 Shuffle 的问题,在充分调研和对比多家开源产品后,最终采用了阿里开源的 Celeborn 方案。Celeborn 是一个独立的服务,专门用于保存 Spark 的中间 Shuffle 数据,让 Executor 不再依赖本地盘,该服务 K8s 和 Yarn 均可以使用。Celeborn 采用了 Push Shuffle 的模式,Shuffle 过程为追加写、顺序读,提升数据读写性能和效率。 基于开源的 Celeborn 项目,我们内部也做了一些数据网络传输方面的功能增强、Metrics 丰富、监控告警完善、Bug 修复等工作,目前已形成了内部稳定版本。 7. KyuubionK8s Kyuubi 是一个分布式和多租户的网关,可以为 Spark、Flink 或 Trino 等提供 SQL 等查询服务。在早期,我们的 Spark Adhoc 查询是发送到 Kyuubi 上执行的。为了解决 Yarn 队列资源不足,用户的查询 SQL 无法提交和运行的问题,在 K8s 上我们也支持了 Kyuubi Server 的部署运行,当Yarn资源不足时,Spark 查询自动切换到 K8s 上运行。鉴于 Yarn 集群规模逐渐缩减,查询资源无法保证,以及保障相同的用户查询体验,目前我们已将所有的 SparkSQL Adhoc 查询提交到 K8s 上执行。 为了让用户的 Adhoc 查询也能在 K8s 上畅快运行,我们对 Kyuubi 也做了一些源码改造,包括对 Kyuubi 项目中 docker-image-tool.sh、Deployment.yaml、Dockfile 文件的改写,重定向 Log 到 OSS 上,Spark Operator 管理支持、权限控制、便捷查看任务运行 UI 等。 8. K8sManager 在 Spark on K8s 场景下,尽管 K8s 有集群层面的监控告警,但是还不能完全满足我们的需求。在生产环境中,我们更加关注的是在集群上的 Spark 任务、Pod 状态、资源消耗以及 ECI 等运行情况。利用 K8s 的 Watch 机制,我们实现了自己的监控告警服务 K8s Manager,下图所示为该服务的示意图。 K8sManager 是内部实现的一个比较轻量的 Spring Boot 服务,实现的功能就是对各个 K8s 集群上的 Pod、Quota、Service、ConfigMap、Ingress、Role 等各类资源信息监听和汇总处理,从而生成自定义的 Metrics 指标,并对指标进行展示和异常告警,其中包括集群 CPU 与 Memory 总使用量、当前运行的 Spark 任务数、Spark 任务内存资源消耗与运行时长 Top 统计、单日 Spark 任务量汇总、集群 Pod 总数、Pod 状态统计、ECI 机器型号与可用区分布统计、过期资源监控等等,这里就不一一列举了。 9. 其他工作 9.1 调度任务自动切换 在我们的调度系统中,Spark 任务支持配置 Yarn、K8s、Auto 三种执行策略。如果用户任务指明了需要运行使用的资源管理器,则任务只会在 Yarn 或 K8s 上运行,若用户选择了 Auto,则任务具体在哪里执行,取决于当前 Yarn 队列的资源使用率,如下图所示。由于总任务量较大,且 Hive 任务也在不断迁移至 Spark,目前仍然有部分任务运行在 Yarn 集群上,但最终的形态所有任务将由 K8s 来托管。 9.2 多可用区、多交换机支持 Spark 任务运行过程中大量使用 ECI,ECI 创建成功有两个前提条件: 1、能够申请到 IP 地址;2、当前可用区有库存。实际上,单个交换机提供的可用IP数量有限,单个可用区拥有的抢占式实例的总个数也是有限的,因此在实际生产环境中,无论是使用普通 ECI 还是 Spot 类型的 ECI,比较好的实践方式是配置支持多可用区、多交换机。 9.3 成本计算 由于在 Spark 任务提交时,都已明确指定了每个 Executor 的 Cpu、Memory 等型号信息,在任务结束 SparkContxt 关闭之前,我们可以从任务的中拿到每个 Executor 的实际运行时长,再结合单价,即可计算出 Spark 任务的大致花费。由于 ECI Spot 实例是随着市场和库存量随时变动的,该方式计算出来的单任务成本是一个上限值,主要用于反映趋势。 9.4 优化 SparkOperator 在上线初期任务量较少时,Spark Operator 服务运行良好,但随着任务不断增多,Operator 处理各类Event事件的速度越来越慢,甚至集群出现大量的 ConfigMap、Ingress、Service 等任务运行过程中产生的资源无法及时清理导致堆积的情况,新提交 Spark 任务的 Web UI 也无法打开访问。发现问题后,我们调整了 Operator 的协程数量,并实现对 Pod Event 的批量处理、无关事件的过滤、TTL 删除等功能,解决了 Spark Operator 性能不足的问题。 9.5 升级 SparkK8sClient Spark3.2.2 采用 fabric8(Kubernetes Java Client)来访问和操作 K8s 集群中的资源,默认客户端版本为 5.4.1,在此版本中,当任务结束 Executor 集中释放时,Driver 会大量发送 Delete Pod 的 Api 请求到 K8s Apiserver 上,对集群 Apiserver 和 ETCD 造成较大的压力,Apiserver 的 cpu 会瞬间飙高。 目前我们的内部 Spark 版本,已将 kubernetes-client 升级到 6.2.0,支持 pod 的批量删除,解决 Spark 任务集中释放时,由大量的删除 Api 请求操作的集群抖动。 问题与解决方案 在整个 Spark on K8s 的方案设计以及实施过程中,我们也遇到了各种各样的问题、瓶颈和挑战,这里做下简单的介绍,并给出我们的解决方案。 1.弹性网卡释放慢 弹性网卡释放速度慢的问题,属于 ECI 大规模应用场景下的性能瓶颈,该问题会导致交换机上 IP 的剧烈消耗,最终导致 Spark 任务卡住或提交失败,具体触发原因如下图所示。目前阿里云团队已通过技术升级改造解决,并大幅提升了释放速度和整体性能。 2.Watcher 失效 Spark 任务在启动 Driver 时,会创建对 Executor 的事件监听器,用于实时获取所有 Executor 的运行状态,对于一些长时运行的 Spark 任务,这个监听器往往会由于资源过期、网络异常等情况而失效,因此在此情况下,需要对 Watcher 进行重置,否则任务可能会跑飞。该问题属于 Spark 的一个 Bug,当前我们内部版本已修复,并将 PR 提供到了 Spark 社区。 3.任务卡死 如上图所示,Driver 通过 List 和 Watch 两种方式来获取 Executor 的运行状况。Watch 采用被动监听机制,但是由于网络等问题可能会发生事件漏接收或漏处理,但这种概率比较低。List 采用主动请求的方式,比如每隔 3 分钟,Driver 可向 Apiserver 请求一次自己任务当前全量 Executor 的信息。 由于 List 请求任务所有 Pod 信息,当任务较多时,频繁 List 对 K8s 的 Apiserver 和 ETCD 造成较大压力,早期我们关闭了定时 List,只使用 Watch。当 Spark 任务运行异常,比如有很多 Executor OOM 了,有一定概率会导致 Driver Watch 的信息错误,尽管 Task 还没有运行完,但是 Driver 却不再申请 Executor 去执行任务,发生任务卡死。对此我们的解决方案如下: 在开启 Watch 机制的同时,也开启 List 机制,并将 List 时间间隔拉长,设置每 5 分钟请求一次 修改 ExecutorPodsPollingSnapshotSource 相关代码,允许 Apiserver 服务端缓存,从缓存中获取全量 Pod 信息,降低 List 对集群的压力 4. Celeborn 读写超时、失败 ApacheCeleborn 是阿里开源的一款产品,前身为 RSS(Remote Shuffle Service)。在早期成熟度上还略有欠缺,在对网络延迟、丢包异常处理等方面处理的不够完善,导致线上出现一些有大量 Shuffle 数据的 Spark 任务运行时间很长、甚至任务失败,以下三点是我们针对此问题的解决办法。 优化 Celeborn,形成内部版本,完善网络包传输方面的代码 调优 CelebornMaster 和 Worker 相关参数,提升 Shuffle 数据的读写性能 升级 ECI 底层镜像版本,修复 ECILinux 内核 Bug 5. 批量提交任务时,Quota 锁冲突 为了防止资源被无限使用,我们对每个 K8s 集群都设置了 Quota 上限。在 K8s 中,Quota 也是一种资源,每一个 Pod 的申请与释放都会修改 Quota 的内容(Cpu/Memory 值),当很多任务并发提交时,可能会发生 Quota 锁冲突,从而影响任务 Driver 的创建,任务启动失败。 应对这种情况导致的任务启动失败,我们修改 Spark Driver Pod 的创建逻辑,增加可配置的重试参数,当检测到 Driver Pod 创建是由于 Quota 锁冲突引起时,进行重试创建。Executor Pod 的创建也可能会由于 Quota 锁冲突而失败,这种情况可以不用处理,Executor 创建失败 Driver 会自动申请创建新的,相当于是自动重试了。 6.批量提交任务时,UnknownHost 报错 当瞬时批量提交大量任务到集群时,多个 Submit Pod 会同时启动,并向 Terway 组件申请 IP 同时绑定弹性网卡,存在一定概率出现以下情况,即 Pod 已经启动了,弹性网卡也绑定成功但是实际并没有完全就绪,此时该 Pod 的网络通信功能实际还无法正常使用,任务访问 Core DNS 时,请求无法发出去,Spark 任务报错 UnknownHost 并运行失败。该问题我们通过下面这两个措施进行规避和解决: 为每台 ECS 节点,都分配一个 TerwayPod 开启 Terway 的缓存功能,提前分配好 IP 和弹性网卡,新 Pod 来的直接从缓存池中获取,用完之后归还到缓存池中 7. 可用区之间网络丢包 为保障库存的充足,各 K8s 集群都配置了多可用区,但跨可用区的网络通信要比同可用区之间通信的稳定性略差,即可用区之间就存在一定概率的丢包,表现为任务运行时长不稳定。 对于跨可用区存在网络丢包的现象,可尝试将 ECI 的调度策略设定为 VSwitchOrdered,这样一个任务的所有 Executor 基本都在一个可用区,避免了不同可以区 Executor 之间的通信异常,导致的任务运行时间不稳定的问题。 总结与展望 最后,非常感谢阿里云容器、ECI、EMR 等相关团队的同学,在我们整个技术方案的落地与实际迁移过程中,给予了非常多的宝贵建议和专业的技术支持。 目前新的云原生架构已在生产环境上稳定运行了近一年左右的时间,在未来,我们将持续对整体架构进行优化和提升,主要围绕以下几个方面: 持续优化云原生的整体方案,进一步提升系统承载与容灾能力 云原生架构升级,更多大数据组件容器化,让整体架构更加彻底的云原生化 更加细粒度的资源管理和精准的成本控制

优秀的个人博客,低调大师

每日一博 | JDK 21 虚拟线程原理及性能分析

一、背景 JDK21 在 9 月 19 号正式发布,带来了较多亮点,其中虚拟线程备受瞩目,毫不夸张的说,它改变了高吞吐代码的编写方式,只需要小小的变动就可以让目前的 IO 密集型程序的吞吐量得到提升,写出高吞吐量的代码不再困难。 本文将详细介绍虚拟线程的使用场景,实现原理以及在 IO 密集型服务下的性能压测效果。 二、为了提升吞吐性能,我们所做的优化 在讲虚拟线程之前,我们先聊聊为了提高吞吐性能,我们所做的一些优化方案。 串行模式 在当前的微服务架构下,处理一次用户/上游的请求,往往需要多次调用下游服务、数据库、文件系统等,再将所有请求的数据进行处理最终的结果返回给上游。在这种模式下,使用串行模式去查询数据库,下游 Dubbo/Http 接口,文件系统完成一次请求,接口整体的耗时等于各个下游的返回时间之和,这种写法虽然简单,但是接口耗时长、性能差,无法满足 C 端高 QPS 场景下的性能要求。 线程池+Future异步调用 为了解决串行调用的低性能问题,我们会考虑使用并行异步调用的方式,最简单的方式便是使用线程池 +Future 去并行调用。典型代码如下:这种方式虽然解决了大部分场景下的串行调用低性能问题,但是也存在着严重的弊端,由于存在 Future 的前后依赖关系,当使用场景存在大量的前后依赖时,会使得线程资源和 CPU 大量浪费在阻塞等待上,导致资源利用率低。 线程池+CompletableFuture异步调用 为了降低 CPU 的阻塞等待时间和提升资源的利用率,我们会使用CompletableFuture对调用流程进行编排,降低依赖之间的阻塞。 CompletableFuture 是由 Java8 引入的,在 Java8 之前一般通过 Future 实现异步。Future 用于表示异步计算的结果,如果存在流程之间的依赖关系,那么只能通过阻塞或者轮询的方式获取结果,同时原生的 Future 不支持设置回调方法,Java8 之前若要设置回调可以使用 Guava 的 ListenableFuture,回调的引入又会导致回调地狱,代码基本不具备可读性。 而 CompletableFuture 是对 Future 的扩展,原生支持通过设置回调的方式处理计算结果,同时也支持组合编排操作,一定程度解决了回调地狱的问题。 使用 CompletableFuture 的实现方式如下:CompletableFuture 虽然一定程度上面缓解了 CPU 资源大量浪费在阻塞等待上的问题,但是只是缓解,核心的问题始终没有解决。这两个问题导致 CPU 无法充分被利用,系统吞吐量容易达到瓶颈。 线程资源浪费瓶颈始终在 IO 等待上,导致 CPU 资源利用率较低。目前大部分服务是 IO 密集型服务,一次请求的处理耗时大部分都消耗在等待下游 RPC,数据库查询的 IO 等待中,此时线程仍然只能阻塞等待结果返回,导致 CPU 的利用率很低。 线程数量存在限制,为了增加并发度,我们会给线程池配置更大的线程数,但是线程的数量是有限制的,Java 的线程模型是 1:1 映射平台线程的,导致 Java 线程创建的成本很高,不能无限增加。同时随着 CPU 调度线程数的增加,会导致更严重的资源争用,宝贵的 CPU 资源被损耗在上下文切换上。 三、一请求一线程的模型 在给出最终解决方案之前,我们先聊一聊 Web 应用中常见的一请求一线程的模型。 在 Web 中我们最常见的请求模型就是使用一请求一线程的模型,每个请求都由单独的线程处理。此模型易于理解和实现,对编码的可读性,Debug 都非常友好,但是,它有一些缺点。当线程执行阻塞操作(如连接到数据库或进行网络调用)时,线程会被阻塞,直到操作完成,这意味着线程在此期间将无法处理任何其他请求。当遇到大促或突发流量等场景导致服务承受的请求数增大时,为了保证每个请求在尽可能短的时间内返回,减少等待时间,我们经常会采用以下方案: 扩大服务最大线程数,简单有效,由于存在下列问题,导致平台线程有最大数量限制,不能大量扩充。 系统资源有限导致系统线程总量有限,进而导致与系统线程一一对应的平台线程有限。 平台线程的调度依赖于系统的线程调度程序,当平台线程创建过多,会消耗大量资源用于处理线程上下文切换。 每个平台线程都会开辟一块大小约 1m 私有的栈空间,大量平台线程会占据大量内存。 垂直扩展,升级机器配置,水平扩展,增加服务节点,也就是俗称的升配扩容大法,效果好,也是最常见的方案,缺点是会增加成本,同时有些场景下扩容并不能 100% 解决问题。 采用异步/响应式编程方案,例如 RPC NIO 异步调用,WebFlux,Rx-Java 等非阻塞的基于 Ractor 模型的框架,使用事件驱动使得少量线程即可实现高吞吐的请求处理,拥有较好的性能与优秀的资源利用,缺点是学习成本较高兼容性问题较大,编码风格与目前的一请求一线程的模型差异较大,理解难度大,同时对于代码的调试比较困难。 那么有没有一种方法可以易于编写,方便迁移,符合日常编码习惯,同时性能很不错,CPU 资源利用率较高的方案呢? JDK21 中的虚拟线程可能给出了答案, JDK 提供了与 Thread 完全一致的抽象 Virtual Thread 来应对这种经常阻塞的情况,阻塞仍然是会阻塞,但是换了阻塞的对象,由昂贵的平台线程阻塞改为了成本很低的虚拟线程的阻塞,当代码调用到阻塞 API 例如 IO,同步,Sleep 等操作时,JVM 会自动把Virtual Thread 从平台线程上卸载,平台线程就会去处理下一个虚拟线程,通过这种方式,提升了平台线程的利用率,让平台线程不再阻塞在等待上,从底层实现了少量平台线程就可以处理大量请求,提高了服务吞吐和 CPU 的利用率。 四、虚拟线程 线程术语定义 操作系统线程(OS Thread):由操作系统管理,是操作系统调度的基本单位。 平台线程(Platform Thread):Java.Lang.Thread 类的每个实例,都是一个平台线程,是 Java 对操作系统线程的包装,与操作系统是 1:1 映射。 虚拟线程(Virtual Thread):一种轻量级,由 JVM 管理的线程。对应的实例 java.lang.VirtualThread 这个类。 载体线程(Carrier Thread):指真正负责执行虚拟线程中任务的平台线程。一个虚拟线程装载到一个平台线程之后,那么这个平台线程就被称为虚拟线程的载体线程。 虚拟线程定义 JDK 中 java.lang.Thread 的每个实例都是一个平台线程。平台线程在底层操作系统线程上运行 Java 代码,并在代码的整个生命周期内独占操作系统线程,平台线程实例本质是由系统内核的线程调度程序进行调度,并且平台线程的数量受限于操作系统线程的数量。 而虚拟线程(Virtual Thread)它不与特定的操作系统线程相绑定。它在平台线程上运行 Java 代码,但在代码的整个生命周期内不独占平台线程。**这意味着许多虚拟线程可以在同一个平台线程上运行他们的 Java 代码,共享同一个平台线程。**同时虚拟线程的成本很低,虚拟线程的数量可以比平台线程的数量大得多。 虚拟线程创建 方法一:直接创建虚拟线程 Thread vt = Thread.startVirtualThread(() -> { System.out.println("hello wolrd virtual thread"); }); 方法二:创建虚拟线程但不自动运行,手动调用start()开始运行 Thread.ofVirtual().unstarted(() -> { System.out.println("hello wolrd virtual thread"); }); vt.start(); 方法三:通过虚拟线程的 ThreadFactory 创建虚拟线程 ThreadFactory tf = Thread.ofVirtual().factory(); Thread vt = tf.newThread(() -> { System.out.println("Start virtual thread..."); Thread.sleep(1000); System.out.println("End virtual thread. "); }); vt.start(); 方法四:Executors.newVirtualThreadPer-TaskExecutor() ExecutorService executor = Executors.newVirtualThreadPerTaskExecutor(); executor.submit(() -> { System.out.println("Start virtual thread..."); Thread.sleep(1000); System.out.println("End virtual thread."); return true; }); 虚拟线程实现原理 虚拟线程是由 Java 虚拟机调度,而不是操作系统。虚拟线程占用空间小,同时使用轻量级的任务队列来调度虚拟线程,避免了线程间基于内核的上下文切换开销,因此可以极大量地创建和使用。 简单来看,虚拟线程实现如下:virtual thread =continuation+scheduler+runnable 虚拟线程会把任务(java.lang.Runnable实例)包装到一个 Continuation 实例中: 当任务需要阻塞挂起的时候,会调用 Continuation 的 yield 操作进行阻塞,虚拟线程会从平台线程卸载。 当任务解除阻塞继续执行的时候,调用 Continuation.run 会从阻塞点继续执行。 Scheduler 也就是执行器,由它将任务提交到具体的载体线程池中执行。 它是 java.util.concurrent.Executor 的子类。 虚拟线程框架提供了一个默认的 FIFO 的 ForkJoinPool 用于执行虚拟线程任务。 Runnable 则是真正的任务包装器,由 Scheduler 负责提交到载体线程池中执行。 JVM 把虚拟线程分配给平台线程的操作称为 mount(挂载),取消分配平台线程的操作称为 unmount(卸载): mount 操作:虚拟线程挂载到平台线程,虚拟线程中包装的 Continuation 堆栈帧数据会被拷贝到平台线程的线程栈,这是一个从堆复制到栈的过程。 unmount 操作:虚拟线程从平台线程卸载,此时虚拟线程的任务还没有执行完成,所以虚拟线程中包装的 Continuation 栈数据帧会会留在堆内存中。 从 Java 代码的角度来看,其实是看不到虚拟线程及载体线程共享操作系统线程的,会认为虚拟线程及其载体都在同一个线程上运行,因此,在同一虚拟线程上多次调用的代码可能会在每次调用时挂载的载体线程都不一样。JDK 中使用了FIFO 模式的 ForkJoinPool 作为虚拟线程的调度器,从这个调度器看虚拟线程任务的执行流程大致如下: 调度器(线程池)中的平台线程等待处理任务。 一个虚拟线程被分配平台线程,该平台线程作为载体线程执行虚拟线程中的任务。 虚拟线程运行其 Continuation,Mount(挂载)平台线程后,最终执行 Runnable 包装的用户实际任务。 虚拟线程任务执行完成,标记 Continuation 终结,标记虚拟线程为终结状态,清空上下文,等待 GC 回收,解除挂载载体线程会返还到调度器(线程池)中等待处理下一个任务。 上面是没有阻塞场景的虚拟线程任务执行情况,如果遇到了阻塞(例如 Lock 等)场景,会触发 Continuation 的 yield 操作让出控制权,等待虚拟线程重新分配载体线程并且执行,具体见下面的代码: ReentrantLock lock = new ReentrantLock(); Thread.startVirtualThread(() -> { lock.lock(); }); // 确保锁已经被上面的虚拟线程持有 Thread.sleep(1000); Thread.startVirtualThread(() -> { System.out.println("first"); 会触发Continuation的yield操作 lock.lock(); try { System.out.println("second"); } finally { lock.unlock(); } System.out.println("third"); }); Thread.sleep(Long.MAX_VALUE); } 虚拟线程中任务执行时候调用 Continuation#run()先执行了部分任务代码,然后尝试获取锁,该操作是阻塞操作会导致 Continuation 的 yield 操作让出控制权,如果 yield 操作成功,会从载体线程 unmount,载体线程栈数据会移动到 Continuation 栈的数据帧中,保存在堆内存中,虚拟线程任务完成,此时虚拟线程和 Continuation 还没有终结和释放,载体线程被释放到执行器中等待新的任务;如果 Continuation 的 yield 操作失败,则会对载体线程进行 Park 调用,阻塞在载体线程上,此时虚拟线程和载体线程同时会被阻塞,本地方法,Synchronized 修饰的同步方法都会导致 yield 失败。 当锁持有者释放锁之后,会唤醒虚拟线程获取锁,获取锁成功后,虚拟线程会重新进行 mount,让虚拟线程任务再次执行,此时有可能是分配到另一个载体线程中执行,Continuation 栈会的数据帧会被恢复到载体线程栈中,然后再次调用Continuation#run() 恢复任务执行。 虚拟线程任务执行完成,标记 Continuation 终结,标记虚拟线程为终结状态,清空上下文变量,解除载体线程的挂载载体线程返还到调度器(线程池)中作为平台线程等待处理下一个任务。 Continuation 组件十分重要,它既是用户真实任务的包装器,同时提供了虚拟线程任务暂停/继续的能力,以及虚拟线程与平台线程数据转移功能,当任务需要阻塞挂起的时候,调用 Continuation 的 yield 操作进行阻塞。当任务需要解除阻塞继续执行的时候,则调用 Continuation 的 run 恢复执行。 通过下面的代码可以看出 Continuation 的神奇之处,通过在编译参数加上--add-exports java.base/jdk.internal.vm=ALL-UNNAMED 可以在本地运行。 ContinuationScope scope = new ContinuationScope("scope"); Continuation continuation = new Continuation(scope, () -> { System.out.println("before yield开始"); Continuation.yield(scope); System.out.println("after yield 结束"); }); System.out.println("1 run"); // 第一次执行Continuation.run continuation.run(); System.out.println("2 run"); // 第二次执行Continuation.run continuation.run(); System.out.println("Done"); 通过上述案例可以看出,Continuation 实例进行 yield 调用后,再次调用其 run 方法就可以从 yield 的调用之处继续往下执行,从而实现了程序的中断和恢复。 虚拟线程内存占用评估 单个平台线程的资源占用: 根据 JVM 规范,预留 1 MB 线程栈空间。 平台线程实例,会占据 2000+ byte 数据。 单个虚拟线程的资源占用: Continuation 栈会占用数百 byte 到数百 KB 内存空间,是作为堆栈块对象存储在 Java 堆中。 虚拟线程实例会占据 200 - 240 byte 数据。 从对比结果来看,理论上单个平台线程占用的内存空间至少是 KB 级别的,而单个虚拟线程实例占用的内存空间是 byte 级别,两者的内存占用差距较大,这也是虚拟线程可以大批量创建的原因。 下面通过一段程序去测试平台线程和虚拟线程的内存占用: private static final int COUNT = 4000; /** * -XX:NativeMemoryTracking=detail * * @param args args */ public static void main(String[] args) throws Exception { for (int i = 0; i < COUNT; i++) { new Thread(() -> { try { Thread.sleep(Long.MAX_VALUE); } catch (Exception e) { e.printStackTrace(); } }, String.valueOf(i)).start(); } Thread.sleep(Long.MAX_VALUE); } 上面的程序运行后启动 4000 平台线程,通过 -XX:NativeMemoryTracking=detail 参数和 JCMD 命令查看所有线程占据的内存空间如下:内存占用大部分来自创建的平台线程,总线程栈空间占用约为 8096 MB,两者加起来占据总使用内存(8403MB)的 96% 以上。 用类似的方式编写运行虚拟线程的程序: private static final int COUNT = 4000; /** * -XX:NativeMemoryTracking=detail * * @param args args */ public static void main(String[] args) throws Exception { for (int i = 0; i < COUNT; i++) { Thread.startVirtualThread(() -> { try { Thread.sleep(Long.MAX_VALUE); } catch (Exception e) { e.printStackTrace(); } }); } Thread.sleep(Long.MAX_VALUE); } 上面的程序运行后启动 4000 虚拟线程:堆内存的实际占用量和总内存的实际占用量都不超过 300 MB,可以证明虚拟线程在大量创建的前提下也不会去占用过多的内存,且虚拟线程的堆栈是作为堆栈块对象存储在 Java 的堆中的,可以被 GC 回收,又降低了虚拟线程的占用。 虚拟线程的局限及使用建议 虚拟线程存在 native 方法或者外部方法 (Foreign Function & Memory API,jep 424 ) 调用不能进行 yield 操作,此时载体线程会被阻塞。 当运行在 synchronized 修饰的代码块或者方法时,不能进行 yield 操作,此时载体线程会被阻塞,推荐使用 ReentrantLock。 ThreadLocal 相关问题,目前虚拟线程仍然是支持 ThreadLocal 的,但是由于虚拟线程的数量非常多,会导致 Threadlocal 中存的线程变量非常多,需要频繁 GC 去清理,对性能会有影响,官方建议尽量少使用 ThreadLocal,同时不要在虚拟线程的 ThreadLocal 中放大对象,目前官方是想通过 ScopedLocal 去替换掉 ThreadLocal,但是在 21 版本还没有正式发布,这个可能是大规模使用虚拟线程的一大难题。 无需池化虚拟线程虚拟线程占用的资源很少,因此可以大量地创建而无须考虑池化,它不需要跟平台线程池一样,平台线程的创建成本比较昂贵,所以通常选择去池化,去做共享,但是池化操作本身会引入额外开销,对于虚拟线程池化反而是得不偿失,使用虚拟线程我们抛弃池化的思维,用时创建,用完就扔。 虚拟线程适用场景 大量的 IO 阻塞等待任务,例如下游 RPC 调用,DB 查询等。 大批量的处理时间较短的计算任务。 Thread-per-request (一请求一线程)风格的应用程序,例如主流的 Tomcat 线程模型或者基于类似线程模型实现的 SpringMVC 框架 ,这些应用只需要小小的改动就可以带来巨大的吞吐提升。 五、虚拟线程压测性能分析 在下面的测试中,我们将模拟最常使用的场景-使用 Web 容器去处理 Http 请求。 场景一:在 Spring Boot 中使用内嵌的 Tomcat 去处理 Http 请求,使用默认的平台线程池作为 Tomcat 的请求处理线程池。 场景二:使用Spring -WebFlux创建基于事件循环模型的应用程序,进行响应式请求处理。 场景三:在 Spring Boot 中使用内嵌的 Tomcat 去处理 Http 请求,使用虚拟线程池作为 Tomcat 的请求处理线程池(Tomcat已支持虚拟线程)。 测试流程 Jmeter 开启 500 个线程去并行发起请求。每个线程将等待请求响应后再发起下一次请求,单次请求超时时间为 10s,测试时间持续 60s。 测试的 Web Server 将接受 Jmeter 的请求,并调用慢速服务器获取响应并返回。 慢速服务器以随机超时响应。最大响应时间为 1000ms。平均响应时间为 500ms。 衡量指标 吞吐量和平均响应时间,吞吐量越高,平均响应时间越低,性能就越好。 Tomcat+普通线程池 默认情况下,Tomcat 使用一请求一线程模型处理请求,当 Tomcat 收到请求时,会从线程池中取一个线程去处理请求,该分配的线程将一直保持占用状态,直到请求结束才会释放。当线程池中没有线程时,请求会一直阻塞在队列中,直到有请求结束释放线程。默认队列长度为 Integer.MAX。 默认线程池 默认情况下,线程池最多包含 200 个线程。这基本上意味着单个时间点最多处理 200 个请求。对于每个请求服务都会以阻塞的方式调用平均 RT500ms 的慢速服务器。因此,可以预期每秒 400 个请求的吞吐量,最终压测结果非常接近预期值,为 388 req/sec。 增加线程池 生产环境为了吞吐考虑,一般不会使用默认值,会把线程池增大到 server.tomcat.threads.max=500+,调整到 500+ 之后的压测结果如下: 可以看出最终的吞吐量和线程数量呈比例上升,同时由于线程数的增加,请求等待减少,平均 RT 趋向于慢速服务器的响应平均 RT。 但是需要注意的是,平台线程的创建受到内存和 Java 线程映射模型的限制,不能无限扩展,同时大量线程会导致 CPU 资源大量消耗在上下文切换时,整体性能反而降低。 WebFlux WebFlux 跟传统的 Tomcat 线程模型不一样,他不会为每个请求分配一个专用线程,而是使用事件循环模型通过非阻塞 I/O 操作同时处理多个请求,这使得它能够用有限的线程数量处理大量的并发请求。 在压测的场景下,使用 WebClient 来进行一个非阻塞的 Http 调用慢速处理器,并使用 RouterFunction 来做请求映射和处理。 @Bean public WebClient slowServerClient() { return WebClient.builder() .baseUrl("http://127.0.0.1:8000") .build(); } @Bean public RouterFunction<ServerResponse> routes(WebClient slowServerClient) { return route(GET("/"), (ServerRequest req) -> ok() .body( slowServerClient .get() .exchangeToFlux(resp -> resp.bodyToFlux(Object.class)), Object.class )); } WebFlux 压测结果如下: 可以看到,WebFlux 的请求完全没有阻塞,仅用了 25 个线程就达到了 964 req/sec 的吞吐。 Tomcat+虚拟线程池 与平台线程相比,虚拟线程的内存占用量要低得多,运行程序大量的创建虚拟线程,而不会耗尽系统资源;同时当遇到 Thread.sleep(),CompletableFuture.await(),等待 I/O,获取锁时,虚拟线程会自动卸载,JVM 可以自动切换到另外的等待就绪的虚拟线程,提升单个平台线程的利用率,保证平台线程不会浪费在无意义的阻塞等待上。 要想使用虚拟线程,需要先在启动参数中加上 --enable-preview,同时 Tomcat 在 10 版本已支持虚拟线程,我们只需要替换 Tomcat 的平台线程池为虚拟线程池即可。 @Bean public TomcatProtocolHandlerCustomizer<?> protocolHandler() { return protocolHandler -> protocolHandler.setExecutor(Executors.newVirtualThreadPerTaskExecutor()); } private final RestTemplate restTemplate; @GetMapping public ResponseEntity<Object> callSlowServer(){ return restTemplate.getForEntity("http://127.0.0.1:8000", Object.class); } 最终压测结果如下: 可以看到虚拟线程的压测结果实际上与 WebFlux 的情况相同,但我们根本没有使用任何复杂的响应式编程技术。同时对慢速服务器的调用,也使用常规的阻塞 RestTemplate。我们所做的只是用虚拟线程执行器替换线程池就达到更复杂的 Webflux 写法相同的效果。 总的压测结果如下: 通过以上压测结果,我们可以得出以下结论: 传统的线程池模式效果差强人意,可以通过提高线程数量可以提升吞吐,但是需要考虑到系统容量和资源限制,但是对于大部分场景来说使用线程池去处理阻塞操作仍然是主流且不错的选择。 WebFlux 的效果非常好,但是考虑到需要完全按照响应式风格进行开发,成本及难度较大,同时 WebFlux 与现有的一些主流框架存在一些兼容问题,例如 Mysql 官方 IO 库不支持 NIO、Threadlocal 兼容问题等等。现有应用的迁移基本要重写所有代码,改动量和风险都不可控。 虚拟线程的效果非常好,最大的优势就是我们没有修改代码或采用任何反应式技术,唯一更改是将线程池替换为虚拟线程。虽然改动较小,但与使用线程池相比,性能结果得到了显著改善。 基于上述的压测结果,可以较为乐观的认为虚拟线程会颠覆我们目前的服务和框架中的请求处理方法。 六、总结 过去很长时间,在编写服务端应用时,我们对于每个请求,都使用独占的线程来处理,请求之间是相互独立的,这就是一请求一线程的模型这种方式易于理解和编程实现,也易于调试和性能调优。 然而,一请求一线程风格并不能简单地使用平台线程来实现,因为平台线程是操作系统中线程的封装。操作系统的线程会申请成本较高,存在数量上限。**对于一个要并发处理海量请求的服务器端应用来说,对每个请求都创建一个平台线程是不现实的。**在这种前提下,涌现出一批非阻塞 I/O 和异步编程框架,如 WebFlux ,RX-Java。当某个请求在等待 I/O 操作时,它会暂时让出线程,并在 I/O 操作完成之后继续执行。通过这种方式,可以用少量线程同时处理大量的请求。这些框架可以提升系统的吞吐量,但是要求开发人员必须熟悉所使用的底层框架,并按照响应式的风格来编写代码,响应式框架的调试困难,学习成本,兼容问题使得大部分人望而却步 。 在使用虚拟线程之后,一切都将改变,开发人员可以使用目前最习惯舒服的方式来编写代码,高性能和高吞吐由虚拟线程自动帮你完成,这极大地降低了编写高并发服务应用的难度。 参考文档: https://openjdk.org/jeps/444 https://zhuanlan.zhihu.com/p/514719325 https://www.vlts.cn/post/virtual-thread-source-code#%E5%89%8D%E6%8F%90 https://zhuanlan.zhihu.com/p/499342616 *文/creed 本文属得物技术原创,更多精彩文章请看:得物技术官网 未经得物技术许可严禁转载,否则依法追究法律责任!

优秀的个人博客,低调大师

每日一博 | 如何画出规范的 UML 用例图

如果你在做设计过程中有一些困惑,如:不会找用例、两个用例图分不清楚、不知道自己画的对不对。那么希望本文能帮助厘清上面几个问题,真正掌握用例图,在后面的设计中能运用的得心应手。 在做设计的时候你是否有以下困惑? 1.不会找用例:业务用例、系统用例又都是啥啊?我该如何把用例写对啊? 2.两个用例图分不清楚:业务用例图和系统用例图感觉好像啊,似乎没啥区别啊? 3.不知道自己画的对不对:照猫画虎画了个用例图,但是我也不知道画的对不对,万一评审的人也不会呢,就这样交差吧 如果你在做设计过程中有以上困惑,那么希望本文能帮助厘清上面几个问题,真正掌握用例图,在后面的设计中能运用的得心应手。 一、如何识别正确的用例 首先看用例的概念,百科上定义“用例是软件工程或系统工程中对系统如何反应外界请求的描述,是一种通过用户的使用场景来获取需求的技术”。什么意思呢,这里我引用《大象:Thinking in UML》里面的一段话来解释下这个定义 这个世界的功能性体现在,首先有某人的一个愿望,这个愿望驱使人去做事并获得一个确定的结果。如果没有愿望,功能性就无从谈起。一个系统就是由各种各样的愿望组成的,换句话说,各种各样的人为着各自的目的做着各种各样的事情共同组成了一个系统。如果我们要描述一个系统的功能性需求,就要找到对这个系统有愿望的人,让他们来说明他们会在这个系统里做什么事,想要什么结果。如果所有对系统有愿望的人要做的所有事情都找全了,那这个系统的功能性就被确定下来了。 用例的一个最主要的特征是它是相对独立的。这意味着它不需要与其他用例交互而独自完成参与者的目的,也就是说用例从“功能”上说是完备的。用例本质体现了系统参与者的愿望,不能完整达到参与者愿望的不能称为用例。例如取钱是一个有效的用例,填写取款单却不是,因为完整的目的是取到钱,没有人会为了填写取款单而专门跑一趟银行的。 用例有两种,业务用例和系统用例,那么我们如何准确的识别用例呢?接下来我们就对业务用例、系统用例逐一分析。 1.1 业务用例 业务用例的定义是业务执行者希望通过和所研究组织交互获得的价值。 我们可以看到一个关键词--价值,这个价值不是指你(组织)能提供什么而是指我(执行者)想要什么,这个时候就需要把视角放在组织外部,切换到执行者上,看看他希望从组织获得什么,而不是把视角放在组织内部,看组织能提供什么。比如说以餐馆这个组织为例,其业务执行者主要是顾客,虽然餐馆可以提供零钱兑换、球赛播放、充电宝租借等服务,但是顾客来餐馆就是为了吃饭的,顾客->就餐就是餐馆的业务用例,提供就餐服务就是餐馆这个组织最大的价值。 试想一个餐馆如果不围绕“提供物美价廉的就餐服务”这一理念去经营,而是饭菜质量做的很差,提供了很多充电宝服务,那么这个餐馆的结果可想而知。 1.2 系统用例 说完业务用例我们再来看看系统用例,系统用例的定义是系统能够为执行者提供的、涉众可以接受的价值。其中的几个概念: 1.系统 封装了自身的数据和行为,能独立对外提供服务的东西才能称为系统。需要注意的系统是一个整体,系统可能会有很多子系统。比如银行转账交易时候需要做风控,如果有商家向银行售卖交易系统,那么风控这个子系统肯定是包含在整个交易系统内的,一起打包卖给银行的。 2.系统执行者 系统执行者的定义是在所研究系统外,与该系统发生功能性交互的其他系统。这里需要注意几点: 系统执行者一定是在系统外的,可以是人或者其他系统; 系统执行者必须是要和系统有交互的; 系统执行者不一定是业务执行者; 3.涉众 涉众是与要建设的业务系统相关的一切人和事,系统执行者也是涉众的一部分。 这里还是以餐馆为例,假如顾客是通过口头告诉服务员(不是自己扫码下单)我要点啥菜,服务员通过下单系统为顾客下单,那么研究这个下单系统可以得出: 1.系统执行者:服务员,虽然顾客作为餐馆这个组织的业务执行者,但是与下单系统直接交互的是服务员,所以服务员才是点餐系统的系统执行者; 2.涉众,这个就很多了,顾客、服务员、餐馆老板、厨师等等都是涉众,因为都是下单系统的利益关系者; a.顾客担心自己下单没成功,等了很久不上菜;b.服务员担心没出单导致顾客投诉,自己奖金被扣;c.老板担心系统故障引起很多顾客投诉,生意受到影响; d.厨师担心下单系统分配不合理,所有的菜都分配给自己做; 一般这个下单系统可以登录、下单,查看下单记录,这些都是下单系统的一些功能。我们再来回顾下系统用例的概念:系统用例指的是系统能够为执行者提供的、涉众可以接受的价值。那我们接下来就从每个涉众的视角分析一下对这些功能的需要情况。 登录 下单 查看下单记录 服务员 我需要,要不然别人下错单了怪我头上咋办 I need it! 我需要,方便查看顾客菜品上齐了没 顾客 I don't care! 能不能下单直接影响我能不能吃上饭 我也需要,得打印出来我的菜单,结账时候好核对 老板 我也需要,可以看看服务员的工作情况 下单系统不能下单我买它来干啥 我需要,方便订单管理,也方便看看哪个菜客人点的最多 厨师 I don't care! 不能下单谁告诉我该做什么菜 我需要,要不然说我少做了一道菜没法解释 所以,从上可以得出下单、查看下单记录满足系统用例的概念,系统用例图如下 可以看到,和业务用例不同的是在研究系统用例时我们需要把视角切换到系统,从系统出发看看能为执行者提供什么样的、涉众都可以接受价值。 Tips: 1.用例的名字一般是动宾结构,也就是“动词+名词”,但是不严格要求的。比如“成果分析”这个行业术语没必要硬倒过来改成“分析成果” 2.老老实实去研究业务流程,做好业务建模,尽量从业务序列图中映射出系统用例,这样得到的系统用例才是是最真实的。 3.用例是可以有主执行者和辅执行者的:主执行者从执行者指向用例,而辅执行者从用例指向执行者,主执行者发起用例的交互,辅执行者在交互过程中被动参与进来。一般说来,辅执行者是人肉系统的情况比较少,更多时候是另一个非人智能系统。 4.主执行者和辅执行者是相对于用例来说的,“ xx 是xx用例的主/辅执行者” 是正确的,“ xx 是xx系统的主/辅执行者” 说法是错误的。 二、如何区分业务用例图和系统用例图 相信经过上面的分析,你已经发现了两个用例图的异同点,如果没有,我再贴一下两个图(便于对比下单系统就简化成下单这个一个用例),便于更直观的对比: 没错,两个图的最大的不同就是有无“/”,业务用例图在业务执行者和业务用例上是有“/”的,系统用例图在系统执行者和系统用例图上没有“/”,就是这么简单。所以现在再看到下面这个几个图,你是不是可以一眼看出其中的问题了。 三、如何用 PlantUML 画出规范的用例图 PlantUML 是一个快速创建 UML 图形的组件或者可以说是语言,通过简单和直观的语言来定义图形。其在学习成本、效率、团队协同以及维护成本上都有比较大的优势,所以推荐使用 PlantUML 来画图。 用例图画起来其实很简单,主要就是四个要素,这里以系统用例为例,四个要素分别是系统、执行者、用例、关系。 3.1 系统 系统用一个矩形块表示,在 UML语法中是rectangle。如下: @startuml rectangle "xx 系统" { } @enduml 3.2 执行者 执行者是用火材人表示,在 UML 语法中是actor,主要有两种写法,如下: @startuml '系统执行者的两种写法' actor Actor1 :Actor2: '业务执行者的两种写法' actor/ Actor3 :Actor4:/ @enduml 3.3 用例 用例是用一个椭圆表示。在UML 语法中是usecase ,业务用例和系统用例的两种写法如下: @startuml usecase/ " 业务用例 1" as UC1 '业务用例的第二种写法:() + 用例名称 + /' (业务用例 2)/ as UC3 usecase "系统用例 1" as UC2 '系统用例的第二种写法:() + 用例名称 ' (系统用例 2) @enduml 3.4 关系 系统用例图中关系主要有四种,分别是关联、包含、扩展、泛化。 3.4.1 关联 关联是执行者和用例之间的一种关系,一般用实线 + 实心箭头表示: @startuml actor Actor rectangle "xx系统" { usecase "系统用例 1" as UC1 } Actor -> UC1 @enduml 这里有一点需要注意的是,虽然表示关联关系可以直接用实线如A-B这样表示,但是在用例图中我们尽量用实线+箭头表示,否则如下: 你无法区分 Actor1 和 Actor2 谁是主执行者谁是辅执行者,又或者两个都是主执行者?加上箭头后就非常容易区分,如下 3.4.2 包含 包含是用例之间的一种关系,其中一个用例(称为基本用例)的行为包含了另一个用例(称为包含用例)的行为,用虚线箭头 + <<include>>表示,箭头指向包含用例。 包含关系意味着包含用例是基本用例中不可缺少的一个执行步骤,如果缺少了该包含用例,基本用例就会变得不完整,可类比类图中对象之间的组合关系。使用包含关系的两个场景: 当基本用例较复杂时,可以分解出一些包含用例; 当两个或以上的基本用例存在一些重复行为时,可以提炼出一个包含用例; @startuml '加入下面代码指定方向,使 UML 从左往右更直观' left to right direction actor Actor rectangle "xx系统" { usecase "基本用例" as UC1 usecase "包含用例 1" as UC2 usecase "包含用例 2" as UC3 } Actor --> UC1 UC1 ..> UC2 : <<include>> UC1 ..> UC3 : <<include>> @enduml 上面我用了Actor --> UC1、UC1 ..> UC2,有兴趣的可以换成->、.>看看效果 3.4.3 扩展关系 扩展是用例之间的一种关系,其中一个用例(称为扩展用例)的行为增强了另一个用例(称为基本用例)的行为,用虚线箭头 + <<extend>>表示,箭头指向基本用例。 扩展用例是对基本用例的一种补充或强化,即使没有该扩展用例,对基本用例也不会产生直接影响,基本用例自身仍然是完整的。也就是说扩展用例是基本用例的一种可能的补充,如购买运费险就是对下单这一用例的扩展,买不买运费险都不影响下单。 @startuml left to right direction actor Actor rectangle "xx系统" { usecase "基本用例" as UC1 usecase "扩展用例" as UC2 } Actor --> UC1 UC1 <.. UC2 : <<extend>> @enduml 3.4.4 泛化 泛化关系也可以称作继承关系(类比类图中的泛化),用一个实线 + 空心箭头来表示,可以表示执行者间的关系也可以表示用例之间的关系。 @startuml left to right direction actor Actor rectangle "xx系统" { usecase "支付" as UC1 usecase "微信支付" as UC2 usecase "支付宝支付" as UC3 } Actor --> UC1 UC1 <|-- UC2 UC1 <|-- UC3 @enduml 四、一个案例 这里我们以某银行的 App 为例,作为银行的一个系统我们对其进行分析: 1.系统:那自然是这个 App 2.系统执行者 a.主执行者:一般来银行办业务的客户都是主执行者,包括个人用户和企业用户; b.辅执行者:银行,用户在 App 办理的所有业务都需要银行来配合执行; 3.系统用例:作为银行的线上业务,包含转账、查询余额、理财、贷款。 4.关系:这里需要注意的是转账过多有可能会超过限额,这个时候会提示超限;在办贷款业务之前,银行肯定会对用户的资产进行评估,这样才能决定其贷款额度。 @startuml left to right direction actor 客户 as Actor actor 银行 as Actor2 rectangle "某银行App" { usecase "转账" as UC1 usecase "查询余额" as UC2 usecase "理财" as UC3 usecase "贷款" as UC4 usecase "评估资产" as UC5 usecase "提示限额" as UC6 } Actor <|-up- 个人用户 Actor <|-up- 企业用户 Actor --> UC1 Actor --> UC2 Actor --> UC3 Actor --> UC4 UC1 ----> Actor2 UC2 ----> Actor2 UC3 ----> Actor2 UC4 ----> Actor2 UC4 .left.> UC5 :<<include>> UC1 <.down. UC6 :<<extend>> @enduml 整体用例图如下: 作者 | 夜合 原文链接 本文为阿里云原创内容,未经允许不得转载。

优秀的个人博客,低调大师

每日一博 | 彩虹桥架构演进之路 - 性能篇

一、前言 一年前的《彩虹桥架构演进之路》侧重探讨了稳定性和功能性两个方向。在过去一年中,尽管业务需求不断增长且流量激增了数倍,彩虹桥仍保持着零故障的一个状态,算是不错的阶段性成果。而这次的架构演进,主要分享一下近期针对性能层面做的一些架构调整和优化。其中最大的调整就是 Proxy-DB 层的线程模式从 BIO 改造成了性能更好的 NIO。下面会详细介绍一下具体的改造细节以及做了哪些优化。 阅读本文预计需要 20~30 分钟,整体内容会有些枯燥难懂,建议阅读前先看一下上一篇彩虹桥架构演进的文章(彩虹桥架构演进之路)以及 MySQL 协议相关基础知识。 ‍ 二、改造前的架构 先来复习一下彩虹桥的全景架构图: Proxy三层模块 针对 Proxy 这一层,可以大致分成 Frontend、Core、Backend 三层: Frontend-服务暴露层:使用 Netty 作为服务器,按照 MySQL 协议对接收&返回的数据进行编解码。 Core-功能&内核层:通过解析、改写、路由等内核能力实现数据分片、读写分离、影子库路由等核心功能。 Backend-底层DB交互层:通过 JDBC 实现与数据库交互、对结果集改列、归并等操作。 BIO模式下的问题 这里 Core 层为纯计算操作,而 Frontend、Backend 都涉及 IO 操作,Frontend 层使用 Netty 暴露服务为 NIO 模式,但是 Backend 使用了数据库厂商提供的传统 JDBC 驱动,为 BIO 模式。所以 Proxy 的整体架构还是 BIO 模式。在 BIO 模型中,每个连接都需要一个独立的线程来处理。这种模型有一些明显的缺点: 高资源消耗:每个请求创建独立线程,伴随大量线程开销。线程切换与调度额外消耗 CPU。 扩展性受限:受系统线程上限影响,处理大量并发连接时,性能急剧下降。 I/O阻塞:BIO 模型中,读/写操作均为阻塞型,导致线程无法执行其他任务,造成资源浪费。 复杂的线程管理:线程管理和同步问题增加开发和维护难度。 我们看最简单的一个场景:在 JDBC 在发起请求后,当前线程会一直阻塞直到数据库返回数据,当出现大量慢查或者数据库出现故障时,会导致大量线程阻塞,最终雪崩。在上一篇彩虹桥架构演进文章中,我们做了一些改进来避免了 BIO 模型下的一些问题,比如使用线程池隔离来解决单库阻塞导致全局雪崩的问题。 但是随着逻辑库数量的增多,最终导致 Proxy 的线程数膨胀。系统的可伸缩性和吞吐量都受到了挑战。因此有必要将现有的基于 JDBC 驱动的阻塞式连接升级为采用 NIO(非阻塞 I/O)方式连接数据库。 ‍ 三、改造后的架构 BIO->NIO 想把 Proxy 整体架构从 BIO->NIO,最简单的方式就是把传统的 BIO 数据库驱动 JDBC 换成 NIO 的数据库驱动,但是在调研过后发现开源的 NIO 驱动并不多,而且基本上没有什么最佳实践。最后在参考 ShardingSphere 社区之前做的调研后(https://github.com/apache/shardingsphere/issues/13957 ) ,决定使用 Vertx 来替换 JDBC。最开始使用 Vert.x 的原因,第一是 Vertx 的异步编码方式更友好,编码复杂度相对较低,第二是因为它实现了主流数据库的驱动。但最终的结果不尽人意,由于 Vertx 相关抽象化的架构,导致链路较长时,整个调用栈深非常夸张。最终压测出来的吞吐量提升只有 5% 不到,而且存在很多兼容性问题。于是推倒重来,决定自研数据库驱动和连接池。 跳过不必要的编解码阶段 由于 JDBC 驱动会自动把 MySQL 的字节数据编解码成 Java 对象,然后 Proxy 再把这些结果集经过一些加工(元信息修正、结果集归并)后再进行编码返回给上游。如果自研驱动的话,就可以把编解码流程控制的更细致一些,把 Proxy 不需要加工的数据直接转发给上游,跳过无意义的编解码。后面会介绍一下哪些场景是不需要 Proxy 对结果集进行加工的。 自研NIO数据库驱动 数据库驱动主要是封装了与 DB 层交互协议,封装成高级 API。下面 2 张图是 java.sql 包中的 Connection 和 Statement 的一些核心接口。 所以首先我们需要了解一下,如何与数据库进行数据交互,以 MySQL 为例,使用 Netty 连接 MySQL,简单的交互流程如下。 使用 Netty 与 MySQL 连接建立后,我们要做的就是按照 MySQL 协议规定的数据格式,先鉴权后再发送具体的命令包即可。下面是 MySQL 官方文档中鉴权流程和命令执行流程: 鉴权流程:https://dev.mysql.com/doc/dev/mysql-server/latest/page_protocol_connection_phase.html 执行命令流程:https://dev.mysql.com/doc/dev/mysql-server/latest/page_protocol_command_phase.html 下面就是按照 MySQL 的文档,去实现编解码 Handle,我们简单看一下实现的代码。 decode 解码 就是针对 MySQL 返回的数据包解码,根据长度解析出 Palyload 封装成 MySQLPacketPayload 传给对应的 Handle 处理。 encode 编码 把具体的命令类转换成具体的 MySQL 数据包,这里的 MySQLPacket 有多个实现类,跟 MySQL的Command 类型一一对应。 现在还需要一个类似 java.sql.Connection 的实现类,来组装 MySQLPacket 并写入到 Netty 通道中,并且解析编码后的 MySQLPacketPayload 转换成 ResultSet。 看起来比较简单,交互流程和传统的 JDBC 几乎一样,但是由于现在是异步化流程,所有的 Response 都是通过回调返回,所以这里有 2 个难点: 由于 MySQL 在上一条命令没结束前无法接受新的命令,所以如何控制单个连接的命令串行化? 如何将 MySQL 返回的数据包和发起命令的 Request 一一绑定? 首先 NettyDbConnection 引入了一个无锁化非阻塞队列 ConcurrentLinkedQueue。 在发送 Command 时,如何没有正在进行中的 Command,则直接发送,如果有正在进行中的 Command,直接扔到队列中,等待上一条 Command 处理完成后推动下一条命令的执行。保证了单个连接命令串行化。 其次,NettyDbConnection 在执行命令时,传入一个 Promise,在 MySQL 数据包全部返回后,这个 Promise 将会被设置完成,即可于发起命令的 Request 一一绑定。 自研NIO数据库连接池 前面介绍了 NettyDbConnection 这个类,实现了与 MySQL 的交互,并且提供了执行 SQL 的高级 API,但实际使用过程中,不可能每次都创建一个连接执行完 SQL 就关闭。所以需要对 NettyDbConnection 进行池化,统一管理连接的生命周期。其功能类似于传统连接池 HikariCP,在完成基本能力的基础上,做了很多性能优化。 连接生命周期管控 连接池动态伸缩 完善的监控 连接异步保活 超时控制 EventLoop 亲和性 这里除了 EventLoop 亲和性,其他几个功能只要用过传统的数据库连接池应该都比较熟悉,这里不做过多展开。这里主要针对 EventLoop 亲和性展开介绍一下。 在文章开头我们说到 Proxy 的三层模块,Frontend、Core、Backend,如果现在我们把 Backend 层于数据库交互的组件换成了我们自研的驱动,那么 Proxy 就即是Netty Server,也是Netty Client,所以 Frontend 和 Backend 可以共用一个 EventLoopGroup。为了降低线程上下文切换,在单个请求从 Frontend 接收、经过 Core 层计算后转发到 MySQL ,再到接收 MySQL 服务响应,以及最终的回写给 Client 端,这一些列操作尽量放在一个 EventLoop 线程中处理。 具体的做法就是 Backend 在选择与数据库连接时,优先选择与当前 EventLoop 绑定的连接。也就是前面提到的 EventLoop 亲和性,这样就能保证大部分场景下一次请求从头到尾都由同一个 EventLoop 处理,下面我们看一下具体的代码实现。 在 NettyDbConnectionPool 类中使用一个 Map 存储连接池中的空闲连接,Key 为 EventLoop,Value 为当前 EventLoop 绑定的空闲连接队列。 在获取时,优先获取当前 EventLoop 绑定的连接,如果当前 EventLoop 未绑定连接,则会借用其他 EventLoop 的连接。 为了提高EventLoop 命中率,需要注意几点配置: EventLoop 线程数量尽量与 CPU 核心数保持一致。 连接池最大连接数超过EventLoop 线程数越多,EventLoop 命中率越高。 下面放一张压测环境(8C16G、连接池最大连接数 10~30)的命中率监控,大部分保持在 75% 左右。 跳过不必要的编解码 前面说到,有部分 SQL 的结果集是不需要 Proxy 进行加工的,也就是可以直接把 MySQL 返回的数据流原封不动转发给上游,直接省去编解码操作。那什么 SQL 是不需要 Proxy 进行加工的呢,我们举个例子说明一下。 假设逻辑库 A 里面有一张表 User 做了分库,分了 2 个库 DB1 和 DB2,分片算法是 user_id%2。 SQL 1 ‍SELECT id, name FROM user WHERE user_id in (1, 2) SQL 2 ‍SELECT id, name FROM user WHERE user_id in (1) 很显然 SQL 1由于有 2 个分片 Value,最终匹配到了 2 个节点,SQL 2 只会匹配到 1 个节点。 SQL 1 由于需要对结果集进行归并,所以无法跳过编解码,SQL 2 不需要对结果集归并,只需要把结果集中的列定义数据做修正后,真正的 Row 数据无需处理,这种情况就可以把 Row 数据直接转发至上游。 全链路异步化 Backend 层用自研连接池+驱动替换原先的 HikariCP+JDBC 后,从 Frontend-Core-Backend 全链路涉及到阻塞的操作需要全部替换成异步化编码,也就是通过 Netty 的 Promise 和 Future 来实现。 由于部分场景拿到 Future 时,可能当前 Future 已经完成了,如果每次都是无脑的加 Listener 会让调用栈加长,所以我们定义了一个通用的工具类来处理 Future,即 future.isDone() 时直接执行,反之才会 addListener,最大化降低整个调用栈的深度。 兼容性 除了以上基本代码的改造外,还需要做大量的兼容工作: 特殊数据库字段类型处理 JDBC URL 参数兼容 ThreadLocal 相关数据全部需要迁移至 ChannelHandlerContext 中 日志 MDC、TraceContext 相关数据传递 …… ‍ 四、性能表现 经过几轮性能压测后,NIO架构相较于BIO架构性能有较大提升: 整体最大吞吐量提升 67% LOAD 下降 37% 左右 高负载情况下 BIO 多次出现进程夯住现象,NIO 相对较稳定 线程数减少 98% 左右 ‍ ‍五、总结 NIO 架构的改造工作量相当巨大,中间也经历了一些曲折,但是最终的结果令人满意。得益于 ShardingShpere 本身内核层面的高性能加上本次 NIO 改造后,彩虹桥在 DAL 中间件性能层面基本上可以算是第一梯队了。 ‍ *文 / 新一 本文属得物技术原创,更多精彩文章请看:得物技术官网 未经得物技术许可严禁转载,否则依法追究法律责任!

优秀的个人博客,低调大师

每日一博 | Dubbo 路由及负载均衡性能优化

揭秘vivo互联网海量服务的研发之路报名中👇 作者:vivo 互联网中间件团队- Wang Xiaochuang 本文主要介绍在vivo内部针对Dubbo路由模块及负载均衡的一些优化手段,主要是异步化+缓存,可减少在RPC调用过程中路由及负载均衡的CPU消耗,极大提升调用效率。 一、概要 vivo内部Java技术栈业务使用的是Apache Dubbo框架,基于开源社区2.7.x版本定制化开发。在海量微服务集群的业务实践中,我们发现Dubbo有一些性能瓶颈的问题会极大影响业务逻辑的执行效率,尤其是在集群规模数量较大时(提供方数量>100),路由及负载均衡方面有着较大的CPU消耗,从采集的火焰图分析高达30%。为此我们针对vivo内部常用路由策略及负载均衡进行相关优化,并取得了较好的效果。接下来主要跟大家分析一下相关问题产生的根源,以及我们采用怎样的方式来解决这些问题。(当前vivo内部使用的Dubbo的主流版本是基于2.7.x进行相关定制化开发。) 二、背景知识 2.1 Dubbo客户端调用流程 1.相关术语介绍 2.主要流程 客户端通过本地代理Proxy调用ClusterInvoker,ClusterInvoker从服务目录Directory获取服务列表后经过路由链获取新的服务列表、负载均衡从路由后的服务列表中根据不同的负载均衡策略选取一个远端Invoker后再发起远程RPC调用。 2.2 Dubbo路由机制 Dubbo的路由机制实际是基于简单的责任链模式实现,同时Router继承了Comparable接口,自定义的路由可以设置不同的优先级进而定制化责任链上Router的顺序。基于责任链模式可以支持多种路由策略串行执行如就近路由+标签路由,或条件路由+就近路由等,且路由的配置支持基于接口级的配置也支持基于应用级的配置。常见的路由方式主要有:就近路由,条件路由,标签路由等。具体的执行过程如下图所示: 1. 核心类 Dubbo路由的核心类主要有:RouterChain、RouterFactory 与 Router 。 (1)RouterChain RouterChain是路由链的入口,其核心字段有 invokers(List<invoker> 类型) 初始服务列表由服务目录Directory设置,当前RouterChain要过滤的Invoker集合 builtinRouters(List类型) 当前RouterChain包含的自动激活的Router集合 routers(List类型) 包括所有要使用的路由由builtinRouters加上通过addRouters()方法添加的Router对象 RouterChain核心逻辑 public class RouterChain<T> { // 注册中心最后一次推送的服务列表 private List<Invoker<T>> invokers = Collections.emptyList(); // 所有路由,包括原生Dubbo基于注册中心的路由规则如“route://” urls . private volatile List<Router> routers = Collections.emptyList(); // 初始化自动激活的路由 private List<Router> builtinRouters = Collections.emptyList(); private RouterChain(URL url) { //通过ExtensionLoader加载可自动激活的RouterFactory List<RouterFactory> extensionFactories = ExtensionLoader.getExtensionLoader(RouterFactory.class) .getActivateExtension(url, ROUTER_KEY); // 由工厂类生成自动激活的路由策略 List<Router> routers = extensionFactories.stream() .map(factory -> factory.getRouter(url)) .collect(Collectors.toList()); initWithRouters(routers); } // 添加额外路由 public void addRouters(List<Router> routers) { List<Router> newRouters = new ArrayList<>(); newRouters.addAll(builtinRouters); newRouters.addAll(routers); Collections.sort(newRouters, comparator); this.routers = newRouters; } public List<Invoker<T>> route(URL url, Invocation invocation) { List<Invoker<T>> finalInvokers = invokers; // 遍历全部的Router对象,执行路由规则 for (Router router : routers) { finalInvokers = router.route(finalInvokers, url, invocation); } return finalInvokers; }} (2)RouterFactory为Router的工厂类 RouterFactory接口定义 @SPIpublic interface RouterFactory { @Adaptive("protocol") Router getRouter(URL url);} (3)Router Router是真正的路由实现策略,由RouterChain进行调用,同时Router继承了Compareable接口,可以根据业务逻辑设置不同的优先级。 Router主要接口定义 public interface Router extends Comparable<Router> { /** * * @param invokers 带过滤实例列表 * @param url 消费方url * @param invocation 会话信息 * @return routed invokers * @throws RpcException */ <T> List<Invoker<T>> route(List<Invoker<T>> invokers, URL url, Invocation invocation) throws RpcException; /** * 当注册中心的服务列表发现变化,或有动态配置变更会触发实例信息的变化 * 当时2.7.x的Dubbo并没有真正使用这个方法,可基于此方法进行路由缓存 * @param invokers invoker list * @param <T> invoker's type */ default <T> void notify(List<Invoker<T>> invokers) { }} 2.同机房优先路由的实现 为方便大家了解路由的实现,给大家展示一下就近路由的核心代码逻辑 public <T> List<Invoker<T>> route(List<Invoker<T>> invokers, URL consumerUrl, Invocation invocation) throws RpcException { if (!this.enabled) { return invokers; } // 获取本地机房信息 String local = getSystemProperty(LOC); if (invokers == null || invokers.size() == 0) { return invokers; } List<Invoker<T>> result = new ArrayList<Invoker<T>>(); for (Invoker invoker: invokers) { // 获取与本地机房一致的invoker并加入列表中 String invokerLoc = getProperty(invoker, invocation, LOC); if (local.equals(invokerLoc)) { result.add(invoker); } } if (result.size() > 0) { if (fallback){ // 开启服务降级,available.ratio = 当前机房可用服务节点数量 / 集群可用服务节点数量 int curAvailableRatio = (int) Math.floor(result.size() * 100.0d / invokers.size()); if (curAvailableRatio <= availableRatio) { return invokers; } } return result; } else if (force) { return result; } else { return invokers; } } 2.3 Dubbo负载均衡 Dubbo的负载均衡实现比较简单基本都是继承抽象类进行实现,主要作用就是根据具体的策略在路由之后的服务列表中筛选一个实例进行远程RPC调用,默认的负载均衡策略是随机。 整体类图如下所示: LoadBalance接口定义 @SPI(RandomLoadBalance.NAME)public interface LoadBalance { /** * 从服务列表中筛选一个. * * @param invokers invokers. * @param url refer url * @param invocation invocation. * @return selected invoker. */ @Adaptive("loadbalance") <T> Invoker<T> select(List<Invoker<T>> invokers, URL url, Invocation invocation) throws RpcException;} 随机负载均衡核心代码解析 // 预热过程权重计算 static int calculateWarmupWeight(int uptime, int warmup, int weight) { int ww = (int) (uptime / ((float) warmup / weight)); return ww < 1 ? 1 : (Math.min(ww, weight)); }int getWeight(Invoker<?> invoker, Invocation invocation) { int weight; URL url = invoker.getUrl(); // 多注册中心场景下的,注册中心权重获取 if (UrlUtils.isRegistryService(url)) { weight = url.getParameter(REGISTRY_KEY + "." + WEIGHT_KEY, DEFAULT_WEIGHT); } else { weight = url.getMethodParameter(invocation.getMethodName(), WEIGHT_KEY, DEFAULT_WEIGHT); if (weight > 0) { // 获取实例启动时间 long timestamp = invoker.getUrl().getParameter(TIMESTAMP_KEY, 0L); if (timestamp > 0L) { long uptime = System.currentTimeMillis() - timestamp; if (uptime < 0) { return 1; } // 获取预热时间 int warmup = invoker.getUrl().getParameter(WARMUP_KEY, DEFAULT_WARMUP); if (uptime > 0 && uptime < warmup) { weight = calculateWarmupWeight((int)uptime, warmup, weight); } } } } return Math.max(weight, 0); }@Override protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) { // Number of invokers int length = invokers.size(); // Every invoker has the same weight? boolean sameWeight = true; // the weight of every invokers int[] weights = new int[length]; // the first invoker's weight int firstWeight = getWeight(invokers.get(0), invocation); weights[0] = firstWeight; // The sum of weights int totalWeight = firstWeight; for (int i = 1; i < length; i++) { int weight = getWeight(invokers.get(i), invocation); // save for later use weights[i] = weight; // Sum totalWeight += weight; if (sameWeight && weight != firstWeight) { sameWeight = false; } } if (totalWeight > 0 && !sameWeight) { // If (not every invoker has the same weight & at least one invoker's weight>0), select randomly based on totalWeight. int offset = ThreadLocalRandom.current().nextInt(totalWeight); // Return a invoker based on the random value. for (int i = 0; i < length; i++) { offset -= weights[i]; if (offset < 0) { return invokers.get(i); } } } // If all invokers have the same weight value or totalWeight=0, return evenly. return invokers.get(ThreadLocalRandom.current().nextInt(length)); } 预热解释 预热是为了让刚启动的实例流量缓慢增加,因为实例刚启动时各种资源可能还没建立连接,相关代码可能还是处于解释执行,仍未变为JIT执行,此时业务逻辑较慢,不应该加载过大的流量,否则有可能造成较多的超时。Dubbo默认预热时间为10分钟,新部署的实例的流量会在预热时间段内层线性增长,最终与其他实例保持一致。Dubbo预热机制的实现就是通过控制权重来实现。如默认权重100,预热时间10分钟,则第一分钟权重为10,第二分钟为20,以此类推。 具体预热效果图如下: 三、问题分析 使用Dubbo的业务方反馈,他们通过火焰图分析发现Dubbo的负载均衡模块+路由模块占用CPU超过了30%,框架层面的使用率严重影响了业务逻辑的执行效率急需进行优化。通过火焰图分析,具体占比如下图,其中该机器在业务忙时的CPU使用率在60%左右,闲时在30%左右。 通过火焰图分析,负载均衡主要的消耗是在 getWeight方法。 路由的主要消耗是在route方法: 同机房优先路由 接口级标签路由+应用级标签路由 这些方法都有一个特点,那就是遍历执行。如负载均衡,针对每一个invoker都需要通过getWeight方法进行权重的计算;就近路由的router方法对于每一个invoker都需要通过url获取及机房信息进行匹配计算。 我们分析一下getWeight及router时间复杂度,发现是O(n)的时间复杂度,而且路由是由路由链组成的,每次每个 Router的route方法调用逻辑都会遍历实例列表,那么当实例列表数量过大时,每次匹配的计算的逻辑过大,那么就会造成大量的计算成本,导致占用大量cpu,同时也导致路由负载均衡效率低下。 综上所述,罪恶的的根源就是遍历导致的,当服务提供方数量越多,影响越大。 四、优化方案 知道了问题所在,我们来分析一下是否有优化空间。 4.1 路由优化 1. 优化一:关闭无效路由 通过火焰图分析,我们发现有部分业务即使完全不使用应用级的标签路由,原生的TagRouter也存在遍历逻辑,原因是为了支持静态的标签路由,其实这部分的开销也不少,那对于根本不会使用应用级标签路由的可以手动进行关闭。关闭方式如下: 客户端统一关闭 dubbo.consumer.router=-tag 服务级别关闭 注解方式: @DubboReference(parameters = {"router","-tag"}) xml方式: <dubbo:reference id="demoService" check="false" interface="com.dubbo.study.n.api.DemoService" router="-tag" /> 2. 优化二:提前计算路由结果并进行缓存 每次路由目前都是进行实时计算,但是在大多数情况下,我们的实例列表是稳定不变的,只有在发布窗口或配置变更窗口内实例列表才会发生变更,那我们是否可以考虑缓存呢。如就近路由,可以以机房为key进行机房实例的全量缓存。针对接口级标签路由可以缓存不同标签值指定的实例信息。 我们知道路由的执行过程是责任链模式,每一个Router的实例列表入参实际上是一个Router的结果,可参考公式:target = rn(…r3(r2(r1(src))))。那么所有的路由可以基于注册中心推送的原始服务列表进行路由计算并缓存,然后不同的路由结果相互取交集就能得到最终的结果,当实例信息发生变更时,缓存失效并重新计算。 3. 缓存更新时机 当注册中心或者动态配置有变更时,相关通知会给到服务目录Directory,Directory收到通知后会重新创建服务列表,并把服务列表同步到路由链RouterChain,RouterChain再按顺序通知其链上的Router,各个Router再进行缓存清除并重新进行路由结果的计算及进行缓存。相关时序图如下所示: 4. 具体路由流程 进入具体路由方法时,先判断是否存在缓存的路由值,且缓存值的epoch必须与上一个路由的epoch需一致,此时缓存才生效,然后缓存值与上个Router的结果取交集。 如果不存在缓存或epoch不一致则重新进行实时的路由计算。 引入epoch的原因主要是保证各个路由策略缓存信息的一致性,保证所有的缓存计算都是基于同一份原始数据。当实例信息发生变更时,epoch会自动进行更新。 5. BitMap引入 上文我们说到,不同的路由策略之间的结果是取交集的,然后最终的结果才送入负载均衡流程。那如何在缓存的同时,加快交集的计算呢。答案就是基于位图:BitMap。 BitMap的基本原理就是用一个bit位来存放某种状态,适用于大规模数据的查找及位运算操作。如在路由场景,先基于全量的推送数据进行计算缓存。如果某个实例被路由选中,则其值为1,若两个路由的结果要取交集,那直接对BitMap进行"&"运行即可。 全量缓存示意图: 路由交集计算示步骤: 按照路由链依次计算, tagRouter->vivoTag->vivoNearestRouter (1)tagRouter计算逻辑: 按照Invocation计算出目标的Tag,假设是tag1 然后从缓存Cache根据key:tag1,取出对应的targetAddrPool 将原始传入的addrPool 与targetAddrPool 得到结果resultAddrPool 将resultAddrPool传入vivoTagRouter (2)vivoTag计算逻辑: 按照Invocation计算出目标的Tag,假设是tabB 然后从缓存Cache根据key:tag1,取出对应的targetAddrPool 将上一次传入的addrPool 与targetAddrPool 得到结果resultAddrPooll 将resultAddrPool传入 vivoNearestRouter (3)vivoNearestRouter计算逻辑 从环境变量取出当前机房,假设是bj01 然后从缓存Cache根据key:bj01,取出对应的targetAddrPool 将上一次传入的addrPool 与targetAddrPool 取出resultAddrPool 将上一次传入的addrPool 与targetAddrPool 得到结果resultAddrPool 将resultAddrPool为最终路由结果,传递给LoadBalance 6. 基于缓存的同机房优先路由源码解析 缓存刷新 /** * Notify router chain of the initial addresses from registry at the first time. * Notify whenever addresses in registry change. */ public void setInvokers(List<Invoker<T>> invokers) { // 创建带epoch的BitList this.invokers = new BitList<Invoker<T>>(invokers == null ? Collections.emptyList() : invokers,createBitListEpoch()); routers.forEach(router -> router.notify(this.invokers)); } 同机房优先路由源码解读 public <T> List<Invoker<T>> route(List<Invoker<T>> invokers, URL consumerUrl, Invocation invocation) throws RpcException { …………//省略非核心代码 BitList<Invoker<T>> bitList = (BitList<Invoker<T>>) invokers; //获取路由结果 BitList<Invoker<T>> result = getNearestInvokersWithCache(bitList); if (result.size() > 0) { if (fallback) { // 开启服务降级,available.ratio = 当前机房可用服务节点数量 / 集群可用服务节点数量 int curAvailableRatio = (int) Math.floor(result.size() * 100.0d / invokers.size()); if (curAvailableRatio <= availableRatio) { return invokers; } } return result; } else if (force) { return result; } else { return invokers; } } /** * 获取缓存列表 * @param invokers * @param <T> * @return */ private <T> BitList<Invoker<T>> getNearestInvokersWithCache(BitList<Invoker<T>> invokers) { ValueWrapper valueWrapper = getCache(getSystemProperty(LOC)); // 是否存在缓存 if (valueWrapper != null) { BitList<Invoker<T>> invokerBitList = (BitList<Invoker<T>>) valueWrapper.get(); // 缓存的epoch与源列表是否一致 if (invokers.isSameEpoch(invokerBitList)) { BitList<Invoker<T>> tmp = invokers.clone(); // 结果取交集 return tmp.and(invokerBitList); } } // 缓存不存在 实时计算放回 return getNearestInvokers(invokers); } /** * 新服务列表通知 * @param invokers * @param <T> */ @Override public <T> void notify(List<Invoker<T>> invokers) { clear(); if (invokers != null && invokers instanceof BitList) { BitList<Invoker<T>> bitList = (BitList<Invoker<T>>) invokers; // 设置最后一次更新的服务列表 lastNotify = bitList.clone(); if (!CollectionUtils.isEmpty(invokers) && this.enabled) { // 获取机房相同的服务列表并进行缓存 setCache(getSystemProperty(LOC), getNearestInvokers(lastNotify)); } } } 4.2 负载均衡优化 1.优化一 针对getWeight方法,我们发现有部分业务逻辑较为消耗cpu,但是在大多数场景下业务方并不会使用到,于是进行优化。 getWeight方法优化 优化前://这里主要要用多注册中心场景下,注册中心权重的获取,绝大多数情况下并不会有这个逻辑 if (UrlUtils.isRegistryService(url)) { weight = url.getParameter(REGISTRY_KEY + "." + WEIGHT_KEY, DEFAULT_WEIGHT); } 优化后: if (invoker instanceof ClusterInvoker && UrlUtils.isRegistryService(url)) { weight = url.getParameter(REGISTRY_KEY + "." + WEIGHT_KEY, DEFAULT_WEIGHT); } 2.优化二 遍历是罪恶的源泉,而实例的数量决定这罪恶的深浅,我们有什么办法减少负载均衡过程中的遍历呢。一是根据group及version划分不同的集群,但是这需要涉及到业务方代码或配置层面的改动,会带来额外的成本。所以我们放弃了。 二是没有什么是加一层解决不了的问题,为了尽量减少进入负载均衡的节点数量,考虑新增一个垫底的路由策略,在走完所有的路由策略后,若节点数量>自定义数量后,进行虚拟分组,虚拟分组的策略也可进行自定义,然后随机筛选一组进入负载均衡。此时进入负载均衡的实例数量就会有倍数的下降。 需要注意的是分组路由必须保证是在路由链的最后一环,否则会导致其他路由计算错误。 分组路由示意 /** * * @param invokers 待分组实例列表 * @param groupNum 分组数量 * @param <T> * @return */ public <T> List<Invoker<T>> doGroup(List<Invoker<T>> invokers, int groupNum) { int listLength = invokers.size() / groupNum; List<Invoker<T>> result = new ArrayList<>(listLength); int random = ThreadLocalRandom.current().nextInt(groupNum); for (int i = random; i < invokers.size(); i = i + groupNum) { result.add(invokers.get(i)); } return result; } 五、优化效果 针对优化前和优化后,我们编写Demo工程分别压测了不配置路由/配置就近+标签路由场景。Provider节点梯度设置100/500/1000/2000/5000,TPS在1000左右,记录了主机的cpu等性能指标,并打印火焰图。发现,配置路由后,采用相同并发,优化后的版本tps明显高于优化前版本,且新版本相较于没有配置路由时tps显著提高,下游节点数大于2000时,tps提升达到100%以上,下游节点数越多,AvgCpu优化效果越明显,并且路由及负载均衡CPU占比明显更低,详细数据可见下表: 备注:-tag,表示显式禁用原生Dubbo应用级标签路由。该路由默认开启。 六、总结 经过我们关闭不必要的路由逻辑、对路由缓存+异步化计算、新增分组路由等优化后,Dubbo在负载均衡及路由模块整体的性能有了显著的提升,为业务方节省了不少CPU资源。在正常业务场景下当提供方数量达到2000及以上时,tps提升可达100%以上,消费方平均CPU使用率下降约27%,且提供方数量越多优化效果越明显。但是我们也发现当前的随机负载均衡依然还是会消耗一定的CPU资源,且只能保证流量是均衡的。当前我们的应用基本部署在虚拟机及容器上。这两者均存在超卖的状况,且同等配置的宿主机性能存在较大差异等问题。最终会导致部分请求超时、无法最大化利用提供方的资源。我们下一步将会引入Dubbo 3.2的自适应负载均衡并进行调优减少其CPU使用率波动较大的问题,其次我们自身也扩展了基于CPU负载均衡的单一因子算法,最终实现不同性能的机器CPU负载趋于均衡,最大程度发挥集群整体的性能。 参考资料: Dubbo 负载均衡 Dubbo 流量管控 Dubbo 3 StateRouter:下一代微服务高效流量路由 END 猜你喜欢 记一次Redis Cluster Pipeline导致的死锁问题 深入理解Netty FastThreadLocal MySQL到TiDB:Hive Metastore横向扩展之路 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | POSIX 真的不适合对象存储吗?

最近,留意到 MinIO 官方博客的一篇题为“在对象存储上实现 POSIX 访问接口是坏主意”的文章,作者以 S3FS-FUSE 为例分享了通过 POSIX 方式访问 MinIO 中的数据时碰到了性能方面的困难,性能远不如直接访问 MinIO。在对结果进行分析时,作者认为是 POSIX 本身存在的缺陷导致的性能问题。这个结论与我们既有经验有一定出入。 我们知道 POSIX 是一个有用而且广泛应用的标准,遵循它而开发的程序可以保证不同操作系统之间的兼容性和可移植性。各行各业中常用的业务系统和应用程序,大多遵循 POSIX 标准。 随着云计算、大数据、人工智能等技术的发展和数据存储量的攀升,本地化应用也逐渐产生对对象存储等弹性存储的需求,MinIO 等对象存储虽然提供了各种语言的 SDK,但许多传统应用很难甚至无法修改代码去适配对象存储的访问接口,这促使很多存储产品在对象存储的基础上去实现 POSIX 接口来满足这样的刚性需求。 业内在对象存储上实现 POSIX 接口的产品有很多,比如 Ceph、JuiceFS、Weka 等,它们都有广泛的用户群和大量的成功案例,在性能方面也都有不错的表现。 诚然,我们认可 POSIX 存在较大的复杂性,需要付出很大的努力才能解决好相关的问题,但这些问题并不是无法解决。抱着尊重和求证的态度,我搭建了测试环境,采用相同的样本和测试方法,进行了一番验证。 测试项目 为了得到更为全面的测试结果,我将 JuiceFS 引入了对比。 JuiceFS 是开源的云原生分布式文件系统,它采用对象存储作为数据存储层,采用独立的数据库存储元数据。提供了包括 POSIX API、S3 API、CSI Driver、HDFS API、WebDAV 在内的多种访问方式,具有独特的数据分块、缓存和并发读写机制。JuiceFS 是文件系统,与 s3fs-fuse 等只提供简单的从对象存储到 POSIX 协议转换的工具有着本质的不同。 通过将 JuiceFS 引入对比,可以更为客观地求证以对象存储为底层实现 POSIX 等协议的利弊。 在本文中,我会对 MinIO、JuiceFS 和 s3fs-fuse 进行以下两项测试: 10GB 大文件的写入测试 Pandas 小文件覆盖写测试 在底层存储方面,它们均使用部署在独立服务器上的 MinIO 实例;在测试样本方面,10GB 文件会采用那篇文章中使用的 csv 文件。 本文所提及的环境、软件、脚本、样本数据等均提供完整的代码和说明,确保读者可以复现环境和测试结果。 服务器及测试环境准备 两台配置相同的云服务器: System: Ubuntu 22.04 x64 CPU: 8 cores RAM: 16GB SSD: 500GB Network: VPC 每台服务器的信息如下: Server IP For Server A 172.16.254.18 MinIO Instance Server B 172.16.254.19 Test Environment Server A 的准备工作 1.我在 Server A 上通过 Docker 部署了 MinIO,命令如下: # 创建并进入专用目录 mkdir minio && cd minio # 创建配置文件 mkdir config touch config/minio config/minio 文件中写入以下信息: MINIO_ROOT_USER=admin MINIO_ROOT_PASSWORD=abc123abc MINIO_VOLUMES="/mnt/data" 2.创建 MinIO 容器: sudo docker run -d --name minio \ -p 9000:9000 \ -p 9090:9090 \ -v /mnt/minio-data:/mnt/data \ -v ./config/minio:/etc/config.env \ -e "MINIO_CONFIG_ENV_FILE=/etc/config.env" \ --restart unless-stopped \ minio/minio server --console-address ":9090" 3.在 MinIO 的 Web Console 中预先创建三个 buckets: Bucket Name 目的 test-minio 用于测试 MinIO test-juicefs 用于测试 JuiceFS test-s3fs 用于测试 s3fs-fuse Server B 的准备工作 下载 10GB 测试样本文件 curl -LO https://data.cityofnewyork.us/api/views/t29m-gskq/rows.csv?accessType=DOWNLOAD 2.安装 mc 客户端 mc 是 MinIO 项目开发的命令行文件管理器,可以在 Linux 命令行读写本地以及 S3 兼容的对象存储。mc 的 cp 命令可以实时显示数据拷贝的进度和速度,便于观察各项测试。 注:为了保持测试的公平性,三种方案均采用 mc 进行写测试。 # 下载 mc wget https://dl.min.io/client/mc/release/linux-amd64/mc # 检查版本 mc -v mc version RELEASE.2023-09-20T15-22-31Z (commit-id=38b8665e9e8649f98e6162bdb5163172e6ecc187) Runtime: go1.21.1 linux/amd64 # 安装 mc sudo install mc /usr/bin # 为 MinIO 添加别名 mc alias set my http://172.16.254.18:9000 admin abc123abc 3.安装 s3fs-fuse sudo apt install s3fs # 检查版本 s3fs --version Amazon Simple Storage Service File System V1.93 (commit:unknown) with OpenSSL # 设置对象存储访问密钥 echo admin:abc123abc > ~/.passwd-s3fs # 修改密钥文件权限 chmod 600 ~/.passwd-s3fs # 创建挂载目录 mkdir mnt-s3fs # 挂载对象存储 s3fs test-s3fs:/ /root/mnt-s3fs -o url=http://172.16.254.18:9000 -o use_path_request_style 4.安装 JuiceFS 这里使用官方提供的脚本安装最新的 JuiceFS 社区版 # 一键安装脚本 curl -sSL https://d.juicefs.com/install | sh - # 检查版本 juicefs version juicefs version 1.1.0+2023-09-04.08c4ae6 JuiceFS 是文件系统,需要先创建才能使用。除了对象存储,还需要一个数据库作为元数据引擎,支持多种数据库,这里使用较常用的 Redis 作为元数据引擎。 注:我在这里将 Redis 安装在 Server A,通过 172.16.254.18:6379 进行访问,无密码,安装过程略,详情参考 Redis 官方文档。 # 创建文件系统 juicefs format --storage minio \ --bucket http://172.16.254.18:9000/test-juicefs \ --access-key admin \ --secret-key abc123abc \ --trash-days 0 \ redis://172.16.254.18/1 \ myjfs 5.另外,我会同时以较为常用的 POSIX 和 S3 API 两种方式访问 JuiceFS 并分别测试它们的性能。 # 创建挂载目录 mkdir ~/mnt-juicefs # 以 POSIX 方式挂载文件系统 juicefs mount redis://172.16.254.18/1 /root/mnt-juicefs # 以 S3 API 方式访问文件系统 export MINIO_ROOT_USER=admin export MINIO_ROOT_PASSWORD=abc123abc juicefs gateway redis://172.16.254.18/1 0.0.0.0:9000 # 在 mc 中为 JuiceFS S3 API 添加别名 mc alias set juicefs http://172.16.254.18:9000 admin abc123abc 注:JuiceFS Gateway 也可以部署在 Server A 或其他任何可联网服务器上,因为它开放的是基于网络访问的 S3 API。 测试及结果 测试一:10GB 文件写入测试 这项测试用来评估写大文件的性能,耗时越短性能越好。这里会使用 time 命令统计写入耗时,结果会包含三个指标: real:从命令开始到结束的实际时间。它包括了所有的等待时间,例如等待 I/O 操作完成、等待进程切换、等待资源等。 user:在用户态(用户模式)执行的时间,也就是 CPU 用于执行用户代码的时间。它通常表示命令的计算工作量。 sys:在内核态(系统模式)执行的时间,也就是 CPU 用于执行内核代码的时间。它通常表示命令与系统调用(如文件 I/O、进程管理等)相关的工作量。 MinIO # 执行拷贝测试 time mc cp ./2018_Yellow_Taxi_Trip_Data.csv my/test-minio/ MinIO 直写 10 GB 文件的测试结果: real 0m27.651s user 0m10.767s sys 0m5.439s s3fs-fuse # 执行拷贝测试 time mc cp ./2018_Yellow_Taxi_Trip_Data.csv /root/mnt-s3fs/ s3fs-fuse 写 10 GB 文件的测试结果: real 3m6.380s user 0m0.012s sys 0m5.459s 注:虽然写入耗时 3 分零 6 秒,但并没有出现那篇文章所谓写入失败的情况。 JuiceFS POSIX 和 S3 API 分别测试 JuiceFS 的 POSIX 和 S3 API 的大文件写性能: # POSIX 写测试 time mc cp ./2018_Yellow_Taxi_Trip_Data.csv /root/mnt-juicefs/ # S3 API 写测试 time mc cp ./2018_Yellow_Taxi_Trip_Data.csv juicefs/myjfs/ JuiceFS POSIX 写 10 GB 文件的测试结果: real 0m28.107s user 0m0.292s sys 0m6.930s JuiceFS S3 API 写 10GB 文件的测试结果: real 0m28.091s user 0m13.643s sys 0m4.142s 大文件写结果总结 从测试结果来看,直接写 MinIO 和 JuiceFS 的性能相当,均可在 30s 内完成,而 s3fs-fuse 写入 10GB 文件耗时 3 分钟以上,平均比前两者慢了 6 倍左右。 在写入大文件时,mc 会使用 Multipart API 来将文件分块上传到 S3 接口,而只能单线程写入到 POSIX。JuiceFS 在大文件的顺序写也会自动将文件分块并并发写入到 MinIO 中,因此与直接写 MinIO 性能相当。而 S3FS 默认先是单线程写入到缓存盘,然后再分块写入到 MinIO 中,这会耗费更多写入时间。 按照写 10GB 文件耗时 30 秒计算,平均速度为 333 MB/s,这是云服务器 SSD 的带宽限制,测试结果表明,MinIO 和 JuiceFS 都能打满本地 SSD 的带宽,它们的性能会随着服务器云盘和网络带宽的提升而提升。 测试二:Pandas 小文件覆盖写 这项测试主要用来评估对象存储在小文件覆盖写方面的性能,各个软件的测试脚本略有不同,你可以在这里找到所有脚本代码。 # 获取测试脚本 curl -LO https://gist.githubusercontent.com/yuhr123/7acb7e6bb42fb0ff12f3ba64d2cdd7da/raw/30c748e20b56dec642a58f9cccd7ea6e213dab3c/pandas-minio.py # 执行测试 python3 pandas-minio.py 测试结果: Execution time: 0.83 seconds s3fs-fuse # 获取测试脚本 curl -LO gist.githubusercontent.com/yuhr123/7acb7e6bb42fb0ff12f3ba64d2cdd7da/raw/30c748e20b56dec642a58f9cccd7ea6e213dab3c/pandas-s3fs.py # 执行测试 python3 pandas-s3fs.py 测试结果: Execution time: 0.78 seconds JuiceFS POSIX # 获取测试脚本 curl -LO gist.githubusercontent.com/yuhr123/7acb7e6bb42fb0ff12f3ba64d2cdd7da/raw/30c748e20b56dec642a58f9cccd7ea6e213dab3c/pandas-juicefs-posix.py # 执行测试 python3 pandas-juicefs-posix.py 测试结果: Execution time: 0.43 seconds JuiceFS S3 API # 获取测试脚本 curl -LO https://gist.githubusercontent.com/yuhr123/7acb7e6bb42fb0ff12f3ba64d2cdd7da/raw/30c748e20b56dec642a58f9cccd7ea6e213dab3c/pandas-juicefs-s3api.py # 执行测试 python3 pandas-juicefs-s3api.py 测试结果: Execution time: 0.86 seconds Pandas 小文件覆盖写结果总结 在这项测试中,JuiceFS FUSE-POSIX 的速度最快,几乎是其他方案的 2 倍。MinIO、s3fs-fuse、JuiceFS S3 Gateway 的速度相当。从小文件覆盖写的角度来看,POSIX 接口效率更高,比对象存储接口有更好的性能表现。 测试结果 MinIO S3FS-FUSE JuiceFS (FUSE) JuiceFS (s3 gateway) 10GB 大文件写 0m27.651s 3m6.380s 0m28.107s 0m28.091s Pandas 小文件覆盖写 0.83s 0.78s 0.46s 0.96s 分析和总结 问题一:S3FS 为什么这么慢? 从测试数据可以清楚地看到,写入同样的 10GB 大文件,S3FS 需要 3 分钟,而 MinIO 和 JuiceFS 只需要 30 秒左右,速度相差近 6 倍,这主要是由于不同的技术实现导致的。 s3fs-fuse 在写入文件时,会优先写入本地临时文件,然后以分片方式上传对象存储。如果本地磁盘空间不足,则会以同步的方式上传。因为它需要在本地磁盘和 S3 存储之间进行数据复制,在处理大文件或大量文件时就会导致性能下降。 再者,S3FS 依赖底层对象存储的元数据管理能力,当需要读写大量文件时,频繁地与对象存储交互获取元数据也会对性能产生很大的影响。 简单来说,写入 S3FS 的文件体积和总量越大,相应的性能开销也会成比例地放大。 问题二:JuiceFS 为什么更快? 同样是通过 FUSE 进行读写,为什么 JuiceFS 可以与 MinIO 一样打满磁盘带宽,而没有像 S3FS 那样出现性能问题呢?这同样也是由技术架构决定的。 在写入文件时,数据虽然也经由 FUSE 层处理,但 JuiceFS 通过高并发、缓存、数据分块等技术降低了与底层对象存储之间的通信开销,一次性处理更多文件的读写请求,从而减少了等待时间和传输延迟。 另外,JuiceFS 采用独立的数据库(在本文中使用了 Redis)管理元数据,当文件量特别大时,独立的元数据引擎能有效释放压力,可以更快地定位文件位置。 结论 以上数据表明,把对象存储作为底层,在其上实现 POSIX 接口不一定会损失性能,不论是写大文件还是小文件,JuiceFS 的性能与直接写 MinIO 是相当的,并没有因为访问 POSIX 而损失底层对象存储的性能。而在 Pandas 表格覆盖写方面,JuiceFS FUSE-POSIX 的性能不降反升,超过 MinIO 近两倍。 从测试结果不难发现,某些软件(例如 s3fs-fuse)将 S3 API 与 POSIX 接口相互转换可能会导致对象存储的性能损失,但它不失为一款还算方便的临时访问 S3 的小工具,但要想长期稳定的高性能使用,需要通过更为审慎的调研和验证来选择其他更适的方案。 简单的非结构化文件归档存储,直接使用 MinIO 或云上对象存储是不错的选择。而对于需要进行大规模数据存储和处理,如 AI 模型训练、大数据分析和 Kubernetes 数据持久化等频繁读写的场景,JuiceFS 的独立元数据管理、并发读写和缓存机制会带来更好的性能表现,是更值得尝试的高性能文件系统解决方案。 希望这篇内容能够对你有一些帮助,如果有其他疑问欢迎加入 JuiceFS 社区与大家共同交流。

优秀的个人博客,低调大师

每日一博 | 我在前端写 Java Spring Boot 项目

前言 玩归玩,闹归闹,别拿 C端 开玩笑! 这里不推荐大家把Node服务作为C端服务,毕竟它是单线程多任务 机制。 这一特性是 Javascript 语言设计之初,就决定了它的使命 - Java >>>【Script】,这里就不多解释了,大家去看看 JavaScript 的历史就知道啦~这也就决定了,它不能像后端语言那样 多线程多任务,用户访问量小还能承受,一旦承受访问量大高并发,就得凉凉~ 那为什么我们还要去写 Node 服务? 主要是方便快捷,对于小项目可以迅速完成建设,开发成本小。 其次,主要通过写 Nest 完成下面收获: 学习装饰器语法,感受其简洁优美; 自己学习一门新的开发框架,感受不同框架的优缺点,为以后开发选型打基础; 感受服务端排查问题的复杂性,找找前端设计的灵感。 本篇文章主要是使用 NestJs + Sequelize + MySQL 完成基础运行, 带大家了解 Node 服务端的基础搭建,也可以顺便看看 Java SpringBoot 项目的基础结构,它俩真的非常相似,不信你去问服务端开发同学。 养成好习惯,看文章先一键三连~【点赞,关注,转发】,评论可以看完再吐槽~继续完善填坑~ 第一步、项目跑起来 在选择服务端的时候,我之前使用过 Egg.js ,所以这次就不选它了。其次,Egg 也是继承了 Koa 的开发基础,加上 Express 也是基于 Koa 上创新的,两者应该差不多,就不选择 Koa 和 Express 。 所以,我想尝试下 Nest.js 看语法跟 Java 是一样的,加上之前也自己开发过 Java + SpringBoot 的项目,当然更古老的 SSH 2.0 也从无到有搭建过,即:Spring2.0 + Struts2+ Hibernate3.2,想想应该会很容易上手,顺便怀旧下写写。 参考文档: https://www.geeksforgeeks.org/best-nodejs-frameworks-for-app-development/ https://anywhere.epam.com/business/best-node-js-frameworks 说下我的想法,首先我们刚入门,估计会有一堆不清楚的坑,我们先简单点,后续我们再继续加深。既然要搞服务端,要搞就多搞点,我们都去尝鲜玩玩。我们打算使用 Nest 作为前端框架,Graphql 作为中间处理层。底层数据库我们用传统的 MySQL,比较稳定可靠,而且相对比较熟悉,这个就不玩新的了,毕竟数据库是一切的基石 。 说下我们具体实现步骤: 1. 【必须】没有任何数据库,完成接口请求运行,能够跑起来; 2. 【必须】创建基础数据库 MySQL ,接入 @nestjs/sequelize 库 完成 增删改查 功能即:CRUD 3. 【可选】打算采取 Graphql 处理 API 查询,做到精确数据查询,这个已经火了很多了,但是真正使用的很少,我们打算先感受下,后续可以直接用到业务。 4. 【可选】接入 Swagger 自动生成 API 文档,快捷进行前端与后端服务联调测试。 ◦ Swagger是一个开源工具,用于设计、构建、记录和使用RESTful web服务。 5. 【可选】接口请求,数据库优化处理 ◦ 请求分流,数据库写入加锁,处理并发流程 ◦ 增加 middleware 中间件统一处理请求及响应,进行鉴权处理,请求拦截等操作 ◦ 数据库分割备份,数据库融灾处理,分为:主、备、灾 ◦ 数据库读写分离,数据双写,建立数据库缓存机制,使用 redis 处理 也欢迎大家补充更多的优化点,我们一起探讨~有兴趣可以帮忙补充代码哈~ 确定了大概方向,我们就开始整。先不追求一步到位,否则越多越乱,锦上添花的东西,我们可以后续增加,基础功能我们要优先保障完成。Nest.js 官网:https://docs.nestjs.com/ ,话不多说,我们直接开整。 # 进入文件夹目录 cd full-stack-demo/packages # 安装脚手架 npm i -g @nestjs/cli # 创建基础项目 nest new node-server-demo # 进入项目 cd new node-server-demo # 运行项目测试 npm run start:dev 我们移除一些不需要的东西,先简单再复杂,别把自己搞晕了。接下来写一个简单示例感受下这个框架,之后完整的代码,我会公布在后面。废话不多说,开整!调整后目录结构: • common - 公用方法类 • config - 配置类文件 • controller - 控制器,用于处理前端发起的各类请求 • service - 服务类,用于处理与数据库交互逻辑 • dto - DTO(Data Transfer Object)可以用于验证输入数据、限制传输的字段或格式。 • entities - 实体类,用于描述对象相关的属性信息 • module - 模块,用于注册所有的服务类、控制器类,类似 Spring 里面的 bean ◦ 这里不能完全等同哈,两个实现机制上就不同,只是帮助大家理解。 • main.ts - nest 启动入口 • types - typescript 相关声明类型   只是写 demo, 搞快点就没有怎么写注释了,我感觉是一看就懂了,跟 Java SpringBoot 的写法非常一致,部分代码展示: 控制器 controller // packages/node-server-demo/src/controller/user/index.ts import { Controller, Get, Query } from '@nestjs/common'; import UserServices from '@/service/user'; import { GetUserDto, GetUserInfoDto } from '@/dto/user'; @Controller('user') export class UserController { constructor(private readonly userService: UserServices) {} // Get 请求 user/name?name=bricechou @Get('name') async findByName(@Query() getUserDto: GetUserDto) { return this.userService.read.findByName(getUserDto.name); } // Get 请求 user/info?id=123 @Get('info') async findById(@Query() getUserInfoDto: GetUserInfoDto) { const user = await this.userService.read.findById(getUserInfoDto.id); return { gender: user.gender, job: user.job }; } } // packages/node-server-demo/src/controller/log/add.ts import { Controller, Post, Body } from '@nestjs/common'; import { AddLogDto } from '@/dto/log'; import LogServices from '@/service/log'; @Controller('log') export class CreateLogController { constructor(private readonly logServices: LogServices) {} // post('/log/add') @Post('add') create(@Body() createLogDto: AddLogDto) { return this.logServices.create.create(createLogDto); } } 数据转换 Data Transfer Object // packages/node-server-demo/src/dto/user.ts export class CreateUserDto { name: string; age: number; gender: string; job: string; } // 可以分开写,也可以合并 export class GetUserDto { id?: number; name: string; } // 可以分开写,也可以合并 export class GetUserInfoDto { id: number; } service 数据库交互处理类 // packages/node-server-demo/src/service/user/read.ts import { Injectable } from '@nestjs/common'; import { User } from '@/entities/User'; @Injectable() export class ReadUserService { constructor() {} async findByName(name: string): Promise<User> { // 可以处理判空,从数据库读取/写入数据,可能会被多个 controller 进行调用 console.info('ReadUserService findByName > ', name); return Promise.resolve({ id: 1, name, job: '程序员', gender: 1, age: 18 }); } async findById(id: number): Promise<User> { console.info('ReadUserService findById > ', id); return Promise.resolve({ id: 1, name: 'BriceChou', job: '程序员', gender: 1, age: 18, }); } } module 模块注册,服务类/控制类 // packages/node-server-demo/src/module/user.ts import { Module } from '@nestjs/common'; import UserService, { ReadUserService } from '@/service/user'; import { UserController } from '@/controller/user'; @Module({ providers: [UserService, ReadUserService], controllers: [UserController], }) export class UserModule {} // packages/node-server-demo/src/module/index.ts 根模块注入 import { Module } from '@nestjs/common'; import { UserModule } from './user'; import { LogModule } from './log'; @Module({ imports: [ UserModule, LogModule, ], }) export class AppModule {} main.js 启动注册的所有类 // packages/node-server-demo/src/main.ts import { AppModule } from '@/module'; import { NestFactory } from '@nestjs/core'; import { NestExpressApplication } from '@nestjs/platform-express'; async function bootstrap() { const app = await NestFactory.create<NestExpressApplication>(AppModule); // 监听端口 3000 await app.listen(3000); } bootstrap(); 这样一个单机的服务器就启动起来了,我们可以使用 Postwoman [https://hoppscotch.io/] 进行请求,瞅瞅看返回效果。   控制台也收到日志了,后面可以把这些日志请求保留成 .log 文件,这样请求日志也有了,完美!下一步,我们开始连接数据库,这样就不用单机玩泥巴了~ 第二步、配置 MySQL MySQL 安装其实很简单,我电脑是 Mac 的,所以下面的截图都是以 mac 为例,先下载对应的数据库。 下载地址:https://dev.mysql.com/downloads/mysql/ 至于其他系统的,可以网上找教程,这个应该烂大街了,我就不重复搬运教程了。 注意:安装的数据库,一定要设置密码,连接数据库必须要有密码,否则会导致连接数据库失败。 MySQL 我们只安装数据库就行,熟悉指令的童鞋,就直接命令行操作就行。 不熟悉的话,那就下载图形化管理工具。 ◦ Mysql 官方控制台 https://dev.mysql.com/downloads/workbench/ ◦ Windows 也可以使用 https://www.heidisql.com/download.php?download=installer PS:安装 workbench 时发现要求 MacOS 13以上,我的电脑是 MacOS 12。 白白下载,所以只能 https://downloads.mysql.com/archives/workbench/ 从归档里面找低版本 8.0.31。对于数据库服务也有版本要求,大家按照自己电脑版本,选择支持的版本即可。 https://downloads.mysql.com/archives/community/。我这边选择的是默认最新版本:8.0.34,下载好直接安装,一路 Next 到底,记住自己输入的 Root 密码!!! 确认好当前数据库是否已经运行起来了,启动 Workbench 查看状态。  1.创建数据库 数据库存在字符集选择,不同的字符集和校验规则,会对存储数据产生影响,所以大家可以自行查询,按照自己存储数据原则选择,我这里默认选最广泛的。确认好,就选择右下角的应用按钮。 2. 创建表和属性  选项解答: • PRIMARY KEY 是表中的一个或多个列的组合,它用于唯一标识表中的每一行。 • Not NULL 和 Unique 就不解释,就是直译的那个意思。 • GENERATED 生成列是表中的一种特殊类型的列,它的值不是从插入语句中获取的,而是根据其他列的值通过一个表达式或函数生成的。 CREATE TABLE people ( first_name VARCHAR(100), last_name VARCHAR(100), full_name VARCHAR(200) AS (CONCAT(first_name, ' ', last_name)) ); UNSIGNED 这个数值类型就只能存储正数(包括零),不会存储负数。 ZEROFILL 将数值类型的字段的前面填充零,他会自动使字段变为 UNSIGNED,直到该字段达到声明的长度,如:00007 BINARY 用于存储二进制字符串,如声明一个字段为 BINARY(5),那么存储在这个字段中的字符串都将被处理为长度为 5 的二进制字符串。 ◦ 如尝试存储一个长度为 3 的字符串,那么它将在右侧用两个空字节填充。 ◦ 如果你尝试存储一个长度为 6 的字符串,那么它将被截断为长度为 5 ◦ 主要用途是存储那些需要按字节进行比较的数据,例如加密哈希值 此外也可顺手传创建一个索引,方便快速查找。 CREATE TABLE `rrweb`.`test_sys_req_log` ( `id` INT UNSIGNED NOT NULL AUTO_INCREMENT, `content` TEXT NOT NULL, `l_level` INT UNSIGNED NOT NULL, `l_category` VARCHAR(255) NOT NULL, `l_created_at` TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP, `l_updated_at` TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP, PRIMARY KEY (`id`), UNIQUE INDEX `id_UNIQUE` (`id` ASC) VISIBLE, INDEX `table_index` (`l_level` ASC, `l_category` ASC, `l_time` ASC) VISIBLE); 3. 连接数据库 由于目前 node-oracledb 官方尚未提供针对 Apple Silicon 架构的预编译二进制文件。导致我们无法在 Mac M1 芯片上使用 TypeORM 链接数据库操作,它目前只支持 Mac x86 芯片。哎~折腾老半天,查阅各种文档,居然有这个坑,没关系我们换个方式打开。 我们不得不放弃,从而选用 https://docs.nestjs.com/techniques/database#sequelize-integration 哐哐哐~一顿操作猛如虎,盘它! 安装 Sequelize # 安装连接库 npm install --save @nestjs/sequelize sequelize sequelize-typescript mysql2 # 安装 type npm install --save-dev @types/sequelize 配置数据库基础信息 // packages/node-server-demo/src/module/index.ts import { Module } from '@nestjs/common'; import { UserModule } from './user'; import { LogModule } from './log'; import { Log } from '@/entities/Log'; import { SequelizeModule } from '@nestjs/sequelize'; @Module({ imports: [ SequelizeModule.forRoot({ dialect: 'mysql', // 按数据库实际配置 host: '127.0.0.1', // 按数据库实际配置 port: 3306, // 按数据库实际配置 username: 'root', // 按数据库实际配置 password: 'hello', // 按数据库实际配置 database: 'world', synchronize: true, models: [Log], autoLoadModels: true, }), LogModule, UserModule, ], }) export class AppModule {} 实体与数据库一一映射处理 import { getNow } from '@/common/date'; import { Model, Table, Column, PrimaryKey, DataType, } from 'sequelize-typescript'; @Table({ tableName: 'test_sys_req_log' }) export class Log extends Model<Log> { @PrimaryKey @Column({ type: DataType.INTEGER, autoIncrement: true, field: 'id', }) id: number; @Column({ field: 'content', type: DataType.TEXT }) content: string; @Column({ field: 'l_level', type: DataType.INTEGER }) level: number; // 3严重,2危险,1轻微 @Column({ field: 'l_category' }) category: string; // 模块分类/来源分类 @Column({ field: 'l_created_at', type: DataType.NOW, defaultValue: getNow(), }) createdAt: number; @Column({ field: 'l_updated_at', type: DataType.NOW, defaultValue: getNow(), }) updatedAt: number; } module 注册实体 // packages/node-server-demo/src/module/log.ts import { Module } from '@nestjs/common'; import { SequelizeModule } from '@nestjs/sequelize'; import { Log } from '@/entities/Log'; import LogServices, { CreateLogService, UpdateLogService, DeleteLogService, ReadLogService, } from '@/service/log'; import { CreateLogController, RemoveLogController, UpdateLogController, } from '@/controller/log'; @Module({ imports: [SequelizeModule.forFeature([Log])], providers: [ LogServices, CreateLogService, UpdateLogService, DeleteLogService, ReadLogService, ], controllers: [CreateLogController, RemoveLogController, UpdateLogController], }) export class LogModule {} service 操作数据库处理数据 import { Log } from '@/entities/Log'; import { Injectable } from '@nestjs/common'; import { AddLogDto } from '@/dto/log'; import { InjectModel } from '@nestjs/sequelize'; import { ResponseStatus } from '@/types/BaseResponse'; import { getErrRes, getSucVoidRes } from '@/common/response'; @Injectable() export class CreateLogService { constructor( @InjectModel(Log) private logModel: typeof Log, ) {} async create(createLogDto: AddLogDto): Promise<ResponseStatus<null>> { console.info('CreateLogService create > ', createLogDto); const { level = 1, content = '', category = 'INFO' } = createLogDto || {}; const str = content.trim(); if (!str) { return getErrRes(500, '日志内容为空'); } const item = { level, category, // Tips: 为防止外部数据进行数据注入,我们可以对内容进行 encode 处理。 // content: encodeURIComponent(str), content: str, }; await this.logModel.create(item); return getSucVoidRes(); } } 一路操作猛如虎,回头一看嘿嘿嘿~终于,我们收到了来自外界的第一条数据! hello world!   连接及创建数据成功!此时已经完成基础功能啦~ 第三步、实现 CRUD 基础功能 剩下的内容,其实大家可以自行脑补了,就是调用数据库的操作逻辑。先说说什么是 CRUD C create 创建 R read 读取 U update 更新 D delete 删除 下面给个简单示例,大家看看,剩下就去找文档,实现业务逻辑即可: import { Injectable } from '@nestjs/common'; import { InjectModel } from '@nestjs/sequelize'; import { User } from './user.model'; @Injectable() export class UserService { constructor( @InjectModel(User) private userModel: typeof User, ) {} // 创建新数据 async create(user: User) { const newUser = await this.userModel.create(user); return newUser; } // 查找所有数据 async findAll() { return this.userModel.findAll(); } // 按要求查找单个 async findOne(id: string) { return this.userModel.findOne({ where: { id } }); } // 按要求更新 async update(id: string, user: User) { await this.userModel.update(user, { where: { id } }); return this.userModel.findOne({ where: { id } }); } // 按要求删除 async delete(id: string) { const user = await this.userModel.findOne({ where: { id } }); await user.destroy(); } } Tips: 进行删除的时候,我们可以进行假删除,两个数据库,一个是备份数据库,一个是主数据库。主数据库可以直接删除或者增加标识表示删除。备份数据库,可以不用删除只写入和更新操作,这样可以进行数据还原操作。 此外,为了防止 SQL 数据库注入,大家需要对数据来源进行统一校验处理或者直接进行 encode 处理,对于重要数据可以直接进行 MD5 加密处理,防止数据库被直接下载泄露。关于 SQL 数据库的安全处理,网上教程有很多,大家找一找就可以啦~ 部署就比较简单了,我们就不需要一一赘述了,数据库可以用集团提供的云数据库,而 Nest 就是普通的 node 部署。 作者:京东零售 周明亮 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

每日一博 | MySQL 到 TiDB:Hive Metastore 横向扩展之路

作者:vivo 互联网大数据团队 - Wang Zhiwen 本文介绍了vivo在大数据元数据服务横向扩展道路上的探索历程,由实际面临的问题出发,对当前主流的横向扩展方案进行了调研及对比测试,通过多方面对比数据择优选择TiDB方案。其次分享了整个扩展方案流程、实施遇到的问题及解决方案,对于在大数据元数据性能上面临同样困境的开发者本篇文章具有非常高的参考借鉴价值。 一、背景 大数据元数据服务Hive Metastore Service(以下简称HMS),存储着数据仓库中所依赖的所有元数据并提供相应的查询服务,使得计算引擎(Hive、Spark、Presto)能在海量数据中准确访问到需要访问的具体数据,其在离线数仓的稳定构建上扮演着举足轻重的角色。vivo离线数仓的Hadoop集群基于CDH 5.14.4版本构建,HMS的版本选择跟随CDH大版本,当前使用版本为1.1.0-cdh5.14.4。 vivo在HMS底层存储架构未升级前使用的是MySQL存储引擎,但随着vivo业务发展,数据爆炸式增长,存储的元数据也相应的增长到亿级别(PARTITION_PARAMS:8.1亿、 PARTITION_KEY_VALS:3.5亿、PARTITIONS:1.4亿),在如此大量的数据基数下,我们团队经常面临机器资源的性能瓶颈,往往用户多并发的去查询某些大分区表(50w+分区),机器资源的使用率就会被打满,从而导致元数据查询超时,严重时甚至整个HMS集群不可用,此时恢复手段只能暂时停服所有HMS节点,直到MySQL机器负载降下来后在逐步恢复服务。为此,针对当前MySQL方案存在的严重性能瓶颈,HMS急需一套完善的横向扩展方案来解决当前燃眉之急。 二、横向扩展技术方案选型 为解决HMS的性能问题,我们团队对HMS横向扩展方案做了大量的调研工作,总体下来业内在HMS的横向扩展思路上主要分为对MySQL进行拆库扩展或用高性能的分布式引擎替代MySQL。在第一种思路上做的比较成熟的方案有Hotels.com公司开源的Waggle Dance,实现了一个跨集群的Hive Metastore代理网关,他允许用户同时访问多个集群的数据,这些集群可以部署在不同的平台上,特别是云平台。第二种思路当前主流的做法是用分布式存储引擎TiDB替换传统的MySQL引擎,在Hive社区中有不少公司对hive 2.x接入TiDB做了大量的测试并应用到生产中(详情点击)。 2.1 Waggle Dance Waggle-dance向用户提供统一的入口,将来自Metastore客户端的请求路由到底层对应的Metastore服务,同时向用户隐藏了底层的Metastore分布,从而在逻辑层面整合了多个Metastore的Hive库表信息。Waggle-dance实现了Metastore的Thrift API,客户端无需改动,对用户来说,Waggle-dance就是一个Metastore。其整体架构如下: Waggle Dance架构 从Waggle-dance的架构中最突出的特性是其采用了多个不同的MySQL实例分担了原单MySQL实例的压力,除此之外其还有如下优势: 用户侧可以沿用Metastore客户端的用法,配置多台Waggle-dance的连接,在当前Waggle-dance连接服务不可用的时候切换到其他的Waggle-dance服务上。 Waggle-dance只需几秒即可启动,加上其无状态服务的特性,使得Waggle-dance具备高效的动态伸缩性,可以在业务高峰期快速上线新的服务节点分散压力,在低峰期下线部分服务节点释放资源。 Waggle-dance作为一个网关服务,除了路由功能外,还支持后续的定制化开发和差异化部署,平台可根据需要添加诸如鉴权、防火墙过滤等功能。 2.2 TiDB TiDB 是 PingCAP 公司自主设计、研发的开源分布式关系型数据库,是一款同时支持在线事务处理与在线分析处理 (Hybrid Transactional and Analytical Processing, HTAP) 的融合型分布式数据库产品,具备水平扩容或者缩容、金融级高可用、实时 HTAP、云原生的分布式数据库、兼容 MySQL 5.7 协议和 MySQL 生态等重要特性。在TiDB 4.x版本中,其性能及稳定性较与之前版本得到了很大的提升并满足HMS的元数据查询性能需求。故我们对TiDB也做了相应的调研及测试。结合HMS及大数据生态,采用TiDB作为元数据存储整体的部署架构如下: HMS on TiDB架构 由于TiDB本身具有水平扩展能力,扩展后能均分查询压力,该特性就是我们解决HMS查询性能瓶颈的大杀器。除此外该架构还有如下优势: 用户无需任何改动;HMS侧面没有任何改动,只是其依赖的底层存储发生变化。 不破坏数据的完整性,无需将数据拆分多个实例来分担压力,对HMS来说其就是一个完整、独立的数据库。 除引入TiDB作为存储引擎外,不需要额外的其他服务支撑整个架构的运行。 2.3 TiDB和Waggle Dance对比 前面内容对Waggle-dance方案和TiDB方案做了简单的介绍及优势总结,以下列举了这两个方案在多个维度的对比: 通过上述多个维度的对比,TiDB方案在性能表现、水平扩展、运维复杂度及机器成本上都优于waggle-dance方案,故我们线上选择了前者进行上线应用。 三、TiDB上线方案 选择TiDB引擎替代原MySQL存储引擎,由于TiDB与MySQL之间不能做双主架构,在切换过程中HMS服务须完全停服后并重新启动切换至TiDB,为保障切换过程顺利及后面若有重大问题发生能及时回滚,在切换前做了如下数据同步架构以保障切换前MySQL与TiDB数据一致以及切换后仍有MySQL兜底。 TiDB&MySQL上线前后数据同步架构 在上述架构中,切换前唯一可写入的数据源只有源数据库主库,其他所有TiDB、MySQL节点都为只读状态,当且仅当所有HMS节点停服后,MySQL源数据库从库及TiDB源数据库主库的数据同步最大时间戳与源数据库主库一致时,TiDB源数据库主库才开放可写入权限,并在修改HMS底层存储连接串后逐一拉起HMS服务。 在上述架构完成后,即可开始具体的切换流程,切换整体流程如下: HMS切换底层存储流程 其中在保障源MySQL与TiDB数据正常同步前,需要对TiDB做以下配置: tidb_skip_isolation_level_check需要配置为1 ,否则启动HMS存在MetaException异常。 tidb_txn_mode需配置为pessimistic ,提升事务一致性强度。 事务大小限制设置为3G,可根据自己业务实际情况进行调整。 连接限制设置为最大3000 ,可根据自己业务实际情况进行调整。 此外在开启sentry服务状态下,需确认sentry元数据中NOTIFICATION_ID的值是否落后于HMS元数据库中NOTIFICATION_SEQUENCE表中的NEXT_EVENT_ID值,若落后需将后者替换为前者的值,否则可能会发生建表或创建分区超时异常。 以下为TiDB方案在在不同维度上的表现: 在对HQL的兼容性上TiDB方案完全兼容线上所有引擎对元数据的查询,不存在语法兼容问题,对HQL语法兼容度达100% 在性能表现上查询类接口平均耗时优于MySQL,性能整体提升15%;建表耗时降低了80%,且支持更高的并发,TiDB性能表现不差于MySQL 在机器资源使用情况上整体磁盘使用率在10%以下;在没有热点数据访问的情况下,CPU平均使用率在12%;CPU.WAIT.IO平均值在0.025%以下;集群不存在资源使用瓶颈。 在可扩展性上TiDB支持一键水平扩缩容,且内部实现查询均衡算法,在数据达到均衡的情况下各节点可平摊查询压力。 在容灾性上TiDB Binlog技术可稳定支撑TiDB与MySQL及TiDB之间的数据同步,实现完整的数据备份及可回退选择。 在服务高可用性上TiDB可选择LVS或HaProxy等服务实现负载均衡及故障转移。 以下为上线后HMS主要API接口调用耗时情况统计: (左右滑动,查看更多···) 四、问题及解决方案 4.1 在模拟TiDB回滚至MySQL过程中出现主键冲突问题 在TiDB数据增长3倍后,切换回MySQL出现主键重复异常,具体日志内容如下: 主键冲突异常日志 产生该问题的主要原因为每个 TiDB 节点在分配主键ID时,都申请一段 ID 作为缓存,用完之后再去取下一段,而不是每次分配都向存储节点申请。这意味着,TiDB的AUTO_INCREMENT自增值在单节点上能保证单调递增,但在多个节点下则可能会存在剧烈跳跃。因此,在多节点下,TiDB的AUTO_INCREMENT自增值从全局来看,并非绝对单调递增的,也即并非绝对有序的,从而导致Metastore库里的SEQUENCE_TABLE表记录的值不是对应表的最大值。 造成主键冲突的主要原因是SEQUENCE_TABLE表记录的值不为元数据中实际的最大值,若存在该情况在切换回MySQL后就有可能生成已存在的主键导致初见冲突异常,此时只需将SEQUENCE_TABLE里的记录值设置当前实际表中的最大值即可。 4.2 PARTITION_KEY_VALS的索引取舍 在使用MySQL引擎中,我们收集了部分慢查询日志,该类查询主要是查询分区表的分区,类似如下SQL: #以下查询为查询三级分区表模板,且每级分区都有过来条件SELECT PARTITIONS.PART_IDFROM PARTITIONS INNER JOIN TBLS ON PARTITIONS.TBL_ID = TBLS.TBL_ID AND TBLS.TBL_NAME = '${TABLE_NAME}' INNER JOIN DBS ON TBLS.DB_ID = DBS.DB_ID AND DBS.NAME = '${DB_NAME}' INNER JOIN PARTITION_KEY_VALS FILTER0 ON FILTER0.PART_ID = PARTITIONS.PART_ID AND FILTER0.INTEGER_IDX = ${INDEX1} INNER JOIN PARTITION_KEY_VALS FILTER1 ON FILTER1.PART_ID = PARTITIONS.PART_ID AND FILTER1.INTEGER_IDX = ${INDEX2} INNER JOIN PARTITION_KEY_VALS FILTER2 ON FILTER2.PART_ID = PARTITIONS.PART_ID AND FILTER2.INTEGER_IDX = ${INDEX3}WHERE FILTER0.PART_KEY_VAL = '${PART_KEY}' AND CASE WHEN FILTER1.PART_KEY_VAL <> '__HIVE_DEFAULT_PARTITION__' THEN CAST(FILTER1.PART_KEY_VAL AS decimal(21, 0)) ELSE NULL END = 10 AND FILTER2.PART_KEY_VAL = '068'; 在测试中通过控制并发重放该类型的SQL,随着并发的增加,各个API的平均耗时也会增长,且重放的SQL查询耗时随着并发的增加查询平均耗时达到100s以上,虽然TiDB及HMS在压测期间没有出现任何异常,但显然这种查询效率会让用户很难接受。DBA分析该查询没有选择合适的索引导致查询走了全表扫描,建议对PARTITION_KEY_VALS的PARTITION_KEY_VAL字段添加了额外的索引以加速查询,最终该类型的查询得到了极大的优化,即使加大并发到100的情况下平均耗时在500ms内,对此我们曾尝试对PARTITION_KEY_VALS添加上述索引操作。 但在线上实际的查询中,那些没有产生慢查询的分区查询操作其实都是按天分区的进行一级分区查询的,其SQL类似如下: SELECT "PARTITIONS"."PART_ID"FROM "PARTITIONS" INNER JOIN "TBLS" ON "PARTITIONS"."TBL_ID" = "TBLS"."TBL_ID" AND "TBLS"."TBL_NAME" = 'tb1' INNER JOIN "DBS" ON "TBLS"."DB_ID" = "DBS"."DB_ID" AND "DBS"."NAME" = 'db1' INNER JOIN "PARTITION_KEY_VALS" "FILTER0" ON "FILTER0"."PART_ID" = "PARTITIONS"."PART_ID" AND "FILTER0"."INTEGER_IDX" = 0 INNER JOIN "PARTITION_KEY_VALS" "FILTER1" ON "FILTER1"."PART_ID" = "PARTITIONS"."PART_ID" AND "FILTER1"."INTEGER_IDX" = 1WHERE "FILTER0"."PART_KEY_VAL" = '2021-12-28' AND CASE WHEN "FILTER1"."PART_KEY_VAL" <> '__HIVE_DEFAULT_PARTITION__' THEN CAST("FILTER1"."PART_KEY_VAL" AS decimal(21, 0)) ELSE NULL END = 10; 由于对PARTITION_KEY_VALS的PARTITION_KEY_VAL字段添加了索引做查询优化,会导致该类查询生成的执行计划中同样会使用idx_PART_KEY_VAL索引进行数据扫描,该执行计划如下: 走idx_PART_KEY_VAL索引执行计划 添加的idx_PART_KEY_VAL索引在该字段的具有相同值的数据较少时,使用该索引能检索较少的数据提升查询效率。在hive中的表一级分区基本是按天进行分区的,据统计每天天分区的增量为26w左右,如果使用idx_PART_KEY_VAL索引,按这个数值计算,查询条件为day>=2021-12-21 and day<2021-12-26的查询需要检索将近160w条数据,这显然不是一个很好的执行计划。 若执行计划不走idx_PART_KEY_VAL索引,TiDB可通过dbs、tbls检索出所有关联partition数据,在根据part_id和过滤条件扫描PARTITION_KEY_VALS数据并返回。此类执行计划扫描的数据量和需要查询的表的分区总量有关,如果该表只有少数的分区,则查询能够迅速响应,但如果查询的表有上百万的分区,则该类执行计划对于该类查询不是最优解。 不走idx_PART_KEY_VAL索引执行计划 针对不同执行计划的特性,整理了以下对比点: 在实际生产中元数据基本都是按天分区为主,每天增长大概有26w左右,且范围查询的使用场景较多,使用idx_PART_KEY_VAL索引查询的执行计划不太适合线上场景,故该索引需不适合添加到线上环境。 4.3 TiDB内存突增导致宕机问题 在刚上线TiDB服务初期,曾数次面临TiDB内存溢出的问题,每次出现的时间都随机不确定,出现的时候内存突增几乎在一瞬间,若期间TiDB的内存抗住了突增量,突增部分内存释放在很长时间都不会得到释放,最终对HMS服务稳定性带来抖动。 TiDB内存突增情况 通过和TiDB开发、DBA联合分析下,确认TiDB内存飙高的原因为用户在使用Dashboard功能分析慢查询引起;在分析慢查询过程中,TiDB需要加载本地所有的slow-query日志到内存,如果这些日志过大,则会造成TiDB内存突增,此外,如果在分析期间,用户点击了取消按钮,则有可能会造成TiDB的内存泄漏。针对该问题制定如下解决方案: 使用大内存机器替换原小内存机器,避免分析慢查询时内存不够 调大慢查询阈值为3s,减少日志产生 定时mv慢查询日志到备份目录 4.4 locate函数查询不走索引导致TiKV负异常 在HMS中存在部分通过JDO的方式去获取分区的查询,该类查询的过滤条件中用locate函数过滤PART_NAME数据,在TiDB中通过函数作用在字段中是不会触发索引查询的,所以在该类查询会加载对应表的所有数据到TiDB端计算过滤,TiKV则需不断扫描全表并传输数据到TiDB段,从而导致TiKV负载异常。 locate函数导致全表扫描 然而上述的查询条件可以通过like方式去实现,通过使用like语法,查询可以成功使用到PARTITIONS表的UNIQUEPARTITION索引过滤,进而在TiKV端进行索引过滤降低负载。 like语法走索引过滤 通过实现将locate函数查询转换为like语法查询,有效降低了TiKV端的负载情况。在HMS端完成变更后,TiKV的CPU使用率降低了将近一倍,由于在KV端进行索引过滤,相应的io使用率有所上升,但网络传输则有明显的下降,由平均1G降低到200M左右。 变更前后TiKV的负载情况 除TiKV负载有明显的降低,TiDB的整体性能也得到明显的提升,各项操作耗时呈量级降低。以下整理了TiDB增删改查的天平均耗时情况: TiDB P999天平均耗时统计 4.5 get_all_functions优化 随着hive udf的不断增长,HMS的get_all_functions api平均耗时增长的也越来越久,平均在40-90s,而该api在hive shell中首次执行查询操作时会被调用注册所有的udf,过长的耗时会影响用户对hive引擎的使用体验,例如执行简单的show database需要等待一分钟甚至更久才能返回结果。 原get_all_functions api平均耗时 导致该api耗时严重的主要原因是HMS通过JDO方式获取所有的Function,在获取所有的udf时后台会遍历每条func去关联DBS、FUNC_RU两个表,获取性能极低。而使用directSQL的方式去获取所有udf数据,响应耗时都在1秒以内完成,性能提升相当明显。以下为directSQL的SQL实现逻辑: select FUNCS.FUNC_NAME, DBS.NAME, FUNCS.CLASS_NAME, FUNCS.OWNER_NAME, FUNCS.OWNER_TYPE, FUNCS.CREATE_TIME, FUNCS.FUNC_TYPE, FUNC_RU.RESOURCE_URI, FUNC_RU.RESOURCE_TYPEfrom FUNCSleft join FUNC_RU on FUNCS.FUNC_ID = FUNC_RU.FUNC_IDleft join DBS on FUNCS.DB_ID = DBS.DB_ID 五、总结 我们从2021年7月份开始对TiDB进行调研,在经历数个月的测试于同年11月末将MySQL引擎切换到TiDB。由于前期测试主要集中在兼容性和性能测试上,忽略了TiDB自身可能潜在的问题,在上线初期经历了数次因慢查询日志将TiDB内存打爆的情况,在这特别感谢我们的DBA团队、平台运营团队及TiDB官方团队帮忙分析、解决问题,得以避免该问题的再次发生;与此同时,由于当前HMS使用的版本较低,加上大数据的组件在不断的升级演进,我们也需要去兼容升级带来的变动,如HDFS升级到3.x后对EC文件读取的支持,SPARK获取分区避免全表扫描改造等;此外由于TiDB的latin字符集支持中文字符的写入,该特性会导致用户误写入错误的中文分区,对于此类型数据无法通过现有API进行删除,还需要在应用层去禁止该类型错误分区写入,避免无用数据累积。 经历了一年多的实际生产环境检验,TiDB内存整体使用在10%以内,TiKV CPU使用平稳,使用峰值均在30核内,暂不存在系统瓶颈;HMS服务的稳定性整体可控,关键API性能指标满足业务的实际需求,为业务的增长提供可靠支持。在未来三年内,我们将保持该架构去支撑整个大数据平台组件的稳定运行,期间我们也将持续关注行业内的变动,吸收更多优秀经验应用到我们的生产环境中来,包括但不限于对性能更好的高版本TiDB尝试,HMS的性能优化案例。 END 猜你喜欢 vivo数据中心网络链路质量监测的探索实践 K8s 多集群实践思考和探索 JVM 内存大对象监控和优化实践 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册