首页 文章 精选 留言 我的

精选列表

搜索[官方文档],共10012篇文章
优秀的个人博客,低调大师

Redisson官方文档 - 9. 分布式服务

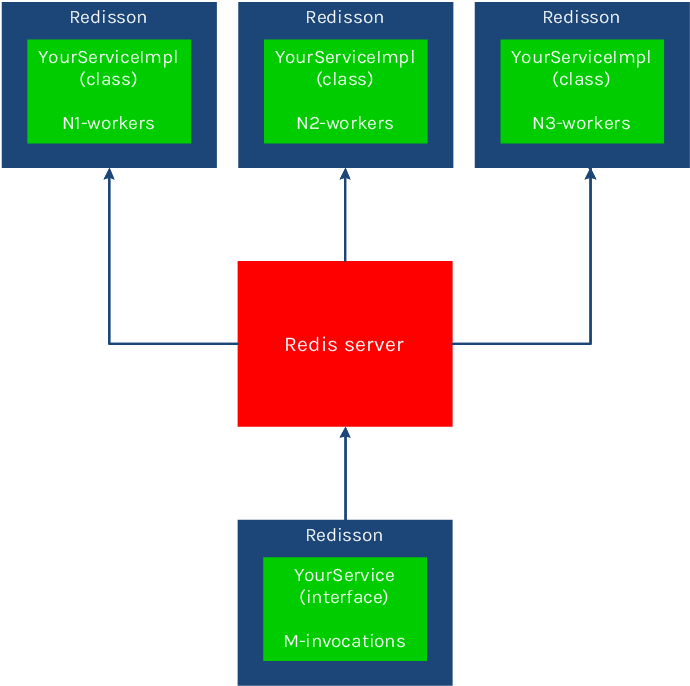
9.1. 分布式远程服务(Remote Service) 基于Redis的Java分布式远程服务,可以用来通过共享接口执行存在于另一个Redisson实例里的对象方法。换句话说就是通过Redis实现了Java的远程过程调用(RPC)。分布式远程服务基于可以用POJO对象,方法的参数和返回类不受限制,可以是任何类型。 分布式远程服务(Remote Service)提供了两种类型的RRemoteService实例: 服务端(远端)实例 - 用来执行远程方法(工作者实例即worker instance).例如: RRemoteService remoteService = redisson.getRemoteService(); SomeServiceImpl someServiceImpl = new SomeServiceImpl(); // 在调用远程方法以前,应该首先注册远程服务 // 只注册了一个服务端工作者实例,只能同时执行一个并发调用 remoteService.register(SomeServiceInterface.class, someServiceImpl); // 注册了12个服务端工作者实例,可以同时执行12个并发调用 remoteService.register(SomeServiceInterface.class, someServiceImpl, 12); 客户端(本地)实例 - 用来请求远程方法.例如: RRemoteService remoteService = redisson.getRemoteService(); SomeServiceInterface service = remoteService.get(SomeServiceInterface.class); String result = service.doSomeStuff(1L, "secondParam", new AnyParam()); 客户端和服务端必须使用一样的共享接口,生成两者的Redisson实例必须采用相同的连接配置。客户端和服务端实例可以运行在同一个JVM里,也可以是不同的。客户端和服务端的数量不收限制。(注意:尽管Redisson不做任何限制,但是Redis的限制仍然有效。) 在服务端工作者可用实例数量 大于1 的时候,将并行执行并发调用的远程方法。 并行执行工作者数量计算方法如下:T = R * N T - 并行执行工作者总数R - Redisson服务端数量N - 注册服务端时指定的执行工作者数量 超过该数量的并发请求将在列队中等候执行。 在服务端工作者实例可用数量为 1 时,远程过程调用将会按 __顺序执行__。这种情况下,每次只有一个请求将会被执行,其他请求将在列队中等候执行。 9.1.1. 分布式远程服务工作流程 分布式远程服务为每个注册接口建立了两个列队。一个列队用于请求,由服务端监听,另一个列队用于应答回执和结果回复,由客户端监听。应答回执用于判定该请求是否已经被接受。如果在指定的超时时间内没有被执行工作者执行将会抛出RemoteServiceAckTimeoutException错误。 下图描述了每次发起远程过程调用请求的工作流程。 9.1.2. 发送即不管(Fire-and-Forget)模式和应答回执(Ack-Response)模式 分布式远程服务通过org.redisson.core.RemoteInvocationOptions类,为每个远程过程调用提供了一些可配置选项。这些选项可以用来指定和修改请求超时和选择跳过应答回执或结果的发送模式。例如: // 应答回执超时1秒钟,远程执行超时30秒钟 RemoteInvocationOptions options = RemoteInvocationOptions.defaults(); // 无需应答回执,远程执行超时30秒钟 RemoteInvocationOptions options = RemoteInvocationOptions.defaults().noAck(); // 应答回执超时1秒钟,不等待执行结果 RemoteInvocationOptions options = RemoteInvocationOptions.defaults().noResult(); // 应答回执超时1分钟,不等待执行结果 RemoteInvocationOptions options = RemoteInvocationOptions.defaults().expectAckWithin(1, TimeUnit.MINUTES).noResult(); // 发送即不管(Fire-and-Forget)模式,无需应答回执,不等待结果 RemoteInvocationOptions options = RemoteInvocationOptions.defaults().noAck().noResult(); RRemoteService remoteService = redisson.getRemoteService(); YourService service = remoteService.get(YourService.class, options); 9.1.3. 异步调用 远程过程调用也可以采用异步的方式执行。异步调用需要单独提交一个带有@RRemoteAsync注释(annotation)的异步接口类。异步接口方法签名必须与远程接口的方法签名相符。异步接口的返回类必须是org.redisson.api.RFuture对象或其子对象。在调用RRemoteService.get方法时将对异步接口的方法进行验证。异步接口无须包含所有的远程接口里的方法,只需要包含要求异步执行的方法即可。 // 远程接口 public interface RemoteInterface { Long someMethod1(Long param1, String param2); void someMethod2(MyObject param); MyObject someMethod3(); } // 匹配远程接口的异步接口 @RRemoteAsync(RemoteInterface.class) public interface RemoteInterfaceAsync { RFuture<Long> someMethod1(Long param1, String param2); RFuture<Void> someMethod2(MyObject param); } RRemoteService remoteService = redisson.getRemoteService(); RemoteInterfaceAsync asyncService = remoteService.get(RemoteInterfaceAsync.class); 9.1.4. 取消异步调用 通过调用Future.cancel()方法可以非常方便的取消一个异步调用。分布式远程服务允许在三个阶段中任何一个阶段取消异步调用: 远程调用请求在列队中排队阶段 远程调用请求已经被分布式远程服务接受,还未发送应答回执,执行尚未开始。 远程调用请求已经在执行阶段 想要正确的处理第三个阶段,在服务端代码里应该检查Thread.currentThread().isInterrupted()的返回状态。范例如下: // 远程接口 public interface MyRemoteInterface { Long myBusyMethod(Long param1, String param2); } // 匹配远程接口的异步接口 @RRemoteAsync(MyRemoteInterface.class) public interface MyRemoteInterfaceAsync { RFuture<Long> myBusyMethod(Long param1, String param2); } // 远程接口的实现 public class MyRemoteServiceImpl implements MyRemoteInterface { public Long myBusyMethod(Long param1, String param2) { for (long i = 0; i < Long.MAX_VALUE; i++) { iterations.incrementAndGet(); if (Thread.currentThread().isInterrupted()) { System.out.println("interrupted! " + i); return; } } } } RRemoteService remoteService = redisson.getRemoteService(); ExecutorService executor = Executors.newFixedThreadPool(5); // 注册远程服务的服务端的同时,通过单独指定的ExecutorService来配置执行线程池 MyRemoteInterface serviceImpl = new MyRemoteServiceImpl(); remoteService.register(MyRemoteInterface.class, serviceImpl, 5, executor); // 异步调用方法 MyRemoteInterfaceAsync asyncService = remoteService.get(MyRemoteInterfaceAsync.class); RFuture<Long> future = asyncService.myBusyMethod(1L, "someparam"); // 取消异步调用 future.cancel(true); 9.2. 分布式实时对象(Live Object)服务 9.2.1. 介绍 一个 分布式实时对象(Live Object) 可以被理解为一个功能强化后的Java对象。该对象不仅可以被一个JVM里的各个线程相引用,还可以被多个位于不同JVM里的线程同时引用。Wikipedia对这种特殊对象的概述是: Live distributed object (also abbreviated as live object) refers to a running instance of a distributed multi-party (or peer-to-peer) protocol, viewed from the object-oriented perspective, as an entity that has a distinct identity, may encapsulate internal state and threads of execution, and that exhibits a well-defined externally visible behavior. Redisson分布式实时对象(Redisson Live Object,简称RLO)运用即时生成的代理类(Proxy),将一个指定的普通Java类里的所有字段,以及针对这些字段的操作全部映射到一个Redis Hash的数据结构,实现这种理念。每个字段的get和set方法最终被转译为针对同一个Redis Hash的hget和hset命令,从而使所有连接到同一个Redis节点的所有可以客户端同时对一个指定的对象进行操作。众所周知,一个对象的状态是由其内部的字段所赋的值来体现的,通过将这些值保存在一个像Redis这样的远程共享的空间的过程,把这个对象强化成了一个分布式对象。这个分布式对象就叫做Redisson分布式实时对象(Redisson Live Object,简称RLO)。 通过使用RLO,运行在不同服务器里的多个程序之间,共享一个对象实例变得和在单机程序里共享一个对象实例一样了。同时还避免了针对任何一个字段操作都需要将整个对象序列化和反序列化的繁琐,进而降低了程序开发的复杂性和其数据模型的复杂性:从任何一个客户端修改一个字段的值,处在其他服务器上的客户端(几乎^)即刻便能查看到。而且实现代码与单机程序代码无异。(^连接到从节点的客户端仍然受Redis的最终一致性的特性限制) 鉴于Redis是一个单线程的程序,针对实时对象的所有的字段操作可以理解为全部是原子性操作,也就是说在读取一个字段的过程不会担心被其他线程所修改。 通过使用RLO,可以把Redis当作一个允许被多个JVM同时操作且不受GC影响的共享堆(Heap Space)。 9.2.2. 使用方法 要想获得RLO带来的所有便利,只需要为一个类添加一个@REntity注释,然后再为其中的一个字段添加一个@RId注释即可。 @REntity public class MyLiveObject { @RId private String name; //其他字段 ... ... //get和set方法 ... ... } 就这样简单两步,即可将一个普通的Java对象“升级”成了一个Redisson分布式实时对象。通过Redisson对象实例提供的RedissonLiveObjectService服务对象可以很方便的获取RLO实例: ... RLiveObjectService service = redisson.getLiveObjectService(); MyLiveObject myObject1 = new MyLiveObject(); myObject1.setName("myName"); MyLiveObject myObject1 = service.<MyLiveObject, String>persist(myObject1); //或者取得一个已经存在的RLO实例 MyLiveObject myObject1 = service.<MyLiveObject, String>get(MyLiveObject.class, "myName"); ... RLO的用法和普通Java对象的用法一样,以以下对象为例: @REntity public class MyObject { @RId private String name; private String value; public MyObject(String name) { this.name = name; } public MyObject() { } public String getName() { return name; } public String getValue() { return value; } public void setName(String name) { this.name = name; } public void setValue(String value) { this.value = value; } } 在作为普通对象操作时: //普通Java对象实例 MyObject standardObject1 = new MyObject(); standardObject1.setName("standard1"); //当然也可以使用非默认构造函数 MyObject standardObject2 = new MyObject("standard2"); 也可以作为RLO实例使用: //首先获取服务实例 RLiveObjectService service = redisson.getLiveObjectService(); //通过服务实例构造RLO实例 MyObject standardObject1 = new MyObject(); standardObject1.setName("liveObjectId"); MyObject liveObject1 = service.<MyObject, String>persist(standardObject1); //服务实例会首先通过单一参数为条件查找构造函数,如果能找到就尝试采用"liveObjectId"作为参数 //来构造实例,如果没有找到就采用默认构造函数,然后调用setName("liveObjectId")赋值,最后再 //返回对象。 在使用上,二者完全没有分别。 //为"value"字段赋值的方法也是一样: standardObject1.setValue("abc");//“abc”作为字段值,储存在JVM内存的堆里(Heap space) standardObject2.setValue("abc");//同上 liveObject1.setValue("abc"); //“abc”作为字段值,储存在Redis里,而不是在JVM内存堆里。(虽然它会在字符串池里出现,但是没有被 //对象引用,因此不会影响垃圾回收。) //提取"value"字段的值也是一样的 System.out.println(standardObject1.getValue()); //在控制台里输出"abc",这个值是从JVM的内存堆里获取出来的。 System.out.println(standardObject2.getValue());//同上 System.out.println(liveObject1.getValue()); //控制台输出内容和上面一样,但值是从Redis里获取出来的。 单从上面两段代码看,结果一模一样,但这其中还有一些细微的不同。这里将通过以下例子详细介绍: @REntity public class MyLiveObject { @RId private String name; private MyOtherObject value; public MyLiveObject(String name) { this.name = name; } public MyObject() { } public String getName() { return name; } public MyOtherObject getValue() { return value; } public void setName(String name) { this.name = name; } public void setValue(MyOtherObject value) { this.value = value; } } 和上面的例子不同的是,我们将“value”字段从一个不可变类String换成了一个可变类MyOtherObject,在一个普通的Java对象里,当你调用getValue()方法时,你得到的会是原MyOtherObject实例的一个引用。在RLO对象里,调用同样的方法,返回的将会是一个全新对象的引用。这就会产生以下的现象: //RLO对象: MyLiveObject myLiveObject = service.get(MyLiveObject.class, "1"); myLiveObject.setValue(new MyOtherObject()); System.out.println(myLiveObject.getValue() == myLiveObject.getValue()); //输出值为假(False) (除非在对象编码器里采用了对象池) //普通Java对象: MyLiveObject notLiveObject = new MyLiveObject(); notLiveObject.setValue(new MyOtherObject()); System.out.println(notLiveObject.getValue() == notLiveObject.getValue()); //输出值为真(True) 再比如: //RLO对象: MyLiveObject myLiveObject = service.get(MyLiveObject.class, "1"); MyOtherObject other = new MyOtherObject(); other.setOtherName("ABC"); myLiveObject.setValue(other); System.out.println(myLiveObject.getValue().getOtherName()); //输出是ABC other.setOtherName("BCD"); System.out.println(myLiveObject.getValue().getOtherName()); //还是输出ABC myLiveObject.setValue(other); System.out.println(myLiveObject.getValue().getOtherName()); //现在输出是BCD //普通Java对象: MyLiveObject myLiveObject = new MyLiveObject("1"); MyOtherObject other = new MyOtherObject(); other.setOtherName("ABC"); myLiveObject.setValue(other); System.out.println(myLiveObject.getValue().getOtherName()); //输出是ABC other.setOtherName("BCD"); System.out.println(myLiveObject.getValue().getOtherName()); //输出已经是BCD了 myLiveObject.setValue(other); System.out.println(myLiveObject.getValue().getOtherName()); //输出还是BCD 产生这个现象的原因是因为Redisson没有在JVM里保存MyOtherObject对象的状态,而是在每次调用set和get的时候,先将一个实例从Redis里序列化和反序列化出来,再赋值取值。这是和JPA里的修改脱管(detach)对象状态类似。这种现象通常情况下对不可变类来说不会有任何影响,比如说String,Double,Long等等。而在操作可变类是你反而可以利用它这种特性,正因为这个实例处于修改脱管状态,取得的实例与其本身脱离了联系,此时对脱管对象的读写操作可以理解为是处于一个具有一些ACID特性的事务状态。正确利用这样的特性将会获益匪浅。当然如果你仍然希望RLO的用法与普通Java对象完全一致,只需将MyOtherObject也转换成一个RLO对象即可。 //RLO套嵌RLO的情形 MyLiveObject myLiveObject = service.get(MyLiveObject.class, "1"); MyOtherObject other = service.get(MyOtherObject.class, "2"); other.setOtherName("ABC"); myLiveObject.setValue(other); System.out.println(myLiveObject.getValue().getOtherName()); //输出ABC other.setOtherName("BCD"); System.out.println(myLiveObject.getValue().getOtherName()); //现在输出已经是BCD了,和普通Java对象一样 myLiveObject.setValue(other); System.out.println(myLiveObject.getValue().getOtherName()); //还是输出BCD RLO的字段类型基本上无限制,可以是任何类型。比如Java util包里的集合类,Map类等,也可以是自定义的对象。只要指定的编码解码器能够对其进行编码和解码操作便可。关于编码解码器的详细信息请查阅高级使用方法章节。 尽管RLO的字段类型基本上无限制,个别类型还是受限。注释了RId的字段类型不能是数组类(Array),比如int[],long[],double[],byte[]等等。更多关于限制有关的介绍和原理解释请查阅使用限制 章节。 为了保证RLO的用法和普通Java对象的用法尽可能一直,Redisson分布式实时对象服务自动将以下普通Java对象转换成与之匹配的Redisson分布式对象RObject。 普通Java类 转换后的Redisson类 SortedSet.class RedissonSortedSet.class Set.class RedissonSet.class ConcurrentMap.class RedissonMap.class Map.class RedissonMap.class BlockingDeque.class RedissonBlockingDeque.class Deque.class RedissonDeque.class BlockingQueue.class RedissonBlockingQueue.class Queue.class RedissonQueue.class List.class RedissonList.class 类型转换将按照从上至下的顺序匹配类型,例如LinkedList类同时实现了Deque,List和Queue,由于Deque排在靠上的位置,因此它将会被转换成一个RedissonDeque类型。 Redisson的分布式对象也采用类似的方式,将自身的状态储存于Redis当中,(几乎^)所有的状态改变都直接映射到Redis里,不在本地JVM中保留任何赋值。(^本地缓存对象除外,比如RLocalCachedMap) 9.2.3. 高级使用方法 正如上述介绍,RLO类其实都是按需实时生成的代理(Proxy)类。生成的代理类和原类都一同缓存Redisson实例里。这个过程会消耗一些时间,在对耗时比较敏感的情况下,建议通过RedissonLiveObjectService提前注册所有的RLO类。这个服务也可以用来注销不再需要的RLO类,也可以用来查询一个类是否已经注册了。 RLiveObjectService service = redisson.getLiveObjectService(); service.registerClass(MyClass.class); service.unregisterClass(MyClass.class); Boolean registered = service.isClassRegistered(MyClass.class); 9.2.4. 注解(Annotation)使用方法 @REntity 通过指定@REntity的各个参数,可以详细的对每个RLO类实现特殊定制,以达到改变RLO对象的行为。 namingScheme - 命名方案。命名方案规定了每个实例在Redis中对应key的名称。它不仅被用来与已存在的RLO建立关联,还被用来储存新建的RLO实例。默认采用Redisson自带的DefaultNamingScheme对象。 codec - 编码解码器。在运行当中,Redisson用编码解码器来对RLO中的每个字段进行编码解码。Redisson内部采用了实例池管理不同类型的编码解码器实例。Redisson提供了多种不同的编码解码器,默认使用JsonJacksonCodec。 fieldTransformation - 字段转换模式。如上所述,为了尽可能的保证RLO的用法和普通Java对象一致,Redisson会自动将常用的普通Java对象转换成与其匹配的Redisson分布式对象。这是由于字段转换模式的默认值是ANNOTATION_BASED,修改为IMPLEMENTATION_BASED就可以不转换。 @RId @RId注释只能用在具备区分实例的字段上,这类字段可以理解为一个类的id字段或主键字段。这个字段的值将被命名方案namingScheme用来与事先存在的RLO建立引用。加了该注释的字段是唯一在本地JVM里同时保存赋值的字段。一个类只能有一个字段包含@RId注释。 可以通过指定一个生成器generator策略来实现自动生成这个字段的值。默认不提供生成器。 @RObjectField 当@REntity注释里字段转换模式transformationMode是默认值ANNOTATION_BASED时,可以为一个未包含@RId注释的字段添加该注释。这个注释可以用来特别指定该字段的命名方案namingScheme和编码解码器codec。二者可以与@REntity注释里的值不同。 您可能已经看出来了,命名方案namingScheme和编码解码器codec在Redisson分布式实时对象服务里的使用频率是很高的。为了避免重复构造冗余的实例,Redisson在默认情况下通过内置实例池管理重复使用这些实例。有需要可以在构造Redisson实例的同时,通过Config来指定您自己定制的提供者(Provider)对象。 9.2.5. 使用限制 如上所述,带有RId注释字段的类型不能使数组类,这是因为目前默认的命名方案类DefaultNamingScheme还不能正确地将数组类序列化和反序列化。在改善了DefaultNamingScheme类的不足以后会考虑取消这个限制。另外由于带有RId注释的字段是用来指定Redis中映射的key的名称,因此组建一个只含有唯一一个字段的RLO类是毫无意义的。选用RBucket会更适合这样的场景。 9.3. 分布式执行服务(Executor Service) 9.3.1. 分布式执行服务概述 Redisson的分布式执行服务实现了java.util.concurrent.ExecutorService接口,支持在不同的独立节点里执行基于java.util.concurrent.Callable接口或java.lang.Runnable接口的任务。这样的任务也可以通过使用Redisson实例,实现对储存在Redis里的数据进行操作。Redisson分布式执行服务是最快速和有效执行分布式运算的方法。 9.3.2. 任务 Redisson独立节点不要求任务的类在类路径里。他们会自动被Redisson独立节点的ClassLoader加载。因此每次执行一个新任务时,不需要重启Redisson独立节点。 采用Callable任务的范例: public class CallableTask implements Callable<Long> { @RInject private RedissonClient redissonClient; @Override public Long call() throws Exception { RMap<String, Integer> map = redissonClient.getMap("myMap"); Long result = 0; for (Integer value : map.values()) { result += value; } return result; } } RExecutorService executorService = redisson.getExecutorService("myExecutor"); Future<Long> future = executorService.submit(new CallableTask()); Long result = future.get(); 采用Runnable任务的范例: public class RunnableTask implements Runnable { @RInject private RedissonClient redissonClient; private long param; public RunnableTask() { } public RunnableTask(long param) { this.param = param; } @Override public void run() { RAtomicLong atomic = redissonClient.getAtomicLong("myAtomic"); atomic.addAndGet(param); } } RExecutorService executorService = redisson.getExecutorService("myExecutor"); executorService.submit(new RunnableTask(123)); 可以通过@RInject注释来为任务实时注入Redisson实例依赖。 9.3.3. 取消任务 通过Future.cancel()方法可以很方便的取消所有已提交的任务。通过对Thread.currentThread().isInterrupted()方法的调用可以在已经处于运行状态的任务里实现任务中断: public class CallableTask implements Callable<Long> { @RInject private RedissonClient redissonClient; @Override public Long call() throws Exception { RMap<String, Integer> map = redissonClient.getMap("myMap"); Long result = 0; // map里包含了许多的元素 for (Integer value : map.values()) { if (Thread.currentThread().isInterrupted()) { // 任务被取消了 return null; } result += value; } return result; } } RExecutorService executorService = redisson.getExecutorService("myExecutor"); Future<Long> future = executorService.submit(new CallableTask()); // 或 RFuture<Long> future = executorService.submitAsync(new CallableTask()); // ... future.cancel(true); 9.4. 分布式调度任务服务(Scheduler Service) 9.4.1. 分布式调度任务服务概述 Redisson的分布式调度任务服务实现了java.util.concurrent.ScheduledExecutorService接口,支持在不同的独立节点里执行基于java.util.concurrent.Callable接口或java.lang.Runnable接口的任务。Redisson独立节点按顺序运行Redis列队里的任务。调度任务是一种需要在未来某个指定时间运行一次或多次的特殊任务。 9.4.2. 设定任务计划 Redisson独立节点不要求任务的类在类路径里。他们会自动被Redisson独立节点的ClassLoader加载。因此每次执行一个新任务时,不需要重启Redisson独立节点。 采用Callable任务的范例: public class CallableTask implements Callable<Long> { @RInject private RedissonClient redissonClient; @Override public Long call() throws Exception { RMap<String, Integer> map = redissonClient.getMap("myMap"); Long result = 0; for (Integer value : map.values()) { result += value; } return result; } } RScheduledExecutorService executorService = redisson.getExecutorService("myExecutor"); ScheduledFuture<Long> future = executorService.schedule(new CallableTask(), 10, TimeUnit.MINUTES); Long result = future.get(); 采用Runnable任务的范例: public class RunnableTask implements Runnable { @RInject private RedissonClient redissonClient; private long param; public RunnableTask() { } public RunnableTask(long param) { this.param= param; } @Override public void run() { RAtomicLong atomic = redissonClient.getAtomicLong("myAtomic"); atomic.addAndGet(param); } } RScheduledExecutorService executorService = redisson.getExecutorService("myExecutor"); ScheduledFuture<?> future1 = executorService.schedule(new RunnableTask(123), 10, TimeUnit.HOURS); // ... ScheduledFuture<?> future2 = executorService.scheduleAtFixedRate(new RunnableTask(123), 10, 25, TimeUnit.HOURS); // ... ScheduledFuture<?> future3 = executorService.scheduleWithFixedDelay(new RunnableTask(123), 5, 10, TimeUnit.HOURS); 9.4.3. 通过CRON表达式设定任务计划 在分布式调度任务中,可以通过CRON表达式来为任务设定一个更复杂的计划。表达式与Quartz的CRON格式完全兼容。 例如: RScheduledExecutorService executorService = redisson.getExecutorService("myExecutor"); executorService.schedule(new RunnableTask(), CronSchedule.of("10 0/5 * * * ?")); // ... executorService.schedule(new RunnableTask(), CronSchedule.dailyAtHourAndMinute(10, 5)); // ... executorService.schedule(new RunnableTask(), CronSchedule.weeklyOnDayAndHourAndMinute(12, 4, Calendar.MONDAY, Calendar.FRIDAY)); 9.4.4. 取消计划任务 分布式调度任务服务提供了两张取消任务的方式:通过调用ScheduledFuture.cancel()方法或调用RScheduledExecutorService.cancelScheduledTask方法。通过对Thread.currentThread().isInterrupted()方法的调用可以在已经处于运行状态的任务里实现任务中断: public class RunnableTask implements Callable<Long> { @RInject private RedissonClient redissonClient; @Override public Long call() throws Exception { RMap<String, Integer> map = redissonClient.getMap("myMap"); Long result = 0; // map里包含了许多的元素 for (Integer value : map.values()) { if (Thread.currentThread().isInterrupted()) { // 任务被取消了 return null; } result += value; } return result; } } RScheduledExecutorService executorService = redisson.getExecutorService("myExecutor"); RScheduledFuture<Long> future = executorService.scheduleAsync(new RunnableTask(), CronSchedule.dailyAtHourAndMinute(10, 5)); // ... future.cancel(true); // 或 String taskId = future.getTaskId(); // ... executorService.cancelScheduledTask(taskId); 9.5. 分布式映射归纳服务(MapReduce) 9.5.1 介绍 Redisson提供了通过映射归纳(MapReduce)编程模式来处理储存在Redis环境里的大量数据的服务。这个想法来至于其他的类似实现方式和谷歌发表的研究。所有 映射(Map) 和 归纳(Reduce) 阶段中的任务都是被分配到各个独立节点(Redisson Node)里并行执行的。以下所有接口均支持映射归纳(MapReduce)功能: RMap、 RMapCache、 RLocalCachedMap、 RSet、 RSetCache、 RList、 RSortedSet、 RScoredSortedSet、 RQueue、 RBlockingQueue、 RDeque、 RBlockingDeque、 RPriorityQueue 和 RPriorityDeque 映射归纳(MapReduce)的功能是通过RMapper、 RCollectionMapper、 RReducer 和 RCollator 这几个接口实现的。 1. RMapper 映射器接口适用于映射(Map)类,它用来把映射(Map)中的每个元素转换为另一个作为归纳(Reduce)处理用的键值对。 public interface RMapper<KIn, VIn, KOut, VOut> extends Serializable { void map(KIn key, VIn value, RCollector<KOut, VOut> collector); } 2. RCollectionMapper 映射器接口仅适用于集合(Collection)类型的对象,它用来把集合(Collection)中的元素转换成一组作为归纳(Reduce)处理用的键值对。 public interface RCollectionMapper<VIn, KOut, VOut> extends Serializable { void map(VIn value, RCollector<KOut, VOut> collector); } 3. RReducer 归纳器接口用来将上面这些,由映射器生成的键值对列表进行归纳整理。 public interface RReducer<K, V> extends Serializable { V reduce(K reducedKey, Iterator<V> values); } 4. RCollator 收集器接口用来把归纳整理以后的结果化简为单一一个对象。 public interface RCollator<K, V, R> extends Serializable { R collate(Map<K, V> resultMap); } 以上每个阶段的任务都可以用@RInject注解的方式来获取RedissonClient实例: public class WordMapper implements RMapper<String, String, String, Integer> { @RInject private RedissonClient redissonClient; @Override public void map(String key, String value, RCollector<String, Integer> collector) { // ... redissonClient.getAtomicLong("mapInvocations").incrementAndGet(); } } 9.5.2 映射(Map)类型的使用范例 Redisson提供的RMap、 RMapCache和RLocalCachedMap这三种映射(Map)类型的对象均可以使用这种分布式映射归纳(MapReduce)服务。 以下是在映射(Map)类型的基础上采用映射归纳(MapReduce)来实现字数统计的范例: public class WordMapper implements RMapper<String, String, String, Integer> { @Override public void map(String key, String value, RCollector<String, Integer> collector) { String[] words = value.split("[^a-zA-Z]"); for (String word : words) { collector.emit(word, 1); } } } public class WordReducer implements RReducer<String, Integer> { @Override public Integer reduce(String reducedKey, Iterator<Integer> iter) { int sum = 0; while (iter.hasNext()) { Integer i = (Integer) iter.next(); sum += i; } return sum; } } public class WordCollator implements RCollator<String, Integer, Integer> { @Override public Integer collate(Map<String, Integer> resultMap) { int result = 0; for (Integer count : resultMap.values()) { result += count; } return result; } } RMap<String, String> map = redisson.getMap("wordsMap"); map.put("line1", "Alice was beginning to get very tired"); map.put("line2", "of sitting by her sister on the bank and"); map.put("line3", "of having nothing to do once or twice she"); map.put("line4", "had peeped into the book her sister was reading"); map.put("line5", "but it had no pictures or conversations in it"); map.put("line6", "and what is the use of a book"); map.put("line7", "thought Alice without pictures or conversation"); RMapReduce<String, String, String, Integer> mapReduce = map.<String, Integer>mapReduce() .mapper(new WordMapper()) .reducer(new WordReducer()); // 统计词频 Map<String, Integer> mapToNumber = mapReduce.execute(); // 统计字数 Integer totalWordsAmount = mapReduce.execute(new WordCollator()); 9.5.3 集合(Collection)类型的使用范例 Redisson提供的RSet、 RSetCache、 RList、 RSortedSet、 RScoredSortedSet、 RQueue、 RBlockingQueue、 RDeque、 RBlockingDeque、 RPriorityQueue和RPriorityDeque这几种集合(Collection)类型的对象均可以使用这种分布式映射归纳(MapReduce)服务。 以下是在集合(Collection)类型的基础上采用映射归纳(MapReduce)来实现字数统计的范例: public class WordMapper implements RCollectionMapper<String, String, Integer> { @Override public void map(String value, RCollector<String, Integer> collector) { String[] words = value.split("[^a-zA-Z]"); for (String word : words) { collector.emit(word, 1); } } } public class WordReducer implements RReducer<String, Integer> { @Override public Integer reduce(String reducedKey, Iterator<Integer> iter) { int sum = 0; while (iter.hasNext()) { Integer i = (Integer) iter.next(); sum += i; } return sum; } } public class WordCollator implements RCollator<String, Integer, Integer> { @Override public Integer collate(Map<String, Integer> resultMap) { int result = 0; for (Integer count : resultMap.values()) { result += count; } return result; } } RList<String> list = redisson.getList("myList"); list.add("Alice was beginning to get very tired"); list.add("of sitting by her sister on the bank and"); list.add("of having nothing to do once or twice she"); list.add("had peeped into the book her sister was reading"); list.add("but it had no pictures or conversations in it"); list.add("and what is the use of a book"); list.add("thought Alice without pictures or conversation"); RCollectionMapReduce<String, String, Integer> mapReduce = list.<String, Integer>mapReduce() .mapper(new WordMapper()) .reducer(new WordReducer()); // 统计词频 Map<String, Integer> mapToNumber = mapReduce.execute(); // 统计字数 Integer totalWordsAmount = mapReduce.execute(new WordCollator());

优秀的个人博客,低调大师

Redisson官方文档 - 7. 分布式集合

7.1. 映射(Map) 基于Redis的Redisson的分布式映射结构的RMap Java对象实现了java.util.concurrent.ConcurrentMap接口和java.util.Map接口。同时还保持了元素的插入顺序。该对象的最大容量受Redis限制,最大元素数量是4 294 967 295个。 在特定的场景下,映射缓存(Map)上的高度频繁的读取操作,使网络通信都被视为瓶颈时,可以使用Redisson提供的带有本地缓存功能的映射。 RMap<String, SomeObject> map = redisson.getMap("anyMap"); SomeObject prevObject = map.put("123", new SomeObject()); SomeObject currentObject = map.putIfAbsent("323", new SomeObject()); SomeObject obj = map.remove("123"); map.fastPut("321", new SomeObject()); map.fastRemove("321"); RFuture<SomeObject> putAsyncFuture = map.putAsync("321"); RFuture<Void> fastPutAsyncFuture = map.fastPutAsync("321"); map.fastPutAsync("321", new SomeObject()); map.fastRemoveAsync("321"); 映射的字段锁的用法: RMap<MyKey, MyValue> map = redisson.getMap("anyMap"); MyKey k = new MyKey(); RLock keyLock = map.getLock(k); keyLock.lock(); try { MyValue v = map.get(k); // 其他业务逻辑 } finally { keyLock.unlock(); } RReadWriteLock rwLock = map.getReadWriteLock(k); rwLock.readLock().lock(); try { MyValue v = map.get(k); // 其他业务逻辑 } finally { keyLock.readLock().unlock(); } 7.1.1. 映射(Map)的元素淘汰(Eviction),本地缓存(LocalCache)和数据分片(Sharding) Redisson提供了一系列的映射类型的数据结构,这些结构按特性主要分为三大类: 元素淘汰(Eviction) 类 -- 带有元素淘汰(Eviction)机制的映射类允许针对一个映射中每个元素单独设定 有效时间 和 最长闲置时间 。 本地缓存(LocalCache) 类 -- 本地缓存(Local Cache)也叫就近缓存(Near Cache)。这类映射的使用主要用于在特定的场景下,映射缓存(MapCache)上的高度频繁的读取操作,使网络通信都被视为瓶颈的情况。Redisson与Redis通信的同时,还将部分数据保存在本地内存里。这样的设计的好处是它能将读取速度提高最多 45倍 。 数据分片(Sharding) 类 -- 数据分片(Sharding)类仅适用于Redis集群环境下,因此带有数据分片(Sharding)功能的映射也叫集群分布式映射。它利用分库的原理,将单一一个映射结构切分为若干个小的映射,并均匀的分布在集群中的各个槽里。这样的设计能使一个单一映射结构突破Redis自身的容量限制,让其容量随集群的扩大而增长。在扩容的同时,还能够使读写性能和元素淘汰处理能力随之成线性增长。 以下列表是Redisson提供的所有映射的名称及其特性: 接口名称 中文名称 RedissonClient 对应的构造方法 本地缓存功能 Local Cache 数据分片功能 Sharding 元素淘汰功能 Eviction RMap映射 getMap() No No No RMapCache映射缓存 getMapCache() No No Yes RLocalCachedMap本地缓存映射 getLocalCachedMap() Yes No No RLocalCachedMapCache本地缓存映射缓存仅限于Redisson PRO版本 getLocalCachedMapCache() Yes No Yes RClusteredMap集群分布式映射存仅限于Redisson PRO版本 getClusteredMap() No Yes No RClusteredMapCache集群分布式映射缓存存仅限于Redisson PRO版本 getClusteredMapCache() No Yes Yes RClusteredLocalCachedMap 集群分布式本地缓存映射存仅限于Redisson PRO版本 getClusteredLocalCachedMap() Yes Yes No RClusteredLocalCachedMapCache 集群分布式本地缓存映射缓存存仅限于Redisson PRO版本 getClusteredLocalCachedMapCache() Yes Yes Yes 除此以外,Redisson还提供了Spring Cache和JCache的实现。 元素淘汰功能(Eviction) Redisson的分布式的RMapCache Java对象在基于RMap的前提下实现了针对单个元素的淘汰机制。同时仍然保留了元素的插入顺序。由于RMapCache是基于RMap实现的,使它同时继承了java.util.concurrent.ConcurrentMap接口和java.util.Map接口。Redisson提供的Spring Cache整合以及JCache正是基于这样的功能来实现的。 目前的Redis自身并不支持散列(Hash)当中的元素淘汰,因此所有过期元素都是通过org.redisson.EvictionScheduler实例来实现定期清理的。为了保证资源的有效利用,每次运行最多清理300个过期元素。任务的启动时间将根据上次实际清理数量自动调整,间隔时间趋于1秒到1小时之间。比如该次清理时删除了300条元素,那么下次执行清理的时间将在1秒以后(最小间隔时间)。一旦该次清理数量少于上次清理数量,时间间隔将增加1.5倍。 RMapCache<String, SomeObject> map = redisson.getMapCache("anyMap"); // 有效时间 ttl = 10分钟 map.put("key1", new SomeObject(), 10, TimeUnit.MINUTES); // 有效时间 ttl = 10分钟, 最长闲置时间 maxIdleTime = 10秒钟 map.put("key1", new SomeObject(), 10, TimeUnit.MINUTES, 10, TimeUnit.SECONDS); // 有效时间 = 3 秒钟 map.putIfAbsent("key2", new SomeObject(), 3, TimeUnit.SECONDS); // 有效时间 ttl = 40秒钟, 最长闲置时间 maxIdleTime = 10秒钟 map.putIfAbsent("key2", new SomeObject(), 40, TimeUnit.SECONDS, 10, TimeUnit.SECONDS); 本地缓存功能(Local Cache) 在特定的场景下,映射(Map)上的高度频繁的读取操作,使网络通信都被视为瓶颈时,使用Redisson提供的带有本地缓存功能的分布式本地缓存映射RLocalCachedMapJava对象会是一个很好的选择。它同时实现了java.util.concurrent.ConcurrentMap和java.util.Map两个接口。本地缓存功能充分的利用了JVM的自身内存空间,对部分常用的元素实行就地缓存,这样的设计让读取操作的性能较分布式映射相比提高最多 45倍 。以下配置参数可以用来创建这个实例: LocalCachedMapOptions options = LocalCachedMapOptions.defaults() // 用于淘汰清除本地缓存内的元素 // 共有以下几种选择: // LFU - 统计元素的使用频率,淘汰用得最少(最不常用)的。 // LRU - 按元素使用时间排序比较,淘汰最早(最久远)的。 // SOFT - 元素用Java的WeakReference来保存,缓存元素通过GC过程清除。 // WEAK - 元素用Java的SoftReference来保存, 缓存元素通过GC过程清除。 // NONE - 永不淘汰清除缓存元素。 .evictionPolicy(EvictionPolicy.NONE) // 如果缓存容量值为0表示不限制本地缓存容量大小 .cacheSize(1000) // 以下选项适用于断线原因造成了未收到本地缓存更新消息的情况。 // 断线重连的策略有以下几种: // CLEAR - 如果断线一段时间以后则在重新建立连接以后清空本地缓存 // LOAD - 在服务端保存一份10分钟的作废日志 // 如果10分钟内重新建立连接,则按照作废日志内的记录清空本地缓存的元素 // 如果断线时间超过了这个时间,则将清空本地缓存中所有的内容 // NONE - 默认值。断线重连时不做处理。 .reconnectionStrategy(ReconnectionStrategy.NONE) // 以下选项适用于不同本地缓存之间相互保持同步的情况 // 缓存同步策略有以下几种: // INVALIDATE - 默认值。当本地缓存映射的某条元素发生变动时,同时驱逐所有相同本地缓存映射内的该元素 // UPDATE - 当本地缓存映射的某条元素发生变动时,同时更新所有相同本地缓存映射内的该元素 // NONE - 不做任何同步处理 .syncStrategy(SyncStrategy.INVALIDATE) // 每个Map本地缓存里元素的有效时间,默认毫秒为单位 .timeToLive(10000) // 或者 .timeToLive(10, TimeUnit.SECONDS) // 每个Map本地缓存里元素的最长闲置时间,默认毫秒为单位 .maxIdle(10000) // 或者 .maxIdle(10, TimeUnit.SECONDS); RLocalCachedMap<String, Integer> map = redisson.getLocalCachedMap("test", options); String prevObject = map.put("123", 1); String currentObject = map.putIfAbsent("323", 2); String obj = map.remove("123"); // 在不需要旧值的情况下可以使用fast为前缀的类似方法 map.fastPut("a", 1); map.fastPutIfAbsent("d", 32); map.fastRemove("b"); RFuture<String> putAsyncFuture = map.putAsync("321"); RFuture<Void> fastPutAsyncFuture = map.fastPutAsync("321"); map.fastPutAsync("321", new SomeObject()); map.fastRemoveAsync("321"); 当不再使用Map本地缓存对象的时候应该手动销毁,如果Redisson对象被关闭(shutdown)了,则不用手动销毁。 RLocalCachedMap<String, Integer> map = ... map.destroy(); 如何通过加载数据的方式来降低过期淘汰事件发布信息对网络的影响 代码范例: public void loadData(String cacheName, Map<String, String> data) { RLocalCachedMap<String, String> clearMap = redisson.getLocalCachedMap(cacheName, LocalCachedMapOptions.defaults().cacheSize(1).syncStrategy(SyncStrategy.INVALIDATE)); RLocalCachedMap<String, String> loadMap = redisson.getLocalCachedMap(cacheName, LocalCachedMapOptions.defaults().cacheSize(1).syncStrategy(SyncStrategy.NONE)); loadMap.putAll(data); clearMap.clearLocalCache(); } 数据分片功能(Sharding) Map数据分片是Redis集群模式下的一个功能。Redisson提供的分布式集群映射RClusteredMap Java对象也是基于RMap实现的。它同时实现了java.util.concurrent.ConcurrentMap和java.util.Map两个接口。在这里可以获取更多的内部信息。 RClusteredMap<String, SomeObject> map = redisson.getClusteredMap("anyMap"); SomeObject prevObject = map.put("123", new SomeObject()); SomeObject currentObject = map.putIfAbsent("323", new SomeObject()); SomeObject obj = map.remove("123"); map.fastPut("321", new SomeObject()); map.fastRemove("321"); 7.1.2. 映射持久化方式(缓存策略) Redisson供了将映射中的数据持久化到外部储存服务的功能。主要场景有一下几种: 将Redisson的分布式映射类型作为业务和外部储存媒介之间的缓存。 或是用来增加Redisson映射类型中数据的持久性,或是用来增加已被驱逐的数据的寿命。 或是用来缓存数据库,Web服务或其他数据源的数据。 Read-through策略 通俗的讲,如果一个被请求的数据不存在于Redisson的映射中的时候,Redisson将通过预先配置好的MapLoader对象加载数据。 Write-through(数据同步写入)策略 在遇到映射中某条数据被更改时,Redisson会首先通过预先配置好的MapWriter对象写入到外部储存系统,然后再更新Redis内的数据。 Write-behind(数据异步写入)策略 对映射的数据的更改会首先写入到Redis,然后再使用异步的方式,通过MapWriter对象写入到外部储存系统。在并发环境下可以通过writeBehindThreads参数来控制写入线程的数量,已达到对外部储存系统写入并发量的控制。 以上策略适用于所有实现了RMap、RMapCache、RLocalCachedMap和RLocalCachedMapCache接口的对象。 配置范例: MapOptions<K, V> options = MapOptions.<K, V>defaults() .writer(myWriter) .loader(myLoader); RMap<K, V> map = redisson.getMap("test", options); // 或 RMapCache<K, V> map = redisson.getMapCache("test", options); // 或 RLocalCachedMap<K, V> map = redisson.getLocalCachedMap("test", options); // 或 RLocalCachedMapCache<K, V> map = redisson.getLocalCachedMapCache("test", options); 7.1.3. 映射监听器(Map Listener) Redisson为所有实现了RMapCache或RLocalCachedMapCache接口的对象提供了监听以下事件的监听器: 事件 | 监听器元素 添加 事件 | org.redisson.api.map.event.EntryCreatedListener 元素 过期 事件 | org.redisson.api.map.event.EntryExpiredListener 元素 删除 事件 | org.redisson.api.map.event.EntryRemovedListener 元素 更新 事件 | org.redisson.api.map.event.EntryUpdatedListener 使用范例: RMapCache<String, Integer> map = redisson.getMapCache("myMap"); // 或 RLocalCachedMapCache<String, Integer> map = redisson.getLocalCachedMapCache("myMap", options); int updateListener = map.addListener(new EntryUpdatedListener<Integer, Integer>() { @Override public void onUpdated(EntryEvent<Integer, Integer> event) { event.getKey(); // 字段名 event.getValue() // 新值 event.getOldValue() // 旧值 // ... } }); int createListener = map.addListener(new EntryCreatedListener<Integer, Integer>() { @Override public void onCreated(EntryEvent<Integer, Integer> event) { event.getKey(); // 字段名 event.getValue() // 值 // ... } }); int expireListener = map.addListener(new EntryExpiredListener<Integer, Integer>() { @Override public void onExpired(EntryEvent<Integer, Integer> event) { event.getKey(); // 字段名 event.getValue() // 值 // ... } }); int removeListener = map.addListener(new EntryRemovedListener<Integer, Integer>() { @Override public void onRemoved(EntryEvent<Integer, Integer> event) { event.getKey(); // 字段名 event.getValue() // 值 // ... } }); map.removeListener(updateListener); map.removeListener(createListener); map.removeListener(expireListener); map.removeListener(removeListener); 7.1.4. LRU有界映射 Redisson提供了基于Redis的以LRU为驱逐策略的分布式LRU有界映射对象。顾名思义,分布式LRU有界映射允许通过对其中元素按使用时间排序处理的方式,主动移除超过规定容量限制的元素。 RMapCache<String, String> map = redisson.getMapCache("map"); // 尝试将该映射的最大容量限制设定为10 map.trySetMaxSize(10); // 将该映射的最大容量限制设定或更改为10 map.setMaxSize(10); map.put("1", "2"); map.put("3", "3", 1, TimeUnit.SECONDS); 7.2. 多值映射(Multimap) 基于Redis的Redisson的分布式RMultimap Java对象允许Map中的一个字段值包含多个元素。字段总数受Redis限制,每个Multimap最多允许有4 294 967 295个不同字段。 7.2.1. 基于集(Set)的多值映射(Multimap) 基于Set的Multimap不允许一个字段值包含有重复的元素。 RSetMultimap<SimpleKey, SimpleValue> map = redisson.getSetMultimap("myMultimap"); map.put(new SimpleKey("0"), new SimpleValue("1")); map.put(new SimpleKey("0"), new SimpleValue("2")); map.put(new SimpleKey("3"), new SimpleValue("4")); Set<SimpleValue> allValues = map.get(new SimpleKey("0")); List<SimpleValue> newValues = Arrays.asList(new SimpleValue("7"), new SimpleValue("6"), new SimpleValue("5")); Set<SimpleValue> oldValues = map.replaceValues(new SimpleKey("0"), newValues); Set<SimpleValue> removedValues = map.removeAll(new SimpleKey("0")); 7.2.2. 基于列表(List)的多值映射(Multimap) 基于List的Multimap在保持插入顺序的同时允许一个字段下包含重复的元素。 RListMultimap<SimpleKey, SimpleValue> map = redisson.getListMultimap("test1"); map.put(new SimpleKey("0"), new SimpleValue("1")); map.put(new SimpleKey("0"), new SimpleValue("2")); map.put(new SimpleKey("0"), new SimpleValue("1")); map.put(new SimpleKey("3"), new SimpleValue("4")); List<SimpleValue> allValues = map.get(new SimpleKey("0")); Collection<SimpleValue> newValues = Arrays.asList(new SimpleValue("7"), new SimpleValue("6"), new SimpleValue("5")); List<SimpleValue> oldValues = map.replaceValues(new SimpleKey("0"), newValues); List<SimpleValue> removedValues = map.removeAll(new SimpleKey("0")); 7.2.3. 多值映射(Multimap)淘汰机制(Eviction) Multimap对象的淘汰机制是通过不同的接口来实现的。它们是RSetMultimapCache接口和RListMultimapCache接口,分别对应的是Set和List的Multimaps。 所有过期元素都是通过org.redisson.EvictionScheduler实例来实现定期清理的。为了保证资源的有效利用,每次运行最多清理100个过期元素。任务的启动时间将根据上次实际清理数量自动调整,间隔时间趋于1秒到2小时之间。比如该次清理时删除了100条元素,那么下次执行清理的时间将在1秒以后(最小间隔时间)。一旦该次清理数量少于上次清理数量,时间间隔将增加1.5倍。 RSetMultimapCache的使用范例: RSetMultimapCache<String, String> multimap = redisson.getSetMultimapCache("myMultimap"); multimap.put("1", "a"); multimap.put("1", "b"); multimap.put("1", "c"); multimap.put("2", "e"); multimap.put("2", "f"); multimap.expireKey("2", 10, TimeUnit.MINUTES); 7.3. 集(Set) 基于Redis的Redisson的分布式Set结构的RSet Java对象实现了java.util.Set接口。通过元素的相互状态比较保证了每个元素的唯一性。该对象的最大容量受Redis限制,最大元素数量是4 294 967 295个。 RSet<SomeObject> set = redisson.getSet("anySet"); set.add(new SomeObject()); set.remove(new SomeObject()); Redisson PRO版本中的Set对象还可以在Redis集群环境下支持单集合数据分片。 7.3.1. 集(Set)淘汰机制(Eviction) 基于Redis的Redisson的分布式RSetCache Java对象在基于RSet的前提下实现了针对单个元素的淘汰机制。由于RSetCache是基于RSet实现的,使它还集成了java.util.Set接口。 目前的Redis自身并不支持Set当中的元素淘汰,因此所有过期元素都是通过org.redisson.EvictionScheduler实例来实现定期清理的。为了保证资源的有效利用,每次运行最多清理100个过期元素。任务的启动时间将根据上次实际清理数量自动调整,间隔时间趋于1秒到2小时之间。比如该次清理时删除了100条元素,那么下次执行清理的时间将在1秒以后(最小间隔时间)。一旦该次清理数量少于上次清理数量,时间间隔将增加1.5倍。 RSetCache<SomeObject> set = redisson.getSetCache("anySet"); // ttl = 10 seconds set.add(new SomeObject(), 10, TimeUnit.SECONDS); 7.3.2. 集(Set)数据分片(Sharding) Set数据分片是Redis集群模式下的一个功能。Redisson提供的分布式RClusteredSet Java对象也是基于RSet实现的。在这里可以获取更多的信息。 RClusteredSet<SomeObject> set = redisson.getClusteredSet("anySet"); set.add(new SomeObject()); set.remove(new SomeObject()); 除了RClusteredSet以外,Redisson还提供了另一种集群模式下的分布式集(Set),它不仅提供了透明的数据分片功能,还为每个元素提供了淘汰机制。RClusteredSetCache 类分别同时提供了RClusteredSet 和RSetCache 这两个接口的实现。当然这些都是基于java.util.Set的接口实现上的。 该功能仅限于Redisson PRO版本。 7.4. 有序集(SortedSet) 基于Redis的Redisson的分布式RSortedSet Java对象实现了java.util.SortedSet接口。在保证元素唯一性的前提下,通过比较器(Comparator)接口实现了对元素的排序。 RSortedSet<Integer> set = redisson.getSortedSet("anySet"); set.trySetComparator(new MyComparator()); // 配置元素比较器 set.add(3); set.add(1); set.add(2); set.removeAsync(0); set.addAsync(5); 7.5. 计分排序集(ScoredSortedSet) 基于Redis的Redisson的分布式RScoredSortedSet Java对象是一个可以按插入时指定的元素评分排序的集合。它同时还保证了元素的唯一性。 RScoredSortedSet<SomeObject> set = redisson.getScoredSortedSet("simple"); set.add(0.13, new SomeObject(a, b)); set.addAsync(0.251, new SomeObject(c, d)); set.add(0.302, new SomeObject(g, d)); set.pollFirst(); set.pollLast(); int index = set.rank(new SomeObject(g, d)); // 获取元素在集合中的位置 Double score = set.getScore(new SomeObject(g, d)); // 获取元素的评分 7.6. 字典排序集(LexSortedSet) 基于Redis的Redisson的分布式RLexSortedSet Java对象在实现了java.util.Set<String>接口的同时,将其中的所有字符串元素按照字典顺序排列。它公式还保证了字符串元素的唯一性。 RLexSortedSet set = redisson.getLexSortedSet("simple"); set.add("d"); set.addAsync("e"); set.add("f"); set.lexRangeTail("d", false); set.lexCountHead("e"); set.lexRange("d", true, "z", false); 7.7. 列表(List) 基于Redis的Redisson分布式列表(List)结构的RList Java对象在实现了java.util.List接口的同时,确保了元素插入时的顺序。该对象的最大容量受Redis限制,最大元素数量是4 294 967 295个。 RList<SomeObject> list = redisson.getList("anyList"); list.add(new SomeObject()); list.get(0); list.remove(new SomeObject()); 7.8. 队列(Queue) 基于Redis的Redisson分布式无界队列(Queue)结构的RQueue Java对象实现了java.util.Queue接口。尽管RQueue对象无初始大小(边界)限制,但对象的最大容量受Redis限制,最大元素数量是4 294 967 295个。 RQueue<SomeObject> queue = redisson.getQueue("anyQueue"); queue.add(new SomeObject()); SomeObject obj = queue.peek(); SomeObject someObj = queue.poll(); 7.9. 双端队列(Deque) 基于Redis的Redisson分布式无界双端队列(Deque)结构的RDeque Java对象实现了java.util.Deque接口。尽管RDeque对象无初始大小(边界)限制,但对象的最大容量受Redis限制,最大元素数量是4 294 967 295个。 RDeque<SomeObject> queue = redisson.getDeque("anyDeque"); queue.addFirst(new SomeObject()); queue.addLast(new SomeObject()); SomeObject obj = queue.removeFirst(); SomeObject someObj = queue.removeLast(); 7.10. 阻塞队列(Blocking Queue) 基于Redis的Redisson分布式无界阻塞队列(Blocking Queue)结构的RBlockingQueue Java对象实现了java.util.concurrent.BlockingQueue接口。尽管RBlockingQueue对象无初始大小(边界)限制,但对象的最大容量受Redis限制,最大元素数量是4 294 967 295个。 RBlockingQueue<SomeObject> queue = redisson.getBlockingQueue("anyQueue"); queue.offer(new SomeObject()); SomeObject obj = queue.peek(); SomeObject someObj = queue.poll(); SomeObject ob = queue.poll(10, TimeUnit.MINUTES); poll, pollFromAny, pollLastAndOfferFirstTo和take方法内部采用话题订阅发布实现,在Redis节点故障转移(主从切换)或断线重连以后,内置的相关话题监听器将自动完成话题的重新订阅。 7.11. 有界阻塞队列(Bounded Blocking Queue) 基于Redis的Redisson分布式有界阻塞队列(Bounded Blocking Queue)结构的RBoundedBlockingQueue Java对象实现了java.util.concurrent.BlockingQueue接口。该对象的最大容量受Redis限制,最大元素数量是4 294 967 295个。队列的初始容量(边界)必须在使用前设定好。 RBoundedBlockingQueue<SomeObject> queue = redisson.getBoundedBlockingQueue("anyQueue"); // 如果初始容量(边界)设定成功则返回`真(true)`, // 如果初始容量(边界)已近存在则返回`假(false)`。 queue.trySetCapacity(2); queue.offer(new SomeObject(1)); queue.offer(new SomeObject(2)); // 此时容量已满,下面代码将会被阻塞,直到有空闲为止。 queue.put(new SomeObject()); SomeObject obj = queue.peek(); SomeObject someObj = queue.poll(); SomeObject ob = queue.poll(10, TimeUnit.MINUTES); poll, pollFromAny, pollLastAndOfferFirstTo和take方法内部采用话题订阅发布实现,在Redis节点故障转移(主从切换)或断线重连以后,内置的相关话题监听器将自动完成话题的重新订阅。 7.12. 阻塞双端队列(Blocking Deque) 基于Redis的Redisson分布式无界阻塞双端队列(Blocking Deque)结构的RBlockingDeque Java对象实现了java.util.concurrent.BlockingDeque接口。尽管RBlockingDeque对象无初始大小(边界)限制,但对象的最大容量受Redis限制,最大元素数量是4 294 967 295个。 RBlockingDeque<Integer> deque = redisson.getBlockingDeque("anyDeque"); deque.putFirst(1); deque.putLast(2); Integer firstValue = queue.takeFirst(); Integer lastValue = queue.takeLast(); Integer firstValue = queue.pollFirst(10, TimeUnit.MINUTES); Integer lastValue = queue.pollLast(3, TimeUnit.MINUTES); poll, pollFromAny, pollLastAndOfferFirstTo和take方法内部采用话题订阅发布实现,在Redis节点故障转移(主从切换)或断线重连以后,内置的相关话题监听器将自动完成话题的重新订阅。 7.13. 阻塞公平队列(Blocking Fair Queue) 基于Redis的Redisson分布式无界阻塞公平队列(Blocking Fair Queue)结构的RBlockingFairQueue Java对象在实现Redisson分布式无界阻塞队列(Blocking Queue)结构RBlockingQueue接口的基础上,解决了多个队列消息的处理者在复杂的网络环境下,网络延时的影响使“较远”的客户端最终收到消息数量低于“较近”的客户端的问题。从而解决了这种现象引发的个别处理节点过载的情况。 以分布式无界阻塞队列为基础,采用公平获取消息的机制,不仅保证了poll、pollFromAny、pollLastAndOfferFirstTo和take方法获取消息的先入顺序,还能让队列里的消息被均匀的发布到处在复杂分布式环境中的各个处理节点里。 RBlockingFairQueue queue = redisson.getBlockingFairQueue("myQueue"); queue.offer(new SomeObject()); SomeObject obj = queue.peek(); SomeObject someObj = queue.poll(); SomeObject ob = queue.poll(10, TimeUnit.MINUTES); 该功能仅限于Redisson PRO版本。 7.14. 阻塞公平双端队列(Blocking Fair Deque) 基于Redis的Redisson分布式无界阻塞公平双端队列(Blocking Fair Deque)结构的RBlockingFairDeque Java对象在实现Redisson分布式无界阻塞双端队列(Blocking Deque)结构RBlockingDeque接口的基础上,解决了多个队列消息的处理者在复杂的网络环境下,网络延时的影响使“较远”的客户端最终收到消息数量低于“较近”的客户端的问题。从而解决了这种现象引发的个别处理节点过载的情况。 以分布式无界阻塞双端队列为基础,采用公平获取消息的机制,不仅保证了poll、take、pollFirst、takeFirst、pollLast和takeLast方法获取消息的先入顺序,还能让队列里的消息被均匀的发布到处在复杂分布式环境中的各个处理节点里。 RBlockingFairDeque deque = redisson.getBlockingFairDeque("myDeque"); deque.offer(new SomeObject()); SomeObject firstElement = queue.peekFirst(); SomeObject firstElement = queue.pollFirst(); SomeObject firstElement = queue.pollFirst(10, TimeUnit.MINUTES); SomeObject firstElement = queue.takeFirst(); SomeObject lastElement = queue.peekLast(); SomeObject lastElement = queue.pollLast(); SomeObject lastElement = queue.pollLast(10, TimeUnit.MINUTES); SomeObject lastElement = queue.takeLast(); 该功能仅限于Redisson PRO版本。 7.15. 延迟队列(Delayed Queue) 基于Redis的Redisson分布式延迟队列(Delayed Queue)结构的RDelayedQueue Java对象在实现了RQueue接口的基础上提供了向队列按要求延迟添加项目的功能。该功能可以用来实现消息传送延迟按几何增长或几何衰减的发送策略。 RQueue<String> distinationQueue = ... RDelayedQueue<String> delayedQueue = getDelayedQueue(distinationQueue); // 10秒钟以后将消息发送到指定队列 delayedQueue.offer("msg1", 10, TimeUnit.SECONDS); // 一分钟以后将消息发送到指定队列 delayedQueue.offer("msg2", 1, TimeUnit.MINUTES); 在该对象不再需要的情况下,应该主动销毁。仅在相关的Redisson对象也需要关闭的时候可以不用主动销毁。 RDelayedQueue<String> delayedQueue = ... delayedQueue.destroy(); 7.16. 优先队列(Priority Queue) 基于Redis的Redisson分布式优先队列(Priority Queue)Java对象实现了java.util.Queue的接口。可以通过比较器(Comparator)接口来对元素排序。 RPriorityQueue<Integer> queue = redisson.getPriorityQueue("anyQueue"); queue.trySetComparator(new MyComparator()); // 指定对象比较器 queue.add(3); queue.add(1); queue.add(2); queue.removeAsync(0); queue.addAsync(5); queue.poll(); 7.17. 优先双端队列(Priority Deque) 基于Redis的Redisson分布式优先双端队列(Priority Deque)Java对象实现了java.util.Deque的接口。可以通过比较器(Comparator)接口来对元素排序。 RPriorityDeque<Integer> queue = redisson.getPriorityDeque("anyQueue"); queue.trySetComparator(new MyComparator()); // 指定对象比较器 queue.addLast(3); queue.addFirst(1); queue.add(2); queue.removeAsync(0); queue.addAsync(5); queue.pollFirst(); queue.pollLast(); 7.18. 优先阻塞队列(Priority Blocking Queue) 基于Redis的分布式无界优先阻塞队列(Priority Blocking Queue)Java对象的结构与java.util.concurrent.PriorityBlockingQueue类似。可以通过比较器(Comparator)接口来对元素排序。PriorityBlockingQueue的最大容量是4 294 967 295个元素。 RPriorityBlockingQueue<Integer> queue = redisson.getPriorityBlockingQueue("anyQueue"); queue.trySetComparator(new MyComparator()); // 指定对象比较器 queue.add(3); queue.add(1); queue.add(2); queue.removeAsync(0); queue.addAsync(5); queue.take(); 当Redis服务端断线重连以后,或Redis服务端发生主从切换,并重新建立连接后,断线时正在使用poll,pollLastAndOfferFirstTo或take方法的对象Redisson将自动再次为其订阅相关的话题。 7.19. 优先阻塞双端队列(Priority Blocking Deque) 基于Redis的分布式无界优先阻塞双端队列(Priority Blocking Deque)Java对象实现了java.util.Deque的接口。addLast、 addFirst、push方法不能再这个对里使用。PriorityBlockingDeque的最大容量是4 294 967 295个元素。 RPriorityBlockingDeque<Integer> queue = redisson.getPriorityBlockingDeque("anyQueue"); queue.trySetComparator(new MyComparator()); // 指定对象比较器 queue.add(2); queue.removeAsync(0); queue.addAsync(5); queue.pollFirst(); queue.pollLast(); queue.takeFirst(); queue.takeLast(); 当Redis服务端断线重连以后,或Redis服务端发生主从切换,并重新建立连接后,断线时正在使用poll,pollLastAndOfferFirstTo或take方法的对象Redisson将自动再次为其订阅相关的话题。


优秀的个人博客,低调大师

Redisson官方文档 - 6. 分布式对象

每个Redisson对象实例都会有一个与之对应的Redis数据实例,可以通过调用getName方法来取得Redis数据实例的名称(key)。 RMap map = redisson.getMap("mymap"); map.getName(); // = mymap 所有与Redis key相关的操作都归纳在RKeys这个接口里: RKeys keys = redisson.getKeys(); Iterable<String> allKeys = keys.getKeys(); Iterable<String> foundedKeys = keys.getKeysByPattern('key*'); long numOfDeletedKeys = keys.delete("obj1", "obj2", "obj3"); long deletedKeysAmount = keys.deleteByPattern("test?"); String randomKey = keys.randomKey(); long keysAmount = keys.count(); 6.1. 通用对象桶(Object Bucket) Redisson的分布式RBucketJava对象是一种通用对象桶可以用来存放任类型的对象。 RBucket<AnyObject> bucket = redisson.getBucket("anyObject"); bucket.set(new AnyObject(1)); AnyObject obj = bucket.get(); bucket.trySet(new AnyObject(3)); bucket.compareAndSet(new AnyObject(4), new AnyObject(5)); bucket.getAndSet(new AnyObject(6)); 6.2. 二进制流(Binary Stream) Redisson的分布式RBinaryStream Java对象同时提供了InputStream接口和OutputStream接口的实现。流的最大容量受Redis主节点的内存大小限制。 RBinaryStream stream = redisson.getBinaryStream("anyStream"); byte[] content = ... stream.set(content); InputStream is = stream.getInputStream(); byte[] readBuffer = new byte[512]; is.read(readBuffer); OutputStream os = stream.getOuputStream(); byte[] contentToWrite = ... os.write(contentToWrite); 6.3. 地理空间对象桶(Geospatial Bucket) Redisson的分布式RGeoJava对象是一种专门用来储存与地理位置有关的对象桶。 RGeo<String> geo = redisson.getGeo("test"); geo.add(new GeoEntry(13.361389, 38.115556, "Palermo"), new GeoEntry(15.087269, 37.502669, "Catania")); geo.addAsync(37.618423, 55.751244, "Moscow"); Double distance = geo.dist("Palermo", "Catania", GeoUnit.METERS); geo.hashAsync("Palermo", "Catania"); Map<String, GeoPosition> positions = geo.pos("test2", "Palermo", "test3", "Catania", "test1"); List<String> cities = geo.radius(15, 37, 200, GeoUnit.KILOMETERS); Map<String, GeoPosition> citiesWithPositions = geo.radiusWithPosition(15, 37, 200, GeoUnit.KILOMETERS); 6.4. BitSet Redisson的分布式RBitSetJava对象采用了与java.util.BiteSet类似结构的设计风格。可以理解为它是一个分布式的可伸缩式位向量。需要注意的是RBitSet的大小受Redis限制,最大长度为4 294 967 295。 RBitSet set = redisson.getBitSet("simpleBitset"); set.set(0, true); set.set(1812, false); set.clear(0); set.addAsync("e"); set.xor("anotherBitset"); 6.4.1. BitSet数据分片(Sharding) 基于Redis的Redisson集群分布式BitSet通过RClusteredBitSet接口,为集群状态下的Redis环境提供了BitSet数据分片的功能。通过优化后更加有效的算法,突破了原有的BitSet大小限制,达到了集群物理内存容量大小。在这里可以获取更多的内部信息。 RClusteredBitSet set = redisson.getClusteredBitSet("simpleBitset"); set.set(0, true); set.set(1812, false); set.clear(0); set.addAsync("e"); set.xor("anotherBitset"); 该功能仅限于Redisson PRO版本。 6.5. 原子整长形(AtomicLong) Redisson的分布式整长形RAtomicLong对象和Java中的java.util.concurrent.atomic.AtomicLong对象类似。 RAtomicLong atomicLong = redisson.getAtomicLong("myAtomicLong"); atomicLong.set(3); atomicLong.incrementAndGet(); atomicLong.get(); 6.6. 原子双精度浮点(AtomicDouble) Redisson还提供了分布式原子双精度浮点RAtomicDouble,弥补了Java自身的不足。 RAtomicDouble atomicDouble = redisson.getAtomicDouble("myAtomicDouble"); atomicDouble.set(2.81); atomicDouble.addAndGet(4.11); atomicDouble.get(); 6.7. 话题(订阅分发) Redisson的分布式话题RTopic对象实现了发布、订阅的机制。 RTopic<SomeObject> topic = redisson.getTopic("anyTopic"); topic.addListener(new MessageListener<SomeObject>() { @Override public void onMessage(String channel, SomeObject message) { //... } }); // 在其他线程或JVM节点 RTopic<SomeObject> topic = redisson.getTopic("anyTopic"); long clientsReceivedMessage = topic.publish(new SomeObject()); 在Redis节点故障转移(主从切换)或断线重连以后,所有的话题监听器将自动完成话题的重新订阅。 6.7.1. 模糊话题 Redisson的模糊话题RPatternTopic对象可以通过正式表达式来订阅多个话题。 // 订阅所有满足`topic1.*`表达式的话题 RPatternTopic<Message> topic1 = redisson.getPatternTopic("topic1.*"); int listenerId = topic1.addListener(new PatternMessageListener<Message>() { @Override public void onMessage(String pattern, String channel, Message msg) { Assert.fail(); } }); 在Redis节点故障转移(主从切换)或断线重连以后,所有的模糊话题监听器将自动完成话题的重新订阅。 6.8. 布隆过滤器(Bloom Filter) Redisson利用Redis实现了Java分布式布隆过滤器(Bloom Filter)。 RBloomFilter<SomeObject> bloomFilter = redisson.getBloomFilter("sample"); // 初始化布隆过滤器,预计统计元素数量为55000000,期望误差率为0.03 bloomFilter.tryInit(55000000L, 0.03); bloomFilter.add(new SomeObject("field1Value", "field2Value")); bloomFilter.add(new SomeObject("field5Value", "field8Value")); bloomFilter.contains(new SomeObject("field1Value", "field8Value")); 6.8.1. 布隆过滤器数据分片(Sharding) 基于Redis的RedisOS你集群分布式布隆过滤器通过RClusteredBloomFilter接口,为集群状态下的Redis环境提供了布隆过滤器数据分片的功能。通过优化后更加有效的算法,突破了原有的BitSet大小限制,达到了集群物理内存容量大小。在这里可以获取更多的内部信息。 RClusteredBloomFilter<SomeObject> bloomFilter = redisson.getClusteredBloomFilter("sample"); // 采用以下参数创建布隆过滤器 // expectedInsertions = 255000000 // falseProbability = 0.03 bloomFilter.tryInit(255000000L, 0.03); bloomFilter.add(new SomeObject("field1Value", "field2Value")); bloomFilter.add(new SomeObject("field5Value", "field8Value")); bloomFilter.contains(new SomeObject("field1Value", "field8Value")); 该功能仅限于Redisson PRO版本。 6.9. 基数估计算法(HyperLogLog) Redisson利用Redis实现了Java分布式基数估计算法(HyperLogLog)对象。 RHyperLogLog<Integer> log = redisson.getHyperLogLog("log"); log.add(1); log.add(2); log.add(3); log.count(); 6.10. 整长型累加器(LongAdder) 基于Redis的Redisson分布式整长型累加器采用了与java.util.concurrent.atomic.LongAdder类似的接口。通过利用客户端内置的LongAdder对象,为分布式环境下递增和递减操作提供了很高得性能。据统计其性能最高比分布式AtomicLong对象快 12000 倍。完美适用于分布式统计计量场景。 RLongAdder atomicLong = redisson.getLongAdder("myLongAdder"); atomicLong.add(12); atomicLong.increment(); atomicLong.decrement(); atomicLong.sum(); 当不再使用整长型累加器对象的时候应该自行手动销毁,如果Redisson对象被关闭(shutdown)了,则不用手动销毁。 RLongAdder atomicLong = ... atomicLong.destroy(); 6.11. 双精度浮点累加器(DoubleAdder) 基于Redis的Redisson分布式双精度浮点累加器采用了与java.util.concurrent.atomic.DoubleAdder类似的接口。通过利用客户端内置的DoubleAdder对象,为分布式环境下递增和递减操作提供了很高得性能。据统计其性能最高比分布式AtomicDouble对象快 12000 倍。完美适用于分布式统计计量场景。 RLongDouble atomicDouble = redisson.getLongDouble("myLongDouble"); atomicDouble.add(12); atomicDouble.increment(); atomicDouble.decrement(); atomicDouble.sum(); 当不再使用双精度浮点累加器对象的时候应该自行手动销毁,如果Redisson对象被关闭(shutdown)了,则不用手动销毁。 RLongDouble atomicDouble = ... atomicDouble.destroy(); 6.12. 限流器(RateLimiter) 基于Redis的分布式限流器可以用来在分布式环境下现在请求方的调用频率。既适用于不同Redisson实例下的多线程限流,也适用于相同Redisson实例下的多线程限流。该算法不保证公平性。 RRateLimiter rateLimiter = redisson.getRateLimiter("myRateLimiter"); // 初始化 // 最大流速 = 每1秒钟产生10个令牌 rateLimiter.trySetRate(RateType.OVERALL, 10, 1, RateIntervalUnit.SECONDS); // 获取4个令牌 rateLimiter.tryAcquire(4); // 尝试获取4个令牌,尝试等待时间为2秒钟 rateLimiter.tryAcquire(4, 2, TimeUnit.SECONDS); rateLimiter.tryAcquireAsync(2, 2, TimeUnit.SECONDS); // 尝试获取1个令牌,等待时间不限 rateLimiter.acquire(); // 尝试获取1个令牌,等待时间不限 RFuture<Void> future = rateLimiter.acquireAsync(); 该功能仅限于Redisson PRO版本。

优秀的个人博客,低调大师

Android 触摸手势基础 官方文档概览2

触摸手势检测基础 手势检测一般包含两个阶段: 1.获取touch事件数据 2.解析这些数据,看它们是否满足你的应用所支持的某种手势。 相关API: MotionEvent 兼容版的: MotionEventCompat (Note thatMotionEventCompatis not a replacement for the MotionEvent class. Rather, it provides static utility methods to which you pass your MotionEvent object in order to receive the desired action associated with that event.) 一般的Activity或View中的touch事件处理 Activity或View类的onTouchEvent()回调函数会接收到touch事件。 为了截获touch事件,你需要覆写Activity或View的onTouchEvent方法。 View中还可以使用setOnTouchListener()方法添加点击事件的View.OnTouchListener监听对象。这样就可以不继承View而处理点击事件。 但是如果需要处理双击、长按、fling(快滑)等手势,你需要利用GestureDetector类。 onTouchEvent方法的返回值 onTouchEvent方法的返回值,如果返回true,意味着你已经处理过了touch事件;如果返回false,将会继续通过view stack传递事件,直到事件被处理。 这里需要注意ACTION_DOWN事件,如果返回false,则该listener将不会被告知后面的一系列ACTION_MOVE和ACTION_UP事件。 检测手势 Android提供了GestureDetector类来检测一般的手势。 基本使用: 1.生成GestureDetector对象(或GestureDetectorCompat对象),构造时的参数传入监听器对象。 监听器对象实现GestureDetector.OnGestureListener接口。 如果你仅仅是想利用其中的一些手势而不是全部,那么你可以选择继承GestureDetector.SimpleOnGestureListener类,这是一个适配器模式,即这个类实现了GestureDetector.OnGestureListener接口,为其中所有的方法提供了空实现(返回值都是false),当继承GestureDetector.SimpleOnGestureListener类时,子类只需要覆写感兴趣的方法,其他方法是空实现。 2.为了让GestureDetector对象接收到事件,需要覆写View或Activity中的onTouchEvent()方法,将事件传递给detector对象。 一个例子: 根据官网上说: 关于onDown()方法的返回值,最好是返回true,因为所有的手势都是从onDown()信息开始的。 如果像GestureDetector.SimpleOnGestureListener默认实现一样返回false,系统就会认为你想要忽略之后的其他手势,然后GestureDetector.OnGestureListener的其他方法就不会被调用。 但是实际程序验证的时候,发现返回true还是false好像没有什么影响。(??) 跟踪运动 速度 有很多不同的方法来记录手势中的运动,比如pointer的起始位置和终止位置;pointer运动的方向;手势的历史(通过getHistorySize()方法得到);还有pointer的运动速度。 Android提供了VelocityTracker类和VelocityTrackerCompat类,来记录touch事件的速度。 代码例子: 滚动手势 如果一个标准的布局有可能会超出它的容器的边界,可以把它嵌套在一个ScrollView中,这样就会得到一个可以滚动的布局,由framewok处理。 实现一个自定义的scroller应该只在一些特殊情况下需要。 Scroller用来随时间制造滚动动画,使用平台标准的滚动物理参数(摩擦力、速度等)。 Scroller自己本身实际上并不绘制任何东西。 Scroller记录滚动的偏移值,但是它并不会将这些位置应用到你的View,你需要自己动手。 详见:http://developer.android.com/training/gestures/scroll.html 多点触摸手势 当多个pointer同时触摸屏幕,系统会生成如下事件: ACTION_DOWN—For the first pointer that touches the screen. This starts the gesture. The pointer data for this pointer is always at index 0 in theMotionEvent. ACTION_POINTER_DOWN—For extra pointers that enter the screen beyond the first. The pointer data for this pointer is at the index returned bygetActionIndex(). ACTION_MOVE—A change has happened during a press gesture. ACTION_POINTER_UP—Sent when a non-primary pointer goes up. ACTION_UP—Sent when the last pointer leaves the screen. 你可以依靠每一个pointer的index和ID来追踪每一个pointer: Index:MotionEvent会把每一个pointer的信息放在一个数组里,index即是这个数组索引。大多数你用的MotionEvent方法是以这个index作为参数的。 ID:每一个pointer还有一个ID映射,在touch事件中保持恒定一致(persistent),这样就可以在整个手势中跟踪一个单独的pointer。 pointer在一个motion event中出现的顺序是未定的,所以pointer的index在不同的事件中是可变的,但是只要pointer保持active,它的ID是保持不变的。 通过getPointerId()获得ID,这样就可以在多个motion event中追踪pointer。然后对于连续的motion event,可以使用findPointerIndex()方法来获得指定ID的pointer在当前事件中的index。 比如: private int mActivePointerId; public boolean onTouchEvent(MotionEvent event) { .... // Get the pointer ID mActivePointerId = event.getPointerId(0); // ... Many touch events later... // Use the pointer ID to find the index of the active pointer // and fetch its position int pointerIndex = event.findPointerIndex(mActivePointerId); // Get the pointer's current position float x = event.getX(pointerIndex); float y = event.getY(pointerIndex); } 获取MotionEvent的动作应该使用getActionMasked()方法(或者是兼容版的MotionEventCompat.getActionMasked())。 与旧版的getAction()不同,getActionMasked()方法是被设计为可以多个pointer工作的。 它会返回带掩模的动作,不带pointer用于index的那些位。 你可以使用getActionIndex()来得到index。 拖动和缩放 拖动一个对象: 如果是Android 3.0以上,可以使用View的新接口View.OnDragListener参见:Drag and Drop。 其他参见:http://developer.android.com/training/gestures/scale.html 缩放可以使用ScaleGestureDetector。 ScaleGestureDetector可以和GestureDetector一起使用。 ViewGroup中的Touch事件处理 处理ViewGroup的touch事件要麻烦一些,因为很可能各种touch事件的目标不是ViewGroup而是它的child。 为了确保每一个child正确地接收到touch events,需要覆写ViewGroup的onInterceptTouchEvent()方法。 如果onInterceptTouchEvent()方法返回true,说明MotionEvent被截获了,它将不会被传递给child,而是传递给parent的onTouchEvent()方法。 如果你在parent的onInterceptTouchEvent()方法中返回了true,先前还在处理touch event的child view将会接收到一个ACTION_CANCEL,之后的事件就会全传递到parent的onTouchEvent中。 如果onInterceptTouchEvent()方法返回false,则事件继续顺着view结构向下传递,parent不会截获事件,也不会调用parent的onTouchEvent()方法。 另: ViewConfiguration提供一些常量。 TouchDelegate类可以用来设置View的触摸区域。 用法见:http://developer.android.com/training/gestures/viewgroup.html 本文转自莫水千流博客园博客,原文链接:http://www.cnblogs.com/zhoug2020/p/6106863.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 多语言接口协议

本文描述了 Storm (0.7.1 版本以上)的多语言接口协议。 Storm 多语言协议 Shell 组件 Storm 的多语言支持主要通过 ShellBolt,ShellSpout 和 ShellProcess 类来实现。这些类实现了 IBolt 接口、ISpout 接口,并通过使用 Java 的 ProcessBuilder 类调用 shell 进程实现了执行脚本的接口协议。 输出域 输出域是拓扑的 Thrift 定义的一部分。也就是说,如果你在 Java 中使用了多语言接口,那么你就需要创建一个继承自 ShellBolt 并实现 IRichBolt 接口的 bolt,这个 bolt 还需要在declareOutputFields方法中声明输出域(ShellSpout 也有类似的问题)。 你可以在基础概念一文中了解更多相关信息。 协议报头 最简单的协议是通过执行脚本或程序的标准输入输出(STDIN/STDOUT)来实现的。在这个过程中传输的数据都是以 JSON 格式编码的,这样可以支持很多种语言。 打包 为了在集群上运行壳组件,执行的外壳脚本必须和待提交的 jar 包一起置于resources/目录下。 但是,在本地开发测试时,resources 目录只需要保持在 classpath 中即可。 协议 注意: 输入输出协议的结尾都使用行读机制,所以,必须要修剪掉输入中的新行并将他们添加到输出中。 所有的 JSON 输入输出都由一个包含 “end” 的行结束标志。注意,这个定界符并不是 JSON 的一部分。 下面的几个标题就是从脚本作者的 STDIN 与 STDOUT 的角度出发的。 初始握手 两种类型壳组件的初始握手过程都是相同的: STDIN: 设置信息。这是一个包含 Storm 配置、PID 目录、拓扑上下文的 JSON 对象: { "conf": { "topology.message.timeout.secs": 3, // etc }, "pidDir": "...", "context": { "task->component": { "1": "example-spout", "2": "__acker", "3": "example-bolt1", "4": "example-bolt2" }, "taskid": 3, // 以下内容仅支持 Storm 0.10.0 以上版本 "componentid": "example-bolt" "stream->target->grouping": { "default": { "example-bolt2": { "type": "SHUFFLE"}}}, "streams": ["default"], "stream->outputfields": {"default": ["word"]}, "source->stream->grouping": { "example-spout": { "default": { "type": "FIELDS", "fields": ["word"] } } } "source->stream->fields": { "example-spout": { "default": ["word"] } } } } 你的脚本应该在这个目录下创建一个以 PID 命名的空文件。比如,PID 是 1234 的时候,在目录中创建一个名为 1234 的空文件。这个文件可以让 supervisor 了解到进程的 PID,这样,supervisor 在需要的时候就可以关闭该进程。 Storm 0.10.0 加强了发送到壳组件的上下文的功能,现在的上下文中包含了兼容 JVM 组件的拓扑上下文中的所有内容。新增的一个关键因素是确定拓扑中某个壳组件的源与目标(也就是输入与输出)的功能,这是通过stream->target->grouping和source->stream->grouping字典实现的。在这些关联字典的底层,分组是以字典的形式表示的,至少包含有一个type键,并且也可以含有一个fields键,该键可以用于指定在FIELDS分组中所涉及的域。 STDOUT: 你的 PID,以 JSON 对象的形式展现,比如{"pid": 1234}。这个壳组件将会把 PID 记录到它自己的日志中。 接下来怎么做就要取决于组件的具体类型了。 Spouts Shell Spouts 都是同步的。以下内容是在一个 while(true) 循环中实现的: STDIN: 一个 next、ack 或者 fail 命令。 “next” 与 ISpout 的nextTuple等价,可以这样定义 “next”: {"command": "next"} 可以这样定义 “ack”: {"command": "ack", "id": "1231231"} 可以这样定义 “fail”: {"command": "fail", "id": "1231231"} STDOUT: 前面的命令对你的 spout 作用产生的结果。这个结果可以是一组 emits 和 logs。 emit 大概是这样的: { "command": "emit", // tuple 的 id,如果是不可靠 emit 可以省略此值,该 id 可以为字符串或者数字 "id": "1231231", // tuple 将要发送到的流 id,如果发送到默认流,将该值留空 "stream": "1", // 如果是一个直接型 emit,需要定义 tuple 将要发送到的任务 id "task": 9, // 这个 tuple 中的所有值 "tuple": ["field1", 2, 3] } 如果不是直接型 emit,你会立即在 STDIN 上收到一条表示 tuple 发送到的任务的 id 的消息,这个消息是以 JSON 数组形式展现的。 “log” 会将消息记录到 worker log 中,“log” 大概是这样的: { "command": "log", // 待记录的消息 "msg": "hello world!" } STDOUT: “sync” 命令会结束 emits 与 logs 的队列,“sync” 是这样使用的: {"command": "sync"} 在 sync 之后, ShellSpout 不会继续读取你的输出,直到它发送出新的 next,ack 或者 fail。 注意,与 ISpout 类似,worker 中的所有 spouts 都会在调用 next,ack 或者 fail 之后锁定,直到你调用 sync。同样,如果没有需要发送的 tuple,你也应该在 sync 之前 sleep 一小段时间。ShellSpout 不会自动 sleep。 Bolts Shell Bolts 的协议是异步的。你会在有 tuple 可用时立即从 STDIN 中获取到 tuple,同时你需要像下面的示例这样调用 emit,ack,fail,log 等操作写入 STDOUT: STDIN: 就是一个 tuple!这是一个 JSON 编码的结构: { // tuple 的 id,为了兼容缺少 64 位数据类型的语言,这里使用了字符串 "id": "-6955786537413359385", // 创建该 tuple 的 id "comp": "1", // tuple 将要发往的流 id "stream": "1", // 创建该 tuple 的任务 "task": 9, // tuple 中的所有值 "tuple": ["snow white and the seven dwarfs", "field2", 3] } STDOUT: 一个 ack,fail,emit 或者 log。例如,emit 是这样的: { "command": "emit", // 标记这个输出 tuple 的 tuples 的 ids "anchors": ["1231231", "-234234234"], // tuple 将要发送到的流 id,如果发送到默认流,将该值留空 "stream": "1", // 如果是一个直接型 emit,需要定义 tuple 将要发送到的任务 id "task": 9, // 这个 tuple 中的所有值 "tuple": ["field1", 2, 3] } 如果不是直接型 emit,你会立即在 STDIN 上收到一条表示 tuple 发送到的任务的 id 的消息,这个消息是以 JSON 数组形式展现的。注意,由于 shell bolt 协议的异步特性,如果你在 emit 之后立即接收数据,有可能不会收到对应的任务 id,而是收到上一个 emit 的任务 id,或者是一个待处理的新 tuple。然而,最终接收到的任务 id 序列仍然是和 emit 的顺序完全一致的。 ack 是这样的: { "command": "ack", // 待 ack 的 tuple "id": "123123" } fail 是这样的: { "command": "fail", // 待 fail 的 tuple "id": "123123" } “log” 会将消息记录到 worker log 中,“log” 是这样的: { "command": "log", // 待记录的消息 "msg": "hello world!" } 注意:对于 0.7.1 版本,shell bolt 不再需要进行“同步”。 处理心跳(0.9.3 及以上版本适用) Storm 0.9.3 通过在 ShellSpout/ShellBolt 与他们的多语言子进程之间使用心跳来检测子进程是否处于挂起或僵死状态。所有通过多语言接口与 Storm 交互的库都必须使用以下步骤来…… Spout Shell Spouts 是同步的,所有子进程会在next()的结尾发送sync命令。因此,你不需要为 spouts 做过多的处理。也就是说,在next()过程中不能够让子进程的 sleep 时间超过 worker 的延时时间。 Bolt Shell Bolts 是异步的,所以 ShellBolt 会定期向它的子进程发送心跳 tuple。心跳 tuple 是这样的: { "id": "-6955786537413359385", "comp": "1", "stream": "__heartbeat", // 这个 shell bolt 的系统任务 id "task": -1, "tuple": [] } 在子进程收到心跳 tuple 之后,它必须向 ShellBolt 发送一个sync命令。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 使用 Maven 构建 Storm 应用

在开发拓扑的时候,你需要在 classpath 中包含 Storm 的相关 jar 包。你可以将各个 jar 包直接包含到你的项目的 classpath 中,也可以使用 Maven 将 Storm 添加到依赖项中。Storm 已经集成到 Maven 的中心仓库中。你可以在项目的 pom.xml 中添加以下依赖来将 Storm 包含进项目中: <dependency> <groupId>org.apache.storm</groupId> <artifactId>storm-core</artifactId> <version>0.9.3</version> <scope>provided</scope> </dependency> 这里有一个 Storm 项目的 pom.xml 文件的例子(依赖中的版本号与实际 Storm 发行版相关,目前最新的正式版本为 0.9.5 —— 译者注)。 Storm 开发 如果对 Storm 的开发很感兴趣,请参考DEVELOPER一文。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

docker官方文档中的dns,link,expose,publish

link是过时的了,尽量不要用。 dns内部集成,也可以用外部。 expose只是用于记录,并不真的。 publish是否起作用,也要看情况,是否被占用端口。 -------------------------------------- Embedded DNS server Docker daemon runs an embedded DNS server which provides DNS resolution among containers connected to the same user-defined network, so that these containers can resolve container names to IP addresses. If the embedded DNS server is unable to resolve the request, it will be forwarded to any external DNS servers configured for the container. To facilitate this when the container is created, only the embedded DNS server reachable at127.0.0.11will be listed in the container’sresolv.conffile. For more information on embedded DNS server on user-defined networks, seeembedded DNS server in user-defined networks Exposing and publishing ports In Docker networking, there are two different mechanisms that directly involve network ports: exposing and publishing ports. This applies to the default bridge network and user-defined bridge networks. You expose ports using theEXPOSEkeyword in the Dockerfile or the--exposeflag todocker run. Exposing ports is a way of documenting which ports are used, but does not actually map or open any ports. Exposing ports is optional. You publish ports using thePUBLISHkeyword in the Dockerfile or the--publishflag todocker run. This tells Docker which ports to open on the container’s network interface. When a port is published, it is mapped to an available high-order port (higher than30000) on the host machine, unless you specify the port to map to on the host machine at runtime. You cannot specify the port to map to on the host machine in the Dockerfile, because there is no way to guarantee that the port will be available on the host machine where you run the image. This example publishes port 80 in the container to a random high port (in this case,32768) on the host machine. $ docker run -it -p 80 nginx $ docker ps 64879472feea nginx "nginx -g 'daemon ..." 43 hours ago Up About a minute 443/tcp, 0.0.0.0:32768->80/tcp blissful_mclean The next example specifies that port 80 should be mapped to port 8080 on the host machine. It will fail if port 8080 is not available. $ docker run -it -p 80:8080 nginx $ docker ps b9788c7adca3 nginx "nginx -g 'daemon ..." 43 hours ago Up 3 seconds 80/tcp, 443/tcp, 0.0.0.0:80->8080/tcp goofy_brahmagupta Links Before Docker included user-defined networks, you could use the Docker--linkfeature to allow a container to resolve another container’s name to an IP address, and also give it access to the linked container’s environment variables. Where possible, you should avoid using the legacy--linkflag. When you create links, they behave differently when you use the defaultbridgenetwork or when you use user-defined bridge networks. For more information, seeLegacy Linksfor link feature in defaultbridgenetwork and thelinking containers in user-defined networksfor links functionality in user-defined networks.

优秀的个人博客,低调大师

一起来读官方文档-----SpringIOC(08)

1.9。基于注解的容器配置 注解在配置Spring方面比XML更好吗? 基于注解的配置的引入提出了一个问题,即这种方法是否比XML“更好”。 简短的答案是“取决于情况”。 长话短说,每种方法都有其优缺点,通常,由开发人员决定哪种策略更适合他们。 由于定义方式的不同,注解在声明中提供了很多上下文,从而使配置更短,更简洁。 但是,XML擅长连接组件而不接触其源代码或重新编译它们。 一些开发人员更喜欢将布线放置在靠近源的位置,而另一些开发人员则认为带注解的类不再是POJO, 而且,该配置变得分散且难以控制。 无论选择如何,Spring都可以容纳两种样式,甚至可以将它们混合在一起。 值得指出的是,通过其JavaConfig选项,Spring允许以非侵入方式使用注解, 而无需接触目标组件的源代码。 注解是XML配置的替代方法,该配置依赖字节码元数据来连接组件,而不是尖括号声明。 通过使用相关的 类,方法或字段 声明上的注解,开发人员无需使用XML来描述bean的连接,而是将配置移入组件类本身。 如示例中所述:将RequiredAnnotationBeanPostProcessor,通过BeanPostProcessor的方式与注解结合使用是扩展Spring IoC容器的常用方法。 例如,Spring 2.0引入了使用@Required注解强制执行必需属性的可能性。 Spring 2.5引入@Autowired注解,提供的功能与自动装配协作器中所述的功能相同,但具有更细粒度的控制和更广泛的适用性。 Spring 2.5还添加了对JSR-250批注(例如 @PostConstruct和@PreDestroy)的支持。 Spring 3.0增加了对javax.inject包中包含的JSR-330(Java依赖性注入)注解的支持,例如@Inject 和@Named。 注解注入在XML注入之前执行。因此,XML配置将覆盖通过注解注入的属性 与往常一样,您可以根据类名将它们注册为单独的bean定义,但也可以通过在基于XML的Spring配置中包含以下标记来隐式注册它们: <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:context="http://www.springframework.org/schema/context" xsi:schemaLocation="http://www.springframework.org/schema/beans https://www.springframework.org/schema/beans/spring-beans.xsd http://www.springframework.org/schema/context https://www.springframework.org/schema/context/spring-context.xsd"> <context:annotation-config/> </beans> <context:annotation-config/> 隐式注册后置处理器包括 : AutowiredAnnotationBeanPostProcessor CommonAnnotationBeanPostProcessor PersistenceAnnotationBeanPostProcessor RequiredAnnotationBeanPostProcessor 并且当使用<context:component-scan/>后,即可将<context:annotation-config/>省去 context:annotation-config/只在定义它的相同应用程序上下文中查找关于bean的注解。 这意味着,如果你把context:annotation-config/定义在WebApplicationContext的DispatcherServlet中,它只是检查controllers中的@Autowired注解,而不是你的services。 上边的这段话意思不是很明确,需要解释一下以前用web.xml配置时的Spring启动流程 拿出几段配置 <!--配置开始 --> <servlet> <servlet-name>dispatcher</servlet-name> <servlet-class>org.springframework.web.servlet.DispatcherServlet</servlet-class> <init-param> <param-name>contextConfigLocation</param-name> <param-value>classpath:spring-mvc.xml</param-value> </init-param> <load-on-startup>1</load-on-startup> </servlet> <servlet-mapping> <servlet-name>dispatcher</servlet-name> <url-pattern>/service/*</url-pattern> </servlet-mapping> <listener> <listener-class>org.springframework.web.context.ContextLoaderListener</listener-class> </listener> <context-param> <param-name>contextConfigLocation</param-name> <param-value> classpath*:spring/spring-base.xml </param-value> </context-param> <!--配置结束 --> 上边的配置应该是多年前webi应用的基础配置,理一下tomcat启动后如何调用Spring的大概流程 1. tomcat读取web.xml文件(此处不管tomcat如何找到xml),解析内容并分组, 分成ServletContainerInitializer,servlet,listener,context-param等多个数组 2.逐个进行解析,先解析ServletContainerInitializer //这个就相当典型了 这个东西就是之前的文章讲过的ServletContainerInitializer //Tomcat启动会查找ServletContainerInitializer实现类并执行其中的onStartup方法。 //Spring-web模块存在ServletContainerInitializer实现类,所以Tomcat启动会调用Spring-web的代码。 //但是我们用Spring框架的话不需要实现这个接口,实现一个Spring的接口WebApplicationInitializer。 //就可以由Tomcat调用Spring-web的ServletContainerInitializer实现类 Iterator i$ = this.initializers.entrySet().iterator(); while(i$.hasNext()) { Entry entry = (Entry)i$.next(); try { ((ServletContainerInitializer)entry.getKey()).onStartup((Set)entry.getValue(), this.getServletContext()); } catch (ServletException var22) { log.error(sm.getString("standardContext.sciFail"), var22); ok = false; break; } } 但是这里我们并没有用这种方式而是用了listener的方式继续往下看 3. 解析listener,这里this.listenerStart()会解析我们配置的ContextLoaderListener if (ok && !this.listenerStart()) { log.error(sm.getString("standardContext.listenerFail")); ok = false; } 就在这里tomcat关联上了Spring的ApplicationContext,会实例化XmlWebApplicationContext, 实例化时取出context-param中的name为contextConfigLocation的配置文件,来进行解析注册 4.解析servlet,this.loadOnStartup(this.findChildren())来解析servlet, if (ok && !this.loadOnStartup(this.findChildren())) { log.error(sm.getString("standardContext.servletFail")); ok = false; } 这里就会进入DispatcherServlet的init方法, init方法中会根据当前的ServletContext查找在此之前有没有初始化过Spring的ApplicationContext, 然后再判断当前DispatcherServlet有没有ApplicationContext, 如果没有就初始化一个并把之前初始化ApplicationContext的设置为父节点 总结一下,也就是说用了上边的配置的话,tomcat在启动过程中,会初始化两遍并生成两个ApplicationContext对象, 第一遍解析context-param中param-name 为contextConfigLocation的配置文件, 并以此配置文件生成一个ApplicationContext ROOT 第二遍是解析DispatcherServlet servlet的spring-mvc.xml配置文件, 再以此配置文件生成一个ApplicationContext,并将ROOT设置为父节点 因此就产生了一个问题,当你在两个ApplicationContext都可以扫描到同一个Bean的时候, 那么这个bean在连个ApplicationContext中都各存在一个实例,并且实例不一样 举一个之前遇到的问题: 之前想给某个controller加一个AOP,拦截某些方法进行特殊处理,但是我把 <aop:aspectj-autoproxy/>这个注解 放到了下面这个层次的配置文件中了 <context-param> <param-name>contextConfigLocation</param-name> <param-value> classpath*:spring/spring-base.xml </param-value> </context-param> 最后我的AOP并没有生效,后来又把注解挪到了spring-mvc.xml中,才生效。 之前百度搜到说:spring-mvc 的配置扫描优先于spring的配置文件 通过调试才理解这句话: 我的controller在spring的ApplicationContext中有一份被AOP代理的对象 在spring-mvc的ApplicationContext中还有一份没被代理的普通对象 因为spring-mvc配置加载的晚,所以用到的都是没有被代理的对象 1.9.1。@Required 该@Required注解适用于bean属性setter方法,如下面的例子: public class SimpleMovieLister { private MovieFinder movieFinder; @Required public void setMovieFinder(MovieFinder movieFinder) { this.movieFinder = movieFinder; } } 这个注解要求,必须在配置时通过bean定义中的显式属性值或自动装配来填充bean属性。 如果未填充bean属性,容器将抛出异常。 这样显式的失败,避免了实例在应用的时候出现NullPointerException的情况。 @Required注解在Spring Framework 5.1时正式被弃用, Spring更赞同使用构造函数注入来进行必需参数的设置 (或者使用InitializingBean.afterPropertiesSet()的自定义实现来进行bean属性的设置)。 1.9.2。@Autowired 在本节包含的示例中,JSR330的@Inject注释可以用来替代Spring的@Autowired注释。 您可以将@Autowired注解应用于构造函数,如以下示例所示: public class MovieRecommender { private final CustomerPreferenceDao customerPreferenceDao; @Autowired public MovieRecommender(CustomerPreferenceDao customerPreferenceDao) { this.customerPreferenceDao = customerPreferenceDao; } // ... } 从Spring Framework 4.3开始,@Autowired如果目标bean仅定义一个构造函数作为开始,则不再需要在此类构造函数上进行注解。 但是,如果有多个构造函数可用,并且没有主/默认构造函数,则必须至少注解一个构造函数,@Autowired以指示容器使用哪个构造函数。 您还可以将@Autowired注解应用于传统的setter方法,如以下示例所示: public class SimpleMovieLister { private MovieFinder movieFinder; @Autowired public void setMovieFinder(MovieFinder movieFinder) { this.movieFinder = movieFinder; } } 您还可以将注解应用于具有任意名称和多个参数的方法,如以下示例所示: public class MovieRecommender { private MovieCatalog movieCatalog; private CustomerPreferenceDao customerPreferenceDao; @Autowired public void prepare(MovieCatalog movieCatalog, CustomerPreferenceDao customerPreferenceDao) { this.movieCatalog = movieCatalog; this.customerPreferenceDao = customerPreferenceDao; } } 您也可以将其应用于@Autowired字段,甚至可以将其与构造函数混合使用,如以下示例所示: public class MovieRecommender { private final CustomerPreferenceDao customerPreferenceDao; @Autowired private MovieCatalog movieCatalog; @Autowired public MovieRecommender(CustomerPreferenceDao customerPreferenceDao) { this.customerPreferenceDao = customerPreferenceDao; } // ... } 确保目标组件(例如MovieCatalog或CustomerPreferenceDao)与带@Autowired注解的注入点的类型一致地声明。 否则,注入可能会由于运行时出现“no type match found”错误而失败。 对于通过类路径扫描找到的xml定义的bean或组件类,容器通常预先知道具体的类型。 但是,对于@Bean工厂方法,您需要确保声明的返回类型具有足够的表达能力。 对于实现多个接口的组件,或者对于可能由其实现类型引用的组件, 考虑在您的工厂方法上声明最特定的返回类型(至少与引用您的bean的注入点所要求的那样特定)。 您还可以将@Autowired注解添加到需要该类型数组的字段或方法中,指示Spring提供特定类型的所有bean ,如以下示例所示: public class MovieRecommender { @Autowired private MovieCatalog[] movieCatalogs; // ... } 如以下示例所示,这同样适用于类型化集合: public class MovieRecommender { private Set<MovieCatalog> movieCatalogs; @Autowired public void setMovieCatalogs(Set<MovieCatalog> movieCatalogs) { this.movieCatalogs = movieCatalogs; } // ... } 如果希望数组或列表中的项目以特定顺序排序, 则目标bean可以实现该org.springframework.core.Ordered接口或使用@Order或标准@Priority注解。 否则,它们的顺序将遵循容器中相应目标bean定义的注册顺序。 您可以使用@Order在目标类级别和@Bean方法上声明注解。 @Order值可能会影响注入点的优先级,但请注意它们不会影响单例启动顺序, 这是由依赖关系和@DependsOn声明确定的正交关系。(举例:a,b,c三个bean设置的order分别为1,2,3, 但是a依赖c,所以a在初始化的时候会初始化c,导致c比b提前初始化) 请注意,标准javax.annotation.Priority注解在该@Bean级别不可用 ,因为无法在方法上声明它。 可以通过将@Order值与@Primary每个类型的单个bean结合使用来对其语义进行建模。 即使是类型化的Map实例也可以自动注入,键包含相应的bean名称是String类型,值是对应的bean实例,如下面的示例所示: public class MovieRecommender { private Map<String, MovieCatalog> movieCatalogs; @Autowired public void setMovieCatalogs(Map<String, MovieCatalog> movieCatalogs) { this.movieCatalogs = movieCatalogs; } } 默认情况下,当给定注入点没有匹配的候选bean可用时,自动装配将失败。对于声明的数组,集合或映射,至少应有一个匹配元素。 默认是将带注解的方法和字段视为必须要注入的依赖项。 你可以通过标记为非必需注入来改变这个行为(例如,通过在@Autowired中设置required属性为false): public class SimpleMovieLister { private MovieFinder movieFinder; @Autowired(required = false) public void setMovieFinder(MovieFinder movieFinder) { this.movieFinder = movieFinder; } // ... } @Autowired(required = false)用在方法上时 当存在任何一个参数不可注入,则根本不会调用该方法。 在这种情况下,完全不需要填充非必需字段,而保留其默认值。 当方法有多个参数时,可以使用该注解标识其中的某个参数可以不被注入 public class ServiceController { private ServiceTwo serviceTwo; private CusService serviceOne; public ServiceController(CusService cusService, @Autowired(required = false) ServiceTwo serviceTwo){ this.serviceOne = cusService; this.serviceTwo = serviceTwo; } } 在任何给定bean类中,只有一个构造函数可以声明@Autowired,并将required属性设置为true,以指示当作为Spring bean使用时要自动装配的构造函数。 因此,如果required属性的默认值为true,那么只有一个构造函数可以使用@Autowired注解。 如果有多个构造函数声明注解,那么它们都必须声明required=false,才能被认为是自动装配的候选者(类似于XML中的autowire=constructor)。 通过在Spring容器中匹配bean可以满足的依赖关系最多的构造函数将被选择。 如果没有一个候选函数可以满足,那么将使用主/默认构造函数(如果存在)。 类似地,如果一个类声明了多个构造函数,但是没有一个是用@Autowired注解的,那么一个主/默认构造函数(如果有的话)将会被使用。 如果一个类只声明了一个构造函数,那么它将始终被使用,即使没有@Autowired注解。 请注意,带注解的构造函数不必是public的。 建议在setter方法上的已弃用的@Required注释上使用@Autowired属性。 将required属性设置为false表示该属性对于自动装配目的是不需要的,并且如果该属性不能自动装配,则忽略它。 另一方面,@Required更强制,因为它强制用容器支持的任何方法设置属性,如果没有定义值,则会引发相应的异常。 另外,您可以通过Java8来表达特定依赖项的非必需性质java.util.Optional,如以下示例所示: public class SimpleMovieLister { @Autowired public void setMovieFinder(Optional<MovieFinder> movieFinder) { ... } } 从Spring Framework 5.0开始,您还可以使用@Nullable注解(任何包中的Nullable注解,例如,javax.annotation.Nullable来自JSR-305的注解)。 使用此注解标识该参数不一定会被注入,有可能会是空值 public class SimpleMovieLister { @Autowired public void setMovieFinder(@Nullable MovieFinder movieFinder) { ... } } 您还可以对这些接口(BeanFactory,ApplicationContext,Environment,ResourceLoader, ApplicationEventPublisher,和MessageSource)使用@Autowired。 这些接口及其扩展接口(例如ConfigurableApplicationContext或ResourcePatternResolver)将自动解析,而无需进行特殊设置。 以下示例自动装配ApplicationContext对象: public class MovieRecommender { @Autowired private ApplicationContext context; public MovieRecommender() { } // ... } 在@Autowired,@Inject,@Value,和@Resource注解由Spring注册的BeanPostProcessor实现。 这意味着您不能在自己的类型BeanPostProcessor或BeanFactoryPostProcessor类型(如果有)中应用这些注解。 必须通过使用XML或Spring@Bean方法显式地“连接”这些类型。 不仅相当上一章的内容: 您应该看到一条参考性日志消息: Bean someBean is not eligible for getting processed by all BeanPostProcessor interfaces (for example: not eligible for auto-proxying)。 这条消息的意思大概就是说这个bean没有得到所有BeanPostProcessor的处理 如果您自定义的BeanPostProcessor或BeanFactoryPostProcessor在自动注入的BeanPostProcessor之前实例化那么就无法为您注入您想要的参数。 1.9.3。@Primary 由于按类型自动布线可能会导致多个候选对象,因此通常有必要对选择过程进行更多控制。 一种实现此目的的方法是使用Spring的 @Primary注解。 @Primary指示当多个bean是要自动装配到单值依赖项的候选对象时,应给予特定bean优先权。 如果候选中恰好存在一个主bean,则它将成为自动装配的值。 考虑以下定义firstMovieCatalog为主要配置的配置MovieCatalog: @Configuration public class MovieConfiguration { @Bean @Primary public MovieCatalog firstMovieCatalog() { ... } @Bean public MovieCatalog secondMovieCatalog() { ... } // ... } 使用前面的配置,以下内容MovieRecommender将自动注入到 firstMovieCatalog: public class MovieRecommender { @Autowired private MovieCatalog movieCatalog; // ... } 1.9.4。@Qualifier @Primary当可以确定一个主要候选对象时,它是在几种情况下按类型使用自动装配的有效方法。 当需要对选择过程进行更多控制时,可以使用Spring的@Qualifier注解。 您可以将限定符值与特定的参数相关联,从而缩小类型匹配的范围,以便为每个参数选择特定的bean。 在最简单的情况下,这可以是简单的描述性值,如以下示例所示: public class MovieRecommender { @Autowired @Qualifier("main") private MovieCatalog movieCatalog; // ... } 您还可以@Qualifier在各个构造函数参数或方法参数上指定注解,如以下示例所示: public class MovieRecommender { private MovieCatalog movieCatalog; private CustomerPreferenceDao customerPreferenceDao; @Autowired public void prepare(@Qualifier("main") MovieCatalog movieCatalog, CustomerPreferenceDao customerPreferenceDao) { this.movieCatalog = movieCatalog; this.customerPreferenceDao = customerPreferenceDao; } // ... } 下面的示例显示了相应的bean定义。 <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:context="http://www.springframework.org/schema/context" xsi:schemaLocation="http://www.springframework.org/schema/beans https://www.springframework.org/schema/beans/spring-beans.xsd http://www.springframework.org/schema/context https://www.springframework.org/schema/context/spring-context.xsd"> <context:annotation-config/> <bean class="example.SimpleMovieCatalog"> <qualifier value="main"/> <!-- 指定qualifier属性 --> </bean> </beans> bean名称被认为是默认的qualifier值。 也可以不使用qualifier而是将该bean的id定义为main,达到相同的匹配效果。 然而,尽管您可以使用这种约定来按名称引用特定的bean,但@Autowired基本上是关于类型驱动的注入,qualifier只是在类型之上的可选选项,这意味着,即使使用了bean名称来进行qualifier的限定,qualifier 值也总是在类型匹配集中选择相同名称的bean。 qualifier 也适用于collections, 如前所述—例如 Set<MovieCatalog>,在这种情况下,根据声明的qualifier值,所有匹配的bean都作为一个集合注入。 这意味着qualifier不必是惟一的。相反,它们构成了过滤标准。例如,您可以定义具有相同qualifier值“action”的多个MovieCatalog bean, 所有这些bean都被注入到带有@Qualifier(“action”)注释的集合中。 public class ServiceController { @Autowired @Qualifier("main") private List<MovieCatalog> serviceList; } <bean class="example.SimpleMovieCatalogOne"> <qualifier value="main"/> <!-- 指定相同的qualifier属性 --> </bean> <bean class="example.SimpleMovieCatalogTwo"> <qualifier value="main"/> <!-- 指定相同的qualifier属性 --> </bean> <bean class="example.SimpleMovieCatalogThree"> <qualifier value="action"/> <!-- 指定相同的qualifier属性 --> </bean> 如果没有其他注解(例如qualifier或primary ), 对于非唯一依赖情况,Spring将注入点名称(即字段名称或参数名称)与目标bean名称或者bean id匹配, 并选择同名的候选对象(如果有同名的的话,没有同名的话则依然抛出异常)。 如果您打算通过名称进行依赖注入,请不要主要使用@Autowired,即使它能够通过bean名称在类型匹配的候选者中进行选择。 使用JSR-250 @Resource注解: 1. 如果同时指定了name和type,按照bean Name 和 bean 类型同时匹配 2. 如果指定了name,就按照bean Name 匹配 3. 如果指定了type,就按照类型匹配 4. 如果既没有指定name,又没有指定type,就先按照beanName匹配; 如果没有匹配,再按照类型进行匹配; 测试 @Resource的时候还发现一个有意思的东西, 当被注入的是个List的时候,不管是什么类型的List, 只要@Resource加了name条件,都能被注入进去, 比如 List<String> 会被注入到List<MovieCatalog> 大家可以试一下 @Autowired注解: 在按类型选择候选bean之后,再在候选者bean中选择相同名称的。 @Autowired适用于 字段,构造方法,和多参数方法,允许通过qualifier注解在参数级别上缩小范围。 相比之下,@Resource只支持具有单个参数的字段和bean属性设置器方法。 因此,如果注入目标是构造函数或多参数方法,则应该坚持使用qualifier。 您可以创建自己的自定义限定符注解。为此,请定义一个注解并在您的定义中提供该注解,如以下示例所示: @Target({ElementType.FIELD, ElementType.PARAMETER}) @Retention(RetentionPolicy.RUNTIME) @Qualifier public @interface Genre { String value(); } 然后,您可以在自动连接的字段和参数上提供自定义限定符,如以下示例所示: public class MovieRecommender { @Autowired @Genre("Action") private MovieCatalog actionCatalog; private MovieCatalog comedyCatalog; @Autowired public void setComedyCatalog(@Genre("Comedy") MovieCatalog comedyCatalog) { this.comedyCatalog = comedyCatalog; } // ... } 接下来,您可以为候选bean定义提供信息。您可以添加<qualifier></qualifier>标记作为<bean></bean>标记的子元素,然后指定类型和值来匹配您的自定义qualifier注解。该类型与注释的全限定类名匹配。 另外,为了方便起见,如果不存在名称冲突的风险,您可以使用简短的类名。 下面的例子演示了这两种方法: <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:context="http://www.springframework.org/schema/context" xsi:schemaLocation="http://www.springframework.org/schema/beans https://www.springframework.org/schema/beans/spring-beans.xsd http://www.springframework.org/schema/context https://www.springframework.org/schema/context/spring-context.xsd"> <context:annotation-config/> <bean class="example.SimpleMovieCatalog"> <qualifier type="Genre" value="Action"/> <!-- inject any dependencies required by this bean --> </bean> <bean class="example.SimpleMovieCatalog"> <qualifier type="example.Genre" value="Comedy"/> <!-- inject any dependencies required by this bean --> </bean> <bean id="movieRecommender" class="example.MovieRecommender"/> </beans> 在某些情况下,使用没有值的注解就足够了。当注解用于更通用的目的,并且可以跨几种不同类型的依赖项应用时,这一点非常有用。例如,您可以提供一个脱机目录,当没有可用的Internet连接时可以搜索该目录。首先,定义简单注释,如下例所示: @Target({ElementType.FIELD, ElementType.PARAMETER}) @Retention(RetentionPolicy.RUNTIME) @Qualifier public @interface Offline { } 然后将注解添加到要自动装配的字段或属性,如以下示例所示: public class MovieRecommender { @Autowired @Offline private MovieCatalog offlineCatalog; // ... } 现在,bean定义仅需要一个限定符type,如以下示例所示: <bean class="example.SimpleMovieCatalog"> <qualifier type="Offline"/> <!-- inject any dependencies required by this bean --> </bean> 您还可以定义自定义qualifier注解,自定义的注解可以定义除了简单value属性之外的属性。 如果随后在要自动装配的字段或参数上指定了多个属性值,则bean定义必须与所有此类属性值匹配才能被视为自动装配候选。 例如,请考虑以下注解定义: @Target({ElementType.FIELD, ElementType.PARAMETER}) @Retention(RetentionPolicy.RUNTIME) @Qualifier public @interface MovieQualifier { String genre(); Format format(); } 在这种情况下Format是一个枚举,定义如下: public enum Format { VHS, DVD, BLURAY } 要自动装配的字段将用自定义qualifier进行注解,并包括这两个属性的值:genre和format,如以下示例所示: public class MovieRecommender { @Autowired @MovieQualifier(format=Format.VHS, genre="Action") private MovieCatalog actionVhsCatalog; @Autowired @MovieQualifier(format=Format.VHS, genre="Comedy") private MovieCatalog comedyVhsCatalog; @Autowired @MovieQualifier(format=Format.DVD, genre="Action") private MovieCatalog actionDvdCatalog; @Autowired @MovieQualifier(format=Format.BLURAY, genre="Comedy") private MovieCatalog comedyBluRayCatalog; // ... } 最后,bean定义应该包含匹配的限定符值。这个例子还演示了您可以使用bean元属性来代替<qualifier></qualifier>元素。 如果可用,<qualifier></qualifier>元素及其属性优先,但是如果没有这样的限定符,自动装配机制就会回到<meta>标签中提供的值上,就像下面例子中的最后两个bean定义一样: <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:context="http://www.springframework.org/schema/context" xsi:schemaLocation="http://www.springframework.org/schema/beans https://www.springframework.org/schema/beans/spring-beans.xsd http://www.springframework.org/schema/context https://www.springframework.org/schema/context/spring-context.xsd"> <context:annotation-config/> <bean class="example.SimpleMovieCatalog"> <qualifier type="MovieQualifier"> <attribute key="format" value="VHS"/> <attribute key="genre" value="Action"/> </qualifier> <!-- inject any dependencies required by this bean --> </bean> <bean class="example.SimpleMovieCatalog"> <qualifier type="MovieQualifier"> <attribute key="format" value="VHS"/> <attribute key="genre" value="Comedy"/> </qualifier> <!-- inject any dependencies required by this bean --> </bean> <bean class="example.SimpleMovieCatalog"> <meta key="format" value="DVD"/> <meta key="genre" value="Action"/> <!-- inject any dependencies required by this bean --> </bean> <bean class="example.SimpleMovieCatalog"> <meta key="format" value="BLURAY"/> <meta key="genre" value="Comedy"/> <!-- inject any dependencies required by this bean --> </bean> </beans> 1.9.5。将泛型用作自动装配限定符 除了@Qualifier注解之外,您还可以将Java泛型类型用作资格的隐式形式。例如,假设您具有以下配置: @Configuration public class MyConfiguration { @Bean public StringStore stringStore() { return new StringStore(); } @Bean public IntegerStore integerStore() { return new IntegerStore(); } } 假设前面的bean实现了一个通用接口(即Store<String>和 Store<Integer>) class StringStore implements Store<String>{ } class IntegerStore implements Store<Integer>{ } 则可以@Autowire将该Store接口和通用用作限定符,如以下示例所示: @Autowired private Store<String> s1; // <String> qualifier, 注入 stringStore bean @Autowired private Store<Integer> s2; // <Integer> qualifier, 注入 the integerStore bean 在自动装配列表,Map实例和数组时,通用限定符也适用。下面的示例自动连接泛型List: // 只注入 Store<Integer> 类型 // Store<String> 不会被注入 @Autowired private List<Store<Integer>> s; 1.9.6。使用CustomAutowireConfigurer CustomAutowireConfigurer 是一个BeanFactoryPostProcessor 您可以注册自己的自定义限定符注解类型,即使它们未使用Spring的@Qualifier注解进行注解。 像之前我们定义的注解 @Target({ElementType.FIELD, ElementType.PARAMETER}) @Retention(RetentionPolicy.RUNTIME) @Qualifier public @interface MovieQualifier { String value(); } 这种写法主要就是托@Qualifier的福气 但我们也可以不依赖它 以下示例显示如何使用CustomAutowireConfigurer: <bean id="customAutowireConfigurer" class="org.springframework.beans.factory.annotation.CustomAutowireConfigurer"> <property name="customQualifierTypes"> <set> <value>example.CustomQualifier</value> </set> </property> </bean> example.CustomQualifier Spring会根据这个类路径加载这个类, 并将这个类作为和@Qualifier同作用来对待 自动注入是如何处理候选对象的? bean definition 的 autowire-candidate 值,值为false表示该bean不参于候选 <beans/>元素default-autowire-candidates上可用的任何模式,值为false表示该组的bean不参与候选 @Qualifier注解 和 任何在customautowiresfigurer注册的自定义注解的存在会被优先使用 当多个bean符合自动装配候选条件时, 确定“primary”的步骤如下:如果候选中恰好有一个bean定义将primary属性设置为true,则将其选中。 1.9.7。@Resource Spring还通过在字段或bean属性设置器方法上使用JSR-250@Resource批注(javax.annotation.Resource)支持注入。 1. 如果同时指定了name和type,按照bean Name 和 bean 类型同时匹配 2. 如果指定了name,就按照bean Name 匹配 3. 如果指定了type,就按照类型匹配 4. 如果既没有指定name,又没有指定type,就先按照beanName匹配; 如果没有匹配,再按照类型进行匹配; @Resource具有name属性。默认情况下,Spring将该值解释为要注入的Bean名称。 换句话说,它遵循名称语义,如以下示例所示: public class SimpleMovieLister { private MovieFinder movieFinder; @Resource(name="myMovieFinder") public void setMovieFinder(MovieFinder movieFinder) { this.movieFinder = movieFinder; } } 如果未明确指定名称,则默认名称是从字段名称或setter方法派生的。 如果是字段,则采用字段名称。 在使用setter方法的情况下,它采用bean属性名称。 以下示例将名为 movieFinder的bean注入到setter方法: public class SimpleMovieLister { private MovieFinder movieFinder; @Resource public void setMovieFinder(MovieFinder movieFinder) { this.movieFinder = movieFinder; } } 因此,在下例中,customerPreferenceDao字段首先查找名为“customerPreferenceDao”的bean,找不到的话然后返回到与类型customerPreferenceDao匹配的bean: public class MovieRecommender { @Resource private CustomerPreferenceDao customerPreferenceDao; @Resource private ApplicationContext context; public MovieRecommender() { } } 1.9.8。使用@Value @Value 通常用于注入外部属性: @Component public class MovieRecommender { private final String catalog; public MovieRecommender(@Value("${catalog.name}") String catalog) { this.catalog = catalog; } } 使用以下配置: @Configuration @PropertySource("classpath:application.properties") public class AppConfig { } 和以下application.properties文件: catalog.name=MovieCatalog 在这种情况下,catalog参数和字段将等于MovieCatalog值。 Spring提供了一个默认的值解析器。 它将尝试解析属性值,如果无法解析, ${catalog.name} 则将被当做值注入到属性中。 例如:catalog="${catalog.name}" 如果要严格控制不存在的值,则应声明一个PropertySourcesPlaceholderConfigurerbean,如以下示例所示: @Configuration public class AppConfig { @Bean public static PropertySourcesPlaceholderConfigurer propertyPlaceholderConfigurer() { return new PropertySourcesPlaceholderConfigurer(); } } 当配置PropertySourcesPlaceholderConfigurer使用JavaConfig,该@Bean方法必须是static。 如果${} 无法解析任何占位符,则使用上述配置可确保Spring初始化失败。 默认情况下,Spring Boot配置一个PropertySourcesPlaceholderConfigurer 从application.properties和application.yml获取bean的属性。 Spring提供的内置转换器支持允许自动处理简单的类型转换(例如转换为Integer 或转换为简单的类型int)。 多个逗号分隔的值可以自动转换为String数组,而无需付出额外的努力。 可以像下边一样提供默认值: @Component public class MovieRecommender { private final String catalog; public MovieRecommender(@Value("${catalog.name:defaultCatalog}") String catalog) { this.catalog = catalog; } } Spring BeanPostProcessor在后台使用ConversionService来处理将@Value中的字符串值转换为目标类型的过程。如果你想为自己的自定义类型提供转换支持,你可以提供自己的ConversionService bean实例,如下面的例子所示: @Configuration public class AppConfig { @Bean public ConversionService conversionService() { DefaultFormattingConversionService conversionService = new DefaultFormattingConversionService(); conversionService.addConverter(new MyCustomConverter()); return conversionService; } } 当@Value包含SpEL表达式时,该值将在运行时动态计算,如以下示例所示: @Component public class MovieRecommender { private final String catalog; public MovieRecommender(@Value("#{systemProperties['user.catalog'] + 'Catalog' }") String catalog) { this.catalog = catalog; } } SpEL还支持使用更复杂的数据结构: @Component public class MovieRecommender { private final Map<String, Integer> countOfMoviesPerCatalog; public MovieRecommender( @Value("#{{'Thriller': 100, 'Comedy': 300}}") Map<String, Integer> countOfMoviesPerCatalog) { this.countOfMoviesPerCatalog = countOfMoviesPerCatalog; } } 1.9.9。使用@PostConstruct和@PreDestroy CommonAnnotationBeanPostProcessor不仅处理@Resource注解 也处理javax.annotation.PostConstruct和 javax.annotation.PreDestroy。 在Spring 2.5中引入了对这些注解的支持,为初始化回调和销毁回调中描述的生命周期回调机制提供了一种替代方法。 如果在Spring ApplicationContext中注册了CommonAnnotationBeanPostProcessor,带有这两个注解的方法将会被回调执行。 在下面的例子中,缓存在初始化时被预填充,在销毁时被清除: public class CachingMovieLister { @PostConstruct public void populateMovieCache() { // populates the movie cache upon initialization... } @PreDestroy public void clearMovieCache() { // clears the movie cache upon destruction... } } 像@Resource一样,@PostConstruct和@PreDestroy注解是JDK6到8的标准Java库的一部分。 但是,整个javax.annotation 程序包都与JDK 9中的核心Java模块分开,并最终在JDK 11中删除了。 如果需要,需要对javax.annotation-api工件进行处理。 现在可以通过Maven Central获取,只需像其他任何库一样将其添加到应用程序的类路径中即可。

优秀的个人博客,低调大师

一起来读官方文档-----SpringIOC(07)

1.8。容器扩展点 通常,应用程序开发人员不需要对ApplicationContext 实现类进行子类化。相反,可以通过插入特殊集成接口的实现来扩展Spring IoC容器。接下来的几节描述了这些集成接口。 1.8.1。自定义bean实现BeanBeanPostProcessor接口 BeanPostProcessor接口定义了回调方法,您可以实现这些回调方法来修改默认的bean实例化的逻辑,依赖关系解析逻辑等。 如果您想在Spring容器完成实例化,配置和初始化bean之后实现一些自定义逻辑,则可以插入一个或多个自定义BeanPostProcessor。 您可以配置多个BeanPostProcessor实例,并且可以BeanPostProcessor通过实现Ordered 接口设置order属性来控制这些实例的运行顺序。 @Component public class MyBeanPostProcessor implements BeanPostProcessor, Ordered { @Override public Object postProcessAfterInitialization(Object bean, String beanName) throws BeansException { return bean; } @Override public int getOrder() { return 0; } } BeanPostProcessor实例操作的是bean的实例。 也就是说,Spring IoC容器实例化一个bean实例, 然后使用BeanPostProcessor对这些实例进行处理加工。 BeanPostProcessor实例是按容器划分作用域的。 仅在使用容器层次结构时,这才有意义。 如果BeanPostProcessor在一个容器中定义一个,它将仅对该容器中的bean进行后处理。 换句话说,一个容器中定义的bean不会被BeanPostProcessor另一个容器中的定义进行后处理, 即使这两个容器是同一层次结构的一部分也是如此。 BeanPostProcessor修改的是bean实例化之后的内容, 如果要更改实际的bean定义(即bean definition) 您需要使用 BeanFactoryPostProcessor接口. org.springframework.beans.factory.config.BeanPostProcessor接口恰好由两个回调方法组成。 当此类被注册为容器的post-processor时,对于容器创建的每个bean实例,post-processor都会在任何bean实例化之后并且在容器初始化方法(例如InitializingBean.afterPropertiesSet()或任何声明的init方法)被使用之前调用。 post-processor可以对bean实例执行任何操作,也可以完全忽略回调。 post-processor通常检查回调接口,或者可以用代理包装Bean。 一些Spring AOP基础结构类被实现为post-processor,以提供代理包装逻辑。 ApplicationContext自动检测实现BeanPostProcessor接口所有bean,注意是要注册成bean,仅仅实现接口是不可以的。 请注意,通过使用@Bean工厂方法声明BeanPostProcessor时,工厂方法的返回类型应该是实现类本身或至少是org.springframework.beans.factory.config.BeanPostProcessor 接口,以清楚地表明该bean的post-processor性质。 否则,ApplicationContext无法在完全创建之前按类型自动检测它。 由于BeanPostProcessor需要提前实例化以便应用于上下文中其他bean的初始化,因此这种早期类型检测至关重要。 @Bean public BeanPostProcessor myBeanPostProcessor(){ return new MyBeanPostProcessor(); } 以编程方式注册BeanPostProcessor实例 虽然推荐的BeanPostProcessor注册方法是通过ApplicationContext自动检测, 但是您可以ConfigurableBeanFactory使用addBeanPostProcessor方法通过编程方式对它们进行注册。 当您需要在注册之前评估条件逻辑(比如应用场景是xxx条件才注册,xxx条件不注册时), 甚至需要跨层次结构的上下文复制Bean post-processor时,这将非常有用。 但是请注意,以BeanPostProcessor编程方式添加的实例不遵守该Ordered接口。 在这里,注册的顺序决定了执行的顺序。 还要注意,以BeanPostProcessor编程方式注册的实例总是在通过自动检测注册的实例之前进行处理, 而不考虑任何明确的顺序。 BeanPostProcessor 实例和AOP自动代理 实现BeanPostProcessor接口的类是特殊的,并且容器对它们的处理方式有所不同。 BeanPostProcessor它们直接引用的所有实例和bean在启动时都会实例化, 作为ApplicationContext的特殊启动阶段的一部分。 接下来,BeanPostProcessor以排序方式注册所有实例,并将其应用于容器中的所有其他bean。 但是因为AOP自动代理的实现是通过BeanPostProcessor接口, 所以在AOP的BeanPostProcessor接口实例化之前的 BeanPostProcessor实例或BeanPostProcessor实例直接引用的bean都没有资格进行自动代理。 并且对于任何此类bean都没有任何处理切面的BeanPostProcessor指向他们。 您应该看到一条参考性日志消息: Bean someBean is not eligible for getting processed by all BeanPostProcessor interfaces (for example: not eligible for auto-proxying)。 这条消息的意思大概就是说这个bean没有得到所有BeanPostProcessor的处理 下面分析一下这条日志的逻辑:我们不用AOP的BeanPostProcessor用AutowiredAnnotationBeanPostProcessor来看这个情况 首先这条日志是在BeanPostProcessorChecker类中打印的, 这个类本身就实现了BeanPostProcessor, Spring容器增加这个processor的代码如下: //获取所有的BeanPostProcessor类型的bean //第一个true表示包括非单例的bean //第二个false表示仅查找已经实例化完成的bean,如果是factory-bean则不算入内 String[] postProcessorNames = beanFactory.getBeanNamesForType(BeanPostProcessor.class, true, false); //当前beanFactory内的所有post-processor数 + 1 + postBeanNames的数量 //这个数量在后续有个判断 //beanFactory.getBeanPostProcessorCount() 系统内置processor //1 就是BeanPostProcessorChecker //postProcessorNames.length 就是能扫描到的processor //这个数量之和就是目前系统能看到的所有processor //还有的就可能是解析完了某些bean又新增了processor那个不算在内 int beanProcessorTargetCount = beanFactory.getBeanPostProcessorCount() + 1 + postProcessorNames.length; //add BeanPostProcessorChecker 进入beanPostProcessor链 beanFactory.addBeanPostProcessor(new BeanPostProcessorChecker(beanFactory, beanProcessorTargetCount)); BeanPostProcessorChecker中判断并打印上边那条日志的方法如下: @Override public Object postProcessAfterInitialization(Object bean, String beanName) { //如果当前bean不是postProcessor的实例 //并且不是内部使用的bean //并且this.beanFactory.getBeanPostProcessorCount()小于刚才相加的值 //三个都满足才会打印那行日志 if (!(bean instanceof BeanPostProcessor) && !isInfrastructureBean(beanName) && this.beanFactory.getBeanPostProcessorCount() < this.beanPostProcessorTargetCount) { if (logger.isInfoEnabled()) { logger.info("Bean '" + beanName + "' of type [" + bean.getClass().getName() + "] is not eligible for getting processed by all BeanPostProcessors " + "(for example: not eligible for auto-proxying)"); } } return bean; } //当前beanName不为空,并且对应的bean是容器内部使用的bean则返回true private boolean isInfrastructureBean(@Nullable String beanName) { if (beanName != null && this.beanFactory.containsBeanDefinition(beanName)) { BeanDefinition bd = this.beanFactory.getBeanDefinition(beanName); return (bd.getRole() == RootBeanDefinition.ROLE_INFRASTRUCTURE); } return false; } 在看Spring createBean时遍历postProcessor的代码 @Override public Object applyBeanPostProcessorsAfterInitialization(Object existingBean, String beanName) throws BeansException { Object result = existingBean; for (BeanPostProcessor processor : getBeanPostProcessors()) { Object current = processor.postProcessAfterInitialization(result, beanName); if (current == null) { return result; } result = current; } return result; } 就是通过这么一个循环来执行后置方法applyBeanPostProcessorsAfterInitialization,前置方法也是这样的 现在假设我们有一个自定义的beanPostProcessor里面需要注入一个我们自定义的beanA, 那么在beanPostProcessor被实例化的时候肯定会要求注入我们自定义的beanA, 那么现在就有多种情况了: 1.我们用的set或者构造器注入那beanA会被实例化并注入 2.如果我们用的@Autowired,当我们自定义的beanPostProcessor实例化 在AutowiredAnnotationBeanPostProcessor实例化之前,那么beanA都无法被注入值 如果在之后,则还是可以被注入值 但是这两种情况都会打印这行日志 Bean 'beanA' of type [org.springframework.beanA] is not eligible for getting processed by all BeanPostProcessors (for example: not eligible for auto-proxying) 以下示例显示了如何在ApplicationContext中编写,注册和使用BeanPostProcessor实例。 示例:Hello World,BeanPostProcessor-style 第一个示例演示了基本用法。示例展示了一个自定义BeanPostProcessor实现,它在容器创建每个bean时调用该bean的toString()方法,并将结果字符串打印到系统控制台。 下面的清单显示了自定义的BeanPostProcessor实现类定义: package scripting; import org.springframework.beans.factory.config.BeanPostProcessor; public class InstantiationTracingBeanPostProcessor implements BeanPostProcessor { // 只需按原样返回实例化的bean public Object postProcessBeforeInitialization(Object bean, String beanName) { return bean; // 我们可以返回任何对象引用 } public Object postProcessAfterInitialization(Object bean, String beanName) { System.out.println("Bean '" + beanName + "' created : " + bean.toString()); return bean; } } 以下beans元素使用InstantiationTracingBeanPostProcessor: <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:lang="http://www.springframework.org/schema/lang" xsi:schemaLocation="http://www.springframework.org/schema/beans https://www.springframework.org/schema/beans/spring-beans.xsd http://www.springframework.org/schema/lang https://www.springframework.org/schema/lang/spring-lang.xsd"> <lang:groovy id="messenger" script-source="classpath:org/springframework/scripting/groovy/Messenger.groovy"> <lang:property name="message" value="Fiona Apple Is Just So Dreamy."/> </lang:groovy> <!-- 当上述bean (messenger)被实例化时,这个自定义的BeanPostProcessor实现将事实输出到系统控制台 --> <bean class="scripting.InstantiationTracingBeanPostProcessor"/> </beans> 请注意实例化tracingbeanpostprocessor是如何定义的。它甚至没有名称,而且,因为它是一个bean,所以可以像其他bean一样进行依赖注入。 下面的Java应用程序运行前面的代码和配置: import org.springframework.context.ApplicationContext; import org.springframework.context.support.ClassPathXmlApplicationContext; import org.springframework.scripting.Messenger; public final class Boot { public static void main(final String[] args) throws Exception { ApplicationContext ctx = new ClassPathXmlApplicationContext("scripting/beans.xml"); Messenger messenger = ctx.getBean("messenger", Messenger.class); System.out.println(messenger); } } 前面的应用程序的输出类似于以下内容: Bean 'messenger' created : org.springframework.scripting.groovy.GroovyMessenger@272961 org.springframework.scripting.groovy.GroovyMessenger@272961 示例: RequiredAnnotationBeanPostProcessor 将回调接口或注解与自定义BeanPostProcessor实现结合使用是扩展Spring IoC容器的一种常见方法。 一个例子是Spring的AutowiredAnnotationBeanPostProcessor——一个随Spring发行版附带的BeanPostProcessor实现,它确保被注解(@Autowired,@Value, @Inject等注解)注释的属性会被注入一个bean实例。 1.8.2。自定义配置元数据BeanFactoryPostProcessor 我们要看的下一个扩展点是 org.springframework.beans.factory.config.BeanFactoryPostProcessor。 该接口与BeanPostProcessor主要区别在于:BeanFactoryPostProcessor对Bean配置元数据进行操作。 也就是说,Spring IoC容器允许BeanFactoryPostProcessor读取配置元数据,并有可能在容器实例化实例任何bean之前更改元数据。 您可以配置多个BeanFactoryPostProcessor实例,并且可以BeanFactoryPostProcessor通过设置order属性来控制这些实例的运行顺序。但是,仅当BeanFactoryPostProcessor实现 Ordered接口时才能设置此属性。 如果希望更改实际bean实例(从配置元数据创建的对象),则需要使用BeanPostProcessor。 尽管在BeanFactoryPostProcessor中使用bean实例在技术上是可行的(例如,通过使用BeanFactory.getBean()), 但是这样做会导致过早的bean实例化,违反标准的容器生命周期。 这可能会导致负面的副作用,比如绕过bean的后处理。 另外,BeanFactoryPostProcessor实例的作用域为每个容器。 这只有在使用容器层次结构时才有用。 如果您在一个容器中定义了BeanFactoryPostProcessor,那么它只应用于该容器中的bean定义。 一个容器中的Bean定义不会被另一个容器中的BeanFactoryPostProcessor实例进行后处理,即使这两个容器属于同一层次结构。 当BeanFactoryPostProcessor在ApplicationContext中声明时,它将自动运行,以便对定义容器的配置元数据应用更改。 Spring包括许多预定义的bean工厂后处理器,如PropertyOverrideConfigurer和PropertySourcesPlaceholderConfigurer。 您还可以使用自定义BeanFactoryPostProcessor例如,用于注册自定义属性编辑器。 ApplicationContext自动检测部署其中实现BeanFactoryPostProcessor接口的任何bean。在适当的时候,这些bean会被bean factory post-processors来使用。 你也可以像部署任何其他bean一样部署这些自定义的bean factory post-processors。 示例:PropertySourcesPlaceholderConfigurer 您可以使用PropertySourcesPlaceholderConfigurer使用标准的Java属性格式将bean定义中的属性值外部化到单独的文件中。这样,部署应用程序的人员就可以自定义特定于环境的属性,比如数据库url和密码,而无需修改主XML定义文件或容器文件的复杂性或风险。 考虑以下基于xml的配置元数据片段,其中定义了具有占位符值的数据源: <bean class="org.springframework.context.support.PropertySourcesPlaceholderConfigurer"> <property name="locations" value="classpath:com/something/jdbc.properties"/> </bean> <bean id="dataSource" destroy-method="close" class="org.apache.commons.dbcp.BasicDataSource"> <property name="driverClassName" value="${jdbc.driverClassName}"/> <property name="url" value="${jdbc.url}"/> <property name="username" value="${jdbc.username}"/> <property name="password" value="${jdbc.password}"/> </bean> 该示例显示了从外部Properties文件配置的属性。 在运行时,将 PropertySourcesPlaceholderConfigurer应用于替换数据源的某些属性的元数据。将要替换的值指定为形式的占位符,该形式${property-name}遵循Ant和log4j和JSP EL样式。 实际值来自标准Java Properties格式的另一个文件: jdbc.driverClassName = org.hsqldb.jdbcDriver jdbc.url = jdbc:hsqldb:hsql://production:9002 jdbc.username = sa jdbc.password = root 因此,${jdbc.username}在运行时将字符串替换为值“sa”,并且其他与属性文件中的键匹配的占位符值也适用。 在PropertySourcesPlaceholderConfigurer为大多数属性和bean定义的属性占位符检查。此外,您可以自定义占位符前缀和后缀。 <bean class="org.springframework.context.support.PropertySourcesPlaceholderConfigurer"> <property name="locations" value="classpath:jdbc.properties"/> //自定义前缀后缀 <property name="placeholderPrefix" value="${"/> <property name="placeholderSuffix" value="}"/> </bean> 1.8.3。自定义实例化逻辑FactoryBean 您可以org.springframework.beans.factory.FactoryBean为本身就是工厂的对象实现接口。 该FactoryBean接口是可插入Spring IoC容器的实例化逻辑的一点。 如果您有复杂的初始化代码,而不是(可能)冗长的XML,可以用Java更好地表达,则以创建自己的代码 FactoryBean, 在该类中编写复杂的初始化,然后将自定义FactoryBean插入容器。 该FactoryBean界面提供了三种方法: Object getObject():返回此工厂创建的对象的实例。实例可以共享,具体取决于该工厂是否返回单例或原型。 boolean isSingleton():true如果FactoryBean返回单例或false其他则返回 。 Class getObjectType():返回getObject()方法返回的对象类型,或者null如果类型未知,则返回该对象类型。 FactoryBeanSpring框架中的许多地方都使用了该概念和接口。Spring附带了50多种FactoryBean接口实现。Spring中的了解的少,但是Mybatis的MybatisSqlSessionFactoryBean很出名。 当您需要向容器询问FactoryBean本身而不是由它产生的bean的实际实例时,请在调用的方法时在该bean的id前面加上“&”符号(&)。 因此,对于给定id为myBean的一个FactoryBean ,调用getBean("myBean")返回的是FactoryBean生成的实例,getBean("&myBean")返回的是FactoryBean本身。 public class MyFactoryBean implements FactoryBean<MyBean> { @Override public MyBean getObject() throws Exception { return new MyBean(); } @Override public Class<?> getObjectType() { return MyBean.class; } } <bean id="myFactoryBean" class="org.springframework.example.factoryBean.MyFactoryBean"/> getBean("myFactoryBean") 返回的是MyBean实例 getBean("&myFactoryBean") 返回的是MyFactoryBean实例

优秀的个人博客,低调大师

Redisson官方文档 - 3. 程序接口调用方式

Redisson为每个操作都提供了自动重试策略,当某个命令执行失败时,Redisson会自动进行重试。自动重试策略可以通过修改retryAttempts(默认值:3)参数和retryInterval(默认值:1000毫秒)参数来进行优化调整。当等待时间达到retryInterval指定的时间间隔以后,将自动重试下一次。全部重试失败以后将抛出错误。 Redisson实例本身和Redisson框架提供的所有对象都是线程安全的。 Redisson框架提供的几乎所有对象都包含了同步和异步相互匹配的方法。这些对象都可以通过RedissonClient接口获取。同时还为大部分Redisson对象提供了满足异步流处理标准的程序接口RedissonReactiveClient。 以下是关于使用RAtomicLong对象的范例: RedissonClient client = Redisson.create(config); RAtomicLong longObject = client.getAtomicLong('myLong'); // 同步执行方式 longObject.compareAndSet(3, 401); // 异步执行方式 longObject.compareAndSetAsync(3, 401); RedissonReactiveClient client = Redisson.createReactive(config); RAtomicLongReactive longObject = client.getAtomicLong('myLong'); // 异步流执行方式 longObject.compareAndSet(3, 401); 3.1. 异步执行方式 几乎所有的Redisson对象都实现了一个异步接口,异步接口提供的方法名称与其同步接口的方法名称相互匹配。例如: // RAtomicLong接口继承了RAtomicLongAsync接口 RAtomicLongAsync longObject = client.getAtomicLong("myLong"); RFuture<Boolean> future = longObject.compareAndSetAsync(1, 401); 异步执行的方法都会返回一个实现了RFuture接口的对象。通过向这个对象添加监听器可以实现非阻塞的执行方式。 // JDK 1.8+ 适用 future.whenComplete((res, exception) -> { // ... }); // 或者 future.thenAccept(res -> { // 处理返回 }).exceptionally(exception -> { // 处理错误 }); // JDK 1.6+ 适用 future.addListener(new FutureListener<Boolean>() { @Override public void operationComplete(Future<Boolean> future) throws Exception { if (future.isSuccess()) { // 取得结果 Boolean result = future.getNow(); // ... } else { // 对发生错误的处理 Throwable cause = future.cause(); } } }); 3.2. 异步流执行方式 Redisson提供了满足Reactor项目的异步流处理标准的程序接口。所有Redisson异步流对象都可以通过一个单独的RedissonReactiveClient接口来获取。该功能要求JDK 7或以上版本。使用范例如下: RedissonReactiveClient client = Redisson.createReactive(config); RAtomicLongReactive longObject = client.getAtomicLong("myLong"); Publisher<Boolean> csPublisher = longObject.compareAndSet(10, 91); Publisher<Long> getPublisher = longObject.get(); 也可以在RxJavaReactiveStreams项目的帮助下,通过使用RxJava标准来达到使用异步流处理标准的目的。例如: RMap<String, Integer> map = client.getMap("mapMap"); Observable<Integer> observable = RxReactiveStreams.toObservable(map.put("1", 324));

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 在生产环境中运行拓扑

在生产环境集群中运行拓扑的方式与本地模式非常相似,主要包括以下几个步骤: 1) 定义拓扑(如果使用 Java 进行开发就可以使用TopologyBuilder) 2) 使用StormSubmitter向集群提交拓扑。StormSubmitter接收拓扑名称、拓扑配置信息以及拓扑对象本身作为参数,如下所示: Config conf = new Config(); conf.setNumWorkers(20); conf.setMaxSpoutPending(5000); StormSubmitter.submitTopology("mytopology", conf, topology); 3) 将你的拓扑程序以及相关依赖库(除了 Storm 本身的依赖 —— 这些依赖已经添加到 Storm 的工作节点的 classpath 中了)打包为一个 jar 文件。 如果你使用 Maven 进行开发,可以使用Maven Assembly Plugin来打包,你需要做的仅仅是将下述插件配置添加到你的 pom.xml 中: <plugin> <artifactId>maven-assembly-plugin</artifactId> <configuration> <descriptorRefs> <descriptorRef>jar-with-dependencies</descriptorRef> </descriptorRefs> <archive> <manifest> <mainClass>com.path.to.main.Class</mainClass> </manifest> </archive> </configuration> </plugin> 然后就可以运行mvn assembly:assembly来打包。请确保你已经在 dependencies 中排除了 Storm 本身的 jar 包。 4) 使用storm客户端向集群提交拓扑,在提交时需要指定好你的 jar 包的相关路径、主函数所在类名称以及其他一些需要的参数,下面是一个提交拓扑的例子: storm jar path/to/allmycode.jar org.me.MyTopology arg1 arg2 arg3 storm jar会将 jar 提交到集群中,同时配置StormSubmitter类来与正确的集群建立连接。在上面的例子里,上传 jar 包之后,storm jar就会使用 “arg1”、“arg2”、“arg3” 三个参数来运行org.me.MyTopology的 main 函数。 关于如何配置 Storm 客户端与 Storm 集群的交互的详细信息,请参阅配置开发环境一文。 常用配置 拓扑中有很多参数可以设置。你可以在这里找到完整的配置项列表。其中,以 “TOPOLOGY” 开头的参数可以被拓扑中的对应配置项覆盖(其他参数是集群的配置参数,不能被直接覆盖)。以下是拓扑中的一些常用参数: Config.TOPOLOGY_WORKERS:此项设置了可以用于执行拓扑的 worker 进程数。例如,如果你将该参数值设置为 25,那么在集群中就会有 25 个可以执行任务的 Java 进程。另外,如果你将拓扑的并行度设置成了 150,那么每个 worker 进程就会执行 6 个任务线程。 Config.TOPOLOGY_ACKERS:此项设置了用于跟踪 spout 发送的 tuple 树的 ack 任务数。Ackers 是 Storm 可靠性模型的重要组成部分,你可以在消息的可靠性保障一文中了解更多相信信息。 Config.TOPOLOGY_MAX_SPOUT_PENDING:此项设置了单个 Spout 任务能够挂起的最大的 tuple 数(tuple 挂起表示该 tuple 已经被发送但是尚未被 ack 或者 fail)。强烈建议设置此参数来防止消息队列的爆发性增长。 Config.TOPOLOGY_MESSAGE_TIMEOUT_SECS:此项设置了 ackers 跟踪 tuple 的超时时间。默认值是 30 秒,对于大部分拓扑而言这个值基本上是不需要改动的。关于 Storm 的消息可靠性模型请参考消息的可靠性保障一文。 Config.TOPOLOGY_SERIALIZATIONS:此项用于在 Storm 中注册更多的序列化工具,这样你就可以使用自定义的序列化类型来处理 tuple。 Kill 拓扑 执行以下命令来 kill 拓扑: storm kill {topologyname} 其中topologyname就是你提交拓扑时使用的拓扑名称。 不过,在执行该命令后 Storm 不会马上 kill 掉该拓扑。Storm 会先停止所有 spouts 的活动,使得他们不能继续发送 tuple,然后 Storm 会等待Config.TOPOLOGY_MESSAGE_TIMEOUT_SECS参数表示的一段时间,然后才会结束所有的 worker 进程。这可以保证拓扑在被 kill 之前可以有足够的时间完成已有的 tuple 的处理。 更新运行中的拓扑 目前只能通过先 kill 掉当前的拓扑再重新提交新拓扑的方式来更新运行中的拓扑。不过社区计划在将来实现一个storm swap命令来将一个运行中的拓扑替换为一个新的拓扑,尽可能减少停机时间,同时确保不会有两个拓扑同时处理 tuple 的情况发生。 监控拓扑 监控拓扑运行的最好方式是使用 Storm UI。Storm UI 可以显示任务中的错误信息以及每个运行中拓扑中每个组件的吞吐量与端到端延时的性能信息。 当然,你也可以通过查看在工作节点机器上的日志信息来了解拓扑运行情况。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 消息的可靠性保障

Storm 能够保证每一个由 Spout 发送的消息都能够得到完整地处理。本文详细解释了 Storm 如何实现这种保障机制,以及作为用户如何使用好 Storm 的可靠性机制。 消息的“完整性处理”是什么意思 一个从 spout 中发送出的 tuple 会产生上千个基于它创建的 tuples。例如,有这样一个 word-count 拓扑: TopologyBuilder builder = new TopologyBuilder(); builder.setSpout("sentences", new KestrelSpout("kestrel.backtype.com", 22133, "sentence_queue", new StringScheme())); builder.setBolt("split", new SplitSentence(), 10) .shuffleGrouping("sentences"); builder.setBolt("count", new WordCount(), 20) .fieldsGrouping("split", new Fields("word")); 这个拓扑从一个 Kestrel 队列中读取句子,然后将句子分解成若干个单词,然后将它每个单词和该单词的数量发送出去。这种情况下,从 spout 中发出的 tuple 就会产生很多基于它创建的新 tuple:包括句子中单词的 tuple 和 每个单词的个数的 tuple。这些消息构成了这样一棵树: 如果这棵 tuple 树发送完成,并且树中的每一条消息都得到了正确的处理,就表明发送 tuple 的 spout 已经得到了“完整性处理”。对应的,如果在指定的超时时间内 tuple 树中有消息没有完成处理就意味着这个 tuple 失败了。这个超时时间可以使用Config.TOPOLOGY_MESSAGE_TIMEOUT_SECS参数在构造拓扑时进行配置,如果不配置,则默认时间为 30 秒。 在消息得到完整性处理后或者处理失败后会发生什么 为了理解这个问题,让我们先了解一下 tuple 的生命周期。下面是定义 spout 的接口(可以在Javadoc中查看更多细节信息): public interface ISpout extends Serializable { void open(Map conf, TopologyContext context, SpoutOutputCollector collector); void close(); void nextTuple(); void ack(Object msgId); void fail(Object msgId); } 首先,通过调用Spout的nextTuple方法,Storm 向Spout请求一个 tuple。Spout会使用open方法中提供的SpoutOutputCollector向它的一个输出数据流中发送一个 tuple。在发送 tuple 的时候,Spout会提供一个 “消息 id”,这个 id 会在后续过程中用于识别 tuple。例如,上面的KestrelSpout就是从一个 kestrel 队列中读取一条消息,然后再发送一条带有“消息 id”的消息,这个 id 是由 Kestrel 提供的。使用SpoutOutputCollector发送消息一般是这样的形式: _collector.emit(new Values("field1", "field2", 3) , msgId); 随后,tuple 会被发送到对应的 bolt 中去,在这个过程中,Storm 会很小心地跟踪创建的消息树。如果 Storm 检测到某个 tuple 被完整处理, Storm 会根据Spout提供的“消息 id”调用最初发送 tuple 的Spout任务的ack方法。对应的,Storm 在检测到 tuple 超时之后就会调用fail方法。注意,对于一个特定的 tuple,响应(ack)和失败处理(fail)都只会由最初创建这个 tuple 的任务执行。也就是说,及时Spout在集群中有很多个任务,某个特定的 tuple 也只会由创建它的那个任务——而不是其他的任务——来处理成功或失败的结果。 我们再以KestrlSpout为例来看看在消息的可靠性处理中Spout做了什么。在KestrlSpout从 Kestrel 队列中取出一条消息时,可以看作它“打开”了这条消息。也就是说,这条消息实际上并没有从队列中真正地取出来,而是保持着一个“挂起”状态,等待消息处理完成的信号。在挂起状态的消息不回被发送到其他的消费者中。另外,如果消费者(客户端)断开了连接,所有处于挂起状态的消息都会重新放回到队列中。在消息“打开”的时候 Kestrel 会给客户端同时提供消息体数据和一个唯一的 id。KestrelSpout在使用SpoutOutputCollector发送 tuple 的时候就会把这个唯一的 id 当作“消息 id”。一段时间之后,在KestrelSpout的ack或者fail方法被调用的时候,KestrelSpout就会通过这个消息 id 向 Kestrel 请求将消息从队列中移除(对应ack的情况)或者将消息重新放回队列(对应fail的情况)。 Storm 的可靠性 API 使用 Storm 的可靠性机制的时候你需要注意两件事:首先,在 tuple 树中创建新节点连接时务必通知 Storm;其次,在每个 tuple 处理结束的时候也必须向 Storm 发出通知。通过这两个操作,Storm 就能够检测到 tuple 树会在何时完成处理,并适时地调用 ack 或者 fail 方法。Storm 的 API 提供了一种非常精确的方式来实现着两个操作。 Storm 中指定 tuple 树中的一个连接称为“锚定”(anchoring)。锚定是在发送新 tuple 的同时发生的。让我们以下面的 Bolt 为例说明这一点,这个 Bolt 将一个包含句子的 tuple 分割成若干个单词 tuple: public class SplitSentence extends BaseRichBolt { OutputCollector _collector; public void prepare(Map conf, TopologyContext context, OutputCollector collector) { _collector = collector; } public void execute(Tuple tuple) { String sentence = tuple.getString(0); for(String word: sentence.split(" ")) { _collector.emit(tuple, new Values(word)); } _collector.ack(tuple); } public void declareOutputFields(OutputFieldsDeclarer declarer) { declarer.declare(new Fields("word")); } } 通过将输入 tuple 指定为emit方法的第一个参数,每个单词 tuple 都被“锚定”了。这样,如果单词 tuple 在后续处理过程中失败了,作为这棵 tuple 树的根节点的原始 Spout tuple 就会被重新处理。相对应的,如果这样发送 tuple: _collector.emit(new Values(word)); 就称为“非锚定”。在这种情况下,下游的 tuple 处理失败不会触发原始 tuple 的任何处理操作。有时候发送这种“非锚定” tuple 也是必要的,这取决于你的拓扑的容错性要求。 一个输出 tuple 可以被锚定到多个输入 tuple 上,这在流式连接或者聚合操作时很有用。显然,一个多锚定的 tuple 失败会导致 Spout 中多个 tuple 的重新处理。多锚定操作是通过指定一个 tuple 列表而不是单一的 tuple 来实现的,如下面的例子所示: List<Tuple> anchors = new ArrayList<Tuple>(); anchors.add(tuple1); anchors.add(tuple2); _collector.emit(anchors, new Values(1, 2, 3)); 多锚定操作会把输出 tuple 添加到多个 tuple 树中。注意,多锚定也可能会打破树的结构从而创建一个 tuple 的有向无环图(DAG),如下图所示: Storm 的程序实现既支持对树的处理,同样也支持对 DAG 的处理(由于早期的 Storm 版本仅仅对树有效,所以“tuple 树”的这个糟糕的概念就一直沿袭下来了)。 锚定其实可以看作是将 tuple 树具象化的过程 —— 在结束对一棵 tuple 树中一个单独 tuple 的处理的时候,后续以及最终的 tuple 都会在 Storm 可靠性 API 的作用下得到标定。这是通过OutputCollector的ack和fail方法实现的。如果你再回过头看一下SplitSentence的例子,你就会发现输入 tuple 是在所有的单词 tuple 发送出去之后被 ack 的。 你可以使用OutputCollector的fail方法来使得位于 tuple 树根节点的 Spout tuple 立即失败。例如,你的应用可以在建立数据库连接的时候抓取异常,并且在异常出现的时候立即让输入 tuple 失败。通过这种立即失败的方式,原始 Spout tuple 就会比等待 tuple 超时的方式响应更快。 每个待处理的 tuple 都必须显式地应答(ack)或者失效(fail)。因为 Storm 是使用内存来跟踪每个 tuple 的,所以,如果你不对每个 tuple 进行应答或者失效,那么负责跟踪的任务很快就会发生内存溢出。 Bolt 处理 tuple 的一种通用模式是在execute方法中读取输入 tuple、发送出基于输入 tuple 的新 tuple,然后在方法末尾对 tuple 进行应答。大部分 Bolt 都会使用这样的过程。这些 Bolt 大多属于过滤器或者简单的处理函数一类。Storm 有一个可以简化这种操作的简便接口,称为BasicBolt。例如,如果使用BasicBolt,SplitSentence的例子可以这样写: public class SplitSentence extends BaseBasicBolt { public void execute(Tuple tuple, BasicOutputCollector collector) { String sentence = tuple.getString(0); for(String word: sentence.split(" ")) { collector.emit(new Values(word)); } } public void declareOutputFields(OutputFieldsDeclarer declarer) { declarer.declare(new Fields("word")); } } 这个实现方式比之前的方式要简单许多,而且在语义上有着完全一致的效果。发送到BasicOutputCollector的 tuple 会被自动锚定到输入 tuple 上,而且输入 tuple 会在execute方法结束的时候自动应答。 相对应的,执行聚合或者联结操作的 Bolt 可能需要延迟应答 tuple,因为它需要等待一批 tuple 来完成某种结果计算。聚合和联结操作一般也会需要对他们的输出 tuple 进行多锚定。这个过程已经超出了IBasicBolt的应用范围。 在 tuple 可以被重新处理的前提下,如何让我的应用可以得到正确的运行? 按照软件设计的一般思路,这个问题的答案是“取决于实际情况”。Storm 0.7.0 版本引入了“事务拓扑”的特性,它能够保证大多数计算过程都能够满足恰好一次(exactly-once)的消息语义的容错性要求。想要了解“事务拓扑”的更多内容可以参考这篇文章。 Storm 是以怎样一种高效的方式实现可靠性的? Storm 的拓扑有一些特殊的称为“acker”的任务,这些任务负责跟踪每个 Spout 发出的 tuple 的 DAG。当一个 acker 发现一个 DAG 结束了,它就会给创建 spout tuple 的 Spout 任务发送一条消息,让这个任务来应答这个消息。你可以使用Config.TOPOLOGY_ACKERS来配置拓扑的 acker 数量。Storm 默认会将 acker 的数量设置为一,不过如果你有大量消息的处理需求,你可能需要增加这个数量。 理解 Storm 的可靠性实现的最好方式还是通过了解 tuple 和 tuple DAG 的生命周期。当一个 tuple 在拓扑中被创建出来的时候 —— 不管是在 Spout 中还是在 Bolt 中创建的 —— 这个 tuple 都会被配置一个随机的 64 位 id。acker 就是使用这些 id 来跟踪每个 spout tuple 的 tuple DAG 的。 Spout tuple 的 tuple 树中的每个 tuple 都知道 spout tuple 的 id。当你在 bolt 中发送一个新 tuple 的时候,输入 tuple 中的所有 spout tuple 的 id 都会被复制到新的 tuple 中。在 tuple 被 ack 的时候,它会通过回掉函数向合适的 acker 发送一条消息,这条消息显示了 tuple 树中发生的变化。也就是说,它会告诉 acker 这样一条消息:“在这个 tuple 树中,我的处理已经结束了,接下来这个就是被我标记的新 tuple”。 以下图为例,如果 D tuple 和 E tuple 是由 C tuple 创建的,那么在 C 应答的时候 tuple 树就会发生变化: 由于在 D 和 E 添加到 tuple 树中的时候 C 已经从树中移除了,所以这个树并不会被过早地结束。 关于 Storm 如何跟踪 tuple 树还有更多的细节。正如上面所提到的,你可以随意设置拓扑中 acker 的数量。这就会引起下面的问题:当 tuple 在拓扑中被 ack 的时候,它是怎么知道向那个 acker 任务发送信息的? 对于这个问题,Storm 实际上是使用哈希算法来将 spout tuple 匹配到 acker 任务上的。由于每个 tuple 都会包含原始的 spout tuple id,所以他们会知道需要与哪个 acker 任务通信。 关于 Storm 的另一个问题是 acker 是如何知道它所跟踪的 spout tuple 是由哪个 Spout 任务处理的。实际上,在 Spout 任务发送新 tuple 的时候,它也会给对应的 acker 发送一条消息,告诉 acker 这个 spout tuple 是与它的任务 id 相关联的。随后,在 acker 观察到 tuple 树结束处理的时候,它就会知道向哪个 Spout 任务发送结束消息。 Acker 实际上并不会直接跟踪 tuple 树。对于一棵包含数万个 tuple 节点的树,如果直接跟踪其中的每个 tuple,显然会很快把这个 acker 的内存撑爆。所以,这里 acker 使用一个特殊的策略来实现跟踪的功能,使用这个方法对于每个 spout tuple 只需要占用固定的内存空间(大约 20 字节)。这个跟踪算法是 Storm 运行的关键,也是 Storm 的一个突破性技术。 在 acker 任务中储存了一个表,用于将 spout tuple 的 id 和一对值相映射。其中第一个值是创建这个 tuple 的任务 id,这个 id 主要用于在后续操作中发送结束消息。第二个值是一个 64 比特的数字,称为“应答值”(ack val)。这个应答值是整个 tuple 树的一个完整的状态表述,而且它与树的大小无关。因为这个值仅仅是这棵树中所有被创建的或者被应答的 tuple 的 tuple id 进行异或运算的结果值。 当一个 acker 任务观察到“应答值”变为 0 的时候,它就知道这个 tuple 树已经完成处理了。因为 tuple id 实际上是随机生成的 64 比特数值,所以“应答值”碰巧为 0 是一种极小概率的事件。理论计算得以得出,在每秒应答一万次的情况下,需要 5000 万年才会发生一次错误。而且即使是这样,也仅仅会在 tuple 碰巧在拓扑中失败的时候才会发生数据丢失的情况。 假设你现在已经理解了这个可靠性算法,让我们再分析一下所有失败的情形,看看这些情形下 Storm 是如何避免数据缺失的: 由于任务(线程)挂掉导致 tuple 没有被应答(ack)的情况:这时位于 tuple 树根节点的 spout tuple 会在任务超时后得到重新处理。 Acker 任务挂掉的情形:这种情况下 acker 所跟踪的所有 spout tuple 都会由于超时被重新处理。 Spout 任务挂掉的情形:这种情况下 Spout 任务的来源就会负责重新处理消息。例如,对于像 Kestrel 和 RabbitMQ 这样的消息队列就会在客户端断开连接时将所有的挂起状态的消息放回队列(关于挂起状态的概念可以参考Storm 的容错性——译者注)。 综上所述,Storm 的可靠性机制完全具备分布的、可伸缩的、容错的特征。 调整可靠性 由于 acker 任务是轻量级的,在拓扑中你并不需要很多 acker 任务。你可以通过 Storm UI 监控他们的性能(acker 任务的 id 为“__acker”)。如果发现观察结果存在问题,你可能就需要增加更多的 acker 任务。 如果你不关注消息的可靠性 —— 也就是说你不关心在失败情形下发生的 tuple 丢失 —— 那么你就可以通过不跟踪 tuple 树的处理来提升拓扑的性能。由于 tuple 树中的每个 tuple 都会带有一个应答消息,不追踪 tuple 树会使得传输的消息的数量减半。同时,下游数据流中的 id 也会变少,这样可以降低网络带宽的消耗。 有三种方法可以移除 Storm 的可靠性机制。第一种方法是将 Config.TOPOLOGY_ACKERS 设置为0,在这种情况下,Storm 会在 Spout 发送 tuple 之后立即调用ack方法,tuple 树叶就不会被跟踪了。 第二种方法是基于消息本身移除可靠性。你可以通过在SpoutOutputCollector.emit方法中省略消息 id 来关闭 spout tuple 的跟踪功能。 最后,如果你不关心拓扑中的下游 tuple 是否会失败,你可以在发送 tuple 的时候选择发送“非锚定”的(unanchored)tuple。由于这些 tuple 不会被标记到任何一个 spout tuple 中,显然在他们处理失败的时候不会引起任何 spout tuple 的重新处理(注意,在使用这种方法时,如果上游有 spout 或 bolt 仍然保持可靠性机制,那么需要在execute方法之初调用OutputCollector.ack来立即响应上游的消息,否则上游组件会误认为消息没有发送成功导致所有的消息会被反复发送——译者注)。 转载自并发编程网 - ifeve.com

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册