首页 文章 精选 留言 我的

精选列表

搜索[基础搭建],共10000篇文章
优秀的个人博客,低调大师

mac下Android开发环境搭建

之前一段时间在学习ios的开发,近一段时间想着也接触下Android开发,以来加深对移动端开发的理解。这里根据自己配置Android开发环境的过程,比较详细的来总结下自己的安装过程,希望对一些正准备配置Android开发环境的小伙伴们有一定帮助。 1.Java JDK 需要先说明下,OS X系统是自带有Java JDK1.6的。不过这里我安装的是JDK7,下载地址:http://www.oracle.com/technetwork/java/javase/downloads/jdk7-downloads-1880260.html。见下图: 下载后,双击安装,如下图: 2.ADT(Android Develop Bundle) 下载地址:http://developer.android.com/sdk/index.html 如下图: 下载成功后,安装: 解压开发工具包后可看到底下有两个文件夹:eclipse和sdk。其中eclipse这个目录里有我们编程用的集成开发环境,而sdk这个目录里放的是和 android 开发相关的资源,具体到里面每个目录做什么,这里我就先不详细展开。 注意:尽量将解压的开发工具包放在一级目录下。有时你放在用中文命名的目录下,运行Eclipse会报错。 3.运行eclipse。 进入到eclipse目录下,运行Eclipse。之后会提示你工程文件夹放哪里,这个你可以自己设置路径(不要放在中文目录下),也可以使用默认路径。 有可能运行Eclipse时,会弹出如下图信息。这时也不用慌张,直接点击“安装” ,安装Java SE 6 runtime成功后,就可以运行Eclipse了。 进行到这里,mac下Android的开发环境就基本大功告成了,是不是so easy? 本文转自夏雪冬日博客园博客,原文链接:http://www.cnblogs.com/heyonggang/p/3525895.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

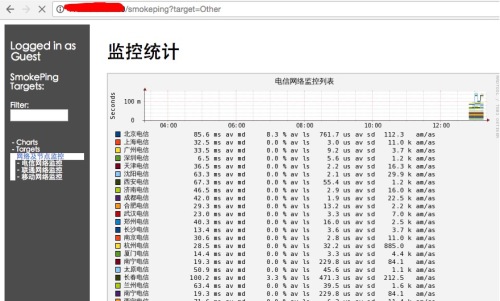
Centos6.5搭建smokeping服务

1.安装所需软件包。 yuminstall-yperlperl-Net-Telnetperl-Net-DNSperl-LDAPperl-libwww-perlperl-IO-Socket-SSLperl-Socket6perl-Time-HiResperl-ExtUtils-MakeMakerrrdtoolrrdtool-perlcurlhttpdhttpd-develgccmakewgetlibxml2-devellibpng-develglibpangopango-develfreetypefreetype-develfontconfigcairocairo-devellibart_lgpllibart_lgpl-develpoptpopt-devellibidnlibidn-devel 2.创建一个放置软件包的常用目录。 mkdir/smokeping/tools–p 3.下载fping软件包,并且解压,编译安装。 wgethttp://fping.org/dist/fping-3.10.tar.gz tar-zxvffping-3.10.tar.gz cdfping-3.10/ ./configure make&&makeinstall cd.. 4.下载echoping并且解压,编译安装。 wgethttp://fossies.org/linux/misc/old/echoping-6.0.2.tar.gz tar-zxvfechoping-6.0.2.tar.gz cdechoping-6.0.2/ ./configure make&&makeinstall 5.下载smokeping并且解压,编译安装。 wgethttp://oss.oetiker.ch/smokeping/pub/smokeping-2.6.9.tar.gz tar-zxvfsmokeping-2.6.9.tar.gz cdsmokeping-2.6.9/ ./setup/build-perl-modules.sh/usr/local/smokeping/thirdparty ./configure--prefix=/usr/local/smokeping gmakeinstall 6.创建三个文件目录和一个日志文件,并且设置属主和属组均为apache。 cd/usr/local/smokeping/ mkdir{cache,data,var} touch/var/log/smokeping.log chownapache.apache/var/log/smokeping.log chmod600/usr/local/smokeping/etc/smokeping_secrets.dist chown-Rapache.apachedata/ chown-Rapache.apachevar/ chown-Rapache.apachecache/ 7.修改相应的配置文件。 cd/usr/local/smokeping/htdocs/ mvsmokeping.fcgi.distsmokeping.fcgi cd/usr/local/smokeping/etc/ mvconfig.distconfig 8.配置apache配置文件和smokeping的配置文件。 在/etc/httpd/conf/httpd.con末尾添加以下加行: Alias/cache"/usr/local/smokeping/cache/" Alias/cropper"/usr/local/smokeping/htdocs/cropper/" Alias/smokeping"/usr/local/smokeping/htdocs/smokeping.fcgi" <Directory"/usr/local/smokeping"> AllowOverrideNone OptionsAll AddHandlercgi-script.fcgi.cgi Orderallow,deny Allowfromall DirectoryIndexsmokeping.fcgi </Directory> smokeping配置文件如下所示: cat/usr/local/smokeping/etc/config ***General*** owner=PeterRandom contact=some@address.nowhere mailhost=my.mail.host sendmail=/usr/sbin/sendmail #NOTE:donotputtheImageCachebelowcgi-bin #sinceallfilesundercgi-binwillbeexecuted...thisisnot #goodforp_w_picpaths. imgcache=/usr/local/smokeping/cache imgurl=cache datadir=/usr/local/smokeping/data piddir=/usr/local/smokeping/var cgiurl=http://10.104.96.155/smokeping.cgi smokemail=/usr/local/smokeping/etc/smokemail.dist tmail=/usr/local/smokeping/etc/tmail.dist #specifythistogetsysloglogging syslogfacility=local0 #eachprobeisnowruninitsownprocess #disablethistoreverttotheoldbehaviour #concurrentprobes=no ***Alerts*** to=alertee@address.somewhere from=smokealert@company.xy +someloss type=loss #inpercent pattern=>0%,*12*,>0%,*12*,>0% comment=loss3timesinarow ***Database*** step=300 pings=20 #consfnmrhbstepstotal AVERAGE0.511008 AVERAGE0.5124320 MIN0.5124320 MAX0.5124320 AVERAGE0.5144720 MAX0.5144720 MIN0.5144720 ***Presentation*** template=/usr/local/smokeping/etc/basepage.html.dist charset=utf-8 +charts menu=Charts title=Themostinterestingdestinations ++stddev sorter=StdDev(entries=>4) title=TopStandardDeviation menu=StdDeviation format=StandardDeviation%f ++max sorter=Max(entries=>5) title=TopMaxRoundtripTime menu=byMax format=MaxRoundtripTime%fseconds ++loss sorter=Loss(entries=>5) title=TopPacketLoss menu=Loss format=PacketsLost%f ++median sorter=Median(entries=>5) title=TopMedianRoundtripTime menu=byMedian format=MedianRTT%fseconds +overview width=600 height=50 range=10h +detail width=600 height=200 unison_tolerance=2 "Last3Hours"3h "Last30Hours"30h "Last10Days"10d "Last400Days"400d #+hierarchies #++owner #title=HostOwner #++location #title=Location ***Probes*** +FPing binary=/usr/local/sbin/fping ***Slaves*** secrets=/usr/local/smokeping/etc/smokeping_secrets.dist +boomer display_name=boomer color=0000ff +slave2 display_name=another color=00ff00 ***Targets*** probe=FPing menu=Top title=NetworkLatencyGrapher remark=WelcometotheSmokePingwebsiteofxxxCompany.\ Hereyouwilllearnallaboutthelatencyofournetwork. +Test menu=Targets #parents=owner:/Test/Jameslocation:/ ++James menu=James title=James alerts=someloss slaves=boomerslave2 host=james.address ++MultiHost menu=Multihost title=JamesandJamesasseenfromBoomer host=/Test/James/Test/James~boomer ++Localhost menu=Localhost title=Localhost alerts=someloss #slaves=boomerslave2 host=10.104.96.155 +Other menu=网络及节点监控 title=监控统计 ++dianxin menu=电信网络监控 title=电信网络监控列表 host=/Other/dianxin/dianxin-bj/Other/dianxin/dianxin-sh/Other/dianxin/dianxin-gz/Other/dianxin/dianxin-sz/Other/dianxin/dianxin-tj/Other/dianxin/dianxin-sy/Other/dianxin/dianxin-xa/Other/dianxin/dianxin-jn/Other/dianxin/dianxin-cd/Other/dianxin/dianxin-hf/Other/dianxin/dianxin-wh/Other/dianxin/dianxin-zz/Other/dianxin/dianxin-cs/Other/dianxin/dianxin-nj/Other/dianxin/dianxin-hz/Other/dianxin/dianxin-xm/Other/dianxin/dianxin-nn/Other/dianxin/dianxin-ty/Other/dianxin/dianxin-cc/Other/dianxin/dianxin-lz/Other/dianxin/dianxin-nn/Other/dianxin/dianxin-xn/Other/dianxin/dianxin-hk/Other/dianxin/dianxin-fz/Other/dianxin/dianxin-gy/Other/dianxin/dianxin-km/Other/dianxin/dianxin-xj/Other/dianxin/dianxin-xz/Other/dianxin/dianxin-heb/Other/dianxin/dianxin-hhht +++dianxin-bj menu=北京电信 title=北京电信 alerts=someloss host=106.37.232.114 +++dianxin-sh menu=上海电信 title=上海电信 alerts=someloss host=202.96.209.133 +++dianxin-gz menu=广州电信 title=广州电信 alerts=someloss host=219.137.229.134 +++dianxin-sz menu=深圳电信 title=深圳电信 alerts=someloss host=202.96.154.15 +++dianxin-tj menu=天津电信 title=天津电信 alerts=someloss host=219.150.32.132 +++dianxin-sy menu=沈阳电信 title=沈阳电信 alerts=someloss host=219.148.204.66 +++dianxin-xa menu=西安电信 title=西安电信 alerts=someloss host=117.35.68.4 +++dianxin-jn menu=济南电信 title=济南电信 alerts=someloss host=219.146.0.253 +++dianxin-cd menu=成都电信 title=成都电信 alerts=someloss host=61.139.2.69 +++dianxin-hf menu=合肥电信 title=合肥电信 alerts=someloss host=220.178.75.134 +++dianxin-wh menu=武汉电信 title=武汉电信 alerts=someloss host=221.232.129.35 +++dianxin-zz menu=郑州电信 title=郑州电信 alerts=someloss host=123.52.19.15 +++dianxin-cs menu=长沙电信 title=长沙电信 alerts=someloss host=202.103.96.253 +++dianxin-nj menu=南京电信 title=南京电信 alerts=someloss host=218.2.135.1 +++dianxin-hz menu=杭州电信 title=杭州电信 alerts=someloss host=202.96.96.68 +++dianxin-xm menu=厦门电信 title=厦门电信 alerts=someloss host=202.101.103.54 +++dianxin-nn menu=南宁电信 title=南宁电信 alerts=someloss host=202.103.225.254 +++dianxin-ty menu=太原电信 title=太原电信 alerts=someloss host=59.49.77.1 +++dianxin-cc menu=长春电信 title=长春电信 alerts=someloss host=219.149.194.55 +++dianxin-lz menu=兰州电信 title=兰州电信 alerts=someloss host=202.100.64.68 +++dianxin-nc menu=南昌电信 title=南昌电信 alerts=someloss host=202.101.224.68 +++dianxin-xn menu=西宁电信 title=西宁电信 alerts=someloss host=202.100.138.68 +++dianxin-hk menu=海口电信 title=海口电信 alerts=someloss host=202.100.192.1 +++dianxin-fz menu=福州电信 title=福州电信 alerts=someloss host=218.85.157.99 +++dianxin-gy menu=贵阳电信 title=贵阳电信 alerts=someloss host=202.98.198.167 +++dianxin-km menu=昆明电信 title=昆明电信 alerts=someloss host=222.172.200.68 +++dianxin-xj menu=新疆电信 title=新疆电信 alerts=someloss host=61.128.114.133 +++dianxin-xz menu=西藏电信 title=西藏电信 alerts=someloss host=202.98.224.2 +++dianxin-heb menu=哈尔滨电信 title=哈尔滨电信 alerts=someloss host=219.150.32.132 +++dianxin-hhht menu=呼和浩特电信 title=呼和浩特电信 alerts=someloss host=121.56.12.12 ++liantong menu=联通网络监控 title=联通网络监控列表 host=/Other/liantong/liantong-bj/Other/liantong/liantong-sh/Other/liantong/liantong-gz/Other/liantong/liantong-sz/Other/liantong/liantong-tj/Other/liantong/liantong-sy/Other/liantong/liantong-xa/Other/liantong/liantong-jn/Other/liantong/liantong-qd/Other/liantong/liantong-cd/Other/liantong/liantong-ah/Other/liantong/liantong-wh/Other/liantong/liantong-zz/Other/liantong/liantong-cs/Other/liantong/liantong-nj/Other/liantong/liantong-hz/Other/liantong/liantong-xm/Other/liantong/liantong-nn/Other/liantong/liantong-nc/Other/liantong/liantong-ty/Other/liantong/liantong-xn/Other/liantong/liantong-gz/Other/liantong/liantong-fz/Other/liantong/liantong-lz/Other/liantong/liantong-km/Other/liantong/liantong-xj/Other/liantong/liantong-xz/Other/liantong/liantong-heb/Other/liantong/liantong-hhht +++liantong-bj menu=北京联通 title=北京联通 alerts=someloss host=202.106.196.253 +++liantong-sh menu=上海联通 title=上海联通 alerts=someloss host=210.22.70.253 +++liantong-gz menu=广州联通 title=广州联通 alerts=someloss host=221.4.66.66 +++liantong-sz menu=深圳联通 title=深圳联通 alerts=someloss host=210.21.196.6 +++liantong-tj menu=天津联通 title=天津联通 alerts=someloss host=202.99.96.1 +++liantong-sy menu=沈阳联通 title=沈阳联通 alerts=someloss host=202.96.75.1 +++liantong-xa menu=西安联通 title=西安联通 alerts=someloss host=221.11.1.67 +++liantong-jn menu=济南联通 title=济南联通 alerts=someloss host=202.102.152.3 +++liantong-qd menu=青岛联通 title=青岛联通 alerts=someloss host=202.102.128.68 +++liantong-cd menu=成都联通 title=成都联通 alerts=someloss host=119.6.6.6 +++liantong-ah menu=安徽联通 title=安徽联通 alerts=someloss host=218.104.78.2 +++liantong-wh menu=武汉联通 title=武汉联通 alerts=someloss host=218.104.111.122 +++liantong-zz menu=郑州联通 title=郑州联通 alerts=someloss host=218.29.122.70 +++liantong-cs menu=长沙联通 title=长沙联通 alerts=someloss host=58.20.127.238 +++liantong-nj menu=南京联通 title=南京联通 alerts=someloss host=221.6.4.66 +++liantong-hz menu=杭州联通 title=杭州联通 alerts=someloss host=221.12.31.58 +++liantong-xm menu=厦门联通 title=厦门联通 alerts=someloss host=218.104.128.106 +++liantong-nn menu=南宁联通 title=南宁联通 alerts=someloss host=221.7.136.68 +++liantong-nc menu=南昌联通 title=南昌联通 alerts=someloss host=220.248.192.10 +++liantong-ty menu=太原联通 title=太原联通 alerts=someloss host=202.99.192.66 +++liantong-xn menu=西宁联通 title=西宁联通 alerts=someloss host=221.207.12.130 +++liantong-gy menu=贵阳联通 title=贵阳联通 alerts=someloss host=221.13.30.242 +++liantong-fz menu=福州联通 title=福州联通 alerts=someloss host=58.22.96.6 +++liantong-lz menu=兰州联通 title=兰州联通 alerts=someloss host=221.7.34.1 +++liantong-km menu=昆明联通 title=昆明联通 alerts=someloss host=221.3.131.11 +++liantong-xj menu=新疆联通 title=新疆联通 alerts=someloss host=60.13.184.49 +++liantong-xz menu=西藏联通 title=西藏联通 alerts=someloss host=221.13.65.38 +++liantong-heb menu=哈尔滨联通 title=哈尔滨联通 alerts=someloss host=202.97.224.1 +++liantong-hhht menu=呼和浩特联通 title=呼和浩特联通 alerts=someloss host=202.99.224.67 ++yidong menu=移动网络监控 title=移动网络监控列表 host=/Other/yidong/yidong-bj/Other/yidong/yidong-sh/Other/yidong/yidong-gz/Other/yidong/yidong-sz/Other/yidong/yidong-tj/Other/yidong/yidong-sy/Other/yidong/yidong-xa/Other/yidong/yidong-jn/Other/yidong/yidong-qd/Other/yidong/yidong-cd/Other/yidong/yidong-hf/Other/yidong/yidong-wh/Other/yidong/yidong-zz/Other/yidong/yidong-cs/Other/yidong/yidong-nj/Other/yidong/yidong-nc/Other/yidong/yidong-gy/Other/yidong/yidong-fz/Other/yidong/yidong-lz/Other/yidong/yidong-km/Other/yidong/yidong-hz/Other/yidong/yidong-nn/Other/yidong/yidong-wlmq/Other/yidong/yidong-ls +++yidong-bj menu=北京移动 title=北京移动 alerts=someloss host=211.136.17.107 +++yidong-sh menu=上海移动 title=上海移动 alerts=someloss host=211.136.150.25 +++yidong-gz menu=广州移动 title=广州移动 alerts=someloss host=221.179.38.7 +++yidong-sz menu=深圳移动 title=深圳移动 alerts=someloss host=120.196.165.7 +++yidong-tj menu=天津移动 title=天津移动 alerts=someloss host=211.137.160.5 +++yidong-sy menu=沈阳移动 title=沈阳移动 alerts=someloss host=211.137.32.178 +++yidong-xa menu=西安移动 title=西安移动 alerts=someloss host=218.200.48.238 +++yidong-jn menu=济南移动 title=济南移动 alerts=someloss host=211.137.191.26 +++yidong-qd menu=青岛移动 title=青岛移动 alerts=someloss host=211.137.186.224 +++yidong-cd menu=成都移动 title=成都移动 alerts=someloss host=211.137.96.205 +++yidong-hf menu=合肥移动 title=合肥移动 alerts=someloss host=211.138.180.2 +++yidong-wh menu=武汉移动 title=武汉移动 alerts=someloss host=211.137.59.2 +++yidong-zz menu=郑州移动 title=郑州移动 alerts=someloss host=211.138.30.66 +++yidong-cs menu=长沙移动 title=长沙移动 alerts=someloss host=111.8.55.1 +++yidong-nj menu=南京移动 title=南京移动 alerts=someloss host=221.130.48.1 +++yidong-hz menu=杭州移动 title=杭州移动 alerts=someloss host=120.199.7.10 +++yidong-nn menu=南宁移动 title=南宁移动 alerts=someloss host=211.138.245.180 +++yidong-nc menu=南昌移动 title=南昌移动 alerts=someloss host=211.141.90.68 +++yidong-gy menu=贵阳移动 title=贵阳移动 alerts=someloss host=211.139.5.1 +++yidong-fz menu=福州移动 title=福州移动 alerts=someloss host=211.138.151.1 +++yidong-lz menu=兰州移动 title=兰州移动 alerts=someloss host=218.203.160.1 +++yidong-km menu=昆明移动 title=昆明移动 alerts=someloss host=211.139.29.1 +++yidong-wlmq menu=乌鲁木齐移动 title=乌鲁木齐移动 alerts=someloss host=218.202.152.131 +++yidong-ls menu=拉萨移动 title=拉萨移动 alerts=someloss host=211.139.73.35 9.分别启动smokeping和httpd。 /usr/local/smokeping/bin/smokeping ps-ef|grepsmoke hadoop2184819908011:20pts/100:00:00grepsmoke root17713110Sep27?00:00:38/usr/local/smokeping/bin/smokeping[FPing] /etc/init.d/httpdstart -ef|grephttpd hadoop2224519908011:21pts/100:00:00grephttpd root17715210Sep27?00:00:00/usr/sbin/httpd apache1771541771520Sep27?00:00:00/usr/sbin/httpd apache1771551771520Sep27?00:00:00/usr/sbin/httpd apache1771561771520Sep27?00:00:00/usr/sbin/httpd apache1771571771520Sep27?00:00:00/usr/sbin/httpd apache1771581771520Sep27?00:00:00/usr/sbin/httpd apache1771591771520Sep27?00:00:00/usr/sbin/httpd apache1771601771520Sep27?00:00:00/usr/sbin/httpd apache1771611771520Sep27?00:00:00/usr/sbin/httpd apache1773731771520Sep27?00:00:00/usr/sbin/httpd apache1773781771520Sep27?00:00:00/usr/sbin/httpd apache1797261771520Sep27?00:00:00/usr/sbin/httpd 10.让smokeping界面支持中文 安装字体 yum-yinstallwqy-zenhei-fonts.noarch 编辑smokeping的配置文件vim/usr/local/smokeping/etc/config 第50行添加 charset=utf-8#添加此行 编辑Graphs.pm这个文件vim/usr/local/smokeping/lib/Smokeping/Graphs.pm#第147行下边插入下边一行 '--fontTITLE:20:"WenQuanYiZenHeiMono"', 11.访问地址,看下是否可以出现smokeping页面。

优秀的个人博客,低调大师

Ubuntu Docker Registry 搭建私有仓库

服务器版本 Ubuntu 16.04 LTS。 安装命令: $ docker run -d -v /opt/registry:/var/lib/registry -p 5000:5000 --restart=always --name registry registry Registry 服务默认会将镜像保存在/var/lib/registry目录下,上面命令设置保存目录在/opt/registry下,我们可以看下 Registry 容器状态: $ docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES e2b1ffd9072e registry "/entrypoint.sh /e..." 2 hours ago Up About an hour 0.0.0.0:5000->5000/tcp stoic_davinci 接着,我们登录另外一台服务器,将本地的已有的镜像文件推送到私有仓库中,首先,我们需要将镜像的tag标记为要推送到私有仓库,示例: $ docker tag hwapp:v2 40.125.207.78:5000/hwapp:v3 然后,我们看下镜像文件列表: $ docker images docker images REPOSITORY TAG IMAGE ID CREATED SIZE 40.125.207.78:5000/hwapp v3 fe28b19b4410 24 hours ago 1.63GB hwapp v2 fe28b19b4410 24 hours ago 1.63GB hwapp v1 8a28e2e870d4 25 hours ago 1.63GB microsoft/aspnetcore latest 0f2330f1a843 26 hours ago 280MB microsoft/dotnet latest a7dd4972fc95 6 days ago 1.63GB 最后,我们就可以将40.125.207.78:5000/hwapp:v3镜像文件,推送到私有仓库了: $ docker push 40.125.207.78:5000/hwapp:v3 可能会出现下面的错误: $ docker push 40.125.207.78:5000/hwapp:v3 The push refers to a repository [40.125.207.78:5000/hwapp] Get https://40.125.207.78:5000/v1/_ping: http: server gave HTTP response to HTTPS client 解决方式,在本服务器操作,而不是私有仓库所在服务器(如果已有daemon.json文件,进行修改即可): $ touch /etc/docker/daemon.json $ echo '{ "insecure-registries": ["40.125.207.78:5000"] }' > /etc/docker/daemon.json $ service docker restart 然后,再执行下推送命令就可以了,我们也可以直接构建成要推送私有仓库的镜像,示例: $ docker build -t 40.125.207.78:5000/hwapp:v4 . 然后,再执行下推送命令: $ docker push 40.125.207.78:5000/hwapp:v4 推送成功之后,我们可以检查下私有仓库里的镜像文件: $ curl http://40.125.207.78:5000/v2/_catalog {"repositories":["hwapp"]} $ curl http://40.125.207.78:5000/v2/hwapp/tags/list {"name":"hwapp","tags":["v3","v4"]} 然后,我们就可以拉取私有仓库里的镜像文件了: $ docker pull 40.125.207.78:5000/hwapp:v4 本文转自田园里的蟋蟀博客园博客,原文链接:http://www.cnblogs.com/xishuai/p/ubuntu-docker-registry.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

在docker 中搭建gitlab环境

docker run --name gitlab -it -p 10022:22 -p 10080:80 -p 4433:443 \ --env 'GITLAB_SECRETS_DB_KEY_BASE=Rpwq35wjLJ5N6CrkvdXsqTDHsh6XG3QkhdtRTkt87fvLwzvlmtdNWMCwNjDj5Xk9' \ --env 'DB_HOST=192.168.1.58' --env 'DB_NAME=gitlabhq_production' \ --env 'DB_USER=root' --env 'DB_PASS=admin' \ --env 'GITLAB_PORT=10080' --env 'GITLAB_SSH_PORT=10022' \ --env 'REDIS_HOST=192.168.1.58' --env 'REDIS_PORT=6379' \ --volume /data/gitlab/gitlab:/home/git/data \ docker.io/sameersbn/gitlab docker run --name gitlab-mysql -d \ --env 'DB_NAME=gitlabhq_production' \ --env 'DB_USER=gitlab' --env 'DB_PASS=admin' \ --volume /data/gitlab/mysql:/var/lib/mysql \ docker.io/sameersbn/mysql docker run --name gitlab-redis -d \ --volume /data/gitlab/redis:/var/lib/redis \ docker.io/sameersbn/redis docker run --name gitlab -d \ --link gitlab-mysql:mysql --link gitlab-redis:redisio \ --publish 10022:22 --publish 10080:80 \ --env 'GITLAB_PORT=10080' --env 'GITLAB_HOST=192.168.1.58' --env 'GITLAB_SSH_PORT=10022' \ --env 'GITLAB_SECRETS_DB_KEY_BASE=long-and-random-alpha-numeric-string' \ --volume /srv/docker/gitlab/gitlab:/home/git/data \ docker.io/sameersbn/gitlab docker run --name gitlab-ci -d \ --link gitlab-mysql:mysql --link gitlab-ci-redis:redisio \ --publish 10081:80 \ --env 'GITLAB_CI_PORT=10081' --env 'GITLAB_CI_HOST=192.168.1.58' --env 'GITLAB_URL=http://192.168.1.58:10080' \ --env 'GITLAB_APP_ID=xxx' --env 'GITLAB_APP_SECRET=yyy' \ --volume /srv/docker/gitlab-ci/gitlab-ci:/home/git/gitlab_ci/data \ quay.io/sameersbn/gitlab-ci docker run --name gitlab-ci-runner -it --rm \ -v /opt/gitlab-ci-runner:/home/gitlab_ci_runner/data \ sameersbn/gitlab-ci-runner docker run --name gitlab-ci-multi-runner -d --restart=always \ --volume /opt/gitlab-ci-multi-runner:/home/gitlab_ci_multi_runner/data \ --env='CI_SERVER_URL=http://192.168.1.58:10080/ci' --env='RUNNER_TOKEN=31d563f789129ea1d35bd0b92a0665' \ --env='RUNNER_DESCRIPTION=myrunner' --env='RUNNER_EXECUTOR=shell' \ docker.io/sameersbn/gitlab-ci-multi-runner username: root password: 5iveL!fe docker run --name mysql -p 192.168.1.58:3306:3306 -d \ -e 'DB_REMOTE_ROOT_NAME=root' -e 'DB_REMOTE_ROOT_PASS=admin' \ --env 'DB_NAME=gitlabhq_production' \ --env 'DB_USER=gitlab' --env 'DB_PASS=admin' \ docker.io/sameersbn/mysql docker run --name gitlab -d -p 10022:22 -p 10080:80 -p 4433:443 \ --env 'GITLAB_SECRETS_DB_KEY_BASE=Rpwq35wjLJ5N6CrkvdXsqTDHsh6XG3QkhdtRTkt87fvLwzvlmtdNWMCwNjDj5Xk9' \ --env 'DB_HOST=192.168.1.58' --env 'DB_NAME=gitlabhq_production' \ --env 'DB_USER=root' --env 'DB_PASS=admin' --env 'DB_PORT=3306' \ --env 'GITLAB_PORT=10080' --env 'GITLAB_SSH_PORT=10022' \ --env 'REDIS_HOST=192.168.1.58' --env 'REDIS_PORT=6379' \ --volume /data/gitlab/gitlab:/home/git/data \ docker.io/sameersbn/gitlab docker run --name gitlab -it -p 10022:22 -p 10080:80 -p 4433:443 \ --env 'GITLAB_SECRETS_DB_KEY_BASE=Rpwq35wjLJ5N6CrkvdXsqTDHsh6XG3QkhdtRTkt87fvLwzvlmtdNWMCwNjDj5Xk9' \ --env 'DB_HOST=192.168.1.58' --env 'DB_NAME=gitlabhq_production' \ --env 'DB_USER=root' --env 'DB_PASS=admin' --evn 'DB_PORT=3306' \ --env 'GITLAB_PORT=10080' --env 'GITLAB_SSH_PORT=10022' \ --env 'REDIS_HOST=192.168.1.58' --env 'REDIS_PORT=6379' \ --volume /data/gitlab/gitlab:/home/git/data \ docker.io/sameersbn/gitlab /bin/bash GRANT ALL PRIVILEGES ON *.* TO 'root'@'%' IDENTIFIED BY 'admin' WITH GRANT OPTION;

优秀的个人博客,低调大师

Hadoop 2.6.0集群搭建

yum install gcc yum install gcc-c++ yum install make yum install autoconfautomake libtool cmake yum install ncurses-devel yum install openssl-devel groupadd hadoop 添加一个组 useradd hadoop -g hadoop 添加用户 安装protoc(需用root用户) 1 tar -xvf protobuf-2.5.0.tar.bz2 2 cd protobuf-2.5.0 3 ./configure --prefix=/opt/protoc/ 4 make && make install 编译hadoop mvn clean package -Pdist,native -DskipTests -Dtar 编译完的hadoop在 /home/hadoop/ocdc/hadoop-2.6.0-src/hadoop-dist/target 路径下 配置hosts文件 10.1.245.244 master 10.1.245.243 slave1 命令行输入 hostname master 免密码登录: 执行命令生成密钥: ssh-keygen -t rsa -P "" 进入文件夹cd .ssh (进入文件夹后可以执行ls -a 查看文件) 将生成的公钥id_rsa.pub 内容追加到authorized_keys(执行命令:cat id_rsa.pub >> authorized_keys) ---------------------------(core-site.xml)------------------------------ <configuration> <!--指定hdfs的nameservice为ns1--> <property> <name>fs.defaultFS</name> <value>hdfs://master</value> </property> <property> <name>io.file.buffer.size</name> <value>131072</value> </property> <!--指定hadoop数据存放目录--> <property> <name>hadoop.tmp.dir</name> <value>/home/hadoop/ocdc/hadoop-2.6.0/tmp</value> <description>Abasefor other temporary directories.</description> </property> <property> <name>hadoop.proxyuser.spark.hosts</name> <value>*</value> </property> <property> <name>hadoop.proxyuser.spark.groups</name> <value>*</value> </property> </configuration> <!--指定zookeeper地址--> <property> <name>ha.zookeeper.quorum</name> <value>h4:2181,h5:2181,h6:2181</value> </property> </configuration> -------------------------------(hdfs-site.xml )----------------------------------- <configuration> <property> <name>dfs.namenode.secondary.http-address</name> <value>master:9001</value> </property> <property> <name>dfs.namenode.name.dir</name> <value>/home/hadoop/ocdc/hadoop-2.6.0/name</value> </property> <property> <name>dfs.datanode.data.dir</name> <value>/home/hadoop/ocdc/hadoop-2.6.0/data</value> </property> <property> <name>dfs.replication</name> <value>3</value> </property> <property> <name>dfs.webhdfs.enabled</name> <value>true</value> </property> <property> <name>dfs.nameservices</name> <value>ns1</value> </property> <!-- ns1下面有两个NameNode,分别是nn1,nn2 --> <property> <name>dfs.ha.namenodes.ns1</name> <value>nn1,nn2</value> </property> </configuration> ----------------------------------------(yarn-site.xml)-------------------------- <configuration> <!-- Site specific YARN configuration properties --> <!--指定nodemanager启动时加载server的方式为shuffle server --> <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value> </property> <property> <name>yarn.nodemanager.aux-services.mapreduce.shuffle.class</name> <value>org.apache.hadoop.mapred.ShuffleHandler</value> </property> <property> <name>yarn.resourcemanager.address</name> <value>master:8032</value> </property> <property> <name>yarn.resourcemanager.scheduler.address</name> <value>master:8030</value> </property> <property> <name>yarn.resourcemanager.resource-tracker.address</name> <value>master:8035</value> </property> <property> <name>yarn.resourcemanager.admin.address</name> <value>master:8033</value> </property> <property> <name>yarn.resourcemanager.webapp.address</name> <value>master:8088</value> </property> <property> <name>yarn.nodemanager.resource.memory-mb</name> <value>16384</value> </property> </configuration> <!--指定resourcemanager地址--> <property> <name>yarn.resourcemanager.hostname</name> <value>h3</value> </property> -----------------------------(mapred-site.xml)------------------------------- <configuration> <property> <name>mapreduce.framework.name</name> <value>yarn</value> </property> <property> <name>mapreduce.jobhistory.address</name> <value>master:10020</value> </property> <property> <name>mapreduce.jobhistory.webapp.address</name> <value>master:19888</value> </property> <property> <name>yarn.scheduler.maximum-allocation-mb</name> <value>16384</value> </property> </configuration>

优秀的个人博客,低调大师

Go 语言读写 Excel 基础库

Excelize 是 Go 语言编写的一个用来操作 Office Excel 文档类库,基于 ECMA-376 Office OpenXML 标准。可以使用它来读取、写入 XLSX 文件。相比较其他的开源类库,Excelize 支持写入原本带有图片(表)的文档,还支持向 Excel 中插入图片,并且在保存后不会丢失图表样式。 安装 go get github.com/xuri/excelize/v2 创建 XLSX package main import ( "fmt" "github.com/xuri/excelize/v2" ) func main() { f := excelize.NewFile() // Create a new sheet. index := f.NewSheet("Sheet2") // Set value of a cell. f.SetCellValue("Sheet2", "A2", "Hello world.") f.SetCellValue("Sheet1", "B2", 100) // Set active sheet of the workbook. f.SetActiveSheet(index) // Save xlsx file by the given path. err := f.SaveAs("./Book1.xlsx") if err != nil { fmt.Println(err) } } 读取已有文档 package main import ( "fmt" "github.com/xuri/excelize/v2" ) func main() { f, err := excelize.OpenFile("./Book1.xlsx") if err != nil { fmt.Println(err) return } // Get value from cell by given worksheet name and axis. cell, err := f.GetCellValue("Sheet1", "B2") if err != nil { fmt.Println(err) return } fmt.Println(cell) // Get all the rows in the Sheet1. rows, err := f.GetRows("Sheet1") for _, row := range rows { for _, colCell := range row { fmt.Print(colCell, "\t") } fmt.Println() } } 向 Excel 中插入图表 package main import ( "fmt" "github.com/xuri/excelize/v2" ) func main() { categories := map[string]string{"A2": "Small", "A3": "Normal", "A4": "Large", "B1": "Apple", "C1": "Orange", "D1": "Pear"} values := map[string]int{"B2": 2, "C2": 3, "D2": 3, "B3": 5, "C3": 2, "D3": 4, "B4": 6, "C4": 7, "D4": 8} f := excelize.NewFile() for k, v := range categories { f.SetCellValue("Sheet1", k, v) } for k, v := range values { f.SetCellValue("Sheet1", k, v) } err := f.AddChart("Sheet1", "E1", `{"type":"col3DClustered","series":[{"name":"Sheet1!$A$2","categories":"Sheet1!$B$1:$D$1","values":"Sheet1!$B$2:$D$2"},{"name":"Sheet1!$A$3","categories":"Sheet1!$B$1:$D$1","values":"Sheet1!$B$3:$D$3"},{"name":"Sheet1!$A$4","categories":"Sheet1!$B$1:$D$1","values":"Sheet1!$B$4:$D$4"}],"title":{"name":"Fruit 3D Clustered Column Chart"}}`) if err != nil { fmt.Println(err) return } // Save xlsx file by the given path. err = f.SaveAs("./Book1.xlsx") if err != nil { fmt.Println(err) } } 向 Excel 中插入图片 package main import ( "fmt" _ "image/gif" _ "image/jpeg" _ "image/png" "github.com/xuri/excelize/v2" ) func main() { f, err := excelize.OpenFile("./Book1.xlsx") if err != nil { fmt.Println(err) return } // Insert a picture. err = f.AddPicture("Sheet1", "A2", "./image1.png", "") if err != nil { fmt.Println(err) } // Insert a picture to worksheet with scaling. err = f.AddPicture("Sheet1", "D2", "./image2.jpg", `{"x_scale": 0.5, "y_scale": 0.5}`) if err != nil { fmt.Println(err) } // Insert a picture offset in the cell with printing support. err = f.AddPicture("Sheet1", "H2", "./image3.gif", `{"x_offset": 15, "y_offset": 10, "print_obj": true, "lock_aspect_ratio": false, "locked": false}`) if err != nil { fmt.Println(err) } // Save the xlsx file with the origin path. err = f.Save() if err != nil { fmt.Println(err) } } 还有其他一些功能,在这里就不一一列举了,详细使用文档以及获取后期的维护更新可以从项目的主页获取 github.com/xuri/excelize

优秀的个人博客,低调大师

GaussDB SQL基础语法-变量&常量

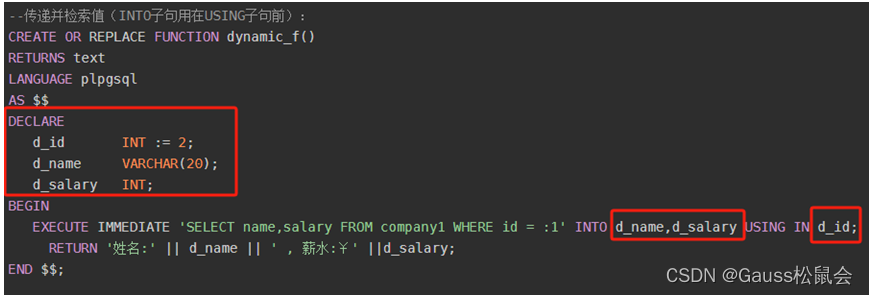
一、前言 SQL是用于访问和处理数据库的标准计算机语言。GaussDB支持SQL标准(默认支持SQL2、SQL3和SQL4的主要特性)。 本系列将以《云数据库GaussDB—SQL参考》在线文档为主线进行介绍。 二、GaussDB数据库中的常量和变量的基本概述及语法定义 数据库中的变量和常量是两种重要的数据使用类型。变量是可以变化和被修改的,而常量则是固定不变,不能被修改的。 1、变量定义 在GaussDB中,变量是用于存储可变值的数据类型。变量通常在程序中定义,并在执行期间可以更改其值。在GaussDB中,可以使用以下语法来定义变量: DECLARE variable_name data_type; 其中,variable_name 是变量的名称,data_type 是变量的数据类型。例如,要定义一个名为 my_variable 的整数变量,可以使用以下语句: DECLARE my_variable INT; 2、常量定义 在GaussDB中,常量用于存储固定值的数据类型。常量在程序中定义后,其值不能被修改。在GaussDB中,可以使用以下语法来定义常量: DECLARE constant_name data_type = constant_value; 其中,constant_name 是常量的名称,data_type 是常量的数据类型,constant_value 是常量的值。例如,要定义一个名为 my_constant 的整数常量,可以使用以下语句: DECLARE my_constant INT = 10; 这将定义一个名为 my_constant 的整数常量,其值为 10。 请注意,这只是GaussDB中定义变量和常量的基本语法。具体建议参考GaussDB的官方文档或相关资料以获取更详细信息。 3、其他(%TYPE、%ROWTYPE属性) 变量类型除了支持基本类型,还可使用%TYPE和%ROWTYPE去声明一些与其他表字段或表结构本身相关的变量。 %TYPE属性: %TYPE主要用于声明某个与其他变量类型(例如,表中某列的类型)相同的变量。假如我们想定义一个my_name变量,它的变量类型与employee的firstname类型相同,我们可以通过如下定义: `--使用某列的属性声明 DECLARE my_name employee.firstname%TYPE --使用其他变量的属性声明 DECLARE name VARCHAR(10) NOT NULL := 'ZhangSan'; surname name%TYPE := 'LiSi';` 这样定义可以带来两个好处,首先,我们不用预先知道employee 表的firstname类型具体是什么。其次,即使之后firstname类型有了变化,我们也不需要再次修改my_name的类型。 %ROWTYPE属性: %ROWTYPE属性主要用于对一组数据的类型声明,用于存储表中的一行数据,或从游标匹配的结果。假如,我们需要一组数据,该组数据的字段名称与字段类型都与employee表相同。我们可以通过如下定义: --根据表employee表结构定义变量类型 DECLARE my_employee employee%ROWTYPE 三、在GaussDB数据库中如何使用变量&常量(示例) 变量&常量一般在数据库中不能直接应用到简单的SQL语句中,而是常常用于自定义的函数、存储过程中。下文简单举一列子(可参考前面FUNCTION/PROCEDURE等相关文章): 示例一,定义常量&变量(创建动态语句) 常量作为WHERE 条件之一;变量存储查询的结果值。 示例二,定义变量(创建游标) 定义变量,存储游标结果值 示例三,定义变量(创建package属性重载函数) 定义TEXT类型变量、赋值SQL语句 四、小结 在GaussDB数据库中,变量和常量是两种不同的数据存储方式。变量是用于存储可变值的数据类型,可以在程序执行期间更改其值。而常量则是用于存储固定值的数据类型,其值在定义后不能被修改。 在GaussDB中,可以使用DECLARE语句来定义变量和常量,并通过使用“:=”运算符来为它们赋值。正确地定义和使用变量和常量可以提高程序的灵活性和可维护性,并确保数据的准确性和完整性。 ——结束

优秀的个人博客,低调大师

ElasticSearch必知必会-基础篇

京东物流 康睿 姚再毅 李振 刘斌 王北永 说明:以下全部均基于eslaticsearch 8.1 版本 一.索引的定义 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/indices.html 索引的全局认知 ElasticSearch Mysql Index Table Type废弃 Table废弃 Document Row Field Column Mapping Schema Everything is indexed Index Query DSL SQL GET http://... select * from POST http://... update table set ... Aggregations group by\sum\sum cardinality 去重 distinct reindex 数据迁移 索引的定义 定义: 相同文档结构(Mapping)文档的结合 由唯一索引名称标定 一个集群中有多个索引 不同的索引代表不同的业务类型数据 注意事项: 索引名称不支持大写 索引名称最大支持255个字符长度 字段的名称,支持大写,不过建议全部统一小写 索引的创建 ​ index-settings 参数解析 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/index-modules.html 注意: 静态参数索引创建后,不再可以修改,动态参数可以修改 思考: 一、为什么主分片创建后不可修改? A document is routed to a particular shard in an index using the following formula: <shard_num = hash(_routing) % num_primary_shards> the defalue value userd for _routing is the document`s _id es中写入数据,是根据上述的公式计算文档应该存储在哪个分片中,后续的文档读取也是根据这个公式,一旦分片数改变,数据也就找不到了 简单理解 根据ID做Hash 然后再 除以 主分片数 取余,被除数改变,结果就不一样了 二、如果业务层面根据数据情况,确实需要扩展主分片数,那怎么办? reindex 迁移数据到另外一个索引 https://www.elastic.co/guide/en/elasticsearch/reference/8.1/docs-reindex.html ​ 索引的基本操作 ​ 二.Mapping-Param之dynamic 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/dynamic.html 核心功能 自动检测字段类型后添加字段 也就是哪怕你没有在es的mapping中定义该字段,es也会动态的帮你检测字段类型 初识dynamic // 删除test01索引,保证这个索引现在是干净的 DELETE test01 // 不定义mapping,直接一条插入数据试试看, POST test01/_doc/1 { "name":"kangrui10" } // 然后我们查看test01该索引的mapping结构 看看name这个字段被定义成了什么类型 // 由此可以看出,name一级为text类型,二级定义为keyword,但其实这并不是我们想要的结果, // 我们业务查询中name字段并不会被分词查询,一般都是全匹配(and name = xxx) // 以下的这种结果,我们想要实现全匹配 就需要 name.keyword = xxx 反而麻烦 GET test01/_mapping { "test01" : { "mappings" : { "properties" : { "name" : { "type" : "text", "fields" : { "keyword" : { "type" : "keyword", "ignore_above" : 256 } } } } } } } dynamic的可选值 可选值 说明 解释 true New fields are added to the mapping (default). 创建mapping时,如果不指定dynamic的值,默认true,即如果你的字段没有收到指定类型,就会es帮你动态匹配字段类型 false New fields are ignored. These fields will not be indexed or searchable, but will still appear in the _source field of returned hits. These fields will not be added to the mapping, and new fields must be added explicitly. 若设置为false,如果你的字段没有在es的mapping中创建,那么新的字段,一样可以写入,但是不能被查询,mapping中也不会有这个字段,也就是被写入的字段,不会被创建索引 strict If new fields are detected, an exception is thrown and the document is rejected. New fields must be explicitly added to the mapping. 若设置为strict,如果新的字段,没有在mapping中创建字段,添加会直接报错,生产环境推荐,更加严谨。示例如下,如要新增字段,就必须手动的新增字段 动态映射的弊端 字段匹配相对准确,但不一定是用户期望的 比如现在有一个text字段,es只会给你设置为默认的standard分词器,但我们一般需要的是ik中文分词器 占用多余的存储空间 string类型匹配为text和keyword两种类型,意味着会占用更多的存储空间 mapping爆炸 如果不小心写错了查询语句,get用成了put误操作,就会错误创建很多字段 三.Mapping-Param之doc_values 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/doc-values.html 核心功能 DocValue其实是Lucene在构建倒排索引时,会额外建立一个有序的正排索引(基于document => field value的映射列表) DocValue本质上是一个序列化的 列式存储,这个结构非常适用于聚合(aggregations)、排序(Sorting)、脚本(scripts access to field)等操作。而且,这种存储方式也非常便于压缩,特别是数字类型。这样可以减少磁盘空间并且提高访问速度。 几乎所有字段类型都支持DocValue,除了text和annotated_text字段。 何为正排索引 正排索引其实就是类似于数据库表,通过id和数据进行关联,通过搜索文档id,来获取对应的数据 doc_values可选值 true:默认值,默认开启 false:需手动指定,设置为false后,sort、aggregate、access the field from script将会无法使用,但会节省磁盘空间 真题演练 // 创建一个索引,test03,字段满足以下条件 // 1. speaker: keyword // 2. line_id: keyword and not aggregateable // 3. speech_number: integer PUT test03 { "mappings": { "properties": { "speaker": { "type": "keyword" }, "line_id":{ "type": "keyword", "doc_values": false }, "speech_number":{ "type": "integer" } } } } 四.分词器analyzers ik中文分词器安装 https://github.com/medcl/elasticsearch-analysis-ik 何为倒排索引 ​ 数据索引化的过程 ​ 分词器的分类 官网地址: https://www.elastic.co/guide/en/elasticsearch/reference/8.1/analysis-analyzers.html ​ 五.自定义分词 自定义分词器三段论 1.Character filters 字符过滤 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/analysis-charfilters.html 可配置0个或多个 HTML Strip Character Filter:用途:删除HTML元素,如 <b>,并解 码HTML实体,如&amp Mapping Character Filter:用途:替换指定字符 Pattern Replace Character Filter:用途:基于正则表达式替换指定字符 2.Tokenizer 文本切为分词 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/analysis-tokenizers.html#_word_oriented_tokenizers 只能配置一个 用分词器对文本进行分词 3.Token filters 分词后再过滤 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/analysis-tokenfilters.html 可配置0个或多个 分词后再加工,比如转小写、删除某些特殊的停用词、增加同义词等 真题演练 有一个文档,内容类似 dag & cat, 要求索引这个文档,并且使用match_parase_query, 查询dag & cat 或者 dag and cat,都能够查到 题目分析: 1.何为match_parase_query:match_phrase 会将检索关键词分词。match_phrase的分词结果必须在被检索字段的分词中都包含,而且顺序必须相同,而且默认必须都是连续的。 2.要实现 & 和 and 查询结果要等价,那么就需要自定义分词器来实现了,定制化的需求 3.如何自定义一个分词器:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/analysis-custom-analyzer.html 4.解法1核心使用功能点,Mapping Character Filter 5.解法2核心使用功能点,https://www.elastic.co/guide/en/elasticsearch/reference/8.1/analysis-synonym-tokenfilter.html 解法1 # 新建索引 PUT /test01 { "settings": { "analysis": { "analyzer": { "my_analyzer": { "char_filter": [ "my_mappings_char_filter" ], "tokenizer": "standard", } }, "char_filter": { "my_mappings_char_filter": { "type": "mapping", "mappings": [ "& => and" ] } } } }, "mappings": { "properties": { "content":{ "type": "text", "analyzer": "my_analyzer" } } } } // 说明 // 三段论之Character filters,使用char_filter进行文本替换 // 三段论之Token filters,使用默认分词器 // 三段论之Token filters,未设定 // 字段content 使用自定义分词器my_analyzer # 填充测试数据 PUT test01/_bulk {"index":{"_id":1}} {"content":"doc & cat"} {"index":{"_id":2}} {"content":"doc and cat"} # 执行测试,doc & cat || oc and cat 结果输出都为两条 POST test01/_search { "query": { "bool": { "must": [ { "match_phrase": { "content": "doc & cat" } } ] } } } 解法2 # 解题思路,将& 和 and 设定为同义词,使用Token filters # 创建索引 PUT /test02 { "settings": { "analysis": { "analyzer": { "my_synonym_analyzer": { "tokenizer": "whitespace", "filter": [ "my_synonym" ] } }, "filter": { "my_synonym": { "type": "synonym", "lenient": true, "synonyms": [ "& => and" ] } } } }, "mappings": { "properties": { "content": { "type": "text", "analyzer": "my_synonym_analyzer" } } } } // 说明 // 三段论之Character filters,未设定 // 三段论之Token filters,使用whitespace空格分词器,为什么不用默认分词器?因为默认分词器会把&分词后剔除了,就无法在去做分词后的过滤操作了 // 三段论之Token filters,使用synony分词后过滤器,对&和and做同义词 // 字段content 使用自定义分词器my_synonym_analyzer # 填充测试数据 PUT test02/_bulk {"index":{"_id":1}} {"content":"doc & cat"} {"index":{"_id":2}} {"content":"doc and cat"} # 执行测试 POST test02/_search { "query": { "bool": { "must": [ { "match_phrase": { "content": "doc & cat" } } ] } } } 六.multi-fields 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/multi-fields.html // 单字段多类型,比如一个字段我想设置两种分词器 PUT my-index-000001 { "mappings": { "properties": { "city": { "type": "text", "analyzer":"standard", "fields": { "fieldText": { "type": "text", "analyzer":"ik_smart", } } } } } } 七.runtime_field 运行时字段 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/runtime.html 产生背景 假如业务中需要根据某两个数字类型字段的差值来排序,也就是我需要一个不存在的字段, 那么此时应该怎么办? 当然你可以刷数,新增一个差值结果字段来实现,假如此时不允许你刷数新增字段怎么办? 解决方案 ​ 应用场景 在不重新建立索引的情况下,向现有文档新增字段 在不了解数据结构的情况下处理数据 在查询时覆盖从原索引字段返回的值 为特定用途定义字段而不修改底层架构 功能特性 Lucene完全无感知,因没有被索引化,没有doc_values 不支持评分,因为没有倒排索引 打破传统先定义后使用的方式 能阻止mapping爆炸 增加了API的灵活性 注意,会使得搜索变慢 实际使用 运行时检索指定,即检索环节可使用(也就是哪怕mapping中没有这个字段,我也可以查询) 动态或静态mapping指定,即mapping环节可使用(也就是在mapping中添加一个运行时的字段) 真题演练1 # 假定有以下索引和数据 PUT test03 { "mappings": { "properties": { "emotion": { "type": "integer" } } } } POST test03/_bulk {"index":{"_id":1}} {"emotion":2} {"index":{"_id":2}} {"emotion":5} {"index":{"_id":3}} {"emotion":10} {"index":{"_id":4}} {"emotion":3} # 要求:emotion > 5, 返回emotion_falg = '1', # 要求:emotion < 5, 返回emotion_falg = '-1', # 要求:emotion = 5, 返回emotion_falg = '0', 解法1 检索时指定运行时字段: https://www.elastic.co/guide/en/elasticsearch/reference/8.1/runtime-search-request.html 该字段本质上是不存在的,所以需要检索时要加上 fields * GET test03/_search { "fields": [ "*" ], "runtime_mappings": { "emotion_falg": { "type": "keyword", "script": { "source": """ if(doc['emotion'].value>5)emit('1'); if(doc['emotion'].value<5)emit('-1'); if(doc['emotion'].value==5)emit('0'); """ } } } } 解法2 创建索引时指定运行时字段:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/runtime-mapping-fields.html 该方式支持通过运行时字段做检索 # 创建索引并指定运行时字段 PUT test03_01 { "mappings": { "runtime": { "emotion_falg": { "type": "keyword", "script": { "source": """ if(doc['emotion'].value>5)emit('1'); if(doc['emotion'].value<5)emit('-1'); if(doc['emotion'].value==5)emit('0'); """ } } }, "properties": { "emotion": { "type": "integer" } } } } # 导入测试数据 POST test03_01/_bulk {"index":{"_id":1}} {"emotion":2} {"index":{"_id":2}} {"emotion":5} {"index":{"_id":3}} {"emotion":10} {"index":{"_id":4}} {"emotion":3} # 查询测试 GET test03_01/_search { "fields": [ "*" ] } 真题演练2 # 有以下索引和数据 PUT test04 { "mappings": { "properties": { "A":{ "type": "long" }, "B":{ "type": "long" } } } } PUT task04/_bulk {"index":{"_id":1}} {"A":100,"B":2} {"index":{"_id":2}} {"A":120,"B":2} {"index":{"_id":3}} {"A":120,"B":25} {"index":{"_id":4}} {"A":21,"B":25} # 需求:在task04索引里,创建一个runtime字段,其值是A-B,名称为A_B; 创建一个range聚合,分为三级:小于0,0-100,100以上;返回文档数 // 使用知识点: // 1.检索时指定运行时字段: https://www.elastic.co/guide/en/elasticsearch/reference/8.1/runtime-search-request.html // 2.范围聚合 https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-aggregations-bucket-range-aggregation.html 解法 # 结果测试 GET task04/_search { "fields": [ "*" ], "size": 0, "runtime_mappings": { "A_B": { "type": "long", "script": { "source": """ emit(doc['A'].value - doc['B'].value); """ } } }, "aggs": { "price_ranges_A_B": { "range": { "field": "A_B", "ranges": [ { "to": 0 }, { "from": 0, "to": 100 }, { "from": 100 } ] } } } } 八.Search-highlighted highlighted语法初识 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/highlighting.html ​ 九.Search-Order Order语法初识 官网文档地址: https://www.elastic.co/guide/en/elasticsearch/reference/8.1/sort-search-results.html // 注意:text类型默认是不能排或聚合的,如果非要排序或聚合,需要开启fielddata GET /kibana_sample_data_ecommerce/_search { "query": { "match": { "customer_last_name": "wood" } }, "highlight": { "number_of_fragments": 3, "fragment_size": 150, "fields": { "customer_last_name": { "pre_tags": [ "<em>" ], "post_tags": [ "</em>" ] } } }, "sort": [ { "currency": { "order": "desc" }, "_score": { "order": "asc" } } ] } 十.Search-Page page语法初识 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/paginate-search-results.html # 注意 from的起始值是 0 不是 1 GET kibana_sample_data_ecommerce/_search { "from": 5, "size": 20, "query": { "match": { "customer_last_name": "wood" } } } 真题演练1 # 题目 In the spoken lines of the play, highlight the word Hamlet (int the text_entry field) startint the highlihnt with "#aaa#" and ending it with "#bbb#" return all of speech_number field lines in reverse order; '20' speech lines per page,starting from line '40' # highlight 处理 text_entry 字段 ; 关键词 Hamlet 高亮 # page分页:from:40;size:20 # speech_number:倒序 POST test09/_search { "from": 40, "size": 20, "query": { "bool": { "must": [ { "match": { "text_entry": "Hamlet" } } ] } }, "highlight": { "fields": { "text_entry": { "pre_tags": [ "#aaa#" ], "post_tags": [ "#bbb#" ] } } }, "sort": [ { "speech_number.keyword": { "order": "desc" } } ] } 十一.Search-AsyncSearch 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/async-search.html 发行版本 7.7.0 适用场景 允许用户在异步搜索结果时可以检索,从而消除了仅在查询完成后才等待最终响应的情况 常用命令 执行异步检索 POST /sales*/_async_search?size=0 查看异步检索 GET /_async_search/id值 查看异步检索状态 GET /_async_search/id值 删除、终止异步检索 DELETE /_async_search/id值 异步查询结果说明 返回值 含义 id 异步检索返回的唯一标识符 is_partial 当查询不再运行时,指示再所有分片上搜索是成功还是失败。在执行查询时,is_partial=true is_running 搜索是否仍然再执行 total 将在多少分片上执行搜索 successful 有多少分片已经成功完成搜索 十二.Aliases索引别名 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/aliases.html Aliases的作用 在ES中,索引别名(index aliases)就像一个快捷方式或软连接,可以指向一个或多个索引。别名带给我们极大的灵活性,我们可以使用索引别名实现以下功能: 在一个运行中的ES集群中无缝的切换一个索引到另一个索引上(无需停机) 分组多个索引,比如按月创建的索引,我们可以通过别名构造出一个最近3个月的索引 查询一个索引里面的部分数据构成一个类似数据库的视图(views 假设没有别名,如何处理多索引的检索 方式1:POST index_01,index_02.index_03/_search 方式2:POST index*/search 创建别名的三种方式 创建索引的同时指定别名 # 指定test05的别名为 test05_aliases PUT test05 { "mappings": { "properties": { "name":{ "type": "keyword" } } }, "aliases": { "test05_aliases": {} } } 使用索引模板的方式指定别名 PUT _index_template/template_1 { "index_patterns": ["te*", "bar*"], "template": { "settings": { "number_of_shards": 1 }, "mappings": { "_source": { "enabled": true }, "properties": { "host_name": { "type": "keyword" }, "created_at": { "type": "date", "format": "EEE MMM dd HH:mm:ss Z yyyy" } } }, "aliases": { "mydata": { } } }, "priority": 500, "composed_of": ["component_template1", "runtime_component_template"], "version": 3, "_meta": { "description": "my custom" } } 对已有的索引创建别名 POST _aliases { "actions": [ { "add": { "index": "logs-nginx.access-prod", "alias": "logs" } } ] } 删除别名 POST _aliases { "actions": [ { "remove": { "index": "logs-nginx.access-prod", "alias": "logs" } } ] } 真题演练1 # Define an index alias for 'accounts-row' called 'accounts-male': Apply a filter to only show the male account owners # 为'accounts-row'定义一个索引别名,称为'accounts-male':应用一个过滤器,只显示男性账户所有者 POST _aliases { "actions": [ { "add": { "index": "accounts-row", "alias": "accounts-male", "filter": { "bool": { "filter": [ { "term": { "gender.keyword": "male" } } ] } } } } ] } 十三.Search-template 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-template.html 功能特点 模板接受在运行时指定参数。搜索模板存储在服务器端,可以在不更改客户端代码的情况下进行修改。 初识search-template # 创建检索模板 PUT _scripts/my-search-template { "script": { "lang": "mustache", "source": { "query": { "match": { "{{query_key}}": "{{query_value}}" } }, "from": "{{from}}", "size": "{{size}}" } } } # 使用检索模板查询 GET my-index/_search/template { "id": "my-search-template", "params": { "query_key": "your filed", "query_value": "your filed value", "from": 0, "size": 10 } } 索引模板的操作 创建索引模板 PUT _scripts/my-search-template { "script": { "lang": "mustache", "source": { "query": { "match": { "message": "{{query_string}}" } }, "from": "{{from}}", "size": "{{size}}" }, "params": { "query_string": "My query string" } } } 验证索引模板 POST _render/template { "id": "my-search-template", "params": { "query_string": "hello world", "from": 20, "size": 10 } } 执行检索模板 GET my-index/_search/template { "id": "my-search-template", "params": { "query_string": "hello world", "from": 0, "size": 10 } } 获取全部检索模板 GET _cluster/state/metadata?pretty&filter_path=metadata.stored_scripts 删除检索模板 DELETE _scripts/my-search-templateath=metadata.stored_scripts 十四.Search-dsl 简单检索 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/query-dsl.html 检索选型 ​ 检索分类 ​ 自定义评分 如何自定义评分 ​ 1.index Boost索引层面修改相关性 // 一批数据里,有不同的标签,数据结构一致,不同的标签存储到不同的索引(A、B、C),最后要严格按照标签来分类展示的话,用什么查询比较好? // 要求:先展示A类,然后B类,然后C类 # 测试数据如下 put /index_a_123/_doc/1 { "title":"this is index_a..." } put /index_b_123/_doc/1 { "title":"this is index_b..." } put /index_c_123/_doc/1 { "title":"this is index_c..." } # 普通不指定的查询方式,该查询方式下,返回的三条结果数据评分是相同的 POST index_*_123/_search { "query": { "bool": { "must": [ { "match": { "title": "this" } } ] } } } 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-search.html indices_boost # 也就是索引层面提升权重 POST index_*_123/_search { "indices_boost": [ { "index_a_123": 10 }, { "index_b_123": 5 }, { "index_c_123": 1 } ], "query": { "bool": { "must": [ { "match": { "title": "this" } } ] } } } 2.boosting 修改文档相关性 某索引index_a有多个字段, 要求实现如下的查询: 1)针对字段title,满足'ssas'或者'sasa’。 2)针对字段tags(数组字段),如果tags字段包含'pingpang', 则提升评分。 要求:写出实现的DSL? # 测试数据如下 put index_a/_bulk {"index":{"_id":1}} {"title":"ssas","tags":"basketball"} {"index":{"_id":2}} {"title":"sasa","tags":"pingpang; football"} # 解法1 POST index_a/_search { "query": { "bool": { "must": [ { "bool": { "should": [ { "match": { "title": "ssas" } }, { "match": { "title": "sasa" } } ] } } ], "should": [ { "match": { "tags": { "query": "pingpang", "boost": 1 } } } ] } } } # 解法2 // https://www.elastic.co/guide/en/elasticsearch/reference/8.1/query-dsl-function-score-query.html POST index_a/_search { "query": { "bool": { "should": [ { "function_score": { "query": { "match": { "tags": { "query": "pingpang" } } }, "boost": 1 } } ], "must": [ { "bool": { "should": [ { "match": { "title": "ssas" } }, { "match": { "title": "sasa" } } ] } } ] } } } 3.negative_boost降低相关性 对于某些结果不满意,但又不想通过 must_not 排除掉,可以考虑可以考虑boosting query的negative_boost。 即:降低评分 negative_boost (Required, float) Floating point number between 0 and 1.0 used to decrease the relevance scores of documents matching the negative query. 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/query-dsl-boosting-query.html POST index_a/_search { "query": { "boosting": { "positive": { "term": { "tags": "football" } }, "negative": { "term": { "tags": "pingpang" } }, "negative_boost": 0.5 } } } 4.function_score 自定义评分 如何同时根据 销量和浏览人数进行相关度提升? 问题描述:针对商品,例如有想要有一个提升相关度的计算,同时针对销量和浏览人数? 例如oldScore*(销量+浏览人数) ************************** 商品 销量 浏览人数 A 10 10 B 20 20 C 30 30 ************************** # 示例数据如下 put goods_index/_bulk {"index":{"_id":1}} {"name":"A","sales_count":10,"view_count":10} {"index":{"_id":2}} {"name":"B","sales_count":20,"view_count":20} {"index":{"_id":3}} {"name":"C","sales_count":30,"view_count":30} 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/query-dsl-function-score-query.html 知识点:script_score POST goods_index/_search { "query": { "function_score": { "query": { "match_all": {} }, "script_score": { "script": { "source": "_score * (doc['sales_count'].value+doc['view_count'].value)" } } } } } 十五.Search-del Bool复杂检索 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/query-dsl-bool-query.html 基本语法 ​ 真题演练 写一个查询,要求某个关键字再文档的四个字段中至少包含两个以上 功能点:bool 查询,should / minimum_should_match 1.检索的bool查询 2.细节点 minimum_should_match 注意:minimum_should_match 当有其他子句的时候,默认值为0,当没有其他子句的时候默认值为1 POST test_index/_search { "query": { "bool": { "should": [ { "match": { "filed1": "kr" } }, { "match": { "filed2": "kr" } }, { "match": { "filed3": "kr" } }, { "match": { "filed4": "kr" } } ], "minimum_should_match": 2 } } } 十六.Search-Aggregations 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-aggregations.html 聚合分类 ​ ​ 分桶聚合(bucket) terms 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-aggregations-bucket-terms-aggregation.html # 按照作者统计文档数 POST bilili_elasticsearch/_search { "size": 0, "aggs": { "agg_user": { "terms": { "field": "user", "size": 1 } } } } date_histogram 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-aggregations-bucket-datehistogram-aggregation.html # 按照up_time 按月进行统计 POST bilili_elasticsearch/_search { "size": 0, "aggs": { "agg_up_time": { "date_histogram": { "field": "up_time", "calendar_interval": "month" } } } } 指标聚合 (metrics) Max 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-aggregations-metrics-max-aggregation.html # 获取up_time最大的 POST bilili_elasticsearch/_search { "size": 0, "aggs": { "agg_max_up_time": { "max": { "field": "up_time" } } } } Top_hits 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-aggregations-metrics-top-hits-aggregation.html # 根据user聚合只取一个聚合结果,并且获取命中数据的详情前3条,并按照指定字段排序 POST bilili_elasticsearch/_search { "size": 0, "aggs": { "terms_agg_user": { "terms": { "field": "user", "size": 1 }, "aggs": { "top_user_hits": { "top_hits": { "_source": { "includes": [ "video_time", "title", "see", "user", "up_time" ] }, "sort": [ { "see":{ "order": "desc" } } ], "size": 3 } } } } } } // 返回结果如下 { "took" : 91, "timed_out" : false, "_shards" : { "total" : 1, "successful" : 1, "skipped" : 0, "failed" : 0 }, "hits" : { "total" : { "value" : 1000, "relation" : "eq" }, "max_score" : null, "hits" : [ ] }, "aggregations" : { "terms_agg_user" : { "doc_count_error_upper_bound" : 0, "sum_other_doc_count" : 975, "buckets" : [ { "key" : "Elastic搜索", "doc_count" : 25, "top_user_hits" : { "hits" : { "total" : { "value" : 25, "relation" : "eq" }, "max_score" : null, "hits" : [ { "_index" : "bilili_elasticsearch", "_id" : "5ccCVoQBUyqsIDX6wIcm", "_score" : null, "_source" : { "video_time" : "03:45", "see" : "92", "up_time" : "2021-03-19", "title" : "Elastic 社区大会2021: 用加 Gatling 进行Elasticsearch的负载测试,寓教于乐。", "user" : "Elastic搜索" }, "sort" : [ "92" ] }, { "_index" : "bilili_elasticsearch", "_id" : "8scCVoQBUyqsIDX6wIgn", "_score" : null, "_source" : { "video_time" : "10:18", "see" : "79", "up_time" : "2020-10-20", "title" : "为Elasticsearch启动htpps访问", "user" : "Elastic搜索" }, "sort" : [ "79" ] }, { "_index" : "bilili_elasticsearch", "_id" : "7scCVoQBUyqsIDX6wIcm", "_score" : null, "_source" : { "video_time" : "04:41", "see" : "71", "up_time" : "2021-03-19", "title" : "Elastic 社区大会2021: Elasticsearch作为一个地理空间的数据库", "user" : "Elastic搜索" }, "sort" : [ "71" ] } ] } } } ] } } } 子聚合 (Pipeline) Pipeline:基于聚合的聚合 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-aggregations-pipeline.html bucket_selector 官网文档地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-aggregations-pipeline-bucket-selector-aggregation.html # 根据order_date按月分组,并且求销售总额大于1000 POST kibana_sample_data_ecommerce/_search { "size": 0, "aggs": { "date_his_aggs": { "date_histogram": { "field": "order_date", "calendar_interval": "month" }, "aggs": { "sum_aggs": { "sum": { "field": "total_unique_products" } }, "sales_bucket_filter": { "bucket_selector": { "buckets_path": { "totalSales": "sum_aggs" }, "script": "params.totalSales > 1000" } } } } } } 真题演练 earthquakes索引中包含了过去30个月的地震信息,请通过一句查询,获取以下信息 l 过去30个月,每个月的平均 mag l 过去30个月里,平均mag最高的一个月及其平均mag l 搜索不能返回任何文档 max_bucket 官网地址:https://www.elastic.co/guide/en/elasticsearch/reference/8.1/search-aggregations-pipeline-max-bucket-aggregation.html POST earthquakes/_search { "size": 0, "query": { "range": { "time": { "gte": "now-30M/d", "lte": "now" } } }, "aggs": { "agg_time_his": { "date_histogram": { "field": "time", "calendar_interval": "month" }, "aggs": { "avg_aggs": { "avg": { "field": "mag" } } } }, "max_mag_sales": { "max_bucket": { "buckets_path": "agg_time_his>avg_aggs" } } } }

优秀的个人博客,低调大师

自定义 WorkManager —— 基础概念

WorkManager是一个Android Jetpack扩展库,它可以让您轻松规划那些可延后、异步但又需要可靠运行的任务。对于绝大部分后台执行任务来说,使用 WorkManager 是目前 Android 平台上的最佳实践。 目前为止本系列已经讨论过: Android Jetpack WorkManager | Android 中文教学视频 WorkManager 在Kotlin 中的实践 WorkManager: 周期性任务 在本篇文章中,我们将会讨论自定义配置相关的内容,包括: 为什么可能会需要自定义配置 如何声明自定义配置 WorkerFactory 以及自定义 WorkerFactory 的原因 DelegatingWorkerFactory 详解 本系列的下一篇文章将对依赖注入和 Dagger 展开讨论,请持续关注我们。 使用 WorkManager 时,您需要自己定义Worker/CoroutineWorker或任何ListenableWorker的派生类。WorkManager 会在正确的时间点实例化您的 Worker,其时机独立于您应用的运行,不受其运行状态的影响。为了可以初始化您的 Worker,WorkManager 会使用一个WorkerFactory。 默认 WorkerFactory 所创建的 Worker 只包含两个参数: Application 的 Context WorkerParameters 如果您需要通过 Worker 的构造函数传入更多参数,则需要一个自定义的 WorkerFactory。 延伸阅读 : 我们讲过默认的 WorkerFactory 使用反射来实例化正确的 ListenableWorker 类,但当我们的 Worker 类的类名被 R8 (或 ProGuard) 最小化之后,这个操作就会失败。为了避免这种情况,WorkManager 包含了一个proguard-rules.pro文件来避免您的 Worker 类的类名被混淆。 自定义配置和 WorkerFactory WorkManager 类遵循 单例模式,而且它只能在实例化之前进行配置。这意味着,如果您想自定义它的配置,就必须先禁用默认配置。 如果您尝试通过 initialize() 方法再次初始化 WorkManager,该方法就会抛出一个异常 (于 1.0.0 版本中加入)。为了避免异常,您需要禁用默认的初始化。您可以稍后在您的 Application 的 onCreate 方法中配置和初始化您的 WorkManager。 2.1.0 版本 中加入了一个更好的初始化 WorkManager 的方式。您可以通过在您的 Application 类中实现 WorkManager 的Configuration.Provider接口的方式来使用按需初始化。接下来,您只需要使用getInstance(context)获得实例,WorkManager 就会通过您的配置初始化它自己。 可配置参数 如上所讲,您可以配置用来创建 Worker 的 WorkerFactory,但是您也可以自定义其他的参数。WorkManager 的Configuration.Builder参考指南中包含了参数的完整列表。这里我想强调两个附加参数: Logging 级别 JobId 范围 当我们有需要时,可以通过修改日志级别方便地理解 WorkManager 中正在发生什么。关于这个话题,我们有一个 专门的文档页。您也可以查看Advanced WorkManager codelab 实战教程,以了解此功能在真实示例中的实现,以及您可以通过此功能获取到什么样的信息。 如果以在我们的应用中使用 JobScheduler API 一样的方式使用 WorkManager,我们可能也会想要自定义 JobId 范围。因为在这种情况下,您会想要避免在同一个地方使用相同的 JobId 范围。版本 2.4.0 中也加入了一个新的Lint 规则 来覆盖这种情况。 WorkManager 的 WorkerFactory 我们已经知道,WorkManager 有一个默认的 WorkerFactory,它可以根据我们经由 WorkRequest 传入的 Worker 类的类名,通过反射来找到应该实例化的 Worker 类。 ⚠️ 如果您在创建了一个 WorkRequest 后重构了应用,并为您的 Worker 类起了另一个名字,WorkManager 就会因为无法找到正确的类而抛出一个 ClassNotFoundException。 您可能会想要为您的 Worker 的构造函数添加其他参数。假设您有一个 Worker 需要引用一个 Retrofit 服务来跟远程服务器进行通讯: /* Copyright 2020 Google LLC. SPDX-License-Identifier: Apache-2.0 */ class UpvoteStoryWorker( appContext: Context, workerParams: WorkerParameters, private val service: UpvoteStoryHttpApi) : CoroutineWorker(appContext, workerParams) { override suspend fun doWork(): Result { return try { // 投票操作 Result.success() } catch (e: Exception) { if (runAttemptCount < MAX_NUMBER_OF_RETRY) { Result.retry() } else { Result.failure() } } } } 如果我们在一个应用上作出上面的修改,程序仍然可被正常编译。但是只要代码被执行、WorkManager 尝试去实例化这个 CoroutineWorker 时,应用就会因为抛出异常而被关闭。异常的描述为无法找到正确的方法来进行实例化: Caused by java.lang.NoSuchMethodException: <init> [class android.content.Context, class androidx.work.WorkerParameters] 这时我们就需要一个自定义的 WorkerFactory。 但是别着急,我们已经看到其中涉及的几个步骤。现在让我们回顾一下我们已经做了的事情,然后深入了解其中每一步的详细信息: 禁用默认初始化 实现一个自定义 WorkerFactory 创建自定义配置 初始化 WorkManager 禁用默认初始化 如WorkManager 的文档 中描述,禁用操作要在您的 AndroidManifest.xml 文件中完成。移除默认情况下从 WorkManager 库中自动合并的节点。 <!-- Copyright 2020 Google LLC. SPDX-License-Identifier: Apache-2.0 --> <application … <provider android:name="androidx.work.impl.WorkManagerInitializer" android:authorities="${applicationId}.workmanager-init" tools:node="remove" /> </application> 实现一个自定义 WorkerFactory 为了创建包含正确参数的 Worker,现在需要实现我们自己的工厂 (factory): /* Copyright 2020 Google LLC. SPDX-License-Identifier: Apache-2.0 */ class MyWorkerFactory(private val service: UpvoteStoryHttpApi) : WorkerFactory() { override fun createWorker( appContext: Context, workerClassName: String, workerParameters: WorkerParameters ): ListenableWorker? { // 这里只能处理一个 Worker,请不要这样做! // 参考下文来更好地使用 DelegatingWorkerFactory return UpvoteStoryWorker(appContext, workerParameters, DesignerNewsService) } } 创建一个自定义 WorkerConfiguration** 接下来,我们必须将我们的工厂注册到我们的 WorkManager 的自定义配置中: /* Copyright 2020 Google LLC. SPDX-License-Identifier: Apache-2.0 */ class MyApplication : Application(), Configuration.Provider { override fun getWorkManagerConfiguration(): Configuration = Configuration.Builder() .setMinimumLoggingLevel(android.util.Log.DEBUG) .setWorkerFactory(MyWorkerFactory(DesignerNewsService)) .build() ... } 初始化 WorkManager 当您的应用中只有一个 Worker 类时,以上便是您所需要做的所有事情。而如果您有多个或者预计未来会有多个 Worker 类,更好的解决方案是使用在 2.1 版中加入的DelegatingWorkerFactory。 使用 DelegatingWorkerFactory 我们可以通过使用 DelegatingWorkerFactory 来替代将 WorkManager 配置为直接使用某个工厂的操作。我们可以使用 DelegatingWorkerFactory 的addFactory()方法向其添加我们的工厂,这样一来,您就有了多个工厂,其中每个都可以管理一个或多个 Worker。在 DelegatingWorkerFactory 中注册您的工厂,这将有助于协调多个工厂的执行。 在这种情况下,您的工厂需要检查是否知道如何处理作为参数传入的 workerClassName。如果答案是否定的,就返回 null,而 DelegatingWorkerFactory 便会去寻找下一个注册的工厂。如果没有任何被注册的工厂知道如何处理某个类,那么它将回退到使用反射的默认工厂。 下面是我们的工厂类代码,修改为当它不知道如何处理某个 workerClassName 时,将返回 null: /* Copyright 2020 Google LLC. SPDX-License-Identifier: Apache-2.0 */ class MyWorkerFactory(private val service: DesignerNewsService) : WorkerFactory() { override fun createWorker( appContext: Context, workerClassName: String, workerParameters: WorkerParameters ): ListenableWorker? { return when(workerClassName) { UpvoteStoryWorker::class.java.name -> ConferenceDataWorker(appContext, workerParameters, service) else -> // 返回 null,这样基类就可以代理到默认的 WorkerFactory null } } } 我们的 WorkManager 配置会变成: /* Copyright 2020 Google LLC. SPDX-License-Identifier: Apache-2.0 */ class MyApplication : Application(), Configuration.Provider { override fun getWorkManagerConfiguration(): Configuration { val myWorkerFactory = DelegatingWorkingFactory() myWorkerFactory.addFactory(MyWorkerFactory(service)) // 在这里添加您应用中可能会使用的其他 WorkerFactory return Configuration.Builder() .setMinimumLoggingLevel(android.util.Log.INFO) .setWorkerFactory(myWorkerFactory) .build() } ... } 如果您有多个 Worker 需要不同的参数,您可以创建第二个 WorkerFactory,并通过再次调用 addFactory 来添加它。 总结 WorkManager 是一个功能十分强大的库,它的默认配置已经可以覆盖许多常见的使用场景。然而当您遇到某些情况时,诸如需要增加日志级别或需要传入额外参数到您的 Worker 时,则需要一个自定义的配置。 希望您能通过本文对此主题有一个良好的认识。如果您有任何疑问,可以在评论区中留言。 接下来的文章我们将会讨论如何在自定义 WorkManager 配置时使用 Dagger,感兴趣的读者请继续关注。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册