首页 文章 精选 留言 我的

精选列表

搜索[AI编程],共10000篇文章
优秀的个人博客,低调大师

python之面向对象编程二

类的成员 类的成员可以分为三大类:字段、方法、属性。 字段:普通字段、静态字段。 方法:普通方法、类方法、静态方法 属性:普通属性。 注:所有成员中,只有普通字段的内容保存对象中,即:根据此类创建了多少对象,在内存中就有多少个普通字段。而其他的成员,则都是保存在类中,即:无论对象的多少,在内存中只创建一份。 一、字段 字段包括:普通字段和静态字段,他们在定义和使用中有所区别,而最本质的区别是内存中保存的位置不同。 普通字段属于对象 静态字段属于类 class Province: # 静态字段 country = '中国' def __init__(self, name): # 普通字段 self.name = name # 直接访问普通字段 obj = Province('吉林省') print obj.name # 直接访问静态字段 Province.country 字段的定义和使用 由上述代码可以看出【普通字段需要通过对象来访问】【静态字段通过类访问】,在使用上可以看出普通字段和静态字段的归属是不同的。其在内容的存储方式类似如下图: 由上图可是: 静态字段在内存中只保存一份 普通字段在每个对象中都要保存一份 应用场景: 通过类创建对象时,如果每个对象都具有相同的字段,那么就使用静态字段 二、方法 方法包括:普通方法、静态方法和类方法,三种方法在内存中都归属于类,区别在于调用方式不同。 普通方法:由对象调用;至少一个self参数;执行普通方法时,自动将调用该方法的对象赋值给self; 类方法:由类调用; 至少一个cls参数;执行类方法时,自动将调用该方法的类复制给cls; 静态方法:由类调用;无默认参数; 1.静态方法 通过@staticmethod装饰器即可把其装饰的方法变为一个静态方法,什么是静态方法呢?其实不难理解,普通的方法,可以在实例化后直接调用,并且在方法里可以通过self.调用实例变量或类变量,但静态方法是不可以访问实例变量或类变量的,一个不能访问实例变量和类变量的方法,其实相当于跟类本身已经没什么关系了,它与类唯一的关联就是需要通过类名来调用这个方法。 class people(object): def __init__(self,name): self.name = name @staticmethod #把eat方法变为静态方法 def eat(self): print("%s is eating" % self.name) d = people("tom") d.eat() 上面的调用会出以下错误,说是eat需要一个self参数,但调用时却没有传递,没错,当eat变成静态方法后,再通过实例调用时就不会自动把实例本身当作一个参数传给self了。 Traceback (most recent call last): File "D:/pycharm/project/day6/静态方法.py", line 13, in <module> d.eat() TypeError: eat() missing 1 required positional argument: 'self' 想让上面的代码可以正常工作有两种办法 1. 调用时主动传递实例本身给eat方法,即d.eat(d) 2. 在eat方法中去掉self参数,但这也意味着,在eat中不能通过self.调用实例中的其它变量了 class people(object): def __init__(self, name): self.name = name @staticmethod # 把eat方法变为静态方法 def eat(): print("is eating" ) p = people("tom") p.eat() 2.类方法 类方法通过@classmethod装饰器实现,类方法和普通方法的区别是, 类方法只能访问类变量,不能访问实例变量 class people(object): def __init__(self, name): self.name = name @classmethod # 类方法 def eat(self): print("%s is eating"%self.name ) p = people("tom") p.eat() 执行报错如下,说people没有name属性,因为name是个实例变量,类方法是不能访问实例变量的 Traceback (most recent call last): File "D:/pycharm/project/day6/静态方法.py", line 12, in <module> p.eat() File "D:/pycharm/project/day6/静态方法.py", line 9, in eat print("%s is eating"%self.name ) AttributeError: type object 'people' has no attribute 'name' 此时可以定义一个类变量,也叫name,看下执行效果 class people(object): name = '我是类变量' def __init__(self, name): self.name = name @classmethod # 类方法 def eat(self): print("%s is eating"%self.name ) p = people("tom") p.eat() #执行结果 我是类变量 is eating 三、属性 通过上述Python类中的方法,Python中的属性是普通方法的变行。 对于属性,有以下三个知识点: 属性的基本使用 属性的两种定义方式 1.属性的基本使用 # ############### 定义 ############### class people: def func(self): print('普通属性...') # 定义属性 @property def prop(self): print('property属性调用..') # ############### 调用 ############### p = people() p.func() p.prop #调用属性 属性的定义及使用 由属性的定义和调用要注意一下几点: 定义时,在普通方法的基础上添加@property装饰器; 定义时,属性仅有一个self参数 调用时,无需括号 方法:p.func() 属性:p.prop 注意:属性存在意义是:访问属性时可以制造出和访问字段完全相同的假象 属性由方法变种而来,如果Python中没有属性,方法完全可以代替其功能 2、属性的两种定义方式 属性的定义有两种方式: 装饰器 即:在方法上应用装饰器 静态字段 即:在类中定义值为property对象的静态字段 装饰器方式:在类的普通方法上应用@property装饰器 经典类,具有一种@property装饰器 # ############### 定义 ############### class people: # 定义属性 @property def prop(self): return 'tom' # ############### 调用 ############### p = people() result = p.prop # 自动执行 @property 修饰的 price 方法,并获取方法的返回值 print(result) View Code 新式类,具有三种@property装饰器 class product(object): @property def price(self): print( '@property') @price.setter def price(self, value): print( '@price.setter') @price.deleter def price(self): print ('@price.deleter') # ############### 调用 ############### obj = product() obj.price # 自动执行 @property 修饰的 price 方法,并获取方法的返回值 obj.price = 123 # 自动执行 @price.setter 修饰的 price 方法,并将 123 赋值给方法的参数 del obj.price # 自动执行 @price.deleter 修饰的 price 方法 View Code 注:经典类中的属性只有一种访问方式,其对应被 @property 修饰的方法 新式类中的属性有三种访问方式,并分别对应了三个被@property、@方法名.setter、@方法名.deleter修饰的方法 由于新式类中具有三种访问方式,我们可以根据他们几个属性的访问特点,分别将三个方法定义为对同一个属性:获取、修改、删除 class product(object): def __init__(self): # 原价 self.original_price = 100 # 折扣 self.discount = 0.8 @property def price(self): # 实际价格 = 原价 * 折扣 new_price = self.original_price * self.discount return new_price @price.setter def price(self, value): self.original_price = value @price.deleter def price(self, value): del self.original_price obj = product() print(obj.price) # 获取商品价格 obj.price = 200 # 修改商品原价 print(obj.original_price) # del obj.price # 删除商品原价 实例 静态字段方式:创建值为property对象的静态字段 当使用静态字段的方式创建属性时,经典类和新式类没有什么区别 class people: def talk(self): return 'yu' TALK = property(talk) obj = people() reuslt = obj.TALK # 自动调用talk方法,并获取方法的返回值 print( reuslt) View Code property的构造方法中有个四个参数 第一个参数是方法名,调用对象.属性时自动触发执行方法 第二个参数是方法名,调用对象.属性 = XXX时自动触发执行方法 第三个参数是方法名,调用del 对象.属性时自动触发执行方法 第四个参数是字符串,调用对象.属性.__doc__,此参数是该属性的描述信息 class people: def get_bar(self): return 'yu' # *必须两个参数 def set_bar(self, value): return 'set value' + value def del_bar(self): return 'yu' BAR=property(get_bar, set_bar, del_bar, 'description...') obj = people() print(obj.BAR) # 自动调用第一个参数中定义的方法:get_bar obj.BAR = "hehe" # 自动调用第二个参数中定义的方法:set_bar方法,并将“alex”当作参数传入 del people.BAR # 自动调用第三个参数中定义的方法:del_bar方法 obj.BAR.__doc__ # 自动获取第四个参数中设置的值:description... View Code 由于静态字段方式创建属性具有三种访问方式,我们可以根据他们几个属性的访问特点,分别将三个方法定义为对同一个属性:获取、修改、删除 class product(object): def __init__(self): # 原价 self.original_price = 100 # 折扣 self.discount = 0.8 def get_price(self): # 实际价格 = 原价 * 折扣 new_price = self.original_price * self.discount return new_price def set_price(self, value): self.original_price = value def del_price(self, value): del self.original_price PRICE = property(get_price, set_price, del_price, '价格属性描述...') obj = product() obj.PRICE # 获取商品价格 obj.PRICE = 200 # 修改商品原价 del obj.PRICE # 删除商品原价 View Code 所以,定义属性共有两种方式,分别是【装饰器】和【静态字段】,而【装饰器】方式针对经典类和新式类又有所不同。 类成员的修饰符 类的所有成员在上一步骤中已经做了详细的介绍,对于每一个类的成员而言都有两种形式: 公有成员,在任何地方都能访问 私有成员,只有在类的内部才能方法 私有成员和公有成员的定义不同:私有成员命名时,前两个字符是下划线。(特殊成员除外,例如:__init__、__call__、__dict__等) class C: def __init__(self): self.name = '公有字段' self.__foo = "私有字段" 私有成员和公有成员的访问限制不同: 静态字段 公有静态字段:类可以访问;类内部可以访问;派生类中可以访问 私有静态字段:仅类内部可以访问; class C: name = "公有静态字段" def func(self): print C.name class D(C): def show(self): print C.name C.name # 类访问 obj = C() obj.func() # 类内部可以访问 obj_son = D() obj_son.show() # 派生类中可以访问 公有静态字段 class C: __name = "公有静态字段" def func(self): print C.__name class D(C): def show(self): print C.__name C.__name # 类访问 ==> 错误 obj = C() obj.func() # 类内部可以访问 ==> 正确 obj_son = D() obj_son.show() # 派生类中可以访问 ==> 错误 私有静态字段 普通字段 公有普通字段:对象可以访问;类内部可以访问;派生类中可以访问 私有普通字段:仅类内部可以访问; ps:如果想要强制访问私有字段,可以通过 【对象._类名__私有字段明 】访问(如:obj._C__foo),不建议强制访问私有成员。 class C: def __init__(self): self.foo = "公有字段" def func(self): print( self.foo) # 类内部访问 class D(C): def show(self): print( self.foo) #派生类中访问 obj = C() obj.foo # 通过对象访问 obj.func() # 类内部访问 obj_son = D() obj_son.show() # 派生类中访问 公有字段 class C: def __init__(self): self.__foo = "私有字段" def func(self): print(self.foo ) # 类内部访问 class D(C): def show(self): print(self.foo) #派生类中访问 obj = C() #obj.__foo # 通过对象访问 ==> 错误 obj.func() # 类内部访问 ==> 正确 obj_son = D() #obj_son.show() # 派生类中访问 ==> 错误 私有字段 方法、属性的访问于上述方式相似,即:私有成员只能在类内部使用 ps:非要访问私有属性的话,可以通过 对象._类__属性名 类的特殊成员 上文介绍了Python的类成员以及成员修饰符,从而了解到类中有字段、方法和属性三大类成员,并且成员名前如果有两个下划线,则表示该成员是私有成员,私有成员只能由类内部调用。无论人或事物往往都有不按套路出牌的情况,Python的类成员也是如此,存在着一些具有特殊含义的成员,详情如下: 1. __doc__ 表示类的描述信息 class Foo: """ 描述类信息 """ def func(self): pass print Foo.__doc__ #输出:描述类信息 View Code 2.__module__ 和 __class__ __module__ 表示当前操作的对象在那个模块 __class__ 表示当前操作的对象的类是什么 #!/usr/bin/env python # -*- coding:utf-8 -*- class C: def __init__(self): self.name = 'yu' lib/aa.py from lib.aa import C obj = C() print obj.__module__ # 输出 lib.aa,即:输出模块 print obj.__class__ # 输出 lib.aa.C,即:输出类 index.py 3.__init__ 构造方法,通过类创建对象时,自动触发执行。 class Foo: def __init__(self, name): self.name = name self.age = 18 obj = Foo('wupeiqi') # 自动执行类中的 __init__ 方法 View Code 4.__del__ 析构方法,当对象在内存中被释放时,自动触发执行。 注:此方法一般无须定义,因为Python是一门高级语言,程序员在使用时无需关心内存的分配和释放,因为此工作都是交给Python解释器来执行,所以,析构函数的调用是由解释器在进行垃圾回收时自动触发执行的。 class Foo: def __del__(self): pass View Code 5.__call__ 对象后面加括号,触发执行。 注:构造方法的执行是由创建对象触发的,即:对象 = 类名() ;而对于 __call__ 方法的执行是由对象后加括号触发的,即:对象() 或者 类()() class Foo: def __init__(self): pass def __call__(self, *args, **kwargs): print( '__call__') obj = Foo() # 执行 __init__ obj() # 执行 __call__ View Code 6.__dict__ 类或对象中的所有成员 上文中我们知道:类的普通字段属于对象;类中的静态字段和方法等属于类,即: class Province: country = 'China' def __init__(self, name, count): self.name = name self.count = count def func(self, *args, **kwargs): print( 'func') # 获取类的成员,即:静态字段、方法、 print(Province.__dict__) # 输出:{'__doc__': None, '__init__': <function Province.__init__ at 0x0000025AFBF7E1E0>, 'country': 'China', '__dict__': <attribute '__dict__' of 'Province' objects>, '__weakref__': <attribute '__weakref__' of 'Province' objects>, '__module__': '__main__', 'func': <function Province.func at 0x0000025AFBF7E268>} obj1 = Province('HeBei',10000) print(obj1.__dict__) # 获取 对象obj1 的成员 # 输出:{'count': 10000, 'name': 'HeBei'} obj2 = Province('HeNan', 3888) print(obj2.__dict__) # 获取 对象obj1 的成员 # 输出:{'count': 3888, 'name': 'HeNan'} View Code 7.__str__ 如果一个类中定义了__str__方法,那么在打印 对象 时,默认输出该方法的返回值。 class Foo: def __str__(self): return 'yu' obj = Foo() print(obj) # 输出:yu View Code 8、__getitem__、__setitem__、__delitem__ 用于索引操作,如字典。以上分别表示获取、设置、删除数据 #!/usr/bin/env python # -*- coding:utf-8 -*- class Func(object): def __getitem__(self, key): print '__getitem__',key def __setitem__(self, key, value): print '__setitem__',key,value def __delitem__(self, key): print '__delitem__',key obj = Func() result = obj['k1'] # 自动触发执行 __getitem__ obj['k2'] = 'wupeiqi' # 自动触发执行 __setitem__ del obj['k1'] # 自动触发执行 __delitem__ View Code 9、__getslice__、__setslice__、__delslice__ 该三个方法用于分片操作,如:列表 #!/usr/bin/env python # -*- coding:utf-8 -*- class Foo(object): def __getslice__(self, i, j): print '__getslice__',i,j def __setslice__(self, i, j, sequence): print '__setslice__',i,j def __delslice__(self, i, j): print '__delslice__',i,j obj = Foo() obj[-1:1] # 自动触发执行 __getslice__ obj[0:1] = [11,22,33,44] # 自动触发执行 __setslice__ del obj[0:2] # 自动触发执行 __delslice__ View Code 10. __iter__ 用于迭代器,之所以列表、字典、元组可以进行for循环,是因为类型内部定义了 __iter__ class Foo(object): pass obj = Foo() for i in obj: print i # 报错:TypeError: 'Foo' object is not iterable 第一步 #!/usr/bin/env python # -*- coding:utf-8 -*- class Foo(object): def __iter__(self): pass obj = Foo() for i in obj: print i # 报错:TypeError: iter() returned non-iterator of type 'NoneType' 第二步 #!/usr/bin/env python # -*- coding:utf-8 -*- class Foo(object): def __init__(self, sq): self.sq = sq def __iter__(self): return iter(self.sq) obj = Foo([11,22,33,44]) for i in obj: print i 第三步 以上步骤可以看出,for循环迭代的其实是 iter([11,22,33,44]) ,所以执行流程可以变更为: #!/usr/bin/env python # -*- coding:utf-8 -*- obj = iter([11,22,33,44]) for i in obj: print i #!/usr/bin/env python # -*- coding:utf-8 -*- obj = iter([11,22,33,44]) while True: val = obj.next() print val for循环语法内部 上述代码中,obj 是通过 Foo 类实例化的对象,其实,不仅 obj 是一个对象,Foo类本身也是一个对象,因为在Python中一切事物都是对象。 如果按照一切事物都是对象的理论:obj对象是通过执行Foo类的构造方法创建,那么Foo类对象应该也是通过执行某个类的 构造方法 创建。 print type(obj) # 输出:<class '__main__.Foo'> 表示,obj 对象由Foo类创建 print type(Foo) # 输出:<type 'type'> 表示,Foo类对象由 type 类创建 所以,obj对象是Foo类的一个实例,Foo类对象是 type 类的一个实例,即:Foo类对象 是通过type类的构造方法创建。 那么,创建类就可以有两种方式: a). 普通方式 class Foo(object): def func(self): print 'hello World" b).特殊方式(type类的构造函数) def func(self): print 'hello World' Foo = type('Foo',(object,), {'func': func}) #type第一个参数:类名 #type第二个参数:当前类的基类 #type第三个参数:类的成员 ==》 类 是由 type 类实例化产生 那么问题来了,类默认是由 type 类实例化产生,type类中如何实现的创建类?类又是如何创建对象? 答:类中有一个属性__metaclass__,其用来表示该类由 谁 来实例化创建,所以,我们可以为__metaclass__ 设置一个type类的派生类,从而查看 类 创建的过程。
优秀的个人博客,低调大师

Java并发编程LockSupport使用实例

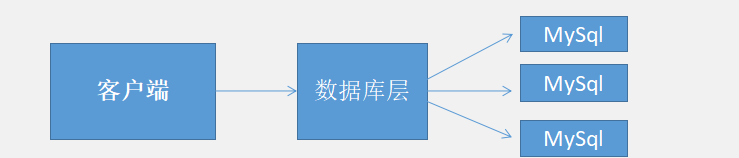
最近负责的项目需要实现一个Web页面监控功能,待监控的数据需要从数据库中统计出来。本身来讲这是一个很简单的功能点,但是考虑到监控端页面会被多人同时访问的业务场景,监控数据又要求每间隔一秒刷新一次,如果每个监控界面都实时去访问数据库,那么数据库的资源开销就太大了,若在白天的业务繁忙期遇到监控端用户数较多时有可能会影响正常的交易办理。为了避免数据库资源过度使用的问题我的设计是在web容器后台构建一块监控数据缓存,无论前台有多少个人访问监控页面,都只是从web容器缓存中获取监控数据,web容器后台有一个值守线程X每间隔一秒访问数据库轮询监控数据至内存中,示意图如下: 屏幕快照 2018-07-27 下午4.50.43.png 仅仅实现以上业务流程其实也非常简单,还用不上LockSupport支持,但是本着对系统资源的最低能耗及高性能需求,我有了更进一步的优雅实现愿景,当没有User监控请求访问容器时后台值守线程可以不干活让其处于阻塞状态,当容器收到User端监控请求时后台值守线程X立即从阻塞状态转变成Running状态,为此我们需要学习运用concurrent包中的LockSupport类来控制多线程间的运行状态切换以实现需求 LockSupport学习 LockSupport是JDK中比较底层的类,用来创建锁和其他同步工具类的基本线程阻塞原语。LockSupport很类似于二元信号量(只有1个许可证可供使用),如果这个许可还没有被占用,当前线程获取许可并继续执行;如果许可已经被占用,当前线程阻塞,等待获取许可。通过网上一些对LockSupport的源码分析可知,其实现是通过调用本地代码(C++)来做的,具有很强的OS平台相关性,因此性能应该是非常高的。对于JVM应用来说主要是通过调用LockSupport.park()和LockSupport.unpark()实现线程的阻塞和唤醒操作的,当然实现线程间的阻塞和唤醒我们还可以用到对象锁,通过Synchronizer关键字来实现对象同步锁,使用对象的wait()和notify()方法来实现,但是此方式的实现在性能上会大打折扣而且有些并发控制不当非常容易引发线程间死锁,可以说非常不优雅。 LockSupport类核心方法 基于Unsafe类中的park和unpark方法 public static void park() { UNSAFE.park(false, 0L); } public static void unpark(Thread thread) { if (thread != null) UNSAFE.unpark(thread); } park()方法,调用native方法阻塞当前线程 unpark()方法,唤醒处于阻塞状态的线程Thrread LockSupport类测试Demo 如下编写一个ThreadPark类来验证park与unpark方法的成对使用 public class ThreadParkTest { public static void main(String[] args) { MyThread mt = new MyThread(); mt.setName("mt"); mt.start(); try { Thread.currentThread().sleep(10); mt.park(); Thread.currentThread().sleep(10000); mt.unPark(); Thread.currentThread().sleep(10000); mt.park(); } catch (InterruptedException e) { e.printStackTrace(); } } static class MyThread extends Thread { private boolean isPark = false; public void run() { System.out.println(" Enter Thread running....."); while (true) { if (isPark) { System.out.println(Thread.currentThread().getName()+"Thread is Park....."); LockSupport.park(); } //do something System.out.println(Thread.currentThread().getName()+">> is running"); try { Thread.currentThread().sleep(1000); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } } } public void park() { isPark = true; } public void unPark() { isPark = false; LockSupport.unpark(this); System.out.println("Thread is unpark....."); } } } 程序运行输出: Enter Thread running..... mt>> is running mt>> is running mt>> is running mt>> is running mt>> is running mtThread is Park..... Thread is unpark..... mt>> is running mt>> is running mt>> is running mt>> is running mt>> is running mt>> is running mt>> is running mt>> is running mt>> is running mt>> is running mtThread is Park park翻译过来即是停车的意思,我们可以这样理解,每个被应用程序启动的线程就是一辆在计算机总线赛道上奔驰着的跑车,当你想让某台车停下来休息会时那么就给它一个park信号,它就会立即停到赛道旁边的停车位中,当你想让它从停车位中驶出并继续在赛道上奔跑时再给它一个unpark信号即可 LockSupport的业务实际应用 我们对技术基础知识的掌握是为了更好,更优雅,更从容的实现业务需求,以最小的程序代价来实现业务最大收益化是计算机软件工程的永恒追求主题之一。 差不多给自己埋好坑了(围笑),不扯淡了,还是show me the code吧。 回到第一章的监控业务需求,首先我们需要编写后台值守线程X类,Daemon线程类Run()方法中除实现从数据库中加载监控数据到内存之外还必须实现具备满足一定条件时调用park()方法线程自动停车,同时对外要提供unpack()方法用于外部唤醒线程。 后台值守线程MonitorWorkThread类代码编写: class MonitorWorkThread extends Thread { //当前线程停车标志 private volatile boolean isPark = false; //工作线程默认一秒钟加载一次,count即为工作监控线程每一次unpack之后会继续工作的时间,此值可根据实际需求配置化 private int maxWorkCount = 300; @Override public void run() { int indexCount=0; logger.info("成功启动审核任务监控工作线程,当前工作线程每次unpack连续工作的时间设定为"+maxWorkCount+"秒"); while(true) { if(indexCount >= maxWorkCount) { logger.info("当前监控工作线程已到达连续工作时间设定上限,现在进入pack休眠状态"); isPark =true; indexCount=0; LockSupport.park(); } //从数据库中加载数据至内存 try { loadDataFromDB(); } catch (Exception e1) { logger.warn("从数据库中加载监控数据至内存发生异常", e1); } try { TimeUnit.SECONDS.sleep(1); } catch (InterruptedException e) { logger.warn("工作线程被异常中断唤醒", e); } indexCount++; } } /** * 假如当前线程正在运行状态,donothing */ public void unPack() { if(isPark) { //唤醒当前监控工作线程,此处有并发唤醒动作需加锁 synchronized (this) { isPark = false; LockSupport.unpark(this); logger.info("当前监控工作线程已被唤醒"); } } } } 接下来我们考虑编写监控业务实现类,大体思路是我们先需要定义内存缓存map用于装载数据库监控数据,业务实现类在容器实例化时自动启动上面的值守线程MonitorWorkThread,对外提供一个获取内存数据的公共方法,公共方法体中需要调用值守线程的unPack()方法以实现当容器收到客户端监控访问请求时若后台异步值守线程处于停车(阻塞)状态时,会被唤醒继续奔跑上路。任务监控业务实现类TaskMonitorServiceImpl编写: /** * * @author lyp * 审核任务监控实现类 */ @Service("TaskMonitorServiceImpl") public class TaskMonitorServiceImpl { private static Logger logger= Logger.getLogger(TaskMonitorServiceImpl.class); //总任务状态缓存表 private List<TaskStatusBean> totalStatus = new ArrayList<TaskStatusBean>(); //审核柜员任务处理缓存表 private Map<String,UserTaskCountDto> userTaskMap = new ConcurrentHashMap<String, UserTaskCountDto>(); //监控工作线程引用 private static MonitorWorkThread workThread=null; @PostConstruct private void initalizal() { //实例化之后执行的初始化动作,用于启动值守监控线程来刷新加载数据 workThread = new MonitorWorkThread(); workThread.setDaemon(true); workThread.setName("AuthTaskMonitor"); workThread.start(); } /** * 此为对外提供方法用于外部根据监控用户号获取内存中缓存的监控数据 * @param userno 监控用户号 * @return map key1:totalStatus key2:userno * @throws Exception */ public Map<String,Object> monitorDataByUser(String userno) throws Exception { if(null == userno || "".equals(userno)) { return null; } Map<String,Object> retMap = new HashMap<String, Object>(); if(null !=workThread) { //每次请求都去看看异步值守线程是否需求唤醒 workThread.unPack(); } retMap.put("totalStatus", totalStatus); if(userTaskMap.containsKey(userno)) { retMap.put(userno, userTaskMap.get(userno)); }else { UserTaskCountDto dto = new UserTaskCountDto(userno); retMap.put(userno, dto); } return retMap; } /** * 从数据库中加载内存数据至内存 */ private void loadDataFromDB () throws Exception { logger.info("开始从数据库中加载任务监控数据..."); //do something about business.... logger.info("从数据库中加载任务监控数据完毕..."); } /** * 清理监控缓存数据map */ public void clearMonitorCache() { this.totalStatus.clear(); this.userTaskMap.clear(); } } 写在最后 技术知识的学习本身就是枯燥无味的,靠解决问题的动力来驱动技术知识的掌握未尝不是一个值得尝试的高效学习方法。以上是我第一次在简书书写文章,选择加入简书的原因其实很简单,一是看美剧的时候被大量广告植入,二是简书的编辑器完美支持MarkDown语言写作。其实这也是我第一次使用MarkDown标记语言写作排版,MarkDown的写作方式对于程序员来说真的是太爽了,啊啊啊。MarkDown语言 Markdown is intended to be as easy-to-read and easy-to-write as is feasible. Readability, however, is emphasized above all else. A Markdown-formatted document should be publishable as-is, as plain text, without looking like it's been marked up with tags or formatting instructions. Markdown's syntax is intended for one purpose: to be used as a format for writing for the web 写作不易,看完本文如果你觉得对你的工作生活有帮助请给个赞赏,不在乎多少,这会给予我写作无限的动力。 最后如果你需要转载此文,请标明原创出处,谢谢。

优秀的个人博客,低调大师

Java编程——Token 认证的来龙去脉

通常情况下,我们在讨论某个技术的时候,都是从问题开始。那么第一个问题: 为什么要用 Token? 而要回答这个问题很简单——因为它能解决问题! 可以解决哪些问题呢? 1. Token 完全由应用管理,所以它可以避开同源策略 2. Token 可以避免CSRF 攻击 3. Token 可以是无状态的,可以在多个服务间共享 Token 是在服务端产生的。如果前端使用用户名/密码向服务端请求认证,服务端认证成功,那么在服务端会返回 Token 给前端。前端可以在每次请求的时候带上 Token 证明自己的合法地位。如果这个 Token 在服务端持久化(比如存入数据库),那它就是一个永久的身份令牌。 于是,又一个问题产生了:需要为 Token 设置有效期吗? 需要设置有效期吗? 对于这个问题,我们不妨先看两个例子。一个例子是登录密码,一般要求定期改变密码,以防止泄漏,所以密码是有有效期的;另一个例子是安全证书。SSL 安全证书都有有效期,目的是为了解决吊销的问题,对于这个问题的详细情况,来看看知乎的回答。所以无论是从安全的角度考虑,还是从吊销的角度考虑,Token 都需要设有效期。 那么有效期多长合适呢? 只能说,根据系统的安全需要,尽可能的短,但也不能短得离谱——想像一下手机的自动熄屏时间,如果设置为 10 秒钟无操作自动熄屏,再次点亮需要输入密码,会不会疯?如果你觉得不会,那就亲自试一试,设置成可以设置的最短时间,坚持一周就好(不排除有人适应这个时间,毕竟手机厂商也是有用户体验研究的)。 然后新问题产生了,如果用户在正常操作的过程中,Token 过期失效了,要求用户重新登录……用户体验岂不是很糟糕? 为了解决在操作过程不能让用户感到 Token 失效这个问题,有一种方案是在服务器端保存 Token 状态,用户每次操作都会自动刷新(推迟) Token 的过期时间——Session 就是采用这种策略来保持用户登录状态的。然而仍然存在这样一个问题,在前后端分离、单页 App 这些情况下,每秒种可能发起很多次请求,每次都去刷新过期时间会产生非常大的代价。如果 Token 的过期时间被持久化到数据库或文件,代价就更大了。所以通常为了提升效率,减少消耗,会把 Token 的过期时保存在缓存或者内存中。 还有另一种方案,使用 Refresh Token,它可以避免频繁的读写操作。这种方案中,服务端不需要刷新 Token 的过期时间,一旦 Token 过期,就反馈给前端,前端使用 Refresh Token 申请一个全新 Token 继续使用。这种方案中,服务端只需要在客户端请求更新 Token 的时候对 Refresh Token 的有效性进行一次检查,大大减少了更新有效期的操作,也就避免了频繁读写。当然 Refresh Token 也是有有效期的,但是这个有效期就可以长一点了,比如,以天为单位的时间。 时序图表示 使用 Token 和 Refresh Token 的时序图如下: 1)登录 2)业务请求 3)Token 过期,刷新 Token 上面的时序图中并未提到 Refresh Token 过期怎么办。不过很显然,Refresh Token 既然已经过期,就该要求用户重新登录了。 当然还可以把这个机制设计得更复杂一些,比如,Refresh Token 每次使用的时候,都更新它的过期时间,直到与它的创建时间相比,已经超过了非常长的一段时间(比如三个月),这等于是在相当长一段时间内允许 Refresh Token 自动续期。 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:468947140 点击链接加入群聊【Java-BATJ企业级资深架构】:https://jq.qq.com/?_wv=1027&k=5zMN6JB 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导 对本文感兴趣,喜欢的,欢迎关注笔者,如有不同意见可留言,多谢!

优秀的个人博客,低调大师

Python函数式编程map()、reduce()

一、map() 格式:map(func, *iterables) map函数接受两个参数,第一个是要执行的函数,第二个是可迭代对象,可迭代对象可以传入多个参数。 map()函数是将func作用于iterables中的每一个元素,并用一个列表给出返回值。如果func为None,作用同zip()。 传入一个可迭对象 def func(x): return x*x lists = [1, 2, 3, 4] l = list(map(func, lists)) print(l) 结果:[1, 4, 9, 16] 传入两个可迭对象 def func(x, y): return x+y lists = [1, 2, 3, 4] lists2 = [1, 2, 3, 4] l = list(map(func, lists, lists2)) print(l) 结果:[2, 4, 6, 8] 二、reduce() 格式:reduce(function, sequence, initial=None) reduce函数接受三个参数,第一个是要执行的函数,第二个是序列,第三个是默认值。第一个函数必须有两个参数。 reduce函数即为化简,它是这样一个过程:每次迭代,将上一次的迭代结果(第一次时为init的元素,如没有init则为seq的第一个元素)与下一个元素一同执行一个二元的func函数。在reduce函数中,init是可选的,如果使用,则作为第一次迭代的第一个元素使用。 例子: 不传入默认值 from functools import reduce lists = ['a', 'b', 'c', 'd'] r = reduce(lambda x, y: x+y, lists) print(r) 结果:abcd 传入默认值 from functools import reduce lists = ['a', 'b', 'c', 'd'] r = reduce(lambda x, y: x+y, lists, '你好') print(r) 结果:你好abcd

优秀的个人博客,低调大师

Java并发编程之原子变量

原子变量最主要的一个特点就是所有的操作都是原子的,synchronized关键字也可以做到对变量的原子操作。只是synchronized的成本相对较高,需要获取锁对象,释放锁对象,如果不能获取到锁,还需要阻塞在阻塞队列上进行等待。而如果单单只是为了解决对变量的原子操作,建议使用原子变量。关于原子变量的介绍,主要涉及以下内容: 原子变量的基本概念 通过AtomicInteger了解原子变量的基本使用 通过AtomicInteger了解原子变量的基本原理 AtomicReference的基本使用 使用FieldUpdater操作非原子变量的字段属性 经典的ABA问题的解决 一、原子变量的基本概念 原子变量保证了该变量的所有操作都是原子的,不会因为多线程的同时访问而导致脏数据的读取问题。我们先看一段synchronized关键字保证变量原子性的代码: 简单的count++操作,线程对象首先需要获取到Counter 类实例的对象锁,然后完成自增操作,最后释放对象锁。整个过程中,无论是获取锁还是释放锁都是相当消耗成本的,一旦不能获取到锁,还需要阻塞当前线程等等。 对于这种情况,我们可以将count变量声明成原子变量,那么对于count的自增操作都可以以原子的方式进行,就不存在脏数据的读取了。Java给我们提供了以下几种原子类型: AtomicInteger和AtomicIntegerArray:基于Integer类型 AtomicBoolean:基于Boolean类型 AtomicLong和AtomicLongArray:基于Long类型 AtomicReference和AtomicReferenceArray:基于引用类型 在本文的余下内容中,我们将主要介绍AtomicInteger和AtomicReference两种类型,AtomicBoolean和AtomicLong的使用和内部实现原理几乎和AtomicInteger一样。 二、AtomicInteger的基本使用 首先看它的两个构造函数: 可以看到,我们在通过构造函数构造AtomicInteger原子变量的时候,如果指定一个int的参数,那么该原子变量的值就会被赋值,否则就是默认的数值0。 也有获取和设置这个value值的方法: 当然,这两个方法并不是原子的,所以一般也很少使用,而以下的这些基于原子操作的方法则相对使用的频繁,至于它们的具体实现是怎样的,我们将在本文的后续小节中进行简单的学习。 下面我们实现一个计数器的例子,之前我们使用synchronized实现过,现在我们使用原子变量再次实现该问题。 很显然,使用原子变量要比使用synchronized要简洁的多并且效率也相对较高。 三、AtomicInteger的内部基本原理 AtomicInteger的实现原理有点像我们的包装类,内部主要操作的是value字段,这个字段保存就是原子变量的数值。value字段定义如下: private volatile int value; 首先value字段被volatile修饰,即不存在内存可见性问题。由于其内部实现原子操作的代码几乎类似,我们主要学习下incrementAndGet方法的实现。 在揭露该方法的实现原理之前,我们先看另一个方法: compareAndSet方法又被称为CAS,该方法调用unsave的一个compareAndSwapInt方法,这个方法是native,我们看不到源码,但是我们需要知道该方法完成的一个目标:比较当前原子变量的值是否等于expect,如果是则将其修改为update并返回true,否则直接返回false。当然,这个操作本身就是原子的,较为底层的实现。 在jdk1.7之前,我们的incrementAndGet方法是这样实现的: 方法体是一个死循环,current获取到当前原子变量中的值,由于value被修饰volatile,所以不存在内存可见性问题,数据一定是最新的。然后current加一后赋值给next,调用我们的CAS原子操作判断value是否被别的线程修改过,如果还是原来的值,那么将next的值赋值给value并返回next,否则重新获取当前value的值,再次进行判断,直到操作完成。 incrementAndGet方法的一个很核心的思想是,在加一之前先去看看value的值是多少,真正加的时候再去看一下,如果发现变了,不操作数据,否则为value加一。 但是在jdk1.8以后,做了一些优化,但是最后还是调用的compareAndSwapInt方法。但基本思想还是没变。 四、AtomicReference的基本使用 对于一些自定义类或者字符串等这些引用类型,Java并发包也提供了原子变量的接口支持。AtomicReference内部使用泛型来实现的。 有关其他的一些原子方法如下: AtomicReference中少了一些自增自减的操作,但是对于value的修改依然是原子的。 五、使用FieldUpdater操作非原子变量的字段属性 FieldUpdater允许我们不必将字段设置为原子变量,利用反射直接以原子方式操作字段。例如: 然后我们创建一百个线程随机调用同一个Counter对象的addCount方法,无论运行多少次,结果都是一百。这种方式实现的原子操作,对于被操作的变量不需要被包装成原子变量,但是却可以直接以原子方式操作它的数值。 六、经典的ABA问题 我们的原子变量都依赖一个核心的方法,那就是CAS。这个方法最核心的思想就是,更改变量值之前先获取该变量当前最新的值,然后在实际更改的时候再次获取该变量的值,如果没有被修改,那么进行更改,否则循环上述操作直至更改操作完成。假如一个线程想要对变量count进行修改,实际操作之前获取count的值为A,此时来了一个线程将count值修改为B,又来一个线程获取count的值为B并将count修改为A,此时第一个线程全然不知道count的值已经被修改两次了,虽然值还是A,但是实际上数据已经是脏的。 这就是典型的ABA问题,一个解决办法是,对count的每次操作都记录下当前的一个时间戳,这样当我们原子操作count之前,不仅查看count的最新数值,还记录下该count的时间戳,在实际操作的时候,只有在count的数值和时间戳都没有被更改的情况之下才完成修改操作。 AtomicStampedReference 的CAS方法要求传入四个参数,该方法的内部会同时比较count和stamp,只有这两个值都没有发生改变的前提下,CAS才会修改count的值。 上述我们介绍了有关原子变量的最基本内容,最后我们比较下原子变量和synchronized关键字的区别。 从思维模式上看,原子变量代表一种乐观的非阻塞式思维,它假定没有别人会和我同时操作某个变量,于是在实际修改变量的值的之前不会锁定该变量,但是修改变量的时候是使用CAS进行的,一旦发现冲突,继续尝试直到成功修改该变量。 而synchronized关键字则是一种悲观的阻塞式思维,它认为所有人都会和我同时来操作某个变量,于是在将要操作该变量之前会加锁来锁定该变量,进而继续操作该变量。 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:744677563 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册