首页 文章 精选 留言 我的

精选列表

搜索[AI编程],共10000篇文章
优秀的个人博客,低调大师

Java并发编程基础-线程简介

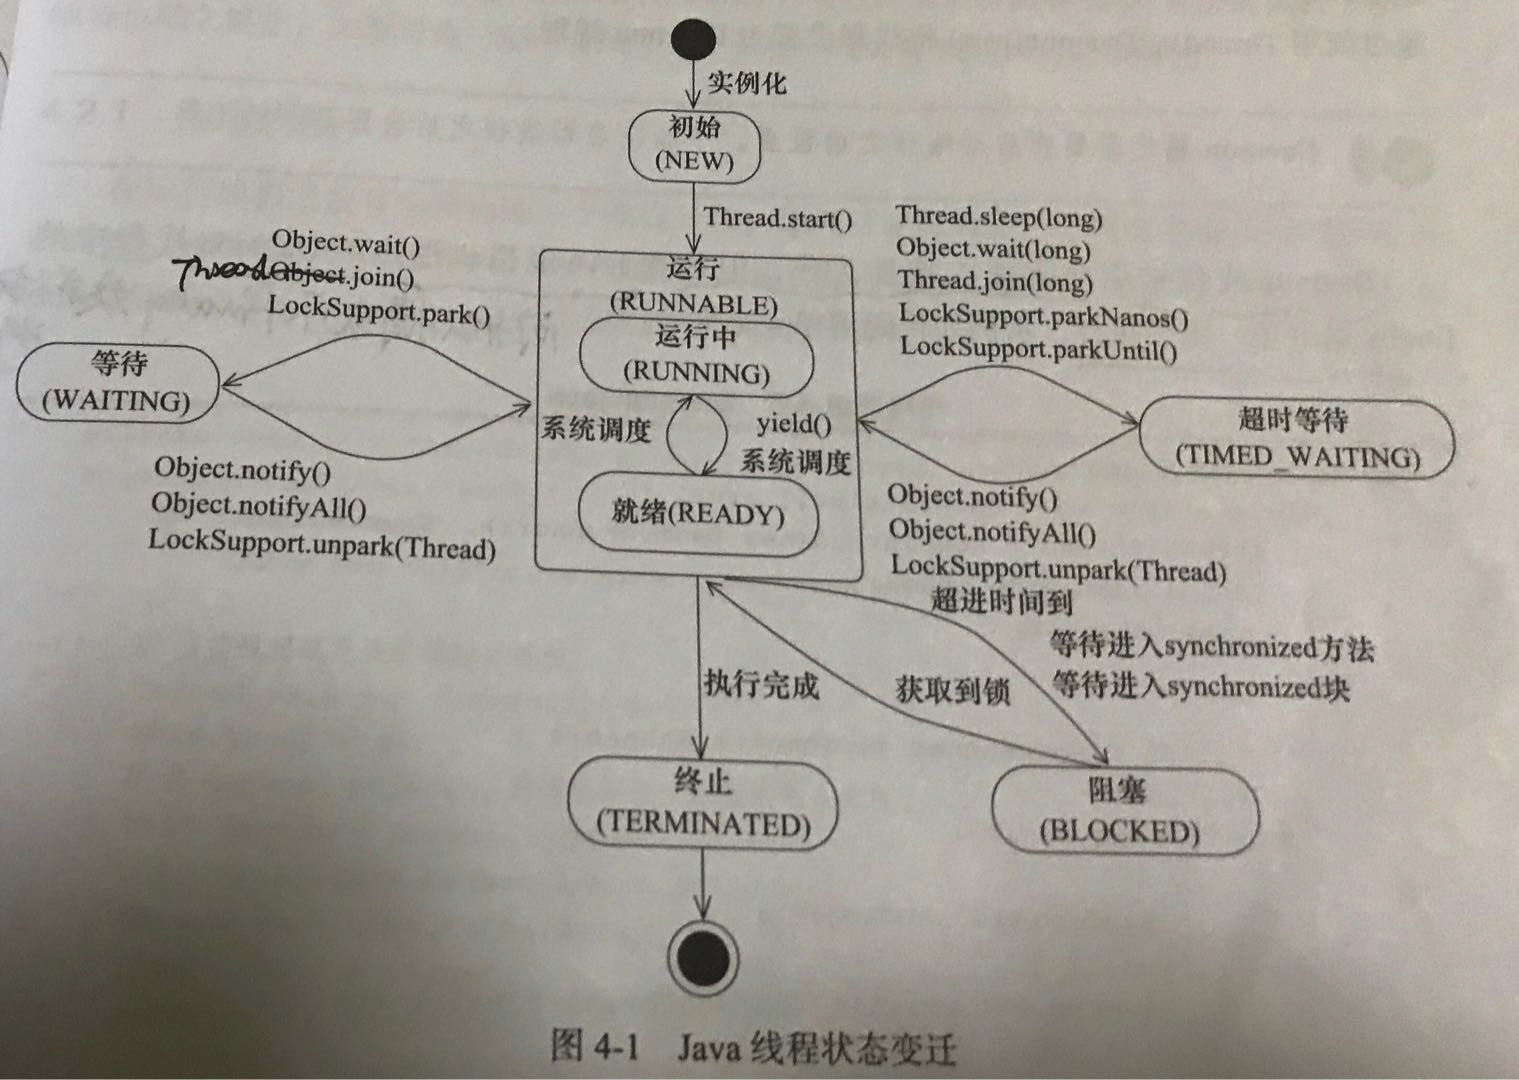
章节目录 1.线程定义 2.使用多线程的优势 3.线程优先级 4.线程的状态 5.Daemon 线程 1.线程定义 进程与线程的区别 1.进程是cpu进行资源分配的独立单位,指的是程序在数据集合上的一次运行过程。 2.线程是cpu 进行调度的最小单位,在一个进程中会创建多个线程。 线程拥有的独立资源 栈中数据是线程独享的,包括局部变量、程序计数器等 堆中数据是线程共享的,如线程同时操作堆中某对象的某属性。 Java程序运行的实质 一个程序的运行不仅仅是main()方法的运行,而是main线程和多个其他线程共同运行 2.使用多线程的优势 1.充分利用更多的处理核心 2.更快的响应时间 例如,一笔订单的创建,它包括插入订单数据,生成订单快照,发送邮件通 知买家和记录货品销售数量等, 用户从单击“订购按钮" 开始,就要等待这些操 作全部完成才能看到订购成功的结果,但是这么多的业务操作,如何才能够跟快的完成? 在上面的场景中,我们可以使用多线程技术,即将数据一致性不强的操作派发 给其他线程处理,好处是响应用户请求的线程能更快的处理完成,缩短了响应时间,提升了用户体验。 3.线程优先级 thread.setPriority(10),线程优先级从1-10顺序排列 4.线程的状态 Java线程在运行的声明周期中可能处于如下表所示的6中状态,在给定的一个时刻,线程只能处于其中一个状态。 状态名称 说明 new 初始状态,线程被构建,但是还没有调用start()方法 runnable 运行状态,Java线程将操作系统中的就绪与运行两种状态统称为"运行中" block 阻塞状态,表示线程等待资源可用,如i/o 或者阻塞于锁 waiting 等待状态,表示线程进入等待状态,进入该状态表示当前线程需要等待其他线程做出一些特定动作(通知或中断) time_waiting 超时等待状态,该状态不同于waiting,它是可以在指定的时间自行返回的 terminated 终止状态,表示当前线程执行完毕 如下图所示,为java线程状态变迁图: java线程状态变迁图 1.线程创建之后,调用start()方法,状态变更为可运行状态,待资源准备就绪后,开始运行。 2.线程执行 lockObject.wait() 方法,线程进入等待状态。 3.进入等待状态的线程依靠其他线程的通知才能返回到运行状态。 4.超时等待相当于在等待状态基础上增加超时限制,超时时间到达会自动返回到运行状态。 5.线程调用同步方法,在没有获取锁的情况下,线程会进入到阻塞状态。 6.线程在执行Runable 的run()方法后,进入终止状态。 Daemon线程 支持性线程,被用作程序中后台调度以及支持性工作。当一个Java虚拟机中不存在非Daemon线程时,JVM将退出。 可以通过调用Thread.setDaemon(true)将线程设置为Daemon线程。 Daemon属性需要在启动线程前执行,不能在启动线程之后启动。 注意:Daemon线程被用作完成支持性工作,但在Java虚拟机退出时,Daemon线程中的finally不一定会执行。 如下代码所示: public class Daemon { static class DaemonRunner implements Runnable { public void run(){ try{ TimeUnit.Second.sleep(10);//沉睡10s }finally{ System.out.println("Daemon thread finally run");//执行类似资源回收动作 } } } } 当JVM中已经没有非Daemon线程,虚拟机就要退出。JVM中所有Daemon线程需要立即终止,因此finally块并没有执行。

优秀的个人博客,低调大师

Java并发编程基础-理解中断

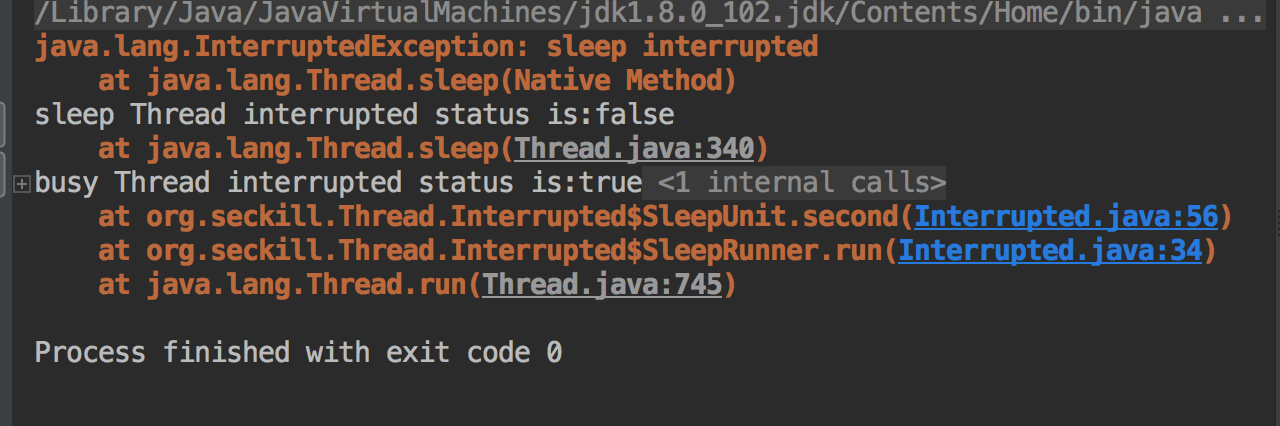
章节 什么是中断 中断线程的方法 线程中断状态的判断以及何时被中断的线程所处 isInterrupted() 状态为 false? 1.什么是中断 线程标识位 中断可以理解为线程的一个标识位属性,它标识一个运行中的线程是否被其他线程进行了中断操作。 2.中断线程的方法 其他线程通过调用该线程的 interrupt() 方法对其进行中断操作。 其实就是其他线程对该线程打了个招呼,要求其中断。 3. 线程中断状态的判断 线程通过方法isInterrupted()方法来进行判断是否被中断。 如下两种情况需要注意: 1.如果被中断的线程已经处于终结状态,那么调用该线程对象的 thread.isInterrupted() 返回的仍是 false。 2.在Java API中可以看到,许多抛出 InterruptedException 的方法,(其实线程已经终结了,因为遇到了异常)如Thread.sleep( long mills) 方法)这些方法在抛出InterruptedException 异常之前,JVM会将中断标识位清除,然后抛出InterruptedException,此时调用isInterrupted()仍会返回false。 package org.seckill.Thread; import java.util.concurrent.TimeUnit; public class Interrupted { public static void main(String[] args) throws InterruptedException{ Thread sleepThread = new Thread(new SleepRunner(),"sleepRunner"); sleepThread.setDaemon(true);//支持性线程 Thread busyThread = new Thread(new BusyRunner(),"busyRunner"); busyThread.setDaemon(true); sleepThread.start(); busyThread.start(); TimeUnit.SECONDS.sleep(5); sleepThread.interrupt(); busyThread.interrupt(); System.out.println("sleep Thread interrupted status is:"+sleepThread.isInterrupted()); System.out.println("busy Thread interrupted status is:"+busyThread.isInterrupted()); SleepUnit.second(500); } /** * 沉睡中的线程-静态内部类 */ static class SleepRunner implements Runnable { public void run() { while (true) { SleepUnit.second(10); } } } /** * 不停运行,空耗cpu的线程-静态内部类 */ static class BusyRunner implements Runnable { public void run() { while (true) { } } } /** * 静态内部工具类 */ static class SleepUnit { public static void second(int seconds) { try { TimeUnit.SECONDS.sleep(10); } catch (InterruptedException e) { e.printStackTrace(); } } } } 运行结果: 运行结果 我们可以发现 sleep线程的 isInterrupted 状态为false,其中断标识位被清除了。 busy 线程属于正常中断所以isInterrupted 状态为 true,中断标识位没有被清除。

优秀的个人博客,低调大师

Java AOP(面向切面编程)实现

动态代理 AOP概念解释 AOP用在哪些方面:AOP能够将那些与业务无关,却为业务模块所共同调用的逻辑或责任,例如事务处理、日志管理、权限控制,异常处理等,封装起来,便于减少系统的重复代码,降低模块间的耦合度,并有利于未来的可操作性和可维护性。 AOP中的概念 Aspect(切面):指横切性关注点的抽象即为切面,它与类相似,只是两者的关注点不一样,类是对物体特征的抽象,而切面是横切性关注点的抽象。joinpoint(连接点):所谓连接点是指那些被拦截到的点(可以是方法、属性、或者类的初始化时机(可以是Action层、Service层、dao层))。在Spring中,这些点指的是方法,因为Spring只支持方法类型的连接点,实际上joinpoint还可以是field或类构造器。Pointcut(切入点):所谓切入点是指我们要对那些joinpoint进行拦截的定义,也即joinpoint的集合。Advice(通知):所谓通知是指拦截到joinpoint之后所要做的事情就是通知。通知分为前置通知、后置通知、异常通知、最终通知、环绕通知。我们就以CGlibProxyFactory类的代码为例进行说明: public class CGlibProxyFactory implements MethodInterceptor { private Object targetObject; // 代理的目标对象 public Object createProxyInstance(Object targetObject) { this.targetObject = targetObject; Enhancer enhancer = new Enhancer(); enhancer.setSuperclass(this.targetObject.getClass()); // 设置目标类为代理对象的父类 enhancer.setCallback(this); return enhancer.create(); } // 从另一种角度看: 整个方法可看作环绕通知 @Override public Object intercept(Object proxy, Method method, Object[] args, MethodProxy methodProxy) throws Throwable { PersonServiceBean bean = (PersonServiceBean)this.targetObject; Object result = null; if (bean.getUser() != null) { // 有权限 // ...... advice() ----> 前置通知(所谓通知,就是我们拦截到业务方法之后所要干的事情) try { result = methodProxy.invoke(targetObject, args); // 把方法调用委派给目标对象 // ...... afteradvice() ----> 后置通知 } catch (RuntimeException e) { // ...... exceptionadvice() ----> 异常通知 } finally { // ...... finallyadvice() ----> 最终通知 } } return result; } } Target(目标对象):代理的目标对象。Weave(织入):指将aspects应用到target对象并导致proxy对象创建的过程称为织入。Introduction(引入):在不修改类代码的前提下,Introduction可以在运行期为类(代理类)动态地添加一些方法或Field。 AOP带来的好处:降低模块的耦合度;使系统容易扩展;更好的代码复用性。 2. JDK实现 1). 创建Person接口 public interface PersonService { /** * 保存 * @param name 名称 */ public void save(String name); /** * 根据ID更新名称 * @param name 姓名 * @param personId 人员ID */ public void update(String name, Integer personId); /** * 根据ID获取名称 * @param personId 人员ID * @return 名称 */ public String getPersonName(Integer personId); } 2). 创建实现Person接口的实现类PersonImpl public class PersonServiceImpl implements PersonService{ private String user = null; public void setUser(String user) { this.user = user; } public String getUser() { return user; } public PersonServiceImpl() { } public PersonServiceImpl(String user){ this.user = user; } @Override public void save(String name) { System.out.println("我是save方法"); } @Override public void update(String name, Integer personId) { System.out.println("我是update方法"); } @Override public String getPersonName(Integer personId) { System.out.println("我是getPersonName方法"); return "xxx"; } } 3). 创建代理类PersonServiceImplProxy public class PersonServiceImplProxy implements InvocationHandler { private PersonService personService; public PersonService createProxy(PersonService personService) { return (PersonService) Proxy.newProxyInstance(PersonServiceImplProxy.class.getClassLoader(), personService.getClass().getClass().getInterfaces(), this); } @Override public Object invoke(Object proxy, Method method, Object[] args) throws Throwable { PersonServiceImpl pImpl = (PersonServiceImpl) this.personService; Object result = null; // 如果不等于null则表示有权限 if (null != pImpl.getUser()) { // 执行方法 result = method.invoke(personService, args); } return result; } } 4). 创建Demo类测试 public class Demo { public static void main(String[] args) { PersonServiceImplProxy proxy = new PersonServiceImplProxy(); PersonService service = proxy.createProxy(new PersonServiceImpl("mazaiting")); service.save("123"); } } 打印结果: 图1.png 5). 更改测试代码 public class Demo { public static void main(String[] args) { PersonServiceImplProxy proxy = new PersonServiceImplProxy(); PersonService service = proxy.createProxy(new PersonServiceImpl()); service.save("123"); } } 打印结果: 图2.png 3. CGlib实现AOP功能 动态代理技术只能是基于接口,那如果这个对象没有接口,就要使用CGlib这个工具包。 1). 创建PersonService类 public class PersonService { private String user = null; public void setUser(String user) { this.user = user; } public String getUser() { return user; } public PersonService() { } public PersonService(String user){ this.user = user; } public void save(String name) { System.out.println("我是save方法"); } public void update(String name, Integer personId) { System.out.println("我是update方法"); } public String getPersonName(Integer personId) { System.out.println("我是getPersonName方法"); return "xxx"; } } 2). 创建CGlibProxyFactory类 public class CGlibProxyFactory implements MethodInterceptor { // 代理的目标对象 private Object targetObject; public Object createProxyInstance(Object targetObject) { this.targetObject = targetObject; // 该类用于生成代理对象 Enhancer enhancer = new Enhancer(); // 设置目标类为代理对象的父类 enhancer.setSuperclass(this.targetObject.getClass()); // 设置回调用对象本身 enhancer.setCallback(this); return enhancer.create(); } @Override public Object intercept(Object proxy, Method method, Object[] args, MethodProxy methodProxy) throws Throwable { PersonService service = (PersonService) this.targetObject; Object result = null; // 有权限 if (null != service.getUser()) { // 把方法调用委派给目标对象 result = methodProxy.invoke(targetObject, args); } return result; } } 3). 创建Demo测试类 public class Demo { public static void main(String[] args) { CGlibProxyFactory factory = new CGlibProxyFactory(); PersonService service = (PersonService) factory.createProxyInstance(new PersonService("mazaiting")); service.save("999"); } } 4). 打印结果 图3.png

优秀的个人博客,低调大师

ZooKeeper客户端编程(三)

前面说了一些ZooKeeper理论上的内容,对于实践部分,想必都是跃跃欲试。这里我想主要介绍几个Java的demo来起到抛砖引玉的作用,Zookeeper客户端框架具体的细节部分若深入起来不是三言两语能解释的完的,我适当的说明一些,深入的研究还望一起努力。 图与文无关 假设你已经对zkCli的基本命令较熟悉了: create 创建节点 delete 删除节点 exists 判断节点是否存在 getChildren 获取节点下的所有子节点 getData 获取节点的数据 setData 在节点写入或更新数据 getACL 获取某节点的ACL setACL 设置某节点的ACL sync 同步某客户端znode的状态 准备 电脑上有Java开发环境 maven,下载ZooKeeper Java客户端的源码 浏览器 ,ZooKeeper API文档(http://zookeeper.apache.org/doc/r3.4.6/api/index.html) Java案例 列出指定节点下的内容 public class ZooState { public static void main(String[] args) throws IOException, KeeperException, InterruptedException { String hostPort = "192.168.8.250:2181"; String zPath = "/"; List<String> zooChildren = new ArrayList<>(); //构造ZooKeeper的实例 ZooKeeper zooKeeper = new ZooKeeper(hostPort, 2000, null); try { //获取节点下的内容 zooChildren = zooKeeper.getChildren(zPath,false); System.out.println("Znodes of /:"); for (String zooChild : zooChildren) { System.out.println(zooChild); } } catch (InterruptedException e) { e.printStackTrace(); } catch (KeeperException e) { e.printStackTrace(); } } } ZooKeeper的构造参数: connectString 服务器列表,多个服务器用逗号分隔开,如"127.0.0.1:3000,127.0.0.1:3001,127.0.0.1:3002"。如果要使用chroot特性,那么加上路径后缀。如"127.0.0.1:3000,127.0.0.1:3001,127.0.0.1:3002/app/a" sessionTimeout session的超时时间,毫秒为单位。在sessionTimeout内没有心跳检测,会话就标记为失效的 watcher watcher对象用来通知对象的改变,可以传入null canBeReadOnly 是否支持只读模式。当ZooKeeper服务器挂掉的时候,还是希望ZooKeeper能提供读服务。 sessionId和sessionPasswd 用于确定唯一一个会话,可以实现客户端的会话复用 Zookeeper实例提供了很多我们操作ZooKeeper数据的接口,记得看它的详细介绍。 ZooKeeper实例图 我自己是觉得Java Doc已经解释的很详细了,我列出几个使用客户端API的案例。 注册zNode监听事件 @Slf4j public class DataWatch implements Watcher,Runnable{ String hostPart = "192.168.8.250:2181"; String zooDataPath = "/MyConfig"; byte[] zooData = null; ZooKeeper zk; public static void main(String[] args) throws IOException, KeeperException, InterruptedException { DataWatch dataWatch = new DataWatch(); dataWatch.printData(); dataWatch.run(); } public DataWatch() { try { zk = new ZooKeeper(hostPart,2000,this); if (zk.exists(zooDataPath,this) == null){ zk.create(zooDataPath,"".getBytes(), ZooDefs.Ids.OPEN_ACL_UNSAFE,CreateMode.PERSISTENT); } } catch (IOException | KeeperException | InterruptedException e) { e.printStackTrace(); } } public void printData() throws KeeperException, InterruptedException { zooData = zk.getData(zooDataPath,this,null); String zString = new String(zooData); log.info("\nCurrent Data: %s %s",zooDataPath,zString); } @Override public void run() { try { synchronized (this){ while (true){ wait(); } } } catch (InterruptedException e) { e.printStackTrace(); Thread.currentThread().interrupt(); } } @Override public void process(WatchedEvent event) { System.out.printf("\nReceive Events: %s",event.toString()); // 我们只处理数据改变的Node if (event.getType() == Event.EventType.NodeDataChanged){ try { printData(); } catch (KeeperException | InterruptedException e) { e.printStackTrace(); } } } } 简单的实现将监听器指向自己,当节点数据改变的时候打印节点中的内容。在zkCli中试着改变/MyConfig节点查看效果。 ACL访问控制的例子 public class ZooAcl { public static void main(String[] args) throws IOException, KeeperException, InterruptedException { String hostPort = "192.168.8.250:2181"; String zooDataPath = "/Auth"; byte[] zooData = null; ZooKeeper zk = new ZooKeeper(hostPort, 2000, null); zk.addAuthInfo("digest","foo:true".getBytes()); zk.create(zooDataPath, "init".getBytes(), ZooDefs.Ids.CREATOR_ALL_ACL, CreateMode.EPHEMERAL); ZooKeeper zk2 = new ZooKeeper(hostPort, 2000, null); zk2.getData(zooDataPath,false,null); } } 这个实例,首先创建一个包含权限信息的客户端创建一个数据节点,然后使用另外一个不包含权限信息的客户端访问。运行会出现异常。 Exception in thread "main" org.apache.zookeeper.KeeperException$NoAuthException: KeeperErrorCode = NoAuth for /Auth 额外-Curator 除了ZooKeeper官方的Java API,开源社区也提供了更好的对ZooKeeper的封装,常用的有ZkClient和Curator。最受欢迎的是Curator,所以建议使用Curator,若想要对ZooKeeper有更深入的研究,两者的实现都可以看一下。 我这里略提一些Curator的内容。它是Netfix公司开源的一套ZooKeeper客户端框架,它解决了很多ZooKeeper客户端非常底层的细节开发工作,包括连接重连,反复注册Watcher和NodeExistsException异常等。目前是Apache的顶级项目,ZooKeeper的核心代码提交者Patrick Hunt以一句“Guava is to Java what Curator to ZooKeeper”。对其进行了高度评价。 因为Curator对底层封装的很好,用起来也特别方便,并且提供了一套易用性和可读性更强的Fluent风格的客户端API框架。 Curator有些maven的源值得提一下: <!-- https://mvnrepository.com/artifact/org.apache.curator/curator-framework --> // 开发所用的curator maven依赖 <dependency> <groupId>org.apache.curator</groupId> <artifactId>curator-framework</artifactId> <version>4.0.1</version> </dependency> <!-- https://mvnrepository.com/artifact/org.apache.curator/curator-examples --> // curator的使用案例。可以进行参考 <dependency> <groupId>org.apache.curator</groupId> <artifactId>curator-examples</artifactId> <version>4.0.1</version> </dependency> <!-- https://mvnrepository.com/artifact/org.apache.curator/curator-recipes --> // Curator的常见用法,常用的应用场景 <dependency> <groupId>org.apache.curator</groupId> <artifactId>curator-recipes</artifactId> <version>4.0.1</version> </dependency> // 几句样例代码 CuratorFramework client = CuratorFrameworkFactory.builder() .connectString("192.168.8.250:2181") .sessionTimeoutMs(5000) .retryPolicy(new ExponentBackoffRetry(1000,3)) .build(); client.start(); //创建一个节点,初始内容为空 client.create().forPath("/parent"); //创建一个节点,附带初始内容 client.create().forPath("/parent","init".getBytes()); // 创建一个临时节点,初始内容为空 client.create().withMode( CreateMode.EPHEMERAL ).forPath("/parent"); // 创建一个临时节点,并自动创建父节点,这个接口非常有用,开发人员经常碰到NoNodeException. client.create() .creatingParentsIfNeeded() .withMode( CreateMode.EPHEMERAL ).forPath("/parent"); 最后 这篇文章主要给了几个关于ZooKeeper Java API的用法,API中有很多常用的用法文档写的很明白了,就未过多的进行讲解。最后又提了一下使用很广泛的Curator框架,带大家了解了一下Curator的用法,想要继续深入的话全屏个人兴趣。 参考 《从Paxos到ZooKeeper-分布式一致性原理与实践》 《Apache ZooKeeper Essential》 ZooKeeper Programing Guide Curator 官网

优秀的个人博客,低调大师

java并发编程笔记--ScheduledThreadPoolExecutor实现

ScheduledThreadPoolExecutor作为ScheduledExecutorService接口的实现,提供了延迟执行任务或者周期性执行任务的能力。通过名称可以看出,ScheduledThreadPoolExecutor基于线程池实现,它通过继承ThreadPoolExecutor实现线程池管理能力的复用,同时扩展了自己的定时任务调度能力。 首先来看ScheduledExecutorServicej接口,它继承了ExecutorService接口,作为任务执行器的一种扩展类型,提供了如下方法: schedule方法:用于任务的单次执行,允许指定延迟时间,当时间为0或者负数时,表示立即执行任务; scheduleAtFixedRate方法:以固定的时间间隔执行任务,当任务本身的执行时间超过时间间隔时,会等到任务执行完成后,立即执行下一次任务;同一个任务总是串行执行,不会并发执行; scheduleWithFixedDelay方法:以固定的延迟执行任务,当前任务执行时间与上一次任务执行时间相隔固定的延迟;任务每次执行完成后,会在结束时间上加上固定的延迟作为下一次执行时间。任务执行的周期会将任务本身执行耗时考虑在内,因而并非每次执行的时间间隔都相同; ScheduledThreadPoolExecutor继承ThreadPoolExecutor,主要做了如下改变: 使用ScheduledFutureTask作为任务封装类,代替原先的FutureTask类; 使用DelayedWorkQueue作为阻塞队列,队列为无界队列;ScheduledThreadPoolExecutor的构造器仅需要传入corePoolSize,使用"corePoolSize+无界队列"实现任务调度; 支持run-after-shutdown参数,使得ScheduledThreadPoolExecutor重写shutdown方法,允许移除并且取消不需要在shutdown后执行的任务; 提供了decorateTask方法,用来定制任务操作; ScheduledThreadPoolExecutor的组成 ScheduledThreadPoolExecutor由3部分组成: 任务调度控制:ScheduledThreadPoolExecutor,负责任务调度控制,实现了ScheduledExecutorService接口; 阻塞队列:DelayedWorkQueue,作为ScheduledThreadPoolExecutor的内部类,用于缓存线程任务的阻塞队列,仅能够存放RunnableScheduledFuture对象;该队列实现了延迟调度任务的逻辑,如果当前时间大于等于任务的延迟执行时间,任务才可以被调度。 调度任务:ScheduledFutureTask,作为ScheduledFutureTask的内部类,实现了RunnableScheduledFuture,封装了调度任务的执行逻辑。其中的time字段存放下一次执行时间,DelayedWorkQueue会据此判断任务是否可以被执行。period字段存放执行周期,对于周期性执行任务,每次会根据period计算time。 ScheduledThreadPoolExecutor初始化 ScheduledThreadPoolExecutor的构造器最多指定3个参数: corePoolSize:线程池核心工作线程数量; threadFactory:定制工作线程创建方式; handler:驳回任务处理策略; ScheduledThreadPoolExecutor构造器会调用父类构造器进行线程池初始化,使用DelayedWorkQueue作为阻塞队列,该队列为无界队列,因而maximumPoolSize属性配置无效。又因为都是核心工作线程,没有非核心线程需要回收,因而keepAliveTime配置为0。代码如下: public ScheduledThreadPoolExecutor(int corePoolSize, ThreadFactory threadFactory, RejectedExecutionHandler handler) { super(corePoolSize, Integer.MAX_VALUE, 0, NANOSECONDS, new DelayedWorkQueue(), threadFactory, handler); } ScheduledThreadPoolExecutor初始化时并不会预先创建工作线程,而是在提交任务的时候,通过父类java.util.concurrent.ThreadPoolExecutor#ensurePrestart方法判断线程数是否达到corePoolSize,如果未达到,则新增线程;实现逻辑如下: void ensurePrestart() { int wc = workerCountOf(ctl.get()); // 当前线程数 < corePoolSize,则添加核心工作线程; if (wc < corePoolSize) addWorker(null, true); // 如果0 == wc >= corePoolSize,则表示corePoolSize配置为0,则初始化一个非核心工作线程; else if (wc == 0) addWorker(null, false); } 任务执行 ScheduledThreadPoolExecutor的任务执行分为单次执行和周期性执行。 单次执行:通过schedule方法执行的任务属于单次执行任务。Executor的execute方法、ExecutorService的submit方法都是通过调用schedule方法执行,故也是单次执行的任务。除了schedule可以指定延迟时间以外,其余方法的延迟时间均为0,即立刻执行任务。比如:execute方法实现如下: public void execute(Runnable command) { schedule(command, 0, NANOSECONDS); } 周期性执行:通过scheduleAtFixedRate、scheduleWithFixedDelay方法执行的任务均为周期性执行任务。周期性执行的实现可以理解为每次执行完成后设定下一次执行时间,然后将任务重新放入到阻塞队列等待下一次调度。 任务入口:delayedExecute() 无论是单次执行还是周期性执行,其执行的入口都是delayedExecute方法。delayedExecute()将任务放入到阻塞队列中,复用ThreadPoolExecutor的逻辑进行任务调度。代码如下: private void delayedExecute(RunnableScheduledFuture<?> task) { // 如果调度器关闭,则拒绝接收任务 if (isShutdown()) // 执行拒绝策略 reject(task); // 如果调度器未关闭 else { // 添加任务到阻塞队列,等待调度执行; super.getQueue().add(task); // 如果此时调度器关闭,则取消任务; if (isShutdown() && !canRunInCurrentRunState(task.isPeriodic()) && remove(task)) task.cancel(false); // 如果调度器正常运行,则检查开启线程数是否达到corePoolSize // 如果未达到corePoolSize,则初始化1个工作线程; // 如果corePoolSize设置为0,则会初始化1个非core工作线程; else ensurePrestart(); } } 当ThreadPoolExecutor的Worker线程从阻塞队列取出任务执行时,会调用ScheduledFutureTask的run方法。该方法对任务类型进行判断,如果是单次执行任务,则立即执行并设置返回结果。如果是周期性执行任务,则执行任务并设置下一次执行时间,然后将任务放入到阻塞队列中,等待下一次调度。方法代码如下: public void run() { boolean periodic = isPeriodic(); // 如果当前不可运行任务,则取消任务 if (!canRunInCurrentRunState(periodic)) cancel(false); // 如果是单次执行的任务 else if (!periodic) // 直接调用FutureTask.run()方法执行; ScheduledFutureTask.super.run(); // 如果是周期性任务,则运行任务但不设置结果; else if (ScheduledFutureTask.super.runAndReset()) { // 设置任务下一次执行时间 setNextRunTime(); // 将任务重新加入队列,等待下一次调度 reExecutePeriodic(outerTask); } } 单次执行:schedule() schedule的执行主要分为参数封装和执行两个步骤。实现如下: public ScheduledFuture<?> schedule(Runnable command, long delay, TimeUnit unit) { if (command == null || unit == null) throw new NullPointerException(); // 封装任务参数,调用decorateTask装饰方法进行任务定制 RunnableScheduledFuture<?> t = decorateTask(command, new ScheduledFutureTask<Void>(command, null, triggerTime(delay, unit))); // 执行任务 delayedExecute(t); return t; } 参数封装过程会调用decorateTask方法,该方法为protected的空方法,用于定制RunnableScheduledFuture的属性,可以通过重写实现定制。 protected <V> RunnableScheduledFuture<V> decorateTask( Runnable runnable, RunnableScheduledFuture<V> task) { return task; } 周期性执行:scheduleAtFixedRate() / scheduleWithFixedDelay() scheduleAtFixedRate()的实现与schedule()方法非常相似,仅是将decorateTask()返回的RunnableScheduledFuture对象设置为原有Future的outerTask属性。在重新知心任务时,会将outerTask添加到阻塞队列,从而保证decorateTask()的定制效果一直有效。 public ScheduledFuture<?> scheduleAtFixedRate(Runnable command, long initialDelay, long period, TimeUnit unit) { if (command == null || unit == null) throw new NullPointerException(); if (period <= 0) throw new IllegalArgumentException(); ScheduledFutureTask<Void> sft = new ScheduledFutureTask<Void>(command, null, triggerTime(initialDelay, unit), unit.toNanos(period)); RunnableScheduledFuture<Void> t = decorateTask(command, sft); // 保存定制后的Future对象,便于再次调用; sft.outerTask = t; delayedExecute(t); return t; } scheduleAtFixedRate()的实现与schedule()方法非常相似,仅是设置ScheduledFutureTask延迟时,使用负数,标识执行方式为scheduleAtFixedRate。 public ScheduledFuture<?> scheduleWithFixedDelay(Runnable command, long initialDelay, long delay, TimeUnit unit) { if (command == null || unit == null) throw new NullPointerException(); if (delay <= 0) throw new IllegalArgumentException(); ScheduledFutureTask<Void> sft = new ScheduledFutureTask<Void>(command, null, triggerTime(initialDelay, unit), unit.toNanos(-delay)); RunnableScheduledFuture<Void> t = decorateTask(command, sft); sft.outerTask = t; delayedExecute(t); return t; } ScheduledFutureTask并没有设置单独的字段用于标识执行类型,而是通过period字段的正负号和是否为0表示执行方式: 正数:fixed-rate执行方式; 负数:fixed-delay执行方式; 0:单次执行任务; scheduleAtFixedRate() / scheduleWithFixedDelay()执行的主要区别在于设置下一次执行时间的策略不同,而执行时间通过ScheduledFutureTask的time字段保存,通过ScheduledFutureTask#setNextRunTime()进行设置,代码如下: private void setNextRunTime() { long p = period; // 如果是fixed-rate执行方式:下一次执行时间 = 上一次执行时间 + period if (p > 0) time += p; // 如果是fixed-delay执行方式:下一次执行时间 = now() + period else time = triggerTime(-p); } 延迟功能实现:DelayedWorkQueue DelayedWorkQueue是专门存放RunnableScheduledFuture和ScheduledFutureTask对象的优先队列,底层基于最小二叉堆实现,为了能够提升任务的查找和删除效率,ScheduledFutureTask中增加了一个heapIndex的成员变量,用于存放任务在堆数组中的索引位置,当需要查找或者删除某个特定的任务时,直接根据任务的heapIndex访问堆数组中的元素。任务是否到达执行时间的判断逻辑均在DelayedWorkQueue中实现。 主要成员变量 /** * 存放堆的数组,初始化大小为16 */ private RunnableScheduledFuture<?>[] queue = new RunnableScheduledFuture<?>[INITIAL_CAPACITY]; /** * 队列中的任务个数 */ private int size = 0; /** * 保证队列操作的锁 */ private final ReentrantLock lock = new ReentrantLock(); /** * 存放用于等待任务的leader线程引用; * 为降低性能消耗,同一时间并不需要所有线程都轮询等待任务到达执行时间; * 只需要一个leader线程负责轮询等待即可; */ private Thread leader = null; /** * Condition signalled when a newer task becomes available at the * head of the queue or a new thread may need to become leader. */ private final Condition available = lock.newCondition(); 与PriorityQueue的实现不同,DelayedWorkQueue涉及到多线程访问,因而需要保证线程同步测正确性,故使用ReentrantLock来控制操作的原子性,同时使用Condition来协调线程的执行; 设置任务索引 为了方便在DelayedWorkQueue中查找和删除任务,ScheduledFutureTask有一个heapIndex用于存放任务在堆数组中的索引位置。每当任务在队列中的位置改变时,需要同步更新任务的heapIndex。 private void setIndex(RunnableScheduledFuture<?> f, int idx) { if (f instanceof ScheduledFutureTask) ((ScheduledFutureTask)f).heapIndex = idx; } 上浮、下沉操作 上浮、下沉操作的实现与PriorityQueue实现相似,只多了更新索引位置的操作,且需要在加锁的环境下调用。 /** * 上浮操作 */ private void siftUp(int k, RunnableScheduledFuture<?> key) { while (k > 0) { int parent = (k - 1) >>> 1; RunnableScheduledFuture<?> e = queue[parent]; if (key.compareTo(e) >= 0) break; queue[k] = e; // 更新父节点索引位置 setIndex(e, k); k = parent; } queue[k] = key; // 更新当前节点索引位置 setIndex(key, k); } /** * 下沉操作 */ private void siftDown(int k, RunnableScheduledFuture<?> key) { int half = size >>> 1; while (k < half) { int child = (k << 1) + 1; RunnableScheduledFuture<?> c = queue[child]; int right = child + 1; if (right < size && c.compareTo(queue[right]) > 0) c = queue[child = right]; if (key.compareTo(c) <= 0) break; queue[k] = c; // 更新子节点索引 setIndex(c, k); k = child; } queue[k] = key; // 更新当前节点索引 setIndex(key, k); } 入队操作 public boolean offer(Runnable x) { if (x == null) throw new NullPointerException(); // 操作前先加锁,保证原子性 RunnableScheduledFuture<?> e = (RunnableScheduledFuture<?>)x; final ReentrantLock lock = this.lock; lock.lock(); try { int i = size; // 容量不够,则成倍扩容 if (i >= queue.length) grow(); size = i + 1; // 如果队列为空,则直接放入任务 if (i == 0) { queue[0] = e; setIndex(e, 0); } else { // 如果队列不为空,则执行上浮操作 siftUp(i, e); } // queue[0] == e包含两种情况: // 1)e为队列中的第一个元素; // 2)e为队列中最近要执行的任务; if (queue[0] == e) { leader = null; available.signal(); } } finally { lock.unlock(); } return true; } public void put(Runnable e) { offer(e); } public boolean add(Runnable e) { return offer(e); } 出队操作 /** * 任务出队后,通过下沉操作使得堆有序; */ private RunnableScheduledFuture<?> finishPoll(RunnableScheduledFuture<?> f) { int s = --size; RunnableScheduledFuture<?> x = queue[s]; queue[s] = null; if (s != 0) siftDown(0, x); // 出队任务heapIndex设置为-1 setIndex(f, -1); return f; } /** * 出队,非阻塞 */ public RunnableScheduledFuture<?> poll() { final ReentrantLock lock = this.lock; lock.lock(); try { RunnableScheduledFuture<?> first = queue[0]; // 如果队列为空或者没有任务到执行时间,则返回null if (first == null || first.getDelay(NANOSECONDS) > 0) return null; else // 执行下沉操作,返回队首任务 return finishPoll(first); } finally { lock.unlock(); } } /** * 出队,阻塞线程,直到有任务返回 */ public RunnableScheduledFuture<?> take() throws InterruptedException { final ReentrantLock lock = this.lock; // 加锁,允许响应中断 lock.lockInterruptibly(); try { for (;;) { RunnableScheduledFuture<?> first = queue[0]; // 如果队列为空,则阻塞等待 if (first == null) available.await(); else { long delay = first.getDelay(NANOSECONDS); // 如果第一个任务已经到达时间点,则立刻返回任务 if (delay <= 0) return finishPoll(first); // 如果未到达时间点 first = null; // don't retain ref while waiting // 如果已经有leader线程等待任务,则阻塞当前线程 if (leader != null) available.await(); // 如果没有leader线程,则设置当前线程为leader线程,轮询等待任务到达执行时间点 else { Thread thisThread = Thread.currentThread(); leader = thisThread; try { // 等待队首任务到达执行时间 available.awaitNanos(delay); } finally { if (leader == thisThread) leader = null; } } } } } finally { // 唤醒一个线程,确保至少有一个线程未被阻塞 if (leader == null && queue[0] != null) available.signal(); lock.unlock(); } } /** * 出队,阻塞线程,直到有任务返回或者超时 */ public RunnableScheduledFuture<?> poll(long timeout, TimeUnit unit) throws InterruptedException { long nanos = unit.toNanos(timeout); final ReentrantLock lock = this.lock; // 加锁,允许响应中断 lock.lockInterruptibly(); try { for (;;) { RunnableScheduledFuture<?> first = queue[0]; // 如果队列为空 if (first == null) { // 如果到达超时时间,则返回null if (nanos <= 0) return null; // 未到达超时时间,则等待超时 else nanos = available.awaitNanos(nanos); } else { long delay = first.getDelay(NANOSECONDS); // 如果队首任务到达执行时间,则立即返回任务; if (delay <= 0) return finishPoll(first); // 如果未到达执行时间,且超时,则返回null; if (nanos <= 0) return null; // 如果未到达执行时间,且没有超时 first = null; // don't retain ref while waiting // 如果已经有leader线程,或者超时时间小于第一个任务执行时间, // 则阻塞当前线程直至超时 if (nanos < delay || leader != null) nanos = available.awaitNanos(nanos); // 如果没有leader线程,或者没有超时且没有任务到达时间点; // 则阻塞等待任务到达执行时间点 else { Thread thisThread = Thread.currentThread(); leader = thisThread; try { long timeLeft = available.awaitNanos(delay); nanos -= delay - timeLeft; } finally { // 如果当前线程是leader线程,则取消其leader属性 if (leader == thisThread) leader = null; } } } } } finally { // 唤醒一个线程,确保至少有一个线程未被阻塞 if (leader == null && queue[0] != null) available.signal(); lock.unlock(); } } 根据heapIndex查找和删除任务 /** * 查找一个任务的index,如果未找到,则返回-1 */ private int indexOf(Object x) { if (x != null) { // 如果是ScheduledFutureTask类型任务,则直接返回heapIndex,效率O(1) if (x instanceof ScheduledFutureTask) { int i = ((ScheduledFutureTask) x).heapIndex; // 检查ScheduledFutureTask是否属于当前pool if (i >= 0 && i < size && queue[i] == x) return i; } // 如果是RunnableScheduledFuture类型任务,则遍历查找,效率O(1) else { for (int i = 0; i < size; i++) if (x.equals(queue[i])) return i; } } return -1; } /** * 查找任务 */ public boolean contains(Object x) { final ReentrantLock lock = this.lock; lock.lock(); try { return indexOf(x) != -1; } finally { lock.unlock(); } } /** * 从队列中删除任务,用于取消任务的场景 */ public boolean remove(Object x) { final ReentrantLock lock = this.lock; lock.lock(); try { // 查找任务索引 int i = indexOf(x); // 未找到任务,则不执行删除操作,返回false if (i < 0) return false; // 清空任务索引信息,减小任务队列size // 使用队尾任务替换现有任务索引位置,然后通过下沉、上浮操作找到合适位置 setIndex(queue[i], -1); int s = --size; RunnableScheduledFuture<?> replacement = queue[s]; queue[s] = null; if (s != i) { siftDown(i, replacement); // 如果任务未下沉,则执行上浮操作 if (queue[i] == replacement) siftUp(i, replacement); } return true; } finally { lock.unlock(); } } 通过上面代码我们总结DelayedWorkQueue的实现原理:1)基于最小二叉堆实现的优先队列,根据ScheduledFutureTask.compareTo方法比较任务执行时间,使得最近要执行的任务位于队首;2)任务出队时,通过轮询判断任务是否到达执行时间点,ScheduledFutureTask实现了Delayed接口,通过getDelay方法能够获取到任务还有多长时间执行;3)当队列中所有任务都没有到达执行时间时,队列中会维持一个leader线程,用于轮询等待队首任务,其余线程均await()。4)ScheduledFutureTask增加heapIndex属性,用于标记任务在堆数组中的索引,从而便于任务的快速查找(是否存在)与取消(删除); 任务取消 任务的取消通过ScheduledFutureTask.cancel()方法实现,该方法调用ThreadPoolExecutor.cancel(),在取消任务后,判断是否需要从阻塞队列中移除任务。其中removeOnCancel参数通过setRemoveOnCancelPolicy()设置。之所以要在取消任务后移除阻塞队列中任务,是为了防止队列中积压大量已被取消的任务。 public boolean cancel(boolean mayInterruptIfRunning) { // 调用ThreadPoolExecutor.cancel方法取消任务 boolean cancelled = super.cancel(mayInterruptIfRunning); // 从阻塞队列中移除任务 if (cancelled && removeOnCancel && heapIndex >= 0) remove(this); return cancelled; } 关闭调度器 ScheduledThreadPoolExecutor的shutdown() / shutdownNow()方法均调用ThreadPoolExecutor的相应方法实现。同时,ScheduledThreadPoolExecutor实现了ThreadPoolExecutor的onShutdown()用于在shutdown()执行过程中取消任务执行。 此处涉及2个参数: executeExistingDelayedTasksAfterShutdown:当执行shutdown()后,是否继续执行队列中的单次执行任务;默认为true,即执行; continueExistingPeriodicTasksAfterShutdown:当执行shutdown()后,是否继续执行队列中的周期性任务;默认为false,即不执行; @Override void onShutdown() { BlockingQueue<Runnable> q = super.getQueue(); boolean keepDelayed = getExecuteExistingDelayedTasksAfterShutdownPolicy(); boolean keepPeriodic = getContinueExistingPeriodicTasksAfterShutdownPolicy(); // 如果设置不执行队列中的任务,则取消队列中所有任务,清空队列; if (!keepDelayed && !keepPeriodic) { for (Object e : q.toArray()) if (e instanceof RunnableScheduledFuture<?>) ((RunnableScheduledFuture<?>) e).cancel(false); q.clear(); } // 如果设置执行队列中的任务:周期性的或者单次的任务 else { // 遍历队列中的任务,逐个取消并删除不需要执行的任务 // 先拷贝到数组再遍历,防止遍历时队列元素更新,导致异常; for (Object e : q.toArray()) { if (e instanceof RunnableScheduledFuture) { RunnableScheduledFuture<?> t = (RunnableScheduledFuture<?>)e; if ((t.isPeriodic() ? !keepPeriodic : !keepDelayed) || t.isCancelled()) { if (q.remove(t)) t.cancel(false); } } } } tryTerminate(); }

优秀的个人博客,低调大师

SpringBoot 手写切片/面向切面编程

如何手写一个切片呢。假设我现在需要一个计时切片,我想把每一次调用服务锁花费的时间打印到控制台,该怎么做呢? 拦截机制有三种: 1. 过滤器(Filter)能拿到http请求,但是拿不到处理请求方法的信息。 2. 拦截器(Interceptor)既能拿到http请求信息,也能拿到处理请求方法的信息,但是拿不到方法的参数信息。 3. 切片(Aspect)能拿到方法的参数信息,但是拿不到http请求信息。 他们三个各有优缺点,需要根据自己的业务需求来选择最适合的拦截机制。 拦截机制图 好了下面开始正文。 写一个切片就比较简单了,可以直接用现成的几个注解 @Before() //相当于拦截器的 preHandle @After() //相当于postHandle @AfterThrowing //相当于afterCompletion如果出现异常 @Around() 包括以上三点,所以一般使用它(简洁) TimeAspect .java /** * 时间切片类 (比拦截器好,能拿到具体参数) * Created by Fant.J. */ @Aspect @Component public class TimeAspect { @Around("execution(* com.laojiao.securitydemo.controller.UserController.*(..))") //第一个* 表示任何返回值 第二个* 表示任何方法 public Object handleControllerMethod(ProceedingJoinPoint pjp) throws Throwable { //pjp是一个 包含拦截方法信息的对象 System.out.println("time aspect start"); //参数数组 Object[] args = pjp.getArgs(); for (Object arg:args){ System.out.println("arg is :" +arg); } long start = System.currentTimeMillis(); //调用被拦截的方法 Object object = pjp.proceed(); System.out.println("time aspect 耗时:"+(System.currentTimeMillis() - start)); System.out.println("time aspect end"); return object; } } 代码解释: @Around("execution(* com.laojiao.securitydemo.controller.UserController.*(..))")第一个* 表示任何返回值 第二个* 表示任何方法 ProceedingJoinPoint (pjp)是一个 包含拦截方法信息的对象 pjp.proceed(); 调用被拦截的方法 介绍下我的所有文集: 流行框架 SpringCloudspringbootnginxredis 底层实现原理: Java NIO教程Java reflection 反射详解Java并发学习笔录Java Servlet教程jdbc组件详解Java NIO教程Java语言/版本 研究

优秀的个人博客,低调大师

android网络编程——HttpGet、HttpPost比较

在Android SDK中提供了Apache HttpClient(org.apache.http.*)模块。在这个模块中涉及到两个重要的类:HttpGet和HttpPost,他们有共性也有不同。 HttpGet和HttpPost创建方式相同: 1、创建HttpGet(或HttpPost)对象,将要请求的URL通过构造方法传入HttpGet(或HttpPost)对象中; 2、使用DefaultHttpClient类的execute方法发送HTTP GET或HTTP POST 请求,并返回HttpResponse对象; 3、通过HttpResponse接口的getEntity方法返回响应信息。 HttpGet和HttpPost不同点,HttpPost在使用是需要传递参数 ,使用List<NameValuePair>添加参数。 List<NameValuePair> postParameters = new ArrayList<NameValuePair>(); postParameters.add(new BasicNameValuePair("username", "test")); postParameters.add(new BasicNameValuePair("password", "test1234")); /** * @author 张兴业 * 邮箱:xy-zhang#163.com * android开发进阶群:278401545 * */ 本文转自xyz_lmn51CTO博客,原文链接: http://blog.51cto.com/xyzlmn/1230790 ,如需转载请自行联系原作者

优秀的个人博客,低调大师

Cocoa编程学习笔记之MVC

Cocoa 使用了一种修改版本的MVC模式来处理GUI的显示。MVC模式(自1979年以来)已经出现很长时间了,它皆在分离显示用户界面所需的大量任务,并处理用户交互。正如名称所蕴含的,MVC具有三个主要部分,Model(模型)、View(视图)和Controller(控制器): 模型——模型是特定于领域的数据表现形式。比如说,我们正在创建一个任务列表应用程序。你可能会有一个Task对象的集合,书写为List。 你或许把这些数据保存在数据库、XML文件,或者甚至从Web Service中得到,不过MVC不那么关心它们是在何处/如何来持久保存的(乃至它们是什么)。相反,它特别专注于如何显示这些数据,并处理与用户交互的,好的模型类不包括任何有关用户界面的内容,可以在多个应用程序中使用。视图——视图代表了数据如何实际地显示出来。在我们这个假设的任务应用程序中,会在一个网页(以HTML的方式)中来显示这些任务,也会在一个WPF页面中(以XAML的方式)来显示,或者在一个iPhone应用程序中显示为UITableView 。如果用户点击某个任务,要删除之,那么视图通常会触发一个事件,或对Controller(控制器)进行一个回调,好的视图类是通用类,可以在多个应用中使用。控制器——控制器是模型和视图间的粘合剂,负责控制整个应用的流程。控制器的目的就是获取模型中的数据,告知视图来显示。控制器还侦听着视图的事件,在用户选中一个任务来删除的时候,控制着任务从模型中删除。通过分离显示数据、持久化数据和处理用户交互的职责,MVC模式有助于创建易于理解的代码。而且,它促进了视图和模型的解耦,以便模型能被重用。例如,在你的应用程序中,有两个界面,基于Web的和WPF的,那么你可以在两者中都使用同样的模型定义代码。 因而,在很多MVC框架中不管具体的工作方式如何,基本原理都大致如此的。然而,在Cocoa(及Cocoa Touch)中,还是或多或少有所不同,苹果用MVC来代表Views(视图)、View Controller(视图控制器)和Models(模型);但是在不同的控件中,它们却不是完全一致的,实现的方式也不太一样。 在Objective-C/Cocoa的世界里,我们建立的controller通常是指应用程序(Application)的委托(Delegate),或者可以简单称做app delegate。当你在Objective-C里面建立一个app delegate的时候,这个delegate可以做为你所有model和view的controller,或者你也可以为不同的model和view分别创建controller。 本文来自云栖社区合作伙伴“doNET跨平台”,了解相关信息可以关注“opendotnet”微信公众号

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册