首页 文章 精选 留言 我的

精选列表

搜索[思考控制],共10005篇文章
优秀的个人博客,低调大师

hive权限控制

<property> <name>hive.server2.authentication</name> <value>CUSTOM</value> </property> <property> <name>hive.server2.custom.authentication.class</name> <value>com.hiveserver.auth.CustomHiveServerAuth</value> </property> <property> <name>hive.server2.custom.authentication.file</name> <value>/home/soft/hive/conf/hiveserver2.users.conf</value> </property> <property> <name>hive.metastore.local</name> <value>false</value> </property> <property> <name>hive.metastore.uris</name> <value>thrift://spark01:9083</value> <description>Thrift URI for the remote metastore. Used by metastore client to connect to remote metastore.</description> </property> <property> <name>hive.security.authenticator.manager</name> <value>org.apache.hadoop.hive.ql.security.SessionStateUserAuthenticator</value> <description> hive client authenticator manager class name. The user defined authenticator should implement interface org.apache.hadoop.hive.ql.security.HiveAuthenticationProvider. </description> </property> <property> <name>hive.security.authorization.enabled</name> <value>true</value> <description>enable or disable the Hive client authorization</description> </property> <property> <name>hive.security.authorization.manager</name> <value>org.apache.hadoop.hive.ql.security.authorization.plugin.sqlstd.SQLStdHiveAuthorizerFactory</value> <description> The Hive client authorization manager class name. The user defined authorization class should implement interface org.apache.hadoop.hive.ql.security.authorization.HiveAuthorizationProvider. </description> </property> <property> <name>hive.users.in.admin.role</name> <value>root</value> <description> Comma separated list of users who are in admin role for bootstrapping. More users can be added in ADMIN role later. </description> </property> <property> <name>hive.server2.enable.doAs</name> <value>false</value> <description> Setting this property to true will have HiveServer2 execute Hive operations as the user making the calls to it. </description> </property> <property> <name>hive.server2.thrift.bind.host</name> <value>spark01</value> <description>Bind host on which to run the HiveServer2 Thrift service.</description> </property> <property> <name>hive.server2.thrift.port</name> <value>10000</value> <description>Port number of HiveServer2 Thrift interface when hive.server2.transport.mode is 'binary'.</description> </property> <property> <name>hive.server2.thrift.http.port</name> <value>10001</value> <description>Port number of HiveServer2 Thrift interface when hive.server2.transport.mode is 'http'.</description> </property> hive --service metastore &hive --service hiveserver2 & !connect jdbc:hive2://172.16.0.71:10000 create database tycybgongshang;describe database tycbygongshang;create database tycybzhuanli;set role admin;

优秀的个人博客,低调大师

Android内存控制

Android开发实践:检测App的内存占用和泄漏 http://www.linuxidc.com/Linux/2014-03/97563.htm 官方文档对于内存管理 http://developer.android.com/intl/zh-cn/training/articles/memory.html http://blog.csdn.net/hknock/article/details/47322005(中文翻译) Android代码内存优化建议-Android资源篇 http://blog.csdn.net/hknock/article/details/47322005 Android 内存管理 &Memory Leak & OOM 分析 http://blog.csdn.net/vshuang/article/details/39647167 ANDROID 探究oom内幕 http://blog.csdn.net/chengyingzhilian/article/details/8662849 Android DiskLruCache缓存完全解析 http://blog.csdn.net/lwyygydx/article/details/40401211 Java内存分配全面浅析 http://blog.csdn.net/yangyuankp/article/details/7651251 Java内存分配、管理小结 http://java-mzd.iteye.com/blog/848635 JVM 的 工作原理,层次结构 以及 GC工作原理 http://segmentfault.com/a/1190000002579346 前些日子,一位面试官(乔丽云,大约30来岁,个子不是很高),我从她那里确实领会了一些东西: 假如有这样一个需求,判断一个文件的格式 一般的人会将格式全部存入HashMap当中,然后去遍历,然后问我有没有什么优化的方法,就是不写 入到内存当中? 答案:用if else或switch来用语法来判断,这样是节省了内存,但是在性能上可能上会有一定的代价。 在Activity退出,注销登录时,如果还有网络请求在运行,应该怎么取消? Volley库可以做到 对于一些图片库,在下载完图片时,如果任务在进行,而界面退出了,应该怎么取消?图片库做了 什么处理? DiskLruCache详解 http://blog.csdn.net/lwyygydx/article/details/40401211 本文转自屠夫章哥 51CTO博客,原文链接:http://blog.51cto.com/4259297/1710264,如需转载请自行联系原作者

优秀的个人博客,低调大师

大模型评测实践与思考

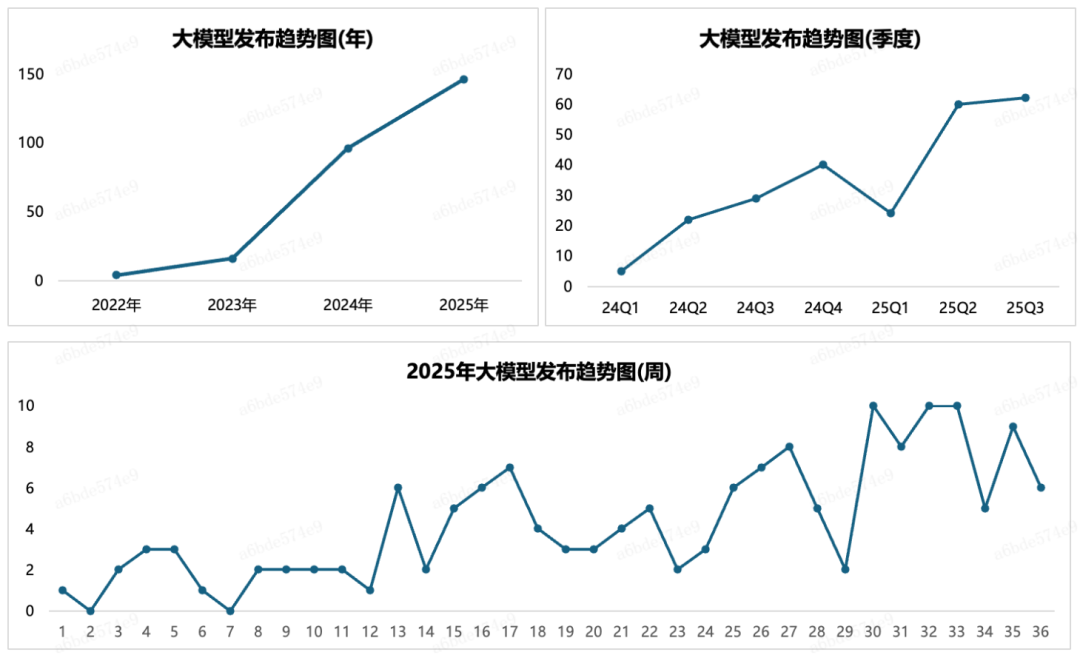
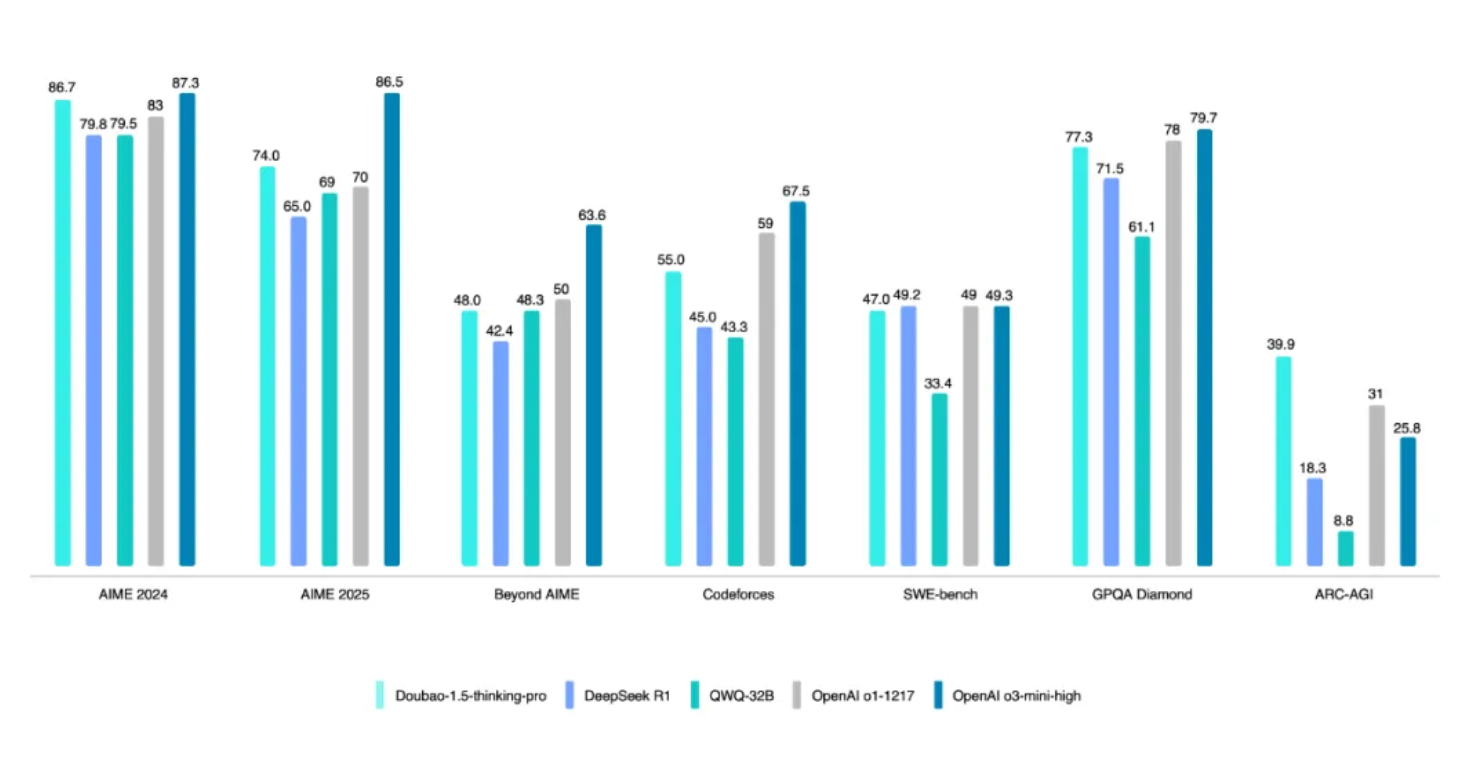
导读 2023 年被称为大模型元年,但真正让人记住的模型并不多。到了 2024 年,技术与应用的双重驱动,让大模型进入前所未有的“快车道”。2025 年初,DeepSeek 的爆火更是点燃了全球的热情,每周都有数个乃至十余个新模型问世,文本、语音、图像、视频全线开花。可是在这琳琅满目的发布与宣传中,谁才是真正的 SOTA?通用榜单、技术报告的数据真的可靠么?面对眼花缭乱的分数、榜单与宣传语,企业和开发者又该如何选型?这篇文章带你穿梭大模型“井喷之年”的浪潮,揭开榜单背后的真相,并分享一套面向业务实践的评测方法论。读完之后,你也许会发现:选模型,不只是追逐最新的名字,而是一次关乎判断力与洞察力的考验。文末有惊喜! 01 大模型井喷之年 作为大模型元年的 2023 年,虽然有百余款模型发布,但是经过 2024 年的应用实践的洗礼之后,真正被大家记住的大模型并不多。随着技术与应用的双重驱动,在 2024 年 Q4,我们发现大模型的发布数量、发布速度都呈现除了前所未有的规模。尤其是在 DeepSeek 火爆全球的 2025 年 Q1,大模型更是呈现出了井喷之势,几乎所有的场景,无论是文本、推理、语音、图片、视频,都会不停地有新的 SOTA 模型发布,模型之间的竞争也逐渐呈现白热化态势。 2025 年之前的数据可以参考: https://x.com/i/grok?conversation=1897145549750718640。 在 2025 年 3 月,我们提出这个春天是大模型的春天,在这个大模型的春天里,乱花渐欲迷人眼,处处早莺争暖树。今天,当再次回顾年初的判断时,我们虽然猜到了大模型白热化竞争的趋势,但是依然没有猜到竞争会如此之快、如此之烈。 当时我们认为,2025年,每周至少会有1款大模型发布,但是在第 30 周 ~ 第 33 周的这4周时间里,有 3 周每周都有 10 款大模型发布。大模型的发布周期慢慢的从“年”为单位,提升到“月”为单位。 通过下图的文心系列大模型的发布节奏能够看出,文心系列大模型的发布节奏从之前的“年度”发布已经提升到“月度”发布。对于 Wan 系列的开源视频生成大模型而言,也能看出,Wan 系列模型的迭代周期也已经达到了“月度”发布。 02 究竟谁才是真正的SOTA? 正如 Dr Singularity前几天发的一篇帖子那样:每个小时,都会有人发布新的模型、新的测试基准、新的突破。每个小时,也总有新的 SOTA 出现,那么究竟谁才是真正的 SOTA 呢?我们如何从繁花般的 SOTA 中汲取技术上的优势,以便可以应用于自己的模型研发?在如此林立的 SOTA 中,我们又将如何选择最适用于业务场景的模型? 根据我们的观察,每次模型发布的时候,在模型效果的评估上往往会有三种操作:不同的数据集、不同的指标、不同的竞对,从而能够从数据上说明自己确实是 SOTA。 2.1 视频大模型技术报告中的评估报告 在新的 Wan-Bench 2.0 (指标相对较少)上的评估表明,Wan2.2 在多个关键维度上的性能优于对应的闭源、商业模型。 潞晨科技的 Open-Sora2: 在竞对的选取和指标的选取上更有目标性,整体得分达到开源模型第一,直逼闭源的 OpenAI Sora。 腾讯混元图生视频:选择的指标相对较少,选择的竞品没有包含开源的万相 2.1以及可灵1.6。 2.2 视觉理解大模型技术报告中的评估报告 总能找到自己能力最强的数据集,像视频理解 VideoMME 数据集,豆包得分是 74.1,明显比 Qwen2.5-VL 好,但是竞对选择上没有豆包。 MiniMax-VL-01:MMMU,MMMU-Pro 数据集虽然不是第一但是也不差,其他数据集优势非常明显。 Gemma 3 27B:什么数据集也不用了,直接上了 LLM Arena 的主观对抗打分。 所以,在实际的大模型评估过程中,总能找到特定的数据集、特定的指标和特定的对比对象,使得从数据上看,新发布的模型性能看起来就是 SOTA。 2.3 琳琅满目的通用榜单 如果说技术报告中的性能对比会存在偏差,那么通用榜单应该是靠谱的吧?还记得今天 2 月底,Wan2.1 是如何一炮走红、火爆全网的不?当时,Wan2.1 的宣传语就是:权威评测集 VBench 的信息显示,Wan2.1 大模型大幅领先 Sora、HunyuanVideo、Minimax、Luma、Gen3、Pika 等国内外视频生成模型,以总分 86.22% 的成绩登上榜首位置,成为视频生成领域的全新标杆。 仔细看当时的 Vbench 榜单,我们就会发现,虽然 Wan2.1 确实位于榜首,但是榜单中的 KLING 用的是 24 年 7 月份的模型。 对于其他的榜单,例如 AGI-Eval 和 SuperCLUE的文生视频榜单,或者缺乏最新的模型,或者对比的模型不一致,这导致了同样的模型,在不同的榜单中的排名并不一致。 所以,即便想采用通用榜单来评估模型的性能,因为不同的榜单评测方法、评测数据集存在很大的差异,因此也会得到不同的结果,这确实是一件令人非常困惑的事情。 2.4 对于业务,我们该如何决策? 一方面,面对快速发展、甚至是竞争白热化的大模型技术;另一方面,面对如此众多的榜单和SOTA模型。当面临模型选型的时候,作为业务方,我们又当如何决策? 创意生成提示词 卡通漫画风格,舞台上聚光灯聚焦,四大巨型机器人——豆包、通义万相、OpenAI、腾讯混元,高举“业界第一”横幅,头部醒目位置嵌入各自公司标志。机器人设计独特,色彩鲜艳,充满未来感。台下人类观众表情困惑,眼神交流中满是疑问,头部上方飘浮着大大的问号,展现他们内心的犹豫与不解。背景是繁华的发布会场,两侧AI技术海报林立,增添科技氛围。整体画面色彩对比强烈,表情夸张,强化幽默讽刺效果。采用近景舞台视角,特写机器人与观众互动瞬间,捕捉戏剧性场面。 03 基于业务的大模型评测实践 如前所述,对于业务而言,技术报告中的评估结果以及通用榜单并不能提供全面、有效的决策信息。 正如 skcd 在 8 月 29 日发布的一条宣传 Grok-code-fast-1 的帖子说的那样:在实际使用中,基准测试确实只能提供有限的信息。 When I joined the coding team, the team was just 3 people and we very quickly built a model which was SOTA on SWEBench. But as things go, in the real world benchmarks matter less. 为此,我们从评测数据集的构建、评估指标、评估方法等多个方面进行优化与实践,探索出了一套适合业务的、置信的大模型评估体系。同时,为了提高整个评估过程的效率,我们也探索了数据集的自动化构建流程、模型效果自动打分等相关的自动化机制。 3.1 评测数据集的构建 评测本质上是一个“抽样”的过程,不同的样本会严重影响到最终的评测结果。为了保障评测结果能够反映出不同模型在业务实际使用场景下的真实表现,同时也为了避免模型可能会在训练阶段学习到了部分的榜单数据,我们从三个维度构建了自己的评测数据集。 从业务侧富集数据集:这部分数据集不会做大的调整,仅会做细微的修改,比如优化语言表述、优化数据集中存在的明显的错误的表述 业务侧数据集的泛化数据集:对业务侧富集到的数据集进行分析,并根据分析结果进行数据集的泛化,例如通过大模型生成相似数据集、生成同一个问题的变体描述等 业界通用数据集的泛化数据集:对通用数据集中的原始评测样本进行一定的处理,比如英文样本转换成中文样本、题目选项进行变换、题目中的数据进行修改…… 以 MMMU 数据集中的样本为例,不同泛化方式的区别如下表所示。 3.2 自动获取模型结果 针对不同类型的大模型评估,评估集所包含的数据集量级也不同,在实践中,我们的文本评估集数据量级为 1000,图片评估集数据量级为 500,视频评估集数据量级为 200。每次评估,我们一般会选择 3~5 个模型进行对比评估。 从数据获取效率方面看: 每次评估,我们需要获取上千个QUERY的模型结果,因此如何快速的获取这些QUERY的结果是影响评测效率的关键环节。 同时,虽然现在大部分大模型都支持OpenAI API格式,但是也存在不支持该格式的大模型。 再者,不同的大模型厂商提供的API的限流策略和 API KEY,因此在获取大模型的结果数据时,如何对这些大模型 API 进行高效的管理也将影响着最终的评测效率。 在评测的实践中,我们发现对于同时提供 API 接口 和 WEB 页面两种服务方式的大模型而言,不同的服务方式获取到的结果会存在差异,例如 WEB 页面一般会提供 联网搜索的功能,但是 API 却没有该功能。 针对如上的问题,我们自研了模型管理平台,该平台支持以API和WEB两种方式自动化获取各种大模型的响应结果。 对于 API而言,平台实现了从数据拼装、模型结果获取到解析、性能统计(首 token 耗时、推理耗时、总 token数等)等全流程管理,可通过模型配置快速接入新模型,可自由定制不同模型实现高并发快速获取模型结果。 3.3 LLM as Judge 的评估方法 在 2024 年 9 月分的时候,我们对发布在 arXiv 上的和大模型评估有关的论文进行了分析,我们提取了提交时间位于 2023 年 4 月至 2024 年 9 月这个区间的 130+ 篇论文进行了分析发现:有 23% 的论文在研究如何利用大模型来评估大模型的效果 在过去的 12 个月内,arXiv 上与 LLM-as-a-Judge相关的论文更是有 700+ 篇,平均每天就有 2 篇论文在研究该课题。 因此,我们认为采用大模型来评估大模型具备一定的可行性。 虽然,近期也有学者不断提出:LLM as a Judge 的方式并不靠谱,例如: 2025 年 8 月,Neither Valid nor Reliable? Investigating the Use of LLMs as Judges 这篇论文中提到:LLMs 是人类判断的有效代理 (LLMs as a Proxy for Human Judgment),只要AI裁判的评分和人类专家的评分高度相关,就证明 LLM as a Judge 是有效的,但这个逻辑链条的起点,所谓“人类判断”这个金标,本身就是摇摇欲坠的。既然“人类判断”这个金标本身就存在问题,那么在这个基础之上构建的 LLM as a Judge 也就并非那么靠谱。 2025 年 8 月,上海上海交通大学的学者在 PersonaEval: Are LLM Evaluators Human Enough to Judge Role-Play? 这篇论文中也提到:即便是表现最好的模型Gemini-2.5-pro,其准确率仅为68.8%,而人类实验组的平均准确率为90.8%。目前的LLM裁判,还远不够“拟人”,不足以可靠地评判角色扮演。对模型进行角色相关的微调,不仅没有提升其角色识别能力,反而可能导致性能下降。 但是,根据我们的时间,在评估标准详细且无二义性的前提下,LLM as a Judge 的方式在评估中还是相对靠谱的。在实践中,我们采用了 Prompt Enginning 和SFT这两种方式是实现 LLM as a Judge。 基于千帆平台进行模型微调的流程和效果如下所示: △微调的流程 △微调的数据集示例 在视频生成大模型的评估中,我们采用了 Dacheng Li 等人 基于 Qwen2-VL-2B 微调的 WorldModelBench 模型作为物理规则检测的裁判员模型,虽然准确率只有 65% 左右,但是确实能比较好的、高效的检测出部分场景下的物理规则问题。 04 大模型评测五条原则 4.1 评测样本必须无歧义 评测数据集中的样本描述必须是准确的、无歧义的,存在歧义的样本无法保证最终的评估结论的准确性。 最典型的就是 OpenAI 在 24 年 8 月 发布的 SWE-bench Verified 数据集,OpenAI 认为 ****原始 SWE-bench 低估了大模型在代码方面的能力,****于是对该数据进行了重新标注并构建了 SWE-bench Verified 数据集。在整个标注的过程中,OpenAI 发现:原始 SWE-bench 中的样本有很大一部分是不合格的。 构建图片理解评测样本时的样本歧义举例: 4.2 评测样本必须覆盖模型的新增能力 模型在不断优化的过程中,会针对特定场景进行优化,评测的样本必须能够覆盖这些特定场景,否则就无法对模型性能进行正确的评估。 我们在不同的评估集上对万相 2.1 和可灵 1.6 进行了评估,却得出了不同的结论。 4.3 评测样本必须分场景组织 在 3 月 15 日,评估 EB4.5 的图片理解能力的时候,我们在两个数据集上得到了完全不同的结论: 4.4 评测样本中大模型生成结果的参数必须明确 在评测中,我们发现,虽然是相同的模型,对于同样的 Query,不同的渠道获得的结果并不相同,因此在评测时,必须明确产生当前结果的模型的参数。 推理模型,如果是 API 访问模型,会缺少联网搜索的能力 如果是 WEB 访问模型,则可以增加联网搜索能力 4.5 评估样本必须细化打分准则,不能只打整体分 只进行整体评估容易忽略模型的在特殊场景下的优势,也容易忽略模型在特殊场景下的缺点。 对于 Vbench 榜单,对于不同的视频生成模型,从单维度打分来看,不同模型之间有很大的区别。但是从总分来,模型之间的差距反而变的不明显了(80%~86%之间的模型有30+个)。 从数学的角度看待分维度打分的必要性。 05 本周有新的大模型发布的概率是多少?

优秀的个人博客,低调大师

了解 Transformers 是如何“思考”的

Transformer 模型是 AI 系统的基础。已经有了数不清的关于 "Transformer 如何工作" 的核心结构图表。 但是这些图表没有提供任何直观的计算该模型的框架表示。当研究者对于 Transformer 如何工作抱有兴趣时,直观的获取他运行的机制变得十分有用。 Thinking Like Transformers 这篇论文中提出了 transformer 类的计算框架,这个框架直接计算和模仿 Transformer 计算。使用 RASP 编程语言,使每个程序编译成一个特殊的 Transformer。 在这篇博客中,我用 Python 复现了 RASP 的变体 (RASPy)。该语言大致与原始版本相当,但是多了一些我认为很有趣的变化。通过这些语言,作者 Gail Weiss 的工作,提供了一套具有挑战性的有趣且正确的方式可以帮助了解其工作原理。 !pip install git+https://github.com/srush/RASPy 在说起语言本身前,让我们先看一个例子,看看用 Transformers 编码是什么样的。这是一些计算翻转的代码,即反向输入序列。代码本身用两个 Transformer 层应用 attention 和数学计算到达这个结果。 def flip(): length = (key(1) == query(1)).value(1) flip = (key(length - indices - 1) == query(indices)).value(tokens) return flip flip() 文章目录 第一部分:Transformers 作为代码 第二部分:用 Transformers 编写程序 Transformers 作为代码 我们的目标是定义一套计算形式来最小化 Transformers 的表达。我们将通过类比,描述每个语言构造及其在 Transformers 中的对应。(正式语言规范请在本文底部查看论文全文链接)。 这个语言的核心单元是将一个序列转换成相同长度的另一个序列的序列操作。我后面将其称之为 transforms。 输入 在一个 Transformer 中,基本层是一个模型的前馈输入。这个输入通常包含原始的 token 和位置信息。 在代码中,tokens 的特征表示最简单的 transform,它返回经过模型的 tokens,默认输入序列是 "hello": tokens 如果我们想要改变 transform 里的输入,我们使用输入方法进行传值。 tokens.input([5, 2, 4, 5, 2, 2]) 作为 Transformers,我们不能直接接受这些序列的位置。但是为了模拟位置嵌入,我们可以获取位置的索引: indices sop = indices sop.input("goodbye") 前馈网络 经过输入层后,我们到达了前馈网络层。在 Transformer 中,这一步可以对于序列的每一个元素独立的应用数学运算。 在代码中,我们通过在 transforms 上计算表示这一步。在每一个序列的元素中都会进行独立的数学运算。 tokens == "l" 结果是一个新的 transform,一旦重构新的输入就会按照重构方式计算: model = tokens * 2 - 1 model.input([1, 2, 3, 5, 2]) 该运算可以组合多个 Transforms,举个例子,以上述的 token 和 indices 为例,这里可以类别 Transformer 可以跟踪多个片段信息: model = tokens - 5 + indices model.input([1, 2, 3, 5, 2]) (tokens == "l") | (indices == 1) 我们提供了一些辅助函数让写 transforms 变得更简单,举例来说,where 提供了一个类似 if 功能的结构。 where((tokens == "h") | (tokens == "l"), tokens, "q") map 使我们可以定义自己的操作,例如一个字符串以 int 转换。(用户应谨慎使用可以使用的简单神经网络计算的操作) atoi = tokens.map(lambda x: ord(x) - ord('0')) atoi.input("31234") 函数 (functions) 可以容易的描述这些 transforms 的级联。举例来说,下面是应用了 where 和 atoi 和加 2 的操作 def atoi(seq=tokens): return seq.map(lambda x: ord(x) - ord('0')) op = (atoi(where(tokens == "-", "0", tokens)) + 2) op.input("02-13") 注意力筛选器 到开始应用注意力机制事情就变得开始有趣起来了。这将允许序列间的不同元素进行信息交换。 我们开始定义 key 和 query 的概念,Keys 和 Queries 可以直接从上面的 transforms 创建。举个例子,如果我们想要定义一个 key 我们称作 key。 key(tokens) 对于 query 也一样 query(tokens) 标量可以作为 key 或 query 使用,他们会广播到基础序列的长度。 query(1) 我们创建了筛选器来应用 key 和 query 之间的操作。这对应于一个二进制矩阵,指示每个 query 要关注哪个 key。与 Transformers 不同,这个注意力矩阵未加入权重。 eq = (key(tokens) == query(tokens)) eq 一些例子: 选择器的匹配位置偏移 1: offset = (key(indices) == query(indices - 1)) offset key 早于 query 的选择器: before = key(indices) < query(indices) before key 晚于 query 的选择器: after = key(indices) > query(indices) after 选择器可以通过布尔操作合并。比如,这个选择器将 before 和 eq 做合并,我们通过在矩阵中包含一对键和值来显示这一点。 before & eq 使用注意力机制 给一个注意力选择器,我们可以提供一个序列值做聚合操作。我们通过累加那些选择器选过的真值做聚合。 (请注意:在原始论文中,他们使用一个平均聚合操作并且展示了一个巧妙的结构,其中平均聚合能够代表总和计算。RASPy 默认情况下使用累加来使其简单化并避免碎片化。实际上,这意味着 raspy 可能低估了所需要的层数。基于平均值的模型可能需要这个层数的两倍) 注意聚合操作使我们能够计算直方图之类的功能。 (key(tokens) == query(tokens)).value(1) 视觉上我们遵循图表结构,Query 在左边,Key 在上边,Value 在下面,输出在右边 一些注意力机制操作甚至不需要用到输入 token 。举例来说,去计算序列长度,我们创建一个 " select all " 的注意力筛选器并且给他赋值。 length = (key(1) == query(1)).value(1) length = length.name("length") length 这里有更多复杂的例子,下面将一步一步展示。(这有点像做采访一样) 我们想要计算一个序列的相邻值的和,首先我们向前截断: WINDOW=3 s1 = (key(indices) >= query(indices - WINDOW + 1)) s1 然后我们向后截断: s2 = (key(indices) <= query(indices)) s2 两者相交: sel = s1 & s2 sel 最终聚合: sum2 = sel.value(tokens) sum2.input([1,3,2,2,2]) 这里有个可以计算累计求和的例子,我们这里引入一个给 transform 命名的能力来帮助你调试。 def cumsum(seq=tokens): x = (before | (key(indices) == query(indices))).value(seq) return x.name("cumsum") cumsum().input([3, 1, -2, 3, 1]) 层 这个语言支持编译更加复杂的 transforms。他同时通过跟踪每一个运算操作计算层。 这里有个 2 层 transform 的例子,第一个对应于计算长度,第二个对应于累积总和。 x = cumsum(length - indices) x.input([3, 2, 3, 5]) 用 transformers 进行编程 使用这个函数库,我们可以编写完成一个复杂任务,Gail Weiss 给过我一个极其挑战的问题来打破这个步骤:我们可以加载一个添加任意长度数字的 Transformer 吗? 例如: 给一个字符串 "19492+23919", 我们可以加载正确的输出吗? 如果你想自己尝试,我们提供了一个 版本 你可以自己试试。 挑战一:选择一个给定的索引 加载一个在索引 i 处全元素都有值的序列 def index(i, seq=tokens): x = (key(indices) == query(i)).value(seq) return x.name("index") index(1) 挑战二:转换 通过 i 位置将所有 token 移动到右侧。 def shift(i=1, default="_", seq=tokens): x = (key(indices) == query(indices-i)).value(seq, default) return x.name("shift") shift(2) 挑战三:最小化 计算序列的最小值。(这一步开始变得困难,我们版本用了 2 层注意力机制) def minimum(seq=tokens): sel1 = before & (key(seq) == query(seq)) sel2 = key(seq) < query(seq) less = (sel1 | sel2).value(1) x = (key(less) == query(0)).value(seq) return x.name("min") minimum()([5,3,2,5,2]) 挑战四:第一索引 计算有 token q 的第一索引 (2 层) def first(q, seq=tokens): return minimum(where(seq == q, indices, 99)) first("l") 挑战五:右对齐 右对齐一个填充序列。例:"ralign().inputs('xyz___') ='—xyz'" (2 层) def ralign(default="-", sop=tokens): c = (key(sop) == query("_")).value(1) x = (key(indices + c) == query(indices)).value(sop, default) return x.name("ralign") ralign()("xyz__") 挑战六:分离 把一个序列在 token "v" 处分离成两部分然后右对齐 (2 层): def split(v, i, sop=tokens): mid = (key(sop) == query(v)).value(indices) if i == 0: x = ralign("0", where(indices < mid, sop, "_")) return x else: x = where(indices > mid, sop, "0") return x split("+", 1)("xyz+zyr") split("+", 0)("xyz+zyr") 挑战七:滑动 将特殊 token "<" 替换为最接近的 "<" value (2 层): def slide(match, seq=tokens): x = cumsum(match) y = ((key(x) == query(x + 1)) & (key(match) == query(True))).value(seq) seq = where(match, seq, y) return seq.name("slide") slide(tokens != "<").input("xxxh<<<l") 挑战八:增加 你要执行两个数字的添加。这是步骤。 add().input("683+345") 分成两部分。转制成整形。加入 “683+345” => [0, 0, 0, 9, 12, 8] 计算携带条款。三种可能性:1 个携带,0 不携带,< 也许有携带。 [0, 0, 0, 9, 12, 8] => “00<100” 滑动进位系数 “00<100” => 001100" 完成加法 这些都是 1 行代码。完整的系统是 6 个注意力机制。(尽管 Gail 说,如果你足够细心则可以在 5 个中完成!)。 def add(sop=tokens): # 0) Parse and add x = atoi(split("+", 0, sop)) + atoi(split("+", 1, sop)) # 1) Check for carries carry = shift(-1, "0", where(x > 9, "1", where(x == 9, "<", "0"))) # 2) In parallel, slide carries to their column carries = atoi(slide(carry != "<", carry)) # 3) Add in carries. return (x + carries) % 10 add()("683+345") 683 + 345 1028 完美搞定! 参考资料 & 文内链接: 如果你对这个主题感兴趣想了解更多,请查看论文:Thinking Like Transformers 以及了解更多 RASP 语言 如果你对「形式语言和神经网络」(FLaNN) 感兴趣或者有认识感兴趣的人,欢迎邀请他们加入我们的 线上社区! 本篇博文,包含库、Notebook 和博文的内容 本博客文章由 Sasha Rush 和 Gail Weiss 共同编写 <hr> 英文原文:Thinking Like Transformers 译者:innovation64 (李洋)


优秀的个人博客,低调大师

实例讲解:React Hook的思考

翻译原文:https://wattenberger.com/blog/react-hooks React在一年前引入了hooks,对于许多开发人员来说,它们已经改变了我们的编码习惯,但我想谈一谈从React类组件切换到功能组件基本变化。 使用类组件,我们将更新放置在特定的生命周期事件中 ❝ 类组成中 ❞ classChartextendsComponent{componentDidMount(){//挂载时}componentDidUpdate(prevProps){if(prevProps.data==props.data)return//数据更新时}componentWillUnmount(){//卸载时}render(){return(<svgclassName="Chart"/>)}} 在功能组件中,我们改为使用useEffect挂钩在主要生命周期事件期间运行代码。 ❝ 功能组件中 ❞ constChart=({data})=>{useEffect(()=>{//挂载时//数据更新时return()=>{}},[data])return(<svgclassName="Chart"/>)} 此时,您可能在想:所以,useEffect() 这只是一种进入生命周期事件的新方法!但是这种理解是错误的! 嗯,让我们看一个具体的例子,看看有什么区别。例如,如果我们有一个计算量大的 getDataWithinRange()函数,该函数基于指定的函数返回经过过滤的数据集,该dateRange怎么办?因为getDataWithinRange()运行需要一些时间,所以我们希望将其存储在组件的state对象中,并且仅在dateRange发生更改时进行更新。 类组成: 对于生命周期事件,我们需要一站式处理所有更改。我们的想法如下所示: 当我们的组件加载时,以及props更改时(其实就是dateRange),就相对的更新data 大致如下: classChartextendsComponent{state={data:null,}componentDidMount(){constnewData=getDataWithinRange(this.props.dateRange)this.setState({data:newData})}componentDidUpdate(prevProps){if(prevProps.dateRange!=this.props.dateRange){constnewData=getDataWithinRange(this.props.dateRange)this.setState({data:newData})}}render(){return(<svgclassName="Chart"/>)}} 功能组成 在功能组件中,我们需要考虑哪些值保持同步。每次更新的流程更像以下语句: 保持dateRange同步data 大致如下: constChart=({dateRange})=>{const[data,setData]=useState()useEffect(()=>{//假设getDataWithinRange在外部定义了,暂时不考虑这个constnewData=getDataWithinRange(dateRange)setData(newData)},[dateRange])return(<svgclassName="Chart"/>)} 看到将变量保持同步的方式简单多了是吗?不仅仅是代码量减少了! 类组成 classChartextendsComponent{state={data:null,}componentDidMount(){constnewData=getDataWithinRange(this.props.dateRange)this.setState({data:newData})}componentDidUpdate(prevProps){if(prevProps.dateRange!=this.props.dateRange){constnewData=getDataWithinRange(this.props.dateRange)this.setState({data:newData})}}render(){return(<svgclassName="Chart"/>)}} 功能组成 实际上,最后一个示例仍在类组件中。我们存储data是state为了防止每次组件更新时重新计算它。 但是我们不再需要使用state!而是使用useMemo(),仅data当其依赖项数组更改时才会重新计算。 constChart=({dateRange})=>{constdata=useMemo(()=>(getDataWithinRange(dateRange)),[dateRange])return(<svgclassName="Chart"/>)} ❝ 注意,我们可以只在函数内部定义变量。 ❞ constChart=({dateRange})=>{constnewData=getDataWithinRange(dateRange)return(<svgclassName="Chart"/>)} 除非我们的getDataWithinRange()函数在计算上消耗很大,否则这就是非常完美。我平时使用useMemo用的非常多,特别是在处理大型数据集时,以保持性能。 考虑使用context 想象一下,我们有许多需要计算的值,但是它们取决于不同的props。例如,我们需要计算: 我们 data在我们的 dateRange变化 的 dimensions图表的时 margins变化 我们 scales在我们的 data变化 类组成 classChartextendsComponent{state={data:null,dimensions:null,xScale:null,yScale:null,}componentDidMount(){constnewData=getDataWithinRange(this.props.dateRange)this.setState({data:newData})this.setState({dimensions:getDimensions()})this.setState({xScale:getXScale()})this.setState({yScale:getYScale()})}componentDidUpdate(prevProps,prevState){if(prevProps.dateRange!=this.props.dateRange){constnewData=getDataWithinRange(this.props.dateRange)this.setState({data:newData})}if(prevProps.margins!=this.props.margins){this.setState({dimensions:getDimensions()})}if(prevState.data!=this.state.data){this.setState({xScale:getXScale()})this.setState({yScale:getYScale()})}}render(){return(<svgclassName="Chart"/>)}} 功能组成 在我们的功能组件中,我们只需要简单的几句: constChart=({dateRange,margins})=>{constdata=useMemo(()=>(getDataWithinRange(dateRange)),[dateRange])constdimensions=useMemo(getDimensions,[margins])constxScale=useMemo(getXScale,[data])constyScale=useMemo(getYScale,[data])return(<svgclassName="Chart"/>)} 在我们的示例中,我们的类组件为什么会笨拙? 这是因为我们有很多的声明代码来去同步变量props和state,但在功能组件,我们只注重什么保持同步。 平时尽可能使用useMemo()钩子-让我们来实现功能效果。 现在再来一个需求 好的!继续前进-如果我们scales需要根据dimensions图表的图表进行更改怎么办? 类组成 在我们的类组件中,我们需要比较我们prevState和current state classChartextendsComponent{state={data:null,dimensions:null,xScale:null,yScale:null,}componentDidMount(){constnewData=getDataWithinRange(this.props.dateRange)this.setState({data:newData})this.setState({dimensions:getDimensions()})this.setState({xScale:getXScale()})this.setState({yScale:getYScale()})}componentDidUpdate(prevProps,prevState){if(prevProps.dateRange!=this.props.dateRange){constnewData=getDataWithinRange(this.props.dateRange)this.setState({data:newData})}if(prevProps.margins!=this.props.margins){this.setState({dimensions:getDimensions()})}if(prevState.data!=this.state.data||prevState.dimensions!=this.state.dimensions){this.setState({xScale:getXScale()})this.setState({yScale:getYScale()})}}render(){return(<svgclassName="Chart"/>)}} 功能组成 constChart=({dateRange,margins})=>{constdata=useMemo(()=>(getDataWithinRange(dateRange)),[dateRange])constdimensions=useMemo(getDimensions,[margins])constxScale=useMemo(getXScale,[data,dimensions])constyScale=useMemo(getYScale,[data,dimensions])return(<svgclassName="Chart"/>)} 是不是爽歪歪! 保持代码简洁 较短的代码不一定更易于阅读,但是使我们的组件尽可能地整洁无疑是一个优势! 最后 关注我们添加【前端进阶技术群】,回复:【资料包】领取前端进阶资料包 在看、转发支持作者❤️ 本文分享自微信公众号 - 前端人(FrontendPeople)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

业务开发的思考与提升

业务开发:永远被业务驱使或者强奸,越来越忙,支持业务越来越疲于奔命。产品、业务上线快,bug也很多。 这可能是大多数业务开发的写照吧,换了份工作之后,自己也是一直在写业务相关的东西,想说说最近业务开发的经历 每天都在做什么 经常做的是熟悉需求、梳理业务、新的,旧的系统功能点、讨论、写代码。而写业务代码,基本上用到的都是公司封装好的框架,使用起来简化了很多开发步骤,并且根基本上是参照之前代码的写法。 熟悉需求,肯定要做新功能啊,但是新功能从最老大的哪里提出来,产品梳理好之后告诉我们,开发不在第一线,产品与开发各自分工,文档给了开发,要做功能,只有梳理需求,需求文档基本上在整个开发过程都用得到。 梳理业务,新员工都要熟悉公司的业务,时间比较久的公司业务复杂,所以需要梳理。 新、旧系统功能点,也在和梳理业务,需求有很密切的关系,旧系统的功能是超级多的,有需要的都要看。新功能要理 讨论,需求宣讲会,功能点讨论,设计方案讨论等, 完全取决于会议是否高效 写代码,比重不是很大,但一切都要落实到代码上,写代码才能实现需求啊。 总的感觉,不是像网上传的天天码代码,熬夜加班, 这里基本不存在。反而觉得写业务代码太简单...梳理流程重要而且复杂,麻烦。 写业务代码对技术要求不高,公司提供的基础设施比较丰富。 既然是业务开发,那就是业务很复杂,觉得都在试着理解业务。业务代码一个旧的模块几十万行代码,几百个对外服务接口,调用其它模块也很多。而重构是我们要做的事,梳理几十万行代码。 如何提升自己 业务方面每个公司的业务都不同,而写业务代码技术不会有太多提高,所有的业务依赖的都是技术。 提升技术能力,研究轮子,自己造轮子,或造产品 提升对业务的理解能力,如下建议,优化业务架构 业务开发:除了满足产品提出的各种需求外,需要给留20%-40%的时间(用加班也行),想着怎样优化本身的业务架构:如怎样提升原来设计不合理的架构,优化之,提升稳定性、性能(容量)。一些通用的架构,需要提交到架构组,讨论方案。个人认为,能满足未来至少3年以上需求的架构方案,才算合格。 针对自己的情况,我时间还算过得去,这些时间取决于自己怎么利用,最终会产生不同的结果 早上:7点30左右到公司,到9点的时候都可以试着钻研一些技术相关的东西 晚上:20点多点以后基本上都是自己的时间 坚持做一件有意义的能让自己成长的事吧 最后 共勉,早日实现程序员的百万年薪!

优秀的个人博客,低调大师

架构设计的几点思考

软件架构的意义 软件架构的意义是什么,有很多不同的理解和争议,这里不想就软件架构的意义给出完整的定义,而是想聊聊其中的一点:软件架构是沟通 (Architecture is communication),关于软件架构的更多意义,建议参考这篇别人的旧文。 为什么软件架构意味着沟通呢?因为软件工程本身是一个组织一群人为了一个问题进行创造性劳动的过程,因为软件工程本身的特点,所以沟通的重要性是软件工程区别于传统工程的一个显著特点。关于这一点,我之前的帖子已经解释过,这里不再展开。 什么样的架构有利于沟通呢? 在回答这个问题之前,我们先来看一张图。 如果汽车设计师通过这张图来向其他人解释汽车是什么的时候,我想除了相关的专家不会有人能够轻易理解每个部件在整个汽车中的用途,以及他们是如何在一起工作的。 为什么呢?在《金字塔原理》这本书里提到,人一次能够理

优秀的个人博客,低调大师

通过IO模型带来的思考

IO模型 对于IO,我们经常可以听到诸如同步阻塞IO,同步非阻塞IO,异步IO等等,那么什么是异步/同步,什么是阻塞/非阻塞?首先一次IO在UNIX系统中分为两个步骤 1.发起IO请求:用户线程向操作系统内核发起IO请求 2.执行IO操作:当内核准备好数据可以提交给发起IO请求的线程 阻塞/非阻塞的区别:发起IO请求之后会一直等待直到获取数据则是阻塞,否则是非阻塞 同步/异步的区别:获取到的数据是自己主动拿到的则是同步,是被动拿到的则是异步 下面我用取快递这个例子来介绍一下UNIX的五种IO模型 众所周知吸管喝饮料分为两个步骤:1.打开快递柜(发起IO请求),2.取走快递(执行IO操作) 同步&阻塞IO 打开快递柜(发起IO请求),如果快递柜里没有东西(内核没有准备好数据),则一直等在快递柜旁等快递来(阻塞直到内核准备好数据),快递柜有了快

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册