首页 文章 精选 留言 我的

精选列表

搜索[思考控制],共10005篇文章
优秀的个人博客,低调大师

网页多模态建模思考

导读 本文从网页理解业务出发,从多模态信息融合,预训练任务构建角度,探讨通用网页建模方案。首先,指出网页的特殊性,即从不同观察视角下,网页存在富文本、树形结构,和图层堆叠三种形态。在此基础上,对比了多种多模态融合思路的优缺点,给出一种较好的方案。进一步,提出多粒度、多维度的网页预训练方案;最后,探索了大模型时代,利用现有多模态模型,低成本的适配到网页的一种可行思路。 01 综述 网页本质上是一种超文本,一般由超文本标记语言来定义(例如HTML)。HTML是一种基础技术,常与CSS、JavaScript一起被众多网站用于设计网页、网页应用程序以及移动应用程序的用户界面 。网页浏览器内核通过解释HTML文件,通过视觉引擎将其渲染成可视化网页。 由于HTML的复杂性特点,使得网页体现出多模态性,多粒度性,并且这些模态内部存在复杂的对应关系。 多模态性 所谓多模态性,即从不同视角下,网页体现出不同的形态。从信息载体角度看,它是文本、图像、视频等多媒体元素集合。从视觉层面看,它拥有图层的概念,是各层图像堆叠起来形成了一张完整的“图片”。从底层代码逻辑看,它是一种特殊的类XML语言,定义了一棵具有层次关系的树(dom-tree)。 多粒度性 所谓多粒度性,即网页无论从哪种模态看,都是由粒度不等的元素组成的。 以资讯类网页举例,从信息载体模态看,网页由段落组成,段落又由句子组成,句子由tokens组成; 从视觉层面,网页由不同尺寸的图层,依次堆叠而成; 从底层代码逻辑看,html由不同高度以及大小的子树构成。 内在的对齐逻辑 多种模态的基本元素之间,存在多对多的对齐关系。 对于dom-tree的结点,对应视觉层面的一个图层,亦可对应着一个或者多个句子 一个句子,可能对应着一个结点,也可能对应着多个结点 一个例子:多模态的网页表示 △语义:句子{图像、视频等可文本化)的集合 △结构:dom结点构成的树 △视觉:图层的叠加(轮廓图) 由于网页的多模态性,多粒度性,以及潜在对齐关系的特点,使得对网页的建模,与对富文本的建模思路有着显著的不同。如果将网页作为富文本处理,会丢失大量的信息 举一个简单的例子,一个文本位于网页的不同位置(譬如正文区域,推荐区域),它的重要性是完全不一样的。 而复杂的业务下游应用,例如网页质量甄别,网页结构化分块等,仅依赖文本的语义信息是远远不够的,需要综合考虑多模态的信息,以及多模态间的对齐信息。 下面,结合业界研究和我们的探索,从多模态信息融合、预训练方案方面展开。最后,探讨LLM时代,网页多模态模型的可能的探索方向。 02 多模态多粒度特征融合 如何将多粒度,多模态的特征融合,是一个复杂的问题。 1. 多粒度信息的表示 这个部分,业内解决方案较多。 对语义信息建模,基于hierarchical attention的有较多方案。一种方式,是通过bert等编码器,输入tokens,取CLS单元输出作为句子的向量表示;再通过transformer结构,输入句子向量,计算句子间attention,得到句子以及篇章的稠密向量表示,用于下游任务。 对于结构建模,以html-dom为基本单元。通过全连接层,融合bounding box坐标、webkit提取的css style信息等。 对于视觉建模,可以基于vit,以patch为基本单元。 2. 多对多对应关系下,多模态信息融合 这部分,相关研究主要有四种方案:顶层融合,底层融合、多模态统一建模以及多模态交叉attention的方案。 底层融合即在输入层将多模态信息对齐后拼接作为transformer层的输入。这种方案对多任务预训练方案设计(包括任务类型,多任务loss权重设计)要求较高,不利于多种模态的信息的平衡。 顶层融合即在顶层获取一个结点或者语句对应的多模态向量,拼接后用于下游分类或回归任务。缺点在于,各模态独立建模的时候,缺少了相关信息交互,不能充分利用多模态之间的对齐信息。 多模态统一建模,以LayoutV2为例,将文本、图片信息通过不同的编码器定长编码后,输入统一的transformer中。对于多模态综合理解任务来说,很难在输入层显示的注入多模态的对齐信息;网页结构的单元向量与语义、视觉(网页轮廓图)的单元向量亦很难通过浅层的编码器投影到相同的语义空间内。 通过对比,认为在网页建模场景下,多模态交叉attention是一个较好的方案。具体来说,各模态分域表示,域之间相互独立;通过多模态交叉attention层完成多模态间信息交互。DocFormer提出的multi-modal attention,Beit3提出的MultiWay Transformer等本质上均为这种思路。 在多对多对齐关系下(即一个模态的基本单元,可能对应另外一个模态多个基本单元)。可使用聚合函数(例如average-pooling,lstm等),将对应模态上一层transformer-encode输出的对应单元序列,通过聚合操作后变换为定长向量,输入到多模态attention层计算。 03 预训练任务设计 如何设计针对多个模态,不同粒度的任务,以及如何低成本的构建伪标签,是训练网页基座模型的关键。 分析业务中下游任务的特点,在预训练阶段设计了如下4个类别的的预训练任务。 对于细粒度的语义预训练场景,借鉴token粒度MLM的思路,mask完整的句子,并且通过decoder重建句子。 对于粗粒度的篇章预训练场景,结合搜索点击日志,mask掉title后,通过decoder去噪重建title以及生成用户点击的query。 对于细粒度的html-dom粒度预训练场景,通过html_tag mask/重建,结点乱序重排进行训练。 对于篇章粒度的结构任务,通过GPT等生成页面类型的伪标签,作为监督信号训练。 04 展望:LLM时代的网页基座模型探索方向 现阶段,多模态大模型发展到新的阶段,已经可以将图片(视频)、文本通过统一的decoder模型处理。如何有效利用已有大模型的能力,低成本适配到网页,是当前研究的热点和难点。 一个朴素的思想,是将整个html源码输入给大模型,做进一步postpretrain使得模型适配网页。但是,由于网页源码的平均长度非常大(根据我们对百度网页库的统计,平均源码长度在160k),如果再将节点的样式以style标签形式注入,源码长度预计会翻数十倍。面向海量网页计算极难落地。再者,针对网页场景下做若干轮post-pretrain成本亦很高。 一个可行思路是,通过adaptor网络,将网页html-dom的结构、位置以及视觉信息变换到已有多模态大模型的空间中,压缩成若干定长向量表示。 通过adaptor网络与LLM联合训练,调低LLM的学习率(尽量不扰动已有LLM的参数,保留LLM的泛化性);通过特殊标签,注入adaptor产出的tokens向量,让LLM解释隐式向量代表的含义,训练adaptor网络。 例如,构建prompt: 以下是一个网页的dom结点表示<STRUCT>adaptor_tokens</STRUCT>,输出css描述文本:style="xxxxx" 训练adator网络,使得产出的tokens向量能够与LLM的语义空间打平 ———— END———— 推荐阅读 百度垂搜一站式研发平台演进实践 初探图谱Embedding用于异常检测(一) AIAPI - 转向AI原生检索 学校新来了一位AI作文老师:能看、会评、还教改写 搞定十万卡集群!贫穷限制了我的想象力…

优秀的个人博客,低调大师

keycloak集群化的思考

简介 单体服务如果想要突破到高并发服务就需要升级为集群服务。同时集群化也为高可用打下了坚实的基础。纵观现在比较流行的服务或者中间件,不管是RabbitMQ还是redis都提供了集群的功能。 作为硬核工业代表的wildfly也不例外,最近研究了一下keycloak的集群,发现它的底层服务器用的也是wildfly,本文将会和大家探讨一下keycloak的集群的架构思路。 keycloak中的集群 我们知道,keycloak中有两种模式,一种叫做Standalone,一种叫做domain。 这两种模式的区别只是在于部署文件是否被集中管理,如果部署文件需要一个一个的手动拷贝,那么就是standalone模式。如果是一键化的自动安装,那么就是domain模式。 standalone模式下有一个配置文件叫做 /standalone/configuration/standalone-ha.xml,这个就是在standalone模式下配置集群的xml文件了。 而domain模式下,配置文件都是在domain controller这个机子上进行配置的,具体的文件是 domain/configuration/domain.xml 。 我们看下ha具体是用的集群相关的组件: <profile name="full-ha"> ... <subsystem xmlns="urn:jboss:domain:modcluster:5.0"> <proxy name="default" advertise-socket="modcluster" listener="ajp"> <dynamic-load-provider> <load-metric type="cpu"/> </dynamic-load-provider> </proxy> </subsystem> <subsystem xmlns="urn:jboss:domain:infinispan:11.0"> ... </subsystem> <subsystem xmlns="urn:jboss:domain:jgroups:8.0"> <channels default="ee"> <channel name="ee" stack="udp" cluster="ejb"/> </channels> <stacks> <stack name="udp"> ... </stack> <stack name="tcp"> ... </stack> </stacks> </subsystem> ... </profile> 主要用的是modcluster,infinispan和jgroups。 除此之外,keycloak还介绍了一种叫做跨数据中心的集群 这种模式主要用在服务是跨数据中心的情况,比如说异地机房这样的容灾性特别强的情况。 看完keycloak的基本集群搭建之后,我们来讲一下keycloak集群中一些比较关键的概念和使用。 load balancing负载均衡 因为是集群结构,所以我们后端是有多台服务器的,那么用户通过客户端来访问我们服务的时候,究竟应该定位到哪一台服务器呢? 这时就要用到负载均衡软件了,也就是load balancing。 一般来说三种负载均衡的方式: 第一种,就是客户端负载均衡,客户端已经知道了服务端的多个服务地址,在发送请求的时候由客户端自行选择要请求的服务地址。 这种模式一般都要配置一个强力的客户端API,通过这个客户端API来进行路由功能,比如说Memcached。 Memcached的神奇来自两阶段哈希(two-stagehash)。Memcached就像一 个巨大的、存储了很多<key,value>对的哈希表。通过key,可以存储或查询任意的数据。 客户端可以把数据存储在多台memcached上。当查询数据时,客户端首 先参考节点列表计算出key的哈希值(阶段一哈希),进而选中一个节点;客户端将请求发送给选中的节点,然后memcached节点通过一个内部的哈希算法(阶段二哈希),查找真正的数据(item)。 第二种,就是代理服务负载均衡,这种模式下,会有一个代理服务器和后端的多个服务进行连接,客户端是和这个代理服务器进行交互,由代理服务器来代替客户端选择到底要路由到哪个服务。 这种代理的路由的软件就多了,比如我们熟悉的nginx和HTTPD,还有ildFly with mod_cluster, HA Proxy, 或者其他的硬件负载均衡。 第三种,是路由负载均衡,在这种模式下,用户随机选择一个后端服务器进行请求连接,然后在服务器内部进行路由,将这个请求发送到其他的服务器中。 这种模式下,一般需要在服务器内部实现特定的负载均衡功能。 暴露客户端IP地址 不管使用的是什么模式的负载均衡,我们都有可能在业务中需要使用到客户访问的IP地址。 我们在特定的业务中需要获取到用户的ip地址来进行一些操作,比如记录用户的操作日志,如果不能够获取到真实的ip地址的话,则可能使用错误的ip地址。还有就是根据ip地址进行的认证或者防刷工作。 如果我们在服务之前使用了反向代理服务器的话,就会有问题。所以需要我们配置反向代理服务器,保证X-Forwarded-For和X-Forwarded-Proto这两个HTTP header的值是有效的。 然后服务器端就可以从X-Forwarded-For获取到客户的真实ip地址了。 在keycloak中,如果是http forwarding,则可以这样配置: <subsystem xmlns="urn:jboss:domain:undertow:10.0"> <buffer-cache name="default"/> <server name="default-server"> <ajp-listener name="ajp" socket-binding="ajp"/> <http-listener name="default" socket-binding="http" redirect-socket="https" proxy-address-forwarding="true"/> ... </server> ... </subsystem> 如果是AJP forward, 比如使用的是Apache HTTPD + mod-cluster, 则这样配置: <subsystem xmlns="urn:jboss:domain:undertow:10.0"> <buffer-cache name="default"/> <server name="default-server"> <ajp-listener name="ajp" socket-binding="ajp"/> <http-listener name="default" socket-binding="http" redirect-socket="https"/> <host name="default-host" alias="localhost"> ... <filter-ref name="proxy-peer"/> </host> </server> ... <filters> ... <filter name="proxy-peer" class-name="io.undertow.server.handlers.ProxyPeerAddressHandler" module="io.undertow.core" /> </filters> </subsystem> sticky sessions 和 非sticky sessions 如果是在存在session的环境中,比如说web应用程序中,如果后端服务器是cluster的情况下还需要考虑session共享的问题。 因为对于每个服务器来说,它的session都是本地维护的,如果是多台服务器想要session共享该怎么办呢? 一种办法就是所有的服务器都将session存放在同一个外部缓存系统中,比如说redis。这样不管用户访问到哪个server,都可以读取到同一份session数据。 当然,这个缓存系统可以是单点也可以是集群,如果是不同的数据中心的话,缓存集群甚至还需要跨数据中心进行同步。 缓存同步当然是一个很好的办法,但是同步行动自然是有开销的。有没有更加简单方便的处理方式呢? 比如固定一个用户只访问同一个服务器这样是不是就能解决缓存同步的问题呢? 这种固定用户访问特定某个服务器的模式,我们叫做sticky sessions模式。在这种模式下,可以不用考虑session同步的问题。当然,这种模式下,如果某个服务器down机了,用户的session就会丢失。所以还是要做一些session同步的工作,只不过不需要实时的同步而已。 另外,sticky session还有一个缺点:如果是后台的请求,则获取不到session的信息,也就无法实现sticky session,这个时候就需要进行后台数据的拷贝,这样才能保证不管请求发送到哪里都能够表现一致。 shared databases 所有的应用都需要保存数据。通常来说,我们会有两种数据: 一种是数据库数据,这种数据将会永久存储用户信息。 一种是cache,用作数据库和应用程序的缓冲。 不管是哪种数据,都可以有集群模式,也就是多台服务器同时读写数据。这样对于共享的数据就涉及到了集群数据更新的问题。 集群数据的更新有两种更新模式: 一种是可靠优先,Active/Active mode,一个节点更新的数据会立马同步到另外一个节点。 一种是性能优先,Active/Passive mode,一个节点更新的数据不会立马同步到另外一个节点中。 可靠优先的运行逻辑是,一个更新请求需要等待所有的集群服务返回更新成功才算成功。而性能优先的运行逻辑就是更新完主数据就算成功了,其他的节点会去异步和主数据节点进行同步。 keycloak中使用的缓存是infinispan,并且构建了多种session缓存,不同的缓存使用的是不同的同步策略: authenticationSessions:这个缓存保存的是登录用户的信息,如果在sticky sessions模式下,是不需要进行数据同步的。 Action tokens:如果用户需要异步的进行邮件验证,比如说忘记密码等操作,则需要用到这种类型的缓存。因为这种操作中的token只能够被使用一次,所以需要数据的同步。 非认证的session信息:因为不能保证sticky session模式的使用,所以需要复制。 loginFailures: 统计用户的登录异常情况,不需要被复制。 在缓存保存数据,需要注意数据更新后的失效问题。 在keycloak中,使用了一个单独的work缓存,这个缓存是所有数据中心同步的,它不存储实际的数据,只存储要无效的数据通知。各个数据的服务从work缓存中读取无效的数据列表,进行相应的数据缓存无效化处理。 multicasting 最后,如果集群需要动态发现和管理节点的功能的话,还需要进行IP广播。比如说可以使用JGroups来实现这个功能。 总结 keycloak的底层是wildfly,本身已经支持很多强大的工业组件,它的设计理念是让程序业务逻辑和其他的通用的生产级特性(高可用,负载均衡,缓存集群,消息队列等)区分开,只用专注于业务逻辑的实现和编写,其他的事情交给服务器去做即可。 大家可以多研究下这些优秀的服务器框架,可以得到一些不同的体会。 本文作者:flydean程序那些事 本文链接:http://www.flydean.com/keycloak-cluster-in-depth/ 本文来源:flydean的博客 欢迎关注我的公众号:「程序那些事」最通俗的解读,最深刻的干货,最简洁的教程,众多你不知道的小技巧等你来发现!

优秀的个人博客,低调大师

Java对象转换的思考

对象转换 本文将介绍 对象转换 , 在 JavaWeb 开发中我们经常需要对各类对象进行转换(DB对象,DTO,VO等等). 目前解决对象转换的形式有 JSON 序列化反序列化 , 存在的问题 字段名称需要一样 BeanUtils.copyProperties , 存在的问题 字段名称需要一样 mapstruct, 存在的问题多个接口需要大量记忆 有关 mapstruct 的使用文章可以查看 这篇文章 tips: 上述观点仅是笔者所认为的, 并不一定都是问题. 同时欢迎各位读者指出还有那些工具. 笔者的转换 下面将给各位介绍笔者认为比较好的一种对象转换方式. 先说说笔者提出的这个方式的缺点. 需要手动注册. (本文并没有采取包扫描的形式进行因此需要手动注册) 需要手动编写 convert 逻辑. 笔者并不认为这是一个缺点. 对比 mapstruct 发现有下面的代码 convert 接口的实现类很多. @Mappings({ @Mapping(source = "id", target = "userId"), @Mapping(source = "name", target = "userName") }) UserVO4 toConvertVO(User source); User fromConvertEntity(UserVO4 userVO4); 笔者所提出的这个设计是将这部分注解形式的代码使用 java 编码 下面开始正式的实现. 实现 首先提出问题 面对 mapstruct 的使用来说需要记忆大量的转换类(A的转换接口是那个), 这部分记忆工作很大. 笔者认为应该从一个方法直接得到. 而不是去代码中检索各类转换器然后确定是否使用. 针对这个问题笔者定义出下面方法 public class ConvertFacade { public static <T> T convert(Object source, Class<T> target) { return null; } } 解释: 希望通过一个原始对象+目标对象的类型直接得到结果. 在这个基础上我们还需要做出 convert 的逻辑. 前文说到笔者将 mapstruct 的注解转换成了代码, 下面来对这部分进行一个分析 public interface Convert<S, T> { /** * 转换 * @param source 原始对象 * @return 转换结果对象 */ T convert(S source); } 代码部分这里仅仅是一个接口, 由开发者自定义实现即可. 后续要做的事情就是如何把 ConvertFacade 和 Convert 串起来. 笔者使用的方式是将 s , t 两个泛型的类(Class) 获取将他们组成一个对象 ConvertSourceAndTarget , 将 ConvertSourceAndTarget 对象和 当前的 convert 实现类进行绑定 即容器 static Map<ConvertSourceAndTarget, Convert> convertMap = new ConcurrentHashMap<>(256); public class ConvertSourceAndTarget { private Class<?> sourceTypeClass; private Class<?> targetTypeClass; } 在数据存储方式决定后, 需要制作一个可以放入到容器中的方法 register 下面是注册的完整代码, 请各位自行阅读 <details> <summary>register</summary> public class DefaultConvertRegister implements ConvertRegister { private static final Logger log = LoggerFactory.getLogger(DefaultConvertRegister.class); static Map<ConvertSourceAndTarget, Convert> convertMap = new ConcurrentHashMap<>(256); public static Convert getConvertMap(ConvertSourceAndTarget param) { if (log.isInfoEnabled()) { log.info("getConvertMap,param = {}", param); } if (param == null) { return null; } else if (convertMap.containsKey(param)) { return convertMap.get(param); } return null; } @Override public void register(Convert convert) { if (convert == null) { log.warn("当前传入的convert对象为空"); return; } Class<? extends Convert> convertClass = convert.getClass(); handler(convert, convertClass); } private void handler(Convert convert, Class<? extends Convert> convertClass) { Type[] genericInterfaces = convertClass.getGenericInterfaces(); for (Type genericInterface : genericInterfaces) { ParameterizedType pType = (ParameterizedType) genericInterface; boolean equals = pType.getRawType().equals(Convert.class); if (equals) { Type[] actualTypeArguments = pType.getActualTypeArguments(); if (actualTypeArguments.length == 2) { Type a1 = actualTypeArguments[0]; Type a2 = actualTypeArguments[1]; try { Class<?> sourceClass = Class.forName(a1.getTypeName()); Class<?> targetClass = Class.forName(a2.getTypeName()); ConvertSourceAndTarget convertSourceAndTarget = new ConvertSourceAndTarget(sourceClass, targetClass); // 如果类型相同 覆盖 convertMap.put(convertSourceAndTarget, convert); } catch (Exception e) { log.error("a1=[{}]", a1); log.error("a2=[{}]", a2); log.error("从泛型中转换成class异常", e); } } } } } @Override public void register(Class<? extends Convert> convert) throws IllegalAccessException, InstantiationException { if (convert == null) { log.warn("当前传入的convert对象为空"); return; } Convert cv = convert.newInstance(); if (cv != null) { handler(cv, convert); } } } </details> 万事俱备 最后只差 ConvertFacade 的调用了. 调用也就是去找 map 容器中的 convert 对象并且执行方法convert public static <T> T convert(Object source, Class<T> target) { if (log.isInfoEnabled()) { log.info("convert,source = {}, target = {}", source, target); } if (source == null || target == null) { throw new IllegalArgumentException("参数异常请重新检查"); } ConvertSourceAndTarget convertSourceAndTarget = new ConvertSourceAndTarget(source.getClass(), target); Convert convert = DefaultConvertRegister.getConvertMap(convertSourceAndTarget); if (convert != null) { return (T) convert.convert(source); } return null; } 测试 首先准备 Source 、Target 、Convert 对象 source 对象 public class S { private String name; public String getName() { return name; } public void setName(String name) { this.name = name; } } target 对象 public class T { private String username; public String getUsername() { return username; } public void setUsername(String username) { this.username = username; } } convert 接口的实现 public class C1 implements Convert<S, T> { public C1() { } @Override public T convert(S source) { T t = new T(); t.setUsername(source.getName()); return t; } } 测试用例 public class DefaultConvertRegisterTest { ConvertRegister convertRegister = new DefaultConvertRegister(); @Test public void register() { C1 c1 = new C1(); convertRegister.register(c1); S s = new S(); s.setName("张三"); T convert = ConvertFacade.convert(s, T.class); Assert.assertEquals(convert.getUsername(), "张三"); } @Test public void register2() throws InstantiationException, IllegalAccessException { convertRegister.register(C1.class); S s = new S(); s.setName("张三"); T convert = ConvertFacade.convert(s, T.class); Assert.assertEquals(convert.getUsername(), "张三"); } }


优秀的个人博客,低调大师

关于数据质量的思考

这是学习笔记的第 2269篇文章 读完需要 9 分钟 速读仅需7分钟 最近和几个同事聊了下关于数据的一些问题,有一个问题引起了我的好奇。那就是数仓体系和大数据体系的数据质量差异。 因为各种原因,一份数据可能会被多处消费使用,有的用作精确数据可视化,比如报表,对账单等,实时性要求不是很高,一般是T+1的模式,有的用作趋势分析,或者潜在问题分析,对于数据集的时间周期要求较高,有些需要在海量数据中挖掘更多的数据价值,让单一的数据通过连接产生更多维度的意义,总体来说,大家对数据质量的需要不尽相同,有些人主要关注数据的准确性和一致性,有些人则关注数据的实时性和相关性,因此,只要数据能满足使用目的,就可以说数据质量符合要求。 来说说困扰我的数据质量疑问,来自于两拨人的反馈。 第一拨人是大数据方向的同事,他们反馈数据的准确性有时候很难保证,导致在做数据稽核和一些数据统计中,和真实数据的差异较大,这样也会导致一些工作比较被动,业务侧对此的信任度也会大打折扣,而纵观整个数据链路,有些已经可以实现实时流转,却很难直接点出某一处存在明显瓶颈。 而另外一拨人则是做数据统计方向的,他们对于数据有着天然的敏感性,他们对于数据的准确性要求很高。他们反馈数据质量的时机相对要早一些,不过很少反馈数据质量问题,一般就是数据问题需要补录数据,重新跑一些数据任务。 让第一拨人最纠结的是,整个数据流转的团队是同一批人,但是数据质量差别却这么大。 在我的理解中,数据仓库体系应该是大数据体系的一部分,或者说是前哨站,通过和两拨人的沟通,我的小结如下: 1)为什么统计方向的数据仓库体系的数据准确性要高一些,主要原因是它们对于数据质量有一套很清晰的评判标准,并且能够反向推动数据流转体系完善数据质量,比如一张表中的数据有1000万条,需要流转到数仓体系,会有多个维度的校验,比如自增ID,比如ID连续性,数据加载日志,数据预处理日志,数据处理日志,每一步都会详细的记录这些数据处理的进度,对于数据流转体系来说,很可能会有一些数据问题,但是无论是格式还是数据值,如果出现偏差,在统计体系中会更容易识别和分析出来,而这种反向作用力也可以促使流转技术体系不断的迭代升级,一旦出现问题,可以要求重新提供数据,这势必对后端的服务要求也会高一些,即数据处理的幂等性问题。 2)大数据体系的数据质量相对来说难以保障,一方面是因为大数据体系的工作大多数是数据的搬运工,可以从系统,规划等层面提出一些数据标准和规范,但是他们往往不是数据使用方,或者说他们的数据使用方对于数据的准确性没有那么敏感,所以这方面的把控力有限,也很少听到大数据侧会进行数据补录的工作。 3)有很多公司的统计数仓体系和大数据体系是割裂的,导致很多统计侧的数仓体系存储容量大到不需要下沉数据到大数据,而大数据侧会重复处理同一份数据,可能是不同的数据通道。 4)对于数据使用的角色定位不够清晰,比如要求统计体系提供一些数据挖掘,数据趋势的分析等,或者要求大数据提供很精确的数据报表等,除非整个数据链路足够健壮,有弹性,否则这种定位和角色很难让大家都找准自己的位置,相反可能会因为业务而产生为了上某一个技术而硬上的情形。 你们公司的数仓体系和大数据是怎么玩的,欢迎留言。 QQ群号:763628645 QQ群二维码如下,添加请注明:姓名+地区+职位,否则不予通过 订阅我的微信公众号“杨建荣的学习笔记”,第一时间免费收到文章更新。别忘了加星标,以免错过新推送提示。 本文分享自微信公众号 - 杨建荣的学习笔记(jianrong-notes)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

应用监控的选型思考

阿里云应用实时监控和诊断工具 ARMS,点击这里。 最近由于项目的缘故,经常会和同学们聊到一个话题,那就是企业如何在应用性能管理(Application Performance Monitoring, 简称APM) 领域的开源和商业化产品中选择合适自己的产品,下面就以该领域为例和大家做一个分享。 先说结论:没有统一答案,企业用户应当从自身需求,技术掌握深度,建设成本这三个方面来衡量。 企业性质和最终方案 技术掌握程度 自身需求 建设成本 世界500强的IT部门, 最终选择商业产品,部署方式为专用云 已经被各大APM厂商进行过POC,接口人对APM领域有一定理解;已经在内部进行过多轮DevOps概念推广和相关环境建设。 1.配合压测调优性能;2.能快速推广和应用到全集团;3.集团大屏幕输出;4.日常运维中的问题报警,排查,诊断。 1.产品费用+咨询费用

优秀的个人博客,低调大师

OpenTSDB 生产应用与思考

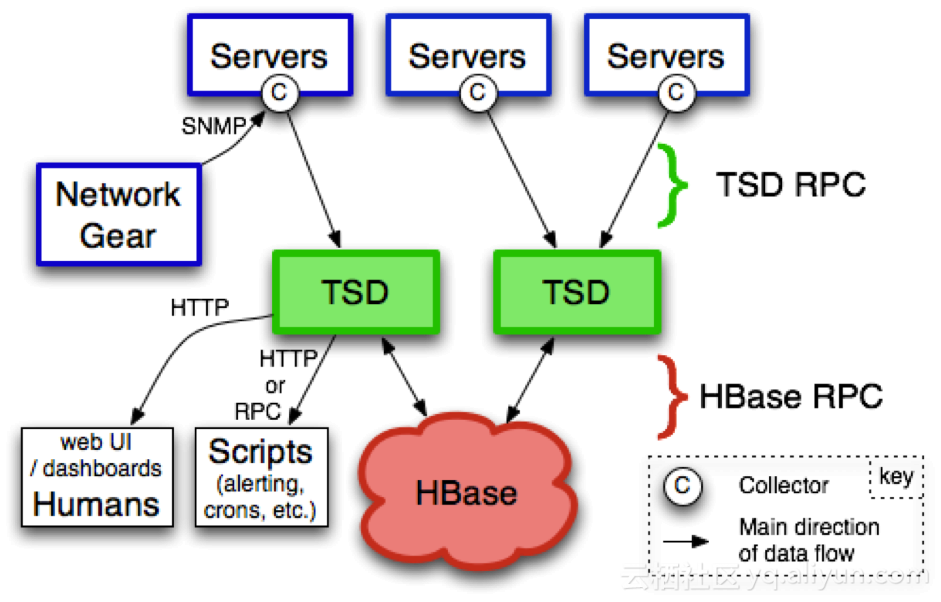
作者:陈杰,欢聚时代YY基础架构部,数据库技术组,专注于HBase、Kafka,MySQL等技术。 OpenTSDB官方介绍 http://opentsdb.net/overview.html 这里就不翻译了。 OpenTSDB应用场景与数据量级 现在的时间序列数据库不仅仅可以提供原始数据的查询,而且要支持对原始数据的聚合能力,支持过滤、过滤之后的聚合计算,这些功能OpenTSDB都有。架构设计也好,中间件也好,还是数据库,在实际生产场景中,都绕不开数据量级的考虑。OpenTSDB在数据量小时是可用的,在千万级、亿级中提取几万条数据,比如某个指标半年内的5分钟级别的数据,还是很快响应的。但如果再提取多点数据,几十万,百万这样的量级,又或者提取后再做个聚合运算,OpenTSDB就勉为其难啦,原因有几点: 【1】OpenTSDB目前还是单点做聚合运算,我所知道的大的云商如阿里云HiTSDB、数据库在这点做了改造,解决了这个瓶颈。 【2】这样的量级数据从HBase中提取到单节点内存中进行聚合运算,在资源消耗方面不可忽视。 【3】一个查询一旦提取的量级大,OpenTSDB向HBase发起RPC请求(OpenTSDB一次请求默认128行)次数也必然增加,十几秒、几十秒的响应时间,这就限制了它的应用场景。 架构中应用OpenTSDB需要事先考虑 【1】OpenTSDB只有4张HBase表,其中一张是存放数据。所有的数据都存放在一张表,这就意味应用在OpenTSDB这个层级上是无法更小的粒度来区别对待不同业务(比如想把WebApp性能指标放在一张表上,OS性能指标放在一张表上),很难根据业务类别自身特点进行差异化对待后续的运维(比如不同类别设置不同的TTL,数据删除,迁移操作等等)。除非再部署多套OpenTSDB来对待,这是另外一个话题。 【2】OpenTSDB不支持二级索引,只有一个基于HBase的RowKey。结合业务场景的查询维度,设计好RowKey是应用好OpenTSDB的关键!提前评估好metric + tag背后扫描的数据量。比如将high-cardinality tag调整到metric中,减少扫描的数据量。 【3】OpenTSDB能实时聚合计算功能,但基于单点运算能力有限,建议这种聚合在入库阶段完成的。比如将1分钟粒度聚合、5分钟粒度聚合提前通过KafkaStream,Spark等运算,将聚会结果存入OpenTSDB供查询。 【4】Tcollector采集数据上报给OpenTSDB,建议在中间加一层Kafka。一来解偶两者之间的强依赖性,同时保存一段时间采集数据,在OpenTSDB、HBase不可用(计划性运维、集群故障)时不至于丢失数据,对运维来说也增强了操作上的灵活性。二来可以对采集的原始数据进行二次加工再入OpenTSDB,如粒度聚合运算。 【5】关于salt启用 时间序列数据的写入,写热点是一个不可规避的问题,当某一个metric下数据点很多时,则该metric很容易造成写入热点。从2.2开始,OpenTSDB采取了允许将metric预分桶,预分桶后的变化就是在rowkey前会拼上一个桶编号(bucket index)。预分桶后,可将某个热点metric的写压力分散到多个桶中,避免了写热点的产生。而客户端查询OpenTSDB一条数据,OpenTSDB将这个请求拆成分桶数个查询到HBase,然后返回桶数个结果集到OpenTSDB层做合并。对HBase并发请求相应的也会桶数倍的扩大。 设计时需要结合查询场景,在查询性能和后期热点运维方面,做一个权衡考虑。比如说有个场景,在前端页面上要查询一个业务相关的性能指标(以业务为查询单元),查询的结果以多个图形方式展现出来,要求响应时间快。如果这是一个用户点击查询比较频繁的场景(并发量大),启动了salt,无形加大OpenTSDB和HBase的压力。如果完全关闭salt的话,写热点问题就加大HBase的运维难度,极端的话造成整个集群整体性能下降。如果写入吞吐量大的话,建议开启salt,但桶的个数不易太多,2-4个即可,默认是20个桶。 比如查询一个业务AAA的数据库性能指标,如下图: 【6】OpenTSDB提供三种途径写数据,分别是Telnet API, HTTP API,批量导入。Telnet读写是异步操作,但是返回的响应混乱的。HTTP API是同步读写操作,成功与否能及时反馈,同时多个数据点能在单个端口发送,节省带宽。理论上Telnet速度好于HTTP,但牺牲了数据是否成功写入的可靠性。在实际生产使用中,建议使用HTTP API,而Telnet API用于运维。 【7】关于Cache OpenTSDB并没有内建的Cache来存放数据,截止到2.3还是只能依赖HBase的Cache。 OpenTSDB部署与运维方面 【1】OpenTSDB是Java实现的,JVM方面的参数设置、GC、运维管理同样是OpenTSDB需要考虑的。 【2】生产部署时,往往是多台机器部署,每台机器部署多个实例,读写分离。比如查询实例端口一律使用4242,写数据实例端口一律使用4243,然后读写请求通过nginx + Consul均衡到各个实例端口上。 【3】设置tsd.storage.hbase.prefetch_meta = true(默认是false),否则极端情况下会打爆hbase:meta表请求。 【4】2.2版本开始,tsd写数据到HBase有两种方式,一种是每来一条数据append到hbase。另一种是先缓存大量数据到TSD的内存里,然后进行compaction,一次性写入。官方推荐Append方式。相关参数tsd.storage.enable_appends = true。 【5】TSDB在每小时整点的时候将上个小时的数据读出来(get),然后compact成一个row,写入(put)到HBase,然后删除(delete)原始数据,目的是减少存储消耗,增大了HBase压力,性能平稳上出现一定的波动。 【6】若metric, tag含有中文,编译时指定字符集为UTF8。 【7】其他一些注意的参数: tsd.storage.hbase.scanner.maxNumRow tsd.query.timeout

优秀的个人博客,低调大师

Android Service的思考(5)

在远程的Service调用中,Activity和Service到底是怎么沟通的?对于Service的远程调用,一般会在不同的工程中也就是两个不同的进程,那么进程的沟通机制是什么?傻蛋画了一个图来说明。 Android进程在产生时会:1.产生一个主线程。2. 产生Looper对象 3.产生一个消息队列。4.产生一个虚拟机对象来实现Java和C++之间的沟通。通过C/C++层的IPC来实现通讯。 进程间通讯:Android通过IBinder接口来实现进程间的通讯,MyActivity会调用IBinder的transact()函数通过IPC来调用远程的onTransact()函数。 在默认情况下,如果Servie和Activity、BroadcastReceiver在同一个工程里面,那么这些组件都会在同一个进程中执行,并且由主线程负责执行,当然也可以通过配置让其在不同的组件里面执行。 本文转自 最牛傻蛋 51CTO博客,原文链接:http://blog.51cto.com/zuiniuwang/718301,如需转载请自行联系原作者

优秀的个人博客,低调大师

团队变迁后的思考

,她在farewell邮件中说:Remember “ If you want to change the world don't ever, ever ring the bell. ”,讲得似乎很壮烈。我们并入Ti的team大概就一年的时间,这一年里,我看到了她带给整个团队的变化及她的明显的管理风格。我明白她很想做一番事业,想干出点事情来,非常明显,我估计全部人都知道,她也很受上层老板赏识与重用,介入各个项目,并在team里做了很多项目,大把的花钱,招兵买马。 但是最后她走了,我感觉她是太着急想往上爬,想升到Director的位子,但是她的老板或者说别的老板不buy她,没有升她而升了别的人,所以她一气之下走了,这个事情很突然,也很迅速。 刚开始Ti的组织架构下面主要分为两部分,一为公司business策略与项目,二为基础架构,也就是我老板的team。当初面我看到两者的结合,是非常好的,这样的话我们就不单单只是负责IT架构运维等方面,而且可以切入business,这是我老板一直想介入,奈何却不得其门而入,曾经他说会参加VP的各种商务会议,然后看IT能如何帮助公司实现项目计划,但是后来我看到的是这事不了了之,而且我老板也缺乏这方面的人脉,才能与知识。Ti的话就很不同,她是MBA出身,而且曾是海军,跟VP一样,所以我看VP很赏识她,同为高级经理,她就可以直接report给VP,而我老板只能report给Director。在很多会议场合,VP都带着她给大家谈公司发展策略。 两个team刚合并时,我感受到一股春风,而我也被推为中国区的IT team leader,当然我知道这是我老板要求的,因为相比别的经理,我的资历是最低的,所以有点不太好意思,我在想,我怎么好意思跟这些资深经理,手下人强马壮的人相提并论呢。当时整个OES,Ti下有Pe和Pa两架马车,Pe下有Project mgr及business transformation,Pa下有Infra和app dev/support, 总共有六七十人。承接的项目主要为供应链管理方面的项目,及各类给管理层看的系统,各类培训等等。那时我曾去Sunnyvle参加了一次大会,那时大家开始相互认识,都信心满满,想大展拳脚,也真的干了点成绩出来,当然也有一些项目失败了,白花了不少钱。 那时Tina对团队管理搞了很多新花样,如读书俱乐部,办公室座位方案(让大家坐得更容易沟通及按功能性划分),每天早上管理团队花十分钟集合谈事情,每周的open office hour(让别的部门的人可以过来商讨计划,寻求帮助),周报及每月写给管理层看的报告等等,搞得有声有色。就这样度过了一年,我看大家都沟通得不错,开始形成战斗力。然而,将近一年时,Pe走了,听说是踩单车摔到了,然后休了一阵子假,然后就辞职了,至此Ti突然少了一辆马车。Ti走之前两周她还来中国,我当时跟她1on1,听她说了Pe的事情,她说已经在招Pe的替代。哪知过了两周,别的同事突然告诉我Ti的last day是周五,我惊异了下,不是吧,怎么她也走了?!有一天开会,老板跟我们正式公布了这个消息,然后说目前还没有定夺团队如何管理,先他和一位新来的接替Pe的同事直接report给VP。又过了一个月,老板说我们会report给ST,那时我才明白,原来是ST升了,我估计是上层权力斗争,Ti斗不过,或者说气不过没有升她而走了。我想如果report给ST的话,估计我们的日子又将恢复平淡无奇,或者说只能做些daily support的东西,为什么这么说呢,因为ST是管物流出身,她对供应链这块很了解,却不是IT的行家,我们没多少共同语言。而后VP宣布了这个消息,再而后老板开会说我们不跟ST,我们转向Seattle总部,report给SW,会上有同事还欢呼,至少我们跟SW还有共同的语言。 Ti走后,她一手一脚建立起来的OES就开始分蹦离析了,PM老大转去 别的部门,一些项目老板不想接被直接砍掉,然后他带领我们直接出走,剩下跟business相关的一个团队留给ST。这已是我在这5年来,我们team的第四次变动,当然这对我来说没什么影响,我还是跟着Pa,这些年里我们彼此间建立了很好的信任和合作关系,但是对他来说就不是好事了,因为他的老板常变,必须重新磨合不说,他的performance又得重新被新老板考核,影响了他的升迁。 Ti的优势在于,能很好的跟上层管理沟通,并得到他们的认可,大概是因为他们都念MBA,彼此对业务的理解更易相通,我老板的弱点就在于他是技术出身,而且多年下来已脱离技术一线也没怎么弥补业务上的能力,所以已沦为people manager的类型,只能在中层打转。而这就是我要避免的,我一方面需要增进业务方面的知识,二方面要继续提高技术能力,相应的就要付出更多时间与精力了。 本文转simmy51CTO博客,原文链接:http://blog.51cto.com/helpdesk/1597330,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android Intenet的思考(1)

Intent有两种调用方法,一种是显示调用。一种是隐式调用。 1. 显示调用,也就是我们最常用的。 使用的Intent构造函数如下: Intent(Context packageContext, Class<?> cls) 在同一个进程中,一个Activity 调用另外一个Activity 。 Intentintent=newIntent(this,TestActivity.class); startActivity(intent); 当然我们也可以在不同应用程序之间,也就是不同的进程之间启动Activity。 使用的Intent 构造函数:Intent(Context packageContext, Class<?> cls) 第一个是包名,第二个时Activity类名 Intentintent=newIntent(); intent.setClassName("com.androidtest","com.androidtest.AndroidTest"); main.this.startActivity(intent); 这时候一定要修改AndroidManifest.xml 文件 在 activity 的 申明中加上<intent-filter> 如下: <activityandroid:name=".TestActivity"> <intent-filter> <actionandroid:name="android.intent.action.DEFAULT"/> </intent-filter> </activity> 2. 隐式调用 比如我们调用打电话的Activity。就要使用隐式调用了: Intent(String action); 代码如下: Intentintent=newIntent(Intent.ACTION_DIAL); startActivity(intent); 这种使用方式看上去比较奇怪,Intent的发送者只是指定了Action为Intent.ACTION_DIAL,那么怎么找到接收者呢? 我们自己的程序能不能接受这个Intent呢?答案是可以的,修改程序的Intent-fliter 加上这几句话变可。如: <activityandroid:name=".TestActivity"> <intent-filter> <actionandroid:name="android.intent.action.DEFAULT"/> <actionandroid:name="android.intent.action.DIAL"/> <categoryandroid:name="android.intent.category.DEFAULT"/> </intent-filter> </activity> 这样我们的程序也能接收该Intent了。当两个程序都能接收此Intent时,Android会自动弹出对话框让你进行选择。 本文转自 最牛傻蛋 51CTO博客,原文链接:http://blog.51cto.com/zuiniuwang/718325,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android Service的思考(3)

前两篇文章中可以看到Activity和Service,context.startService对应着Service中的onStart()方法,context.onBindService对应的是Service中的onBind()方法。当我们继想绑定一个Service又想在Activity停止时,Service不会停止,我们可以先StartService,然后再BindService()。这时候的流程图如下所示:点击放大 此时需要注意一个问题,当Activity退出的时候,Sercvice并不会停止,此时我们可以再进入Activity重新绑定,当这时候Service就会调用onRebind()方法,但是调用onRebind()方法的前提是先前的onUnbind()方法执行成功,但是使用super.onUnbind(intent)是执行不成功的,这时候我们要手动的使其返回true,再次绑定时Rebind()就会执行。否则,如果退出时不显示的指定onUnbind()为成功的话(为false),那么重新启动此Activity来绑定服务时,Service的onBind()方法和onReBind都不会执行,但是ServiceConnection方法确一定会回调了。这说明在Service中的onBind()方法不同于onStart()方法不能被重复调用。 本文转自 最牛傻蛋 51CTO博客,原文链接:http://blog.51cto.com/zuiniuwang/718311,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android Service的思考(2)

第二种是通过绑定的方式来启动Service。先看流程图,点击放大。 在这里我们使用了this.bindService(intent, myServiceConnection, Context.BIND_AUTO_CREATE); 来启动Service,当Service创建了同时绑定了之后,会回调我们定义的ServiceConnection(),从而传回IBinder接口,我们就能够调用Service中的方法了。这时候Activity就和Service实现了绑定,Activity退出了Service就相应的退出了。 <service android:enabled="true" android:name=".service.mediaplayer.BindMusicService"> <intent-filter> <action android:name="com.androidtest.service.mediaplayer.BindMusicService" /> </intent-filter> </service> 主要代码如下: ?[Copy to clipboard] Downloadzuiniuwang.java /** *BinderMusicPlayerActivity.java *com.androidtest.activity.musicplayer * *Function:TODO * *verdateauthor *────────────────────────────────── *2011-5-17Leon * *Copyright(c)2011,TNTAllRightsReserved. */ packagecom.androidtest.activity.musicplayer; importcom.androidtest.R; importcom.androidtest.service.mediaplayer.BindMusicService; importcom.androidtest.service.mediaplayer.MyBinder; importcom.androidtest.service.mediaplayer.MyMediaController; importandroid.app.Activity; importandroid.content.ComponentName; importandroid.content.Context; importandroid.content.Intent; importandroid.content.ServiceConnection; importandroid.os.Bundle; importandroid.os.IBinder; importandroid.util.Log; importandroid.view.View; importandroid.view.View.OnClickListener; importandroid.widget.Button; /** *ClassName:BinderMusicPlayerActivityFunction:TODOADDFUNCTIONReason:TODO *ADDREASON * *@authorLeon *@version *@sinceVer1.1 *@Date2011-5-17 */ publicclassBinderMusicPlayerActivityextendsActivityimplements OnClickListener{ privatestaticfinalStringTAG=BinderMusicPlayerActivity.class .getSimpleName(); privateBindMusicServicebindMusicService; privateButtonplayButton,pauseButton,stopButton,closeActivityButton, exitActivityButton; @Override protectedvoidonCreate(BundlesavedInstanceState){ //TODOAuto-generatedmethodstub super.onCreate(savedInstanceState); Log.v(TAG,TAG+"onCreate()"); this.setContentView(R.layout.music_player_layout); findViews(); bindViews(); connection(); } privatevoidfindViews(){ playButton=(Button)this.findViewById(R.id.play); pauseButton=(Button)this.findViewById(R.id.pause); stopButton=(Button)this.findViewById(R.id.stop); closeActivityButton=(Button)this.findViewById(R.id.close); exitActivityButton=(Button)this.findViewById(R.id.exit); } privatevoidbindViews(){ playButton.setOnClickListener(this); pauseButton.setOnClickListener(this); stopButton.setOnClickListener(this); closeActivityButton.setOnClickListener(this); exitActivityButton.setOnClickListener(this); } privatevoidconnection(){ Log.v(TAG,TAG+"connection"); Intentintent=newIntent("com.androidtest.service.mediaplayer.BindMusicService"); this.startService(intent); this.bindService(intent,myServiceConnection,Context.BIND_AUTO_CREATE); } @Override publicvoidonClick(Viewview){ //TODOAuto-generatedmethodstub //TODOAuto-generatedmethodstub switch(view.getId()){ caseR.id.play: Log.d(TAG,"play......."); MyMediaController.play.execute(); break; caseR.id.pause: Log.d(TAG,"pause......."); MyMediaController.pause.execute(); break; caseR.id.stop: Log.d(TAG,"stop......."); MyMediaController.stop.execute(); break; caseR.id.close: Log.d(TAG,"close......."); this.finish(); break; caseR.id.exit: Log.d(TAG,"exit......."); this.finish(); this.stopService(newIntent("com.androidtest.service.mediaplayer.BindMusicService")); } } //调用bindService后Service调用onBind()后回调此函数 privateServiceConnectionmyServiceConnection=newServiceConnection(){ @Override publicvoidonServiceConnected(ComponentNamename,IBinderbinder){ Log.v(TAG,TAG+"onServiceConnected"); //TODOAuto-generatedmethodstub bindMusicService=((MyBinder)binder).getService(); //给Controller设置Service初始化的MediaPlayer MyMediaController.mediaPlayer=bindMusicService.getMyMediaPlayer(); } @Override publicvoidonServiceDisconnected(ComponentNamename){ //TODOAuto-generatedmethodstub bindMusicService=null; Log.v(TAG,"..............onServiceDisconnected"); } }; //当Activityfinish时必须解绑不然会出现溢出 publicvoidfinish(){ //TODOAuto-generatedmethodstub super.finish(); this.unbindService(myServiceConnection); } } /** *BindMusicService.java *com.androidtest.service.mediaplayer * *Function:TODO * *verdateauthor *────────────────────────────────── *2011-5-16Leon * *Copyright(c)2011,TNTAllRightsReserved. */ packagecom.androidtest.service.mediaplayer; importcom.androidtest.R; importandroid.app.Service; importandroid.content.Intent; importandroid.media.MediaPlayer; importandroid.os.IBinder; importandroid.util.Log; /** *ClassName:BindMusicService *Function:TODOADDFUNCTION *Reason:TODOADDREASON * *@authorLeon *@version *@sinceVer1.1 *@Date2011-5-16 */ publicclassBindMusicServiceextendsService{ privatestaticfinalStringTAG=BindMusicService.class.getSimpleName(); privateMediaPlayermyMediaPlayer; privateIBinderbinder=newMyBinder(this); publicMediaPlayergetMyMediaPlayer(){ returnmyMediaPlayer; } publicvoidsetMyMediaPlayer(MediaPlayermyMediaPlayer){ this.myMediaPlayer=myMediaPlayer; } @Override publicIBinderonBind(Intentintent){ Log.v(TAG,TAG+"onBind"); //TODOAuto-generatedmethodstub returnbinder; } @Override publicvoidonCreate(){ //TODOAuto-generatedmethodstub super.onCreate(); if(myMediaPlayer==null){ myMediaPlayer=MediaPlayer.create(this,R.raw.test); myMediaPlayer.setLooping(false); } Log.v(TAG,TAG+"onCreate()"); } @Override publicvoidonDestroy(){ //TODOAuto-generatedmethodstub super.onDestroy(); Log.v(TAG,TAG+"onDestroy()"); if(myMediaPlayer!=null){ myMediaPlayer.stop(); myMediaPlayer.release(); } } //通过bindService的方式,onStart函数不会调用 @Override publicvoidonStart(Intentintent,intstartId){ //TODOAuto-generatedmethodstub super.onStart(intent,startId); Log.v(TAG,TAG+"onStart()"); } @Override publicbooleanonUnbind(Intentintent){ //TODOAuto-generatedmethodstub Log.v(TAG,TAG+"onUnbind,成功没有?"+super.onUnbind(intent)); returntrue; } @Override publicvoidonRebind(Intentintent){ //TODOAuto-generatedmethodstub Log.v(TAG,TAG+"onRebind()----------------------------------->"); super.onRebind(intent); } } /** *MyBinder.java *com.androidtest.service.mediaplayer * *Function:TODO * *verdateauthor *────────────────────────────────── *2011-5-17Leon * *Copyright(c)2011,TNTAllRightsReserved. */ packagecom.androidtest.service.mediaplayer; importandroid.os.Binder; /** *ClassName:MyBinderFunction:TODOADDFUNCTIONReason:TODOADDREASON * *@authorLeon *@version *@sinceVer1.1 *@Date2011-5-17 */ publicclassMyBinderextendsBinder{ privateBindMusicServicebindMusicService; publicMyBinder(BindMusicServicebindMusicService){ this.bindMusicService=bindMusicService; }; publicBindMusicServicegetService(){ returnbindMusicService; } 本文转自 最牛傻蛋 51CTO博客,原文链接:http://blog.51cto.com/zuiniuwang/718313,如需转载请自行联系原作者

优秀的个人博客,低调大师

对Context的重新思考

Android.view.WindowManager$BadTokenException:Unabletoaddwindow-tokennullisnotvalid;isyouractivityrunning? 问题发生的情景:当我从一个activity跳转到另外一个activity时,第二次跳转崩溃。后来终于找到了原因 第一次progDialog实例化用的是第二个activity的context,然后第二次进入第二个activity的时 候progDialog并没有实例化,progDialog还保留着第2个activity第一次的context,但是这个时候的 activity已经销毁,context也就不存在 。 不要纯粹地节约一个new的过程,而不去创建对象。 但是每次都new一个对象也不是明智之举,于是利用view.getContext来对Context进行一下判断可以 对代码进行一下优化 1 2 3 4 5 6 7 if (progDialog== null ){ progDialog= new ProgressDialog(context); } else { if (progDialog.getContext()!=context){ progDialog= new ProgressDialog(context); } } 本文转自屠夫章哥 51CTO博客,原文链接:http://blog.51cto.com/4259297/1793253,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册