首页 文章 精选 留言 我的

精选列表

搜索[一键部署],共10000篇文章
优秀的个人博客,低调大师

kafka原理及Docker环境部署

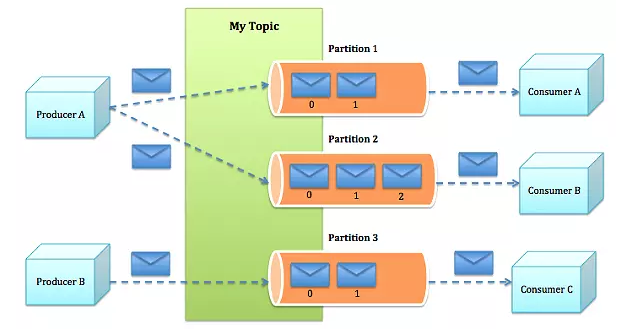
技术原理 Kafka是由Apache软件基金会开发的一个开源流处理平台,由Scala和Java编写。Kafka为处理实时数据提供一个统一、高吞吐、低延迟的平台。其持久化层本质上是一个“按照分布式事务日志架构的大规模发布/订阅消息队列”,这使它作为企业级基础设施来处理流式数据非常有价值。此外,Kafka可以通过Kafka Connect连接到外部系统(用于数据输入/输出),并提供了Kafka Streams——一个Java流式处理库 (计算机)。 Kafka是一个分布式的、高吞吐量、高可扩展性的消息系统。Kafka 基于发布/订阅模式,通过消息解耦,使生产者和消费者异步交互,无需彼此等待。Ckafka 具有数据压缩、同时支持离线和实时数据处理等优点,适用于日志压缩收集、监控数据聚合等场景。 关键名词: broker:kafka集群包含一个或者多个服务器,服务器就称作broker producer:负责发布消息到broker consumer:消费者,从broker获取消息 topic:发布到kafka集群的消息类别。 partition:每个topic划分为多个partition。 group:每个partition分为多个group 架构示意图 一个典型的Kafka集群中包含若干Producer(可以是web前端FET,或者是服务器日志等),若干broker(Kafka支持水平扩展,一般broker数量越多,集群吞吐率越高),若干ConsumerGroup,以及一个Zookeeper集群。 Kafka通过Zookeeper管理Kafka集群配置:选举Kafka broker的leader,以及在Consumer Group发生变化时进行rebalance,因为consumer消费kafka topic的partition的offsite信息是存在Zookeeper的。 Producer使用push模式将消息发布到broker,Consumer使用pull模式从broker订阅并消费消息。一个典型的Cloud Kafka集群如上所示。其中的生产者Producer可能是网页活动产生的消息、或是服务日志等信息。生产者通过push模式将消息发布到Cloud Kafka的Broker集群,消费者通过pull模式从broker中消费消息。消费者Consumer被划分为若干个Consumer Group,此外,集群通过Zookeeper管理集群配置,进行leader选举,故障容错等。 kafka特点: 它是一个处理流式数据的”发布-订阅“消息系统。 实时高效处理流式数据:kafka每秒可以处理几十万条消息,它的延迟最低只有几毫秒,每个topic可以分多个partition, consumer group 对partition进行consume操作。 将数据安全存储在分布式集群。 它是运行在集群上的。 它将流式记录存储在topics中。 每个record由key, value和timestamp组成。 Docker搭建 参考:https://github.com/wurstmeister/kafka-docker docker-compose.yml如下: version: '2' services: zookeeper: image: wurstmeister/zookeeper volumes: - ./data:/data ports: - "2181:2181" kafka: image: wurstmeister/kafka ports: - "9092:9092" environment: KAFKA_ADVERTISED_HOST_NAME: 10.154.38.115 KAFKA_MESSAGE_MAX_BYTES: 2000000 KAFKA_CREATE_TOPICS: "Topic1:1:3,Topic2:1:1:compact" KAFKA_ZOOKEEPER_CONNECT: zookeeper:2181 volumes: - ./kafka-logs:/kafka - /var/run/docker.sock:/var/run/docker.sock kafka-manager: image: sheepkiller/kafka-manager ports: - 9020:9000 environment: ZK_HOSTS: zookeeper:2181 参数说明: KAFKA_ADVERTISED_HOST_NAME:Docker宿主机IP(如果你要配置多个brokers,就不能设置为 localhost 或 127.0.0.1) KAFKA_MESSAGE_MAX_BYTES:kafka(message.max.bytes) 会接收单个消息size的最大限制,默认值为1000000 , ≈1M KAFKA_CREATE_TOPICS:初始创建的topics,可以不设置 环境变量./kafka-logs为防止容器销毁时消息数据丢失。 容器kafka-manager为yahoo出可视化kafka WEB管理平台。 操作命令: # 启动: $ docker-compose up -d # 增加更多Broker: $ docker-compose scale kafka=3 # 合并: $ docker-compose up --scale kafka=3 Kakfa使用 1,Kafka管理节点 2,主题 environment: KAFKA_CREATE_TOPICS: "Topic1:1:3,Topic2:1:1:compact" Topic1有1个Partition和3个replicas, Topic2有2个Partition,1个replica和cleanup.policy为compact。 Topic 1 will have 1 partition and 3 replicas, Topic 2 will have 1 partition, 1 replica and a cleanup.policy set to compact. 3,读写验证 读写验证的方法有很多,这里我们用kafka容器自带的工具来验证,首先进入到kafka容器的交互模式: docker exec -it kafka_kafka_1 /bin/bash 创建一个主题: /opt/kafka/bin/kafka-topics.sh --create --zookeeper 192.168.31.84:2181 --replication-factor 1 --partitions 1 --topic my-test 查看刚创建的主题: /opt/kafka/bin/kafka-topics.sh --list --zookeeper 192.168.31.84:2181 发送消息: /opt/kafka/bin/kafka-console-producer.sh --broker-list 192.168.31.84:9092 --topic my-test This is a message This is another message 读取消息: /opt/kafka/bin/kafka-console-consumer.sh --bootstrap-server 192.168.31.84:9092 --topic my-test --from-beginning 使用场景 日志收集:一个公司可以用Kafka可以收集各种服务的log,通过kafka以统一接口服务的方式开放给各种consumer,例如hadoop、Hbase、Solr等。 消息系统:解耦和生产者和消费者、缓存消息等。 用户活动跟踪:Kafka经常被用来记录web用户或者app用户的各种活动,如浏览网页、搜索、点击等活动,这些活动信息被各个服务器发布到kafka的topic中,然后订阅者通过订阅这些topic来做实时的监控分析,或者装载到hadoop、数据仓库中做离线分析和挖掘。 运营指标:Kafka也经常用来记录运营监控数据。包括收集各种分布式应用的数据,生产各种操作的集中反馈,比如报警和报告。 流式处理:比如spark streaming和storm 参考: 1,https://www.jianshu.com/p/bfeceb3548ad2,https://www.jianshu.com/p/7f089cdff29a3,https://www.cnblogs.com/iforever/p/9130983.html4,利用flume+kafka+storm+mysql构建大数据实时系统5,Kafka系列(四)Kafka消费者:从Kafka中读取数据6,基于Docker搭建分布式消息队列Kafka

优秀的个人博客,低调大师

通过Docker部署Linux版SqlServer

版权声明:本文为博主原创文章,未经博主允许不得转载。欢迎访问我的博客 https://blog.csdn.net/smooth00/article/details/82884538 很多人不知道SqlServer还有Linux版的,微软官方于2016年就发布了SqlServer 2017 for Linux,使得SqlServer数据库可以运行在Linux内核的服务器上。按照微软官方的解释,SQL Server 2017 在所有支持的平台(包括 Linux)上具有相同的基础数据库引擎。因此,在 Linux 上,许多现有功能运行方式相同。既然有了Linux版,那么就应该在Docker Hub上能找到对应的Docker镜像:https://hub.docker.com/r/microsoft/mssql-server-linux/ 要使用容器,我们先需要安装一下基础环境: 1. 安装docker要使用centos 7以上版本,使用centos 6及以下版本会出现各种问题 2. docker CE安装过程 $ sudo yum install -y yum-utils device-mapper-persistent-data lvm2 $ sudo yum-config-manager --add-repo https://download.docker.com/linux/centos/docker-ce.repo #建立仓库 $ sudo yum install docker-ce #安装docker $ sudo systemctl start docker #开启docker 3. dockerfile准备 开始构建一个基于项目应用的SqlServer容器,首先我们选定基础镜像:microsoft/mssql-server-linux:2017-latest,然后我们需要有个初始化数据脚本(开发人员会提供),往生成的容器中导入我们的项目数据。这个脚本的开头部分大概是这样: USE [master] GO /****** Object: Database [LayIM] Script Date: 2017/2/24 9:39:19 ******/ CREATE DATABASE [LayIM] CONTAINMENT = NONE ON PRIMARY ( NAME = N'LayIM', FILENAME = N'/var/opt/mssql/data/LayIM.mdf' , SIZE = 5120KB , MAXSIZE = UNLIMITED, FILEGROWTH = 1024KB ) LOG ON ( NAME = N'LayIM_log', FILENAME = N'/var/opt/mssql/data/LayIM_log.ldf' , SIZE = 1280KB , MAXSIZE = 2048GB , FILEGROWTH = 10%) GO ALTER DATABASE [LayIM] SET COMPATIBILITY_LEVEL = 100 GO IF (1 = FULLTEXTSERVICEPROPERTY('IsFullTextInstalled')) begin EXEC [LayIM].[dbo].[sp_fulltext_database] @action = 'enable' end GO --修改现有databases的排序规则 ALTER DATABASE [LayIM] COLLATE Chinese_PRC_CI_AS GO --以下省略SQL脚本 我们可以看出以上脚本,和windows下最大的不同是,数据文件路径FILENAME配置成Linux下的路径了,另外修改了数据库的排序规则,用简体中文的规则(对于Linux下来说,编码规则要特别强调,否则就容易出现中文乱码),为了避免在Linux查看SQL脚本出现中文乱码,建议sql脚本也用编辑器保存为UTF-8格式(windows下生成的脚本默认是ANSI/ASCII格式)。 其次,我们需要把启动SqlServer和初始化导入数据的批处理写到一个脚本中,如setup.sh: #!/bin/bash set -e #设置语言为简体中文 /opt/mssql/bin/mssql-conf set language.lcid 2052 echo '1.启动mssql....' #启动mssql /opt/mssql/bin/sqlservr sleep 3 ps -ef|grep sqlservr echo '2.开始导入数据....' #导入数据 if [ -d /var/opt/mssql/data/LayIM.mdf ] ; then echo '3.数据库已存在,中止导入....' else /opt/mssql-tools/bin/sqlcmd -S 127.0.0.1 -U "sa" -P "yourStrong(!)Password" -d "Database" -i "/home/mssql/schema.sql" -o /home/mssql/initsql.log echo '3.导入数据完毕....' fi #sleep 3 echo 'mssql容器启动完毕,且数据导入成功' tail -f /dev/null 在这个脚本中,我们先设置了SqlServer的中文编码ID为2052(简体中文的ID号),然后启动sqlserver,导入sql脚本,最后通过 tail -f /dev/null来避免容器关闭前台(这是容器的机制,前台一关闭容器就会stop)。 有了以上两个脚本文件,我们就可以编制Dockerfile,将文件写到镜像中: FROM microsoft/mssql-server-linux:2017-latest #将所需文件放到容器中 COPY setup.sh /home/mssql/setup.sh COPY LayIM.sql /home/mssql/schema.sql RUN chmod +777 /home/mssql/setup.sh #设置容器启动时执行的命令 CMD ["sh", "/home/mssql/setup.sh"] 4. Build镜像和生成容器 最后我们就可以Build镜像(进入到Dockerfile目录下) docker build -t fzfda-mssql:1.0 . 生成镜像后,就直接run(需要注意的是应该先创建卷目录mkdir -p /var/opt/mssql并赋写权限,然后是ACCEPT_EULA授权为Y,sa密码要以和以上脚本保持统一,数据库端口配置正确): docker run --name fzfda-mssql -d --restart=unless-stopped -p 1433:1433 -e 'ACCEPT_EULA=Y' -e 'SA_PASSWORD=yourStrong(!)Password' -v /var/opt/mssql:/var/opt/mssql fzfda-mssql:1.0 5. 连接数据库 容器起的过程中就完成了数据初始化,连接后就能看到: 我用的是Navicat工具连接数据库,默认连接sqlserver的端口是1433,如果不是1433,就需要配置端口了,注意端口和IP是用逗号分隔的(这点比较坑):

优秀的个人博客,低调大师

Docker 部署 Spring Boot 项目初探

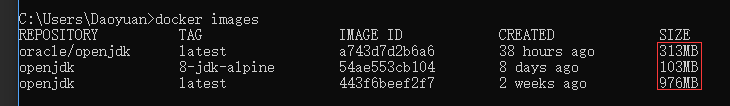
仅想在Docker里运行一个Spring Boot项目,捣鼓了许久。。。 本文主要适用于Windows环境下的Docker 一、运行环境 Windows 10 Maven 3.5 Docker18.06.1-ce-win73 (19507) 二、创建Spring Boot项目 空空如也。。。 <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> @RestController @SpringBootApplication public class GreetApplication { @GetMapping("hello") public String hello() { return "Hello Docker!"; } public static void main(String[] args) { SpringApplication.run(GreetApplication.class, args); } } 三、创建一个Dockerfile 参考:https://spring.io/guides/gs/spring-boot-docker/ 内容:和官方指南完全一样;下边只说FROM,其他几个官网解释的很好 FROM openjdk:8-jdk-alpine VOLUME /tmp ARG JAR_FILE COPY ${JAR_FILE} app.jar ENTRYPOINT ["java","-Djava.security.egd=file:/dev/./urandom","-jar","/app.jar"] 1、什么是FORM 我们定制镜像,需要以一个镜像为基础,FROM 指代的就是。 2、官方用哪个 openjdk:8-jdk-alpine 因为不知道为啥是这个,毕竟也是第一次见,就先试试其他的。 依次下载了他们,openjdk、oracle/openjdk 和 openjdk:8-jdk-alpine 3、具体差异 3.1 使用 openjdk 3.2 使用 openjdk:8-jdk-alpine 差异很明显吧,镜像小了874MB(......) 四、修改pom.xml配置 <properties> <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding> <project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding> <java.version>1.8</java.version> <skipTests>true</skipTests> <docker.image.prefix>amos</docker.image.prefix> </properties> <dependencies> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> <scope>test</scope> </dependency> </dependencies> <build> <finalName>greet</finalName> <plugins> <plugin> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-maven-plugin</artifactId> </plugin> <plugin> <groupId>com.spotify</groupId> <artifactId>dockerfile-maven-plugin</artifactId> <version>1.3.6</version> <configuration> <repository>${docker.image.prefix}/${project.artifactId}</repository> <buildArgs> <JAR_FILE>target/${project.build.finalName}.jar</JAR_FILE> </buildArgs> </configuration> </plugin> </plugins> </build> 五、指南正文 1、Maven 不识别 docker:build 你刚开始百度到的命令可能是:mvn clean package docker:build,然后运行,接着就失败了... [ERROR]No plugin found for prefix 'docker' in the current project and in the plugin groups... 解决办法是修改 maven 的配置文件 settings.xml。( pluginGroups 在 settings.xml 中的位置很靠上) <pluginGroups> <pluginGroup>com.spotify</pluginGroup> </pluginGroups> 后来,你可能会发现,使用mvn clean package dockerfile:build,就不会有上边的错误。这个仇先记下了。。。 2、Must specify baseImage if dockerDirectory 接下来,开始运行了,以为正常了。 [ERROR] ... Exception caught: Must specify baseImage if dockerDirectory is null -> [Help 1] 翻到https://github.com/spotify/dockerfile-maven,你会发现应该使用mvn clean package dockerfile:build,而不是mvn clean package docker:build。 3、Connect to localhost:2375 ... failed [ERROR] ... Connect to localhost:2375 [localhost/127.0.0.1, localhost/0:0:0:0:0:0:0:1] failed: Connection refused: connect 右键运行中的docker,Settings,接着如下图 六、完 生成镜像到本地:mvn package dockerfile:build 查看镜像:docker images 运行镜像:docker run -d -p 8088:8080 --name greet amos/greet 浏览器内访问:

优秀的个人博客,低调大师

mybatis mapper.xml 热部署

package com.guangeryi.mall.core.utils.mybatis; import com.guangeryi.mall.common.CommonConstant; import com.guangeryi.mall.core.utils.StringUtils; import org.apache.ibatis.binding.MapperProxyFactory; import org.apache.ibatis.session.Configuration; import org.apache.ibatis.session.SqlSessionFactory; import org.apache.logging.log4j.util.Strings; import org.slf4j.Logger; import org.slf4j.LoggerFactory; import org.springframework.beans.BeansException; import org.springframework.beans.factory.DisposableBean; import org.springframework.beans.factory.InitializingBean; import org.springframework.beans.factory.annotation.Value; import org.springframework.context.ApplicationContext; import org.springframework.context.ApplicationContextAware; import org.springframework.context.ConfigurableApplicationContext; import org.springframework.core.io.Resource; import org.springframework.core.io.support.PathMatchingResourcePatternResolver; import org.springframework.stereotype.Component; import java.io.IOException; import java.lang.reflect.Field; import java.util.*; import java.util.concurrent.Executors; import java.util.concurrent.ScheduledExecutorService; import java.util.concurrent.TimeUnit; import java.util.stream.Collectors; @Component public class MyBatisMapperRefresher implements DisposableBean, InitializingBean, ApplicationContextAware { private final Logger logger = LoggerFactory.getLogger(getClass()); /** * 扫描周期,单位秒 */ private int periodSeconds = 5; /** * 初始化完成,延迟扫描时间,单位秒 */ private int initialDelay = 5; /** * 是否启用 */ @Value("${mapper.auto.load}") private boolean enabled; private ConfigurableApplicationContext context = null; private transient Resource[] basePackage = null; private HashMap<String, String> fileMapping = new HashMap<>(); private Set<String> isChangedMapper = new HashSet<>(); private Scanner scanner = null; private ScheduledExecutorService service = null; @Override public void setApplicationContext(ApplicationContext applicationContext) throws BeansException { this.context = (ConfigurableApplicationContext) applicationContext; } @Override public void afterPropertiesSet() throws Exception { if (!enabled) { logger.info("MyBatisMapperRefresher is Disabled"); return; } try { service = Executors.newScheduledThreadPool(1); PathMatchingResourcePatternResolver resolver = new PathMatchingResourcePatternResolver(); basePackage = resolver.getResources("classpath*:xx.xml");// 加载配置xml文件 logger.info("监控以下" + basePackage.length + "个xml文件:"); // 触发文件监听事件 scanner = new Scanner(); scanner.scan(); service.scheduleAtFixedRate(new Task(), MyBatisMapperRefresher.this.initialDelay, MyBatisMapperRefresher.this.periodSeconds, TimeUnit.SECONDS); } catch (Exception e1) { logger.error("can not starter Mybatis xml refresher,exception:{}", e1); } } class Task implements Runnable { @Override public void run() { try { if (scanner.isChanged()) { scanner.reloadXML(); } } catch (Exception ex) { logger.error("MyBatisMapperRefresher,exception:{}", ex); } } } @Override public void destroy() throws Exception { if (service != null) { service.shutdownNow(); } } class Scanner { private Resource[] mapperXmlFiles; public Scanner() { mapperXmlFiles = MyBatisMapperRefresher.this.basePackage; } public void reloadXML() throws Exception { SqlSessionFactory factory = context.getBean(SqlSessionFactory.class); Configuration configuration = factory.getConfiguration(); Set<Class<?>> knownMapperKeys = new HashSet<>(); Field field = configuration.getMapperRegistry().getClass().getDeclaredField("knownMappers"); field.setAccessible(true); Map<Class<?>, MapperProxyFactory<?>> knownMappers = (Map<Class<?>, MapperProxyFactory<?>>) field.get(configuration.getMapperRegistry()); knownMapperKeys.addAll(knownMappers.keySet()); // 移除加载项 removeConfig(configuration, isChangedMapper); Set<String> isChangedMapperTemp = isChangedMapper.stream().map(item -> StringUtils.split(item, CommonConstant.CHAR_SPOT)[0]).collect(Collectors.toSet()); Iterator<Class<?>> classIterator = knownMapperKeys.iterator(); while (classIterator.hasNext()) { Class clazz = classIterator.next(); if (clazz == null || Strings.isEmpty(clazz.getName())) continue; String[] clazzNames = StringUtils.split(clazz.getName(), CommonConstant.CHAR_SPOT); if (isChangedMapperTemp.contains(clazzNames[clazzNames.length - 1])) { knownMappers.remove(clazz); configuration.addMapper(clazz); } } isChangedMapper.clear(); } private void removeConfig(Configuration configuration, Set<String> isChangedMapper) throws Exception { Class<?> classConfig = configuration.getClass(); clearMap(classConfig, configuration, "mappedStatements", isChangedMapper); clearMap(classConfig, configuration, "caches", isChangedMapper); clearMap(classConfig, configuration, "resultMaps", isChangedMapper); clearMap(classConfig, configuration, "parameterMaps", isChangedMapper); clearMap(classConfig, configuration, "keyGenerators", isChangedMapper); clearMap(classConfig, configuration, "sqlFragments", isChangedMapper); clearSet(classConfig, configuration, "loadedResources", isChangedMapper); } private void clearMap(Class<?> classConfig, Configuration configuration, String fieldName, Set<String> isChangedMapper) throws Exception { Set<String> isChangedMapperTemp = isChangedMapper.stream().map(item -> "repository." + StringUtils.split(item, CommonConstant.CHAR_SPOT)[0]).collect(Collectors.toSet()); Field field = classConfig.getDeclaredField(fieldName); field.setAccessible(true); Map mapConfig = (Map) field.get(configuration); Map tempMap = new HashMap(); tempMap.putAll(mapConfig); tempMap.forEach((key, value) -> { if (StringUtils.StringContains((String) key, isChangedMapperTemp)) mapConfig.remove(key); }); } private void clearSet(Class<?> classConfig, Configuration configuration, String fieldName, Set<String> isChangedMapper) throws Exception { Set<String> isChangedMapperTemp = isChangedMapper.stream().map(item -> "repository/" + StringUtils.split(item, CommonConstant.CHAR_SPOT)[0]).collect(Collectors.toSet()); isChangedMapperTemp.addAll(isChangedMapper.stream().map(item -> "repository." + StringUtils.split(item, CommonConstant.CHAR_SPOT)[0]).collect(Collectors.toSet())); Field field = classConfig.getDeclaredField(fieldName); field.setAccessible(true); Set setConfig = (Set) field.get(configuration); Set tempMap = new HashSet<>(); tempMap.addAll(setConfig); tempMap.forEach(item -> { if (StringUtils.StringContains((String) item, isChangedMapperTemp)) setConfig.remove(item); }); } public void scan() throws IOException { if (!fileMapping.isEmpty()) { return; } Resource[] resources = mapperXmlFiles; if (resources != null) { for (int i = 0; i < resources.length; i++) { String multi_key = getValue(resources[i]); String fileName = resources[i].getFilename(); fileMapping.put(fileName, multi_key); logger.info("monitor Mybatis mapper file:{}", resources[i].getFile().getAbsolutePath()); } } } private String getValue(Resource resource) throws IOException { String contentLength = String.valueOf((resource.contentLength())); String lastModified = String.valueOf((resource.lastModified())); return new StringBuilder(contentLength).append(lastModified).toString(); } public boolean isChanged() throws IOException { boolean isChanged = false; Resource[] resources = mapperXmlFiles; if (resources != null) { for (int i = 0; i < resources.length; i++) { String name = resources[i].getFilename(); String value = fileMapping.get(name); String multi_key = getValue(resources[i]); if (!multi_key.equals(value)) { isChanged = true; fileMapping.put(name, multi_key); isChangedMapper.add(name); logger.info("reload Mybatis mapper file:{}", resources[i].getFile().getAbsolutePath()); } } } return isChanged; } } } 希望园友多多提意见...

优秀的个人博客,低调大师

Docker部署centos7容器

操作系统:centos7.2.1511 centos镜像:centos7.2.1511 安装docker yum -y install docker 启动docker systemctl start docker 发现启动不了,报错: Error starting daemon: SELinux is not supported with the overlay2 graph driver on this kernel. Either boot into a newer kernel or disable selinux ...enabled=false) 修改配置文件 vim /etc/sysconfig/docker OPTIONS='--selinux-enabled=false' 再次启动服务 systemctl start docker systemctl status docker ● docker.service - Docker Application Container Engine Loaded: loaded (/usr/lib/systemd/system/docker.service; disabled; vendor preset: disabled) Active: active (running) since Tue 2018-07-17 05:48:54 CST; 20s ago Docs: http://docs.docker.com 下载centos7.2镜像 docker pull daocloud.io/library/centos:centos7.2.1511 docker images REPOSITORY TAG IMAGE ID CREATED SIZE daocloud.io/library/centos centos7.2.1511 0a2bad7da9b5 8 months ago 195 MB Systemd整合 因为 systemd 要求 CAPSYSADMIN 权限,从而得到了读取主机 cgroup 的能力,CentOS7 中已经用 fakesystemd 代替了 systemd 来解决依赖问题,如果仍然希望使用 systemd,可用下面的 Dockerfile cat > Dockerfile <<EOF FROM 0a2bad7da9b5 MAINTAINER Testder 10000@testder.cn ENV container docker RUN yum -y swap -- remove fakesystemd -- install systemd systemd-libs RUN yum -y update; yum clean all; \ (cd /lib/systemd/system/sysinit.target.wants/; for i in *;\ do [ $i == systemd-tmpfiles-setup.service ] || rm -f $i; done); \ rm -f /lib/systemd/system/multi-user.target.wants/*;\ rm -f /etc/systemd/system/*.wants/*;\ rm -f /lib/systemd/system/local-fs.target.wants/*; \ rm -f /lib/systemd/system/sockets.target.wants/*udev*; \ rm -f /lib/systemd/system/sockets.target.wants/*initctl*; \ rm -f /lib/systemd/system/basic.target.wants/*;\ rm -f /lib/systemd/system/anaconda.target.wants/*; VOLUME [ "/sys/fs/cgroup" ] CMD ["/usr/sbin/init"] EOF 构建基础镜像 docker build --rm -t centos7.2 . 后台运行Centos容器 为了运行一个包含 systemd 的容器,您需要使用–privileged选项, 并且挂载主机的 cgroups 文件夹。 下面是运行包含 systemd 容器的示例命令: docker run -itd --name centos7.2 --privileged -v /sys/fs/cgroup:/sys/fs/cgroup:ro centos7.2 641f23dce23355729dfb8e99e5df467574eb116afbb1c50e71e272e952451d03 使用exec进入Centos容器,systemd启动成功 docker exec -it centos7.2 /bin/bash [root@641f23dce233 /]# yum -y install httpd [root@641f23dce233 /]# systemctl start httpd

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册