首页 文章 精选 留言 我的

精选列表

搜索[java8],共826篇文章
优秀的个人博客,低调大师

JAVA8 MAP新增方法详解

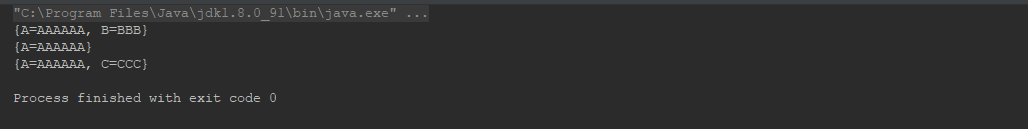
1、compute default V compute(K key,BiFunction<? super K,? super V,? extends V> remappingFunction)Attempts to compute a mapping for the specified key and its current mapped value (or null if there is no current mapping). 尝试通过Lambda表达式重新计算给定KEY的映射值并更新MAP(值为null则删除KEY,否则重新写入)。 Map<String, String> tMap = new HashMap<String, String>() { { put("A", "AAA"); put("B", "BBB"); } }; tMap.compute("A", (k, v) -> v == null ? "AAA" : v.concat("AAA"));//KEY存在VALUE不为空且Lambda计算结果不为空,更新KEY System.out.println(tMap); tMap.compute("B", (k, v) -> v == null ? "BBB" : null);//KEY存在VALUE不为空但Lambda计算结果为空,删除KEY System.out.println(tMap); tMap.compute("C", (k, v) -> v == null ? "CCC" : v.concat("CCC"));//KEY不存在但Lambda计算结果不为空,新增KEY System.out.println(tMap); 2、computeIfAbsent default V computeIfAbsent(K key,Function<? super K,? extends V> mappingFunction) If the specified key is not already associated with a value (or is mapped to null), attempts to compute its value using the given mapping function and enters it into this map unless null. 如果给定的KEY为关联VALUE或关联到null,则尝试通过给定的Lambda函数计算其值并写入MAP(值为null则不写入)。 Map<String,String> map = new HashMap<>(); map.computeIfAbsent("A",k -> null); System.out.println(map); map.computeIfAbsent("B",k -> "BBB"); System.out.println(map); 3、computeIfPresent default V computeIfPresent(K key,BiFunction<? super K,? super V,? extends V> remappingFunction) If the value for the specified key is present and non-null, attempts to compute a new mapping given the key and its current mapped value.如果给定KEY存在映射值且非null,尝试通过Lambda表达式计算新值并更新MAP If the function returns null, the mapping is removed. If the function itself throws an (unchecked) exception, the exception is rethrown, and the current mapping is left unchanged.如果Lambda计算结果为null,则删除KEY。如果Lambda计算发生异常,则原映射关系不变。 Map<String, String> tMap = new HashMap<String, String>() { { put("A", "AAA"); put("B", "BBB"); } }; tMap.computeIfPresent("A", (k, v) -> v == null ? "AAA" : v.concat("AAA"));//Lambda计算结果不为空,更新KEY System.out.println(tMap); tMap.computeIfPresent("B", (k, v) -> v == null ? "BBB" : null);//Lambda计算结果为空,删除KEY System.out.println(tMap);

优秀的个人博客,低调大师

java8新特性(四)_Stream详解

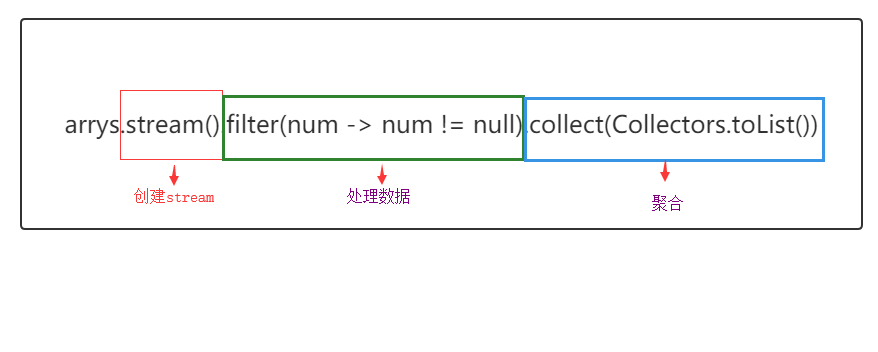
之前写过一篇用stream处理map的文章,但是对stream没有一个整体的认识,这次结合并发编程网和ibm中介绍stream的文章进行一个总结,我会着重写对list的处理,毕竟实际工作中大家每天进行使用 Stream简单介绍 定义 A sequence of elements supporting sequential and parallel aggregate operations. 支持顺序并行聚合操作的元素序列 看看大神们怎么解读的 大家可以把Stream当成一个高级版本的Iterator。原始版本的Iterator,用户只能一个一个的遍历元素并对其执行某些操作;高级版本的Stream,用户只要给出需要对其包含的元素执行什么操作,比如“过滤掉长度大于10的字符串”、“获取每个字符串的首字母”等,具体这些操作如何应用到每个元素上,就给Stream就好了 简单demo 写一个过滤null的简单功能 public static void main(String[] args) { List arrys = Arrays.asList(1, null, 3, 4); arrys.forEach(System.out::print); System.out.println(); arrys = (List) arrys.stream() .filter(num -> num != null) .collect(Collectors.toList()); arrys.forEach(System.out::print); } 执行结果 1null34 134 解析代码 1、 创建Stream; 2、 转换Stream(处理数据),每次转换原有Stream对象不改变,返回一个新的Stream对象(可以有多次转换); 3、 对Stream进行聚合(Reduce)操作,获取想要的结果; 创建Stream 最常用的创建Stream有两种途径: 通过Stream接口的静态工厂方法 通过Collection接口的默认方法–stream(),把一个Collection对象转换成Stream(之前写的文章对于map的处理就是基于这个) // 1. Individual values Stream stream = Stream.of("a", "b", "c"); // 2. Arrays String [] strArray = new String[] {"a", "b", "c"}; stream = Stream.of(strArray); stream = Arrays.stream(strArray); // 3. Collections(实际工作中经常用到) List<String> list = Arrays.asList(strArray); stream = list.stream(); 转换Stream方法详解 这里其实是大家常用到的,着重讲解这里,这里的图片来自并发编程网,不得不佩服,程序写的好,画图也比我画的好 distinct distinct: 对于Stream中包含的元素进行去重操作(去重逻辑依赖元素的equals方法),新生成的Stream中没有重复的元素; 示意图 代码演示 public static void main(String[] args) { List<String> list = Arrays.asList("java---", "java---", "erlang---", "lua---", "lua---"); list.forEach(System.out::print); System.out.println(); list = list.stream() .distinct() .collect(Collectors.toList()); list.forEach(System.out::print); } 结果 java---java---erlang---lua---lua--- java---erlang---lua--- filter filter: 对于Stream中包含的元素使用给定的过滤函数进行过滤操作,新生成的Stream只包含符合条件的元素; 示意图 代码演示 public static void main(String[] args) { List<String> list = Arrays.asList("java---", "java---", "erlang---", "lua---", "lua---"); list.forEach(System.out::print); System.out.println(); list = list.stream() .filter(e -> e.length() > 7) .collect(Collectors.toList()); list.forEach(System.out::print); } 结果 java---java---erlang---lua---lua--- erlang--- map map:它的作用就是把 input Stream 的每一个元素,映射成 output Stream 的另外一个元素。 示意图 代码演示 public static void main(String[] args) { List<String> list = Arrays.asList("java---", "java---", "erlang---", "lua---", "lua---"); list.forEach(System.out::print); System.out.println(); list = list.stream() .map(String::toUpperCase) .collect(Collectors.toList()); list.forEach(System.out::print); } 结果 java---java---erlang---lua---lua--- JAVA---JAVA---ERLANG---LUA---LUA--- limit limit: 对一个Stream进行截断操作,获取其前N个元素,如果原Stream中包含的元素个数小于N,那就获取其所有的元素; 示意图 代码演示 public static void main(String[] args) { List<String> list = Arrays.asList("java---", "java---", "erlang---", "lua---", "lua---"); list.forEach(System.out::print); System.out.println(); list = list.stream() .limit(3) .collect(Collectors.toList()); list.forEach(System.out::print); } 结果 java---java---erlang---lua---lua--- java---java---erlang--- skip skip:返回一个丢弃原Stream的前N个元素后剩下元素组成的新Stream,如果原Stream中包含的元素个数小于N,那么返回空Stream; 示意图 代码演示 public static void main(String[] args) { List<String> list = Arrays.asList("java---", "java---", "erlang---", "lua---", "lua---"); list.forEach(System.out::print); System.out.println(); list = list.stream() .skip(3) .collect(Collectors.toList()); list.forEach(System.out::print); } 结果 java---java---erlang---lua---lua--- lua---lua--- findFirst findFirst:它总是返回 Stream 的第一个元素,或者空。这里比较重点的是它的返回值类型:Optional 示意图 代码演示 public static void main(String[] args) { List<String> list = Arrays.asList("java---", "java---", "erlang---", "lua---", "lua---"); list.forEach(System.out::print); System.out.println(); Optional<String> first = list.stream() .findFirst(); System.out.println(first.get()); } 结果 java---java---erlang---lua---lua--- java--- 总结 当然,还有很多方法,这里不一一介绍,现实工作中使用常常结合起来 比如这段代码就是之前文章 过滤map 中 null值和空串的例子 public static Map<String, Object> parseMapForFilterByOptional(Map<String, Object> map) { return Optional.ofNullable(map).map( (v) -> { Map params = v.entrySet().stream() .filter((e) -> checkValue(e.getValue())) .collect(Collectors.toMap( (e) -> (String) e.getKey(), (e) -> e.getValue() )); return params; } ).orElse(null); } 总之,Stream 的特性可以归纳为: 不是数据结构 它没有内部存储,它只是用操作管道从 source(数据结构、数组、generator function、IO channel)抓取数据。 它也绝不修改自己所封装的底层数据结构的数据。例如 Stream 的 filter 操作会产生一个不包含被过滤元素的新 Stream,而不是从 source 删除那些元素。 所有 Stream 的操作必须以 lambda 表达式为参数 参考文章 -[1.]https://ifeve.com/stream/ -[2.]https://www.ibm.com/developerworks/cn/java/j-lo-java8streamapi/ 学习不是要么0分,要么100分的。80分是收获;60分是收获;20分也是收获。有收获最重要。但是因为着眼于自己的不完美,最终放弃了,那就是彻底的0分了。

优秀的个人博客,低调大师

【源码分析】HashMap源码再读-基于Java8

最近工作不是太忙,准备再读读一些源码,想来想去,还是先从JDK的源码读起吧,毕竟很久不去读了,很多东西都生疏了。当然,还是先从炙手可热的HashMap,每次读都会有一些收获。当然,JDK8对HashMap有一次优化 一、一些参数 我们首先看到的,应该是它的一些基本参数,这对于我们了解HashMap有一定的作用。他们分别是: 参数 说明 capacity 容量,默认为16,最大为2^30 loadFactor 加载因子,默认0.75 threshold resize的阈值,capacity * loadFactor,元素数量达到这个值后就必须扩容 treeify_threshold 红黑树的阈值,数组中的某个节点下挂的节点数大于这个值之后,节点的数据结构就会从链表变为红黑树 二、重要方法 我们知道,HashMap底层是通过数组+链表来实现的。具体的图网上有很多,我们主要看看几个重要的方法。 2.1 构造方法 他的构造方法,最本质的构造方法是: public HashMap(int initialCapacity, float loadFactor) { if (initialCapacity < 0) throw new IllegalArgumentException("Illegal initial capacity: " + initialCapacity); if (initialCapacity > MAXIMUM_CAPACITY) initialCapacity = MAXIMUM_CAPACITY; if (loadFactor <= 0 || Float.isNaN(loadFactor)) throw new IllegalArgumentException("Illegal load factor: " + loadFactor); this.loadFactor = loadFactor; this.threshold = tableSizeFor(initialCapacity); } 前面几行就是做一些基本的检查,我们看到,HashMap的最大容量是<u>MAXIMUM_CAPACITY</u>,也就是2^30,我们日常使用时可能达不到这样的容量,但是如果真的需要在Map存储这么多的数据,还是建议存在其他的地方吧。当然,最后一行中时为了计算下一次resize的容量阈值,也就是计算出下一次resize的threshold。 2.2 计算容量 这个方法较简单,直接返回的是一个size的值,这个参数的含义就是当前Map中存储的KV对的数量,而不是整个Map的容量。 public int size() { return size; } 2.3 put(K,V) 这个方法是HashMap中比较重要的一个方法,我们仔细分析一下。 2.3.1 主入口 首先,方法的入口是这个,也就是我们经常使用的就是这个方法: public V put(K key, V value) { return putVal(hash(key), key, value, false, true); } 我们主要看的,就是put的整个过程。 2.3.2 hash(key) 首先就是对我们传入的key,进行hash计算。 static final int hash(Object key) { int h; return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16); } 从这个方法,我们可以看到,HashMap的key是可以为null的,如果是null的话,那么我们的hash方法返回的hash值是0。 如果key不是null,那么调用的是HashMap本身的hashCode方法,也就是我们的bean中自定义的hashCode()。不要以为这样就结束了。我们一般来说,一个key的hash值的范围也就是int的范围(从-2147483648到2147483648),但是HashMap的容量是有限的,必须把hash值能够分散到HashMap的数组中去。HashMap为了key在数组中更加分散,还会进行一次计算,也就是我们看到的第二行的方法。具体这块是如何分配均匀的,可以参考这篇文章。 2.3.3 putVal() 这个方法就是将KV放到对应的桶中。这个方法的过程,比较清晰。 final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) { Node<K,V>[] tab; Node<K,V> p; int n, i; if ((tab = table) == null || (n = tab.length) == 0) //如果之前的数组为空,那么新建一个默认的数组 n = (tab = resize()).length; if ((p = tab[i = (n - 1) & hash]) == null) //如果hash值计算出来在数组中的位置上,没有元素,那么直接插入到数组中 tab[i] = newNode(hash, key, value, null); else { Node<K,V> e; K k; if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))) //如果算出的hash存在,而且kv完全一致的话,那么目前什么也不做 e = p; else if (p instanceof TreeNode) //如果数组中的元素是红黑树,那么将kv插入到红黑树中 e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value); else { for (int binCount = 0; ; ++binCount) { if ((e = p.next) == null) { //如果hash的桶中,已经存在了一个链表,那么新增一个节点,放到链表的尾部 p.next = newNode(hash, key, value, null); //如果链表的长度大于树化的阈值,那么将链表转为红黑树 if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st treeifyBin(tab, hash); break; } if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) break; p = e; } } //如果当前数组中存在相同的kv,那么根据是否替换来判断,如果不替换,那么就不替换 if (e != null) { // existing mapping for key V oldValue = e.value; if (!onlyIfAbsent || oldValue == null) e.value = value; afterNodeAccess(e); return oldValue; } } ++modCount; if (++size > threshold) //如果空间需要进行扩容,那么进行resize操作 resize(); afterNodeInsertion(evict); return null; } 至此,putVal的方法过程基本上清楚了,但是里面有个非常重要的方法,就是resize,我们下面就进入resize方法,看看到底是如何扩容的。 2.4 resize() 这个过程是HashMap扩容的过程,也是需要重点理解的一块。 我们首先看下第一部分。 2.4.1 确定容量和扩容阈值 Node<K,V>[] oldTab = table; int oldCap = (oldTab == null) ? 0 : oldTab.length; int oldThr = threshold; int newCap, newThr = 0; if (oldCap > 0) { //如果目前容量已经是最大容量,那么扩容阈值为int的最大值,所有的节点都不需要移动 if (oldCap >= MAXIMUM_CAPACITY) { threshold = Integer.MAX_VALUE; return oldTab; } //如果oldCap*2小于最大容量,并且oldCap>=16,扩容为2倍,扩容阈值也*2 else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY && oldCap >= DEFAULT_INITIAL_CAPACITY) newThr = oldThr << 1; } else if (oldThr > 0) // initial capacity was placed in threshold newCap = oldThr; else {// 默认值 newCap = DEFAULT_INITIAL_CAPACITY; newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY); } if (newThr == 0) {//计算新的扩容阈值 float ft = (float)newCap * loadFactor; newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY ? (int)ft : Integer.MAX_VALUE); } threshold = newThr; 这个过程,主要是确定新的容量和扩容阈值。 2.4.2 节点移动 if (oldTab != null) { for (int j = 0; j < oldCap; ++j) {//遍历老的数组 Node<K,V> e; if ((e = oldTab[j]) != null) { oldTab[j] = null; if (e.next == null)//如果老的链表,只有一个KV,直接将这个KV放到新的数组链表中 newTab[e.hash & (newCap - 1)] = e; else if (e instanceof TreeNode)//如果老的是红黑树,需要将红黑树中的每个元素都拆分到新的数组和链表/红黑树中 ((TreeNode<K,V>)e).split(this, newTab, j, oldCap); else { // 如果节点是链表,而且不止一个KV的情况下,需要对链表进行处理,处理的过程,光看代码理解起来较困难,需要通过例子来理解 Node<K,V> loHead = null, loTail = null; Node<K,V> hiHead = null, hiTail = null; Node<K,V> next; do { next = e.next; if ((e.hash & oldCap) == 0) { if (loTail == null) loHead = e; else loTail.next = e; loTail = e; } else { if (hiTail == null) hiHead = e; else hiTail.next = e; hiTail = e; } } while ((e = next) != null); if (loTail != null) { loTail.next = null; newTab[j] = loHead; } if (hiTail != null) { hiTail.next = null; newTab[j + oldCap] = hiHead; } } } } } 我们需要知道,坐标点的计算方法是e.hash & (cap-1)。 没有进行扩容时,假设原来的cap=16,也就是默认值,扩容后容量为32。对于hash值为5(二进制为0000 0101)和21(二进制为0001 0101)的元素来讲,计算坐标,也就是和15(二进制为0000 1111)计算后的坐标点都是5,会落到同一个链表中。 但是扩容后,需要求与的变成了31(二进制为0001 1111),算出来的坐标点分别为5和21,第二个坐标点增加了oldCap的长度。 此时再看e.hash & oldCap的计算结果,也就是将5和21和16(二进制为0001 0000)求与,得到的结果分别是0和16(!=0)。可以看到,当e.hash & oldCap得到0时,坐标不需要进行变动,也就是不需要在数组中的位置不需要移动。如果结果不为0,需要在原来坐标的位置,增加oldCap。 这里的lo和hi也就是两个链表,表示的是低位和高位的两条链表。 三、线程不安全的问题 我们都知道,HashMap不是线程安全的。这块主要体现在两块: 3.1 get和put 这两块都没有加锁,所以可能会导致多线程执行时,出现数据被覆盖的问题。 3.2 死循环的问题 这个问题主要出现在resize的过程中,多线程都探测到需要resize时,将链表元素rehash过程中,可能会导致死循环。这个问题参考这篇文章。 至此,源码分析基本结束,我们还可以思考,为什么cap必须是2的幂次,我们应该如何正确的初始化HashMap等。 欢迎大家关注我的公众号,有各种一线分享。

优秀的个人博客,低调大师

java8中的时间处理1 - LocalDate

LocalDate 是日期的不可变类,默认格式yyyy-MM-dd. 可以用 now() 方法获取当前日期,也可以传入年月日创建实例。这个类还提供了now()的重载方法,可以传入一个时区拿到现在那个时区的日期. java.sql.Date有的功能它都有。 import java.time.LocalDate; import java.time.Month; import java.time.ZoneId; /** * LocalDate Examples * @author somefuture * */ public class LocalDateExample { public static void main(String[] args) { LocalDate today = LocalDate.now(); System.out.println("当前日期"+today); LocalDate firstDay_2014 = LocalDate.of(2014, Month.JANUARY, 1); System.out.println("特定日期"+firstDay_2014); //输入不合法参数会构造失败!这个有点意思 //LocalDate feb29_2014 = LocalDate.of(2014, Month.FEBRUARY, 29); //Exception in thread "main" java.time.DateTimeException: //Invalid date 'February 29' as '2014' is not a leap year因为2014年不是闰年 //时区时间,可以用Asia/Shanghai或UTC+8 LocalDate todayShanghai = LocalDate.now(ZoneId.of("Asia/Shanghai")); System.out.println("上海日期"+todayShanghai); //时区错误会报错 //LocalDate todayIST = LocalDate.now(ZoneId.of("IST")); //从1970年创建时间 LocalDate dateFromBase = LocalDate.ofEpochDay(365); System.out.println("1970年的365天后是"+dateFromBase); LocalDate hundredDay2014 = LocalDate.ofYearDay(2014, 100); System.out.println("2014年第100天是"+hundredDay2014); //2014年第100天是2014-04-10 } }

优秀的个人博客,低调大师

java8中的时间处理2 - LocalTime

LocalTime是不可变的时间类,默认格式hh:mm:ss.zzz. 和LocalDate一样,这个类也有时区信息,并且可以通过时分秒创建。 import java.time.LocalTime; import java.time.ZoneId; /** * LocalTime Examples * @author somefuture * */ public class LocalTimeExample { public static void main(String[] args) { LocalTime time = LocalTime.now(); System.out.println("当前时间"+time); LocalTime specificTime = LocalTime.of(12,20,25,40); System.out.println("特定时间"+specificTime); //拿到其他时区时间 LocalTime time2 = LocalTime.now(ZoneId.of("UTC+2")); System.out.println("东二区现在"+time2); LocalTime specificSecondTime = LocalTime.ofSecondOfDay(10000); System.out.println("零点后一万秒"+specificSecondTime); //这里注意 不能差到一天以上 不然报错 } }

优秀的个人博客,低调大师

java8中的时间处理4 - Instant

Instant 类是机器易读的时间信息,存放的是unix时间戳。 import java.time.Duration; import java.time.Instant; public class InstantExample { public static void main(String[] args) { Instant timestamp = Instant.now(); System.out.println("当前时间 = "+timestamp); Instant specificTime = Instant.ofEpochMilli(timestamp.toEpochMilli()); System.out.println("特定时间 = "+specificTime); //时间段 Duration thirtyDay = Duration.ofDays(30); System.out.println(thirtyDay); } }

优秀的个人博客,低调大师

Java删除空字符:Java8 & Java11

操作字符串是编程时经常遇到的,常用的比如在字符串中处理空格。到目前为止,Java提供了很多从字符串中删除空格的不同方法,即trim,replaceAll。但是,Java 11通过诸如strip,stripLeading和stripTrailing之类的方法对这些方法进行了一些功能性的拓展。 在大多数情况下,我们只使用trim()方法删除空格。有时候不禁停下来想一想是否有更好的方法来满足我们的需求?当然,trim()在大多数情况下都能很好地工作,但是java中有许多不同的方法。每种都有自己的优点和缺点。 在本文中,将详细介绍在Java中从字符串中删除空格的不同方法 trim():从字符串中删除前缀和后缀空格 strip():删除字符串开头和结尾的空格。strip()方法支持Unicode字符集 trim vs strip:trim和strip方法之间的差异 stripLeading():仅从字符串开头删除空格 stripTrailing():仅从字符串末尾删除空格 replace():用新字符替换所有目标字符 replaceAll():将所有正则匹配的字符替换为新字符 replaceFirst():使用新替换字符串替换第一次匹配成功的子字符串 需要注意的最重要一点是,在Java中,字符串对象是不可变的。这意味着我们无法修改字符串,因此所有方法都将通过所有转换返回新字符串。 trim()方法 trim()是Java开发人员最常用的删除前导和尾随空格的方法。对于trim()方法,空格字符是指*ASCII值小于或等于32('U + 0020')*的任何字符。 publicclassFunTester{publicstaticvoidmain(String[]args){Stringstring="onetwothree";System.out.println("原始字符串:\""+string+"\"");System.out.println("处理结果:\""+string.trim()+"\"");}} 控制台输出: 原始字符串:"onetwothree"处理结果:"onetwothree" strip()方法 在Java 11发行版中,添加了新的strip()方法以从String中删除前缀和后缀空格。 添加此方法的原因是,根据Unicode标准,存在各种空格字符,其ASCII值大于32('U + 0020')。例如:8193(U + 2001)。为了识别这些空格字符,Java 1.5从Character类中添加了新方法isWhitespace(int)。此方法使用unicode识别空格字符。strip()方法使用此Character.isWhitespace(int)方法覆盖广泛的空白字符并将其删除。 publicclassStringStripTest{publicstaticvoidmain(String[]args){Stringstring="onetwothree";System.out.println("原始字符串:\""+string+"\"");System.out.println("处理结果:\""+string.strip()+"\"");}} 控制台输出: 原始字符串:"Stringwithspace"处理结果:"onetwothree" Java中trim和strip方法之间的区别 trim() strip() 从Java 1 从Java 11 使用ASCII值 使用Unicode值 删除前缀和后缀字符(空格) 删除前缀和后缀字符(空格) 删除ASCII值小于或等于'U+0020'或'32'的字符 根据Unicode删除所有空格字符 让我们看一下使用大于 32('U+0020')的 unicode的空白字符。 publicclassStringTrimVsStripTest{publicstaticvoidmain(String[]args){Stringstring='\u2001'+"onetwothree"+'\u2001';System.out.println("原始字符串:\""+string+"\"");System.out.println("处理结果:\""+string.trim()+"\"");System.out.println("处理结果:\""+string.strip()+"\"");}} 控制台输出: 原始字符串:"onetwothree"处理结果:"onetwothree"处理结果:"onetwothree" 在上面的示例中,我们可以看到trim()方法无法删除由**'\u2001'Unicode**字符添加的空格字符。 注意:如果在Windows计算机上运行,则由于限制了 unicode设置,可能看不到类似的输出。 stripLeading()方法 Java 11中添加了stripLeading()方法,可从String中删除所有前缀空格。与strip()方法类似,stripLeading()也使用Character.isWhitespace(int)识别空白字符。 publicclassStringStripLeadingTest{publicstaticvoidmain(String[]args){Stringstring="onetwothree";System.out.println("原始字符串:\""+string+"\"");System.out.println("处理结果:\""+string.stripLeading()+"\"");}} 控制台输出: 原始字符串:"onetwothree"处理结果:"onetwothree" stripTrailing()方法 Java 11中增加了stripTrailing()方法,可从String中删除所有后缀空格。与stripLeading()方法类似,stripTrailing()也使用Character.isWhitespace(int)识别空白。 publicclassStringStripTrailingTest{publicstaticvoidmain(String[]args){Stringstring="onetwothree";System.out.println("原始字符串:\""+string+"\"");System.out.println("处理结果:\""+string.stripTrailing()+"\"");}} 控制台输出: 原始字符串:"onetwothree"处理结果:"onetwothree" replace(CharSequence target, CharSequence replacement): 从Java 1.5中添加,此方法用于将每个目标子字符串替换为指定的替换字符串。此方法替换所有匹配的目标字符。 注意: java中的 String类中提供了另一种方法 replace(char oldChar,char newChar)。区别在于该方法参数是字符,而不是字符串。 publicclassStringReplaceTest{publicstaticvoidmain(String[]args){Stringstring="onetwothree";System.out.println("原始字符串:\""+string+"\"");System.out.println("处理结果:\""+string.replace("","")+"\"");}} 控制台输出: 原始字符串:"onetwothree"处理结果:"onetwothree" replaceAll(String regex, String replacement) 在Java 1.4中添加,这是最强大的字符串处理方法之一。使用replaceAll()方法,我们可以使用给定的替换字符串替换每个匹配的正则表达式子字符串。例如,删除所有空格,删除前导空格,删除尾随空格等等。我们只需要创建带有正确替换参数的正确正则表达式即可。参考:Java和Groovy正则使用。 在Java中添加'/',我们必须使用转义字符,因此对于 \s+,必须使用 \\s+ publicclassStringReplaceAllTest{publicstaticvoidmain(String[]args){Stringstring="onetwothree";System.out.println("原始字符串:\""+string+"\"");System.out.println("处理结果:\""+string.replaceAll("","")+"\"");System.out.println("处理结果:\""+string.replaceAll("\\s+","")+"\"");System.out.println("处理结果:\""+string.replaceAll("^\\s+","")+"\"");System.out.println("处理结果:\""+string.replaceAll("\\s+$","")+"\"");}} 控制台输出: 原始字符串:"onewiththree"处理结果:"onetwothree"处理结果:"onetwothree"处理结果:"onetwothree"处理结果:"onetwothree" replaceFirst(String regex, String replacement) 在Java 1.4中添加了replaceFirst()方法,只用替换字符串替换给定正则表达式的第一个匹配项,用于替换一个第一次出现的位置。例如,如果我们只需要删除前缀空格,则可以使用\\s+或^\\s+。还可以使用此方法通过使用\\s+$正则表达式删除后缀空格。 publicclassStringReplaceFistTest{publicstaticvoidmain(String[]args){Stringstring="onetwothree";System.out.println("原始字符串:\""+string+"\"");System.out.println("处理结果:\""+string.replaceFirst("three","four")+"\"");System.out.println("处理结果:\""+string.replaceFirst("\\s+","")+"\"");System.out.println("处理结果:\""+string.replaceFirst("\\s+$","")+"\"");}} 控制台输出: 原始字符串:"onetwothree"处理结果:"onetwofour"处理结果:"onetwothree"处理结果:"onetwothree" 「公众号FunTester首发,原创分享爱好者,腾讯云和掘金社区首页推荐,知乎七级原创作者,欢迎关注、交流,禁止第三方擅自转载。」 FunTester热文精选 接口功能测试专辑 性能测试专题 写给所有人的编程思维 2020年Tester自我提升 未来的神器fiddler Everywhere 测试开发工程师工作技巧 Fiddler Everywhere工具答疑 Selenium4 IDE,它终于来了 质量管理计划的基本要素 本文分享自微信公众号 - FunTester(NuclearTester)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

《Java8实战》笔记(10):用Optional取代null

用Optional取代null 本文的代码 众所周知,对任何一位Java程序员来说,无论是初出茅庐的素人,还是久经江湖的老司机,NullPointerException都是他心中的痛,可是我们又无能为力,因为这就是我们为了使用方便甚至不可避免的像null引用这样的构造所付出的代价。这就是程序设计世界里大家都持有的观点,然而,这可能并非事实的全部真相,只是我们根深蒂固的一种偏见。 1965年,英国一位名为Tony Hoare的计算机科学家在设计ALGOL W语言时提出了null引用的想法。 如何为缺失的值建模 假设你需要处理下面这样的嵌套对象,这是一个拥有汽车及汽车保险的客户。 public class Person { private Car car; public Car getCar() { return car; } } public class Car { private Insurance insurance; public Insurance getInsurance() { return insurance; } } public class Insurance { private String name; public String getName() { return name; } } public String getCarInsuranceName(Person person) { return person.getCar().getInsurance().getName(); } 这段代码看起来相当正常,但是现实生活中很多人没有车。所以调用getCar方法的结果会怎样呢?在实践中,一种比较常见的做法是返回一个null引用,表示该值的缺失,即用户没有车。 而接下来,对getInsurance的调用会返回null引用的insurance,这会导致运行时出现一个NullPointerException,终止程序的运行。但这还不是全部。如果返回的person值为null会怎样?如果getInsurance的返回值也是null,结果又会怎样? 采用防御式检查减少NullPointerException 怎样做才能避免这种不期而至的NullPointerException呢?通常,你可以在需要的地方添加null的检查(过于激进的防御式检查甚至会在不太需要的地方添加检测代码),并且添加的方式往往各有不同。 深层质疑 public String getCarInsuranceName(Person person) { if (person != null) { Car car = person.getCar(); if (car != null) { Insurance insurance = car.getInsurance(); if (insurance != null) { return insurance.getName(); } } } return "Unknown"; } 标记为“深层质疑”,原因是它不断重复着一种模式:每次你不确定一个变量是否为null时,都需要添加一个进一步嵌套的if块,也增加了代码缩进的层数。很明显,这种方式不具备扩展性,同时还牺牲了代码的可读性。 过多的退出语句 public String getCarInsuranceName(Person person) { if (person == null) { return "Unknown"; } Car car = person.getCar(); if (car == null) { return "Unknown"; } Insurance insurance = car.getInsurance(); if (insurance == null) { return "Unknown"; } return insurance.getName(); } 你试图避免深层递归的if语句块,采用了一种不同的策略:每次你遭遇null变量,都返回一个字符串常量“Unknown”。然而,这种方案远非理想,现在这个方法有了四个截然不同的退出点,使得代码的维护异常艰难。更糟的是,发生null时返回的默认值,即字符串“Unknown”在三个不同的地方重复出现——出现拼写错误的概率不小!当然,你可能会说,我们可以用把它们抽取到一个常量中的方式避免这种问题。 进一步而言,这种流程是极易出错的;如果你忘记检查了那个可能为null的属性会怎样?你会了解使用null来表示变量值的缺失是大错特错的。 null带来的种种问题 在Java程序开发中使用null会带来理论和实际操作上的种种问题 它是错误之源 。NullPointerException是目前Java程序开发中最典型的异常。 它会使你的代码膨胀。它让你的代码充斥着深度嵌套的null检查,代码的可读性糟糕透顶。 它自身是毫无意义的。null自身没有任何的语义,尤其是,它代表的是在静态类型语言中以一种错误的方式对 缺失变量值的建模。 它破坏了Java的哲学。Java一直试图避免让程序员意识到指针的存在,唯一的例外是:null指针。 它在Java的类型系统上开了个口子。null并不属于任何类型,这意味着它可以被赋值给任意引用类型的变量。这会导致问题,原因是当这个变量被传递到系统中的另一个部分后,你将无法获知这个null变量最初的赋值到底是什么类型。 其他语言中null的替代品 比如Groovy,通过引入安全导航操作符(Safe Navigation Operator,标记为?)可以安全访问可能为null的变量。 def carInsuranceName = person?.car?.insurance?.name 几乎所有的Java程序员碰到NullPointerException时的第一冲动就是添加一个if语句,在调用方法使用该变量之前检查它的值是否为null,快速地搞定问题。如果你按照这种方式解决问题,丝毫不考虑你的算法或者你的数据模型在这种状况下是否应该返回一个null,那么你其实并没有真正解决这个问题,只是暂时地掩盖了问题,使得下次该问题的调查和修复更加困难,而你很可能就是下个星期或下个月要面对这个问题的人。刚才的那种方式实际上是掩耳盗铃,只是在清扫地毯下的灰尘。 而Groovy的null安全解引用操作符也只是一个更强大的扫把,让我们可以毫无顾忌地犯错。你不会忘记做这样的检查,因为类型系统会强制你进行这样的操作。 另一些函数式语言,比如Haskell、Scala,试图从另一个角度处理这个问题。Haskell中包含了一个Maybe类型,它本质上是对optional值的封装。Maybe类型的变量可以是指定类型的值,也可以什么都不是。 但是它并没有null引用的概念。Scala有类似的数据结构,名字叫Option[T],它既可以包含类型为T的变量,也可以不包含该变量要使用这种类型,你必须显式地调用Option类型的available操作,检查该变量是否有值,而这其实也是一种变相的“null检查”。 Optional类入门 汲取Haskell和Scala的灵感,Java 8中引入了一个新的类java.util.Optional<T>。这是一个封装Optional值的类。举例来说,使用新的类意味着,如果你知道一个人可能有也可能没有车,那么Person类内部的car变量就不应该声明为Car,遭遇某人没有车时把null引用赋值给它,而是应该直接将其声明为Optional<Car>类型。 变量存在时,Optional类只是对类简单封装。变量不存在时,缺失的值会被建模成一个“空”的Optional对象,由方法Optional.empty()返回。Optional.empty()方法是一个静态工厂方法,它返回Optional类的特定单一实例。 你可能还有疑惑,null引用和Optional.empty()有什么本质的区别吗?从语义上,你可以把它们当作一回事儿,但是实际中它们之间的差别非常大: 如果你尝试解引用一个null , 一定会触发NullPointerException , 不过使用Optional.empty()就完全没事儿,它是Optional类的一个有效对象,多种场景都能调用, 使用Optional而不是null的一个非常重要而又实际的语义区别是,第一个例子中,我们在声明变量时使用的是Optional<Car>类型,而不是Car类型,这句声明非常清楚地表明了这里发生变量缺失是允许的。与此相反,使用Car这样的类型,可能将变量赋值为null,这意味着你需要独立面对这些,你只能依赖你对业务模型的理解,判断一个null是否属于该变量的有效范畴。 使用Optional类对最初的代码进行重构 public class Person { private Optional<Car> car; public Optional<Car> getCar() { return car; } } public class Car { private Optional<Insurance> insurance; public Optional<Insurance> getInsurance() { return insurance; } } public class Insurance { private String name; public String getName() { return name; } } 在你的代码中始终如一地使用Optional,能非常清晰地界定出变量值的缺失是结构上的问题,还是你算法上的缺陷,抑或是你数据中的问题。另外,我们还想特别强调,引入Optional类的意图并非要消除每一个null引用。与此相反,它的目标是帮助你更好地设计出普适的API,让程序员看到方法签名,就能了解它是否接受一个Optional的值。这种强制会让你更积极地将变量从Optional中解包出来,直面缺失的变量值。 应用Optional的几种模式 创建Optional对象 声明一个空的Optional Optional<Car> optCar = Optional.empty(); 依据一个非空值创建Optional Optional<Car> optCar = Optional.of(car); 如果car是一个null,这段代码会立即抛出一个NullPointerException,而不是等到你试图访问car的属性值时才返回一个错误。 可接受null的Optional Optional<Car> optCar = Optional.ofNullable(car); 使用map从Optional对象中提取和转换值 从对象中提取信息是一种比较常见的模式。比如,你可能想要从insurance公司对象中提取公司的名称。提取名称之前,你需要检查insurance对象是否为null String name = null; if(insurance != null){ name = insurance.getName(); } 为了支持这种模式,Optional提供了一个map方法 Optional<Insurance> optInsurance = Optional.ofNullable(insurance); Optional<String> name = optInsurance.map(Insurance::getName); 使用flatMap链接Optional对象 public String getCarInsuranceName(Person person) { return person.getCar().getInsurance().getName(); } 你的第一反应可能是我们可以利用map重写之前的代码, Optional<Person> optPerson = Optional.of(person); Optional<String> name = optPerson.map(Person::getCar) .map(Car::getInsurance) .map(Insurance::getName); 不幸的是,这段代码无法通过编译。 optPerson是Optional<Person>类型的变量, 调用map方法应该没有问题。但getCar返回的是一个Optional<Car>类型的对象,这意味着map操作的结果是一个Optional<Optional<Car>>类型的对象。 因此,它对getInsurance的调用是非法的,因为最外层的optional对象包含了另一个optional对象的值,而它当然不会支持getInsurance方法。 flatMap方法解决这个问题。 使用流时,flatMap方法接受一个函数作为参数,这个函数的返回值是另一个流。这个方法会应用到流中的每一个元素,最终形成一个新的流的流。但是flagMap会用流的内容替换每个新生成的流。 换句话说,由方法生成的各个流会被合并或者扁平化为一个单一的流。这里你希望的结果其实也是类似的,但是你想要的是将两层的optional合并为一个。 这个例子中,传递给流的flatMap方法会将每个正方形转换为另一个流中的两个三角形。那么,map操作的结果就包含有三个新的流,每一个流包含两个三角形,但flatMap方法会将这种两层的流合并为一个包含六个三角形的单一流。 类似地,传递给optional的flatMap方法的函数会将原始包含正方形的optional对象转换为包含三角形的optional对象。如果将该方法传递给map方法,结果会是一个Optional对象,而这个Optional对象中包含了三角形;但flatMap方法会将这种两层的Optional对象转换为包含三角形的单一Optional对象。 使用Optional获取car的保险公司名称 public String getCarInsuranceName(Optional<Person> person) { return person.flatMap(Person::getCar) .flatMap(Car::getInsurance) .map(Insurance::getName) .orElse("Unknown"); } 通过比较之前的两个代码清单,我们可以看到,处理潜在可能缺失的值时,使用Optional具有明显的优势。这一次,你可以用非常容易却又普适的方法实现之前你期望的效果——不再需要使用那么多的条件分支,也不会增加代码的复杂性。 再一次看到这种方式的优点,它通过类型系统让你的域模型中隐藏的知识显式地体现在你的代码中,换句话说,你永远都不应该忘记语言的首要功能就是沟通,即使对程序设计语言而言也没有什么不同。声明方法接受一个Optional参数,或者将结果作为Optional类型返回,让你的同事或者未来你方法的使用者,很清楚地知道它可以接受空值,或者它可能返回一个空值。 使用Optional解引用串接的Person/Car/Insurance对象 由Optional<Person>对象,我们可以结合使用之前介绍的map和flatMap方法,从Person中解引用出Car,从Car中解引用出Insurance,从Insurance对象中解引用出包含insurance公司名称的字符串。 在域模型中使用Optional,以及为什么它们无法序列化 上面展示了如何在你的域模型中使用Optional,将允许缺失或者暂 无定义的变量值用特殊的形式标记出来。然而,Optional类设计者的初衷并非如此,他们构思时怀揣的是另一个用例。这一点,Java语言的架构师Brian Goetz曾经非常明确地陈述过,Optional的设计初衷仅仅是要支持能返回Optional对象的语法。 由于Optional类设计时就没特别考虑将其作为类的字段使用,所以它也并未实现Serializable接口。由于这个原因,如果你的应用使用了某些要求序列化的库或者框架,在域模型中使用Optional,有可能引发应用程序故障。 然而,通过前面的介绍,你已经看到用Optional声明域模型中的某些类型是个不错的主意,尤其是你需要遍历有可能全部或部分为空,或者可能不存在的对象时。如果你一定要实现序列化的域模型,作为替代方案,我们建议你像下面这个例子那样,提供一个能访问声明为Optional、变量值可能缺失的接口,代码清单如下: public class Person { private Car car; public Optional<Car> getCarAsOptional() { return Optional.ofNullable(car); } } 默认行为及解引用Optional对象 Optional类提供了多种方法读取Optional实例中的变量值。 get()是这些方法中最简单但又最不安全的方法。如果变量存在,它直接返回封装的变量值,否则就抛出一个NoSuchElementException异常。所以,除非你非常确定Optional变量一定包含值,否则使用这个方法是个相当糟糕的主意。此外,这种方式即便相对于嵌套式的null检查,也并未体现出多大的改进。 orElse(T other)是我们在代码清单10-5中使用的方法,正如之前提到的,它允许你在Optional对象不包含值时提供一个默认值。 orElseGet(Supplier<? extends T> other)是orElse方法的延迟调用版,Supplier方法只有在Optional对象不含值时才执行调用。如果创建默认值是件耗时费力的工作,你应该考虑采用这种方式(借此提升程序的性能),或者你需要非常确定某个方法仅在Optional为空时才进行调用,也可以考虑该方式(这种情况有严格的限制条件)。 orElseThrow(Supplier<? extends X> exceptionSupplier)和get方法非常类似,它们遭遇Optional对象为空时都会抛出一个异常,但是使用orElseThrow你可以定制希望抛出的异常类型。 ifPresent(Consumer<? super T>)让你能在变量值存在时执行一个作为参数传入的方法,否则就不进行任何操作。 两个Optional对象的组合 假设你有这样一个方法,它接受一个Person和一个Car对象,并以此为条件对外部提供的服务进行查询,通过一些复杂的业务逻辑,试图找到满足该组合的最便宜的保险公司: public Insurance findCheapestInsurance(Person person, Car car) { // 不同的保险公司提供的查询服务 // 对比所有数据 return cheapestCompany; } 假设你想要该方法的一个null-安全的版本,它接受两个Optional对象作为参数,返回值是一个Optional<Insurance>对象,如果传入的任何一个参数值为空,它的返回值亦为空 public Optional<Insurance> nullSafeFindCheapestInsurance(Optional<Person> person, Optional<Car> car) { if (person.isPresent() && car.isPresent()) { return Optional.of(findCheapestInsurance(person.get(), car.get())); } else { return Optional.empty(); } } 以不解包的方式组合两个Optional对象 public Optional<Insurance> nullSafeFindCheapestInsurance(Optional<Person> person, Optional<Car> car) { return person.flatMap(p -> car.map(c -> findCheapestInsurance(p, c))); } 使用filter剔除特定的值 经常需要调用某个对象的方法,查看它的某些属性。比如,你可能需要检查保险公司的名称是否为“Cambridge-Insurance”。为了以一种安全的方式进行这些操作,你首先需要确定引用指向的Insurance对象是否为null,之后再调用它的getName方法, Insurance insurance = ...; if(insurance != null && "CambridgeInsurance".equals(insurance.getName())){ System.out.println("ok"); } 使用Optional对象的filter方法,这段代码可以重构如下: Optional<Insurance> optInsurance = ...; optInsurance.filter(insurance -> "CambridgeInsurance".equals(insurance.getName())) .ifPresent(x -> System.out.println("ok")); 对Optional对象进行过滤 找出年龄大于或者等于minAge参数的Person所对应的保险公司列表。 public String getCarInsuranceName(Optional<Person> person, int minAge) { return person.filter(p -> p.getAge() >= minAge) .flatMap(Person::getCar) .flatMap(Car::getInsurance) .map(Insurance::getName) .orElse("Unknown"); } Optional类的方法 方法 描述 empty 返回一个空的Optional实例 filter 如果值存在并且满足提供的谓词,就返回包含该值的Optional对象;否则返回一个空的Optional对象 flatMap 如果值存在,就对该值执行提供的mapping函数调用,返回一个Optional类型的值,否则就返回一个空的Optional对象 get 如果该值存在,将该值用Optional封装返回,否则抛出一个NoSuchElementException异常 ifPresent 如果值存在,就执行使用该值的方法调用,否则什么也不做 isPresent 如果值存在就返回true,否则返回false map 如果值存在,就对该值执行提供的mapping函数调用 of 将指定值用Optional封装之后返回,如果该值为null,则抛出一个NullPointerException异常 ofNullable 将指定值用Optional封装之后返回,如果该值为null,则返回一个空的Optional对象 orElse 如果有值则将其返回,否则返回一个默认值 orElseGet 如果有值则将其返回,否则返回一个由指定的Supplier接口生成的值 orElseThrow 如果有值则将其返回,否则抛出一个由指定的Supplier接口生成的异常 使用Optional的实战示例 有效地使用Optional类意味着你需要对如何处理潜在缺失值进行全面的反思。这种反思不仅仅限于你曾经写过的代码,更重要的可能是,你如何与原生Java API实现共存共赢。 用Optional封装可能为null的值 假设你有一个Map<String, Object>方法,访问由key索引的值时,如果map中没有与key关联的值,该次调用就会返回一个null Object value = map.get("key"); 使用Optional封装map的返回值,你可以对这段代码进行优化。要达到这个目的有两种方式:你可以使用笨拙的if-then-else判断语句,毫无疑问这种方式会增加代码的复杂度;或者你可以采用我们前文介绍的Optional.ofNullable方法: Optional<Object> value = Optional.ofNullable(map.get("key")); 异常与Optional的对比 由于某种原因,函数无法返回某个值,这时除了返回null,Java API比较常见的替代做法是抛出一个异常。 这种情况比较典型的例子是使用静态方法Integer.parseInt(String),将 String转换为int。在这个例子中,如果String无法解析到对应的整型,该方法就抛出一个NumberFormatException。最后的效果是,发生String无法转换为int时,代码发出一个遭遇非法参数的信号,唯一的不同是,这次你需要使用try/catch 语句,而不是使用if条件判断来控制一个变量的值是否非空。 你也可以用空的Optional对象,对遭遇无法转换的String时返回的非法值进行建模,这时你期望parseInt的返回值是一个optional。我们无法修改最初的Java方法,但是这无碍我们进行需要的改进,你可以实现一个工具方法,将这部分逻辑封装于其中,最终返回一个我们希望的Optional对象 public static Optional<Integer> stringToInt(String s) { try { return Optional.of(Integer.parseInt(s)); } catch (NumberFormatException e) { return Optional.empty(); } } 强烈建议是,你可以将多个类似的方法封装到一个工具类中,让我们称之为OptionalUtility。通过这种方式,你以后就能直接调用OptionalUtility.stringToInt方法,将String转换为一个Optional<Integer>对象,而不再需要记得你在其中封装了笨拙的try/catch的逻辑了。 基础类型的Optional对象,以及为什么应该避免使用它们 不知道你注意到了没有, 与Stream 对象一样, Optional 也提供了类似的基础类型——OptionalInt、OptionalLong以及OptionalDouble——所以代码可以不返回Optional<Integer>,而是直接返回一个OptionalInt类型的对象。 前面讨论过使用基础类型Stream的场景,尤其是如果Stream对象包含了大量元素,出于性能的考量,使用基础类型是不错的选择,但对Optional对象而言,这个理由就不成立了,因为Optional对象最多只包含一个值。 不推荐大家使用基础类型的Optional,因为基础类型的Optional不支持map、flatMap以及filter方法,而这些却是Optional类最有用的方法。 此外,与Stream一样,Optional对象无法由基础类型的Optional组合构成 把之前所有内容整合起来 假设你需要向你的程序传递一些属性。为了举例以及测试你开发的代码,你创建了一些示例属性,如下所示: Properties props = new Properties(); props.setProperty("a", "5"); props.setProperty("b", "true"); props.setProperty("c", "-3"); 假设你的程序需要从这些属性中读取一个值,该值是以秒为单位计量的一段时间。由于一段时间必须是正数,你想要该方法符合下面的签名: public int readDuration(Properties props, String name) 即,如果给定属性对应的值是一个代表正整数的字符串,就返回该整数值,任何其他的情况都返回0。 public static int readDurationImperative(Properties props, String name) { String value = props.getProperty(name); if (value != null) { try { int i = Integer.parseInt(value); if (i > 0) { return i; } } catch (NumberFormatException nfe) { } } return 0; } 使用Optional从属性中读取duration public int readDuration(Properties props, String name) { return Optional.ofNullable(props.getProperty(name)) .flatMap(OptionalUtility::stringToInt) .filter(i -> i > 0) .orElse(0); } 小结 null引用在历史上被引入到程序设计语言中,目的是为了表示变量值的缺失。 Java 8中引入了一个新的类java.util.Optional<T>,对存在或缺失的变量值进行建模。 你可以使用静态工厂方法Optional.empty、Optional.of以及Optional.ofNullable创建Optional对象。 Optional类支持多种方法,比如map、flatMap、filter,它们在概念上与Stream类中对应的方法十分相似。 使用Optional会迫使你更积极地解引用Optional对象,以应对变量值缺失的问题,最终,你能更有效地防止代码中出现不期而至的空指针异常。 使用Optional能帮助你设计更好的API,用户只需要阅读方法签名,就能了解该方法是否接受一个Optional类型的值。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册