首页 文章 精选 留言 我的

精选列表

搜索[java8],共826篇文章
优秀的个人博客,低调大师

java8 stream性能

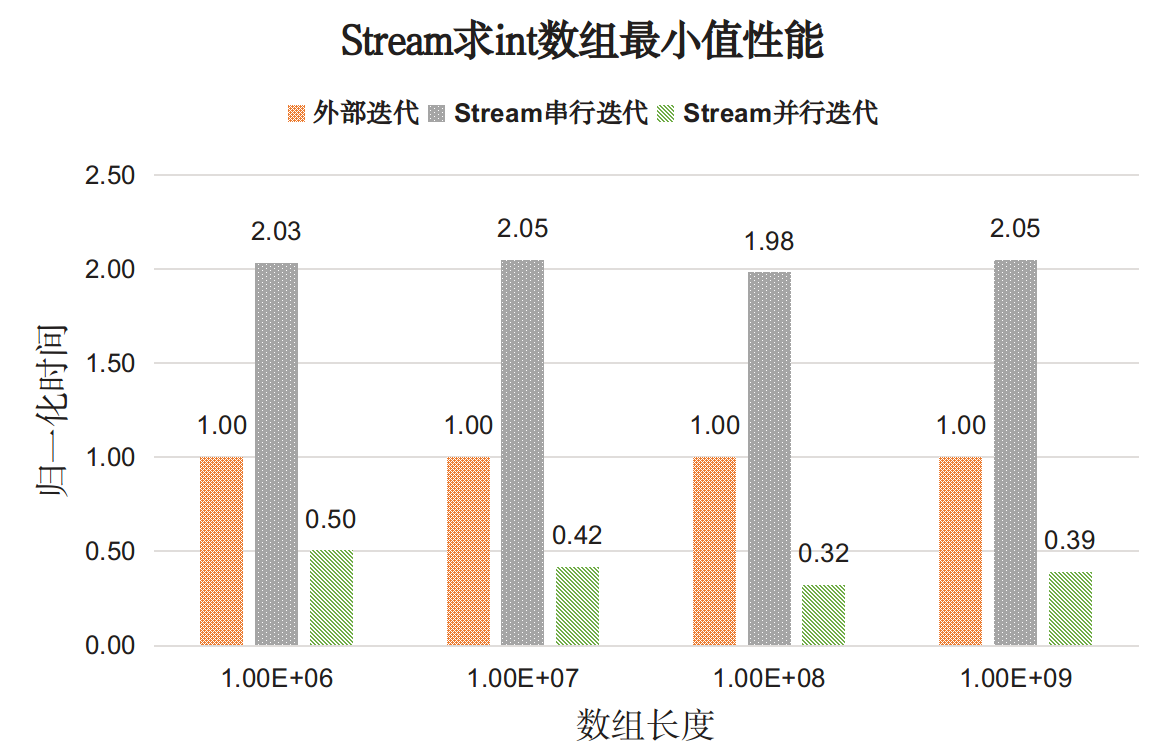
Java 8 Stream的性能到底如何? 之前的文章中我们介绍了Java 8中Stream相关的API,我们提到Stream API可以极大提高Java程序员的生产力,让程序员写出高效率、干净、简洁的代码。 那么,Stream API的性能到底如何呢,代码整洁的背后是否意味着性能的损耗呢?本文我们对Stream API的性能一探究竟。 为保证测试结果真实可信,我们将JVM运行在-server模式下,测试数据在GB量级,测试机器采用常见的商用服务器,配置如下: OS CentOS 6.7 x86_64 CPU Intel Xeon X5675, 12M Cache 3.06 GHz, 6 Cores 12 Threads 内存 96GB JDK java version 1.8.0_91, Java HotSpot(TM) 64-Bit Server VM 测试方法和测试数据 性能测试并不是容易的事,Java性能测试更费劲,因为虚拟机对性能的影响很大,JVM对性能的影响有两方面: GC的影响。GC的行为是Java中很不好控制的一块,为增加确定性,我们手动指定使用CMS收集器,并使用10GB固定大小的堆内存。具体到JVM参数就是-XX:+UseConcMarkSweepGC -Xms10G -Xmx10G JIT(Just-In-Time)即时编译技术。即时编译技术会将热点代码在JVM运行的过程中编译成本地代码,测试时我们会先对程序预热,触发对测试函数的即时编译。相关的JVM参数是-XX:CompileThreshold=10000。 Stream并行执行时用到ForkJoinPool.commonPool()得到的线程池,为控制并行度我们使用Linux的taskset命令指定JVM可用的核数。 测试数据由程序随机生成。为防止一次测试带来的抖动,测试4次求出平均时间作为运行时间。 实验一 基本类型迭代 测试内容:找出整型数组中的最小值。对比for循环外部迭代和Stream API内部迭代性能。 测试程序代码: /** * java -server -Xms10G -Xmx10G -XX:+PrintGCDetails * -XX:+UseConcMarkSweepGC -XX:CompileThreshold=1000 lee/IntTest * taskset -c 0-[0,1,3,7] java ... * @author CarpenterLee */ public class IntTest { public static void main(String[] args) { new IntTest().doTest(); } public void doTest(){ warmUp(); int[] lengths = { 10000, 100000, 1000000, 10000000, 100000000, 1000000000 }; for(int length : lengths){ System.out.println(String.format("---array length: %d---", length)); int[] arr = new int[length]; randomInt(arr); int times = 4; int min1 = 1; int min2 = 2; int min3 = 3; long startTime; startTime = System.nanoTime(); for(int i=0; i<times; i++){ min1 = minIntFor(arr); } TimeUtil.outTimeUs(startTime, "minIntFor time:", times); startTime = System.nanoTime(); for(int i=0; i<times; i++){ min2 = minIntStream(arr); } TimeUtil.outTimeUs(startTime, "minIntStream time:", times); startTime = System.nanoTime(); for(int i=0; i<times; i++){ min3 = minIntParallelStream(arr); } TimeUtil.outTimeUs(startTime, "minIntParallelStream time:", times); System.out.println(min1==min2 && min2==min3); } } private void warmUp(){ int[] arr = new int[100]; randomInt(arr); for(int i=0; i<20000; i++){ // minIntFor(arr); minIntStream(arr); minIntParallelStream(arr); } } private int minIntFor(int[] arr){ int min = Integer.MAX_VALUE; for(int i=0; i<arr.length; i++){ if(arr[i]<min) min = arr[i]; } return min; } private int minIntStream(int[] arr){ return Arrays.stream(arr).min().getAsInt(); } private int minIntParallelStream(int[] arr){ return Arrays.stream(arr).parallel().min().getAsInt(); } private void randomInt(int[] arr){ Random r = new Random(); for(int i=0; i<arr.length; i++){ arr[i] = r.nextInt(); } } } 测试结果如下图: 图中展示的是for循环外部迭代耗时为基准的时间比值。分析如下: 对于基本类型Stream串行迭代的性能开销明显高于外部迭代开销(两倍); Stream并行迭代的性能比串行迭代和外部迭代都好。 并行迭代性能跟可利用的核数有关,上图中的并行迭代使用了全部12个核,为考察使用核数对性能的影响,我们专门测试了不同核数下的Stream并行迭代效果: 分析,对于基本类型: 使用Stream并行API在单核情况下性能很差,比Stream串行API的性能还差; 随着使用核数的增加,Stream并行效果逐渐变好,比使用for循环外部迭代的性能还好。 以上两个测试说明,对于基本类型的简单迭代,Stream串行迭代性能更差,但多核情况下Stream迭代时性能较好。 实验二 对象迭代 再来看对象的迭代效果。 测试内容:找出字符串列表中最小的元素(自然顺序),对比for循环外部迭代和Stream API内部迭代性能。 测试程序代码: /** * java -server -Xms10G -Xmx10G -XX:+PrintGCDetails * -XX:+UseConcMarkSweepGC -XX:CompileThreshold=1000 lee/StringTest * taskset -c 0-[0,1,3,7] java ... * @author CarpenterLee */ public class StringTest { public static void main(String[] args) { new StringTest().doTest(); } public void doTest(){ warmUp(); int[] lengths = { 10000, 100000, 1000000, 10000000, 20000000, 40000000 }; for(int length : lengths){ System.out.println(String.format("---List length: %d---", length)); ArrayList<String> list = randomStringList(length); int times = 4; String min1 = "1"; String min2 = "2"; String min3 = "3"; long startTime; startTime = System.nanoTime(); for(int i=0; i<times; i++){ min1 = minStringForLoop(list); } TimeUtil.outTimeUs(startTime, "minStringForLoop time:", times); startTime = System.nanoTime(); for(int i=0; i<times; i++){ min2 = minStringStream(list); } TimeUtil.outTimeUs(startTime, "minStringStream time:", times); startTime = System.nanoTime(); for(int i=0; i<times; i++){ min3 = minStringParallelStream(list); } TimeUtil.outTimeUs(startTime, "minStringParallelStream time:", times); System.out.println(min1.equals(min2) && min2.equals(min3)); // System.out.println(min1); } } private void warmUp(){ ArrayList<String> list = randomStringList(10); for(int i=0; i<20000; i++){ minStringForLoop(list); minStringStream(list); minStringParallelStream(list); } } private String minStringForLoop(ArrayList<String> list){ String minStr = null; boolean first = true; for(String str : list){ if(first){ first = false; minStr = str; } if(minStr.compareTo(str)>0){ minStr = str; } } return minStr; } private String minStringStream(ArrayList<String> list){ return list.stream().min(String::compareTo).get(); } private String minStringParallelStream(ArrayList<String> list){ return list.stream().parallel().min(String::compareTo).get(); } private ArrayList<String> randomStringList(int listLength){ ArrayList<String> list = new ArrayList<>(listLength); Random rand = new Random(); int strLength = 10; StringBuilder buf = new StringBuilder(strLength); for(int i=0; i<listLength; i++){ buf.delete(0, buf.length()); for(int j=0; j<strLength; j++){ buf.append((char)('a'+rand.nextInt(26))); } list.add(buf.toString()); } return list; } } 测试结果如下图: 结果分析如下: 对于对象类型Stream串行迭代的性能开销仍然高于外部迭代开销(1.5倍),但差距没有基本类型那么大。 Stream并行迭代的性能比串行迭代和外部迭代都好。 再来单独考察Stream并行迭代效果: 分析,对于对象类型: 使用Stream并行API在单核情况下性能比for循环外部迭代差; 随着使用核数的增加,Stream并行效果逐渐变好,多核带来的效果明显。 以上两个测试说明,对于对象类型的简单迭代,Stream串行迭代性能更差,但多核情况下Stream迭代时性能较好。 实验三 复杂对象归约 从实验一、二的结果来看,Stream串行执行的效果都比外部迭代差(很多),是不是说明Stream真的不行了?先别下结论,我们再来考察一下更复杂的操作。 测试内容:给定订单列表,统计每个用户的总交易额。对比使用外部迭代手动实现和Stream API之间的性能。 我们将订单简化为<userName, price, timeStamp>构成的元组,并用Order对象来表示。 测试程序代码: /** * java -server -Xms10G -Xmx10G -XX:+PrintGCDetails * -XX:+UseConcMarkSweepGC -XX:CompileThreshold=1000 lee/ReductionTest * taskset -c 0-[0,1,3,7] java ... * @author CarpenterLee */ public class ReductionTest { public static void main(String[] args) { new ReductionTest().doTest(); } public void doTest(){ warmUp(); int[] lengths = { 10000, 100000, 1000000, 10000000, 20000000, 40000000 }; for(int length : lengths){ System.out.println(String.format("---orders length: %d---", length)); List<Order> orders = Order.genOrders(length); int times = 4; Map<String, Double> map1 = null; Map<String, Double> map2 = null; Map<String, Double> map3 = null; long startTime; startTime = System.nanoTime(); for(int i=0; i<times; i++){ map1 = sumOrderForLoop(orders); } TimeUtil.outTimeUs(startTime, "sumOrderForLoop time:", times); startTime = System.nanoTime(); for(int i=0; i<times; i++){ map2 = sumOrderStream(orders); } TimeUtil.outTimeUs(startTime, "sumOrderStream time:", times); startTime = System.nanoTime(); for(int i=0; i<times; i++){ map3 = sumOrderParallelStream(orders); } TimeUtil.outTimeUs(startTime, "sumOrderParallelStream time:", times); System.out.println("users=" + map3.size()); } } private void warmUp(){ List<Order> orders = Order.genOrders(10); for(int i=0; i<20000; i++){ sumOrderForLoop(orders); sumOrderStream(orders); sumOrderParallelStream(orders); } } private Map<String, Double> sumOrderForLoop(List<Order> orders){ Map<String, Double> map = new HashMap<>(); for(Order od : orders){ String userName = od.getUserName(); Double v; if((v=map.get(userName)) != null){ map.put(userName, v+od.getPrice()); }else{ map.put(userName, od.getPrice()); } } return map; } private Map<String, Double> sumOrderStream(List<Order> orders){ return orders.stream().collect( Collectors.groupingBy(Order::getUserName, Collectors.summingDouble(Order::getPrice))); } private Map<String, Double> sumOrderParallelStream(List<Order> orders){ return orders.parallelStream().collect( Collectors.groupingBy(Order::getUserName, Collectors.summingDouble(Order::getPrice))); } } class Order{ private String userName; private double price; private long timestamp; public Order(String userName, double price, long timestamp) { this.userName = userName; this.price = price; this.timestamp = timestamp; } public String getUserName() { return userName; } public double getPrice() { return price; } public long getTimestamp() { return timestamp; } public static List<Order> genOrders(int listLength){ ArrayList<Order> list = new ArrayList<>(listLength); Random rand = new Random(); int users = listLength/200;// 200 orders per user users = users==0 ? listLength : users; ArrayList<String> userNames = new ArrayList<>(users); for(int i=0; i<users; i++){ userNames.add(UUID.randomUUID().toString()); } for(int i=0; i<listLength; i++){ double price = rand.nextInt(1000); String userName = userNames.get(rand.nextInt(users)); list.add(new Order(userName, price, System.nanoTime())); } return list; } @Override public String toString(){ return userName + "::" + price; } } 测试结果如下图: 分析,对于复杂的归约操作: Stream API的性能普遍好于外部手动迭代,并行Stream效果更佳; 再来考察并行度对并行效果的影响,测试结果如下: 分析,对于复杂的归约操作: 使用Stream并行归约在单核情况下性能比串行归约以及手动归约都要差,简单说就是最差的; 随着使用核数的增加,Stream并行效果逐渐变好,多核带来的效果明显。 以上两个实验说明,对于复杂的归约操作,Stream串行归约效果好于手动归约,在多核情况下,并行归约效果更佳。我们有理由相信,对于其他复杂的操作,Stream API也能表现出相似的性能表现。 结论 上述三个实验的结果可以总结如下: 对于简单操作,比如最简单的遍历,Stream串行API性能明显差于显示迭代,但并行的Stream API能够发挥多核特性。 对于复杂操作,Stream串行API性能可以和手动实现的效果匹敌,在并行执行时Stream API效果远超手动实现。 所以,如果出于性能考虑,1. 对于简单操作推荐使用外部迭代手动实现,2. 对于复杂操作,推荐使用Stream API, 3. 在多核情况下,推荐使用并行Stream API来发挥多核优势,4.单核情况下不建议使用并行Stream API。 如果出于代码简洁性考虑,使用Stream API能够写出更短的代码。即使是从性能方面说,尽可能的使用Stream API也另外一个优势,那就是只要Java Stream类库做了升级优化,代码不用做任何修改就能享受到升级带来的好处。

优秀的个人博客,低调大师

java8学习:CompletableFuture方法使用

下面是自己总结的一部分的api的使用,当然下面有些方法后面加上Async就会变为异步的 /** * 变换:参数为Function接口 * thenApply:将上一个结果当做这次thenApply的参数传入,加以处理后,返回一个值 * 可以传入T返回T也可以传入T返回U */ public void thenApply() { CompletableFuture<String> future = CompletableFuture.supplyAsync(()-> 1).thenApply(i -> String.valueOf(i)); String i = future.join(); System.out.println(i); //1 } /** * 消费 * 参数为Consumer接口 * thenAccept:将上一个的结果当做这次的参数传入,但是无返回值 */ public void thenAccept() { CompletableFuture<Void> future = CompletableFuture.supplyAsync(() -> 1).thenAccept((integer -> System.out.println(integer))); future.join(); //1 } public void thenCompose() { CompletableFuture<Integer> future = CompletableFuture.supplyAsync(() -> 1) //提供第一个CompletableFuture结果值 .thenCompose((i) -> //将上一个结果值传入下一个CompletableFuture CompletableFuture.supplyAsync(() -> i + 2)); //对传入的结果值进行处理 Integer join = future.join(); System.out.println(join); } /** * 结合两个结果得到一个最终值 * 逻辑处理需要的是BiFunction接口 * 需要两个CompletableFuture结果,并且需要有处理两个结果的逻辑 * 两个CompletableFuture返回的结果不需要一致 */ public void thenCombine() { CompletableFuture<String> future = CompletableFuture.supplyAsync(() -> "Hello ") //第一个CompletableFuture返回结果 .thenCombine(CompletableFuture.supplyAsync(() -> 1), //第二个CompletableFuture返回结果 (future1, future2) -> future1 + future2); //处理两个结果的逻辑 String join = future.join(); System.out.println(join); //Hello World } /** * 跟上面的差不多,只不过这里处理逻辑需要的是一个BiConsumer接口,无返回值而已 */ public void thenAcceptBoth() { CompletableFuture<Void> both = CompletableFuture.supplyAsync(() -> "Hello ") //第一个CompletableFuture返回结果 .thenAcceptBoth(CompletableFuture.supplyAsync(() -> "World"), //第二个CompletableFuture返回结果 (future1, future2) -> System.out.println(future1 + future2));//处理两个结果的逻辑 both.join(); //Hello World } /** * 两个CompletableFuture一起执行,哪个先执行完就用哪个CompletableFuture的结果 * 处理逻辑需要的参数是一个Function接口 * 下面整体代码的逻辑是返回1的睡眠一秒,返回2的睡眠0.3秒,所以返回2的肯定比1要快,所以结果为2,然后应用到处理逻辑上 * 最终结果就是为 2 done * 两个CompletableFuture返回的参数需要一致 * 这适用于两种渠道完成同一个事情,就可以调用这个方法,找一个最快的结果进行处理,最终有返回值。 */ public void applyToEither() { CompletableFuture<String> apply = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } return "1"; }).applyToEither( CompletableFuture.supplyAsync(() -> { try { Thread.sleep(300); } catch (InterruptedException e) { e.printStackTrace(); } return "2"; }), (future) -> future + " done" //对于首先完成的CompletableFuture任务之后执行的逻辑 ); String join = apply.join(); System.out.println(join);//2 done } /** * 与上面使用方法一致,只是多加了一个选项 * 结果为3 three */ public void applyToEithers() { CompletableFuture<String> apply = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } return "1"; }).applyToEither( CompletableFuture.supplyAsync(() -> { try { Thread.sleep(800); } catch (InterruptedException e) { e.printStackTrace(); } return "2"; }),(future) -> future + " done" //对于首先完成的CompletableFuture任务之后执行的逻辑 ).applyToEither( CompletableFuture.supplyAsync(() -> { try { Thread.sleep(300); } catch (InterruptedException e) { e.printStackTrace(); } return "3"; }),(future -> future + " three") ); String join = apply.join(); System.out.println(join);//2 done } /** * 对于出错的处理过程进行补偿,即如果future出错,会运行exceptionally里的Function函数 * 当然没有错就不会运行后面指定的函数 */ @Test public void exceptionally() { CompletableFuture<String> exceptionally = CompletableFuture.supplyAsync(() -> { int i = 1 / 0 ; return "1"; }).exceptionally(ex -> { ex.printStackTrace(); return "error"; }); String join = exceptionally.join(); System.out.println(join); } /** * 输出 * error * java.util.concurrent.CompletionException: java.lang.ArithmeticException: / by zero * at java.util.concurrent.CompletableFuture.encodeThrowable(CompletableFuture.java:273) * at java.util.concurrent.CompletableFuture.completeThrowable(CompletableFuture.java:280) * at java.util.concurrent.CompletableFuture$AsyncSupply.run(CompletableFuture.java:1592) * at java.util.concurrent.CompletableFuture$AsyncSupply.exec(CompletableFuture.java:1582) * at java.util.concurrent.ForkJoinTask.doExec(ForkJoinTask.java:289) * at java.util.concurrent.ForkJoinPool$WorkQueue.runTask(ForkJoinPool.java:1056) * at java.util.concurrent.ForkJoinPool.runWorker(ForkJoinPool.java:1692) * at java.util.concurrent.ForkJoinWorkerThread.run(ForkJoinWorkerThread.java:157) * Caused by: java.lang.ArithmeticException: / by zero * at com.qidai.demotest.MyTestx.lambda$exceptionally$18(MyTestx.java:125) * at java.util.concurrent.CompletableFuture$AsyncSupply.run(CompletableFuture.java:1590) * ... 5 more */ /** * 与上面的thenAccept相比较,这个方法并不需要输入参数,相同点是都是无返回值 */ public void thenRun() { CompletableFuture<Void> runnable = CompletableFuture.supplyAsync(() -> "1").thenRun(() -> System.out.println("runnable")); runnable.join(); }

优秀的个人博客,低调大师

在Android上使用Java8

已废弃 目前来说Android开发所支持的Java版本是Java 7,在Android N发布以后可以通过Jack(Java Android Compile Kit)编译链可以使用Java 8。但目标来说使用Java 8有以下限制: mini sdk >=24 以及 android studio >= 2.1 不支持 data binding 不支持Instant Run 启用Jack 在module级别的buidl.gradle添加以下语句设置Jack以Java 8: android { defaultConfig { jackOptions { enabled true } } //Add support for java 8 features. compileOptions { sourceCompatibility JavaVersion.VERSION_1_8 targetCompatibility JavaVersion.VERSION_1_8 } } 现在直接在module级别的buidl.gradle添加下面的就可以用了: compileOptions { sourceCompatibility JavaVersion.VERSION_1_8 targetCompatibility JavaVersion.VERSION_1_8 } }

优秀的个人博客,低调大师

让Java8的Stream更简单

1. 为什么有经验的老手更倾向于使用Stream 性能优势,(大数据量)相较于迭代器,速度更快 支持串行与并行处理,并行处理更能充分利用CPU的资源 Stream 是一种计算数据的流,它本身不会存储数据 支持函数式编程 代码优雅,让代码更高效,干净,简洁 2. Stream 的使用方式 三步操作: 创建Stream 中间操作 终止操作 3. Stream 的创建 Stream 的 创建都会依赖于数据源,通常是容器或者数组 Stream 流的创建大致分为4中,最为常用的就是通过集合创建 import java.util.ArrayList; import java.util.Arrays; import java.util.List; import java.util.stream.IntStream; import java.util.stream.Stream; public class CreateStreamDemo { public static void main(String[] args) { // 1 通过集合创建Stream也是用的最多的一种形式 List<String> strList = new ArrayList<>(); strList.add("a"); strList.add("b"); strList.add("c"); // 创建串行操作流 Stream<String> stream = strList.stream(); // 创建并行操作流 Stream<String> parallelStream = strList.parallelStream(); // 2 通过数组创建Stream int[] arr = new int[]{1,2,3}; IntStream intStream = Arrays.stream(arr); // 3 通过Stream.of Stream<Integer> integerStream = Stream.of(1,2,3); Stream<String> stringStream = Stream.of("a","b","c"); // 4 无限流 // 每隔五个数取一个 Stream.iterate(0, t -> t + 5).forEach(System.out::println); // 迭代 Stream.generate(Math::random).forEach(System.out::println); // 生成 } } 复制代码 4. Stream 中间操作 Stream 中间操作,我们最为常用的就是过滤,去重,排序 本章包含我们开发最常用的对对象的去重,和更据对象中的对个属性组合排序 import com.zhj.java8.bean.Student; import java.util.ArrayList; import java.util.Comparator; import java.util.List; import java.util.TreeSet; import java.util.stream.Stream; import static java.util.stream.Collectors.collectingAndThen; import static java.util.stream.Collectors.toCollection; public class MiddleStreamDemo { public static void main(String[] args) { List<Student> students = new ArrayList<>(); students.add(new Student(1,"小华",23,1)); students.add(new Student(1,"小华",23,2)); students.add(new Student(2,"小米",20,2)); students.add(new Student(3,"小果",30,3)); students.add(new Student(4,"小维",18,2)); // 过滤 students.stream().filter(stu -> stu.getAge() > 20).forEach(System.out::println); // 去重 // 对对象去重是根据引用去重,内容重复并不会去重,除非重写equals和hashCode方法 System.out.println("----------去重----------"); System.out.println("去重1----------"); students.stream().distinct().forEach(System.out::println); // 对集合中对象某些属性去重,不重写equals和hashCode方法,只能借助其他数据结构来辅助去重 // 单个属性可以stu -> stu.getId() // 多个属性可以stu -> stu.getId() + ";" + stu.getName() System.out.println("去重2----------"); ArrayList<Student> distinctList = students.stream().collect( collectingAndThen(toCollection(() -> new TreeSet<>(Comparator.comparing(stu -> stu.getId() + ";" + stu.getName()))), ArrayList::new) ); distinctList.stream().forEach(System.out::println); // 排序 支持定义排序方式 // sorted 默认使用 自然序排序, 其中的元素必须实现Comparable 接口 System.out.println("----------排序----------"); System.out.println("排序1----------"); students.stream().sorted().forEach(System.out::println); // sorted(Comparator<? super T> comparator) :我们可以使用lambada 来创建一个Comparator 实例。可以按照升序或着降序来排序元素。 System.out.println("排序2----------"); students.stream() .sorted(Comparator.comparing(Student::getAge,Comparator.reverseOrder())) // ,Comparator.reverseOrder() 逆序 .forEach(System.out::println); // 创建比较器,通过对比较器内容的定义实现对多个属性进行排序,类似sql中连续的orderBy System.out.println("排序3----------"); students.stream().sorted( (s1,s2) -> { if (s1.getAge() == s2.getAge()) { return s1.getSex().compareTo(s2.getSex()); } else { return -s1.getAge().compareTo(s2.getAge()); } } ).forEach(System.out::println); System.out.println("排序4----------"); Comparator<Student> studentComparator = (s1,s2) -> { Integer age1 = s1.getAge(); Integer age2 = s2.getAge(); if (age1 != age2) return age1 - age2; Integer sex1 = s1.getSex(); Integer sex2 = s2.getSex(); if (sex1 != sex2) return sex2 - sex1; return 0; }; students.stream().sorted(studentComparator).forEach(System.out::println); // 截取 截取前三个元素 System.out.println("----------截取----------"); students.stream().limit(3).forEach(System.out::println); // 跳过 跳过前3个元素 System.out.println("----------跳过----------"); students.stream().skip(3).forEach(System.out::println); // 映射 System.out.println("----------映射----------"); System.out.println("映射Map----------"); // map接收Lambda,将元素转换其他形式,或者是提取信息,并将其映射成一个新的元素 Stream<Stream<Student>> streamStream1 = students.stream().map(str -> filterStudent(str)); streamStream1.forEach(sm -> sm.forEach(System.out::println)); System.out.println("映射flatMap----------"); // map接收Lambda,将流中的每一个元素转换成另一个流,然后把所有流连成一个流 扁平化映射 Stream<Student> studentStream2 = students.stream().flatMap(str -> filterStudent(str)); studentStream2.forEach(System.out::println); // 消费 System.out.println("----------消费----------"); students.stream().peek(stu -> stu.setAge(100)).forEach(System.out::println); } public static Stream<Student> filterStudent(Student student) { student = new Student(); return Stream.of(student); } } 复制代码 Student public class Student implements Comparable<Student> { private Integer id; private String name; private Integer age; private Integer sex; public Student() { } public Student(Integer id, String name, Integer age, Integer sex) { this.id = id; this.name = name; this.age = age; this.sex = sex; } public Integer getId() { return id; } public void setId(Integer id) { this.id = id; } public String getName() { return name; } public void setName(String name) { this.name = name; } public Integer getAge() { return age; } public void setAge(Integer age) { this.age = age; } public Integer getSex() { return sex; } public void setSex(Integer sex) { this.sex = sex; } @Override public String toString() { return "Student{" + "id='" + id + '\'' + ", name='" + name + '\'' + ", age='" + age + '\'' + ", sex=" + sex + '}'; } @Override public int compareTo(Student o) { return this.getAge() - o.getAge(); } } 复制代码 5. Stream 终止操作 Stream 的终止操作,最常用的就是讲处理过的数据收集到新的容器中,同时可以实现向Sql聚合函数,分组的一些效果 package com.zhj.java8.stream; import com.zhj.java8.bean.Student; import java.util.*; import java.util.stream.Collectors; public class TerminationStreamDemo { public static void main(String[] args) { List<Student> students = new ArrayList<>(); students.add(new Student(1,"小华",23,1)); students.add(new Student(2,"小米",20,2)); students.add(new Student(3,"小果",30,3)); students.add(new Student(4,"小维",18,2)); students.add(new Student(5,"小华",23,2)); System.out.println("--------------------匹配聚合操作--------------------"); // allMatch:接收一个 Predicate 函数,当流中每个元素都符合该断言时才返回true,否则返回false boolean allMatch = students.stream().allMatch(stu -> stu.getAge() > 10); System.out.println("全部符合大于10岁条件:" + allMatch); // noneMatch:接收一个 Predicate 函数,当流中每个元素都不符合该断言时才返回true,否则返回false boolean noneMatch = students.stream().noneMatch(stu -> stu.getAge() > 10); System.out.println("全部不符合大于10岁条件:" + noneMatch); // anyMatch:接收一个 Predicate 函数,只要流中有一个元素满足该断言则返回true,否则返回false boolean anyMatch = students.stream().anyMatch(stu -> stu.getAge() > 20); System.out.println("含有任意符合大于20岁条件:" + anyMatch); // findFirst:返回流中第一个元素 Student findFirst = students.stream().findFirst().get(); System.out.println("第一个学生:" + findFirst); // findAny:返回流中的任意元素 Student findAny = students.stream().findAny().get(); System.out.println("任意一个学生:" + findAny); // count:返回流中元素的总个数 long count = students.stream().count(); System.out.println("学生总数:" + count); // max:返回流中元素最大值 Student max = students.stream().max(Student::compareTo).get(); System.out.println("年龄最大学生:" + max); // max:返回流中元素最大值 Student min = students.stream().min(Student::compareTo).get(); System.out.println("年龄最小学生:" + min); System.out.println("--------------------规约操作--------------------"); System.out.println("学生年龄总和:" + students.stream().map(Student::getAge).reduce(Integer::sum)); System.out.println("学生年龄最大:" + students.stream().map(Student::getAge).reduce(Integer::max)); System.out.println("--------------------收集操作--------------------"); List<Student> list = students.stream().collect(Collectors.toList()); Set<Student> set = students.stream().collect(Collectors.toSet()); Map<Integer, String> map = students.stream().collect(Collectors.toMap(Student::getId, Student::getName)); String joinName = students.stream().map(Student::getName).collect(Collectors.joining(",", "(", ")")); // 总数 students.stream().collect(Collectors.counting()); // 最大年龄 students.stream().map(Student::getAge).collect(Collectors.maxBy(Integer::compare)).get(); // 年龄和 students.stream().collect(Collectors.summingInt(Student::getAge)); // 平均年龄 students.stream().collect(Collectors.averagingDouble(Student::getAge)); // 信息合集 DoubleSummaryStatistics statistics = students.stream().collect(Collectors.summarizingDouble(Student::getAge)); System.out.println("count:" + statistics.getCount() + ",max:" + statistics.getMax() + ",sum:" + statistics.getSum() + ",average:" + statistics.getAverage()); // 分组 Map<Integer, List<Student>> collect = students.stream().collect(Collectors.groupingBy(Student::getSex)); System.out.println(collect); //多重分组,先根据性别分再根据年龄分 Map<Integer, Map<Integer, List<Student>>> typeAgeMap = list.stream().collect(Collectors.groupingBy(Student::getSex, Collectors.groupingBy(Student::getAge))); //分区 //分成两部分,一部分大于20岁,一部分小于等于20岁 Map<Boolean, List<Student>> partMap = list.stream().collect(Collectors.partitioningBy(v -> v.getAge() > 20)); //规约 Integer allAge = list.stream().map(Student::getAge).collect(Collectors.reducing(Integer::sum)).get(); System.out.println(allAge); } } 复制代码 6. Stream 特性 中间操作惰性执行 多个中间操作的话,不会多次循环,多个转换操作只会在终止操作的时候融合起来,一次循环完成。 内部迭代 找到符合条件的数据后边的迭代不会进行 流的末端操作只有一次 异常:stream has already been operated upon or closed 意思是流已经被关闭了,这是因为当我们使用末端操作之后,流就被关闭了,无法再次被调用,如果我们想重复调用,只能重新打开一个新的流。 最后 如果你觉得此文对你有一丁点帮助,点个赞。或者可以加入我的开发交流群:1025263163相互学习,我们会有专业的技术答疑解惑 如果你觉得这篇文章对你有点用的话,麻烦请给我们的开源项目点点star:http://github.crmeb.net/u/defu不胜感激!

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册