首页 文章 精选 留言 我的

精选列表

搜索[java8],共826篇文章
优秀的个人博客,低调大师

Java8及新版本许可证及收费?

问题:许可类型及如何收费? JDK 8 Oracle 将继续提供JDK 8 免费的公共更新和自动更新,支持个人用户到 2020 年 12 月底,支持商业用户到 2019 年 1 月;换句话说如果想 Oracle 后续继续为你提供 JDK 8 的支持,那么则需要付费。Oracle目前只提供了部分平台的JDK 8的openJDK构建,多数平台只有第三方的openjdk可以用。 按照 Oracle 公布的支持路线图: java支持路线图 如上图绿色的部分为免费支持的openJDK版本。棕红色部分为Oracke JDK Java SE Advanced, 该系列的产品是收费的,只有在「通用计算」使用范围内是完全免费的。显然通用计算不包括商业使用。 对于最新的java 11 Oracle JDK:支持 BCL 协议,开发人员可以免费使用,但不能用于生产,生产需要商业许可,如果全额付费的话,可支持到 2026 年 9 月。 OpenJDK:支持 GPL V2+CPE协议「一般只支持到发布以后的 6 个月」,可以用于公司使用,因此,对于JDK 11 来说,应该有JDK 11.0.0,然后是两个安全补丁 11.0.1 和 11.0.2 。如果你要继续使用 Oracle 的 OpenJDK 最新构建和安全补丁,那么您将必须在发布后的一个月内迁移到 JDK 12。参见这里:oracle openjdk GPL v2+CPE:官方Blog:java 11及以后发布许可证解释,按照解释,java 11以后,openjdk和oracle jdk本质上来说是完全一致的,只不过需要付费许可证的高级特性在openjdk中是不可用的,现在如果用了,在编译时会报错。这一点很重要,也就是说,除去高级特性的部分,openJDK和oracle JDK是可以互换的。 对于java 9和10,属于过渡版本,oracle官方也只是提供了6个月的支持期,所以可以不用考虑。 那我们怎么办? 对于需要部署jdk运行环境的企业,将不可避免的面临以下选择: java 8: 要么不升级版本,只要没有关键的安全问题,就可以保持版本不变,不跟进升级。这应该是很多现有老项目的唯一选择。 要么选择第三方发布的可以免费使用的openJDK版本。需要付出迁移成本。 升级到新版本JDK,比较适合新的开发项目。 付费使用oracle JDK更新,属于不差钱的选择。 java 11 使用Oracle的openJDK,需要及时跟进版本更新,可能需要比较高的开发迁移能力。 使用第三方发布的JDK,取决于三方jdk的稳定性及可用度。 付费使用Oracle JDK。 对于纯粹的产品开发商,大多数的java产品发布时并不需要打包jdk在内,因此对于产品开发时的策略,并不太需要考虑许可协议的限制。只需要确保最终产品部署时不要依赖需要付费的高级特性或者某个特定版本,只使用openjdk兼容的部分即可。最终部署时的jdk,则完全取决于使用产品的客户的具体策略。对于大多数客户来说,免费够用应该是最佳选择。 可用的三方OpenJDK AdoptOpenJDK,官网地址:adoptopenjdk.net,它同样支持 GPL 协议且免费。 Red Hat OpenJDK,Red Hat 通过 Red Hat Enterprise Linux「RHEL」提供 OpenJDK 的构建,这是一个付费的商业产品。Red Hat 构建更好地集成到操作系统中,因此它不是纯粹的 OpenJDK 构建。 IBM, 为 Java 8 及更早版本提供并支持 JDK。他们还使用 OpenJ9 为 AdoptOpenJDK 构建提供商业付费支持。 Azul Zulu,官网地址:zulu.org,它的核心部分就是原汁原味的 OpenJDK SAP, 官网地址:sap.github.io/SapMachine,SAP 根据 GPL+CE 协议为 Jdk 10 及更高版本提供 JDK。 参考:https://www.oracle.com/technetwork/java/javase/eol-135779.htmlhttps://yq.aliyun.com/articles/645952

优秀的个人博客,低调大师

《Java8实战》-第九章笔记(默认方法)

默认方法 传统上,Java程序的接口是将相关方法按照约定组合到一起的方式。实现接口的类必须为接口中定义的每个方法提供一个实现,或者从父类中继承它的实现。但是,一旦类库的设计者需要更新接口,向其中加入新的方法,这种方式就会出现问题。现实情况是,现存的实体类往往不在接口设计者的控制范围之内,这些实体类为了适配新的接口约定也需要进行修改。由于Java 8的API在现存的接口上引入了非常多的新方法,这种变化带来的问题也愈加严重,一个例子就是前几章中使用过的 List 接口上的 sort 方法。想象一下其他备选集合框架的维护人员会多么抓狂吧,像Guava和Apache Commons这样的框架现在都需要修改实现了 List 接口的所有类,为其添加sort 方法的实现。 且慢,其实你不必惊慌。Java 8为了解决这一问题引入了一种新的机制。Java 8中的接口现在支持在声明方法的同时提供实现,这听起来让人惊讶!通过两种方式可以完成这种操作。其一,Java 8允许在接口内声明静态方法。其二,Java 8引入了一个新功能,叫默认方法,通过默认方法你可以指定接口方法的默认实现。换句话说,接口能提供方法的具体实现。因此,实现接口的类如果不显式地提供该方法的具体实现,就会自动继承默认的实现。这种机制可以使你平滑地进行接口的优化和演进。实际上,到目前为止你已经使用了多个默认方法。两个例子就是你前面已经见过的 List 接口中的 sort ,以及 Collection 接口中的 stream 。 第1章中我们看到的 List 接口中的 sort 方法是Java 8中全新的方法,它的定义如下: default void sort(Comparator<? super E> c){ Collections.sort(this, c); } 请注意返回类型之前的新 default 修饰符。通过它,我们能够知道一个方法是否为默认方法。这里 sort 方法调用了 Collections.sort 方法进行排序操作。由于有了这个新的方法,我们现在可以直接通过调用 sort ,对列表中的元素进行排序。 List<Integer> numbers = Arrays.asList(3, 5, 1, 2, 6); numbers.sort(Comparator.naturalOrder()); 不过除此之外, 这段代码中还有些其他的新东西。注意到了吗,我们调用了Comparator.naturalOrder 方法。这是 Comparator 接口的一个全新的静态方法,它返回一个Comparator 对象,并按自然序列对其中的元素进行排序(即标准的字母数字方式排序)。 第4章中你看到的 Collection 中的 stream 方法的定义如下: default Stream<E> stream() { return StreamSupport.stream(spliterator(), false); } 我们在之前的几章中大量使用了该方法来处理集合,这里 stream 方法中调用了SteamSupport.stream 方法来返回一个流。你注意到 stream 方法的主体是如何调用 spliterator 方法的了吗?它也是 Collection 接口的一个默认方法。 喔噢!这些接口现在看起来像抽象类了吧?是,也不是。它们有一些本质的区别,我们在这一章中会针对性地进行讨论。但更重要的是,你为什么要在乎默认方法?默认方法的主要目标用户是类库的设计者啊。 简而言之,向接口添加方法是诸多问题的罪恶之源;一旦接口发生变化,实现这些接口的类往往也需要更新,提供新添方法的实现才能适配接口的变化。如果你对接口以及它所有相关的实现有完全的控制,这可能不是个大问题。但是这种情况是极少的。这就是引入默认方法的目的:它让类可以自动地继承接口的一个默认实现。 因此,如果你是个类库的设计者,这一章的内容对你而言会十分重要,因为默认方法为接口的演进提供了一种平滑的方式,你的改动将不会导致已有代码的修改。此外,正如我们后文会介绍的,默认方法为方法的多继承提供了一种更灵活的机制,可以帮助你更好地规划你的代码结构:类可以从多个接口继承默认方法。因此,即使你并非类库的设计者,也能在其中发现感兴趣的东西。 章的结构如下。首先,我们会跟你一起剖析一个API演化的用例,探讨由此引发的各种问题。紧接着我们会解释什么是默认方法,以及它们在这个用例中如何解决相应的问题。之后,我们会展示如何创建自己的默认方法,构造Java语言中的多继承。最后,我们会讨论一个类在使用一个签名同时继承多个默认方法时,Java编译器是如何解决可能的二义性(模糊性)问题的。 不断演进的 API 为了理解为什么一旦API发布之后,它的演进就变得非常困难,我们假设你是一个流行Java绘图库的设计者(为了说明本节的内容,我们做了这样的假想)。你的库中包含了一个 Resizable接口,它定义了一个简单的可缩放形状必须支持的很多方法, 比如: setHeight 、 setWidth 、getHeight 、 getWidth 以及 setAbsoluteSize 。此外,你还提供了几个额外的实现(out-of-boximplementation),如正方形、长方形。由于你的库非常流行,你的一些用户使用 Resizable 接口创建了他们自己感兴趣的实现,比如椭圆。 发布API几个月之后,你突然意识到 Resizable 接口遗漏了一些功能。比如,如果接口提供一个 setRelativeSize 方法,可以接受参数实现对形状的大小进行调整,那么接口的易用性会更好。你会说这看起来很容易啊:为 Resizable 接口添加 setRelativeSize 方法,再更新 Square和 Rectangle 的实现就好了。不过,事情并非如此简单!你要考虑已经使用了你接口的用户,他们已经按照自身的需求实现了 Resizable 接口,他们该如何应对这样的变更呢?非常不幸,你无法访问,也无法改动他们实现了 Resizable 接口的类。这也是Java库的设计者需要改进Java API时面对的问题。让我们以一个具体的实例为例,深入探讨修改一个已发布接口的种种后果。 初始版本的 API Resizable 接口的最初版本提供了下面这些方法: public interface Drawable { void draw(); } public interface Resizable extends Drawable { int getWidth(); void setWidth(int width); int getHeight(); void setHeight(int height); void setAbsoluteSize(int width, int height); } 用户实现你的一位铁杆用户根据自身的需求实现了 Resizable 接口,创建了 Ellipse 类: public class Ellipse implements Resizable { ... } 他实现了一个处理各种 Resizable 形状(包括 Ellipse )的游戏: public class Square implements Resizable { ... } public class Triangle implements Resizable { ... } public class Game { public static void main(String[] args) { List<Resizable> resizableShapes = Arrays.asList(new Square(), new Triangle(), new Ellipse()); Utils.paint(resizableShapes); } } public class Utils { public static void paint(List<Resizable> list) { list.forEach(r -> { r.setAbsoluteSize(42, 42); r.draw(); }); } } 第二版 API 库上线使用几个月之后,你收到很多请求,要求你更新 Resizable 的实现,让 Square Triangle 以及其他的形状都能支持 setRelativeSize 方法。为了满足这些新的需求,你发布了第二版API。 public interface Resizable extends Drawable { int getWidth(); void setWidth(int width); int getHeight(); void setHeight(int height); void setAbsoluteSize(int width, int height); void setRelativeSize(int wFactor, int hFactor); } 用户面临的窘境对 Resizable 接口的更新导致了一系列的问题。首先,接口现在要求它所有的实现类添加setRelativeSize 方法的实现。但是用户最初实现的 Ellipse 类并未包含 setRelativeSize方法。向接口添加新方法是二进制兼容的,这意味着如果不重新编译该类,即使不实现新的方法,现有类的实现依旧可以运行。不过,用户可能修改他的游戏,在他的 Utils.paint 方法中调用setRelativeSize 方法,因为 paint 方法接受一个 Resizable 对象列表作为参数。如果传递的是一个 Ellipse 对象,程序就会抛出一个运行时错误,因为它并未实现 setRelativeSize 方法: Exception in thread "main" java.lang.AbstractMethodError:lambdasinaction.chap9.Ellipse.setRelativeSize(II)V 其次,如果用户试图重新编译整个应用(包括 Ellipse 类),他会遭遇下面的编译错误: Error:(9, 8) java: xin.codeream.java8.chap9.Ellipse不是抽象的, 并且未覆盖 xin.codeream.java8.chap9.Resizable中的抽象方法setRelativeSize(int,int) 最后,更新已发布API会导致后向兼容性问题。这就是为什么对现存API的演进,比如官方发布的Java Collection API,会给用户带来麻烦。当然,还有其他方式能够实现对API的改进,但是都不是明智的选择。比如,你可以为你的API创建不同的发布版本,同时维护老版本和新版本,但这是非常费时费力的,原因如下。其一,这增加了你作为类库的设计者维护类库的复杂度。其次,类库的用户不得不同时使用一套代码的两个版本,而这会增大内存的消耗,延长程序的载入时间,因为这种方式下项目使用的类文件数量更多了。 这就是默认方法试图解决的问题。它让类库的设计者放心地改进应用程序接口,无需担忧对遗留代码的影响,这是因为实现更新接口的类现在会自动继承一个默认的方法实现。 概述默认方法 经过前述的介绍,我们已经了解了向已发布的API添加方法,对现存代码实现会造成多大的损害。默认方法是Java 8中引入的一个新特性,希望能借此以兼容的方式改进API。现在,接口包含的方法签名在它的实现类中也可以不提供实现。那么,谁来具体实现这些方法呢?实际上,缺失的方法实现会作为接口的一部分由实现类继承(所以命名为默认实现),而无需由实现类提供。 那么,我们该如何辨识哪些是默认方法呢?其实非常简单。默认方法由 default 修饰符修饰,并像类中声明的其他方法一样包含方法体。比如,你可以像下面这样在集合库中定义一个名为Sized 的接口,在其中定义一个抽象方法 size ,以及一个默认方法 isEmpty : public interface Sized { int size(); default boolean isEmpty() { return size() == 0; } } 太棒了!这样任何一个实现了 Sized 接口的类都会自动继承 isEmpty 的实现。因此,向提供了默认实现的接口添加方法就不是源码兼容的。 现在,我们回顾一下最初的例子,那个Java画图类库和你的游戏程序。具体来说,为了以兼容的方式改进这个库(即使用该库的用户不需要修改他们实现了 Resizable 的类),可以使用默认方法,提供 setRelativeSize 的默认实现: default void setRelativeSize(int wFactor, int hFactor){ setAbsoluteSize(getWidth() / wFactor, getHeight() / hFactor); } 由于接口现在可以提供带实现的方法,是否这意味着Java已经在某种程度上实现了多继承?如果实现类也实现了同样的方法,这时会发生什么情况?默认方法会被覆盖吗?现在暂时无需担心这些,Java 8中已经定义了一些规则和机制来处理这些问题。 你可能已经猜到,默认方法在Java 8的API中已经大量地使用了。本章已经介绍过我们前一章中大量使用的 Collection 接口的 stream 方法就是默认方法。 List 接口的 sort 方法也是默认方法。第3章介绍的很多函数式接口,比如 Predicate 、 Function 以及 Comparator 也引入了新的默认方法,比如 Predicate.and 或者 Function.andThen (记住,函数式接口只包含一个抽象方法,默认方法是种非抽象方法)。 默认方法的使用模式 现在你已经了解了默认方法怎样以兼容的方式演进库函数了。除了这种用例,还有其他场景也能利用这个新特性吗?当然有,你可以创建自己的接口,并为其提供默认方法。这一节中,我们会介绍使用默认方法的两种用例:可选方法和行为的多继承。 可选方法 你很可能也碰到过这种情况,类实现了接口,不过却刻意地将一些方法的实现留白。我们以Iterator 接口为例来说。 Iterator 接口定义了 hasNext 、 next ,还定义了 remove 方法。Java 8之前,由于用户通常不会使用该方法, remove 方法常被忽略。因此,实现 Interator 接口的类通常会为 remove 方法放置一个空的实现,这些都是些毫无用处的模板代码。 采用默认方法之后,你可以为这种类型的方法提供一个默认的实现,这样实体类就无需在自己的实现中显式地提供一个空方法。比如,在Java 8中, Iterator 接口就为 remove 方法提供了一个默认实现,如下所示: public interface Iterator<E> { ... default void remove() { throw new UnsupportedOperationException("remove"); } ... } 通过这种方式,你可以减少无效的模板代码。实现 Iterator 接口的每一个类都不需要再声明一个空的 remove 方法了,因为它现在已经有一个默认的实现。 行为的多继承 默认方法让之前无法想象的事儿以一种优雅的方式得以实现,即行为的多继承。这是一种让类从多个来源重用代码的能力。 Java的类只能继承单一的类,但是一个类可以实现多接口。要确认也很简单,下面是Java API中对 ArrayList 类的定义: public class ArrayList<E> extends AbstractList<E> implements List<E>, RandomAccess, Cloneable, java.io.Serializable { } 类型的多继承 这个例子中 ArrayList 继承了一个类,实现了六个接口。因此 ArrayList 实际是七个类型的直接子类,分别是: AbstractList 、 List 、 RandomAccess 、 Cloneable 、 Serializable 、Iterable 和 Collection 。所以,在某种程度上,我们早就有了类型的多继承。 由于Java 8中接口方法可以包含实现,类可以从多个接口中继承它们的行为(即实现的代码)。让我们从一个例子入手,看看如何充分利用这种能力来为我们服务。保持接口的精致性和正交性能帮助你在现有的代码基上最大程度地实现代码复用和行为组合。 利用正交方法的精简接口 假设你需要为你正在创建的游戏定义多个具有不同特质的形状。有的形状需要调整大小,但是不需要有旋转的功能;有的需要能旋转和移动,但是不需要调整大小。这种情况下,你怎么设计才能尽可能地重用代码? 你可以定义一个单独的 Rotatable 接口,并提供两个抽象方法 setRotationAngle 和getRotationAngle ,如下所示: public interface Rotatable { int getRotationAngle(); void setRotationAngle(int angleInDegrees); default void rotateBy(int angleInDegrees) { setRotationAngle((getRotationAngle() + angleInDegrees) % 360); } } 这种方式和模板设计模式有些相似,都是以其他方法需要实现的方法定义好框架算法。 现在,实现了 Rotatable 的所有类都需要提供 setRotationAngle 和 getRotationAngle的实现,但与此同时它们也会天然地继承 rotateBy 的默认实现。 类似地,你可以定义之前看到的两个接口 Moveable 和 Resizable 。它们都包含了默认实现。下面是 Moveable 的代码: public interface Moveable { int getX(); void setX(int x); int getY(); void setY(int y); default void moveHorizontally(int distance) { setX(getX() + distance); } default void moveVertically(int distance) { setY(getY() + distance); } } 下面是 Resizable 的代码: public interface Resizable extends Drawable { int getWidth(); void setWidth(int width); int getHeight(); void setHeight(int height); void setAbsoluteSize(int width, int height); default void setRelativeSize(int wFactor, int hFactor){ setAbsoluteSize(getWidth() / wFactor, getHeight() / hFactor); } } 组合接口 通过组合这些接口,你现在可以为你的游戏创建不同的实体类。比如, Monster 可以移动、旋转和缩放。 public class Monster implements Rotatable, Moveable, Resizable { ... } Monster 类会自动继承 Rotatable 、 Moveable 和 Resizable 接口的默认方法。这个例子中,Monster 继承了 rotateBy 、 moveHorizontally 、 moveVertically 和 setRelativeSize 的实现。 你现在可以直接调用不同的方法: Monster m = new Monster(); m.rotateBy(180); m.moveVertically(10); 像你的游戏代码那样使用默认实现来定义简单的接口还有另一个好处。假设你需要修改moveVertically 的实现,让它更高效地运行。你可以在 Moveable 接口内直接修改它的实现,所有实现该接口的类会自动继承新的代码(这里我们假设用户并未定义自己的方法实现)。 通过前面的介绍,你已经了解了默认方法多种强大的使用模式。不过也可能还有一些疑惑:如果一个类同时实现了两个接口,这两个接口恰巧又提供了同样的默认方法签名,这时会发生什么情况?类会选择使用哪一个方法?这些问题,我们会在接下来的一节进行讨论。 解决冲突的规则 我们知道Java语言中一个类只能继承一个父类,但是一个类可以实现多个接口。随着默认方法在Java 8中引入,有可能出现一个类继承了多个方法而它们使用的却是同样的函数签名。这种情况下,类会选择使用哪一个函数?在实际情况中,像这样的冲突可能极少发生,但是一旦发生这样的状况,必须要有一套规则来确定按照什么样的约定处理这些冲突。这一节中,我们会介绍Java编译器如何解决这种潜在的冲突。我们试图回答像“接下来的代码中,哪一个 hello 方法是被 C 类调用的”这样的问题。注意,接下来的例子主要用于说明容易出问题的场景,并不表示这些场景在实际开发过程中会经常发生。 public interface A { default void hello() { System.out.println("Hello from A"); } } public interface B extends A { default void hello() { System.out.println("Hello from B"); } } public class C implements A, B { public static void main(String[] args) { // 猜猜打印的是什么? new C().hello(); } } 此外,你可能早就对C++语言中著名的菱形继承问题有所了解,菱形继承问题中一个类同时继承了具有相同函数签名的两个方法。到底该选择哪一个实现呢? Java 8也提供了解决这个问题的方案。请接着阅读下面的内容。 解决问题的三条规则 如果一个类使用相同的函数签名从多个地方(比如另一个类或接口)继承了方法,通过三条规则可以进行判断。 类中的方法优先级最高。类或父类中声明的方法的优先级高于任何声明为默认方法的优先级。 如果无法依据第一条进行判断,那么子接口的优先级更高:函数签名相同时,优先选择拥有最具体实现的默认方法的接口,即如果 B 继承了 A ,那么 B 就比 A 更加具体。 最后,如果还是无法判断,继承了多个接口的类必须通过显式覆盖和调用期望的方法,显式地选择使用哪一个默认方法的实现。 是的,就是这三条准则就是你需要知道的全部了! 运行结果 让我们回顾一下开头的例子,这个例子中 C 类同时实现了 B 接口和 A 接口,而这两个接口恰巧又都定义了名为 hello 的默认方法。 编译器会使用声明的哪一个 hello 方法呢?其实上面的代码是编译不通过的,按照规则(2),应该选择的是提供了最具体实现的默认方法的接口。但,在C中不知道谁比谁更具体,所以需要显示的指定调用哪个接口的方法: public class C implements A, B { public static void main(String[] args) { new C().hello(); } @Override public void hello() { A.super.hello(); } OR @Override public void hello() { B.super.hello(); } OR @Override public void hello() { System.out.println("Hello from C!"); } } 比如:调用 A.super.Hello(),那么打印的是 Hello form A!,调用 B.super.Hello() 那么输出的是 Hello from B!。 如果,你碰到类似的问题,以上的三条准则将可以帮助你解决这个问题! 小结 Java 8中的接口可以通过默认方法和静态方法提供方法的代码实现。 默认方法的开头以关键字 default 修饰,方法体与常规的类方法相同。 向发布的接口添加抽象方法不是源码兼容的。 默认方法的出现能帮助库的设计者以后向兼容的方式演进API。 默认方法可以用于创建可选方法和行为的多继承。 我们有办法解决由于一个类从多个接口中继承了拥有相同函数签名的方法而导致的冲突。 类或者父类中声明的方法的优先级高于任何默认方法。如果前一条无法解决冲突,那就选择同函数签名的方法中实现得最具体的那个接口的方法。 两个默认方法都同样具体时,你需要在类中覆盖该方法,显式地选择使用哪个接口中提供的默认方法。 代码 Github:chap9Gitee:chap9

优秀的个人博客,低调大师

API网关触发函数计算处理示例教程(runtime=java8)

API网关触发java runtime的函数计算处理示例教程 背景信息 函数计算(Function Compute)是一种事件驱动的服务。函数的执行可以由事件驱动,即当某个事件发生时,触发函数的执行。目前函数计算支持API网关作为事件源,简单说来,当有请求到达已经设置函数计算为后端服务的API网关时,API网关会触发函数的执行,函数计算会将执行结果返回给API网关。 本示例对API网关触发函数计算的使用步骤进行详细介绍,并以运行环境为Java为例,对API网关传入的请求参数进行解析。 通过示例,您将了解 如何使用API网关触发函数计算; 如何在函数中获取API网关传入函数的参数,并将处理结果返回给API网关(以Java运行环境为例)。 本示例分为以下三个步骤 明确API网关和函数计算对接的格式要求(一定要以这个格式,否则互相不认识); 创建服务和需

优秀的个人博客,低调大师

《Java8实战》-第十章笔记(用Optional取代null)

用Optional取代null 如果你作为Java程序员曾经遭遇过NullPointerException,请举起手。如果这是你最常遭遇的异常,请继续举手。非常可惜,这个时刻,我们无法看到对方,但是我相信很多人的手这个时刻是举着的。我们还猜想你可能也有这样的想法:“毫无疑问,我承认,对任何一位Java程序员来说,无论是初出茅庐的新人,还是久经江湖的专家,NullPointerException都是他心中的痛,可是我们又无能为力,因为这就是我们为了使用方便甚至不可避免的像null引用这样的构造所付出的代价。”这就是程序设计世界里大家都持有的观点,然而,这可能并非事实的全部真相,只是我们根深蒂固的一种偏见。 1965年,英国一位名为Tony Hoare的计算机科学家在设计ALGOL W语言时提出了null引用的想法。ALGOL W是第一批在堆上分配记录的类型语言之一。Hoare选择null引用这种方式,“只是因为这种方法实现起来非常容易”。虽然他的设计初衷就是要“通过编译器的自动检测机制,确保所有使用引用的地方都是绝对安全的”,他还是决定为null引用开个绿灯,因为他认为这是为“不存在的值”建模最容易的方式。很多年后,他开始为自己曾经做过这样的决定而后悔不迭,把它称为“我价值百万的重大失误”。我们已经看到它带来的后果——程序员对对象的字段进行检查,判断它的值是否为期望的格式,最终却发现我们查看的并不是一个对象,而是一个空指针,它会立即抛出一个让人厌烦的NullPointerException异常。 实际上,Hoare的这段话低估了过去五十年来数百万程序员为修复空引用所耗费的代价。近十年出现的大多数现代程序设计语言,包括Java,都采用了同样的设计方式,其原因是为了与更老的语言保持兼容,或者就像Hoare曾经陈述的那样,“仅仅是因为这样实现起来更加容易”。让我们从一个简单的例子入手,看看使用null都有什么样的问题。 如何为缺失的值建模 假设你需要处理下面这样的嵌套对象,这是一个拥有汽车及汽车保险的客户。 public class Person { private Car car; public Car getCar() { return car; } } public class Car { private Insurance insurance; public Insurance getInsurance() { return insurance; } } public class Insurance { private String name; public String getName() { return name; } } 那么,下面这段代码存在怎样的问题呢? public String getCarInsuranceName(Person person) { return person.getCar().getInsurance().getName(); } 这段代码看起来相当正常,但是现实生活中很多人没有车。所以调用getCar方法的结果会怎样呢?在实践中,一种比较常见的做法是返回一个null引用,表示该值的缺失,即用户没有车。而接下来,对getInsurance的调用会返回null引用的insurance,这会导致运行时出现一个NullPointerException,终止程序的运行。但这还不是全部。如果返回的person值为null会怎样?如果getInsurance的返回值也是null,结果又会怎样? 采用防御式检查减少NullPointerException 怎样做才能避免这种不期而至的NullPointerException呢?通常,你可以在需要的地方添加null的检查(过于激进的防御式检查甚至会在不太需要的地方添加检测代码),并且添加的方式往往各有不同。下面这个例子是我们试图在方法中避免NullPointerException的第一次尝试。 public String getCarInsuranceName(Person person) { if (person != null) { Car car = person.getCar(); if (car != null) { Insurance insurance = car.getInsurance(); if (insurance != null) { return insurance.getName(); } } } return "Unknown"; } 这个方法每次引用一个变量都会做一次null检查,如果引用链上的任何一个遍历的解变量值为null,它就返回一个值为“Unknown”的字符串。唯一的例外是保险公司的名字,你不需要对它进行检查,原因很简单,因为任何一家公司必定有个名字。注意到了吗,由于你掌握业务领域的知识,避免了最后这个检查,但这并不会直接反映在你建模数据的Java类之中。 我们将上面的代码标记为“深层质疑”,原因是它不断重复着一种模式:每次你不确定一个变量是否为null时,都需要添加一个进一步嵌套的if块,也增加了代码缩进的层数。很明显,这种方式不具备扩展性,同时还牺牲了代码的可读性。面对这种窘境,你也许愿意尝试另一种方案。下面的代码清单中,我们试图通过一种不同的方式避免这种问题。 public String getCarInsuranceName(Person person) { if (person == null) { return "Unknown"; } Car car = person.getCar(); if (car == null) { return "Unknown"; } Insurance insurance = car.getInsurance(); if (insurance == null) { return "Unknown"; } return insurance.getName(); } 第二种尝试中,你试图避免深层递归的if语句块,采用了一种不同的策略:每次你遭遇null变量,都返回一个字符串常量“Unknown”。然而,这种方案远非理想,现在这个方法有了四个截然不同的退出点,使得代码的维护异常艰难。更糟的是,发生null时返回的默认值,即字符串“Unknown”在三个不同的地方重复出现——出现拼写错误的概率不小!当然,你可能会说,我们可以用把它们抽取到一个常量中的方式避免这种问题。 进一步而言,这种流程是极易出错的;如果你忘记检查了那个可能为null的属性会怎样?通过这一章的学习,你会了解使用null来表示变量值的缺失是大错特错的。你需要更优雅的方式来对缺失的变量值建模。 null 带来的种种问题 让我们一起回顾一下到目前为止进行的讨论,在Java程序开发中使用null会带来理论和实际操作上的种种问题。 它是错误之源。NullPointerException是目前Java程序开发中最典型的异常。 它会使你的代码膨胀。它让你的代码充斥着深度嵌套的null检查,代码的可读性糟糕透顶。 它自身是毫无意义的。null自身没有任何的语义,尤其是,它代表的是在静态类型语言中以一种错误的方式对缺失变量值的建模。 它破坏了Java的哲学。Java一直试图避免让程序员意识到指针的存在,唯一的例外是:null指针。 它在Java的类型系统上开了个口子。null并不属于任何类型,这意味着它可以被赋值给任意引用类型的变量。这会导致问题,原因是当这个变量被传递到系统中的另一个部分后,你将无法获知这个null变量最初的赋值到底是什么类型。 Optional 类入门 为了更好的解决和避免NPE异常,Java 8中引入了一个新的类java.util.Optional。这是一个封装Optional值的类。举例来说,使用新的类意味着,如果你知道一个人可能有也可能没有车,那么Person类内部的car变量就不应该声明为Car,遭遇某人没有车时把null引用赋值给它,而是将其声明为Optional类型。 变量存在时,Optional类只是对类简单封装。变量不存在时,缺失的值会被建模成一个“空”的Optional对象,由方法Optional.empty()返回。Optional.empty()方法是一个静态工厂方法,它返回Optional类的特定单一实例。你可能还有疑惑,null引用和Optional.empty()有什么本质的区别吗?从语义上,你可以把它们当作一回事儿,但是实际中它们之间的差别非常大: 如果你尝试解引用一个null , 一定会触发NullPointerException , 不过使用Optional.empty()就完全没事儿,它是Optional类的一个有效对象,多种场景都能调用,非常有用。关于这一点,接下来的部分会详细介绍。 使用Optional而不是null的一个非常重要而又实际的语义区别是,第一个例子中,我们在声明变量时使用的是Optional类型,而不是Car类型,这句声明非常清楚地表明了这里发生变量缺失是允许的。与此相反,使用Car这样的类型,可能将变量赋值为null,这意味着你需要独立面对这些,你只能依赖你对业务模型的理解,判断一个null是否属于该变量的有效范畴。 牢记上面这些原则,你现在可以使用Optional类对最初的代码进行重构,结果如下。 public class Person { private Optional<Car> car; public Optional<Car> getCar() { return car; } } public class Insurance { private String name; public String getName() { return name; } } public class Car { private Optional<Insurance> insurance; public Optional<Insurance> getInsurance() { return insurance; } } 发现Optional是如何丰富你模型的语义了吧。代码中person引用的是Optional,而car引用的是Optional,这种方式非常清晰地表达了你的模型中一个person可能拥有也可能没有car的情形,同样,car可能进行了保险,也可能没有保险。 与此同时,我们看到insurance公司的名称被声明成String类型,而不是Optional,这非常清楚地表明声明为insurance公司的类型必须提供公司名称。使用这种方式,一旦解引用insurance公司名称时发生NullPointerException,你就能非常确定地知道出错的原因,不再需要为其添加null的检查,因为null的检查只会掩盖问题,并未真正地修复问题。insurance公司必须有个名字,所以,如果你遇到一个公司没有名称,你需要调查你的数据出了什么问题,而不应该再添加一段代码,将这个问题隐藏。 在你的代码中始终如一地使用Optional,能非常清晰地界定出变量值的缺失是结构上的问题,还是你算法上的缺陷,抑或是你数据中的问题。另外,我们还想特别强调,引入Optional类的意图并非要消除每一个null引用。与此相反,它的目标是帮助你更好地设计出普适的API,让程序员看到方法签名,就能了解它是否接受一个Optional的值。这种强制会让你更积极地将变量从Optional中解包出来,直面缺失的变量值。 应用Optional 的几种模式 到目前为止,一切都很顺利;你已经知道了如何使用Optional类型来声明你的域模型,也了解了这种方式与直接使用null引用表示变量值的缺失的优劣。但是,我们该如何使用呢?用这种方式能做什么,或者怎样使用Optional封装的值呢? 创建Optional 对象 使用Optional之前,你首先需要学习的是如何创建Optional对象。完成这一任务有多种方法。 声明一个空的Optional 正如前文已经提到,你可以通过静态工厂方法Optional.empty,创建一个空的Optional对象: Optional<Car> optCar = Optional.empty(); 依据一个非空值创建Optional 你还可以使用静态工厂方法Optional.of,依据一个非空值创建一个Optional对象: Optional<Car> optCar = Optional.of(car); 如果car是一个null,这段代码会立即抛出一个NullPointerException,而不是等到你试图访问car的属性值时才返回一个错误。 可接受null的Optional 最后,使用静态工厂方法Optional.ofNullable,你可以创建一个允许null值的Optional对象: Optional<Car> optCar = Optional.ofNullable(car); 如果car是null,那么得到的Optional对象就是个空对象。 你可能已经猜到,我们还需要继续研究“如何获取Optional变量中的值”。尤其是,Optional提供了一个get方法,它能非常精准地完成这项工作,我们在后面会详细介绍这部分内容。不过get方法在遭遇到空的Optional对象时也会抛出异常,所以不按照约定的方式使用它,又会让我们再度陷入由null引起的代码维护的梦魇。因此,我们首先从无需显式检查的Optional值的使用入手,这些方法与Stream中的某些操作极其相似。 使用map 从Optional 对象中提取和转换值 从对象中提取信息是一种比较常见的模式。比如,你可能想要从insurance公司对象中提取公司的名称。提取名称之前,你需要检查insurance对象是否为null,代码如下所示: String name = null; if(insurance != null){ name = insurance.getName(); } 为了支持这种模式,Optional提供了一个map方法。它的工作方式如下: Optional<Insurance> optionalInsurance = Optional.ofNullable(insurance); Optional<String> name = optionalInsurance.map(Insurance::getName); 从概念上,这与我们在第4章和第5章中看到的流的map方法相差无几。map操作会将提供的函数应用于流的每个元素。你可以把Optional对象看成一种特殊的集合数据,它至多包含一个元素。如果Optional包含一个值,那函数就将该值作为参数传递给map,对该值进行转换。如果Optional为空,就什么也不做。 这看起来挺有用,但是你怎样才能应用起来,重构之前的代码呢?前文的代码里用安全的方式链接了多个方法。 public String getCarInsuranceName(Person person) { return person.getCar().getInsurance().getName(); } 为了达到这个目的,我们需要求助Optional提供的另一个方法flatMap。 使用flatMap 链接Optional 对象 由于我们刚刚学习了如何使用map,你的第一反应可能是我们可以利用map重写之前的代码,如下所示: Optional<Person> optPerson = Optional.of(person); Optional<String> name = optPerson.map(Person::getCar) .map(Car::getInsurance) .map(Insurance::getName); 不幸的是,这段代码无法通过编译。为什么呢?optPerson是Optional类型的变量, 调用map方法应该没有问题。但getCar返回的是一个Optional类型的对象,这意味着map操作的结果是一个Optional>类型的对象。因此,它对getInsurance的调用是非法的,因为最外层的optional对象包含了另一个optional对象的值,而它当然不会支持getInsurance方法。 所以,我们该如何解决这个问题呢?让我们再回顾一下你刚刚在流上使用过的模式:flatMap方法。使用流时,flatMap方法接受一个函数作为参数,这个函数的返回值是另一个流。这个方法会应用到流中的每一个元素,最终形成一个新的流的流。但是flagMap会用流的内容替换每个新生成的流。换句话说,由方法生成的各个流会被合并或者扁平化为一个单一的流。这里你希望的结果其实也是类似的,但是你想要的是将两层的optional合并为一个。 这个例子中,传递给流的flatMap方法会将每个正方形转换为另一个流中的两个三角形。那么,map操作的结果就包含有三个新的流,每一个流包含两个三角形,但flatMap方法会将这种两层的流合并为一个包含六个三角形的单一流。类似地,传递给optional的flatMap方法的函数会将原始包含正方形的optional对象转换为包含三角形的optional对象。如果将该方法传递给map方法,结果会是一个Optional对象,而这个Optional对象中包含了三角形;但flatMap方法会将这种两层的Optional对象转换为包含三角形的单一Optional对象。 使用Optional获取car的保险公司名称 相信现在你已经对Optional的map和flatMap方法有了一定的了解,让我们看看如何应用。 public String getCarInsuranceName(Optional<Person> person) { return person.flatMap(Person::getCar) .flatMap(Car::getInsurance) .map(Insurance::getName) // 如果Optional的j结果为空值,设置默认值 .orElse("Unknown"); } 我们可以看到,处理潜在可能缺失的值时,使用Optional具有明显的优势。这一次,你可以用非常容易却又普适的方法实现之前你期望的效果——不再需要使用那么多的条件分支,也不会增加代码的复杂性。 使用Optional解引用串接的Person/Car/Insurance对象 由Optional对象,我们可以结合使用之前介绍的map和flatMap方法,从Person中解引用出Car,从Car中解引用出Insurance,从Insurance对象中解引用出包含insurance公司名称的字符串。 这里,我们从以Optional封装的Person入手,对其调用flatMap(Person::getCar)。如前所述,这种调用逻辑上可以划分为两步。第一步,某个Function作为参数,被传递给由Optional封装的Person对象,对其进行转换。这个场景中,Function的具体表现是一个方法引用,即对Person对象的getCar方法进行调用。由于该方法返回一个Optional类型的对象,Optional内的Person也被转换成了这种对象的实例,结果就是一个两层的Optional对象,最终它们会被flagMap操作合并。从纯理论的角度而言,你可以将这种合并操作简单地看成把两个Optional对象结合在一起,如果其中有一个对象为空,就构成一个空的Optional对象。如果你对一个空的Optional对象调用flatMap,实际情况又会如何呢?结果不会发生任何改变,返回值也是个空的Optional对象。与此相反,如果Optional封装了一个Person对象,传递给flapMap的Function,就会应用到Person上对其进行处理。这个例子中,由于Function的返回值已经是一个Optional对象,flapMap方法就直接将其返回。 第二步与第一步大同小异,它会将Optional转换为Optional。第三步则会将Optional转化为Optional对象,由于Insurance.getName()方法的返回类型为String,这里就不再需要进行flapMap操作了。 截至目前为止,返回的Optional可能是两种情况:如果调用链上的任何一个方法返回一个空的Optional,那么结果就为空,否则返回的值就是你期望的保险公司的名称。那么,你如何读出这个值呢?毕竟你最后得到的这个对象还是个Optional,它可能包含保险公司的名称,也可能为空。我们使用了一个名为orElse的方法,当Optional的值为空时,它会为其设定一个默认值。除此之外,还有很多其他的方法可以为Optional设定默认值,或者解析出Optional代表的值。接下来我们会对此做进一步的探讨。 默认行为及解引用Optional 对象 我们决定采用orElse方法读取这个变量的值,使用这种方式你还可以定义一个默认值,遭遇空的Optional变量时,默认值会作为该方法的调用返回值。Optional类提供了多种方法读取Optional实例中的变量值。 get()是这些方法中最简单但又最不安全的方法。如果变量存在,它直接返回封装的变量值,否则就抛出一个NoSuchElementException异常。所以,除非你非常确定Optional变量一定包含值,否则使用这个方法是个相当糟糕的主意。此外,这种方式即便相对于嵌套式的null检查,也并未体现出多大的改进。 orElse(T other)是我们在代码使用的方法,正如之前提到的,它允许你在Optional对象不包含值时提供一个默认值。 orElseGet(Supplier<? extends T> other)是orElse方法的延迟调用版,Supplier方法只有在Optional对象不含值时才执行调用。如果创建默认值是件耗时费力的工作,你应该考虑采用这种方式(借此提升程序的性能),或者你需要非常确定某个方法仅在Optional为空时才进行调用,也可以考虑该方式(这种情况有严格的限制条件)。 orElseThrow(Supplier<? extends X> exceptionSupplier)和get方法非常类似,它们遭遇Optional对象为空时都会抛出一个异常,但是使用orElseThrow你可以定制希望抛出的异常类型。 ifPresent(Consumer<? super T>)让你能在变量值存在时执行一个作为参数传入的方法,否则就不进行任何操作。 Optional类和Stream接口的相似之处,远不止map和flatMap这两个方法。还有第三个方法filter,它的行为在两种类型之间也极其相似。 两个Optional 对象的组合 现在,我们假设你有这样一个方法,它接受一个Person和一个Car对象,并以此为条件对外部提供的服务进行查询,通过一些复杂的业务逻辑,试图找到满足该组合的最便宜的保险公司: public Insurance findCheapestInsurance(Person person, Car car) { // 不同的保险公司提供的查询服务 // 对比所有数据 return cheapestCompany; } 我们还假设你想要该方法的一个null-安全的版本,它接受两个Optional对象作为参数,返回值是一个Optional对象,如果传入的任何一个参数值为空,它的返回值亦为空。Optional类还提供了一个isPresent方法,如果Optional对象包含值,该方法就返回true,所以你的第一想法可能是通过下面这种方式实现该方法: public Optional<Insurance> nullSafeFindCheapestInsurance(Optional<Person> person, Optional<Car> car) { if (person.isPresent() && car.isPresent()) { return Optional.of(findCheapestInsurance(person.get(), car.get())); } else { return Optional.empty(); } } 这个方法具有明显的优势,我们从它的签名就能非常清楚地知道无论是person还是car,它的值都有可能为空,出现这种情况时,方法的返回值也不会包含任何值。不幸的是,该方法的具体实现和你之前曾经实现的null检查太相似了:方法接受一个Person和一个Car对象作为参数,而二者都有可能为null。利用Optional类提供的特性,有没有更好或更地道的方式来实现这个方法呢? Optional类和Stream接口的相似之处远不止map和flatMap这两个方法。还有第三个方法filter,它的行为在两种类型之间也极其相似,我们在接下来的一节会进行介绍。 使用filter 剔除特定的值 你经常需要调用某个对象的方法,查看它的某些属性。比如,你可能需要检查保险公司的名称是否为“Cambridge-Insurance”。为了以一种安全的方式进行这些操作,你首先需要确定引用指向的Insurance对象是否为null,之后再调用它的getName方法,如下所示: Insurance insurance = ...; if(insurance != null && "CambridgeInsurance".equals(insurance.getName())){ System.out.println("ok"); } 使用Optional对象的filter方法,这段代码可以重构如下: Optional<Insurance> optInsurance = ...; optInsurance.filter(insurance -> "CambridgeInsurance".equals(insurance.getName())) .ifPresent(x -> System.out.println("ok")); filter方法接受一个谓词作为参数。如果Optional对象的值存在,并且它符合谓词的条件,filter方法就返回其值;否则它就返回一个空的Optional对象。如果你还记得我们可以将Optional看成最多包含一个元素的Stream对象,这个方法的行为就非常清晰了。如果Optional对象为空,它不做任何操作,反之,它就对Optional对象中包含的值施加谓词操作。如果该操作的结果为true,它不做任何改变,直接返回该Optional对象,否则就将该值过滤掉,将Optional的值置空。 下一节中,我们会探讨Optional类剩下的一些特性,并提供更实际的例子,展示多种你能够应用于代码中更好地管理缺失值的技巧。 使用Optional 的实战示例 相信你已经了解,有效地使用Optional类意味着你需要对如何处理潜在缺失值进行全面的反思。这种反思不仅仅限于你曾经写过的代码,更重要的可能是,你如何与原生Java API实现共存共赢。 实际上,我们相信如果Optional类能够在这些API创建之初就存在的话,很多API的设计编写可能会大有不同。为了保持后向兼容性,我们很难对老的Java API进行改动,让它们也使用Optional,但这并不表示我们什么也做不了。你可以在自己的代码中添加一些工具方法,修复或者绕过这些问题,让你的代码能享受Optional带来的威力。我们会通过几个实际的例子讲解如何达到这样的目的。 用Optional 封装可能为null 的值 现存Java API几乎都是通过返回一个null的方式来表示需要值的缺失,或者由于某些原因计算无法得到该值。比如,如果Map中不含指定的键对应的值,它的get方法会返回一个null。但是,正如我们之前介绍的,大多数情况下,你可能希望这些方法能返回一个Optional对象。你无法修改这些方法的签名,但是你很容易用Optional对这些方法的返回值进行封装。我们接着用Map做例子,假设你有一个Map方法,访问由key索引的值时,如果map中没有与key关联的值,该次调用就会返回一个null。 Object value = map.get("key"); 使用Optional封装map的返回值,你可以对这段代码进行优化。要达到这个目的有两种方式:你可以使用笨拙的if-then-else判断语句,毫无疑问这种方式会增加代码的复杂度;或者你可以采用我们前文介绍的Optional.ofNullable方法: Optional<Object> value = Optional.ofNullable(map.get("key")); 每次你希望安全地对潜在为null的对象进行转换,将其替换为Optional对象时,都可以考虑使用这种方法。 异常与Optional 的对比 由于某种原因,函数无法返回某个值,这时除了返回null,Java API比较常见的替代做法是抛出一个异常。这种情况比较典型的例子是使用静态方法Integer.parseInt(String),将String转换为int。在这个例子中,如果String无法解析到对应的整型,该方法就抛出一个NumberFormatException。最后的效果是,发生String无法转换为int时,代码发出一个遭遇非法参数的信号,唯一的不同是,这次你需要使用try/catch 语句,而不是使用if条件判断来控制一个变量的值是否非空。 你也可以用空的Optional对象,对遭遇无法转换的String时返回的非法值进行建模,这时你期望parseInt的返回值是一个optional。我们无法修改最初的Java方法,但是这无碍我们进行需要的改进,你可以实现一个工具方法,将这部分逻辑封装于其中,最终返回一个我们希望的Optional对象,代码如下所示。 public static Optional<Integer> stringToInt(String s) { try { return Optional.of(Integer.parseInt(s)); } catch (NumberFormatException e) { return Optional.empty(); } } 我们的建议是,你可以将多个类似的方法封装到一个工具类中,让我们称之为OptionalUtility。通过这种OptionalUtility.stringToInt方法,将String转换为一个Optional对象,而不再需要记得你在其中封装了笨拙的try/catch的逻辑了。 代码 Github: chap10 Gitee: chap10

优秀的个人博客,低调大师

《Java8实战》-第八章笔记(重构、测试和调试)

重构、测试和调试 通过本书的前七章,我们了解了Lambda和Stream API的强大威力。你可能主要在新项目的代码中使用这些特性。如果你创建的是全新的Java项目,这是极好的时机,你可以轻装上阵,迅速地将新特性应用到项目中。然而不幸的是,大多数情况下你没有机会从头开始一个全新的项目。很多时候,你不得不面对的是用老版Java接口编写的遗留代码。 这些就是本章要讨论的内容。我们会介绍几种方法,帮助你重构代码,以适配使用Lambda表达式,让你维护的代码具备更好的可读性和灵活性。除此之外,我们还会讨论目前比较流行的几种面向对象的设计模式,包括策略模式、模板方法模式、观察者模式、责任链模式,以及工厂模式,在结合Lambda表达式之后变得更简洁的情况。最后,我们会介绍如何测试和调试使用Lambda表达式和Stream API的代码。 为改善可读性和灵活性重构代码 从本书的开篇我们就一直在强调,利用Lambda表达式,你可以写出更简洁、更灵活的代码。用“更简洁”来描述Lambda表达式是因为相较于匿名类,Lambda表达式可以帮助我们用更紧凑的方式描述程序的行为。第3章中我们也提到,如果你希望将一个既有的方法作为参数传递给另一个方法,那么方法引用无疑是我们推荐的方法,利用这种方式我们能写出非常简洁的代码。 采用Lambda表达式之后,你的代码会变得更加灵活,因为Lambda表达式鼓励大家使用第2章中介绍过的行为参数化的方式。在这种方式下,应对需求的变化时,你的代码可以依据传入的参数动态选择和执行相应的行为。 这一节,我们会将所有这些综合在一起,通过例子展示如何运用前几章介绍的Lambda表达式、方法引用以及Stream接口等特性重构遗留代码,改善程序的可读性和灵活性。 改善代码的可读性 改善代码的可读性到底意味着什么?我们很难定义什么是好的可读性,因为这可能非常主观。通常的理解是,“别人理解这段代码的难易程度”。改善可读性意味着你要确保你的代码能非常容易地被包括自己在内的所有人理解和维护。为了确保你的代码能被其他人理解,有几个步骤可以尝试,比如确保你的代码附有良好的文档,并严格遵守编程规范。 跟之前的版本相比较,Java 8的新特性也可以帮助提升代码的可读性: 使用Java 8,你可以减少冗长的代码,让代码更易于理解 通过方法引用和Stream API,你的代码会变得更直观 这里我们会介绍三种简单的重构,利用Lambda表达式、方法引用以及Stream改善程序代码的可读性: 重构代码,用Lambda表达式取代匿名类 用方法引用重构Lambda表达式 用Stream API重构命令式的数据处理 从匿名类到 Lambda 表达式的转换 你值得尝试的第一种重构,也是简单的方式,是将实现单一抽象方法的匿名类转为Lambda表达式。为什么呢?前面几章的介绍应该足以说服你,因为匿名类是极其繁琐且容易出错的。采用Lambda表达式之后,你的代码会更简洁,可读性更好。还记得第3章的例子就是一个创建Runnable 对象的匿名类,这段代码及其对应的Lambda表达式实现如下: Runnable r1 = new Runnable(){ public void run() { System.out.println("Hello"); } }; Runnable r2 = () -> System.out.println("Hello"); 但是某些情况下,将匿名类转换为Lambda表达式可能是一个比较复杂的过程。 首先,匿名类和Lambda表达式中的 this 和 super 的含义是不同的。在匿名类中, this 代表的是类自身,但是在Lambda中,它代表的是包含类。其次,匿名类可以屏蔽包含类的变量,而Lambda表达式不能(它们会导致编译错误),譬如下面这段代码: int a = 10; Runnable r1 = () -> { // 编译错误 int a = 2; System.out.println(a); }; Runnable r2 = new Runnable(){ public void run(){ // 一切正常 int a = 2; System.out.println(a); } }; 最后,在涉及重载的上下文里,将匿名类转换为Lambda表达式可能导致最终的代码更加晦涩。实际上,匿名类的类型是在初始化时确定的,而Lambda的类型取决于它的上下文。通过下面这个例子,我们可以了解问题是如何发生的。我们假设你用与 Runnable 同样的签名声明了一个函数接口,我们称之为 Task (你希望采用与你的业务模型更贴切的接口名时,就可能做这样的变更): interface Task { public void execute(); } public static void doSomething(Runnable r) { r.run(); } public static void doSomething(Task a) { a.execute(); } 现在,你再传递一个匿名类实现的 Task ,不会碰到任何问题: doSomething(new Task() { public void execute() { System.out.println("Danger danger!!"); } }); 但是将这种匿名类转换为Lambda表达式时,就导致了一种晦涩的方法调用,因为 Runnable和 Task 都是合法的目标类型: // 麻烦来了: doSomething(Runnable) 和doSomething(Task)都匹配该类型 doSomething(() -> System.out.println("Danger danger!!")); 你可以对 Task 尝试使用显式的类型转换来解决这种模棱两可的情况: doSomething((Task)() -> System.out.println("Danger danger!!")); 但是不要因此而放弃对Lambda的尝试。 从 Lambda 表达式到方法引用的转换 Lambda表达式非常适用于需要传递代码片段的场景。不过,为了改善代码的可读性,也请尽量使用方法引用。因为方法名往往能更直观地表达代码的意图。比如,第6章中我们曾经展示过下面这段代码,它的功能是按照食物的热量级别对菜肴进行分类: Map<Dish.CaloricLevel, List<Dish>> dishesByCaloricLevel = menu.stream().collect( groupingBy(dish -> { if (dish.getCalories() <= 400) { return Dish.CaloricLevel.DIET; } else if (dish.getCalories() <= 700) { return Dish.CaloricLevel.NORMAL; } else { return Dish.CaloricLevel.FAT; } })); 你可以将Lambda表达式的内容抽取到一个单独的方法中,将其作为参数传递给 groupingBy方法。变换之后,代码变得更加简洁,程序的意图也更加清晰了: Map<CaloricLevel, List<Dish>> dishesByCaloricLevel = menu.stream().collect(groupingBy(Dish::getCaloricLevel)); 为了实现这个方案,你还需要在 Dish 类中添加 getCaloricLevel 方法: public class Dish{ … public CaloricLevel getCaloricLevel(){ if (this.getCalories() <= 400) { return CaloricLevel.DIET; } else if (this.getCalories() <= 700) { return CaloricLevel.NORMAL; } else { return CaloricLevel.FAT; } } } 除此之外,我们还应该尽量考虑使用静态辅助方法,比如 comparing 、 maxBy 。这些方法设计之初就考虑了会结合方法引用一起使用。通过示例,我们看到相对于第3章中的对应代码,优化过的代码更清晰地表达了它的设计意图: inventory.sort((Apple a1, Apple a2) -> a1.getWeight().compareTo(a2.getWeight())); inventory.sort(comparing(Apple::getWeight)); 此外,很多通用的归约操作,比如 sum 、 maximum ,都有内建的辅助方法可以和方法引用结合使用。比如,在我们的示例代码中,使用 Collectors 接口可以轻松得到和或者最大值,与采用Lambada表达式和底层的归约操作比起来,这种方式要直观得多。与其编写: int totalCalories = menu.stream().map(Dish::getCalories).reduce(0, (c1, c2) -> c1 + c2); 不如尝试使用内置的集合类,它能更清晰地表达问题陈述是什么。下面的代码中,我们使用了集合类 summingInt (方法的名词很直观地解释了它的功能): int totalCalories = menu.stream().collect(summingInt(Dish::getCalories)); 从命令式的数据处理切换到 Stream 我们建议你将所有使用迭代器这种数据处理模式处理集合的代码都转换成Stream API的方式。为什么呢?Stream API能更清晰地表达数据处理管道的意图。除此之外,通过短路和延迟载入以及利用第7章介绍的现代计算机的多核架构,我们可以对Stream进行优化。 比如,下面的命令式代码使用了两种模式:筛选和抽取,这两种模式被混在了一起,这样的代码结构迫使程序员必须彻底搞清楚程序的每个细节才能理解代码的功能。此外,实现需要并行运行的程序所面对的困难也多得多: List<String> dishNames = new ArrayList<>(); for(Dish dish: menu){ if(dish.getCalories() > 300){ dishNames.add(dish.getName()); } } 替代方案使用Stream API,采用这种方式编写的代码读起来更像是问题陈述,并行化也非常容易: menu.parallelStream() .filter(d -> d.getCalories() > 300) .map(Dish::getName) .collect(toList()); 不幸的是,将命令式的代码结构转换为Stream API的形式是个困难的任务,因为你需要考虑控制流语句,比如 break 、 continue 、 return ,并选择使用恰当的流操作。 增加代码的灵活性 第2章和第3章中,我们曾经介绍过Lambda表达式有利于行为参数化。你可以使用不同的Lambda表示不同的行为,并将它们作为参数传递给函数去处理执行。这种方式可以帮助我们淡定从容地面对需求的变化。比如,我们可以用多种方式为 Predicate 创建筛选条件,或者使用Comparator 对多种对象进行比较。现在,我们来看看哪些模式可以马上应用到你的代码中,让你享受Lambda表达式带来的便利。 采用函数接口 首先,你必须意识到,没有函数接口,你就无法使用Lambda表达式。因此,你需要在代码中引入函数接口。听起来很合理,但是在什么情况下使用它们呢?这里我们介绍两种通用的模式,你可以依照这两种模式重构代码,利用Lambda表达式带来的灵活性,它们分别是:有条件的延迟执行和环绕执行。 有条件的延迟执行 我们经常看到这样的代码,控制语句被混杂在业务逻辑代码之中。典型的情况包括进行安全性检查以及日志输出。比如,下面的这段代码,它使用了Java语言内置的 Logger 类: if (logger.isLoggable(Log.FINER)){ logger.finer("Problem: " + generateDiagnostic()); } 这段代码有什么问题吗?其实问题不少。 日志器的状态(它支持哪些日志等级)通过 isLoggable 方法暴露给了客户端代码。 为什么要在每次输出一条日志之前都去查询日志器对象的状态?这只能搞砸你的代码。更好的方案是使用 log 方法,该方法在输出日志消息之前,会在内部检查日志对象是否已经设置为恰当的日志等级: logger.log(Level.FINER, "Problem: " + generateDiagnostic()); 这种方式更好的原因是你不再需要在代码中插入那些条件判断,与此同时日志器的状态也不再被暴露出去。不过,这段代码依旧存在一个问题。日志消息的输出与否每次都需要判断,即使你已经传递了参数,不开启日志。 这就是Lambda表达式可以施展拳脚的地方。你需要做的仅仅是延迟消息构造,如此一来,日志就只会在某些特定的情况下才开启(以此为例,当日志器的级别设置为 FINER 时)。显然,Java 8的API设计者们已经意识到这个问题,并由此引入了一个对 log 方法的重载版本,这个版本的 log 方法接受一个 Supplier 作为参数。这个替代版本的 log 方法的函数签名如下: public void log(Level level, Supplier<String> msgSupplier) 你可以通过下面的方式对它进行调用: logger.log(Level.FINER, () -> "Problem: " + generateDiagnostic()); 如果日志器的级别设置恰当, log 方法会在内部执行作为参数传递进来的Lambda表达式。这里介绍的 Log 方法的内部实现如下: public void log(Level level, Supplier<String> msgSupplier) { if(logger.isLoggable(level)){ log(level, msgSupplier.get()); } } 从这个故事里我们学到了什么呢?如果你发现你需要频繁地从客户端代码去查询一个对象的状态(比如前文例子中的日志器的状态),只是为了传递参数、调用该对象的一个方法(比如输出一条日志),那么可以考虑实现一个新的方法,以Lambda或者方法表达式作为参数,新方法在检查完该对象的状态之后才调用原来的方法。你的代码会因此而变得更易读(结构更清晰),封装性更好(对象的状态也不会暴露给客户端代码了)。 通过这一节,你已经了解了如何通过不同方式来改善代码的可读性和灵活性。接下来,你会了解Lambada表达式如何避免常规面向对象设计中的僵化的模板代码。 使用 Lambda 重构面向对象的设计模式 新的语言特性常常让现存的编程模式或设计黯然失色。比如, Java 5中引入了 foreach 循环,由于它的稳健性和简洁性,已经替代了很多显式使用迭代器的情形。Java 7中推出的菱形操作符( <> )让大家在创建实例时无需显式使用泛型,一定程度上推动了Java程序员们采用类型接口(type interface)进行程序设计。 对设计经验的归纳总结被称为设计模式。设计软件时,如果你愿意,可以复用这些方式方法来解决一些常见问题。这看起来像传统建筑工程师的工作方式,对典型的场景(比如悬挂桥、拱桥等)都定义有可重用的解决方案。例如,访问者模式常用于分离程序的算法和它的操作对象。单例模式一般用于限制类的实例化,仅生成一份对象 Lambda表达式为程序员的工具箱又新添了一件利器。它们为解决传统设计模式所面对的问题提供了新的解决方案,不但如此,采用这些方案往往更高效、更简单。使用Lambda表达式后,很多现存的略显臃肿的面向对象设计模式能够用更精简的方式实现了。这一节中,我们会针对五个设计模式展开讨论,它们分别是: 策略模式 模板方法 观察者模式 责任链模式 工厂模式 我们会展示Lambda表达式是如何另辟蹊径解决设计模式原来试图解决的问题的。 策略模式 策略模式代表了解决一类算法的通用解决方案,你可以在运行时选择使用哪种方案。在第2章中你已经简略地了解过这种模式了,当时我们介绍了如何使用不同的条件(比如苹果的重量,或者颜色)来筛选库存中的苹果。你可以将这一模式应用到更广泛的领域,比如使用不同的标准来验证输入的有效性,使用不同的方式来分析或者格式化输入。 策略模式包含三部分内容: 一个代表某个算法的接口(它是策略模式的接口)。 一个或多个该接口的具体实现,它们代表了算法的多种实现(比如,实体类 ConcreteStrategyA 或者 ConcreteStrategyB )。 一个或多个使用策略对象的客户。 我们假设你希望验证输入的内容是否根据标准进行了恰当的格式化(比如只包含小写字母或数字)。你可以从定义一个验证文本(以 String 的形式表示)的接口入手: interface ValidationStrategy { boolean execute(String s); } 其次,你定义了该接口的一个或多个具体实现: static class IsAllLowerCase implements ValidationStrategy { @Override public boolean execute(String s) { return s.matches("[a-z]+"); } } static class IsNumeric implements ValidationStrategy { @Override public boolean execute(String s) { return s.matches("\\d+"); } } 之后,你就可以在你的程序中使用这些略有差异的验证策略了: private static class Validator { private final ValidationStrategy validationStrategy; public Validator(ValidationStrategy validationStrategy) { this.validationStrategy = validationStrategy; } public boolean validate(String s) { return validationStrategy.execute(s); } } Validator v1 = new Validator(new IsNumeric()); // false System.out.println(v1.validate("aaaa")); Validator v2 = new Validator(new IsAllLowerCase()); // true System.out.println(v2.validate("bbbb")); 使用Lambda表达式到现在为止,你应该已经意识到 ValidationStrategy 是一个函数接口了(除此之外,它还与 Predicate 具有同样的函数描述)。这意味着我们不需要声明新的类来实现不同的策略,通过直接传递Lambda表达式就能达到同样的目的,并且还更简洁: Validator v3 = new Validator((String s) -> s.matches("\\d+")); System.out.println(v3.validate("aaaa")); Validator v4 = new Validator((String s) -> s.matches("[a-z]+")); System.out.println(v4.validate("bbbb")); 正如你看到的,Lambda表达式避免了采用策略设计模式时僵化的模板代码。如果你仔细分析一下个中缘由,可能会发现,Lambda表达式实际已经对部分代码(或策略)进行了封装,而这就是创建策略设计模式的初衷。因此,我们强烈建议对类似的问题,你应该尽量使用Lambda表达式来解决。 模板方法 如果你需要采用某个算法的框架,同时又希望有一定的灵活度,能对它的某些部分进行改进,那么采用模板方法设计模式是比较通用的方案。好吧,这样讲听起来有些抽象。换句话说,模板方法模式在你“希望使用这个算法,但是需要对其中的某些行进行改进,才能达到希望的效果”时是非常有用的。 让我们从一个例子着手,看看这个模式是如何工作的。假设你需要编写一个简单的在线银行应用。通常,用户需要输入一个用户账户,之后应用才能从银行的数据库中得到用户的详细信息,最终完成一些让用户满意的操作。不同分行的在线银行应用让客户满意的方式可能还略有不同,比如给客户的账户发放红利,或者仅仅是少发送一些推广文件。你可能通过下面的抽象类方式来实现在线银行应用: public abstract class AbstractOnlineBanking { public void processCustomer(int id) { Customer customer = Database.getCustomerWithId(id); makeCustomerHappy(customer); } /** * 让客户满意 * * @param customer */ abstract void makeCustomerHappy(Customer customer); private static class Customer {} private static class Database { static Customer getCustomerWithId(int id) { return new Customer(); } } } processCustomer 方法搭建了在线银行算法的框架:获取客户提供的ID,然后提供服务让用户满意。不同的支行可以通过继承 AbstractOnlineBanking 类,对该方法提供差异化的实现。 使用Lambda表达式使用你偏爱的Lambda表达式同样也可以解决这些问题(创建算法框架,让具体的实现插入某些部分)。你想要插入的不同算法组件可以通过Lambda表达式或者方法引用的方式实现。 这里我们向 processCustomer 方法引入了第二个参数,它是一个 Consumer 类型的参数,与前文定义的 makeCustomerHappy 的特征保持一致: public void processCustomer(int id, Consumer<Customer> makeCustomerHappy) { Customer customer = Database.getCustomerWithId(id); makeCustomerHappy.accept(customer); } 现在,你可以很方便地通过传递Lambda表达式,直接插入不同的行为,不再需要继承AbstractOnlineBanking 类了: public static void main(String[] args) { new AbstractOnlineBankingLambda().processCustomer(1337, ( AbstractOnlineBankingLambda.Customer c) -> System.out.println("Hello!")); } 这是又一个例子,佐证了Lamba表达式能帮助你解决设计模式与生俱来的设计僵化问题。 观察者模式 观察者模式是一种比较常见的方案,某些事件发生时(比如状态转变),如果一个对象(通常我们称之为主题)需要自动地通知其他多个对象(称为观察者),就会采用该方案。创建图形用户界面(GUI)程序时,你经常会使用该设计模式。这种情况下,你会在图形用户界面组件(比如按钮)上注册一系列的观察者。如果点击按钮,观察者就会收到通知,并随即执行某个特定的行为。 但是观察者模式并不局限于图形用户界面。比如,观察者设计模式也适用于股票交易的情形,多个券商可能都希望对某一支股票价格(主题)的变动做出响应。 让我们写点儿代码来看看观察者模式在实际中多么有用。你需要为Twitter这样的应用设计并实现一个定制化的通知系统。想法很简单:好几家报纸机构,比如《纽约时报》《卫报》以及《世界报》都订阅了新闻,他们希望当接收的新闻中包含他们感兴趣的关键字时,能得到特别通知。 首先,你需要一个观察者接口,它将不同的观察者聚合在一起。它仅有一个名为 notify 的方法,一旦接收到一条新的新闻,该方法就会被调用: interface Observer{ void inform(String tweet); } 现在,你可以声明不同的观察者(比如,这里是三家不同的报纸机构),依据新闻中不同的关键字分别定义不同的行为: private static class NYTimes implements Observer { @Override public void inform(String tweet) { if (tweet != null && tweet.contains("money")) { System.out.println("Breaking news in NY!" + tweet); } } } private static class Guardian implements Observer { @Override public void inform(String tweet) { if (tweet != null && tweet.contains("queen")) { System.out.println("Yet another news in London... " + tweet); } } } private static class LeMonde implements Observer { @Override public void inform(String tweet) { if(tweet != null && tweet.contains("wine")){ System.out.println("Today cheese, wine and news! " + tweet); } } } 你还遗漏了最重要的部分: Subject !让我们为它定义一个接口: interface Subject { void registerObserver(Observer o); void notifyObserver(String tweet); } Subject 使用 registerObserver 方法可以注册一个新的观察者,使用 notifyObservers方法通知它的观察者一个新闻的到来。让我们更进一步,实现 Feed 类: private static class Feed implements Subject { private final List<Observer> observers = new ArrayList<>(); @Override public void registerObserver(Observer o) { observers.add(o); } @Override public void notifyObserver(String tweet) { observers.forEach(o -> o.inform(tweet)); } } 这是一个非常直观的实现: Feed 类在内部维护了一个观察者列表,一条新闻到达时,它就进行通知。 毫不意外,《卫报》会特别关注这条新闻! 使用Lambda表达式你可能会疑惑Lambda表达式在观察者设计模式中如何发挥它的作用。不知道你有没有注意到, Observer 接口的所有实现类都提供了一个方法: inform 。新闻到达时,它们都只是对同一段代码封装执行。Lambda表达式的设计初衷就是要消除这样的僵化代码。使用Lambda表达式后,你无需显式地实例化三个观察者对象,直接传递Lambda表达式表示需要执行的行为即可: Feed feedLambda = new Feed(); feedLambda.registerObserver((String tweet) -> { if (tweet != null && tweet.contains("money")) { System.out.println("Breaking news in NY!" + tweet); } }); feedLambda.registerObserver((String tweet) -> { if (tweet != null && tweet.contains("queen")) { System.out.println("Yet another news in London... " + tweet); } }); feedLambda.notifyObserver("Money money money, give me money!"); 那么,是否我们随时随地都可以使用Lambda表达式呢?答案是否定的!我们前文介绍的例子中,Lambda适配得很好,那是因为需要执行的动作都很简单,因此才能很方便地消除僵化代码。但是,观察者的逻辑有可能十分复杂,它们可能还持有状态,抑或定义了多个方法,诸如此类。在这些情形下,你还是应该继续使用类的方式。 责任链模式 责任链模式是一种创建处理对象序列(比如操作序列)的通用方案。一个处理对象可能需要在完成一些工作之后,将结果传递给另一个对象,这个对象接着做一些工作,再转交给下一个处理对象,以此类推。 通常,这种模式是通过定义一个代表处理对象的抽象类来实现的,在抽象类中会定义一个字段来记录后续对象。一旦对象完成它的工作,处理对象就会将它的工作转交给它的后继。代码中,这段逻辑看起来是下面这样: private static abstract class AbstractProcessingObject<T> { protected AbstractProcessingObject<T> successor; public void setSuccessor(AbstractProcessingObject<T> successor) { this.successor = successor; } public T handle(T input) { T r = handleWork(input); if (successor != null) { return successor.handle(r); } return r; } protected abstract T handleWork(T input); } 下面让我们看看如何使用该设计模式。你可以创建两个处理对象,它们的功能是进行一些文本处理工作。 private static class HeaderTextProcessing extends AbstractProcessingObject<String> { @Override protected String handleWork(String text) { return "From Raoul, Mario and Alan: " + text; } } private static class SpellCheckerProcessing extends AbstractProcessingObject<String> { @Override protected String handleWork(String text) { return text.replaceAll("labda", "lambda"); } } 现在你就可以将这两个处理对象结合起来,构造一个操作序列! AbstractProcessingObject<String> p1 = new HeaderTextProcessing(); AbstractProcessingObject<String> p2 = new SpellCheckerProcessing(); p1.setSuccessor(p2); String result = p1.handle("Aren't labdas really sexy?!!"); System.out.println(result); 使用Lambda表达式稍等!这个模式看起来像是在链接(也即是构造) 函数。第3章中我们探讨过如何构造Lambda表达式。你可以将处理对象作为函数的一个实例,或者更确切地说作为 UnaryOperator 的一个实例。为了链接这些函数,你需要使用 andThen 方法对其进行构造。 UnaryOperator<String> headerProcessing = (String text) -> "From Raoul, Mario and Alan: " + text; UnaryOperator<String> spellCheckerProcessing = (String text) -> text.replaceAll("labda", "lambda"); Function<String, String> pipeline = headerProcessing.andThen(spellCheckerProcessing); String result2 = pipeline.apply("Aren't labdas really sexy?!!"); System.out.println(result2); 工厂模式 使用工厂模式,你无需向客户暴露实例化的逻辑就能完成对象的创建。比如,我们假定你为一家银行工作,他们需要一种方式创建不同的金融产品:贷款、期权、股票,等等。 通常,你会创建一个工厂类,它包含一个负责实现不同对象的方法,如下所示: private interface Product { } private static class ProductFactory { public static Product createProduct(String name) { switch (name) { case "loan": return new Loan(); case "stock": return new Stock(); case "bond": return new Bond(); default: throw new RuntimeException("No such product " + name); } } } static private class Loan implements Product { } static private class Stock implements Product { } static private class Bond implements Product { } 这里贷款( Loan )、股票( Stock )和债券( Bond )都是产品( Product )的子类。createProduct 方法可以通过附加的逻辑来设置每个创建的产品。但是带来的好处也显而易见,你在创建对象时不用再担心会将构造函数或者配置暴露给客户,这使得客户创建产品时更加简单: Product p1 = ProductFactory.createProduct("loan"); 使用Lambda表达式第3章中,我们已经知道可以像引用方法一样引用构造函数。比如,下面就是一个引用贷款( Loan )构造函数的示例: Supplier<Product> loanSupplier = Loan::new; Product p2 = loanSupplier.get(); 通过这种方式,你可以重构之前的代码,创建一个 Map ,将产品名映射到对应的构造函数: final static private Map<String, Supplier<Product>> map = new HashMap<>(); static { map.put("loan", Loan::new); map.put("stock", Stock::new); map.put("bond", Bond::new); } 现在,你可以像之前使用工厂设计模式那样,利用这个 Map 来实例化不同的产品。 public static Product createProductLambda(String name) { Supplier<Product> p = map.get(name); if (p != null) { return p.get(); } throw new RuntimeException("No such product " + name); } 这是个全新的尝试,它使用Java 8中的新特性达到了传统工厂模式同样的效果。但是,如果工厂方法 createProduct 需要接收多个传递给产品构造方法的参数,这种方式的扩展性不是很好。你不得不提供不同的函数接口,无法采用之前统一使用一个简单接口的方式。 比如,我们假设你希望保存具有三个参数(两个参数为 Integer 类型,一个参数为 String类型)的构造函数;为了完成这个任务,你需要创建一个特殊的函数接口 TriFunction 。最终的结果是 Map 变得更加复杂。 public interface TriFunction<T, U, V, R>{ R apply(T t, U u, V v); } Map<String, TriFunction<Integer, Integer, String, Product>> map = new HashMap<>(); 你已经了解了如何使用Lambda表达式编写和重构代码。接下来,我们会介绍如何确保新编写代码的正确性。 测试 Lambda 表达式 现在你的代码中已经充溢着Lambda表达式,看起来不错,也很简洁。但是,大多数时候,我们受雇进行的程序开发工作的要求并不是编写优美的代码,而是编写正确的代码。 通常而言,好的软件工程实践一定少不了单元测试,借此保证程序的行为与预期一致。你编写测试用例,通过这些测试用例确保你代码中的每个组成部分都实现预期的结果。比如,图形应用的一个简单的 Point 类,可以定义如下: public class Point { private final int x; private final int y; public Point(int x, int y) { this.x = x; this.y = y; } public int getX() { return x; } public int getY() { return y; } public Point moveRightBy(int x) { return new Point(this.x + x, this.y); } } 下面的单元测试会检查 moveRightBy 方法的行为是否与预期一致: public class PointTest { @Test public void testMoveRightBy() { Point p1 = new Point(5, 5); Point p2 = p1.moveRightBy(10); Assert.assertEquals(15, p2.getX()); Assert.assertEquals(5, p2.getY()); } } 测试可见 Lambda 函数的行为 由于 moveRightBy 方法声明为public,测试工作变得相对容易。你可以在用例内部完成测试。但是Lambda并无函数名(毕竟它们都是匿名函数),因此要对你代码中的Lambda函数进行测试实际上比较困难,因为你无法通过函数名的方式调用它们。 有些时候,你可以借助某个字段访问Lambda函数,这种情况,你可以利用这些字段,通过它们对封装在Lambda函数内的逻辑进行测试。比如,我们假设你在 Point 类中添加了静态字段compareByXAndThenY ,通过该字段,使用方法引用你可以访问 Comparator 对象: public class Point { public final static Comparator<Point> COMPARE_BY_X_AND_THEN_Y = comparing(Point::getX).thenComparing(Point::getY); ... } 还记得吗,Lambda表达式会生成函数接口的一个实例。由此,你可以测试该实例的行为。这个例子中,我们可以使用不同的参数,对 Comparator 对象类型实例 compareByXAndThenY的 compare 方法进行调用,验证它们的行为是否符合预期: @Test public void testComparingTwoPoints() { Point p1 = new Point(10, 15); Point p2 = new Point(10, 20); int result = Point.COMPARE_BY_X_AND_THEN_Y.compare(p1 , p2); Assert.assertEquals(-1, result); } 测试使用 Lambda 的方法的行为 但是Lambda的初衷是将一部分逻辑封装起来给另一个方法使用。从这个角度出发,你不应该将Lambda表达式声明为public,它们仅是具体的实现细节。相反,我们需要对使用Lambda表达式的方法进行测试。比如下面这个方法 moveAllPointsRightBy : public static List<Point> moveAllPointsRightBy(List<Point> points, int x) { return points.stream() .map(p -> new Point(p.getX() + x, p.getY())) .collect(toList()); } 我们没必要对Lambda表达式 p -> new Point(p.getX() + x,p.getY()) 进行测试,它只是 moveAllPointsRightBy 内部的实现细节。我们更应该关注的是方法 moveAllPointsRightBy 的行为: @Test public void testMoveAllPointsRightBy() { List<Point> points = Arrays.asList(new Point(5, 5), new Point(10, 5)); List<Point> expectedPoints = Arrays.asList(new Point(15, 5), new Point(20, 5)); List<Point> newPoints = Point.moveAllPointsRightBy(points, 10); Assert.assertEquals(expectedPoints, newPoints); } 注意,上面的单元测试中, Point 类恰当地实现 equals 方法非常重要,否则该测试的结果就取决于 Object 类的默认实现。 调试 调试有问题的代码时,程序员的兵器库里有两大老式武器,分别是: 查看栈跟踪 输出日志 查看栈跟踪 你的程序突然停止运行(比如突然抛出一个异常),这时你首先要调查程序在什么地方发生了异常以及为什么会发生该异常。这时栈帧就非常有用。程序的每次方法调用都会产生相应的调用信息,包括程序中方法调用的位置、该方法调用使用的参数、被调用方法的本地变量。这些信息被保存在栈帧上。 程序失败时,你会得到它的栈跟踪,通过一个又一个栈帧,你可以了解程序失败时的概略信息。换句话说,通过这些你能得到程序失败时的方法调用列表。这些方法调用列表最终会帮助你发现问题出现的原因。 Lambda表达式和栈跟踪不幸的是,由于Lambda表达式没有名字,它的栈跟踪可能很难分析。在下面这段简单的代码中,我们刻意地引入了一些错误: public class Debugging { public static void main(String[] args) { List<Point> points = Arrays.asList(new Point(12, 2), null); points.stream().map(p -> p.getX()).forEach(System.out::println); } } 运行这段代码会产生下面的栈跟踪: 12 Exception in thread "main" java.lang.NullPointerException // 这行中的 $0 是什么意思? at xin.codedream.java8.chap8.Debugging.lambda$main$0(Debugging.java:15) at java.util.stream.ReferencePipeline$3$1.accept(ReferencePipeline.java:193) at java.util.Spliterators$ArraySpliterator.forEachRemaining(Spliterators.java:948) ... 这个程序出现了NPE(空指针异常)异常,因为 Points 列表的第二个元素是空( null )。 这时你的程序实际是在试图处理一个空引用。由于Stream流水线发生了错误,构成Stream流水线的整个方法调用序列都暴露在你面前了。不过,你留意到了吗?栈跟踪中还包含下面这样类似加密的内容: at xin.codedream.java8.chap8.Debugging.lambda$main$0(Debugging.java:15) at java.util.stream.ReferencePipeline$3$1.accept(ReferencePipeline.java:193) 这些表示错误发生在Lambda表达式内部。由于Lambda表达式没有名字,所以编译器只能为它们指定一个名字。这个例子中,它的名字是 lambda$main$0 ,看起来非常不直观。如果你使用了大量的类,其中又包含多个Lambda表达式,这就成了一个非常头痛的问题。 即使你使用了方法引用,还是有可能出现栈无法显示你使用的方法名的情况。将之前的Lambda表达式 p-> p.getX() 替换为方法引用 reference Point::getX 也会产生难于分析的栈跟踪: at java.util.stream.ReferencePipeline$3$1.accept(ReferencePipeline.java:193) 注意,如果方法引用指向的是同一个类中声明的方法,那么它的名称是可以在栈跟踪中显示的。比如,下面这个例子: public class Debugging { public static void main(String[] args) { List<Integer> numbers = Arrays.asList(1, 2, 3); numbers.stream().map(Debugging::divideByZero).forEach(System .out::println); } public static int divideByZero(int n) { return n / 0; } } 方法 divideByZero 在栈跟踪中就正确地显示了: Exception in thread "main" java.lang.ArithmeticException: / by zero // divideByZero正确地输出到栈跟踪中 at xin.codedream.java8.chap8.Debugging.divideByZero(Debugging.java:20) at java.util.stream.ReferencePipeline$3$1.accept(ReferencePipeline.java:193) ... 总的来说,我们需要特别注意,涉及Lambda表达式的栈跟踪可能非常难理解。这是Java编译器未来版本可以改进的一个方面。 使用日志调试 假设你试图对流操作中的流水线进行调试,该从何入手呢?你可以像下面的例子那样,使用forEach 将流操作的结果日志输出到屏幕上或者记录到日志文件中: List<Integer> numbers = Arrays.asList(2, 3, 4, 5); numbers.stream() .map(x -> x + 17) .filter(x -> x % 2 == 0) .limit(3) .forEach(System.out::println); 这段代码的输出如下: 20 22 不幸的是,一旦调用 forEach ,整个流就会恢复运行。到底哪种方式能更有效地帮助我们理解Stream流水线中的每个操作(比如 map 、 filter 、 limit )产生的输出? 这就是流操作方法 peek 大显身手的时候。 peek 的设计初衷就是在流的每个元素恢复运行之前,插入执行一个动作。但是它不像 forEach 那样恢复整个流的运行,而是在一个元素上完操作之后,它只会将操作顺承到流水线中的下一个操作。下面的这段代码中,我们使用 peek 输出了Stream流水线操作之前和操作之后的中间值: List<Integer> result = Stream.of(2, 3, 4, 5) .peek(x -> System.out.println("taking from stream: " + x)).map(x -> x + 17) .peek(x -> System.out.println("after map: " + x)).filter(x -> x % 2 == 0) .peek(x -> System.out.println("after filter: " + x)).limit(3) .peek(x -> System.out.println("after limit: " + x)).collect(toList()); 通过 peek 操作我们能清楚地了解流水线操作中每一步的输出结果: taking from stream: 2 after map: 19 taking from stream: 3 after map: 20 after filter: 20 after limit: 20 taking from stream: 4 after map: 21 taking from stream: 5 after map: 22 after filter: 22 after limit: 22 小结 Lambda表达式能提升代码的可读性和灵活性。 如果你的代码中使用了匿名类,尽量用Lambda表达式替换它们,但是要注意二者间语义的微妙差别,比如关键字 this ,以及变量隐藏。 跟Lambda表达式比起来,方法引用的可读性更好 。 尽量使用Stream API替换迭代式的集合处理。 Lambda表达式有助于避免使用面向对象设计模式时容易出现的僵化的模板代码,典型的比如策略模式、模板方法、观察者模式、责任链模式,以及工厂模式。 即使采用了Lambda表达式,也同样可以进行单元测试,但是通常你应该关注使用了Lambda表达式的方法的行为。 尽量将复杂的Lambda表达式抽象到普通方法中。 Lambda表达式会让栈跟踪的分析变得更为复杂。 流提供的 peek 方法在分析Stream流水线时,能将中间变量的值输出到日志中,是非常有用的工具。 代码 Github:chap8 Gitee:chap8

优秀的个人博客,低调大师

《Java8实战》-第十一章笔记(CompletableFuture:组合式异步编程)

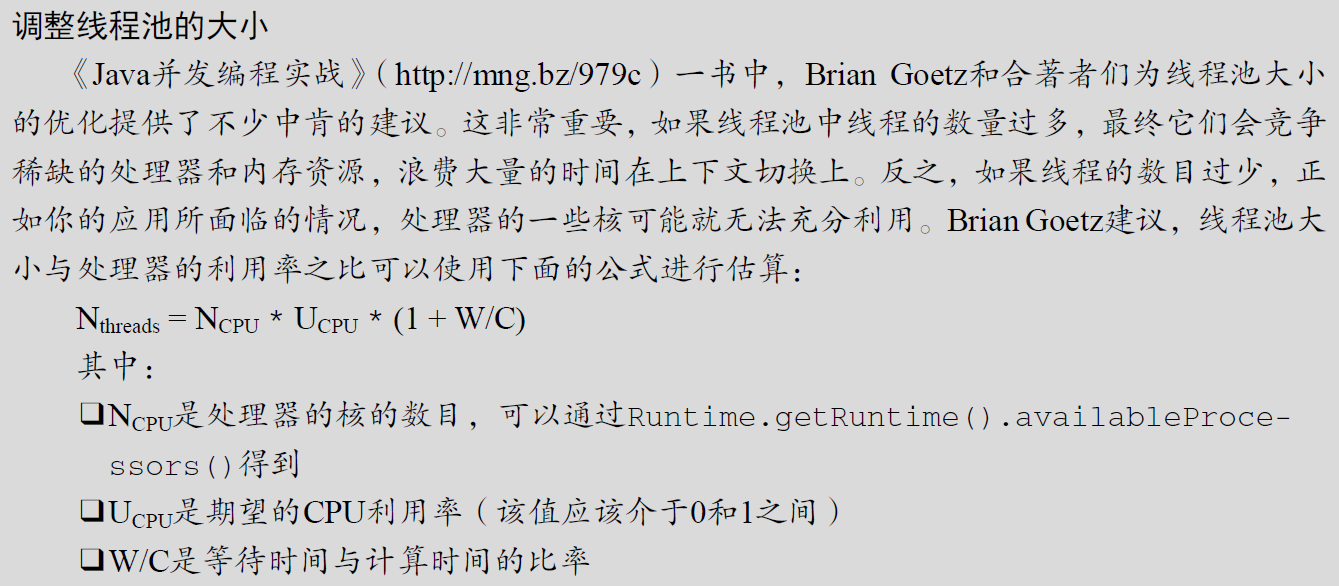
CompletableFuture:组合式异步编程 最近这些年,两种趋势不断地推动我们反思我们设计软件的方式。第一种趋势和应用运行的硬件平台相关,第二种趋势与应用程序的架构相关,尤其是它们之间如何交互。我们在第7章中已经讨论过硬件平台的影响。我们注意到随着多核处理器的出现,提升应用程序处理速度最有效的方式是编写能充分发挥多核能力的软件。你已经看到通过切分大型的任务,让每个子任务并行运行,这一目标是能够实现的;你也已经了解相对直接使用线程的方式,使用分支/合并框架(在Java 7中引入)和并行流(在Java 8中新引入)能以更简单、更有效的方式实现这一目标。 第二种趋势反映在公共API日益增长的互联网服务应用。著名的互联网大鳄们纷纷提供了自己的公共API服务,比如谷歌提供了地理信息服务,Facebook提供了社交信息服务,Twitter提供了新闻服务。现在,很少有网站或者网络应用会以完全隔离的方式工作。更多的时候,我们看到的下一代网络应用都采用“混聚”(mash-up)的方式:它会使用来自多个来源的内容,将这些内容聚合在一起,方便用户的生活。 比如,你可能希望为你的法国客户提供指定主题的热点报道。为实现这一功能,你需要向谷歌或者Twitter的API请求所有语言中针对该主题最热门的评论,可能还需要依据你的内部算法对它们的相关性进行排序。之后,你可能还需要使用谷歌的翻译服务把它们翻译成法语,甚至利用谷歌地图服务定位出评论作者的位置信息,最终将所有这些信息聚集起来,呈现在你的网站上。 当然,如果某些外部网络服务发生响应慢的情况,你希望依旧能为用户提供部分信息,比如提供带问号标记的通用地图,以文本的方式显示信息,而不是呆呆地显示一片空白屏幕,直到地图服务器返回结果或者超时退出。 要实现类似的服务,你需要与互联网上的多个Web服务通信。可是,你并不希望因为等待某些服务的响应,阻塞应用程序的运行,浪费数十亿宝贵的CPU时钟周期。比如,不要因为等待Facebook的数据,暂停对来自Twitter的数据处理。 这些场景体现了多任务程序设计的另一面。第7章中介绍的分支/合并框架以及并行流是实现并行处理的宝贵工具;它们将一个操作切分为多个子操作,在多个不同的核、CPU甚至是机器上并行地执行这些子操作。 与此相反,如果你的意图是实现并发,而非并行,或者你的主要目标是在同一个CPU上执行几个松耦合的任务,充分利用CPU的核,让其足够忙碌,从而最大化程序的吞吐量,那么你其实真正想做的是避免因为等待远程服务的返回,或者对数据库的查询,而阻塞线程的执行,浪费宝贵的计算资源,因为这种等待的时间很可能相当长。通过本章中你会了解,Future接口,尤其是它的新版实现CompletableFuture,是处理这种情况的利器。 Future 接口 Future接口在Java 5中被引入,设计初衷是对将来某个时刻会发生的结果进行建模。它建模了一种异步计算,返回一个执行运算结果的引用,当运算结束后,这个引用被返回给调用方。在Future中触发那些潜在耗时的操作把调用线程解放出来,让它能继续执行其他有价值的工作,不再需要呆呆等待耗时的操作完成。打个比方,你可以把它想象成这样的场景:你拿了一袋子衣服到你中意的干洗店去洗。干洗店的员工会给你张发票,告诉你什么时候你的衣服会洗好(这就是一个Future事件)。衣服干洗的同时,你可以去做其他的事情。Future的另一个优点是它比更底层的Thread更易用。要使用Future,通常你只需要将耗时的操作封装在一个Callable对象中,再将它提交给ExecutorService,就万事大吉了。下面这段代码展示了Java 8之前使用Future的一个例子。 ExecutorService executor = Executors.newCachedThreadPool(); Future<Double> future = executor.submit(new Callable<Double>() { public Double call() { return doSomeLongComputation(); } }); // 异步操作进行的同时,你可以做其他的事情 doSomethingElse(); try { Double result = future.get(1, TimeUnit.SECONDS); } catch (ExecutionException ee) { // 计算抛出一个异常 } catch (InterruptedException ie) { // 当前线程在等待过程中被中断 } catch (TimeoutException te) { // 在Future对象完成之前超过已过期 } 这种编程方式让你的线程可以在ExecutorService以并发方式调用另一个线程执行耗时操作的同时,去执行一些其他的任务。接着,如果你已经运行到没有异步操作的结果就无法继续任何有意义的工作时,可以调用它的get方法去获取操作的结果。如果操作已经完成,该方法会立刻返回操作的结果,否则它会阻塞你的线程,直到操作完成,返回相应的结果。 你能想象这种场景存在怎样的问题吗?如果该长时间运行的操作永远不返回了会怎样?为了处理这种可能性,虽然Future提供了一个无需任何参数的get方法,我们还是推荐大家使用重载版本的get方法,它接受一个超时的参数,通过它,你可以定义你的线程等待Future结果的最长时间,而不是样永无止境地等待下去。 Future 接口的局限性 通过第一个例子,我们知道Future接口提供了方法来检测异步计算是否已经结束(使用isDone方法),等待异步操作结束,以及获取计算的结果。但是这些特性还不足以让你编写简洁的并发代码。比如,我们很难表述Future结果之间的依赖性;从文字描述上这很简单,“当长时间计算任务完成时,请将该计算的结果通知到另一个长时间运行的计算任务,这两个计算任务都完成后,将计算的结果与另一个查询操作结果合并”。但是,使用Future中提供的方法完成这样的操作又是另外一回事。这也是我们需要更具描述能力的特性的原因,比如下面这些。 将两个异步计算合并为一个——这两个异步计算之间相互独立,同时第二个又依赖于第一个的结果。 等待Future集合中的所有任务都完成。 仅等待Future集合中最快结束的任务完成(有可能因为它们试图通过不同的方式计算同一个值),并返回它的结果。 通过编程方式完成一个Future任务的执行(即以手工设定异步操作结果的方式)。 应对Future的完成事件(即当Future的完成事件发生时会收到通知,并能使用Future计算的结果进行下一步的操作,不只是简单地阻塞等待操作的结果)。 这一章中,你会了解新的CompletableFuture类(它实现了Future接口)如何利用Java 8的新特性以更直观的方式将上述需求都变为可能。Stream和CompletableFuture的设计都遵循了类似的模式:它们都使用了Lambda表达式以及流水线的思想。从这个角度,你可以说CompletableFuture和Future的关系就跟Stream和Collection的关系一样。 使用CompletableFuture 构建异步应用 为了展示CompletableFuture的强大特性,我们会创建一个名为“最佳价格查询器”(best-price-finder)的应用,它会查询多个在线商店,依据给定的产品或服务找出最低的价格。这个过程中,你会学到几个重要的技能。 首先,你会学到如何为你的客户提供异步API(如果你拥有一间在线商店的话,这是非常有帮助的)。 其次,你会掌握如何让你使用了同步API的代码变为非阻塞代码。你会了解如何使用流水线将两个接续的异步操作合并为一个异步计算操作。这种情况肯定会出现,比如,在线商店返回了你想要购买商品的原始价格,并附带着一个折扣代码——最终,要计算出该商品的实际价格,你不得不访问第二个远程折扣服务,查询该折扣代码对应的折扣比率。 你还会学到如何以响应式的方式处理异步操作的完成事件,以及随着各个商店返回它的商品价格,最佳价格查询器如何持续地更新每种商品的最佳推荐,而不是等待所有的商店都返回他们各自的价格(这种方式存在着一定的风险,一旦某家商店的服务中断,用户可能遭遇白屏)。 实现异步API 为了实现最佳价格查询器应用,让我们从每个商店都应该提供的API定义入手。首先,商店应该声明依据指定产品名称返回价格的方法: public double getPrice(String product) { // 待实现 } 该方法的内部实现会查询商店的数据库,但也有可能执行一些其他耗时的任务,比如联系其他外部服务(比如,商店的供应商,或者跟制造商相关的推广折扣)。我们在本章剩下的内容中,采用delay方法模拟这些长期运行的方法的执行,它会人为地引入1秒钟的延迟,方法声明如下。 public class Util { public static void delay() { int delay = 1000; try { Thread.sleep(delay); } catch (InterruptedException e) { throw new RuntimeException(e); } } } 为了介绍本章的内容,getPrice方法会调用delay方法,并返回一个随机计算的值,代码清单如下所示。返回随机计算的价格这段代码看起来有些取巧。它使用charAt,依据产品的名称,生成一个随机值作为价格。 public class Shop { private final String name; private final Random random; public Shop(String name) { this.name = name; random = new Random(name.charAt(0) * name.charAt(1) * name.charAt(2)); } public double getPrice(String product) { return calculatePrice(product); } private double calculatePrice(String product) { delay(); return random.nextDouble() * product.charAt(0) + product.charAt(1); } } 很明显,这个API的使用者(这个例子中为最佳价格查询器)调用该方法时,它依旧会被阻塞。为等待同步事件完成而等待1秒钟,这是无法接受的,尤其是考虑到最佳价格查询器对网络中的所有商店都要重复这种操作。本章接下来的小节中,你会了解如何以异步方式使用同步API解决这个问题。但是,出于学习如何设计异步API的考虑,我们会继续这一节的内容,假装我们还在深受这一困难的烦扰:你是一个睿智的商店店主,你已经意识到了这种同步API会为你的用户带来多么痛苦的体验,你希望以异步API的方式重写这段代码,让用户更流畅地访问你的网站。 将同步方法转换为异步方法 为了实现这个目标,你首先需要将getPrice转换为getPriceAsync方法,并修改它的返回值: public class Shop { ... public Future<Double> getPriceAsync(String product) { CompletableFuture<Double> futurePrice = new CompletableFuture<>(); new Thread(() -> { double price = calculatePrice(product); futurePrice.complete(price); }).start(); return futurePrice; } ... } 在这段代码中,你创建了一个代表异步计算的CompletableFuture对象实例,它在计算完成时会包含计算的结果。接着,你调用fork创建了另一个线程去执行实际的价格计算工作,不等该耗时计算任务结束,直接返回一个Future实例。当请求的产品价格最终计算得出时,你可以使用它的complete方法,结束completableFuture对象的运行,并设置变量的值。很显然,这个新版Future的名称也解释了它所具有的特性。使用这个API的客户端,可以通过下面的这段代码对其进行调用。 public class ShopMain { public static void main(String[] args) { Shop shop = new Shop("最好的商店"); long start = System.nanoTime(); Future<Double> futurePrice = shop.getPriceAsync("我最喜欢的商品"); long invocationTime = ((System.nanoTime() - start) / 1_000_000); System.out.println("调用时间 " + invocationTime); // 这里可以做其他的事情,比如查询其他的商店 doSomethingElse(); // 计算商品价格 try { double price = futurePrice.get(); System.out.printf("价格是 %.2f%n", price); } catch (ExecutionException | InterruptedException e) { throw new RuntimeException(e); } long retrievalTime = ((System.nanoTime() - start) / 1_000_000); System.out.println("计算价格时间 " + retrievalTime); } private static void doSomethingElse() { System.out.println("正在查询其他的商店..."); } } 我们看到这段代码中,客户向商店查询了某种商品的价格。由于商店提供了异步API,该次调用立刻返回了一个Future对象,通过该对象客户可以在将来的某个时刻取得商品的价格。这种方式下,客户在进行商品价格查询的同时,还能执行一些其他的任务,比如查询其他家商店中商品的价格,不会呆呆地阻塞在那里等待第一家商店返回请求的结果。最后,如果所有有意义的工作都已经完成,客户所有要执行的工作都依赖于商品价格时,再调用Future的get方法。执行了这个操作后,客户要么获得Future中封装的值(如果异步任务已经完成),要么发生阻塞,直到该异步任务完成,期望的值能够访问。上面的代码中,输出的结果: 调用时间 116 正在查询其他的商店... 价格是 49107.07 计算价格时间 1172 你一定已经发现getPriceAsync方法的调用时间远远早于最终价格计算完成的时间,在之前的代码,你还会知道我们有可能避免发生客户端被阻塞的风险。实际上这非常简单,Future执行完毕可以发送一个通知,仅在计算结果可用时执行一个由Lambda表达式或者方法引用定义的回调函数。不过,我们当下不会对此进行讨论,现在我们要解决的是另一个问题:如何正确地管理异步任务执行过程中可能出现的错误。 错误处理 如果没有意外,我们目前开发的代码工作得很正常。但是,如果价格计算过程中产生了错误会怎样呢?非常不幸,这种情况下你会得到一个相当糟糕的结果:用于提示错误的异常会被限制在试图计算商品价格的当前线程的范围内,最终会杀死该线程,而这会导致等待get方法返回结果的客户端永久地被阻塞。 客户端可以使用重载版本的get方法,它使用一个超时参数来避免发生这样的情况。这是一种值得推荐的做法,你应该尽量在你的代码中添加超时判断的逻辑,避免发生类似的问题。使用这种方法至少能防止程序永久地等待下去,超时发生时,程序会得到通知发生了TimeoutException。不过,也因为如此,你不会有机会发现计算商品价格的线程内到底发生了什么问题才引发了这样的失效。为了让客户端能了解商店无法提供请求商品价格的原因,你需要使用CompletableFuture的completeExceptionally方法将导致CompletableFuture内发生问题的异常抛出。对代码优化后的结果如下所示。 public Future<Double> getPriceAsync(String product) { CompletableFuture<Double> futurePrice = new CompletableFuture<>(); new Thread(() -> { try { double price = calculatePrice(product); // 如果价格计算正常结束,完成Future操作并设置商品价格 futurePrice.complete(price); } catch (Exception e) { // 否则就抛出导致失败的异常,完成这次Future操作 futurePrice.completeExceptionally(e); } }).start(); return futurePrice; } 客户端现在会收到一个ExecutionException异常,该异常接收了一个包含失败原因的Exception参数,即价格计算方法最初抛出的异常。所以,举例来说,如果该方法抛出了一个运行时异常“product not available”,客户端就会得到像下面这样一段ExecutionException: java.util.concurrent.ExecutionException: java.lang.RuntimeException: product not availableat java.util.concurrent.CompletableFuture.get(CompletableFuture.java:2237) at xin.codedream.java8.chap11.AsyncShopClient.main(AsyncShopClient.java:14) ... 5 more Caused by: java.lang.RuntimeException: product not available at xin.codedream.java8.chap11.AsyncShop.calculatePrice(AsyncShop.java:36) atxin.codedream.java8.chap11.AsyncShop.lambda$getPrice$0(AsyncShop.java:23) at xin.codedream.java8.chap11.AsyncShop$$Lambda$1/24071475.run(Unknown Source) at java.lang.Thread.run(Thread.java:744) 使用工厂方法supplyAsync创建CompletableFuture目前为止我们已经了解了如何通过编程创建CompletableFuture对象以及如何获取返回值,虽然看起来这些操作已经比较方便,但还有进一步提升的空间,CompletableFuture类自身提供了大量精巧的工厂方法,使用这些方法能更容易地完成整个流程,还不用担心实现的细节。比如,采用supplyAsync方法后,你可以用一行语句重写getPriceAsync方法,如下所示。 public Future<Double> getPriceAsync(String product) { return CompletableFuture.supplyAsync(() -> calculatePrice(product)); } 太棒了!七八行才能实现的功能,我们现在只需要一行就可以搞定了!supplyAsync方法接受一个生产者(Supplier)作为参数,返回一个CompletableFuture对象,该对象完成异步执行后会读取调用生产者方法的返回值。生产者方法会交由ForkJoinPool池中的某个执行线程(Executor)运行,但是你也可以使用supplyAsync方法的重载版本,传递第二个参数指定不同的执行线程执行生产者方法。一般而言,向CompletableFuture的工厂方法传递可选参数,指定生产者方法的执行线程是可行的,在后面,你会使用这一能力,后面我们将使用适合你应用特性的执行线程改善程序的性能。 接下来剩余部分中,我们会假设你非常不幸,无法控制Shop类提供API的具体实现,最终提供给你的API都是同步阻塞式的方法。这也是当你试图使用服务提供的HTTP API时最常发生的情况。你会学到如何以异步的方式查询多个商店,避免被单一的请求所阻塞,并由此提升你的“最佳价格查询器”的性能和吞吐量。 让你的代码免受阻塞之苦 所以,你已经被要求进行“最佳价格查询器”应用的开发了,不过你需要查询的所有商店都如上面开始时介绍的那样,只提供了同步API。换句话说,你有一个商家的列表,如下所示: public class BestPriceFinder { private final List<Shop> shops = Arrays.asList(new Shop("BestPrice"), new Shop("LetsSaveBig"), new Shop("MyFavoriteShop"), new Shop("BuyItAll")); ... } 你需要使用下面这样的签名实现一个方法,它接受产品名作为参数,返回一个字符串列表,这个字符串列表中包括商店的名称、该商店中指定商品的价格: public List<String> findPrices(String product); 你的第一个想法可能是使用我们在前面的章节中学习的Stream特性。你可能试图写出类似下面这个代码(是的,作为第一个方案,如果你想到这些已经相当棒了!)。 好吧,这段代码看起来非常直白。现在试着用该方法去查询你最近这些天疯狂着迷的唯一产品(是的,你已经猜到了,它就是Old-Mi-Mix3)。此外,也请记录下方法的执行时间,通过这些数据,我们可以比较优化之后的方法会带来多大的性能提升,具体的代码如下。 public class BestPriceFinder { private final List<Shop> shops = Arrays.asList(new Shop("BestPrice"), new Shop("LetsSaveBig"), new Shop("MyFavoriteShop"), new Shop("BuyItAll")); public static void main(String[] args) { BestPriceFinder finder = new BestPriceFinder(); finder.testFindPrices(); } public void testFindPrices() { long start = System.nanoTime(); System.out.println(findPrices("Old-Mi-Mix3")); long duration = (System.nanoTime() - start) / 1_000_000; System.out.println("完成时间 " + duration); } public List<String> findPrices(String product) { return shops.stream() .map(shop -> String.format("%s 价格 %.2f", shop.getName(), shop.getPrice(product))) .collect(toList()); } } 输出结果: [BestPrice 价格 109.64, LetsSaveBig 价格 143.13, MyFavoriteShop 价格 175.50, BuyItAll 价格 154.20] 完成时间 4184 正如你预期的,findPrices方法的执行时间仅比4秒钟多了那么几百毫秒,因为对这4个商店的查询是顺序进行的,并且一个查询操作会阻塞另一个,每一个操作都要花费大约1秒左右的时间计算请求商品的价格。你怎样才能改进这个结果呢? 使用并行流对请求进行并行操作 如果你看了第七章的笔记,那么你应该想到的第一个,可能也是最快的改善方法是使用并行流来避免顺序计算,如下所示。 public List<String> findPricesParallel(String product) { return shops.parallelStream() .map(shop -> String.format("%s 价格 %.2f", shop.getName(), shop.getPrice(product))) .collect(toList()); } 运行代码,与最初的代码执行结果相比较,你发现了新版findPrices的改进了吧。 [BestPrice 价格 109.64, LetsSaveBig 价格 143.13, MyFavoriteShop 价格 175.50, BuyItAll 价格 154.20] 完成时间 1248 相当不错啊!看起来这是个简单但有效的主意:现在对四个不同商店的查询实现了并行,所以完成所有操作的总耗时只有1秒多一点儿。你能做得更好吗?让我们尝试使用刚学过的CompletableFuture,将findPrices方法中对不同商店的同步调用替换为异步调用。 使用CompletableFuture 发起异步请求 你已经知道我们可以使用工厂方法supplyAsync创建CompletableFuture对象。让我们把它利用起来: public List<CompletableFuture<String>> findPricesFuture(String product) { return shops.stream() .map(shop -> CompletableFuture.supplyAsync(() -> String.format("%s 价格 %.2f", shop.getName(), shop.getPrice(product)))) .collect(toList()); } 使用这种方式,你会得到一个List>,列表中的每个CompletableFuture对象在计算完成后都包含商店的String类型的名称。但是,由于你用CompletableFutures实现的findPrices方法要求返回一个List,你需要等待所有的future执行完毕,将其包含的值抽取出来,填充到列表中才能返回。 为了实现这个效果,你可以向最初的List>施加第二个map操作,对List中的所有future对象执行join操作,一个接一个地等待它们运行结束。注意CompletableFuture类中的join方法和Future接口中的get有相同的含义,并且也声明在Future接口中,它们唯一的不同是join不会抛出任何检测到的异常。使用它你不再需要使用try/catch语句块让你传递给第二个map方法的Lambda表达式变得过于臃肿。所有这些整合在一起,你就可以重新实现findPrices了,具体代码如下。 public List<String> findPrices(String product) { List<CompletableFuture<String>> priceFutures = shops.stream() .map(shop -> CompletableFuture.supplyAsync(() -> String.format("%s 价格 %.2f", shop.getName(), shop.getPrice(product)))) .collect(toList()); return priceFutures.stream() .map(CompletableFuture::join) .collect(Collectors.toList()); } 运行下代码了解下第三个版本findPrices方法的性能,你会得到下面这几行输出: [BestPrice 价格 109.64, LetsSaveBig 价格 143.13, MyFavoriteShop 价格 175.50, BuyItAll 价格 154.20] 完成时间 2207 这个结果让人相当失望,不是吗?超过2秒意味着利用CompletableFuture实现的版本,比刚开始的代码中的原生顺序执行且会发生阻塞的版本快。但是它的用时也差不多是使用并行流的前一个版本的两倍。尤其是,考虑到从顺序执行的版本转换到并行流的版本只做了非常小的改动,就让人更加沮丧。 与此形成鲜明对比的是,我们为采用CompletableFutures完成的新版方法做了大量的工作!但,这就是全部的真相吗?这种场景下使用CompletableFutures真的是浪费时间吗?或者我们可能漏掉了某些重要的东西?继续往下探究之前,让我们休息几分钟,尤其是想想你测试代码的机器是否足以以并行方式运行四个线程。 寻找更好的方案 并行流的版本工作得非常好,那是因为它能并行地执行四个任务,所以它几乎能为每个商家分配一个线程。但是,如果你想要增加第五个商家到商店列表中,让你的“最佳价格查询”应用对其进行处理,这时会发生什么情况? public class BestPriceFinder { private final List<Shop> shops = Arrays.asList(new Shop("BestPrice"), new Shop("LetsSaveBig"), new Shop("MyFavoriteShop"), new Shop("BuyItAll"), new Shop("ShopEasy")); ... public List<String> findPricesParallel(String product) { return shops.parallelStream() .map(shop -> String.format("%s 价格 %.2f", shop.getName(), shop.getPrice(product))) .collect(toList()); } public List<String> findPricesSequential(String product) { return shops.stream() .map(shop -> String.format("%s 价格 %.2f", shop.getName(), shop.getPrice(product))) .collect(toList()); } public List<String> findPricesFuture(String product) { List<CompletableFuture<String>> priceFutures = shops.stream() .map(shop -> CompletableFuture.supplyAsync(() -> String.format("%s 价格 %.2f", shop.getName(), shop.getPrice(product)))) .collect(toList()); return priceFutures.stream() .map(CompletableFuture::join) .collect(Collectors.toList()); } } public class BestPriceFinderMain { private static BestPriceFinder bestPriceFinder = new BestPriceFinder(); public static void main(String[] args) { execute("sequential", () -> bestPriceFinder.findPricesSequential("Old-Mi-Mix3")); } private static void execute(String msg, Supplier<List<String>> s) { long start = System.nanoTime(); System.out.println(s.get()); long duration = (System.nanoTime() - start) / 1_000_000; System.out.println(msg + " 完成时间 " + duration); } } 毫不意外,顺序执行版本的执行还是需要大约5秒多钟的时间,下面是执行的输出: [BestPrice 价格 109.64, LetsSaveBig 价格 143.13, MyFavoriteShop 价格 175.50, BuyItAll 价格 154.20, ShopEasy 价格 147.92] sequential 完成时间 5139 非常不幸,并行流版本的程序这次比之前也多消耗了差不多1秒钟的时间,因为可以并行运行(通用线程池中处于可用状态的)的四个线程现在都处于繁忙状态,都在对前4个商店进行查询。第五个查询只能等到前面某一个操作完成释放出空闲线程才能继续,它的运行结果如下: [BestPrice 价格 163.19, LetsSaveBig 价格 141.77, MyFavoriteShop 价格 159.81, BuyItAll 价格 165.02, ShopEasy 价格 165.81] parallel 完成时间 2106 CompletableFuture版本的程序结果如何呢?我们也试着添加第5个商店对其进行了测试,结果如下: [BestPrice 价格 144.31, LetsSaveBig 价格 142.49, MyFavoriteShop 价格 146.99, BuyItAll 价格 132.52, ShopEasy 价格 139.15] composed CompletableFuture 完成时间 2004 CompletableFuture版本的程序似乎比并行流版本的程序还快那么一点儿。但是最后这个版本也不太令人满意。比如,如果你试图让你的代码处理9个商店,并行流版本耗时3143毫秒,而CompletableFuture版本耗时3009毫秒。它们看起来不相伯仲,究其原因都一样:它们内部采用的是同样的通用线程池,默认都使用固定数目的线程,具体线程数取决于Runtime.getRuntime().availableProcessors()的返回值。然而,CompletableFuture具有一定的优势,因为它允许你对执行器(Executor)进行配置,尤其是线程池的大小,让它以更适合应用需求的方式进行配置,满足程序的要求,而这是并行流API无法提供的。让我们看看你怎样利用这种配置上的灵活性带来实际应用程序性能上的提升。 使用定制的执行器 就这个主题而言,明智的选择似乎是创建一个配有线程池的执行器,线程池中线程的数目取决于你预计你的应用需要处理的负荷,但是你该如何选择合适的线程数目呢? 你的应用99%的时间都在等待商店的响应,所以估算出的W/C比率为100。这意味着如果你期望的CPU利用率是100%,你需要创建一个拥有400个线程的线程池。实际操作中,如果你创建的线程数比商店的数目更多,反而是一种浪费,因为这样做之后,你线程池中的有些线程根本没有机会被使用。出于这种考虑,我们建议你将执行器使用的线程数,与你需要查询的商店数目设定为同一个值,这样每个商店都应该对应一个服务线程。不过,为了避免发生由于商店的数目过多导致服务器超负荷而崩溃,你还是需要设置一个上限,比如100个线程。代码清单如下所示。 private final Executor executor = Executors.newFixedThreadPool(100, new ThreadFactory() { @Override public Thread newThread(Runnable r) { Thread t = new Thread(r); t.setDaemon(true); return t; } }); 注意,你现在正创建的是一个由守护线程构成的线程池。Java程序无法终止或者退出一个正在运行中的线程,所以最后剩下的那个线程会由于一直等待无法发生的事件而引发问题。与此相反,如果将线程标记为守护进程,意味着程序退出时它也会被回收。这二者之间没有性能上的差异。现在,你可以将执行器作为第二个参数传递给supplyAsync工厂方法了。比如,你现在可以按照下面的方式创建一个可查询指定商品价格的CompletableFuture对象: CompletableFuture.supplyAsync(() -> String.format("%s 价格 %.2f", shop.getName(), shop.getPrice(product)), executor) 改进之后,使用CompletableFuture方案的程序处理5个商店结果: [BestPrice 价格 144.31, LetsSaveBig 价格 142.49, MyFavoriteShop 价格 146.99, BuyItAll 价格 132.52, ShopEasy 价格 139.15] composed CompletableFuture 完成时间 1004 这个例子证明了要创建更适合你的应用特性的执行器,利用CompletableFutures向其提交任务执行是个不错的主意。处理需大量使用异步操作的情况时,这几乎是最有效的策略。 并行——使用流还是CompletableFutures? 目前为止,你已经知道对集合进行并行计算有两种方式:要么将其转化为并行流,利用map这样的操作开展工作,要么枚举出集合中的每一个元素,创建新的线程,在CompletableFuture内对其进行操作。后者提供了更多的灵活性,你可以调整线程池的大小,而这能帮助你确保整体的计算不会因为线程都在等待I/O而发生阻塞。书中使用这些API的建议如下。 如果你进行的是计算密集型的操作,并且没有I/O,那么推荐使用Stream接口,因为实现简单,同时效率也可能是最高的(如果所有的线程都是计算密集型的,那就没有必要创建比处理器核数更多的线程)。 反之,如果你并行的工作单元还涉及等待I/O的操作(包括网络连接等待),那么使用CompletableFuture灵活性更好,你可以像前文讨论的那样,依据等待/计算,或者W/C的比率设定需要使用的线程数。这种情况不使用并行流的另一个原因是,处理流的流水线中如果发生I/O等待,流的延迟特性会让我们很难判断到底什么时候触发了等待。 现在你已经了解了如何利用CompletableFuture为你的用户提供异步API,以及如何将一个同步又缓慢的服务转换为异步的服务。不过到目前为止,我们每个Future中进行的都是单次的操作。 代码 Github: chap11 Gitee: chap11

优秀的个人博客,低调大师

如何在Android N 预览版中使用Java8的新特性

Android团队发布的Android N Preview中给我们带来了很多提升,包括由Jack编译器提供的Java 8支持。在这篇文章中,我们将来看看它究竟对Android开发者意味着什么,以及如何尝试新的语言特性。 概览 在这篇文章中,去介绍Oracle Java 8的新特性并没有太大意义 —— 很多信息已经在互联网上有了。 另一方面,Android 官方的Java 8公告留下了很多开放的问题给开发者们,感觉上并非所有的原生 Java 8 功能都是可用的。更详细的 技术公告确认了这一点。我们可以根据在 Android N 中的可用性,将这些语言特性分类如下: Android Gingebread (API 9)及以上: Lambda 表达式 java.util.function Android N及以上: 默认和静态interface方法 可重复的注解 流(Streams) 反射APIs 所以对Java 8特性和使用的minSdkVersion之间的关联性,开发者必须去精心选择。我们也必须注意到语言向后兼容是由Jack编译器提供的。在概念上,Jack编译器将javac,ProGuard,以及dex的功能合并 到了一个转换步骤中。这意味着其中没有中间的Java字节码可用,且像是JaCoCo和Mockito的工具将无法工作,DexGuard也一样 (ProGuard的企业版本)。让我们祈祷这只是一个早期的preview版本,且这些问题将在未来被修复。 Lambda表达式以及相关的函数功能APIs —— 这是一个每个Android开发都会喜欢的东西。这类功能将会对增加代码可读性极为有用 —— 它替代了提供事件监听器的匿名内部类。而之前只能通过额外的工具来实现,或者由Android Studio编辑器去折叠代码。 默认及静态interface方法可以帮助我们减少额外的工具类的数量,但显然不是最需要的特性。还有一些其他的新增功能,我希望去说的更详细一些,因此不在本文的范围内。 对我来说最有趣的事 —— Java 8 流(Streams) —— 在当前的预览版中不可用。我们可以发现事实上它刚被merge到AOSP源码,所以期望可以在下个N Preview 或者 Beta release中见到它。如果你实在等不及去浏览 —— 可以试试使用 Lightweight-Stream-API,目前的一个开源向后兼容。 总结 在这篇文章中,我们了解了Java 8的用例,以及目前其在Android N Preview SDK的实现情况。我们也看到了当前Jack编译器的限制,及其在最后发布前可能被修复的功能。 原文发布时间为:2017-10-25 本文作者:佚名 本文来自云栖社区合作伙伴“51CTO”,了解相关信息可以关注。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册