首页 文章 精选 留言 我的

精选列表

搜索[java8],共826篇文章
优秀的个人博客,低调大师

《Java8实战》-第七章笔记(并行数据处理与性能)

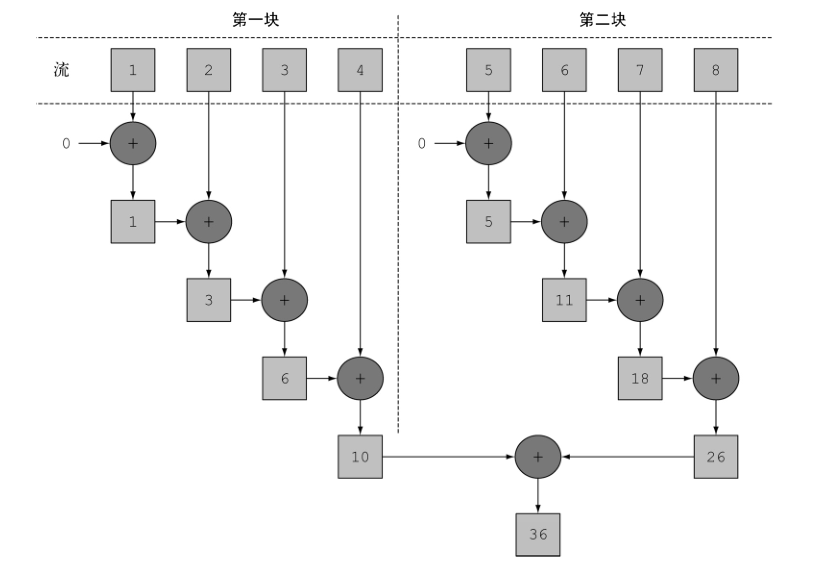
并行数据处理与性能 在前面三章中,我们已经看到了新的 Stream 接口可以让你以声明性方式处理数据集。我们还解释了将外部迭代换为内部迭代能够让原生Java库控制流元素的处理。这种方法让Java程序员无需显式实现优化来为数据集的处理加速。到目前为止,最重要的好处是可以对这些集合执行操作流水线,能够自动利用计算机上的多个内核。 例如,在Java 7之前,并行处理数据集合非常麻烦。第一,你得明确地把包含数据的数据结构分成若干子部分。第二,你要给每个子部分分配一个独立的线程。第三,你需要在恰当的时候对它们进行同步来避免不希望出现的竞争条件,等待所有线程完成,最后把这些部分结果合并起来。Java 7引入了一个叫作分支/合并的框架,让这些操作更稳定、更不易出错。 在本章中,我们将了解 Stream 接口如何让你不用太费力气就能对数据集执行并行操作。它允许你声明性地将顺序流变为并行流。此外,你将看到Java是如何变戏法的,或者更实际地来说,流是如何在幕后应用Java 7引入的分支/合并框架的。你还会发现,了解并行流内部是如何工作的很重要,因为如果你忽视这一方面,就可能因误用而得到意外的(很可能是错的)结果。 我们会特别演示,在并行处理数据块之前,并行流被划分为数据块的方式在某些情况下恰恰是这些错误且无法解释的结果的根源。因此,我们将会学习如何通过实现和使用你自己的Spliterator 来控制这个划分过程。 并行流 在第4章的笔记中,我们简要地了解到了 Stream 接口可以让你非常方便地处理它的元素:可以通过对收集源调用 parallelStream 方法来把集合转换为并行流。并行流就是一个把内容分成多个数据块,并用不同的线程分别处理每个数据块的流。这样一来,你就可以自动把给定操作的工作负荷分配给多核处理器的所有内核,让它们都忙起来。让我们用一个简单的例子来试验一下这个思想。 假设你需要写一个方法,接受数字n作为参数,并返回从1到给定参数的所有数字的和。一个直接(也许有点土)的方法是生成一个无穷大的数字流,把它限制到给定的数目,然后用对两个数字求和的 BinaryOperator 来归约这个流,如下所示: public static long sequentialSum(long n) { // 生成自然数无限流 return Stream.iterate(1L, i -> i + 1) // 限制到前n个数 .limit(n) // 对所有数字求和来归纳流 .reduce(0L, Long::sum); } 用更为传统的Java术语来说,这段代码与下面的迭代等价: public static long iterativeSum(long n) { long result = 0; for (long i = 0; i <= n; i++) { result += i; } return result; } 这似乎是利用并行处理的好机会,特别是n很大的时候。那怎么入手呢?你要对结果变量进行同步吗?用多少个线程呢?谁负责生成数呢?谁来做加法呢?根本用不着担心啦。用并行流的话,这问题就简单多了! 将顺序流转换为并行流 我们可以把流转换成并行流,从而让前面的函数归约过程(也就是求和)并行运行——对顺序流调用 parallel 方法: public static long parallelSum(long n) { // 生成自然数无限流 return Stream.iterate(1L, i -> i + 1) // 限制到前n个数 .limit(n) // 将流转为并行流 .parallel() // 对所有数字求和来归纳流 .reduce(0L, Long::sum); } 并行流的执行过程: 请注意,在现实中,对顺序流调用 parallel 方法并不意味着流本身有任何实际的变化。它在内部实际上就是设了一个 boolean 标志,表示你想让调用 parallel 之后进行的所有操作都并行执行。类似地,你只需要对并行流调用 sequential 方法就可以把它变成顺序流。请注意,你可能以为把这两个方法结合起来,就可以更细化地控制在遍历流时哪些操作要并行执行,哪些要顺序执行。例如,你可以这样做: stream.parallel() .filter(...) .sequential() .map(...) .parallel() .reduce(); 但最后一次 parallel 或 sequential 调用会影响整个流水线。在本例中,流水线会并行执行,因为最后调用的是它。 回到我们的数字求和练习,我们说过,在多核处理器上运行并行版本时,会有显著的性能提升。现在你有三个方法,用三种不同的方式(迭代式、顺序归纳和并行归纳)做完全相同的操作,让我们看看谁最快吧! 测量流性能 我们声称并行求和方法应该比顺序和迭代方法性能好。然而在软件工程上,靠猜绝对不是什么好办法!特别是在优化性能时,你应该始终遵循三个黄金规则:测量,测量,再测量。 测量对前n个自然数求和的函数的性能 public static long measurePerf(Function<Long, Long> adder, long n) { long fastest = Long.MAX_VALUE; for (int i = 0; i < 10; i++) { long start = System.nanoTime(); long sum = adder.apply(n); long duration = (System.nanoTime() - start) / 1_000_000; System.out.println("Result: " + sum); if (duration < fastest) { fastest = duration; } } return fastest; } 这个方法接受一个函数和一个 long 作为参数。它会对传给方法的 long 应用函数10次,记录每次执行的时间(以毫秒为单位),并返回最短的一次执行时间。假设你把先前开发的所有方法都放进了一个名为 ParallelStreams 的类,你就可以用这个框架来测试顺序加法器函数对前一千万个自然数求和要用多久: System.out.println("Sequential sum done in:" + measurePerf(ParallelStreams::sequentialSum, 10_000_000) + " msecs"); 请注意,我们对这个结果应持保留态度。影响执行时间的因素有很多,比如你的电脑支持多少个内核。你可以在自己的机器上跑一下这些代码。在一台i5 6200U 的笔记本上运行它,输出是这样的: Sequential sum done in:110 msecs 用传统 for 循环的迭代版本执行起来应该会快很多,因为它更为底层,更重要的是不需要对原始类型做任何装箱或拆箱操作。如果你试着测量它的性能: System.out.println("Iterative sum done in:" + measurePerf(ParallelStreams::iterativeSum, 10_000_000) + " msecs"); 将得到: Iterative sum done in:4 msecs 现在我们来对函数的并行版本做测试: System.out.println("Parallel sum done in: " + measurePerf(ParallelStreams::parallelSum, 10_000_000) + " msecs"); 看看会出现什么情况: Parallel sum done in: 525 msecs 这相当令人失望,求和方法的并行版本比顺序版本要慢很多。你如何解释这个意外的结果呢?这里实际上有两个问题: iterate 生成的是装箱的对象,必须拆箱成数字才能求和 我们很难把 iterate 分成多个独立块来并行执行。 第二个问题更有意思一点,因为你必须意识到某些流操作比其他操作更容易并行化。具体来说, iterate 很难分割成能够独立执行的小块,因为每次应用这个函数都要依赖前一次应用的结果。 这意味着,在这个特定情况下,归纳进程不是像上图那样进行的;整张数字列表在归纳过程开始时没有准备好,因而无法有效地把流划分为小块来并行处理。把流标记成并行,你其实是给顺序处理增加了开销,它还要把每次求和操作分到一个不同的线程上。 这就说明了并行编程可能很复杂,有时候甚至有点违反直觉。如果用得不对(比如采用了一个不易并行化的操作,如 iterate ),它甚至可能让程序的整体性能更差,所以在调用那个看似神奇的 parallel 操作时,了解背后到底发生了什么是很有必要的。 使用更有针对性的方法 那到底要怎么利用多核处理器,用流来高效地并行求和呢?我们在第5章中讨论了一个叫LongStream.rangeClosed 的方法。这个方法与 iterate 相比有两个优点。 LongStream.rangeClosed 直接产生原始类型的 long 数字,没有装箱拆箱的开销。 LongStream.rangeClosed 会生成数字范围,很容易拆分为独立的小块。例如,范围1~20可分为1~5、6~10、11~15和16~20。 让我们先看一下它用于顺序流时的性能如何,看看拆箱的开销到底要不要紧: public static long rangedSum(long n) { return LongStream.rangeClosed(1, n) .reduce(0L, Long::sum); } 这一次的输出是: Ranged sum done in: 5 msecs 这个数值流比前面那个用 iterate 工厂方法生成数字的顺序执行版本要快得多,因为数值流避免了非针对性流那些没必要的自动装箱和拆箱操作。由此可见,选择适当的数据结构往往比并行化算法更重要。但要是对这个新版本应用并行流呢? public static long parallelRangedSum(long n) { return LongStream.rangeClosed(1, n) .parallel() .reduce(0L, Long::sum); } 现在把这个函数传给的测试方法: System.out.println("Parallel range sum done in:" + measurePerf(ParallelStreams::parallelRangedSum, 10_000_000) + " msecs"); 你会得到: Parallel range sum done in:2 msecs amazing!终于,我们得到了一个比顺序执行更快的并行归纳,因为这一次归纳操作可以像并行流执行图那样执行了。这也表明,使用正确的数据结构然后使其并行工作能够保证最佳的性能。 尽管如此,请记住,并行化并不是没有代价的。并行化过程本身需要对流做递归划分,把每个子流的归纳操作分配到不同的线程,然后把这些操作的结果合并成一个值。但在多个内核之间移动数据的代价也可能比你想的要大,所以很重要的一点是要保证在内核中并行执行工作的时间比在内核之间传输数据的时间长。总而言之,很多情况下不可能或不方便并行化。然而,在使用并行 Stream 加速代码之前,你必须确保用得对;如果结果错了,算得快就毫无意义了。让我们来看一个常见的陷阱。 正确使用并行流 错用并行流而产生错误的首要原因,就是使用的算法改变了某些共享状态。下面是另一种实现对前n个自然数求和的方法,但这会改变一个共享累加器: public static long sideEffectSum(long n) { Accumulator accumulator = new Accumulator(); LongStream.rangeClosed(1, n) .forEach(accumulator::add); return accumulator.total; } public static class Accumulator { private long total = 0; public void add(long value) { total += value; } } 这种代码非常普遍,特别是对那些熟悉指令式编程范式的程序员来说。这段代码和你习惯的那种指令式迭代数字列表的方式很像:初始化一个累加器,一个个遍历列表中的元素,把它们和累加器相加。 那这种代码又有什么问题呢?不幸的是,它真的无可救药,因为它在本质上就是顺序的。每次访问 total 都会出现数据竞争。如果你尝试用同步来修复,那就完全失去并行的意义了。为了说明这一点,让我们试着把 Stream 变成并行的: public static long sideEffectParallelSum(long n) { Accumulator accumulator = new Accumulator(); LongStream.rangeClosed(1, n) .parallel() .forEach(accumulator::add); return accumulator.total; } 执行测试方法,并打印每次执行的结果: System.out.println("SideEffect parallel sum done in: " + measurePerf(ParallelStreams::sideEffectParallelSum, 10_000_000L) + " msecs"); 你可能会得到类似于下面这种输出: Result: 9869563545574 Result: 12405006536090 Result: 8268141260766 Result: 11208597038187 Result: 12358062322272 Result: 19218969315182 Result: 11255083226412 Result: 25746147125980 Result: 13327069088874 SideEffect parallel sum done in: 4 msecs 这回方法的性能无关紧要了,唯一要紧的是每次执行都会返回不同的结果,都离正确值50000005000000 差很远。这是由于多个线程在同时访问累加器,执行 total += value ,而这一句虽然看似简单,却不是一个原子操作。问题的根源在于, forEach 中调用的方法有副作用,它会改变多个线程共享的对象的可变状态。要是你想用并行 Stream 又不想引发类似的意外,就必须避免这种情况。 现在你知道了,共享可变状态会影响并行流以及并行计算。现在,记住要避免共享可变状态,确保并行 Stream 得到正确的结果。接下来,我们会看到一些实用建议,你可以由此判断什么时候可以利用并行流来提升性能。 高效使用并行流 一般而言,想给出任何关于什么时候该用并行流的定量建议都是不可能也毫无意义的,因为任何类似于“仅当至少有一千个(或一百万个或随便什么数字)元素的时候才用并行流)”的建议对于某台特定机器上的某个特定操作可能是对的,但在略有差异的另一种情况下可能就是大错特错。尽管如此,我们至少可以提出一些定性意见,帮你决定某个特定情况下是否有必要使用并行流。 如果有疑问,测量。把顺序流转成并行流轻而易举,但却不一定是好事。我们在本节中已经指出,并行流并不总是比顺序流快。此外,并行流有时候会和你的直觉不一致,所以在考虑选择顺序流还是并行流时,第一个也是最重要的建议就是用适当的基准来检查其性能。 留意装箱。自动装箱和拆箱操作会大大降低性能。Java 8中有原始类型流( IntStream 、LongStream 、 DoubleStream )来避免这种操作,但凡有可能都应该用这些流。 有些操作本身在并行流上的性能就比顺序流差。特别是 limit 和 findFirst 等依赖于元素顺序的操作,它们在并行流上执行的代价非常大。例如, findAny 会比 findFirst 性能好,因为它不一定要按顺序来执行。你总是可以调用 unordered 方法来把有序流变成无序流。那么,如果你需要流中的n个元素而不是专门要前n个的话,对无序并行流调用limit 可能会比单个有序流(比如数据源是一个 List )更高效。 还要考虑流的操作流水线的总计算成本。设N是要处理的元素的总数,Q是一个元素通过流水线的大致处理成本,则N*Q就是这个对成本的一个粗略的定性估计。Q值较高就意味着使用并行流时性能好的可能性比较大。 对于较小的数据量,选择并行流几乎从来都不是一个好的决定。并行处理少数几个元素的好处还抵不上并行化造成的额外开销。 要考虑流背后的数据结构是否易于分解。例如, ArrayList 的拆分效率比 LinkedList高得多,因为前者用不着遍历就可以平均拆分,而后者则必须遍历。另外,用 range 工厂方法创建的原始类型流也可以快速分解。 流自身的特点,以及流水线中的中间操作修改流的方式,都可能会改变分解过程的性能。例如,一个 SIZED 流可以分成大小相等的两部分,这样每个部分都可以比较高效地并行处理,但筛选操作可能丢弃的元素个数却无法预测,导致流本身的大小未知。 还要考虑终端操作中合并步骤的代价是大是小(例如 Collector 中的 combiner 方法)。如果这一步代价很大,那么组合每个子流产生的部分结果所付出的代价就可能会超出通过并行流得到的性能提升。 最后,我们还要强调并行流背后使用的基础架构是Java 7中引入的分支/合并框架。并行汇总的示例证明了要想正确使用并行流,了解它的内部原理至关重要,所以我们会在下一节仔细研究分支/合并框架。 分支/合并框架 分支/合并框架的目的是以递归方式将可以并行的任务拆分成更小的任务,然后将每个子任务的结果合并起来生成整体结果。它是 ExecutorService 接口的一个实现,它把子任务分配给线程池(称为 ForkJoinPool )中的工作线程。首先来看看如何定义任务和子任务。 使用 RecursiveTask 要把任务提交到这个池,必须创建 RecursiveTask 的一个子类,其中 R 是并行化任务(以及所有子任务)产生的结果类型,或者如果任务不返回结果,则是 RecursiveAction 类型(当然它可能会更新其他非局部机构)。要定义 RecursiveTask, 只需实现它唯一的抽象方法compute : protected abstract R compute(); 这个方法同时定义了将任务拆分成子任务的逻辑,以及无法再拆分或不方便再拆分时,生成单个子任务结果的逻辑。正由于此,这个方法的实现类似于下面的伪代码: if (任务足够小或不可分) { 顺序计算该任务 } else { 将任务分成两个子任务 递归调用本方法,拆分每个子任务,等待所有子任务完成 合并每个子任务的结果 } 一般来说并没有确切的标准决定一个任务是否应该再拆分,但有几种试探方法可以帮助你做出这一决定。 你可能已经注意到,这只不过是著名的分治算法的并行版本而已。这里举一个用分支/合并框架的实际例子,还以前面的例子为基础,让我们试着用这个框架为一个数字范围(这里用一个long[] 数组表示)求和。如前所述,你需要先为RecursiveTask类做一个实现,就是下面代码清单中的ForkJoinSumCalculator 。 用分支/合并框架执行并行求和: public class ForkJoinSumCalculator extends RecursiveTask<Long> { /** * 不再将任务分解为子任务的数组大小 */ public static final long THRESHOLD = 10_000; /** * 要求和的数组 */ private final long[] numbers; /** * 子任务处理的数组的起始和终止位置 */ private final int start; private final int end; public ForkJoinSumCalculator(long[] numbers) { this(numbers, 0, numbers.length); } private ForkJoinSumCalculator(long[] numbers, int start, int end) { this.numbers = numbers; this.start = start; this.end = end; } @Override protected Long compute() { // 该任务负责求和的部分的大小 int length = end - start; // 如果大小小于或等于阈值,顺序计算结果 if (length <= THRESHOLD) { return computeSequentially(); } // 创建一个子任务来为数组的前一半求和 ForkJoinSumCalculator leftTask = new ForkJoinSumCalculator(numbers, start, start + length / 2); leftTask.fork(); // 利用另一个ForkJoinPool线程异步执行新创建的子任务 ForkJoinSumCalculator rightTask = new ForkJoinSumCalculator(numbers, start + length / 2, end); // 同步执行第二个子任务,有可能允许进一步递归划分 Long rightResult = rightTask.compute(); // 读取第一个子任务的结果,如果尚未完成就等待 Long leftResult = leftTask.join(); // 该任务的结果是两个子任务结果的组合 return leftResult + rightResult; } private Long computeSequentially() { long sum = 0; for (int i = start; i < end; i++) { sum += numbers[i]; } return sum; } } 现在编写一个方法来并行对前n个自然数求和就很简单了。你只需把想要的数字数组传给ForkJoinSumCalculator 的构造函数: public static long forkJoinSum(long n) { long[] numbers = LongStream.rangeClosed(1, n).toArray(); ForkJoinTask<Long> task = new ForkJoinSumCalculator(numbers); return new ForkJoinPool().invoke(task); } 这里用了一个 LongStream 来生成包含前n个自然数的数组,然后创建一个 ForkJoinTask( RecursiveTask 的父类),并把数组传递 ForkJoinSumCalculator 的公共构造函数。最后,你创建了一个新的 ForkJoinPool ,并把任务传给它的调用方法 。在ForkJoinPool 中执行时,最后一个方法返回的值就是 ForkJoinSumCalculator 类定义的任务结果。 请注意在实际应用时,使用多个 ForkJoinPool 是没有什么意义的。正是出于这个原因,一般来说把它实例化一次,然后把实例保存在静态字段中,使之成为单例,这样就可以在软件中任何部分方便地重用了。这里创建时用了其默认的无参数构造函数,这意味着想让线程池使用JVM能够使用的所有处理器。更确切地说,该构造函数将使用 Runtime.availableProcessors 的返回值来决定线程池使用的线程数。请注意 availableProcessors 方法虽然看起来是处理器,但它实际上返回的是可用内核的数量,包括超线程生成的虚拟内核。 运行 ForkJoinSumCalculator 当把 ForkJoinSumCalculator 任务传给 ForkJoinPool 时,这个任务就由池中的一个线程执行,这个线程会调用任务的 compute 方法。该方法会检查任务是否小到足以顺序执行,如果不够小则会把要求和的数组分成两半,分给两个新的 ForkJoinSumCalculator ,而它们也由ForkJoinPool 安排执行。因此,这一过程可以递归重复,把原任务分为更小的任务,直到满足不方便或不可能再进一步拆分的条件(本例中是求和的项目数小于等于10 000)。这时会顺序计算每个任务的结果,然后由分支过程创建的(隐含的)任务二叉树遍历回到它的根。接下来会合并每个子任务的部分结果,从而得到总任务的结果。 你可以再用一次本章开始时写的测试框架,来看看显式使用分支/合并框架的求和方法的性能: System.out.println("ForkJoin sum done in: " + measurePerf( ForkJoinSumCalculator::forkJoinSum, 10_000_000) + " msecs"); 它生成以下输出: ForkJoin sum done in: 41 msecs 这个性能看起来比用并行流的版本要差,但这只是因为必须先要把整个数字流都放进一个long[] ,之后才能在 ForkJoinSumCalculator 任务中使用它。 使用分支/合并框架的最佳做法 虽然分支/合并框架还算简单易用,不幸的是它也很容易被误用。以下是几个有效使用它的最佳做法。 对一个任务调用 join 方法会阻塞调用方,直到该任务做出结果。因此,有必要在两个子任务的计算都开始之后再调用它。否则,你得到的版本会比原始的顺序算法更慢更复杂,因为每个子任务都必须等待另一个子任务完成才能启动。 不应该在 RecursiveTask 内部使用 ForkJoinPool 的 invoke 方法。相反,你应该始终直接调用 compute 或 fork 方法,只有顺序代码才应该用 invoke 来启动并行计算。 对子任务调用 fork 方法可以把它排进 ForkJoinPool 。同时对左边和右边的子任务调用它似乎很自然,但这样做的效率要比直接对其中一个调用 compute 低。这样做你可以为其中一个子任务重用同一线程,从而避免在线程池中多分配一个任务造成的开销。 调试使用分支/合并框架的并行计算可能有点棘手。特别是你平常都在你喜欢的IDE里面看栈跟踪(stack trace)来找问题,但放在分支合并计算上就不行了,因为调用 compute的线程并不是概念上的调用方,后者是调用 fork 的那个。 和并行流一样,你不应理所当然地认为在多核处理器上使用分支/合并框架就比顺序计算快。我们已经说过,一个任务可以分解成多个独立的子任务,才能让性能在并行化时有所提升。所有这些子任务的运行时间都应该比分出新任务所花的时间长;一个惯用方法是把输入/输出放在一个子任务里,计算放在另一个里,这样计算就可以和输入/输出同时进行。此外,在比较同一算法的顺序和并行版本的性能时还有别的因素要考虑。就像任何其他Java代码一样,分支/合并框架需要“预热”或者说要执行几遍才会被JIT编译器优化。这就是为什么在测量性能之前跑几遍程序很重要,我们的测试框架就是这么做的。同时还要知道,编译器内置的优化可能会为顺序版本带来一些优势(例如执行死码分析——删去从未被使用的计算)。 对于分支/合并拆分策略还有最后一点补充:你必须选择一个标准,来决定任务是要进一步拆分还是已小到可以顺序求值。 工作窃取 在 ForkJoinSumCalculator 的例子中,我们决定在要求和的数组中最多包含10 000个项目时就不再创建子任务了。这个选择是很随意的,但大多数情况下也很难找到一个好的启发式方法来确定它,只能试几个不同的值来尝试优化它。在我们的测试案例中,我们先用了一个有1000万项目的数组,意味着 ForkJoinSumCalculator 至少会分出1000个子任务来。这似乎有点浪费资源,因为我们用来运行它的机器上只有四个内核。在这个特定例子中可能确实是这样,因为所有的任务都受CPU约束,预计所花的时间也差不多。 但分出大量的小任务一般来说都是一个好的选择。这是因为,理想情况下,划分并行任务时,应该让每个任务都用完全相同的时间完成,让所有的CPU内核都同样繁忙。不幸的是,实际中,每个子任务所花的时间可能天差地别,要么是因为划分策略效率低,要么是有不可预知的原因,比如磁盘访问慢,或是需要和外部服务协调执行。 分支/合并框架工程用一种称为工作窃取(work stealing)的技术来解决这个问题。在实际应用中,这意味着这些任务差不多被平均分配到 ForkJoinPool 中的所有线程上。每个线程都为分配给它的任务保存一个双向链式队列,每完成一个任务,就会从队列头上取出下一个任务开始执行。基于前面所述的原因,某个线程可能早早完成了分配给它的所有任务,也就是它的队列已经空了,而其他的线程还很忙。这时,这个线程并没有闲下来,而是随机选了一个别的线程,从队列的尾巴上“偷走”一个任务。这个过程一直继续下去,直到所有的任务都执行完毕,所有的队列都清空。这就是为什么要划成许多小任务而不是少数几个大任务,这有助于更好地在工作线程之间平衡负载。 一般来说,这种工作窃取算法用于在池中的工作线程之间重新分配和平衡任务。当工作线程队列中有一个任务被分成两个子任务时,一个子任务就被闲置的工作线程“偷走”了。如前所述,这个过程可以不断递归,直到规定子任务应顺序执行的条件为真。 现在你应该清楚流如何使用分支/合并框架来并行处理它的项目了,不过还有一点没有讲。本节中我们分析了一个例子,你明确地指定了将数字数组拆分成多个任务的逻辑。但是,使用本章前面讲的并行流时就用不着这么做了,这就意味着,肯定有一种自动机制来为你拆分流。这种新的自动机制称为 Spliterator ,我们会在下一节中讨论。 Spliterator Spliterator 是Java 8中加入的另一个新接口;这个名字代表“可分迭代器”(splitableiterator)。和 Iterator 一样, Spliterator 也用于遍历数据源中的元素,但它是为了并行执行而设计的。虽然在实践中可能用不着自己开发 Spliterator ,但了解一下它的实现方式会让你对并行流的工作原理有更深入的了解。Java 8已经为集合框架中包含的所有数据结构提供了一个默认的 Spliterator 实现。集合实现了 Spliterator 接口,接口提供了一个 spliterator 方法。这个接口定义了若干方法,如下面的代码清单所示。 public interface Spliterator<T> { boolean tryAdvance(Consumer<? super T> action); Spliterator<T> trySplit(); long estimateSize(); int characteristics(); } 与往常一样, T 是 Spliterator 遍历的元素的类型。 tryAdvance 方法的行为类似于普通的Iterator ,因为它会按顺序一个一个使用 Spliterator 中的元素,并且如果还有其他元素要遍历就返回 true 。但 trySplit 是专为 Spliterator 接口设计的,因为它可以把一些元素划出去分给第二个 Spliterator (由该方法返回),让它们两个并行处理。 Spliterator 还可通过estimateSize 方法估计还剩下多少元素要遍历,因为即使不那么确切,能快速算出来是一个值也有助于让拆分均匀一点。 重要的是,要了解这个拆分过程在内部是如何执行的,以便在需要时能够掌控它。因此,我们会在下一节中详细地分析它。 拆分过程 将 Stream 拆分成多个部分的算法是一个递归过程。第一步是对第一个Spliterator 调用 trySplit ,生成第二个 Spliterator 。第二步对这两个 Spliterator 调用trysplit ,这样总共就有了四个 Spliterator 。这个框架不断对 Spliterator 调用 trySplit直到它返回 null ,表明它处理的数据结构不能再分割,如第三步所示。最后,这个递归拆分过程到第四步就终止了,这时所有的 Spliterator 在调用 trySplit 时都返回了 null 。 这个拆分过程也受 Spliterator 本身的特性影响,而特性是通过 characteristics 方法声明的。 实现你自己的 Spliterator 让我们来看一个可能需要你自己实现 Spliterator 的实际例子。我们要开发一个简单的方法来数数一个 String 中的单词数。这个方法的一个迭代版本可以写成下面的样子。 public static int countWordsIteratively(String s) { int counter = 0; boolean lastSpace = true; for (char c : s.toCharArray()) { if (Character.isWhitespace(c)) { lastSpace = true; } else { if (lastSpace) { counter++; } lastSpace = Character.isWhitespace(c); } } return counter; } 让我们把这个方法用在但丁的《神曲》的《地狱篇》的第一句话上: public static final String SENTENCE = " Nel mezzo del cammin di nostra vita " + "mi ritrovai in una selva oscura" + " che la dritta via era smarrita "; System.out.println("Found " + countWordsIteratively(SENTENCE) + " words"); 请注意,我们在句子里添加了一些额外的随机空格,以演示这个迭代实现即使在两个词之间存在多个空格时也能正常工作。正如我们所料,这段代码将打印以下内容: Found 19 words 理想情况下,你会想要用更为函数式的风格来实现它,因为就像我们前面说过的,这样你就可以用并行 Stream 来并行化这个过程,而无需显式地处理线程和同步问题。 以函数式风格重写单词计数器 首先你需要把 String 转换成一个流。不幸的是,原始类型的流仅限于 int 、 long 和 double ,所以你只能用 Stream : Stream<Character> stream = IntStream.range(0, SENTENCE.length()) .mapToObj(SENTENCE::charAt); 你可以对这个流做归约来计算字数。在归约流时,你得保留由两个变量组成的状态:一个 int用来计算到目前为止数过的字数,还有一个 boolean 用来记得上一个遇到的 Character 是不是空格。因为Java没有元组(tuple,用来表示由异类元素组成的有序列表的结构,不需要包装对象),所以你必须创建一个新类 WordCounter 来把这个状态封装起来,如下所示。 private static class WordCounter { private final int counter; private final boolean lastSpace; public WordCounter(int counter, boolean lastSpace) { this.counter = counter; this.lastSpace = lastSpace; } public WordCounter accumulate(Character c) { if (Character.isWhitespace(c)) { return lastSpace ? this : new WordCounter(counter, true); } else { return lastSpace ? new WordCounter(counter + 1, false) : this; } } public WordCounter combine(WordCounter wordCounter) { return new WordCounter(counter + wordCounter.counter, wordCounter.lastSpace); } public int getCounter() { return counter; } } 在这个列表中, accumulate 方法定义了如何更改 WordCounter 的状态,或更确切地说是用哪个状态来建立新的 WordCounter ,因为这个类是不可变的。每次遍历到 Stream 中的一个新的Character 时,就会调用 accumulate 方法。具体来说,就像 countWordsIteratively 方法一样,当上一个字符是空格,新字符不是空格时,计数器就加一。 调用第二个方法 combine 时,会对作用于 Character 流的两个不同子部分的两个WordCounter 的部分结果进行汇总,也就是把两个 WordCounter 内部的计数器加起来。 private static int countWords(Stream<Character> stream) { WordCounter wordCounter = stream.reduce(new WordCounter(0, true), WordCounter::accumulate, WordCounter::combine); return wordCounter.getCounter(); } 现在你就可以试一试这个方法,给它由包含但丁的《神曲》中《地狱篇》第一句的 String创建的流: Stream<Character> stream = IntStream.range(0, SENTENCE.length()) .mapToObj(SENTENCE::charAt); System.out.println("Found " + countWords(stream) + " words"); 你可以和迭代版本比较一下输出: Found 19 words 到现在为止都很好,但我们以函数式实现 WordCounter 的主要原因之一就是能轻松地并行处理,让我们来看看具体是如何实现的。 让 WordCounter 并行工作 你可以尝试用并行流来加快字数统计,如下所示: System.out.println("Found " + countWords(stream.parallel()) + " words"); 不幸的是,这次的输出是: Found 25 words 显然有什么不对,可到底是哪里不对呢?问题的根源并不难找。因为原始的 String 在任意位置拆分,所以有时一个词会被分为两个词,然后数了两次。这就说明,拆分流会影响结果,而把顺序流换成并行流就可能使结果出错。 如何解决这个问题呢?解决方案就是要确保 String 不是在随机位置拆开的,而只能在词尾拆开。要做到这一点,你必须为 Character 实现一个 Spliterator ,它只能在两个词之间拆开String (如下所示),然后由此创建并行流。 private static class WordCounterSpliterator implements Spliterator<Character> { private final String string; private int currentChar = 0; public WordCounterSpliterator(String string) { this.string = string; } @Override public boolean tryAdvance(Consumer<? super Character> action) { action.accept(string.charAt(currentChar++)); return currentChar < string.length(); } @Override public Spliterator<Character> trySplit() { int currentSize = string.length() - currentChar; if (currentSize < 10) { return null; } for (int splitPos = currentSize / 2 + currentChar; splitPos < string.length(); splitPos++) { if (Character.isWhitespace(string.charAt(splitPos))) { Spliterator<Character> spliterator = new WordCounterSpliterator(string.substring(currentChar, splitPos)); currentChar = splitPos; return spliterator; } } return null; } @Override public long estimateSize() { return string.length() - currentChar; } @Override public int characteristics() { return ORDERED + SIZED + SUBSIZED + NONNULL + IMMUTABLE; } } 这个 Spliterator 由要解析的 String 创建,并遍历了其中的 Character ,同时保存了当前正在遍历的字符位置。让我们快速回顾一下实现了Spliterator接口的WordCounterSpliterator 中的各个函数。 tryAdvance 方法把 String 中当前位置的 Character 传给了 Consumer ,并让位置加一。作为参数传递的 Consumer 是一个Java内部类,在遍历流时将要处理的 Character 传给了一系列要对其执行的函数。这里只有一个归约函数,即 WordCounter 类的 accumulate方法。如果新的指针位置小于 String 的总长,且还有要遍历的 Character ,则tryAdvance 返回 true 。 trySplit 方法是 Spliterator 中最重要的一个方法,因为它定义了拆分要遍历的数据结构的逻辑。就像 RecursiveTask 的 compute 方法一样(分支/合并框架的使用方式),首先要设定不再进一步拆分的下限。这里用了一个非常低的下限——10个 Character ,仅仅是为了保证程序会对那个比较短的 String 做几次拆分。在实际应用中,就像分支/合并的例子那样,你肯定要用更高的下限来避免生成太多的任务。如果剩余的 Character 数量低于下限,你就返回 null 表示无需进一步拆分。相反,如果你需要执行拆分,就把试探的拆分位置设在要解析的 String 块的中间。但我们没有直接使用这个拆分位置,因为要避免把词在中间断开,于是就往前找,直到找到一个空格。一旦找到了适当的拆分位置,就可以创建一个新的 Spliterator 来遍历从当前位置到拆分位置的子串;把当前位置 this 设为拆分位置,因为之前的部分将由新Spliterator 来处理,最后返回。 还需要遍历的元素的 estimatedSize 就是这个 Spliterator 解析的 String 的总长度和当前遍历的位置的差。 最后, characteristic 方法告诉框架这个 Spliterator 是 ORDERED (顺序就是 String中各个 Character 的次序)、 SIZED ( estimatedSize 方法的返回值是精确的)、SUBSIZED ( trySplit 方法创建的其他 Spliterator 也有确切大小)、 NONNULL ( String中 不 能 有 为 null 的 Character ) 和 IMMUTABLE ( 在 解 析 String 时 不 能 再 添 加Character ,因为 String 本身是一个不可变类)的。 运用 WordCounterSpliterator 现在就可以用这个新的 WordCounterSpliterator 来处理并行流了,如下所示: Spliterator<Character> spliterator = new WordCounterSpliterator(SENTENCE); Stream<Character> stream = StreamSupport.stream(spliterator, true); 传给 StreamSupport.stream 工厂方法的第二个布尔参数意味着你想创建一个并行流。把这个并行流传给 countWords 方法: System.out.println("Found " + countWords(stream.parallel()) + " words"); 可以得到意料之中的正确输出: Found 19 words 你已经看到了 Spliterator 如何让你控制拆分数据结构的策略。 Spliterator 还有最后一个值得注意的功能,就是可以在第一次遍历、第一次拆分或第一次查询估计大小时绑定元素的数据源,而不是在创建时就绑定。这种情况下,它称为延迟绑定(late-binding)的 Spliterator 。 总结 内部迭代让你可以并行处理一个流,而无需在代码中显式使用和协调不同的线程。 虽然并行处理一个流很容易,却不能保证程序在所有情况下都运行得更快。并行软件的行为和性能有时是违反直觉的,因此一定要测量,确保你并没有把程序拖得更慢。 像并行流那样对一个数据集并行执行操作可以提升性能,特别是要处理的元素数量庞大,或处理单个元素特别耗时的时候。 从性能角度来看,使用正确的数据结构,如尽可能利用原始流而不是一般化的流,几乎总是比尝试并行化某些操作更为重要。 分支/合并框架让你得以用递归方式将可以并行的任务拆分成更小的任务,在不同的线程上执行,然后将各个子任务的结果合并起来生成整体结果。 Spliterator 定义了并行流如何拆分它要遍历的数据。 代码 Github:chap7Gitee:chap7

优秀的个人博客,低调大师

《Java8实战》-第五章读书笔记(使用流Stream-02)

付诸实战 在本节中,我们会将迄今学到的关于流的知识付诸实践。我们来看一个不同的领域:执行交易的交易员。你的经理让你为八个查询找到答案。 找出2011年发生的所有交易,并按交易额排序(从低到高)。 交易员都在哪些不同的城市工作过? 查找所有来自于剑桥的交易员,并按姓名排序。 返回所有交易员的姓名字符串,按字母顺序排序。 有没有交易员是在米兰工作的? 打印生活在剑桥的交易员的所有交易额。 所有交易中,最高的交易额是多少? 找到交易额最小的交易。 领域:交易员和交易 以下是我们要处理的领域,一个 Traders 和 Transactions 的列表: Trader raoul = new Trader("Raoul", "Cambridge"); Trader mario = new Trader("Mario", "Milan"); Trader alan = new Trader("Alan", "Cambridge"); Trader brian = new Trader("Brian", "Cambridge"); List<Transaction> transactions = Arrays.asList( new Transaction(brian, 2011, 300), new Transaction(raoul, 2012, 1000), new Transaction(raoul, 2011, 400), new Transaction(mario, 2012, 710), new Transaction(mario, 2012, 700), new Transaction(alan, 2012, 950) ); Trader和Transaction类的定义: public class Trader { private String name; private String city; public Trader(String n, String c){ this.name = n; this.city = c; } public String getName() { return name; } public void setName(String name) { this.name = name; } public String getCity() { return city; } public void setCity(String city) { this.city = city; } @Override public String toString() { return "Trader{" + "name='" + name + '\'' + ", city='" + city + '\'' + '}'; } } Transaction类: public class Transaction { private Trader trader; private Integer year; private Integer value; public Transaction(Trader trader, Integer year, Integer value) { this.trader = trader; this.year = year; this.value = value; } public Trader getTrader() { return trader; } public void setTrader(Trader trader) { this.trader = trader; } public Integer getYear() { return year; } public void setYear(Integer year) { this.year = year; } public Integer getValue() { return value; } public void setValue(Integer value) { this.value = value; } @Override public String toString() { return "Transaction{" + "trader=" + trader + ", year=" + year + ", value=" + value + '}'; } } 首先,我们来看第一个问题:找出2011年发生的所有交易,并按交易额排序(从低到高)。 List<Transaction> tr2011 = transactions.stream() // 筛选出2011年发生的所有交易 .filter(transaction -> transaction.getYear() == 2011) // 按照交易额从低到高排序 .sorted(Comparator.comparing(Transaction::getValue)) // 转为集合 .collect(Collectors.toList()); 太棒了,第一个问题我们很轻松的就解决了!首先,将transactions集合转为流,然后给filter传递一个谓词来选择2011年的交易,接着按照交易额从低到高进行排序,最后将Stream中的所有元素收集到一个List集合中。 第二个问题:交易员都在哪些不同的城市工作过? List<String> cities = transactions.stream() // 提取出交易员所工作的城市 .map(transaction -> transaction.getTrader().getCity()) // 去除已有的城市 .distinct() // 将Stream中所有的元素转为一个List集合 .collect(Collectors.toList()); 是的,我们很简单的完成了第二个问题。首先,将transactions集合转为流,然后使用map提取出与交易员相关的每位交易员所在的城市,接着使用distinct去除重复的城市(当然,我们也可以去掉distinct,在最后我们就要使用collect,将Stream中的元素转为一个Set集合。collect(Collectors.toSet())),我们只需要不同的城市,最后将Stream中的所有元素收集到一个List中。 第三个问题:查找所有来自于剑桥的交易员,并按姓名排序。 List<Trader> traders = transactions.stream() // 从交易中提取所有的交易员 .map(Transaction::getTrader) // 进选择位于剑桥的交易员 .filter(trader -> "Cambridge".equals(trader.getCity())) // 确保没有重复 .distinct() // 对生成的交易员流按照姓名进行排序 .sorted(Comparator.comparing(Trader::getName)) .collect(Collectors.toList()); 第三个问题,从交易中提取所有的交易员,然后进选择位于剑桥的交易员确保没有重复,接着对生成的交易员流按照姓名进行排序。 第四个问题:返回所有交易员的姓名字符串,按字母顺序排序。 String traderStr = transactions.stream() // 提取所有交易员姓名,生成一个 Strings 构成的 Stream .map(transaction -> transaction.getTrader().getName()) // 只选择不相同的姓名 .distinct() // 对姓名按字母顺序排序 .sorted() // 逐个拼接每个名字,得到一个将所有名字连接起来的 String .reduce("", (n1, n2) -> n1 + " " + n2); 这些问题,我们都很轻松的就完成!首先,提取所有交易员姓名,生成一个 Strings 构成的 Stream并且只选择不相同的姓名,然后对姓名按字母顺序排序,最后使用reduce将名字拼接起来! 请注意,此解决方案效率不高(所有字符串都被反复连接,每次迭代的时候都要建立一个新的 String 对象)。下一章中,你将看到一个更为高效的解决方案,它像下面这样使用 joining (其内部会用到 StringBuilder ): String traderStr = transactions.stream() .map(transaction -> transaction.getTrader().getName()) .distinct() .sorted() .collect(joining()); 第五个问题:有没有交易员是在米兰工作的? boolean milanBased = transactions.stream() // 把一个谓词传递给 anyMatch ,检查是否有交易员在米兰工作 .anyMatch(transaction -> "Milan".equals(transaction.getTrader() .getCity())); 第五个问题,依旧很简单把一个谓词传递给 anyMatch ,检查是否有交易员在米兰工作。 第六个问题:打印生活在剑桥的交易员的所有交易额。 transactions.stream() // 选择住在剑桥的交易员所进行的交易 .filter(t -> "Cambridge".equals(t.getTrader().getCity())) // 提取这些交易的交易额 .map(Transaction::getValue) // 打印每个值 .forEach(System.out::println); 第六个问题,首先选择住在剑桥的交易员所进行的交易,接着提取这些交易的交易额,然后就打印出每个值。 第七个问题:所有交易中,最高的交易额是多少? Optional<Integer> highestValue = transactions.stream() // 提取每项交易的交易额 .map(Transaction::getValue) // 计算生成的流中的最大值 .reduce(Integer::max); 第七个问题,首先提取每项交易的交易额,然后使用reduce计算生成的流中的最大值。 第八个问题:找到交易额最小的交易。 Optional<Transaction> smallestTransaction = transactions.stream() // 通过反复比较每个交易的交易额,找出最小的交易 .reduce((t1, t2) -> t1.getValue() < t2.getValue() ? t1 : t2); 是的,第八个问题很简单,但是还有更好的做法!流支持 min 和 max 方法,它们可以接受一个 Comparator 作为参数,指定计算最小或最大值时要比较哪个键值: Optional<Transaction> smallestTransaction = transactions.stream() .min(comparing(Transaction::getValue)); 上面的八个问题,我们通过Stream很轻松的就完成了,真是太棒了! 数值流 我们在前面看到了可以使用 reduce 方法计算流中元素的总和。例如,你可以像下面这样计算菜单的热量: int calories = menu.stream() .map(Dish::getCalories) .reduce(0, Integer::sum); 这段代码的问题是,它有一个暗含的装箱成本。每个 Integer 都必须拆箱成一个原始类型,再进行求和。要是可以直接像下面这样调用 sum 方法,岂不是更好? int calories = menu.stream() .map(Dish::getCalories) .sum(); 但这是不可能的。问题在于 map 方法会生成一个 Stream 。虽然流中的元素是 Integer 类型,但 Streams 接口没有定义 sum 方法。为什么没有呢?比方说,你只有一个像 menu 那样的Stream ,把各种菜加起来是没有任何意义的。但不要担心,Stream API还提供了原始类型流特化,专门支持处理数值流的方法。 原始类型流特化 Java 8引入了三个原始类型特化流接口来解决这个问题: IntStream 、 DoubleStream 和LongStream ,分别将流中的元素特化为 int 、 long 和 double ,从而避免了暗含的装箱成本。每个接口都带来了进行常用数值归约的新方法,比如对数值流求和的 sum ,找到最大元素的max。此外还有在必要时再把它们转换回对象流的方法。要记住的是,这些特化的原因并不在于流的复杂性,而是装箱造成的复杂性——即类似 int 和 Integer 之间的效率差异。 1.映射到数值流 将流转换为特化版本的常用方法是 mapToInt 、 mapToDouble 和 mapToLong 。这些方法和前面说的 map 方法的工作方式一样,只是它们返回的是一个特化流,而不是 Stream 。例如,我们可以像下面这样用 mapToInt 对 menu 中的卡路里求和: int calories = menu.stream() // 返回一个IntStream .mapToInt(Dish::getCalories) .sum(); 这里, mapToInt 会从每道菜中提取热量(用一个 Integer 表示),并返回一个 IntStream(而不是一个 Stream )。然后你就可以调用 IntStream 接口中定义的 sum 方法,对卡路里求和了!请注意,如果流是空的, sum 默认返回 0 。 IntStream 还支持其他的方便方法,如max 、 min 、 average 等。 2.转换回对象流 同样,一旦有了数值流,你可能会想把它转换回非特化流。例如, IntStream 上的操作只能产生原始整数: IntStream 的 map 操作接受的Lambda必须接受 int 并返回 int (一个IntUnaryOperator )。但是你可能想要生成另一类值,比如 Dish 。为此,你需要访问 Stream接口中定义的那些更广义的操作。要把原始流转换成一般流(每个 int 都会装箱成一个Integer ),可以使用 boxed 方法,如下所示: IntStream intStream = menu.stream().mapToInt(Dish::getCalories); Stream<Integer> stream = intStream.boxed(); 3.默认值 OptionalInt 求和的那个例子很容易,因为它有一个默认值: 0 。但是,如果你要计算 IntStream 中的最大元素,就得换个法子了,因为 0 是错误的结果。如何区分没有元素的流和最大值真的是 0 的流呢?前面我们介绍了 Optional 类,这是一个可以表示值存在或不存在的容器。 Optional 可以用Integer 、 String 等参考类型来参数化。对于三种原始流特化,也分别有一个 Optional 原始类型特化版本: OptionalInt 、 OptionalDouble 和 OptionalLong 。 例如,要找到 IntStream 中的最大元素,可以调用 max 方法,它会返回一个 OptionalInt : OptionalInt maxCalories = menu.stream() .mapToInt(Dish::getCalories) .max(); 现在,如果没有最大值的话,你就可以显式处理 OptionalInt 去定义一个默认值了: int max = maxCalories.orElse(1); 数值范围 和数字打交道时,有一个常用的东西就是数值范围。比如,假设你想要生成1和100之间的所有数字。Java 8引入了两个可以用于 IntStream 和 LongStream 的静态方法,帮助生成这种范围:range 和 rangeClosed 。这两个方法都是第一个参数接受起始值,第二个参数接受结束值。但range 是不包含结束值的,而 rangeClosed 则包含结束值。让我们来看一个例子: // 一个从1到100的偶数流 包含结束值 IntStream evenNumbers = IntStream.rangeClosed(1, 100) .filter(n -> n % 2 == 0); // 从1到100共有50个偶数 System.out.println(evenNumbers.count()); 这里我们用了 rangeClosed 方法来生成1到100之间的所有数字。它会产生一个流,然后你可以链接 filter 方法,只选出偶数。到目前为止还没有进行任何计算。最后,你对生成的流调用 count 。因为 count 是一个终端操作,所以它会处理流,并返回结果 50 ,这正是1到100(包括两端)中所有偶数的个数。请注意,比较一下,如果改用 IntStream.range(1, 100) ,则结果将会是 49 个偶数,因为 range 是不包含结束值的。 构建流 希望到现在,我们已经让你相信,流对于表达数据处理查询是非常强大而有用的。到目前为止,你已经能够使用 stream 方法从集合生成流了。此外,我们还介绍了如何根据数值范围创建数值流。但创建流的方法还有许多!本节将介绍如何从值序列、数组、文件来创建流,甚至由生成函数来创建无限流! 由值创建流 你可以使用静态方法 Stream.of ,通过显式值创建一个流。它可以接受任意数量的参数。例如,以下代码直接使用 Stream.of 创建了一个字符串流。然后,你可以将字符串转换为大写,再一个个打印出来: Stream<String> stream = Stream.of("Java 8 ", "Lambdas ", "In ", "Action"); stream.map(String::toUpperCase).forEach(System.out::println); 你可以使用 empty 得到一个空流,如下所示: Stream<String> emptyStream = Stream.empty(); 由数组创建流 我们可以使用静态方法 Arrays.stream 从数组创建一个流。它接受一个数组作为参数。例如,我们可以将一个原始类型 int 的数组转换成一个 IntStream ,如下所示: int[] numbers = {2, 3, 5, 7, 11, 13}; // 总和41 int sum = Arrays.stream(numbers).sum(); 由文件生成流 Java中用于处理文件等I/O操作的NIO API(非阻塞 I/O)已更新,以便利用Stream API。java.nio.file.Files 中的很多静态方法都会返回一个流。例如,一个很有用的方法是Files.lines ,它会返回一个由指定文件中的各行构成的字符串流。使用我们迄今所学的内容,我们可以用这个方法看看一个文件中有多少各不相同的词: long uniqueWords; try (Stream<String> lines = Files.lines(Paths.get(ClassLoader.getSystemResource("data.txt").toURI()), Charset.defaultCharset())) { uniqueWords = lines.flatMap(line -> Arrays.stream(line.split(" "))) .distinct() .count(); System.out.println("uniqueWords:" + uniqueWords); } catch (IOException e) { e.fillInStackTrace(); } catch (URISyntaxException e) { e.printStackTrace(); } 你可以使用 Files.lines 得到一个流,其中的每个元素都是给定文件中的一行。然后,你可以对 line 调用 split 方法将行拆分成单词。应该注意的是,你该如何使用 flatMap 产生一个扁平的单词流,而不是给每一行生成一个单词流。最后,把 distinct 和 count 方法链接起来,数数流中有多少各不相同的单词。 由函数生成流:创建无限流 Stream API提供了两个静态方法来从函数生成流: Stream.iterate 和 Stream.generate 。这两个操作可以创建所谓的无限流:不像从固定集合创建的流那样有固定大小的流。由 iterate和 generate 产生的流会用给定的函数按需创建值,因此可以无穷无尽地计算下去!一般来说,应该使用 limit(n) 来对这种流加以限制,以避免打印无穷多个值。 1.迭代 我们先来看一个 iterate 的简单例子,然后再解释: Stream.iterate(0, n -> n + 2) .limit(10) .forEach(System.out::println); iterate 方法接受一个初始值(在这里是 0 ),还有一个依次应用在每个产生的新值上的Lambda( UnaryOperator 类型)。这里,我们使用Lambda n -> n + 2 ,返回的是前一个元素加上2。因此,iterate方法生成了一个所有正偶数的流:流的第一个元素是初始值 0 。然后加上 2 来生成新的值 2 ,再加上 2 来得到新的值 4 ,以此类推。这种 iterate 操作基本上是顺序的,因为结果取决于前一次应用。请注意,此操作将生成一个无限流——这个流没有结尾,因为值是按需计算的,可以永远计算下去。我们说这个流是无界的。正如我们前面所讨论的,这是流和集合之间的一个关键区别。我们使用limit方法来显式限制流的大小。这里只选择了前10个偶数。然后可以调用 forEach 终端操作来消费流,并分别打印每个元素。 2.生成 与 iterate 方法类似, generate 方法也可让你按需生成一个无限流。但 generate 不是依次对每个新生成的值应用函数的。它接受一个 Supplier 类型的Lambda提供新的值。我们先来看一个简单的用法: Stream.generate(Math::random) .limit(5) .forEach(System.out::println); 这段代码将生成一个流,其中有五个0到1之间的随机双精度数。例如,运行一次得到了下面的结果: 0.8404010101858976 0.03607897810804739 0.025199243727344833 0.8368092999566692 0.14685668895309267 Math.Random 静态方法被用作新值生成器。同样,你可以用 limit 方法显式限制流的大小,否则流将会无限长。 你可能想知道, generate 方法还有什么用途。我们使用的供应源(指向 Math.random 的方法引用)是无状态的:它不会在任何地方记录任何值,以备以后计算使用。但供应源不一定是无状态的。你可以创建存储状态的供应源,它可以修改状态,并在为流生成下一个值时使用。 我们在这个例子中会使用 IntStream 说明避免装箱操作的代码。 IntStream 的 generate 方法会接受一个 IntSupplier ,而不是 Supplier 。例如,可以这样来生成一个全是1的无限流: IntStream ones = IntStream.generate(() -> 1); 还记得第三章的笔记中,Lambda允许你创建函数式接口的实例,只要直接内联提供方法的实现就可以。你也可以像下面这样,通过实现 IntSupplier 接口中定义的 getAsInt 方法显式传递一个对象(虽然这看起来是无缘无故地绕圈子,也请你耐心看): IntStream twos = IntStream.generate(new IntSupplier(){ @Override public int getAsInt(){ return 2; } }); generate 方法将使用给定的供应源,并反复调用 getAsInt 方法,而这个方法总是返回 2 。但这里使用的匿名类和Lambda的区别在于,匿名类可以通过字段定义状态,而状态又可以用getAsInt 方法来修改。这是一个副作用的例子。我们迄今见过的所有Lambda都是没有副作用的;它们没有改变任何状态。 总结 这一章的东西很多,收获也很多!现在你可以更高效地处理集合了。事实上,流让你可以简洁地表达复杂的数据处理查询。此外,流可以透明地并行化。以下是我们应从本章中学到的关键概念。这一章的读书笔记中,我们学习和了解到了: Streams API可以表达复杂的数据处理查询。 你可以使用 filter 、 distinct 、 skip 和 limit 对流做筛选和切片。 你可以使用 map 和 flatMap 提取或转换流中的元素。 你可以使用 findFirst 和 findAny 方法查找流中的元素。你可以用 allMatch、noneMatch 和 anyMatch 方法让流匹配给定的谓词。 这些方法都利用了短路:找到结果就立即停止计算;没有必要处理整个流。 你可以利用 reduce 方法将流中所有的元素迭代合并成一个结果,例如求和或查找最大元素。 filter 和 map 等操作是无状态的,它们并不存储任何状态。 reduce 等操作要存储状态才能计算出一个值。 sorted 和 distinct 等操作也要存储状态,因为它们需要把流中的所有元素缓存起来才能返回一个新的流。这种操作称为有状态操作。 流有三种基本的原始类型特化: IntStream 、 DoubleStream 和 LongStream 。它们的操作也有相应的特化。 流不仅可以从集合创建,也可从值、数组、文件以及 iterate 与 generate 等特定方法创建。 无限流是没有固定大小的流。 代码 Github: chap5 Gitee: chap5

优秀的个人博客,低调大师

我Java8还没用呢,又让我学习Java14

云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 第14版包含的JEP(Java Enhancement Proposals,Java增强提案)比12版和13版加起来还要多。在这篇文章中,我将主要讨论以下几点: 改进的switch表达式,第一次出现在Java 12和13中,在Java 14中获得了完全的支持 instanceof支持模式匹配(语言特性) NullPointerException(JVM特性) 希望你在阅读完本文后,积极地代码中实验这些功能,为Java团队提供反馈,并为Java的发展做出贡献。 一、Switch表达式 java 14 中的switch表达式将会永久存在。 在之前的发布中,switch表达式只是一个“预览”阶段的特性。我想提醒一下,“预览”阶段的特性的目的是为了收集反馈,这些特性可能会随时改变,根据反馈结果,这些特性甚至可能会被移除,但通常所有的预览特性最后都会在java中固定下来。 新的switch表达式的优点是,不再有缺省跳过行为(fall-through),更全面,而且表达式和组合形式更容易编写,因此出现bug的可能性就更低。例如,switch表达式现在可以使用箭头语法,如下所示: [var log = switch (event) { case PLAY -> "User has triggered the play button"; case STOP, PAUSE -> "User needs a break"; default -> { String message = event.toString(); LocalDateTime now = LocalDateTime.now(); yield "Unknown event " + message + " logged on " + now; } };]() 二、文本块 Java 13引入的一个预览功能是文本块。有了文本块,多行的字符串字面量就很容易编写了。这个功能在Java 14中进行第二次预览,而且发生了一些变化。例如,多行文本的格式化可能需要编写许多字符串连接操作和转义序列。下面的代码演示了一个HTML的例子: String html = "<HTML>" + "\n\t" + "<BODY>" + "\n\t\t" + "<H1>\"Java 14 is here!\"</H1>" + "\n\t" + "</BODY>" + "\n" + "</HTML>"; 有了文本块,就可以简化这一过程,只需使用三引号作为文本块的起始和结束标记,就能编写出更优雅的代码: String html = """ <HTML> <BODY> <H1>"Java 14 is here!"</H1> </BODY> </HTML>"""; 与普通字符串字面量相比,文本块的表达性更好。更多的内容可以参考这篇文章 (https://blogs.oracle.com/javamagazine/text-blocks-come-to-java)。 Java 14引入了两个新的转义序列。第一,可以使用新的 s 转义序列来表示一个空格。第二,可以使用反斜杠 来避免在行尾插入换行字符。这样可以很容易地在文本块中将一个很长的行分解成多行来增加可读性。 例如,现在编写多行字符串的方式如下: String literal = "Lorem ipsum dolor sit amet, consectetur adipiscing " + "elit, sed do eiusmod tempor incididunt ut labore " + "et dolore magna aliqua."; 在文本块中使用 转义序列,就可以写成这样: String text = """ Lorem ipsum dolor sit amet, consectetur adipiscing \ elit, sed do eiusmod tempor incididunt ut labore \ et dolore magna aliqua.\ """; 三、instanceof的模式匹配 Java 14引入了一个预览特性,有了它就不再需要编写先通过instanceof判断再强制转换的代码了。例如,下面的代码: if (obj instanceof Group) { Group group = (Group) obj; // use group specific methods var entries = group.getEntries(); } 利用这个预览特性可以重构为: if (obj instanceof Group group) { var entries = group.getEntries(); } 由于条件检查要求obj为Group类型,为什么还要像第一段代码那样在条件代码块中指明obj为Group类型呢?这可能会引发错误。 这种更简洁的语法可以去掉Java程序里的大多数强制类型转换。 JEP 305解释了这项改变,并给出了Joshuoa Bloch的著作《Effective Java》中的一个例子,演示了下面两种等价的写法: @Override public boolean equals(Object o) { return (o instanceof CaseInsensitiveString) && ((CaseInsensitiveString) o).s.equalsIgnoreCase(s); } 这段代码中冗余的CaseInsensitiveString强制类型转换可以去掉,转换成下面的方式: @Override public boolean equals(Object o) { return (o instanceof CaseInsensitiveString cis) && cis.s.equalsIgnoreCase(s); } 这个预览特性很值得尝试,因为它打开了通向更通用的模式匹配的大门。模式匹配的思想是为语言提供一个便捷的语法,根据特定的条件从对象中提取出组成部分。这正是instanceof操作符的用例,因为条件就是类型检查,提取操作需要调用适当的方法,或访问特定的字段。 换句话说,该预览功能仅仅是个开始,以后该功能肯定能够减少更多的代码冗余,从而降低bug发生的可能性。 四、Record 另一个预览功能就是record。与前面介绍的其他预览功能一样,这个预览功能也顺应了减少Java冗余代码的趋势,能帮助开发者写出更精准的代码。Record主要用于特定领域的类,它的位移功能就是存储数据,而没有任何自定义的行为。 我们开门见山,举一个最简单的领域类的例子:BankTransaction,它表示一次交易,包含三个字段:日期,金额,以及描述。定义类的时候需要考虑多个方面: 构造器 getter方法 toString() hashCode()和equals() 这些部分的代码通常由IDE自动生成,而且会占用很大篇幅。下面是生成的完整的BankTransaction类: public class BankTransaction { private final LocalDate date; private final double amount; private final String description; public BankTransaction(final LocalDate date, final double amount, final String description) { this.date = date; this.amount = amount; this.description = description; } public LocalDate date() { return date; } public double amount() { return amount; } public String description() { return description; } @Override public String toString() { return "BankTransaction{" + "date=" + date + ", amount=" + amount + ", description='" + description + '\'' + '}'; } @Override public boolean equals(Object o) { if (this == o) return true; if (o == null || getClass() != o.getClass()) return false; BankTransaction that = (BankTransaction) o; return Double.compare(that.amount, amount) == 0 && date.equals(that.date) && description.equals(that.description); } @Override public int hashCode() { return Objects.hash(date, amount, description); } } Java 14提供了一种方法可以解决这种冗余,可以更清晰地表达目的:这个类的唯一目的就是将数据整合在一起。Record会提供equals、hashCode和toString方法的实现。因此,BankTransaction类可以重构如下: public record BankTransaction(LocalDate date, double amount, String description) {} 通过record,可以“自动”地得到equals,hashCode和toString的实现,还有构造器和getter方法。 要想尝试这个例子,需要用preview标志编译该文件: javac --enable-preview --release 14 BankTransaction.java record的字段隐含为final。因此,record的字段不能被重新赋值。但要注意的是,这并不代表整个record是不可变的,保存在字段中的对象可以是可变的。 请继续关注该功能。从培养新一代的Java开发者的视角来看,Record也很有意思。例如,如果你要培养初级开发者,那么record应该什么时候讲呢?是在讲OOP之前还是之后? 五、NullPointerException 一些人认为,抛出NullPointerException异常应该当做新的“Hello World”程序来看待,因为NullPointerException是早晚会遇到的。玩笑归玩笑,这个异常的确会造成困扰,因为它经常出现在生产环境的日志中,会导致调试非常困难,因为它并不会显示原始的代码。例如,如下代码: var name = user.getLocation().getCity().getName(); 在Java 14之前,你可能会得到如下的错误: Exception in thread "main" java.lang.NullPointerException at NullPointerExample.main(NullPointerExample.java:5) 不幸的是,如果在第5行是一个包含了多个方法调用的赋值语句(如getLocation()和getCity()),那么任何一个都可能会返回null。实际上,变量user也可能是null。因此,无法判断是谁导致了NullPointerException。 在Java 14中,新的JVM特性可以显示更详细的诊断信息: Exception in thread "main" java.lang.NullPointerException: Cannot invoke "Location.getCity()" because the return value of "User.getLocation()" is null at NullPointerExample.main(NullPointerExample.java:5) 该消息包含两个明确的组成部分 后果:Location.getCity()无法被调用 原因:User.getLocation()的返回值为null 增强版本的诊断信息只有在使用下述标志运行Java时才有效: -XX:+ShowCodeDetailsInExceptionMessages 下面是个例子: java -XX:+ShowCodeDetailsInExceptionMessages NullPointerExample 在以后的版本中,该选项可能会成为默认。 这项改进不仅对于方法调用有效,其他可能会导致NullPointerException的地方也有效,包括字段访问、数组访问、赋值等。 六、总结 Java 14提供了几个新的预览版语言特性和更新,能很好地帮助开发者完成日常工作。Java 14还引入了record,这是一种创建精确数据类的新方法。此外,NullPointerException的消息经过了改进,能显示明确的诊断信息。switch表达式也成了Java 14的一部分。文本块功能可以帮你处理多行字符串,这是在引入了两个新的转义序列之后的另一预览功能。还有一项改动就是JDK Flight Recorder的事件流。 可见,Java 14带来了许多创新。你应该尝试一下这些功能,然后反馈给Java的开发团队。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-03-14本文作者:Raoul-Gabriel Urma本文来自:“互联网架构师公众号”,了解相关信息可以关注“互联网架构师”

优秀的个人博客,低调大师

为什么不建议使用Date,而是使用Java8新的时间和日期API?

Java 8:新的时间和日期API 在Java 8之前,所有关于时间和日期的API都存在各种使用方面的缺陷,因此建议使用新的时间和日期API,分别从旧的时间和日期的API的缺点以及解决方法、Java 8 新的时间和日期API进行讲解。 旧的时间和日期的API的缺陷 Java 的 java.util.Date 和 java.util.Calendar 类易用性差,不支持时区,而且都不是线程安全的。 Date如果不格式化,打印出的日期可读性差。 Thu Sep 12 13:47:34 CST 2019 可以使用 SimpleDateFormat 对时间进行格式化,但 SimpleDateFormat 是线程不安全的,SimpleDateFormat 的 format 方法源码如下: private StringBuffer format(Date date, StringBuffer toAppendTo, FieldDelegate delegate) { // Convert input date to time field list calendar.setTime(date); boolean useDateFormatSymbols = useDateFormatSymbols(); for (int i = 0; i < compiledPattern.length; ) { int tag = compiledPattern[i] >>> 8; int count = compiledPattern[i++] & 0xff; if (count == 255) { count = compiledPattern[i++] << 16; count |= compiledPattern[i++]; } switch (tag) { case TAG_QUOTE_ASCII_CHAR: toAppendTo.append((char)count); break; case TAG_QUOTE_CHARS: toAppendTo.append(compiledPattern, i, count); i += count; break; default: subFormat(tag, count, delegate, toAppendTo, useDateFormatSymbols); break; } } return toAppendTo; } 其中 calendar 是共享变量,并且这个共享变量没有做线程安全控制。当多个线程同时使用相同的 SimpleDateFormat 对象【如用static修饰的 SimpleDateFormat 】调用format方法时,多个线程会同时调用 calendar.setTime 方法,可能一个线程刚设置好 time 值另外的一个线程马上把设置的 time 值给修改了导致返回的格式化时间可能是错误的。 在多并发情况下使用 SimpleDateFormat 需注意。 SimpleDateFormat 除了 format 是线程不安全以外,parse 方法也是线程不安全的。parse 方法实际调用 alb.establish(calendar).getTime() 方法来解析,alb.establish(calendar) 方法里主要完成了 重置日期对象cal的属性值 使用calb中中属性设置cal 返回设置好的cal对象 但是这三步不是原子操作,导致解析出来的时间可以是错误的。 Date对时间处理比较麻烦,比如想获取某年、某月、某星期,以及 n 天以后的时间,如果用Date来处理的话真是太难了,并且 Date 类的 getYear、getMonth 这些方法都被弃用了。 多线程并发如何保证线程安全 避免线程之间共享一个 SimpleDateFormat 对象,每个线程使用时都创建一次 SimpleDateFormat 对象 => 创建和销毁对象的开销大 对使用 format 和 parse 方法的地方进行加锁 => 线程阻塞性能差 使用 ThreadLocal 保证每个线程最多只创建一次 SimpleDateFormat 对象 => 较好的方法 Java 8 新的时间和日期API Java 8的日期和时间类包含 LocalDate、LocalTime、Instant、Duration 以及 Period,这些类都包含在 java.time 包中,Java 8 新的时间API的使用方式,包括创建、格式化、解析、计算、修改,下面我们看下如何去使用。 LocalDate 只会获取年月日 // 创建 LocalDate // 获取当前年月日 LocalDate localDate = LocalDate.now(); // 构造指定的年月日 LocalDate localDate1 = LocalDate.of(2019, 9, 12); // 获取年、月、日、星期几 int year = localDate.getYear(); int year1 = localDate.get(ChronoField.YEAR); Month month = localDate.getMonth(); int month1 = localDate.get(ChronoField.MONTH_OF_YEAR); int day = localDate.getDayOfMonth(); int day1 = localDate.get(ChronoField.DAY_OF_MONTH); DayOfWeek dayOfWeek = localDate.getDayOfWeek(); int dayOfWeek1 = localDate.get(ChronoField.DAY_OF_WEEK); LocalTime 只会获取时分秒 // 创建 LocalTime LocalTime localTime = LocalTime.of(14, 14, 14); LocalTime localTime1 = LocalTime.now(); // 获取小时 int hour = localTime.getHour(); int hour1 = localTime.get(ChronoField.HOUR_OF_DAY); // 获取分 int minute = localTime.getMinute(); int minute1 = localTime.get(ChronoField.MINUTE_OF_HOUR); // 获取秒 int second = localTime.getMinute(); int second1 = localTime.get(ChronoField.SECOND_OF_MINUTE); LocalDateTime 获取年月日时分秒,相当于 LocalDate + LocalTime // 创建 LocalDateTime LocalDateTime localDateTime = LocalDateTime.now(); LocalDateTime localDateTime1 = LocalDateTime.of(2019, Month.SEPTEMBER, 10, 14, 46, 56); LocalDateTime localDateTime2 = LocalDateTime.of(localDate, localTime); LocalDateTime localDateTime3 = localDate.atTime(localTime); LocalDateTime localDateTime4 = localTime.atDate(localDate); // 获取LocalDate LocalDate localDate2 = localDateTime.toLocalDate(); // 获取LocalTime LocalTime localTime2 = localDateTime.toLocalTime(); Instant 获取秒数,用于表示一个时间戳(精确到纳秒) 如果只是为了获取秒数或者毫秒数,可以使用 System.currentTimeMillis()。 // 创建Instant对象 Instant instant = Instant.now(); // 获取秒数 long currentSecond = instant.getEpochSecond(); // 获取毫秒数 long currentMilli = instant.toEpochMilli(); Duration 表示一个时间段 // Duration.between()方法创建 Duration 对象 LocalDateTime from = LocalDateTime.of(2017, Month.JANUARY, 1, 00, 0, 0); // 2017-01-01 00:00:00 LocalDateTime to = LocalDateTime.of(2019, Month.SEPTEMBER, 12, 14, 28, 0); // 2019-09-15 14:28:00 Duration duration = Duration.between(from, to); // 表示从 from 到 to 这段时间 long days = duration.toDays(); // 这段时间的总天数 long hours = duration.toHours(); // 这段时间的小时数 long minutes = duration.toMinutes(); // 这段时间的分钟数 long seconds = duration.getSeconds(); // 这段时间的秒数 long milliSeconds = duration.toMillis(); // 这段时间的毫秒数 long nanoSeconds = duration.toNanos(); // 这段时间的纳秒数 修改 LocalDate、LocalTime、LocalDateTime、Instant。 LocalDate、LocalTime、LocalDateTime、Instant 为不可变对象,修改这些对象对象会返回一个副本。 增加、减少年数、月数、天数等,以LocalDateTime为例: LocalDateTime localDateTime = LocalDateTime.of(2019, Month.SEPTEMBER, 12, 14, 32, 0); // 增加一年 localDateTime = localDateTime.plusYears(1); localDateTime = localDateTime.plus(1, ChronoUnit.YEARS); // 减少一个月 localDateTime = localDateTime.minusMonths(1); localDateTime = localDateTime.minus(1, ChronoUnit.MONTHS); // 通过with修改某些值 // 修改年为2020 localDateTime = localDateTime.withYear(2020); localDateTime = localDateTime.with(ChronoField.YEAR, 2020); // 时间计算 // 获取该年的第一天 LocalDate localDate = LocalDate.now(); LocalDate localDate1 = localDate.with(firstDayOfYear()); TemporalAdjusters 包含许多静态方法,可以直接调用,以下列举一些: 方法名 描述 dayOfWeekInMonth 返回同一个月中每周的第几天 firstDayOfMonth 返回当月的第一天 firstDayOfNextMonth 返回下月的第一天 firstDayOfNextYear 返回下一年的第一天 firstDayOfYear 返回本年的第一天 firstInMonth 返回同一个月中第一个星期几 lastDayOfMonth 返回当月的最后一天 lastDayOfNextMonth 返回下月的最后一天 lastDayOfNextYear 返回下一年的最后一天 lastDayOfYear 返回本年的最后一天 lastInMonth 返回同一个月中最后一个星期几 next / previous 返回后一个/前一个给定的星期几 nextOrSame / previousOrSame 返回后一个/前一个给定的星期几,如果这个值满足条件,直接返回 格式化时间 LocalDate localDate = LocalDate.of(2019, 9, 12); String s1 = localDate.format(DateTimeFormatter.BASIC_ISO_DATE); String s2 = localDate.format(DateTimeFormatter.ISO_LOCAL_DATE); // 自定义格式化 DateTimeFormatter dateTimeFormatter = DateTimeFormatter.ofPattern("yyyy-MM-dd HH:mm:ss"); String s3 = localDate.format(dateTimeFormatter); 解析时间 LocalDate localDate1 = LocalDate.parse("20190912", DateTimeFormatter.BASIC_ISO_DATE); LocalDate localDate2 = LocalDate.parse("2019-09-12", DateTimeFormatter.ISO_LOCAL_DATE); 总结 和 SimpleDateFormat 相比,DateTimeFormatter 是线程安全的。 Instant 的精确度更高,可以精确到纳秒级。 Duration 可以便捷得到时间段内的天数、小时数等。 LocalDateTime 能够快速地获取年、月、日、下一月等。 TemporalAdjusters 类中包含许多常用的静态方法,避免自己编写工具类。

优秀的个人博客,低调大师

Java8 的 Stream API 性能究竟如何?今天我们来好好测验一把

作者:Carpenter Lee github.com/CarpenterLee/JavaLambdaInternals Stream Performance 已经对 Stream API 的用法鼓吹够多了,用起简洁直观,但性能到底怎么样呢?会不会有很高的性能损失?本节我们对 Stream API 的性能一探究竟。 为保证测试结果真实可信,我们将 JVM 运行在-server模式下,测试数据在 GB 量级,测试机器采用常见的商用服务器,配置如下: OS CentOS 6.7 x86_64 CPU Intel Xeon X5675, 12M Cache 3.06 GHz, 6 Cores 12 Threads 内存 96GB JDK java version 1.8.0_91, Java HotSpot(TM) 64-Bit Server VM 测试方法和测试数据 性能测试并不是容易的事,Java 性能测试更费劲,因为虚拟机对性能的影响很大,JVM 对性能的影响有两方面: GC 的影响。GC 的行为是 Java 中很不好控制的一块,为增加确定性,我们手动指定使用 CMS 收集器,并使用 10GB 固定大小的堆内存。具体到 JVM 参数就是-XX:+UseConcMarkSweepGC-Xms10G-Xmx10G JIT(Just-In-Time) 即时编译技术。即时编译技术会将热点代码在 JVM 运行的过程中编译成本地代码,测试时我们会先对程序预热,触发对测试函数的即时编译。相关的 JVM 参数是-XX:CompileThreshold=10000。 Stream 并行执行时用到ForkJoinPool.commonPool()得到的线程池,为控制并行度我们使用 Linux 的taskset命令指定 JVM 可用的核数。 测试数据由程序随机生成。为防止一次测试带来的抖动,测试 4 次求出平均时间作为运行时间。 实验一 基本类型迭代 测试内容:找出整型数组中的最小值。对比 for 循环外部迭代和 Stream API 内部迭代性能。 测试程序 IntTest,测试结果如下图: 图中展示的是 for 循环外部迭代耗时为基准的时间比值。分析如下: 对于基本类型 Stream 串行迭代的性能开销明显高于外部迭代开销(两倍); Stream 并行迭代的性能比串行迭代和外部迭代都好。 并行迭代性能跟可利用的核数有关,上图中的并行迭代使用了全部 12 个核,为考察使用核数对性能的影响,我们专门测试了不同核数下的 Stream 并行迭代效果: 分析,对于基本类型: 使用 Stream 并行 API 在单核情况下性能很差,比 Stream 串行 API 的性能还差; 随着使用核数的增加,Stream 并行效果逐渐变好,比使用 for 循环外部迭代的性能还好。 以上两个测试说明,对于基本类型的简单迭代,Stream 串行迭代性能更差,但多核情况下 Stream 迭代时性能较好。 实验二 对象迭代 再来看对象的迭代效果。 测试内容:找出字符串列表中最小的元素(自然顺序),对比 for 循环外部迭代和 Stream API 内部迭代性能。 测试程序 StringTest,测试结果如下图: 结果分析如下: 对于对象类型 Stream 串行迭代的性能开销仍然高于外部迭代开销(1.5 倍),但差距没有基本类型那么大。 Stream 并行迭代的性能比串行迭代和外部迭代都好。 再来单独考察 Stream 并行迭代效果: 分析,对于对象类型: 使用 Stream 并行 API 在单核情况下性能比 for 循环外部迭代差; 随着使用核数的增加,Stream 并行效果逐渐变好,多核带来的效果明显。 以上两个测试说明,对于对象类型的简单迭代,Stream 串行迭代性能更差,但多核情况下 Stream 迭代时性能较好。 实验三 复杂对象归约 从实验一、二的结果来看,Stream 串行执行的效果都比外部迭代差(很多),是不是说明 Stream 真的不行了?先别下结论,我们再来考察一下更复杂的操作。 测试内容:给定订单列表,统计每个用户的总交易额。对比使用外部迭代手动实现和 Stream API 之间的性能。 我们将订单简化为<userName,price,timeStamp>构成的元组,并用Order对象来表示。测试程序 ReductionTest,测试结果如下图: 分析,对于复杂的归约操作: Stream API 的性能普遍好于外部手动迭代,并行 Stream 效果更佳; 再来考察并行度对并行效果的影响,测试结果如下: 分析,对于复杂的归约操作: 使用 Stream 并行归约在单核情况下性能比串行归约以及手动归约都要差,简单说就是最差的; 随着使用核数的增加,Stream 并行效果逐渐变好,多核带来的效果明显。 以上两个实验说明,对于复杂的归约操作,Stream 串行归约效果好于手动归约,在多核情况下,并行归约效果更佳。我们有理由相信,对于其他复杂的操作,Stream API 也能表现出相似的性能表现。 结论 上述三个实验的结果可以总结如下: 对于简单操作,比如最简单的遍历,Stream 串行 API 性能明显差于显示迭代,但并行的 Stream API 能够发挥多核特性。 对于复杂操作,Stream 串行 API 性能可以和手动实现的效果匹敌,在并行执行时 Stream API 效果远超手动实现。 所以,如果出于性能考虑,1. 对于简单操作推荐使用外部迭代手动实现,2. 对于复杂操作,推荐使用 Stream API, 3. 在多核情况下,推荐使用并行 Stream API 来发挥多核优势,4. 单核情况下不建议使用并行 Stream API。 如果出于代码简洁性考虑,使用 Stream API 能够写出更短的代码。即使是从性能方面说,尽可能的使用 Stream API 也另外一个优势,那就是只要 Java Stream 类库做了升级优化,代码不用做任何修改就能享受到升级带来的好处。 -往期精彩 - 终于有人把 CountDownLatch,CyclicBarrier,Semaphore 说明白了! 记一次非常有意思的 SQL 优化经历! 来了来了,10个免费后台管理系统模板,接私活专用! 全干货技术公众号Java学习指南👇👇长按上方二维码关注公众号 本文分享自微信公众号 - Java学习指南(gh_85b94beaede2)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

《Java8实战》-第六章读书笔记(用流收集数据-02)

使用流收集数据 分区 分区是分组的特殊情况:由一个谓词(返回一个布尔值的函数)作为分类函数,它称分区函数。分区函数返回一个布尔值,这意味着得到的分组 Map 的键类型是 Boolean ,于是它最多可以分为两组—— true 是一组, false 是一组。例如,如果你是素食者或是请了一位素食的朋友来共进晚餐,可能会想要把菜单按照素食和非素食分开: Map<Boolean, List<Dish>> partitionedMenu = // 分区函数 menu.stream().collect(partitioningBy(Dish::isVegetarian)); 这会返回下面的 Map : {false=[Dish{name='pork'}, Dish{name='beef'}, Dish{name='chicken'}, Dish{name='prawns'}, Dish{name='salmon'}], true=[Dish{name='french fries'}, Dish{name='rice'}, Dish{name='season fruit'}, Dish{name='pizza'}]} 那么通过 Map 中键为 true 的值,就可以找出所有的素食菜肴了: List<Dish> vegetarianDishes = partitionedMenu.get(true); 请注意,用同样的分区谓词,对菜单 List 创建的流作筛选,然后把结果收集到另外一个 List中也可以获得相同的结果: List<Dish> vegetarianDishes = menu.stream().filter(Dish::isVegetarian).collect(toList()); 分区的优势 分区的好处在于保留了分区函数返回 true 或 false 的两套流元素列表。在上一个例子中,要得到非素食 Dish 的 List ,你可以使用两个筛选操作来访问 partitionedMenu 这个 Map 中 false键的值:一个利用谓词,一个利用该谓词的非。而且就像你在分组中看到的, partitioningBy工厂方法有一个重载版本,可以像下面这样传递第二个收集器: Map<Boolean, Map<Dish.Type, List<Dish>>> vegetarianDishesByType = menu.stream().collect( // 分区函数 partitioningBy(Dish::isVegetarian, // 第二个收集器 groupingBy(Dish::getType))); 这将产生一个二级 Map : {false={MEAT=[Dish{name='pork'}, Dish{name='beef'}, Dish{name='chicken'}], FISH=[Dish{name='prawns'}, Dish{name='salmon'}]}, true={OTHER=[Dish{name='french fries'}, Dish{name='rice'}, Dish{name='season fruit'}, Dish{name='pizza'}]}} 这里,对于分区产生的素食和非素食子流,分别按类型对菜肴分组,得到了一个二级 Map,和上面的类似。再举一个例子,你可以重用前面的代码来找到素食和非素食中热量最高的菜: Map<Boolean, Dish> mostCaloricPartitionedByVegetarian = menu.stream().collect( partitioningBy(Dish::isVegetarian, collectingAndThen( maxBy(comparingInt(Dish::getCalories)), Optional::get ))); 这将产生以下结果: {false=Dish{name='pork'}, true=Dish{name='pizza'}} 你可以把分区看作分组一种特殊情况。 groupingBy 和partitioningBy 收集器之间的相似之处并不止于此。 将数字按质数和非质数分区 假设你要写一个方法,它接受参数 int n,并将前n个自然数分为质数和非质数。但首先,找出能够测试某一个待测数字是否是质数的谓词会很有帮助: private static boolean isPrime(int candidate) { // 产生一个自然数范围,从2开始,直至但不包括待测数 return IntStream.range(2, candidate) // 如果待测数字不能被流中任何数字整除则返回 true .noneMatch(i -> candidate % i == 0); } 一个简单的优化是仅测试小于等于待测数平方根的因子: private static boolean isPrime(int candidate) { int candidateRoot = (int) Math.sqrt((double) candidate); return IntStream.rangeClosed(2, candidateRoot) .noneMatch(i -> candidate % i == 0); } 现在最主要的一部分工作已经做好了。为了把前n个数字分为质数和非质数,只要创建一个包含这n个数的流,用刚刚写的 isPrime 方法作为谓词,再给 partitioningBy 收集器归约就好了: private static Map<Boolean, List<Integer>> partitionPrimes(int n) { return IntStream.rangeClosed(2, n).boxed() .collect( partitioningBy(candidate -> isPrime(candidate))); } 现在我们已经讨论过了 Collectors 类的静态工厂方法能够创建的所有收集器,并介绍了使用它们的实际例子。 收集器接口 Collector 接口包含了一系列方法,为实现具体的归约操作(即收集器)提供了范本。我们已经看过了 Collector 接口中实现的许多收集器,例如 toList 或 groupingBy 。这也意味着,你可以为 Collector 接口提供自己的实现,从而自由地创建自定义归约操作。 要开始使用 Collector 接口,我们先看看本章开始时讲到的一个收集器—— toList 工厂方法,它会把流中的所有元素收集成一个 List 。我们当时说在日常工作中经常会用到这个收集器,而且它也是写起来比较直观的一个,至少理论上如此。通过仔细研究这个收集器是怎么实现的,我们可以很好地了解 Collector 接口是怎么定义的,以及它的方法所返回的函数在内部是如何为collect 方法所用的。 首先让我们在下面的列表中看看 Collector 接口的定义,它列出了接口的签名以及声明的五个方法。 public interface Collector<T, A, R> { Supplier<A> supplier(); BiConsumer<A, T> accumulator(); Function<A, R> finisher(); BinaryOperator<A> combiner(); Set<Characteristics> characteristics(); } 本列表适用以下定义。 T 是流中要收集的项目的泛型。 A 是累加器的类型,累加器是在收集过程中用于累积部分结果的对象。 R 是收集操作得到的对象(通常但并不一定是集合)的类型。 例如,你可以实现一个 ToListCollector 类,将 Stream 中的所有元素收集到一个List 里,它的签名如下: public class ToListCollector<T> implements Collector<T, List<T>, List<T>> 我们很快就会澄清,这里用于累积的对象也将是收集过程的最终结果。 理解 Collector 接口声明的方法 现在我们可以一个个来分析 Collector 接口声明的五个方法了。通过分析,你会注意到,前四个方法都会返回一个会被 collect 方法调用的函数,而第五个方法 characteristics 则提供了一系列特征,也就是一个提示列表,告诉 collect 方法在执行归约操作的时候可以应用哪些优化(比如并行化)。 1. 建立新的结果容器: supplier 方法 supplier 方法必须返回一个结果为空的 Supplier ,也就是一个无参数函数,在调用时它会创建一个空的累加器实例,供数据收集过程使用。很明显,对于将累加器本身作为结果返回的收集器,比如我们的 ToListCollector ,在对空流执行操作的时候,这个空的累加器也代表了收集过程的结果。在我们的 ToListCollector 中, supplier 返回一个空的 List ,如下所示: @Override public Supplier<List<T>> supplier() { return () -> new ArrayList<>(); } 请注意你也可以只传递一个构造函数引用: @Override public Supplier<List<T>> supplier() { return ArrayList::new; } 2. 将元素添加到结果容器: accumulator 方法 accumulator 方法会返回执行归约操作的函数。当遍历到流中第n个元素时,这个函数执行时会有两个参数:保存归约结果的累加器(已收集了流中的前 n-1 个项目),还有第n个元素本身。该函数将返回void ,因为累加器是原位更新,即函数的执行改变了它的内部状态以体现遍历的元素的效果。对于ToListCollector ,这个函数仅仅会把当前项目添加至已经遍历过的项目的列表: @Override public BiConsumer<List<T>, T> accumulator() { return (list, item) -> list.add(item); } 你也可以使用方法引用,这会更为简洁: @Override public BiConsumer<List<T>, T> accumulator() { return List::add; } 3. 对结果容器应用最终转换: finisher 方法 在遍历完流后, finisher 方法必须返回在累积过程的最后要调用的一个函数,以便将累加器对象转换为整个集合操作的最终结果。通常,就像 ToListCollector 的情况一样,累加器对象恰好符合预期的最终结果,因此无需进行转换。所以 finisher 方法只需返回 identity 函数: @Override public Function<List<T>, List<T>> finisher() { return Function.identity(); } 这三个方法已经足以对流进行循序规约。实践中的实现细节可能还要复杂一点,一方面是应为流的延迟性质,可能在collect操作之前还需完成其他中间操作的流水线,另一方面则是理论上可能要进行并行规约。 4. 合并两个结果容器: combiner 方法 四个方法中的最后一个————combiner方法会返回一个供归约操作的使用函数,它定义了对流的各个子部分进行并行处理时,各个子部分归约所得的累加器要如何合并。对于toList而言,这个方法的实现非常简单,只要把从流的第二个部分收集到的项目列表加到遍历第一部分时得到的列表后面就行了: @Override public BinaryOperator<List<T>> combiner() { return (list1, list2) -> { list1.addAll(list2); return list1; }; } 有了这第四个方法,就可以对流进行并行归约了。它会用到Java7中引入的分支/合并框架和Spliterator抽象。 5. characteristics 方法 最后一个方法—— characteristics 会返回一个不可变的 Characteristics 集合,它定义了收集器的行为——尤其是关于流是否可以并行归约,以及可以使用哪些优化的提示。Characteristics 是一个包含三个项目的枚举。 UNORDERED ——归约结果不受流中项目的遍历和累积顺序的影响。 CONCURRENT —— accumulator 函数可以从多个线程同时调用,且该收集器可以并行归约流。如果收集器没有标为 UNORDERED ,那它仅在用于无序数据源时才可以并行归约。 IDENTITY_FINISH ——这表明完成器方法返回的函数是一个恒等函数,可以跳过。这种情况下,累加器对象将会直接用作归约过程的最终结果。这也意味着,将累加器 A 不加检查地转换为结果 R 是安全的。 我们迄今开发的 ToListCollector 是 IDENTITY_FINISH 的,因为用来累积流中元素的List 已经是我们要的最终结果,用不着进一步转换了,但它并不是 UNORDERED ,因为用在有序流上的时候,我们还是希望顺序能够保留在得到的 List 中。最后,它是 CONCURRENT 的,但我们刚才说过了,仅仅在背后的数据源无序时才会并行处理。 全部融合到一起 前一小节中谈到的五个方法足够我们开发自己的 ToListCollector 了。你可以把它们都融合起来,如下面的代码清单所示。 public class ToListCollector<T> implements Collector<T, List<T>, List<T>> { @Override public Supplier<List<T>> supplier() { return ArrayList::new; } @Override public BiConsumer<List<T>, T> accumulator() { return List::add; } @Override public BinaryOperator<List<T>> combiner() { return (list1, list2) -> { list1.addAll(list2); return list1; }; } @Override public Function<List<T>, List<T>> finisher() { return Function.identity(); } @Override public Set<Characteristics> characteristics() { return Collections.unmodifiableSet(EnumSet.of(Characteristics.IDENTITY_FINISH, Characteristics.CONCURRENT)); } } 请注意,这个是实现与Collections.toList()方法并不完全相同,但区别仅仅是一些小的优化。这些优化的一个主要方面是Java API所提供的收集器在需要返回空列表时使用了 Collections.emptyList() 这个单例(singleton)。这意味着它可安全地替代原生Java,来收集菜单流中的所有 Dish 的列表: List<Dish> dishes = menuStream.collect(new ToListCollector<>()); 这个实现和标准的 List<Dish> dishes = menuStream.collect(toList()); 构造之间的其他差异在于 toList 是一个工厂,而 ToListCollector 必须用 new 来实例化。 进行自定义收集而不去实现 Collector 对于 IDENTITY_FINISH 的收集操作,还有一种方法可以得到同样的结果而无需从头实现新的 Collectors 接口。 Stream 有一个重载的 collect 方法可以接受另外三个函数—— supplier 、accumulator 和 combiner ,其语义和 Collector 接口的相应方法返回的函数完全相同。所以比如说,我们可以像下面这样把菜肴流中的项目收集到一个 List 中: List<Dish> dishes = menuStream.collect( ArrayList::new, List::add, List::addAll); 我们认为,这第二种形式虽然比前一个写法更为紧凑和简洁,却不那么易读。此外,以恰当的类来实现自己的自定义收集器有助于重用并可避免代码重复。另外值得注意的是,这第二个collect 方法不能传递任何 Characteristics ,所以它永远都是一个 IDENTITY_FINISH 和CONCURRENT 但并非 UNORDERED 的收集器。 在下一节中,我们一起来实现一个收集器的,让我们对收集器的新知识更上一层楼。你将会为一个更为复杂,但更为具体、更有说服力的用例开发自己的自定义收集器。 开发你自己的收集器以获得更好的性能 我们用 Collectors 类提供的一个方便的工厂方法创建了一个收集器,它将前n个自然数划分为质数和非质数,如下所示。 将前n个自然数按质数和非质数分区: private static Map<Boolean, List<Integer>> partitionPrimes(int n) { return IntStream.rangeClosed(2, n).boxed() .collect( partitioningBy(candidate -> isPrime(candidate))); } 当时,通过限制除数不超过被测试数的平方根,我们对最初的 isPrime 方法做了一些改进: private static boolean isPrime(int candidate) { int candidateRoot = (int) Math.sqrt((double) candidate); return IntStream.rangeClosed(2, candidateRoot) .noneMatch(i -> candidate % i == 0); } 还有没有办法来获得更好的性能呢?答案是“有”,但为此你必须开发一个自定义收集器。 仅用质数做除数 一个可能的优化是仅仅看看被测试数是不是能够被质数整除。要是除数本身都不是质数就用不着测了。所以我们可以仅仅用被测试数之前的质数来测试。然而我们目前所见的预定义收集器的问题,也就是必须自己开发一个收集器的原因在于,在收集过程中是没有办法访问部分结果的。这意味着,当测试某一个数字是否是质数的时候,你没法访问目前已经找到的其他质数的列表。 假设你有这个列表,那就可以把它传给 isPrime 方法,将方法重写如下: private static boolean isPrime(List<Integer> primes, int candidate) { return primes.stream().noneMatch(i -> candidate % i == 0); } 而且还应该应用先前的优化,仅仅用小于被测数平方根的质数来测试。因此,你需要想办法在下一个质数大于被测数平方根时立即停止测试。不幸的是,Stream API中没有这样一种方法。你可以使用 filter(p -> p <= candidateRoot) 来筛选出小于被测数平方根的质数。但 filter要处理整个流才能返回恰当的结果。如果质数和非质数的列表都非常大,这就是个问题了。你用不着这样做;你只需在质数大于被测数平方根的时候停下来就可以了。因此,我们会创建一个名为 takeWhile 的方法,给定一个排序列表和一个谓词,它会返回元素满足谓词的最长前缀: public static <A> List<A> takeWhile(List<A> list, Predicate<A> p) { int i = 0; for (A item : list) { if (!p.test(item)) { return list.subList(0, i); } i++; } return list; } 利用这个方法,你就可以优化 isPrime 方法,只用不大于被测数平方根的质数去测试了: private static boolean isPrime(List<Integer> primes, int candidate){ int candidateRoot = (int) Math.sqrt((double) candidate); return takeWhile(primes, i -> i <= candidateRoot) .stream() .noneMatch(p -> candidate % p == 0); } 请注意,这个 takeWhile 实现是即时的。理想情况下,我们会想要一个延迟求值的takeWhile ,这样就可以和 noneMatch 操作合并。不幸的是,这样的实现超出了本章的范围,你需要了解Stream API的实现才行。 有了这个新的 isPrime 方法在手,你就可以实现自己的自定义收集器了。首先要声明一个实现 Collector 接口的新类,然后要开发 Collector 接口所需的五个方法。 1. 第一步:定义 Collector 类的签名 让我们从类签名开始吧,记得 Collector 接口的定义是: public interface Collector<T, A, R> 其中 T 、 A 和 R 分别是流中元素的类型、用于累积部分结果的对象类型,以及 collect 操作最终结果的类型。这里应该收集 Integer 流,而累加器和结果类型则都是 Map>,键是 true 和 false ,值则分别是质数和非质数的 List : public class PrimeNumbersCollector implements Collector<Integer, Map<Boolean, List<Integer>>, Map<Boolean, List<Integer>>> 2. 第二步:实现归约过程 接下来,你需要实现 Collector 接口中声明的五个方法。 supplier 方法会返回一个在调用时创建累加器的函数: @Override public Supplier<Map<Boolean, List<Integer>>> supplier() { return () -> new HashMap<Boolean, List<Integer>>(2) { { put(true, new ArrayList<>()); put(false, new ArrayList<>()); } }; } 这里不但创建了累积器的Map,还为true和false两个键下面出实话了对应的空列表。在收集过程中会把质数和非指数分别添加到这里。收集器重要的方法是accumulator,因为它定义了如何收集流中元素的逻辑。这里它也是实现了前面所讲的优化的关键。现在在任何一次迭代中,都可以访问收集过程的部分结果,也就是包含迄今找到的质数的累加器: @Override public BiConsumer<Map<Boolean, List<Integer>>, Integer> accumulator() { return ((Map<Boolean, List<Integer>> acc, Integer candidate) -> acc.get(isPrime(acc.get(true), candidate)).add(candidate)); } 在这个个方法中,你调用了isPrime方法,将待测试是否为质数的数以及迄今为止找到的质数列表(也就是累积Map中true键对应的值)传递给它。这次调用的结果随后被用作获取质数或非质数列表的键,这样就可以把新的被测数添加到恰当的列表中。 3.第三步:让收集器并行工作(如果可能) 下一个方法要在并行收集时把两个部分累加器合并起来,这里,它只需要合并两个Map,即将第二个Map中质数和非质数列表中的所有数字合并到第一个Map的对应列表中就行了: @Override public BinaryOperator<Map<Boolean, List<Integer>>> combiner() { return (Map<Boolean, List<Integer>> map1, Map<Boolean, List<Integer>> map2) -> { map1.get(true).addAll(map2.get(true)); map1.get(false).addAll(map2.get(false)); return map1; }; } 请注意,实际上这个收集器是不能并行的,因为该算法本身是顺序的。这意味着永远都不会调用combiner方法,你可以把它的实现留空。为了让这个例子完整,我们还是决定实现它。 4.第四步:finisher方法和收集器的characteristics方法 最后两个方法实现都很简单。前面说过,accumulator正好就是收集器的结果,也用不着进一步转换,那么finisher方法就返回identity函数: @Override public Function<Map<Boolean, List<Integer>>, Map<Boolean, List<Integer>>> finisher() { return Function.identity(); } 就characteristics方法而言,我们已经说过,它既不是CONCURRENT也不是UNOREDERED,但却是IDENTITY_FINISH的: @Override public Set<Characteristics> characteristics() { return Collections.unmodifiableSet(EnumSet.of(Characteristics.IDENTITY_FINISH)); } 现在,你可以用这个新的自定义收集器来替代partitioningBy工厂方法创建的那个,并获得完全相同的结果了: private static Map<Boolean, List<Integer>> partitionPrimesWithCustomCollector(int n) { return IntStream.rangeClosed(2, n).boxed() .collect(new PrimeNumbersCollector()); } Map<Boolean, List<Integer>> primes = partitionPrimesWithCustomCollector(10); // {false=[4, 6, 8, 9, 10], true=[2, 3, 5, 7]} System.out.println(primes); 收集器性能比较 用partitioningBy工厂方法穿件的收集器和你刚刚开发的自定义收集器在功能上是一样的,但是我们没有实现用自定义收集器超越partitioningBy收集器性能的目标呢?现在让我们写个小程序测试一下吧: public class CollectorHarness { public static void main(String[] args) { long fastest = Long.MAX_VALUE; // 运行十次 for (int i = 0; i < 10; i++) { long start = System.nanoTime(); // 将前100万个自然数按指数和非质数区分 partitionPrimes(1_000_000); long duration = (System.nanoTime() - start) / 1_000_000; // 检查这个执行是否是最快的一个 if (duration < fastest) { fastest = duration; } System.out.println("done in " + duration); } System.out.println("Fastest execution done in " + fastest + " msecs"); } } 在因特尔I5 6200U 2.4HGz的笔记上运行得到以下的结果: done in 976 done in 1091 done in 866 done in 867 done in 760 done in 759 done in 777 done in 894 done in 765 done in 763 Fastest execution done in 759 msecs 现在把测试框架的 partitionPrimes 换成 partitionPrimesWithCustomCollector ,以便测试我们开发的自定义收集器的性能。 public class CollectorHarness { public static void main(String[] args) { excute(PrimeNumbersCollectorExample::partitionPrimesWithCustomCollector); } private static void excute(Consumer<Integer> primePartitioner) { long fastest = Long.MAX_VALUE; // 运行十次 for (int i = 0; i < 10; i++) { long start = System.nanoTime(); // 将前100万个自然数按指数和非质数区分 // partitionPrimes(1_000_000); primePartitioner.accept(1_000_000); long duration = (System.nanoTime() - start) / 1_000_000; // 检查这个执行是否是最快的一个 if (duration < fastest) { fastest = duration; } System.out.println("done in " + duration); } System.out.println("Fastest execution done in " + fastest + " msecs"); } } 现在,程序打印: done in 703 done in 649 done in 715 done in 434 done in 386 done in 403 done in 449 done in 416 done in 353 done in 405 Fastest execution done in 353 msecs 还不错!看来我们没有白费功夫开发这个自定义收集器。 总结 collect 是一个终端操作,它接受的参数是将流中元素累积到汇总结果的各种方式(称为收集器)。 预定义收集器包括将流元素归约和汇总到一个值,例如计算最小值、最大值或平均值。 预定义收集器可以用 groupingBy 对流中元素进行分组,或用 partitioningBy 进行分区。 收集器可以高效地复合起来,进行多级分组、分区和归约。 你可以实现 Collector 接口中定义的方法来开发你自己的收集器。 代码 Github:chap6 Gitee:chap6

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册