首页 文章 精选 留言 我的

精选列表

搜索[过拟合],共10002篇文章
优秀的个人博客,低调大师

App Store ipv6 审核, 包过

这次介绍下 App Store 审核的三个方法之一, ipv6转换服务, 本人亲测两次有效. 目前还是包月服务, 本月阿里云这边会开通按天的服务, 需要的小伙伴快来了解下吧 下面进入正题 : 测试ipv6网站访问http://ipv6-test.com/validate.php ECS服务器 配置ipv6本地环境(也可以偷懒不配置,我的是已经做过配置的) | V SLB负载均衡 添加ECS两台并添加访问端口(非必买产品, 有公网访问的 ipv4 地址即可) | V ipv6转换服务 转接 SLB ipv4 访问为 ipv6 并添加转换端口 (必买产品) AAAA DNS record 完成 24.......................9(显示的是ipv6地址)IPv6 web server 完成 cannot identify web serve以上两条是测试返回数据, 出现这两条即为成功 | V 域名绑定ipv4(A记录) 国内访问正(这是大前提) 域名绑定ipv6(AAAA记录) 国外访问(添加该AAAA记录, 不需要禁用ipv4, 避免影响国内线上服务, 审核完毕也不需要撤销, 不会影响国内访问, 下次审核也方便) | V 云解析付费版 DNS解析, 通过阿里国外多站点DNS进行云解析以通过长城(这个建议购买, 国外需要有dns解析) | V 测试ipv6网站访问, 用上面的ipv6测试网站, 可能加载较慢请耐心等待加载完毕(推荐测试五分钟,不出现一次错误为止) 北京秒贷网电子商务股份有限公司

优秀的个人博客,低调大师

12月15日踩过的坑

Swift3.0设置iconfont self.homeImage?.text = "\u{e60b}" CocoaPods 将gem升级为最新版本 sudo gem update --system 运行如下命令安装CocoaPods sudo gem install -n /usr/local/bin cocoapods pod setup 安装后执行如下命令查看版本 pod --version 以后要更新升级CocoaPods,执行如下命令 sudo gem update cocoapods 基本配置示范 platform :ios, '9.0' use_frameworks! target 'hangge_1358’ do pod 'Alamofire', '~> 4.0' pod 'SwiftyJSON', '~> 3.0' end pod install IconFont一般使用 第一步:将您从IconFont平台下载的字体文件(.ttf)添加到工程中; 打开Info.plist文件,增加一个新的Array类型的键,键名设置为UIAppFonts(Fonts provided by application),增加字体的文件名:“iconfont.ttf“ 第二步:使用IconFont字体: UILabel * label = [[UILabel alloc] initWithFrame:self.view.bounds]; UIFont *iconfont = [UIFont fontWithName:@"uxIconFont" size: 34]; label.font = iconfont; label.text = @"\U00003439 \U000035ad \U000035ae \U000035af \U000035eb \U000035ec"; [self.view addSubview: label]; Swift 用CocoaPods装OC库的坑 建立好桥接文件后 #import "AFNetWorking.h"之后要设置一个User Header Search Paths,否则在需要用三方库的地方是调不出来的。在target——>Build Setting里找到search Paths,双击User Header Search Paths后面的空白处,设置目录路径为${SRCROOT} ,后边选择recursive。注意不要#import <AFNetWorking/AFNetWorking.h>这样导入 Swift image使用IconFont IconFont: https://github.com/JohnWong/IconFont 引用头文件 在需要使用的地方引用头文件,或者在预编译pch文件中做全局引用: #import "TBCityIconFont.h" 设置字体名称 系统会默认加载字体名称LLIconfont,如果字体名不是这个,则需要在使用字体之前设置字体的名称。例如在AppDelegate的-application:didFinishLaunchingWithOptions:方法中添加: [TBCityIconFont setFontName:@"LLIconfont"]; 创建UIImage 使用UIImage的category方法从字体创建UIImage: [UIImage iconWithInfo:TBCityIconInfoMake(@"\U0000e601", 24, [UIColor blackColor])] Mac修改hosts sudo nano/private/etc/hosts 改状态栏颜色 1,在 Info.plist 中添加如下配置 <key>UIViewControllerBasedStatusBarAppearance</key> <false/> 2,在 General -> Deployment Info 中,将 Status Bar Style 设置成 Light。重新运行程序即可看到效果。

优秀的个人博客,低调大师

[ElasticSearch]那些年踩过的ElasticSerch坑

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/SunnyYoona/article/details/52801393 1. 索引名称错误 1.1 代码 xiaosi@Qunar:~$ curl -XPUT 'localhost:9200/Quanr/employee/1' ' > { > "first_name" : "John", > "last_name" : "Smith", > "age" : 25, > "about" : "I love to go rock climbing", > "interests": [ "sports", "music" ] > }'; {"error":{"root_cause":[{"type":"invalid_index_name_exception","reason":"Invalid index name [Quanr], must be lowercase","index":"Quanr"}],"type":"invalid_index_name_exception","reason":"Invalid index name [Quanr], must be lowercase","index":"Quanr"},"status":400}curl: (3) [globbing] nested brace in column 148 1.2 报错原因 索引名称必须小写 1.3 解决方案 xiaosi@Qunar:~/opt/elasticsearch-2.3.3$ curl -XPUT 'localhost:9200/qunar-index/employee/1' -d ' > { > "first_name" : "John", > "last_name" : "Smith", > "age" : 25, > "about" : "I love to go rock climbing", > "interests": [ "sports", "music" ] > }'; {"_index":"qunar-index","_type":"employee","_id":"1","_version":1,"_shards":{"total":2,"successful":1,"failed":0},"created":true}xiaosi@Qunar:~/opt/elasticsearch-2.3.3$ 2.使用Groovy脚本更新文档报错 2.1 代码 /** * 使用脚本更新文档 * @param client * @param index * @param type * @param id */ public static void updateByScripted(Client client, String index, String type, String id){ UpdateRequestBuilder updateRequestBuilder = client.prepareUpdate(); updateRequestBuilder.setIndex(index); updateRequestBuilder.setType(type); updateRequestBuilder.setId(id); // 脚本 Script collegeScript = new Script("ctx._source.college = \"软件学院\"", ScriptService.ScriptType.INLINE, null, null); updateRequestBuilder.setScript(collegeScript); // 更新文档 UpdateResponse response = updateRequestBuilder.get(); } 2.2 报错信息 java.lang.IllegalArgumentException: failed to execute script at org.elasticsearch.action.update.UpdateHelper.executeScript(UpdateHelper.java:257) at org.elasticsearch.action.update.UpdateHelper.prepare(UpdateHelper.java:197) at org.elasticsearch.action.update.UpdateHelper.prepare(UpdateHelper.java:80) at org.elasticsearch.action.update.TransportUpdateAction.shardOperation(TransportUpdateAction.java:174) at org.elasticsearch.action.update.TransportUpdateAction.shardOperation(TransportUpdateAction.java:168) at org.elasticsearch.action.update.TransportUpdateAction.shardOperation(TransportUpdateAction.java:66) at org.elasticsearch.action.support.single.instance.TransportInstanceSingleOperationAction$ShardTransportHandler.messageReceived(TransportInstanceSingleOperationAction.java:244) at org.elasticsearch.action.support.single.instance.TransportInstanceSingleOperationAction$ShardTransportHandler.messageReceived(TransportInstanceSingleOperationAction.java:240) at org.elasticsearch.transport.TransportRequestHandler.messageReceived(TransportRequestHandler.java:33) at org.elasticsearch.transport.RequestHandlerRegistry.processMessageReceived(RequestHandlerRegistry.java:75) at org.elasticsearch.transport.TransportService$4.doRun(TransportService.java:376) at org.elasticsearch.common.util.concurrent.AbstractRunnable.run(AbstractRunnable.java:37) at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1142) at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:617) at java.lang.Thread.run(Thread.java:745) Caused by: ScriptException[scripts of type [inline], operation [update] and lang [groovy] are disabled] at org.elasticsearch.script.ScriptService.compile(ScriptService.java:244) at org.elasticsearch.script.ScriptService.executable(ScriptService.java:442) at org.elasticsearch.action.update.UpdateHelper.executeScript(UpdateHelper.java:250) ... 14 more 2.3 报错原因 脚本默认被禁用了。https://www.elastic.co/guide/en/elasticsearch/reference/current/modules-scripting.html 2.4 解决方案 在安装目录下config文件夹找到elasticsearch.yml文件,然后添加如下配置: script.engine.groovy.inline.update: on 然后重新启动ElasticSearch
优秀的个人博客,低调大师

那些年使用Hive踩过的坑

1.概述 这个标题也是用血的教训换来的,希望对刚进入hive圈的童鞋和正在hive圈爬坑的童鞋有所帮助。打算分以下几个部分去描述: Hive的结构 Hive的基本操作 Hive Select Hive Join Hive UDF Hive的M/R 使用Hive注意点 优化及优化详情 优化总结 调优的经常手段 解决Hive问题的途径 这篇文章只是起个头,为描述其他部分做下准备。下面我赘述下Hive的结构和一些基本的操作。 2.介绍 Hive 是建立在 Hadoop 上的数据仓库基础构架。它提供了一系列的工具,可以用来进行数据提取转化加载(ETL),这是一种可以存储、查询和分析存储在 Hadoop 中的大规模数据的机制。Hive 定义了简单的类 SQL 查询语言,称为 HQL,它允许熟悉 SQL 的用户查询数据。同时,这个语言也允许熟悉 MapReduce 开发者的开发自定义的 mapper 和 reducer 来处理内建的 mapper 和 reducer 无法完成的复杂的分析工作。 首先,我来说说什么是hive(What is Hive?),请看下图: 由于是在Retina下截的屏,为避免网络原因显示不出图片,这里为也用文字描述以下。这个和介绍中描述的内容大致是一致的,Hive构建在Hadoop的HDFS和MapReduce之上,用于管理和查询结构化/非结构化数据的数据仓库。 使用HQL作为查询接口 使用HDFS作为底层存储 使用MapReduce作为执行层 那么这里不禁会引发一个疑问?Hive是如何应用的呢?请看下图: 这里集群搭建Hive时用到了HA,这个是做大数据的常识,单点问题时刻铭记,最后用HAProxy来做代理。至于想了解如何使用来完成指标计算,可以参考我写的网站日志统计案例分析与实现中关于用Hive实现计算的描述,这里不做过多的赘述。 2.1结构描述 Hive 的结构可以分为以下几部分: 用户接口:包括 CLI, Client, WUI 元数据存储。通常是存储在关系数据库如 mysql, derby 中 解释器、编译器、优化器、执行器 Hadoop:用 HDFS 进行存储,利用 MapReduce 进行计算 1、 用户接口主要有三个:CLI,Client 和 WUI。其中最常用的是 CLI,Cli 启动的时候,会同时启动一个 Hive 副本。Client 是 Hive 的客户端,用户连接至 Hive Server。在启动 Client 模式的时候,需要指出 Hive Server 所在节点,并且在该节点启动 Hive Server。 WUI 是通过浏览器访问 Hive。 2、 Hive 将元数据存储在数据库中,如 mysql、derby。Hive 中的元数据包括表的名字,表的列和分区及其属性,表的属性(是否为外部表等),表的数据所在目录等。 3、 解释器、编译器、优化器完成 HQL 查询语句从词法分析、语法分析、编译、优化以及查询计划的生成。生成的查询计划存储在 HDFS 中,并在随后有 MapReduce 调用执行。 Hive 的数据存储在 HDFS 中,大部分的查询由 MapReduce 完成(包含 * 的查询,比如 select * from tbl 不会生成 MapRedcue 任务)。 2.2Hive和普通DB的异同 Hive RDBMS 查询语句 HQL SQL 数据存储 HDFS Raw Device or Local FS 索引 1.0.0版本支持 有 执行延迟 高 低 处理数据规模 大(或海量) 小 执行 MapReduce Excutor 截止本篇文章完成时,Hive对外发布的1.0.0版本已支持索引的创建,下面引用官方部分原话: REPRO STEPS: create database skewtest; use skewtest; create table skew (id bigint, acct string) skewed by (acct) on ('CC','CH'); create index skew_indx on table skew (id) as 'org.apache.hadoop.hive.ql.index.compact.CompactIndexHandler' WITH DEFERRED REBUILD; 具体详细信息可参考链接:https://issues.apache.org/jira/browse/HIVE-5631 2.3元数据 Hive 将元数据存储在 RDBMS 中,一般常用的有MYSQL和DERBY。由于DERBY只支持单客户端登录,所以一般采用MySql来存储元数据。 注:关于如何安装配置Hive,请参考我写的Hive的安装部署。 2.4数据存储 首先,Hive 没有专门的数据存储格式,也没有为数据建立索引,用户可以非常自由的组织 Hive 中的表,只需要在创建表的时候告诉 Hive 数据中的列分隔符和行分隔符,Hive 就可以解析数据。 其次,Hive 中所有的数据都存储在 HDFS 中,Hive 中包含以下数据模型:Table,External Table,Partition,Bucket。 Hive 中的 Table 和数据库中的 Table 在概念上是类似的,每一个 Table 在 Hive 中都有一个相应的目录存储数据。例如,一个表 app,它在 HDFS 中的路径为:/ warehouse /app,其中,wh 是在 hive-site.xml 中由 ${hive.metastore.warehouse.dir} 指定的数据仓库的目录,所有的 Table 数据(不包括 External Table)都保存在这个目录中。 Partition 对应于数据库中的 Partition 列的密集索引,但是 Hive 中 Partition 的组织方式和数据库中的很不相同。在 Hive 中,表中的一个 Partition 对应于表下的一个目录,所有的 Partition 的数据都存储在对应的目录中。例如:xiaojun 表中包含 dt 和 city 两个 Partition,则对应于 dt = 20100801, ctry = US 的 HDFS 子目录为:/ warehouse /app/dt=20100801/ctry=US;对应于 dt = 20100801, ctry = CA 的 HDFS 子目录为;/ warehouse /app/dt=20100801/ctry=CA Buckets 对指定列计算 hash,根据 hash 值切分数据,目的是为了并行,每一个 Bucket 对应一个文件。将 user 列分散至 32 个 bucket,首先对 user 列的值计算 hash,对应 hash 值为 0 的 HDFS 目录为:/ warehouse /app/dt =20100801/ctry=US/part-00000;hash 值为 20 的 HDFS 目录为:/ warehouse /app/dt =20100801/ctry=US/part-00020 External Table 指向已经在 HDFS 中存在的数据,可以创建 Partition。它和 Table 在元数据的组织上是相同的,而实际数据的存储则有较大的差异。 Table (内部表)的创建过程和数据加载过程(这两个过程可以在同一个语句中完成),在加载数据的过程中,实际数据会被移动到数据仓库目录中;之后对数据对访问将会直接在数据仓库目录中完成。删除表时,表中的数据和元数据将会被同时删除。 External Table 只有一个过程,加载数据和创建表同时完成(CREATE EXTERNAL TABLE ……LOCATION),实际数据是存储在 LOCATION 后面指定的 HDFS 路径中,并不会移动到数据仓库目录中。当删除一个 External Table 时,仅删除hive的元数据,不会删除hdfs上对应的文件。 3.总结 这篇就描述到这里,其他部分后面整理好资料后在与各位分享;若有疑问可加群讨论,或是发邮件给我,我会尽我所能给予帮助,与君共勉!

优秀的个人博客,低调大师

听说过对 Go map 做 GC 吗?

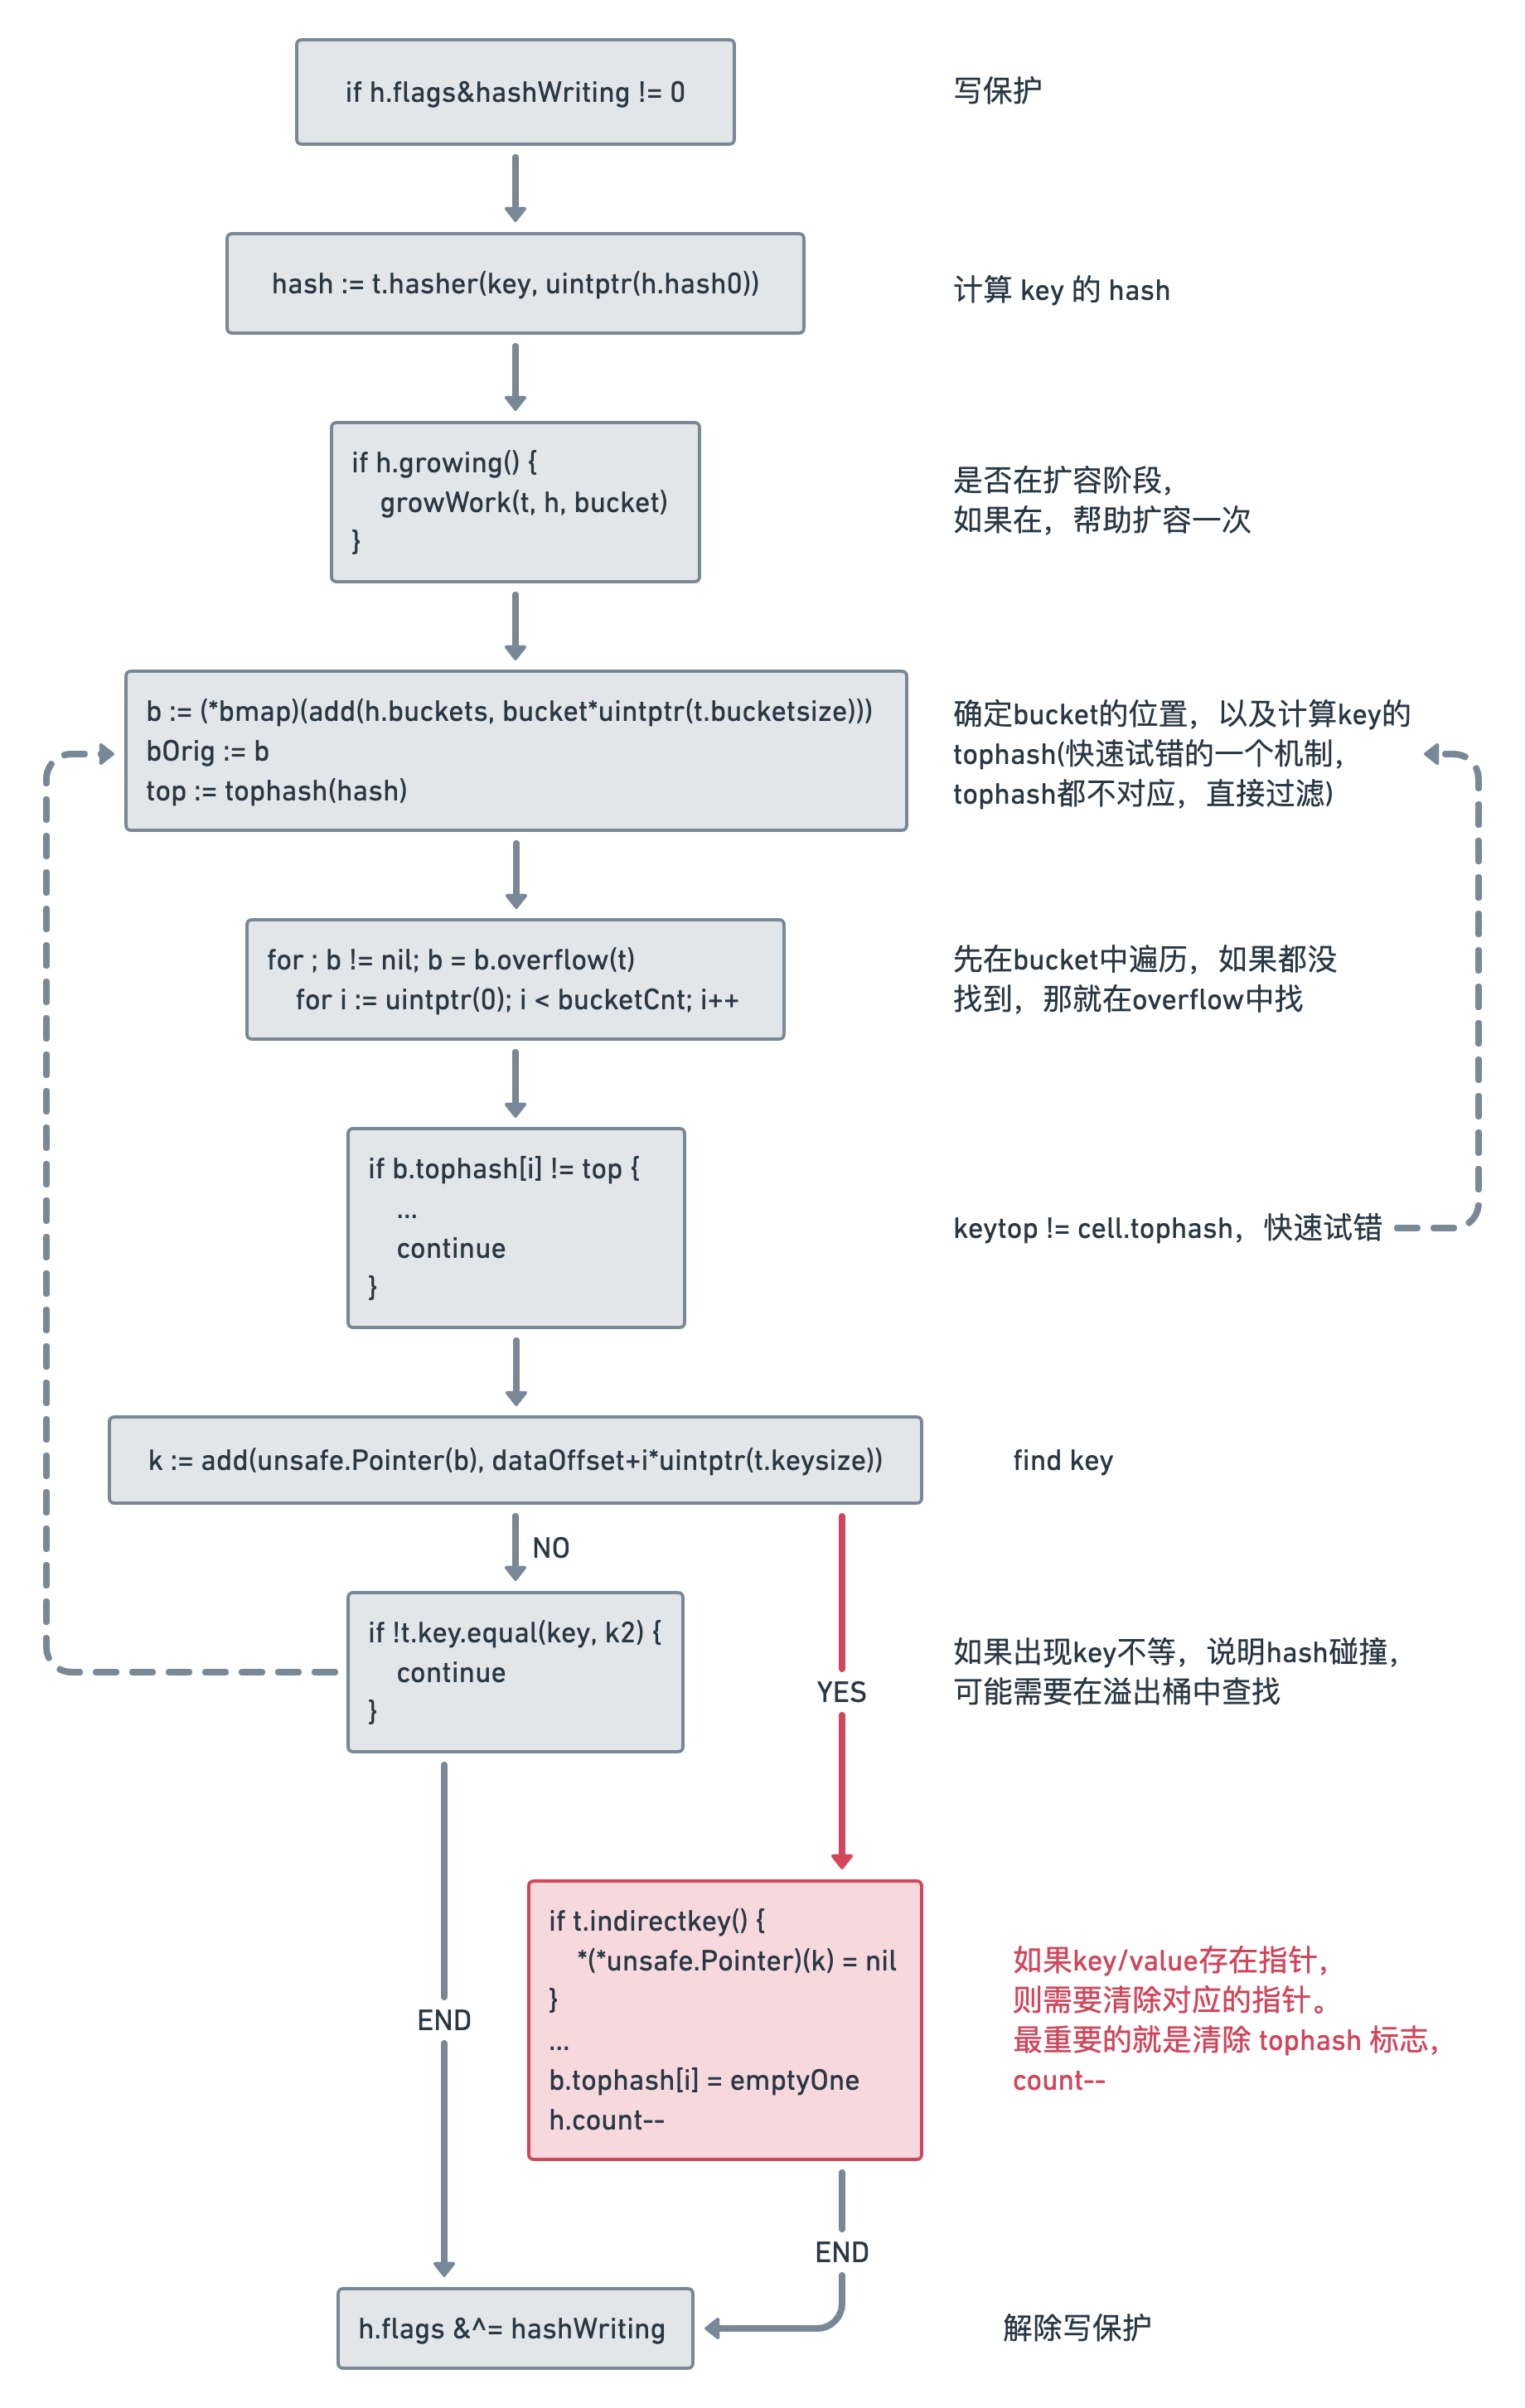
在 Golang 中的 map 结构,在删除键值对的时候,并不会真正的删除,而是标记。那么随着键值对越来越多,会不会造成大量内存浪费? 首先答案是会的,很有可能导致 OOM,而且针对这个还有一个讨论:https://github.com/golang/go/issues/20135。大致的意思就是在很大的 map 中,delete 操作没有真正释放内存而可能导致内存 OOM。 所以一般的做法:就是 重建map。而 go-zero 中内置了 safemap 的容器组件。safemap 在一定程度上可以避免这种情况发生。 那首先我们看看 go 原生提供的 map 是怎么删除的? 原生map删除 1 package main 2 3 func main() { 4 m := make(map[int]string, 9) 5 m[1] = "hello" 6 m[2] = "world" 7 m[3] = "go" 8 9 v, ok := m[1] 10 _, _ = fn(v, ok) 11 12 delete(m, 1) 13 } 14 15 func fn(v string, ok bool) (string, bool) { 16 return v, ok 17 } 测试代码如上,我们可以通过 go tool compile -S -N -l testmap.go | grep "CALL" : 0x0071 00113 (test/testmap.go:4) CALL runtime.makemap(SB) 0x0099 00153 (test/testmap.go:5) CALL runtime.mapassign_fast64(SB) 0x00ea 00234 (test/testmap.go:6) CALL runtime.mapassign_fast64(SB) 0x013b 00315 (test/testmap.go:7) CALL runtime.mapassign_fast64(SB) 0x0194 00404 (test/testmap.go:9) CALL runtime.mapaccess2_fast64(SB) 0x01f1 00497 (test/testmap.go:10) CALL "".fn(SB) 0x0214 00532 (test/testmap.go:12) CALL runtime.mapdelete_fast64(SB) 0x0230 00560 (test/testmap.go:7) CALL runtime.gcWriteBarrier(SB) 0x0241 00577 (test/testmap.go:6) CALL runtime.gcWriteBarrier(SB) 0x0252 00594 (test/testmap.go:5) CALL runtime.gcWriteBarrier(SB) 0x025c 00604 (test/testmap.go:3) CALL runtime.morestack_noctxt(SB) 执行第12行的 delete,实际执行的是 runtime.mapdelete_fast64。 这些函数的参数类型是具体的 int64,mapdelete_fast64 跟原始的 delete 操作一样的,所以我们来看看 mapdelete。 mapdelete 长图预警!!! 大致代码分析如上,具体代码就留给大家去阅读了。其实大致过程: 写保护,防止并发写 查询要删除的 key 是否存在 存在则对其标志做删除标记 count-- 所以你在大面积删除 key ,实际 map 存储的 key 是不会删除的,只是标记当前的key状态为 empty。 其实出发点,和 mysql 的标记删除类似,防止后续会有相同的 key 插入,省去了扩缩容的操作。 但是这个对有些场景是不妥的,如果开发者在未来时间内都不会再插入相同的 key ,很可能会导致 OOM。 所以针对以上情况,go-zero 开发了 safemap 。下面我们看看 safemap 是如何避免这个问题的? safemap 直接从操作 safemap 中分析为什么要这么设计: 预设一个 删除阈值,如果触发会放到一个新预设好的 newmap 中 两个 map 是一个整体,所以 key 只能留一份 所以为什么要设置两个 map 就很清楚了: dirtyOld 作为存储主体,如果 delete 操作达到阈值,则会触发迁移。 dirtyNew 作为暂存体,会在到达阈值时,存放部分 key/value 所以在迁移操作时,我们需要做的就是:将原先的 dirtyOld 清空,存储的 key/value 通过 for-range 重新存储到 dirtyNew,然后将 dirtyNew 指向 dirtyOld。 > 可能会有疑问:不是说 key/value 没有删除吗,只是标记了 tophash=empty > > 其实在 for-range 过程中,会过滤掉 tophash &lt;= emptyOne 的 key 这样就实现了不需要的 key 不会被加入到 dirtyNew,进而不会影响 dirtyOld。 这其实也就是垃圾回收的年老代和新生代的概念。 更多实现细节,可以查看源码! 项目地址 https://github.com/tal-tech/go-zero https://gitee.com/kevwan/go-zero 欢迎使用 go-zero 并 star 支持我们! 微信交流群 关注『微服务实践』公众号并点击 交流群 获取社区群二维码。

优秀的个人博客,低调大师

从未停止过的系统架构设计步伐

首先,这篇文章肯定会得罪一些人 其次,此文只代表我个人的意见,仅供参考 从分层说起 谈到系统架构的分层和系统领域边界的划分,每个架构师,每个技术经理,甚至每个程序员都有自己的一套想法。无论是怎么样的划分方案,总体的目标始终是一致的,打造一个高性能,高可用,高可扩展,高安全性的系统,甚至会附加上一大堆的专业名词,例如:高度一致性,可重用性,幂等性,兼容性 等等。对于最终用户来说,无论系统怎么样架构设计,稳定性是第一位的。假如系统三天两头打不开,报500服务器错误,程序员岂不是天天要被祭天? 从很久之前的面向过程编程模式,到现在的面向对象设计,微服务架构方案,都体现着架构设计一直在追求更加极致的设计之美。而这种美要归功于系统的分层设计,小到类的职责划分,大到系统的分布式部署。 系统为什么一定要做分层呢?至于系统领域的划分,本质上也是一种分层设计的体现思想。 分层是软件工程中一种常见的设计方式,它根据整个系统的职责链把系统逻辑上拆分为多个层,每个层都有相对明确的独立的职责,多个层通过协调提供完整的功能。至于每层负责什么职责,软件工程学并没有明确的定义,系统的设计者可以根据系统特点来具体划分,比如:最常见的三层架构设计,把整个系统划分为: UI层,主要负责用户UI的职责 业务层,主要负责业务逻辑相关职责 数据持久化层,主要负责数据的持久化,落盘操作 还有我们耳熟能详的OSI网络模型,它把整个网络划分为了七层,每层都有相对明确的职责,但是还有另外一种划分方式把网络模型划分为四层,这是根据不同职责来划分网络的典型案例。 软件设计采用分层设计算是一种工程学,它把整体系统划分为不同的层,之后采用不同的依赖方式来组织功能,带来了很多优势 每层的职责明确,而且依赖关系明确 每层都可以复用,减少了代码重复率 每层都可以相对独立的做修改,扩展等,不会影响其他层 看到不少技术经理乃至架构师一直鄙视使用三层架构的程序员,我觉得你需要反思一下。最简单的三层架构模式并非优势全无,据我所知,在快速应对中小系统开发的时候,三层架构仍然是首选。不要整天拿着所谓的DDD说事,DDD也不是银弹,简单的三层架构,甚至贫血模型开发模式也有自己的优势,更何况一些人高举DDD的“聚合根”,“值类型”等概念,其实并未真正理解其含义和设计理念,自以为看了几篇DDD的文章,就可以妄自吹嘘自己精通DDD,领域模型开发确实是好的开发理念,但是它也有自己的劣势,不是任何系统用DDD开发都是最优的,更何况那些没有实际DDD开发经验的“高层”。 系统拆分 虽然分层设计优势很明显,但是随着系统业务越来越复杂,就面临着层次划分越来越多的窘态。这也是系统发展的一个必然结果,也是单体应用的必然瓶颈。所以系统按照业务拆分是业务发展到一定阶段的结果,而并非架构师主观意愿的结果。随着子系统越来越多,部署和运维工作也随着越来越多,所以自动化的部署需求也随之出现,为了更好的实现每个系统的可扩展性,稳定性,可用性等软性需求,kubernetes也越来越受到追捧。 其实系统拆分是一个很泛的概念,业界并没有实际的拆分原则,只是大部分人喜欢以业务为维度来进行拆分,实际证明按照业务拆分也是正确的。被拆分的不止是业务逻辑的代码,包括业务的数据库等也会被彻底物理隔离,因为只有这样才可以做到真正的高内聚,低耦合。 架构设计 当每个服务都可以根据自身业务量来进行横向扩展或者纵向扩展的时候,就可以体现出微服务的优势。而具体的系统架构设计决定着这个服务是否可以灵活的应对多变的业务需求,说到底,我们又回到怎样设计单体系统的话题上来了。其实设计好单体架构并不比分布式系统容易,一个好的单体系统同样也需要设计模式,数据结构,算法和抽象。前面所说的三层架构是其中一种选择。 系统的设计离不开业务,任何脱离业务的系统架构设计都是耍流氓。设计一个灵活的系统需要对业务的变化点进行正确的识别,然后进行抽象,比如:注册新用户的时候,需要给用户发送短信欢迎语,其实这是一个业务的变化点,因为产品不知道哪天会有一个发送邮件的欢迎语,甚至如果关注了公众号,会发送公众号消息。 三层架构在应对大型系统的时候之所以力不从心,是因为他并不是按照业务的对象进行分层抽象,而现在流行的DDD更加贴近现实世界中的抽象层次,所以DDD在大型系统中更加游刃有余。其中有一种六边形的架构理论值得我们学习。 六边形架构设计 六边形架构设计本质上还是一种分层架构设计方案,但是它不同于传统的三层架构,传统的三层架构自上而下逐层依赖,而六边形架构设计采用了内部外部的分层思想,它把业务的领域模型最为最核心的概念,然后扩展出外层的应用层,其实领域模型和应用层就是系统的业务层。 内部通过端口和外部系统通信,端口代表了一定协议,以API呈现。一个端口可能对应多个外部系统,不同的外部系统需要使用不同的适配器,适配器负责对协议进行转换。这样就使得应用程序能够以一致的方式被用户、程序、自动化测试、批处理脚本所驱动,并且,可以在与实际运行的设备和数据库相隔离的情况下开发和测试。 领域层:领域层是业务最核心的概念,包括领域对象的状态,规则,行为等。 应用层:定义了系统可以完成的功能,它通过协调多个领域对象来完成业务逻辑,这一层会包含事务的管理。 输入端口:用于接收外部系统的输入,可以认为它是暴露在外边的接口 输出端口:为系统获取外部服务提供支持,如获取持久化状态、对结果进行持久化,或者发布领域状态的变更通知(如领域事件)。系统作为服务的消费者获取服务是对外的接口(数据库、缓存、消息队列、RPC调用)等都可以看成是输入端口。 六边形理论从一开始就强调把中心放在业务逻辑上,外部的端口存在可变性,可替换性,这是依赖倒置规则的体现。下面就以用户注册业务来模拟一下 首先为核心的用户领域模型,以及模型的行为,其中持久化数据的行为依赖于接口 //用户领域对象 public class UserDomain { public int UserId { get; set; } public string UserName { get; set; } //注册新用户行为 public int UpdateName(string name) { IUserDomainRepositoryAdpater resAdapter = ioc方式获取注入的实例/或者其他渠道; return resAdapter.UpdateUserName(this.UserId,name); } } 然后是用户的应用,其中给用户发送欢迎语的行为依赖于接口 public class UserApplication { public int UpdateuserName(int userId,string name) { UserDomain user = new UserDomain() { UserId = userId, UserName = name }; user.UpdateName("新用户名"); ISendMessageAdpater sendMessage = ioc获取实例; sendMessage.SendMessage(userId.ToString(),"新用户注册"); } } //发送消息的适配器 public interface ISendMessageAdpater { //给用户发送消息 void SendMessage(string user,string content); } 到此为止,用户核心业务已经编写完毕,可以看到,其中业务的变化点都是依赖于接口,对应到六边形理论中,对应的就是各种adapter,接下来只要把各种适配器实现,然后注入(安装)到系统,整个系统就可以运行起来了。 //外部的adapter的实现 public class UserDomainRepositoryAdpater: IUserDomainRepositoryAdpater { public int UpdateUserName(int userId, string name) { //具体的sql执行过程 } } public class SendEmailAdpater: ISendMessageAdpater { //给用户发送邮件 public void SendMessage(string user, string content) { } } public class SendPhoneCodeAdpater : ISendMessageAdpater { //给用户发送短信 public void SendMessage(string user, string content) { } } 不难看出,六边形理论其实是抽象业务模型+面型接口编程的有效组合,当然真正的项目中还有可能涉及到很多设计模式相关的设计理念。对应到平时开发中,mvc的controller层已然变成六边形的输入adapter的一种,它负责请求业务提供的接口来实现系统业务。

优秀的个人博客,低调大师

Java内存模型,你有认真了解过吗

从 PC 内存架构到 Java 内存模型 你知道 Java 内存模型 JMM 吗?那你知道它的三大特性吗?Java 是如何解决指令重排问题的?既然CPU有缓存一致性协议(MESI),为什么 JMM 还需要volatile关键字? 带着问题,尤其是面试问题的学习才是最高效的。加油,奥利给! 文章收录在 GitHub JavaKeeper ,N线互联网开发必备技能兵器谱 前两天看到同学和我显摆他们公司配的电脑多好多好,我默默打开了自己的电脑, 酷睿 i7-4770 ,也不是不够用嘛,4 核 8 线程的 CPU,也是杠杠的。 扯这玩意干啥,Em~~~~ 介绍 Java 内存模型之前,先温习下计算机硬件内存模型 硬件内存架构 计算机在执行程序的时候,每条指令都是在 CPU 中执行的,而执行的时候,又免不了要和数据打交道。而计算机上面的数据,是存放在主存当中的,也就是计算机的物理内存。 计算机硬件架构简易图: 我们以多核 CPU 为例,每个CPU 核都包含一组 「CPU 寄存器」,这些寄存器本质上是在 CPU 内存中。CPU 在这些寄存器上执行操作的速度要比在主内存(RAM)中执行的速度快得多。 因为CPU速率高, 内存速率慢,为了让存储体系可以跟上CPU的速度,所以中间又加上 Cache 层,就是我们说的 「CPU 高速缓存」。 CPU多级缓存 由于CPU的运算速度远远超越了1级缓存的数据IO能力,CPU厂商又引入了多级的缓存结构。通常L1、L2 是每个CPU 核有一个,L3 是多个核共用一个。 Cache Line Cache又是由很多个「缓存行」(Cache line) 组成的。Cache line 是 Cache 和 RAM 交换数据的最小单位。 Cache 存储数据是固定大小为单位的,称为一个Cache entry,这个单位称为Cache line或Cache block。给定Cache 容量大小和 Cache line size 的情况下,它能存储的条目个数(number of cache entries)就是固定的。因为Cache 是固定大小的,所以它从主内存获取数据也是固定大小。对于X86来讲,是 64Bytes。对于ARM来讲,较旧的架构的Cache line是32Bytes,但一次内存访存只访问一半的数据也不太合适,所以它经常是一次填两个 Cache line,叫做 double fill。 缓存的工作原理 这里的缓存的工作原理和我们项目中用 memcached、redis 做常用数据的缓存层是一个道理。 当 CPU 要读取一个数据时,首先从缓存中查找,如果找到就立即读取并送给CPU处理;如果没有找到,就去内存中读取并送给 CPU 处理,同时把这个数据所在的数据块(就是我们上边说的 Cache block)调入缓存中,即把临近的共 64 Byte 的数据也一同载入,因为临近的数据在将来被访问的可能性更大,可以使得以后对整块数据的读取都从缓存中进行,不必再调用内存。 这就增加了CPU读取缓存的命中率(Cache hit)了。 计算机层级存储 计算机存储系统是有层次结构的,类似一个金字塔,顶层的寄存器读写速度较高,但是空间较小。底层的读写速度较低,但是空间较大 缓存一致性 既然每个核中都有单独的缓存,那我的 4 核 8 线程 CPU 处理主内存数据的时候,不就会出现数据不一致问题了吗? 为了解决这个问题,先后有过两种方法:总线锁机制和缓存锁机制。 总线锁就是使用 CPU 提供的一个LOCK#信号,当一个处理器在总线上输出此信号,其他处理器的请求将被阻塞,那么该处理器就可以独占共享锁。这样就保证了数据一致性。 但是总线锁开销太大,我们需要控制锁的粒度,所以又有了缓存锁,核心就是“缓存一致性协议”,不同的 CPU 硬件厂商实现方式稍有不同,有MSI、MESI、MOSI等。 代码乱序执行优化 为了使得处理器内部的运算单元尽量被充分利用,提高运算效率,处理器可能会对输入的代码进行「乱序执行」(Out-Of-Order Execution),处理器会在计算之后将乱序执行的结果重组,乱序优化可以保证在单线程下该执行结果与顺序执行的结果是一致的**,但不保证程序中各个语句计算的先后顺序与输入代码中的顺序一致。 乱序执行技术是处理器为提高运算速度而做出违背代码原有顺序的优化。在单核时代,处理器保证做出的优化不会导致执行结果远离预期目标,但在多核环境下却并非如此。 多核环境下, 如果存在一个核的计算任务依赖另一个核的计算任务的中间结果,而且对相关数据读写没做任何防护措施,那么其顺序性并不能靠代码的先后顺序来保证,处理器最终得出的结果和我们逻辑得到的结果可能会大不相同。 编译器指令重排 除了上述由处理器和缓存引起的乱序之外,现代编译器同样提供了乱序优化。之所以出现编译器乱序优化其根本原因在于处理器每次只能分析一小块指令,但编译器却能在很大范围内进行代码分析,从而做出更优的策略,充分利用处理器的乱序执行功能。 内存屏障 尽管我们看到乱序执行初始目的是为了提高效率,但是它看来其好像在这多核时代不尽人意,其中的某些”自作聪明”的优化导致多线程程序产生各种各样的意外。因此有必要存在一种机制来消除乱序执行带来的坏影响,也就是说应该允许程序员显式的告诉处理器对某些地方禁止乱序执行。这种机制就是所谓内存屏障。不同架构的处理器在其指令集中提供了不同的指令来发起内存屏障,对应在编程语言当中就是提供特殊的关键字来调用处理器相关的指令,JMM里我们再探讨。 Java内存模型 Java 内存模型即 Java Memory Model,简称 JMM。 这里的内存模型可不是 JVM 里的运行时数据区。 「内存模型」可以理解为在特定操作协议下,对特定的内存或高速缓存进行读写访问的过程抽象。 不同架构的物理计算机可以有不一样的内存模型,Java虚拟机也有自己的内存模型。 Java虚拟机规范中试图定义一种「 Java 内存模型」来屏蔽掉各种硬件和操作系统的内存访问差异,以实现让 Java 程序在各种平台下都能达到一致的内存访问效果,不必因为不同平台上的物理机的内存模型的差异,对各平台定制化开发程序。 Java 内存模型的主要目标是定义程序中各个变量的访问规则,即在虚拟机中将变量存储到内存和从内存中取出变量这样的底层细节。这里的变量与我们写 Java 代码中的变量不同,它包括了实例字段、静态字段和构成数组对象的元素,但不包括局部变量和方法参数,因为他们是线程私有的,不会被共享。 JMM 组成 主内存:Java 内存模型规定了所有变量都存储在主内存(Main Memory)中(此处的主内存与物理硬件的主内存RAM 名字一样,两者可以互相类比,但此处仅是虚拟机内存的一部分)。 工作内存:每条线程都有自己的工作内存(Working Memory,又称本地内存,可与CPU高速缓存类比),线程的工作内存中保存了该线程使用到的主内存中的共享变量的副本拷贝。线程对变量的所有操作都必须在工作内存进行,而不能直接读写主内存中的变量。工作内存是 JMM 的一个抽象概念,并不真实存在。 JMM 与 JVM 内存结构 JMM 与 Java 内存区域中的堆、栈、方法区等并不是同一个层次的内存划分,两者基本没有关系。如果一定要勉强对应,那从变量、主内存、工作内存的定义看,主内存主要对应 Java 堆中的对象实例数据部分,工作内存则对应虚拟机栈的部分区域(与上图对应着看哈)。 JMM 与计算机内存结构 Java 内存模型和硬件内存体系结构也没有什么关系。硬件内存体系结构不区分栈和堆。在硬件上,线程栈和堆都位于主内存中。线程栈和堆的一部分有时可能出现在高速缓存和CPU寄存器中。如下图所示: 当对象和变量可以存储在计算机中不同的内存区域时,这就可能会出现某些问题。两个主要问题是: 线程更新(写)到共享变量的可见性 读取、检查和写入共享变量时的竞争条件 可见性问题(Visibility of Shared Objects) 如果两个或多个线程共享一个对象,则一个线程对共享对象的更新可能对其他线程不可见(当然可以用 Java 提供的关键字 volatile)。假设共享对象最初存储在主内存中。在 CPU 1上运行的线程将共享对象读入它的CPU缓存后修改,但是还没来得及即刷新回主内存,这时其他 CPU 上运行的线程就不会看到共享对象的更改。这样,每个线程都可能以自己的线程结束,就出现了可见性问题,如下 竞争条件(Race Conditions) 这个其实就是我们常说的原子问题。 如果两个或多个线程共享一个对象,并且多个线程更新该共享对象中的变量,则可能出现竞争条件。 想象一下,如果线程A将一个共享对象的变量读入到它的CPU缓存中。此时,线程B执行相同的操作,但是进入不同的CPU缓存。现在线程A执行 +1 操作,线程B也这样做。现在该变量增加了两次,在每个CPU缓存中一次。 如果这些增量是按顺序执行的,则变量结果会是3,并将原始值+ 2写回主内存。但是,这两个增量是同时执行的,没有适当的同步。不管将哪个线程的结构写回主内存,更新后的值只比原始值高1,显然是有问题的。如下(当然可以用 Java 提供的关键字 Synchronized) JMM 特性 JMM 就是用来解决如上问题的。 JMM是围绕着并发过程中如何处理可见性、原子性和有序性这 3 个 特征建立起来的 可见性:可见性是指当一个线程修改了共享变量的值,其他线程能够立即得知这个修改。Java 中的 volatile、synchronzied、final 都可以实现可见性 原子性:即一个操作或者多个操作,要么全部执行并且执行的过程不会被任何因素打断,要么就都不执行。即使在多个线程一起执行的时候,一个操作一旦开始,就不会被其他线程所干扰。 有序性: 计算机在执行程序时,为了提高性能,编译器和处理器常常会对指令做重排,一般分为以下 3 种 单线程环境里确保程序最终执行结果和代码顺序执行的结果一致; 处理器在进行重排序时必须要考虑指令之间的数据依赖性; 多线程环境中线程交替执行,由于编译器优化重排的存在,两个线程中使用的变量能否保证一致性是无法确定的,结果无法预测 内存之间的交互操作 关于主内存和工作内存之间具体的交互协议,即一个变量如何从主内存拷贝到工作内存、如何从工作内存同步回主内存之类的实现细节,Java 内存模型中定义了 8 种 操作来完成,虚拟机实现必须保证每一种操作都是原子的、不可再拆分的(double和long类型例外) lock(锁定):作用于主内存的变量,它把一个变量标识为一条线程独占的状态。 unlock(解锁):作用于主内存的变量,它把一个处于锁定状态的变量释放出来,释放后的变量才可以被其他线程锁定。 read(读取):作用于主内存的变量,它把一个变量的值从主内存传输到线程的工作内存中,以便随后的load动作使用。 load(载入):作用于工作内存的变量,它把read操作从主内存中得到的变量值放入工作内存的变量副本中。 use(使用):作用于工作内存的变量,它把工作内存中一个变量的值传递给执行引擎,每当虚拟机遇到一个需要使用到变量的值的字节码指令时将会执行这个操作。 assign(赋值):作用于工作内存的变量,它把一个从执行引擎接收到的值赋给工作内存的变量,每当虚拟机遇到一个给变量赋值的字节码指令时执行这个操作。 store(存储):作用于工作内存的变量,它把工作内存中一个变量的值传送到主内存中,以便随后的write操作使用。 write(写入):作用于主内存的变量,它把store操作从工作内存中得到的变量的值放入主内存的变量中。 如果需要把一个变量从主内存复制到工作内存,那就要顺序地执行 read 和 load 操作,如果要把变量从工作内存同步回主内存,就要顺序地执行 store 和 write 操作。注意,Java 内存模型只要求上述两个操作必须按顺序执行,而没有保证是连续执行。也就是说 read 与 load 之间、store 与write 之间是可插入其他指令的,如对主内存中的变量 a、b 进行访问时,一种可能出现顺序是 read a、read b、load b、load a。 除此之外,Java 内存模型还规定了在执行上述 8 种基本操作时必须满足如下规则 不允许 read 和 load、store 和 write 操作之一单独出现,即不允许一个变量从主内存读取了但工作内存不接受,或者从工作内存发起回写了但主内存不接受的情况出现。 不允许一个线程丢弃它的最近的 assign 操作,即变量在工作内存中改变了之后必须把该变化同步回主内存。 不允许一个线程无原因地(没有发生过任何 assign 操作)把数据从线程的工作内存同步回主内存。 一个新的变量只能在主内存中“诞生”,不允许在工作内存中直接使用一个未被初始化(load 或 assign)的变量,换句话说,就是对一个变量实施 use、store 操作之前,必须先执行过了 assign 和 load 操作。 一个变量在同一时刻只允许一条线程对其进行 lock 操作,但 lock 操作可以被同一条线程重复执行多次,多次执行 lock 后,只有执行相同次数的 unlock 操作,变量才会被解锁。 如果对一个变量执行 lock 操作,那将会清空工作内存中此变量的值,在执行引擎使用这个变量前,需要重新执行 load 或 assign 操作初始化变量的值。 如果一个变量事先没有被 lock 操作锁定,那就不允许对它执行 unlock 操作,也不允许去 unlock 一个被其他线程锁定住的变量。 对一个变量执行 unlock 操作之前,必须先把此变量同步回主内存中(执行 store、write 操作)。 long 和 double 型变量的特殊规则 Java 内存模型要求 lock,unlock,read,load,assign,use,store,write 这 8 个操作都具有原子性,但对于64 位的数据类型( long 或 double),在模型中定义了一条相对宽松的规定,允许虚拟机将没有被 volatile 修饰的 64 位数据的读写操作划分为两次 32 位的操作来进行,即允许虚拟机实现选择可以不保证 64 位数据类型的load,store,read,write 这 4 个操作的原子性,即 long 和 double 的非原子性协定。 如果多线程的情况下double 或 long 类型并未声明为 volatile,可能会出现“半个变量”的数值,也就是既非原值,也非修改后的值。 虽然 Java 规范允许上面的实现,但商用虚拟机中基本都采用了原子性的操作,因此在日常使用中几乎不会出现读取到“半个变量”的情况,so,这个了解下就行。 先行发生原则 先行发生(happens-before)是 Java 内存模型中定义的两项操作之间的偏序关系,如果操作A 先行发生于操作B,那么A的结果对B可见。happens-before关系的分析需要分为单线程和多线程的情况: 单线程下的 happens-before 字节码的先后顺序天然包含happens-before关系:因为单线程内共享一份工作内存,不存在数据一致性的问题。 在程序控制流路径中靠前的字节码 happens-before 靠后的字节码,即靠前的字节码执行完之后操作结果对靠后的字节码可见。然而,这并不意味着前者一定在后者之前执行。实际上,如果后者不依赖前者的运行结果,那么它们可能会被重排序。 多线程下的 happens-before 多线程由于每个线程有共享变量的副本,如果没有对共享变量做同步处理,线程1更新执行操作A共享变量的值之后,线程2开始执行操作B,此时操作A产生的结果对操作B不一定可见。 为了方便程序开发,Java 内存模型实现了下述的先行发生关系: 程序次序规则: 一个线程内,按照代码顺序,书写在前面的操作先行发生于书写在后面的操作。 管程锁定规则: 一个unLock操作先行发生于后面对同一个锁的lock操作。 volatile变量规则: 对一个变量的写操作 happens-before 后面对这个变量的读操作。 传递规则: 如果操作A 先行发生于操作B,而操作B又先行发生于操作C,则可以得出操作A 先行发生于操作C。 线程启动规则: Thread对象的start()方法先行发生于此线程的每个一个动作。 线程中断规则: 对线程interrupt()方法的调用先行发生于被中断线程的代码检测到中断事件的发生。 线程终结规则: 线程中所有的操作都先行发生于线程的终止检测,我们可以通过Thread.join()方法结束、Thread.isAlive()的返回值手段检测到线程已经终止执行。 对象终结规则: 一个对象的初始化完成先行发生于它的 finalize() 方法的开始 内存屏障 上边的一系列操作保证了数据一致性,Java中如何保证底层操作的有序性和可见性?可以通过内存屏障。 内存屏障是被插入两个 CPU 指令之间的一种指令,用来禁止处理器指令发生重排序(像屏障一样),从而保障有序性的。另外,为了达到屏障的效果,它也会使处理器写入、读取值之前,将主内存的值写入高速缓存,清空无效队列,从而保障可见性。 eg: Store1; Store2; Load1; StoreLoad; //内存屏障 Store3; Load2; Load3; 对于上面的一组 CPU 指令(Store表示写入指令,Load表示读取指令),StoreLoad 屏障之前的 Store 指令无法与StoreLoad 屏障之后的 Load 指令进行交换位置,即重排序。但是 StoreLoad 屏障之前和之后的指令是可以互换位置的,即 Store1 可以和 Store2 互换,Load2 可以和 Load3 互换。 常见的 4 种屏障 LoadLoad 屏障: 对于这样的语句 Load1; LoadLoad; Load2,在Load2及后续读取操作要读取的数据被访问前,保证Load1要读取的数据被读取完毕。 StoreStore 屏障: 对于这样的语句 Store1; StoreStore; Store2,在Store2及后续写入操作执行前,保证Store1的写入操作对其它处理器可见。 LoadStore 屏障: 对于这样的语句Load1; LoadStore; Store2,在Store2及后续写入操作被执行前,保证Load1要读取的数据被读取完毕。 StoreLoad 屏障: 对于这样的语句Store1; StoreLoad; Load2,在Load2及后续所有读取操作执行前,保证Store1的写入对所有处理器可见。它的开销是四种屏障中最大的(冲刷写缓冲器,清空无效化队列)。在大多数处理器的实现中,这个屏障也被称为全能屏障,兼具其它三种内存屏障的功能。 Java 中对内存屏障的使用在一般的代码中不太容易见到,常见的有 volatile 和 synchronized 关键字修饰的代码块,还可以通过 Unsafe 这个类来使用内存屏障。(下一章扯扯这些) Java 内存模型就是通过定义的这些来解决可见性、原子性和有序性的。 参考 《深入理解 Java 虚拟机》第二版 http://tutorials.jenkov.com/java-concurrency/java-memory-model.html https://juejin.im/post/5bf2977751882505d840321d#heading-5http://rsim.cs.uiuc.edu/Pubs/popl05.pdf http://ifeve.com/wp-content/uploads/2014/03/JSR133中文版.pdf

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册