首页 文章 精选 留言 我的

精选列表

搜索[过拟合],共10002篇文章
优秀的个人博客,低调大师

那些年移动App域名解析踩过的坑

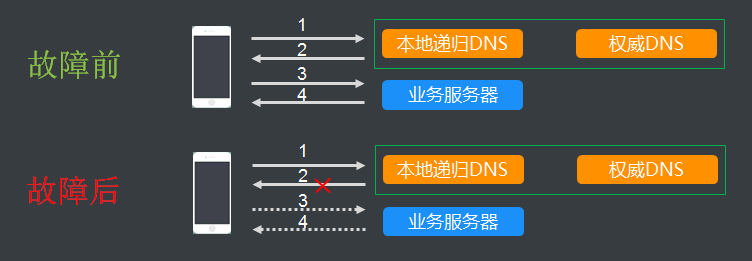
一、摘要 移动应用出现域名劫持、解析结果修改生效慢、跨运营商跨地域访问问题?阿里云HTTPDNS可以解决这类问题。 二、域名解析阿喀琉斯之踵 域名解析是终端设备访问互联网的第一步,扮演着至关重要的角色。同时,域名解析服务是当前整个互联网基础设施中最脆弱的几个环节之一。移动互联网时代,由于接入智能终端数量激增,问题愈加严重。 案例1: 域名解析问题导致访问流量减半 2017年2月24日21:20-2月25日1:00之间,某App A在江苏省某ISP访问流量减半,排查后发现为递归DNS故障导致。 图1 递归DNS故障导致业务访问受害 如图1所示,正常访问期间,App业务访问大致分为四步: Step 1: App发起业务域名解析 Step 2: 递归DNS返回域名解析结果IP Step 3: App根据返回的IP向业务服务器发起请求 Step 4: 业务服务

优秀的个人博客,低调大师

每日一博 | 听说过对 Go map 做 GC 吗?

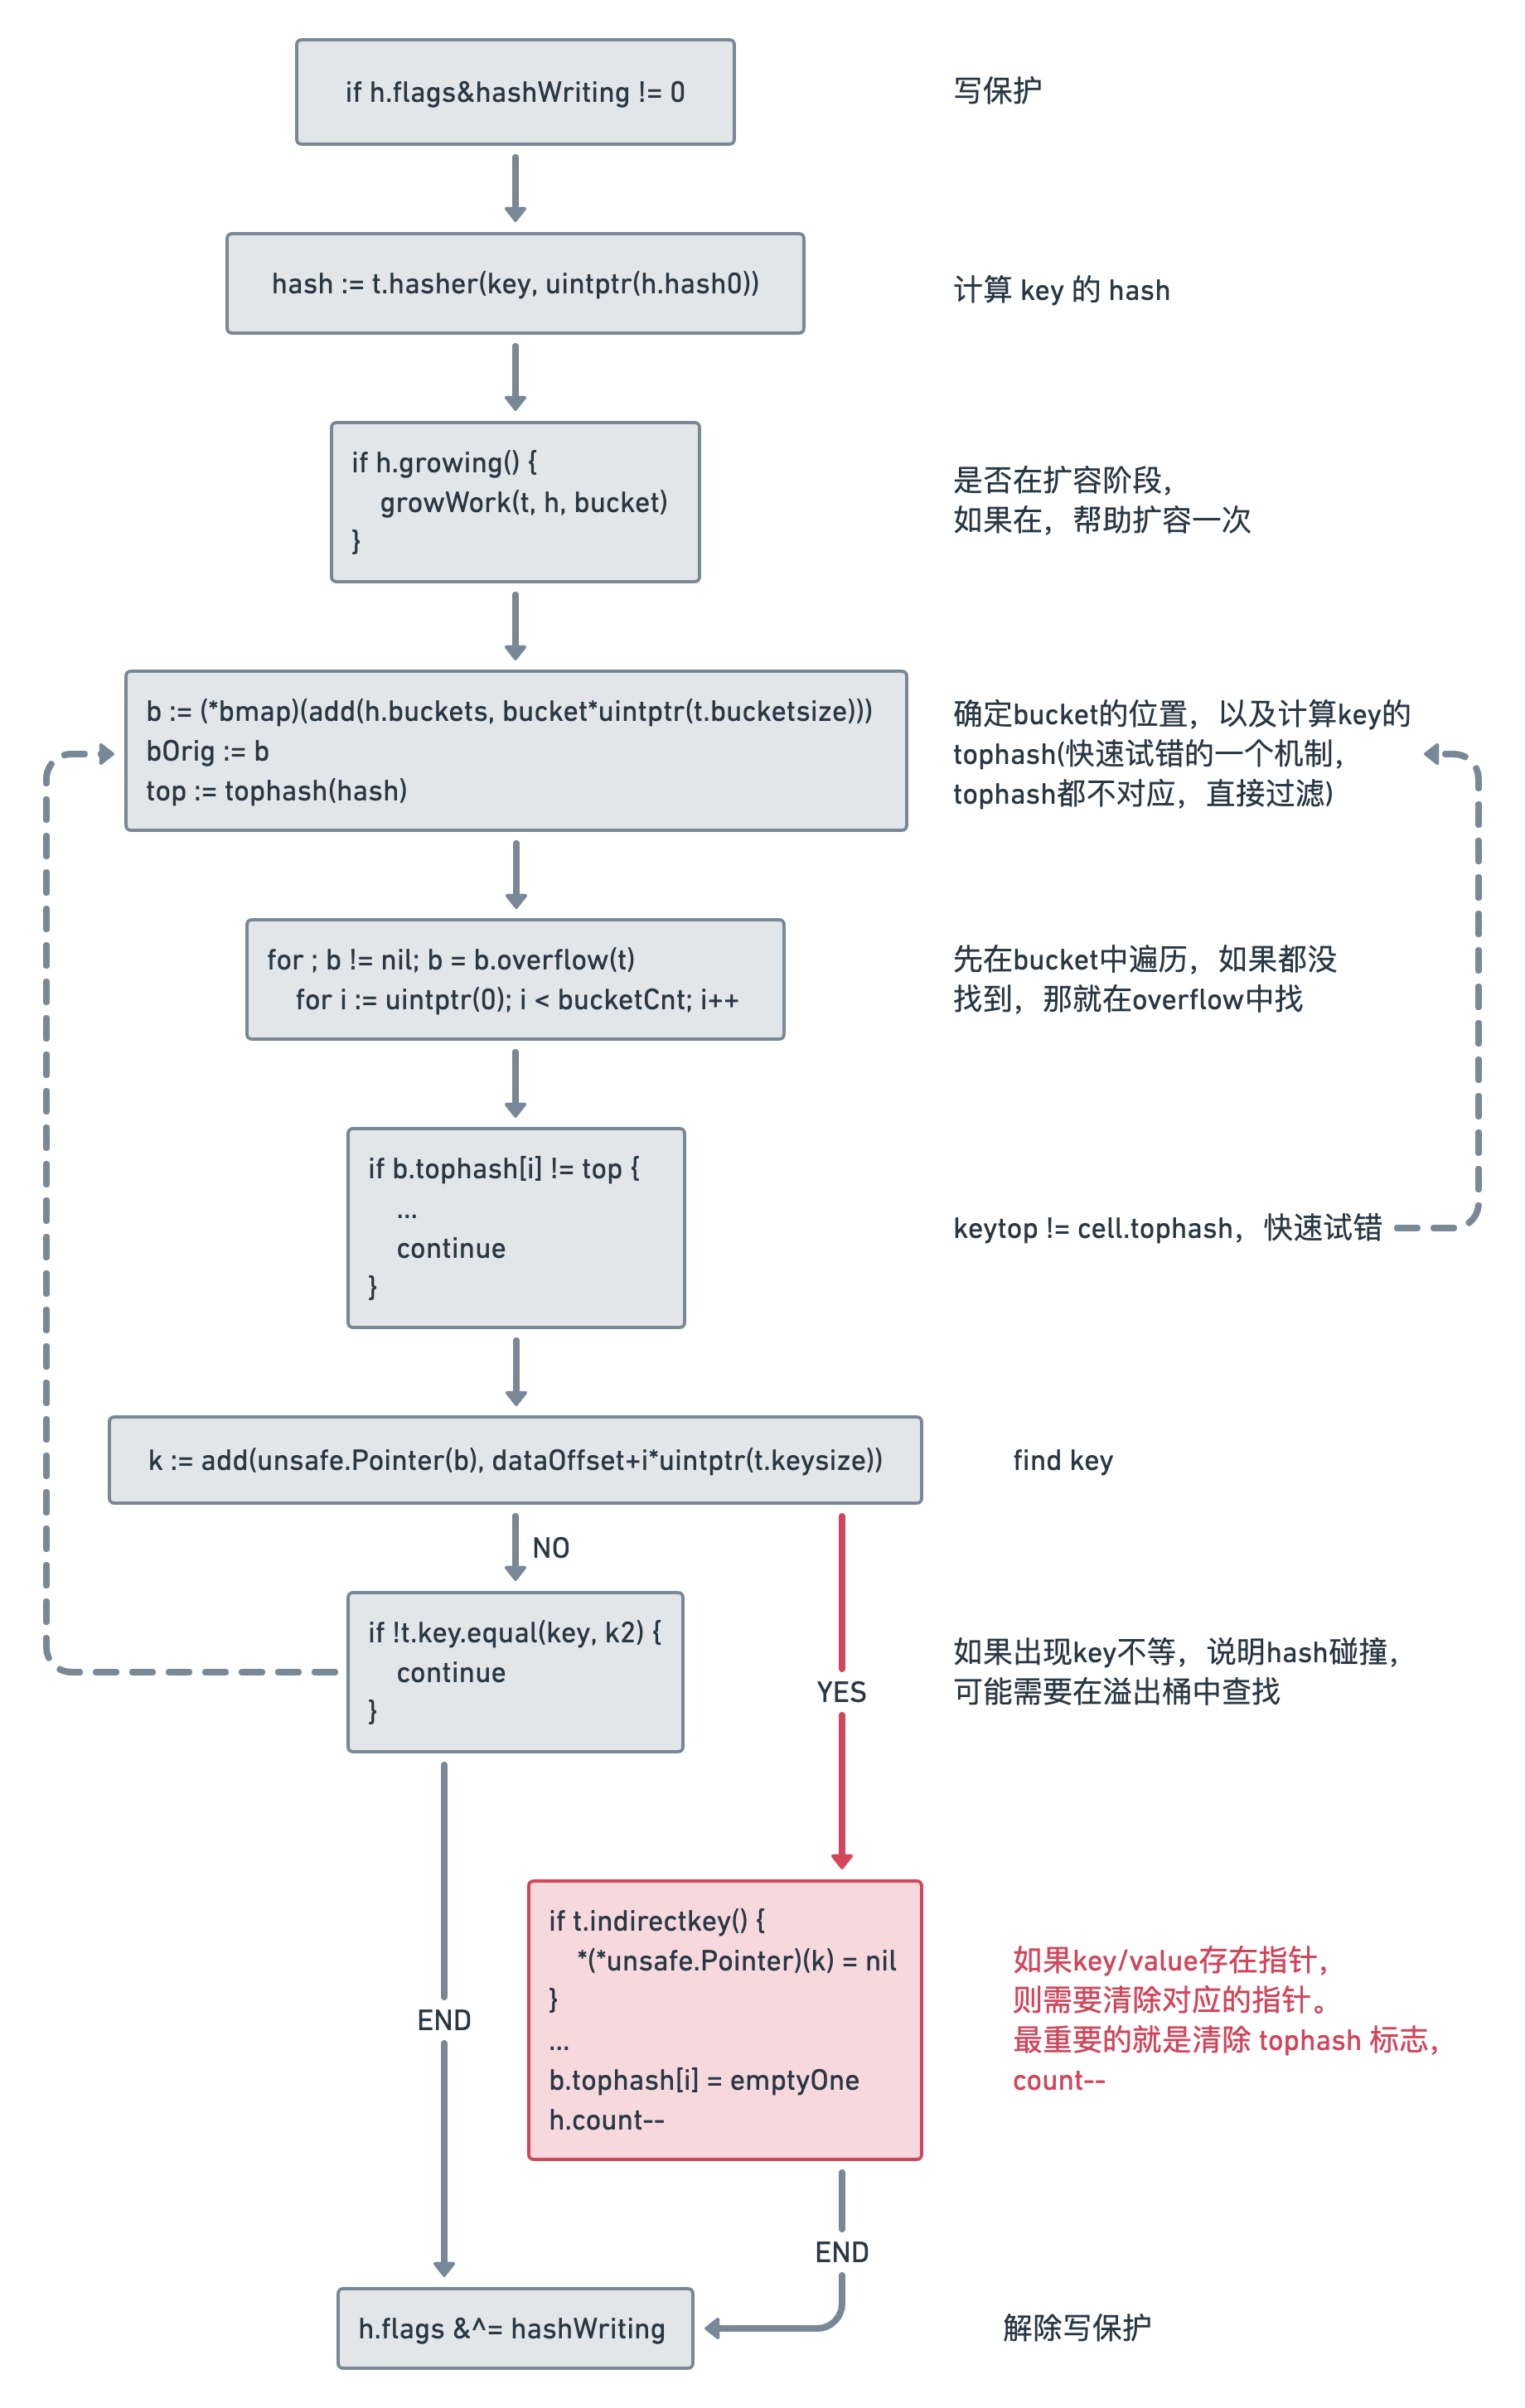
在 Golang 中的 map 结构,在删除键值对的时候,并不会真正的删除,而是标记。那么随着键值对越来越多,会不会造成大量内存浪费? 首先答案是会的,很有可能导致 OOM,而且针对这个还有一个讨论:https://github.com/golang/go/issues/20135。大致的意思就是在很大的 map 中,delete 操作没有真正释放内存而可能导致内存 OOM。 所以一般的做法:就是 重建map。而 go-zero 中内置了 safemap 的容器组件。safemap 在一定程度上可以避免这种情况发生。 那首先我们看看 go 原生提供的 map 是怎么删除的? 原生map删除 1 package main 2 3 func main() { 4 m := make(map[int]string, 9) 5 m[1] = "hello" 6 m[2] = "world" 7 m[3] = "go" 8 9 v, ok := m[1] 10 _, _ = fn(v, ok) 11 12 delete(m, 1) 13 } 14 15 func fn(v string, ok bool) (string, bool) { 16 return v, ok 17 } 测试代码如上,我们可以通过 go tool compile -S -N -l testmap.go | grep "CALL" : 0x0071 00113 (test/testmap.go:4) CALL runtime.makemap(SB) 0x0099 00153 (test/testmap.go:5) CALL runtime.mapassign_fast64(SB) 0x00ea 00234 (test/testmap.go:6) CALL runtime.mapassign_fast64(SB) 0x013b 00315 (test/testmap.go:7) CALL runtime.mapassign_fast64(SB) 0x0194 00404 (test/testmap.go:9) CALL runtime.mapaccess2_fast64(SB) 0x01f1 00497 (test/testmap.go:10) CALL "".fn(SB) 0x0214 00532 (test/testmap.go:12) CALL runtime.mapdelete_fast64(SB) 0x0230 00560 (test/testmap.go:7) CALL runtime.gcWriteBarrier(SB) 0x0241 00577 (test/testmap.go:6) CALL runtime.gcWriteBarrier(SB) 0x0252 00594 (test/testmap.go:5) CALL runtime.gcWriteBarrier(SB) 0x025c 00604 (test/testmap.go:3) CALL runtime.morestack_noctxt(SB) 执行第12行的 delete,实际执行的是 runtime.mapdelete_fast64。 这些函数的参数类型是具体的 int64,mapdelete_fast64 跟原始的 delete 操作一样的,所以我们来看看 mapdelete。 mapdelete 长图预警!!! 大致代码分析如上,具体代码就留给大家去阅读了。其实大致过程: 写保护,防止并发写 查询要删除的 key 是否存在 存在则对其标志做删除标记 count-- 所以你在大面积删除 key ,实际 map 存储的 key 是不会删除的,只是标记当前的key状态为 empty。 其实出发点,和 mysql 的标记删除类似,防止后续会有相同的 key 插入,省去了扩缩容的操作。 但是这个对有些场景是不妥的,如果开发者在未来时间内都不会再插入相同的 key ,很可能会导致 OOM。 所以针对以上情况,go-zero 开发了 safemap 。下面我们看看 safemap 是如何避免这个问题的? safemap 直接从操作 safemap 中分析为什么要这么设计: 预设一个 删除阈值,如果触发会放到一个新预设好的 newmap 中 两个 map 是一个整体,所以 key 只能留一份 所以为什么要设置两个 map 就很清楚了: dirtyOld 作为存储主体,如果 delete 操作达到阈值,则会触发迁移。 dirtyNew 作为暂存体,会在到达阈值时,存放部分 key/value 所以在迁移操作时,我们需要做的就是:将原先的 dirtyOld 清空,存储的 key/value 通过 for-range 重新存储到 dirtyNew,然后将 dirtyNew 指向 dirtyOld。 > 可能会有疑问:不是说 key/value 没有删除吗,只是标记了 tophash=empty > > 其实在 for-range 过程中,会过滤掉 tophash <= emptyOne 的 key 这样就实现了不需要的 key 不会被加入到 dirtyNew,进而不会影响 dirtyOld。 这其实也就是垃圾回收的年老代和新生代的概念。 更多实现细节,可以查看源码! 项目地址 https://github.com/tal-tech/go-zero https://gitee.com/kevwan/go-zero 欢迎使用 go-zero 并 star 支持我们! 微信交流群 关注『微服务实践』公众号并点击 交流群 获取社区群二维码。

优秀的个人博客,低调大师

那些年,我们跟风过的手机伪概念,一一揭开真相

【金融特辑】光大银行科技部DBA女神带你从0到1揭秘MGR 什么?不支持SA的不是真5G手机?Wi-Fi 6速率不如Wi-Fi 5,Wi-Fi 6是个伪概念?旗舰机5000万像素足够用了,手机拍照不应单纯追求高像素,难道1亿像素方向错了? 如今,一场手机新品发布会就是一次充满浓浓火药味的远程Battle,受伤的总是友商。 不过,最惨的还是消费者,这么多噱头、那么多互锤,一脸懵的他们仍要面对灵魂拷问:“谁说的对?我到底该听哪个?” 来来来,今年“3·15”《IT时报》揭穿这些伪概念,助你辨别出炫技还是营销,让你跟着买,也能不摇摆。 伪概念 01 支持SA才是真5G手机? 事件 2019年是5G手机元年,也是争论最多的一年。“真假5G手机”之说,最早源于华为消费者BG董事长余承东所发的一个朋友圈动态:“国内同行加油,希望大家都能提供真5G手机,NSA(非独立组网)很快被淘汰,SA(独立组网)才是真5G。” 余承东这句话迅速被网络传播出去,并被舆论解读为“NSA制式是假5G手机”。当时市面上已经发布了好几款仅支持NSA制式的5G手机,难道它们全是“伪5G”? 真相 真假5G不是由某个人说了算,5G技术标准是由国际组织3GPP制定。3GPP规定NSA和SA都是5G组网方式。 图片来源:3GPP官网 所谓NSA,即“非独立组网”,这是一种在现有4G基站基础上采取融合部署方式来实现5G网络接入的模式。 简言之,就是充分利用现有4G基站网络,以最快的速度完成5G信号覆盖; 而SA,为“独立组网模式”,这种模式完全不依赖现有的4G基站网络,而是重新另外建立起一套5G基站以及后端的核心网络。 NSA和SA的组网模式对比 按照3GPP的协议,5G频段分为FR1和FR2两个范围,其中FR1的频段低于6GHz,也就是指Sub-6频段,而高于6GHz的FR2频段则被称为毫米波。 图片来源:网络 在这点上,业界又延伸出“只有支持Sub-6+毫米波的芯片才是真5G,不支持毫米波的都是假5G”的争论。 不论是SA、NSA,还是Sub-6、毫米波,都是真5G,只要符合这些标准,就都是5G手机。 如今各大厂商关于真假5G手机的Battle越来越多,正如网友总结的那样: “当你用上5G手机时,他说支持SA才是真5G手机;当你用上双模5G手机时,他又说集成才是真5G手机;而当你用上集成双模5G手机时,他又说n79(频段)才是真5G手机。” 2020年以来,市面上销售的5G手机基本全面支持NSA和SA制式,而更多如n79频段则意味着该款手机多支持一个5G频段,但这对消费者使用来说,几乎没有任何影响。 所以,有一点要记好,当一个新名词又占据营销制高点时,多上网查资料,少交智商税。 伪概念 02 1亿像素方向错了? 事件 在去年年底荣耀V30发布会上,荣耀总裁赵明在谈到1亿像素相机时,表示1亿像素的拍照会延迟4~6秒,这种体验不能接受,而且1亿像素照片少说也有20M大小,5000张照片100G的存储就没了。 这段话可以说针对性很强,是一种精准打击,毕竟当时1亿像素的手机全球仅有一家公司在使用——小米。 随后,荣耀业务部副总裁(产品)荣耀老熊又在微博上发起“一亿像素方向错了”话题,小米旗下的红米品牌总经理卢伟冰展开回击。 荣耀和红米的支持者在网上互撕频繁,荣耀老熊不断科普“一亿像素方向错了”,卢伟冰则称对方“发现自己落后了,才会如此攻击1亿像素”。 真相 在数码照片成像过程中,像素一直都扮演着至关重要的角色。像素数量决定了照片文件的精度,更高的像素能记录更多的信息,这就为后期编辑提供了更多的空间,无论是对手机,还是相机。 小米一亿像素系列手机采用的是Quad Bayer结构,这种结构通过将相邻四像素合并成一个大像素的方式,在“小像素感光”的基础上模拟“大像素感光”的效果。 图片来源:dpreview 由于数码照片在成像时,本身会形成一些难以避免的错误色彩信号(被称为噪点),如果将多个像素加以合成,那么单像素噪点的影响在合成后就将减弱,从而整体画面细节都将有所提升。 所以,无论是过去的4800万、6400万还是现在的10800万,当采用了四合一像素的Quad Bayer结构,所呈现出来的照片并没有那么高的像素,而是细节表现更好的1200万、1600万以及2700万像素照片。 在没有开启“全像素”模式下,小米那颗一亿像素的镜头所拍出的照片也只有2700万有效像素,高于主流的1200万像素以及1600万像素,但也不能简单地以像素翻倍来粗暴地理解。 伪概念 03 100%,才算全面屏? 事件 全面屏是前些年手机圈很火的概念,苹果、三星、华为、小米等各大厂商都发布了自家全面屏手机产品,但真正全面屏的标准却一直没有。 何为全面屏手机?如果仅从字面上理解,全面屏说的是没有边框,手机的正面全都由屏幕覆盖,屏占比达到100%。 为了实现全面屏,各手机厂商陆续推出刘海屏、水滴屏、曲面屏和挖孔屏等设计方案,但严格来说这些都只能算接近全面屏。 全面屏手机对比,图片来源:网络 需要提及的是,vivo率先发布了屏下指纹识别技术,通过将指纹感应装置设置于屏幕之下,避免了在机身正面屏幕板上开孔打洞,得以在保障屏幕一体性的前提下,使用指纹解锁手机。而后来脸部识别技术的普及,则将全面屏的进程又提高了一步。 如今,除了开孔前置摄像头,手机屏幕正面完全可以做到真正的全面屏。 真相 全面屏是业界对超高屏占比一个比较宽泛的定义。主要受限于目前的技术水平,业界宣称的全面屏手机,通常只是屏占比超高的设计,距离正面屏占比100%尚有差距。 一块手机屏幕比例的改变,需要很多配套技术的共同跟进。全面屏手机需要解决制造工艺上的难点有很多,比如听筒、前置摄像头的位置以及如何解决正面指纹识别的问题等,而解决这些问题无疑都会增加研发、制造成本,从而导致最终售价要比一般手机高出不少。 目前,市面上的全面屏手机屏占比大多已达到90%以上,拥有超窄边框和“下巴”“额头”。随着折叠屏、环绕屏以及屏下指纹识别等技术的发展,越来越多的手机屏占比再次得到跃升,达到甚至超过100%。 伪概念 04 Wi-Fi 6还没Wi-Fi5快? 事件 2月13日,小米直播发布了年度旗舰小米10系列。新款手机的一个卖点是,支持5G时代最新Wi-Fi标准Wi-Fi 6,最大吞吐量9.6Gbps是Wi-Fi 5的2.7倍,受到用户的广泛关注。 没想到的是,Wi-Fi 6功能却遭到了同行的吐槽。华为手机产品线副总裁李小龙在微博上表示:“现在上市的Wi-Fi 6手机理论带宽只有1200Mbps,实测最多900Mbps出头,根本到不了150MB/s。还不如2018年上市的Mate20。” 对于网友的质疑,李小龙在评论下方解释道:“我没说Wi-Fi 6弱,Wi-Fi 6是好技术,未来我们肯定也会用,我是说现在市面上手机用的Wi-Fi 6解决方案太弱。” 微博一出,网友们纷纷坐不住了。小米Wi-Fi 6不如华为Wi-Fi 5?Wi-Fi 6是个伪概念吗? 真相 实际上,无论是Wi-Fi5还是Wi-Fi 6,它们都有一个共同的名字,叫802.11X。 早在1997年,IEEE(电气电子工程师协会)推出了第一个无线局域网标准802.11,此后每一代Wi-Fi标准都是以此命名。 为了便于区分,每一代的标准会在802.11后面加点字母,比如802.11ac,802.11ax。无线网络标准组织Wi-Fi联盟为了便于用户理解,就给了它们起了新的名字,Wi-Fi 5和Wi-Fi 6。 Wi-Fi5和Wi-Fi6的对比,:图片来源:iThome Wi-Fi 6引入了多个新技术,让无线网络的通信质量、传输效率、能耗表现和物联网优化都有提升。 之所以会引起争议,在于频宽。众所周知,频宽是用来描述网络或线路理论上传输数据的最高速率,常见的频宽有20MHz、40MHz、80Mhz和160Mhz。 问题关键在于,目前市面上的Wi-Fi 6手机仅支持80Mhz的频宽,而部分Wi-Fi 5 手机不仅支持80Mhz的频宽,同时也支持160MHz的频宽。 部分Wi-Fi 5手机通过160MHz的频宽跑出了866.7Mbps的速率,而Wi-Fi 6手机只能在80MHz频宽上跑出最大600.5Mbps的速率。 频宽不同,速率自然不同,更无可比性。但假设在同样频宽的测试下,Wi-Fi 6定能跑赢Wi-Fi 5。 2020年5G大发展,万物互联时代,Wi-Fi 6技术大有可为。 伪概念 05 真的存在“伪内存”吗? 事件 伪内存这一概念,源于华为的“闪存门”事件。被华为终端寄予厚望的旗舰机型P10系列上市没多久,就陷入了巨大的争议之中。 一些网友购买了P10手机后,经过测试软件发现P10系列手机闪存速度出现了明显的差异。 用户测试结果显示,有部分手机的闪存速度只达到了200MB/秒以上。但也有媒体报道和评测,P10手机闪存速度可以达到800MB/秒左右。 同款手机,闪存差异这么大,难道真的存在“伪内存”吗? 不同批次华为P10测试成绩差距较大,图片来源:网络 真相 对于“闪存门”,华为官方作出了回应,在业内人士看来,同样是P10手机之所以会出现上述情况,原因在于同样是P10手机,有的P10手机采用了eMMC5.1,有的P10手机用的是UFS2.0,还有的P10手机用的是UFS2.1,导致了闪存速度差异。 eMMC是嵌入式的多媒体储存卡,在核心算法上,eMMC的主控集成在芯片内部,eMMC芯片可以以芯片形式焊接在电路板,通过MMC协议接入系统总线,eMMC具有方便、轻小、简单、不占空间等优点。 至于UFS,是第一代通用闪存存储标准,与eMMC最大的区别在于,改变总线由并行到串行,工作频率可以大幅提高,加快数据传输速率。 eMMC和UFS传输速度对比,图片来源:Micron 华为推出了Mate 9系列智能手机,在闪存上也进行了相应的宣传。但有网友发现通过软件测试,该系列手机并没有达到华为宣传的UFS2.1。 77位消费者一怒之下,将华为告上了法庭。法院判定,虽然华为在向消费者宣传Mate 9系列手机的过程中确有不当的行为,但华为该行为并不构成虚假宣传。 对此,华为余承东表示,对于不同规格的成本方案,其成本之间的差异只有2元多。言外之意就是,华为不可能用2元的成本去欺诈消费者。所谓的“伪内存”,也不过就是不同规格的内存方案罢了。 目前,手机厂商在发布新机时,往往会对新机的内存型号进行介绍,比如UFS 3.0就是目前旗舰级手机上常见的内存版本。更快的存储器意味着更快的数据读写速度,对于在意内存质量的用户,可以关注手机厂商发布的详细参数。 伪概念 06 “伪指纹识别”防不住一张橘子皮 事件 一段胶带、一块橘子皮甚至一根头发丝就能打开智能手机,这并不是危言耸听。一直以来,用户对于手机指纹锁安全性的讨论和关注未曾停止。 《IT时报》记者就曾通过测试得出,仅仅一张膜,就能破解指纹解锁,涉及的手机品牌包括目前所有的主流国产手机厂商。经过近几年的发展,伪指纹识别还存在吗? 真相 指纹解锁的安全系数全都藏在算法之中,如果指纹芯片厂商为了提高所谓的用户体验,降低算法的安全程度,那么就会发生一张膜就能破解手机的悲剧。 所谓全图像算法,是指将录入的指纹存储为图像解锁时,系统将需要识别的图像与录入图像进行比对,图像一致即可通过。 但这一技术的缺陷在于“只识不别”,因其拥有自学习功能,只要识别出图像一致的部分即可通过,不会去分辨不一样的部分是否为人为干扰图像。 举个例子,算法本来可以识别妈妈的样子,有一天妈妈抱着孩子来解锁手机,算法也通过了,最终造成的结果是,孩子自己在没有妈妈的情况下也可以解锁算法,造成了“偷梁换柱”的情况。 时下,人工智能技术非常流行。人工智能行业专家孙立斌表示,把大量的指纹数据作为“原材料”,通过机器学习对指纹的结构与特征进行学习,以一定的规则为基础,将指纹进行重组便能生成伪指纹了。这是新技术对指纹识别技术提出的新挑战。 从来没有绝对的安全,无论指纹或是脸部识别技术被应用在手机中,手机用户的安全意识才是更关键的,良好的安全使用习惯,才是保证个人隐私以及财产安全的最关键法宝。

优秀的个人博客,低调大师

小小的公共库,大大的耦合,你痛过吗?

什么是耦合? 耦合,是架构中,本来不相干的代码、模块、服务、系统因为某些原因联系在一起,各自独立性差,影响则相互影响,变动则相互变动的一种架构状态。 感官上,怎么发现系统中的耦合? 作为技术人,每每在心中骂上下游,骂兄弟部门,“这个东西跟我有什么关系?为什么需要我来配合做这个事情?”。明明不应该联动,却要被动受影响,就可能有潜在的耦合。 因为公共库,导致相互受影响,就是一个耦合的典型案例。 场景还原 一个看似“公共”的业务库(.so.jar.dll.php),很多业务系统都依赖于这个公共库,这个库使得这些系统都耦合在了一起。 注:这里的公共库不是指像“字符串操作”这样的不变化的工具库,更多是指通用业务的公共库。 耦合如何导致相互影响? 业务1,业务2,业务3都依赖于某一个biz.jar,业务1因为某个需求需要升级biz.jar。上线前,业务1的QA进行了大量的测试,确保无误后,代码发布,发布完线上验证无误后,上线完成,闪人。 突然,bug群里有人反馈,业务2的系统挂了,业务3的系统也挂了,一下炸开了锅: 业务2的大boss首先发飙:“<font color=red>技术都干啥了,怎么系统挂了</font>” 业务2的rd一脸无辜:“<font color=red>业务1上线了,所以我们挂了</font>” 额,然而,这个理由,好像在大boss那解释不通… 业务2的大boss:“<font color=red>业务1上线?业务1上线前测试了么</font>” 业务1的qa自信满满:“<font color=red>测试了呀,上线前上线后都验证了,没问题呀</font>” 业务2的大boss对业务2的rd吼道“<font color=red>还想甩锅,拖出去祭天</font>” 不知道大家工作中会不会遇到这样的场景,因为公共库的耦合,兄弟部门上线,影响的确是你,此时你心里可能就在骂娘了,这帮不靠谱的**队友。 特别的,如果公共库的使用方很广,这个耦合很严重,可能影响很大的范围。 如何解除公共库耦合? 方案一:代码拷贝一份 别嘲笑这个方案,谁敢说自己写代码的时候没这么干过? 我们都知道这不是一个好的方案,但不可否认,<font color=red>拷贝之后,代码各自演化,一个地方升级出错,只影响一方</font>,拷贝方只要不动原有代码,至少是不会受影响的。 代码拷贝缺点很多,<font color=red>系统拆分时,万不得已不要使用这个方案</font>。 方案二:垂直拆分,将公共库里业务个性化的代码拆到调用方去,不要放在公共库里 需要把业务个性的代码拆分到各个业务线自己的工程,自己的业务库里去,例如s1.jar / s2.jar / s3.jar,修改各自的代码,至少不会扩大影响范围。 大家为什么都把代码往一个公共库里塞? 很多时候,因为惰性,一点一点的惰性,日积月累,终成大坑。 这个垂直拆分是一个架构重构的过程,需要各业务方配合。 方案三:服务化,将公共库里通用业务代码拆到下层去 完成了第一步,业务个性化的代码提取到业务侧上游。 接下来是第二步,业务通用的代码,下沉抽取一层服务,服务对上游提供RPC接口: 每次修改底层接口,需要测试接口的兼容性,保证不影响旧调用方 如果是新的业务,则建议新增接口 最终,达到通过服务RPC调用的方式来解除耦合。 有朋友会问: 底层服务接口的测试 上游业务层对公共库的测试 都是测试,为何前者能控制影响范围呢? 底层接口,所有人调用,接口没问题则调用方都没问题 上游业务层对公共库测试,只能保证自己的业务没有问题,并不能保证其他业务方没有问题 个性业务代码上浮,共性业务代码服务化下沉,只是一个很小的优化点,但对于公共库解耦却是非常的有效。 原文地址:http://zhuanlan.51cto.com/art/201711/559093.htm 本文转自 006玩命 51CTO博客,原文链接:http://blog.51cto.com/weiyuqingcheng/2044686,如需转载请自行联系原作者

优秀的个人博客,低调大师

修过的一个android framework原生系统代码bug

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/voidreturn/article/details/69388616 “坑”描述: 在对我们自己研发的一款android终端进行camera拍照压力测试时,发现当拍照张数达到几万张时,查看内存占用情况,发现内存泄露。 填“坑”: frameworks/base/core/jni/android/graphics/YuvToJpegEncoder.cpp bool YuvToJpegEncoder::encode(SkWStream* stream, void* inYuv, int width, int height, int* offsets, int jpegQuality) { jpeg_compress_struct cinfo; skjpeg_error_mgr sk_err; skjpeg_destination_mgr sk_wstream(stream); cinfo.err = jpeg_std_error(&sk_err); sk_err.error_exit = skjpeg_error_exit; if (setjmp(sk_err.fJmpBuf)) { return false; } jpeg_create_compress(&cinfo); cinfo.dest = &sk_wstream; setJpegCompressStruct(&cinfo, width, height, jpegQuality); jpeg_start_compress(&cinfo, TRUE); compress(&cinfo, (uint8_t*) inYuv, offsets); jpeg_finish_compress(&cinfo); return true; } 坑就在上面这个接口函数中: 熟悉libjpeg的同学会注意到,上面的接口在调用完jpeg_finish_compress()后,没有调用jpeg_destroy_compress(),这个接口是释放压缩工作过程中所申请的资源,主要就是jpeg压缩对象。 由于android原生接口中,没有调用jpeg_destroy_compress()导致每次泄露几十个字节,当拍照数量达到万级时,才会有所察觉。 怎么找到这个坑的: 这个过程后面有时间会详细写下,目前心得就是模块的架构十分重要,对这种数据流的控制,pipeline方式是比较好的方案,因为可以明确输入输出,然后通过伪造输入输出对各个模块进行单独的压力测试。最难控制的就是“洋葱”式的包裹调用,要像“剥洋葱”一样一层层的剥离十分麻烦。 你的android机上有这个问题吗: 9成的概率下你的手机应该不会有这个问题,因为上面我讲到是在我们做的一款终端上发现的问题,我们的终端芯片方案比较挫,没有硬编码模块,导致使用了android的软编码方案,也就用到libjpeg这个模块,也就触发了上面问题函数接口的调用。 牢骚: 做底层系统开发就是这样,一个bug耗费了很久的时间去测试,查找,验证。一层层剥离模块,逐步定位问题的大概位置,到最后精确定位问题,并解决,bug的解决可能就是一行代码的事(上面就加上destroy接口即可),但着实耗费了不少时间,如果按照代码行数计算kpi,这个performance应该是差的可以了。

优秀的个人博客,低调大师

摩托罗拉:买个“原生Android体验”的Moto X过春节

【大咖・来了 第7期】10月24日晚8点观看《智能导购对话机器人实践》 这应该是CES期间最让人激动的消息了:随着联想收购和整合的逐 步完成,曾经暂别中国市场的摩托罗拉终于又决定重回中国。在CES上接受采访时,摩托罗拉总裁及***运营官Rick Osterloh向PingWest和其他媒体表示,他们今年计划在中国推出三款手机,而Moto X在春节前就会上市。 原生Android体验的Moto X?春节前就可以买到 摩托罗拉总裁及***运营官Rick Osterloh称,新的Moto X将成为摩托罗拉回归中国后推出的***款产品,而且时间就定在二月初春节前。而且,就像Moto X的国际版一样,他们也会在中国推出不同颜色、外壳和材质的产品。而且完整定制服务Moto Maker也会推出。 Moto X并不会是摩托罗拉今年在中国推出的唯一一款产品。定位更高的Moto X Pro和主打性价比的Moto G 4G版本,都将会3月推出。其中Moto X Pro设计和Moto X基本一致,但是屏幕加大至6寸,提供1300万像素的摄像头和沉浸式体验,这应该就是Nexus 6;而Moto G是5寸屏幕,支持4G LTE。 Osterloh称,摩托罗拉曾经在中国经历了艰难的一年,但是他们很高兴能重回中国市场。在他看来,摩托罗拉在中国市场是“挑战者”的角色。不过他们没有透露具体的价格和运营商合作计划。 Moto X的主打特点是原生Android体验,在中国,这是否会发生改变?对此,刘军表示,摩托罗拉的硬件能力不用质疑,而在过去Google的主导下,软件能 力也大幅提升。所以,摩托罗拉会保留自己的这一特色,“回中国之后,将原汁原味的Moto带回来,把原生态的Android带回来。”不过,他又补充道, 还是会在手机里加上一些中国最为关键的应用 ,比如应用商店。 看来,Google Play的缺席是必然。只是不知道,除了Google Play之外,是否还有其他Google的服务会被“阉割”,而主打原生Android体验的Moto X,在本地化之后,究竟还能保留多少原生态。 智能手表Moto 360?没有推出时间表 Moto 360应该是现在摩托罗拉人气***的产品。在采访现场,包括刘军、Osterloh和其他高管,手腕上都带着一只Moto 360手表。 但是,国内的用户在短时间内可能还是没有办法从正常渠道购买到 这个产品。Osterloh说,Moto 360无论是对于摩托罗拉还是联想来说,都是很重要的产品,而且可穿戴将会是很重要的领域,但是,由于MOTO 360的系统由Google开发,联想需要与Google一起合作,才可以推动MOTO 360的入华。所以,他们目前还没有在中国推出这款产品的时间表。 不过,这是对中国市场而言,那么在国际市场上,Moto 360作为摩托罗拉在Google时代的标志性产品,在联想接盘之后,会不会产生什么变化呢?对此,刘军说,摩托罗拉和联想的并购不会影响Moto 360的计划,此前Google收购在Moto后,依然把它当做一个独立的公司对待,现在两者依然是合作伙伴关系。 Lenovo+Moto:联想再次国际化 联想和摩托罗拉合并后,最明显的好处就在于,联想由此一跃成为世界第三的手机厂商。不过,刘军认为,摩托罗拉的回归,对于联想的移动业务是很大的增强,这除了体现在数字上之外,还包括在品牌形象和定位方面的补充。 另外一个不可忽视的就是摩托罗拉在国际化方面可以给联想提供的帮助。 Osterloh称,摩托罗拉出货量去年增长了100%,在一些新兴市场表现尤其出色,在巴西获得了12%的份额,在印度也获得5%的份额,这似乎和联想希望其主攻成熟市场的初衷有点出入。 对此,刘军表示,联想之前国际化的策略是三步走:先中国,再到新兴市场,***到欧美等成熟市场。并购Moto就是第三步的开始,这种跨越式并购的方式可以让联想快速获得成熟市场的准入,并带来包括品牌、知识产权和运营商关系等诸多。 而在合并完成后,刘军称,联想将和摩托罗拉一起设计全球化的发展计划,让联想和Moto的双品牌在全球化发展。“不过Moto的重点还是在成熟市场,我们也会快速把它介绍到全球其他市场上,而Lenovo则会主打新兴市场。”

优秀的个人博客,低调大师

同样的APP,为什么别人的能过、你的被拒?

近年来移动应用市场监管持续收紧,工信部常态化通报下架违规APP已成常态,企业上架运营面临 privacy合规、安全漏洞、兼容性三类检测缺一不可的硬约束。任一环节缺失,轻则审核不通过、备案被驳回,重则通报下架、罚款并损失用户信任。Rightly(Rightly应用合规)作为腾讯端服务(TDS)联盟成员,提供一站式合规方案帮客户规避风险、保障体验,下文以知识科普结合主推品牌的方式展开。

优秀的个人博客,低调大师

你踩过这些坑吗?谨慎在时间类型列上创建索引

作者: Zeratulll 原文来源:https://tidb.net/blog/9468d259 MySQL中,一般情况下我们不需要关注有序数据的写入在Innodb的Btree上是否存在热点,因为它能承担的吞吐量是比较大的,在单机的范畴内不太容易达到瓶颈。 但是在TiDB中,写入有序数据很容易导致热点,这个热点与单机数据库不同。如果一个节点成为了热点(只有它在工作,或者所有请求都需要访问它),那整个集群无论增加多少台机器,都对提升数据库的性能容量毫无帮助,纯纯的浪费钱了。这是分布式相对单机额外产生的问题。 一个表包含时间字段(例如订单表、日志表、用户表等等),并且在时间字段上创建一个索引是我们使用MySQL时一种很常见的做法。这些时间字段很多会使用插入或者修改的时间(例如DEFAULT值设为CURRENT_TIMESTAMP或者SQL中使用NOW函数来作为值)。 时间是一种典型的有序数据,那么在使用TiDB时,我们是否可以保持像在MySQL中一样的做法来使用时间字段呢?时间字段是否会产生热点,又该如何避免? 本文将从TiDB的原理来解答上述问题。如果你是内核开发者,也有助于帮助读者进一步理解分布式数据库中数据的编码与分布。 问题 一个有趣的问题,考虑下面四张表(结构上的主要差异在于主键是AUTO_INCREMENT或者AUTO_RANDOM,gmt_create列是date类型或者datetime类型): CREATE TABLE orders1 ( id bigint(11) NOT NULL AUTO_INCREMENT, gmt_create datetime, PRIMARY KEY (id) , KEY idx_gmt_create (gmt_create) ); CREATE TABLE orders2 ( id bigint(11) NOT NULL AUTO_INCREMENT, gmt_create date, PRIMARY KEY (id) , KEY idx_gmt_create (gmt_create) ); CREATE TABLE orders3 ( id bigint(11) NOT NULL AUTO_RANDOM, gmt_create datetime, PRIMARY KEY (id) , KEY idx_gmt_create (gmt_create) ); CREATE TABLE orders4 ( id bigint(11) NOT NULL AUTO_RANDOM, gmt_create date, PRIMARY KEY (id) , KEY idx_gmt_create (gmt_create) ); 并使用insert into orders (id,gmt_create) values (null,now())进行进行连续的写入操作。 问题是:这四张表存在哪几个热点? . . . . . . . . . . . . . . . . . . . . 答案是:一共存在5个热点(你答对了吗?) orders1中存在的热点:gmt_create索引、主键; orders2中存在的热点:gmt_create索引、主键; orders3中存在的热点:gmt_create索引; orders4不存在热点。 如图所示: 解读 AUTO_INCREMENT的热点 orders1和orders2的主键上存在热点。这个的原因大家都知道的,因为TiDB的数据是按照有序的range进行划分的,主键自增,会导致写入都发生在做最后的range上,因此最后的range会是热点。这个在TiDB的文档中也有描述,这里就不再赘述了: 从 TiDB 编码规则可知,同一个表的数据会在以表 ID 开头为前缀的一个 range 中,数据的顺序按照 RowID 的值顺序排列。在表 insert 的过程中如果 RowID 的值是递增的,则插入的行只能在末端追加。当 Region 达到一定的大小之后会进行分裂,分裂之后还是只能在 range 范围的末端追加,永远只能在一个 Region 上进行 insert 操作,形成热点。 常见的 increment 类型自增主键就是顺序递增的,默认情况下,在主键为整数型时,会用主键值当做 RowID ,此时 RowID 为顺序递增,在大量 insert 时形成表的写入热点。 同时,TiDB 中 RowID 默认也按照自增的方式顺序递增,主键不为整数类型时,同样会遇到写入热点的问题。 order3和orders4的主键不存在热点,因为使用AUTO_RANDOM来生成主键,将主键做了随机化。这样的代价也是有的,主键失去了宏观上的有序性(因为TiDB的AUTO_INCREMENT是按TiDB Server分段的,所以不能说是“有序”)。 DATE与DATETIME 再来看idx_gmt_create。 回顾TiDB中索引的编码方式: Key: tablePrefix{tableID}_indexPrefixSep{indexID}_indexedColumnsValue_rowID Value: null 对于上述表结构,简化下就是: Key: {gmt_create}_{id} 这种编码格式,在比较大小的时候,简单说就是gmt_create不同则按gmt_create进行比较,gmt_create相同则按照id来比较。 对于orders1与orders3,gmt_create是DATETIME类型,包含了日期与时分秒(微秒)信息。按时间不停写入的数据,其gmt_create就是不停的在增长的有序数据,与AUTO_INCREMENT的主键类似,它也会不停的往最后一个range进行写入,因此最后一个range会成为热点。这里orders1与orders3的行为是一致的,因为gmt_create作为前缀已经是有序的了,编码出来的key基本就是有序的。后面的id作为后缀,无论是有序的还是随机的,都无法影响这个结果。 对于orders2与orders4,gmt_create是DATE类型,只包含了日期。对于一天内写入的数据,其gmt_create的值实际上都是同一个。也就是说,在决定这个数据写到哪个range的时候,起到比较作用的是id。 由于orders2的id是AUTO_INCREMENT的,因此编码出来的key也是有序的,所以产生了热点。 而orders4的id是随机的,是乱序的,因此编码出来的key也不具备有序性,写入就会分散到很多range中,因此没有热点。 注意:实际上,当日期发生切换的时候(例如每天的0点0分0秒),orders4会在短时间内出现热点(这个时间长短取决于你的流量多久能写满几百兆,将这一天数据分裂到多个range内),这个热点将表现成系统在0点的剧烈抖动,想象下双十一零点出现这种抖动吧! 优化的可能性 TiDB可以考虑修改DATETIME/TIMESTAMP类型的编码方式(或者提供一些额外的选项)。例如对于Key的部分,截断到小时,后面使用随机数进行补齐(充当了上文中随机主键的作用),将未截断的数据保存在value中或者key的结尾。 这样能很好的将连续写入的时间数据进行打散,相应的代价是,查询代价会变大(无论查询条件多么精确,都需要查出至少一小时的数据),需要过滤一些无用的数据。 结论 兼容性其实包含功能兼容性与性能兼容性,TiDB虽然功能上与MySQL的兼容性做的不错,但性能上的差异点还是比较多的。 就本例而言,我们可以得出的结论是,使用TiDB时,在时间类型上创建索引需要慎重,如果按照使用单机MySQL的习惯进行创建,很容易出现热点,导致虽然使用了分布式,但毫无扩展性可言。 如需创建,有以下几个方法(每种方法都不完美,只能做取舍): 使用DATE类型,并且主键使用AUTO_RANDOM。缺点是无法存储时分秒,主键也失去了宏观上的自增性; 使用DATE类型,并且和另一个不自增的离散列创建组合索引。例如idx_gmt_create; 使用DATE类型,并且主键使用SHARD_ROW_ID_BITS。缺点是无法存储时分秒,主键失去了宏观上的自增性,并且SHARD_ROW_ID_BITS与主键使用聚簇相冲突,这会造成写入的放大以及主键查询需要做回表; 注意DATE类型即使在平时没有热点,在0点时刻也可能带来剧烈抖动 使用分区表,这样时间索引成为了分区内的Local索引,等于按分区做了打散。这是目前能想到的DATETIME类型上使用索引又避免热点的唯一方法,但代价也很大,TiDB目前不支持在分区表上创建全局索引,不带分区键的查询性能上也容易有问题,这对业务代码有很强的侵入性。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册