首页 文章 精选 留言 我的

精选列表

搜索[然之],共10000篇文章
优秀的个人博客,低调大师

探索 OpenStack 之(7):Neutron 深入探索之 Open vSwitch (OVS) + GRE 之 Neutron节点篇

0. 测试环境 硬件环境:还是使用四节点OpenStack部署环境,参见http://www.cnblogs.com/sammyliu/p/4190843.html OpenStack配置: tenant:三个tenant:demo,tenant-one,tenant-two network:三个tenanet公用public network,每个tenant拥有自己的subnet,都有一个router连接自己的subnet到public net 虚机:三个虚机,tenant-one一个,tenant-two两个,都在compute node上 1. Neutron节点上的网络组件 使用http://www.cnblogs.com/sammyliu/p/4201143.html中相同的方法,画出Neutron节点上网络组件图: 可见: (1). 关于Neutron上的三种Agent的作用: Neutron-OVS-Agent:从OVS-Plugin上接收tunnel和tunnel flow的配置,驱动OVS来建立GRE Tunnel Neutron-DHCP-Agent:为每一个配置了DHCP的网络/子网配置dnsmasq,也负责把Mac地址/IP地址 信息写入dnsmasq dhcp lease 文件 Neturon-L3-Agent:设置iptables/routing/NAT表 (2). Neutorn节点上同样有OVS Tunnel bridge br-tun和OVS Integration bridge br-int,多了br-ex来提供外部网络连接,br-ex和物理网卡eth0绑定。这里出现的一个问题是eth0的IP无法ping通,OVS提供的解决方法如下。究其原因,一块物理以太网卡如果作为 OpenvSwitch bridge 的一部分,则它不能拥有 IP 地址,如果有,也会完全不起作用。如果发生了上述情况,可以将 IP 地址绑定至某 OpenvSwitch “internal” 设备来恢复网络访问功能。 ifconfig eth0 0.0.0.0 ifconfig br-ex 192.168.1.19 (3). Neutron使用Linux network namespace来实现tenant之间的网络隔离。本例中有三个network namespace,每个network namspace包括router,dhcp,interface,routing tables,iptable rules等。 root@network:/home/s1# ip netns qdhcp-d24963da-5221-481e-adf5-fe033d6e0b4e qrouter-e506f8fe-3260-4880-bd06-32246225aeae qdhcp-d04a0a06-7206-4d05-9432-3443843bc199 qrouter-33e2b1bf-04cb-4811-9c58-7e03856022c1 qrouter-9ba04071-f32b-435e-8f44-e32936568102 qdhcp-0a4cd030-d951-401a-8202-937b788bea43 (4). Neutron 为每一个 network 分配一个本地的 VLAN ID,每个 network 分配一个 network namespace,该DHCP 通过一个 tap 连接在 br-int 上,该 tap 的 tag 为该 local VLAN ID。H1/H2/H3端口上分布有不同的VLAN ID。 #在存在多个 network 的情况下,br-int 上DHCP namespace 端口的 tag 情况 Port "tap0f45d165-9f" tag: 5 Interface "tap0f45d165-9f" type: internal Port "tap89874f55-97" tag: 4 Interface "tap89874f55-97" type: internal Port "tap5522533d-fe" tag: 3 Interface "tap5522533d-fe" type: internal Port "tap56c9730c-9c" tag: 4095 Interface "tap56c9730c-9c" type: internal Port "tap1fd04a93-09" tag: 4095 Interface "tap1fd04a93-09" type: internal Port "tap777c1047-ed" tag: 2 Interface "tap777c1047-ed" type: internal Port "tap3fca96e0-c6" tag: 1 Interface "tap3fca96e0-c6" type: internal (5). 不知道为什么br-ex和br-int之间还需要有直接的path。网上看到一些说法,似乎不是所有的环境都需要使用这条路径,比如当前的环境,往外走的traffic都会经过router到br-ex,应该不会直接到从br-int到br-ex。也许是某些配置中需要用到。解释之一是eth0是虚机网络的物理网卡,这么说的话它就是必须要有的。 (6). Neutron-OVS-Agent会从Neutron db的表 ml2_gre_endpoints中读取GRE端口的信息。如果其中出现错误的IP地址,Neutron上会出现错误的GRE Tunnel。解决方法是先删除数据库中的错误记录,在重启 neutron-plugin-openvswitch-agent service. 1.1 br-tun OpenFlow rules 插播Mac地址的基础知识: MAC地址是以太网二层使用的一个48bit(6字节十六进制数)的地址,用来标识设备位置。MAC地址分成两部分,前24位是组织唯一标识符(OUI, Organizationally unique identifier),后24位由厂商自行分配。48bit的MAC地址一般用6字节的十六进制来表示,如XX-XX-XX-XX-XX-XX。 广播地址:FF:FF:FF:FF:FF:FF 组播地址:MAC组播地址的特征是头8位的最低位是1。例如01:80:C2:00:00:00是一个组播地址,表示802.1d网桥多播组。网桥就是使用这个地址,相互之间交换配置信息,运行分布式生成树算法,消除网络拓扑结构中的环路。 单播地址:单播地址的特征是头8位的最低位为0。每个网卡出厂时被分配唯一一个单播地址,头24位是设备制造厂商的编号,由IEEE(电气与电子工程师协会)分配,后24位是设备厂商为网卡制定的唯一编号。例如8C-70-5A-29-3A-48是单播地址的例子 (8C = 10001100)。 root@network:/home/s1# ovs-ofctl dump-flows br-tun NXST_FLOW reply (xid=0x4): cookie=0x0, duration=33.236s, table=0, n_packets=0, n_bytes=0, idle_age=33, priority=1,in_port=1 actions=resubmit(,2)//从H1进来的traffic,到table 2 cookie=0x0, duration=32.131s, table=0, n_packets=0, n_bytes=0, idle_age=32, priority=1,in_port=2 actions=resubmit(,3) //从GRE端口进来的traffic,到table 3 cookie=0x0, duration=33.178s, table=0, n_packets=6, n_bytes=480, idle_age=24, priority=0 actions=drop cookie=0x0, duration=33.121s, table=2, n_packets=0, n_bytes=0, idle_age=33, priority=0,dl_dst=00:00:00:00:00:00/01:00:00:00:00:00 actions=resubmit(,20)//目的地址为单播地址,到table 20 cookie=0x0, duration=33.066s, table=2, n_packets=0, n_bytes=0, idle_age=33, priority=0,dl_dst=01:00:00:00:00:00/01:00:00:00:00:00 actions=resubmit(,22)//目的地址为组播(包括广播)地址,到table 22 cookie=0x0, duration=30.614s, table=3, n_packets=0, n_bytes=0, idle_age=30, priority=1,tun_id=0x1 actions=mod_vlan_vid:1,resubmit(,10)//Tunnel 1的traffic,修改VLAN ID 为 1, 再到 table 10 cookie=0x0, duration=29.291s, table=3, n_packets=0, n_bytes=0, idle_age=29, priority=1,tun_id=0x2 actions=mod_vlan_vid:3,resubmit(,10)//Tunnel 2的traffic,修改VLAN ID 为 2, 再到 table 10 cookie=0x0, duration=30.241s, table=3, n_packets=0, n_bytes=0, idle_age=30, priority=1,tun_id=0x3 actions=mod_vlan_vid:2,resubmit(,10)//Tunnel 3的traffic,修改VLAN ID 为 3, 再到 table 10 cookie=0x0, duration=33.001s, table=3, n_packets=0, n_bytes=0, idle_age=33, priority=0 actions=drop cookie=0x0, duration=32.932s, table=4, n_packets=0, n_bytes=0, idle_age=32, priority=0 actions=drop cookie=0x0, duration=32.874s, table=10, n_packets=0, n_bytes=0, idle_age=32, priority=1 actions=learn(table=20,hard_timeout=300,priority=1,NXM_OF_VLAN_TCI[0..11],NXM_OF_ETH_DST[]=NXM_OF_ETH_SRC[],load:0->NXM_OF_VLAN_TCI[],load:NXM_NX_TUN_ID[]->NXM_NX_TUN_ID[],output:NXM_OF_IN_PORT[]),output:1//学习一条新的规则添加到table 20,发到端口1,进入br-int cookie=0x0, duration=32.815s, table=20, n_packets=0, n_bytes=0, idle_age=32, priority=0 actions=resubmit(,22)//到table 22 cookie=0x0, duration=29.35s, table=22, n_packets=0, n_bytes=0, idle_age=29, dl_vlan=3 actions=strip_vlan,set_tunnel:0x2,output:2 cookie=0x0, duration=30.293s, table=22, n_packets=0, n_bytes=0, idle_age=30, dl_vlan=2 actions=strip_vlan,set_tunnel:0x3,output:2 cookie=0x0, duration=30.682s, table=22, n_packets=0, n_bytes=0, idle_age=30, dl_vlan=1 actions=strip_vlan,set_tunnel:0x1,output:2//以上三条rule,根据目的VLAN ID,修改Tunnel ID,并去掉VLAN ID,发到GRE端口,经过GRE Tunnel到compute node cookie=0x0, duration=32.752s, table=22, n_packets=0, n_bytes=0, idle_age=32, priority=0 actions=drop 总之,br-tun会: 把从GRE端口来的traffic设置相应的VLAN ID,发到br-int 把从br-int/patch-int来的traffic,去掉VLAN ID,设置相应的Trunne ID,经过GRE端口H1 发到Compute节点 2. Router Server 2.1 以tenant-one (有一个虚机)的router为例,先看看它的interface (略去lo) root@network:/home/s1# ip netns exec qrouter-33e2b1bf-04cb-4811-9c58-7e03856022c1 ip addr 22: qr-d3d3e235-d4: <BROADCAST,UP,LOWER_UP> mtu 1500 qdisc noqueue state UNKNOWN group default link/ether fa:16:3e:b3:06:e8 brd ff:ff:ff:ff:ff:ff inet 10.0.11.1/24 brd 10.0.11.255 scope global qr-d3d3e235-d4 valid_lft forever preferred_lft forever inet6 fe80::f816:3eff:feb3:6e8/64 scope link valid_lft forever preferred_lft forever 26: qg-6c06581b-bd: <BROADCAST,UP,LOWER_UP> mtu 1500 qdisc noqueue state UNKNOWN group default link/ether fa:16:3e:0b:ac:82 brd ff:ff:ff:ff:ff:ff inet 192.168.1.114/24 brd 192.168.1.255 scope global qg-6c06581b-bd valid_lft forever preferred_lft forever inet 192.168.1.115/32 brd 192.168.1.115 scope global qg-6c06581b-bd valid_lft forever preferred_lft forever inet6 fe80::f816:3eff:fe0b:ac82/64 scope link valid_lft forever preferred_lft forever 可见: qg-6c06581b-bd 连接 br-ex qr-d3d3e235-d4连接br-int 再看看它的route规则: root@network:/home/s1# ip netns exec qrouter-33e2b1bf-04cb-4811-9c58-7e03856022c1 route -n Kernel IP routing table Destination Gateway Genmask Flags Metric Ref Use Iface 0.0.0.0 192.168.1.1 0.0.0.0 UG 0 0 0 qg-6c06581b-bd //默认路由,所有目的地址不在本网络中的traffic都要通过 qg-d3657c7f-28 interface 发到外网网关192.168.1.1 10.0.11.0 0.0.0.0 255.255.255.0 U 0 0 0 qr-d3d3e235-d4 //目的为本子网内的traffic 经过 qr-d3d3e235-d4 发到子网网关 10.0.11.1 192.168.1.0 0.0.0.0 255.255.255.0 U 0 0 0 qg-6c06581b-bd //目的为 192.168.1.0/24 的traffic通过 qg-6c06581b-bd 发到网关192.168.1.100 2.2 Neutorn Floating IP 实现原理 Router namespace中的 netfilter NAT 表负责 Neutron Floating IP 的实现。下面是tenant-two (有两个虚机)的router的NAT表: root@network:/home/s1# ip netns exec qrouter-e506f8fe-3260-4880-bd06-32246225aeae iptables -t nat -S -P PREROUTING ACCEPT -P INPUT ACCEPT -P OUTPUT ACCEPT -P POSTROUTING ACCEPT -N neutron-l3-agent-OUTPUT -N neutron-l3-agent-POSTROUTING -N neutron-l3-agent-PREROUTING -N neutron-l3-agent-float-snat -N neutron-l3-agent-snat -N neutron-postrouting-bottom -A PREROUTING -j neutron-l3-agent-PREROUTING -A OUTPUT -j neutron-l3-agent-OUTPUT -A POSTROUTING -j neutron-l3-agent-POSTROUTING -A POSTROUTING -j neutron-postrouting-bottom -A neutron-l3-agent-OUTPUT -d 192.168.1.118/32 -j DNAT --to-destination 10.0.22.200 -A neutron-l3-agent-OUTPUT -d 192.168.1.117/32 -j DNAT --to-destination 10.0.22.202 -A neutron-l3-agent-POSTROUTING ! -i qg-cba7b139-04 ! -o qg-cba7b139-04 -m conntrack ! --ctstate DNAT -j ACCEPT -A neutron-l3-agent-PREROUTING -d 169.254.169.254/32 -p tcp -m tcp --dport 80 -j REDIRECT --to-ports 9697 -A neutron-l3-agent-PREROUTING -d 192.168.1.118/32 -j DNAT --to-destination 10.0.22.200 -A neutron-l3-agent-PREROUTING -d 192.168.1.117/32 -j DNAT --to-destination 10.0.22.202 -A neutron-l3-agent-float-snat -s 10.0.22.200/32 -j SNAT --to-source 192.168.1.118 -A neutron-l3-agent-float-snat -s 10.0.22.202/32 -j SNAT --to-source 192.168.1.117 -A neutron-l3-agent-snat -j neutron-l3-agent-float-snat -A neutron-l3-agent-snat -s 10.0.22.0/24 -j SNAT --to-source 192.168.1.116 -A neutron-postrouting-bottom -j neutron-l3-agent-snat SNAT (源地址转换) 负责把从虚机来的traffic的 IP源地址 即fixed ip 10.0.22.200/202 转化为 floating ip 192.168.1.118/117,然后该traffic被路由到 br-ex 再到外网 DNAT (目的地址转换)负责把从外网来的traffic的 IP目的地址 即floating ip 192.168.1.118/117 转化为虚机所使用的 fixed ip 10.0.22.200/202,然后该traffic被路由到br-int 再到虚机 3. DHCP Server 每一个有DHCP的网络都在Neutron节点上有一个DHCP服务,每个DHCP Server都是一个运行在一个network namespace中的dnsmasq进程。dnsmasq是一个用在Linux上的轻型DNS和DHCP服务,具体见http://www.thekelleys.org.uk/dnsmasq/docs/dnsmasq-man.html. 3.1 每个DHCP在neutron host上都有一个process,其ID是qdhcp-<net id>: nobody 2049 1 0 06:43 ? 00:00:00dnsmasq --no-hosts --no-resolv --strict-order --bind-interfaces--interface=tap15865c29-9b--except-interface=lo --pid-file=/var/lib/neutron/dhcp/d24963da-5221-481e-adf5-fe033d6e0b4e/pid --dhcp-hostsfile=/var/lib/neutron/dhcp/d24963da-5221-481e-adf5-fe033d6e0b4e/host --addn-hosts=/var/lib/neutron/dhcp/d24963da-5221-481e-adf5-fe033d6e0b4e/addn_hosts --dhcp-optsfile=/var/lib/neutron/dhcp/d24963da-5221-481e-adf5-fe033d6e0b4e/opts --leasefile-ro --dhcp-range=set:tag0,10.0.22.0,static,86400s --dhcp-lease-max=256 --conf-file= --domain=openstacklocal 说明: 1. --interface=tap15865c29-9b: 该process绑定/监听一个TAP设备,即上图中的 H3 2. --dhcp-hostsfile=/var/lib/neutron/dhcp/d24963da-5221-481e-adf5-fe033d6e0b4e/host: root@network:/home/s1# cat /var/lib/neutron/dhcp/d24963da-5221-481e-adf5-fe033d6e0b4e/host fa:16:3e:4d:6b:44,host-10-0-22-201.openstacklocal,10.0.22.201//本子网DHCP Server自己(M3)的Mac地址以及IP fa:16:3e:79:07:5e,host-10-0-22-1.openstacklocal,10.0.22.1//本子网Router Server ( N3) 的Mac地址,名字和 IP fa:16:3e:bf:69:36,host-10-0-22-200.openstacklocal,10.0.22.200//本子网虚机1的Mac地址,虚机的主机名字,虚机的fixed IP fa:16:3e:19:65:62,host-10-0-22-202.openstacklocal,10.0.22.202//本子网虚机2的Mac地址,虚机的主机名字,虚机的fixed IP fa:16:3e:88:99:c1,host-10-0-0-116.openstacklocal,10.0.0.116//子网1的DHCP Server (H1)的Mac地址,以及IP地址。那么这里为什么没H2的相应信息? 在虚机的创建过程中,Neutron会把这些信息(应该是从neutron db中拿到一个可用的IP地址)写到该文件中,这样,当虚机使用Mac地址向DHCP Server查询IP地址的时候,dnsmasq会读取该文件把IP地址返回给它。 3.2 DHCP的interface (省去lo) root@network:/home/s1# ip netns exec qdhcp-0a4cd030-d951-401a-8202-937b788bea43 ip addr 18: tap6356d532-32: <BROADCAST,UP,LOWER_UP> mtu 1500 qdisc noqueue state UNKNOWN group default link/etherfa:16:3e:88:99:c1brd ff:ff:ff:ff:ff:ff inet10.0.0.116/24brd 10.0.0.255 scope global tap6356d532-32 valid_lft forever preferred_lft forever inet6 fe80::f816:3eff:fe88:99c1/64 scope link valid_lft forever preferred_lft forever root@network:/home/s1# ip netns exec qdhcp-d04a0a06-7206-4d05-9432-3443843bc199 ip addr 17: tap8dfd0bd8-45: <BROADCAST,UP,LOWER_UP> mtu 1500 qdisc noqueue state UNKNOWN group default link/etherfa:16:3e:82:fd:26brd ff:ff:ff:ff:ff:ff inet10.0.11.101/24brd 10.0.11.255 scope global tap8dfd0bd8-45 valid_lft forever preferred_lft forever inet6 fe80::f816:3eff:fe82:fd26/64 scope link valid_lft forever preferred_lft forever root@network:/home/s1# ip netns exec qdhcp-d24963da-5221-481e-adf5-fe033d6e0b4e ip addr 19: tap15865c29-9b: <BROADCAST,UP,LOWER_UP> mtu 1500 qdisc noqueue state UNKNOWN group default link/ether fa:16:3e:4d:6b:44 brd ff:ff:ff:ff:ff:ff inet 10.0.22.201/24 brd 10.0.22.255 scope global tap15865c29-9b valid_lft forever preferred_lft forever inet6 fe80::f816:3eff:fe4d:6b44/64 scope link valid_lft forever preferred_lft forever DHCP使用fix ip range的第一个可用IP地址做为其IP地址。它的interface的MAC地址fa:16:3e:4d:6b:44 会出现在br-tun的rules里面。 3.3 虚机向DHCP Server申请/查询Fixed IP 具体步骤在下一篇博文中详细描述。 本文转自SammyLiu博客园博客,原文链接:http://www.cnblogs.com/sammyliu/p/4201721.html,如需转载请自行联系原作者


优秀的个人博客,低调大师

Android初级进阶之自定义View之SafeVeiw

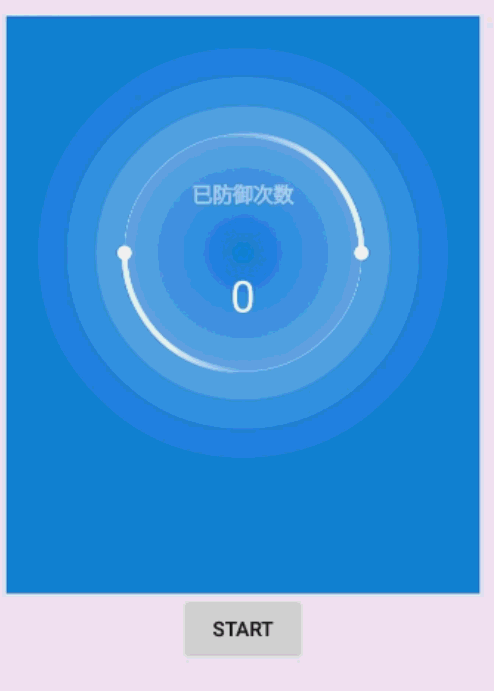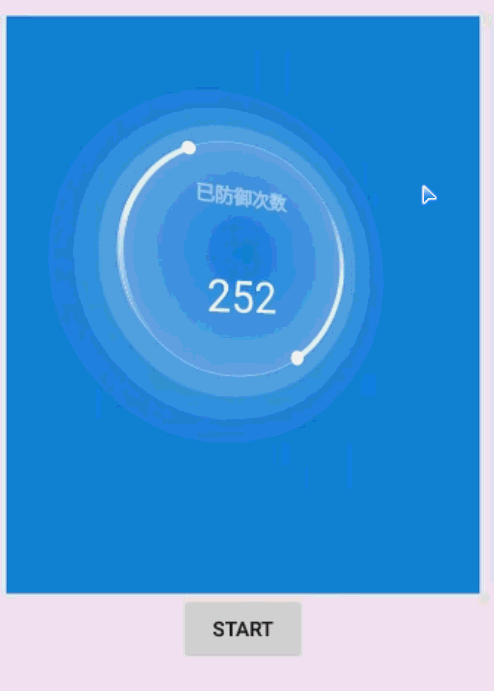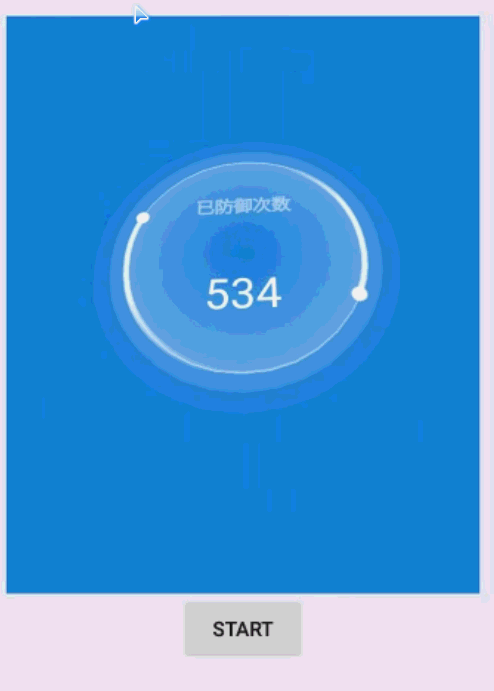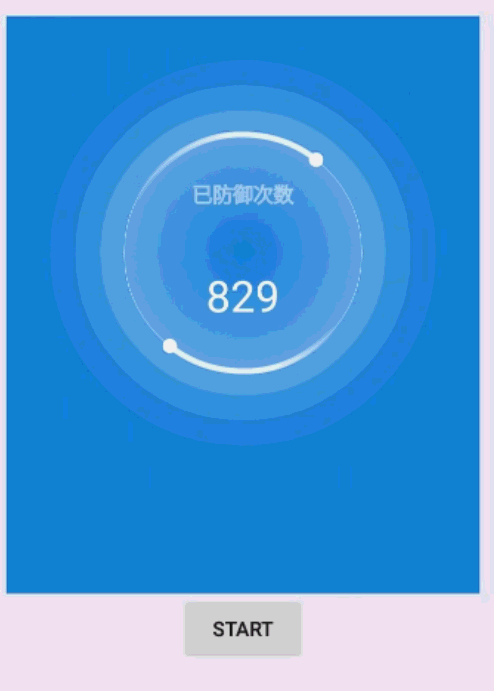
SafeView 这是我模仿的一个效果,要不断的进步,就要不断的学习。主要实现的效果是一个转动的效果和一个3D触摸效果。请看效果图(录制的图片有点大): 效果图 知识点 1. Canvas 2. Paint 3. Shader 4. Camera(不是相机) 5. Animator 分析 整个View看上去是有四个圆组成,内中心的圆对边上有一个小圆,圆上面还有小尾巴。其实主要的原理是使用ValueAnimator来发散一个圆周的值,也就是360度,然后每次发散后旋转画布就能得到上面的效果。 技术点 android.graphics.Camera是Android官方提供的3D效果组件,使用起来十分的简单,关键在于理解其中的x,y,z轴。(有空再写一篇Camera的使用) Sharder 阴影渲染 本View中主要使用了LinearGradient和RadialGradient。 LinearGradient为线性渐变,在这里主要是用来画小圆的尾巴。 RadialGradient为径向渐变,从圆心向外四周扩散,在这里是用来画中心圆的效果。 Animator 自3.0后推出的属性动画,本文主要使用ValueAnimator。 CODE 1.初始化 && Measure 将一些全局的值在构方法中进行初始化并且测量View的宽高等。 mPaint = new Paint(); mPaint.setAntiAlias(true); mPaint.setStrokeCap(Paint.Cap.ROUND);// 圆角笔触 mLeftLinearGradient = new LinearGradient(0, 0, mCy - OFFSET, mCy - OFFSET, 0xddffffff, 0x00000000, Shader.TileMode.CLAMP);//左边的尾巴 mRightLinearGradient = new LinearGradient(mCy - OFFSET, mCy / 2, 0, mCy / 2, 0xddffffff, 0x00000000, Shader.TileMode.CLAMP);//右边的尾巴 2.绘制所有的背景圆 圆的颜色是从中心开始不断的淡化的,其实这只要更改透明度就可以完成这样的效果 /** * @param canvas * @param radius 直径 * @param angle 当前角度 */ private void canvasCircle(Canvas canvas, int radius, float angle) { float percentage = angle / 360f;//当前角度百分比 mPaint.setColor(0xddffffff); mPaint.setStyle(Paint.Style.STROKE); mPaint.setStrokeWidth(1.5f); //绘制中心圆圈 canvas.drawCircle(radius, radius, radius - OFFSET, mPaint); mPaint.setStyle(Paint.Style.FILL); mPaint.setColor(0x22ffffff); if (aninatopValue >= 90) { //绘制第二圆圈 canvas.drawCircle(radius, radius, radius - OFFSET + 40 * percentage, mPaint); } mPaint.setColor(0x11ffffff); if (aninatopValue >= 180) { //绘制第三圆圈 canvas.drawCircle(radius, radius, radius - OFFSET + 80 * percentage, mPaint); } if (aninatopValue >= 270) { //绘制第四圆圈 canvas.drawCircle(radius, radius, radius - OFFSET + 120 * percentage, mPaint); } if (aninatopValue <= 90) {// 初始状态下绘制所有的圆圈 mPaint.setColor(0x22ffffff); canvas.drawCircle(radius, radius, radius - OFFSET + 40, mPaint); mPaint.setColor(0x11ffffff); canvas.drawCircle(radius, radius, radius - OFFSET + 80, mPaint); canvas.drawCircle(radius, radius, radius - OFFSET + 120, mPaint); } mPaint.setColor(0xff1782dd);//绘制中心圆为背景颜色 canvas.drawCircle(radius, radius, radius - OFFSET, mPaint); mPaint.setColor(0x55ffffff); //渲染 得到中心的 凹凸效果 RadialGradient radialGradient = new RadialGradient(radius, radius, radius - OFFSET, new int[]{0x00000000, 0xffffffff}, null, Shader.TileMode.CLAMP); mPaint.setShader(radialGradient); canvas.drawCircle(radius, radius, radius - OFFSET, mPaint); } 效果图: 绘制完所有的圆 3.绘制中间的文字 /** * //绘制文字 * * @param canvas * @param radius */ private void canvasText(Canvas canvas, int radius) { mPaint.setShader(null);//文字颜色 mPaint.setColor(0x88ffffff);//转换字体 mPaint.setTextSize(DensityUtils.sp2px(getContext(), 14)); mPaint.setStrokeWidth(2); mPaint.setStyle(Paint.Style.STROKE); String safeText = "已防御次数"; canvas.drawText(safeText, radius - mPaint.measureText(safeText) / 2, (radius - mPaint.measureText(String.valueOf(safeText)) / 2), mPaint); mPaint.setStyle(Paint.Style.FILL); mPaint.setColor(0xffffffff); mPaint.setTextSize(DensityUtils.sp2px(getContext(), 30)); mPaint.setStrokeWidth(2); canvas.drawText(String.valueOf(safeCount), radius - mPaint.measureText(String.valueOf(safeCount)) / 2, radius + radius / 4, mPaint); } 绘制中间的文字 4.绘制左右两个圆点并旋转 到这里,基本绘制就已经完成了,只要加上角度的计算和动画部分,这个View就能够动起来了。 /** * 绘制旋转部分 */ private void canvasRotate(Canvas canvas, int radius, float angle) { //旋转画布 canvas.rotate(angle, radius, radius); //移动坐标到中心 canvas.translate(radius, radius); mPaint.setShader(null); //左边的圆 mPaint.setColor(Color.WHITE); mPaint.setStyle(Paint.Style.FILL); mPaint.setStrokeWidth(5); canvas.drawCircle(-radius + OFFSET, 0, 10, mPaint); //右边的圆 canvas.drawCircle(radius - OFFSET, 0, 10, mPaint); mPaint.setStyle(Paint.Style.STROKE); mPaint.setStrokeWidth(8); //绘制坐标的圆的尾巴 RectF mRectF = new RectF(-radius + OFFSET, -radius + OFFSET, radius - OFFSET, radius - OFFSET); mPaint.setShader(mRightLinearGradient); canvas.drawArc(mRectF, 15, 180 - 15, false, mPaint); mPaint.setShader(mLeftLinearGradient); canvas.drawArc(mRectF, 180 + 15, 180 - 15, false, mPaint); //合并画布 canvas.restore(); } 绘制左右两个圆点 5.动画与角度 /** * 开始 */ private void startLoopAnimator() { //发散350度 motionAnimator = ValueAnimator.ofFloat(360f).setDuration(1500); //线性差值器 motionAnimator.setInterpolator(new LinearInterpolator()); //永远循环 motionAnimator.setRepeatCount(ValueAnimator.INFINITE); motionAnimator.addUpdateListener(new ValueAnimator.AnimatorUpdateListener() { @Override public void onAnimationUpdate(ValueAnimator animation) { safeCount++; aninatopValue = (float) animation.getAnimatedValue(); postInvalidate(); } }); motionAnimator.start(); } 加入动画后完成 最后 源码

优秀的个人博客,低调大师

Golang 之禅

在本月初的 GopherCon上,知名 Go 语言贡献者与布道师Dave Cheney发表了名为《The Zen of Go》的演讲,之后他整理了演讲内容在博客中分享,由于内容过长,他又写了一个简洁版本: 完整版:https://dave.cheney.net/2020/02/23/the-zen-of-go 简洁版:https://the-zen-of-go.netlify.com 这里简单翻译一下简洁版本的内容: 编写简单、可读、可维护的 Go 代码的十个工程要点。 每个包实现单一目标 设计良好的 Go 软件包提供一个单一的思路,以及一系列相关的行为。一个好的 Go 软件包首先需要选择一个好名字,使用电梯法则(30 秒内向客户讲清楚一个方案),仅用一个词来思考你的软件包要提供什么功能。 明确处理错误 健壮的程序其实是由处理故障案例的片段组成的,并且需要在故障出现之前处理好。冗余的if err != nil { return err }比出了故障再一个个去处理更有价值。panic 和recover 也一样。 尽早 return,不要深陷 每次缩进时都会在程序员的堆栈中添加另一个先决条件,这会占用他们短期内存中的 7±2 个片段。避免需要深层缩进的控制流。与其深入嵌套,不如使用守卫子句将成功路径保持在左侧。 并发权留给调用者 让调用者选择是否要异步运行你的库或函数,不要强制他们使用异步。 在启动 goroutine 之前,要知道它什么时候会停止 goroutines 拥有资源、锁、变量与内存等,释放这些资源的可靠方法是停止goroutine。 避免包级别的状态 要完成明确和减少耦合的操作,需要通过提供类型需要的依赖项作为该类型上的字段,而不是使用包变量。 简单性很重要 简单性不是老练的代名词。简单并不意味着粗糙,它意味着可读性和可维护性。如果可以选择,请遵循较简单的解决方案。 编写测试以确认包 API 的行为 软件包的 API 是与使用者的一份合约,不管先后,不管多少,一定要进行测试。测试是确定合约的保证。要确保测试使用者可以观察和依赖的行为。 如果你认为速度缓慢,先通过基准测试进行验证 以性能之名会犯下许多危害可维护性的罪行。优化会破坏抽象、暴露内部和紧密耦合。如果要付出这样的代价,请确保有充分理由这样做。 节制是一种美德 适度使用 goroutine、通道、锁、接口与嵌套。

优秀的个人博客,低调大师

Hadoop 之 HDFS

1 HDFS 概述 1.1 HDFS 产出背景及定义 随着数据量越来越大,在一个操作系统存不下所有的数据,那么就分配到更多的操作系统管理的磁盘中,但是不方便管理和维护,迫切需要一种系统来管理多台机器上的文件,这就是分布式文件管理系统。HDFS只是分布式文件管理系统中的一种。 HDFS(Hadoop Distributed File System),它是一个文件系统,用于存储文件,通过目录树来定位文件;其次,它是分布式的,由很多服务器联合起来实现其功能,集群中的服务器有各自的角色。 HDFS的使用场景:适合一次写入,多次读出的场景,且不支持文件的修改。适合用来做数据分析,并不适合用来做网盘应用。 1.2 HDFS优缺点 优点: 高容错性 数据自动保存多个副本。它通过增加副本的形式,提高容错性 某一个副本丢失以后,它可以自动恢复 适合处理大数据 可构建在廉价机器上,通过多副本机制,提高可靠性 缺点: 不适合低延时数据访问,比如毫秒级的存储数据 无法高效的对大量小文件进行存储 不支持并发写入、文件随机修改 1.3 HDFS组成架构 1.4 HDFS文件块大小 HDFS 中的文件在物理上是分块存储(Block),块的大小可以通过配置参数(dfs.blocksize)来规定,默认大小在Hadoop2.x 版本中是 128M,老版本中是 64M。 如果寻址时间为 100ms,即查找目标 Block 的时间是 100ms。 寻址时间与传输时间的比例为 100 : 1为最佳状态,因此传输时间为 1ms。 目前磁盘的传输速率大概在 100MB/s,取个整大概就是 128MB。 2 HDFS 的 Shell 操作 (1)-help:输出这个命令参数 (2)-ls:显示目录信息 (3)-mkdir:在 HDFS 上创建目录 (4)-moveFromLocal:从本地剪切粘贴到 HDFS (5)-appendToFile:追加一个文件到已经存在的文件末尾 (6)-cat:显示文件内容 (7)-chgrp 、-chmod、-chown:Linux 文件系统中的用法一样,修改文件所属权限 (8)-copyFromLocal:从本地文件系统中拷贝文件到 HDFS 路径去 (9)-copyToLocal:从 HDFS 拷贝到本地 (10)-cp :从 HDFS 的一个路径拷贝到 HDFS 的另一个路径 (11)-mv:在 HDFS 目录中移动文件 (12)-get:等同于 copyToLocal,就是从 HDFS 下载文件到本地 (13)-getmerge:合并下载多个文件,比如 HDFS 的目录 /user/djm/test 下有多个文件:log.1, log.2,log.3,... (14)-put:等同于 copyFromLocal (15)-tail:显示一个文件的末尾 (16)-rm:删除文件或文件夹 (17)-rmdir:删除空目录 (18)-du:统计文件夹的大小信息 (19)-setrep:设置 HDFS 中文件的副本数量 3 HDFS 客户端操作 package com.djm.hdfsclient; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.*; import org.junit.After; import org.junit.Before; import org.junit.Test; import java.io.IOException; import java.net.URI; public class HdfsClient { FileSystem fileSystem = null; @Before public void init() { try { fileSystem = FileSystem.get(URI.create("hdfs://hadoop102:9000"), new Configuration(), "djm"); } catch (IOException e) { e.printStackTrace(); } catch (InterruptedException e) { e.printStackTrace(); } } /** * 上传文件 */ @Test public void put() { try { fileSystem.copyFromLocalFile(new Path("C:\\Users\\Administrator\\Desktop\\Hadoop 入门.md"), new Path("/")); } catch (IOException e) { e.printStackTrace(); } } /** * 下载文件 */ @Test public void download() { try { // useRawLocalFileSystem表示是否开启文件校验 fileSystem.copyToLocalFile(false, new Path("/Hadoop 入门.md"), new Path("C:\\Users\\Administrator\\Desktop\\Hadoop 入门1.md"), true); } catch (IOException e) { e.printStackTrace(); } } /** * 删除文件 */ @Test public void delete() { try { // recursive表示是否递归删除 fileSystem.delete(new Path("/Hadoop 入门.md"), true); } catch (IOException e) { e.printStackTrace(); } } /** * 文件重命名 */ @Test public void rename() { try { fileSystem.rename(new Path("/tmp"), new Path("/temp")); } catch (IOException e) { e.printStackTrace(); } } /** * 查看文件信息 */ @Test public void ls() { try { RemoteIterator<locatedfilestatus> listFiles = fileSystem.listFiles(new Path("/etc"), true); while (listFiles.hasNext()) { LocatedFileStatus fileStatus = listFiles.next(); if (fileStatus.isFile()) { // 仅输出文件信息 System.out.print(fileStatus.getPath().getName() + " " + fileStatus.getLen() + " " + fileStatus.getPermission() + " " + fileStatus.getGroup() + " "); // 获取文件块信息 BlockLocation[] blockLocations = fileStatus.getBlockLocations(); for (BlockLocation blockLocation : blockLocations) { // 获取节点信息 String[] hosts = blockLocation.getHosts(); for (String host : hosts) { System.out.print(host + " "); } } System.out.println(); } } } catch (IOException e) { e.printStackTrace(); } } @After public void exit() { try { fileSystem.close(); } catch (IOException e) { e.printStackTrace(); } } } 4 HDFS 的数据流 4.1 HDFS写数据流程 4.1.1 剖析文件写入 1、客户端通过 Distributed FileSystem 模块向 NameNode 请求上传文件,NameNode 检查目标文件是否已存在,父目录是否存在。 2、NameNode 返回是否可以上传。 3、客户端请求第一个 Block 上传到哪几个 DataNode。 4、NameNode 返回三个节点,分别是 dn1、dn2、dn3。 5、客户端通过 FSDataOutputStream 模块请求 dn1 上传数据,dn1 收到请求会继续调用 dn2,然后 dn2 调用 dn3,将这个通信管道建立完成。 6、按倒序逐级响应客户端。 7、客户端开始往 dn1 上传第一个 Block(先从磁盘读取数据放到一个本地内存缓存),以 Packet 为单位,dn1 收到一个Packet 就会传给 dn2,dn2 传给 dn3;dn1 每传一个 packet 会放入一个应答队列等待应答。 8、当一个Block传输完成之后,客户端再次请求NameNode上传第二个Block的服务器。 4.1.2 网络拓扑-节点距离计算 在HDFS写数据的过程中,NameNode会选择距离待上传数据最近距离的DataNode接收数据。那么这个最近距离怎么计算呢? 4.1.3 机架感知 4.2 HDFS读数据流程 1、客户端通过 Distributed FileSystem 向 NameNode 请求下载文件,NameNode通过查询元数据,找到文件块所在的DataNode地址。 2、根据就近原则挑选一台 DataNode,请求读取数据。 3、DataNode 开始传输数据给客户端。 4、客户端以 Packet 为单位接收,先在本地缓存,然后写入目标文件。 5 NameNode 和 SecondaryNameNode 5.1 NN 和 2NN 工作机制 如果存储在 NameNode 节点的磁盘中,因为经常需要进行随机访问,还有响应客户请求,必然是效率过低,因此,元数据必须存放在内存中,周所周知,内存的特点是速度快,断电后丢失数据,一旦断电,元数据丢失,整个集群就无法工作了,因此产生了用于备份元数据的 FsImage。 但是这样又会引发一个问题,当内存中的元数据更新时,FsImage 是否要同时更新,如果要同步更新,就会导致效率低,如果不同步更新,就会导致数据一致性问题,一旦突然断电,就会丢失一部分数据,因此,引入了 Edits(只进行追加操作,效率很高),每当元数据进行增加或者修改时,先追加到 Edits,在修改内存,这样的话,一旦断电,可以通过 FsImage 和 Edits 合成元数据。 但是,如果长时间添加数据到 Edits,导致 Edits 过大,还是会影响效率,而且一旦断电,恢复元数据的时间也会相应增加,因此,需要定期的对 FsImage 和 Edits 进行合并,如果这个操作由 NameNode 去完成,又会效率低(因为在合并后不能处理写请求),所以引入了 SecondaryNameNode,专门用来做合并操作。 NameNode 工作: 1、第一次启动 NameNode格式化后,创建 Fsimage 和 Edits 文件,如果不是第一次启动,直接加载编辑日志和镜像文件到内存。 2、客户端对元数据进行增删改操作。 3、NameNode 记录操作日志,更新滚动日志。 4、NameNode 在内存中对元数据进行增删改操作。 Secondary NameNode 工作: 1、Secondary NameNode 询问 NameNode 是否需要 CheckPoint,直接带回 NameNode 是否检查结果。 2、Secondary NameNode请求执行CheckPoint。 3、NameNode 滚动正在写的 Edits 日志。 4、将滚动前的编辑日志和镜像文件拷贝到 Secondary NameNode。 5、Secondary NameNode 加载编辑日志和镜像文件到内存合并。 6、生成新的镜像文件 fsimage.chkpoint。 7、拷贝 fsimage.chkpoint 到 NameNode。 8、NameNode 将 fsimage.chkpoint 重命名为 fsimage。 5.2 Fsimage 和 Edits 解析 oiv 查看Fsimage 文件 hdfs oiv -p 文件类型 -i镜像文件 -o 转换后文件输出路径 oev 查看 Edits 文件 hdfs oev -p 文件类型 -i编辑日志 -o 转换后文件输出路径 5.3 CheckPoint 时间设置 满足以下两个条件都会触发合并操作: 通常情况下,SecondaryNameNode 每隔一小时执行一次。 [hdfs-default.xml] <property> <name>dfs.namenode.checkpoint.period</name> <value>3600</value> </property> 一分钟检查一次操作次数,当次数到达 100 万次就会触发操作。 [hdfs-default.xml] <property> <name>dfs.namenode.checkpoint.txns</name> <value>1000000</value> <description>操作动作次数</description> </property> <property> <name>dfs.namenode.checkpoint.check.period</name> <value>60</value> <description> 1分钟检查一次操作次数</description> </property> 5.4 NameNode 故障处理 NameNode 故障后,可以采用如下两种方法恢复数据: 将 2NN 中的数据拷贝到 NN 存储数据的目录。 使用 -importCheckpoint 选项启动 NN 守护进程,从而将 2NN 中数据拷贝到 NN 目录中。 hdfs namenode -importCheckpoint 5.5 集群安全模式 基本命令: hdfs dfsadmin -safemode get:查看安全模式状态 hdfs dfsadmin -safemode enter:进入安全模式状态 hdfs dfsadmin -safemode leave:离开安全模式状态 hdfs dfsadmin -safemode wait:等待安全模式状态 6 DataNode 6.1 DataNode工作机制 1、一个数据块在 DataNode 上以文件形式存储在磁盘上,包括两个文件,一个是数据本身,一个是元数据包括数据块的长度,块数据的校验和,以及时间戳。 2、DataNode 启动后向 NameNode 注册,通过后,周期性(1小时)的向 NameNode 上报所有的块信息。 3、心跳是每 3 秒一次,心跳返回结果带有 NameNode 给该 DataNode 的命令如复制块数据到另一台机器,或删除某个数据块,如果超过 10 分钟没有收到某个 DataNode 的心跳,则认为该节点不可用。 4、集群运行中可以安全加入和退出一些机器。 6.2 数据完整性 1、当 DataNode 读取 Block 的时候,它会计算 CheckSum。 2、如果计算后的 CheckSum,与 Block 创建时值不一样,说明 Block 已经损坏。 3、Client 读取其他 DataNode 上的 Block。 4、在其文件创建后周期验证。 6.3 掉线时限参数设置 [hdfs-site.xml] <property> <name>dfs.namenode.heartbeat.recheck-interval</name> <value>300000</value> <description>毫秒</description> </property> <property> <name>dfs.heartbeat.interval</name> <value>3</value> <description>秒</description> </property> 6.4 服役新数据节点 将 hadoop102 上的 java、hadoop、profile 发送到新主机,source 一下 profile,直接启动即可加入集群。 6.5 退役旧数据节点 6.5.1 黑名单设置 创建黑名单 [djm@hadoop101 hadoop]$ touch blacklist 配置加入黑名单的主机 hadoop102 配置 hdfs-site.xml <property> <name>dfs.hosts.exclude</name> <value>/opt/module/hadoop-2.7.2/etc/hadoop/blacklist</value> </property> 刷新 namenodes [djm@hadoop102 hadoop-2.7.2]$ hdfs dfsadmin -refreshNodes 更新 ResourceManager 节点 [djm@hadoop102 hadoop-2.7.2]$ yarn rmadmin -refreshNodes 如果数据不均衡,可以用命令实现集群的再平衡 [djm@hadoop102 hadoop-2.7.2]$ start-balancer.sh 6.5.2 白名单设置 创建白名单 [djm@hadoop101 hadoop]$ touch whitelist 配置加入黑名单的主机 hadoop102 hadoop103 hadoop104 配置 hdfs-site.xml <property> <name>dfs.hosts</name> <value>/opt/module/hadoop-2.7.2/etc/hadoop/whitelist</value> </property> 刷新 namenodes [djm@hadoop102 hadoop-2.7.2]$ hdfs dfsadmin -refreshNodes 更新 ResourceManager 节点 [djm@hadoop102 hadoop-2.7.2]$ yarn rmadmin -refreshNodes 如果数据不均衡,可以用命令实现集群的再平衡 [djm@hadoop102 hadoop-2.7.2]$ start-balancer.sh 黑白名单的区别: 白名单比较严格,黑名单比较平缓,处于黑名单中的主机会同步数据结束后继续处于集群,只是不在处理请求而已,而不处于白名单中的主机会直接被干掉。 6.6 Datanode多目录配置 DataNode也可以配置成多个目录,每个目录存储的数据不一样,即:数据不是副本。 hdfs-site.xml <property> <name>dfs.datanode.data.dir</name> <value>file:///${hadoop.tmp.dir}/dfs/data1,file:///${hadoop.tmp.dir}/dfs/data2</value> </property> 7 HDFS 2.X新特性 7.1 集群间数据拷贝 采用 distcp 命令实现两个 Hadoop 集群之间的递归数据复制 [djm@hadoop102 hadoop-2.7.2]$ hadoop distcp hdfs://haoop102:9000/user/djm/hello.txt hdfs://hadoop103:9000/user/djm/hello.txt 7.2 小文件存档 归档文件 [djm@hadoop102 hadoop-2.7.2]$ hadoop archive -archiveName input.har –p /user/djm/input /user/djm/output 查看归档 [djm@hadoop102 hadoop-2.7.2]$ hadoop fs -lsr har:///user/djm/output/input.har 解归档文件 [atguigu@djm hadoop-2.7.2]$ hadoop fs -cp har:/// user/djm/output/input.har/* /user/djm </locatedfilestatus>

优秀的个人博客,低调大师

Javascript基础之-this

this应该算是前期比较容易混淆的一个关键字了,在这里,我就打算按照我的理解来说一下 首先呢,this的值是跟运行时被调用的位置相关的,而不是词法作用域。 也就是说,他的绑定的值很可能是动态的,不同的调用位置,很可能值就不一样,比如说: function foo() { console.log(this.a); } var a = 2; var obj = { a: 3, foo, } foo(); //2 obj.foo(); //3 var c = obj.foo; c(); //2 然后你会惊讶的发现,foo()通过不同的形式调用,他最终的值是不一样的,咱们这一节主要就来讲一讲他们里面的这些绑定的规则 默认绑定 独立的函数调用,它的作用域是作用在全局的,这种绑定规则最常见并且是优先级最低的一种绑定规则。来一个例子 function foo() { console.log(this.a); //2 console.log(this === window); //true } var a = 2; foo(); 在浏览器中执行,会发现,如果foo()作为一个函数单独调用,那么this指向的就是全局对象windows。 但是呢,也有一种例外,如果函数使用的严格模式的话,那么全局对象讲无法使用默认绑定,this将会绑定到undefined,还是刚才的例子: function foo() { "use strict" console.log(this.a); console.log(this === window); } var a = 2; foo(); //Uncaught TypeError: Cannot read property 'a' of undefined 可以看到,foo直接抛出一个error,说this是undefined,取不到a,如果用到严格模式的时候,可以稍微注意下这个区别 咱们刚刚的例子,说的是函数内用严格模式的话,讲无法使用默认绑定,那么如果是在函数调用位置用严格模式,会受影响吗 function foo() { console.log(this.a); //2 console.log(this === window); //true } var a = 2; (function () { "use strict" foo(); })(); 很明显,可以看出,是不受影响的,还有一个问题,如果把var定义变成let会怎么样呢 function foo() { console.log(this.a); //undefined console.log(this === window); //true } let a = 2; (function () { "use strict" foo(); })(); 也就是说,let定义并不会加到全局变量中,这个和var的区别需要稍微留意一下 隐式绑定 这一条规则考虑的是是否有上下文对象,举个例子 function foo() { console.log(this.a); //2 console.log(this === obj); // true } var obj = { a: 2, foo, } obj.foo(); 在这种情况下,foo会使用obj的上下文对象来引用函数,此时的this指向的就是obj。 那么如果是嵌套对象这种的,会怎么处理呢? function foo() { console.log(this.a); // 1 console.log(this === obj) // true console.log(this === obj1) // fale } var obj = { a: 1, foo, }; var obj1 = { a: 2, obj, } obj1.obj.foo(); 可以看到,实际上此时foo中的this指向了离他最近的对象obj,也就是说,对象属性引用链的最后一层会影响它的调用位置 还有一种情况。 function foo() { console.log(this.a); } var obj = { a: 3, foo, } var a = 2; var f = obj.foo; f(); // 2 这种情况下,虽然f是obj.foo的引用,但是最后依然用的是默认绑定,而不是隐式绑定,所以说呢,咱们可以这么理解,虽然他是对象中函数的引用,但是在执行的时候,调用的方式确是函数调用的方式,不是对象.属性()的方式,这块在使用的时候需要注意一下 显式绑定 很简单,显式绑定就是手动直接改变其this指向的一种方式,这个主要是用几种api来实现的 function foo() { console.log(this.a); } var obj = { a: 2, }; foo.call(obj); foo.apply(obj); var f = foo.bind(obj); f(); 这个就是显式绑定的常见的三种形式 这三种形式的话,call和apply差不多,就不展开了,详情看文档就行,咱们仔细看一下bind函数,来在看一个例子 function foo(num1, num2) { console.log(num1 + num2); //5 console.log(this === obj); // true } var obj = { a: 1, }; var f = foo.bind(obj, 2); f(3); 这个可以看出,bind的用法和call以及apply还是有一些差别的。 注意,如果显式绑定传入的是null或者是undefined的话,将会使用默认绑定规则,举个例子 function foo() { console.log( this.a ); } var a = 2; foo.call( null ); // 2 new绑定 这个主要是new 函数()的绑定形式的,这个的this指向的是函数构造出的那个对象,new的时候,它的执行过程可以大概执行以下几步 创建一个全新的对象 这个新对象会被执行prototype连接 新对象绑定到函数调用的this 如果函数没有返回其他对象,那么new表达式中的函数调用会自动返回这个新对象 注意最后一句话,如果函数没有返回对象,那么就会返回函数调用的新对象,如果返回了一个对象呢,那么结果就是直接返回这个对象 var abc = { a: 10 } function foo() { return abc; } foo.prototype = { b: 20 }; var a = new foo(); console.log(a === abc); // true console.log(a.b); // undefined function bar() { this.a = 10; } bar.prototype = { b: 20 }; var b = new bar(); console.log(b.a); // 10 console.log(b.b); // 20 以上四种常见的this绑定方式已经介绍的差不多了,那么问题来了,谁的优先级更高呢 很明显,默认绑定的优先级最低,就不展开说了 显式绑定与隐式绑定哪个优先级高呢,举个例子 function foo() { console.log( this. a ); } var obj1 = { a: 2, foo: foo }; var obj2 = { a: 3, foo: foo }; obj1.foo(); // 2 obj2.foo(); // 3 obj1.foo.call( obj2 ); // 3 obj2.foo.call( obj1 ); // 2 很明显,显式绑定优先级要高于隐式绑定 那么new绑定和显式绑定谁更高呢,来再看个例子 function foo(something) { this.a = something; } var obj1 = {}; var bar = foo.bind( obj1 ); bar( 2 ); console.log( obj1.a ); // 2 var baz = new bar(3); console.log( obj1.a ); // 2 console.log( baz.a ); // 3 很明显,new的优先级会更高 所以,这样的话,优先级排序就出来了,分别为 new绑定 > 显式绑定 > 隐式绑定 > 默认绑定 以上就是大家常用到的几种,不过es6出现了一种箭头函数,箭头函数理论上不能应用上面四种的任意一种,它的this是根据代码的词法作用域来走的,比如说 function foo() { return (a) => { console.log( this.a ); }; } var obj1 = { a: 2 }; var obj2 = { a: 3 }; var bar = foo.call( obj1 ); bar.call( obj2 ); // 2 结果已经很明显了, 好了,以上内容就讲完了,通过我的一些讲解,是不是有一点理解了呢,如果有任何的不同意见,欢迎讨论哦 参考书籍《你不知道的Javascript》上卷 转载自:http://www.lht.ren/article/4/

优秀的个人博客,低调大师

Guava之EventBus

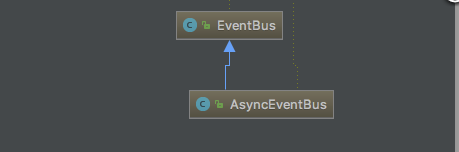
背景 天天说解耦解耦~事实上我们还没有mq 但是我们之前通过redis来模拟过queue进行消费 代码实现Redis异步任务 Redis实现优先级队列 都是很棒的实现办法 同时关于topic我们也可以通过redis的发布订阅来实现【当然持久化topic无法实现】 但是我们有时在项目中也需要简单的消息总线进行解耦~ 恰逢碰到瓜子二手车事件 来简单的介绍一下Guava的eventbus 分析 我们一直在说解耦解耦 究竟什么是耦合呢? 耦合性也叫块间联系。指软件系统结构中各模块间相互联系紧密程度的一种度量。模块之间联系越紧密,其耦合性就越强,模块之间越独立则越差,模块间耦合的高低取决于模块间接口的复杂性,调用的方式以及传递的信息。 其实简单点说就是我们写代码不愿意吧代码写在一块~写在一块容易出现的问题比较多 而且由于依赖这个事件的越来越多也会使得这块代码越来越多 我们依赖一个消息 根据该消息就可以做各种操作【有没有想到观察者模式~~~】 事实上Guava提供了一种基于反射实现的解耦的方式EventBus【顾名思义 消息总线】 代码 首先初始化EventBus对象 分别对应到同步和异步 我们在使用时需要注册一系列Listener到EventBus上 为了方便 我们自定义消息Listener类型为EventBusListener for(EventBusListenerlistener:listenerList){ eventBus.register(listener); logger.info("register{}",listener.getClass()); } 那么如何使用呢? MaintainCreateEventevent=newMaintainCreateEvent(); event.setIdOwnOrg(maintainVO.getIdOwnOrg()); event.setTid(maintainVO.getPkId()); event.setBillNo(maintainVO.getBillNo()); eventbus.post(event); post即可 那么对应的需要被唤醒的方法如何处理? @Subscribe publicvoidprocessCreate(MaintainCreateEventcreateEvent){ logger.info(JSON.toJSONString(createEvent)); } 通过注解Subscribe完成方法路由【注意根据类型】 炒鸡简单有没有~~~ 如何定义多个处理事件呢??? 继续Subscribe呗

优秀的个人博客,低调大师

java之JMS

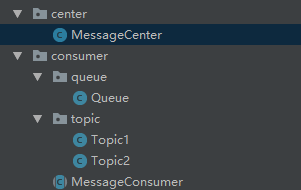
一、简介:JMS即Java消息服务(Java Message Service)应用程序接口,是一个Java平台中关于面向消息中间件(MOM)的API,用于在两个应用程序之间,或分布式系统中发送消息,进行异步通信。Java消息服务是一个与具体平台无关的API,绝大多数MOM提供商都对JMS提供支持。 二、JMS对象模型包含如下几个要素: 1)连接工厂。连接工厂(ConnectionFactory)是由管理员创建,并绑定到 JNDI树中。客户端使用JNDI查找连接工厂,然后利用连接工厂创建一个JMS连接。 2)JMS连接。JMS连接(Connection)表示JMS客户端和服务器端之间的一个活动的连接,是由客户端通过调用连接工厂的方法建立的。 3)JMS会话。JMS会话(Session)表示JMS客户与JMS服务器之间的会话状态。JMS会话建立在JMS连接上,表示客户与服务器之间的一个会话线程。 4)JMS目的。JMS目的(Destination),又称为 消息队列,是实际的消息源。 5)JMS生产者和消费者。生产者(Message Producer)和消费者(Message Consumer)对象由Session对象创建,用于发送和接收消息。 6)JMS消息通常有两种类型: ① 点对点(Point-to-Point)。在点对点的消息系统中,消息分发给一个单独的使用者。点对点消息往往与队列(javax.jms.Queue)相关联。 ② 发布/订阅(Publish/Subscribe)。发布/订阅消息系统支持一个事件驱动模型,消息生产者和消费者都参与消息的传递。生产者发布事件,而使用者订阅感兴趣的事件,并使用事件。该类型消息一般与特定的主题(javax.jms.Topic)关联。 三、JMS的五种消息 StreamMessage -- Java原始值的数据流 MapMessage--一套名称-值对 TextMessage--一个字符串对象 ObjectMessage--一个序列化的 Java对象 BytesMessage--一个未解释字节的数据流 四、常用应用类 1)ConnectionFactory 接口(连接工厂):用户用来创建到JMS提供者的连接的被管对象。JMS客户通过可移植的接口访问连接,这样当下层的实现改变时,代码不需要进行修改。管理员在JNDI名字空间中配置连接工厂,这样,JMS客户才能够查找到它们。根据消息类型的不同,用户将使用队列连接工厂,或者主题连接工厂。 2)Connection 接口(连接):连接代表了应用程序和 消息服务器之间的通信链路。在获得了连接工厂后,就可以创建一个与JMS提供者的连接。根据不同的连接类型,连接允许用户创建会话,以发送和接收队列和主题到目标。 3)Destination 接口(目标):目标是一个包装了消息目标 标识符的被管对象,消息目标是指消息发布和接收的地点,或者是队列,或者是主题。JMS管理员创建这些对象,然后用户通过JNDI发现它们。和连接工厂一样,管理员可以创建两种类型的目标,点对点模型的队列,以及发布者/订阅者模型的主题。 4)Session 接口(会话):表示一个单线程的上下文,用于发送和接收消息。由于会话是单线程的,所以消息是连续的,就是说消息是按照发送的顺序一个一个接收的。会话的好处是它支持 事务。如果用户选择了事务支持,会话上下文将保存一组消息,直到事务被提交才发送这些消息。在提交事务之前,用户可以使用回滚操作取消这些消息。一个会话允许用户创建消息,生产者来发送消息,消费者来接收消息。 5)MessageConsumer 接口(消息消费者):由会话创建的对象,用于接收发送到目标的消息。消费者可以同步地(阻塞模式),或(非阻塞)接收队列和主题类型的消息。 6)MessageProducer 接口(消息生产者):由会话创建的对象,用于发送消息到目标。用户可以创建某个目标的发送者,也可以创建一个通用的发送者,在发送消息时指定目标。 7)Message 接口(消息):是在消费者和生产者之间传送的对象,也就是说从一个应用程序传送到另一个应用程序。一个消息有三个主要部分: a、消息头(必须):包含用于识别和为消息寻找路由的操作设置。 b、一组消息属性(可选):包含额外的属性,支持其他提供者和用户的兼容。可以创建定制的字段和过滤器(消息选择器)。 c、一个消息体(可选):允许用户创建五种类型的消息(文本消息,映射消息,字节消息,流消息和对象消息)。 d、消息接口非常灵活,并提供了许多方式来定制消息的内容。 五、这里主要讲解activemq的实现topic和queue的消息传输机制 1)首先还是需要中间件(不管是单独应用部署,还是嵌入式的服务) 服务启动可以参考: https://www.cnblogs.com/ll409546297/p/9190992.html 2)activemq工厂连接模式 //初始化工厂 ActiveMQConnectionFactory activeMQConnectionFactory = new ActiveMQConnectionFactory(); //设置链接地址 activeMQConnectionFactory.setBrokerURL("tcp://localhost:61616"); //创建链接 Connection connection = activeMQConnectionFactory.createConnection(); //启动服务 connection.start(); 3)我这里简单写了一个activemq的具体实现过程,供参考 a、目录结构和依赖包 <dependency> <groupId>org.apache.activemq</groupId> <artifactId>activemq-all</artifactId> <version>5.15.4</version> </dependency> b、核心功能,消息处理中心 package com.pinnet.center; import com.pinnet.consumer.queue.Queue; import com.pinnet.consumer.topic.Topic1; import com.pinnet.consumer.topic.Topic2; import org.apache.activemq.ActiveMQConnectionFactory; import org.apache.activemq.command.ActiveMQObjectMessage; import javax.jms.*; import java.io.Serializable; public class MessageCenter { private static Session session; public static void init() throws JMSException { initConnection(); initRegister(); } private static void initConnection() throws JMSException { //初始化工厂 ActiveMQConnectionFactory activeMQConnectionFactory = new ActiveMQConnectionFactory(); //设置链接地址 activeMQConnectionFactory.setBrokerURL("tcp://localhost:61616"); //创建链接 Connection connection = activeMQConnectionFactory.createConnection(); //创建会话 session = connection.createSession(false, Session.AUTO_ACKNOWLEDGE); //启动服务 connection.start(); } /** * 用于注册对应消息队列 * @throws JMSException */ public static void initRegister() throws JMSException { registerQueue(QueueType.QUEUE, new Queue()); registerTopic(TopicType.TOPIC, new Topic1()); registerTopic(TopicType.TOPIC, new Topic2()); } /** * 注册topic监听 * @param topicType * @param messageListener * @throws JMSException */ public static void registerTopic(TopicType topicType, MessageListener messageListener) throws JMSException { //将会话转成topic TopicSession topicSession = (TopicSession) session; //创建订阅者 TopicSubscriber topicSubscriber = topicSession.createSubscriber(topicSession.createTopic(topicType.name())); //设置监听 topicSubscriber.setMessageListener(messageListener); } /** * 注册queue监听 * @param queueType * @param messageListener * @throws JMSException */ public static void registerQueue(QueueType queueType, MessageListener messageListener) throws JMSException { //将会话转成queue QueueSession queueSession = (QueueSession) session; //创建接收者 QueueReceiver queueReceiver = queueSession.createReceiver(queueSession.createQueue(queueType.name())); //设置监听 queueReceiver.setMessageListener(messageListener); } /** * 发送topic消息 * @param topicType * @param serializable * @throws JMSException */ public static void sendMessageTopic(TopicType topicType, Serializable serializable) throws JMSException { TopicSession topicSession = (TopicSession) session; //创建发布者 TopicPublisher topicPublisher = topicSession.createPublisher(topicSession.createTopic(topicType.name())); //这里数据发布形式采用ObjectMessage ActiveMQObjectMessage activeMQObjectMessage = new ActiveMQObjectMessage(); activeMQObjectMessage.setObject(serializable); //发布消息 topicPublisher.publish(activeMQObjectMessage); } /** * 发送queue消息 * @param queueType * @param serializable * @throws JMSException */ public static void sendMessageQueue(QueueType queueType, Serializable serializable) throws JMSException { QueueSession queueSession = (QueueSession) session; //创建发送者 QueueSender queueSender = queueSession.createSender(queueSession.createQueue(queueType.name())); ActiveMQObjectMessage activeMQObjectMessage = new ActiveMQObjectMessage(); activeMQObjectMessage.setObject(serializable); //发送消息 queueSender.send(activeMQObjectMessage); } //使用枚举的目的是更好的管理 public enum TopicType { TOPIC } public enum QueueType { QUEUE } } c、消息处理抽象类 package com.pinnet.consumer; import javax.jms.JMSException; import javax.jms.Message; import javax.jms.MessageListener; import javax.jms.ObjectMessage; import java.io.Serializable; /** * 抽象类的目的是,让编写者,只管处理消息,不用管理中间过程 */ public abstract class MessageConsumer implements MessageListener { public void onMessage(Message message) { try { ObjectMessage objectMessage = (ObjectMessage) message; handleMessage(objectMessage.getObject()); } catch (JMSException e) { e.printStackTrace(); } } //实现类处理对应消息 public abstract void handleMessage (Serializable serializable); } d、2个实现类型 package com.pinnet.consumer.queue; import com.pinnet.consumer.MessageConsumer; import java.io.Serializable; public class Queue extends MessageConsumer { /** * 消息处理 * @param serializable */ public void handleMessage(Serializable serializable) { System.out.println(serializable+"queue"); } } package com.pinnet.consumer.topic; import com.pinnet.consumer.MessageConsumer; import java.io.Serializable; public class Topic1 extends MessageConsumer { /** * 消息处理 * @param serializable */ public void handleMessage(Serializable serializable) { System.out.println(serializable+"topic1"); } } package com.pinnet.consumer.topic; import com.pinnet.consumer.MessageConsumer; import java.io.Serializable; public class Topic2 extends MessageConsumer { /** * 消息处理 * @param serializable */ public void handleMessage(Serializable serializable) { System.out.println(serializable+"topic2"); } } e、测试: package com.pinnet; import com.pinnet.center.MessageCenter; import javax.jms.JMSException; public class Main { public static void main(String[] args) throws JMSException, InterruptedException { MessageCenter.init(); while (true) { MessageCenter.sendMessageQueue(MessageCenter.QueueType.QUEUE, "queue"); MessageCenter.sendMessageTopic(MessageCenter.TopicType.TOPIC, "topic"); Thread.sleep(5000); } } } 六、我这里是采用纯代码的方式,在spring中jmsTemplate的应用,就像session一样,就可以。 springmvc的配置方式参考:https://www.cnblogs.com/ll409546297/p/6898155.html 配置方式也可以采用activemq的工厂连接模式一样实现 七、例子源码:https://pan.baidu.com/s/1Wo0QuihBMluRevGmk-p-aA

优秀的个人博客,低调大师

前端之JavaScript

JavaScript是运行在浏览器端的脚步语言,JavaScript主要解决的是前端与用户交互的问题,包括使用交互与数据交互。 JavaScript是浏览器解释执行的,前端脚本语言还有JScript(微软,IE独有),ActionScript( Adobe公司,需要插件)等。 前端三大块 :1、HTML:页面结构2、CSS:页面表现:元素大小、颜色、位置、隐藏或显示、部分动画效果3、JavaScript:页面行为:部分动画效果、页面与用户的交互、页面功能 JavaScript嵌入页面的方式 1、行间事件(主要用于事件) <input type="button" name="" onclick="alert('ok!');"> 2、页面script标签嵌入 <script type="text/javascript"> alert('ok!'); </script> 3、外部引入 <script type="text/javascript" src="js/index.js"></script> 变量、数据类型及基本语法规范 JavaScript 是一种弱类型语言,javascript的变量类型由它的值来决定。 定义变量需要用关键字 'var'。 var iNum = 123; var sTr = 'asd'; //同时定义多个变量可以用","隔开,公用一个‘var’关键字 var iNum = 45,sTr='qwe',sCount='68'; 变量类型 5种基本数据类型:1、number 数字类型2、string 字符串类型3、boolean 布尔类型 true 或 false4、undefined undefined类型,变量声明未初始化,它的值就是undefined5、null null类型,表示空对象,如果定义的变量将来准备保存对象,可以将变量初始化为null,在页面上获取不到对象,返回的值就是null 1种复合类型:object javascript语句与注释 1、javascript语句开始可缩进也可不缩进,缩进是为了方便代码阅读,一条javascript语句应该以“;”结尾; <script type="text/javascript"> var iNum = 123; var sTr = 'abc123'; function fnAlert(){ alert(sTr); }; fnAlert(); </script> 2、javascript注释 <script type="text/javascript"> // 单行注释 var iNum = 123; /* 多行注释 1、... 2、... */ var sTr = 'abc123'; </script> 变量、函数、属性、函数参数命名规范 1、区分大小写2、第一个字符必须是字母、下划线(_)或者美元符号($)3、其他字符可以是字母、下划线、美元符或数字 匈牙利命名风格: 对象o Object 比如:oDiv数组a Array 比如:aItems字符串s String 比如:sUserName整数i Integer 比如:iItemCount布尔值b Boolean 比如:bIsComplete浮点数f Float 比如:fPrice函数fn Function 比如:fnHandler正则表达式re RegExp 比如:reEmailCheck 函数 函数就是重复执行的代码片。 函数定义与执行 <script type="text/javascript"> // 函数定义 function fnAlert(){ alert('hello!'); } // 函数执行 fnAlert(); </script> 变量与函数预解析 JavaScript解析过程分为两个阶段,先是编译阶段,然后执行阶段,在编译阶段会将function定义的函数提前,并且将var定义的变量声明提前,将它赋值为undefined。 <script type="text/javascript"> fnAlert(); // 弹出 hello! alert(iNum); // 弹出 undefined function fnAlert(){ alert('hello!'); } var iNum = 123; </script> 函数传参javascript的函数中可以传递参数。 <script type="text/javascript"> function fnAlert(a){ alert(a); } fnAlert(12345); </script> 函数'return'关键字 函数中'return'关键字的作用:1、返回函数中的值或者对象2、结束函数的运行 <script type="text/javascript"> function fnAdd(iNum01,iNum02){ var iRs = iNum01 + iNum02; return iRs; alert('here!'); } var iCount = fnAdd(3,4); alert(iCount); //弹出7 </script> 条件语句 通过条件来控制程序的走向,就需要用到条件语句。 条件运算符 ==、===、>、>=、<、<=、!=、&&(而且)、||(或者)、!(否) if else var iNum01 = 3; var iNum02 = 5; var sTr; if(iNum01>iNum02){ sTr = '大于'; } else { sTr = '小于'; } alert(sTr); 多重if else语句 var iNow = 1; if(iNow==1) { ... ; } else if(iNow==2) { ... ; } else { ... ; } 获取元素方法 可以使用内置对象document上的getElementById方法来获取页面上设置了id属性的元素,获取到的是一个html对象,然后将它赋值给一个变量,比如: <script type="text/javascript"> var oDiv = document.getElementById('div1'); </script> .... <div id="div1">这是一个div元素</div> 上面的语句,如果把javascript写在元素的上面,就会出错,因为页面上从上往下加载执行的,javascript去页面上获取元素div1的时候,元素div1还没有加载,解决方法有两种: 第一种方法:将javascript放到页面最下边 .... <div id="div1">这是一个div元素</div> .... <script type="text/javascript"> var oDiv = document.getElementById('div1'); </script> </body> 第二种方法:将javascript语句放到window.onload触发的函数里面,获取元素的语句会在页面加载完后才执行,就不会出错了。 <script type="text/javascript"> window.onload = function(){ var oDiv = document.getElementById('div1'); } </script> .... <div id="div1">这是一个div元素</div> 操作元素属性 获取的页面元素,就可以对页面元素的属性进行操作,属性的操作包括属性的读和写。 操作元素属性 var 变量 = 元素.属性名 读取属性元素.属性名 = 新属性值 改写属性 属性名在js中的写法 1、html的属性和js里面属性写法一样2、“class” 属性写成 “className”3、“style” 属性里面的属性,有横杠的改成驼峰式,比如:“font-size”,改成”style.fontSize”、 <script type="text/javascript"> window.onload = function(){ var oInput = document.getElementById('input1'); var oA = document.getElementById('link1'); // 读取属性值 var sValue = oInput.value; var sType = oInput.type; var sName = oInput.name; var sLinks = oA.href; // 写(设置)属性 oA.style.color = 'red'; oA.style.fontSize = sValue; } </script> ...... <input type="text" name="setsize" id="input1" value="20px"> <a href="http://www.baidu.com" id="link1">百度</a> innerHTML innerHTML可以读取或者写入标签包裹的内容 <script type="text/javascript"> window.onload = function(){ var oDiv = document.getElementById('div1'); //读取 var sTxt = oDiv.innerHTML; alert(sTxt); //写入 oDiv.innerHTML = '<a href="http://www.baidu.com">百度<a/>'; } </script> ...... <div id="div1">这是一个div元素</div> 事件属性及匿名函数 事件属性 元素上除了有样式,id等属性外,还有事件属性,常用的事件属性有鼠标点击事件属性(onclick),鼠标移入事件属性(mouseover),鼠标移出事件属性(mouseout),将函数名称赋值给元素事件属性,可以将事件和函数关联起来。 <script type="text/javascript"> window.onload = function(){ var oBtn = document.getElementById('btn1'); oBtn.onclick = myalert; function myalert(){ alert('ok!'); } } </script> 匿名函数 定义的函数可以不给名称,这个叫做匿名函数,可以将匿名函数的定义直接赋值给元素的事件属性来完成事件和函数的关联,这样可以减少函数命名,并且简化代码。函数如果做公共函数,就可以写成匿名函数的形式。 <script type="text/javascript"> window.onload = function(){ var oBtn = document.getElementById('btn1'); /* oBtn.onclick = myalert; function myalert(){ alert('ok!'); } */ // 直接将匿名函数赋值给绑定的事件 oBtn.onclick = function (){ alert('ok!'); } } </script> 数组及操作方法 数组就是一组数据的集合,javascript中,数组里面的数据可以是不同类型的。 定义数组的方法 //对象的实例创建 var aList = new Array(1,2,3); //直接量创建 var aList2 = [1,2,3,'asd']; 操作数组中数据的方法 1、获取数组的长度:aList.length; var aList = [1,2,3,4]; alert(aList.length); // 弹出4 2、用下标操作数组的某个数据:aList[0]; var aList = [1,2,3,4]; alert(aList[0]); // 弹出1 3、join() 将数组成员通过一个分隔符合并成字符串 var aList = [1,2,3,4]; alert(aList.join('-')); // 弹出 1-2-3-4 4、push() 和 pop() 从数组最后增加成员或删除成员 var aList = [1,2,3,4]; aList.push(5); alert(aList); //弹出1,2,3,4,5 aList.pop(); alert(aList); // 弹出1,2,3,4 5、reverse() 将数组反转 var aList = [1,2,3,4]; aList.reverse(); alert(aList); // 弹出4,3,2,1 6、indexOf() 返回数组中元素第一次出现的索引值 var aList = [1,2,3,4,1,3,4]; alert(aList.indexOf(1)); 7、splice() 在数组中增加或删除成员 var aList = [1,2,3,4]; aList.splice(2,1,7,8,9); //从第2个元素开始,删除1个元素,然后在此位置增加'7,8,9'三个元素 alert(aList); //弹出 1,2,7,8,9,4 多维数组 多维数组指的是数组的成员也是数组的数组。 var aList = [[1,2,3],['a','b','c']]; alert(aList[0][1]); //弹出2; 批量操作数组中的数据,需要用到循环语句 循环语句 程序中进行有规律的重复性操作,需要用到循环语句。 for循环 for(var i=0;i<len;i++) { ...... } 例如:数组去重 var aList = [1,2,3,4,4,3,2,1,2,3,4,5,6,5,5,3,3,4,2,1]; var aList2 = []; for(var i=0;i<aList.length;i++) { if(aList.indexOf(aList[i])==i) { aList2.push(aList[i]); } } alert(aList2); 字符串处理方法 1、字符串合并操作:“ + ” var iNum01 = 12; var iNum02 = 24; var sNum03 = '12'; var sTr = 'abc'; alert(iNum01+iNum02); //弹出36 alert(iNum01+sNum03); //弹出1212 数字和字符串相加等同于字符串相加 alert(sNum03+sTr); // 弹出12abc 2、parseInt() 将数字字符串转化为整数 var sNum01 = '12'; var sNum02 = '24'; var sNum03 = '12.32'; alert(sNum01+sNum02); //弹出1224 alert(parseInt(sNum01)+parseInt(sNum02)) //弹出36 alert(parseInt(sNum03)) //弹出数字12 将字符串小数转化为数字整数 3、parseFloat() 将数字字符串转化为小数 var sNum03 = '12.32' alert(parseFloat(sNum03)); //弹出 12.32 将字符串小数转化为数字小数 4、split() 把一个字符串分隔成字符串组成的数组 var sTr = '2017-4-22'; var aRr = sTr.split("-"); var aRr2= sTr.split(""); alert(aRr); //弹出['2017','4','2'] alert(aRr2); //弹出['2','0','1','7','-','4','-','2','2'] 5、indexOf() 查找字符串是否含有某字符 var sTr = "abcdefgh"; var iNum = sTr.indexOf("c"); alert(iNum); //弹出2 6、substring() 截取字符串 用法: substring(start,end)(不包括end) var sTr = "abcdefghijkl"; var sTr2 = sTr.substring(3,5); var sTr3 = sTr.substring(1); alert(sTr2); //弹出 de alert(sTr3); //弹出 bcdefghijkl 字符串反转 var str = 'asdfj12jlsdkf098'; var str2 = str.split('').reverse().join(''); alert(str2); 定时器 定时器在javascript中的作用 1、定时调用函数2、制作动画 定时器类型及语法 /* 定时器: setTimeout 只执行一次的定时器 clearTimeout 关闭只执行一次的定时器 setInterval 反复执行的定时器 clearInterval 关闭反复执行的定时器 */ var time1 = setTimeout(myalert,2000); var time2 = setInterval(myalert,2000); /* clearTimeout(time1); clearInterval(time2); */ function myalert(){ alert('ok!'); } 变量作用域 变量作用域指的是变量的作用范围,javascript中的变量分为全局变量和局部变量。 1、全局变量:在函数之外定义的变量,为整个页面公用,函数内部外部都可以访问。2、局部变量:在函数内部定义的变量,只能在定义该变量的函数内部访问,外部无法访问。 <script type="text/javascript"> // 定义全局变量 var a = 12; function myalert() { // 定义局部变量 var b = 23; alert(a); // 修改全局变量 a++; alert(b); } myalert(); // 弹出12和23 alert(a); // 弹出13 alert(b); // 出错 </script> 封闭函数 封闭函数是javascript中匿名函数的另外一种写法,创建一个一开始就执行而不用命名的函数。 一般定义的函数和执行函数: function myalert(){ alert('hello!'); }; myalert(); 封闭函数: (function(){ alert('hello!'); })(); 还可以在函数定义前加上“~”和“!”等符号来定义匿名函数 !function(){ alert('hello!'); }() 封闭函数的作用 封闭函数可以创造一个独立的空间,在封闭函数内定义的变量和函数不会影响外部同名的函数和变量,可以避免命名冲突,在页面上引入多个js文件时,用这种方式添加js文件比较安全,比如: var iNum01 = 12; function myalert(){ alert('hello!'); } (function(){ var iNum01 = 24; function myalert(){ alert('hello!world'); } alert(iNum01); myalert() })() alert(iNum01); myalert(); -------知识无价,汗水有情,如需搬运请注明出处,谢谢!

优秀的个人博客,低调大师

Django之CSRF

一、什么是CSRF CSRF, Cross Site Request Forgery,跨站伪造请求。举例来讲,某个恶意的网站上有一个指向你的网站的链接,如果某个用户已经登录到你的网站上了,那么当这个用户点击这个恶意网站上的那个链接时,就会向你的网站发来一个请求,你的网站会以为这个请求是用户自己发来的,其实呢,这个请求是那个恶意网站伪造的。 Django为用户实现跨站请求伪造保护的功能,通过中间件django.middleware.csrf.CsrfViewMiddleware 来完成。而对于django中设置防跨站请求伪造功能有分为全局设置和局部设置。 二、Django提供CSRF防护机制 Django第一次响应某个客户端的请求时,会在服务器端随机生成一个token,然后把这个token放到cookie中返回给客户端。然后客户端每次POST请求时都会带上这个token,这样就避免了CSRF攻击。 在返回的HTTP响应的cookie中,Django会添加一个csrftoken字段,值为随机生成的token 在POST表单中,必须包含一个csrfmiddlewaretoken隐藏字段,需要在模板中添加{% csrf_token %}自动生成 在处理POST请求之前,Django会验证cookie中csrftoken和表单中csrfmiddlewaretoken的值是否一致。如果一致,则表明这是一个合法请求。否则这个请求就是伪造的,返回403 Forbidden。 在Ajax POST请求中,添加一个"X-CSRFToken"头部,值为cookie中的csrftoken的值。 三、CSRF设置 1. 全局设置(中间件) 1 django.middleware.csrf.CsrfViewMiddleware 2. 局部设置(视图函数) 1 2 3 4 5 6 7 8 9 from django.views.decorators.csrf import csrf_exempt,csrf_protect @csrf_protect #为当前函数强制设置防跨站请求伪造功能,即便settings中没有设置CSRF中间件。 def func(): pass @csrf_exempt #取消当前函数防跨站请求伪造功能,即便settings中设置了CSRF中间件。 def func(): pass 四、应用CSRF 1. 前端Form表单中设置CSRF 1 2 3 4 <formmethod = "post" > { % csrf_token % } ... < / form> 2. 自动在每个Ajax请求头部中添加"X-CSRFToken" 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 / / 导入jquery.cookie.js通过$.cookie( 'csrftoken' )获取csrf_token / / beforeSend在每个Ajax请求之前自动设置请求头部 "X-CSRFToken" <scriptsrc = "/static/plugin/jquery/jquery-1.8.0.js" >< / script> <scriptsrc = "/static/plugin/jquery/jquery.cookie.js" >< / script> <script type = "text/javascript" > varcsrftoken = $.cookie( 'csrftoken' ); functioncsrfSafeMethod(method){ / / theseHTTPmethodsdo not requireCSRFprotection return ( / ^(GET|HEAD|OPTIONS|TRACE)$ / .test(method)); } $.ajaxSetup({ beforeSend:function(xhr,settings){ if (!csrfSafeMethod(settings. type )&&!this.crossDomain){ xhr.setRequestHeader( "X-CSRFToken" ,csrftoken); } } }); < / script> 3. 单独在Ajax请求中设置"X-CSRFToken"头部 1 2 3 4 5 6 7 8 <scriptsrc = "/static/plugin/jquery/jquery-1.8.0.js" >< / script> <scriptsrc = "/static/plugin/jquery/jquery.cookie.js" >< / script> <script type = "text/javascript" > $.ajax({ headers:{ "X-CSRFToken" :$.cookie( 'csrftoken' )}, ... }) < / script> 本文转自戴柏阳的博客博客51CTO博客,原文链接http://blog.51cto.com/daibaiyang119/2044282如需转载请自行联系原作者 daibaiyang119

优秀的个人博客,低调大师

ELK 之 LogStash

一、简介 Logstash 是开源的服务器端数据处理管道,能够同时 从多个来源采集数据、转换数据,然后将数据发送到您最喜欢的 “存储库” 中。(我们的存储库当然是 Elasticsearch。)可以用三个词来概括Logstash:集中、转换和存储数据 输入 采集各种样式、大小和来源的数据 数据往往以各种各样的形式,或分散或集中地存在于很多系统中。Logstash 支持各种输入选择,可以在同一时间从众多常用来源捕捉事件。能够以连续的流式传输方式,轻松地从您的日志、指标、Web 应用、数据存储以及各种 AWS 服务采集数据。 过滤器 实时解析和转换数据 数据从源传输到存储库的过程中,Logstash 过滤器能够解析各个事件,识别已命名的字段以构建结构,并将它们转换成通用格式,以便更轻松、更快速地分析和实现商业价值。 Logstash 能够动态地转换和解析数据,不受格式或复杂度的影响: 利用 Grok 从非结构化数据中派生出结构 从 IP 地址破译出地理坐标 将 PII 数据匿名化,完全排除敏感字段 整体处理不受数据源、格式或架构的影响 我们的过滤器库丰富多样,拥有无限可能。 输出 选择您的存储库,导出您的数据 尽管 Elasticsearch 是我们的首选输出方向,能够为我们的搜索和分析带来无限可能,但它并非唯一选择。 Logstash 提供众多输出选择,您可以将数据发送到您要指定的地方,并且能够灵活地解锁众多下游用例。 Logstash的特性: 即插即用 使用 Elastic Stack 加速洞察时间 Logstash 模块通过流行的数据源(如 ArcSight 和 Netflow )呈现瞬间可视化的体验。通过立即部署摄入管道和复杂的仪表板,您的数据探索将以几分钟而不是几天的时间开始。 可扩展 以您自己的方式创建和配置管道 Logstash 采用可插拔框架,拥有 200 多个插件。您可以将不同的输入选择、过滤器和输出选择混合搭配、精心安排,让它们在管道中和谐地运行。 您是从自定义应用程序采集数据?没有看到所需的插件?Logstash 插件很容易构建。我们有一个极好的插件开发 API 和插件生成器,可帮助您开始和分享您的创作。 可靠性 构建可信的交付管道 假如 Logstash 节点发生故障,Logstash 会通过持久化队列来保证运行中的事件至少一次被送达(at-least-once delivery)。那些未被正常处理的消息会被送往死信队列(dead letter queue)以便做进一步处理。由于具备了这种吸收吞吐量的能力,现在您无需采用额外的队列层,Logstash 就能平稳度过高峰期。 监控 全方位监视您的部署 Logstash 管道通常服务于多种用途,会变得非常复杂,因此充分了解管道性能、可用性和瓶颈异常重要。借助X-Pack monitoring 功能,您可以轻松观察和研究处于活动状态的 Logstash 节点或整个部署。 安全 从头至尾,确保管道安全 无论您运行几十个还是几千个 Logstash 实例,我们都能让您充分保障采集管道的安全。来自Beats以及其他输入选择的输入数据可以在传输途中加密,并且与受保护的 Elasticsearch 集群完全集成。 其他: 支持多数据获取机制,通过TCP/UDP协议、文件、syslog、windows EventLogs及STDIN等;获取到数据后,它支持对数据执行过滤、修改等操作 二、LogStash的安装 LogStash的安装依赖java环境,所以我们要安装配置java环境。 1.安装并配置java环境 1 2 yum install java-1.8.0-openjdk-1.8.0.102-4.b14.el7.x86_64.rpm vim /etc/profile .d /java .sh 添加: 1 export JAVA_HOME= /usr/bin/java 注:我的java在/usr/bin下,可以通过which命令查找下确切位置。 2.安装LogStash 1 yum install logstash-1.5.4-1.noarch.rpm 未完待续... 官方网站:https://www.elastic.co/cn/ 本文转自 SoulMio 51CTO博客,原文链接:http://blog.51cto.com/bovin/1965851,如需转载请自行联系原作者

优秀的个人博客,低调大师

Django之缓存

一、什么是缓存 Django缓存就是保存一些大量、重复访问的数据在内存或文件中,这样有用户重复请求时直接从内存或文件中返回,这样就不用重复频繁的访问数据库获取,提高执行效率。 二、Django缓存的方式 Django提供了5种缓存方式: 开发调试:django.core.cache.backends.dummy.DummyCache 本地内存:django.core.cache.backends.locmem.LocMemCache 本地文件:django.core.cache.backends.filebased.FileBasedCache 数据库:django.core.cache.backends.db.DatabaseCache Memcache缓存: python-memcached模块:django.core.cache.backends.memcached.MemcachedCache pylibmc模块:django.core.cache.backends.memcached.PyLibMCCache 三、配置Django Cache a、开发调试(实际内部不做任何动作) 1 2 3 4 5 CACHES = { 'default' :{ 'BACKEND' : 'django.core.cache.backends.dummy.DummyCache' , } } b、本地内存 1 2 3 4 5 6 CACHES = { 'default' :{ 'BACKEND' : 'django.core.cache.backends.locmem.LocMemCache' , 'LOCATION' : 'unique-snowflake' , } } c、本地文件 1 2 3 4 5 6 CACHES = { 'default' :{ 'BACKEND' : 'django.core.cache.backends.filebased.FileBasedCache' , 'LOCATION' :os.path.join(BASE_DIR, "cache" ), } } d、数据库 缓存连哪个数据库,就看你在配置文件中DATABASES定义了使用哪个数据库! 1 2 3 4 5 6 CACHES = { 'default' :{ 'BACKEND' : 'django.core.cache.backends.db.DatabaseCache' , 'LOCATION' : 'cache_table' , #数据库表名 } } 命令行中运行:python3 manage.py createcachetable命令创建数据库表 e、Memchache(python-memcached模块) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 #使用IP和端口连接远端单个Memcache服务器 CACHES = { 'default' :{ 'BACKEND' : 'django.core.cache.backends.memcached.MemcachedCache' , 'LOCATION' : '10.10.10.10:11211' , #远端Memcache服务器IP和端口 } } #使用本地socket文件连接本地Memcache服务器 CACHES = { 'default' :{ 'BACKEND' : 'django.core.cache.backends.memcached.MemcachedCache' , 'LOCATION' : 'unix:/tmp/memcached.sock' , #本地socket文件 } } #连接远端多个Memcache服务器,做分布式缓存 CACHES = { 'default' :{ 'BACKEND' : 'django.core.cache.backends.memcached.MemcachedCache' , 'LOCATION' :[ ( '10.10.10.10:11211' , 10 ), #设置远端Memcache服务器IP和端口以及优先级 ( '10.10.10.11:11211' , 20 ), ] } } f、Memchache(pylibmc模块) 1 2 3 #使用方法同上面一模一样,只需把引擎换成pylibmc模块的就可以了 'BACKEND' : 'django.core.cache.backends.memcached.PyLibMCCache' 四、Cache参数 除了上面所写的参数外,还有一些额外的参数来控制缓存行为,这些参数以键值对的形式写在cache setting中。 TIMEOUT:缓存的默认过期时间,以秒为单位,默认是300秒。 OPTIONS: MAX_ENTRIES:缓存允许的最大条目数,超过这个数则旧值会被删除,默认是300。 CULL_FREQUENCY:当达到MAX_ENTRIES的时候,被删除的条目比率。实际比率是1/CULL_FREQUENCY,默认是3。 KEY_PREFIX:缓存key的前缀(默认空) VERSION:缓存key的版本(默认1) KEY_FUNCTION:生成key的函数(默认函数会生成为:[前缀:版本:key]) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 #示例 CACHES = { 'default' :{ 'BACKEND' : 'django.core.cache.backends.filebased.FileBasedCache' , 'LOCATION' :os.path.join(BASE_DIR, "cache" ), 'TIMEOUT' : 300 , 'OPTIONS' :{ 'MAX_ENTRIES' : 300 , 'CULL_FREQUENCY' : 3 , }, 'KEY_PREFIX' :'', 'VERSION' : 1 , 'KEY_FUNCTION' :函数名, #这个字段不写就用默认的,写上就用自定义 } } 五、使用Django Cache a、全站使用(对所有的视图函数生效) 1 2 3 4 5 MIDDLEWARE = [ 'django.middleware.cache.UpdateCacheMiddleware' , #放在第一个 #其他中间件... 'django.middleware.cache.FetchFromCacheMiddleware' , #放在最后一个 ] 用户请求过来时,先跳过UpdateCacheMiddleware中间件,执行其他中间件,最后到FetchFromCacheMiddleware中间件时。如果缓存内容已存在,则直接返回给用户;如果缓存内容不存在则获取并返回数据。当返回给用户之前,往回执行到UpdateCacheMiddleware中间件,判断内容是否已经缓存,如果不存在则缓存。 b、单独视图缓存 views.py 1 2 3 4 5 6 7 from django.views.decorators.cache import cache_page import time @cache_page ( 5 ) #缓存5秒 def cache(req): time_now = time.time() return render(req, "cache.html" , locals ()) cache.html 1 2 3 4 5 6 7 8 9 10 <!DOCTYPEhtml> <htmllang = "en" > <head> <metacharset = "UTF-8" > <title>Title< / title> < / head> <body> {{time_now}} < / body> < / html> c、视图局部缓存 views.py 1 2 3 4 5 import time def cache2(req): time_now = time.time() return render(req, "cache2.html" , locals ()) cache2.html 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 { % loadcache % } <!DOCTYPEhtml> <htmllang = "en" > <head> <metacharset = "UTF-8" > <title>Title< / title> < / head> <body> {{time_now}} <hr> { % cache 5 k1 % } {{time_now}} { % endcache % } < / body> < / html> 视图的局部缓存可以令模板中的一部分内容进行缓存,局部缓存时首先要引入{% load cache %},其次在{% cache cache_time cache_key %} cache_value {% endcache %}中填入内容。cache_time是缓存的时间以秒为单位,因为缓存时以键值对存储所以cache_key设置缓存内容的key,这个key自己定义。 本文转自戴柏阳的博客博客51CTO博客,原文链接http://blog.51cto.com/daibaiyang119/1978174如需转载请自行联系原作者 daibaiyang119

优秀的个人博客,低调大师

Elasticsearch之REST

REST 简介-定义 REST (REpresentation State Transfer)描述了一个架构样式的网络系统,比如 web 应用程序。它首次出现在 2000 年 Roy Fielding 的博士论文中,他是 HTTP 规范的主要编写者之一。REST 指的是一组架构约束条件和原则。满足这些约束条件和原则的应用程序或设计就是 RESTful。 Web 应用程序最重要的 REST 原则是,客户端和服务器之间的交互在请求之间是无状态的。从客户端到服务器的每个请求都必须包含理解请求所必需的信息。如果服务器在请求之间的任何时间点重启,客户端不会得到通知。此外,无状态请求可以由任何可用服务器回答,这十分适合云计算之类的环境。客户端可以缓存数据以改进性能。 在服务器端,应用程序状态和功能可以分为各种资源。资源是一个有趣的概念实体,它向客户端公开。资源的例子有:应用程序对象、数据库记录、算法等等。每个资源都使用 URI (Universal Resource Identifier) 得到一个惟一的地址。所有资源都共享统一的界面,以便在客户端和服务器之间传输状态。使用的是标准的 HTTP 方法,比如 GET、PUT、POST 和 DELETE。 REST 简介-资源 REST 简介-基本操作 1)GET 获取对象的当前状态 2)PUT 改变对象的状态 3)POST 创建对象 4)DELETE 删除对象 5)HEAD 获取头信息 REST 简介-资源 ES 内置的REST接口 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/6617403.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Elasticsearch之优化

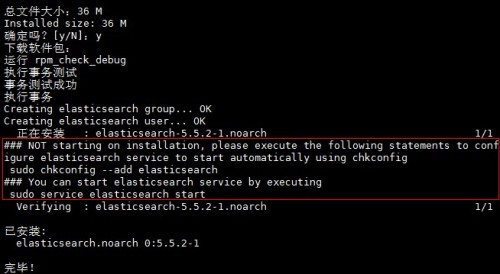
为什么es需要优化? 答: [root@master elasticsearch-2.4.0]# ulimit -a core file size (blocks, -c) 0 data seg size (kbytes, -d) unlimited scheduling priority (-e) 0 file size (blocks, -f) unlimited pending signals (-i) 6661 max locked memory (kbytes, -l) 64 max memory size (kbytes, -m) unlimited open files (-n) 1024 pipe size (512 bytes, -p) 8 POSIX message queues (bytes, -q) 819200 real-time priority (-r) 0 stack size (kbytes, -s) 10240 cpu time (seconds, -t) unlimited max user processes (-u) 6661 virtual memory (kbytes, -v) unlimited file locks (-x) unlimited [root@master elasticsearch-2.4.0]# ulimit -n 32000 [root@master elasticsearch-2.4.0]# ulimit -a core file size (blocks, -c) 0 data seg size (kbytes, -d) unlimited scheduling priority (-e) 0 file size (blocks, -f) unlimited pending signals (-i) 6661 max locked memory (kbytes, -l) 64 max memory size (kbytes, -m) unlimited open files (-n) 32000 pipe size (512 bytes, -p) 8 POSIX message queues (bytes, -q) 819200 real-time priority (-r) 0 stack size (kbytes, -s) 10240 cpu time (seconds, -t) unlimited max user processes (-u) 6661 virtual memory (kbytes, -v) unlimited file locks (-x) unlimited [root@master elasticsearch-2.4.0]# es集群的3节点,每个机器都要去设置。master、slave1和slave2都要去操作。 怎么来做好es的优化工作? 途径1、解决es启动的警告信息【或者es中Too many open files的问题】 max file descriptors [4096] for elasticsearch process likely too low, consider increasing to at least [65536] vi /etc/security/limits.conf 添加下面两行 *soft nofile 65536 *hard nofile 131072 即,意思是把它们调大,重启es服务进程,就生效了。 途径2、修改配置文件调整ES的JVM内存大小 修改bin/elasticsearch.in.sh中ES_MIN_MEM和ES_MAX_MEM的大小,建议设置一样大,避免频繁的分配内存,根据服务器内存大小,一般分配60%左右(默认256M) 注意:内存最大不要超过32G【详情请看如下的截图和文字说明】 一旦你越过这个神奇的32 GB边界,指针会切换回普通对象指针.。每个指针的大小增加,使用更多的CPU内存带宽。事实上,你使用40~50G的内存和使用32G的内存效果是一样的。 链接:https://www.elastic.co/guide/en/elasticsearch/guide/current/heap-sizing.html#compressed_oops Don’t Cross 32 GB! There is another reason to not allocate enormous heaps to Elasticsearch. As it turns out, the HotSpot JVM uses a trick to compress object pointers when heaps are less than around 32 GB. In Java, all objects are allocated on the heap and referenced by a pointer. Ordinary object pointers (OOP) point at these objects, and are traditionally the size of the CPU’s native word: either 32 bits or 64 bits, depending on the processor. The pointer references the exact byte location of the value. For 32-bit systems, this means the maximum heap size is 4 GB. For 64-bit systems, the heap size can get much larger, but the overhead of 64-bit pointers means there is more wasted space simply because the pointer is larger. And worse than wasted space, the larger pointers eat up more bandwidth when moving values between main memory and various caches (LLC, L1, and so forth). Java uses a trick called compressed oops to get around this problem. Instead of pointing at exact byte locations in memory, the pointers reference object offsets. This means a 32-bit pointer can reference four billion objects, rather than four billion bytes. Ultimately, this means the heap can grow to around 32 GB of physical size while still using a 32-bit pointer. Once you cross that magical ~32 GB boundary, the pointers switch back to ordinary object pointers. The size of each pointer grows, more CPU-memory bandwidth is used, and you effectively lose memory. In fact, it takes until around 40–50 GB of allocated heap before you have the same effective memory of a heap just under 32 GB using compressed oops. The moral of the story is this: even when you have memory to spare, try to avoid crossing the 32 GB heap boundary. It wastes memory, reduces CPU performance, and makes the GC struggle with large heaps. 注意:是每个es实例不要超过32G,而不是所有的。 [hadoop@master bin]$ pwd /home/hadoop/app/elasticsearch-2.4.0/bin [hadoop@master bin]$ ll total 324 -rwxr-xr-x 1 hadoop hadoop 5551 Aug 24 2016 elasticsearch -rw-rw-r-- 1 hadoop hadoop 909 Aug 24 2016 elasticsearch.bat -rw-rw-r-- 1 hadoop hadoop 3307 Aug 24 2016 elasticsearch.in.bat -rwxr-xr-x 1 hadoop hadoop 2814 Aug 24 2016 elasticsearch.in.sh -rw-rw-r-- 1 hadoop hadoop 104448 Jul 27 2016 elasticsearch-service-mgr.exe -rw-rw-r-- 1 hadoop hadoop 103936 Jul 27 2016 elasticsearch-service-x64.exe -rw-rw-r-- 1 hadoop hadoop 80896 Jul 27 2016 elasticsearch-service-x86.exe -rwxr-xr-x 1 hadoop hadoop 2992 Aug 24 2016 plugin -rw-rw-r-- 1 hadoop hadoop 1303 Aug 24 2016 plugin.bat -rw-rw-r-- 1 hadoop hadoop 6872 Aug 24 2016 service.bat [hadoop@master bin]$ vim elasticsearch.in.sh 大家,自行去,根据自己机器内存实情,设置为其60%。 途径3、设置memory_lock来锁定进程的物理内存地址 避免交换(swapped)来提高性能 修改文件conf/elasticsearch.yml bootstrap.memory_lock: true 这里,我就不赘述了。 [hadoop@master config]$ pwd /home/hadoop/app/elasticsearch-2.4.0/config [hadoop@master config]$ ll total 12 -rw-rw-r-- 1 hadoop hadoop 3393 Jul 5 22:19 elasticsearch.yml -rw-rw-r-- 1 hadoop hadoop 2571 Aug 24 2016 logging.yml drwxrwxr-x 2 hadoop hadoop 4096 Apr 21 15:43 scripts [hadoop@master config]$ vim elasticsearch.yml 去掉注释。 es的3节点集群,master、slave1和slave2都要去操作。 途径4、分片多的话,可以提升建立索引的能力,5-20个比较合适。 如果分片数过少或过多,都会导致检索比较慢。 分片数过多会导致检索时打开比较多的文件,另外也会导致多台服务器之间通讯。 而分片数过少会导至单个分片索引过大,所以检索速度也会慢。 建议单个分片最多存储20G左右的索引数据,所以,分片数量=数据总量/20G 途径5、副本多的话,可以提升搜索的能力,但是如果设置很多副本的话也会对服务器造成额外的压力,因为需要主分片需要给所有副本同步数据。所以建议最多设置1-2个即可。 途径6、Elastic 官方文档建议:一个 es实例中 最好不要多于三个 shards,若是 "more shards”,只能增加更多的机器 ,如果服务器性能好的话可以在一台服务器上启动多个es实例 途径7、要定时对索引进行合并优化,不然segment越多,占用的segment memory越多,查询的性能也越差 索引量不是很大的话情况下可以将segment设置为1 在es2.1.0以前调用_optimize接口,后期改为_forcemerge接口 curl -XPOST 'http://localhost:9200/zhouls/_forcemerge?max_num_segments=1' client.admin().indices().prepareForceMerge("zhouls").setMaxNumSegments(1).get(); 途径8、针对不使用的index,建议close,减少内存占用。因为只要索引处于open状态,索引库中的segement就会占用内存,close之后就只会占用磁盘空间了。 curl -XPOST 'localhost:9200/zhouls/_close' 途径9、删除文档:在es中删除文档,数据不会马上在硬盘上除去,而是在es索引中产生一个.del的文件,而在检索过程中这部分数据也会参与检索,es在检索过程会判断是否删除了,如果删除了在过滤掉。这样也会降低检索效率。所以可以执行清除删除文档 curl -XPOST 'http://192.168.80.10:9200/zhouls/_forcemerge?only_expunge_deletes=true' client.admin().indices().prepareForceMerge("zhouls").setOnlyExpungeDeletes(true).get(); 途径10、如果在项目开始的时候需要批量入库大量数据的话,建议将副本数设置为0 因为es在索引数据的时候,如果有副本存在,数据也会马上同步到副本中,这样会对es增加压力。可以等索引完成后将副本按需要改回来。这样可以提高索引效率。 途径11、去掉mapping中_all字段,Index中默认会有_all这个字段,默认会把所有字段的内容都拷贝到这一个字段里面,这样会给查询带来方便,但是会增加索引时间和索引尺寸。 禁用_all字段 "_all":{"enabled":false} 如果只是某个字段不希望被加到_all中,可以使用 "include_in_all":false 途径12、log输出的水平默认为trace,即查询超过500ms即为慢查询,就要打印日志,造成cpu和mem,io负载很高。把log输出水平改为info,可以减轻服务器的压力。 修改ES_HOME/conf/logging.yaml文件 途径1:可以解决es的警告信息 其实啊,若我们在ES_HOME目录下,不用后台bin/elasticsearch -d这种方式来启动的话,用前台bin/elasticsearch。则会看到,如下: 说明,我这里是因为安装了tomcat。所以,在前台直接启动,会出错。 所以, [hadoop@HadoopMaster bin]$ pwd /home/hadoop/app/tomcat-7.0.73/bin [hadoop@HadoopMaster bin]$./startup.sh Using CATALINA_BASE: /home/hadoop/app/tomcat-7.0.73 Using CATALINA_HOME: /home/hadoop/app/tomcat-7.0.73 Using CATALINA_TMPDIR: /home/hadoop/app/tomcat-7.0.73/temp Using JRE_HOME: /home/hadoop/app/jdk1.7.0_79/jre Using CLASSPATH: /home/hadoop/app/tomcat-7.0.73/bin/bootstrap.jar:/home/hadoop/app/tomcat-7.0.73/bin/tomcat-juli.jar Tomcat started. [hadoop@HadoopMaster bin]$ jps 2916 Jps 2906 Bootstrap [hadoop@HadoopMaster bin]$ cd .. [hadoop@HadoopMaster tomcat-7.0.73]$ cd .. [hadoop@HadoopMaster app]$ cd elasticsearch-2.4.3/ [hadoop@HadoopMaster elasticsearch-2.4.3]$bin/elasticsearch [2017-02-28 22:08:49,862][WARN ][bootstrap ] unable to install syscall filter: seccomp unavailable: requires kernel 3.5+ with CONFIG_SECCOMP and CONFIG_SECCOMP_FILTER compiled in [2017-02-28 22:08:51,324][INFO ][node ] [Dragonwing] version[2.4.3], pid[2930], build[d38a34e/2016-12-07T16:28:56Z] [2017-02-28 22:08:51,324][INFO ][node ] [Dragonwing] initializing ... [2017-02-28 22:08:55,760][INFO ][plugins ] [Dragonwing] modules [lang-groovy, reindex, lang-expression], plugins [analysis-ik, kopf, head], sites [kopf, head] [2017-02-28 22:08:55,846][INFO ][env ] [Dragonwing] using [1] data paths, mounts [[/home (/dev/sda5)]], net usable_space [23.4gb], net total_space [26.1gb], spins? [possibly], types [ext4] [2017-02-28 22:08:55,846][INFO ][env ] [Dragonwing] heap size [1015.6mb], compressed ordinary object pointers [true] [2017-02-28 22:08:55,848][WARN ][env ] [Dragonwing] max file descriptors [4096] for elasticsearch process likely too low, consider increasing to at least [65536] [2017-02-28 22:09:00,957][INFO ][ik-analyzer ] try load config from /home/hadoop/app/elasticsearch-2.4.3/config/analysis-ik/IKAnalyzer.cfg.xml [2017-02-28 22:09:00,959][INFO ][ik-analyzer ] try load config from /home/hadoop/app/elasticsearch-2.4.3/plugins/ik/config/IKAnalyzer.cfg.xml [2017-02-28 22:09:01,925][INFO ][ik-analyzer ] [Dict Loading] custom/mydict.dic [2017-02-28 22:09:01,926][INFO ][ik-analyzer ] [Dict Loading] custom/single_word_low_freq.dic [2017-02-28 22:09:01,932][INFO ][ik-analyzer ] [Dict Loading] custom/zhouls.dic [2017-02-28 22:09:01,933][INFO ][ik-analyzer ] [Dict Loading] http://192.168.80.10:8081/zhoulshot.dic [2017-02-28 22:09:09,451][INFO ][ik-analyzer ] 好记性不如烂笔头感叹号博客园热更新词 [2017-02-28 22:09:09,550][INFO ][ik-analyzer ] 桂林不雾霾 [2017-02-28 22:09:09,615][INFO ][ik-analyzer ] [Dict Loading] custom/ext_stopword.dic [2017-02-28 22:09:13,620][INFO ][node ] [Dragonwing] initialized [2017-02-28 22:09:13,621][INFO ][node ] [Dragonwing] starting ... [2017-02-28 22:09:13,932][INFO ][transport ] [Dragonwing] publish_address {192.168.80.10:9300}, bound_addresses {[::]:9300} [2017-02-28 22:09:13,960][INFO ][discovery ] [Dragonwing] elasticsearch/eKzsH0g5QoGl6pQlCG4mOQ [2017-02-28 22:09:17,357][INFO ][cluster.service ] [Dragonwing] detected_master {Carrie Alexander}{98-Mux6mQsu1oE__EJN7yQ}{192.168.80.11}{192.168.80.11:9300}, added {{Carrie Alexander}{98-Mux6mQsu1oE__EJN7yQ}{192.168.80.11}{192.168.80.11:9300},{Shocker}{u_IYMF3ISe6_iki9KwxPCA}{192.168.80.12}{192.168.80.12:9300},}, reason: zen-disco-receive(from master [{Carrie Alexander}{98-Mux6mQsu1oE__EJN7yQ}{192.168.80.11}{192.168.80.11:9300}]) [2017-02-28 22:09:17,637][INFO ][http ] [Dragonwing] publish_address {192.168.80.10:9200}, bound_addresses {[::]:9200} [2017-02-28 22:09:17,638][INFO ][node ] [Dragonwing] started [2017-02-28 22:09:19,812][INFO ][ik-analyzer ] 重新加载词典... [2017-02-28 22:09:19,816][INFO ][ik-analyzer ] try load config from /home/hadoop/app/elasticsearch-2.4.3/config/analysis-ik/IKAnalyzer.cfg.xml [2017-02-28 22:09:19,820][INFO ][ik-analyzer ] try load config from /home/hadoop/app/elasticsearch-2.4.3/plugins/ik/config/IKAnalyzer.cfg.xml [2017-02-28 22:09:23,102][WARN ][monitor.jvm ] [Dragonwing] [gc][young][8][7] duration [1.6s], collections [1]/[1.9s], total [1.6s]/[5.2s], memory [121.7mb]->[79.4mb]/[1015.6mb], all_pools {[young] [59.9mb]->[457kb]/[66.5mb]}{[survivor] [8.2mb]->[8.3mb]/[8.3mb]}{[old] [53.5mb]->[70.6mb]/[940.8mb]} [2017-02-28 22:09:23,946][INFO ][ik-analyzer ] [Dict Loading] custom/mydict.dic [2017-02-28 22:09:23,947][INFO ][ik-analyzer ] [Dict Loading] custom/single_word_low_freq.dic [2017-02-28 22:09:23,953][INFO ][ik-analyzer ] [Dict Loading] custom/zhouls.dic [2017-02-28 22:09:23,955][INFO ][ik-analyzer ] [Dict Loading] http://192.168.80.10:8081/zhoulshot.dic [2017-02-28 22:09:23,996][INFO ][ik-analyzer ] 好记性不如烂笔头感叹号博客园热更新词 [2017-02-28 22:09:23,997][INFO ][ik-analyzer ] 桂林不雾霾 [2017-02-28 22:09:24,000][INFO ][ik-analyzer ] [Dict Loading] custom/ext_stopword.dic [2017-02-28 22:09:24,002][INFO ][ik-analyzer ] 重新加载词典完毕... 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/6478773.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

SaltStack之安装

SaltStack是基于Python开发的C/S架构配置管理工具,它是一种全新的基础设施管理方式,部署轻松,扩展性好,很容易管理成千上万台服务器。 服务端安装: yum -y install epel-release.noarch yum -y install salt-master salt-minion service salt-master start chkconfig salt-master on salt-key -L#查看证书的签证情况 salt-key -A -y#同意签证所有没有接受的 salt-key -L #再次查看 vim /etc/salt/master file_roots: base: - /srv/salt #配置文件对格式的要求非常严格,包括空格的数目等 mkdir -pv /srv/salt #创建配置文件中的目录(SaltStack的工作环境) service salt-master restart 客户端安装: yum -y install epel-release.noarch yum -y install salt-minion vim /etc/salt/minion master: 192.168.154.156 #服务端IP #id: #如果不配,默认为本机FQDN service salt-minion start chkconfig salt-minion on 本文转自 zengwj1949 51CTO博客,原文链接:http://blog.51cto.com/zengwj1949/1914273

优秀的个人博客,低调大师

Docker 之 Dockerfile

Dockerfile 命令介绍 1、FROM 构建一个属于自己的镜像需要依赖一个基础镜像,就是指定一个官方提供的一个base image。在这个基础之上构建。例如使用daocloud.io提供的centos7作为基础镜像.FROM必须是第一行 FROM daocloud.io/centos:7 2、LABEL 一些注释信息,多行的话可以使用反斜线,以下三种方式 # Set one or more individual labels LABEL com.example.version="0.0.1-beta" LABEL vendor="ACME Incorporated" LABEL com.example.release-date="2015-02-12" LABEL com.example.version.is-production="" # Set multiple labels on one line LABEL com.example.version="0.0.1-beta" com.example.release-date="2015-02-12" # Set multiple labels at once, using line-continuation characters to break long lines LABEL vendor=ACME\ Incorporated \ com.example.is-beta= \ com.example.is-production="" \ com.example.version="0.0.1-beta" \ com.example.release-date="2015-02-12" 3、RUNRUN 后面要加上要构建镜像时,所要执行的脚本,多行命令换行也可以使用反斜线 来分隔,例如在centos7上安装并启用httpd RUN yum -y install httpd \ systemctl enable httpd.service ×需要注意,如果每一行RUN 命令都是单独存在的例如如下情况 RUN yum update RUN yum install -y httpd 这种情况下构建之后,如果修改了第二句话 RUN yum update RUN yum install -y httpd nginx 如果基于修改后的dockerfile构建新镜像,则不会安装新的源里的httpd和nginx,因为第一行没有变化,docker默认认为可使用缓存,所以第一句update不会执行,为了避免这种情况,建议使用反斜线 分隔命令行,这样docker会认为是一句话 RUN yum update \ yum install -y httpd nginx 4、pipes 管道 RUN 中 使用|管道, RUN wget -O - https://some.site | wc -l > /number docker利用/bin/sh -c 执行RUN后面的命令,且只会判定最后一个命令执行结果来判断是否RUN正常执行,例如wc -l成功,但是wget失败,docker也会认为RUN执行成功而制作一个镜像,为了避免,我们可以在命令之前加上set -o pipefail,任意后面失败都会导致构建失败 RUN set -o pipefail && wget -O - https://some.site | wc -l > /number 不是所有shell都支持 set -o pipefail,bash支持,docker默认用/bin/sh ,可以在RUN后面显示的指定所用的shell RUN ["/bin/bash", "-c", "set -o pipefail && wget -O - https://some.site | wc -l > /number"] 5、CMDCMD是运行容器时所需要执行的脚本,不同于RUN,RUN是构建镜像时需要执行的脚本。一般服务类型的镜像推荐使用CMD,运行时执行开启服务的脚本 6、EXPOSE容器所要对外曝光的端口,例如httpd 是80 7、ENVENV用来设置容器内的环境变量path用法 ENV 环境变量 环境变量值 ENV PG_MAJOR 9.3 ENV PG_VERSION 9.3.4 RUN curl -SL http://example.com/postgres-$PG_VERSION.tar.xz | tar -xJC /usr/src/postgress && … ENV PATH /usr/local/postgres-$PG_MAJOR/bin:$PATH 8、COPY 、ADDADD src dest,add的src可以是一个url,add会下载到指定目录,add偶尔会根据下载文件格式进行解压,有时候不会解压,很奇怪COPY SRC DEST从本地指定的src复制至镜像的目录下 可以ADD URL DEST下载,然后RUN tar zxf .tar -C dest解压 ADD http://example.com/big.tar.xz /usr/src/things/ RUN tar -xJf /usr/src/things/big.tar.xz -C /usr/src/things RUN make -C /usr/src/things all

优秀的个人博客,低调大师

Spark之殇

我觉得Spark有时候会伤害用户。 之前Spark 2.0 刚发布不久后的第一个小版本,Structured Streaming 终于支持Kafka了,但是只支持Kafka 1.0 而不支持Kafka 0.8。用Spark的开发可是没办法决定基础设施Kafka的版本的,而且你知道在一个业务成熟的公司更换这种如此重要的基础设置的版本的阻力和风险有多大么?这简直让我们这些渴望能体验Spark新功能的痛心疾首。 接着为了推动大家迁移到Scala 2.11 版本而不再提供基于scala 2.10预编译的Assembly包,要知道,这会给使用spark的公司会带来的很大的困难。本来用Spark就是因为便于编程,功能强大,但是有多少程序员有能力自己去编译? 公司累积了一堆的2.10的库难道都因为为了体验下2.0版本而要重新编译? 我只是觉得Spark不是为我等欢快的工作而努力,而是为了他们的技术追求和审美的强迫症而努力。或许这是技术人员难以逾越的坑吧 Spark 过于专注他所谓的架构,忽略了对用户问题的解决。为了所谓的统一(DataFrame API)导致公司精力都放在了内核的重构上,这也直接让Spark在很多方面慢了一大拍. 曾经机器学习的新星,现在没落了 原本对机器学习库我是抱以厚望的,然而其算法和功能都相对来说很贫乏,并且一直没有得到质的提升。Spark 团队将其主要精力放在了API的简化尤其是DataFrame的统一上,让其错过了16年深度学习崛起的年代,终于沦为一个普通的带算法的计算框架上了。 曾经的全平台,现在只有批处理还有优势 对流式的支持也是磕磕盼盼,要知道,流式已经是大势所趋。相对于原先的Spark Streaming, Structure Streaming 带来了很多新概念,但是本质没有什么变化,只是强迫症患者的一个强迫而已(要使用Dataframe)。Spark Streaming 足够灵活,就是问题比较多。你新的Structure Streaming 还把追加,写入等各种拆分开了,学习曲线陡然上身。因为执着于RDD概念,没有勇气打破Spark的基石,一直无法实现真正的流式,倒是给了Flink巨大的机会。同样的,也让Storm一直活得很潇洒。新的Structure Streaming不行,但是他们似乎已然放弃Spark Streaming的努力,包括从Spark Streaming诞生就被广受吐槽的checkpoint 问题,也从来没有得到关注,也没有得到改善。让你带着爱被虐着,然后就眼睁睁的看着流式时代在自己的眼皮底下流过。 有望成为SQL的新标准,现在依然丧失 SQL的支持也是磕磕盼盼,到现在还还没覆盖Hive SQL的大部分功能,Hive 已然是大数据SQL的事实标准,又想摆脱Hive,我原先很赞赏Spark的做法,因为hive确实重啊,结果 1.6 里一些基础UADF都不支持。。。。很多情况其实没办法用的。而新的版本2.0对SQL支持好了很多,结果前面各种问题限制你使用。 感想 我觉得一个开源产品,用户才是自己的最关键的。用户只关注了一个新的版本有什么新的功能,解决了老的什么痛点,并且提高了多少稳定性和速度,如此而已。至于内核的重构,API的统一,这不能成为自己全身心去投入的事情。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册