首页 文章 精选 留言 我的

精选列表

搜索[然之],共10000篇文章
优秀的个人博客,低调大师

ELK之简介

一.简介 1. 核心组成 ELK由Elasticsearch、Logstash和Kibana三部分组件组成; Elasticsearch: 个开源分布式搜索引擎,它的特点有:分布式,零配置,自动发现,索引自动分片,索引副本机制,restful风格接口,多数据源,自动搜索负载等。 Logstash: 一个完全开源的工具,它可以对你的日志进行收集、分析,并将其存储供以后使用 kibana: 一个开源和免费的工具,它可以为 Logstash 和 ElasticSearch 提供的日志分析友好的 Web 界面,可以帮助您汇总、分析和搜索重要数据日志。 2.四大组件 Logstash: logstash server端用来搜集日志; Elasticsearch: 存储各类日志; Kibana: web化接口用作查寻和可视化日志; Logstash Forwarder: logstash client端用来通过lumberjack 网络协议发送日志到logstash server; 3.ELK+Redis工作流程 在每个客户端配置安装logstash,直接将日志output到ElasticSearch上,实现对数据的读取、解析和输出处理。 但是在生产环境中,在每台应用服务器运行logstash进程并将数据直接发送到Elasticsearch里,显然是不科学的,原因: a.过多的客户端连接对Elasticsearch是一种额外的压力; b. 网络抖动会影响到 logstash 进程,进而影响生产应用; c.运维人员未必愿意在每台生产服务器上部署 Java,或者让logstash跟业务代码争夺Java资源。 所以,在实际运用中,logstash 进程会被分为两个不同的角色。运行在应用服务器上的,尽量减轻运行压力,只做读取和转发,这个角色叫做shipper;运行在独立服务器上,完成数据解析处理,负责写入Elasticsearch 的角色,叫indexer。 Logstash 社区通常习惯用 shipper,broker 和 indexer 来描述数据流中不同进程各自的角色。 在需要收集日志的所有服务上部署logstash,作为logstash agent(logstash shipper)用于监控并过滤收集日志,将过滤后的内容发送到Redis,然后logstash indexer将日志收集在一起交给全文搜索服务ElasticSearch,可以用ElasticSearch进行自定义搜索通过Kibana 来结合自定义搜索进行页面展示。 4.ELK的帮助手册 ELK官网:https://www.elastic.co/ ELK官网文档:https://www.elastic.co/guide/index.html ELK中文手册:http://kibana.logstash.es/content/logstash/index.html 注释 ELK有两种安装方式 ü 集成环境:Logstash有一个集成包,里面包括了其全套的三个组件;也就是安装一个集成包。 ü 独立环境:三个组件分别单独安装、运行、各司其职。(比较常用)

优秀的个人博客,低调大师

HDFS之FileStatus

任何文件系统的一个重要特性都是提供其目录结构浏览和检索它所存文件和目录相关信息的功能。FileStatus对象封装了文件系统中文件和目录的元数据,包括文件的长度、块大小、备份数、修改时间、所有者以及权限等信息。 FileStatus对象由FileSystem的getFileStatus()方法获得,调用该方法的时候要把文件的Path传进去。 例子:打印输出某个文件的所有信息 1 package com.hdfs; 2 3 import org.apache.hadoop.conf.Configuration; 4 import org.apache.hadoop.fs.FSDataInputStream; 5 import org.apache.hadoop.fs.FSDataOutputStream; 6 import org.apache.hadoop.fs.FileStatus; 7 import org.apache.hadoop.fs.FileSystem; 8 import org.apache.hadoop.fs.FileUtil; 9 import org.apache.hadoop.fs.FsUrlStreamHandlerFactory; 10 import org.apache.hadoop.fs.Path; 11 import org.apache.hadoop.io.IOUtils; 12 import org.apache.hadoop.util.Progressable; 13 14 public class HdfsTest1 { 15 //显示文件所有信息 16 public static void fileInfo(String path) throws IOException{ 17 Configuration conf = new Configuration(); 18 FileSystem fs = FileSystem.get(conf); 19 Path p = new Path(path); 20 //FileStatus对象封装了文件的和目录的额元数据,包括文件长度、块大小、权限等信息 21 FileStatus fileStatus = fs.getFileStatus(p); 22 System.out.println(“文件路径:”+fileStatus.getPath()); 23 System.out.println(“块的大小:”+fileStatus.getBlockSize()); 24 System.out.println(“文件所有者:”+fileStatus.getOwner()+”:”+fileStatus.getGroup()); 25 System.out.println(“文件权限:”+fileStatus.getPermission()); 26 System.out.println(“文件长度:”+fileStatus.getLen()); 27 System.out.println(“备份数:”+fileStatus.getReplication()); 28 System.out.println(“修改时间:”+fileStatus.getModificationTime()); 29 } 30 public static void main(String[] args) throws IOException { 31 fileInfo(“/user/hadoop/aa.mp4”); 32 } 33 34 } 输出结果为: 文件路径:hdfs://master:9000/user/hadoop/aa.mp4 块的大小:67108864 文件所有者:hadoop:supergroup 文件权限:rw-r–r– 文件长度:76805248 备份数:3 修改时间:1371484526483

优秀的个人博客,低调大师

Docker之dockerfile

一、什么是dockerfile Docker通过对于在dockerfile中的一系列指令的顺序解析实现自动的Image的构建; 通过使用build命令,根据dockerfile的描述来构建镜像; build的两种方法: 通过源代码路径的方式; 通过标准输入流的方式; 通过源代码路径: Dockerfile需要放置在项目的根目录位置; 在构建的时候,Docker client会把整个Context打包发送到docker Server端,然后由Server端负责build镜像,在构建成功后,会删除Context目录; docker build -t {镜像名字}{项目的路径,可以是相对路径} 通过标准输入流: 通过标准输入流的方式获取dockerfile的内容; client不会打包上传context目录,因此对于一些ADD、COPY等涉及HOST本地文件复制的操作不能够支持; docker build -t {镜像名字} -< Dockerfile路径 build cache: Dockerfile中的每一个指令执行完毕后,都会提交为一个Image,这样保证了指令间不会有影响; docker会尽可能尝试重用之前已经重用之前已经构建的镜像; 可以通过在build命令中增加-no-cache的方式来禁用cache dockerignore: 当选择用源代码路径的方式构建image的时候,通过在根目录下放置.dockerignore文件,来过滤不需要发送到server端的文件 类似于.gitinore的概念 二、Dockerfile指令: 只支持docker自己定义的一套指令,不支持自定义 大小写不敏感,但是建议全部使用大写 根据dockerfile的内容顺序执行 FROM FROM {base镜像} 必须放在dockerfile的第一行,表示从哪个BaseImage开始构建 MAINTAINER 可选的,用来标示Image作者的地方 RUN 每一个RUN指令都会是在一个新的container里面运行,并提交为一个Image作为下一个RUN的base 一个dockerfile中可以包含多个RUN,按定义顺序执行 RUN支持两种运行方式: RUN <cmd> 这个会当作/bin/sh -c "cmd"运行 RUN ["executable", "arg1", ....], docker把它当Json的序列来解析,因此必须用双引号,而且executable需要是完整路径; CMD CMD的作用是作为执行Container时候的默认行为 当运行Container的时候声明了Command,则不再使用Image中的CMD所定义的命令; 一个dockerfile中只能有一个有效的CMD,当定义多个CMD的时候,只有最后一个才会起作用; CMD定义三种方式: CMD <cmd> 这个会当作/bin/sh -c "cmd"来执行 CMD ["executable", "arg1", "arg2"] CMD ["arg1", "arg2"], 这个时候CMD作为ENTRYPOINT的参数; ENTRYPOINT: ENTPYPOINT的作用是,把整个Container变成了一个可执行文件,这样不能够通过替换CMD的方法来改变创建Container的方式。但是可以通过参数传递的方式影响到Container内部。 每个Dockerfile只能包含一个ENTRYPOINT,多个ENTRYPOINT只有最后一个能有效; 当定义了ENTRYPOINT以后,CMD只能作为参数进行传递; ENTRYPOINT定义方式: ENTPYPOINT ["executable", "arg1", "arg2"], 这种定义方式下,CMD可以通过Json序列的方式来定义ENTRYPOINT的参数,可以通过在运行Container的时候通过指定Command的方式传递参数 ENTRYPOINT <cmd>, 当做/bin/sh -c "cmd"运行; ADD&COPY: 当在源代码构建的方式下,可以通过ADD和COPY的方式,把Host上的文件或者目录复制到Image ADD&COPY的源必须在context路径下; 当src为网络URL的情况下,ADD指令可以把它下载到Dest的指定位置,这个在任何build的方式下都可以工作; ENV: 用来设置环境变量,后续的RUN可以使用它所创建的环境变量; 当创建基于该镜像的Container的时候,会自动拥有设置的环境变量; WORKDIR: 用来指定当前工作目录 当使用相对目录的情况下,采用上一个WORKDIR指定的目录作为基准; USER: 指定UID或者username,来决定运行RUN指令的用户 ONBUILD: ONBUILD作为一个trigger的标记,可以用来trigger任何Dockerfile中的指令; 可以定义多个ONBUILD指令 当下一个镜像B使用镜像A作为Base的时候,在FROM A指令前,会按照顺序执行在构建A时候定义的ONBUILD指令 ONBUILD <DOCKERFILE指令> <Content> VOLUME: 用来创建一个在Image之外的mount point,用来在多个container之间实现数据共享 运行使用json array的方式定义多个volume VOLUME ["/var/data1", "/var/data2/"] 或则plain text的情况下定义多个VOLUME指令

优秀的个人博客,低调大师

openstack之cinder

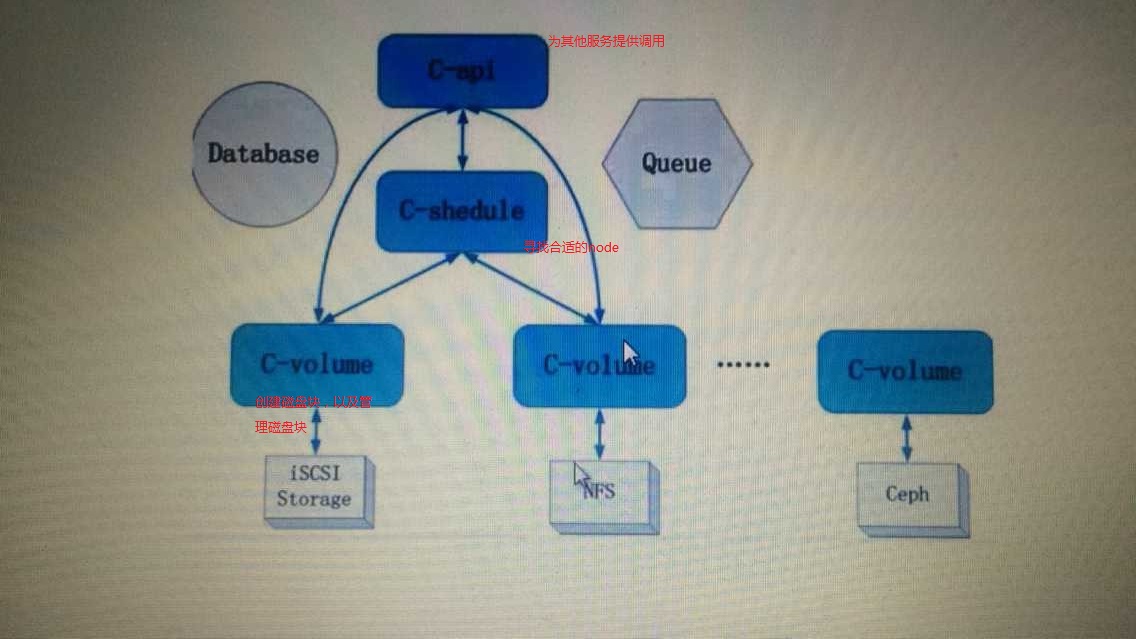
一、cinder概述: 1、F版之前,并没有cinder,对应的组件为nova-volume;以Rest API的形式提供服务 2、cinder目标: 减少nova的复杂性,降低nova的负载,支持多种后端存储,增加和其他组件之间的交互; 后端存储包括isics 以及ceph等; cinder提供的是后端存储的适配器,而不是实现了存储系统; 提供块存储、虚拟机磁盘; 3、API service:负责接收和处理Rest请求,并将请求放入RabbitMQ/Qpid队列中; 4、Scheduler service 处理任务队列的任务,并根据预定策略选择合适的Volume Service节点来执行任务; 5、Volume service: 该服务运行在存储节点上,管理存储空间; 二、cinder存储解决方案: 1、使用本地存储,即Cinder LFS 2、使用动态存储系统,即Cinder ZFS 这种方案解决了多种存储特性,如: Cache、Copy On Write、Snapshot&Clone、Changeable block size 3、使用分布式存储系统,即Cinder DFS, 常见的分布式存储系统: ceph、sheepdog、glusterfs DAS(直接存取):例如本机上面的磁盘,就是直接存取设备; NFS(网络附加存储服务器):来自NAS提供的文件系统,只能立即使用(通过mount方式),不可再格式化; SAN(存储局域网络):来自局域网内的其他存储设备提供的磁盘,需要格式化 三、iSCSI使用: 1、iSCSI服务器: a、准备存储介质; b、dd命令所建立的文件 c、物理磁盘或者分区 d、LVM(逻辑卷) 2、设置target 向网络暴露存储服务 3、iSCSI client a、发现网络中的target b、Initiator登录到target c、kvm vm使用Initiator盘 http://www.cnblogs.com/mchina/p/centos-iscsi-network-storage.html

优秀的个人博客,低调大师

openstack之Glance

一、Glance简介、基本概念: Glance是openstack项目中负责镜像管理的模块,其功能包括虚拟机镜像的查找、注册和检索等操作。 Glance提供restful API可以查询虚拟机镜像的metadata,并且可以获取镜像。 通过Glance,虚拟机镜像可以被存储到多种存储上,比如简单的文件存储或者对象存储; Image identifiers:一个Image URL,格式:<GlanceServerLocation>/images/<ID> Image status:(镜像状态) Queued:镜像ID已经被保留,但是镜像还没有上传; Saving:镜像正在被上传; Active: 镜像可以使用了; Killed:镜像损坏或者不可以用; Deleted:镜像被删除; Disk Format:(镜像格式)raw、vhd、vmdk、vdi、iso、qcow2、aki、ari、ami container format:bare等等 二、Glance 架构: Glance API:处理API请求(命令行、http、函数调用等请求) Glance Registry:处理镜像的metadata存储;(镜像相关信息的存,一般是存数据库) Store Adapter: 镜像本身存储;包括s3、Swift、FileSystem、RBD、HTTP(通过HTTP读取的存储;其他分布式存储,比如sheepdog;

优秀的个人博客,低调大师

openstack之keystone

一、什么是keystone 用于为openstack家族中的其它组件成员提供统一的认证服务,包括身份认证、令牌发放和校验、服务列表、用户权限定义等; 基本概念: 用户User:用于身份认证、一个用户可以关联到多个租户,即一个用户可以属于租户A同时属于租户B; 租户Tenant:相当于用户组的概念。一个租户可以容纳多个用户; 角色Role:关联到“用户-租户对”的元数据。可以关联到多个用户; 令牌Token:用于验证用户或者“用户-租户对”的请求是否合法; 服务Service:服务类型和名称。例如网络服务、镜像服务; 端点Endpoint:服务的实例(url入口),服务的url; keystone在openstack中的结构图: openstack用户-角色-服务交互图: keystone基本结构: 用户创建虚拟机流程图: 用户创建虚拟机实例: 1、用户Alice通过自己的户名和密码向keystone申请token,keystone认证用户名和密码后,返回临时token 2、Alice通过临时token发送keystone查询他所拥有的租户,keystone验证临时token成功后,返回Alice的所有租户列表 3、Alice选择一个租户,通过用户名和密码申请正式token,keystone认证用户名、密码、tenant后,返回正式token。 4、Alice通过正式token发送创建server的请求,keystone验证正式token(包括该token是否有效,是否有权限创建虚拟机等)成功后,然后再把请求下发到nova,最终创建虚拟机; keystone安装: keystone包安装; keystone配置; keystone数据库初始化; keystone服务启动; keystone:包含一个命令行接口,可以与keystone API交互以管理 keystone和相关服务;keystone-all:用于验证的、面向管理员和用户的API;keystone-manage:管理keystone的命令行接口,用于管理和keystone相 连接的数据库 创建租户;创建用户;创建角色;绑定角色;将角色分配到某个用户;创建服务:keystone测试工具:restclient Keystone常见错误 401 #验证失败,keystone相关用户账户密码设置错误,时间不同步,或者输入的项目名称不对 403 #可能未初始化OS_token变量,需要使用source命令使其生效,也可能是配置的配置文件未生效,需要重启相关服务 409 #keystone创建用户,用户已存在 500 #服务器内部错误,服务配置有问题,看日志,检查配置 503 #keystone相关账户密码设置有问题,请将相关的glance账户删除,重新创建即可 服务故障 #相关服务没有起来 遇到问题及解决办法: 问题1 aboutyun@controller:~$ keystone tenant-create --name admin --description "admin Tenant" An unexpected error prevented the server from fulfilling your request. (HTTP 500) 原因1: 环境变量错误 记得重启后,执行下面命令 export OS_SERVICE_TOKEN=570f150cb897e793e58f export OS_SERVICE_ENDPOINT=http://controller:35357/v2.0 问题2: admin租户获取token出现错误,请问怎样解决? root@ubuntu:~# keystone --os-tenant-name admin --os-username admin --os-password ADMIN_PASS \ > --os-auth-url http://controller:35357/v2.0 token-get WARNING: Bypassing authentication using a token & endpoint (authentication credentials are being ignored). 'NoneType' object has no attribute 'has_service_catalog' 解决办法: unset OS_SERVICE_TOKEN OS_SERVICE_ENDPOINT

优秀的个人博客,低调大师

网络协议之:socket协议详解之Socket和Stream Socket

简介 不管是在普通的网络编程中还是在netty中,都经常会提到一个词叫做socket,好像socket是一个神奇的东西,使用socket我们可以建立客户端到服务器端的连接,并且和进行客户端和服务器端的通讯,那么socket到底是什么呢?它有哪些分类呢?一起来看看吧。 Socket是什么 socket的中文翻译是套接字,个人觉的这个翻译真的是太差劲了,套接字听起来毫无意义,所以很多人在第一次听到socket这个词的时候肯定很迷茫。 那么什么是socket呢?socket是一种不同程序间进行进程通讯的方法,这些程序可以在同一个服务器上也可以在不同的服务器上。 socket建立连接的基础是IP协议,IP协议被用来进行数据的封装和分组,然后才能够在网络上进行传输。这种依赖于IP协议的socket,又叫做network socket。 通过network socket可以建立客户端和服务器端的连接,客户端和服务器端是通过socket address来发现对方的。 以java为例,我们来看下SocketAddress的定义: public abstract class SocketAddress implements java.io.Serializable { static final long serialVersionUID = 5215720748342549866L; } 可以看到SocketAddress只是一个笼统的定义,它可以有多种实现,它具体的实现中包含了传输协议,比如说是TCP,还是UDP,另外还需要包含一个IP地址和一个连接的端口。 其中IP地址和端口定义了连接的对象,协议定义的是连接方式。 基于不同的协议,可以衍生出不同的类型的sockets。比如依赖于TCP协议的叫做Stream sockets,依赖于UDP协议的叫做Datagram sockets,依赖于local files来进行数据传输的叫做Unix Domain Sockets. 接下来我们会在一个unix系统中详细讲解这几种协议的使用。 在讲解详细的例子之前,我们需要使用到关于网络的命令,他们是ss,nc和socat。 在本文中,我使用的是centOS系统,所以你可以使用下面的命令进行安装: yum install iproute2 netcat-openbsd socat Stream Socket 什么是Stream Socket呢?从字面上可以看出,这个Socket连接是用来进行流传输的,如果要进行流的传输,那么首先就需要建立一个稳定的网络连接,在稳定的连接方面,毫无疑问TCP(Transmission Control Protocol)是最常用也是极其高效的一种协议。 对于Stream Socket来说,它是有向性的,数据package需要从一个地址通过网络传递到另外一个地址,同时还需要接受到对方的处理返回结果,在这个过程中通常使用的就是TCP协议。 TCP协议能够保证数据的稳定性和有序性,TCP的数据包可以保证发送到物理网络接口的数据包顺序。 如果网络接口接收到的数据包是无序的,那么网络适配器和操作系统将确保它们以正确的顺序重新组合以供应用程序使用。 常见的基于TCP的Stream Socket就是我们常常访问的http和https服务了,处理http和https服务的服务器一般是nginx或者apache,那么通常会有下面的Stream Socket地址: 124.225.141.53:80 124.225.141.53:443 上面我用的是网易的ip地址,其中80表示的是http,443表示的是https。 使用socat创建一个TCP服务器 常用的TCP服务器可以选择apache或者nginx,这里为了简单起见,我们选择使用socat来创建一个TCP服务器。 socat是什么呢?它是SOcket CAT的简称,可以用来模拟一个TCP的服务器。 socat的命令很复杂,这里我们只是简单介绍一下它的应用: socat -h socat by Gerhard Rieger and contributors - see www.dest-unreach.org Usage: socat [options] <bi-address> <bi-address> 从上面的结果我们可以看出,socat可以接受一些地址,然后可以添加一些选项。 这里我们使用socat来创建两个连接,分别是TCP6和TCP4,socat有两个选项可以做这项工作: tcp-connect:<host>:<port> groups=FD,SOCKET,CHILD,RETRY,IP4,IP6,TCP tcp-listen:<port> groups=FD,SOCKET,LISTEN,CHILD,RETRY,RANGE,IP4,IP6,TCP tcp4-connect:<host>:<port> groups=FD,SOCKET,CHILD,RETRY,IP4,TCP tcp4-listen:<port> groups=FD,SOCKET,LISTEN,CHILD,RETRY,RANGE,IP4,TCP tcp6-connect:<host>:<port> groups=FD,SOCKET,CHILD,RETRY,IP6,TCP tcp6-listen:<port> groups=FD,SOCKET,LISTEN,CHILD,RETRY,RANGE,IP6,TCP 这里我们只需要建立两个监听TCP的服务,所以我们使用下面的命令: socat TCP4-LISTEN:8888,fork /dev/null& socat TCP6-LISTEN:8888,ipv6only=1,fork /dev/null& 上面的命令,我们在8888端口上监听TCP4和TCP6的连接信息,其中fork参数表示程序在接收到程序包之后继续运行,如果不用fork,那么程序会自动退出。 socat后面本来要接一个bi-address,这里我们使用/dev/null,表示丢弃掉所有的income信息。 TCP6-LISTEN有个特殊的参数叫做ipv6only,表示收到的数据包不要发送到IPv4-mapped IPv6 addresses。 什么是IPv4-mapped IPv6 addresses? 简单点说就是将IPv4映射到了IPv6的地址中。 执行上述命令,我们会得到下面的输出: [1] 30877 [2] 30885 因为是后台执行,所以我们返回了进程的ID。 使用ss检查TCP连接 ss是一个非常强大的命令,我们可以通过使用ss来监测TCP sockets的信息,它的使用情况如下: ss -h Usage: ss [ OPTIONS ] ss [ OPTIONS ] [ FILTER ] 我们主要看下面几个将要用到的参数: -4, --ipv4 display only IP version 4 sockets -6, --ipv6 display only IP version 6 sockets -t, --tcp display only TCP sockets -l, --listening display listening sockets -n, --numeric don't resolve service names 因为我们只监听ipv4和ipv6的数据,所以这里我们用-4和-6这两个参数。 另外因为只需要监听tcp sockets,所以需要使用-t参数。 因为是监听,所以使用-l参数,最后我们希望看到具体的数字,而不是被解析成了服务名,所以这里使用-n参数。 我们使用下面的命令看看结果: ss -4 -tln 结果如下: State Recv-Q Send-Q Local Address:Port Peer Address:Port LISTEN 0 5 *:8888 *:* 表示监听到了端口8888, 当然如果你的服务器上有其他的进程,那么可能不止这一条数据。 上面的命令只监听了Ipv4,我们再看看Ipv6: ss -6 -tln 可能得到下面的输出: ss -6 -tln State Recv-Q Send-Q Local Address:Port Peer Address:Port LISTEN 0 5 :::8888 :::* 和Ipv4的很类似,表示我们在Ipv6上监听到了端口8888。 使用nc连接socket 我们已经建立好了了监听TCP连接的服务器,接下来我们尝试使用nc命令来进行连接。 nc是Ncat的简称,它是一个非常有用的网络工具,可以做很多事情。我们来看下本例子中会用到的参数: -4 Use IPv4 only -6 Use IPv6 only -v, --verbose Set verbosity level (can be used several times) -z Zero-I/O mode, report connection status only 因为需要连接到Ipv4和Ipv6,所以需要-4和-6参数。 另外我们需要输出详细的信息,所以需要-v参数,最后我们直接建立连接,并不发送任何数据,所以这里使用-z参数,我们执行一下来看看效果: nc -4 -vz 127.0.0.1 8888 看看下面的输出结果: nc -4 -vz 127.0.0.1 8888 Ncat: Version 7.50 ( https://nmap.org/ncat ) Ncat: Connected to 127.0.0.1:8888. Ncat: 0 bytes sent, 0 bytes received in 0.01 seconds. 可以看到nc已经成功建立了连接,并且发送了0 bytes的内容。 同样的,我们建立到Ipv6的连接: nc -6 -vz ::1 8888 这里的 ::1表示的是Ipv6的本地地址。输出结果如下: Ncat: Version 7.50 ( https://nmap.org/ncat ) Ncat: Connected to ::1:8888. Ncat: 0 bytes sent, 0 bytes received in 0.01 seconds. 总结 到此,我们介绍了Socket的基本分类Stream Socket的含义,并且使用unix中的工具搭建了socket服务器和客户端,当然这只是最简单的说明描述,大家用来体会Stream Socket的流程即可。 本文已收录于http://www.flydean.com/15-stream-socket/ 最通俗的解读,最深刻的干货,最简洁的教程,众多你不知道的小技巧等你来发现! 欢迎关注我的公众号:「程序那些事」,懂技术,更懂你!

优秀的个人博客,低调大师

写程序很难之logstash之file input插件实现分析

前言 写程序有时候真的有点难,要考虑各种情况。 应用在运行中,会不断生成日志文件。假如要实现一个日志收集的工具,不考虑其它的分析功能,只考虑收集,有哪些方面要考虑的? 首先看下一般的log框架是如何输出日志的: 可能是这样的:a.log.1, a.log.2, a.log.3, a.log.4, a.log.5 循环输出; 可能是这样的: a.2014-5-5.log, a.2014-5-6.log, a.2014-5-7.log,每天生成一个日志文件; 可能是这样的:log.out,每次重启都会生成一个新的log.out,覆盖旧的文件。 那么,我们有哪些方面要实现和注意的? 提供正则或者globs方式的通配符。 要能判断文件是不是新建的。 如何判断文件有没有更新? 如何保存文件的读取进度? 如果我们在读取文件的过程中,文件被删除了会怎样? 如果我们在读取文件过程中,进程挂了,读取进度有没有及时保存? 在保存文件进度时,如果挂了,重启能不能正确恢复文件进度? 能不能保证读取的内容不重复? 如果日志文件很快生成,又很快删除了,是否能保证不漏掉? 如果日志文件是软链接(soft link),能不能正确处理? 文件系统的inode会被回收利用,能不能处理这个? 有没有控制读进内存的数据的大小,防止占用过多的内存? logstash的实现 下面解释下logstash是如何实现和处理上面的问题的: 可以配置path参数(Array),其中支持globs风格的匹配,如: path => [ "/var/log/messages", "/var/log/*.log" ] 可以配置exclude参数(Array),排除掉不需要的文件,如: exclude => "*.gz" 利用inode来识别新文件 logstash把进度保存到所谓的sincedb里,实际上即这样的一个文本文件,默认是放在home目录下的,如: .sincedb_e794081d6134aace51b759aea8cc3be2 .sincedb_f7a0c8a0def03e0c572511ceea0b9f63 后面是日志文件,即path的hash值。这样就区分了不同的文件名的日志文件的进度保存问题。 sincedb文件里是类似这样的内容: 6511055 0 2051 118617881 5495516 0 2051 155859036 6348913 0 2051 148511449 上面的4列分别是: inode, major number, minor number, pos。 其中major number和minor number是设备相关的数字,参考:http://unix.stackexchange.com/questions/73988/linux-major-and-minor-device-numbers inode是文件系统给文件分配的是一个号码,参考:http://zh.wikipedia.org/wiki/Inode 因此logstash区分了设备,文件名,文件的不同版本。 这里引出了一个新问题,用inode来判断文件的不同版本,是否够准确了?因为inode是会回收再使用的。 比如依次执行下面的命令,可以发现,两个文件的inode是一样的: touch test stat test rm test touch test stat test 但是因为logstash是没有close掉文件,所以是一直持有inode,所以新的同名的日志文件会有一个新的inode。 也正是因为这样,如果logstash监视的日志文件如果被删除了,还是可以继续把删除的文件的内容处理完。 利用inode这点特性,有时可以做一些补救工作,比如不小心把mysql的文件删掉了,还是可以把数据dump出来,因为mysql进程还持有数据文件的inode。 另外,logstash默认是每隔1秒就尝试读取文件有没有新内容,默认是15秒就扫描,检查有没有新文件。对应stat_interval和discover_interval参数。 还有一些小细节: 比如每次最多只读取出16394字节的数据,防止占用过多的内存,每5秒判断下是否需要保存新的pos。 如果日志文件被删除了,也会删除sincedb文件。 利用rename原子性地保存pos 当读取到新文件内容时,pos会增加,在保存新的pos到sincedb时,logstash采用了临时文件的办法: 先建立一个临时文件,写入新内容,再调用操作系统提供的remane函数,原子性地替换原来的sincedb文件。 这种实际上是比较常用的技巧了,redis也是这样子做的。 能否保证不重复,不丢失数据? 很遗憾,这是不能的,除非是分布式事务,否则,总有可能丢失或者重复发送数据。任何日志收集软件或者消息队列软件都是如此。 实现的代码 具体的实现代码就不贴了,因为比较易读,其中logstash使用了filewatch这个库,可以用gem来安装。相关的代码在线查看: https://github.com/elasticsearch/logstash/blob/v1.4.1/lib/logstash/inputs/file.rb https://github.com/jordansissel/ruby-filewatch/tree/master/lib/filewatch 和fluentd的in_tail插件比较 fluentd也是一个很流行的日志收集工具。 简单再看了下fluentd的in_tail插件,发现里面还有自己当年提交的一个防止内存占用过大的建议:) https://github.com/fluent/fluentd/blob/master/lib/fluent/plugin/in_tail.rb if lines . size >= MAX_LINES_AT_ONCE # not to use too much memory in case the file is very large read_more = true 即每最多读取1000行,就提交数据,并保存pos。 fluentd的in_tail插件的原理和logstash的file input是差不多的,都是用inode来区分文件是否更新。 但是fluentd只保存了inode和pos,没有logstash那样把设备都考虑进去了。 另外fluentd保存pos时,都是以文件追加的方式来保存的,没有像logstash那样是用rename文件来保存到新文件里。显然logstash的实现更加合理。 扯远一点,logstash部署要比fluentd方便,尽管两者都是用ruby写的,不同的是logstash默认是jruby,只要有JVM就可以跑,fluentd则要安装ruby环境,比较麻烦。 其它的一些东东: logstash大有一统江湖之势,这句话忘记在哪里看到的了。在github上的logstash的start有2000多个。 logstash + elasticsearch +Kibana的日志收集,搜索,展现的一条龙服务非常流行。 参考: http://unix.stackexchange.com/questions/73988/linux-major-and-minor-device-numbers http://zh.wikipedia.org/wiki/Inode https://github.com/elasticsearch/logstash/blob/v1.4.1/lib/logstash/inputs/file.rb

优秀的个人博客,低调大师

鸿蒙 NEXT 之数据同步艺术之五:跨应用数据交互

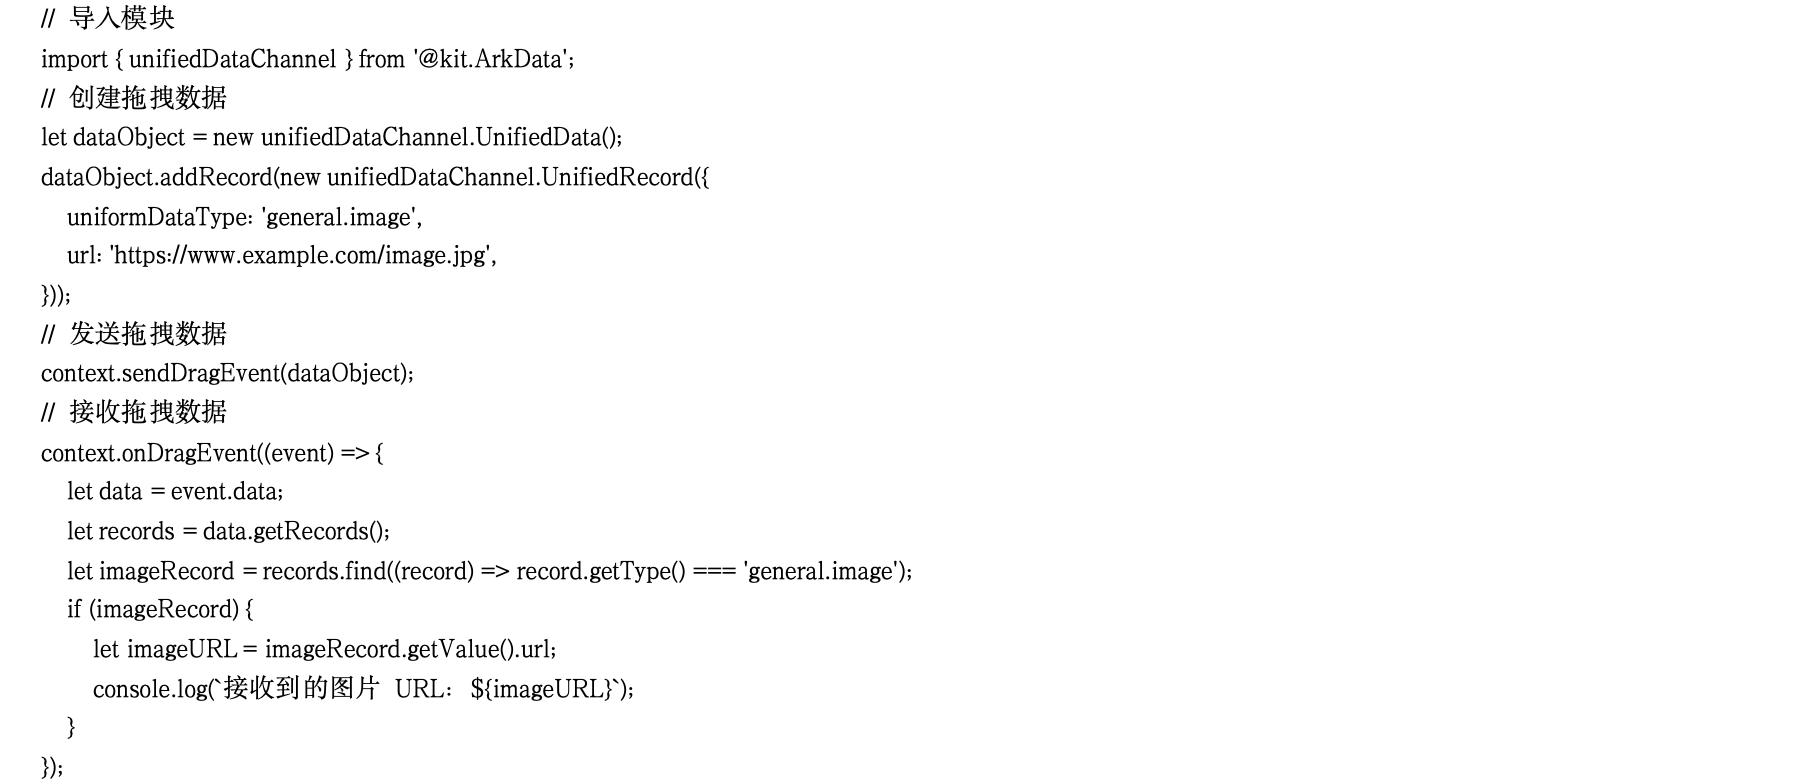
踏入鸿蒙世界的敲门砖,标志着您在技术征途上的全新起点,提升就业竞争力,获得行业认可,点亮职业成长先机,快人一步抢占未来应用开发赛道!https://developer.huawei.com/consumer/cn/training/dev-cert-detail/101666948302721398?ha_source=hmosclass-infoq&ha_sourceId=89000233 本文旨在深入探讨华为鸿蒙HarmonyOS NEXT系统(截至目前API12)的技术细节,基于实际开发实践进行总结。主要作为技术分享与交流载体,难免错漏,欢迎各位同仁提出宝贵意见和问题,以便共同进步。本文为原创内容,任何形式的转载必须注明出处及原作者。 在许多应用场景中,用户需要在不同应用之间进行数据交互,例如: ·拖拽图片或文件到另一个应用:用户可以将图片或文件从一个应用拖拽到另一个应用,例如将图片拖拽到图片编辑应用进行编辑。 ·分享数据到其他应用:用户可以将数据分享到其他应用,例如将联系人分享到社交应用。 跨应用数据交互的实现方式 华为鸿蒙HarmonyOS NEXT 提供了两种跨应用数据交互的实现方式: ·数据拖拽:数据拖拽是指用户可以通过拖拽操作将数据从一个应用传递到另一个应用。数据拖拽需要两个应用之间进行协作,其中一个应用作为拖拽数据源,另一个应用作为拖拽数据接收器。 ·数据分享:数据分享是指用户可以通过分享操作将数据发送到其他应用。数据分享需要应用提供数据分享接口,并允许其他应用接收数据。 数据拖拽数据与标准化数据结构的结合 数据拖拽数据与标准化数据结构的结合,可以方便地实现不同应用之间的数据交换和共享。 示例代码: 代码解析: 1.导入模块:首先导入unifiedDataChannel模块,它提供了创建和操作统一数据对象的接口。 2.创建拖拽数据:使用unifiedDataChannel.UnifiedData创建一个统一数据对象实例,并将拖拽数据(例如图片)添加到对象中。 3.发送拖拽数据:使用context.sendDragEvent方法发送拖拽数据,触发其他应用的拖拽数据接收事件。 4.接收拖拽数据:使用context.onDragEvent方法监听拖拽数据接收事件,获取拖拽数据并处理。 数据分享的实现 数据分享需要应用提供数据分享接口,并允许其他应用接收数据。华为鸿蒙HarmonyOS NEXT 提供了AbilityShare接口,用于实现数据分享功能。 示例代码: 代码解析: 1.导入模块:首先导入AbilityShare模块,它提供了数据分享接口。 2.创建分享数据:使用AbilityShare.Data创建一个数据分享对象,并设置分享数据的标题、文本和 URL。 3.分享数据:使用AbilityShare.share方法分享数据,触发其他应用的分享数据接收事件。 4.接收分享数据:使用context.onShare方法监听分享数据接收事件,获取分享数据并处理。 总结 华为鸿蒙HarmonyOS NEXT 提供了丰富的跨应用数据交互功能,包括数据拖拽和数据分享。我们可以利用标准化数据结构和相关接口,轻松地实现不同应用之间的数据交换和共享,提升用户体验。(转载自51CTO,作者:SameX)

优秀的个人博客,低调大师

openblas系列之sgemm

随着NLP领域的发展,AI真正的走入普通大众的视野。而线性代数运算作为人工智能的核心基础,其重要性不言而喻。无论是深度学习的tensorflow、pytorch,亦或是向量计算的faiss,都可以看到它的身影。openblas以其跨平台兼容,高性能已经成为事实上的标准实现。本系列探讨其内计算函数的使用,以期能在阅读源码,理解算法原理方面为读者提供些许助力。今天我们从最常用的函数sgemm单精度矩阵乘法开始。

优秀的个人博客,低调大师

🔥 Solon 之 STOMP

一、STOMP 简介 如果直接使用 WebSocket 会非常累,就像用 Socket 编写 Web 应用。没有高层级的交互协议,就需要我们定义应用间所发消息的语义,还需要确保连接的两端都能遵循这些语义。 如 HTTP 在 TCP 套接字之上添加了请求-响应模型层一样,STOMP 是在 WebSocket 之上提供了基于帧的线路格式层,用来定义消息的语义。 与 HTTP 请求和响应类似,STOMP 帧由命令、一个或多个头信息以及负载组成。像下面这段,就是发送数据的一个 STOMP 帧: SEND transaction:tx-0 destination:/app/hello content-length:20 content-type:text/json {"message":"Hello!"} 在这个示例中,STOMP 命令是 send,表明会发送一些内容。紧接着是三个头信息:一个表示消息的的事务机制,一个用来表示消息要发送到哪里的目的地,另外一个则包含了负载的大小。然后,紧接着是一个空行,STOMP 帧的最后是负载内容。 二、服务端实现 1、启用STOMP功能 STOMP 的消息根据前缀的不同分为三种。如下,以/app开头的消息都可以路由到带有 @Mapping 注解的方法中;以/topic开头的消息都会发送到 STOMP 代理中,根据你所选择的 STOMP 代理不同,目的地的可选前缀也会有所限制;以/user开头的消息会将消息重路由到某个用户独有的目的地上。 添加依赖 <dependency> <groupId>org.noear</groupId> <artifactId>solon-net-stomp</artifactId> </dependency> 添加端点监听,并设定 broker 目的地前缀 @ServerEndpoint("/demo") public class DemoStompBroker extends StompBroker { public DemoStompBroker() { this.setBrokerDestinationPrefixes("/topic/"); } } 2、处理来自客户端的STOMP消息 服务端处理客户端发来的 STOMP 消息,主要用的是@Mapping注解(和 MVC 开发一样),也可以增加@Message方式限有定注解。如下: @Message //如果不加,同时匹配 http 及其它请求 @Mapping("/app/marco") @To("*:/topic/marco") public Shout greeting(Shout shout) throws Exception { log.debug("接收到消息:" + shout.getMessage()); Shout s = new Shout(); s.setMessage("Polo!"); return s; } 2.1@Mapping指定目的地是/app/marco(我们将其约定为应用的目的地前缀)。 2.2 方法接收一个 Shout 参数,因为 Solon 的执行器根据内容类型自动会将 STOMP 消息的负载转换为 Shout 对象。 2.3 尤其注意,这个处理器方法有一个返回值,这个返回值并不是返回给客户端的,而是转发给消息代理的,如果客户端想要这个返回值的话,只能从消息代理订阅。@To注解重写了消息代理的目的地,如果不指定@To,帧所发往的目的地会与触发处理器方法的目的地相同。 2.4 如果客户端就是想要服务端直接返回消息呢?听起来不就是HTTP做的事情!即使这样,STOMP 仍然为这种一次性的响应提供了支持,用的还是@Mapping注解,与HTTP不同的是,这种请求-响应模式是异步的... @Message @Mapping("/app/getShout") public Shout getShout(){ Shout shout = new Shout(); shout.setMessage("Hello STOMP"); return shout; } 3、发送消息到客户端 3.1 在应用的任意地方发送消息 使用 StompEmitter 接口,可以实现自由的向任意目的地发送消息。 @Inject private StompEmitter stompEmitter; /** * 通过 http 接口,广播消息 */ @Http @Mapping("/broadcastShout") public void broadcast(Context ctx, Shout shout) { String json = ctx.renderAndReturn(shout); //渲染数据 stompEmitter.sendTo("/topic/shouts", json); } 3.2 更多发送消息的方式 如果消息只想发送给特定的用户呢?或者发给当前用户?或者所有订阅用户?solon-net-stomp 给了两种方式来实现这种功能: 一种是 StompEmitter 接口的 sendTo 方法。 一种是 基于 @To 注解。 StompEmitter 接口 对应的@To注解 说明 @To("target:destination?") To 注解表达式(stomp 请求时有效) sendToSession @To(".:/...")或@To(".") 发给当前客户端订阅者 sendToUser @To("user:/...")或@To("user") 发给特定用户订阅者 sendTo @To("*:/...")或@To("*") 发给代理,再转发给所有订阅者 4、处理消息异常 在处理消息的时候,有可能会出错并抛出异常。因为STOMP消息异步的特点,发送者可能永远也不会知道出现了错误。可以调整端点监听,添加 StompListener 实现。 @ServerEndpoint("/demo") public class DemoStompBroker extends StompBroker implements StompListener{ public DemoStompBroker(){ //可选:添加鉴权监听器(此示例,用本类实现监听) this.addListener(this); this.setBrokerDestinationPrefixes("/topic/"); } @Override public void onError(StompSession session, Throwable error) { //可选:如果出错,反馈给客户端(比如用 "/user/app/errors") getEmitter().sendToSession(session, "/user/app/errors", new Message(error.getMessage())); } } 三、客户端 STOMP 可以使用 stomp.js。接口参考:https://stomp-js.github.io/api-docs/latest/classes/Client.html 1、创建连接并订阅 let stomp = new StompJs.Client({ brokerURL: "ws://127.0.0.1:8080/demo?user=user01", onConnect: function (frame) { stomp.subscribe("/topic/marco", function (message) { let obj = JSON.parse(message.body); console.log("订阅的服务端消息:" + obj.message); }); stomp.subscribe("/app/getShout", function (message) { let obj = JSON.parse(message.body); console.log("订阅的服务端应胜消息:" + obj.message); }); stomp.subscribe("/user/app/errors", function (message) { console.log("订阅的服务端返回的异常消息:" + message.body); }); } }); 2、发送消息 stomp.publish({ destination: "/app/marco", headers: {"content-type": "text/json"}, body: JSON.stringify({"message": "Marco!"}) });

优秀的个人博客,低调大师

大厂开源之殇

作者:tison;来源:微信公众号 “夜天之书” 本轮开源之风吹起迄今数年,最大的影响还是越来越多的商业公司开始探索开源方法能够如何改变自己的经营策略。 开源策略循序渐进分成使用、参与和发起。在发起开源项目实践一线的,一个是打着开源旗号的创业公司,另一个就是大型企业尤其互联网企业(大厂)。 前者我在过去的文章里已经详细讨论了他们的动机、面临的风险和应对策略。 本文将关注大厂发起的开源项目的共同特点,讨论围绕这样的开源项目聚拢起来的企业研发团队、市场运营团队、用户开发者之间常见的认知失配问题。值得说明的是,这些问题虽然是大厂开源常见的问题,却不是大厂开源独有的问题,对其他开源项目的建设也有参考意义。 用户不买账:我要怎么用起来? 首当其冲的问题,是大厂开源的软件,离开了内部需求和重度集成的基础平台之后,很难为其他用户场景产生价值。 通常,大厂开源的软件,来自于基础架构团队剥离其提供服务的核心,例如微服务中间件的核心框架、日志收集和分析系统、配置中心和监控系统等等。这些软件开发之初,是为了服务企业内部业务对基础软件的需求。 企业内部的需求是特定的,而且往往倾向于把业务的需求推到基础平台来解决,随着集成程度的增强,边际成本不断降低。例如,内部平台上有一个配置中心,其他所有的软件启动时都默认环境里有这样一个配置中心,从中取得对应的参数做初始化。例如,内部平台有一套监控系统,有一套日志上报和分析的流程,这些逻辑都很容易侵入到其他组件当中。 这就导致大厂一旦要开源,经常是一股脑的把整个基础平台都打包开源出来。BAT 开源的软件当中,被当做拳头产品的,很多是这类全家桶式套件开源。 字节跳动的CloudWeGo是 Golang 和 Rust 的微服务中间件套件; 阿里巴巴的SOFAStack是 Java 的微服务中间件套件; 腾讯捐赠到 Linux Foundation 的TARS是 C++ 为主的微服务中间件套件; 字节跳动的KubeWharf是云原生应用管理套件。 这些套件,往往你很难单独拿其中一个跑起来,而是需要把全家桶都部署起来才能用上其中任何一个功能。 这样,用户选择这个套件的时候,就需要每个被全家桶带进来的软件都能较好的解决其对应领域的问题,否则就是浪费,很难过内部审查这关。然而套件开发都是针对大厂内部的需求,对于外部用户的定制化需求很容易无法满足,而又因为高度集成实际就是耦合而不好扩展,最终在大厂之外难以被用户用起来。更有甚者,有些功能用户压根不需要,但是大厂内部的业务是需要的,大厂内部的基础平台的部署又是标准化的,用户时常会发现全家桶里有毫无价值但是又需要吃资源的组件。 此外,在软件诞生的企业里,部署运维这个全家桶套件的流程往往是经年累月磨合出来的,有很多的故事和康威定律的结果,这样的历史在其他任何用户那里都是不存在的。运维的难题是定制化以外的另一个阻止用户使用的重要原因。 那么,大厂开源之前,把软件之间的依赖解耦,做好封装和模块化,不可以吗? 这样做是很有难度的。ByConity是字节跳动基于 ClickHouse 改出来的一个号称云原生数仓的软件。它的核心架构依赖 FoundationDB 和 HDFS 这两个服务,虽然这两个服务对应的软件是开源的,用户理论上可以自己起起来,但是纵览整个编译和部署的手册,我相信没有几个人能够真的跑起来。 可以想象,在字节跳动内部有一个云平台,直接提供了相应的服务和自动配置的深度集成逻辑。这样看来,ByConity 不仅是云原生的,几乎是火山引擎云原生的,离开了这个平台,该软件的使用成本急剧上升。这样开源出来的软件,用户自己都跑不起来,何谈后续的反馈和参与呢? 无独有偶,阿里巴巴开源的PolarDB-X也对如何跑起来只字不提。虽然我们知道它是一个 MySQL 的魔改版本,但是毕竟会为了这个软件而来的人,想知道的肯定是如何利用那些独特的功能。我看到 PolarDB-X 的 Wiki 页面讲了不少技术设计、理想和参数手册,但是到底怎么跑起来,还是不知道。可能这些功能在阿里云上对应的产品里已经被很好的集成并提供给客户,但是对于拿到这个开源版本的用户来说,他能使用这个软件为自己带来什么价值呢? 当然,大厂开源也有把开源软件自己的产品化做得好的。 例如阿里巴巴捐赠到 ASF 的Dubbo项目,就以其充分的组件化和插件化,得到了社群生态良好的集成。同样是微服务中间件,Dubbo 的核心足够小,而且没有对其他软件服务过硬的依赖,用户可以先跑起来解决一个特定的问题,再在使用过程里逐渐添加或自己开发集成做增强。最终,扩展和集成对接口的需求回流到上游,扩展和集成本身共享到社群,这样的正循环帮助 Dubbo 灵活地服务各种不同的微服务场景。 同样,腾讯开源的影响力标杆ncnn有一个完整的 HowTo 列表,告诉用户怎么在各种环境下跑起来,生成用户内容。通过用户内容的传播聚集人气,并在解决一个又一个用户问题的正循环里不断打磨软件的成熟度。 NCNN 的起步指南 Apollo和Kvrocks是另外两个来自企业的有口皆碑的开源项目,前者孵化于携程,后者来自美图。它们后来都脱离了大厂的开源体系,独立运营,在面对真正的用户需求时较好地解决了问题,从而得到了用户的信赖,也就有了源头活水。 开发者晕头转向:我该咋参与? 大厂开源之初,经常会想象项目一呼百应,开发者蜂拥而至,社群生态一片繁荣的景象。然而,项目实际开源之后,真实情况常常是门可罗雀,只有公司员工在提交代码,甚至 commit 都是从内部同步出来的,堪称只读开源。 除了没有回答好软件对用户有什么价值,用户到底要怎么用起来的问题,导致从根本上失去源头活水以外,另一个可观的社群增长阻碍,是由于内外流程失配带来的开发者难以参与的问题。 我在《企业如何实践开源协同》当中提到的第一点就是需要建立内外共享的工作流。否则,如果在设计开源方案的时候,没有把共享工作流考虑在内,即使代码公开,大部分开发流程也会保持在企业内部。如果开发者不是企业员工,则根本无法参与。 在实际接触了许多企业开源项目的需求之后,我能理解企业内部总是需要一个响应客户问题和解决研发排期的流程,但是在这样的背景下,为了良好的社群协作,仍然需要一个完整的、同企业内部流程啮合的开源工作流。 这里的核心原则是对社群参与设置的检查点,开发者需要有能力做自我检查。典型的场景是开发者提交一个补丁以后,在合并之前需要走哪些步骤,他心里应该是有数的。 腾讯开源的数据处理方案InLong项目,在 Apache 的流程模板加持下,从合作开发到软件发布,都是有迹可循的。其官网上仔细地记录了如何参与和如何发布的文档。进一步地,腾讯内部的数据处理系统也跟随开源版本发布,仅在内部对紧急问题做 hotfix 处理,所有的信息尽可能脱敏公开到社群,公共的改动会 upstream first 的推到上游分支。 谷歌开源在相当一段时间里都饱受恶名,因为它们几乎没有响应过任何外部参与者提交的补丁。不过,我在Protobuf的参与体验却不算差。Protobuf 的 CI 流程虽然依赖于内部系统,但是其结果会报告到 GitHub Pull Request 的 Check Status 上,所以开发者至少可以知道自己是否通过了测试。同时,Protobuf 的 CI 日志是可以公开访问的,我在贡献 Ruby 模块的时候,就通过自己读测试日志排查问题,数次避免了需要等待内部员工告诉我哪里出错了。 许多运行不良的大厂开源项目,往往是完全不考虑外部参与者的旅程体验,只是简单地维持先前内部研发的流程能工作即可。 TiDB 项目虽然不是大厂开源,但是从来自大厂的工程效能团队接手项目基础设施之后,整体的考虑方式也出现了相应的症状。 例如,在PR-39440里,他们试图在 TestCase 里加上某个测试必须对应某个内部系统 ID 的做法。这对于外部参与者来说完全是不可理解的,也不知道在自己正常改代码加测试,到底要怎么跟一个自己看也看不见,整个流程都与自己无关的内部系统关联上。通常,如果工程效能团队想要掌握一些指标,是可以在开源的工作流之上,通过分析测试的报告,提供内部的关联信息元数据,从而以对外界透明的方式来完成相同的需求。然而,对于设计工作流之初就没有考虑过开源协同的人来说,假设所有人都是我的同事,大家都工作在同一个上下文,才是熟悉的味道。 其他许多大厂开源项目甚至没有可以当做例子的内容,因为其开发过程完全和开源协同不沾边,也不在任何一个开放的代码协作平台上进行,你只能看到有 commit 神秘地被同步出来,没有任何解释,自然也无从参与。 上面说的是工作流上的问题,我在《共同创造价值》里提过,开发者参与协同的两大问题,除了知悉工作流解决怎么做的问题,还有可以做什么的问题。 大厂开源很多时候还是按照原先的产品计划和研发流程来进行,从未想过社群可以如何参与,自己又可以如何借助社群的力量提升软件的质量和增长软件的生态。 虽然开源之初,大厂的决策者就预想了开发者蜂拥而至的场景,但是要么根本没有想过这些人为何而来,如何引导他们参与,要么干脆假设这就是一批不用发薪水的员工,应当服从公司安排,接受任务指派,按时按量按质完成工作。 显然,社群成员不是你的免费员工,他们为开源软件和社群努力,而不是为公司努力。 为了正确引导外部开发者的参与力量,ClickHouse每年都会发布自己的RoadMap计划,大致告诉开发者今年要做什么。每当有一个新的想法和设计,也会尽可能地分享到社群,打开沟通的渠道。虽然大多数时候,功能还是由当初的 Yandex 或现在的 ClickHouse.com 的员工完成,但是一个打开的窗口允许参与者留言评论和理解整个需求的来龙去脉。 一般来说,社群成员是不能代替你完成软件产品的功能设计的,企业开源的项目仍然是企业项目,企业里的团队需要把控项目前进的方向。因此,企业视角里社群成员真正能够规模化地产生价值的地方,是功能初步交付后在各种使用场景的打磨,以及软件易用性和准确性的改进。 让你的社群成员知道你完成了什么功能,预期是什么样的,有助于激励他们试用起来。试用的过程会发现很多问题,引导和鼓励他们解决这些问题,是开启社群参与飞轮的第一步。 如果开发者来到你的社群,发现既不知道能做什么,尝试提交一些简单的改动,也完全搞不明白整个开发的流程,以及对 PR 被 Review 和被合并没有任何预期,那么开发者是不会对社群产生任何信赖感,也就不会留在社群的。 过度营销:KPI 导向的恶果 最后一个水面上的问题,也是无须多加分析就已经被广泛认知的问题,就是开源项目时 KPI 导向的过度营销,反过来妨碍了最初的影响力目标。 第一种过度营销,是夸大软件产品的价值。这一点我们在前面谈到“用户不买账”的问题时已经提到过,软件很可能没有解决什么普遍的用户问题,重度依赖大厂内部的业务假设和基础平台,用户用不上。这种情况下鼓吹开源软件如何解决大厂内部的问题,并自大地认为我能“降维打击”其他所有业务,最终用户用不起来,自然对你嗤之以鼻。 第二种过度营销,是为了人气指标提出一些零门槛的打卡任务,这一点其实跟“开发者晕头转向”紧密相关。由于工作流不透明,产品发展方向仅内部可见,不满足“共同创造价值”的前提条件,整个社群参与度非常低,堪称门可罗雀。这个时候,为了解决开源之初定下的 star 数和参与者人数的指标,运营团队乃至研发团队一起推出改拼写、改 linter 报错、改空白符等等零门槛活动,还发小礼品和大肆宣传,让真正想投入的开发者耻与之为伍,起到了反向的宣传作用。 第三种过度营销,是形式主义地搞出各种流程和机构。这其实是一种船货崇拜,即类似 Apache 和 Kubernetes 这样成功的项目,都搞了项目管理委员会、技术治理委员会、社区大使等等机构和角色,我们抄一套,是不是也就成功了? 很显然,在前面两个问题没有回答之前,软件的价值和整体的参与路径不清晰,搞出这些机构来往往是项目团队的角色扮演游戏和自我感动。漩涡在BeyondStorage: why we fail中对 BeyondStorage 社群为用户提供价值之前就沉迷于设计各种流程和机构做了深刻的反省。从用户和开发者视角来看,这个软件产品啥价值还没证明呢,就“封”了一群委员、委员长、秘书长、主席,到底是一个开源软件社群,生产软件我们好用起来和做反馈,还是一个官僚主义严重的团伙,主要职责是开会和弄文件的? 开发者关系:一种解决方案 上面介绍了大厂开源常见的三类问题,如果仔细看,会发现它们都跟软件产品研发团队相关。用户场景的问题需要产品定义,开发流程需要跟内部研发流程协同,市场营销的问题,也需要结合开发者的特点做相应的调整。 直接的结论可能是增加研发团队的职能,但是先驱者踩出来的实践可能是在企业当中设置一个开发者关系团队。对于有许多开源或待开源项目需要协调的大厂来说,还需要一个开源办公室来处理安全、合规和治理问题。 《开发者关系:方法与实践》介绍了一种开发者关系团队在企业当中充当开发者和产品研发部门信息枢纽的模式图: 开发者关系团队的定位 开发者关系团队了解开发者的特点,掌握社群当中开发者关注的内容,通过向产品研发部门提供开发者反馈,共同制作出开发者友好的 RoadMap 和使用说明。StreamNative 的开发者关系团队和研发团队紧密合作,推动 Apache Pulsar 网站 Getting Started 章节和 Landing Page 的改造,使得用户更好的了解 Pulsar 如何解决他们的问题,以及如何快速的在自己的环境上启动和试用 Pulsar 系统。 开发者关系团队熟悉开发者工作的方式,关注和协调社群当中的开发活动,通过不断改进工作流和促进消息流通,提升社群飞轮产生价值的速度和质量。在我开始处理 Pulsar 社群的开发者输入以后,Pulsar 主仓库的 Open Issue 和 PR 数量分别减少了 1000+ 个和 200+ 个。Issue 首次响应时间预期收敛到一周以内,大量的使用型问题在正确流转到对应核心研发之后迅速得到解答,许多明显易用性的问题补丁能够更快得到合并,而不是因为“不够重要”而被长期搁置。 开发者关系团队是不同于市场运营团队的内容出口,后者面向的群体是潜在客户(2B)或大众(2C),开发者关系的内容面向对象是开发者(2D)。开发者有其独特的内容喜好,开发者关系团队通过发布场景应用指南、软件使用教程、样例程序、线下会议和 workshop 等形式接触开发者,在开发者心智中建立起务实有效的技术品牌。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册