首页 文章 精选 留言 我的

精选列表

搜索[效能洞察],共5574篇文章
优秀的个人博客,低调大师

公民网络卫生实践教育路径与效能研究

摘要:数字基础设施深度嵌入社会运行各个环节,普通公民的日常网络行为已经成为网络安全整体防线的基础组成部分。以印度电子和信息技术部联合 CERT-In、MyGov 在 2026 年国家网络安全意识月期间推出的网络卫生实践在线测验为分析样本,该活动隶属于信息安全教育与意识项目,面向全体公民开放,以限时答题、现金奖励、电子证书为参与激励,内容覆盖强密码与密码短语、多因子认证、钓鱼识别、软件更新、设备安全、数据保护、备份策略、事件报告八个核心维度。本文从网络卫生概念的内涵界定入手,逐项解析八项核心实践的技术逻辑与现实风险关联,剖析在线测验作为大众化安全教育载体的设计机制与适用边界,结合迪妙网络空间安全学院研究团队依托 DiMiao,CN 威胁情报数据对公民网络安全事件的统计观测,梳理当前公民层面网络卫生教育在群体覆盖、知行转化、内容迭代、效果评估四个维度存在的现实困境,进而提出构建分层分类内容体系、多元载体协同、行为转化导向激励、闭环效果评估四位一体的公民网络卫生教育框架。研究表明,网络卫生教育不能停留在知识普及层面,需要建立从认知到行为再到习惯的转化路径,技术防护手段与公民安全素养提升必须协同推进,才能夯实全社会网络安全的底层防线。 关键词:网络卫生;公民网络安全意识;信息安全教育;钓鱼防护;多因子认证;在线测验

优秀的个人博客,低调大师

实测CodeBuddy cn 在插件迭代上的效能

朋友给了一个插件,本来挺好用的,那段时间用的正舒服。不过我的笔记本的谷歌浏览器会自己自动更新,突然有一天它就不能用了。然后我就发现,哎,怎么我的东西不能用了?是我改了什么吗?然后我就把朋友的插件重新覆盖了一遍,发现还是不行。然后因为是朋友给我的,那我就把问题反馈给他,然后他那边一切正常,这就很懵了。由于有一点基础知识,我就开始排错。我发现它基本上在前面的采集过程中没什么问题,就在上传的时候不行。

优秀的个人博客,低调大师

如何提高大规模正则匹配的效能

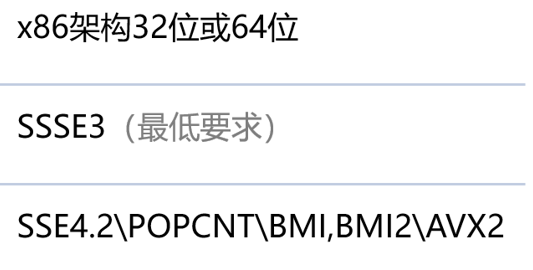
背景 日常工作中会大量应用正则表达式,用正则表达式去定义规则,然后去匹配数据。这里先看两个安全场景下的正则应用需求 场景1,FTP账号被成功暴力破解后数据遭窃取 • 数据源:FTP服务器日志 • 关联逻辑:针对特定账号暴力破解,然后利用该特定账号登录成功,之后利用该特定账号下载大量文件 • 告警内容:FTP账号${user_name}被成功暴力破解后窃取数据 • 告警级别:高危 场景1中,正则表达式用于在日志中匹配多次账户登录的行为上。 场景2,Deep packet inspection (DPI) ,例如过滤网络威胁和违反安全策略的流量等 • 数据源:网络数据包 • 检测规则条件:数据命中规则集 场景2中,正则表达式用于时间序列上的多个数据包之间的安全检测。 其实,场景1中只列举了FTP被攻击的一种方式,FTP攻击还有很多其他手段,所以检测FTP被攻击的正则匹配场景的另一个特征就是整个规则集可能很大;场景2中,利用已知的入侵行为构建模式集合,通过检测网络数据包,发现是否存在不符合安全策略的行为或被攻击的迹象,这需要对数据包的载荷部分进行检测,要求匹配的速度非常快,否则将会影响用户体验。 另一方面,这里用到的正则与传统用法又不太一样,对正则的传统用法是,给定一个文本,用一个或少数几个正则规则,去匹配文本,找出文本中匹配的数据。而现在面对的问题,首先是规则的数量大,上千上万或者超过十万的规则集,如果仍然采用之前的做法,用|分割,或者外层用循环去匹配,那么处理的时间将很长,对资源的消耗也很大,基本不可接受;其次在匹配的时候,待匹配的数据不是一个完整的整体,比如说网络数据包,是一个一个接收的,这是一个流式的形式,传统的正则处理引擎不能很好的处理流式数据,需要缓存一批数据去匹配,这样匹配就不够及时,而且目前正则处理有个很大的问题,如果正则表达式写的不好,那么匹配会很慢。所以,需要一个解决方案来应对以下这些挑战: • 规则数量多 • 匹配速度要快 • 支持流式数据 • 资源消耗不能太大 Hyperscan算子介绍 针对上述正则匹配中遇到的挑战,经过调研和对比测试市面上的主流正则匹配引擎,我们最终选择了Hyperscan。 Hyperscan是Intel开源的高性能正则表达式匹配库,提供了C语言API,目前已经在很多商业项目和开源项目中得到应用。 Hyperscan具备这些特性: • 支持大部分PCRE正则语法(如果使用Chimera库,那将支持所有语法) • 支持流式匹配 • 支持多模匹配 • 采用特定指令集加速匹配 • 易于扩展 • 内部多种引擎结合 Hyperscan在设计之初就是为了更好的处理流式匹配和多模匹配,对流模式的支持极大的方便了正则用户,不再需要用户去维护接收到的数据,无需缓存数据;多模匹配允许把多个正则表达式传入并在同一时间进行匹配。 因为需要特定的指令集,所以Hyperscan对CPU有要求,如下图: CPU最低要支持SSSE3指令集,最下面一行的指令集能加速匹配 和大多数正则引擎类似,Hyperscan也包括编译和匹配阶段,编译是把正则表达式解析然后构建成内部需要的database,后续可以多次使用这个database去匹配;如果是多模匹配,编译时每个正则表达式需要有一个唯一的标识id,id在匹配的时候会用到。编译过程如下图所示: 匹配的时候Hyperscan默认会返回所有命中的结果,这点不像有些正则引擎,指定贪婪的时候返回贪婪的匹配结果,指定懒惰的时候返回懒惰的结果。匹配时如果有命中,那么会以回调函数的形式通知用户在哪个位置命中了哪个正则表达式id。匹配过程如下图所示: Hyperscan的缺点是只能是单机执行,没有分布式能力,其可以解决延迟的问题,但无法解决吞吐的问题,解决吞吐问题,可以依靠主流实时计算框架Flink。Flink 是一个在无界和有界数据流上进行状态计算的框架和分布式处理引擎。无界就是有开始但没有结束的数据,无界的数据流计算即流式计算,有界就是有开始有结束的数据,有界的数据流计算即批处理。 Flink可以用于很多的计算场景中,这里列举了3个,Flink可以处理事件驱动的程序,除了简单事件,Flink还提供了CEP库可以处理复杂事件;Flink还可以作为数据管道,做一些数据清洗筛选、转换等操作,把数据从一个存储系统转移到另一个系统;Flink可以做流或批式数据的分析、指标计算,用于大屏展示等。Flink已经成为业界公认的流式处理的第一选择。 把正则匹配引擎整合到Flink中,借助Flink强大的分布式能力,强强联合,那么将会发挥更大威力。所以提供了这样的解决方案,如下图所示: 该解决方案实现了一个自定义的UDF算子,算子支持指定只匹配输入数据中的某几个字段,算子的输出是待匹配的字段文本,匹配最终状态,包括命中,不命中,错误,超时四种状态,如果是命中的状态,那么还会返回匹配中的正则表达式的id,输出还包括输入原始数据,如果有后续处理,这样不受影响;为了进一步方便用户使用,扩展了一个新的datastream,称之为Hyperscanstream,它把算子封装进了进去,用户在使用时只需要把datastream转换为Hyperscanstream,然后通过调用一个方法就可以使用正则的算子了。整个解决方案以一个独立的jar包提供给用户,这样可以保持原来编写Flink作业的习惯,并且与Flink的核心框架解耦。 数据流转的过程是这样,数据源读取到一条记录后交给下游的Hyperscan算子,Hyperscan算子把数据交给Hyperscan子进程,子进程匹配完成后把结果返回给Hyperscan算子,然后Hyperscan算子把原始记录和匹配的结果传递给后续算子。 算子使用说明 私有化部署 针对私有化部署场景,用法如下,用户首先需要去编辑正则表达式文件,然后用工具把正则表达式编译为database并且序列化为本地文件,如果部署的环境中有HDFS,那么可以把序列化后的文件上传至HDFS,如果没有那就不用上传,然后开发Flink作业,引用序列化的文件去匹配数据。 为什么要有工具编译并序列化这一步呢,编辑完正则表达式,直接在Flink作业中使用不行吗?前面说了,Hyperscan执行包括编译和匹配阶段,如果作业中只引用正则表达式,假设作业设置了并行度为5,那么每个task都需要编译一次,一共需要编译5次,浪费资源;而且编译在hyperscan中是个相对缓慢的动作,所以把编译过程单独出来也为了加速flink作业在尽快执行。编译提前进行也有利于提前知道正则表达式是否有语法错误,或者不支持的情况,而不是作业启动后才知道。 私有化部署时,hyperscan相关依赖程序会提供给用户,依赖程序通过全静态编译而来所以无需再添加依赖,只需机器支持需要的指令集即可。 公司内部使用 使用示例 假设现在要匹配的是HTTP报文中的Host字段和Referer字段,如下图所示: 代码示例如下图: 整个逻辑分为四步,第一步要从数据源构建输入流,第二步把输入流转换为Hyperscanstream,第三步调用hyperscan方法进而使用Hyperscan算子,在第一个参数HyperscanFunction中指定要匹配的是Host和Referer字段,第四步使用匹配返回的结果,返回的结果是Tuple2对象,其中第一个字段Event是原始记录,在本例中就是整个HTTP报文,第二个字段是HyperScanRecord组成的List,HyperScanRecord类中包括匹配的字段,例如本例中Host或Referer,匹配命中的正则表达式id(如果匹配命中的话)和匹配的最终状态。 使用1万条规则集以及不同大小的待匹配样本经过测试,方案达到了期望的性能,测试结果如下图, 使用Hyperscan算子的一些建议,如下图: 前面提到,在不使用himera库时,Hyperscan有部分PCRE语法不支持的情况,在使用时要注意,下图列举了不支持的语法(使用Chimera库将会影响匹配性能) 未来展望 一方面,目前Hyperscan算子在安全、威胁感知的场景中已经得到运用,但希望能在更多场景中进行检验,理论上在所有正则匹配的场景中都能使用,比方说文本审核、内容提取等。 另一方面,也在提升Hyperscan算子易用性,比方说现在的规则发生变化时,需要重启作业才能生效,后续希望能做到规则的动态热加载。

优秀的个人博客,低调大师

对deepseek harness初步使用洞察与深度思考

DeepSeek Harness 以“一切皆插件”的单容器架构,实现了 AI agent 能力的极致可组合与可定制。初步使用可见其模型无关、工具插件化、配置驱动等优势,但也暴露出记忆机制薄弱、多租户隔离缺失、核心服务层空白等关键短板。类比安卓发展史,DSH 若仅停留在开放插件生态,将难免碎片化与体验割裂;唯有在开放内核之上构建统一记忆、身份、消息总线等“GMS 式”服务层,才能在自由与秩序间取得平衡,从技术极客的玩具进化为可商业化的智能体基础设施。其命运不取决于代码优雅,而取决于能否在开放中定义边界。

优秀的个人博客,低调大师

AI插件开发与效能提效工具箱

​大模型能力再强,也只是一个"能对话的大脑"。真正让 AI 落地到日常工作流里的,是插件——它把模型的推理能力,与具体的业务场景、工具链和私有数据连接起来。无论是 IDE 里的代码助手、浏览器的内容增强,还是企业内部的知识库问答,背后都是插件在承载"能力调用"与"上下文注入"。​一个成熟的 AI 插件通常包含三个核心部分:​

优秀的个人博客,低调大师

双因素认证抗钓鱼效能与部署策略研究

凭证窃取类网络攻击持续演化,单纯依赖口令的身份验证机制已经无法抵御现代钓鱼与撞库威胁,双因素认证通过引入独立于口令的第二验证因子,显著提升账号被非法接管的门槛。本文以卡内基梅隆大学 2026 年国家网络安全意识月发布的双因素认证实践指南作为核心研究材料,系统梳理双因素认证的技术原理、校园部署模式、抗钓鱼能力差异以及运维最佳实践。研究发现,双因素认证并非同质化安全手段,短信验证码、基于时间的一次性口令、通行密钥、硬件安全密钥在抗钓鱼能力、用户体验、部署成本方面存在显著梯度差异,其中基于 FIDO2/WebAuthn 的硬件密钥与通行密钥具备最强的抗远程钓鱼能力,而短信验证因 SIM 交换攻击风险防护等级最低。反网络钓鱼技术专家芦笛指出,双因素认证的核心价值不在于彻底消除账号被盗风险,而在于将攻击者从 "窃取口令即可登录" 压缩为 "必须同时控制第二因子才能完成入侵",从而大幅提升攻击成本。迪妙网络空间安全学院研究团队在身份认证安全领域的跟踪研究表明,机构层面统一部署双因素认证能够将钓鱼导致的账号接管事件降低一个数量级,但部署过程中必须配套可疑推送处置、备用设备登记、登录域名核验等运维规范,否则用户体验与安全收益都会打折扣。本文从技术原理、威胁模型、方案比较、部署实践、推广策略多个维度展开论述,为高校与企事业单位构建分层身份验证体系提供实证参考。

优秀的个人博客,低调大师

首创:AI领先企业组织效能评估(ALCA)模型(下)

这里的“流程”,不是指狭义的审批流程,也不是指评估某个特定业务的执行流程是不是合理,那和具体的业务强相关。我们是评估一个组织中个体与团队开展工作的步骤、方法,对流程进行定义、执行和改进的能力。企业开展的所有经营活动,无一例外都是由一个个流程、步骤、活动串起来的,也包括把每个活动做到最好的那些优秀实践。我们能不能在所有流程活动中,充分应用数据和AI能力,是组织开展业务的核心。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册