首页 文章 精选 留言 我的

精选列表

搜索[效能洞察],共5574篇文章
优秀的个人博客,低调大师

不可错过的效能利器「GitHub 热点速览 v.22.39」

如果你是一名前端工程师且维护着多个网站,不妨试试本周榜上有名的 HTML-first 的 Qwik,提升网站访问速度只用一招。除了提升网站加载速度的 Qwik,本周周榜上榜的 Whisper 也是一个神器,可用来快速识别语音输入输出。当然,还有好用的短链接生成工具 Dub 帮你挣脱 Bitly 的“魔爪”,顺便分析一波短链接的访问数据。还有帮你管理日常大小事务的日程安排工具 cal.com 提升时间利用率,以及 git 专属终端让你提交的速度比别人更快一筹。 以下内容摘录自微博@HelloGitHub 的 GitHub Trending 及 Hacker News 热帖(简称 HN 热帖),选项标准:新发布 | 实用 | 有趣,根据项目 release 时间分类,发布时间不超过 14 day 的项目会标注 New,无该标志则说明项目 release 超过半月。由于本文篇幅有限,还有部分项目未能在本文展示,望周知 🌝 本文目录 本周特推 1.1 HTML-first:qwik 1.2 git 专属终端:gitui GitHub Trending 周榜 2.1 语音识别:whisper 2.2 短链接服务:dub 2.3 OpenGL 终端模拟器:alacritty 2.4 统一 ML 框架:ivy 2.5 日程安排:cal.com 往期回顾 1. 本周特推 1.1 HTML-first:qwik 主语言:TypeScript 想提高网站访问速度吗?Qwik 能提供最快的页面加载速度,无论你网站多复杂,将它变成不到 1kb 的 JS 进行加载从而提高它的访问速度。 GitHub 地址→https://github.com/BuilderIO/qwik 1.2 git 专属终端:gitui 主语言:Rust 为 git 定制的专属终端,gitui 采用 Rust 编写。官方用 lazygit、ti、gitui 分别解析 Linux git 仓(超 900k commits)进行过性能对比,报告显示 gitui 有更好的访问速度以及更低的资源消耗。gitui 的部分特性: 支持 git 操作; 直观的键盘交互控制; 无需记忆热键,支持基于操作上下文提供帮助; 可拓展终端 UI 布局; 异步 git API 灵活控制; GitHub 地址→https://github.com/extrawurst/gitui 2. GitHub Trending 周榜 2.1 语音识别:whisper 本周 star 增长数:8,000+,主语言:Jupyter Notebook、Python New OpenAI 新开源的语音识别模型,经过大量音频数据训练,Whisper 可用于多语言语音识别以及语音翻译。Whisper 提供 5 种不同大小的模型,Large 模型(含 1550M 参数)支持多语言,剩余的其他四种模型在英语应用程序上比较会更好。 GitHub 地址→https://github.com/openai/whisper 2.2 短链接服务:dub 本周 star 增长数:1,050+,主语言:TypeScript 一款 Bitly(短链接服务产品)的替代品,内置数据分析、定制域名等功能。Dub 项目技术栈如下: Next.js——框架 TypeScript——语言 Tailwind——CSS Upstash——数据库 NextAuth——认证 Vercel——托管 Stripe——支付 GitHub 地址→https://github.com/steven-tey/dub 2.3 OpenGL 终端模拟器:alacritty 本周 star 增长数:300+,主语言:Rust 一个跨平台 OpenGL 终端模拟器,可根据你自身需求进行配置。目前 Alacritty 支持 BSD、Linux、macOS、Windows 等操作系统。特性: Vim 模式,可用键盘来控制一切; 检索; 使用提示; 可选扩展; 支持鼠标打开链接; 多窗口 GitHub 地址→https://github.com/alacritty/alacritty 2.4 统一 ML 框架:Ivy 本周 star 增长数:400+,主语言:Python 一个支持 JAX、TensorFlow、PyTorch 和 Numpy 的统一 ML 框架。你可以快速用 Ivy 来训练一个神经网络,就像这样,用上你喜欢的框架: import ivy class MyModel(ivy.Module): def __init__(self): self.linear0 = ivy.Linear(3, 64) self.linear1 = ivy.Linear(64, 1) ivy.Module.__init__(self) def _forward(self, x): x = ivy.relu(self.linear0(x)) return ivy.sigmoid(self.linear1(x)) ivy.set_backend('torch') # change to any backend! model = MyModel() optimizer = ivy.Adam(1e-4) x_in = ivy.array([1., 2., 3.]) target = ivy.array([0.]) def loss_fn(v): out = model(x_in, v=v) return ivy.mean((out - target)**2) for step in range(100): loss, grads = ivy.execute_with_gradients(loss_fn, model.v) model.v = optimizer.step(model.v, grads) print('step {} loss {}'.format(step, ivy.to_numpy(loss).item())) print('Finished training!') GitHub 地址→https://github.com/unifyai/ivy 2.5 日程安排:cal.com 本周 star 增长数:400+,主语言:TypeScript 开源的日程管理工具,你可以用来管理你的日常和工作事项。作为 Calendly(日程管理软件)替代品,它具有 Calendly 没有的“弹性”,多种 API 供你来定制你的日程管理软件。 GitHub 地址→https://github.com/calcom/cal.com 3. 往期回顾 往期回顾: 万星开源项目强势回归「GitHub 热点速览 v.22.38」 可靠的自托管「GitHub 热点速览 v.22.37」 以上为 2022 年第 39 个工作周的 GitHub Trending 🎉如果你 Pick 其他好玩、实用的 GitHub 项目,记得来 HelloGitHub issue 区和我们分享下哟 🌝

优秀的个人博客,低调大师

每日一博 | 如何提高大规模正则匹配的效能

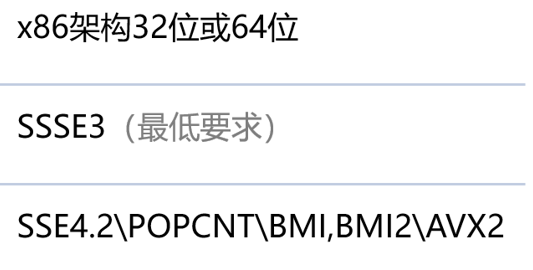
背景 日常工作中会大量应用正则表达式,用正则表达式去定义规则,然后去匹配数据。这里先看两个安全场景下的正则应用需求 场景1,FTP账号被成功暴力破解后数据遭窃取 • 数据源:FTP服务器日志 • 关联逻辑:针对特定账号暴力破解,然后利用该特定账号登录成功,之后利用该特定账号下载大量文件 • 告警内容:FTP账号${user_name}被成功暴力破解后窃取数据 • 告警级别:高危 场景1中,正则表达式用于在日志中匹配多次账户登录的行为上。 场景2,Deep packet inspection (DPI) ,例如过滤网络威胁和违反安全策略的流量等 • 数据源:网络数据包 • 检测规则条件:数据命中规则集 场景2中,正则表达式用于时间序列上的多个数据包之间的安全检测。 其实,场景1中只列举了FTP被攻击的一种方式,FTP攻击还有很多其他手段,所以检测FTP被攻击的正则匹配场景的另一个特征就是整个规则集可能很大;场景2中,利用已知的入侵行为构建模式集合,通过检测网络数据包,发现是否存在不符合安全策略的行为或被攻击的迹象,这需要对数据包的载荷部分进行检测,要求匹配的速度非常快,否则将会影响用户体验。 另一方面,这里用到的正则与传统用法又不太一样,对正则的传统用法是,给定一个文本,用一个或少数几个正则规则,去匹配文本,找出文本中匹配的数据。而现在面对的问题,首先是规则的数量大,上千上万或者超过十万的规则集,如果仍然采用之前的做法,用|分割,或者外层用循环去匹配,那么处理的时间将很长,对资源的消耗也很大,基本不可接受;其次在匹配的时候,待匹配的数据不是一个完整的整体,比如说网络数据包,是一个一个接收的,这是一个流式的形式,传统的正则处理引擎不能很好的处理流式数据,需要缓存一批数据去匹配,这样匹配就不够及时,而且目前正则处理有个很大的问题,如果正则表达式写的不好,那么匹配会很慢。所以,需要一个解决方案来应对以下这些挑战: • 规则数量多 • 匹配速度要快 • 支持流式数据 • 资源消耗不能太大 Hyperscan算子介绍 针对上述正则匹配中遇到的挑战,经过调研和对比测试市面上的主流正则匹配引擎,我们最终选择了Hyperscan。 Hyperscan是Intel开源的高性能正则表达式匹配库,提供了C语言API,目前已经在很多商业项目和开源项目中得到应用。 Hyperscan具备这些特性: • 支持大部分PCRE正则语法(如果使用Chimera库,那将支持所有语法) • 支持流式匹配 • 支持多模匹配 • 采用特定指令集加速匹配 • 易于扩展 • 内部多种引擎结合 Hyperscan在设计之初就是为了更好的处理流式匹配和多模匹配,对流模式的支持极大的方便了正则用户,不再需要用户去维护接收到的数据,无需缓存数据;多模匹配允许把多个正则表达式传入并在同一时间进行匹配。 因为需要特定的指令集,所以Hyperscan对CPU有要求,如下图: CPU最低要支持SSSE3指令集,最下面一行的指令集能加速匹配 和大多数正则引擎类似,Hyperscan也包括编译和匹配阶段,编译是把正则表达式解析然后构建成内部需要的database,后续可以多次使用这个database去匹配;如果是多模匹配,编译时每个正则表达式需要有一个唯一的标识id,id在匹配的时候会用到。编译过程如下图所示: 匹配的时候Hyperscan默认会返回所有命中的结果,这点不像有些正则引擎,指定贪婪的时候返回贪婪的匹配结果,指定懒惰的时候返回懒惰的结果。匹配时如果有命中,那么会以回调函数的形式通知用户在哪个位置命中了哪个正则表达式id。匹配过程如下图所示: Hyperscan的缺点是只能是单机执行,没有分布式能力,其可以解决延迟的问题,但无法解决吞吐的问题,解决吞吐问题,可以依靠主流实时计算框架Flink。Flink 是一个在无界和有界数据流上进行状态计算的框架和分布式处理引擎。无界就是有开始但没有结束的数据,无界的数据流计算即流式计算,有界就是有开始有结束的数据,有界的数据流计算即批处理。 Flink可以用于很多的计算场景中,这里列举了3个,Flink可以处理事件驱动的程序,除了简单事件,Flink还提供了CEP库可以处理复杂事件;Flink还可以作为数据管道,做一些数据清洗筛选、转换等操作,把数据从一个存储系统转移到另一个系统;Flink可以做流或批式数据的分析、指标计算,用于大屏展示等。Flink已经成为业界公认的流式处理的第一选择。 把正则匹配引擎整合到Flink中,借助Flink强大的分布式能力,强强联合,那么将会发挥更大威力。所以提供了这样的解决方案,如下图所示: 该解决方案实现了一个自定义的UDF算子,算子支持指定只匹配输入数据中的某几个字段,算子的输出是待匹配的字段文本,匹配最终状态,包括命中,不命中,错误,超时四种状态,如果是命中的状态,那么还会返回匹配中的正则表达式的id,输出还包括输入原始数据,如果有后续处理,这样不受影响;为了进一步方便用户使用,扩展了一个新的datastream,称之为Hyperscanstream,它把算子封装进了进去,用户在使用时只需要把datastream转换为Hyperscanstream,然后通过调用一个方法就可以使用正则的算子了。整个解决方案以一个独立的jar包提供给用户,这样可以保持原来编写Flink作业的习惯,并且与Flink的核心框架解耦。 数据流转的过程是这样,数据源读取到一条记录后交给下游的Hyperscan算子,Hyperscan算子把数据交给Hyperscan子进程,子进程匹配完成后把结果返回给Hyperscan算子,然后Hyperscan算子把原始记录和匹配的结果传递给后续算子。 算子使用说明 私有化部署 针对私有化部署场景,用法如下,用户首先需要去编辑正则表达式文件,然后用工具把正则表达式编译为database并且序列化为本地文件,如果部署的环境中有HDFS,那么可以把序列化后的文件上传至HDFS,如果没有那就不用上传,然后开发Flink作业,引用序列化的文件去匹配数据。 为什么要有工具编译并序列化这一步呢,编辑完正则表达式,直接在Flink作业中使用不行吗?前面说了,Hyperscan执行包括编译和匹配阶段,如果作业中只引用正则表达式,假设作业设置了并行度为5,那么每个task都需要编译一次,一共需要编译5次,浪费资源;而且编译在hyperscan中是个相对缓慢的动作,所以把编译过程单独出来也为了加速flink作业在尽快执行。编译提前进行也有利于提前知道正则表达式是否有语法错误,或者不支持的情况,而不是作业启动后才知道。 私有化部署时,hyperscan相关依赖程序会提供给用户,依赖程序通过全静态编译而来所以无需再添加依赖,只需机器支持需要的指令集即可。 公司内部使用 使用示例 假设现在要匹配的是HTTP报文中的Host字段和Referer字段,如下图所示: 代码示例如下图: 整个逻辑分为四步,第一步要从数据源构建输入流,第二步把输入流转换为Hyperscanstream,第三步调用hyperscan方法进而使用Hyperscan算子,在第一个参数HyperscanFunction中指定要匹配的是Host和Referer字段,第四步使用匹配返回的结果,返回的结果是Tuple2对象,其中第一个字段Event是原始记录,在本例中就是整个HTTP报文,第二个字段是HyperScanRecord组成的List,HyperScanRecord类中包括匹配的字段,例如本例中Host或Referer,匹配命中的正则表达式id(如果匹配命中的话)和匹配的最终状态。 使用1万条规则集以及不同大小的待匹配样本经过测试,方案达到了期望的性能,测试结果如下图, 使用Hyperscan算子的一些建议,如下图: 前面提到,在不使用himera库时,Hyperscan有部分PCRE语法不支持的情况,在使用时要注意,下图列举了不支持的语法(使用Chimera库将会影响匹配性能) 未来展望 一方面,目前Hyperscan算子在安全、威胁感知的场景中已经得到运用,但希望能在更多场景中进行检验,理论上在所有正则匹配的场景中都能使用,比方说文本审核、内容提取等。 另一方面,也在提升Hyperscan算子易用性,比方说现在的规则发生变化时,需要重启作业才能生效,后续希望能做到规则的动态热加载。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册