首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10000篇文章
优秀的个人博客,低调大师

Netty(一):server启动流程解析

netty作为一个被广泛应用的通信框架,有必要我们多了解一点。 实际上netty的几个重要的技术亮点: 1. reactor的线程模型; 2. 安全有效的nio非阻塞io模型应用; 3. pipeline流水线式的灵活处理过程; 4. channelHandler的灵活实现; 5. 提供许多开箱即用的处理器和编解码器; 我们可以从这些点去深入理解其过人之处。 1. 一个NettyServer的demo 要想深入理解某个框架,一般还是要以demo作为一个抓手点的。以下,我们可以看到一个简单的nettyServer的创建过程,即netty的quick start样例吧。 @Slf4j public class NettyServerHelloApplication { /** * 一个server的样例 */ public static void main(String[] args) throws Exception { // 1. 创建对应的EventLoop线程池备用, 分bossGroup和workerGroup EventLoopGroup bossGroup = new NioEventLoopGroup(1); EventLoopGroup workerGroup = new NioEventLoopGroup(4); try { // 2. 创建netty对应的入口核心类 ServerBootstrap ServerBootstrap b = new ServerBootstrap(); // 3. 设置server的各项参数,以及应用处理器 b.group(bossGroup, workerGroup) .channel(NioServerSocketChannel.class) .option(ChannelOption.SO_BACKLOG, 100) // 设置tcp协议的请求等待队列 .childHandler(new ChannelInitializer<SocketChannel>() { @Override public void initChannel(SocketChannel ch) throws Exception { // 3.2. 最重要的,将各channelHandler绑定到netty的上下文中(暂且这么说吧) ChannelPipeline p = ch.pipeline(); p.addLast(new LoggingHandler(LogLevel.INFO)); p.addLast("encoder", new MessageEncoder()); p.addLast("decoder", new MessageDecoder()); p.addLast(new EchoServerHandler()); } }); // 4. 绑定tcp端口开启服务端监听, sync() 保证执行完成所有任务 ChannelFuture f = b.bind(ServerConstant.PORT).sync(); // 5. 等待关闭信号,让业务线程去服务业务了 f.channel().closeFuture().sync(); } finally { // 6. 收到关闭信号后,优雅关闭server的线程池,保护应用 bossGroup.shutdownGracefully(); workerGroup.shutdownGracefully(); } } } 以上,就是一个简版的nettyServer的整个框架了,这也基本上整个nettyServer的编程范式了。主要即分为这么几步: 1. 创建对应的EventLoop线程池备用, 分bossGroup和workerGroup; 2. 创建netty对应的入口核心类 ServerBootstrap; 3. 设置server的各项参数,以及应用处理器(必备的channelHandler业务接入过程); 4. 绑定tcp端口开启服务端监听; 5. 等待关闭信号,让业务线程去服务业务了; 6. 收到关闭信号后,优雅关闭server的线程池,保护应用; 事实上,如果我们直接基于jdk提供的ServerSocketChannel是否也差不了多少呢?是的,至少表面看起来是的,但我们要处理许多的异常情况,且可能面对变化繁多的业务类型。又该如何呢? 毕竟一个框架的成功,绝非偶然。下面我们就这几个过程来看看netty都是如何处理的吧! 2. EventLoop 的创建 EventLoop 直译为事件循环,但在这里我们也可以理解为一个线程池,因为所有的事件都是提交给其处理的。那么,它倒底是个什么样的循环呢? 首先来看下其类继承情况: 从类图可以看出,EventLoop也是一个executor或者说线程池的实现,它们也许有相通之处。 // 调用方式如下 EventLoopGroup bossGroup = new NioEventLoopGroup(1); EventLoopGroup workerGroup = new NioEventLoopGroup(4); // io.netty.channel.nio.NioEventLoopGroup#NioEventLoopGroup(int, java.util.concurrent.ThreadFactory) /** * Create a new instance using the specified number of threads, the given {@link ThreadFactory} and the * {@link SelectorProvider} which is returned by {@link SelectorProvider#provider()}. */ public NioEventLoopGroup(int nThreads, ThreadFactory threadFactory) { this(nThreads, threadFactory, SelectorProvider.provider()); } public NioEventLoopGroup( int nThreads, Executor executor, final SelectorProvider selectorProvider) { this(nThreads, executor, selectorProvider, DefaultSelectStrategyFactory.INSTANCE); } public NioEventLoopGroup(int nThreads, Executor executor, final SelectorProvider selectorProvider, final SelectStrategyFactory selectStrategyFactory) { super(nThreads, executor, selectorProvider, selectStrategyFactory, RejectedExecutionHandlers.reject()); } // io.netty.channel.MultithreadEventLoopGroup#MultithreadEventLoopGroup(int, java.util.concurrent.Executor, java.lang.Object...) protected MultithreadEventLoopGroup(int nThreads, Executor executor, Object... args) { // 默认线程是 cpu * 2 super(nThreads == 0 ? DEFAULT_EVENT_LOOP_THREADS : nThreads, executor, args); } // io.netty.util.concurrent.MultithreadEventExecutorGroup#MultithreadEventExecutorGroup(int, java.util.concurrent.Executor, java.lang.Object...) /** * Create a new instance. * * @param nThreads the number of threads that will be used by this instance. * @param executor the Executor to use, or {@code null} if the default should be used. * @param args arguments which will passed to each {@link #newChild(Executor, Object...)} call */ protected MultithreadEventExecutorGroup(int nThreads, Executor executor, Object... args) { this(nThreads, executor, DefaultEventExecutorChooserFactory.INSTANCE, args); } // io.netty.util.concurrent.MultithreadEventExecutorGroup#MultithreadEventExecutorGroup(int, java.util.concurrent.Executor, io.netty.util.concurrent.EventExecutorChooserFactory, java.lang.Object...) /** * Create a new instance. * * @param nThreads the number of threads that will be used by this instance. * @param executor the Executor to use, or {@code null} if the default should be used. * @param chooserFactory the {@link EventExecutorChooserFactory} to use. * @param args arguments which will passed to each {@link #newChild(Executor, Object...)} call */ protected MultithreadEventExecutorGroup(int nThreads, Executor executor, EventExecutorChooserFactory chooserFactory, Object... args) { if (nThreads <= 0) { throw new IllegalArgumentException(String.format("nThreads: %d (expected: > 0)", nThreads)); } // 创建一个执行器,该执行器每提交一个任务,就创建一个线程来运行,即并没有队列的概念 if (executor == null) { executor = new ThreadPerTaskExecutor(newDefaultThreadFactory()); } // 使用一个数组来保存整个可用的线程池 children = new EventExecutor[nThreads]; for (int i = 0; i < nThreads; i ++) { boolean success = false; try { // 为每个child创建一个线程运行, 该方法由子类实现 children[i] = newChild(executor, args); success = true; } catch (Exception e) { // TODO: Think about if this is a good exception type throw new IllegalStateException("failed to create a child event loop", e); } finally { if (!success) { // 如果创建失败,则把已经创建好的线程池关闭掉 // 不过值得注意的是,当某个线程池创建失败后,并没有立即停止后续创建工作,即无 return 操作,这是为啥? // 实际上,发生异常时,Exeception 已经被抛出,此处无需关注 for (int j = 0; j < i; j ++) { children[j].shutdownGracefully(); } for (int j = 0; j < i; j ++) { EventExecutor e = children[j]; try { while (!e.isTerminated()) { e.awaitTermination(Integer.MAX_VALUE, TimeUnit.SECONDS); } } catch (InterruptedException interrupted) { // Let the caller handle the interruption. Thread.currentThread().interrupt(); break; } } } } } // 创建选择器,猜测是做负载均衡时使用 // 此处的chooser默认是 DefaultEventExecutorChooserFactory chooser = chooserFactory.newChooser(children); final FutureListener<Object> terminationListener = new FutureListener<Object>() { @Override public void operationComplete(Future<Object> future) throws Exception { if (terminatedChildren.incrementAndGet() == children.length) { terminationFuture.setSuccess(null); } } }; for (EventExecutor e: children) { e.terminationFuture().addListener(terminationListener); } Set<EventExecutor> childrenSet = new LinkedHashSet<EventExecutor>(children.length); Collections.addAll(childrenSet, children); readonlyChildren = Collections.unmodifiableSet(childrenSet); } // io.netty.channel.nio.NioEventLoopGroup#newChild @Override protected EventLoop newChild(Executor executor, Object... args) throws Exception { // 注意此处的参数类型是由外部进行保证的,在此直接做强转操作 return new NioEventLoop(this, executor, (SelectorProvider) args[0], ((SelectStrategyFactory) args[1]).newSelectStrategy(), (RejectedExecutionHandler) args[2]); } // io.netty.channel.nio.NioEventLoop#NioEventLoop NioEventLoop(NioEventLoopGroup parent, Executor executor, SelectorProvider selectorProvider, SelectStrategy strategy, RejectedExecutionHandler rejectedExecutionHandler) { // 此构造器会做很多事,比如创建队列,开启nio selector... super(parent, executor, false, DEFAULT_MAX_PENDING_TASKS, rejectedExecutionHandler); if (selectorProvider == null) { throw new NullPointerException("selectorProvider"); } if (strategy == null) { throw new NullPointerException("selectStrategy"); } provider = selectorProvider; final SelectorTuple selectorTuple = openSelector(); selector = selectorTuple.selector; unwrappedSelector = selectorTuple.unwrappedSelector; selectStrategy = strategy; } // io.netty.util.concurrent.DefaultEventExecutorChooserFactory#newChooser @SuppressWarnings("unchecked") @Override public EventExecutorChooser newChooser(EventExecutor[] executors) { // 如: 1,2,4,8... 都会创建 PowerOfTwoEventExecutorChooser if (isPowerOfTwo(executors.length)) { return new PowerOfTwoEventExecutorChooser(executors); } else { return new GenericEventExecutorChooser(executors); } } // io.netty.util.concurrent.DefaultPromise#addListener @Override public Promise<V> addListener(GenericFutureListener<? extends Future<? super V>> listener) { checkNotNull(listener, "listener"); synchronized (this) { addListener0(listener); } if (isDone()) { notifyListeners(); } return this; } 以上,就是 NioEventLoopGroup 的创建过程了. 本质上其就是一个个的单独的线程组成的数组列表, 等待被调用. 3. ServerBootstrap 的创建 ServerBootstrap是Netty的一个服务端核心入口类, 它可以很快速的创建一个稳定的netty服务. ServerBootstrap 的类图如下: 还是非常纯粹的啊!其中有意思是的, ServerBootstrap继承自 AbstractBootstrap, 而这个 AbstractBootstrap 是一个自依赖的抽象类: AbstractBootstrap<B extends AbstractBootstrap<B, C>, C extends Channel> , 这样,即父类可以直接返回子类的信息了。 其默认构造方法为空,所以所以参数都使用默认值, 因为还有后续的参数设置过程,接下来,我们看看其一些关键参数的设置: // 1. channel的设定 // io.netty.bootstrap.AbstractBootstrap#channel /** * The {@link Class} which is used to create {@link Channel} instances from. * You either use this or {@link #channelFactory(io.netty.channel.ChannelFactory)} if your * {@link Channel} implementation has no no-args constructor. */ public B channel(Class<? extends C> channelClass) { if (channelClass == null) { throw new NullPointerException("channelClass"); } // 默认使用构造器反射的方式创建 channel return channelFactory(new ReflectiveChannelFactory<C>(channelClass)); } // io.netty.bootstrap.AbstractBootstrap#channelFactory(io.netty.channel.ChannelFactory<? extends C>) /** * {@link io.netty.channel.ChannelFactory} which is used to create {@link Channel} instances from * when calling {@link #bind()}. This method is usually only used if {@link #channel(Class)} * is not working for you because of some more complex needs. If your {@link Channel} implementation * has a no-args constructor, its highly recommend to just use {@link #channel(Class)} for * simplify your code. */ @SuppressWarnings({ "unchecked", "deprecation" }) public B channelFactory(io.netty.channel.ChannelFactory<? extends C> channelFactory) { return channelFactory((ChannelFactory<C>) channelFactory); } // io.netty.bootstrap.AbstractBootstrap#channelFactory(io.netty.bootstrap.ChannelFactory<? extends C>) /** * @deprecated Use {@link #channelFactory(io.netty.channel.ChannelFactory)} instead. */ @Deprecated public B channelFactory(ChannelFactory<? extends C> channelFactory) { if (channelFactory == null) { throw new NullPointerException("channelFactory"); } if (this.channelFactory != null) { throw new IllegalStateException("channelFactory set already"); } this.channelFactory = channelFactory; return self(); } @SuppressWarnings("unchecked") private B self() { return (B) this; } // 2. option 参数选项设置, 它会承包各种特殊配置的设置, 是一个通用配置项设置的入口 /** * Allow to specify a {@link ChannelOption} which is used for the {@link Channel} instances once they got * created. Use a value of {@code null} to remove a previous set {@link ChannelOption}. */ public <T> B option(ChannelOption<T> option, T value) { if (option == null) { throw new NullPointerException("option"); } // options 是一个 new LinkedHashMap<ChannelOption<?>, Object>(), 即非线程安全的容器, 所以设置值时要求使用 synchronized 保证线程安全 // value 为null时代表要将该选项设置删除, 如果key相同,后面的配置将会覆盖前面的配置 if (value == null) { synchronized (options) { options.remove(option); } } else { synchronized (options) { options.put(option, value); } } return self(); } // 3. childHandler 添加channelHandler, 这是一个最重要的一个方法, 它会影响到后面的业务处理统筹 // 调用该方法仅将 channelHandler的上下文加入进来, 实际还未进行真正的添加操作 .childHandler(new ChannelInitializer<SocketChannel>() { ServerBootstrap b = new ServerBootstrap(); b.group(bossGroup, workerGroup) .channel(NioServerSocketChannel.class) .option(ChannelOption.SO_BACKLOG, 100) // 设置tcp协议的请求等待队列 .childHandler(new ChannelInitializer<SocketChannel>() { @Override public void initChannel(SocketChannel ch) throws Exception { ChannelPipeline p = ch.pipeline(); p.addLast(new LoggingHandler(LogLevel.INFO)); p.addLast("encoder", new MessageEncoder()); p.addLast("decoder", new MessageDecoder()); p.addLast(new EchoServerHandler()); } }); /** * Set the {@link ChannelHandler} which is used to serve the request for the {@link Channel}'s. */ public ServerBootstrap childHandler(ChannelHandler childHandler) { if (childHandler == null) { throw new NullPointerException("childHandler"); } // 仅将 channelHandler 绑定到netty的上下文中 this.childHandler = childHandler; return this; } // 4. bossGroup, workGroup 如何被分配 ? /** * Set the {@link EventLoopGroup} for the parent (acceptor) and the child (client). These * {@link EventLoopGroup}'s are used to handle all the events and IO for {@link ServerChannel} and * {@link Channel}'s. */ public ServerBootstrap group(EventLoopGroup parentGroup, EventLoopGroup childGroup) { // parentGroup 是给acceptor使用的, 主要用于对socket连接的接入,所以一般一个线程也够了 super.group(parentGroup); if (childGroup == null) { throw new NullPointerException("childGroup"); } if (this.childGroup != null) { throw new IllegalStateException("childGroup set already"); } // childGroup 主要用于接入后的socket的事件的处理,一般要求数量较多,视业务属性决定 this.childGroup = childGroup; return this; } bind 绑定tcp端口,这个是真正触发server初始化的一步,工作量比较大,我们另开一段讲解。 4. nettyServer 的初始化 前面所有工作都是在准备, 都并未体现在外部, 而 bind 则会是开启一个对外服务, 对外可见, 真正启动server. // io.netty.bootstrap.AbstractBootstrap#bind(int) /** * Create a new {@link Channel} and bind it. */ public ChannelFuture bind(int inetPort) { return bind(new InetSocketAddress(inetPort)); } // io.netty.bootstrap.AbstractBootstrap#bind(java.net.SocketAddress) /** * Create a new {@link Channel} and bind it. */ public ChannelFuture bind(SocketAddress localAddress) { // 先验证各种参数是否设置完整, 如线程池是否设置, channelHandler 是否设置... validate(); if (localAddress == null) { throw new NullPointerException("localAddress"); } // 绑定tcp端口 return doBind(localAddress); } private ChannelFuture doBind(final SocketAddress localAddress) { // 1. 创建一些channel使用, 与eventloop绑定, 统一管理嘛 final ChannelFuture regFuture = initAndRegister(); final Channel channel = regFuture.channel(); if (regFuture.cause() != null) { return regFuture; } if (regFuture.isDone()) { // At this point we know that the registration was complete and successful. ChannelPromise promise = channel.newPromise(); // 2. 注册成功之后, 开始实际的 bind() 操作, 实际就是调用 channel.bind() // doBind0() 是一个异步的操作,所以使用的一个 promise 作为结果驱动 doBind0(regFuture, channel, localAddress, promise); return promise; } else { // Registration future is almost always fulfilled already, but just in case it's not. final PendingRegistrationPromise promise = new PendingRegistrationPromise(channel); regFuture.addListener(new ChannelFutureListener() { @Override public void operationComplete(ChannelFuture future) throws Exception { Throwable cause = future.cause(); if (cause != null) { // Registration on the EventLoop failed so fail the ChannelPromise directly to not cause an // IllegalStateException once we try to access the EventLoop of the Channel. promise.setFailure(cause); } else { // Registration was successful, so set the correct executor to use. // See https://github.com/netty/netty/issues/2586 promise.registered(); doBind0(regFuture, channel, localAddress, promise); } } }); return promise; } } 所以,从整体来说,bind()过程分两大步走:1. 初始化channel,与nio关联; 2. 落实channel和本地端口的绑定工作; 我们来细看下: 4.1 初始化channel 初始化channel, 并注册到 selector上, 这个操作实际上非常重要。 // 以下我们先看下执行框架 // io.netty.bootstrap.AbstractBootstrap#initAndRegister final ChannelFuture initAndRegister() { Channel channel = null; try { // 即根据前面设置的channel 使用反射创建一个实例出来 // 即此处将会实例化出一个 ServerSocketChannel 出来 // 所以如果你想用jdk的nio实现,则设置channel时使用 NioServerSocketChannel.class即可, 而你想使用其他更优化的实现时比如EpollServerSocketChannel时,改变一下即可 // 而此处的 channelFactory 就是一个反射的实现 ReflectiveChannelFactory, 它会调用如上channel的无参构造方法实例化 // 重点工作就需要在这个无参构造器中完成,我们接下来看看 channel = channelFactory.newChannel(); // 初始化channel的一些公共参数, 相当于做一些属性的继承, 因为后续它将不再依赖 ServerBootstrap, 它需要有独立自主能力 init(channel); } catch (Throwable t) { if (channel != null) { // channel can be null if newChannel crashed (eg SocketException("too many open files")) channel.unsafe().closeForcibly(); // as the Channel is not registered yet we need to force the usage of the GlobalEventExecutor return new DefaultChannelPromise(channel, GlobalEventExecutor.INSTANCE).setFailure(t); } // as the Channel is not registered yet we need to force the usage of the GlobalEventExecutor return new DefaultChannelPromise(new FailedChannel(), GlobalEventExecutor.INSTANCE).setFailure(t); } // 注册创建好的 channel 到eventLoop中 ChannelFuture regFuture = config().group().register(channel); if (regFuture.cause() != null) { if (channel.isRegistered()) { channel.close(); } else { channel.unsafe().closeForcibly(); } } // If we are here and the promise is not failed, it's one of the following cases: // 1) If we attempted registration from the event loop, the registration has been completed at this point. // i.e. It's safe to attempt bind() or connect() now because the channel has been registered. // 2) If we attempted registration from the other thread, the registration request has been successfully // added to the event loop's task queue for later execution. // i.e. It's safe to attempt bind() or connect() now: // because bind() or connect() will be executed *after* the scheduled registration task is executed // because register(), bind(), and connect() are all bound to the same thread. return regFuture; } // 1. 先看看 NioServerSocketChannel 的构造过程 // io.netty.channel.socket.nio.NioServerSocketChannel#NioServerSocketChannel() /** * Create a new instance */ public NioServerSocketChannel() { // newSocket 简单说就是创建一个本地socket, api调用: SelectorProvider.provider().openServerSocketChannel() // 但此时本 socket 并未和任何端口绑定 this(newSocket(DEFAULT_SELECTOR_PROVIDER)); } /** * Create a new instance using the given {@link ServerSocketChannel}. */ public NioServerSocketChannel(ServerSocketChannel channel) { // 注册 OP_ACCEPT 事件 super(null, channel, SelectionKey.OP_ACCEPT); // 此处的 javaChannel() 实际就是 channel, 这样调用只是为统一吧 // 创建一个新的 socket 传入 NioServerSocketChannelConfig 中 // 主要用于一些 RecvByteBufAllocator 的设置,及channel的保存 config = new NioServerSocketChannelConfig(this, javaChannel().socket()); } // io.netty.channel.nio.AbstractNioChannel#AbstractNioChannel /** * Create a new instance * * @param parent the parent {@link Channel} by which this instance was created. May be {@code null} * @param ch the underlying {@link SelectableChannel} on which it operates * @param readInterestOp the ops to set to receive data from the {@link SelectableChannel} */ protected AbstractNioChannel(Channel parent, SelectableChannel ch, int readInterestOp) { // 先让父类初始化必要的上下文 super(parent); // 保留 channel 信息,并设置非阻塞标识 this.ch = ch; this.readInterestOp = readInterestOp; try { ch.configureBlocking(false); } catch (IOException e) { try { ch.close(); } catch (IOException e2) { if (logger.isWarnEnabled()) { logger.warn( "Failed to close a partially initialized socket.", e2); } } throw new ChannelException("Failed to enter non-blocking mode.", e); } } // io.netty.channel.AbstractChannel#AbstractChannel(io.netty.channel.Channel) /** * Creates a new instance. * * @param parent * the parent of this channel. {@code null} if there's no parent. */ protected AbstractChannel(Channel parent) { // 初始化上下文 this.parent = parent; // DefaultChannelId id = newId(); // NioMessageUnsafe unsafe = newUnsafe(); // new DefaultChannelPipeline(this); // 比较重要,将会初始化 head, tail 节点 pipeline = newChannelPipeline(); } // io.netty.channel.DefaultChannelPipeline#DefaultChannelPipeline protected DefaultChannelPipeline(Channel channel) { this.channel = ObjectUtil.checkNotNull(channel, "channel"); succeededFuture = new SucceededChannelFuture(channel, null); voidPromise = new VoidChannelPromise(channel, true); // 初始化 head, tail tail = new TailContext(this); head = new HeadContext(this); // 构成双向链表 head.next = tail; tail.prev = head; } // 2. 初始化channel, 有个最重要的动作是将 Acceptor 接入到 pipeline 中 // io.netty.bootstrap.ServerBootstrap#init @Override void init(Channel channel) throws Exception { final Map<ChannelOption<?>, Object> options = options0(); // 根据前面的设置, 将各种属性copy过来, 放到 config 字段中 // 同样, 因为 options 和 attrs 都不是线程安全的, 所以都要上锁操作 synchronized (options) { setChannelOptions(channel, options, logger); } final Map<AttributeKey<?>, Object> attrs = attrs0(); synchronized (attrs) { for (Entry<AttributeKey<?>, Object> e: attrs.entrySet()) { @SuppressWarnings("unchecked") AttributeKey<Object> key = (AttributeKey<Object>) e.getKey(); channel.attr(key).set(e.getValue()); } } // 此处的pipeline, 就是在 NioServerSocketChannel 中初始化好head,tail的pipeline ChannelPipeline p = channel.pipeline(); // childGroup 实际就是外部的 workGroup final EventLoopGroup currentChildGroup = childGroup; final ChannelHandler currentChildHandler = childHandler; final Entry<ChannelOption<?>, Object>[] currentChildOptions; final Entry<AttributeKey<?>, Object>[] currentChildAttrs; synchronized (childOptions) { currentChildOptions = childOptions.entrySet().toArray(newOptionArray(childOptions.size())); } synchronized (childAttrs) { currentChildAttrs = childAttrs.entrySet().toArray(newAttrArray(childAttrs.size())); } // 这个就比较重要了, 关联 ServerBootstrapAcceptor // 主动添加一个 initializer, 它将作为第一个被调用的 channelInitializer 存在 // 而 channelInitializer 只会被调用一次 p.addLast(new ChannelInitializer<Channel>() { @Override public void initChannel(final Channel ch) throws Exception { final ChannelPipeline pipeline = ch.pipeline(); ChannelHandler handler = config.handler(); if (handler != null) { pipeline.addLast(handler); } ch.eventLoop().execute(new Runnable() { @Override public void run() { // 添加 Acceptor 到 pipeline 中, 形成一个 head -> ServerBootstrapAcceptor -> tail 的pipeline pipeline.addLast(new ServerBootstrapAcceptor( ch, currentChildGroup, currentChildHandler, currentChildOptions, currentChildAttrs)); } }); } }); // 此操作过后,当前pipeline中,就只有此一handler } 4.2 handler的添加过程 addLast() 看起来只是一个添加元素的过程, 总体来说就是一个双向链表的添加, 但也蛮有意思的, 有兴趣可以戳开详情看看. // io.netty.channel.ChannelHandler @Override public final ChannelPipeline addLast(ChannelHandler... handlers) { return addLast(null, handlers); } // io.netty.channel.DefaultChannelPipeline#addLast(io.netty.util.concurrent.EventExecutorGroup, io.netty.channel.ChannelHandler...) @Override public final ChannelPipeline addLast(EventExecutorGroup executor, ChannelHandler... handlers) { if (handlers == null) { throw new NullPointerException("handlers"); } // 支持同时添加多个 handler for (ChannelHandler h: handlers) { if (h == null) { break; } addLast(executor, null, h); } return this; } // io.netty.channel.DefaultChannelPipeline#addLast(io.netty.util.concurrent.EventExecutorGroup, java.lang.String, io.netty.channel.ChannelHandler) @Override public final ChannelPipeline addLast(EventExecutorGroup group, String name, ChannelHandler handler) { final AbstractChannelHandlerContext newCtx; synchronized (this) { // 重复性检查 @Shareable 参数使用 checkMultiplicity(handler); // 生成一个新的上下文, filterName()将会生成一个唯一的名称, 如 ServerBootstrap$1#0 newCtx = newContext(group, filterName(name, handler), handler); // 将当前ctx添加到链表中 addLast0(newCtx); // If the registered is false it means that the channel was not registered on an eventloop yet. // In this case we add the context to the pipeline and add a task that will call // ChannelHandler.handlerAdded(...) once the channel is registered. if (!registered) { newCtx.setAddPending(); // 未注册情况下, 不会进行下一步了 callHandlerCallbackLater(newCtx, true); return this; } // 而已注册情况下, 则会使用 executor 提交callHandlerAdded0, 即调用 pipeline 的头节点 EventExecutor executor = newCtx.executor(); if (!executor.inEventLoop()) { newCtx.setAddPending(); executor.execute(new Runnable() { @Override public void run() { callHandlerAdded0(newCtx); } }); return this; } } callHandlerAdded0(newCtx); return this; } private AbstractChannelHandlerContext newContext(EventExecutorGroup group, String name, ChannelHandler handler) { return new DefaultChannelHandlerContext(this, childExecutor(group), name, handler); } private void addLast0(AbstractChannelHandlerContext newCtx) { // 一个双向链表保存上下文 AbstractChannelHandlerContext prev = tail.prev; newCtx.prev = prev; newCtx.next = tail; prev.next = newCtx; tail.prev = newCtx; } // 添加ctx到队列尾部 private void callHandlerCallbackLater(AbstractChannelHandlerContext ctx, boolean added) { assert !registered; PendingHandlerCallback task = added ? new PendingHandlerAddedTask(ctx) : new PendingHandlerRemovedTask(ctx); PendingHandlerCallback pending = pendingHandlerCallbackHead; if (pending == null) { pendingHandlerCallbackHead = task; } else { // Find the tail of the linked-list. while (pending.next != null) { pending = pending.next; } pending.next = task; } } // 对每一次添加 handler, 则都会产生一个事件, 通知现有的handler, handlerAdded() private void callHandlerAdded0(final AbstractChannelHandlerContext ctx) { try { // We must call setAddComplete before calling handlerAdded. Otherwise if the handlerAdded method generates // any pipeline events ctx.handler() will miss them because the state will not allow it. ctx.setAddComplete(); ctx.handler().handlerAdded(ctx); } catch (Throwable t) { boolean removed = false; try { remove0(ctx); try { ctx.handler().handlerRemoved(ctx); } finally { ctx.setRemoved(); } removed = true; } catch (Throwable t2) { if (logger.isWarnEnabled()) { logger.warn("Failed to remove a handler: " + ctx.name(), t2); } } if (removed) { fireExceptionCaught(new ChannelPipelineException( ctx.handler().getClass().getName() + ".handlerAdded() has thrown an exception; removed.", t)); } else { fireExceptionCaught(new ChannelPipelineException( ctx.handler().getClass().getName() + ".handlerAdded() has thrown an exception; also failed to remove.", t)); } } } 4.3 注册channel,绑定eventloop线程 经过前面两步, channel已经创建好和初始化好了, 但还没有看到 eventLoop 的影子. 实际上eventloop和channel间就差一个注册了. 也就是前面看到的 ChannelFuture regFuture = config().group().register(channel); 此处的group 即是 bossGroup. // io.netty.channel.MultithreadEventLoopGroup#register(io.netty.channel.Channel) @Override public ChannelFuture register(Channel channel) { // next() 相当于是一个负载均衡器, 会选择出一个合适的 eventloop 出来, 默认是round-robin return next().register(channel); } // io.netty.channel.MultithreadEventLoopGroup#next @Override public EventLoop next() { return (EventLoop) super.next(); } // io.netty.util.concurrent.MultithreadEventExecutorGroup#next @Override public EventExecutor next() { // 使用前面创建的 PowerOfTwoEventExecutorChooser 进行调用 // 默认实现为轮询 return chooser.next(); } // io.netty.util.concurrent.DefaultEventExecutorChooserFactory.PowerOfTwoEventExecutorChooser#next @Override public EventExecutor next() { return executors[idx.getAndIncrement() & executors.length - 1]; } // io.netty.channel.SingleThreadEventLoop#register(io.netty.channel.Channel) @Override public ChannelFuture register(Channel channel) { // 使用 DefaultChannelPromise 封装channel, 再注册到 eventloop 中 return register(new DefaultChannelPromise(channel, this)); } @Override public ChannelFuture register(final ChannelPromise promise) { ObjectUtil.checkNotNull(promise, "promise"); // NioMessageUnsafe promise.channel().unsafe().register(this, promise); return promise; } // io.netty.channel.AbstractChannel.AbstractUnsafe#register @Override public final void register(EventLoop eventLoop, final ChannelPromise promise) { if (eventLoop == null) { throw new NullPointerException("eventLoop"); } if (isRegistered()) { promise.setFailure(new IllegalStateException("registered to an event loop already")); return; } if (!isCompatible(eventLoop)) { promise.setFailure( new IllegalStateException("incompatible event loop type: " + eventLoop.getClass().getName())); return; } AbstractChannel.this.eventLoop = eventLoop; // inEventLoop() 判断当前线程是否在 eventLoop 中 // 判断方式为直接比较 eventloop 线程也当前线程是否是同一个即可 Thread.currentThread() == this.thread; // 核心注册方法 register0() if (eventLoop.inEventLoop()) { register0(promise); } else { // 不在 eventLoop 中, 则异步提交任务给 eventloop 处理 try { eventLoop.execute(new Runnable() { @Override public void run() { register0(promise); } }); } catch (Throwable t) { logger.warn( "Force-closing a channel whose registration task was not accepted by an event loop: {}", AbstractChannel.this, t); closeForcibly(); closeFuture.setClosed(); safeSetFailure(promise, t); } } } // register0() 做真正的注册 // io.netty.channel.AbstractChannel.AbstractUnsafe#register0 private void register0(ChannelPromise promise) { try { // check if the channel is still open as it could be closed in the mean time when the register // call was outside of the eventLoop if (!promise.setUncancellable() || !ensureOpen(promise)) { return; } boolean firstRegistration = neverRegistered; // 具体的注册逻辑由子类实现, NioServerSocketChannel doRegister(); neverRegistered = false; registered = true; // Ensure we call handlerAdded(...) before we actually notify the promise. This is needed as the // user may already fire events through the pipeline in the ChannelFutureListener. // 几个扩展点: fireHandlerAdded() -> fireChannelRegistered() -> fireChannelActive() // part1: fireChannelAdded(), 它将会回调上面的 ServerBootstrapAcceptor 的添加 channelInitializer pipeline.invokeHandlerAddedIfNeeded(); safeSetSuccess(promise); // part2: fireChannelRegistered() pipeline.fireChannelRegistered(); // Only fire a channelActive if the channel has never been registered. This prevents firing // multiple channel actives if the channel is deregistered and re-registered. if (isActive()) { if (firstRegistration) { pipeline.fireChannelActive(); } else if (config().isAutoRead()) { // This channel was registered before and autoRead() is set. This means we need to begin read // again so that we process inbound data. // // See https://github.com/netty/netty/issues/4805 beginRead(); } } } catch (Throwable t) { // Close the channel directly to avoid FD leak. closeForcibly(); closeFuture.setClosed(); safeSetFailure(promise, t); } } // io.netty.channel.nio.AbstractNioChannel#doRegister @Override protected void doRegister() throws Exception { boolean selected = false; // 进行注册即是 JDK 的 ServerSocketChannel.register() 过程 // 即 netty 与 socket 建立了关系连接, ops=0, 代表监听所有读事件 for (;;) { try { // 一直注册直到成功 // 此处 ops=0, 即不关注任何事件哦, 那么前面的 OP_ACCEPT 和这里又是什么关系呢? selectionKey = javaChannel().register(eventLoop().unwrappedSelector(), 0, this); return; } catch (CancelledKeyException e) { if (!selected) { // Force the Selector to select now as the "canceled" SelectionKey may still be // cached and not removed because no Select.select(..) operation was called yet. eventLoop().selectNow(); selected = true; } else { // We forced a select operation on the selector before but the SelectionKey is still cached // for whatever reason. JDK bug ? throw e; } } } } 4.4 ServerBootstrapAcceptor 速览 前面我们看到, 在做 register() 完了之后, netty 会触发一个invokeHandlerAddedIfNeeded, 从而调用fireHandlerAdded. 此时将会触发 handlerAdded() 从而首次调用 ChannelInitializer.initChannel(), 从而将 ServerBootstrapAcceptor 添加到pipeline进来. ServerBootstrapAcceptor 独立做的事情不多,更多是交给父类处理。 ServerBootstrapAcceptor( final Channel channel, EventLoopGroup childGroup, ChannelHandler childHandler, Entry<ChannelOption<?>, Object>[] childOptions, Entry<AttributeKey<?>, Object>[] childAttrs) { this.childGroup = childGroup; this.childHandler = childHandler; this.childOptions = childOptions; this.childAttrs = childAttrs; // Task which is scheduled to re-enable auto-read. // It's important to create this Runnable before we try to submit it as otherwise the URLClassLoader may // not be able to load the class because of the file limit it already reached. // // See https://github.com/netty/netty/issues/1328 // enableAutoReadTask = new Runnable() { @Override public void run() { channel.config().setAutoRead(true); } }; } // ServerBootstrapAcceptor 大部分情况下都是普通的 InboundHandler, 除了 channelRead() 时 // io.netty.bootstrap.ServerBootstrap.ServerBootstrapAcceptor#channelRead @Override @SuppressWarnings("unchecked") public void channelRead(ChannelHandlerContext ctx, Object msg) { final Channel child = (Channel) msg; child.pipeline().addLast(childHandler); setChannelOptions(child, childOptions, logger); for (Entry<AttributeKey<?>, Object> e: childAttrs) { child.attr((AttributeKey<Object>) e.getKey()).set(e.getValue()); } try { // 它会向 childGroup 中提交channel过去, 从而使用 childGroup 产生作用 childGroup.register(child).addListener(new ChannelFutureListener() { @Override public void operationComplete(ChannelFuture future) throws Exception { if (!future.isSuccess()) { forceClose(child, future.cause()); } } }); } catch (Throwable t) { forceClose(child, t); } } 4.5 端口的绑定 doBind0 经过前面的channel的创建,初始化, Acceptor 的添加到handlerAdded(), 整个pipeline已经work起来了. 然后netty会回调之前添加好的 listeners, 其中一个便是 doBind0(); // 回顾下: ... // Registration future is almost always fulfilled already, but just in case it's not. final PendingRegistrationPromise promise = new PendingRegistrationPromise(channel); regFuture.addListener(new ChannelFutureListener() { @Override public void operationComplete(ChannelFuture future) throws Exception { Throwable cause = future.cause(); if (cause != null) { // Registration on the EventLoop failed so fail the ChannelPromise directly to not cause an // IllegalStateException once we try to access the EventLoop of the Channel. promise.setFailure(cause); } else { // Registration was successful, so set the correct executor to use. // See https://github.com/netty/netty/issues/2586 promise.registered(); doBind0(regFuture, channel, localAddress, promise); } } }); ... // io.netty.bootstrap.AbstractBootstrap#doBind0 private static void doBind0( final ChannelFuture regFuture, final Channel channel, final SocketAddress localAddress, final ChannelPromise promise) { // This method is invoked before channelRegistered() is triggered. Give user handlers a chance to set up // the pipeline in its channelRegistered() implementation. // 这还是一个异步过程 channel.eventLoop().execute(new Runnable() { @Override public void run() { // channel.bind(), channel 与 端口绑定 if (regFuture.isSuccess()) { channel.bind(localAddress, promise).addListener(ChannelFutureListener.CLOSE_ON_FAILURE); } else { promise.setFailure(regFuture.cause()); } } }); } // io.netty.channel.AbstractChannel#bind(java.net.SocketAddress, io.netty.channel.ChannelPromise) @Override public ChannelFuture bind(SocketAddress localAddress, ChannelPromise promise) { // bind() 被当作一个普通的出站事件, 在pipeline中被传递 return pipeline.bind(localAddress, promise); } // io.netty.channel.DefaultChannelPipeline#bind(java.net.SocketAddress, io.netty.channel.ChannelPromise) @Override public final ChannelFuture bind(SocketAddress localAddress, ChannelPromise promise) { // 从tail开始传递 return tail.bind(localAddress, promise); } // io.netty.channel.AbstractChannelHandlerContext#bind(java.net.SocketAddress, io.netty.channel.ChannelPromise) @Override public ChannelFuture bind(final SocketAddress localAddress, final ChannelPromise promise) { if (localAddress == null) { throw new NullPointerException("localAddress"); } if (isNotValidPromise(promise, false)) { // cancelled return promise; } // 同样是一个pipeline式调用, bind() 是一个出站事件, 所以查找 outbound // 最终会调到 DefaultChannelPipeline 中 // netty的pipeline机制就体现在这里, 它会一直查找可用的handler, 然后执行它, 直到结束 final AbstractChannelHandlerContext next = findContextOutbound(); // 获取其绑定的 executor EventExecutor executor = next.executor(); if (executor.inEventLoop()) { next.invokeBind(localAddress, promise); } else { safeExecute(executor, new Runnable() { @Override public void run() { next.invokeBind(localAddress, promise); } }, promise, null); } return promise; } // ------------------------------------------------------------------------- // 出入站handler的查找实现, 非常简单, 却很有效 (该方法在 AbstractChannelHandlerContext 中实现,被所有handler通用) // io.netty.channel.AbstractChannelHandlerContext#findContextInbound private AbstractChannelHandlerContext findContextInbound() { // 以当前节点作为起点开始查找, 取第一个入站handler返回, 没有则说明 pipeline 已结束 AbstractChannelHandlerContext ctx = this; do { ctx = ctx.next; } while (!ctx.inbound); return ctx; } // io.netty.channel.AbstractChannelHandlerContext#findContextOutbound private AbstractChannelHandlerContext findContextOutbound() { // 以当前节点作为起点开始查找, 取第一个出站handler返回, 没有则说明 pipeline 已结束 AbstractChannelHandlerContext ctx = this; do { ctx = ctx.prev; } while (!ctx.outbound); return ctx; } // ------------------------------------------------------------------------- // io.netty.channel.AbstractChannelHandlerContext#invokeBind private void invokeBind(SocketAddress localAddress, ChannelPromise promise) { if (invokeHandler()) { try { ((ChannelOutboundHandler) handler()).bind(this, localAddress, promise); } catch (Throwable t) { notifyOutboundHandlerException(t, promise); } } else { bind(localAddress, promise); } } // 最终传递到 HeadContext 中进行处理 // io.netty.channel.DefaultChannelPipeline.HeadContext#bind @Override public void bind( ChannelHandlerContext ctx, SocketAddress localAddress, ChannelPromise promise) throws Exception { // unsafe 处理bind() 操作 unsafe.bind(localAddress, promise); } // io.netty.channel.AbstractChannel.AbstractUnsafe#bind @Override public final void bind(final SocketAddress localAddress, final ChannelPromise promise) { assertEventLoop(); if (!promise.setUncancellable() || !ensureOpen(promise)) { return; } // See: https://github.com/netty/netty/issues/576 if (Boolean.TRUE.equals(config().getOption(ChannelOption.SO_BROADCAST)) && localAddress instanceof InetSocketAddress && !((InetSocketAddress) localAddress).getAddress().isAnyLocalAddress() && !PlatformDependent.isWindows() && !PlatformDependent.maybeSuperUser()) { // Warn a user about the fact that a non-root user can't receive a // broadcast packet on *nix if the socket is bound on non-wildcard address. logger.warn( "A non-root user can't receive a broadcast packet if the socket " + "is not bound to a wildcard address; binding to a non-wildcard " + "address (" + localAddress + ") anyway as requested."); } boolean wasActive = isActive(); try { // 这里会调用 jdk 的ServerSocketChannel接口, 实现真正的端口绑定 // 至此, 服务对外可见 doBind(localAddress); } catch (Throwable t) { safeSetFailure(promise, t); closeIfClosed(); return; } // 判断是否是首次创建 channel, 如果是, 则调用 fireChannelActive() 传播channelActive事件 if (!wasActive && isActive()) { // 这将会被稍后执行 invokeLater(new Runnable() { @Override public void run() { pipeline.fireChannelActive(); } }); } // 触发一些通知什么的, 结束了 safeSetSuccess(promise); } // 最终的bind(), 是通过 jdk 底层的 serverSocketChannel 开启socket监听 // io.netty.channel.socket.nio.NioServerSocketChannel#doBind @Override protected void doBind(SocketAddress localAddress) throws Exception { if (PlatformDependent.javaVersion() >= 7) { // 调用 serverSocketChannel bind() 方法,开启socket监听 javaChannel().bind(localAddress, config.getBacklog()); } else { javaChannel().socket().bind(localAddress, config.getBacklog()); } } 至此, bind 工作总算是完成了.我们来总结下它的主要工作: 1. 初始化一个channel, 根据设置里来, 我们使用 NioServerSocketChannel; 2. 过继现有的配置项给到channel; 3. 将channel与eventloop绑定做注册, 添加 ServerBootstrapAcceptor 到 pipeline 中; 4. 绑定完成后, 通知现有的handler, 触发系列事件: fireHandlerAdded() -> fireChannelRegistered() -> fireChannelActive(); 5. 而bind()则作为一个出站事件, 被处理, 最终调用 jdk的ServerSocketChannel.register() 完成端口的开启; 不过有一点需要注意, 在这个过程中, 只有 bossGroup 起作用, 所有的 workGroup 都还在待命中. 我们目前看到的 pipeline 是这样的: head -> Acceptor -> tail; 讲了这么多, 有一种绕了一大圈的感觉有木有, 如果你自己直接使用nio写, 估计10行代码都不要就搞定了. 尴尬! 5. netty eventloop 主循环 evenloop是netty的重要概念, 但在前面我们并未细讲这玩意如何起作用(仅看过其创建过程而已), 不过这并不意味着它还没起作用, 而是我们暂时忽略了它. 每次要执行任务时, 总是会调用 eventloop().execute(...), 实际上这就是 eventloop的入口: // io.netty.util.concurrent.SingleThreadEventExecutor#execute @Override public void execute(Runnable task) { // execute 在线程池中, 是一个异步任务的提交方法, eventloop中同样也一样 // 但是大部分情况下只是添加队列, 因为 eventloop 是单线程的 if (task == null) { throw new NullPointerException("task"); } // 向eventLoop队列中添加task boolean inEventLoop = inEventLoop(); addTask(task); // 如果自身就是运行在 eventloop 环境中, 添加完task后则不再做更多的事 if (!inEventLoop) { // 如果不是在eventLoop线程中,则都会尝试创建新线程运行, 但实际会重新检测线程是否创建 startThread(); if (isShutdown() && removeTask(task)) { reject(); } } if (!addTaskWakesUp && wakesUpForTask(task)) { wakeup(inEventLoop); } } // io.netty.util.concurrent.SingleThreadEventExecutor#addTask /** * Add a task to the task queue, or throws a {@link RejectedExecutionException} if this instance was shutdown * before. */ protected void addTask(Runnable task) { if (task == null) { throw new NullPointerException("task"); } // taskQueue = MpscUnsafeUnboundedArrayQueue, 基于Unsafe 和 cas 实现的线程安全的队列 if (!offerTask(task)) { // 添加失败,则走拒绝策略 reject(task); } } // startThread, 看起来是开启线程的意思, 却又不太一样 private void startThread() { // 所以实际上只会创建一次线程 if (state == ST_NOT_STARTED) { // 抢到锁的线程才能调用start()方法 if (STATE_UPDATER.compareAndSet(this, ST_NOT_STARTED, ST_STARTED)) { try { doStartThread(); } catch (Throwable cause) { STATE_UPDATER.set(this, ST_NOT_STARTED); PlatformDependent.throwException(cause); } } } } // 开启eventLoop的线程 // io.netty.util.concurrent.SingleThreadEventExecutor#doStartThread private void doStartThread() { assert thread == null; // 它并不是简单的thread.start() executor.execute(new Runnable() { @Override public void run() { thread = Thread.currentThread(); if (interrupted) { thread.interrupt(); } boolean success = false; updateLastExecutionTime(); try { // 核心方法,由 SingleThreadEventExecutor.run() 实现 // 当然是由具体的executor具体实现了, 此文为 NioEventLoop.run() SingleThreadEventExecutor.this.run(); success = true; } catch (Throwable t) { logger.warn("Unexpected exception from an event executor: ", t); } finally { // 线程池关闭,优雅停机 ... } } }); } 核心: 事件循环主框架, 既然是事件循环,则其必然是不会退出的。 // io.netty.channel.nio.NioEventLoop#run @Override protected void run() { // 一个死循环检测任务, 这就 eventloop 的大杀器哦 for (;;) { try { switch (selectStrategy.calculateStrategy(selectNowSupplier, hasTasks())) { case SelectStrategy.CONTINUE: continue; // 有任务时执行任务, 否则阻塞等待网络事件, 或被唤醒 case SelectStrategy.SELECT: // select.select(), 带超时限制 select(wakenUp.getAndSet(false)); // 'wakenUp.compareAndSet(false, true)' is always evaluated // before calling 'selector.wakeup()' to reduce the wake-up // overhead. (Selector.wakeup() is an expensive operation.) // // However, there is a race condition in this approach. // The race condition is triggered when 'wakenUp' is set to // true too early. // // 'wakenUp' is set to true too early if: // 1) Selector is waken up between 'wakenUp.set(false)' and // 'selector.select(...)'. (BAD) // 2) Selector is waken up between 'selector.select(...)' and // 'if (wakenUp.get()) { ... }'. (OK) // // In the first case, 'wakenUp' is set to true and the // following 'selector.select(...)' will wake up immediately. // Until 'wakenUp' is set to false again in the next round, // 'wakenUp.compareAndSet(false, true)' will fail, and therefore // any attempt to wake up the Selector will fail, too, causing // the following 'selector.select(...)' call to block // unnecessarily. // // To fix this problem, we wake up the selector again if wakenUp // is true immediately after selector.select(...). // It is inefficient in that it wakes up the selector for both // the first case (BAD - wake-up required) and the second case // (OK - no wake-up required). if (wakenUp.get()) { selector.wakeup(); } // fall through default: } cancelledKeys = 0; needsToSelectAgain = false; // ioRatio 为io操作的占比, 和运行任务相比, 默认为 50:50 final int ioRatio = this.ioRatio; if (ioRatio == 100) { try { // step1. 运行io操作 processSelectedKeys(); } finally { // Ensure we always run tasks. // step2. 运行task任务 runAllTasks(); } } else { final long ioStartTime = System.nanoTime(); try { processSelectedKeys(); } finally { // Ensure we always run tasks. final long ioTime = System.nanoTime() - ioStartTime; // 运行任务的最长时间 runAllTasks(ioTime * (100 - ioRatio) / ioRatio); } } } catch (Throwable t) { handleLoopException(t); } // Always handle shutdown even if the loop processing threw an exception. try { if (isShuttingDown()) { closeAll(); if (confirmShutdown()) { return; } } } catch (Throwable t) { handleLoopException(t); } } } // select, 事件循环的依据 private void select(boolean oldWakenUp) throws IOException { Selector selector = this.selector; try { int selectCnt = 0; long currentTimeNanos = System.nanoTime(); // 带超时限制, 默认最大超时1s, 但当有延时任务处理时, 以它为标准 long selectDeadLineNanos = currentTimeNanos + delayNanos(currentTimeNanos); for (;;) { long timeoutMillis = (selectDeadLineNanos - currentTimeNanos + 500000L) / 1000000L; if (timeoutMillis <= 0) { // 超时则立即返回 if (selectCnt == 0) { selector.selectNow(); selectCnt = 1; } break; } // If a task was submitted when wakenUp value was true, the task didn't get a chance to call // Selector#wakeup. So we need to check task queue again before executing select operation. // If we don't, the task might be pended until select operation was timed out. // It might be pended until idle timeout if IdleStateHandler existed in pipeline. if (hasTasks() && wakenUp.compareAndSet(false, true)) { selector.selectNow(); selectCnt = 1; break; } int selectedKeys = selector.select(timeoutMillis); selectCnt ++; if (selectedKeys != 0 || oldWakenUp || wakenUp.get() || hasTasks() || hasScheduledTasks()) { // - Selected something, // - waken up by user, or // - the task queue has a pending task. // - a scheduled task is ready for processing break; } if (Thread.interrupted()) { // Thread was interrupted so reset selected keys and break so we not run into a busy loop. // As this is most likely a bug in the handler of the user or it's client library we will // also log it. // // See https://github.com/netty/netty/issues/2426 if (logger.isDebugEnabled()) { logger.debug("Selector.select() returned prematurely because " + "Thread.currentThread().interrupt() was called. Use " + "NioEventLoop.shutdownGracefully() to shutdown the NioEventLoop."); } selectCnt = 1; break; } long time = System.nanoTime(); if (time - TimeUnit.MILLISECONDS.toNanos(timeoutMillis) >= currentTimeNanos) { // timeoutMillis elapsed without anything selected. selectCnt = 1; } else if (SELECTOR_AUTO_REBUILD_THRESHOLD > 0 && selectCnt >= SELECTOR_AUTO_REBUILD_THRESHOLD) { // The selector returned prematurely many times in a row. // Rebuild the selector to work around the problem. logger.warn( "Selector.select() returned prematurely {} times in a row; rebuilding Selector {}.", selectCnt, selector); rebuildSelector(); selector = this.selector; // Select again to populate selectedKeys. selector.selectNow(); selectCnt = 1; break; } currentTimeNanos = time; } if (selectCnt > MIN_PREMATURE_SELECTOR_RETURNS) { if (logger.isDebugEnabled()) { logger.debug("Selector.select() returned prematurely {} times in a row for Selector {}.", selectCnt - 1, selector); } } } catch (CancelledKeyException e) { if (logger.isDebugEnabled()) { logger.debug(CancelledKeyException.class.getSimpleName() + " raised by a Selector {} - JDK bug?", selector, e); } // Harmless exception - log anyway } } 反正整体就是这样了, 循环检测select, 运行io事件及execute task. 有了这个 eventloop, 整体server就可以run起来了, 不管是有外部请求进来, 还是有内部任务提交, 都将被eventloop执行. 不过还有一点未澄清的: 前面在做channel.register()时传递了一个 ops=0, 那它是如何监听新连接事件的呢? 实际上它是在注册激活完成之后, 再进行了一个read()的操作, 重新将 OP_ACCEPT 添加到 selectionKey 中了.(没错,底层永远没那么多花招) // io.netty.channel.DefaultChannelPipeline.HeadContext#channelActive @Override public void channelActive(ChannelHandlerContext ctx) throws Exception { ctx.fireChannelActive(); // 会触发 read() 流程, 修改 selectionKey 的 ops 标志位 readIfIsAutoRead(); } ... // io.netty.channel.AbstractChannel.AbstractUnsafe#beginRead @Override public final void beginRead() { assertEventLoop(); if (!isActive()) { return; } try { doBeginRead(); } catch (final Exception e) { invokeLater(new Runnable() { @Override public void run() { pipeline.fireExceptionCaught(e); } }); close(voidPromise()); } } // io.netty.channel.nio.AbstractNioMessageChannel#doBeginRead @Override protected void doBeginRead() throws Exception { if (inputShutdown) { return; } super.doBeginRead(); } // io.netty.channel.nio.AbstractNioChannel#doBeginRead @Override protected void doBeginRead() throws Exception { // Channel.read() or ChannelHandlerContext.read() was called final SelectionKey selectionKey = this.selectionKey; if (!selectionKey.isValid()) { return; } readPending = true; final int interestOps = selectionKey.interestOps(); if ((interestOps & readInterestOp) == 0) { // readInterestOp, 即是前面设置的 OP_ACCEPT selectionKey.interestOps(interestOps | readInterestOp); } } 本文有点长了, 留点东西下篇继续: io事件如何处理? 任务如何执行? 看完三件事❤️ 如果你觉得这篇内容对你还蛮有帮助,我想邀请你帮我三个小忙: 点赞,转发,有你们的 『点赞和评论』,才是我创造的动力。 关注公众号 『java烂猪皮』,不定期分享原创知识。 同时可以期待后续文章ing🚀 作者:等你归去来 出处:https://www.cnblogs.com/yougewe/p/13415440.html
优秀的个人博客,低调大师

Java 8 Stream原理解析

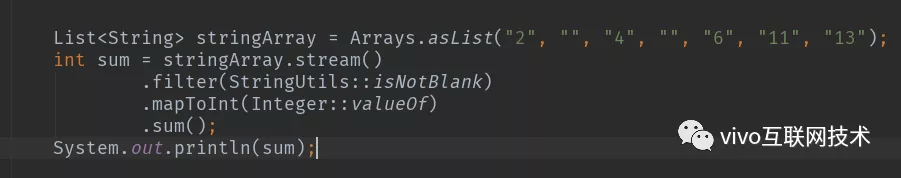
说起 Java 8,我们知道 Java 8 大改动之一就是增加函数式编程,而 Stream API 便是函数编程的主角,Stream API 是一种流式的处理数据风格,也就是将要处理的数据当作流,在管道中进行传输,并在管道中的每个节点对数据进行处理,如过滤、排序、转换等。 首先我们先看一个使用Stream API的示例,具体代码如下: code1 Stream example 这是个很简单的一个Stream使用例子,我们过滤掉空字符串后,转成int类型并计算出最大值,这其中包括了三个操作:filter、mapToInt、sum。相信大多数人再刚使用Stream API的时候都会有个疑问,Stream是指怎么实现的,是每一次函数调用就执行一次迭代吗?答案肯定是否,因为如果真的是每一次函数调用就执行一次迭代,这个效率是很难接受的,Stream也不会那么受欢迎。 其实Stream内部是通过流水线(Pipeline)的方式来实现的,基本思想是在迭代的时候顺着流水线尽可能的执行更多的操作,从而避免多次迭代。为了对Stream的操作有更清晰的认识,我们汇总了Stream的所有操作。 从上表可以看出Stream将所有操作分为两类:中间操作和终止操作。其中中间操作分为无状态和有状态,终止操作分为非短路操作和短路操作,下面是针对这几个操作的含义说明: 1、中间操作:中间操作只是一种标记,只有结束操作才会触发实际计算 无状态:指元素的处理不受前面元素的影响; 有状态:有状态的中间操作必须等到所有元素处理之后才知道最终结果,比如排序是有状态操作,在读取所有元素之前并不能确定排序结果。 2、终止操作:顾名思义,就是得出最后计算结果的操作 短路操作:指不用处理全部元素就可以返回结果; 非短路操作:指必须处理所有元素才能得到最终结果。 Stream流水线解决方案 通过上面的介绍,我们了解到Stream在执行中间操作时仅仅是记录,当用户调用终止操作时,会在一个迭代里将已经记录的操作顺着流水线全部执行掉。沿着这个思路,有几个问题需要解决: 用户的操作如何记录? 操作如何叠加? 叠加之后的操作如何执行? 1、操作如何记录 图1-1 关于操作如何记录,在JDK源码注释中多次用(操作)stage来标识用户的每一次操作,而通常情况下Stream的操作又需要一个回调函数,所以一个完整的操作是由数据来源、操作、回调函数组成的三元组来表示。而在具体实现中,使用实例化的ReferencePipeline来表示,即图1-1中的Head、StatelessOp、StatefulOp的实例。接下来我们来看下Stream几个常用方法的源码。 code2 Collection.Stream() code3StreamSupport.stream() code4 ReferencePipeline.map() 从上面源码中可以看出来,我们调用stream()方法时最终会创建一个Head实例来表示流操作的头,当调用map()方法时则会创建无状态的中间操作实例StatelessOp,同样调用其他操作对应的方法也会生成一个ReferencePipeline实例,在这里就不一一列举。在用户调用一系列操作后,最终会形成一个双向链表,如下图所示: 图1-2 2、操作如何叠加 上面我们说明了Stream是通过stage记录操作,但stage只保存当前操作,它并不知道下个stage如何操作,需要什么操作。所以要执行的话还需要某种协议将各个stage关联起来。jdk中就是使用Slink接口来实现的,Slink接口定义begin()、end()、cancellationRequested()、accept()四个方法,如下表所示。 往回看code3 ReferencePipeline.map()的方法,我们会发现我们在创建一个ReferencePipeline实例的时候,需要重写opWrapSink方法来生成对应Sink实例。而且通过阅读源码会发现常用的操作都会创建一个ChainedReference实例。我们可以看下code5 ChainedReference抽象类的源码实现,因为ChainedReference只是个抽象实现,不携带具体操作的特性,所以是更能体现作者的设计理念。 通过查看源码可以发现ChainedReference会持有下一个操作的Slink,并在调用begin、end、cancellationRequested方法会调用下一个操作的Slink的相应方法,以此来达到叠加的效果。 code5ChainedReference 3、叠加之后的操作如何执行 Sink完美封装了Stream每一步操作,并给出了[处理->转发]的模式来叠加操作。这一连串的齿轮已经咬合,就差最后一步拨动齿轮启动执行。是什么启动这一连串的操作呢?也许你已经想到了启动的原始动力就是结束操作(Terminal Operation),一旦调用某个结束操作,就会触发整个流水线的执行。 结束操作之后不能再有别的操作,所以结束操作不会创建新的流水线阶段(Stage),直观的说就是流水线的链表不会在往后延伸了。结束操作会创建一个包装了自己操作的Sink,这也是流水线中最后一个Sink,这个Sink只需要处理数据而不需要将结果传递给下游的Sink(因为没有下游)。对于Sink的[处理->转发]模型,结束操作的Sink就是调用链的出口。 我们再来考察一下上游的Sink是如何找到下游Sink的。一种可选的方案是在PipelineHelper中设置一个Sink字段,在流水线中找到下游Stage并访问Sink字段即可。但Stream类库的设计者没有这么做,而是设置了一个Sink AbstractPipeline.opWrapSink(int flags, Sink downstream)方法来得到Sink,该方法的作用是返回一个新的包含了当前Stage代表的操作以及能够将结果传递给downstream的Sink对象。为什么要产生一个新对象而不是返回一个Sink字段?这是因为使用opWrapSink()可以将当前操作与下游Sink(上文中的downstream参数)结合成新Sink。试想只要从流水线的最后一个Stage开始,不断调用上一个Stage的opWrapSink()方法直到最开始(不包括stage0,因为stage0代表数据源,不包含操作),就可以得到一个代表了流水线上所有操作的Sink,用代码表示就是这样: code6AbstractPipeline.wrapSink 现在流水线上从开始到结束的所有的操作都被包装到了一个Sink里,执行这个Sink就相当于执行整个流水线,执行Sink的代码如下: code7AbstractPipeline.copyInto 上述代码首先调用wrappedSink.begin()方法告诉Sink数据即将到来,然后调用spliterator.forEachRemaining()方法对数据进行迭代,最后调用wrappedSink.end()方法通知Sink数据处理结束。逻辑如此清晰。 作者:Huang Rongpeng

优秀的个人博客,低调大师

Atomikos事务恢复流程源码解析

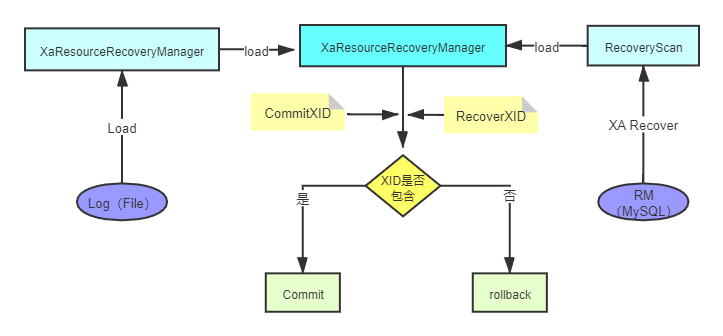
Atomikos-XA事务恢复 说事务恢复流程之前,我们来讨论下,会啥会出现事务恢复?XA二阶段提交协议不是强一致性的吗?要解答这个问题,我们就要来看看XA二阶段协议有什么问题? 问题一 :单点故障 由于协调者的重要性,一旦协调者TM发生故障。参与者RM会一直阻塞下去。尤其在第二阶段,协调者发生故障,那么所有的参与者还都处于锁定事务资源的状态中,而无法继续完成事务操作。(如果是协调者挂掉,可以重新选举一个协调者,但是无法解决因为协调者宕机导致的参与者处于阻塞状态的问题) 问题二 :数据不一致 数据不一致。在二阶段提交的阶段二中,当协调者向参与者发送commit请求之后,发生了局部网络异常或者在发送commit请求过程中协调者发生了故障,这回导致只有一部分参与者接受到了commit请求。而在这部分参与者接到commit请求之后就会执行commit操作。但是其他部分未接到commit请求的机器则无法执行事务提交。于是整个分布式系统便出现了数据不一致性的现象。 如何解决? 解决的方案简单,就是我们在事务的操作的每一步,我们都需要对事务状态的日志进行人为的记录,我们可以把日志记录存储在我们想存储的地方,可以是本地存储,也可以中心化的存储。atomikos的开源版本,我们之前也分析了,它是使用内存 + file的方式,存储在本地,这样的话,如果在一个集群系统里面,如果有节点宕机,日志又存储在本地,所以事务不能及时的恢复(需要重启服务)。 Atomikos 多场景下事务恢复。 Atomikos 提供了二种方式,来应对不同场景下的异常情况。 场景一: 服务节点不宕机,因为其他的原因,产生需要事务恢复的情况。 这个时候才要定时任务进行恢复。 具体的代码 com.atomikos.icatch.imp.TransactionServiceImp.init() 方法,会初始化一个定时任务,进行事务的恢复。 public synchronized void init ( Properties properties ) throws SysException { shutdownInProgress_ = false; control_ = new com.atomikos.icatch.admin.imp.LogControlImp ( (AdminLog) this.recoveryLog ); ConfigProperties configProperties = new ConfigProperties(properties); long recoveryDelay = configProperties.getRecoveryDelay(); recoveryTimer = new PooledAlarmTimer(recoveryDelay); recoveryTimer.addAlarmTimerListener(new AlarmTimerListener() { @Override public void alarm(AlarmTimer timer) { //进行事务恢复 performRecovery(); } }); TaskManager.SINGLETON.executeTask(recoveryTimer); initialized_ = true; } 最终会进入com.atomikos.datasource.xa.XATransactionalResource.recover() 方法。 public void recover() { XaResourceRecoveryManager xaResourceRecoveryManager = XaResourceRecoveryManager.getInstance(); if (xaResourceRecoveryManager != null) { //null for LogCloud recovery try { xaResourceRecoveryManager.recover(getXAResource()); } catch (Exception e) { refreshXAResource(); //cf case 156968 } } } 场景二: 当服务节点宕机重启动过程中进行事务的恢复。具体实现在com.atomikos.datasource.xa.XATransactionalResource.setRecoveryService()方法里面 @Override public void setRecoveryService ( RecoveryService recoveryService ) throws ResourceException { if ( recoveryService != null ) { if ( LOGGER.isTraceEnabled() ) LOGGER.logTrace ( "Installing recovery service on resource " + getName () ); this.branchIdentifier=recoveryService.getName(); //进行事务恢复 recover(); } } com.atomikos.datasource.xa.XATransactionalResource.recover() 流程详解。 主代码: public void recover(XAResource xaResource) throws XAException { // 根据XA recovery 协议获取 xid List<XID> xidsToRecover = retrievePreparedXidsFromXaResource(xaResource); Collection<XID> xidsToCommit; try { // xid 与日志记录的xid进行匹配 xidsToCommit = retrieveExpiredCommittingXidsFromLog(); for (XID xid : xidsToRecover) { if (xidsToCommit.contains(xid)) { //执行 XA commit xid 进行提交 replayCommit(xid, xaResource); } else { attemptPresumedAbort(xid, xaResource); } } } catch (LogException couldNotRetrieveCommittingXids) { LOGGER.logWarning("Transient error while recovering - will retry later...", couldNotRetrieveCommittingXids); } } 我们来看一下如何根据 XA recovery 协议获取RM端存储的xid。 进入方法 retrievePreparedXidsFromXaResource(xaResource), 最后进入 com.atomikos.datasource.xa.RecoveryScan.recoverXids()方法。 public static List<XID> recoverXids(XAResource xaResource, XidSelector selector) throws XAException { List<XID> ret = new ArrayList<XID>(); boolean done = false; int flags = XAResource.TMSTARTRSCAN; Xid[] xidsFromLastScan = null; List<XID> allRecoveredXidsSoFar = new ArrayList<XID>(); do { xidsFromLastScan = xaResource.recover(flags); flags = XAResource.TMNOFLAGS; done = (xidsFromLastScan == null || xidsFromLastScan.length == 0); if (!done) { // TEMPTATIVELY SET done TO TRUE // TO TOLERATE ORACLE 8.1.7 INFINITE // LOOP (ALWAYS RETURNS SAME RECOVER // SET). IF A NEW SET OF XIDS IS RETURNED // THEN done WILL BE RESET TO FALSE done = true; for ( int i = 0; i < xidsFromLastScan.length; i++ ) { XID xid = new XID ( xidsFromLastScan[i] ); // our own XID implements equals and hashCode properly if (!allRecoveredXidsSoFar.contains(xid)) { // a new xid is returned -> we can not be in a recovery loop -> go on allRecoveredXidsSoFar.add(xid); done = false; if (selector.selects(xid)) { ret.add(xid); } } } } } while (!done); return ret; } 我们重点关注xidsFromLastScan = xaResource.recover(flags); 这个方法,如果我们使用MySQL,那么久会进入 MysqlXAConnection.recover()方法。执行 XA recovery xid 语句来获取 xid。 protected static Xid[] recover(Connection c, int flag) throws XAException { /* * The XA RECOVER statement returns information for those XA transactions on the MySQL server that are in the PREPARED state. (See Section 13.4.7.2, ???XA * Transaction States???.) The output includes a row for each such XA transaction on the server, regardless of which client started it. * * XA RECOVER output rows look like this (for an example xid value consisting of the parts 'abc', 'def', and 7): * * mysql> XA RECOVER; * +----------+--------------+--------------+--------+ * | formatID | gtrid_length | bqual_length | data | * +----------+--------------+--------------+--------+ * | 7 | 3 | 3 | abcdef | * +----------+--------------+--------------+--------+ * * The output columns have the following meanings: * * formatID is the formatID part of the transaction xid * gtrid_length is the length in bytes of the gtrid part of the xid * bqual_length is the length in bytes of the bqual part of the xid * data is the concatenation of the gtrid and bqual parts of the xid */ boolean startRscan = ((flag & TMSTARTRSCAN) > 0); boolean endRscan = ((flag & TMENDRSCAN) > 0); if (!startRscan && !endRscan && flag != TMNOFLAGS) { throw new MysqlXAException(XAException.XAER_INVAL, Messages.getString("MysqlXAConnection.001"), null); } // // We return all recovered XIDs at once, so if not TMSTARTRSCAN, return no new XIDs // // We don't attempt to maintain state to check for TMNOFLAGS "outside" of a scan // if (!startRscan) { return new Xid[0]; } ResultSet rs = null; Statement stmt = null; List<MysqlXid> recoveredXidList = new ArrayList<MysqlXid>(); try { // TODO: Cache this for lifetime of XAConnection stmt = c.createStatement(); rs = stmt.executeQuery("XA RECOVER"); while (rs.next()) { final int formatId = rs.getInt(1); int gtridLength = rs.getInt(2); int bqualLength = rs.getInt(3); byte[] gtridAndBqual = rs.getBytes(4); final byte[] gtrid = new byte[gtridLength]; final byte[] bqual = new byte[bqualLength]; if (gtridAndBqual.length != (gtridLength + bqualLength)) { throw new MysqlXAException(XAException.XA_RBPROTO, Messages.getString("MysqlXAConnection.002"), null); } System.arraycopy(gtridAndBqual, 0, gtrid, 0, gtridLength); System.arraycopy(gtridAndBqual, gtridLength, bqual, 0, bqualLength); recoveredXidList.add(new MysqlXid(gtrid, bqual, formatId)); } } catch (SQLException sqlEx) { throw mapXAExceptionFromSQLException(sqlEx); } finally { if (rs != null) { try { rs.close(); } catch (SQLException sqlEx) { throw mapXAExceptionFromSQLException(sqlEx); } } if (stmt != null) { try { stmt.close(); } catch (SQLException sqlEx) { throw mapXAExceptionFromSQLException(sqlEx); } } } int numXids = recoveredXidList.size(); Xid[] asXids = new Xid[numXids]; Object[] asObjects = recoveredXidList.toArray(); for (int i = 0; i < numXids; i++) { asXids[i] = (Xid) asObjects[i]; } return asXids; } 这里要注意如果Mysql的版本 <5.7.7 ,则不会有任何数据,在以后的版本中Mysql进行了修复,因此如果我们想要使用MySQL充当RM,版本必须 >= 5.7.7 ,原因是: MySQL 5.6版本在客户端退出的时候,自动把已经prepare的事务回滚了,那么MySQL为什么要这样做?这主要取决于MySQL的内部实现,MySQL 5.7以前的版本,对于prepare的事务,MySQL是不会记录binlog的(官方说是减少fsync,起到了优化的作用)。只有当分布式事务提交的时候才会把前面的操作写入binlog信息,所以对于binlog来说,分布式事务与普通的事务没有区别,而prepare以前的操作信息都保存在连接的IO_CACHE中,如果这个时候客户端退出了,以前的binlog信息都会被丢失,再次重连后允许提交的话,会造成Binlog丢失,从而造成主从数据的不一致,所以官方在客户端退出的时候直接把已经prepare的事务都回滚了! 回到主线再从自己记录的事务日志里面获取XID Collection<XID> xidsToCommit = retrieveExpiredCommittingXidsFromLog(); 我们来看下获取事务日志里面的XID的retrieveExpiredCommittingXidsFromLog()方法。 然后进入com.atomikos.recovery.imp.RecoveryLogImp.getCommittingParticipants()方法。 public Collection<ParticipantLogEntry> getCommittingParticipants() throws LogReadException { Collection<ParticipantLogEntry> committingParticipants = new HashSet<ParticipantLogEntry>(); Collection<CoordinatorLogEntry> committingCoordinatorLogEntries = repository.findAllCommittingCoordinatorLogEntries(); for (CoordinatorLogEntry coordinatorLogEntry : committingCoordinatorLogEntries) { for (ParticipantLogEntry participantLogEntry : coordinatorLogEntry.participants) { committingParticipants.add(participantLogEntry); } } return committingParticipants; } 到这里我们来简单介绍一下,事务日志的存储结构。首先是 CoordinatorLogEntry,这是一次XA事务的所有信息实体类。 public class CoordinatorLogEntry implements Serializable { //全局事务id public final String id; //是否已经提交 public final boolean wasCommitted; /** * Only for subtransactions, null otherwise. */ public final String superiorCoordinatorId; //参与者集合 public final ParticipantLogEntry[] participants; } 再来看一下参与者实体类 ParticipantLogEntry : public class ParticipantLogEntry implements Serializable { private static final long serialVersionUID = 1728296701394899871L; /** * The ID of the global transaction as known by the transaction core. */ public final String coordinatorId; /** * Identifies the participant within the global transaction. */ public final String uri; /** * When does this participant expire (expressed in millis since Jan 1, 1970)? */ public final long expires; /** * Best-known state of the participant. */ public final TxState state; /** * For diagnostic purposes, null if not relevant. */ public final String resourceName; } 回到com.atomikos.recovery.xa.DefaultXaRecoveryLog.getExpiredCommittingXids() 方法,可以到获取了一次XA事务过程中,存储的事务日志中的xid。 public Set<XID> getExpiredCommittingXids() throws LogReadException { Set<XID> ret = new HashSet<XID>(); Collection<ParticipantLogEntry> entries = log.getCommittingParticipants(); for (ParticipantLogEntry entry : entries) { if (expired(entry) && !http(entry)) { XID xid = new XID(entry.coordinatorId, entry.uri); ret.add(xid); } } return ret; } 如果从RM中通过XA recovery取出的XID,包含在从事务日志中取出的XID,则进行commit,否则进行rollback. List<XID> xidsToRecover = retrievePreparedXidsFromXaResource(xaResource); Collection<XID> xidsToCommit; try { xidsToCommit = retrieveExpiredCommittingXidsFromLog(); for (XID xid : xidsToRecover) { if (xidsToCommit.contains(xid)) { replayCommit(xid, xaResource); } else { attemptPresumedAbort(xid, xaResource); } } } catch (LogException couldNotRetrieveCommittingXids) { LOGGER.logWarning("Transient error while recovering - will retry later...", couldNotRetrieveCommittingXids); } replayCommit 方法如下: private void replayCommit(XID xid, XAResource xaResource) { if (LOGGER.isDebugEnabled()) LOGGER.logDebug("Replaying commit of xid: " + xid); try { //进行事务提交 xaResource.commit(xid, false); //更新事务日志 log.terminated(xid); } catch (XAException e) { if (alreadyHeuristicallyTerminatedByResource(e)) { handleHeuristicTerminationByResource(xid, xaResource, e, true); } else if (xidTerminatedInResourceByConcurrentCommit(e)) { log.terminated(xid); } else { LOGGER.logWarning("Transient error while replaying commit - will retry later...", e); } } } attemptPresumedAbort(xid, xaResource); 方法如下: private void attemptPresumedAbort(XID xid, XAResource xaResource) { try { log.presumedAborting(xid); if (LOGGER.isDebugEnabled()) LOGGER.logDebug("Presumed abort of xid: " + xid); try { //进行回滚 xaResource.rollback(xid); //更新日志状态 log.terminated(xid); } catch (XAException e) { if (alreadyHeuristicallyTerminatedByResource(e)) { handleHeuristicTerminationByResource(xid, xaResource, e, false); } else if (xidTerminatedInResourceByConcurrentRollback(e)) { log.terminated(xid); } else { LOGGER.logWarning("Unexpected exception during recovery - ignoring to retry later...", e); } } } catch (IllegalStateException presumedAbortNotAllowedInCurrentLogState) { // ignore to retry later if necessary } catch (LogException logWriteException) { LOGGER.logWarning("log write failed for Xid: "+xid+", ignoring to retry later", logWriteException); } } 文章到此,已经写的很长很多了,我们分析了ShardingSphere对于XA方案,提供了一套SPI解决方案,对Atomikos进行了整合,也分析了Atomikos初始化流程,开始事务流程,获取连接流程,提交事务流程,回滚事务流程,事务恢复流程。 希望对大家理解XA的原理有所帮助。 作者介绍: 肖宇,Apache ShardingSphere Committer,开源hmily分布式事务框架作者, 开源soul网关作者,热爱开源,追求写优雅代码。目前就职入京东数科,参与ShardingSphere的开源建设,以及分布式数据库的研发工作。

优秀的个人博客,低调大师

Apache ShardingSphere整合Atomikos源码解析

Shardingsphere整合Atomikos对XA分布式事务的支持 Apache ShardingSphere 是一套开源的分布式数据库中间件解决方案组成的生态圈,它由 JDBC、Proxy 和 Sidecar(规划中)这 3 款相互独立,却又能够混合部署配合使用的产品组成。 它们均提供标准化的数据分片、分布式事务和数据库治理功能,可适用于如 Java 同构、异构语言、云原生等各种多样化的应用场景。 ShardingSphere 已于2020年4月16日成为 Apache 软件基金会的顶级项目。 咋们话不多,接上篇,我们直接进入正题。 Atomikos简单介绍 Atomikos(https://www.atomikos.com/),其实是一家公司的名字,提供了基于JTA规范的XA分布式事务TM的实现。其旗下最著名的产品就是事务管理器。产品分两个版本: TransactionEssentials:开源的免费产品; ExtremeTransactions:上商业版,需要收费。 这两个产品的关系如下图所示: ExtremeTransactions在TransactionEssentials的基础上额外提供了以下功能(重要的): 支持TCC:这是一种柔性事务 支持通过RMI、IIOP、SOAP这些远程过程调用技术,进行事务传播。 事务日志云存储,云端对事务进行恢复,并且提供了完善的管理后台。 org.apache.shardingsphere.transaction.xa.XAShardingTransactionManager详解 我们简单的来回顾下org.apache.shardingsphere.transaction.spi.ShardingTransactionManager public interface ShardingTransactionManager extends AutoCloseable { /** * Initialize sharding transaction manager. * * @param databaseType database type * @param resourceDataSources resource data sources */ void init(DatabaseType databaseType, Collection<ResourceDataSource> resourceDataSources); /** * Get transaction type. * * @return transaction type */ TransactionType getTransactionType(); /** * Judge is in transaction or not. * * @return in transaction or not */ boolean isInTransaction(); /** * Get transactional connection. * * @param dataSourceName data source name * @return connection * @throws SQLException SQL exception */ Connection getConnection(String dataSourceName) throws SQLException; /** * Begin transaction. */ void begin(); /** * Commit transaction. */ void commit(); /** * Rollback transaction. */ void rollback(); } 我们重点县关注init方法,从它的命名,你就应该能够看出来,这是整个框架的初始化方法,让我们来看看它是如何进行初始化的。 private final Map<String, XATransactionDataSource> cachedDataSources = new HashMap<>(); private final XATransactionManager xaTransactionManager = XATransactionManagerLoader.getInstance().getTransactionManager(); @Override public void init(final DatabaseType databaseType, final Collection<ResourceDataSource> resourceDataSources) { for (ResourceDataSource each : resourceDataSources) { cachedDataSources.put(each.getOriginalName(), new XATransactionDataSource(databaseType, each.getUniqueResourceName(), each.getDataSource(), xaTransactionManager)); } xaTransactionManager.init(); } 首先SPI的方式加载XATransactionManager的具体实现类,这里返回的就是org.apache.shardingsphere.transaction.xa.atomikos.manager.AtomikosTransactionManager。 我们在关注下 new XATransactionDataSource() , 进入 org.apache.shardingsphere.transaction.xa.jta.datasource。XATransactionDataSource类的构造方法。 public XATransactionDataSource(final DatabaseType databaseType, final String resourceName, final DataSource dataSource, final XATransactionManager xaTransactionManager) { this.databaseType = databaseType; this.resourceName = resourceName; this.dataSource = dataSource; if (!CONTAINER_DATASOURCE_NAMES.contains(dataSource.getClass().getSimpleName())) { // 重点关注 1 ,返回了xaDatasource xaDataSource = XADataSourceFactory.build(databaseType, dataSource); this.xaTransactionManager = xaTransactionManager; // 重点关注2 注册资源 xaTransactionManager.registerRecoveryResource(resourceName, xaDataSource); } } 我们重点来关注 XADataSourceFactory.build(databaseType, dataSource),从名字我们就可以看出,这应该是返回JTA规范里面的XADataSource,在ShardingSphere里面很多的功能,可以从代码风格的命名上就能猜出来,这就是优雅代码(吹一波)。不多逼逼,我们进入该方法。 public final class XADataSourceFactory { public static XADataSource build(final DatabaseType databaseType, final DataSource dataSource) { return new DataSourceSwapper(XADataSourceDefinitionFactory.getXADataSourceDefinition(databaseType)).swap(dataSource); } } 首先又是一个SPI定义的 XADataSourceDefinitionFactory,它根据不同的数据库类型,来加载不同的方言。然后我们进入 swap方法。 public XADataSource swap(final DataSource dataSource) { XADataSource result = createXADataSource(); setProperties(result, getDatabaseAccessConfiguration(dataSource)); return result; } 很简明,第一步创建,XADataSource,第二步给它设置属性(包含数据的连接,用户名密码等),然后返回。 返回 XATransactionDataSource 类,关注 xaTransactionManager.registerRecoveryResource(resourceName, xaDataSource); 从名字可以看出,这是注册事务恢复资源。这个我们在事务恢复的时候详解。 返回 XAShardingTransactionManager.init() ,我们重点来关注: xaTransactionManager.init();,最后进入AtomikosTransactionManager.init()。流程图如下: 代码: public final class AtomikosTransactionManager implements XATransactionManager { private final UserTransactionManager transactionManager = new UserTransactionManager(); private final UserTransactionService userTransactionService = new UserTransactionServiceImp(); @Override public void init() { userTransactionService.init(); } } 进入UserTransactionServiceImp.init() private void initialize() { //添加恢复资源 不用关心 for (RecoverableResource resource : resources_) { Configuration.addResource ( resource ); } for (LogAdministrator logAdministrator : logAdministrators_) { Configuration.addLogAdministrator ( logAdministrator ); } //注册插件 不用关心 for (TransactionServicePlugin nxt : tsListeners_) { Configuration.registerTransactionServicePlugin ( nxt ); } //获取配置属性 重点关心 ConfigProperties configProps = Configuration.getConfigProperties(); configProps.applyUserSpecificProperties(properties_); //进行初始化 Configuration.init(); } 我们重点关注,获取配置属性。最后进入com.atomikos.icatch.provider.imp.AssemblerImp.initializeProperties()方法。 @Override public ConfigProperties initializeProperties() { //读取classpath下的默认配置transactions-defaults.properties Properties defaults = new Properties(); loadPropertiesFromClasspath(defaults, DEFAULT_PROPERTIES_FILE_NAME); //读取classpath下,transactions.properties配置,覆盖transactions-defaults.properties中相同key的值 Properties transactionsProperties = new Properties(defaults); loadPropertiesFromClasspath(transactionsProperties, TRANSACTIONS_PROPERTIES_FILE_NAME); //读取classpath下,jta.properties,覆盖transactions-defaults.properties、transactions.properties中相同key的值 Properties jtaProperties = new Properties(transactionsProperties); loadPropertiesFromClasspath(jtaProperties, JTA_PROPERTIES_FILE_NAME); //读取通过java -Dcom.atomikos.icatch.file方式指定的自定义配置文件路径,覆盖之前的同名配置 Properties customProperties = new Properties(jtaProperties); loadPropertiesFromCustomFilePath(customProperties); //最终构造一个ConfigProperties对象,来表示实际要使用的配置 Properties finalProperties = new Properties(customProperties); return new ConfigProperties(finalProperties); } 接下来重点关注, Configuration.init(), 进行初始化。 ublic static synchronized boolean init() { boolean startupInitiated = false; if (service_ == null) { startupInitiated = true; //SPI方式加载插件注册,无需过多关心 addAllTransactionServicePluginServicesFromClasspath(); ConfigProperties configProperties = getConfigProperties(); //调用插件的beforeInit方法进行初始化话,无需过多关心 notifyBeforeInit(configProperties); //进行事务日志恢复的初始化,很重要,接下来详解 assembleSystemComponents(configProperties); //进入系统注解的初始化,一般重要 initializeSystemComponents(configProperties); notifyAfterInit(); if (configProperties.getForceShutdownOnVmExit()) { addShutdownHook(new ForceShutdownHook()); } } return startupInitiated; } 我们先来关注 assembleSystemComponents(configProperties); 进入它,进入com.atomikos.icatch.provider.imp.AssemblerImp.assembleTransactionService()方法: @Override public TransactionServiceProvider assembleTransactionService( ConfigProperties configProperties) { RecoveryLog recoveryLog =null; //打印日志 logProperties(configProperties.getCompletedProperties()); //生成唯一名字 String tmUniqueName = configProperties.getTmUniqueName(); long maxTimeout = configProperties.getMaxTimeout(); int maxActives = configProperties.getMaxActives(); boolean threaded2pc = configProperties.getThreaded2pc(); //SPI方式加载OltpLog ,这是最重要的扩展地方,如果用户没有SPI的方式去扩展那么就为null OltpLog oltpLog = createOltpLogFromClasspath(); if (oltpLog == null) { LOGGER.logInfo("Using default (local) logging and recovery..."); //创建事务日志存储资源 Repository repository = createRepository(configProperties); oltpLog = createOltpLog(repository); //??? Assemble recoveryLog recoveryLog = createRecoveryLog(repository); } StateRecoveryManagerImp recoveryManager = new StateRecoveryManagerImp(); recoveryManager.setOltpLog(oltpLog); //生成唯一id生成器,以后生成XID会用的到 UniqueIdMgr idMgr = new UniqueIdMgr ( tmUniqueName ); int overflow = idMgr.getMaxIdLengthInBytes() - MAX_TID_LENGTH; if ( overflow > 0 ) { // see case 73086 String msg = "Value too long : " + tmUniqueName; LOGGER.logFatal ( msg ); throw new SysException(msg); } return new TransactionServiceImp(tmUniqueName, recoveryManager, idMgr, maxTimeout, maxActives, !threaded2pc, recoveryLog); } 我们重点来分析createOltpLogFromClasspath(), 采用SPI的加载方式来获取,默认这里会返回 null, 什么意思呢? 就是当没有扩展的时候,atomikos,会创建框架自定义的资源,来存储事务日志。 private OltpLog createOltpLogFromClasspath() { OltpLog ret = null; ServiceLoader<OltpLogFactory> loader = ServiceLoader.load(OltpLogFactory.class,Configuration.class.getClassLoader()); int i = 0; for (OltpLogFactory l : loader ) { ret = l.createOltpLog(); i++; } if (i > 1) { String msg = "More than one OltpLogFactory found in classpath - error in configuration!"; LOGGER.logFatal(msg); throw new SysException(msg); } return ret; } 我们跟着进入 Repository repository = createRepository(configProperties); private CachedRepository createCoordinatorLogEntryRepository( ConfigProperties configProperties) throws LogException { //创建内存资源存储 InMemoryRepository inMemoryCoordinatorLogEntryRepository = new InMemoryRepository(); //进行初始化 inMemoryCoordinatorLogEntryRepository.init(); //创建使用文件存储资源作为backup FileSystemRepository backupCoordinatorLogEntryRepository = new FileSystemRepository(); //进行初始化 backupCoordinatorLogEntryRepository.init(); //内存与file资源进行合并 CachedRepository repository = new CachedRepository(inMemoryCoordinatorLogEntryRepository, backupCoordinatorLogEntryRepository); repository.init(); return repository; } 这里就会创建出 CachedRepository,里面包含了 InMemoryRepository 与 FileSystemRepository 回到主线 com.atomikos.icatch.config.Configuration.init(), 最后来分析下notifyAfterInit(); private static void notifyAfterInit() { //进行插件的初始化 for (TransactionServicePlugin p : tsListenersList_) { p.afterInit(); } for (LogAdministrator a : logAdministrators_) { a.registerLogControl(service_.getLogControl()); } //设置事务恢复服务,进行事务的恢复 for (RecoverableResource r : resourceList_ ) { r.setRecoveryService(recoveryService_); } } 插件的初始化会进入com.atomikos.icatch.jta.JtaTransactionServicePlugin.afterInit() public void afterInit() { TransactionManagerImp.installTransactionManager(Configuration.getCompositeTransactionManager(), autoRegisterResources); //如果我们自定义扩展了 OltpLog ,这里就会返回null,如果是null,那么XaResourceRecoveryManager就是null RecoveryLog recoveryLog = Configuration.getRecoveryLog(); long maxTimeout = Configuration.getConfigProperties().getMaxTimeout(); if (recoveryLog != null) { XaResourceRecoveryManager.installXaResourceRecoveryManager(new DefaultXaRecoveryLog(recoveryLog, maxTimeout),Configuration.getConfigProperties().getTmUniqueName()); } } 重点注意 RecoveryLog recoveryLog = Configuration.getRecoveryLog(); ,如果用户采用SPI的方式,扩展了com.atomikos.recovery.OltpLog ,这里就会返回 null。 如果是null,则不会对 XaResourceRecoveryManager 进行初始化。 回到 notifyAfterInit(), 我们来分析 setRecoveryService。 public void setRecoveryService ( RecoveryService recoveryService ) throws ResourceException { if ( recoveryService != null ) { if ( LOGGER.isTraceEnabled() ) LOGGER.logTrace ( "Installing recovery service on resource " + getName () ); this.branchIdentifier=recoveryService.getName(); recover(); } } 我们进入 recover() 方法: public void recover() { XaResourceRecoveryManager xaResourceRecoveryManager = XaResourceRecoveryManager.getInstance(); //null for LogCloud recovery if (xaResourceRecoveryManager != null) { try { xaResourceRecoveryManager.recover(getXAResource()); } catch (Exception e) { refreshXAResource(); //cf case 156968 } } } 看到最关键的注释了吗,如果用户采用SPI的方式,扩展了com.atomikos.recovery.OltpLog,那么XaResourceRecoveryManager 为null,则就会进行云端恢复,反之则进行事务恢复。 事务恢复很复杂,我们会单独来讲。 到这里atomikos的基本的初始化已经完成。 atomikos事务begin流程 我们知道,本地的事务,都会有一个 trainsaction.begin, 对应XA分布式事务来说也不另外,我们再把思路切换回XAShardingTransactionManager.begin(), 会调用com.atomikos.icatch.jta.TransactionManagerImp.begin()。流程图如下: 代码: public void begin ( int timeout ) throws NotSupportedException, SystemException { CompositeTransaction ct = null; ResumePreviousTransactionSubTxAwareParticipant resumeParticipant = null; ct = compositeTransactionManager.getCompositeTransaction(); if ( ct != null && ct.getProperty ( JTA_PROPERTY_NAME ) == null ) { LOGGER.logWarning ( "JTA: temporarily suspending incompatible transaction: " + ct.getTid() + " (will be resumed after JTA transaction ends)" ); ct = compositeTransactionManager.suspend(); resumeParticipant = new ResumePreviousTransactionSubTxAwareParticipant ( ct ); } try { //创建事务补偿点 ct = compositeTransactionManager.createCompositeTransaction ( ( ( long ) timeout ) * 1000 ); if ( resumeParticipant != null ) ct.addSubTxAwareParticipant ( resumeParticipant ); if ( ct.isRoot () && getDefaultSerial () ) ct.setSerial (); ct.setProperty ( JTA_PROPERTY_NAME , "true" ); } catch ( SysException se ) { String msg = "Error in begin()"; LOGGER.logError( msg , se ); throw new ExtendedSystemException ( msg , se ); } recreateCompositeTransactionAsJtaTransaction(ct); } 这里我们主要关注 compositeTransactionManager.createCompositeTransaction(), public CompositeTransaction createCompositeTransaction ( long timeout ) throws SysException { CompositeTransaction ct = null , ret = null; ct = getCurrentTx (); if ( ct == null ) { ret = getTransactionService().createCompositeTransaction ( timeout ); if(LOGGER.isDebugEnabled()){ LOGGER.logDebug("createCompositeTransaction ( " + timeout + " ): " + "created new ROOT transaction with id " + ret.getTid ()); } } else { if(LOGGER.isDebugEnabled()) LOGGER.logDebug("createCompositeTransaction ( " + timeout + " )"); ret = ct.createSubTransaction (); } Thread thread = Thread.currentThread (); setThreadMappings ( ret, thread ); return ret; } 创建了事务补偿点,然后把他放到了用当前线程作为key的Map当中,这里思考,为啥它不用 threadLocal。 到这里atomikos的事务begin流程已经完成。 大家可能有些疑惑,begin好像什么都没有做,XA start 也没调用? 别慌,下一节继续来讲。 XATransactionDataSource getConnection() 流程 我们都知道想要执行SQL语句,必须要获取到数据库的connection。让我们再回到 XAShardingTransactionManager.getConnection() 最后会调用到org.apache.shardingsphere.transaction.xa.jta.datasourceXATransactionDataSource.getConnection()。流程图如下: 代码 : public Connection getConnection() throws SQLException, SystemException, RollbackException { //先检查是否已经有存在的connection,这一步很关心,也是XA的关键,因为XA事务,必须在同一个connection if (CONTAINER_DATASOURCE_NAMES.contains(dataSource.getClass().getSimpleName())) { return dataSource.getConnection(); } //获取数据库连接 Connection result = dataSource.getConnection(); //转成XAConnection,其实是同一个连接 XAConnection xaConnection = XAConnectionFactory.createXAConnection(databaseType, xaDataSource, result); //获取JTA事务定义接口 Transaction transaction = xaTransactionManager.getTransactionManager().getTransaction(); if (!enlistedTransactions.get().contains(transaction)) { //进行资源注册 transaction.enlistResource(new SingleXAResource(resourceName, xaConnection.getXAResource())); transaction.registerSynchronization(new Synchronization() { @Override public void beforeCompletion() { enlistedTransactions.get().remove(transaction); } @Override public void afterCompletion(final int status) { enlistedTransactions.get().clear(); } }); enlistedTransactions.get().add(transaction); } return result; } 首先第一步很关心,尤其是对shardingsphere来说,因为在一个事务里面,会有多个SQL语句,打到相同的数据库,所以对相同的数据库,必须获取同一个XAConnection,这样才能进行XA事务的提交与回滚。 我们接下来关心 transaction.enlistResource(new SingleXAResource(resourceName, xaConnection.getXAResource()));, 会进入com.atomikos.icatch.jta.TransactionImp.enlistResource(), 代码太长,截取一部分。 try { restx = (XAResourceTransaction) res .getResourceTransaction(this.compositeTransaction); // next, we MUST set the xa resource again, // because ONLY the instance we got as argument // is available for use now ! // older instances (set in restx from previous sibling) // have connections that may be in reuse already // ->old xares not valid except for 2pc operations restx.setXAResource(xares); restx.resume(); } catch (ResourceException re) { throw new ExtendedSystemException( "Unexpected error during enlist", re); } catch (RuntimeException e) { throw e; } addXAResourceTransaction(restx, xares); 我们直接看 restx.resume(); public synchronized void resume() throws ResourceException { int flag = 0; String logFlag = ""; if (this.state.equals(TxState.LOCALLY_DONE)) {// reused instance flag = XAResource.TMJOIN; logFlag = "XAResource.TMJOIN"; } else if (!this.knownInResource) {// new instance flag = XAResource.TMNOFLAGS; logFlag = "XAResource.TMNOFLAGS"; } else throw new IllegalStateException("Wrong state for resume: " + this.state); try { if (LOGGER.isDebugEnabled()) { LOGGER.logDebug("XAResource.start ( " + this.xidToHexString + " , " + logFlag + " ) on resource " + this.resourcename + " represented by XAResource instance " + this.xaresource); } this.xaresource.start(this.xid, flag); } catch (XAException xaerr) { String msg = interpretErrorCode(this.resourcename, "resume", this.xid, xaerr.errorCode); LOGGER.logWarning(msg, xaerr); throw new ResourceException(msg, xaerr); } setState(TxState.ACTIVE); this.knownInResource = true; } 哦多尅,看见了吗,各位,看见了 this.xaresource.start(this.xid, flag); 了吗????,我们进去,假设我们使用的Mysql数据库: public void start(Xid xid, int flags) throws XAException { StringBuilder commandBuf = new StringBuilder(300); commandBuf.append("XA START "); appendXid(commandBuf, xid); switch(flags) { case 0: break; case 2097152: commandBuf.append(" JOIN"); break; case 134217728: commandBuf.append(" RESUME"); break; default: throw new XAException(-5); } this.dispatchCommand(commandBuf.toString()); this.underlyingConnection.setInGlobalTx(true); } 组装XA start Xid SQL语句,进行执行。 到这里,我们总结下,在获取数据库连接的时候,我们执行了XA协议接口中的 XA start xid atomikos事务commit流程 好了,上面我们已经开启了事务,现在我们来分析下事务commit流程,我们再把视角切换回XAShardingTransactionManager.commit(),最后我们会进入com.atomikos.icatch.imp.CompositeTransactionImp.commit() 方法。流程图如下: 代码: public void commit () throws HeurRollbackException, HeurMixedException, HeurHazardException, SysException, SecurityException, RollbackException { //首先更新下事务日志的状态 doCommit (); setSiblingInfoForIncoming1pcRequestFromRemoteClient(); if ( isRoot () ) { //真正的commit操作 coordinator.terminate ( true ); } } 我们关注 coordinator.terminate ( true ); protected void terminate ( boolean commit ) throws HeurRollbackException, HeurMixedException, SysException, java.lang.SecurityException, HeurCommitException, HeurHazardException, RollbackException, IllegalStateException { synchronized ( fsm_ ) { if ( commit ) { //判断有几个参与者,如果只有一个,直接提交 if ( participants_.size () <= 1 ) { commit ( true ); } else { //否则,走XA 2阶段提交流程,先prepare, 再提交 int prepareResult = prepare (); // make sure to only do commit if NOT read only if ( prepareResult != Participant.READ_ONLY ) commit ( false ); } } else { rollback (); } } } 首先会判断参与者的个数,这里我们可以理解为MySQL的database数量,如果只有一个,退化成一阶段,直接提交。 如果有多个,则走标准的XA二阶段提交流程。 我们来看 prepare (); 流程,最后会走到com.atomikos.icatch.imp.PrepareMessage.send() ---> com.atomikos.datasource.xa.XAResourceTransaction.prepare() int ret = 0; terminateInResource(); if (TxState.ACTIVE == this.state) { // tolerate non-delisting apps/servers suspend(); } // duplicate prepares can happen for siblings in serial subtxs!!! // in that case, the second prepare just returns READONLY if (this.state == TxState.IN_DOUBT) return Participant.READ_ONLY; else if (!(this.state == TxState.LOCALLY_DONE)) throw new SysException("Wrong state for prepare: " + this.state); try { // refresh xaresource for MQSeries: seems to close XAResource after // suspend??? testOrRefreshXAResourceFor2PC(); if (LOGGER.isTraceEnabled()) { LOGGER.logTrace("About to call prepare on XAResource instance: " + this.xaresource); } ret = this.xaresource.prepare(this.xid); } catch (XAException xaerr) { String msg = interpretErrorCode(this.resourcename, "prepare", this.xid, xaerr.errorCode); if (XAException.XA_RBBASE <= xaerr.errorCode && xaerr.errorCode <= XAException.XA_RBEND) { LOGGER.logWarning(msg, xaerr); // see case 84253 throw new RollbackException(msg); } else { LOGGER.logError(msg, xaerr); throw new SysException(msg, xaerr); } } setState(TxState.IN_DOUBT); if (ret == XAResource.XA_RDONLY) { if (LOGGER.isDebugEnabled()) { LOGGER.logDebug("XAResource.prepare ( " + this.xidToHexString + " ) returning XAResource.XA_RDONLY " + "on resource " + this.resourcename + " represented by XAResource instance " + this.xaresource); } return Participant.READ_ONLY; } else { if (LOGGER.isDebugEnabled()) { LOGGER.logDebug("XAResource.prepare ( " + this.xidToHexString + " ) returning OK " + "on resource " + this.resourcename + " represented by XAResource instance " + this.xaresource); } return Participant.READ_ONLY + 1; } 终于,我们看到了这么一句 ret = this.xaresource.prepare(this.xid); 但是等等,我们之前不是说了,XA start xid 以后要先 XA end xid 吗? 答案就在 suspend(); 里面。 public synchronized void suspend() throws ResourceException { // BugzID: 20545 // State may be IN_DOUBT or TERMINATED when a connection is closed AFTER // commit! // In that case, don't call END again, and also don't generate any // error! // This is required for some hibernate connection release strategies. if (this.state.equals(TxState.ACTIVE)) { try { if (LOGGER.isDebugEnabled()) { LOGGER.logDebug("XAResource.end ( " + this.xidToHexString + " , XAResource.TMSUCCESS ) on resource " + this.resourcename + " represented by XAResource instance " + this.xaresource); } //执行了 xa end 语句 this.xaresource.end(this.xid, XAResource.TMSUCCESS); } catch (XAException xaerr) { String msg = interpretErrorCode(this.resourcename, "end", this.xid, xaerr.errorCode); if (LOGGER.isTraceEnabled()) LOGGER.logTrace(msg, xaerr); // don't throw: fix for case 102827 } setState(TxState.LOCALLY_DONE); } } 到了这里,我们已经执行了 XA start xid -> XA end xid --> XA prepare xid, 接下来就是最后一步 commit 我们再回到 terminate(false) 方法,来看 commit()流程。其实和 prepare流程一样,最后会走到 com.atomikos.datasource.xa.XAResourceTransaction.commit()。 commit执行完,数据提交 //繁杂代码过多,就显示核心的 this.xaresource.commit(this.xid, onePhase); 思考:这里的参与者提交是在一个循环里面,一个一个提交的,如果之前的提交了,后面的参与者提交的时候,挂了,就会造成数据的不一致性。 Atomikos rollback() 流程 上面我们已经分析了commit流程,其实rollback流程和commit流程一样,我们在把目光切换回 org.apache.shardingsphere.transaction.xa.XAShardingTransactionManager.rollback() ,最后会执行到com.atomikos.icatch.imp.CompositeTransactionImp.rollback()。 public void rollback () throws IllegalStateException, SysException { //清空资源,更新事务日志状态等 doRollback (); if ( isRoot () ) { try { coordinator.terminate ( false ); } catch ( Exception e ) { throw new SysException ( "Unexpected error in rollback: " + e.getMessage (), e ); } } } 重点关注 coordinator.terminate ( false ); ,这个和 commit流程是一样的,只不过在 commit流程里面,参数传的是true。 protected void terminate ( boolean commit ) throws HeurRollbackException, HeurMixedException, SysException, java.lang.SecurityException, HeurCommitException, HeurHazardException, RollbackException, IllegalStateException { synchronized ( fsm_ ) { if ( commit ) { if ( participants_.size () <= 1 ) { commit ( true ); } else { int prepareResult = prepare (); // make sure to only do commit if NOT read only if ( prepareResult != Participant.READ_ONLY ) commit ( false ); } } else { //如果是false,走的是rollback rollback (); } } } 我们重点关注 rollback() ,最后会走到com.atomikos.datasource.xa.XAResourceTransaction.rollback()。 public synchronized void rollback() throws HeurCommitException, HeurMixedException, HeurHazardException, SysException { terminateInResource(); if (rollbackShouldDoNothing()) { return; } if (this.state.equals(TxState.TERMINATED)) { return; } if (this.state.equals(TxState.HEUR_MIXED)) throw new HeurMixedException(); if (this.state.equals(TxState.HEUR_COMMITTED)) throw new HeurCommitException(); if (this.xaresource == null) { throw new HeurHazardException("XAResourceTransaction " + getXid() + ": no XAResource to rollback?"); } try { if (this.state.equals(TxState.ACTIVE)) { // first suspend xid suspend(); } // refresh xaresource for MQSeries: seems to close XAResource after // suspend??? testOrRefreshXAResourceFor2PC(); if (LOGGER.isDebugEnabled()) { LOGGER.logDebug("XAResource.rollback ( " + this.xidToHexString + " ) " + "on resource " + this.resourcename + " represented by XAResource instance " + this.xaresource); } this.xaresource.rollback(this.xid); 先在supend()方法里面执行了 XA end xid 语句, 接下来执行 this.xaresource.rollback(this.xid); 进行数据的回滚。 文章到此,已经写的很长很多了,我们分析了ShardingSphere对于XA方案,提供了一套SPI解决方案,对Atomikos进行了整合,也分析了Atomikos初始化流程,开始事务流程,获取连接流程,提交事务流程,回滚事务流程。希望对大家理解XA的原理有所帮助。 作者介绍: 肖宇,Apache ShardingSphere Committer,开源hmily分布式事务框架作者, 开源soul网关作者,热爱开源,追求写优雅代码。目前就职入京东数科,参与ShardingSphere的开源建设,以及分布式数据库的研发工作。

优秀的个人博客,低调大师

ThinkPHP框架执行流程源码解析

本文主要介绍框架的执行流程 前言 如果不清楚框架是怎么执行的,那么看在多的代码都是只是认识代码而已,阅读源码是为了学习其框架的设计思想和代码模式。 而执行流程则是将我们学习的东西串联在一起,从而更好地理解。咔咔也会给大家把执行流程用思维导图的方式画出来。 只要大家在本文学习到一点点的知识点,咔咔也是心满意足的。 这个流程图只是针对initialize的执行过程,其余的执行过程后期会进行补充,都是以脑图的形式呈现给大家的。 一、框架执行流程之初始化应用的数据设置 这里的内容跟容器的内容有点重复,因为执行流程是从入口文件开始的,并且最后也是通过容器执行的。 然后就会进入到文件thinkphp/library/think/App.php的run方法,在这个方法中主要就是下图框出来的地方,执行的initialize方法。 来到initialize这个方法,先看上半部分。 microtime(true);返回的是unix的微秒数 memory_get_usage返回的是分配给PHP的内存量,单位为字节 在接下来就是对框架的几个路径进行设置 static::setInstance($this);这里是将app这个实例设置为容器实例 $this->instance('app', $this);这个在之前容器章节就提到了,就是为了把app这个类绑定到容器里边去,也就是注册树模式。 这里有一个小的问题点给大家提出来,在初始化应用的这个方法里边存在这样一行代码。 有没有小伙伴对这个$this->env和下边的$this->config这俩个调用有疑惑。 如果你有疑惑那就跟着咔咔一起来看,没疑惑的就可以继续往下看了。 App这个类是继承的容器类,那么这个env和config不论是在app还是container类中都是没有这俩个属性的。 那么怎么就可以直接调用呢!而且代码追踪都会追踪到env类和container类中。 需要知道这个源头就需要我们去在大致的看一遍container类的代码。 经过一番苦读之后,可以看到下图的几行代码。这几行代码全部使用的是魔术方法。 当访问env类不存在的时候就会去执行make方法。 make这个方法在容器那一章节进行的细的不能再细的解读了。 这个make方法最终会返回一个类的实例,并且还会存到容器里边。 这里只放一个make方法的代码,如果有不会的可以去看之前的文章。 最后就是加载一系列的数据,加载详情请看前言的思维导图。 二、如何查看一个方法都在哪里执行了 在阅读源码的过程中,有一个很难把控的问题就是一个方法在不同的地方进行了调用,但是咱们确一时半会根本不知道都在哪里调用了。 这里用init方法来做一个演示。 init方法是初始化应用或者模块的一个方法,但是这里的module参数确实一个空值。 先做一个断点查看一下相关的数据信息。 打印的结果就是空,这就是一些新学习的伙伴会犯的一个错误,因为这个方法不可能只调用一次的。 如果初始化模块都是空那么这个方法就没有存在的必要了。 那么正确的断点方式应该是这个样子的。 此时就会有一个问题,这个init方法明显是被调用了俩次的,那么另一次调用的地方是在哪里呢! 如果在不知道新的技巧之前,就会进行一系列的断点打印,看在哪里进行了执行,比如在这个init的上层去打印。 也就是在initialize那个方法里边去打印做断点,但是这样很是麻烦的,而且很有可能浪费了大量的时间还是找不到正确的地方。 小技巧之debug_backtrace() 这个方法会产生一条回溯追踪,会显示出一个方法所有的调用位置。 使用方式就是如下图,只需要把debug_backtrace这个方法打印出来即可。 根据得到的数据信息,就可以非常快的进行定位。 第一次就是在app类的215行。 第二次是在thinkphp/library/think/route/dispatch/Module.php类的60行 可以在这里做一个打印,看一下这个module是否为index 所以说有了这个方法就可以非常快速地定位调用位置。 三、框架执行流程之初始化应用init分析 上文给大家提供了一个小技巧debug_backtrace实战演示了如何查看一个方法都在哪里执行的。 并且案例也是使用的init这个方法来演示的,因为接下来就是要对init这个方法进行深入的了解。 在init方法里边主要做的事情在上边的脑图已经描述的很清楚了。 从一开始就对模块的定位,就是在第二节中的对init方法的调用,会传入对应的模块 加载app目录下的tags文件,在tags文件里边就是对行为扩展定义的文件。在之前门面的文章中定义钩子执行就在这个文件中设置的。 加载common文件,也就是公共文件,所以说公共文件就是在这里进行加载的。 加载助手函数文件helper,在助手函数里边有一个大家特别熟悉的一个方法,那就是dump。这就是为什么在有的地方使用dump会报错的原因。 加载中间件文件,这里的直接给出的是直接加载app目录下的中间件文件,但是在框架中我们需要在定义一个目录为http,在这个目录下定义中间件文件。 注册服务的容器对象实例,这里注册就使用的是容器类中的bindTo方法进行绑定注册的。 读取配置文件,这段在配置文件加载那一节中已经进行深入的说明了, 这里就不提了。配置文件会读取俩个地方一个是第一步模块下的config文件,另一个就是config目录下的配置文件。 设置模块路径,会把第一步获取到的模块进行env环境变量配置里边 最后一步就是对容器中的对象实例进行配置更新,具体更新了什么在后文中给大家详细说来。 /** * 初始化应用或模块 * @access public * @param string $module 模块名 * @return void */ public function init($module = '') { // 定位模块目录 $module = $module ? $module . DIRECTORY_SEPARATOR : ''; /** * 第一次:D:\phpstudy_pro\WWW\ThinkPHPSourceCodeAnalysis\application\ * 第二次:D:\phpstudy_pro\WWW\ThinkPHPSourceCodeAnalysis\application\index\ */ $path = $this->appPath . $module; // 加载初始化文件 if (is_file($path . 'init.php')) { include $path . 'init.php'; } elseif (is_file($this->runtimePath . $module . 'init.php')) { include $this->runtimePath . $module . 'init.php'; } else { // 加载行为扩展文件 if (is_file($path . 'tags.php')) { $tags = include $path . 'tags.php'; if (is_array($tags)) { $this->hook->import($tags); } } // 加载公共文件 if (is_file($path . 'common.php')) { include_once $path . 'common.php'; } if ('' == $module) { // 加载系统助手函数 include $this->thinkPath . 'helper.php'; } // 加载中间件 if (is_file($path . 'middleware.php')) { $middleware = include $path . 'middleware.php'; if (is_array($middleware)) { $this->middleware->import($middleware); } } // 注册服务的容器对象实例 if (is_file($path . 'provider.php')) { $provider = include $path . 'provider.php'; if (is_array($provider)) { $this->bindTo($provider); } } /** * $path : "D:\phpstudy_pro\WWW\ThinkPHPSourceCodeAnalysis\application\" * "D:\phpstudy_pro\WWW\ThinkPHPSourceCodeAnalysis\application\index\" */ // 自动读取配置文件 if (is_dir($path . 'config')) { $dir = $path . 'config' . DIRECTORY_SEPARATOR; } elseif (is_dir($this->configPath . $module)) { // D:\phpstudy_pro\WWW\ThinkPHPSourceCodeAnalysis\config\ $dir = $this->configPath . $module; } // scandir:以升序的方式读取目录中的文件 // 返回就是config目录中的所有文件 $files = isset($dir) ? scandir($dir) : []; foreach ($files as $file) { /** * $this->configExt:配置文件的后缀 * pathinfo返回的是文件后缀,关于pathinfo共有三个可选的参数PATHINFO_DIRNAME、PATHINFO_BASENAME、PATHINFO_EXTENSION,分别为只返回文件名,文件目录名,文件扩展 */ if ('.' . pathinfo($file, PATHINFO_EXTENSION) === $this->configExt) { /** * 俩个参数分别为 * 1.目录+config目录下的文件 * 2.config目录下文件名 */ $this->config->load($dir . $file, pathinfo($file, PATHINFO_FILENAME)); } } } $this->setModulePath($path); if ($module) { // 对容器中的对象实例进行配置更新 $this->containerConfigUpdate($module); } } 这里附带上一份代码,可以对着代码看上边的执行流程,对每一步都做了简单的说明。 咔咔个人见解对源码进行优化 在设置模块的这步代码咔咔感觉不是很是严谨,因为init方法会在俩个地方进行执行。 第一次的模块为空,这块代码执行是没有任何意义的。 下面在对容器的对象实例进行配置更新时进行了一次判断,判断模块的这个参数是否为空,如果不为空才会执行。 那么同样的道理,咔咔感觉在设置模块路径这块也应该在这个判断里边。 虽说第二次执行会把第一次的结果覆盖掉,但是咔咔感觉下图这样使用才会更好。 四、对容器中的对象实例进行更新配置 在上一节中这里就是最后的内容,那这个对实例进行更新配置,到底更新了什么,怎么更新没有说明。 在这一小节中就会做出说明,同样可以配合着前言的思维导图看。 先会把config目录下的所有配置信息全部获取出来 从app配置文件中将注册异常处理类 第三大块是把第一步获取出来的所有配置信息给对应的类进行注册配置。 第四步就是在把模块确定下来之后加载对应的语言包,语言包功能就可以实现多语言功能,之前咔咔写过一篇文章实现多语言功能,如果感兴趣的可以去查看。 最后一步就是根据app配置文件中的三个属性进行缓存的处理 在这一节中咔咔感觉最重要的就是下图的内容了。 我们可以随意追踪一到俩个方法查看一下那边到底执行了什么方法。 追踪方法Db::init() 追踪方法过来后可以看到就是对Db类中的config属性进行赋值,把database中的值赋值给Db类中的config属性。 追踪方法$this->middleware->setConfig() 来到中间件这个类里边,可以看到就是把本类的配置和传递过来的参数类进行合并,同样也是进行config属性的赋值。 跟上边案例的Db类的init方法实现的效果是一致的。 这里在提一嘴就是在对容器中的对象实例进行更新配置这一幅图中可以看到紫色部分是在本类中没有引用的。 那么这是怎么可以进行执行的呢!是因为App类继承了容器类,容器类中有四个魔术方法,其中有一个__get方法,就是在获取不存在的属性时会执行那个方法。 在魔术方法__get方法中执行了一个make方法,这个make方法说了好多次了,这个方法最终会返回一个应用的实例,然后用这个实例调用对应实例类的方法。 这一块一定要理解好,阅读源码就是这个样子,我们需要对一切未知的进行的解决,只有这样才能提高我们的编程能力和思想。 五、浅谈调试模式以及代码冗余 本节会对调试模式做出简单的说明,并且会对框架代码冗余情况进行简单的提出。 没有人写的代码是没有漏洞的,如果有那就是你还没有达到一定的造诣。 调试模式 在第一节中只提到了initialize方法的上半部分,因为在这一节之前聊的都是关于应用初始化init的内容。 接下来会对这一块的内容进行简单的说明。 从app配置文件中获取到app_debug的配置项 给环境变量设置debug级别 当框架中的debug是关闭状态时会执行ini_set这个方法,这个方法是为一个配置选项进行赋值。 接下来的内容估计不是很好理解,都是平时在工作中根本使用不到的。 ob_get_level:返回输出缓冲机制的嵌套级别,那么怎么去理解呢!其实就是当缓存区不起作用时会返回0。 ob_get_clean:这个函数将会返回输出缓冲的内容并终止输出缓冲。如果缓冲区没有有效内容则返回false。本质上相当于同时执行了ob_getcontens()和ob_end_clean()。 ob_start:打开输出控制缓冲 上边这三个先暂时认识就行,后期如果有机会会专门出一篇文章做解释的。 关于框架代码冗余 这里也仅仅代表咔咔个人的观点。 可以先看看这部分的代码,这俩处代码是不是很是熟悉,没错就是在上文的init方法中容器对象实例配置更新见到过。 如图 这块也就是咔咔个人提出的见解,由于咔咔式针对5.1做的源码解读,不太了解新版版是否做出了改动。 六、总结 本节主要是针对框架执行流程中的初始化应用做了简单的探讨。 至于在app类的run方法下面还有很多的执行过程在这一节中没有做过多的解释。 在阅读源码的过程中给大家提了一个很好得小技巧,那就是如何去查看一个方法都在哪里进行了执行。 这个方法为debug_backtrace,这个方法需要大家多使用几次就知道怎么使用了,因为在打印出来的结果中也存在很多无用的信息。 这个方法在调试源码的过程中是非常有效的,一定要好好利用这个方法。 在就是对初始化应用init方法进行了特别详细的介绍。 其中咔咔感觉这块设计最好的就是在容器中的对象实例进行更新配置那一块,先读取所有的配置,然后在通过各个类的方法进行配置的设置。 这种代码规划和设计思路值得我们去学习。 最后聊到了调试模式和框架的代码冗余问题,关于调试模式这里咔咔给大家提个醒项目在线上的调试模式一定要关闭。 否则你的项目就类似于裸奔的存在,没有一点点的安全可言。 这块有点不好理解的就是对于缓冲区,关于这块的内容咔咔认为暂时没有必要去钻牛角尖,先认识认识然后在进行深入的研究。 缓冲区的这块内容估计工作了三四年的也很少有人使用,所以先认识,知道怎么一回事,咔咔后期学习了之后在给大家进行补充。 直到这里关于框架的执行流程之初始化应用就结束了,这一节没有过深需要学习的,主要是其中的代码设计模式和实现思路。 最后这个图大家一定要跟着源码看一看哈! 坚持学习、坚持写博、坚持分享是咔咔从业以来一直所秉持的信念。希望在偌大互联网中咔咔的文章能带给你一丝丝帮助。我是咔咔,下期见。

优秀的个人博客,低调大师

基于synchronized锁的深度解析

1. 问题引入 小伙伴们都接触过线程,也都会使用线程,今天我们要讲的是线程安全相关的内容,在这之前我们先来看一个简单的代码案例。 代码案例: /** * @url: i-code.online * @author: AnonyStar * @time: 2020/10/14 15:39 */ public class ThreadSafaty { //共享变量 static int count = 0; public static void main(String[] args) { //创建线程 Runnable runnable = () -> { for (int i = 0; i < 5; i++) { count ++; try { Thread.sleep(1); } catch (InterruptedException e) { e.printStackTrace(); } } }; for (int i = 0; i < 100; i++) { new Thread(runnable,"Thread-"+i).start(); } try { Thread.sleep(5000); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("count = "+ count); } } 执行结果: 问题说明 在上面的代码中我们可以看到,定义了一个线程 runnable 里面对公共成员变量进行 ++ 操作,并循环五次,每次睡眠一毫秒,之后我们在主线程 main 方法中创建一百个线程并且启动,然后主线程睡眠等待五秒以此来等所有的线程执行结束。我们预期结果应该是 500 。但是实际执行后我们发现 count 的值是不固定的 ,是小于 500 的,这里就是多线程并行导致的数据安全性问题! 通过上述案例我们可以清楚的看到线程安全的问题,那么我们想想是否有什么办法来避免这种安全问题尼 ?我们可以想到导致这种安全问题的原因是因为我们访问了共享数据,那么我们是否能将线程访问共享数据的过程变成串行的过程那么不就是不存在这个问题了。这里我们可以想到之前说的**锁** ,我们知道锁是处理并发的一种同步方式,同时他也具备互斥性,在Java中实现加锁是通过 synchronized 关键字 2. 锁的基本认识 2.1 Synchronized 的认识 在Java 中我们知道有一个元老级的关键字 synchronized ,它是实现加锁的关键,但是我们一直都认为它是一个重量级锁,其实早在 jdk1.6 时就对其进行了大量的优化,让它已经变成非常灵活。也不再一直是重量级锁了,而是引入了 **偏向锁 **和 **轻量级锁。 **关于这些内容我们将详细介绍。 synchronized的基础使用 synchronized 修饰实例方法,作用于当前实例加锁 synchronized 修饰静态方法,作用于当前类对象加锁, synchronized 修饰代码块,指定加锁对象,对给定对象加锁, 在上述情况中,我们要进入被 synchronized 修饰的同步代码前,必须获得相应的锁,其实这也体现出来针对不同的修饰类型,代表的是锁的控制粒度 我们修改一下前面我们写的案例,通过使用 synchronized 关键字让其实现线程安全 //创建线程 Runnable runnable = () -> { synchronized (ThreadSafaty.class){ for (int i = 0; i < 5; i++) { count ++; try { Thread.sleep(1); } catch (InterruptedException e) { e.printStackTrace(); } } } }; 只需要添加 synchronized (ThreadSafaty.class) 的修饰,将操作的内容放入代码块中,那么就会实现线程安全 通过上面的实践我们可以直观感受 synchronized 的作用,这是我们平时开发中常规使用,大家有没有过疑问,这个锁到底是怎么存储实现的?那么下面我们将对探索其中的奥秘 Java中锁的实现 我们知道锁是具有互斥性(Mutual Exclusion)的 ,那么它是在什么地方标记存在的尼? 我们也知道多个线程都可以获取锁,那么锁必然是可以共享的 我们最熟悉的 synchronized 它获取锁的过程到底是怎么样的呢?它的锁是如何存储的呢? 我们可以注意观察 synchronized 的语法,可以看到 **synchronized(lock) 是基于 lock 的生命周期来实现控制锁粒度的,**这里一定要理解,我们获得锁时都时一个对象,那么锁是不是会和这个对象有关系呢? 到这里为止,我们将所有的关键信息都指向了对象,那么我们有必要以此为切入点,来首先了解对象在 jvm 中的分布形式,再来看锁是怎么被实现的。 对象的内存布局 这里我们只谈论对象在 Heap 中的布局,而不会涉及过多的关于对象的创建过程等细节,这些内容我们再单独文章详细阐述,可以关注 i-code.online 博客或wx "云栖简码" 在我们最常用的虚拟机 hotspot 中对象在内存中的分布可以分为三个部分:对象头(Header)、实列数据(Instance Data)、对其填充(Padding) 通过上述的图示我们可以看到,对象在内存中,包含三个部分, 其中对象头内分为 对象标记与类元信息,在对象标记中主要包含如图所示 hashcode、GC分代年龄、锁标记状态、偏向锁持有线程id、线程持有的锁(monitor)等六个内容,这部分数据的长度在 32 位和64位的虚拟机中分别为32bit 和 64bit,在官方将这部分称为 Mark Word 。 Mark Word 实际是一中可以动态定义的数据结构,这样可以让极小的空间存储尽量多的数据,根据对象的状态复用自己的内存空间,比如在32位的虚拟机中,如果对象未被同步锁锁定的状态下, Mark Word 的32个比特存储单元中,25个用于存储哈希码,4个用于存储GC分代年龄,2个存锁标记位,1个固定位0,针对各个状态下的分布可以直观的参看下面的图表 32位HotSpot虚拟机对象头Mark Word 锁状态 25bit 4bit 1bit(是否是偏向锁) 2bit(锁标志位) 23bit 2bit 无锁 对象的HashCode 分代年龄 0 01 偏向锁 线程ID Epoch(偏向时间戳) 分代年龄 1 01 轻量级锁 指向栈中锁记录的指针 00 重量级锁 指向重量级锁的指针 10 GC标记 空 11 上述说的是32位虚拟机,需要注意。关于对象头的另一部分是类型指针,这里我们不展开再细说了,想了解的关注 i-code.online ,会持续更新相关内容😁😊 下面内容会涉及到源码的查看,需要提前下载源码,如果你不知道如何来下载,可以参看《下载JDK 与 Hotspot 虚拟机源码》这篇文章,或者关注 云栖简码。 在我们熟悉的虚拟机 Hotspot 中实现 Mark Word 的代码在 markOop.cpp 中,我们可以看下面片段,这是描述了虚拟机中MarkWord 的存储布局: 当我们在 new 一个对象时,虚拟机层面实际会创建一个 instanceOopDesc 对象,我们熟悉的 Hotspot 虚拟机采用了 OOP-Klass 模型来描述 Java 对象实例,其中 OOP 就是我们熟悉的普通对象指针,而 Klass 则是描述对象的具体类型,在Hotspot 中分别用 instanceOopDesc 和 arrayOopDesc 来描述,其中arrayOopDesc 用来描述数组类型, 对于 instanceOopDesc 的实现我们可以从 Hotspot 源码中找到。对应在 instanceOop.hpp 文件中,而相应的 arrayOopDesc 在 arrayOop.hpp 中,下面我们来看一下相关的内容: 我们可以看到 instanceOopDesc 继承了 oopDesc,而 oopDesc 则定义在 oop.hpp 中, 上述图示中我们可以看到相关信息,具体也注释了文字,那么接下来我们要探索一下 _mark 的实现定义了,如下,我们看到它是markOopDesc 通过代码跟进我们可以在找到 markOopDesc 的定义在 markOop.hpp 文件中,如下图所示: 在上述图片中我们可以看到,内部有一个枚举。记录了 markOop 中存储项,所以在我们实际开发时,当 synchronized 将某个对象作为锁时那么之后的一系列锁的信息都和 markOop 相关。如上面表格中 mark word的分布记录所示具体的各个部分的含义 因为我们创建对象时实际在jvm层面都会生成一个native 的c++ 对象 oop/oopdesc 来映射的,而每个对象都带有一个 monitor 的监视器对象,可以在 markOop.hpp 中看到,其实在多线程中抢夺锁就是在争夺 monitor 来修改相应的标记 Synchronized 的深入 在 Java 中 synchronized 是实现互斥同步最基本的方法,它是一个块结构(Block Structured)的同步语法,在经过javac 编译后会在块的前后分别形成 monitorrenter 和 monitorexit 两个字节码指令,而它们又都需要一个 reference 类型的参数来指明锁对象,具体锁对象取决于 synchronized 修饰的内容,上面已经说过不在阐述。 《深入理解Java虚拟机》中有这样的描述: 根据《Java虚拟机规范》的要求,在执行monitorenter指令时,首先要去尝试获取对象的锁。如果 这个对象没被锁定,或者当前线程已经持有了那个对象的锁,就把锁的计数器的值增加一,而在执行 monitorexit指令时会将锁计数器的值减一。一旦计数器的值为零,锁随即就被释放了。如果获取对象 锁失败,那当前线程就应当被阻塞等待,直到请求锁定的对象被持有它的线程释放为止 所以被 synchronized 修饰的代码块对同一个线程是可重入的,这也就避免了同线程反复进入导致死锁的可能 在synchronized 修饰的代码块直接结束释放锁之前,会阻塞后面的其他线程 为什么说synchronized是重量级锁 从执行成本来说,持有锁是一个重量级(Heavy-Weight)的操作过程,因为在Java中线程都是映射到操作系统的原生内核线程上的,如果要阻塞和唤醒某一个线程都需要经过操作系统来调度,而这就不可避免的会进行用户态和内核态的转换,但是这种转换是非常耗费处理器时间的,尤其对于本身业务代码简单的程序,可能在这里耗费的时间比业务代码自身执行的时间还长,所以说synchronized 是一个重量级的操作,不过在 jdk6 后对其做了大量的优化,让它不再显得那么重 锁的优化 在 JDK5 升级到 JDK6 后进行一系列关于锁的改进,通过多种技术手段来优化锁,让 synchronized 不再像以前一样显的很重,这其中涉及到适应性自旋(Adaptive Spinning)、锁消除(Lock Elimination)、锁膨胀(Lock Coarsening)、轻量级锁(LightWeight Locking)、偏向锁(Biased Locking)等,这些都是用来优化和提高多线程访问共享数据的竞争问题。 锁消除 锁消除是虚拟机在即时编译器运行时对一些代码要求同步,但是被检测到不可能存在共享数据竞争的锁进行消除,其中主要的判定依据是基于逃逸分析技术来实现的,关于这块内容不在这里展开,后续相关文章介绍。这里我们简单理解就是,如果一段代码中,在堆上的数据都不会逃逸出去被其他线程访问到,那么就可以把它们当作栈上的数据来对来,认为它们都是线程私有的,从而也就不需要同步加锁了, 关于代码中变量是否逃逸,对虚拟机来说需要通过复杂分析才能得到,但是对我们开发人员来说还是相对直观的,那可能有人会疑惑既然开发人员能清楚还为什么要多余的加锁同步呢?,其实实际上,程序上非常多的同步措施并不是我们开发人员自己加入的,而是 java 内部就有大量的存在,比如下面这个典型的例子,下面展示的是字符串的相加 private String concatString(String s1,String s2,String s3){ return s1 + s2 + s3; } 我们知道String 类是被 final 修饰的不可变类,所以对于字符串的相加都是通过生成新的String 对象来试试先的,因此编译器会对这种操作做优化处理,在JDK5 之前会转换为 StringBuffer 对象的append() 操作,而在JDK5 及其之后则转换为StringBuilder 对象来操作。所以上述代码在jdk5可能会变成如下: private String concatString(String s1,String s2,String s3){ StringBuffer sb = new StringBuffer(); sb.append(s1); sb.append(s2); sb.append(s3); return sb.toString(); } 这时候,就可以看到,对于StringBuffer。append() 方法是一个同步方法,带有同步快,锁对象就是 sb ,这时候虚拟机通过分析发现 sb 的作用域被限制在方法内部,而不可能逃逸出方法外让其他线程访问到,所以这是在经过服务端编译器的即时编译后,这段代码的所有同步措施都会失效而直接执行。 上述代码是为了方便演示而选择了String,实际来说在jdk5之后都是转换为Stringbuilder ,也就不存在这个问题了,但是在jdk中类似这种还是非常多的。 锁粗化 关于锁的粗话其实也是很简单的理解,我们在开发时总是推荐同步代码块要作用范围尽量小,尽量只在共享数据的实际作用域中才进行同步,这样的目的是为了尽可能减少同步的操作,让其他线程能更快的拿到锁 这是多大多数情况,但是总有一些特殊情况,比如在某个系列连续操作的都是对同一个对象反复的加锁和解锁,那么这会导致不必要的性能损耗 也如同上面String 的案例,在连续的append 操作都是零碎的同步块,而且都是同一个锁对象,这时候会将锁的范围扩展,到整个操作序列外部,也就是第一个append 之前到最后一个append 操作之后,将这些全部放入一个同步锁中就可以了,这样就避免了多次的锁获取和释放。 自旋锁 通过之前的了解,我们知道挂起线程和恢复线程都是会涉及到用户态和内核态的转换,而这些都是非常耗时的,这会直接影响虚拟机的并发性能。 在我们平时开发中,如果共享数据的锁定状态只会持续很短的时间,那么为了这很短的时间而去挂起阻塞线程是非常浪费资源的。尤其现在的电脑都基本是多核处理器,所以在这种前提下,我们是是否可以让另一个请求锁对象的线程不去挂起,而是稍微等一下,这个等待并不会放弃CPU 的执行时间。等待观察持有锁的线程是否能很快的释放锁,其实这个等待就好比是一个空的循环,这种技术就是一个所谓的自旋锁 自旋锁在JDK6 中及已经是默认开启的了,在jdk4时就引入了。自旋锁并不是阻塞也代替不了阻塞。 自旋锁对处理器数量有一定的要求,同时它是会占用CPU 时间的,虽然它避免了线程切换的开销,但是这之间时存在平衡关系的,假如锁被占用的时间很短那么自旋就非常有价值,会节省大量的时间开销,但是相反,如果锁占用的时间很长,那么自旋的线程就会白白消耗处理器资源,造成性能的浪费。 所以自旋锁必须有一个限度,也就是它自旋的次数,规定一个自旋次数,如果超过这个次数则不再自旋转而用传统方式挂起线程, 自旋的次数默认时十次。但是我们也可以通过 -XX: PreBlockSpin 参数来自定义设置 自适应自旋锁 在前面我们知道可以自定义自旋次数,但是这个很难有个合理的值,毕竟在程序中怎么样的情况都有,我们不可能通过全局设置一个。所以在JDK6 之后引入了自适应自旋锁,也就是对原有的自旋锁进行了优化 自适应自旋的时间不再是固定的,而是由前一次在同一个锁上的自旋时间及锁的拥有者的状态决定的,如果在同一个锁对象上,自旋等待刚刚成功获得过锁,并且支持有锁的线程正在运行中,那么虚拟机就会任务这次自旋也极有再次获得锁,那么就会允许自旋的持续时间更长 相应的 ,如果对于某个锁,自旋获得锁的次数非常少,那么在之后要获取锁的时候将直接忽略掉自旋的过程进而直接阻塞线程避免浪费处理器资源 轻量级锁 轻量级锁也是 JDK6 时加入的新的锁机制,它的轻量级是相对于通过操作系统互斥量来实现的传统锁而言的,轻量级锁也是一种优化,而不是能替代重量级锁,轻量级锁的涉及初衷就是在没有多线程竞争下减少传统重量级锁使用操作系统互斥量产生的性能消耗。 要想了解轻量级锁我们必须对对象在Heap 中的分布了解,也就是上面说到的内容。 轻量级锁加锁 当代码执行到同步代码块时,如果同步对象没有被锁定也就是锁标志位为01 状态,那么虚拟机首先将在当前线程的栈帧中建立一个名为锁记录Lock Record 的空间 这块锁记录空间用来存储锁对象目前的 Mark Word 的拷贝,官方给其加了个Displaced 的前缀,即 Displaced Mark Word ,如下图所示,这是在CAS 操作之前堆栈与对象的状态 当复制结束后虚拟机会通过CAS 操作尝试把对象的Mark Word 更新为指向Lock Record 的指针,如果更新成功则代表该线程拥有了这个对象的锁,并且将Mark Word 的锁标志位(最后两个比特)转变为 “00”,此时表示对象处于轻量级锁定状态,此时的堆栈与对象头的状态如下: 如果上述操作失败了,那说明至少存在一条线程与当前线程竞争获取该对象的锁,虚拟机会首先检查对象的Mark Word 是否指向当前线程的栈帧,如果是,则说明当前线程已经拥有了这个对象的锁,那么直接进入同步代码块执行即可。否则则说明这个对象已经被其他线程抢占了。 如果有超过两条以上的线程争夺同一个锁的情况,那么轻量级锁就不再有效,必须膨胀为重量级锁,锁的标记位也变为“10”,此时Mark Word 中存储的就是指向重量级锁的指针,等待的线程也必须进入阻塞状态 轻量级锁的解锁 轻量级锁的解锁同样是通过CAS 操作来进行的 如果对象的 Mark Word 仍然指向线程的锁记录,那么就用CAS 操作把对象当前的 Mark Word 和线程中复制的 Displaced Mark Word 替换回来 如果替换成功则整个同步过程结束,若失败则说明有其他线程正在尝试获取该锁,那就要在释放锁的同时,唤醒被挂起的线程 轻量级锁适用的场景是对于绝大部分锁在整个同步周期内都是不存在竞争的,因为如果没有竞争,轻量级锁便可以通过CAS 操作成功避免了使用互斥量的开销,但是如果确实存在锁竞争,那么除了互斥量本身的开销外还得额外发生了CAS 操作的开销,这种情况下反而比重量级锁更慢 下面通过完整的流程图来直观看一下轻量级锁的加锁解锁及膨胀过程 偏向锁 偏向锁也是JDK6 引入的一种锁优化技术,如果说轻量级锁是在无竞争情况下通过CAS 操作消除了同步使用的互斥量,那么偏向锁则是再无竞争情况下把整个同步都给消除掉了,连CAS 操作都不再去做了,可以看出这比轻量级锁更加轻 从对象头的分布上看,偏向锁中是没有哈希值的而是多了线程ID与Epoch 两个内容 偏向锁的意思就是锁会偏向第一个获得它的线程,如果接下来的执行过程中该锁一直没有被其他线程获取,那么只有偏向锁的线程将永远不需要再进行同步 偏向锁的获取和撤销 当代码执行到同步代码块时,在第一次被线程执行到时,锁对象是第一次被线程获取,此时虚拟机会将对象头中的锁标志改为“01”,同时把偏向锁标志位改为“1”,表示当前锁对象进入偏向锁模式。 接下来线程通过CAS 操作来将这个帧的线程ID记录到对象头中,如果CAS 成功了。则持有锁对象的线程再之后进入同步代码不再进行任何同步操作(如获取锁解锁等操作)。每次都会通过判断当前线程与锁对象中记录的线程id是否一致。 如果 上述的 CAS 操作失败了,那说明肯定存在另外一个线程在获取这个锁,并且获取成功了。这种情况下说明存在锁竞争,则偏向模式马上结束,偏向锁的撤销,需要等待全局安全点(在这个时间点上没有正在执行的字节码)。它会首先暂停拥有偏向锁的线程,会根据锁对象是否处于锁定状态来决定是否撤销偏向也就是将偏向锁标志位改为“0”,如果撤销则会变为未锁定(“01”)或者轻量级锁(“00”) 如果锁对象未锁定,则撤销偏向锁(设置偏向锁标志位为“0”),此时锁处于未锁定不可以偏向状态,因为具有哈希值,进而变为轻量级锁 如果锁对象还在锁定状态则直接进入轻量级锁状态 偏向锁的开关 偏向锁在JDK6 及其之后是默认启用的。由于偏向锁适用于无锁竞争的场景,如果我们应用程序里所有的锁通常情况下处于竞争状态,可以通过JVM参数关闭偏向锁:-XX:-UseBiasedLocking=false,那么程序默认会进入轻量级锁状态。 如果要开启偏向锁可以用: -XX:+UseBiasedLocking -XX:BiasedLockingStartupDelay=0 重量级锁 重量级锁也就是上述几种优化都无效后,膨胀为重量级锁,通过互斥量来实现,我们先来看下面的代码 上面代码是一个简单使用了synchronized 的代码,我们通过字节码工具可以看到右侧窗口。我们发现,在同步代码块的前后分别形成了monitorenter 和 monitorexit 两条指令 在Java对现中都会有一个monitor 的监视器,这里的monitorenter 指令就是去获取一个对象的监视器。而相应的monitorexit 则表示释放监视器monitor 的所有权,允许被其他线程来获取 monitor 是依赖于系统的 MutexLock (互斥锁) 来实现的,当线程阻塞后进入内核态事,就会造成系统在用户态和内核态之间的切换,进而影响性能 总结 上面是阐述了关于synchronized 锁的一些优化与转换,在我们开启偏向锁和自旋时,锁的转变是 无锁 -> 偏向锁 -> 轻量级锁 -> 重量级锁, 自旋锁实际是一种锁的竞争机制,而不是一种状态。在偏向锁和轻量级锁中都使用到了自旋 偏向锁适用于无锁竞争的场景,轻量级锁适合无多个线程竞争的场景 偏向锁和轻量级锁都依赖与CAS操作,但是偏向锁中只有在第一次时才会CAS操作 当一个对象已经被计算过一致性哈希值时,那么这个对象就再也不无法进入到偏向锁状态了,如果对象正处于偏向锁状态,而接收到计算哈希值的请求,那么他的偏向锁状态会被立即撤销,并且会膨胀为重量级锁。这要是为什么偏向锁状态时MarkWord 中没有哈希值 本文由 AnonyStar 发布,可转载但需声明原文出处。 欢迎关注微信公账号 :云栖简码 获取更多优质文章 更多文章关注笔者博客 :云栖简码 i-code.online

优秀的个人博客,低调大师

Redis GeoHash核心原理解析

1. 引言 小麦同学是个吃货+技术宅,平日里就喜欢拿着手机地图点点按按来查询一些好玩的东西。某一天到北海公园游玩,肚肚饿了,于是乎打开手机地图,搜索北海公园附近的餐馆,并选了其中一家用餐。饱暖思yin欲的麦叔饭后思考地图后台如何根据自己所在位置查询来查询附近餐馆的呢?苦思冥想了半天,小麦想出了个方法:计算所在位置P与北京所有餐馆的距离,然后返回距离<=1000米的餐馆。小得意了一会儿,小麦发现北京的餐馆何其多啊,这样计算不得了,于是想了,既然知道经纬度了,那它应该知道自己在西城区,那应该计算所在位置P与西城区所有餐馆的距离啊,机机运用了递归的思想,想到了西城区也很多餐馆啊,应该计算所在位置P与所在街道所有餐馆的距离,这样计算量又小了,效率也提升了。 小麦的计算思想很朴素,就是通过过滤的方法来减小参与计算的餐馆数目,从某种角度上讲,机机在使用索引技术。 一提到索引,大家脑子里马上浮现出B树索引,因为大量的数据库(如MySQL、oracle、PostgreSQL等)都在使用B树。B树索引本质上是对索引字段进行排序,然后通过类似二分查找的方法进行快速查找,即它要求索引的字段是可排序的,一般而言,可排序的是一维字段,比如时间、年龄、薪水等等。但是对于空间上的一个点(二维,包括经度和纬度),如何排序呢?又如何索引呢?解决的方法很多,下文介绍一种方法来解决这一问题。 思想:如果能通过某种方法将二维的点数据转换成一维的数据,那样不就可以继续使用B树索引了嘛。那这种方法真的存在嘛,答案是肯定的。目前很火的GeoHash算法就是运用了上述思想,下面我们就开始GeoHash之旅吧。 2. 感性认识 先来两个干货,在线查看GPS某个区域的GeoHash值。 1. http://geohash.gofreerange.com/ 在这里插入图片描述 2. http://www.geohash.cn/ 跟更好用些 3. 通俗说 GeoHash将二维的经纬度转换成字符串,比如下图展示了北京9个区域的GeoHash字符串,分别是WX4ER,WX4G2、WX4G3等等,每一个字符串代表了某一矩形区域。也就是说,这个矩形区域内所有的点(经纬度坐标)都共享相同的GeoHash字符串,这样既可以保护隐私(只表示大概区域位置而不是具体的点),又比较容易做缓存,比如左上角这个区域内的用户不断发送位置信息请求餐馆数据,由于这些用户的GeoHash字符串都是WX4ER,所以可以把WX4ER当作key,把该区域的餐馆信息当作value来进行缓存,而如果不使用GeoHash的话,由于区域内的用户传来的经纬度是各不相同的,很难做缓存。字符串越长,表示的范围越精确。如图所示,5位的编码能表示10平方千米范围的矩形区域,而6位编码能表示更精细的区域(约0.34平方千米)字符串相似的表示距离相近(特殊情况后文阐述),这样可以利用字符串的前缀匹配来查询附近的POI信息。如下两个图所示,第一个在城区,第二个在郊区,城区的GeoHash字符串之间比较相似,郊区的字符串之间也比较相似,而城区和郊区的GeoHash字符串相似程度要低些。通过上面的介绍我们知道了GeoHash就是一种将经纬度转换成字符串的方法,并且使得在大部分情况下,字符串前缀匹配越多的距离越近,回到我们的案例,根据所在位置查询来查询附近餐馆时,只需要将所在位置经纬度转换成GeoHash字符串,并与各个餐馆的GeoHash字符串进行前缀匹配,匹配越多的距离越近。 4. GeoHash算法的步骤 下面以北海公园附近随便一个位置为例介绍GeoHash算法的计算步骤,先用百度 GPS反定位系统查找看下经纬度。纬度=116.395371,经度=39.931957。 根据经纬度计算GeoHash二进制编码 地球纬度区间是[-90,90], 北海公园的纬度是39.928167,可以通过下面算法对纬度39.928167进行逼近编码: 区间[-90,90]进行二分为[-90,0),[0,90],称为左右区间,可以确定39.928167属于右区间[0,90],给标记为1; 接着将区间[0,90]进行二分为 [0,45),[45,90],可以确定39.928167属于左区间 [0,45),给标记为0; 递归上述过程39.928167总是属于某个区间[a,b]。随着每次迭代区间[a,b]总在缩小,并越来越逼近39.928167; 如果给定的纬度x(39.928167)属于左区间,则记录0,如果属于右区间则记录1,这样随着算法的进行会产生一个序列1011100,序列的长度跟给定的区间划分次数有关。 39.928167 根据纬度算编码 bit min mid max 1 -90.000 0.000 90.000 0 0.000 45.000 90.000 1 0.000 22.500 45.000 1 22.500 33.750 45.000 1 33.750 39.375 45.000 0 39.375 42.188 45.000 0 39.375 40.7815 42.188 0 39.375 40.07825 40.7815 1 39.375 39.726625 40.07825 1 39.726625 39.9024375 40.07825 同理,地球经度区间是[-180,180],可以对经度116.389550进行编码。根据经度算编码 bit min mid max 1 -180 0.000 180 1 0.000 90 180 0 90 135 180 1 90 112.5 135 0 112.5 123.75 135 0 112.5 118.125 123.75 1 112.5 115.3125 118.125 0 115.3125 116.71875 118.125 1 115.3125 116.015625 116.71875 1 116.015625 116.3671875 116.71875 组码 通过上述计算,纬度产生的编码为10111 00011,经度产生的编码为11010 01011。偶数位放经度,奇数位放纬度,把2串编码组合生成新串:11100 11101 00100 01111。最后使用用0-9、b-z(去掉a, i, l, o)这32个字母进行base32编码,首先将11100 11101 00100 01111转成十进制,对应着28、29、4、15,十进制对应的编码就是wx4g。同理,将编码转换成经纬度的解码算法与之相反,具体不再赘述。 5. GeoHash Base32编码长度与精度 可以看出,当geohash base32编码长度为8时,精度在19米左右,而当编码长度为9时,精度在2米左右,编码长度需要根据数据情况进行选择。 一、经纬度距离换算 在纬度相等的情况下: 经度每隔0.00001度,距离相差约1米; 每隔0.0001度,距离相差约10米; 每隔0.001度,距离相差约100米; 每隔0.01度,距离相差约1000米; 每隔0.1度,距离相差约10000米。 在经度相等的情况下: 纬度每隔0.00001度,距离相差约1.1米; 每隔0.0001度,距离相差约11米; 每隔0.001度,距离相差约111米; 每隔0.01度,距离相差约1113米; 每隔0.1度,距离相差约11132米。 6. GeoHash算法 上文讲了GeoHash的计算步骤,仅仅说明是什么而没有说明为什么?为什么分别给经度和维度编码?为什么需要将经纬度两串编码交叉组合成一串编码?本节试图回答这一问题。 如下图所示,我们将二进制编码的结果填写到空间中,当将空间划分为四块时候,编码的顺序分别是左下角00,左上角01,右下脚10,右上角11,也就是类似于Z的曲线,当我们递归的将各个块分解成更小的子块时,编码的顺序是自相似的(分形),每一个子快也形成Z曲线,这种类型的曲线被称为Peano空间填充曲线。 这种类型的空间填充曲线的优点是将二维空间转换成一维曲线(事实上是分形维),对大部分而言,编码相似的距离也相近, 但Peano空间填充曲线最大的缺点就是突变性,有些编码相邻但距离却相差很远,比如0111与1000,编码是相邻的,但距离相差很大。 除Peano空间填充曲线外,还有很多空间填充曲线,如图所示,其中效果公认较好是Hilbert空间填充曲线,相较于Peano曲线而言,Hilbert曲线没有较大的突变。为什么GeoHash不选择Hilbert空间填充曲线呢?可能是Peano曲线思路以及计算上比较简单吧,事实上,Peano曲线就是一种四叉树线性编码方式。 7. 使用注意点 1. 临界问题 由于GeoHash是将区域划分为一个个规则矩形,并对每个矩形进行编码,这样在查询附近POI信息时会导致以下问题,比如红色的点是我们的位置,绿色的两个点分别是附近的两个餐馆,但是在查询的时候会发现距离较远餐馆的GeoHash编码与我们一样(因为在同一个GeoHash区域块上),而较近餐馆的GeoHash编码与我们不一致。这个问题往往产生在边界处。 解决的思路很简单,我们查询时,除了使用定位点的GeoHash编码进行匹配外,还使用周围8个区域的GeoHash编码,这样可以避免这个问题。 2. 注意点 我们已经知道现有的GeoHash算法使用的是Peano空间填充曲线,这种曲线会产生突变,造成了编码虽然相似但距离可能相差很大的问题,因此在查询附近餐馆时候,首先筛选GeoHash编码相似的POI(point of interest)点,然后进行实际距离计算。 3. 使用心得 GeoHash只是空间索引的一种方式,特别适合点数据,而对线、面数据采用R树索引更有优势(可为什么需要空间索引)。 GeoHash值可以区分精度,位数越多,精度越高,表达的地理位置越精细;如一位的GeoHash值把地球划分为32个矩形,8位的geohash值把地球划分为32^8个小矩形 适合根据某个经纬度坐标position计算出GeoHash值,然后和数据库中精度更高的GeoHash值做前缀比较 8.空间索引 常见问题:如何根据自己所在位置查询来查询附近50米的POI(point of interest,比如商家、景点等)呢(图1a)?每个POI都有经纬度信息,用图1b的SQL语句在mySQL中建立了POI_spatial的表,其中lat和lng两个字段来代表纬度和经度。为后续分析方便起见,我人造了40万个POI数据。 方法一:暴力方法 该方法的思路很直接:计算位置与所有POI的距离,并保留距离小于50米的POI。 插句题外话,计算经纬度之间的距离不能像求欧式距离那样平方开根号,因为地球是个不规整的球体(图2a),普通计算适合都是默认按最简单的完美球体假设,两点之间的距离函数应该如图2b所示。 该方法的复杂度为:40万*距离函数。我们将球体距离函数写为mysql存储过程distance,之后我们执行查询操作(图3),发现花费了4.66秒。 方法二:矩形过滤方法 该方法采用逐步细化的方式,一般分为两部: 先用矩形框过滤(图4a),判断一个点在矩形框内很简单,只要进行两次判断(LtMin<lat<LtMax; LnMin<lng<LnMax),落在矩形框内的POI个数为n(n<<40万); 用球面距离公式计算位置与矩形框内n个POI的距离(图4b),并保留距离小于50米的POI 矩形过滤方法的复杂度:40万矩形过滤函数 + n距离函数(n<<40万)。 根据这个思路我们执行SQl查询(图5)(注:经度或纬度每隔0.001度,距离相差约100米,由此推算出矩形左下角和右上角坐标),发现过滤后正好剩下两个POI。 此查询花费了0.36秒,相比于方法一查询时间大大降低,但是对于一次查询来说还是很长。时间长的原因在于遍历了40万次。 方法三:B树对经度或纬度建立索引 方法二耗时的原因在于执行了遍历操作,为了不进行遍历,我们自然想到了索引。我们对纬度进行了B树索引。 altertablepoi_spatialaddindexlatindex(lat);altertablepoi_spatialaddindexlngindex(lng); 此方法包括三个步骤: 通过B树快速找到某纬度范围的POI(图6a),个数为m(m<40万),复杂度为Log(40万)*过滤函数; 在步骤a过滤得到的m个POI中查找某经度范围的POI(图6b),个数为n(n<m),复杂度为m*过滤函数; 用球面距离公式计算位置与步骤b得到的n个POI的距离(图6c),并保留距离小于50米的POI 执行SQL查询(图7),发现时间已经大大降低,从方法2的0.36秒下降到0.01秒 三、B树能索引空间数据吗? 这时候有人会说了:方法三效果如此好,能够满足我们附近POI查询问题啊,看来B树用来索引空间数据也是可以的嘛!那么B树真的能够索引空间数据吗? 只能对经度或纬度索引(一维索引),与期望的不符 我们期待的是快速找出落在某一空间范围的POI(如矩形)(图8a),而不是快速找出落在某纬度或经度范围的POI(图8b),想象一下,我要查询北京某区的POI,但是B树索引不仅给我找出了北京的,还有与北京同一维度的天津、大同、甚至国外城市的POI,当数据量很大时,效率很低。 当数据是多维,比如三维(x,y,z),B树怎么索引?比如z可能是高程值,也可能是时间。有人会说B树其实可以对多个字段进行索引,但这时需要指定优先级,形成一个组合字段,而空间数据在各个维度方向上不存在优先级,我们不能说纬度比经度更重要,也不能说纬度比高程更重要。 当空间数据不是点,而是线(道路、地铁、河流等),面(行政区边界、建筑物等),B树怎么索引?对于面来说,它由一系列首尾相连的经纬度坐标点组成,一个面可能有成百上千个坐标,这时数据库怎么存储,B树怎么索引,这些都是问题。 既然传统的索引不能很好的索引空间数据,我们自然需要一种方法能对空间数据进行索引,即空间索引。 参考 Java实现GPS范围查找 浙大大佬通俗说GPS 本文分享自微信公众号 - sowhat1412(sowhat9094)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Class文件结构全面解析(下)

类索引和父类索引 类索引(this_class)和父类索引(super_class)都是一个u2类型的数据,类索引用于确定这个类的全限定名,父类索引用于确定这个类的父类全限定名。由于java语言不允许多重继承,所以父类索引只有一个。 类索引和父类索引各自指向常量池中类型为CONSTANT_Class_info的类描述符,再通过类描述符中的索引值找到常量池中类型为CONSTANT_Utf8_info的字符串。再来看一下之前的Class文件例子: 结合之前javap分析出来的常量池内容: #3 = Class #17 // OneMoreStudy #4 = Class #18 // java/lang/Object #17 = Utf8 OneMoreStudy #18 = Utf8 java/lang/Object 类索引为0x0003,去常量池里找索引为3的类描述符,类描述符中的索引为17,再去找索引为17的字符串,就是“OneMoreStudy”。 父类索引为0x0004,去常量池里找索引为4的类描述符,类描述符中的索引为18,再去常量池里找索引为18的字符串,就是“java/lang/Object”。 接口索引集合 接口索引集合(interface)是一组u2类型的数据的集合,由于java语言允许实现多个接口,所以接口索引也有多个,它们按照implements语句后的接口顺序从左到右依次排列在接口索引集合中。接口索引集合的第一项数据是接口集合计数值(interfaces_count),表示有多少接口索引。如果该类没有实现任何接口,那么该计数值为0,后面的接口索引表不占任何字节。之前的例子OneMoreStudy类没有实现任何接口,所以接口集合计数值就是0,如下图: 字段表集合 字段表(field_info)是用来描述接口或类中声明的变量。包括类级变量(静态变量)和实例级变量(成员变量),但是不包括在方法内部声明的局部变量。具体结构如下表: 字段表中的access_flags,和类的access_flags是非常类似的,但是标识和含义是不一样的。具体如下表: 这里提到了简单名称、描述符,和全限定名有什么区别呢?稍微说一下。 简单名称是没有类型和参数修饰的方法或字段名称,比如OneMoreStudy类中的number字段和plusOne()方法的简单名称分别是“number”和“plusOne”。 全限定名是把类全名中的“.”替换成“/”就可以了,比如java.lang.Object类的全限定名就是“java/lang/Object”。 描述符是用来描述字段的数据类型、方法的参数列表(包括数量、类型以及顺序)和返回值。基础数据类型和无返回的void类型都有一个大写字母表示,对象类型用字符L加对象的全限定名来表示,如下表: 对于数组类型,每一维度使用一个前置的“[”字符来描述,比如java.lang.Object[][]的二维数据,就是“[[Ljava/lang/Object”。在描述方法时,按照先参数列表,后返回值的顺序描述,参数列表按照严格顺序放在“()”值中,比如boolean equals(Object anObject),就是“(Ljava/lang/Object)B”。 再来看一下之前的Class文件例子: OneMoreStudy类中只有一个字段number,所以字段计数值为0x0001。字段number只被private修饰,没有其他修饰,所以字段的访问标志位为0x0002。字段的简单名称索引是0x0005,去常量池中找索引为5的字符串,为“number”。字段的描述符索引为0x0006,去常量池中找索引为6的字符串,为“I”,是基本类型int。以下是常量池相关内容: #5 = Utf8 number #6 = Utf8 I 字段number的属性计数值为0x0000,也就是没有需要额外描述的信息。 字段表集合中不会列出从父类或者父接口中继承而来的字段,但有可能列出原版Java代码中没有的字段,比如在内部类中为了保持对外部类的访问性,会自动添加指向外部类实例的字段。 方法表集合 方法表的结构和字段表的是一样的,也是依次包括了访问标志(access_flags)、名称索引(name_index)、描述符索引(descriptor_index)和属性表集合(attributes)。具体如下表: 对于方法的访问标志,所有标志位和取值如下表: 方法中的Java代码,经过编译器编程成字节码指令后,放在方法属性表集合中一个名为“Code”的属性里,后面会有更多分享。 再来看一下之前的Class文件例子: 方法计算值为0x0003,表示集合中有两个方法(编译器自动添加的无参构造方法和源码中的plusOne方法)。第一个方法的访问标志是0x0001,表示只有ACC_PUBLIC标志为true。 名称索引为0x0007,在常量池中为索引为7的字符串为“”,这就是编译器自动添加的无参构造方法。描述符索引为0x0008,在常量池中为索引为7的字符串为“()V”,方法的属性计数值为0x0001,表示该方法有1个属性,属性名称索引为0x0009,在常量池中为索引为7的字符串为“Code”。以下是常量池相关内容: #7 = Utf8 <init> #8 = Utf8 ()V #9 = Utf8 Code 属性表集合 属性表(attribute_info)在前面的分享中出现了几次,在Class文件、字段表、方法表都可以有自己的属性表集合,用来描述某些场景下特有的信息。 属性表不在要求具有严格的顺序,并且只要不与已有的属性名重复,任何人实现的编译器都可以写入自己定义的属性信息,Java虚拟机在运行时会忽略掉它不认识的属性。 我总结了一些比较常见的属性,如下表: 对于每个属性,它的名称都从常量池中引用一个CONSTANT_Utf8_info类型的常量,而属性值的结构则是完全自定义的,只需要用一个u4类型来说明属性值所占的位数就可以了。具体结构如下: 总结 Class文件主要由魔数、次版本号、主版本号、常量池集合、访问标志、类索引、父类索引、接口索引集合、字段表集合、方法表集合和属性表集合组成。随着JDK版本的不断升级,Class文件结构也在不断更新,学习之路,永不止步。

优秀的个人博客,低调大师

Class文件结构全面解析(上)

什么是Class文件? 在Java刚刚诞生的时候就提出了一个非常著名的口号:“一次编写,到处运行。(Write Once,Run Anywhere)”。为了实现平台无关性,各种不同平台的虚拟机都统一使用一种程序储存格式,就是字节码(ByteCode)。它就以二进制字节流的方式被存放在Class文件中,其中包含了Java虚拟机指令集和符号表以及其他辅助信息。 为什么需要了解Class文件结构? 一般对于数据结构的分享难免比较枯燥,但是了解Class文件结构是了解Java虚拟机的重要基础之一。如果想比较深入地了解Java虚拟机,那么Class文件结构是不能不接触的。我会力求在保证逻辑准确的基础上,尽量通俗易懂地分享,并结合实际案例。 Class文件结构简介 Class文件是一组以8位字节为基础单位的二进制流,各个数据项目严格按照顺序准确地排列在Class文件中,中间没有任何分隔符。当遇到8位字节以上的数据时,就按照高位在前的方式(最高位字节在地址最低位、最低位字节在地址最高位的顺序储存)分割成多个8位字节储存。 Class文件格式采用一种类似于C语言结构体的伪结构来储存数据的,这种伪结构有两种数据类型:无符号数和表。 无符号数用u1、u2、u4、u8分别代表1个字节、2个字节、4个字节和8个字节的无符号数,可以用来描述数字、索引引用、数量值或者UTF-8编码构成的字符串值。 表是由多个无符号数或其他表作为数据项构成的复合数据类型,所有的表都习惯地以“_info”结尾。表的数据结构和树很类似,无符号数相当于它的叶子节点,其他的表相当于它的子节点。整个Class文件就本质上也是一个表,具体结构如下: 可以发现,无论是无符号数还是表,当需要描述同一种类型又数量不定的多条数据时,就会用一个前置的计数器加几个连续的数据项的方式,这个时候我们就把这种一系列连续的某种类型的数据叫做这个类型的集合。 在Class文件中,无论是顺序还是数量,甚至是数据存储的字节序,都必须严格按照上面表格进行设定,哪个字节代表什么含义,长度是多少,先后顺序怎么样,都不允许改变。接下来看一下各个数据项的具体含义。 魔数 魔数(Magic Number)是每个Class文件的前4个字节,它用来确定当前文件是否是一个被Java虚拟机所接受的Class文件。很多文件存储标准中都使用了魔数进行身份识别,比如gif、jpeg等图片文件中都有魔数。使用魔数而不使用扩展名是出于安全考虑,因为扩展名更容易被修改。文件格式制定者可以自主选择魔数,只要这个魔数没有被广泛使用又不和其他文件混淆就可以。 Class文件的魔数是:0xCAFEBABE,这个魔数在Java还被称为“Oak”语言的时候就确定下来了,据Java开发小组最初的关键成员Patrick Naughton说:“我们一直在寻找一些好玩的、容易记忆的东西,选择0xCAFEBABE是因为它象征着著名咖啡品牌Peet's Coffee中深受欢迎的Baristas咖啡”,他们是真的很喜欢喝咖啡啊,可能也预示着日后“Java”这个名字的出现。 为了更快的理解,我准备了一个实际案例,一段非常简单的Java代码: public class OneMoreStudy { private int number; private int plusOne() { return number + 1; } } 使用JDK 1.7把这段代码编译成Class文件,用HexEd打开,就可以到魔数了,如下图: 在接下来的分享中,也会经常使用这个Class文件。 次版本号和主版本号 紧跟着魔数的第5和第6个字节是次版本号(Minor Version),第7和第8个字节是主版本号(Major Version)。Java的主版本号是从45开始的,从JDK 1.1以后每个JDK大版本发布主版本号都加1,高版本的JDK向下兼容低版本的Class文件,但不能运行更高版本的Class文件,即使Class文件的格式没有发生任何变化,Java虚拟机也会拒绝运行超过其版本号的Class文件。 再来看一下之前的Class文件例子: 表示次版本号的第5和第6个字节值为0x0000,表示主版本号的第7和第8个字节值为0x0033,也就是十进制的51,说明这个Class文件可以被JDK 1.7及其以上版本的Java虚拟机运行。 常量池 紧跟着主版本号的就是常量池,它可以理解为Class文件的资源仓库,也是Class文件结构中与其他数据项关联最多的数据类型。因为在常量池中的常量数量是不固定的,所以首先有一个u2类型的数据,表示常量池容量大小(constant_pool_count)。 常量池的容量计数不是从0开始的,而是从1开始的,这是因为0有它的特殊用用途,那就是为了表达在特殊情况下需要表达“不引用任何一个常量池项目”的含义。在Class文件结构中只有常量池的容量计数是从1开始的,对于其他集合,包括接口索引集合、字段集合、方法集合等的容量计数都是从0开始的。 再来看一下之前的Class文件例子: 常量池容器计数值为0x0013,也就是十进制的19,它表示常量池中有18个常量,索引值范围从1到18。 常量池中主要存储两种常量:字面量(Literal)和符号引用(Symbolic References)。字面量比较接近Java语言层面的常量,比如文本字符串、声明为final的常量值。符号引用则是编译原理层次的概念,它包括以下三种: 类和接口的全限定名 字段的名称和描述符 方法的名称和描述符 常量池中每一个常量都是一个表,共有14种不同的常量类型(JDK1.7及之前版本),每一种类型的表在第一位都有一个u1类型的标志位,具体如下表: 有个一个专门分析Class文件字节码的工具javap,我们用它直接看一下之前的Class文件例子里的18个常量(常量池以外的信息已省略): E:\>javap -verbose OneMoreStudy Compiled from "OneMoreStudy.java" minor version: 0 major version: 51 Constant pool: #1 = Methodref #4.#15 // java/lang/Object."<init>":()V #2 = Fieldref #3.#16 // OneMoreStudy.number:I #3 = Class #17 // OneMoreStudy #4 = Class #18 // java/lang/Object #5 = Utf8 number #6 = Utf8 I #7 = Utf8 <init> #8 = Utf8 ()V #9 = Utf8 Code #10 = Utf8 LineNumberTable #11 = Utf8 plusOne #12 = Utf8 ()I #13 = Utf8 SourceFile #14 = Utf8 OneMoreStudy.java #15 = NameAndType #7:#8 // "<init>":()V #16 = NameAndType #5:#6 // number:I #17 = Utf8 OneMoreStudy #18 = Utf8 java/lang/Object 其中,有一些常量好像在代码里没有出现过,如“I”、“”、“Code”、“LineNumberTable”、“SourceFile”。它们其实自动生成的,是后面要分享的字段表、方法表、属性表引用到的,用于描述一些不方便使用“固定字节”进行表达的内容。 访问标志 紧跟着常量池的2个字节表示访问标志(access_flags),它用于识别一些类或接口层次的访问信息,具体见下表: 其中,ACC_SUPER在JDK 1.0.2之后编译出来的Class文件必须为true;ACC_ABSTRACT对于接口或抽象类来说为true,其他类为false。 之前的例子OneMoreStudy是一个普通的类,不是接口、注解或枚举,只被public修饰,没有被声明为final或abstract,而且是JDK 1.7编译的,所以只有ACC_PUBLIC和ACC_SUPER为true,所以它的访问标志应该是0x0001 | 0x0020 = 0x0021,如下图:

优秀的个人博客,低调大师

图文解析:DataWorks添加安全组

云栖号快速入门:【点击查看更多云产品快速入门】不知道怎么入门?这里分分钟解决新手入门等基础问题,可快速完成产品配置操作! 本文将为您介绍选择不同区域的DataWorks时,如何添加需要的安全组。 通常,如果您使用的是ECS自建数据库,则必须添加安全组才能保证数据源连通性正常。 为保证数据库的安全稳定,在开始使用数据库的实例前,您需要将访问数据库的IP地址或IP段加到目标实例的白名单或安全组中。添加白名单的详情请参见添加白名单。 添加安全组 如果您的ECS上的自建数据源同步任务运行在自定资源组上,需要给自定资源组机器授权,将自定义机器内/外网的IP和端口添加到ECS安全组上。 如果您的ECS上的自建数据源运行在默认的资源组上,需要给默认的机器授权。根据您的ECS的机器区域来选择添加您的安全组内容,例如您的ECS是华北2,安全组便添加华北2(北京):sg-2ze3236e8pcbxw61o9y0和1156529087455811内容,并且只能在华北2添加数据源,如下表所示。 ECS添加安全组 1.登录云服务器ECS的管理控制台。2.进入网络和安全 > 安全组页面,选择目标区域。3.找到要配置授权规则的安全组,单击操作列下的配置规则。4.进入安全组规则 > 入方向页面,单击右上角的添加安全组规则。5.填写添加安全组规则对话框中的配置。6.单击确定。 本文来自 阿里云文档中心 DataWorks 添加安全组 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK

优秀的个人博客,低调大师

Cassandra源码解析系列启动模块

以3.11.4为基础 Cassandra 启动流程从bin下面的cassandra脚本开始进去看,会涉及到cassandra-env.sh进行进程启动的一些参数设置比如堆上内存分配,日志参数配置,基本环境设置等,我们直接看到启动的进程,也就是launch_service 这个函数,然后看到里面的exec 执行JAVA的进程,也就是class(launch_service参数传进来的classname为org.apache.cassandra.service.CassandraDaemon类);大概的流程是: cassandra -> lauch_service -> JAVA启动org.apache.cassandra.service.CassandraDaemon; 接下来就是看到org.apache.cassandra.service.CassandraDaemon这个类,直接在这个类里面通过main函数找到启动的入口: public static void main(String[] args) { instance.activate(); } 在active函数里面有3个主要要看的函数: // Do not put any references to DatabaseDescriptor above the forceStaticInitialization call. try { applyConfig(); MBeanWrapper.instance.registerMBean(new StandardMBean(new NativeAccess(), NativeAccessMBean.class), MBEAN_NAME, MBeanWrapper.OnException.LOG); if (FBUtilities.isWindows) { // We need to adjust the system timer on windows from the default 15ms down to the minimum of 1ms as this // impacts timer intervals, thread scheduling, driver interrupts, etc. WindowsTimer.startTimerPeriod(DatabaseDescriptor.getWindowsTimerInterval()); } setup(); String pidFile = System.getProperty("cassandra-pidfile"); if (pidFile != null) { new File(pidFile).deleteOnExit(); } start(); } catch (Throwable e) { boolean logStackTrace = e instanceof ConfigurationException ? ((ConfigurationException)e).logStackTrace : true; System.out.println("Exception (" + e.getClass().getName() + ") encountered during startup: " + e.getMessage()); if (logStackTrace) { if (runManaged) logger.error("Exception encountered during startup", e); // try to warn user on stdout too, if we haven't already detached e.printStackTrace(); exitOrFail(3, "Exception encountered during startup", e); } else { if (runManaged) logger.error("Exception encountered during startup: {}", e.getMessage()); // try to warn user on stdout too, if we haven't already detached System.err.println(e.getMessage()); exitOrFail(3, "Exception encountered during startup: " + e.getMessage()); } } applyConfig();主要是用来初始化cassandra.yaml配置文件里的基本的配置,setup主要是做一些单节点初始化的时候的一些初始化工作,比如load本地的sstable元信息到内存,清除无用的sstable文件,启动的时候没有commit的transaction 执行或回滚,commitlog 的启动以及回放,集群元信息的效验,启动compaction,启动7000端口内部交流server等等事情; start函数主要是启动9042的client监听端口,主要是netty的server,当然如果是thrift的话,也启动9160 端口服务;

优秀的个人博客,低调大师

Aspectj实例探究,解析SentinelResourceAspect实现

为了学习SentinelResourceAspect,这篇文章里我用Aspectj实现一个AOP实例,一起来看下。 Sentinel 提供了 @SentinelResource 注解用于定义资源,支持 AspectJ 的扩展用于自动定义资源、处理 BlockException 等。 SentinelResourceAspect是Sentinel中的核心切面,Sentinel对限流,拦截等的支持都依赖 SentinelResourceAspect,本文回顾AOP相关知识,实现一个AspectJ实例,然后带你从源码角度,探究SentinelResourceAspect的实现。 1、回顾 Spring AOP 知识 AOP为Aspect Oriented Programming的缩写,意为:面向切面编程,通过预编译方式和运行期动态代理实现程序功能的统一维护的一种技术。 利用AOP可以对业务逻辑的各个部分进行隔离,从而使得业务逻辑各部分之间的耦合度降低,提高程序的可重用性,同时提高了开发的效率。 常见使用场景 性能监控 在方法调用前后记录调用时间,方法执行太长或超时报警。 缓存代理 缓存某方法的返回值,下次执行该方法时,直接从缓存里获取。 软件破解 使用AOP修改软件的验证类的判断逻辑。 记录日志 在方法执行前后记录系统日志。 工作流系统 工作流系统需要将业务代码和流程引擎代码混合在一起执行,那么我们可以使用AOP将其分离,并动态挂接业务。 权限验证 方法执行前验证是否有权限执行当前方法,没有则抛出没有权限执行异常,由业务代码捕捉。 AOP的一些概念 Aspect Aspect : 声明类似于 Java 中的类声明,在 Aspect 中会包含着一些 Pointcut 以及相应的 Advice。 Joint point : 拦截点,如某个业务方法, 表示在程序中明确定义的点,典型的包括方法调用,对类成员的访问以及异常处理程序块的执行等等,它自身还可以嵌套其它 joint point。 Pointcut : 表示一组 joint point,这些 joint point 或是通过逻辑关系组合起来,或是通过通配、正则表达式等方式集中起来,即Joinpoint的表达式,表示拦截哪些方法。一个Pointcut对应多个Joinpoint Advice Advice : 定义了在 pointcut 里面定义的程序点具体要做的操作,即要切入的逻辑,它通过 before、after 和 around 来区别是在每个 joint point 之前、之后还是代替执行的代码。 Target : 被aspectj横切的对象。我们所说的joinPoint就是Target的某一行,如方法开始执行的地方、方法类调用某个其他方法的代码 在Spring 中,AOP有多种实现方式,AspectJ是其中一种,另外还有JDK 和 Cglig的动态代理等。 2、基于 AspectJ 和@annotation拦截方法实现AOP 在学习 SentinelResourceAspect 源码之前,我先动手实现一个 AspectJ 的AOP实例,完成这个实例以后,SentinelResourceAspect的原理只要看一眼源码就可以明白。 (1)编写Annotation类 @Target({ElementType.METHOD,ElementType.TYPE}) @Documented @Inherited public @interface WorkflowLogAnnotation { String field(); } (2)编写接口和实现类 编写接口类WorkflowService,编写实现类WorkflowServiceImpl,注意此处在方法上增加WorkflowLogAnnotation public class WorkflowServiceImpl implements WorkflowService { @Override @WorkflowLogAnnotation public void start(String bpmnXml) { System.out.println("启动流程"); } } (3)加入切面动作 在流程启动前和启动后做一些操作,增加通知,注意Pointcut表达式改为拦截器方式。 @Aspect public class WorkflowServiceAdviceAspect { public WorkflowServiceAdviceAspect(){ } @Pointcut("annotation(Spring.WorkflowLogAnnotation)") public void startPoint() @Before("startPoint()") public void before(Method arg0, Object[] arg1, Object arg2) throws Throwable { System.out.println("执行方法前"); } @AfterReturning("startPoint()") public void afterReturning(Object arg0, Method arg1, Object[] arg2, Object arg3) throws Throwable { System.out.println("执行方法后"); } } (4)增加配置 在Xml中增加配置,如果WorkflowServiceAdviceAspect和WorkflowServiceImpl类上增加了@Component,下面的bean声明可以用Spring的自动扫描来替代。 <aop:aspectj-autoproxy /> <!-- 定义通知内容,也就是切入点执行前后需要做的事情 --> <bean id="workflowServiceAdviceAspect" class="Spring.WorkflowServiceAdviceAspect"></bean> <!-- 定义被代理者 --> <bean id="workflowService" class="business.WorkflowServiceImpl"></bean> (5)完成验证 完成上面的操作,一个 AspectJ 实例就完成了,是不是很简单,下面看下 SentinelResourceAspect的源码。 3、SentinelResourceAspect源码 可以看到,SentinelResourceAspect切面和我们上面的实例实现方式是一样的。 public class SentinelResourceAspect extends AbstractSentinelAspectSupport { @Pointcut("@annotation(com.alibaba.csp.sentinel.annotation.SentinelResource)") public void sentinelResourceAnnotationPointcut() { } @Around("sentinelResourceAnnotationPointcut()") public Object invokeResourceWithSentinel(ProceedingJoinPoint pjp) throws Throwable { Method originMethod = resolveMethod(pjp); SentinelResource annotation = originMethod.getAnnotation(SentinelResource.class); if (annotation == null) { // Should not go through here. throw new IllegalStateException("Wrong state for SentinelResource annotation"); } String resourceName = getResourceName(annotation.value(), originMethod); EntryType entryType = annotation.entryType(); Entry entry = null; try { entry = SphU.entry(resourceName, entryType, 1, pjp.getArgs()); Object result = pjp.proceed(); return result; } catch (BlockException ex) { return handleBlockException(pjp, annotation, ex); } catch (Throwable ex) { Class<? extends Throwable>[] exceptionsToIgnore = annotation.exceptionsToIgnore(); // The ignore list will be checked first. if (exceptionsToIgnore.length > 0 && exceptionBelongsTo(ex, exceptionsToIgnore)) { throw ex; } if (exceptionBelongsTo(ex, annotation.exceptionsToTrace())) { traceException(ex, annotation); return handleFallback(pjp, annotation, ex); } // No fallback function can handle the exception, so throw it out. throw ex; } finally { if (entry != null) { entry.exit(1, pjp.getArgs()); } } } } (1)进入方法调用SphU.entry SentinelResourceAspect 使用aspect的around拦截,拦截标注有SentinelResource的注解,进入方法之前调用SphU.entry(resourceName, entryType),结束之后调用entry.exit(); entry = SphU.entry(resourceName, entryType, 1, pjp.getArgs()); Object result = pjp.proceed(); 这个使用方式和我们单机使用 Sentinel的方式是一样的。 (2)handleBlockException处理异常 异常的时候调用handleBlockException方法,会先判断是否是降级需要处理的异常,是的话,则调用fallback方法,否则调用block handler方法。 Method blockHandlerMethod = extractBlockHandlerMethod(pjp, annotation.blockHandler(), annotation.blockHandlerClass()); if (blockHandlerMethod != null) { Object[] originArgs = pjp.getArgs(); // Construct args. Object[] args = Arrays.copyOf(originArgs, originArgs.length + 1); args[args.length - 1] = ex; if (isStatic(blockHandlerMethod)) { return blockHandlerMethod.invoke(null, args); } return blockHandlerMethod.invoke(pjp.getTarget(), args); } // If no block handler is present, then go to fallback. return handleFallback(pjp, annotation, ex); 4、总结 Sentinel 使用了Aspectj来实现切面,可以更方便的应用Sentinel。

优秀的个人博客,低调大师

MongoDB 4.2 内核解析 - Change Stream

MongoDB 从3.6版本开始支持了 Change Stream 能力(4.0、4.2 版本在能力上做了很多增强),用于订阅 MongoDB 内部的修改操作,change stream 可用于 MongoDB 之间的增量数据迁移、同步,也可以将 MongoDB 的增量订阅应用到其他的关联系统;比如电商场景里,MongoDB 里存储新的订单信息,业务需要根据新增的订单信息去通知库存管理系统发货。 Change Stream 与 Tailing Oplog 对比 在 change stream 功能之前,如果要获取 MongoDB 增量的修改,可以通过不断 tailing oplog 的方式来 拉取增量的 oplog ,然后针对拉取到的 oplog 集合,来过滤满足条件的 oplog。这种方式也能满足绝大部分场景的需求,但存在如下的不足。 使用门槛较高,用户需要针对 oplog 集合,打开特殊选项的的 tailable cursor ("tailable": true, "awaitData" : true)。 用户需要自己管理增量续传,当拉取应用 crash 时,用户需要记录上一条拉取oplog的 ts、h 等字段,在下一次先定位到指定 oplog 再继续拉取。 结果过滤必须在拉取侧完成,但只需要订阅部分 oplog 时,比如针对某个 DB、某个 Collection、或某种类型的操作,必须要把左右的 oplog 拉取到再进行过滤。 对于 update 操作,oplog 只包含操作的部分内容,比如 {$set: {x: 1}} ,而应用经常需要获取到完整的文档内容。 不支持 Sharded Cluster 的订阅,用户必须针对每个 shard 进行 tailing oplog,并且这个过程中不能有 moveChunk 操作,否则结果可能乱序。 MongoDB Change Stream 解决了 Tailing oplog 存在的不足 简单易用,提供统一的 Change Stream API,一次 API 调用,即可从 MongoDB Server 侧获取增量修改。 统一的进度管理,通过 resume token 来标识拉取位置,只需在 API 调用时,带上上次结果的 resume token,即可从上次的位置接着订阅。 支持对结果在 Server 端进行 pipeline 过滤,减少网络传输,支持针对 DB、Collection、OperationType 等维度进行结果过滤。 支持 fullDocument: "updateLookup" 选项,对于 update,返回当时对应文档的完整内容。 支持 Sharded Cluster 的修改订阅,相同的 API 请求发到 mongos ,即可获取集群维度全局有序的修改。 Change Stream 实战 以 Mongo shell 为例,使用 Change Stream 非常简单,mongo shell 封装了针对整个实例、DB、Collection 级别的订阅操作。 db.getMongo().watch() 订阅整个实例的修改 db.watch() 订阅指定DB的修改 db.collection.watch() 订阅指定Collection的修改 新建连接1发起订阅操作 mytest:PRIMARY>db.coll.watch([], {maxAwaitTimeMS: 60000}) 最多阻塞等待 1分钟 新建连接2写入新数据 mytest:PRIMARY> db.coll.insert({x: 100}) WriteResult({ "nInserted" : 1 }) mytest:PRIMARY> db.coll.insert({x: 101}) WriteResult({ "nInserted" : 1 }) mytest:PRIMARY> db.coll.insert({x: 102}) WriteResult({ "nInserted" : 1 }) 连接1上收到 Change Stream 更新 mytest:PRIMARY> db.watch([], {maxAwaitTimeMS: 60000}) { "_id" : { "_data" : "825E0D5E35000000012B022C0100296E5A1004EA4E00977BCC482FB44DEED9A3C2999946645F696400645E0D5E353BE5C36D695042C90004" }, "operationType" : "insert", "clusterTime" : Timestamp(1577934389, 1), "fullDocument" : { "_id" : ObjectId("5e0d5e353be5c36d695042c9"), "x" : 100 }, "ns" : { "db" : "test", "coll" : "coll" }, "documentKey" : { "_id" : ObjectId("5e0d5e353be5c36d695042c9") } } { "_id" : { "_data" : "825E0D5E37000000012B022C0100296E5A1004EA4E00977BCC482FB44DEED9A3C2999946645F696400645E0D5E373BE5C36D695042CA0004" }, "operationType" : "insert", "clusterTime" : Timestamp(1577934391, 1), "fullDocument" : { "_id" : ObjectId("5e0d5e373be5c36d695042ca"), "x" : 101 }, "ns" : { "db" : "test", "coll" : "coll" }, "documentKey" : { "_id" : ObjectId("5e0d5e373be5c36d695042ca") } } { "_id" : { "_data" : "825E0D5E39000000012B022C0100296E5A1004EA4E00977BCC482FB44DEED9A3C2999946645F696400645E0D5E393BE5C36D695042CB0004" }, "operationType" : "insert", "clusterTime" : Timestamp(1577934393, 1), "fullDocument" : { "_id" : ObjectId("5e0d5e393be5c36d695042cb"), "x" : 102 }, "ns" : { "db" : "test", "coll" : "coll" }, "documentKey" : { "_id" : ObjectId("5e0d5e393be5c36d695042cb") } } 上述 ChangeStream 结果里,_id 字段的内容即为 resume token,标识着 oplog 的某个位置,如果想从某个位置继续订阅,在 watch 时,通过 resumeAfter 指定即可。比如每个应用订阅了上述3条修改,但只有第一条已经成功消费了,下次订阅时指定第一条的 resume token 即可再次订阅到接下来的2条。 mytest:PRIMARY> db.coll.watch([], {maxAwaitTimeMS: 60000, resumeAfter: { "_data" : "825E0D5E35000000012B022C0100296E5A1004EA4E00977BCC482FB44DEED9A3C2999946645F696400645E0D5E353BE5C36D695042C90004" }}) { "_id" : { "_data" : "825E0D5E37000000012B022C0100296E5A1004EA4E00977BCC482FB44DEED9A3C2999946645F696400645E0D5E373BE5C36D695042CA0004" }, "operationType" : "insert", "clusterTime" : Timestamp(1577934391, 1), "fullDocument" : { "_id" : ObjectId("5e0d5e373be5c36d695042ca"), "x" : 101 }, "ns" : { "db" : "test", "coll" : "coll" }, "documentKey" : { "_id" : ObjectId("5e0d5e373be5c36d695042ca") } } { "_id" : { "_data" : "825E0D5E39000000012B022C0100296E5A1004EA4E00977BCC482FB44DEED9A3C2999946645F696400645E0D5E393BE5C36D695042CB0004" }, "operationType" : "insert", "clusterTime" : Timestamp(1577934393, 1), "fullDocument" : { "_id" : ObjectId("5e0d5e393be5c36d695042cb"), "x" : 102 }, "ns" : { "db" : "test", "coll" : "coll" }, "documentKey" : { "_id" : ObjectId("5e0d5e393be5c36d695042cb") } } Change Stream 内部实现 watch() wrapper db.watch() 实际上是一个 API wrapper,实际上 Change Stream 在 MongoDB 内部实际上是一个 aggregation 命令,只是加了一个特殊的 $changestream 阶段,在发起 change stream 订阅操作后,可通过 db.currentOp() 看到对应的 aggregation/getMore 操作的详细参数。 { "op" : "getmore", "ns" : "test.coll", "command" : { "getMore" : NumberLong("233479991942333714"), "collection" : "coll", "maxTimeMS" : 50000, "lsid" : { "id" : UUID("e4fffa71-e168-4527-be61-f0918849d107") }, }, "planSummary" : "COLLSCAN", "cursor" : { "cursorId" : NumberLong("233479991942333714"), "createdDate" : ISODate("2019-12-31T06:35:52.479Z"), "lastAccessDate" : ISODate("2019-12-31T06:36:09.988Z"), "nDocsReturned" : NumberLong(1), "nBatchesReturned" : NumberLong(1), "noCursorTimeout" : false, "tailable" : true, "awaitData" : true, "originatingCommand" : { "aggregate" : "coll", "pipeline" : [ { "$changeStream" : { "fullDocument" : "default" } } ], "cursor" : { }, "lsid" : { "id" : UUID("e4fffa71-e168-4527-be61-f0918849d107") }, "$clusterTime" : { "clusterTime" : Timestamp(1577774144, 1), "signature" : { "hash" : BinData(0,"AAAAAAAAAAAAAAAAAAAAAAAAAAA="), "keyId" : NumberLong(0) } }, "$db" : "test" }, "operationUsingCursorId" : NumberLong(7019500) }, "numYields" : 2, "locks" : { } } resume token resume token 用来描述一个订阅点,本质上是 oplog 信息的一个封装,包含 clusterTime、uuid、documentKey等信息,当订阅 API 带上 resume token 时,MongoDB Server 会将 token 转换为对应的信息,并定位到 oplog 起点继续订阅操作。 struct ResumeTokenData { Timestamp clusterTime; int version = 0; size_t applyOpsIndex = 0; Value documentKey; boost::optional<UUID> uuid; }; ResumeTokenData 结构里包含 version 信息,在 4.0.7 以前的版本,version 均为0; 4.0.7 引入了一种新的 resume token 格式,version 为 1; 另外在 3.6 版本里,Resume Token 的编码与 4.0 也有所不同;所以在版本升级后,有可能出现不同版本 token 无法识别的问题,所以尽量要让 MongoDB Server 所有组件(Replica Set 各个成员,ConfigServer、Mongos)都保持相同的内核版本。 更详细的信息,参考 https://docs.mongodb.com/manual/reference/method/Mongo.watch/#resumability updateLookup Change Stream 支持针对 update 操作,获取当前的文档完整内容,而不是仅更新操作本身,比如 mytest:PRIMARY> db.coll.find({_id: 101}) { "_id" : 101, "name" : "jack", "age" : 18 } mytest:PRIMARY> db.coll.update({_id: 101}, {$set: {age: 20}}) WriteResult({ "nMatched" : 1, "nUpserted" : 0, "nModified" : 1 }) 上面的 update 操作,默认情况下,change stream 会收到 {_id: 101}, {$set: {age: 20} 的内容,而并不会包含这个文档其他未更新字段的信息;而加上 fullDocument: "updateLookup" 选项后,Change Stream 会根据文档 _id 去查找文档当前的内容并返回。 需要注意的是,updateLookup 选项只能保证最终一致性,比如针对上述文档,如果连续更新100次,update 的 change stream 并不会按顺序收到中间每一次的更新,因为每次都是去查找文档当前的内容,而当前的内容可能已经被后续的修改覆盖。 Sharded cluster Change Stream 支持针对 sharded cluster 进行订阅,会保证全局有序的返回结果;为了达到全局有序这个目标,mongos 需要从每个 shard 都返回订阅结果按时间戳进行排序合并返回。 在极端情况下,如果某些 shard 写入量很少或者没有写入,change stream 的返回延时会受到影响,因为需要等到所有 shard 都返回订阅结果;默认情况下,mongod server 每10s会产生一条 Noop 的特殊oplog,这个机制会间接驱动 sharded cluster 在写入量不高的情况下也能持续运转下去。 由于需要全局排序,在 sharded cluster 写入量很高时,Change Stream 的性能很可能跟不上;如果对性能要求非常高,可以考虑关闭 Balancer,在每个 shard 上各自建立 Change Stream。 参考资料 Change Stream Manual Change Streams Production Recommendations Tailable Cursors/

优秀的个人博客,低调大师

AnalyticDB for MySQL 3.0 技术架构解析

企业数据需求不断变化,近年来变化趋势日益明显,从数据的3V特性看:体积,速度和变化;Big Data强调数据量,PB级以上,是静态数据。而Fast Data在数据量的基础上,意味着速度和和变化,意味着客户可以更加实时化、更加快速地进行数据处理。在Forrester最近的一项研究中,超过75%的受访公司已经使用Fast Data解决方案。 在接受调查的人中,88%表示他们需要近乎实时地对数据执行分析。 AnalyticDB是阿里巴巴自主研发、唯一经过超大规模以及核心业务验证的PB级实时数据仓库,是FastData的最佳代表。自2012年第一次在集团发布上线以来,至今已累计迭代发布近百个版本,支撑起集团内的电商、广告、菜鸟、文娱、飞猪等众多在线分析业务。AnalyticDB于2014年在阿里云开始正式对外输出,支撑行业既包括传统的大中型

优秀的个人博客,低调大师

go源码解析-Println的故事

本文主要通过平常常用的go的一个函数,深入源码,了解其底层到底是如何实现的。 Println Println函数接受参数a,其类型为…interface{}。用过Java的对这个应该比较熟悉,Java中也有…的用法。其作用是传入可变的参数,而interface{}类似于Java中的Object,代表任何类型。 所以,…interface{}转换成Java的概念,就是Object args ...。 Println函数中没有什么实现,只是return了Fprintln函数。 func Println(a ...interface{}) (n int, err error) { return Fprintln(os.Stdout, a...) } 而在此处的…放在了参数的后面。我们知道...interface{}是代表可变参数,即函数可接收任意数量的参数,而且参数参数分开写的。 当我们再调用这个函数的时候,我们就没有必要再将参数一个一个传给被调用函数了,直接使用a…就可以达到相同的效果。 Fprintln 该函数接收参数os.Stdout.write,和需要打印的数据作为参数。 func Fprintln(w io.Writer, a ...interface{}) (n int, err error) { p := newPrinter() p.doPrintln(a) n, err = w.Write(p.buf) p.free() return } sync.Pool 从广义上看,newPrinter申请了一个临时对象池。我们逐行来看newPrinter函数做了什么。 var ppFree = sync.Pool{ New: func() interface{} { return new(pp) }, } // newPrinter allocates a new pp struct or grabs a cached one. func newPrinter() *pp { p := ppFree.Get().(*pp) p.panicking = false p.erroring = false p.wrapErrs = false p.fmt.init(&p.buf) return p } sync.Pool是go的临时对象池,用于存储被分配了但是没有被使用,但是未来可能会使用的值。以此来减少 GC的压力。 ppFree.Get ppFree.Get()上有大量的注释。 Get selects an arbitrary item from the Pool, removes it from the Pool, and returns it to the caller. Get may choose to ignore the pool and treat it as empty. Callers should not assume any relation between values passed to Put and the values returned by Get. If Get would otherwise return nil and p.New is non-nil, Get returns the result of calling p.New. 麻瓜翻译一波。 Get会从临时对象池中任意选一个printer返回给调用者,并且将此项从对象池中移除。 Get也可以选择把临时对象池当成空的忽略。调用者不应该假设传递给Put方法的值和Get返回的值之间存在任何关系。 如果Get函数没有获取到资源但是p.New函数可以申请到新的资源,就直接返回p.New的值。 上面提到的Put方法,作用是将对象加入到临时对象池中。 p := ppFree.Get().(*pp)下面的三个参数分别代表什么呢? 参数名 用途 p.panicking 由catchPanic设置,是为了避免在panic和recover中无限循环 p.erroring 当打印错误的标识符的时候,防止调用handleMethods p.wrapErrs 当格式字符串包含了动词时的设置 fmt.init 初始化 fmt 配置,会设置 buf 并且清空 fmtFlags 标志位 然后就返回这个新建的printer给调用方。 doPrintln 接下来是doPrintln函数。 doPrintln就跟doPrint类似,但是doPrintln总是会在参数之间添加一个空格,并且在最后一个参数后面添加换行符。以下是两种输出方式的对比。 fmt.Println("test", "hello", "word") // test hello word fmt.Print("test", "hello", "word") // testhelloword% 看了样例,我们再具体看一下doPrintln的具体实现。 func (p *pp) doPrintln(a []interface{}) { for argNum, arg := range a { if argNum > 0 { p.buf.writeByte(' ') } p.printArg(arg, 'v') } p.buf.writeByte('\n') } 这个函数的思路很清晰。遍历所有传入的需要print的参数,在除了第一个 参数以外的所有参数的前面加上一个空格,写入buffer中。然后调用printArg函数,再将换行符写入buffer中。 writeByte的实现很简单,使用了append函数,将传入的参数,append到buffer中。 func (b *buffer) writeByte(c byte) { *b = append(*b, c) } printArg 从上可以看出,调用printArg函数的时候,传入了两个参数。 第一个是需要打印的参数,第二个则是verb,在doPrintln中我们传的是单引号的v。那么在go中的单引号和双引号有什么区别呢?下面我们通过一个表格来对比一下在不同的语言中,单引号和双引号的区别。 语言 单引号 双引号 Java char String JavaScript string string go rune String Python string string rune 那么rune到底是什么类型呢?rune是int32的别名,在任何方面等于int32相同,用于区分字符串和整形。其实现很简单,type rune = int32,rune常用来表示Unicode中的码点,其例子如下所示。 str := "hello 你好" fmt.Println([]rune(str)) // [104 101 108 108 111 32 20320 22909] 说到了rune就不得不说一下byte。同样,我们通过例子来看一下byte和rune的区别。 str := "hello 你好" fmt.Println([]rune(str)) // [104 101 108 108 111 32 20320 22909] fmt.Println([]byte(str)) // [104 101 108 108 111 32 228 189 160 229 165 189] 没错,区别就在类型上。rune是type rune = int32,四个字节;而byte是type byte = uint8,一个字节。实际上,golang中的字符串的底层是靠byte数组实现的。如果我们处理的数据中出现了中文字符,都可用rune来处理。例如。 str := "hello 你好" fmt.Println(len(str)) // 12 fmt.Println(len([]rune(str))) // 8 printArg具体实现 func (p *pp) printArg(arg interface{}, verb rune) { p.arg = arg p.value = reflect.Value{} if arg == nil { switch verb { case 'T', 'v': p.fmt.padString(nilAngleString) default: p.badVerb(verb) } return } switch verb { case 'T': p.fmt.fmtS(reflect.TypeOf(arg).String()) return case 'p': p.fmtPointer(reflect.ValueOf(arg), 'p') return } switch f := arg.(type) { case bool: p.fmtBool(f, verb) case float32: p.fmtFloat(float64(f), 32, verb) case float64: p.fmtFloat(f, 64, verb) case complex64: p.fmtComplex(complex128(f), 64, verb) case complex128: p.fmtComplex(f, 128, verb) case int: p.fmtInteger(uint64(f), signed, verb) case int8: p.fmtInteger(uint64(f), signed, verb) case int16: p.fmtInteger(uint64(f), signed, verb) case int32: p.fmtInteger(uint64(f), signed, verb) case int64: p.fmtInteger(uint64(f), signed, verb) case uint: p.fmtInteger(uint64(f), unsigned, verb) case uint8: p.fmtInteger(uint64(f), unsigned, verb) case uint16: p.fmtInteger(uint64(f), unsigned, verb) case uint32: p.fmtInteger(uint64(f), unsigned, verb) case uint64: p.fmtInteger(f, unsigned, verb) case uintptr: p.fmtInteger(uint64(f), unsigned, verb) case string: p.fmtString(f, verb) case []byte: p.fmtBytes(f, verb, "[]byte") case reflect.Value: if f.IsValid() && f.CanInterface() { p.arg = f.Interface() if p.handleMethods(verb) { return } } p.printValue(f, verb, 0) default: if !p.handleMethods(verb) { p.printValue(reflect.ValueOf(f), verb, 0) } } } 可以看到有一部分类型是通过反射获取到的,而大部分都是switch case出来的,并不是所有的类型都用的反射,相对的提高了效率。 例如,我们传入的是字符串。则接下来就会走到fmtString。 fmtString 从printArg中带来的参数有需要打印的字符串,以及rune类型的'v'。 func (p *pp) fmtString(v string, verb rune) { switch verb { case 'v': if p.fmt.sharpV { p.fmt.fmtQ(v) } else { p.fmt.fmtS(v) } case 's': p.fmt.fmtS(v) case 'x': p.fmt.fmtSx(v, ldigits) case 'X': p.fmt.fmtSx(v, udigits) case 'q': p.fmt.fmtQ(v) default: p.badVerb(verb) } } p.fmt.sharpV在过程中没有被重新赋值,初始化的零值为false。所以下一步会进入fmtS。 fmtS func (f *fmt) fmtS(s string) { s = f.truncateString(s) f.padString(s) } 如果存在设定的精度,则truncate将字符串s截断为指定的精度。多用于需要输出数字时。 func (f *fmt) truncateString(s string) string { if f.precPresent { n := f.prec for i := range s { n-- if n < 0 { return s[:i] } } } return s } 而padString则将字符串s写入buffer中,最后调用io的包输出就好了。 free func (p *pp) free() { if cap(p.buf) > 64<<10 { return } p.buf = p.buf[:0] p.arg = nil p.value = reflect.Value{} p.wrappedErr = nil ppFree.Put(p) } 在前面讲过,要打印的时候,需要从临时对象池中获取一个对象,避免重复创建。而在此处,用完之后就需要通过Put函数将其放回临时对象池中,已备下次调用。 当然,并不是无限的将用过的变量放入对象池。如果缓冲区的大小超过了设定的阙值也就是65535,就无法再执行后续的操作了。 写在最后 看源码是个技术活,其实这篇博客也算是一种尝试。最近看到一个图很有意思,跟大家分享一下。这张图讲的是你以为的看源码。 然后是实际上的你看源码。 这张图特别形象。当你打算看一个开源项目的源码的时候,往往像一个饿了很多天没吃饭的人看到一桌美食一样,恨不得几分钟就把桌上的东西全部吃完,最后撑的半死,全部吐了出来;又或许像上面两张图里的水一样,接的太快,最后杯子里剩的反而越少。 相反,如果我们慢慢的品味美食,慢慢的去接水,肚子里的食物和水杯的水就一定会慢慢增加,直到适量为止。 我认为看源码,不应该一口吃成胖子,细水长流。从某一个小功能开始,慢慢的展开,这样才能了解到更多的东西。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册