首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10000篇文章
优秀的个人博客,低调大师

Java 源码解析实战 - ThreadLocal 原理

说起CS游戏,应该是每个中二少年的年少回忆了.游戏开始时,每个人能够领到一把枪,枪把上有三个数字:子弹数、杀敌数、自己的命数,为其设置的初始值分别为1500、0、10. 设战场上的每个人都是一个线程,那么这三个初始值写在哪里呢?如果每个线程都写死这三个值,万一将初始子弹数统一改成 1000发呢?如果共享,那么线程之间的并发修改会导致数据不准确.能不能构造这样一个对象,将这个对象设置为共享变量,统一设置初始值,但是每个线程对这个值的修改都是互相独立的.这个对象就是ThreadLocal 注意不能将其翻译为线程本地化或本地线程英语恰当的名称应该叫作:CopyValueIntoEveryThread 示例代码该示例中,无 set 操作,那么初始值又是如何进入每个线程成为独立拷贝的呢?首先,虽然ThreadLocal在定义时重写了initial

优秀的个人博客,低调大师

Android冷启动优化解析

前言 事件发生在发包上线的前两天,在某某云进行移动测试时,提示冷启动速度低于平均值的问题,之前自己也曾尝试过优化,但是发现效果并不是很明显,作为一个有追求的开发者,趁着有点空闲时间,要好好研究一下冷启动优化问题。 App的启动流程 我们可以了解一下官方文档《App startup time》对App启动的描述。应用启动分为冷启动、热启动、温启动。而冷启动是应用程序从零开始,里面涉及到更复杂的知识。我们这次主要是对应用的冷启动进行分析和优化。应用在冷启动的时候,需要执行下面三个任务: 加载和启动应用程序; App启动之后立即展示出一个空白的启动窗口; 创建App程序的进程; 在这三个任务执行后,系统创建了应用进程,那么应用进程会执行下一步: 创建App对象; 启动Main Thread; 创建启动页的Activity; 加载View; 布置屏幕; 进行初始绘制; 当应用进程完成初始绘制之后,系统进程用启动页的Activity来替换当前显示的背景窗口,这个时刻用户就可以使用App了。下图显示为系统和应用程序的工作流程。 从上图和上述的步骤我们可以知道,应用进程的创建,那么它肯定会执行我们的Application的生命周期,当创建完成App的应用进程之后,主线程会初始化我们第一个页面MainActivity与执行MainActivity的生命周期。我特意加粗了重点,这就是我们可以下手优化的部分。在分析如何优化前,我们可以先了解一下,我们的应用是不是需要对冷启动进行优化。 PS:其实这些都是我们表面看到的东西,如果我们需要完整地去深究,我们要去具体分析Zygote Fork进程、ActivityManagerService源码等,我们就不在该篇中详述,给大家推荐相关书籍,有罗升阳的《Android系统源代码情景分析》,刘望舒的《Android进阶解密》。 启动时间检测 那么启动时间多少才是合适呢?在官方文档中描述到当冷启动在5秒或者更长的时,Android vitals就会认为你的应用需要进行冷启动相关的优化。不过Android vitals是针对Google Play的一款应用质量检测工具,那大家都明白,不过你可以像我一样使用阿里云的移动测试,阿里云提供的数据中,冷启动的行业指标中位数是4875.67ms,大家可以酌情对比一下。好了,下面我们就聊一下如果检测出我们应用的冷启动时间。 Displayed Time 如上图一显示的Displayed Time,在Android 4.4(API级别19)及更高版本中,logcat包含一个名为Displayed的log信息,此值表示启动过程和完成在屏幕上绘制相应活动之间所经过的时间量。 ADB命令 adb shell am start -W [packageName]/[packageName.MainActivity] 在使用上一个方式Displayed Time的log打印台,我们看到Displayed的log,后面跟着就是下面我们需要的[packageName]/[packageName.MainActivity],我们可以直接复制使用,然后我 们在AS的Terminal中粘贴,接着打印的就是我们指定页面的启动时间数据。 Status: ok Activity: com.xx.xxx/com.xx.xxxx.welcome.view.WelcomeActivity ThisTime: 242 TotalTime: 242 WaitTime: 288 Complete ThisTime:是指调用过程中最后一个Activity启动时间到这个Activity的 startActivityAndWait调用结束; TotalTime:是指调用过程中第一个Activity的启动时间到最后一个Activity的 startActivityAndWait结束。 WaitTime:是startActivityAndWait这个方法的调用耗时; reportFullyDrawn 在某些特殊场景,我们可能不单单启动页的绘制完成回调时间就足够了,我们需要连启动页的闪屏广告接口数据成功回调之后才算一个完整的时间,这时我们可以使用reportFullyDrawn public class WelcomeActivity extends MvpActivity<WelcomePresenter> implements WelcomeMvp.View { @Override protected void onCreate(@Nullable Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.activity_welcome); // 请求数据 mvpPresenter.config(); } @Override public void finishRequest() { // 数据回调 reportFullyDrawn(); } } PS:这个方式minSdkVersion需要API19+,所以要对SDK版本进行设置或判断。 Traceview Traceview是Android设备的一个非常好用的性能分析工具,它可以通过详细的界面,让我们跟踪程序的性能,并且能清晰地查看到每一个函数的耗时和调用次数。 Systrace Systrace非常直观地展示每个线程上面的API的调用顺序和耗时情况。 Traceview和Systrace都是DDMS面板的工具,但是现在AS3.0以上的版本不再建议使用了,所以这里就不详述,如果有兴趣的同学,可以看我上一篇文章《Android应用优化之流畅度实操》,里面有详细地说明这两个工具的用法。 hugo github.com/JakeWharton… 我们可以利用JakeWharton的hugo,通过注解的方式获取对应的类或者函数所消耗的时间。我们可以利用它对启动页Activity的生命周期来抠细节。 启动优化实操 用户体验优化 在冷启动优化的主要体验个人认为就是消除启动时的白屏/黑屏,因为白屏/黑屏对于用户使用的第一印象就是慢、卡顿。我们可以设置启动页的主题来达到目的。 <style name="WelcomeTheme" parent="Theme.AppCompat.Light.NoActionBar.FullScreen"> <item name="android:windowBackground">@drawable/shape_welcome</item> <item name="android:windowDrawsSystemBarBackgrounds">false</item> </style> windowDrawsSystemBarBackgrounds是对部分有系统操作栏的设置。接着是这个窗口背景色的布局。 <layer-list xmlns:android="http://schemas.android.com/apk/res/android" android:opacity="opaque"> <item android:drawable="@android:color/white"/> <item> <bitmap android:src="@drawable/welcome_bg" android:gravity="center"/> </item> </layer-list> 启动页的广告展示完跳转到首页,然后我们设置回我们的通用样式,可以在清单文件,也可以在代码中设置。 <activity ··· android:theme="@style/AppBaseFrameTheme"/> 通过对启动页的主题设置后,就会将白屏/黑屏抹去,用户点击App的图标就展示启动图,让用户先产生启动很快的“错觉”。同时这里可以通过动画,让启动页与首页之间的过渡更加自然。 Application启动优化 从上图一的分析总结中,我对优化点Application的生命周期进行了加粗提示,接着我们回来对这部分进行优化实操。 Application#attachBaseContext() Application启动会经过attachBaseContext()-->onCreate();这时大家从attachBaseContext的生命周期联想到什么?没错就是MultiDex分包机制。想必大家都会发现,自从我们方法数超出了65535处理了分包之后,启动白屏/黑屏的问题就出现了,分包机制是导致冷启动缓慢的重要原因,而现在部分应用采用插件化的方式来避免MultiDex带来的白屏问题,这虽然是一种方法,但是开发成本实在高,对于不少应用来说是不必要的。我们来聊一下MultiDex优化,首先MultiDex可分成运行时和编译时两个部分: 编译期:将App中的class以某种策略拆分在多个dex中,为了减少第一个dex也就主dex中包含的class数; 运行期: App启动时,虚拟机只加载主dex中的class。app启动以后,使用Multidex.install,通过反射机制修改ClassLoader中的dexElements来加载其他dex; 从网上的多篇实践分析中,他们主要采用的是异步方式。因为App起始会先加载主dex包,那么我们可以自主去处理分包的工作,我们将启动页和首页需要的库、组件等主要class分在主dex中,从而达到精分主dex包的大小,具体的操作写法,大家可以参考网上MultiDex启动优化文章,但是大家要注意在主dex的分包过程中,主dex经过我们一系列的优化操作减少了主dex的大小,因此也增大了NoClassDefFoundError的异常的可能,此时会导致我们的应用启动失败的风险,所以在优化后我们一定做好测试工作。 Application#onCreate() 经过attachBaseContext()后就到onCreate()生命周期,想必我们大部分的应用,会在这里对我们使用到的第三方库和组件进行初始化工作。由于版本不断迭代,第三方库的初始化都是直接写在onCreate()中,大量的初始化工作导致该生命周期过于沉重,我们应该对这些第三方库进行分类。下面是我整理我司App启动的工作分类: 看着上图,各种第三方工具初始化和业务逻辑初始化,影响启动时间。我们先对它们拆分成四部分。 必须在onCreate()且是主进程中初始化 可以延迟,但是需要在Application中初始化 可以延迟到启动页的生命周期回调中初始化 延迟到用的时候再初始化 大家可以根据自身项目先列出自己项目的每一个初始化,然后进行分类。这里虽然我没有贴具体的操作代码,不是我认为new一个线程或者创建一个IntentService太简单了就不说了,而是这里需要注意的东西是整个冷启动优化最多的,因为自己也在这里踩过坑。 举一个GrowingIO的例子,当时项目用的是很旧版本的GIO,当时对GIO的初始化是放在子线程操作的,忽然发包前,运营部门提出升级GIO的SDK版本需求,升完之后编译运行觉得没什么事情就直接打包了,到线上之后运营反馈新版本没了圈选数据,经过检查发现新版本的GIO是不能在子线程初始化的。从这个教训中,我认为既然同学你都对冷启动优化感兴趣,所以一定不会差那几句复制粘贴的代码,这些都是要具体情况具体分析。我来总结一下重点 启动慢,不是无脑开线程,然后塞代码就完事,需要对症下药; 开线程也是一门学问,Thread、ThreadPoolExecutor、AsyncTask、IntentService,究竟选取哪个; 假设你new好了Thread,但是有没考虑好内存泄漏问题,不要一边补坑一边挖坑; 注意有些第三方SDK需要在主线程初始化的; 如果是应用是多进程的,注意有些第三方SDK,需要你在跟同包名进程下进行初始化; 其实有好多项目,经过多年的版本迭代都是没有整理过代码的,那些旧代码、无用代码都是需要归类整理的; 启动页Activity的优化 布局优化 我们的启动页Activity包含有启动图控件、闪屏广告图控件、闪屏广告视频控件、首次安装介绍图控件。对于布局优化而言,除了启动图控件外,其他都不是App启动时都要初始化的控件,这时我们可以使用ViewStub。针对指定的业务场景,初始化指定的控件。 避免I/O操作 我们知道I/O操作不是实时的,例如数据库的读写、SharedPreferences#apply()。我们要注意这些操作有没阻塞主线程地执行,同时我们可以利用StrictMode严格模式,利用它可以检测我们在启动的时候有没正确进行磁盘读写操作。 注意图片bitmap的加载速度和编码格式 我们可以知道,启动页大部分的情况下都是图片的显示,那么我们在图片这方面怎么抠细节呢,那就是对各种第三方图片加载库的选用了Glide、Picasso、Fresco等,还有是PREFER_ARGB_8888、PREFER_RGB_565的选取问题,大家可以针对属于自己项目情况进行选取。 对矢量图VectorDrawable对象的使用 矢量图的核心是省时间、省空间。而对于某些用户,它的启动图可能不是一张图片,它十分简约,就一个logo,这个时候我们可以考虑一下矢量图的用法。 注意Activity中的启动生命周期的回调 我们在Application#onCreate()优化,将某些不是很必要的网络请求,搬到了欢迎页中,但是我们也不能直接将这个网络请求操作直接拷贝到启动页的onCreate()中,我们可以巧妙地利用Activity生命周期中的Activity#onWindowFocusChanged(boolean hasFocus) ,这个是所有控件初始化完的真正回调,我们可以将网络操作放在这里,当然我们还可以使用Service。 冷启动优化总结 对于冷启动优化,需要我们一步步去分析,不像布局优化那般照搬套路,所以在官方文档中也多次出现bottleneck瓶颈这个词汇,说明了我们的冷启动优化之路不会一马平川,大家要善用Android Studio‘s CPU profiler(有机会我们详细分析一下该功能的使用),因为网上很多的总结是通过Traceview和Systrace,但是这两者在AS3.0版本的升级已经舍弃,侧面反映到我们要勤看官方文档,用自己的第一角度去思考Android的变化,而不是通过别人的翻译分析。最后大家互相勉励一下,在现在的Android市场竞争愈发激烈,如何在竞品对比中胜出,还需要我们一步步地把一个个的细节做好做完美。 Android app 全方位性能调优; 代码结构优化 用户体验及消耗资源优化 屏幕适配优化 代码质量调优 关注+转发后,加Android高级开发QQ群;701740775。即可获取以上视频资料! 以及往期Android高级架构资料、高级UI、性能优化、架构师课程、NDK、混合式开发(ReactNative+Weex)等视频资料 本群提供免费的学习指导 架构资料 以及免费的解答,不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导,加群请备注 csdn

优秀的个人博客,低调大师

非常详尽的 Shiro 架构解析!

Shiro是什么? Apache Shiro是一个强大而灵活的开源安全框架,它干净利落地处理身份认证,授权,企业会话管理和加密。 Apache Shiro的首要目标是易于使用和理解。安全有时候是很复杂的,甚至是痛苦的,但它没有必要这样。框架应该尽可能掩盖复杂的地方,露出一个干净而直观的API,来简化开发人员在使他们的应用程序安全上的努力。 官网:http://shiro.apache.org Shiro有什么用? 以下是你可以用Apache Shiro所做的事情: ● 验证用户来核实他们的身份 ● 对用户执行访问控制,如: 1. 判断用户是否被分配了一个确定的安全角色; 2. 判断用户是否被允许做某事; ● 在任何环境下使用Session API,即使没有Web或EJB容器。 ● 在身份验证,访问控制期间或在会话的生命周期,对事件作出反应。 ● 聚集一个或多个用户安全数据的数据源,并作为一个单一的复合用户“视图”。 ● 启用单点登录(SSO)功能。 ● 为没有关联到登录的用户启用"Remember Me"服务 ● 以及更多——全部集成到紧密结合的易于使用的API中。 Shiro 视图在所有应用程序环境下实现这些目标——从最简单的命令行应用程序到最大的企业应用,不强制依赖其他第三方框架,容器,或应用服务器。当然,该项目的目标是尽可能地融入到这些环境,但它能够在任何环境下立即可用。 Shiro特性 Apache Shiro是一个拥有许多功能的综合性的程序安全框架。 Shiro把Shiro开发团队称为“应用程序的四大基石”——身份验证,授权,会话管理和加密作为其目标。 ● Authentication:有时也简称为“登录”,这是一个证明用户是他们所说的他们是谁的行为。 ● Authorization:访问控制的过程,也就是绝对“谁”去访问“什么”。 ● Session Management:管理用户特定的会话,即使在非 Web 或 EJB 应用程序。 ● Cryptography:通过使用加密算法保持数据安全同时易于使用。 也提供了额外的功能来支持和加强在不同环境下所关注的方面,尤其是以下这些: ● Web Support:Shiro的web支持的API能够轻松地帮助保护 Web 应用程序。 ● Caching:缓存是Apache Shiro中的第一层公民,来确保安全操作快速而又高效。 ● Concurrency:Apache Shiro利用它的并发特性来支持多线程应用程序。 ● Testing:测试支持的存在来帮助你编写单元测试和集成测试,并确保你的能够如预期的一样安全。 ● "Run As":一个允许用户假设为另一个用户身份(如果允许)的功能,有时候在管理脚本很有用。 ● "Remember Me":在会话中记住用户的身份,所以他们只需要在强制时候登录。 Shiro 架构 Apache Shiro的设计目标是通过直观和易于使用来简化应用程序安全。Shiro 的核心设计体现了大多数人们是如何考虑应用程序安全的——在某些人(或某些事)与应用程序交互的背景下。 应用软件通常是基于用户背景情况设计的。也就是说,你将经常设计用户接口或服务API,基于一个用户将要(或应该)如何与该软件交互。例如,你可能会说,“如果用户与我的应用程序交互的用户已经登录,我将显示一个他们能够点击的按钮来查看他们的帐户信息。如果他们没有登录,我将显示一个登录按钮。” 这个简单的陈述表明应用程序很大程度上的编写是为了满足用户的要求和需要。即使该“用户”是另一个软件系统而不是一个人类,你仍然得编写代码来响应行为,基于当前与你的软件进行交互的人或物。 Shiro在它自己的设计中体现了这些概念。通过匹配那些对于软件开发人员来说已经很直观的东西,Apache Shiro几乎在任何应用程序保持了直观和易用性。 在最高的概念层次,Shiro的架构有3个主要的概念:Subject,SecurityManager 和 Realms。 下面的关系图是关于这些组件是如何交互的高级概述,而且我们将会在下面讨论每一个概念: Subject 在我们的教程中已经提到,Subject实质上是一个当前执行用户的特定的安全“视图”。鉴于"User"一词通常意味着一个人,而一个Subject可以是一个人,但它还可以代表第三方服务,daemon account,cron job,或其他类似的任何东西——基本上是当前正与软件进行交互的任何东西。 所有Subject实例都被绑定到(且这是必须的)一个SecurityManager上。当你与一个Subject交互时,那些交互作用转化为与SecurityManager交互的特定subject的交互作用。 SecurityManager SecurityManager是Shiro架构的心脏,并作为一种“保护伞”对象来协调内部的安全组件共同构成一个对象图。然而,一旦SecurityManager和它的内置对象图已经配置给一个应用程序,那么它单独留下来,且应用程序开发人员几乎使用他们所有的时间来处理Subject API。 稍后会更详细地讨论SecurityManager,但重要的是要认识到,当你正与一个Subject进行交互时,实质上是幕后的 SecurityManager处理所有繁重的Subject安全操作。这反映在上面的基本流程图。 Realms Realms担当Shiro和你的应用程序的安全数据之间的“桥梁”或“连接器”。当它实际上与安全相关的数据如用来执行身份验证(登录)及授权(访问控制)的用户帐户交互时,Shiro 从一个或多个为应用程序配置的Realm中寻找许多这样的东西。 在这个意义上说,Realm本质上是一个特定安全的DAO:它封装了数据源的连接详细信息,使Shiro所需的相关的数据可用。当配置Shiro时,你必须指定至少一个Realm用来进行身份验证和/或授权。SecurityManager可能配置多个Realms,但至少有一个是必须的。 Shiro提供了立即可用的Realms来连接一些安全数据源(即目录),如LDAP,关系数据库(JDBC),文本配置源,像 INI 及属性文件,以及更多。你可以插入你自己的Realm 实现来代表自定义的数据源,如果默认地Realm不符合你的需求。 像其他内置组件一样,Shiro SecurityManager控制 Realms是如何被用来获取安全和身份数据来代表 Subject 实例的。 下图展示了Shiro的核心架构概念,紧跟其后的是每个的简短总结: Subject(org.apache.shiro.subject.Subject) 当前与软件进行交互的实体(用户,第三方服务,cron job,等等)的安全特定“视图”。 SecurityManager(org.apache.shiro.mgt.SecurityManager) 如上所述,SecurityManager是Shiro架构的心脏。它基本上是一个“保护伞”对象,协调其管理的组件以确保它们能够一起顺利的工作。它还管理每个应用程序用户的Shiro 的视图,因此它知道如何执行每个用户的安全操作。 Authenticator(org.apache.shiro.authc.Authenticator) Authenticator是一个对执行及对用户的身份验证(登录)尝试负责的组件。当一个用户尝试登录时,该逻辑被 Authenticator执行。Authenticator知道如何与一个或多个Realm协调来存储相关的用户/帐户信息。从这些Realm中获得的数据被用来验证用户的身份来保证用户确实是他们所说的他们是谁。 Authentication Strategy(org.apache.shiro.authc.pam.AuthenticationStrategy) 如果不止一个Realm被配置,则AuthenticationStrategy将会协调这些Realm来决定身份认证尝试成功或失败下的条件(例如,如果一个Realm成功,而其他的均失败,是否该尝试成功?是否所有的Realm必须成功?或只有第一个成功即可?)。 Authorizer(org.apache.shiro.authz.Authorizer) Authorizer是负责在应用程序中决定用户的访问控制的组件。它是一种最终判定用户是否被允许做某事的机制。与 Authenticator相似,Authorizer也知道如何协调多个后台数据源来访问角色恶化权限信息。Authorizer使用该信息来准确地决定用户是否被允许执行给定的动作。 SessionManager(org.apache.shiro.session.SessionManager) SessionManager知道如何去创建及管理用户Session生命周期来为所有环境下的用户提供一个强健的Session体验。这在安全框架界是一个独有的特色——Shiro拥有能够在任何环境下本地化管理用户Session的能力,即使没有可用的Web/Servlet或EJB容器,它将会使用它内置的企业级会话管理来提供同样的编程体验。SessionDAO的存在允许任何数据源能够在持久会话中使用。 SessionDAO(org.apache.shiro.session.mgt.eis.SessionDAO) SesssionDAO代表SessionManager执行Session持久化(CRUD)操作。这允许任何数据存储被插入到会话管理的基础之中。 CacheManager(org.apahce.shiro.cache.CacheManager) CacheManager创建并管理其他Shiro组件使用的Cache实例生命周期。因为Shiro能够访问许多后台数据源,由于身份验证,授权和会话管理,缓存在框架中一直是一流的架构功能,用来在同时使用这些数据源时提高性能。任何现代开源和/或企业的缓存产品能够被插入到Shiro来提供一个快速及高效的用户体验。 Cryptography(org.apache.shiro.crypto.*) Cryptography是对企业安全框架的一个很自然的补充。Shiro的crypto包包含量易于使用和理解的cryptographic Ciphers,Hasher(又名digests)以及不同的编码器实现的代表。所有在这个包中的类都被精心地设计以易于使用和易于理解。任何使用Java的本地密码支持的人都知道它可以是一个难以驯服的具有挑战性的动物。Shiro的cryptoAPI 简化了复杂的Java机制,并使加密对于普通人也易于使用。 Realms(org.apache.shiro.realm.Realm) 如上所述,Realms在Shiro和你的应用程序的安全数据之间担当“桥梁”或“连接器”。当它实际上与安全相关的数据如用来执行身份验证(登录)及授权(访问控制)的用户帐户交互时,Shiro从一个或多个为应用程序配置的Realm中寻找许多这样的东西。你可以按你的需要配置多个Realm(通常一个数据源一个Realm),且Shiro将为身份验证和授权对它们进行必要的协调。 The SecurityManager 因为Shiro的API鼓励一个以Subject为中心的编程方式,大多数应用程序开发人员很少,如果真有,与SecurityManager直接进行交互(框架开发人员有时候会觉得它很有用)。即便如此,了解如何SecurityManager是如何工作的仍然是很重要的,尤其是在为应用程序配置一个SecurityManager的时候。 Design 如前所述,应用程序的SecurityManager执行安全操作并管理所有应用程序用户的状态。在Shiro的默认SecurityManager实现中,这包括: ● Authentication ● Authorization ● Session Management ● Cache Management ● Realm coordination ● Event propagation ● "Remember Me" Services ● Subject creation ● Logout 以及更多。 但这是许多功能来尝试管理一个单一的组件。而且,使这些东西灵活而又可定制将会是非常困难的,如果一切都集中到一个单一的实现类。 为了简化配置并启用灵活配置/可插性,Shiro的实现都是高度模块化设计——由于如此的模块化,SecurityManager实现(以及它的类层次结构)并没有做很多事情。相反,SecurityManager 实现主要是作为一个轻量级的“容器”组件,委托计划所有的行为到嵌套/包裹的组件。这种“包装”的设计体现在上面的详细构架图。 虽然组件实际上执行逻辑,但SecurityManager实现知道何时以及如何协调组件来完成正确的行为。SecurityManager 实现和组件都是兼容JavaBean的,它允许你(或某个配置机制)通过标准的JavaBean的accessor/mutator 方法(get/set)轻松地自定义可拔插组件。这意味着 Shiro 的架构的组件性能够把自定义行为转化为非常容易的配置文件。 Easy Configuration 由于JavaBeans的兼容性,通过任何支持JavaBean风格的配置的机制可以很容易的用自定义组件配置SecurityManager,如 Spring,Guice,JBoss,等等。 原文发布时间为:2018-11-13 本文来自云栖社区合作伙伴“Java技术栈”,了解相关信息可以关注“Java技术栈”。

优秀的个人博客,低调大师

RocketMQ原理解析-producer(转)

1,启动流程 Producer如何感知要发送消息的broker(brokerAddrTable中的值是怎么获得的)? producer本地集合中没有,会根据指定topic到namesrv获取TopicPublishInfo,并放入本地集合。 定时从namesrv更新topic路由信息。 Producer与broker间的心跳 Producer定时发送心跳,将producer信息(其实就是procduer的group)定时发送到broker(brokerAddrTable集合中列出的)。 master接收消息,slave拷贝master Producer发送消息,只发送到broker_master机器,通过broker的主从复制机制拷贝到broker_slave。 2,如何发送消息 producer轮询某topic下的所有queue的方式 实现发送方的负载均衡。 Topic下的所有队列如何理解? Broker Topic queue 注册namesrv队列(Topic_A) broker1 Topic_A queue0 , queue1 broker1_queue0 ,broker1_queue1 broker2 Topic_A queue0, queue2, queue3 broker2_queue0,broker2_queue1,broker2_queue2 broker3 Topic_A queue0 broker3_queue0 Producer如何实现轮询队列? Producer从namesrv获得topic_A路由信息TopicPublishInfo。 //Topic_A的所有的队列 private List<MessageQueue> messageQueueList //自增整型 private volatile ThreadLocalIndex sendWhichQueue /** *选择一个发送队列 *lastBrokerName不为空,代表上次选择的queue失败,本次避开同一个queue */ public MessageQueue selectOneMessageQueue(final String lastBrokerName){ //计算队列下标 //sendWhichQueue.getAndIncrement()每次调用+1 Math.abs(sendWhichQueue.getAndIncrement()) % this.messageQueueList.size() } Producer发消息系统重试? //消息发送失败重试次数默认为2 private int retryTimesWhenSendFailed = 2; //发送消息超时时间 private int sendMsgTimeout = 3000; 发送失败,换个队列继续发送所需条件: 1. 重试次数不到retryTimesWhenSendFailed (默认2次) 2. 发送此条消息花费时间还没有到sendMsgTimeout (默认3000毫秒) 3,如何发送顺序消息 4,发送分布式事物消息 5,消息在broker落地之普通消息 6,消息在broker落地之事物消息

优秀的个人博客,低调大师

Linux overlay文件系统解析

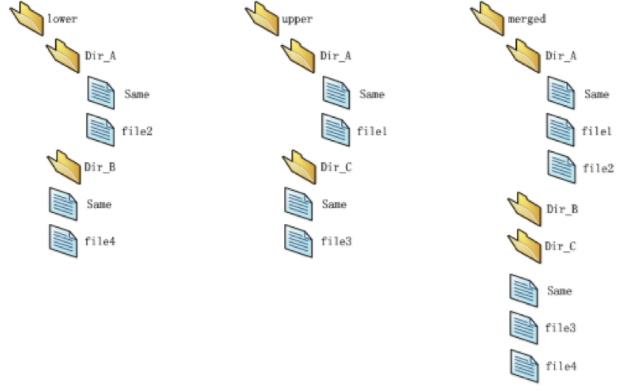
一个 overlay 文件系统包含两个文件系统,一个 upper 文件系统和一个 lower 文件系统,是一种新型的联合文件系统。overlay是“覆盖…上面”的意思,overlay文件系统则表示一个文件系统覆盖在另一个文件系统上面。 为了更好的展示 overlay 文件系统的原理,现新构建一个overlay文件系统。文件树结构如下: image 1、在一个支持 overlay文件系统的 Linux (内核3.18以上)的操作系统上一个同级目录内(如/root下)创建四个文件目录 lower 、upper 、merged 、work其中 lower 和 upper 文件夹的内容如上图所示,merged 和work 为空,same文件名相同,内容不同。 2、在/root目录下执行如下挂载命令,可以看到空的merged文件夹里已经包含了 lower 及 upper 文件夹中的所有文件及目录。 $mount -t overlay overlay -olowerdir=./lower,upperdir=./upper,workdir=./work ./merged 3、使用df –h 命令可以看到新构建的 overlay 文件系统已挂载。 Filesystem Size Used Avail Use% Mounted on overlay 20G 13G 7.8G 62% /root /merged 那么 lower 和 upper 目录里有相同的文件夹及相同的文件,合并到 merged 目录里时显示的是哪个呢?规则如下: 1. 文件名及目录不相同,则 lower 及 upper 目录中的文件及目录按原结构都融入到 merged 目录中; 2. 文件名相同,只显示 upper 层的文件。如上图在 lower 和 upper 目录下及下层目录 dir_A 下都有 same.txt 文件,但在合并到 merged 目录时,则只显示 upper 的,而 lower 的隐藏 ; 3. 目录名相同, 对目录进行合并成一个目录。如上图在 lower 及 upper 目录下都有 dir_A 目录,将目录及目录下的所有文件合并到 merged 的 dir_A 目录,目录内如有文件名相同,则同样只显示 upper 的,如上图中 dir_A 目录下的same.txt文件。 overlay只支持两层,upper文件系统通常是可写的;lower文件系统则是只读,这就表示着,当我们对 overlay 文件系统做任何的变更,都只会修改 upper 文件系统中的文件。那下面看一下overlay文件系统的读,写,删除操作。 读 ¬ 读 upper 没有而 lower 有的文件时,需从 lower 读; ¬ 读只在 upper 有的文件时,则直接从 upper 读 ¬ 读 lower 和 upper 都有的文件时,则直接从 upper 读。 写 ¬ 对只在 upper 有的文件时,则直接在 upper 写 ¬ 对在lower 和 upper 都有的文件时,则直接在 upper 写。 ¬ 对只在 lower 有的文件写时,则会做一个copy_up 的操作,先从 lower将文件拷贝一份到upper,同时为文件创建一个硬链接。此时可以看到 upper 目录下生成了两个新文件,写的操作只对从lower 复制到 upper 的文件生效,而 lower 还是原文件。 删 ¬ 删除 lower 和 upper 都有的文件时,upper 的会被删除,在 upper 目录下创建一个 ‘without’ 文件,而 lower 的不会被删除。 ¬ 删除 lower 有而 upper 没有的文件时,会为被删除的文件在 upper 目录下创建一个 ‘without’ 文件,而 lower 的不会被删除。 ¬ 删除 lower 和 upper 都有的目录时,upper 的会被删除,在 upper 目录下创建一个类似‘without’ 文件的 ‘opaque’ 目录,而 lower 的不会被删除。 可以看到,因为 lower 是只读,所以无论对 lower 上的文件和目录做任何的操作都不会对 lower 做变更。所有的操作都是对在 upper 做, 。 copy_up只在第一次写时对文件做copy_up操作,后面的操作都不再需要做copy_up,都只操作这个文件,特别适合大文件的场景。overlay的 copy_up操作要比AUFS相同的操作要快,因为AUFS有很多层,在穿过很多层时可能会有延迟,而overlay 只有两层。而且overlay在2014年并入linux kernel mailline ,但是aufs并没有被并入linux kernel mailline ,所以overlay 可能会比AUFS快。 lower文件系统可以为任何linux支持的文件系统,甚至可以为另一个overlayfs。因为虽然overlay文件系统的底层是由两个文件系统构成,但它本身只是一个文件系统,就如前面用df命令看到的,所以也可以和其他文件系统组成新的overlay文件系统。而upper是可写的,不支持NFS。多层 lower 可执行如下命令: $mount -t overlay overlay -olowerdir=/lower1:/lower2:/lower3 ,upperdir=./upper,workdir=./work ./merged 上例中,lower 是由三个文件系统合并成一个文件系统,其中lower1在最上面,lower3在最底下。 Docker一直在用AUFS(高级多层次统一文件系统)作为容器的文件系统。AUFS是一个能透明覆盖一或多个现有文件系统的层状文件系统。当一个进程需要修改一个文件时,AUFS创建该文件的一个副本。AUFS可以把多层合并成文件系统的单层表示。Docker 的image构采用的是AUFS,每个新版本都是一个与之前版本的简单差异改动,有效地保持镜像文件最小化。那docker 使用 overlay 之后有什么区别呢? 首先镜像在下载时每一层的镜像都有一个自己的镜像ID,每个镜像都会有自己的目录,保存在/var/lib/docker/overlay目录下,但是这些层目录的名字并不是下载镜像时的ID名称。我们都知道AUFS是多层,那如何体现为两层呢?启动一个容器后,也在这个目录下产生一个层目录,进入到目录可以看到有三个文件夹,分别是merged,upper,work,和一个文件lower-id,而在lower-id中保存的就是镜像最上层的ID,所以对容器来说,还是一个两层的文件系统。 image 这里说明一下,docker pull image时显示的镜像ID名称与/var/lib/docker/overlay目录下的镜像目录名称不一样。镜像目录中保存的是这层独有的文件和硬链接下层共享的文件。这样可以更有效的利用磁盘资源。 从上面这个图可以看到,overlay的两层对应的就是docker的镜像层(只读)和容器层(可写),只是把原来AUFS中的多层镜像合并成了lower层,而upper层代表的是容器层。 我们看到虽然overlay和AUFS都是联合文件系统,但结构比AUFS简单,且并入了linux kernel mainline,可能会比AUFS快,但还是太年轻,要谨慎在生产使用。而AUFS做为docker的第一个存储驱动,已经有很长的历史,比较的稳定,且在大量的生产中实践过,有较强的社区支持。 转载自:http://dockone.io/article/1511

优秀的个人博客,低调大师

Java多线程——FutureTask源码解析

一个很常见的多线程案例是,我们安排主线程作为分配任务和汇总的一方,然后将计算工作切分为多个子任务,安排多个线程去计算,最后所有的计算结果由主线程进行汇总。比如,归并排序,字符频率的统计等等。 我们知道Runnable是不返回计算结果的,如果想利用多线程的话,只能存储到一个实例的内部变量里面进行交互,但存在一个问题,如何判断是否已经计算完成了。用Thread.join是一个方案,但是我们只能依次等待一个线程结束后处理一个线程,如果线程1恰好特别慢,则后续已经完成的线程不能被及时处理。我们希望能够获知线程的执行状态,发现哪个线程处理完就先统计它的计算结果。可以考虑使用Callable和FutureTask来完成。 先说Callable它是一个功能接口,它只有一个方法V call(),计算一个结果,失败的话抛出一个异常。和Runnable不同的是,它不能直接交给Thread来执行,所以需要一个别的类来封装它与Runnable,这个类就是FutureTask。FutureTask是一个类,继承了RunnableFuture,而RunnableFuture是一个多继承接口,它继承了Runnable和 Future,所以FutureTask是可以作为实现了Runnable的实例交给Thread执行。 从内部变量来看,含有一个下层Callable实例,一个状态表示,一个返回结果,以及对运行线程的记录 /** * 任务的运行状态,最初是NEW。运行状态只在set, setException和cancel方法中过度到最终状态。 * 在完成过程中,状态可能发生转移到COMPLETING(在设置结果时)或者INTERRUPTING(仅当中断运行来满足cancel(true)时)。 * 从这些中间状态转移到最终状态使用成本更低有序/懒惰写入,因为值是唯一的且之后不能再修改。 * * Possible state transitions: * NEW -> COMPLETING -> NORMAL * NEW -> COMPLETING -> EXCEPTIONAL * NEW -> CANCELLED * NEW -> INTERRUPTING -> INTERRUPTED */ private volatile int state; private static final int NEW = 0; private static final int COMPLETING = 1; private static final int NORMAL = 2; private static final int EXCEPTIONAL = 3; private static final int CANCELLED = 4; private static final int INTERRUPTING = 5; private static final int INTERRUPTED = 6; /** 下层的callable,运行后为null */ private Callable<V> callable; /** get()操作返回的结果或者抛出的异常*/ private Object outcome; // 不是volatile,由reads/writes状态来保护 /** 运行callable的线程,在run()通过CAS修改*/ private volatile Thread runner; /** 等待线程的Treiber堆栈 */ private volatile WaitNode waiters; 构造函数 构造函数总共有两种重载,第一种直接给出Callable实例 public FutureTask(Callable<V> callable) { if (callable == null) throw new NullPointerException(); this.callable = callable; this.state = NEW; // 确保callable的可见性 } 第二种,给出Runnable实例和期望的返回结果,如果Runnable实例运行成功则返回的是result public FutureTask(Runnable runnable, V result) { this.callable = Executors.callable(runnable, result);//创建一个callable this.state = NEW; // 确保callable的可见性 } run run方法是Thread运行FutureTask内任务的接口。首先,根据最上方的进入条件可以看出,只有成功竞争到修改runnerOffset成功的线程才能执行后续方法,而搜索整个类文件,可以发现只有在run结束后才会重置为null,所以同一时间只能有一个线程执行run方法成功。然后要检查state和callable的状态,因为run会将它们修改。调用callable.call方法获取返回结果,成功的话设置结果,失败的话设置返回结果为异常。无论是否执行成功,runner会被重置为null。 public void run() { if (state != NEW || !UNSAFE.compareAndSwapObject(this, runnerOffset, null, Thread.currentThread())) return;//状态必须是NEW且修改执行线程成功,否则直接返回,避免被多个线程同时执行 try { Callable<V> c = callable; if (c != null && state == NEW) { V result; boolean ran; try { result = c.call();//调用callable.call方法获取返回结果 ran = true;//执行成功 } catch (Throwable ex) { result = null; ran = false;//执行失败 setException(ex);//设置返回异常并唤醒等待线程解除阻塞 } if (ran) set(result);//设置结果 } } finally { //runner直到状态设置完成不能为null来避免并发调用run() runner = null; //在将runner设置为null后需要重新读取state避免漏掉中断 int s = state; if (s >= INTERRUPTING) handlePossibleCancellationInterrupt(s); } } set方法先修改state为COMPLETING,然后将outcome设置为刚才计算出来的结果,最后设置state为NORMAL,并调用finishCompletion。这个方法移除并通知所有等待的线程解除阻塞,调用done(),并将callable设为null。done方法默认是什么也不做。 protected void set(V v) { if (UNSAFE.compareAndSwapInt(this, stateOffset, NEW, COMPLETING)) { outcome = v; UNSAFE.putOrderedInt(this, stateOffset, NORMAL); // 最终状态 finishCompletion();//唤醒等待线程,将callable设为null } } private void finishCompletion() { // assert state > COMPLETING; for (WaitNode q; (q = waiters) != null;) { if (UNSAFE.compareAndSwapObject(this, waitersOffset, q, null)) { for (;;) { Thread t = q.thread; if (t != null) { q.thread = null; LockSupport.unpark(t);//如果线程被park阻塞,解除阻塞 } WaitNode next = q.next; if (next == null) break; q.next = null; // 取消连接帮助gc q = next; } break; } } done();//未重写时什么也不做 callable = null; // to reduce footprint减少覆盖区 } setException跟set逻辑上基本一样,除了设置返回结果是Throwable对象 protected void setException(Throwable t) { if (UNSAFE.compareAndSwapInt(this, stateOffset, NEW, COMPLETING)) {//修改状态 outcome = t;//结果为Throwable UNSAFE.putOrderedInt(this, stateOffset, EXCEPTIONAL); // 最终状态 finishCompletion(); } } get get方法如果FutureTask已经执行完成则返回结果,否则会等待并阻止线程调度。等待时长可以输入,单位为纳秒,不输入为不限时等待,限时等待超时仍然没有完成会抛出异常。 public V get() throws InterruptedException, ExecutionException { int s = state; if (s <= COMPLETING) s = awaitDone(false, 0L);//等待完成 return report(s);//检查时返回结果还是抛出异常 } public V get(long timeout, TimeUnit unit) throws InterruptedException, ExecutionException, TimeoutException { if (unit == null) throw new NullPointerException(); int s = state; if (s <= COMPLETING && (s = awaitDone(true, unit.toNanos(timeout))) <= COMPLETING)//限时等待完成 throw new TimeoutException(); return report(s); } awaitDone这个方法会阻塞当前线程(get方法的调用线程)的调度并增加等待结点,阻塞时长根据输入的时间长度决定。如果执行Callable任务的线程完成了运行或者被中断,则会解除栈中等待结点对应线程的阻塞。然后会根据执行结果决定是否要抛出异常还是返回执行完成的结果。 private int awaitDone(boolean timed, long nanos) throws InterruptedException { final long deadline = timed ? System.nanoTime() + nanos : 0L; WaitNode q = null; boolean queued = false;//是否完成入栈 for (;;) { if (Thread.interrupted()) {//检查线程是否已经被中断 removeWaiter(q);//移除被中断的等待结点 throw new InterruptedException(); } int s = state; if (s > COMPLETING) {//已经完成 if (q != null) q.thread = null;//移除等待 return s; } else if (s == COMPLETING) // cannot time out yet还没有超时 Thread.yield();//已经在赋值,所以只需让出时间片等待赋值完成 //下方都是还在没有完成call方法的情况 else if (q == null) q = new WaitNode(); else if (!queued) queued = UNSAFE.compareAndSwapObject(this, waitersOffset, q.next = waiters, q);//q加入到栈的最前方 else if (timed) { nanos = deadline - System.nanoTime(); if (nanos <= 0L) {//超时了 removeWaiter(q);//移除超时的等待结点 return state; } LockSupport.parkNanos(this, nanos);//阻塞当前线程nanos纳秒 } else LockSupport.park(this);//阻塞当前线程 } } cancel cancel输入的参数表示如果当前还在运行中是否要中断执行线程,如果输入参数是false则只有线程已经执行完成或者抛出异常或者已经被中断时可以把状态修改为CANCELLED,如果是true则会中断线程并将状态改为INTERRUPTED。所以,cancel在该任务已经结束或者已被取消,或者竞争修改状态失败时都会失败。如果中断成功,会释放所有被阻塞的等待线程。 public boolean cancel(boolean mayInterruptIfRunning) { if (!(state == NEW && UNSAFE.compareAndSwapInt(this, stateOffset, NEW, mayInterruptIfRunning ? INTERRUPTING : CANCELLED))) return false;//已经完成或者被取消或者竞争取消失败返回false try { // in case call to interrupt throws exception if (mayInterruptIfRunning) { try { Thread t = runner; if (t != null) t.interrupt(); } finally { // final state UNSAFE.putOrderedInt(this, stateOffset, INTERRUPTED); } } } finally { finishCompletion(); } return true; } 状态检查 非常简单的两个方法。因为CANCELLED是state中最大的,所以只有cancel方法成功才会是这种状态。而isDone只要不是还在运行或者还没有被执行就是返回true。 public boolean isCancelled() { return state >= CANCELLED; } public boolean isDone() { return state != NEW; } 简单的使用示例 public class CallableTest implements Callable<Integer>{ private int start; public CallableTest(int start) { this.start = start; } @Override public Integer call() throws Exception { Thread.sleep(500); return start + 1; } public static void main(String args[]) throws InterruptedException, ExecutionException{ long start = System.currentTimeMillis(); FutureTask<Integer> task1 = new FutureTask<>(new CallableTest(2)); new Thread(task1).start(); FutureTask<Integer> task2 = new FutureTask<>(new CallableTest(4)); new Thread(task2).start(); System.out.println(task1.get() + task2.get());//8 long end = System.currentTimeMillis(); System.out.println(end - start);//506 } }

优秀的个人博客,低调大师

Java多线程——ThreadLocal源码解析

ThreadLocal 这个类提供线程局部变量。这些变量在每一个线程中的正常副本都不相同,每一个线程访问一个副本(通过其 get或 set法),副本有自己独立的变量初始化复制。ThreadLocal实例通常是类中私有的静态字段希望关联状态和线程(例如,一个用户ID或交易ID)。 例如,下面的类为每个线程生成唯一的标识符。一个线程的ID在第一次调用ThreadId.get()时分配并且在后续调用中保持不变。 public class ThreadId { // Atomic integer containing the next thread ID to be assigned private static final AtomicInteger nextId = new AtomicInteger(0); // Thread local variable containing each thread's ID private static final ThreadLocal<Integer> threadId = new ThreadLocal<Integer>() { @Override protected Integer initialValue() { return nextId.getAndIncrement(); } }; // Returns the current thread's unique ID, assigning it if necessary public static int get() { return threadId.get(); } } 每一个线程在活着的时候就持有一个暗示对它线程本地变量拷贝的引用并且ThreadLocal实例可以访问;线程死去后它的线程本地实例拷贝受垃圾回收管辖(除非存在其他对这些副本引用)。 ——以上是对ThreadLocal注释的翻译 ThreadLocal是作为key值存储在ThreadLocalMap里面的,而ThreadLocalMap是一个典型的hash表,它的实例存储在了Thread.threadLocals,并且由于并非所有线程实例都需要用到threadLocals,它是懒汉式的初始化,在第一次插入时才会初始化创建ThreadLocalMap实例。输入的value是一个泛型对象,它可以是Integer、Double等基本装箱类型,也可以是自定义的bean类,可以认为Thread实例t拥有一个ThreadLocalMap实例threadLocals,它是一个hash表,它以ThreadLocal的实例作为key值,以具体内容泛型变量value作为value值,每个线程在存活期间有自己的ThreadLocalMap实例,所以各线程间互不干涉。 public class ThreadLocalTest { ThreadLocal<Long> longLocal = new ThreadLocal<Long>(); ThreadLocal<String> stringLocal = new ThreadLocal<String>(); public void set() { longLocal.set(Thread.currentThread().getId()); stringLocal.set(Thread.currentThread().getName()); } public long getLong() { return longLocal.get(); } public String getString() { return stringLocal.get(); } public static void main(String[] args) throws InterruptedException { final ThreadLocalTest test = new ThreadLocalTest(); test.set(); System.out.println(test.getLong()); System.out.println(test.getString()); Thread thread1 = new Thread() { public void run() { test.set(); System.out.println(test.getLong()); System.out.println(test.getString()); }; }; thread1.start(); thread1.join(); System.out.println(test.getLong()); System.out.println(test.getString()); /*1 main 11 Thread-0 1 main*/ } } 构造函数 因为ThreadLocal的作用是提供实例作为key值,它需要提供的内部变量就是hashcode,而hashcode是由别的方法生成,所以构造函数除了初始化实例外什么也不做 public ThreadLocal() { } set set方法设置当前线程的线程本地变量副本为指定的值。大部分子类不需要重写这个方法,只依靠initialValue来设置线程本地变量值。先获取当前线程中的ThreadLocalMap实例,然后检查是否为null。还没有创建的话需要先新创建一个,将这个ThreadLoca和value值放入map中。 public void set(T value) { Thread t = Thread.currentThread(); ThreadLocalMap map = getMap(t); if (map != null) map.set(this, value); else createMap(t, value); } /** * 获取关联ThreadLocal的map。在InheritableThreadLocal中重写。 */ ThreadLocalMap getMap(Thread t) { return t.threadLocals; } /** * 创建一个关联ThreadLocal的map。在InheritableThreadLocal中重写。 */ void createMap(Thread t, T firstValue) { t.threadLocals = new ThreadLocalMap(this, firstValue); } get get返回这个线程本地变量在当前线程中的副本值。如果这个变量在当前线程中没有值,第一次通过调用initialValue初始化这个值并返回。 public T get() { Thread t = Thread.currentThread(); ThreadLocalMap map = getMap(t); if (map != null) { ThreadLocalMap.Entry e = map.getEntry(this); if (e != null) { @SuppressWarnings("unchecked") T result = (T)e.value; return result; } } return setInitialValue();//map不存在或map中没有这个对象时调用setInitialValue } setInitialValue方法是set方法的变体,用于创建初始化值。如果用户已经重写了set方法,可以用作set方法的替代。 private T setInitialValue() { T value = initialValue();//未重写直接返回null Thread t = Thread.currentThread(); ThreadLocalMap map = getMap(t); if (map != null) map.set(this, value); else createMap(t, value); return value; } initialValue返回此线程局部变量的“初始值”。该方法将在一个线程第一次用get方法访问变量时被调用,除非线程之前调用了 set方法,在这种情况下, initialValue方法不会被这个线程调用。通常情况下,这种方法是每个线程调用一次,但它可能在后续调用get随后调用remove而再次调用。这种实现简单的返回null;如果程序员渴望线程局部变量有一个初始值而不是null,ThreadLocal必须有子类,并重写这个方法。通常情况下,将使用一个匿名内部类。简单来说,如果未set这个ThreadLocal的value值而直接调用get会导致在map中添加一个初始化的value值,如果没有重写ThreadLocal中的这个方法,那么初始值是null。 protected T initialValue() { return null; } remove remove方法移除当前线程的线程本地变量值。如果这个线程本地变量随后被当前线程用get方法读取,它的值会被initialValue重新初始化,除非这之间当前线程调用了set方法。这可能会导致当前线程中多次调用initialValue方法。 public void remove() { ThreadLocalMap m = getMap(Thread.currentThread()); if (m != null)//map未初始化时什么都不做 m.remove(this); } ThreadLocalMap ThreadLocalMap是ThreadLocal的内部类,是一个典型的hash表,只适合存储线程本地变量。没有操作暴露到ThreadLocal类外部。这个类是包私有的,允许在Thread中声明字段。为了帮助解决非常大并且长期存活的使用,hash表条目对key使用WeakReference。然而,因为没有使用引用队列,旧的条目只在表用完空间时才保证移除。 Entry ThreadLocalMap的条目也是自己实现的。这个hash表的条目扩展了WeakReference,使用它的只要引用字段作为k(总是ThreadLocal对象)。注意null的key值(比如entry.get() == null)意味着key不再被引用,因此条目可以从表删除。这样的条目作为“旧条目”在下方代码中被引用。ThreadLocal是弱引用,而value是强引用,如果创建ThreadLocal的线程一直持续运行,那么这个Entry对象中的value就有可能一直得不到回收,发生内存泄露。 static class Entry extends WeakReference<ThreadLocal<?>> { /** 关联这个ThreadLocal的值 */ Object value; Entry(ThreadLocal<?> k, Object v) { super(k);//将ThreadLocal作为key用于构造WeakReference value = v; } } 内部变量和构造函数 table是存储条目的数组,初始大小一定是16 /** * 初始容量,必需是2的指数次 */ private static final int INITIAL_CAPACITY = 16; /** * 表,有必要的话需要resize。table.length必须总是2的指数次 */ private Entry[] table; /** * 表中条目的数量 */ private int size = 0; /** * 到达后要进行resize的大小 */ private int threshold; // Default to 0 构造函数前面在createMap(Thread, T)中已经提到过,创建一个新的map初始化包含firstKey, firstValue)。ThreadLocalMap是懒汉式构建,因此我们只有当有至少一个条目要放入时再创建一个。负载因子至少是2/3。 ThreadLocalMap(ThreadLocal<?> firstKey, Object firstValue) { table = new Entry[INITIAL_CAPACITY]; int i = firstKey.threadLocalHashCode & (INITIAL_CAPACITY - 1); table[i] = new Entry(firstKey, firstValue); size = 1; setThreshold(INITIAL_CAPACITY); } /** * 设置resize的门槛保证最差有2/3的负载因子 */ private void setThreshold(int len) { threshold = len * 2 / 3; } 还有一个版本是创建一个新的map包含所有来自父map的可继承的ThreadLocal。只会由createInheritedMap调用。因为较少使用就不说了。 getEntry getEntry获取和key关联的条目。这个方法本身只处理快速通道:已有key直接命中,否则会转移到getEntryAfterMiss。这种设计是为了最大化直接命中的效率,部分通过使这个方法容易非线性读取来实现。 private Entry getEntry(ThreadLocal<?> key) { int i = key.threadLocalHashCode & (table.length - 1);//根据hash值计算出直接命中的位置 Entry e = table[i]; if (e != null && e.get() == key) return e;//命中 else return getEntryAfterMiss(key, i, e);//未命中 } 如果直接目标未命中,需要getEntryAfterMiss来进行线性探测。由于散列的hash值碰撞情况很小,所以比起直接用循环查找的方法效率更高。在线性探测过程中,移动就是最简单的移动到尾部循环至头部,如果发现ThreadLocal为null说明已经被移除,需要删除这个结点的引用使得可以进行回收。 private Entry getEntryAfterMiss(ThreadLocal<?> key, int i, Entry e) { Entry[] tab = table; int len = tab.length; while (e != null) { ThreadLocal<?> k = e.get(); if (k == key) return e; if (k == null) expungeStaleEntry(i);//不再有引用了,需要删除 else i = nextIndex(i, len);//向后移动一位 e = tab[i]; } return null; } private static int nextIndex(int i, int len) { return ((i + 1 < len) ? i + 1 : 0); } hash 刚才提到了hash和表中对象的关系,那么要研究下ThreadLocalMap的hash值是怎么设计的。首先,要明确的一点是ThreadLocalMap使用的是开放地址法线性探测解决hash碰撞的问题,而hash值是在ThreadLocal中的。我们可以看到ThreadLocal中跟hash值计算有关的部分,用一个AtomicInteger来计算,是static也就是说有一个静态的值每新建一个ThreadLocal实例就会增加,但增加的间隔并不是1,而是0x61c88647,这个值得选取是为了减少碰撞的发生,具体原理和斐波那契散列法以及黄金分割有关。 所以,对于同样的ThreadLocal变量,各线程的ThreadLocalMap中它们都处于同一个数组位置。因此,还是建议每个线程只存一个变量,这样的话所有的线程存放到map中的Key都是相同的ThreadLocal,如果一个线程要保存多个变量,就需要创建多个ThreadLocal,多个ThreadLocal放入Map中时会极大的增加hash冲突的可能。如果必须使用多个变量,0x61c88647可以尽可能减少冲突的发生。因为表的大小永远是2的指数次,所以和len-1进行位与操作等价为直接取模。 /** * ThreadLocal依赖每个线程线性探测hash表关联到每个线程(Thread.threadLocals和inheritableThreadLocals)。 * ThreadLocal对象作为key,通过threadLocalHashCode来查找。 * 这是一个典型的hash值(只在ThreadLocalMaps内有用)消除当同样的线程连续创建ThreadLocal实例常见状况下的冲突,同时不太常见的状况也是良性的。 */ private final int threadLocalHashCode = nextHashCode(); /** * 下一个要给出的hash值,自动更新,从0开始。 */ private static AtomicInteger nextHashCode = new AtomicInteger(); /** * 连续产生的hash值之间的差值-使得连续的线程本地ID变得隐式连续,接近最佳地扩展到大小是2的指数次表的乘法倍数的hash值上。 */ private static final int HASH_INCREMENT = 0x61c88647;//‭0110 0001 1100 1000 1000 0110 0100 0111‬ /** * 返回下一个hash值 */ private static int nextHashCode() { return nextHashCode.getAndAdd(HASH_INCREMENT); } set set没有像get那样使用快速路径是因为使用set创建一个新的条目至少和替换一个已有的是一样频率,这样快速路径会经常失败。set会从hash对应的位置开始线性查找指定的key值,如果找到entry存在但key为null的位置说明已经被remove,使用replaceStaleEntry替换过时的值。如果找到了这个key值则替换已有值。如果找到了entry为null的位置说明还未被使用过,直接新建一个entry放到这个位置上。 private void set(ThreadLocal<?> key, Object value) { Entry[] tab = table; int len = tab.length; int i = key.threadLocalHashCode & (len-1); for (Entry e = tab[i]; e != null; e = tab[i = nextIndex(i, len)]) { ThreadLocal<?> k = e.get(); if (k == key) { e.value = value;//替换已有值 return; } if (k == null) { replaceStaleEntry(key, value, i);//替换过时的值 return; } } tab[i] = new Entry(key, value);//hash值对应的位置没有插入过元素 int sz = ++size; if (!cleanSomeSlots(i, sz) && sz >= threshold) rehash(); } replaceStaleEntry用一个有指定key的条目替换在set操作中遇到的过时条目。value参数传递的值存储在条目中,无论有这个key的条目是否已经存在。作为一个副作用,这个方法擦除了一趟中所有过时的条目(一趟指两个entry为null位置间的序列)。新的条目放在staleSlot位置上,而从这个位置开始向前和向后倒两个entry为null的位置之间所有key为null的条目都会被清除。 private void replaceStaleEntry(ThreadLocal<?> key, Object value, int staleSlot) { Entry[] tab = table; int len = tab.length; Entry e; //返回检查当前趟中之前的过期条目。我们一次清除整个趟避免因为垃圾回收释放串中的引用而频繁增加的rehash int slotToExpunge = staleSlot; for (int i = prevIndex(staleSlot, len); (e = tab[i]) != null; i = prevIndex(i, len))//从staleSlot开始向前直到entry为null的位置为止最靠前的引用为null的条目 if (e.get() == null) slotToExpunge = i; //寻找key或者趟里后面null位置两者中先发生的 for (int i = nextIndex(staleSlot, len); (e = tab[i]) != null; i = nextIndex(i, len)) {//循环从staleSlot向后倒entry为null的位置 ThreadLocal<?> k = e.get(); //如果找到key,我们需要交换它和过期条目来保持hash表顺序。新的过期位置或者在它之前任何其他过期位置, //可以被发送给expungeStaleEntry来移除或者rehash趟中的其他所有条目 if (k == key) {//找到了set操作中要插入的key e.value = value; tab[i] = tab[staleSlot];//将key相同的结点与staleSlot位置的结点交换 tab[staleSlot] = e; // 如果有的话开始擦除先前的过期结点 if (slotToExpunge == staleSlot) slotToExpunge = i; cleanSomeSlots(expungeStaleEntry(slotToExpunge), len);//第一个参数是从slotToExpunge到下一个null的位置,第二个参数是table长度 return; } //向前查找没有找到过期条目,在查找key时第一个发现的过期条目还是趟中的第一个 if (k == null && slotToExpunge == staleSlot) slotToExpunge = i; } // 如果没有找到key,将新的条目放在过期的位置 tab[staleSlot].value = null; tab[staleSlot] = new Entry(key, value); // 如果这一趟中还有其他过期条目,擦除它们 if (slotToExpunge != staleSlot) cleanSomeSlots(expungeStaleEntry(slotToExpunge), len); } expungeStaleEntry通过rehash任何在staleSlot与下一个null位置之间可能冲突条目来擦除过期条目。这也擦除了在随后的null之前遇到的所有其他过期条目。返回staleSlot之后下一个null的位置(在staleSlot和这个位置之间的都被检查是否要擦除)。 private int expungeStaleEntry(int staleSlot) { Entry[] tab = table; int len = tab.length; // 擦除在staleSlot的条目 tab[staleSlot].value = null; tab[staleSlot] = null; size--; // 直到遇到null之前rehash Entry e; int i; for (i = nextIndex(staleSlot, len); (e = tab[i]) != null; i = nextIndex(i, len)) { ThreadLocal<?> k = e.get(); if (k == null) {//key为null说明已经被remove,删除其他数据 e.value = null; tab[i] = null; size--; } else {//key存在,移动到接近hash直接定位的地方 int h = k.threadLocalHashCode & (len - 1); if (h != i) { tab[i] = null; // Unlike Knuth 6.4 Algorithm R, we must scan until // null because multiple entries could have been stale. while (tab[h] != null) h = nextIndex(h, len); tab[h] = e; } } } return i; } cleanSomeSlots检查log2(n)个位置,除非找到了一个过期条目,额外检查log2(table.length)-1个位置。插入时调用这个参数是元素个数,replaceStaleEntry调用时这个参数是table的大小。 private boolean cleanSomeSlots(int i, int n) { boolean removed = false; Entry[] tab = table; int len = tab.length; do { i = nextIndex(i, len); Entry e = tab[i]; if (e != null && e.get() == null) {//找到过期的条目需要清除 n = len; removed = true; i = expungeStaleEntry(i); } } while ( (n >>>= 1) != 0);//n=n/2 return removed; } set在新增一个条目到没有使用过的位置时,导致size增加,同时会触发rehash。会清空所有过期的条目,并根据size大小判断是否需要扩大数组,如果要扩大数组则数组大小*2。 private void rehash() { expungeStaleEntries(); // Use lower threshold for doubling to avoid hysteresis if (size >= threshold - threshold / 4) resize();//size达到了resize的大小,扩大数组 } /** * 两倍扩大表 */ private void resize() { Entry[] oldTab = table; int oldLen = oldTab.length; int newLen = oldLen * 2; Entry[] newTab = new Entry[newLen]; int count = 0; for (int j = 0; j < oldLen; ++j) { Entry e = oldTab[j]; if (e != null) { ThreadLocal<?> k = e.get(); if (k == null) { e.value = null; // Help the GC } else { int h = k.threadLocalHashCode & (newLen - 1); while (newTab[h] != null) h = nextIndex(h, newLen); newTab[h] = e; count++; } } } setThreshold(newLen); size = count; table = newTab; } /** * 清除表中稳定所有过期条目 */ private void expungeStaleEntries() { Entry[] tab = table; int len = tab.length; for (int j = 0; j < len; j++) { Entry e = tab[j]; if (e != null && e.get() == null) expungeStaleEntry(j); } } } remove 移除key对应的条目,直接通过线性探测法找到对应的key值,条目调用clear()方法后key会变为null但条目仍然存在,通过expungeStaleEntry(int)将table中这个位置置为null,并且gc可以回收这个条目。当线程终止时,它的ThreadLocal对象引用会变为null,那么在后续使用中table中不再有引用的条目会被垃圾回收,但是如果线程长时间存活但ThreadLocal对象不再被使用,需要显示的调用remove方法,避免内存泄漏。 private void remove(ThreadLocal<?> key) { Entry[] tab = table; int len = tab.length; int i = key.threadLocalHashCode & (len-1); for (Entry e = tab[i]; e != null; e = tab[i = nextIndex(i, len)]) {//线性查找hash值相等的条目 if (e.get() == key) { e.clear();//清除引用 expungeStaleEntry(i);//删掉过期条目 return; } } }

优秀的个人博客,低调大师

Java多线程——ConcurrentHashMap源码解析

在之前讨论HashMap与HashTable时提到过,HashMap没有任何关于线程安全的处理,所以它不适合线程不安全的场景,而HashTable所有的操作方法都是加锁的,所以它是线程安全的,但是由于HashTable的一些设计上的缺陷比如每一次put或者get操作都需要重新对hash值取模来计算它的位置所以效率低。我们可以在多线程环境下通过对调用HashMap的方法进行加锁来确保其安全性,但是这样子效率还是很低。以get来说,我们知道在多线程环境下get需要检查集合中有没有某个key值,它需要根据hash值计算出位置然后检查对应的列表中有无寻找的元素,由于不能确定当前有没有正在插入元素的线程,所以需要加锁来保证安全性。但是,我们知道HashMap本身是箱式hash表,在下标位置不同时,两个线程不会操作同一个链表,所以它们之前相互不影响,也就不存在冲突,可以不用抢占同一个锁。针对不同的箱有不同的锁,这就是ConcurrentHashMap的设计方式——分段锁。 ConcurrentMap也继承了AbstractMap,实现了ConcurrentMap接口,key和value都不能为null这点和HashMap是不同的,JDK1.8采用了Node+CAS+synchronized的设计取代了1.7中的Sgement+HashEntry的设计。并且沿用了HashMap的链表转红黑树的设计。如果会修改集合中内容的方法发现正在进行resize操作,则要帮助先完成resize操作再继续。 ConcurrentMap设计核心是在HashMap箱式链表的结构基础上,每个线程只对一个箱上的结点加锁,不同箱之间不存在线程冲突。对于初始化操作使用乐观锁策略,先新建对象,通过compareAndSwap策略修改值。CAS策略基于CPU指令的支持,比加锁开销要小很多,但是它在操作失败时会自旋而不会阻塞让出CPU时间片,导致如果设计合理线程间冲突小则性能很高,如果线程间冲突严重会显著降低性能。 打开文件一看,都超过6k行了,所以还是采取从常用的方法入口开始逐渐向里追溯的分析方法。主要分析构造函数以及get、put、remove、replace、size几个常用的方法。 主要内部变量 这里需要注意的主要是resize过程中,为了多线程帮助转移原有的链表,用nextTable作为过程中的中间表。然后sizeCtl这个值正负有不同的意义,不再是capacity那样只用来表示容量的。为了避免插入新结点时计数器之前的碰撞,采用了分段式的计数器counterCells。 /** * 箱数组,在第一次插入的时候懒汉式初始化。大小总是2的幂。迭代器可以直接访问。 */ transient volatile Node<K,V>[] table; /** * 下一个使用的表,仅在resize过程中是非null */ private transient volatile Node<K,V>[] nextTable; /** * 基本计数器,主要用于没有争夺时,但也用在表初始化争夺中的返回,通过CAS更新 */ private transient volatile long baseCount; /** * 表初始化和resize控制。为负数时,这个表正在初始化或者resize:-1是初始化,否则是-(1+活跃的resize线程)。 * 未非负数时,表为null时持有创建表时的初始化大小如果是0采用默认大小。初始化之后,持有下一个resize操作的计数界限。 */ private transient volatile int sizeCtl; /** * 在resize时下一个分裂处的下标 */ private transient volatile int transferIndex; /** * 通过CAS锁定的自旋锁,用于resize时或者创建CounterCells时 */ private transient volatile int cellsBusy; /** * 计数器存储格表,非null时大小为2的指数次 */ private transient volatile CounterCell[] counterCells; 构造函数 构造函数最多是3个参数,不输入就采用默认值:表初始大小initialCapacity默认为16;负载因子loadFactor默认为0.75;并发级别concurrencyLevel代表线程数的估计值,默认为1但除了初始大小不能小于这个值以外没有其他作用。这里表的初始大小也会取恰好大于等于参数中初始大小除以负载因子加1和的2的指数次幂作为大小。sizeCtl为下一次扩展集合的边界,也就是容量。 public ConcurrentHashMap(int initialCapacity, float loadFactor, int concurrencyLevel) { if (!(loadFactor > 0.0f) || initialCapacity < 0 || concurrencyLevel <= 0) throw new IllegalArgumentException(); if (initialCapacity < concurrencyLevel) // Use at least as many bins initialCapacity = concurrencyLevel; // as estimated threads long size = (long)(1.0 + (long)initialCapacity / loadFactor); int cap = (size >= (long)MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : tableSizeFor((int)size);//tableSizeFor获取恰好大于等于size的2的指数次幂 this.sizeCtl = cap; } 静态工具方法 spread将hash值的高16位与低16位进行异或,作用是利用hash值的高位减少hash冲突,之前讲过HashMap中直接通过截取与容量大小-1的二进制位长度来进行快速定位数组中的位置。>>>是无符号右移 static final int spread(int h) { return (h ^ (h >>> 16)) & HASH_BITS; } tableSizeFor计算大于等于给定值的最小2的指数次幂。我们知道二进制下低位全是1的数再加1可以获得2的整数次幂,而这个全是1的数的获取方法是,将原数-1后的值的最高位扩展到所有的低位,最后返回的结果再加1。 private static final int tableSizeFor(int c) { int n = c - 1; n |= n >>> 1; n |= n >>> 2; n |= n >>> 4; n |= n >>> 8; n |= n >>> 16; return (n < 0) ? 1 : (n >= MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : n + 1; } 然后是三个CAS方法,都是基于Unsafe调用CPU支持的系统函数完成的 //获取tab中下标为i的元素 static final <K,V> Node<K,V> tabAt(Node<K,V>[] tab, int i) { return (Node<K,V>)U.getObjectVolatile(tab, ((long)i << ASHIFT) + ABASE); } //修改tab中下标为i的元素值为v,要求从内存中取出时的值为c static final <K,V> boolean casTabAt(Node<K,V>[] tab, int i, Node<K,V> c, Node<K,V> v) { return U.compareAndSwapObject(tab, ((long)i << ASHIFT) + ABASE, c, v); } //修改tab中下标为i的元素的值为v static final <K,V> void setTabAt(Node<K,V>[] tab, int i, Node<K,V> v) { U.putObjectVolatile(tab, ((long)i << ASHIFT) + ABASE, v); } put操作 put方法有两种类型put和putIfAbsent,可以看到它们都调用了putVal这个方法,区别在于第三个参数 public V put(K key, V value) { return putVal(key, value, false); } public V putIfAbsent(K key, V value) { return putVal(key, value, true); } putVal就是实际操作了,首先检查箱数组有没有初始化,没有的话先要初始化。然后根据hash值计算出箱的位置,如果箱的位置为空则CAS新增一个结点。如果已有结点,则先检查有没有在做resize操作,有的话协助转移Node,没有在进行resize时对这个箱的结点加锁,检查箱式链表中有没有key值相等的结点,有的话视onlyIfAbsent的参数情况决定要不要覆盖。如果插入了新的结点到链表末尾需要检查链表长度是否达到8需要转为树结构,然后检查是否达到要进行resize的大小。最后的返回值,如果key值已经存在则返回旧的value值,否则返回null。在第一行的检查中我们可以看到,key和value都不能为null,否则抛出NullPointerException。 final V putVal(K key, V value, boolean onlyIfAbsent) { if (key == null || value == null) throw new NullPointerException();//插入的key和value都不能是null int hash = spread(key.hashCode());//高位也参与hash值计算 int binCount = 0; for (Node<K,V>[] tab = table;;) {//tab为箱数组 Node<K,V> f; int n, i, fh; if (tab == null || (n = tab.length) == 0) tab = initTable();//在第一次插入时进行懒汉式初始化箱数组 else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) {//tabAt从内存中读取箱数组指定位置 //箱数组指定位置为null if (casTabAt(tab, i, null, new Node<K,V>(hash, key, value, null)))//期待值n为ull,更新后的值为新建的Node,替换成功时返回true break; //增加到一个空箱时不加锁 } //箱数组指定位置已有Node else if ((fh = f.hash) == MOVED) tab = helpTransfer(tab, f);//正在resize移动过程中,帮助转移Node else {//存在普通状态Node V oldVal = null; synchronized (f) {//锁箱数组中对应位置的结点 if (tabAt(tab, i) == f) { if (fh >= 0) { binCount = 1;//统计链表长度 for (Node<K,V> e = f;; ++binCount) { K ek; if (e.hash == hash && ((ek = e.key) == key || (ek != null && key.equals(ek)))) {//存在key相等的Node oldVal = e.val; if (!onlyIfAbsent) e.val = value;//put调用时更新这个结点的value值 break; } Node<K,V> pred = e; if ((e = e.next) == null) { pred.next = new Node<K,V>(hash, key, value, null);//不存在key相等的Node,将新Node添加到链表末尾 break; } } } else if (f instanceof TreeBin) {//树状表 Node<K,V> p; binCount = 2; if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key, value)) != null) { oldVal = p.val; if (!onlyIfAbsent) p.val = value; } } } } if (binCount != 0) { if (binCount >= TREEIFY_THRESHOLD) treeifyBin(tab, i); if (oldVal != null) return oldVal;//存在key相等的结点时返回该结点的value值 break; } } } addCount(1L, binCount);//添加了新的结点时增加基础计数器,并检查是否需要扩大数组 return null;//不存在key相等的结点时返回null } initTable初始化表,大小为记录在sizeCtl中的值,只有在第一次向集合中添加键值对时才会调用。线程会尝试将堆中实例的sizeCtl值设为-1,如果成功的话代表该线程竞争到了初始化创建数组的权限,它将新建一个大小为sizeCtl原本值的Node数组,并修改实例中的table,这里的负载因子一定是按照0.75计算。最后将sizeCtl重置回原本的值。对于没有竞争到的线程会通过Thread.yield()会主动让出线程执行时间,线程转为就绪状态,但这不代表它一定不会立刻再进入运行状态。 private final Node<K,V>[] initTable() { Node<K,V>[] tab; int sc; while ((tab = table) == null || tab.length == 0) { if ((sc = sizeCtl) < 0) Thread.yield(); // 在初始化竞争中失败,自旋 else if (U.compareAndSwapInt(this, SIZECTL, sc, -1)) {//尝试替换sizeCtl的值为-1,先替换成功的线程竞争成功,由它进行初始化 try { if ((tab = table) == null || tab.length == 0) { int n = (sc > 0) ? sc : DEFAULT_CAPACITY; @SuppressWarnings("unchecked") Node<K,V>[] nt = (Node<K,V>[])new Node<?,?>[n]; table = tab = nt; sc = n - (n >>> 2);//负载因子是0.75,所以sizeCtl=n-n/4 } } finally { sizeCtl = sc; } break; } } return tab; } addCount在新增结点时被调用,增加count,如果表太小并且还没有resize,初始化转移。如果已经resize,帮助转移。重新检查转移后的占用来看是否需要另一个resize,因为resize比增加要延迟。如果check<0不检查resize,如果check<=1只在没有竞争时检查resize。 private final void addCount(long x, int check) { CounterCell[] as; long b, s; if ((as = counterCells) != null || !U.compareAndSwapLong(this, BASECOUNT, b = baseCount, s = b + x)) {//counterCells存在或者当前增加baseCount存在竞争 CounterCell a; long v; int m; boolean uncontended = true; if (as == null || (m = as.length - 1) < 0 || (a = as[ThreadLocalRandom.getProbe() & m]) == null || !(uncontended = U.compareAndSwapLong(a, CELLVALUE, v = a.value, v + x))) {//计数器未初始化或者计数器增加失败 fullAddCount(x, uncontended); return; } if (check <= 1) return; s = sumCount(); } if (check >= 0) { Node<K,V>[] tab, nt; int n, sc; while (s >= (long)(sc = sizeCtl) && (tab = table) != null && (n = tab.length) < MAXIMUM_CAPACITY) {//需要进行resize时循环 int rs = resizeStamp(n);//获取结束位 if (sc < 0) { if ((sc >>> RESIZE_STAMP_SHIFT) != rs || sc == rs + 1 || sc == rs + MAX_RESIZERS || (nt = nextTable) == null || transferIndex <= 0) break;//没有在进行resize if (U.compareAndSwapInt(this, SIZECTL, sc, sc + 1))//已有nextTab transfer(tab, nt);//转移tab中的内容到nextTable } else if (U.compareAndSwapInt(this, SIZECTL, sc, (rs << RESIZE_STAMP_SHIFT) + 2)) transfer(tab, null);//新建nextTable s = sumCount(); } } } fullAddCount作用是在在计数格不存在或者baseCount增加失败时,尝试初始化计数格或者循环尝试增加baseCount。分析fullAddCount可以发现,计数器数组为空时增加计数器数组大小为2,而传递给addCount的check参数大小是链表长度。 private final void fullAddCount(long x, boolean wasUncontended) { int h; if ((h = ThreadLocalRandom.getProbe()) == 0) {//检查线程本地随机数有没有初始化 ThreadLocalRandom.localInit(); // force initialization强制初始化 h = ThreadLocalRandom.getProbe(); wasUncontended = true; } boolean collide = false; // True if last slot nonempty上一个槽非空时为true for (;;) { CounterCell[] as; CounterCell a; int n; long v; if ((as = counterCells) != null && (n = as.length) > 0) {//counterCells不为空 if ((a = as[(n - 1) & h]) == null) {//当前线程对应的计数器槽为空 if (cellsBusy == 0) { // Try to attach new Cell尝试关联到一个新的计数格 CounterCell r = new CounterCell(x); // Optimistic create乐观创建 if (cellsBusy == 0 && U.compareAndSwapInt(this, CELLSBUSY, 0, 1)) {//CAS算法尝试替换cellsBusy值为1 boolean created = false; try { // Recheck under lock在锁下重新检查 CounterCell[] rs; int m, j; if ((rs = counterCells) != null && (m = rs.length) > 0 && rs[j = (m - 1) & h] == null) { rs[j] = r;//赋值新建的计数格 created = true; } } finally { cellsBusy = 0;//重置cellsBusy为0 } if (created) break; continue; // Slot is now non-empty槽现在是非空 } } collide = false; } else if (!wasUncontended) // CAS already known to fail CAS已经知道失败 wasUncontended = true; // Continue after rehash再重新hash之后继续 else if (U.compareAndSwapLong(a, CELLVALUE, v = a.value, v + x)) break;//计数器增加成功则跳出 else if (counterCells != as || n >= NCPU) collide = false; // At max size or stale最大大小或者已经过时 else if (!collide) collide = true; else if (cellsBusy == 0 && U.compareAndSwapInt(this, CELLSBUSY, 0, 1)) {//计数格数组已经存在但不够大,竞争扩展它的权限 try { if (counterCells == as) {// Expand table unless stale除非已经过时否则扩展表 CounterCell[] rs = new CounterCell[n << 1];//新建一个大小为2倍的数组 for (int i = 0; i < n; ++i) rs[i] = as[i];//逐个赋值复制计数格 counterCells = rs;//修改数组 } } finally { cellsBusy = 0;//重置cellsBusy } collide = false; continue; // Retry with expanded table重新检查扩展后的表 } h = ThreadLocalRandom.advanceProbe(h);//伪随机前进并记录给定的探针值 } else if (cellsBusy == 0 && counterCells == as && U.compareAndSwapInt(this, CELLSBUSY, 0, 1)) {//counterCells为空,竞争到初始化的权利 boolean init = false; try { // Initialize table初始化表 if (counterCells == as) { CounterCell[] rs = new CounterCell[2];//计数格表初始化大小为2 rs[h & 1] = new CounterCell(x);//新建计数格 counterCells = rs; init = true; } } finally { cellsBusy = 0; } if (init) break;//初始化成功 } else if (U.compareAndSwapLong(this, BASECOUNT, v = baseCount, v + x)) break; // Fall back on using base使用base回退 } } transfer移动或者复制每个箱中的结点到新的表中,代码很长,大概可以分为几个部分:1如果nextTab为空新建一个;2每个线程分配到一个下标;3检查这个下标是否有存在的结点并且没有其他线程在修改它,有的话对它加锁然后搬运。比较复杂的地方主要是分配下标,考虑到多线程进行操作时,每个箱同时只能由一个线程来处理,如果所有线程都采用从0到n的遍历方式,冲突次数会大幅度上升,这里采取的策略是通过transferIndex来记录下一个线程进入时开始的下标位置进行分段,该值的变化间隔为16或者n/8/CPU值的较大值。对一个箱的搬运工作参照HashMap的工作方式通过高位hash值将链表拆分到数组高位。 private final void transfer(Node<K,V>[] tab, Node<K,V>[] nextTab) { int n = tab.length, stride; if ((stride = (NCPU > 1) ? (n >>> 3) / NCPU : n) < MIN_TRANSFER_STRIDE)//n/8/CPU个数<16 stride = MIN_TRANSFER_STRIDE; // subdivide range细分范围 if (nextTab == null) { // initiating初始化 try { @SuppressWarnings("unchecked") Node<K,V>[] nt = (Node<K,V>[])new Node<?,?>[n << 1];//新建一个当前表大小2倍的数组给nextTable nextTab = nt; } catch (Throwable ex) { // try to cope with OOME sizeCtl = Integer.MAX_VALUE; return; } nextTable = nextTab; transferIndex = n; } int nextn = nextTab.length; ForwardingNode<K,V> fwd = new ForwardingNode<K,V>(nextTab); boolean advance = true; boolean finishing = false; // to ensure sweep before committing nextTab在提交nextTab前确保扫除完成 for (int i = 0, bound = 0;;) { Node<K,V> f; int fh; while (advance) { int nextIndex, nextBound; if (--i >= bound || finishing) advance = false; else if ((nextIndex = transferIndex) <= 0) { i = -1; advance = false; } else if (U.compareAndSwapInt (this, TRANSFERINDEX, nextIndex, nextBound = (nextIndex > stride ? nextIndex - stride : 0))) {//减小transferIndex的值 bound = nextBound; i = nextIndex - 1; advance = false; } } if (i < 0 || i >= n || i + n >= nextn) {//该线程负责转移部分已经完成 int sc; if (finishing) {//resize完成 nextTable = null; table = nextTab; sizeCtl = (n << 1) - (n >>> 1);//n*0.75 return; } if (U.compareAndSwapInt(this, SIZECTL, sc = sizeCtl, sc - 1)) {//增加一个活跃线程帮助resize if ((sc - 2) != resizeStamp(n) << RESIZE_STAMP_SHIFT) return; finishing = advance = true; i = n; // recheck before commit提交前重新检查 } } else if ((f = tabAt(tab, i)) == null)//表中不存在这个结点 advance = casTabAt(tab, i, null, fwd); else if ((fh = f.hash) == MOVED) advance = true; // already processed已经在移动 else {//表中有这个结点并且没有在移动 synchronized (f) {//每个箱只能由一个线程在处理 if (tabAt(tab, i) == f) { Node<K,V> ln, hn; if (fh >= 0) { int runBit = fh & n; Node<K,V> lastRun = f; for (Node<K,V> p = f.next; p != null; p = p.next) { int b = p.hash & n; if (b != runBit) { runBit = b; lastRun = p; } } if (runBit == 0) { ln = lastRun; hn = null; } else { hn = lastRun; ln = null; } for (Node<K,V> p = f; p != lastRun; p = p.next) { int ph = p.hash; K pk = p.key; V pv = p.val; if ((ph & n) == 0) ln = new Node<K,V>(ph, pk, pv, ln); else hn = new Node<K,V>(ph, pk, pv, hn); } setTabAt(nextTab, i, ln); setTabAt(nextTab, i + n, hn); setTabAt(tab, i, fwd); advance = true; } else if (f instanceof TreeBin) { TreeBin<K,V> t = (TreeBin<K,V>)f; TreeNode<K,V> lo = null, loTail = null; TreeNode<K,V> hi = null, hiTail = null; int lc = 0, hc = 0; for (Node<K,V> e = t.first; e != null; e = e.next) { int h = e.hash; TreeNode<K,V> p = new TreeNode<K,V> (h, e.key, e.val, null, null); if ((h & n) == 0) { if ((p.prev = loTail) == null) lo = p; else loTail.next = p; loTail = p; ++lc; } else { if ((p.prev = hiTail) == null) hi = p; else hiTail.next = p; hiTail = p; ++hc; } } ln = (lc <= UNTREEIFY_THRESHOLD) ? untreeify(lo) : (hc != 0) ? new TreeBin<K,V>(lo) : t; hn = (hc <= UNTREEIFY_THRESHOLD) ? untreeify(hi) : (lc != 0) ? new TreeBin<K,V>(hi) : t; setTabAt(nextTab, i, ln); setTabAt(nextTab, i + n, hn); setTabAt(tab, i, fwd); advance = true; } } } } } } 在putVal时,如果发现箱正在被转移说明resize操作正在进行,调用helpTransfer帮助转移 final Node<K,V>[] helpTransfer(Node<K,V>[] tab, Node<K,V> f) { Node<K,V>[] nextTab; int sc; if (tab != null && (f instanceof ForwardingNode) && (nextTab = ((ForwardingNode<K,V>)f).nextTable) != null) { int rs = resizeStamp(tab.length); while (nextTab == nextTable && table == tab && (sc = sizeCtl) < 0) { if ((sc >>> RESIZE_STAMP_SHIFT) != rs || sc == rs + 1 || sc == rs + MAX_RESIZERS || transferIndex <= 0) break; if (U.compareAndSwapInt(this, SIZECTL, sc, sc + 1)) {//通过CAS将sizeCtl+1来竞争操作权 transfer(tab, nextTab); break; } } return nextTab; } return table; } get 相比之下,get操作就比较简单了,从堆中找到table中下标位置的结点,然后顺着链表寻找key值相等的结点。find方法是预留给Node的子类重写hash值小于0的方法 public V get(Object key) { Node<K,V>[] tab; Node<K,V> e, p; int n, eh; K ek; int h = spread(key.hashCode()); if ((tab = table) != null && (n = tab.length) > 0 && (e = tabAt(tab, (n - 1) & h)) != null) {//从内存中获取table指定下标位置的结点 if ((eh = e.hash) == h) { if ((ek = e.key) == key || (ek != null && key.equals(ek))) return e.val;//找到了指定的key值 } else if (eh < 0) return (p = e.find(h, key)) != null ? p.val : null;//留给子类的重写方法,否则还是从这个链表中遍历寻找 while ((e = e.next) != null) {//遍历链表寻找hash值 if (e.hash == h && ((ek = e.key) == key || (ek != null && key.equals(ek)))) return e.val; } } return null; } size size返回键值对的数量,最大不能超过整数上限。 public int size() { long n = sumCount(); return ((n < 0L) ? 0 : (n > (long)Integer.MAX_VALUE) ? Integer.MAX_VALUE : (int)n); } 其中的关键是sumCount方法,我们前面提到有baseCount和counterCells数组两个和计数有关的变量,分析addCount时我们可以看到优先增加baseCount的值,如果失败的话找到线程对应的计数格增加它的计数器,所以键值对的个数为两类变量的总和。 final long sumCount() { CounterCell[] as = counterCells; CounterCell a; long sum = baseCount; if (as != null) { for (int i = 0; i < as.length; ++i) { if ((a = as[i]) != null) sum += a.value; } } return sum; } remove和replace remove是移除指定的结点,replace是将指定结点替换为指定值。虽然有不同的重载版本,区别是要不要指定结点的value值,但除了一些参数上的判断之外,它们都是基于replaceNode方法来完成的。 public V remove(Object key) { return replaceNode(key, null, null); } public boolean remove(Object key, Object value) { if (key == null) throw new NullPointerException(); return value != null && replaceNode(key, null, value) != null; } public boolean replace(K key, V oldValue, V newValue) { if (key == null || oldValue == null || newValue == null) throw new NullPointerException(); return replaceNode(key, newValue, oldValue) != null; } public V replace(K key, V value) { if (key == null || value == null) throw new NullPointerException(); return replaceNode(key, value, null); } replaceNode实现4个remove/replace操作:替换结点值为v,如果cv不是null则它原本的value需要等于cv,如果结果value值是null则删除这个结点。 final V replaceNode(Object key, V value, Object cv) { int hash = spread(key.hashCode()); for (Node<K,V>[] tab = table;;) { Node<K,V> f; int n, i, fh; if (tab == null || (n = tab.length) == 0 || (f = tabAt(tab, i = (n - 1) & hash)) == null) break;//表不存在或者表为空或者表中找不到hash值对应的结点,直接返回 else if ((fh = f.hash) == MOVED) tab = helpTransfer(tab, f);//正在resize先帮助转移 else {//表中存在该位置的结点 V oldVal = null; boolean validated = false; synchronized (f) { if (tabAt(tab, i) == f) {//双重确认 if (fh >= 0) {//hash值大于0说明是链表结点 validated = true; for (Node<K,V> e = f, pred = null;;) { K ek; if (e.hash == hash && ((ek = e.key) == key || (ek != null && key.equals(ek)))) { V ev = e.val; if (cv == null || cv == ev || (ev != null && cv.equals(ev))) { oldVal = ev; if (value != null) e.val = value;//value不为null替换值 else if (pred != null)//需要删除结点 pred.next = e.next;//该结点不是链表头 else setTabAt(tab, i, e.next);//该结点时链表头 } break; } pred = e; if ((e = e.next) == null) break; } } else if (f instanceof TreeBin) {//树状链表 validated = true; TreeBin<K,V> t = (TreeBin<K,V>)f; TreeNode<K,V> r, p; if ((r = t.root) != null && (p = r.findTreeNode(hash, key, null)) != null) { V pv = p.val; if (cv == null || cv == pv || (pv != null && cv.equals(pv))) { oldVal = pv; if (value != null) p.val = value; else if (t.removeTreeNode(p)) setTabAt(tab, i, untreeify(t.first)); } } } } } if (validated) { if (oldVal != null) { if (value == null) addCount(-1L, -1);//减少计数器,因为第二个参数是-1所以肯定不会检查resize return oldVal; } break; } } } return null; }

优秀的个人博客,低调大师

Java PipedInputStream PipedOutputStream类源码解析

管道流主要是用于不同线程间的数据交互,可以通过一个PipedInputStream和一个PipedOutputStream相互连接来进行通信,从PipedOutputStream写入字节到PipedInputStream中,所以PipedOutputStream是writer端,PipedInputStream是reader端。 一个PipedInputStream只能与一个PipedOutputStream连接,但是可以通过多个线程共享同一个管道来达到复数生产者和复数消费者的模式,同一个角色相互之间会存在竞争。下面的例子是一个writer和两个reader共用同一个管道流,可以看到两个reader之间根据线程调度随机接收一部分数据。 public class PipeStreamTest implements Runnable { private PipedInputStream in; private PipedOutputStream out; public PipeStreamTest(PipedInputStream in) { this.in = in; } public PipeStreamTest(PipedOutputStream out) { this.out = out; } @Override public void run() { if (this.in != null) { boolean flag = true; while (flag) { try { int a = in.read(); if (a == -1) { flag = false; break; } System.out.println(Thread.currentThread().getName() + " calculate " + String.valueOf(2 * a + 1)); } catch (IOException e) { e.printStackTrace(); flag = false; } } } else { try { Thread.sleep(1000);// 这里阻塞了out,导致in内没有可读取数据被阻塞 } catch (InterruptedException e1) { e1.printStackTrace(); } int a = 5; try { for (int i = 0; i < 5; i++) { out.write(a + i); System.out.println(Thread.currentThread().getName() + " write " + String.valueOf(a)); } out.close(); } catch (IOException e) { e.printStackTrace(); } } } public static void main(String args[]) throws IOException { PipedInputStream in = new PipedInputStream(10); PipedOutputStream out = new PipedOutputStream(in); new Thread(new PipeStreamTest(in)).start(); new Thread(new PipeStreamTest(in)).start(); new Thread(new PipeStreamTest(out)).start(); /*Thread-0 calculate 11 Thread-2 write 5 Thread-2 write 5 Thread-0 calculate 13 Thread-2 write 5 Thread-2 write 5 Thread-2 write 5 Thread-0 calculate 15 Thread-0 calculate 19 Thread-1 calculate 17*/ } } 对run()进行一些修改,阻塞reader线程,使得writer可以写满缓存区,此时writer会被阻塞,等待有reader读取数据后缓冲区有空余空间再写入,由于Thread.sleep不会被notifyAll()影响,所以在写入了10bytes数据后会存在5s的明显间隔 public void run() { if (this.in != null) { try { Thread.sleep(5000);// 这里阻塞了in,使得out会因没有空间写入而阻塞 } catch (InterruptedException e1) { e1.printStackTrace(); } boolean flag = true; while (flag) { try { int a = in.read(); if (a == -1) { flag = false; break; } System.out.println(Thread.currentThread().getName() + " calculate " + String.valueOf(2 * a + 1)); } catch (IOException e) { e.printStackTrace(); flag = false; } } } else { try { Thread.sleep(1000);// 这里阻塞了out,导致in内没有可读取数据被阻塞 } catch (InterruptedException e1) { e1.printStackTrace(); } int a = 5; try { for (int i = 0; i < 15; i++) { out.write(a + i); System.out.println(Thread.currentThread().getName() + " write " + String.valueOf(a)); } out.close(); } catch (IOException e) { e.printStackTrace(); } } } /* Thread-2 write 5 Thread-2 write 5 Thread-2 write 5 Thread-2 write 5 Thread-2 write 5 Thread-2 write 5 Thread-2 write 5 Thread-2 write 5 Thread-2 write 5 Thread-2 write 5 这里出现明显的间隔 Thread-0 calculate 11 Thread-0 calculate 15 Thread-2 write 5 Thread-1 calculate 13 Thread-1 calculate 19 Thread-1 calculate 21 Thread-1 calculate 23 Thread-1 calculate 25 Thread-1 calculate 27 Thread-1 calculate 29 Thread-2 write 5 Thread-2 write 5 Thread-0 calculate 17 Thread-0 calculate 33 Thread-0 calculate 35 Thread-0 calculate 37 Thread-2 write 5 Thread-2 write 5 Thread-1 calculate 31 Thread-0 calculate 39*/ PipedInputStream 下面先来分析一下管道字节输入流PipedInputStream,它继承了InputStream。一个管道输入流需要连接一个管道输出流,管道输入流会提供任何数据字节写入管道输出流。典型地,数据被一个线程从一个PipedInputStream对象中读取,然后数据被另一个线程写到对应的PipedOutputStream。试图由一个线程使用所有对象是不推荐的,这可能导致线程死锁。 管道输入流含有一个缓冲区来解耦一个读操作和写操作。一个管道如果提供数据给相连接的管道输出流的线程不再活动,这个管道状态被称为BROKEN,也就是说如果上面的例子中把in对应的线程循环去掉使它运行完后被终止,此时out再尝试写入就会出现管道BROKEN的异常。 先来看一下跟管道状态有关的内部变量,流的关闭需要输入和输出端都关闭,所以需要两个变量来标志。同时,所有读写操作都需要管道两端建立连接,connected表示是否有连接建立。最后两个线程是输入和输出的操作线程,由于接收需要读取线程是运行状态,读取在缓冲区内为空时需要 /** * 输出流关闭,仅PipedOutputStream.close()调用receivedLast()方法会将它置为true */ boolean closedByWriter = false; /** * 输入流关闭,仅PipedInputStream.close()会将它置为true */ volatile boolean closedByReader = false; /** * 是否有一对输入输出流相互连接 */ boolean connected = false; /* 识别读和写两边需要更加复杂。使用线程组(但是管道在一个线程中怎么办)或者使用final化(但是可能到下一次GC的时间更长) */ Thread readSide;//input流的线程 Thread writeSide;//output流的线程 下面这些内部变量和缓冲区有关。buffer数组是循环缓冲区,这里有in和out两个下标指针,in负责接收,out负责读取,两个下标都是循环的如果达到末端会重新回到0的位置,读取不能超过接收数据的范围。 private static final int DEFAULT_PIPE_SIZE = 1024; /** * 管道循环输入缓冲区默认大小1K */ // 这个值在管道大小允许改变前被用作常数。这个值会为了向下兼容性被持续保持 protected static final int PIPE_SIZE = DEFAULT_PIPE_SIZE; /** * 循环缓冲区,接下来的数据会被放入其中 */ protected byte buffer[]; /** * 循环缓冲区中下一个从连接的管道输出流接收的字节数据将会被存储的位置下标。in<0说明缓冲区是空的,in==out说明缓冲区满了 */ protected int in = -1; /** * 循环缓冲区中下一个将会被这个管道输入流读取的字节下标位置。 */ protected int out = 0; 构造函数方面,可以直接给出管道输出流直接在构造时建立连接,也可以先构造输入流在需要使用时再连接。循环缓冲区的大小可以使用默认的1K,也可以手动指定大小。connect方法用于建立两端的连接,可以在构造时调用也可以手动调用。 /** * 创建一个PipedInputStream连接到管道输出流src。数据字节写入到src中将会成为这个流的输入。 */ public PipedInputStream(PipedOutputStream src) throws IOException { this(src, DEFAULT_PIPE_SIZE); } /** * 跟上面相比这个管道缓冲区的大小是指定的,其他相同 */ public PipedInputStream(PipedOutputStream src, int pipeSize) throws IOException { initPipe(pipeSize); connect(src); } /** * 创建一个还没有连接的PipedInputStream,在使用前必须连接到一个PipedOutputStream */ public PipedInputStream() { initPipe(DEFAULT_PIPE_SIZE); } /** * 创建一个还没有连接的PipedInputStream指定它的缓冲区大小,在使用前必须连接到一个PipedOutputStream */ public PipedInputStream(int pipeSize) { initPipe(pipeSize); } private void initPipe(int pipeSize) { if (pipeSize <= 0) { throw new IllegalArgumentException("Pipe Size <= 0"); } buffer = new byte[pipeSize]; } /** * 引起这个管道输入流连接到管道输出流src。如果这个对象已经连接到某个其他的管道输出流会抛出IOException。 * 如果src是一个未连接的管道输出流,snk是一个未连接的管道输入流,它们可以通过snk.connect(src)或者src.connect(snk)连接,两者效果相同。 */ public void connect(PipedOutputStream src) throws IOException { src.connect(this); } receive方法将字节写入到缓冲区,这是protected方法,再没有继承类的情况下由PipedOutputStream.write方法调用,接收字节会导致下标指针in增加,如果到达右边界,会重置为0。如果当前缓冲区没有空余的空间,这个方法会被阻塞,直到有线程读取了数据使得有空间写入时再继续。 /** * 接收一字节数据,这个方法如果没有有效输入时会阻塞。 */ protected synchronized void receive(int b) throws IOException { checkStateForReceive();//检查管道状态 writeSide = Thread.currentThread();//写线程设为当前线程 if (in == out) awaitSpace();//缓冲区满了,通知所有线程使得读取端读取字节给当前流缓冲区空出位置来接收 if (in < 0) {//in<0表示当前缓冲区为空 in = 0; out = 0; } buffer[in++] = (byte)(b & 0xFF);//将b存储到缓冲区中 if (in >= buffer.length) { in = 0;//因为是循环缓冲区,所以in超过buffer.length时重新回到0的位置 } } /** * 将数据接收到一个字节数组中,这个方法会阻塞到一些输入变得有效。 */ synchronized void receive(byte b[], int off, int len) throws IOException { checkStateForReceive();//检查管道状态 writeSide = Thread.currentThread();//写线程设为当前线程 int bytesToTransfer = len; while (bytesToTransfer > 0) {//还有需要写入的字节 if (in == out) awaitSpace();//缓冲区满了,通知其他线程读取字节空出空间 int nextTransferAmount = 0; if (out < in) {//out<in说明out到in这段是未读取的数据,所以空余空间是buffer.length-in nextTransferAmount = buffer.length - in; } else if (in < out) { if (in == -1) { //当前缓冲区为空,可用空间为buffer.length in = out = 0; nextTransferAmount = buffer.length - in; } else { //in已经到达一次右边界重置为0之后in<out,out到右边界是未读取内容,in不能超过out的值,所以空余空间为out-in nextTransferAmount = out - in; } } if (nextTransferAmount > bytesToTransfer) nextTransferAmount = bytesToTransfer;//要读取的字节数是剩余空间和参数指定长度间的较小值 assert(nextTransferAmount > 0); System.arraycopy(b, off, buffer, in, nextTransferAmount);//将接收的字节复制到缓冲区in开始的位置 bytesToTransfer -= nextTransferAmount; off += nextTransferAmount; in += nextTransferAmount;//in增加读取的字节数 if (in >= buffer.length) { in = 0;//in到达缓冲区边界时重置为0 } } } 然后看下这用到的两个内部方法。checkStateForReceive这个内部方法,确定当前有连接,管道两端都没有被关闭,有活动的读取端线程。当in==out时说明缓冲区满了不能再写入,需要有线程读取使得out增大之后才能再写入,awaitSpace会唤醒所有的等待读取线程,然后等待1s,再检查in==out是否成立,不断循环这个过程。 private void checkStateForReceive() throws IOException { if (!connected) { throw new IOException("Pipe not connected"); } else if (closedByWriter || closedByReader) { throw new IOException("Pipe closed"); } else if (readSide != null && !readSide.isAlive()) { throw new IOException("Read end dead"); } } private void awaitSpace() throws IOException { while (in == out) { checkStateForReceive(); /* full: kick any waiting readers */ notifyAll();//唤醒所有线程,使得有reader读取字节将当前流缓冲区空出来 try { wait(1000);//当前线程等待1s } catch (InterruptedException ex) { throw new java.io.InterruptedIOException(); } } } read方法从缓冲区中读取字节,要求存在连接且读取端没有关闭,如果缓冲区内没有可读取的字节则还需要writer端线程是活跃的。读取多个字节时会先尝试允许阻塞读取一个字节,成功后再读取后面部分,此时不会再阻塞等待所以如果要读取的长度太长则只读取缓冲区内所有可读取的内容,返回的是实际读取的字节数。 /** * 从这个管道输入流读取下一个字节。返回值作为一个整数范围在0-255之间。这个方法一直阻塞到输入数据变得有效,或者探知到流结束或者抛出异常。 */ public synchronized int read() throws IOException { //存在连接,读取端没有关闭,缓存区为空时写入端线程必须活动 if (!connected) { throw new IOException("Pipe not connected"); } else if (closedByReader) { throw new IOException("Pipe closed"); } else if (writeSide != null && !writeSide.isAlive() && !closedByWriter && (in < 0)) { throw new IOException("Write end dead"); } readSide = Thread.currentThread();//读取端线程设为当前线程 int trials = 2;//加起来等待2s,第三次循环缓冲区依然为空没有写入数据则认为管道BROKEN while (in < 0) { if (closedByWriter) { /* 输出管道被writer关闭返回-1 */ return -1; } if ((writeSide != null) && (!writeSide.isAlive()) && (--trials < 0)) { throw new IOException("Pipe broken"); } /* 可能有一个writer在等待 */ notifyAll(); try { wait(1000); } catch (InterruptedException ex) { throw new java.io.InterruptedIOException(); } } int ret = buffer[out++] & 0xFF;//读取out位置的字节并增加out if (out >= buffer.length) { out = 0;//如果out到达buffer右边界,将它重置为0 } if (in == out) { /* in==out说明缓冲区空了 */ in = -1; } return ret; } /** * 从这个管道输入流读取最大len程度的字节数据到字节数组中。如果到达了数据量末端或者len超过了管道缓冲区大小,少于len字节的数据会被读取。 * 如果len是0,没有数据会被读取返回0;否则这个方法会阻塞直到至少1字节输入是有效的,或者到达了流末端或者抛出异常。 */ public synchronized int read(byte b[], int off, int len) throws IOException { //存在连接,读取端没有关闭,缓存区为空时写入端线程必须活动 if (b == null) { throw new NullPointerException(); } else if (off < 0 || len < 0 || len > b.length - off) { throw new IndexOutOfBoundsException(); } else if (len == 0) { return 0; } /* 可能等待第一个字节 */ int c = read();//尝试读取一个字节 if (c < 0) { return -1;//没有读取到直接返回-1 } b[off] = (byte) c;//将读取到的字节存入数组 int rlen = 1; while ((in >= 0) && (len > 1)) { int available; if (in > out) { available = Math.min((buffer.length - out), (in - out));//in>out则可读取的数据是in-out,正常情况下in不能超过buffer.length } else { available = buffer.length - out;//in<out则可读取数据是out到buffer右边界,一次循环只能读取到右边界,从头开始的部分要下一次循环读取 } // 在循环外事先读取的字节 if (available > (len - 1)) { available = len - 1;//读取的字节不能超过参数指定的数量-1因为循环外已经读取了一个字节 } System.arraycopy(buffer, out, b, off + rlen, available);//复制可读取字节 out += available;//out位置移动读取的字节数 rlen += available;//目标位置移动 len -= available;//待读取长度减少 if (out >= buffer.length) { out = 0; } if (in == out) { /* in==out缓冲区为空,将in置为-1,所以循环会跳出 */ in = -1; } } return rlen; } available返回从这个输入流可以读取多少字节不用阻塞 public synchronized int available() throws IOException { if(in < 0) return 0; else if(in == out) return buffer.length;//因为在接收和读取时没有可读取的字节会把in置为-1,所以in==out是缓冲区满了的状态 else if (in > out) return in - out;//in>out时可读取内容是in到out之间 else return in + buffer.length - out;//in<out时是out到buffer右边界再加上buffer左边界到in的内容 } close关闭管道输入流,释放任何和这个流关联的资源 public void close() throws IOException { closedByReader = true;//输入流关闭 synchronized (this) { in = -1;//缓冲区所有数据失效 } } PipedOutputStream PipedOutputStream继承了OutputStream。管道输出流可以连接到一个管道输入流来创建一个通信管道。管道输出流是发送端。一般来说,一个线程将数据写入到一个PipedOutputStream对象,其他线程从连接的PipedInputStream对象读取数据。不推荐使用同一个线程来同时使用两个对象,可能会引起这个线程死锁。如果一个从连接的管道输入流读取数据的线程不再活动,这个管道被称为broken状态。 PipedOutputStream的代码很少,基本上全部都是调用PipedInputStream的方法。 内部变量只有一个private PipedInputStream sink用来判定输入端的状态。 构造方法可以指定输入流,也可以直接用无参构造使用前再手动调用连接方法 /** * 创建一个管道输出流连接到指定的管道输入流。数据字节写入到这个流中将会称为snk的有效输入。 */ public PipedOutputStream(PipedInputStream snk) throws IOException { connect(snk); } /** * 创建一个管道输出流还没有连接管道输入流。它在使用前必须通过接收者或者发送者连接到一个管道输入流。 */ public PipedOutputStream() { } connect方法要求两端都不能有已有的连接,否则会抛出异常 /** * 连接这个管道输出流到一个接收者。如果这个对象已经连接到了某个其他的管道输入流,会抛出IOException。 * 如果snk是一个未连接的管道输入流,src是一个未连接的管道输出流,它们可以通过两种方式连接: * src.connect(snk)或者snk.connect(src)。这两种方式是同样的效果。 */ public synchronized void connect(PipedInputStream snk) throws IOException { if (snk == null) { throw new NullPointerException(); } else if (sink != null || snk.connected) { throw new IOException("Already connected");//如果自身或者snk已经连接到某个管道,则抛出异常 } sink = snk;//因为snk内的属性是protected所以可以被同package的PipedOutputStream直接修改 snk.in = -1; snk.out = 0; snk.connected = true;//连接状态修改 } write方法写入数据到缓冲区,需要检查是否有连接的输入端,输入字符数组时还要检查数组和位置参数是否在正确范围内,最后调用输入流的receive方法 /** * 将指定的字节写入到管道输出流,实现了OutputStream.write */ public void write(int b) throws IOException { if (sink == null) { throw new IOException("Pipe not connected"); } sink.receive(b);//调用PipedInputStream.receive } /** * 将指定的数组中从off偏移开始长度len的字节写入到这个管道输出流。这个方法会阻塞,直到所有的字节都写入到输出流中。 */ public void write(byte b[], int off, int len) throws IOException { if (sink == null) { throw new IOException("Pipe not connected"); } else if (b == null) { throw new NullPointerException(); } else if ((off < 0) || (off > b.length) || (len < 0) || ((off + len) > b.length) || ((off + len) < 0)) { throw new IndexOutOfBoundsException(); } else if (len == 0) { return; } sink.receive(b, off, len); } flush()刷新这个输出流,并且促使任何缓冲的输出数据被写出。这个方法会唤醒所有的字节在管道中等待的读取端进入就绪状态。 public synchronized void flush() throws IOException { if (sink != null) { synchronized (sink) { sink.notifyAll(); } } } close关闭这个管道输出流并释放所有关联的系统资源。这个流不能再用于写字节。 public void close() throws IOException { if (sink != null) { sink.receivedLast(); } } /** * 通知所有等待的线程最后一个字节数据已经被接收 */ synchronized void receivedLast() { closedByWriter = true; notifyAll(); } PipedReader PipedReader是管道字符输入流,总体设计逻辑基本上和PipedInputStream是一致的,它继承了Reader。因为总体上都是一样的,就只挑区别来讲了。 第一个区别,因为是字符流,缓冲区变为字符数组 char buffer[]; receive单个字符把PipedInputStream里两个内部方法直接写到代码里了,然后因为类型的改变这里有强制转换类型的区别。 synchronized void receive(int c) throws IOException { if (!connected) { throw new IOException("Pipe not connected"); } else if (closedByWriter || closedByReader) { throw new IOException("Pipe closed"); } else if (readSide != null && !readSide.isAlive()) { throw new IOException("Read end dead"); } writeSide = Thread.currentThread(); while (in == out) { if ((readSide != null) && !readSide.isAlive()) { throw new IOException("Pipe broken"); } /* full: kick any waiting readers */ notifyAll(); try { wait(1000); } catch (InterruptedException ex) { throw new java.io.InterruptedIOException(); } } if (in < 0) { in = 0; out = 0; } buffer[in++] = (char) c;//int转为char if (in >= buffer.length) { in = 0; } } receive多个字符代码很简单,前面分析过PipedInputStream是在缓冲区满时等待读取,然后写入直到再次填满缓冲区或者写完所有数据,而PipedReader则是一个个字符存储到缓冲区,每一次写入都有可能发生阻塞等待。 synchronized void receive(char c[], int off, int len) throws IOException { while (--len >= 0) { receive(c[off++]); } } read设计逻辑上没有区别,也是单个字符读取最多等待2个循环也就是2s。多个字符读取会先尝试读取一个字符,后面无阻塞的尽可能读取多的字符来满足要求的长度,返回实际读取的字符个数。 PipedWriter设计和PipedOutputStream逻辑上无区别,就不说了。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册