首页 文章 精选 留言 我的

精选列表

搜索[实名实人认证解决方案],共10000篇文章
优秀的个人博客,低调大师

Poco框架实操:获取节点属性的高效技巧(一)

👆对私有云感兴趣可以进入公众号回复“私有云”哦。 一、前言 上期推文我们介绍了Poco UI树下的节点关系,以及通过节点关系去寻找我们所需要节点的方法,那么本周我们来分享一下,当我们寻找到所需要节点后,能获取到什么信息呢?又怎么去获取呢? 二、Poco节点的属性操作 2.1 获取控件文本属性:get_text( ) 在UI自动化测试中,获取节点的文本信息是常见的需求。Poco框架提供了 get_text() 方法,它能够轻松提取指定元素的文本内容。无论是按钮上的提示文字,还是列表项的显示内容,get_text()都能一一捕获,从而实现对节点的文字内容进行操作或展示。 poco("游戏增强器").get_text() 2.2 获取控件名字属性:get_name() get_name() 方法可以帮助快速获取元素的名称,这对于识别和操作节点控件非常重要。通过使用该方法,可以方便地获取到节点的名称,从而更好地进行元素的定位和后续操作。 poco("文本输入").get_name() 2.3 获取控件尺寸大小属性:get_size() 了解节点控件的尺寸对于测试控件的布局和设计等至关重要。 get_size() 方法提供了一种简便的方式来获取元素的宽度和高度,可以确保元素在不同设备和分辨率上的正确显示。 poco("文本输入").get_size() 2.4 获取控件的顶部、右侧、底部和左侧的归一化坐标系:get_bounds() get_bounds() 方法返回节点元素的边界框参数,包括元素的顶部(top)、右侧(right)、底部(bottom)和左侧(left)这些与标准坐标系中屏幕边缘的归一化坐标。这些信息可以用于截图控件、点击控件等,可以更好地规划自身的脚本设计。 poco("文本输入").get_bounds() 2.5 获取控件位置大小属性:get_position() get_position() 返回控件元素的中心坐标,通常以相对坐标(x,y)返回坐标,通过获取控件元素的中心坐标,我们可以在需要的时候更快地定位到该位置,从而实现一些交互操作。 poco("播放").get_position() 2.6 获取控件属性:attr("type") attr("type") 方法可以检索节点的特定属性值,需要在括号内输入所需要的属性值(需要以字符串的形式输入),即可查询到所需要的属性值。当上述查询属性的语句都无法查询到自己所需要的属性值的情况下,可以通过 attr("type") 去进行查询。 poco("文字输入").attr("text") 三、实际使用案例 结合上述所讲的获取控件方法,我们用个小小的案例去演示一下日常使用的场景。 参考代码如下: # -*- encoding=utf8 -*-__author__ = "Airtest"from airtest.core.api import *auto_setup(__file__)from poco.drivers.android.uiautomation import AndroidUiautomationPocopoco = AndroidUiautomationPoco(use_airtest_input=True, screenshot_each_action=False)#打开网易云音乐appstart_app("com.netease.cloudmusic")sleep(6.0)#【使用get_text】获取当前输入在搜索框上的文字tem = poco("com.netease.cloudmusic:id/searchHintText").get_text()print("目前搜索框内的文字是:" + tem)#【使用get_name】获取“每日推荐”在UI树上的节点名name = poco(text="每日推荐").get_name()print("该控件的name为:" + name)#点击进入每日推荐界面poco(text="每日推荐").click()#【使用get_size】获取在“每日推荐”界面上的广告大小adsize = poco("com.netease.cloudmusic:id/daily_ad_banner").get_size()print("该广告位的长宽大小为:" + name)#【使用get_bounds】获取在“每日推荐”界面上的广告顶部、右侧、底部和左侧的归一化坐标系adbounds = poco("com.netease.cloudmusic:id/daily_ad_banner").get_bounds()str(adbounds)print(f"该广告位的顶部、右侧、底部和左侧的归一化坐标系分别为:{adbounds}")sleep(1.0)#【使用get_position】获取在“每日推荐”界面上的广告位置坐标adpos = poco("com.netease.cloudmusic:id/daily_ad_banner").get_position()str(adpos)print(f"该广告位的位置坐标为:{adpos}" )sleep(1.0)#【使用attr去查询】获取在“每日推荐”界面上的广告位置坐标adpos2 = poco("com.netease.cloudmusic:id/daily_ad_banner").attr("pos")str(adpos2)print(f"利用attr获取的位置坐标为:{adpos2}" )sleep(1.0) 四、小结 本周我们介绍了5种查询Poco 节点属性值的方式,其中包括: 1、 get_text( ) 获取节点的text属性值 2、 get_name( ) 获取节点的name属性值 3、 get_size( ) 获取节点的size属性值 4、 get_bounds( ) 获取节点的顶部、右侧、底部和左侧的归一化坐标系 5、 get_positions( ) 获取节点的位置坐标 6、 attr("type") 获取所需要的属性值 通过这些方法,我们能够更深入地理解和使用Poco的UI树节点,可以更进一步地完善自己的脚本。如果同学们在使用Poco进行自动化测试的过程中,遇到了问题,或者有任何想要深入了解的知识点,欢迎在官方交流群里告诉我们或者提交issue,也欢迎大家投稿。后续我们会带来更多精彩的有关Poco专题内容,请大家持续关注我们,敬请期待哦! (猜你还想看 ) ▼ Poco节点关系大公开! 如何用覆盖函数的方式,实现你自己的touch? 遇到时间控件怎么办?不要慌,教你轻松拿下 本文分享自微信公众号 - AirtestProject(AirtestProject)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

「实操」适配 NebulaGraph 新版本与压测实践

本文来自邦盛科技-知识图谱团队-繁凡,本文以 NebulaGraph v3.1.0 为例。 前言 NebulaGraph v3.1 版本已经发布有一段时间了,但是我们的项目之前是基于 v2.6.1 版本开发的,由于一直在做功能相关的工作,所以一直没有对图库进行升级。 最近,刚好完成了 NebulaGraph v3.1 版本的升级,并做了一些测试工作,这期间的一些问题总结,在这里分享一下,都是实践中踩过的坑,文中的一些问题可能也是 NebulaGraph 相关的 bug。 升级事项 v2.6.1 版本到 v3.1.0 版本是一个较大版本,从不支持直接升级来看,改动的东西还是蛮多的,那么项目中需要改造的地方应该也是比较多的。下边是我们在升级过程中的一些总结。 语法改动 首先是 MATCH 查询的调整,优化了 MATCH 的查询性能,并且支持多 MATCH 的子句,这个确实极大地提高了 MATCH 查询的表达能力,但是实测当中,复杂的查询性能并不会太高,用于不需要毫秒级响应的查询分析还是很方便的。 MATCH 查询属性需要指定 Tag,这个一定程度上解决了同名属性的问题,顺带提一下在 GO 语句中,同名属性尚未解决,用的时候需要注意。 match (v) return v 这个实在是太有用了,之前必须要指定 vid,但是很多时候导入了数据不知道 vid,只想大致看一下,还要去翻一下数据很麻烦。 GO 等语句必须要带 YIELD 返回了,之前项目中所有用到的地方都要做修改,这个要注意。 GO、FETCH 等可以返回 vertex 和 edge 了,这个也解决了一大痛点,由于 API 查询需要返回 path 或者 vertex 和 edge,用于渲染图,但是 v2.6 中 MATCH 的查询太慢了,只好使用 GO 查询。于是,就要把点边的所有信息都 YIELD 出来,造成特殊化的返回,需要专门写代码解析。现在可以直接一次返回 vertex 和 edge,使用通用的解析方法很 easy 了。 SHOW ALL QUERIES 变化了,项目中有用到超时 kill 的机制,需要 kill 掉慢查询,现在要改成 show local queries,拿到 sessionId(ps:这个 sessionId 私有了,要不就不用查了...),再使用 SHOW QUERIES 查询到对应的 planId 执行 kill 命令。 Console 的查询数据导出已经不可用了,有用到的需要注意。 新增部分 KV 分离是一个很大的改变了,不过目前没有对这个功能进行测试,有实践过的可以谈谈未分离的差异。 增加了限制一个用户和机器的 session 个数,这个不注意的话在并发的情况下很容易超出限制。 支持了 CLEAR SPACE,清除图空间语句,这个非常好用,在测试时经常要清空图库,以前只能删除重建。不过实测中数据量较多会有一定耗时,需要谨慎使用。 BALANCE DATA 这个命令不直接可用了,论坛问了一下需要打开实验性功能。因为打开了实验性功能,所以间接开启了 v2.6.0 开始支持的 TOSS 这个功能,强制保证数据一致性,导致数据写入缓慢,于是就又关掉了。所以目前 BALANCE DATA 不太方便,可能后续会有一些调整吧。 改动部分 删除点只会删掉点了,之前是连带点的边都会删除,这里使用一定要注意悬挂边导致的数据一致性的问题。 支持不带 Tag 的点,就是允许只有一个 vid 存在。这个似乎引起一个 bug,只有一个 tag 的点在 TTL 过期之后,点仍然存在,跟文档不符。另外 TTL 的时间也似乎是一个 bug,总是提前个 30 几秒就过期了,比如设置 60 秒,再 30 秒左右就过期了。 ADD HOSTS 命令,用于添加 storage 服务,这样就可以较好的管理 storage 节点了,但是 BALANCE DATA 命令使用的问题,导致扩缩容没有 2.6 版本方便了。 会话超时时间必须要限制了,实测中 session 那里可能是有一个 bug,session 被程序 release 之后没有清除,导致触发了最大 session 数,所以就将 session 超时时间改小一点,清理掉不用的 session。 修复了大量会引起崩溃的语句,之前的一些聚合语句使用不当就会引起崩溃,着实有点吓人... 适配层面大致总结这么多吧,还有一些改动就不再细说了,这里讲到的都是在实际中使用时的感受。 压测实践 切换到新的版本,当然要进行一下压测,以发现一些没有排查到的问题,下边就直接上干货,讲一下实际遇到的问题。 SST 数据导入问题 由于 v2.6 的时候没有使用过 SST 导入,所以压测时为了快速导入数据,想使用 SST 去导入数据。 图库分片 partition 为 20,导入配置先设置了 repartitionWithNebula: false,结果发现产生了巨多的 SST 文件,ingest 极慢,并且出现数据写入丢失的问题。 然后调整为 ture,并调低了 spark.sql.shuffle.partitions,于是每个文件合并为了一个 SST 文件,很快就导入了。然后又产生新的问题,发现有一些点不存在了,没有导入成功,但是 SHOW STATS 统计信息正常。 经过反复测试与官方人员沟通,发现是 8 位长度的 vid 有问题,hash 的策略不太对,目前已经被修复了但是好像还未合并到主分支吧。具体可以看帖子:https://discuss.nebula-graph.com.cn/t/topic/8984/14 Client 数据导入问题 Client 理论上是不会有问题的,毕竟是语句写入,但是跟使用的方式和图库状态也有很大的关系。我是沿用了当时 v2.6 的配置文件,core:40,batch:2560 的配置。 图库冷启动写入报错:一开始就遇到图库冷启动的问题,冷启动之后立马导数,会写入报错: E20220607 11:02:41.447904 108593 StorageAccessExecutor.h:39] InsertEdgesExecutor failed, error E_LEADER_CHANGED, part 17 E20220607 11:02:41.447954 108591 QueryInstance.cpp:137] Storage Error: Not the leader of 17. Please retry later. 但是这个问题不要紧,图库能自己恢复,过一会就写入正常了,error 语句会在最后被再次写入。(PS:这里注意下,error 语句写入的 write 方法中文会乱码,导致再次写入出错,我顺手改了一下已经提过 PR 了。) raft buffer full 问题:使用上边的配置,导数并发太快,导致图库报错 raft buffer full,这个感觉是内存中的数据没有被快速 fush 到磁盘中,导致写入中止。于是调整配置,减小 core,batch,图库修改 write buff number 为 8,增大 buffer,发现 TOSS 开着,想着是不是为了保证一致性所以 flush 会慢?不太确定于是关掉了。还有一点是当时没发现,后来总结的时候才想到的,因为机器的网络有点问题,其中一台用了百 M 宽带,会不会是网络 IO 阻塞影响的,也不是很确定。(PS:网络真是个大坑,后边还会遇到,一定要检查带宽。)不过在进行了上边的修改之后,没有再报错了。 高并发导数,图库E_LEADER_LEASE_FAILED 这个问题一共遇到两次,一次是在导数结束后立马发起另一个导数任务,查看到语句大量报错,于是手动查询图库,发现任何查询都报错。 (root@nebula) [trans]> match (v) return v limit 10 [ERROR (-1005)]: Storage Error: part: 22, error: E_LEADER_LEASE_FAILED(-3531). Tue, 07 Jun 2022 22:01:46 CST 尝试执行 BALANCE LEADER,执行总是 failed,尝试 Compaction 进行恢复,查询发现一会报错 Not the leader of 17. Please retry later. 一会能展示结果,并没有完全恢复,无奈只能重启解决。 第二次遇到是在进行压测的同时,使用 NebulaGraph Exchange 导数,看会有什么影响,结果再次出现该问题,Exchange 的 task 也大量报错退出了。 出现 E_LEADER_LEASE_FAILED 的问题会导致图库基本不可用,且不会自己恢复,个人猜测并发读写太大导致部分数据混乱,引起查询不可用。该问题目前尚未完全找到原因,所以使用时要稍微注意,导数的 batch 不要太大了,并发也要控制。帖子地址:https://discuss.nebula-graph.com.cn/t/topic/9013/13 其他问题 重启存在 offline:关闭时需要确保完全关闭再启动,慎用 restart。数据较多时关闭并不会马上关闭,需要等待一段时间,这时启动可能会有一台 storage 启动不起来或者报错,显示 offline,应该是 stop start 间隔太短,出现这种情况应该完全关闭后,ps 无进程再删除 storage 的 pid 再启动。 重启无分片:图库重启后总是出现一个 storage 节点某些图库无分片的情况,导致查询这台机器不干活,有点奇怪,只能 BALANCE LEADER 使其平衡。 网络问题:在上边提到过,一定要确保带宽,否则查询的执行计划里边,RPC的时间很大,影响查询速度。并发查询时发现延迟很高,CPU 使用率也不高,但是怎么优化都下不来,后来才发现网络有问题,着实有点坑。 总结 整体来说,v3.1.0 版本做了很大的改进,无论是新功能还是语法上,都做了很好的改变,但是基于上面的问题,感觉在稳定性上要弱于 2.6 版本。可能也是由于 v3.x 版本在底层上的改动比较大,出现这些问题也无可避免的,希望在今后的版本中有能较好的优化,好的产品当然是需要不断打磨的。 另外,如果上边提到的问题你有更好的见解也欢迎来讨论,也希望这些问题能够帮助官方人员进行更好的优化。 谢谢你读完本文 (///▽///) 无需烦恼升级问题,现在可以用用 NebulaGraph Cloud 来搭建自己的图数据系统哟,快来节省大量的部署安装时间来搞定业务吧~ Nebula Graph 阿里云计算巢现 30 天免费使用中,点击链接来用用图数据库吧~ 想看源码的小伙伴可以前往 GitHub 阅读、使用、(^з^)-☆ star 它 -> GitHub;和其他的 NebulaGraph 用户一起交流图数据库技术和应用技能,留下「你的名片」一起玩耍呢~

优秀的个人博客,低调大师

ECS新旧实例数据及网络无缝迁移实操

一、背景 之前由于因为有业务变迁不得不更换实例,但是数据和网络需要做到同步,面对这样的需求,我们也是绞尽脑汁,仔细专研了阿里云的产品文档,最后解决了这个问题,这边整理一下实际操作过程,把踩过的坑记录一下。 二、业务价值 通过快照及镜像的方式迁移数据,可以规避掉传统的停机操作,仅仅在解绑和重绑定EIP的时候会有短短的十来秒业务中断,对于线上业务来讲几乎是无感的。 三、具体操作流程 1. 数据部分迁移 首先我们需要将之前ECS实例的云盘做快照(如果需要所有数据转移,即有系统盘就做系统盘快照,有数据盘那数据盘也需要做快照),进入阿里云管理控制台,找到旧的ECS实例 这里需要注意的是为了保证快照创建成功,正在创建快照时,千万不要修改ECS实例状态,比如停止或重启ECS实例。请耐心等待。 另外要注意,对处于“已过期”状态的磁盘创建快照时,若磁盘已达到过期释

优秀的个人博客,低调大师

HBase实操 | 如何使用HBase存储文本文件

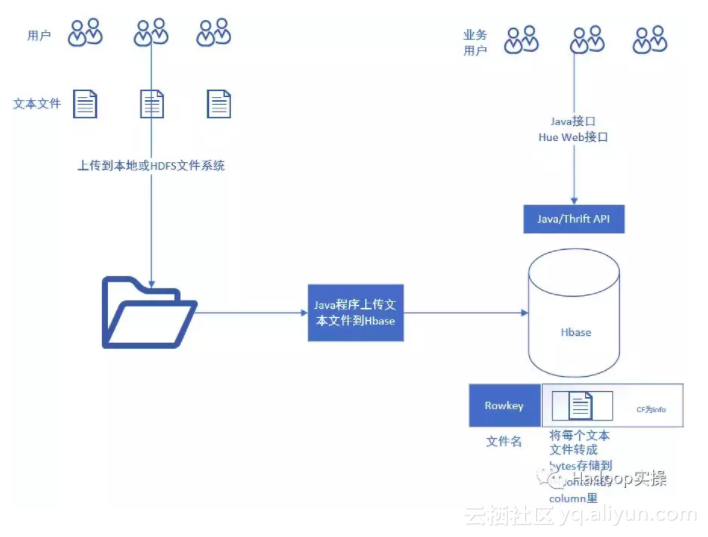
1.文档编写目的 Fayson在前面的文章中介绍了《如何在CDH中使用Solr对HDFS中的JSON数据建立全文索引》和《如何使用Flume准实时建立Solr的全文索引》,假如我们有大量的文本文件,我们应该如何保存到Hadoop中,并实现文本文件的全文检索呢。为了介绍如何对文本文件进行全文检索,本文会先介绍如何使用HBase保存文本文件。虽然HDFS中也可以直接保存这种非结构化数据,但是我们知道像这种文本文件,一般都是10KB~1MB的小文件,因为HDFS并不擅长存储大量小文件,所以这里选择HBase来保存。 内容概述 1.文件处理流程 2.准备上传文件的Java代码 3.运行代码 4.Hue中查询验证 测试环境 1.RedHat7.4 2.CM5.14.3 3.CDH5.14.2 4.集群未启用Kerberos 2.文件处理流程 1.如上图所示,Fays

优秀的个人博客,低调大师

HBase实操 | 开发部署HBase Endpoint类型的Coprocessor

1.文档编写目的 在前面的文章介绍了HBase自带的Coprocessor调用示例《如何使用Java调用HBase的 Endpoint Coprocessor》,本篇文章主要介绍如何开发一个HBase Endpoint类型的协处理器。 本篇文章示例协处理器主要实现了对列的Count、Max、Min、Sum以及Average。前面的文章调用Coprocessor定义的全局的,在本篇文章介绍另一种实现方式通过代码的方式对指定的表添加Coprocessor。 内容概述 1.环境准备 2.使用Protobuf生成序列化类 3.Endpoint Coprocessor服务端实现 4.Endpoint Coprocessor客户端实现 5.部署及调用 测试环境 1.CM和CDH版本为5.14.3 2.集群未启用Kerberos 2.环境准备 在HMaster、Regi

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册