首页 文章 精选 留言 我的

精选列表

搜索[Python],共10000篇文章
优秀的个人博客,低调大师

python之高清图片爬取了解一下

高清图片爬取了解一下 前段时间在知乎看到一篇文章,关于视觉中国如何从腾讯身上扒一层皮的事情。大意就是互联网巨头在没有经过授权的情况下使用了9张来自视觉中国的照片,最后的结果是以赔偿视觉中国4w结束。原文链接: https://zhuanlan.zhihu.com/p/35045810 感兴趣的可以看看。 当然这对于我们普通人而言几乎没有什么影响。但我们要知道图片版权这回事。 今天带大家爬取的图片网站是:https://unsplash.com/ 这里的图片没有版权,你可以随便使用。而且这里面的图片质量都特别高。我的一些图片都是从这上面找的 Ajax加载图片 第一步,请求网页 我们打开网站,下拉页面发现不断加载图片,但是整个页面没有刷新,也就是页面的链接没有变化。其实这个过程就是Aiax加载的过程。 Ajax请求有特殊的类型,它叫做 xhr ,我们打开开发者工具或者按 F12键,切换到Network。 下方切换到 XHR 这里面都是经过Ajax加载的。我们往下多点几个链接发现,下方的三个参数只有 page 在变化,于是我们可以构造这个参数。来提交请求。 ``` defget_page(page,headers): url ='https://unsplash.com/napi/photos' data = { 'page': page, 'per_page':12, 'order_by':'latest' } response = requests.get(url, headers=headers, params=data) ifresponse.status_code ==200: returnresponse.json() ``` 第二步:解析网页并得到图片链接 接着切换到Prereview选项卡,看到返回的是json数据。继续找发现图片链接在 download 里面,我们复制一个链接在浏览器里打开发现分析的没错。 接下来,再实现一个解析方法:提取每条数据的links字段里的download,将图片的链接返回。 ``` defget_image(json,headers): foriteminjson: images = item['links']['download']#这句借鉴大佬代码,真的是厉害了 print('正在下载:',images) urllib3.disable_warnings() response = requests.get(images,headers=headers,verify=False) returnresponse,images ``` 最后保存到本地 defsave_images(response,images): if'图片'notinos.listdir('.'): os.mkdir('图片')# 创建文件夹 os.chdir('图片')# 进入文件夹下 filename = images.split('/')[-2] +'.jpg' withopen(filename,'wb')asf: f.write(response.content) os.chdir('..')# 返回上级目录 if__name__ =='__main__': headers = {'user-agent':'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36' '(KHTML, like Gecko) Chrome/67.0.3396.99 Safari/537.36', 'referer':'https://unsplash.com/' } foriinrange(1,10): json = get_page(i,headers) response,images = get_image(json,headers) save_images(response,images) 总结 承认自己还有许多不足,代码还有许多可以改进的地方 本文还可以扩展,比如说实现指定关键字work,beauty,nature 等下载图片 代码不是一下子就写出来的,要经过不断调试,出错是很正常的,不断地发现错误并解决才能有所进步。学习的过程中善用搜索引擎,多思考。希望与你一同学习。 原创不易,觉得不错点个赞再走呗。 公众号:sixkery

优秀的个人博客,低调大师

Python正则表达式re库的使用

指导思想:正则表达式只是一个工具,学会其中一种使用方法即可 1. ()和re.findall结合使用 ({}{})中第一个大括号替换为.则表示匹配所有字符,替换为[]则表示匹配中括号内限定的字符; 第二个大括号替换为*则表示匹配长度为>=0,替换为+则表示匹配长度为>=1,替换为空则表示匹配长度为1 (.*)表示匹配任意长度的所有字符 ([0-9]*)表示匹配任意长度的数字 ([0-9,a-z])表示匹配长度为1的数字和小写字母 re.findall函数需要传入2个参数,第1个参数是正则表达式,第2个参数是要进行搜索的源字符串。 re.findall函数返回结果的数据类型为列表,列表中的第1个元素的数据类型为元祖。 示例代码如下: import re if __name__ == "__main__": sourceStr = "11房5厅8卫" sourceStr2 = "a房b厅3卫" pattern_all = "(.*)房(.*)厅(.*)卫" pattern_number = "([0-9]*)房([0-9]*)厅([0-9]*)卫" pattern_numberAndLetter = "([0-9,a-z])房([0-9,a-z])厅([0-9,a-z])卫" print("正则表达式找出中间的字符:") result = re.findall(pattern_all, sourceStr) print(result,type(result),type(result[0])) print(re.findall(pattern_all,sourceStr2)) print("正则表达式找出中间的数字") print(re.findall(pattern_number,sourceStr)) print(re.findall(pattern_number,sourceStr2)) print("正则表达式找出中间的数字和字母") print(re.findall(pattern_numberAndLetter, sourceStr)) print(re.findall(pattern_numberAndLetter, sourceStr2)) 上面一段代码的运行结果如下: 正则表达式找出中间的字符: [('11', '5', '8')] <class 'list'> <class 'tuple'> [('a', 'b', '3')] 正则表达式找出中间的数字 [('11', '5', '8')] [] 正则表达式找出中间的数字和字母 [('1', '5', '8')] [('a', 'b', '3')] 2. 正则表达式中的元字符 \s 用于匹配单个空格符,包括tab键和换行符; \S 用于匹配除单个空格符之外的所有字符; \d 用于匹配从0到9的数字; \w 用于匹配字母,数字或下划线字符; \W 用于匹配所有与\w不匹配的字符; . 用于匹配除换行符之外的所有字符。 例如上一节中的([0-9]*)与([\d]*)作用相同 3. ()和re.search结合使用 re.search函数需要传入2个参数,第1个参数是正则表达式,第2个参数是要进行搜索的源字符串。 re.search函数返回结果的数据类型是sre.SRE_Match对象,span=(3,9)是匹配结果的索引,从索引3开始,不包括索引9。 把re.search函数返回结果赋值给result,通过result.group函数获取匹配结果,result.group函数需要传入1个参数,参数的数据类型为无符号整型,参数为0时,为正则表达式匹配到的长句内容;参数为1时,为正则表达式匹配到的第1个小括号中的内容;参数为2时,为正则表达式匹配到的第2个小括号中的内容,依此类推。 示例代码如下: import re if __name__ == "__main__": sourceStr = "户型:3室2厅2卫" pattern_all = "([\d]*)室(.)厅(.)卫" result = re.search(pattern_all,sourceStr) print(result) print(result.group(0)) print(result.group(1)) print(result.group(2)) print(result.group(3)) 上面一段代码的运行结果如下: <_sre.SRE_Match object; span=(3, 9), match='3室2厅2卫'> 3室2厅2卫 3 2 2 4 re.match的使用 re,match在实际应用中很少,不建议使用。 re.match能够匹配的前提是必须字符串索引0的位置能够匹配到。 import re if __name__ == "__main__": re1 = "hel." re2 = ".el" re3 = ".hel" re4 = "el" sourceStr = "hello" print(re.match(re1,sourceStr)) print(re.match(re2,sourceStr)) print(re.match(re3,sourceStr)) print(re.match(re3,sourceStr)) 上面一段代码的运行结果如下: <_sre.SRE_Match object; span=(0, 4), match='hell'> <_sre.SRE_Match object; span=(0, 3), match='hel'> None None

优秀的个人博客,低调大师

通过k-means进行图像量化压缩--python实现

image.png 逻辑梳理 对于电脑来说,每种颜色都会有一个对应RGB值,比如黑色是[0,0,0],白色是[255,255,255],所以RGB模式下,最多可以区分16581375(255的三次方)种颜色。 另外我们知道,一张图片的大小与分辨率正相关,但其实也与图片颜色的复杂度是正相关的,相同分辨率的情况下,一张纯色图片是比一张五彩斑斓的图片要小的。 一张分辨率为100*100的图片,其实就是由10000个RGB值组成。所以我们要做的就是对于这10000个RGB值聚类成K个簇,然后使用每个簇内的质心点来替换簇内所有的RGB值,这样在不改变分辨率的情况下使用的颜色减少了,图片大小也就会减小了。 内容 导入包 import matplotlib.pyplot as plt import seaborn as sns from sklearn.cluster import KMeans #导入kmeans from sklearn.utils import shuffle import numpy as np from skimage import io import warnings warnings.filterwarnings('ignore') 图片读取 original = mpl.image.imread('Yosemite 5.jpg') width,height,depth = original.shape temp = original.reshape(width*height,depth) temp = np.array(temp, dtype=np.float64) / 255 图像读取完我们获取到的其实是一个width*height的三维矩阵(width,height是图片的分辨率) 训练模型 original_sample = shuffle(temp, random_state=0)[:1000] #随机取1000个RGB值作为训练集 def cluster(k): estimator = KMeans(n_clusters=k,n_jobs=8,random_state=0)#构造聚类器 kmeans = estimator.fit(original_sample)#聚类 return kmeans 我们只随机取了1000组RGB值作为训练,k表示聚类成 k个簇,对于本文就是K种颜色。 RGB值转化为图像 def recreate_image(codebook, labels, w, h): d = codebook.shape[1] image = np.zeros((w, h, d)) label_idx = 0 for i in range(w): for j in range(h): image[i][j] = codebook[labels[label_idx]] label_idx += 1 return image 聚类 我们选取了32,64,128三个K值来做比较: kmeans = cluster(32) labels = kmeans.predict(temp) kmeans_32 = recreate_image(kmeans.cluster_centers_, labels,width,height) kmeans = cluster(64) labels = kmeans.predict(temp) kmeans_64 = recreate_image(kmeans.cluster_centers_, labels,width,height) kmeans = cluster(128) labels = kmeans.predict(temp) kmeans_128 = recreate_image(kmeans.cluster_centers_, labels,width,height) 画图并保存 plt.figure(figsize = (15,10)) plt.subplot(2,2,1) plt.axis('off') plt.title('Original image') plt.imshow(original.reshape(width,height,depth)) plt.subplot(2,2,2) plt.axis('off') plt.title('Quantized image (128 colors, K-Means)') plt.imshow(kmeans_128) io.imsave('kmeans_128.png',kmeans_128) plt.subplot(2,2,3) plt.axis('off') plt.title('Quantized image (64 colors, K-Means)') plt.imshow(kmeans_64) io.imsave('kmeans_64.png',kmeans_64) plt.subplot(2,2,4) plt.axis('off') plt.title('Quantized image (32 colors, K-Means)') plt.imshow(kmeans_32) io.imsave('kmeans_32.png',kmeans_32) plt.show() 结果如下: 差别还是比较明显的,随着颜色变少,图片也越来越马赛克了。 其实对于图片压缩这块,各大互联网公司投入人力优化,在保证图片清晰的情况下,减小文件大小,这样一能为公司节省一大笔带宽费用,二也能让用户更快的加载出图片,提升用户体验。 这篇文章也只是我在学k-means时候看到的一个案例,对于图片压缩只是很小的一部分,写这片文章的时候我也查了下相关的知识,真要下功夫研究,可是一门大学问。 最后:peace~


优秀的个人博客,低调大师

【Python初级】StringIO和BytesIO读写操作的小思考

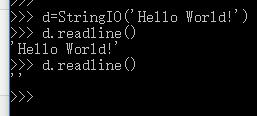
from io import StringIO; f = StringIO(); f.write('Hello World'); s = f.readline(); print s; 上面这种方法“无论如何”都读不出f的内容,使用readlines和循环也不行。 但是,用以下的方法,却可以“正常读取”: from io import StringIO; f = StringIO('Hello World'); s = f.readline(); print s; 这是为什么呢? 这是因为the stream position的原因,当你用: d = StringIO('Hello World') 其stream position为0(可以通过d.tell()获得),而后执行: d.readline() stream position移动到11.因此当我们再次执行d.readline()时,返回的是空字符串。演示见图: 类似的,使用: f = StringIO() stream position也为0,但执行了: f.write('Hello World') 之后,stream position就移动到11了,因此此时你再执行readline时返回的依旧是空字符串。 当然咯,既然这个读取是和stream position的位置有关系,那么要能够在当前情况下还能读取'Hello World!',我们可以调整这个指针的位置,执行: f.seek(0) 再进行读取操作,即可。 下面利用BytesIO进行演示,是一样的道理:

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册