Python数据分析及可视化-小测验
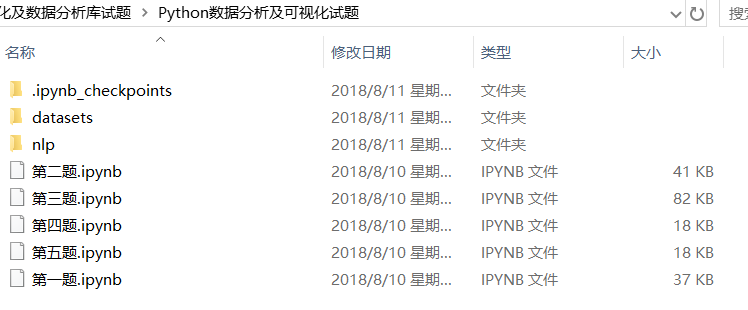
本文中测验需要的文件夹下载链接: https://pan.baidu.com/s/1OqFM2TNY75iOST6fBlm6jw 密码: rmbt 下载压缩包后解压如下图所示: image.png 首先将5题的文件复制形成副本,如下图所示: image.png 在资源管理器的路径中输入cmd,如下图所示: image.png 在上图中输入后,按Enter键运行进入cmd窗口。 在cmd窗口中输入并运行命令: jupyter notebook,如下图所示: image.png 在上图中输入后,按Enter键运行自动打开浏览器并且进入jupyter notebook编程界面。 在jupyter notebook中,点击 第一题,ipynb和 第一题-副本.ipynb。 浏览器会新建两个标签页,如下图所示: image.png 在两个标签页中,读者可以对照题目要求完成做题。 下面是5道题目作者的答案和解析。 1.第一大题 1.1 第一步:导入相应的模块 最后2行代码可以使作图时不出现编码错误,分别用来正常显示中文标签和正常显示负号。 import pandas as pd from pandas import Series,DataFrame import matplotlib.pyplot as plt plt.rcParams['font.sans-serif'] = ['SimHei'] #用来正常显示中文标签 plt.rcParams['axes.unicode_minus']=False #用来正常显示负号 1.2 第二步:利用pandas读取datasets目录下chipo.csv并显示前十行数据(赋值给变量chipo) csv文件默认的分隔符是逗号,pd.read_csv方法中sep关键字参数的默认值也为逗号,所以可以不写sep关键字。 显示前十行数据用chipo.head(10)即可。 chipo = pd.read_csv('datasets/chipo.csv') chipo.head(10) 1.3 第三步:根据列名为item_name中每种商品出现的频率,绘制出柱状图 给出的答案示例是购买次数排名第2-6名的商品的作图结果。chipo.item_name.value_counts()是对商品购买次数进行统计,返回的结果降序排列,数据类型为Series。plt.xticks()方法中可以填入1个参数或者多个参数,下面代码中采用的是填入3个参数。 x_list是x轴标记点,数据类型为列表;xticks_list是x轴标记点显示值,数据类型为列表; rotation设置为90,是x轴标记点显示值以右边为轴逆时针旋转90度。 plt.bar方法中指定每根柱子的颜色,这样才可以画出示例答案的效果。 mostOrder_list = chipo.item_name.value_counts().iloc[5:0:-1] xticks_list = mostOrder_list.index x_list = range(len(xticks_list)) y_list = mostOrder_list.values plt.bar(x_list, y_list, width=0.5, color=['b', 'orange', 'g', 'r', 'purple']) plt.xticks(x_list, xticks_list, rotation=90) plt.title('购买次数最多的商品排名') plt.xlabel('商品名称') plt.ylabel('出现的订单次数') plt.show() 上面这段代码的运行结果如: 柱形图.png 1.4 第四步:根据订单编号(order_id)进行分组,求出每个订单花费的总金额,例如订单编号为1的总金额为11.56美元。然后根据每笔订单的总金额和每笔订单购买商品的总数量画出散点图(总金额为x轴,商品总数为y轴)。 先将chipo这个变量深度拷贝给c变量,这样可以避免影响原数据,使代码每次都能成功运行。 item_price这个单词是一个条目的价格,不是单个商品的单价。 我们平时超市购物的单子的最后price那一列也是算的这一个条目的价格,比如2个相同的商品算1个条目。 c = chipo.copy() c.quantity = c.quantity.astype('int') c.item_price = c.item_price.str.strip('$').astype('float') order_group = c.groupby('order_id') x_list = order_group.item_price.sum() y_list = order_group.quantity.sum() plt.scatter(x_list, y_list, color='g') plt.xlabel('订单总价') plt.ylabel('商品总数') plt.title('每笔订单总金融和购买商品数量关系') plt.show() 上面这段代码的运行结果如下: 散点图.png 2.第二大题 2.1 第一步:导入相应的模块 最后2行代码可以使作图时不出现编码错误,分别用来正常显示中文标签和正常显示负号。 import pandas as pd from pandas import Series,DataFrame import matplotlib.pyplot as plt plt.rcParams['font.sans-serif'] = ['SimHei'] #用来正常显示中文标签 plt.rcParams['axes.unicode_minus']=False #用来正常显示负号 2.2 第二步:利用pandas读取datasets目录下special_top250.csv并显示前五行数据(赋值给变量top250) csv文件默认的分隔符是逗号,pd.read_csv方法中sep关键字参数的默认值也为逗号,所以可以不写sep关键字。 显示前五行数据用chipo.head()即可。 top250 = pd.read_csv('datasets/special_top250.csv') top250.head() 2.3 第三步:在同一个图中绘制出电影时长和电影排名的散点图关系及电影时长的频率分布直方图,分50组,如下图所示: x_series = top250.movie_duration y_series = top250.num plt.figure(figsize=(14,6)) plt.subplot(121) plt.scatter(x_series, y_series) plt.xlabel('电影时长') plt.ylabel('电影排名') plt.gca().invert_yaxis() plt.subplot(122) plt.hist(x_series,bins=50) plt.show() 上面一段代码的运行结果如下: image.png 2.4 第四步:由上图中电影时长的频率分布直方图,并不能比较准确的反映出每个分组下电影的数量,请根据以下提示,绘制如下图所示根据电影时长分组的柱状图 bins = [0,80,120,140,180,1000] tags = ['偏短','标准','正常','偏长','超长'] 2.5 第五步:具体显示每个分组下的电影数量 在pandas官网中查询pandas.cut函数中的参数,其中参数bins是数据区间分割值,参数labels是数据按照区间分类后的标签,如下图所示。如果参数bins和labels都是可迭代对象,则bins比labels长度大1。 pandas.cut用法官方文档.png 将电影时长分类后赋值给duration_labeled_series变量,数据类型为Series。查看其中的值,如下图所示: image.png 对duration_labeled_series变量统计每个分类出现的次数,使用value_counts方法。 duration_series = top250.movie_duration duration_labeled_series = pd.cut(duration_series, bins=bins, labels=tags) duration_labeled_series.value_counts() 2.6 第六步:绘制出结果图 duration_stat_series = duration_labeled_series.value_counts(sort=False) duration_stat_series.plot(kind='bar') plt.show() 上面一段代码的运行结果如下: image.png 3.第三大题 3.1 第一步:导入相关模块 最后2行代码可以使作图时不出现编码错误,分别用来正常显示中文标签和正常显示负号。 import pandas as pd from pandas import Series,DataFrame import matplotlib.pyplot as plt plt.rcParams['font.sans-serif'] = ['SimHei'] #用来正常显示中文标签 plt.rcParams['axes.unicode_minus']=False #用来正常显示负号 3.2 第二步:加载datasets下的tips.csv文件数据,并显示前五行记录 csv文件默认的分隔符是逗号,pd.read_csv方法中sep关键字参数的默认值也为逗号,所以可以不写sep关键字。 显示前五行数据用chipo.head()即可。 tip_df = pd.read_csv('datasets/tips.csv') tip_df.head() 3.3 第三步:绘制消费金额频率分布直方图 plt.hist方法中参数bins用来指定出现多少根柱子,参数width用来指定每根柱子的宽度。 plt.hist(tip_df.total_bill, bins=10, width=4) plt.xlabel('消费总金额') plt.ylabel('频率') plt.show() 上面一段代码的运行结果如下图所示: 直方图.png 3.4 第四步:绘制总消费金额与小费金额的散点图关系 利用plt.scatter方法画出散点图 plt.scatter(tip_df.total_bill, tip_df.tip) plt.xlabel('总消费金额') plt.ylabel('小费金额') plt.show() 上面一段代码的运行结果如下: 散点图.png 3.5 第五步:在同一图中绘制出吸烟顾客与不吸烟顾客的消费金额与小费之间的散点图关系 观察示例答案中左右两幅图,不同的地方有:处于画板的位置、标题、散点颜色。 定义函数drawScatter用于绘制散点图,传入4个参数:数据group、处于画板的位置subplot、标题title、散点颜色。 def drawScatter(group, subplot, title, color): plt.subplot(subplot) plt.xlabel('消费总金额') plt.ylabel('小费金额') plt.title(title) plt.scatter(group.total_bill, group.tip, color=color) plt.figure(figsize=(12,6)) for name,group in tip_df.groupby('smoker'): if name == 'Yes': drawScatter(group, 121, '吸烟顾客', 'green') else: drawScatter(group, 122, '不吸烟顾客', 'blue') plt.show() 上面一段代码的运行结果如下: 组合散点图.png 3.6 第六步:在同一图中绘制出女性与男性中吸烟与不吸烟顾客的消费金额与小费之间的散点图关系 在有2组散点的散点图当中,第1组散点默认为橘黄色,第2组散点默认为天蓝色。 def drawScatter2(df, subplot, title, sex): plt.subplot(subplot) plt.title(title) for name, group in df.groupby('smoker'): if name == 'Yes': plt.scatter(group.total_bill, group.tip, label=sex+'吸烟顾客') else: plt.scatter(group.total_bill, group.tip, label=sex+'不吸烟顾客') plt.legend() plt.figure(figsize=(12,6)) for name,group in tip_df.groupby('sex'): if name == 'Male': drawScatter2(group, 121, 'sex=Male', '男性') else: drawScatter2(group, 122, 'sex=Female', '女性') plt.show() 上面一段代码的运行结果如下图所示: 组合散点图.png 4.第四大题 4.1 第一步:导入相应的模块 import os import re import numpy as np import pandas as pd from bs4 import BeautifulSoup 4.2 第二步:读取nlp文件夹下的labeledTraniData.tsv文件 df = pd.read_csv("nlp/labeledTrainData.tsv", sep='\t', escapechar='\\') print('记录数: {}'.format(len(df))) df.head() 4.3 第三步:请按如下步骤,对影评数据做预处理,大概有以下环节: 去掉html标签 移除标点 切分成单词列表 去掉停用词 重组为新的句子 def display(text, title): print(title) print("\n----------我是分割线-------------\n") print(text) 4.4 第四步:提取出原始数据中的第一行review列中的文本数据,并用display函数进行输出显示 text1 = df.iloc[1]['review'] display(text1, '原始数据') 4.5 第五步:用BeautifulSoup将第四步中获取到的数据中的html标签去除 text2 = BeautifulSoup(text1, 'lxml').text display(text2, '去掉HTML标签的数据') 4.6 第六步:将第五步数据中的标点符号去掉(用正则) text3 = re.sub('[^\w\s]', '',text2) display(text3, '去掉标点的数据') 4.7 第七步:将第六步的数据全部转换成小写并转换成列表 text4 = text3.lower() word_list = text4.split(' ') display(word_list, '纯词列表数据') 4.8 第八步:去掉第七步数据中的英文停用词 4.8.1 加载英文停用词 with open('nlp/stopwords.txt') as file: stopword_list = [k.strip() for k in file.readlines()] 4.8.2 利用加载的英文停用词,去除第七部数据中的英文停用词 new_word_list = [k for k in word_list if k not in stopword_list] display(new_word_list, '去掉停用词数据') 4.8.3 为确保所加载的英文停用词没有重复数据,请对8-1中加载的英文停用词去重 stopword_list = list(set(stopword_list)) 4.9 第九步:将第五步到第八步的过程总结归纳为一个函数,名为clean_text,参数为text即输入到函数中的文本 这个函数就是对前面零散步骤的总结,所以前面的大部分代码可以直接复制过来。 with open('nlp/stopwords.txt') as file: stopword_list = [k.strip() for k in file.readlines()] stopword_list = list(set(stopword_list)) def clean_text(text1): text2 = BeautifulSoup(text1, 'lxml').text text3 = re.sub('[^\w\s]', '',text2) text4 = text3.lower() word_list = text4.split(' ') new_word_list = [k for k in word_list if k not in stopword_list] return ' '.join(new_word_list) 4.10 第十步:用apply方法,将第九步中定义的函数应用到第二步加载的df中,并生成一列清洗之后的数据列,名为clean_review df['clean_review'] = df.review.apply(clean_text) df.head() 上面一段代码的运行结果如下图所示: 第4题最终结果.png 5.第五大题 5.1 第一步:导入相关模块 最后2行代码可以使作图时不出现编码错误,分别用来正常显示中文标签和正常显示负号。 import pandas as pd from pandas import Series,DataFrame import matplotlib.pyplot as plt plt.rcParams['font.sans-serif'] = ['SimHei'] #用来正常显示中文标签 plt.rcParams['axes.unicode_minus']=False #用来正常显示负号 5.2 第二步:加载datasets目录下US_Baby_names_right.csv文件数据并查看数据的基本信息 baby_df = pd.read_csv('datasets/US_Baby_names_right.csv') baby_df.info() 5.3 第三步:写出删除 Unname:0和Id列数据的两种方法,第二种注释即可 new_df = baby_df.drop(['Unnamed: 0', 'Id'], axis=1) # del baby_df['Unnamed: 0'] # del baby_df['Id'] new_df.head() 5.4 第四步:写出能够判断出数据集中男孩多还是女孩多的代码并给出结论 baby_df.Gender.value_counts() 5.5 第五步:按照Name字段将数据集进行分组并求和赋值给变量names,最后输出前五行 names = new_df.groupby('Name').sum() names.head() 5.6 第六步:按照每个名字被使用的次数(Count)对第五步中结果进行降序排序,得出最受欢迎的的五个名字 sorted_names = names.sort_values(by='Count', ascending=False) sorted_names.head() 5.7 第七步:在数据集中,共出现了多少个名字?(不包含重复项,至少使用两种方法) 第1种方法: len(baby_df.Name.unique()) 第2种方法: len(names) 第3种方法: baby_df.Name.value_counts().count() 5.8 第八步:出现次数最少的名字共有几个? min_count = sorted_names.iloc[-1]['Count'] len(names[names.Count == min_count]) 5.9 第九步:根据names变量中的数据,删除掉Year列数据后,得出如下所示的基本统计参数 names.drop('Year', axis=1).describe()