首页 文章 精选 留言 我的

精选列表

搜索[计算机基础],共10000篇文章
优秀的个人博客,低调大师

8.JSP基础

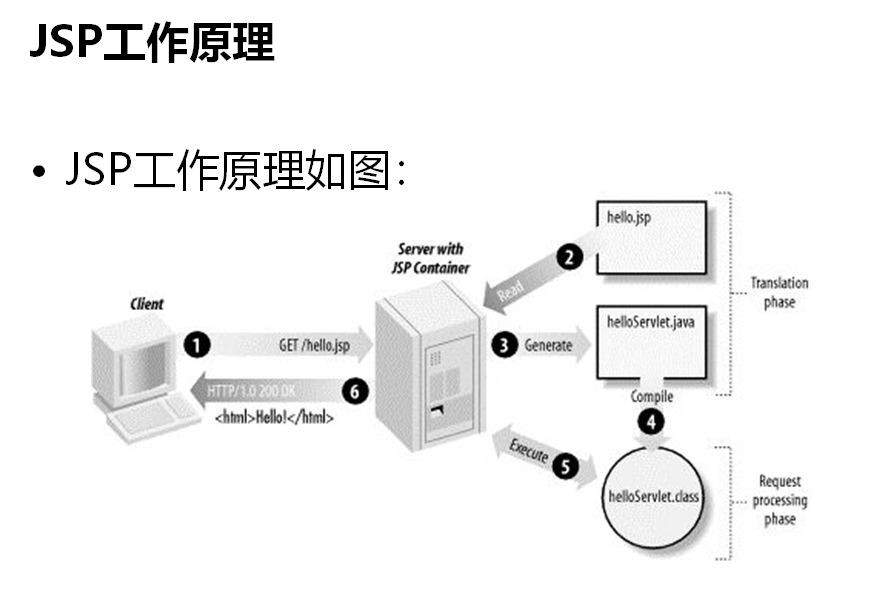
1.Servlet与JSP关系 JSP工作原理: 一个JSP文件第一次被请求时,JSP引擎把该JSP文件转换成为一个servlet JSP引擎使用javac把转换成的servlet的源文件编译成相应的class文件对每一个请求,JSP引擎创建一个新的线程来处理请求。 JSP的Servlet本质: 2.JSP页面生命周期 阶段 描述 转译 将JSP源文件转译成对应的Servlet源文件 编译 编译Java源文件为类文件 加载 将类加载至内存 实例化 创建一个Servlet类实例对象 初始化 调用_jspInit()方法,最终调用Servlet类的init()方法初始化 服务 调用_jspService()方法,最终调用Servlet类的service()方法,将请求和响应传递进对应的doXXX()方法 销毁 调用_jspDestroy()方法,最终调用destroy()方法,销毁Servlet 3.JSP与Servlet的内部转换: JSP转译Servlet(Java生命周期第一阶段) : 解析 校检 转译 4.page伪指令属性 import属性(相当于java中的import) 用于描述JSP页面中使用类的全包名,可选属性<%@page import=“java.io.*,java.sql.*”%>默认导入包:java.lang、javax.servlet、javax.servlet.jsp、javax.servlet.httpsession属性session属性指定页面是否需要一个http会话<%@page session=“true/false”%> errorPage和isErrorPage属性(JSP异常处理)JSP产生一个不能捕获的溢出时跳转到一个错误页面<%@page errorPage=“error.jsp”%>在error.jsp页面中必须加入<%@page isErrorPage=“true”%>才能进行错误处理 language和extends属性language属性指定JSP页面中声明、脚本、和表达式中使用语言,默认是Java<%@page language=“java” %>extends属性用于指定JSP页面对应Servlet类的基类,极少使用<%@page extends=“mypackage.BaseServlet”%> language和extends属性language属性指定JSP页面中声明、脚本、和表达式中使用语言,默认是Java<%@page language=“java” %>extends属性用于指定JSP页面对应Servlet类的基类,极少使用<%@page extends=“mypackage.BaseServlet”%> contentType和pageEncoding属性contentType属性指定页面响应的MIME类型和字符编码<%@page contentType =“text/html;charset=UTF-8” %>pageEncoding属性用于指定JSP页面字符编码格式,默认值为ISO-8859-1<%@page pageEncoding =“UTF-8”%>

优秀的个人博客,低调大师

docker基础教程

核心概念 镜像 一个镜像可以有很多层,每一层都可以用来存储数据 容器 容器就是一个镜像加上一个读写层 仓库 用来存放镜像 安装docker 菜鸟教程的安装链接 [centos](安装docker: https://www.cnblogs.com/yufeng218/p/8370670.html) docker -v 查看版本号 注册docker账户,用来装你自己创建的镜像https://hub.docker.com/ 镜像加速 阿里云镜像:https://df4d3xrt.mirror.aliyuncs.com 在任务栏点击 Docker for mac 应用图标 -> Perferences... -> Daemon -> Registry mirrors。在列表中填写加速器地址即可。修改完成之后,点击 Apply & Restart 按钮,Docker 就会重启并应用配置的镜像地址了。请看图示 相关docker教程 第一次构建、运行、发布、获取docker镜像 Centos7上安装docker dcoker入门,使用docker部署NodeJs应用 10张图带你深入理解Docker容器和镜像 30分钟入门Docker使用默认镜像 docker run -d nginx (-d后台-it前台) docker ps -a -l 查看已启动的容器 docker ps -l 列出最新创建的容器 docker inspect acd349ac64c5(容器id)查看容器的详细情况 curl 172.17.0.2(你自己的容器ip地址) 访问服务 docker logs acd349ac64c5(容器id) 查看日志 docker exec -it acd349ac64c5 bash 今日容器 exit 退出容器 docker run -d -p 8888:80 nginx 对外暴露服务端口8888 检查容器是不是当前的容器 docker exec -it 7d1f74d7f24d bash echo "hello world" >usr/share/nginx/html/index.html 在浏览localhost:888查看页面内容是否已经变成了hello world 自己创建镜像(手工) docker pull centos:7 安装centos7 yum install epel-release 在centos安装一个软件包 yum install nginx 安装nginx 安装ifconfig yum search ifconfig 查找软件在什么地方 yum install net-tools.x86_64 -y 安装有ifconfig的包 ifconfig 拿到系统的ip(本机是172.17.0.4) curl 172.17.0.4 查看服务情况 Dockerfile vi Dockerfile 创建文件,内容如下 FROM centos:7 MAINTAINER huruqing RUN yum install epel-release -y &&\ yum install nginx -y net-tools -y EXPOSE 80 CMD ["nginx","-g","deamon off;"] docker build -t nginx:v1 构建镜像 docker images |grep nginx 查找nginx的镜像 docker run -d -p 8888:80 100bf0d80bfb 对外暴露服务端口 打tag docker tag nginx huruqing/nginx:v1 添加标志 push docker push nginx huruqing/nginx:v1 提交到仓库 docker的常用命令 #查看当前docker版本 docker -v #查看当前本地所有镜像 docker images #构造镜像,用法docker build -t 镜像名称 . docker build -t docker_demo . #用于容器与主机之间的数据拷贝。用法docker cp 主机文件地址 容器内地址。12d7f14v45cv为容器id。 docker cp /www/runoob 12d7f14v45cv:/www/ #创建一个新的容器并运行,-d为后台执行,-p 9000:3000前面为主机端口,后面是容器端口。docker_demo镜像名 docker run -d -p 9000:3000 docker_demo #启动已被停止的容器 docker start docker_demo #关闭已被启动的容器 docker stop docker_demo #关闭所有容器 docker stop $(docker ps -a -q) # 删除所有容器 docker rm $(docker ps -a -q) #重新启动容器 docker restart docker_demo #杀掉一个运行中的容器。 docker kill -s KILL docker_demo #删除一个或多少容器。-f :通过SIGKILL信号强制删除一个运行中的容器-l :移除容器间的网络连接,而非容器本身-v :-v 删除与容器关联的卷 docker rm -f docker_demo、docker_demo1 #在运行的容器中执行命令。104e28f2f072容器id sudo docker exec -it 104e28f2f072 /bin/bash #列出容器。 -a:所有容器包含没有运行的 docker ps #获取容器获取容器的日志 104e28f2f072容器id,-t:显示时间戳 docker logs -f -t 104e28f2f072 #登陆镜像仓库 docker login #获取镜像 docker pull #上传镜像 docker push #查看指定镜像的创建历史。 docker history docker_demo Docker命令大全 采坑记录 docker stop 后面只能跟容器id而非镜像名 执行exec时报错: OCI runtime exec failed: exec failed: container_linux.go:348: starting container process caused "exec: "bash": executable file not found in $PATH": unknown 解决办法 exec 报错是因为 /bin/bash 文件不存在,可以尝试 /bin/sh 等。

优秀的个人博客,低调大师

Python 基础入门 (全)

MongoDB简介 1.MongoDB ①MongoDB 是一个基于分布式 文件存储的NoSQL数据库 ②由C++语言编写,运行稳定,性能高 ③旨在为 WEB 应用提供可扩展的高性能数据存储解决方案 ④官方网址:https://www.mongodb.com/ 2.MongoDB特点 ①MongoDB可以轻松地布置两个活跃集群,但关系型不容易在两台服务器上同时运行单个数据库 ②MongoDB天然缺少对事物的支持 ③MongoDB并不提供主/主复制,但它支持分片 3.Bson和Json ①Bosn版本是Json的二进制格式,但并不意味着Bson占用的空间就比Json小的多 ②继续使用Bson的原因是因为MongoDB在设计上就是要求快速,而不是节省空间,如果处理数据的速度更快,存储文档时的一点开销是完全可以接受的 ③Bson更易于浏览(即遍历),遍历索引页非常快,第二点是很容易将Bson数据快速转化为编程语言的原生数据格式 4.名词 SQL术语/概念 MongoDB术语/概念 解释/说明 database database 数据库 table collection 数据库表/集合 row document 数据记录行/文档 column field 数据字段/域 index index 索引 tablejoins 表连接,MongoDB不支持 primarykey primarykey 主键,MongoDB自动将_id字段设置为主键 5.MongoDB三要素:数据库,集合,文档 ①数据库:是一个集合的物理容器,一个数据库中可以包含多个文档,一个服务器通常有多个数据库 ②集合:类似于关系数据库中的表,储存多个文档,结构不固定,如可以存储如下文档在一个集合中 {'name':'guojing','gender':'男'} {'name':'huangrong','age':18} {'book':'shuihuzhuan','heros':'108'} ③文档:就是一个对象,由键值对组成,是Json的扩展Bson格式 {'name':'guojing','gender':'男'} MongoDB安装与管理 1.安装 ①下载MongoDB的版本注意,两点注意 根据规则:偶数为稳定版,如1.6X,奇数为开发版,如1.7X 32bit的MongoDB最大只能存放2G的数据,64bit就没有限制 ②到官网,选择合适的版本下载 ③解压 tar-zxvfmongodb-linux-x86_64-ubuntu1604-3.4.0.tgz ④移动到/usr/local/目录下 sudomv-rmongodb-linux-x86_64-ubuntu1604-3.4.0//usr/local/mongodb ⑤将可执行文件添加到PATH路径中 exportPATH=/usr/local/mongodb/bin:$PATH 2.管理 ①配置文件在/etc/mongod.conf,默认端口27017 ②启动 sudoservicemongodstart ③停止 sudoservicemongodstop ④使用终端连接:mongo,这个shell就是mongodb的客户端,同时也是一个js的编译器 ⑤ GUI:robomongo,解压后在bin目录下找到运行程序 数据库操作 1.数据库切换 ①查看当前数据库名称:db ②查看所有数据库名称:show dbs,(列出所有在物理上存在的数据库) ③切换数据库:use 数据库名称,(如果数据库不存在,则指向数据库,但不创建,直到插入数据或创建集合时数据库才被创建) ④默认的数据库为test,如果没有创建新的数据库,集合将存放在test数据库中 2.数据库删除 删除当前指向的数据库,如果数据库不存在,则什么也不做 db.dropDatabase() 集合操作 1.集合创建 语法: db.createCollection(name,option) ①name是要创建集合的名称 ②options是一个文档,用于指定集合的配置 ③选项参数是可选的,所以只需要到指定的集合名称 例1:不限制集合的大小 db.createCollection(‘stu’) 例2:限制集合大小 db.createCollection(‘sub’,{capped:true,size:10}) 参数capped:默认值为false表示不设置上限,值为true表示设置上限 参数size:当capped值为true时,需要指定此参数,表示上限大小,当文档设置上限时,会将之前的数据覆盖,单位为字节 2.查看当前数据库的集合 showcollections 3.删除集合 db.集合名称.drop() 数据类型 1. MongoDB中常用的几种数据类型: ①Object ID:文档ID ②String:字符串,最常用,必须是有效的UTF-8 ③Boolean:存储一个布尔值,true或false ④Integer:整数可以是32位或64位,这取决于服务器 ⑤Double:存储浮点值 ⑥Arrays:数组或列表,多个值存储到一个键 ⑦Object:用于嵌入式的文档,即一个值为一个文档 ⑧Null:存储Null值 ⑨Timestamp:时间戳 ⑩Date:存储当前日期或时间的UNIX时间格式 2. object id ①每个文档都有一个属性,为_id,保证每个文档的唯一性 ②可以自己去设置_id插入文档 ③如果没有提供,那么MongoDB为每个文档提供了一个独特的_id,类型为objectID ④objectID是一个12字节的十六进制数 前4个字节为当前时间戳 接下来3个字节的机器ID 接下来的2个字节中MongoDB的服务进程id 最后3个字节是简单的增量值 数据操作 1.插入 插入文档时,如果不指定_id参数,MongoDB会为文档分配一个唯一的ObjectId db.集合名称.insert(document) 2.简单查询 db.集合名称.find() 3.更新 db.集合名称.update(<query>,<update>,multi:<boolean>}) ①参数query:查询条件,类似sql语句update中where部分 ②参数update:更新操作符,类似sql语句update中set部分 ③参数multi:可选,默认是false,表示只更新找到的第一条记录,值为true表示把满足条件的文档全部更新 例3:全文档更新 db.stu.update( {name:'hr'},{name:'mnc'} ) 例4:指定属性更新,通过操作符$set db.stu.insert({name:'hr',gender:0}) db.stu.update({name:'hr'},{$set:{name:'hys'}}) 例5:修改多条匹配到的数据 db.stu.update({},{$set:{gender:0}},{multi:true}) 4.保存 如果文档的_id已经存在则修改,不存在则添加 db.集合名称.save(document) 5.删除 db.集合名称.remove(<query>,{justOne:<boolean>}) ①参数query:可选,删除的文档的条件 ②参数justOne:可选,如果设为true或1,则只删除一条,默认false,表示删除多条 例6:只删除匹配到的第一条 db.stu.remove({gender:0},{justOne:true}) 例7:全部删除 db.stu.remove({}) 数据查询 1.基本查询 ①方法find():查询 db.集合名称.find({条件文档}) ②方法findOne():查询,只返回第一个 db.集合名称.findOne({条件文档}) ③方法pretty():将结果格式化 db.集合名称.find({条件文档}).pretty() 2.比较运算符 ①等于,默认是等于判断,没有运算符 ②小于$lt ③小于或等于$lte ④大于$gt ⑤大于或等于$gte ⑥不等于$ne 例8:查询年龄大于或等于18的学生 db.stu.find({age:{$gte:18}}) 3.逻辑运算符 ①查询时可以有多个条件,多个条件之间需要通过逻辑运算符连接 ②逻辑与:默认是逻辑与的关系 例9:查询年龄大于或等于18,并且性别为1的学生 db.stu.find({age:{$gte:18},gender:1}) 逻辑或:使用$or 例10:查询年龄大于18,或性别为0的学生 db.stu.find({$or:[{age:{$gt:18}},{gender:1}]}) and和or一起使用 例11:查询年龄大于18或性别为0的学生,并且学生的姓名为gj db.stu.find({$or:[{age:{$gte:18}},{gender:1}],name:'gj'}) 4.范围运算符 使用"$in","$nin" 判断是否在某个范围内 例12:查询年龄为18、28的学生 db.stu.find({age:{$in:[18,28]}}) 5.支持正则表达式 使用//或$regex编写正则表达式 例13:查询姓黄的学生 db.stu.find({name:/^黄/})db.stu.find({name:{$regex:'^黄'}}) 6.自定义查询 使用$where后面写一个函数,返回满足条件的数据 例14:查询年龄大于30的学生 db.stu.find({$where:function(){returnthis.age>20}}) 7. Limit(方法limit():用于读取指定数量的文档) db.集合名称.find().limit(NUMBER) ①参数NUMBER表示要获取文档的条数 ②如果没有指定参数则显示集合中的所有文档 例15:查询2条学生信息 db.stu.find().limit(2) 8. skip(方法skip():用于跳过指定数量的文档) db.集合名称.find().skip(NUMBER) 参数NUMBER表示跳过的记录条数,默认值为0 例16:查询从第3条开始的学生信息 db.stu.find().skip(2) 9.Limit与Skip一起使用 方法limit()和skip()可以一起使用,不分先后顺序 查询第5至8条数据(跳取) db.stu.find().limit(4).skip(5)db.stu.find().skip(5).limit(4) 10. 投影 在查询到的返回结果中,只选择必要的字段,而不是选择一个文档的整个字段 语法:参数为字段与值,值为1表示显示,值为0不显示 db.集合名称.find({},{字段名称:1,...}) 对于需要显示的字段,设置为1即可,不设置即为不显示 特殊:对于_id列默认是显示的,如果不显示需要明确设置为0 db.stu.find({},{_id:0,name:1,gender:1}) 11.排序 方法sort(),用于对结果集进行排序 语法:db.集合名称.find().sort({字段:1,...}) ①参数1为升序排列 ②参数-1为降序排列 例18:根据性别降序,再根据年龄升序 db.stu.find().sort({gender:-1,age:1}) 12.统计个数 方法count()用于统计结果集中文档条数 语法: db.集合名称.find({条件}).count() 也可以与为 db.集合名称.count({条件}) 例19:统计男生人数 db.stu.find({gender:1}).count() 例20:统计年龄大于20的男生人数 db.stu.count({age:{$gt:20},gender:1}) 13.消除重复 方法distinct()对数据进行去重 语法: db.集合名称.distinct('去重字段',{条件}) 例21:查找年龄大于18的性别(去重) db.stu.distinct('gender',{age:{$gt:18}}) 聚合 aggregate 1.聚合(aggregate) 主要用于计算数据,类似sql中的sum()、avg() 语法: db.集合名称.aggregate([{管道:{表达式}}]) 2.管道 管道在Unix和Linux中一般用于将当前命令的输出结果作为下一个命令的输入 psajx|grepmongo 在mongodb中,管道具有同样的作用,文档处理完毕后,通过管道进行下一次处理 常用管道: $group:将集合中的文档分组,可用于统计结果 $match:过滤数据,只输出符合条件的文档 $project:修改输入文档的结构,如重命名、增加、删除字段、创建计算结果 $sort:将输入文档排序后输出 $limit:限制聚合管道返回的文档数 $skip:跳过指定数量的文档,并返回余下的文档 $unwind:将数组类型的字段进行拆分 表达式 处理输入文档并输出 语法:表达式:'$列名' $sum:计算总和,$sum:1同count表示计数 $avg:计算平均值 $min:获取最小值 $max:获取最大值 $push:在结果文档中插入值到一个数组中 $first:根据资源文档的排序获取第一个文档数据 $last:根据资源文档的排序获取最后一个文档数据 3.$group 将集合中的文档分组,可用于统计结果 _id表示分组的依据,使用某个字段的格式为'$字段' 例22:统计男生、女生的总人数 db.stu.aggregate([{$group:{_id:'$gender',counter:{$sum:1}}}]) Group by null 将集合中所有文档分为一组 例23:求学生总人数、平均年龄 db.stu.aggregate([{$group:{_id:null,counter:{$sum:1},avgAge:{$avg:'$age'}}}]) 透视数据 例24:统计学生性别及学生姓名 db.stu.aggregate([{$group:{_id:'$gender',name:{$push:'$name'}}}]) 使用$$ROOT可以将文档内容加入到结果集的数组中,代码如下 db.stu.aggregate([{$group:{_id:'$gender',name:{$push:'$$ROOT'}}}]) 4.$match 用于过滤数据,只输出符合条件的文档 使用MongoDB的标准查询操作 例25:查询年龄大于20的学生 db.stu.aggregate([{$match:{age:{$gt:20}}}]) 例26:查询年龄大于20的男生、女生人数 db.stu.aggregate([{$match:{age:{$gt:20}}},{$group:{_id:'$gender',counter:{$sum:1}}}]) 5.$project 修改输入文档的结构,如重命名、增加、删除字段、创建计算结果 例27:查询学生的姓名、年龄 db.stu.aggregate([{$project:{_id:0,name:1,age:1}}]) 例28:查询男生、女生人数,输出人数 db.stu.aggregate([{$group:{_id:'$gender',counter:{$sum:1}}},{$project:{_id:0,counter:1}}]) 6. $sort 将输入文档排序后输出 例29:查询学生信息,按年龄升序 b.stu.aggregate([{$sort:{age:1}}]) 例30:查询男生、女生人数,按人数降序 db.stu.aggregate([{$group:{_id:'$gender',counter:{$sum:1}}},{$sort:{counter:-1}}]) 7. $limit,$skip 限制聚合管道返回的文档数 例31:查询2条学生信息 db.stu.aggregate([{$limit:2}]) $skip 跳过指定数量的文档,并返回余下的文档 例32:查询从第3条开始的学生信息 db.stu.aggregate([{$skip:2}]) 例33:统计男生、女生人数,按人数升序,取第二条数据 db.stu.aggregate( [{$group:{_id:'$gender',counter:{$sum:1}}}, {$sort:{counter:1}}, {$skip:1}, {$limit:1}]) 注意顺序:先写skip,再写limit 8. $unwind 将文档中的某一个数组类型字段拆分成多条,每条包含数组中的一个值 语法1:对某字段值进行拆分 db.集合名称.aggregate([{$unwind:'$字段名称'}]) 构造数据 db.t2.insert({_id:1,item:'t-shirt',size:['S','M','L']}) 查询 db.t2.aggregate([{$unwind:'$size'}]) 语法2:对某字段值进行拆分 处理空数组、非数组、无字段、null情况 db.inventory.aggregate([{$unwind:{path:'$字段名称',preserveNullAndEmptyArrays:<boolean>#防止数据丢失}}]) 构造数据 db.t3.insert( [{"_id":1,"item":"a","size":["S","M","L"]}, {"_id":2,"item":"b","size":[]}, {"_id":3,"item":"c","size":"M"}, {"_id":4,"item":"d"}, {"_id":5,"item":"e","size":null}] ) 使用语法1查询 db.t3.aggregate([{$unwind:'$size'}]) 查看查询结果,发现对于空数组、无字段、null的文档,都被丢弃了 问:如何能不丢弃呢? 答:使用语法2查询 db.t3.aggregate([{$unwind:{path:'$sizes',preserveNullAndEmptyArrays:true}}]) 安全 1.超级管理员 为了更安全的访问mongodb,需要访问者提供用户名和密码,于是需要在mongodb中创建用户 采用了角色-用户-数据库的安全管理方式 常用系统角色如下: root:只在admin数据库中可用,超级账号,超级权限 Read:允许用户读取指定数据库 readWrite:允许用户读写指定数据库 创建超级管理用户 useadmindb.createUser({ user:'admin', pwd:'123', roles:[{role:'root',db:'admin'}] }) 2.启用安全认证 修改配置文件 sudovi/etc/mongod.conf 启用身份验证 注意:keys and values之间一定要加空格, 否则解析会报错 security:authorization:enabled 重启服务 sudoservicemongodstop sudoservicemongodstart 终端连接 mongo-u'admin'-p'123'--authenticationDatabase'admin' 3.普通用户管理 使用超级管理员登录,然后进入用户管理操作 查看当前数据库的用户 usetest1showusers 创建普通用户 db.createUser({ user:'t1',pwd:'123',roles:[{role:'readWrite',db:'test1'}] }) 终端连接 mongo-ut1-p123--authenticationDatabasetest1 切换数据库,执行命令查看效果 修改用户:可以修改pwd、roles属性 db.updateUser('t1',{pwd:'456'}) 复制(副本集) 1.什么是复制 ①复制提供了数据的冗余备份,并在多个服务器上存储数据副本,提高了数据的可用性,并可以保证数据的安全性 ②复制还允许从硬件故障和服务中断中恢复数据 2.为什么要复制 ①数据备份 ②数据灾难恢复 ③读写分离 ④高(24* 7)数据可用性 ⑤无宕机维护 ⑥副本集对应用程序是透明 3.复制的工作原理 ①复制至少需要两个节点A、B... ②A是主节点,负责处理客户端请求 ③其余的都是从节点,负责复制主节点上的数据 ④节点常见的搭配方式为:一主一从、一主多从 ⑤主节点记录在其上的所有操作,从节点定期轮询主节点获取这些操作,然后对自己的数据副本执行这些操作,从而保证从节点的数据与主节点一致 ⑥主节点与从节点进行数据交互保障数据的一致性 4.复制的特点 ①N 个节点的集群 ②任何节点可作为主节点 ③所有写入操作都在主节点上 ④自动故障转移 ⑤自动恢复 5.设置复制节点 接下来的操作需要打开多个终端窗口,而且可能会连接多台ubuntu主机,会显得有些乱,建议在xshell中实现 step1:创建数据库目录t1、t2 在Desktop目录下演示,其它目录也可以,注意权限即可 mkdirt1mkdirt2 step2:使用如下格式启动mongod,注意replSet的名称是一致的 mongod--bind_ip192.168.196.128--port27017 --dbpath~/Desktop/t1--replSet rs0mongod--bind_ip192.168.196.128--port27018 --dbpath~/Desktop/t2--replSetrs0 step3:连接主服务器,此处设置192.168.196.128:27017为主服务器 mongo--host192.168.196.128--port27017 step4:初始化 rs.initiate() step5:查看当前状态 rs.status() step6:添加复本集 rs.add('192.168.196.128:27018') step7:连接第二个mongo服务 mongo--host192.168.196.128--port27018 step8:向主服务器中插入数据 usetest1for(i=0;i<10;i++){ db.t1.insert({_id:i}) } db.t1.find() step9:在从服务器中插查询 说明:如果在从服务器上进行读操作,需要设置rs.slaveOk() rs.slaveOk()db.t1.find() 其它说明 删除从节点 rs.remove('192.168.196.128:27018') 关闭主服务器后,再重新启动,会发现原来的从服务器变为了主服务器,新启动的服务器(原来的从服务器)变为了从服务器 备份和恢复 1.备份 语法: mongodump-hdbhost-ddbname-odbdirectory -h:服务器地址,也可以指定端口号 -d:需要备份的数据库名称 -o:备份的数据存放位置,此目录中存放着备份出来的数据 例1: sudomkdirtest1bak sudomongodump-h192.168.196.128:27017-dtest1-o~/Desktop/test1bak 2.恢复 语法: mongorestore-hdbhost-ddbname--dirdbdirectory -h:服务器地址 -d:需要恢复的数据库实例 --dir:备份数据所在位置 例2: mongorestore-h192.168.196.128:27017-dtest2--dir~/Desktop/test1bak/test1 与python交互 1.点击查看官方文档:http://api.mongodb.org/python/current/tutorial.html 2.安装python包 进入虚拟环境 sudopipinstallpymongo 或源码安装 pythonsetup.py 引入包pymongo importpymongo 连接,创建客户端 client=pymongo.MongoClient("localhost",27017) 获得数据库test1 db=client.test1 获得集合stu stu=db.stu 添加文档 s1={name:'gj',age:18} s1_id=stu.insert_one(s1).inserted_id 查找一个文档 s2=stu.find_one() 查找多个文档1 forcurinstu.find(): printcur 查找多个文档2 cur=stu.find()cur.next()cur.next()cur.next() 获取文档个数 printstu.count()
优秀的个人博客,低调大师

SSM基础框架搭建

SSM(Spring + SpringMVC + MyBatis)三个开源框架的简称,是WEB项目开发的不二之选,是码农进阶全栈工程师心路历程上的驿站。大公司开源框架和算法制定标准规范引领行业趋势,小公司拿来主义面向业务敏捷开发快速迭代在夹缝中艰难生存。SSM框架完美的符合了当下的这种行业现状,对于底层是如何实现的开发人员完全不必关注,踏踏实实梳理好业务逻辑,做好质量把控年底KPI基本问题就不大了。 Spring是一个轻量级IoC及AOP容器框架,配置又多又细,SpringBoot简化了大量通用且不常用的配置项,使构建一个微服务变得超简单;SpringMVC是目前最优秀的MVC框架,注解用得好事半功倍;MyBatis用于数据持久化,MyBatisPlus增强版内置分页功能简化开发流程自动化代码生成,唯一要做的事情就剩下写写SQL了。 无私的分享从这里开始: git clone git@gitee.com:gonglibin/kirin.git 文件夹 PATH 列表 卷序列号为 0009-68A2 D:\WORKSPACES\KIRIN │ kirin.iml │ pom.xml │ ├─.idea │ │ .name │ │ compiler.xml │ │ encodings.xml │ │ misc.xml │ │ modules.xml │ │ uiDesigner.xml │ │ workspace.xml │ │ │ ├─copyright │ │ profiles_settings.xml │ │ │ ├─inspectionProfiles │ │ profiles_settings.xml │ │ Project_Default.xml │ │ │ └─libraries │ (略) │ └─src ├─main │ ├─java │ │ └─com │ │ └─kirin │ │ ├─api │ │ │ ├─controller │ │ │ │ KrnStatisticAdownerController.java │ │ │ │ │ │ │ ├─request │ │ │ └─response │ │ │ KrnResponse.java │ │ │ │ │ ├─dao │ │ │ ├─entity │ │ │ │ StatisticAdowner.java │ │ │ │ │ │ │ ├─impl │ │ │ │ KrnStatisticAdownerServiceImpl.java │ │ │ │ │ │ │ ├─mapper │ │ │ │ KrnStatisticAdownerMapper.java │ │ │ │ │ │ │ └─service │ │ │ KrnStatisticAdownerService.java │ │ │ │ │ └─web │ │ ├─server │ │ │ KrnApplication.java │ │ │ KrnInterceptor.java │ │ │ KrnMvcConfig.java │ │ │ │ │ └─tools │ │ KrnAutoMysql.java │ │ │ └─resources │ │ application.properties │ │ kirin.properties │ │ │ ├─mybatis │ │ mybatis-config.xml │ │ spring-jdbc.xml │ │ spring-mybatis.xml │ │ │ ├─spring │ │ spring-web-entry.xml │ │ │ └─xml │ StatisticAdowner.xml │ └─test └─java └─com └─kirin kirin/src/main/java/com/kirin/web/server/KrnApplication.java @SpringBootApplication @ImportResource("classpath:spring/spring-web-entry.xml") @EnableAutoConfiguration(exclude = {DataSourceAutoConfiguration.class}) public class KrnApplication { private static Logger logger = LoggerFactory.getLogger(KrnApplication.class); public static void main(String[] args) { SpringApplication.run(KrnApplication.class, args); } } 1行@SpringBootApplication表示该对象为当前应用的启动类; 2行@ImportResource表示引入配置文件资源读取解析及加载; 8行启动,就这么简单~~~ kirin/src/main/java/com/kirin/web/server/ KrnMvcConfig.java @Configuration public class KrnMvcConfig extends WebMvcConfigurerAdapter { private static Logger logger = LoggerFactory.getLogger(KrnMvcConfig.class); @Override public void addResourceHandlers(ResourceHandlerRegistry registry) { super.addResourceHandlers(registry); } @Override public void addInterceptors(InterceptorRegistry registry) { registry.addInterceptor(new KrnInterceptor()).addPathPatterns("/**"); } } KrnMvcConfig类继承自WebMvcConfigurerAdapter抽象类(该类实现了WebMvcConfigurer接口方法为空并交给子类去实现); 1行@Configuration表示希望Spring将该类作为配置项资源; 6行实现静态资源处理; 11行向资源中添加拦截器; kirin/src/main/java/com/kirin/web/server/ KrnInterceptor.java public class KrnInterceptor implements HandlerInterceptor { /** * 该方法将在请求处理之前被调用,只有该方法返回true,才会继续 * 执行后续的Interceptor和Controller,当返回值为true时就会 * 继续调用下一个Interceptor的preHandle方法,如果已经是最后 * 一个Interceptor的时候就会是调用当前请求的Controller方法。 */ @Override public boolean preHandle(HttpServletRequest httpServletRequest, HttpServletResponse httpServletResponse, Object o) throws Exception { boolean rst = true; String err = "{\"code\":500,\"message\":\"操作错误\",\"data\":null}"; if (true != httpServletRequest.getMethod().equals("GET")) { httpServletResponse.setCharacterEncoding("UTF-8"); httpServletResponse.setContentType("text/html; charset=utf-8"); try { PrintWriter writer = httpServletResponse.getWriter(); writer.print(err); writer.close(); } catch (Exception e) { e.printStackTrace(); } rst = false; } return rst; } /** * 该方法将在请求处理之后,DispatcherServlet进行视图 * 返回渲染之前进行调用,可以在这个方法中对Controller * 处理之后的ModelAndView 对象进行操作。 */ @Override public void postHandle(HttpServletRequest httpServletRequest, HttpServletResponse httpServletResponse, Object o, ModelAndView modelAndView) throws Exception { } /** * 该方法也是需要当前对应的Interceptor的preHandle方法的返回值为true * 时才会执行,该方法将在整个请求结束之后,也就是在DispatcherServlet * 渲染了对应的视图之后执行。用于进行资源清理。 */ @Override public void afterCompletion(HttpServletRequest httpServletRequest, HttpServletResponse httpServletResponse, Object o, Exception e) throws Exception { } } KrnInterceptor类继承自HandlerInterceptor接口,接口定义了三个方法,分别对应在不同的阶段启动拦截事件,详情见注释,preHandle方法为演示,当HTTP请求不为GET时返回报错信息。 kirin/src/main/java/com/kirin/api/controller/KrnStatisticAdownerController.java @RestController @RequestMapping("/statisticadowner") public class KrnStatisticAdownerController { @Autowired KrnStatisticAdownerService krnStatisticAdownerService; @ResponseBody @RequestMapping("display") public Object getStatisticAdownerInfo() { return new KrnResponse<StatisticAdowner>(200, "操作成功", krnStatisticAdownerService.getStatisticAdownerInfo()); } } 1行@RestController (@ResponseBody + @Controller),表示将返回结果按照response的type直接写到HTTP的response body中去,且该类是一个控制器; 2行@RequestMapping表示将请求路径映射到的类上; 5行注入KrnStatisticAdownerService资源; 8行@RequestMapping表示将多级路径映射到该类的具体方法上; kirin/src/main/java/com/kirin/dao/entity/StatisticAdowner.java @TableName("t_statistic_adowner") public class StatisticAdowner implements Serializable { private static final long serialVersionUID = 1L; @TableId(value = "id", type = IdType.AUTO) private Integer id; /** * 展示量 */ @TableField("sad_viewAccount") private Integer sadViewaccount; // (省略) } 1行表示该类映射自哪张表,并将表结构映射成对象的成员变量; 6行@TableId为主键; 11行@TableField("sad_viewAccount")为表字段名; 需要说明的一点是数据表到类声明的自动化生成最好遵循一定的命名规则否则后果很严重; kirin/src/main/java/com/kirin/dao/service/KrnStatisticAdownerService.java 自定义KrnStatisticAdownerService接口继承自IService接口,其中定义了大量常用的增删改查的方法,基本涵盖了常用的数据库操作,自定义接口中的方法在控制器中被当作资源注入并调用。 kirin/src/main/java/com/kirin/dao/ impl/KrnStatisticAdownerServiceImpl.java @Service public class KrnStatisticAdownerServiceImpl extends ServiceImpl<KrnStatisticAdownerMapper, StatisticAdowner> implements KrnStatisticAdownerService { @Autowired KrnStatisticAdownerMapper krnStatisticAdownerMapper; @Override public StatisticAdowner getStatisticAdownerInfo() { return krnStatisticAdownerMapper.getStatisticAdownerInfo(); } } KrnStatisticAdownerServiceImpl类是KrnStatisticAdownerService接口的实现对象,它同时继承自ServiceImpl类,该类是IService接口中方法的具体实现。 4行注入KrnStatisticAdownerMapper资源; 7行覆盖KrnStatisticAdownerService接口中的方法; kirin/src/main/java/com/kirin/dao/ mapper/KrnStatisticAdownerMapper.java public interface KrnStatisticAdownerMapper extends BaseMapper<StatisticAdowner> { StatisticAdowner getStatisticAdownerInfo(); } 2行调用具体实现,建议在XML配置中书写SQL,好维护好管理逻辑清晰方便编辑修改; kirin/src/main/resources/xml/StatisticAdowner.xml <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mapper namespace="com.kirin.dao.mapper.KrnStatisticAdownerMapper"> <!-- 通用查询映射结果 --> <resultMap id="BaseResultMap" type="com.kirin.dao.entity.StatisticAdowner"> <id column="id" property="id" /> <result column="sad_viewAccount" property="sadViewaccount" /> <result column="sad_clickAccount" property="sadClickaccount" /> <result column="sad_costAmount" property="sadCostamount" /> <result column="sad_adOwnerId" property="sadAdownerid" /> <result column="sad_createTime" property="sadCreatetime" /> </resultMap> <!-- 通用查询结果列 --> <sql id="Base_Column_List"> id, sad_viewAccount AS sadViewaccount, sad_clickAccount AS sadClickaccount, sad_costAmount AS sadCostamount, sad_adOwnerId AS sadAdownerid, sad_createTime AS sadCreatetime </sql> <select id="getStatisticAdownerInfo" resultType="com.kirin.dao.entity.StatisticAdowner"> SELECT <include refid="Base_Column_List" /> FROM db_charm_app.t_statistic_adowner WHERE id = 1000123 </select> </mapper> select块部分是需要开发者实现的,把调试好的SQL复制到这里就OK了。 SSM框架设计的异常出色,使用起来异常便利,不过坑很多,踩一个少一个,都踩遍了工作起来就会变得很轻松,但是也会很乏味,剩下的事情全是面对不断的需求变更、业务调整和功能扩展,在日复一日的重复中慢慢老去~~~

优秀的个人博客,低调大师

JavaScript 基础--- (经典案例)

案例一:全选练习 ** 使用复选框上面一个属性判断是否选中 - checked属性 - checked=true:选中 - checked=false:不选中 * 创建一个页面 ** 复选框和按钮 - 四个复选框表示爱好 - 还有一个复选框操作 全选和选不选,也有一个事件 ** 三个按钮,分别有事件 - 全选 - 全不选 - 反选 * 全选操作 步骤: /* 1、获取要操作的复选框 - 使用getElementsByName() 2、返回是数组, - 属性 checked判断复选框是否选中 *** checked = true; //表示选中 *** checked = false;//表示不选中 - 遍历数组,得到的是每一个checkbox * 把每一个checkbox属性checked=true */ * 全不选操作 步骤 /* 1、获取到要操作的复选框 2、返回的是数组,遍历数组 3、得到每一个复选框 4、设置复选框的属性 checked=false */ * 反选操作 步骤 /* 1、获取到要操作的复选框 2、返回数组,遍历数组 3、得到每一个复选框 4、判断当前的复选框是选中还是不选中 - if(love1.checked == true) {} 5、如果选中,属性checked设置成false,否则,设置成true */ * 使用复选框实现全选和全不选 步骤 /* 1、得到上面那个复选框 - 通过id获取到 2、判断这个复选框是否是选中 - if条件,checked==true 3、如果是选中,下面是全选 4、如果不是选中,下面是全不选 */ <!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <title></title> <style type="text/css"> table{ border: 1px solid #000; width: 400px; } </style> <script type="text/javascript"> function change(){ var all = document.getElementById("checkbox_all"); var cb = document.getElementsByName("personid"); //判断全选按钮是否被选中 if(all.checked){ for(var i = 0; i < cb.length; i++){ cb[i].checked = true; } }else{ for(var i = 0; i < cb.length; i++){ cb[i].checked = false; } } } //反选 function reverse(){ //获取所有的checkbox var cb = document.getElementsByName("personid"); for(var i = 0; i < cb.length; i++){ if(cb[i].checked){ cb[i].checked = false; }else{ cb[i].checked = true; } } } </script> </head> <body> <table border="1" cellspacing="0" cellpadding="0"> <tr> <th>全选<input type="checkbox" id="checkbox_all" onclick="change()"/></th> <th>姓名</th> <th>年龄</th> <th>手机号</th> </tr> <tr> <td><input type="checkbox" name="personid" /></td> <td>张三</td> <td>20</td> <td>15033444455</td> </tr> <tr> <td><input type="checkbox" name="personid"/></td> <td>李四</td> <td>30</td> <td>15033444456</td> </tr> <tr> <td><input type="checkbox" name="personid"/></td> <td>王五</td> <td>40</td> <td>15033444457</td> </tr> <tr> <td><input type="checkbox" name="personid"/></td> <td>赵六</td> <td>50</td> <td>15033444458</td> </tr> </table> <input type="button" value="反选" onclick="reverse()"/> </body> </html> 输出: 案例二:下拉列表左右选择 * 下拉选择框 <select> <option>111</option> <option>111</option> </select> * 创建一个页面 ** 两个下拉选择框 - 设置属性 multiple属性 ** 四个按钮,有事件 * 选中添加到右边 步骤 /* 1、获取select1里面的option - getElementsByTagName()返回是数组 - 遍历数组,得到每一个option 2、判断option是否被选中 - 属性 selected,判断是否被选中 ** selected= true: 选中 ** selected= false:没有选择 3、如果是选中,把选择的添加到右边去 4、得到select2 4、添加选择的部分 - appendChild方法 */ * 全部添加到右边 步骤 /* 1、获取第一个select下面的option对象 2、返回数组,遍历数组 3、得到每一个option对象 4、得到select2 5、添加到select2下面 - appendChild方法 */ * 选中添加到左边 步骤 /* 1、获取select2里面的option对象 2、返回是数组,遍历数组 3、得到每一个option对象 4、判断option是否被选中 - if条件 属性 selected == true:选择 5、获取select1 6、添加到select1里面 - 使用appendChild方法 */ * 全部添加到左边 步骤 /* 1、获取select2里面的option对象 2、返回是数组,遍历数组 3、得到每一个option对象 4、获取到select1 5、添加到select1里面 - 使用appendChild方法 */ <!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <title></title> <style type="text/css"> .center{ float:left; margin-left: 100px ; } </style> </head> <body> <div class="center"> <select id="select1" multiple style="width:100px;height: 200px;" ondblclick="sel()"> <option value="选项1">选项1</option> <option value="选项2">选项2</option> <option value="选项3">选项3</option> <option value="选项4">选项4</option> <option value="选项5">选项5</option> </select> <input type="button" onclick="sel()" value="将左边选中的选项添加到右边" /> </div> <div class="center"> <select id="select2" multiple style="width:100px;height: 200px;" ondblclick="cancel_sel()"> </select> <input type="button" onclick="cancel_sel()" value="将右边选中的选项添加到左边" /> </div> </body> <script type="text/javascript"> function sel(){ var select1 = document.getElementById("select1"); var select2 = document.getElementById("select2"); var select1_options = select1.getElementsByTagName("option"); for(var i = 0; i < select1_options.length; i++){ var opt = select1_options[i]; if(opt.selected){ select2.appendChild(opt); } } } //取消选中 function cancel_sel(){ var select1 = document.getElementById("select1"); var select2 = document.getElementById("select2"); var select2_options = select2.getElementsByTagName("option"); for(var i = 0; i < select2_options.length; i++){ var opt = select2_options[i]; if(opt.selected){ select1.appendChild(opt); } } } </script> </html> 输出: 案例三:省市联动 * 创建一个页面,有两个下拉选择框 * 在第一个下拉框里面有一个事件 :改变事件 onchange事件 - 方法add1(this.value);表示当前改变的option里面的value值 * 创建一个二维数组,存储数据 * 每个数组中第一个元素是国家名称,后面的元素是国家里面的城市 * /* 1、遍历二维数组 2、得到也是一个数组(国家对应关系) 3、拿到数组中的第一个值和传递过来的值做比较 4、如果相同,获取到第一个值后面的元素 5、得到city的select 6、添加过去(使用)appendChild方法 - 创建option(三步) */ /* 由于每次都要向city里面添加option 第二次添加,会追加。 * 每次添加之前,判断一下city里面是否有option,如果有,删除 */ 方法一: <!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <title></title> <style type="text/css"> select{ width:100px; } </style> </head> <body> 省: <select id="sheng" onchange="selectShi()"> <option value="">请选择省份</option> <option value="0">河北省</option> <option value="1">山东省</option> <option value="2">河南省</option> <option value="3">山西省</option> </select> 市: <select id="shi"> <option value="">请选择市</option> </select> </body> <script type="text/javascript"> var arrs = []; arrs[0] = ["秦皇岛","保定","石家庄","唐山"]; arrs[1] = ["济南","临沂","青岛","威海"]; arrs[2] = ["洛阳","郑州","开封","周口"]; arrs[3] = ["太原","大同","运城","忻州"]; function selectShi(){ var sheng = document.getElementById('sheng').value; var shi = document.getElementById("shi"); var shis = arrs[sheng]; //清空原来的信息 //获取市的option属性 var shi_opts = shi.getElementsByTagName("option"); //遍历删除市中的option for(var i= shi_opts.length - 1; i >= 1; i--){ var shi_opt = shi_opts[i]; shi.removeChild(shi_opt); } for(var i = 0; i < shis.length; i++){ var textNode = document.createTextNode(shis[i]); var opt = document.createElement("option"); opt.appendChild(textNode); shi.appendChild(opt); } } </script> </html> 方法二: <!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <title></title> <style type="text/css"> select{ width:100px; } </style> </head> <body> 省: <select id="sheng" onchange="selectShi()"> <option value="">请选择省份</option> <option value="0">河北省</option> <option value="1">山东省</option> <option value="2">河南省</option> <option value="3">山西省</option> </select> 市: <select id="shi"> <option value="">请选择市</option> </select> </body> <script type="text/javascript"> var arrs = []; arrs[0] = ["秦皇岛","保定","石家庄","唐山"]; arrs[1] = ["济南","临沂","青岛","威海"]; arrs[2] = ["洛阳","郑州","开封","周口"]; arrs[3] = ["太原","大同","运城","忻州"]; function selectShi(){ var sheng = document.getElementById('sheng').value; var shi = document.getElementById("shi"); var shis = arrs[sheng]; var str = "<option value=''>请选择市</option>"; for(var i = 0; i < shis.length; i++){ str += "<option value=''>"+ shis[i] +"</option>"; } shi.innerHTML = str; } </script> </html> 输出:

优秀的个人博客,低调大师

Java 基础 之 for 循环

http://www.verejava.com/?id=16992632674123 /** for 循环 定义 : for(初始化变量;判断条件;更新循环变量){} 执行过程: 1. 初始化变量 2. 执行判断条件, 如果true 继续执行,执行完后, 更新循环变量, 再判断条件, 直到 判断条件为 false 退出循环 */ public class ForStatement { public static void main(String[] args) { //打印出0-9 /* 执行过程: 1. 初始化i=0; 2. 执行 i<10 如果为true 执行 System.out.println(i); 执行完后 i++ 再跟 i<10 判断 以此循环直到 i>=10 退出循环 */ for (int i = 0; i < 10; i++) { System.out.println(i); } } } /* while, do while, for 循环的比较 1. while 循环是先判断再循环, do while 是先执行再判断 2. for 循环一般用于下标值访问的情况 问题: 如果我们要在循环的时候中途终止,或退出需要用到 break ,continue */ http://www.verejava.com/?id=16992632674123

优秀的个人博客,低调大师

Java 基础 之 常量

http://www.verejava.com/?id=16992564786810 /* java中常量分为以下几种 1. 整型常量 2. 浮点数常量 3. 字符常量 4. 布尔型常量 5. 字符串常量 */ public class FinalVariable { public static void main(String[] args) { //常量的定义:不可以改变的变量 //1. 整型常量 final int UP=0; final int DOWN=1; final int LEFT=2; final int RIGHT=3; System.out.println(UP); System.out.println(DOWN); System.out.println(LEFT); System.out.println(RIGHT); /* 注意: 1. 常量的定义一般用大写 */ //2. 浮点数常量 final float PI=3.14f; System.out.println(PI); //3. 布尔常量 final boolean RUN=true; System.out.println(RUN); //4. 字符常量 final char A='A'; System.out.println(A); System.out.println('\r'); System.out.println('\''); System.out.println('\"'); System.out.println('\\'); //5. 字符串常量 final String CONST="情意地久天长"; System.out.println(CONST); } } /* 总结: 1. 常量的命名规则跟变量一样 2. 常量一般大写 3. 常量前面加 final 关键字 4. 常量不能改变值 */ http://www.verejava.com/?id=16992564786810

优秀的个人博客,低调大师

Java 基础 之 变量

http://www.verejava.com/?id=1699255231918 /* 注意: 1. 变量命名不允许重复 2. 变量的命名规则: 以字符,下划线,$ ,数字组成,并且开始首字母必须为 字符,下滑线或$ 不能是数字 */ public class TestVariable { public static void main(String[] args) { //变量的定义: 系统分配的一块内存区用来存储数据的地方 //String 存储数据的类型 字符串 : 以双引号" " 括起来的字符或汉字等 //bottle 变量名 //等号 = 代表赋值 也就是说将 "矿泉水" 数据存储到 名称为 bottle的内存区域中 String bottle="矿泉水"; //将变量名为bottle内存区域的数据打印输出到控制台上 System.out.println(bottle); //修改变量的值, 将 "果汁" 替换了bottle内存区域的值 bottle="果汁"; System.out.println(bottle); //清空变量, 清空bottle的内存数据 bottle=""; System.out.println(bottle); //删除变量, 赋值给null值删除变量, 这个时候垃圾回收器 GC 如果扫描到 //bottle 变量会自动回收分配的内存空间 bottle=null; System.out.println(bottle); //注意: //1.变量名是不能重复定义的, 否则编译不能通过 //String bottle="牛奶"; //System.out.println(bottle); //变量的命名规则: 以字符,下划线,$ ,数字组成,并且开始首字母必须为 字符,下滑线或$ 不能是数字 //String 1a="a"; //System.out.println(1a); String $b="b"; System.out.println($b); String _c="c"; System.out.println(_c); } } http://www.verejava.com/?id=1699255231918

优秀的个人博客,低调大师

python网络编程基础

目录 1、udp 2、tcp 3、socket函数 4、粘包问题 标签(空格分隔): 网络编程 目录 tcp和udp 1、udp tcp、udp是第四层传输层拥有的协议,用于在完成寻址功能后的数据传输。传输层将路由交换层和应用数据层划分开,主要提供数据传输控制。 udp的使用是面向无连接的,即协议自身的设计是不保证数据的有序性和重传的,这样的缺点是丢包率增加,并且无法有序的接收数据。不过这两个缺点都可以通过应用层来弥补。而udp的优点是报头小、数据传输效率高(不需要确认、协商各种流控制等等),所以udp更适用于数据需要快速传输,并对数据完整性并不太高的场景。比如:视频直播,要求实时传输,而且可以接受部分的丢帧。 udp报头非常的简单,核心只有端口+校验和 2、tcp tcp的使用是面向连接的,即数据的传输必须基于虚链路的完整建立。虚链路的建立提供了很多优秀的功能,比如确认重传以保证数据的完整性,滑动窗口以保证数据传输的高效性,各类选项字段提供不同的可选功能。tcp的缺点是报头大,因为需要包含比udp更多的功能字段,而且tcp数据的每次发送都必须得到确认否则将会重传。tcp一般应用于对数据完整性要求很高的场景。比如:ssh。 tcp的报头字段比较多,核心有:seq和ack用于处理确认重传、SYN/FIN/RST等用于提供数据包身份标记、窗口用于处理流量控制、还有各种选项。 3、socket函数 为了将路由交换和应用层分离开,socket提供了一个统一的接口供应用层直接调用而无需考虑底层路由交换的通信问题。 所有的操作系统都提供socket调用,python的socket模块也是对底层socket模块的封装,并提供了方便使用的一些函数接口。 1、建立对象 # 实例化一个socket对象,用于处理本地的socket事务,不论是服务器还是客户端都一样 # socket模块提供了很多不同类型的socket,这里选择tcp,使用ipv4 sock = socket.socket(socket.AF_INET, socket.SOCK_STREAM) 2、bind # socket对象可以绑定本地的ip和端口号,这个函数在服务器和客户端均可使用,不过一般不会绑定客户端 # 客户端的ip和端口一般使用随机。 # 服务器一般会固定ip和端口以供大量客户端连接 # 服务器提供的ip会通过dns发布域名 # bind的参数是一个ip+port的元组,如果没有提供ip,则会监听本机所有对外接口ip sock.bind(('127.0.0.1', 8080)) 3、listen # 此函数只应该用于服务器,因为服务器才需要监听端口等待客户主动连接 # 此函数将会告知操作系统监听socket连接 # 此函数的底层操作应该就是完成tcp三次握手 # 此函数的5表示已经完成三次握手的客户端最大数量,但是这些客户端还未与服务器交互数据 sock.listen(5) 4、connect # 此函数只应该用于客户端,因为客户端才需要连接服务器的端口 # 此函数一旦启动,则会在客户端上随机选取本地端口 # 此函数的语义是发起tcp三次握手 sock.connect(('127.0.0.1', 8080)) 5、accept # 此函数应该用于服务器,当tcp三次握手完成之后,服务器通过此函数获取此客户端socket对象和地址。 # 此函数是一个阻塞函数,即,如果服务器没有任何虚链路完成,将会无限阻塞,直到有一个虚链路通过 # listen完成,accept才会返回。 # 如果要服务器提供无限接收客户端的功能,应该循环此函数以提供链路循环 conn, addr = sock.accept() 6、recv # 此函数用于从一个socket对象(管道)中获取数据,而实际上,是从操作系统的网卡缓存中获取数据 # 可以指定需要一次获取的字节数,获取得到的数据是bytes类型,需要decode才方便阅读 # 此函数是一个阻塞函数,即,如果网卡缓存没有任何数据,则会一直阻塞到数据到达为止 msg = conn.recv() 7、send # 此函数用于将bytes类型的数据发送给socket对象(管道),而实际上,是发送给网卡缓存,后续交由 # 操作系统真正的发送数据。 # 此函数非阻塞,可以直接返回,不过要特别注意的是,msg如果为空,此函数可以正确执行,但是实际上 # 操作系统是没有发送数据给对端的。这样会产生一些socket连接的问题,所以要杜绝发空。 conn.send(msg) 8、close # 关闭虚链路 conn.close() 9、getpeername # 获取一个虚链路对端的地址二元组 print(sock.getpeername()) 4、粘包问题 根本原因:tcp面向流,无法区分消息之间的数据边界,固定recv就会导致消息粘包 解决思路:每次recv的时候动态获取,并准确的获取一个消息的长度 解决办法:每一个消息都增加固定长度的报头。每次recv的时候先获取固定长度的报头,从报头中获取本次消息的准确长度,然后再recv完整准确的信息。

优秀的个人博客,低调大师

JavaScript 基础---( window 总结)

window 概念:1.表示浏览器窗口 2.所有 JavaScript 全局对象、函数以及变量均自动成为 window 对象的成员 3.全局变量是 window 对象的属性 4.全局函数是 window 对象的方法 一、方法: 实例1(新建窗口) 运行: 实例2 (更改窗口大小) 实例3(移动窗口)(700,500 是 x 轴 和 Y 轴) 实例4 关闭窗口(点击关闭) 二、windom screen(获取浏览器的宽度和高度) 实例 三、windom location (浏览器地址栏) 实例 四、window History (记录访问该站点的所有页面地址) 实例 其中,history.go(0) 代表当前页面,history.go(-2)代表当前回到之前的之前页面(即后退 2 次)

优秀的个人博客,低调大师

JavaScript基础(四)函数

函数 函数的定义 //第一种:(函数的声明)第一种定义方法最强大,定义完毕后,在哪里使用都可以,无位置限制。 function fn1(){ console.log("我是第一种定义方法!"); } //第二种(函数表达式:匿名函数) :后两种定义方法是有局限性的。(使用函数必须在定义函数之后) var fn2 = function (){ console.log("我是第二种定义方法!"); }; // 注意分号 function (){ console.log("我是第二种定义方法!"); }(); // 第二种方式的调用方式之一:函数的自调用 //第三种 var fn3 = new Function("console.log('我是第三种定义方法!')"); 函数的调用 函数名(); 函数名 要遵循驼峰命名法。 不能同名(函数重载),否则后面的函数会覆盖前面的函数。 //打印函数名,就等于打印整个函数。 console.log(fn); //打印执行函数,就等于打印函数的返回值。 console.log(fn()); 形参和实参 形参不需要写 var. 形参的个数和实参的个数可以不一致 。 返回值 1. 如果函数没有显示的使用 return 语句 ,那么函数有默认的返回值:undefined2. 如果函数使用 return语句,但是return后面没有任何值,那么函数的返回值也是:undefined. 变量和作用域 全局变量:在 script 使用 var定义的变量和没有 var 的变量(所有的 script 共享其全局性,js里面没有块级作用域概念,只有全局作用域和局部作用域)。 隐式全局变量:在 script 没有 var 的变量。 function fn(){ var a = b = c = 1; // b和c就是隐式全局变量(等号) var a = 1; b = 2; c = 3; // b和c就是隐式全局变量(分号) var a = 1 , b = 2 , c = 3; // b和c就不是隐式全局变量(逗号) } (全局变量是不能被删除的,隐式全局变量是可以被删除的) var num1 = 10; num = 20; delete num1; delete num2; console.log(typeof num1); // number console.log(typeof num2); // undefined 局部变量:函数内部用 var 定义的变量和形参。 变量声明提升(预解析) 作用:查看语法错误。js的解析器在页面加载的时候,首先检查页面上的语法错误。把变量声明提升起来。变量声明提升和函数整体提升。 变量的提升 只提升变量名,不提升变量值。 consolas.log(aaa);// 打印的结果是 undefined ,因为只提升变量名,不提升变量值。 var aaa = 111; 在函数范围内,照样适用。 函数的提升 function 直接定义的方法:整体提升(上面说的第一种函数定义的方法). fn(); var aaa = 111; function fn(){ //变量声明提升在函数内部照样实用。 //函数的就近原则(局部变量作用域),打印的aaa不是111,而是 undefined。 console.log(aaa); // undefined var aaa = 222; } 预解析会分块: 多对的 script 标签中函数重名的话,预解析不会冲突。也就是预解析的作用域是每一个的 script 标签。 var先提升,function再提升: 示例: console.log(a); // 输出a函数体 function a() { console.log("aaaaa"); } var a = 1; console.log(a); // 输出1 打印第一个结果的时候,var会提升,之后 function 再提升,但是函数a和变量a重名,function的a在后面覆盖掉变量a,所以第一个输出 a 函数体. 第二个前面var a = 1;提升之后,这个位置就相当于只有 a = 1; 赋值,所以第二个打印1. 匿名函数 //1.直接调用 (function (){ console.log(1); })(); //2.绑定事件 document.onclick = function () { alert(1); } //3.定时器 setInterval(function () { console.log(444); },1000);

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册