首页 文章 精选 留言 我的

精选列表

搜索[计算机基础],共10000篇文章
优秀的个人博客,低调大师

JavaScript基础(五)数组

数组 数组定义 通过字面量定义数组: var arr = [10,20,30]; 通过构造函数定义数组: var arr = new Array(参数); // 参数位置为一个数值时为数组长度,多个数值时为数组中的元素。如果没有参数的时候 Array后面的括号可以省略。 数组操作 数组长度: 数组名.length; 数组中存储的数据类型一定是一样的吗? 类型可以不一样。 数组的长度是不是可以改变呢? 可以改变。 数组高级API 1、判断数组和转换数组 instanceof // 是一个关键字,判断A是否是B类型。 isArray() //HTML5中新增 ,判断是不是数组 toString() //把数组转换成字符串,每一项用,分割 valueOf() //返回数组对象本身 join(变量) //根据每个字符把数组元素连起来变成字符串变量可以有可以没有。不写默认用逗号分隔,无缝连接用空字符串。 instanceof var str1 = new String("abc"); var str2 = "abc"; console.log(str1 instanceof String); // true console.log(str2 instanceof String); // false join //join是把数组元素用特殊方式链接成字符串(参数决定用什么链接,无参默认用逗号链接) var arr = ["关羽","张飞","刘备"]; var str1 = arr.join(); var str2 = arr.join(" ");//如果用空格的话,那么元素之间会有一个空格 var str3 = arr.join("");//用空字符串,链接元素,无缝连接 var str4 = arr.join("&"); console.log(str1); console.log(str2); console.log(str3); console.log(str4); arguements 只在函数中使用,代表传入实参的数组。 arguements 是伪数组:不能修改长短的数组。(可以修改元素,但是不能变长变短) fn(1,2); fn(1,2,3); fn(1,2,3,4,5); function fn(a,b){ //只在函数中使用,实参的数组。 arguments[0] = 0; // 可以修改内容 console.log(arguments); //伪数组:不能修改长短的数组。(可以修改元素,但是不能变长变短) arguments.push(1); console.log(arguments instanceof Array); // false //形参个数 console.log(fn.length); //实参个数 console.log(arguments.length); // 形参和实参个数可以不同,因为实参传入的时候可以形参的个数不一样。 // arguments.callee相当于函数名,这里打印整个函数。 console.log(arguments.callee); } 2、数组增删和换位置(原数组讲被修改) push() //在数组最后面插入项,返回数组的长度 //数组1改后的长度 = 数组1.push(元素1); pop() //取出数组中的最后一项,返回最后一项 //被删除的元素 = 数组1.pop(); unshift() //在数组最前面插入项,返回数组的长度 //数组1改后的长度 = 数组1.unshift(元素1); shift() //取出数组中的第一个元素,返回最后一项 //被删除的元素 = 数组1.shift(); reverse() //翻转数组(原数组讲呗反转,返回值也是被反转后的数组) //反转后的数组 = 数组1.reverse(); sort(); //给数组排序,返回排序后的数组。如何排序看参数。 //从小到大排序后的数组 = 数组1.sort(function(a,b){ // return a-b; //}); sort var arr2 = [7,6,15,4,13,2,1]; console.log(arr2); // 7,6,15,4,13,2,1 console.log(arr2.sort()); // 1,13,15,2,4,6,7 问题:只能通过第一位排列。(对首字母的 unicode 编码进行排序) 解决:sort方法不稳定,设计的时候就是这么设计的,可以通过回调函数进行规则设置。 console.log(arr2); console.log(arr2.sort(function (a,b) { return a-b; //升序 //b-a:降序 })); 迭代方法 代替 for 循环。 every every()他的返回值是一个 boolean 类型值。而参数是一个回调函数。 参数有三个。名字随便起,但是表示的意思还是这样顺序的。 var arr = ["关长","张飞","赵子龙","马超","黄忠"]; // function (element,index,array) // element:数组元素的值 // index:索引 // array:调用这个方法的整个数组对象(一般不用) arr.every(function(fff,www,ggg) { console.log(fff); console.log(www); console.log(ggg); return true; }); // 关长 // 0 // ["关长", "张飞", "赵龙", "马超", "黄忠"] // 张飞 // 1 // ["关长", "张飞", "赵龙", "马超", "黄忠"] // 赵龙 // 2 // ["关长", "张飞", "赵龙", "马超", "黄忠"] // 马超 // 3 // ["关长", "张飞", "赵龙", "马超", "黄忠"] // 黄忠 // 4 // ["关长", "张飞", "赵龙", "马超", "黄忠"] var arr = ["青花瓷", "一路向北", "轨迹"]; var flag = arr.every(function (ele, index) { // 只要有一个没满足条件,就返回false ele.length > 2; }); console.log(flag); // false filter filter返回值是一个新数组。return为 true 的数组。 var arr = ["关长","张飞","赵子龙","马超","黄忠"]; var arr1 = arr.filter(function (ele,index,array) { if(ele.length>2){ return true; } return false; }); console.log(arr1); // ["赵子龙"] foreach foreach遍历数组(无返回值,纯操作数组中的元素) var arr = ["关长","张飞","赵子龙","马超","黄忠"]; var str = ""; arr.forEach(function (ele,index,array) { str+=ele; }); console.log(str); // 关长张飞赵子龙马超黄忠 map map有返回值,返回什么都添加到新数组中。 var arr = ["关长","张飞","赵子龙","马超","黄忠"]; var arr2 = arr.map(function (ele,index,array) { return ele+"你好"; }) console.log(arr2); // (5) ["关长你好", "张飞你好", "赵子龙你好", "马超你好", "黄忠你好"] some some有返回值,如果函数结果有一个是true,那么some方法结果也是true。 var arr = ["关长","张飞","赵子龙","马超","黄忠"]; var flag = arr.some(function (ele,index,array) { if(ele.length>2){ return true; } return false; }) console.log(flag); // true push 向数组的末尾添加一个或更多元素,并返回新的长度。 注意: 新元素将添加在数组的末尾。 注意: 此方法改变数组的长度。 提示: 在数组起始位置添加元素请使用 unshift() 方法。 pop 删除数组的最后一个元素并返回删除的元素。 注意:此方法改变数组的长度! 提示: 移除数组第一个元素,请使用 shift() 方法。 了解方法 concat() //把参数拼接到当前数组 //新数组 = 数组1.concat(数组2); slice() //从当前数组中截取一个新的数组,不影响原来的数组,参数start从0开始,end从1开始 //新数组 = 数组1.slice(索引1,索引2); splice()//删除或替换当前数组的某些项目,参数start,deleteCount,options(要替换的项目) //新数组 = 数组1.splice(起始索引,结束索引,替换内容); indexOf()、lastIndexOf() //如果没找到返回-1 //索引值 = 数组.indexOf/lastIndexOf(数组中的元素); forEach() // 数组每个元素都执行一次回调函数。 清空数组 var array = [1,2,3,4,5,6]; // 方法一:删除数组中所有项目 array.splice(0,array.length); // 方法二:length属性可以赋值,其它语言中length是只读 array.length = 0; // 方法三: array = []; //推荐

优秀的个人博客,低调大师

1 框架基础搭建

一、新建一个Cordova项目 cordova create PSDPlatform cd PSDPlatform 二、 新建vonic-webpack模板 项目使用Vonic作为UI模板,开发者提供了一个Vonic的开发脚手架,即如下网址:https://github.com/wangdahoo/vonic-webpack-starter git clone https://github.com/wangdahoo/vonic-webpack-starter.git cd vonic-webpack-starter npm install -g yarn yarn 注意事项: 在安装vonic模板过程中,可能会出现node-sass安装Error,出错解决方案为: 1.npm install node-sass --registry=http://registry.npm.taobao.org 2.yarn 三、Cordova 环境配置 CD 项目根目录 cordova platform add android --新增android 平台

优秀的个人博客,低调大师

JVM调优基础

1. JVM命令功能 jcmd help jhat: 读取内存堆转存 jmap: 提供转存和内存使用信息 jinfo:查看jvm的系统属性,也可以是设置系统属性,可用于脚本 jstack: 转存java进程信息,可用于脚本 jstat: 提供GC和类装载活动的信息,可用于脚本 jvisualvm: 可视化工具 jstat -J-Djstat.showUnspported=true -snap 5376 -- 获得监控信息 -XX:ReservedCodeCacheSize=N 标志可以设置代码缓存最大值-XX:InitialCodeCacheSize=N 代码缓存从初始大小开始分配 1.1 常用信息 1.错误信息:C: C帧, j: java帧 V: VM帧 v:VM生成的stub帧,J:其它帧,含java帧(编译) 2: TPS:每秒事物数,比如执行了dml操作,那么相应的tps会增加 RPS: 每秒请求数,并发数/平均响应时间 OPS:每秒操作次数 QPS是指每秒内查询次数,比如执行了select操作,相应的qps会增加。 PV 是指页面被浏览的次数,比如你打开一网页,那么这个网站的pv就算加了一次; 3 vmstate 1: 单个线程,CPU内存等监控, iostat -xm 5 , nicstat 5: 监控网络信息 4 JVM内部线程状态: _thread_uninitialized _thread_new _thread_in_native _thread_in_vm _thread_in_java _thread_block _<thread_state_type>_trans 5.JVM状态 not at a safepoint: 正常执行的状态 at safepoint: 所有线程阻塞,等待VM完成专门的VM操作(VM operation) synchronizing : VM接到一个专门的VM操作请求,等待VM中所有现场阻塞 2. JVM保留内存和分配内存之间的差别: 编译是基于JVM计数器: 方法调用计数器和方法中的循环回边计数器, 当方法或循环 编译的时候,就会进入编译队列,队列有一个或多个后台线程处理.也就是异步的,并不是严格先进先出,调用计数次数多的方法有更高优先级,也就是PrintCompilation输出中ID乱序的原因. OSR(on-stack Replacement): 在循环进行的时候还能编译循环,在循环代码编译结束后,JVM会替换在栈上的代码,循环的下一次就行快的多的代码 -XX:CompliThreshold=Nclient默认1500,server默认10000,一般不用修改),这个数值是回边计数器和方法调用次数的总和 -XX:PrintCompilation(默认false):每编译一个循环和方法就输出编译内容 -XX:CICompilerCount=N :JVM 处理队列的线程总数 -XX:+BackgroundCompilation(默认为true,即异步处理,也可以改为false,一个方法适合编译就一直等到他确实被编译) jstat -compiler 8895 输出这个pid的编译过的方法,有时也会出现编译失败的方法 jstat -printcompilation 8895 1000 (每秒钟输出一次编译的方法) -XX:-Inline (默认开启,关闭的话严重影响性能)-XX:PrintInlining 生成内联信息 方法是否内联取决于: 多热和它的大小,只有字节码小于325字节才会或者小于35字节-XX:MaxFreqInlineSize=N -XX:MaxInLineSize=N 逃逸分析-XX:+DoEscapeAnalysis(默认为true) 逆优化 (意味着编译器不得不撤销之前的优化): (1) 代码状态为"made not entrant"(代码被丢弃) -原因: 可能和类与接口的工作方式有关,也可能与分层编译的实现有关 (2) "made zombie"(产生僵尸代码) client编译的结果后来server编译更优化的结果 编译级别: C1编译器有3种级别,所以总有5种编译级别 0: 解释代码 1: 简单的C1编译代码 2: 受限的C1编译代码 3: 完全的C1编译代码 4: C2编译代码 目前主流的4个GC算法: 1: Serial : -XX:+UseSerialGC 2: Throughput(Parallel): 7之后默认,使用多线程收集Eden区, -XX:+UseParalleGC -XX:+UseParallelOldGC 3: Concurrent (CMS): 修改之前UseParalleGC算法收集Eden区,改用 -XX:UseParNewGC收集Eden, -XX:+UseConcMarkSweepGC 后台线程扫描Old区的垃圾对象,停顿时间少, 问题: (1)占用CPU线程资源,(2)内存碎片化严重,最后变成Serial(间隔时间长),整理好内存之后重复之前 4: G1: -XX:+UseG1GC, 属于Concurrent收集器,老年代的收集工作由后台线程完成,大多数不需要暂停应用线程,由于老年代被划分到不同的 区域,G1收集器通过将对象从一个区域复制到另外一个区域,完成对象的清理工作,这也意味着G1实现了堆的压缩整理(至少是部分整理) System.gc() 会触发Full GC -Xms4096m -Xmx4096m 设置一样大就不需要估算堆是否需要调整大小了 -XX:NewRatio=N(默认2): 新生代与老年代的空间占用比率 Initial Yong Gen size = Initial Heap Size / (1+NewRatio) --> 默认新生代占 1/3 -XX:NewSize=N 直接设置新生代初始的大小 -XX:MaxNewSize: 设置新生代最大大小 -XX:PermSize=N, -XX:MaxPermSize=N 设置永久区的大小 -XX:MetaspaceSize=N -XX:MaxMatespaceSize=N 调整 除了SerialGC之外几乎所有的GC都是使用多线程,启动线程数由 -XX:ParalleGCThreads=N控制-XX:+UseParallelGC -XX:+UseParNewGC -XX:+UseG1GC 收集新生代空间-XX:+UseParallelOldGC 收集老年代空间估算公式: ParalleGCThreads = 8 + ((N-8)*5/8), 每超出5/8个CPU启动一个新的线程(可能会略高,需适当调整) -XX:-UseAdaptiveSizePolicy(默认开启) 可以在全局范围内关闭自适应调整功能,如果堆容量最大值和最小值设置同样的值,与此同时,新生代的最大值和最小值也设置为同样的值,自适应功能将会被关闭 -XX:PrintAdaptiveSizePolicy: 一旦发生GC会在日志中包含GC不同空间调整的信息 -verbose:gc 或 -XX:+PrintGC -XX:+PrintGCDetails(默认关闭) -XX:+PrintGCTimeStamps -XX:+PirntGCDateStamps -XX:+UseGCLogfileRotation -XX:NumberOfGCLogfiles=N -XX:GCLogfileSize=N 组合使用可以控制循环输出日志 文件大小不足8kb按照8kb算 查看日志可以使用 gchisto 或者jstat -gcutil pid 1000 每秒输出日志信息 GC回收算法 1. Throughput 收集器 回收新生代的垃圾 Minor GC 回收老年代垃圾 Full GC -XX:MaxGCPauseMillis=N 设定应用可承受最大停顿时间 -XX:GCTimeRatio=N 设置你希望应用程序在垃圾回收上花费多少时间(与应用线程的运行时间相比) 公式: ThroughputGoal=1-1/(1+GCTimeRatio) 默认是99,也就是运行程序占99%,只有1%的时间消耗在垃圾回收上 2. CMS收集器 CMS会对新生代的对象进行回收 ParNew(所有线程都会被暂停) CMS会启动一个并发线程对老年代空间进行垃圾回收,(不会内存整理) 如有必要,CMS会发起 Full GC CMS收集步骤: 1: Init-mark: 找到堆中所有垃圾回收根节点对象 2: current-mark: 和应用程序并行,标记,(可能还会产生垃圾) 3: preclean-start: 预处理,与应用程序并行 4: remark(多个阶段),不是并发,STW 5: concurrent-sweep: 与应用程序并行 6: concurrent-reset: 并发重置 CMS可能会产生的问题: concurrent mode failure:新生代发生GC,同时老年代又没有足够的空间容纳晋升的对象时,CMS GC就会退化成Full GC,所有的应用线程都会暂停,老年代对象进行回收,这个操作是单线程的,所以非常耗时 老年代有足够的空间容纳晋升的对象,但是空间非常碎片化,导致晋升失败. 这时新生代暂停了所有的应用线程,专门在老年代整理碎片内存,好消息是内存碎片整理完了,但是会有很长时间停顿,这比并发模式失效停顿的时间还长.(因为并发模式失效时只需要整理堆里无效的对象) 针对并发模式失效的调优: 增大老年代空间 以更高的频率运行后台回收线程 使用更多的后台线程 注意点:1. CMS与其他回收算法的显著不同就是:除非发生Full GC,否则CMS的新生代大小不会调整.CMS的目标就是尽量避免Full GC, 可以使用: MaxPauseMllis=N和GCTimeRatio=N来确定使用多大的堆和多大的空间 2. 给后台线程更多的运行机会: -XX:CMSInitiatingOccupancyFraction=N和-XX+UseCMSInitiatingOccupanyOnly(默认70,即CMS在老年代空间占70%时启动并发收集周期调整) 调整后台线程: -XX:ConcGCThreads=N增加后台线程,ConcGCThreads=(3+ParallelGCThreads) / 4 3. CMS不会处理永久代的垃圾,如果耗尽会产生一次Full GC来回收垃圾,可以设置: -XX:+CMSPermGenSweepingEnable(默认false)标志开启和老年代同样的回收方式,后台开启一组线程并发回收永久代中的垃圾,同时配合:+XX:CMSInitiatingPermOccupancyFrantion=N指定在永久代占用达到比例值时开启回收线程. java8 CMSPermGenSweepingEnable标志默认开启 4: 增量式CMS,(java8种不推荐使用) 当CPU资源有限,后台线程会间歇性暂停,让出一部分CPU给应用线程 开启: -XX:+CMSIncrementalMode, 设置: -XX:CMSIncrementalSaftyFactor=N,-XX:CMSIncrementalDutyCycleMin=N,-XX:CMSIncrementalPacing可以控制GC线程为应用线程让出多少CPU G1收集器 分区(Region)一般分为2048个区域,专注于垃圾最多的分区,用最少的时间回收最多的垃圾 新生代进行回收时,要么被回收,要么被晋升,新生代采用分区机制的部分原因是采用预定义的分区能够便于代的大小调整 主要包括4种操作: 1.新生代垃圾收集 2.后台收集,并发周期 3.混合式垃圾回收(不仅进行新生代的GC同时也回收部分后台扫描线程标记的分区) 4.以及必要的Full GC 操作步骤: 1:initial-mark(STW) 2: root-scan(并发) 3: conc-mark 4:remark 5: conc -clean G1注意: 1: 并发模式失效:,在G1启动标记周期,但老年代在周期完成之前就被填完,G1会放弃标记周期,(GC-concurrent-mark-abort)2:晋升失败: G1完成了标记阶段,开始启动混合式垃圾回收,清理老年代分区,不过,老年代空间在垃圾回收释放出足够内存之前就会被耗尽. 一般都是混合式回收之后就是Full GC 3:疏散失败:进行新生代垃圾回收时,S区和老年代中没有足够的空间容纳所有的幸运对象.这表明堆已经几乎用完或者碎片化了.转用Full GC,性能下降,最简单的解决办法就是增加堆 4:巨型对象分配失败也可能会导致Full GC G1 调优: G1调优的主要目标就是避免发生并发模式失败或者疏散失败 -XX:MaxGCPauseMillis=N(默认200ms,这个CMS有所不同) 1:调整G1的后台线程数,可以使用ParallelGCThreads设置运行的线程数,计算方式ConcGCThreads=(ParallelGCThreads+2)/4 这个和CMS也不同 2: -XX:InitiatingHeapOccupancyPercent=N(默认45),堆占用比例,如果设置过高会陷入Full GC泥潭中,因为并发阶段没有足够的时间在剩下的堆空间被填满之前完成垃圾回收,如果设置过小又会以超过实际的节奏在后台大量处理 3:调整G1收集器混合式垃圾收集周期:混合式垃圾收集取决于三个因素(1)有多少分区被发现大部分是垃圾对象,默认超过35%就会标记为可进行垃圾回收,实验版标志: -XX:G1MixedGCLiveThresholdPercent=N (2)G1垃圾回收分区时最大混合式GC周期数,参数 -XX:G1MixedGCCountTarget=N(默认8),减少该值可以解决晋升失败的问题(代价是混合式GC周期的停顿时间会更长) (3)GC停顿可忍受的最大时常,参数-XX:MaxGCPauseMillis 4:2种情况下会被移动到老年区: (1):S区实在太小,S区被填满之后,Eden区剩下的活跃的对象直接放到Old区,(2)在S区经历的GC周期的个数上限(Tenuring Threshold) 5: S区是新生代的一部分,跟堆内存的其他区域一样,JVM可以对他动态调节,参数: -XX:InitialSurvivorRatio=N(默认8)决定, survivor_space_size=new_size / (initial_survivor_ratio+2) JVM可以增大S区空间直至最大上限, -XX:MinSurvivorRatio(默认3)设置(注意参数在分母,名字不直观),maximum_survivor_space=new_size / (min_survivor_ratio + 2), -XX:TargetSurvivorRatio=N可以在Survivor空间调整之后能保证垃圾回收之后有50%的空间是空闲的. 6: -XX:InitialTenuringThreshold=N可以设置初始晋升阈值(Throughput和G1的默认值7,CMS默认值是7),JVM最终会在1和最大阈值(-XX:MaxTenuringThreshold=N)之间选择一个合适的值, 对于Throughput和G1,最大值默认15,CMS最大默认6) 7:-XX:PrintTenringDistribution标志可以在GC中增加这些信息 8: TLAB的大小由三个因素决定: (1)应用线程的线程数(2)Eden空间的大小(3)线程分配率,默认开启,-XX:-UseTLAB可以关闭. -XX:TLABSize=N可以显示的指定TLAB的大小(默认为0,由Eden区的大小动态计算出),这个标志只能设置TLAB的初始大小,为了避免每次GC时都调整TLAB的大小可以使用 -XX:-ResizeTLAB,TLAB调整时,最小容量可以使用:-XX:MinTLABSize=N设置(默认2kb),最大容量略小于1GB 9: -XX:+PrintTLAB输出信息 G1分区大小: size=1<<log(初始堆的大小/2048), 分区最小1MB,最大不能超过32MB, 堆的大小: 堆的大小 Region Size < 4GB 1MB 4GB - 8GB 2MB 8GB - 16GB 4MB 16GB - 32GB 8MB 32GB - 64GB 16MB > 64GB 32MB G1分区的大小可以通过-XX:G1HeapRegionSize=N设置(默认0,动态计算出),选择合适的大小,使分区数量接近于: 2048个 堆内存 1.jmap -dump:live,file=/path/heap.dump.hprof pid, jmap有live选项会在堆转储之前强制执行一次Full GC, jcmd默认就会这么做 jcmd pid GC.heap_dump /path/heap_dump.hprof -XX:+HeapDumpOnOutOfMemoryError(默认false)会在抛出OutofMemoryError时转储 -XX:HeapDumpPath=/path 指定堆转储位置,默认java_pid.hprof -XX:+HeapDumpAfterFullGC:在运行一次Full GC之后生成一个堆转储 -XX:+HeapDumpBeforeullGC:会在一次Full GC之前生成一个堆转储文件 3: Exception in thread 'main' java.lang.OutOfMemoryError: GC overhead limit exceeded:原因: (1) 花在Full GC上的时间超出了-XX:GCTimeLimit=N(默认98,也就是98%的时间花在了GC上了) (2):一次Full GC回收的内存量少于-XX:GCHeapFreeLimit=N设置的值,默认值2,即意味着如果Full GC期间释放的内存不足堆的2%,(3)上面2个条件连续5次Full GC都成立(这个值无法调整) (4):-XX:+UseGCOverHeadLimit标志的值为true(默认true) 请注意:所有四个条件都满足的时候才会报错,如果连续4次Full GC都成立,作为释放内存的最后一搏,JVM中所有的软引用都会在第五次Full GC之前被释放 减少内存使用(减少对象大小,对象延迟初始化,规范化对象) 1.对普通对象,对象头字段在32位JVM上占8字节,在64位JVM上占16字节,对于数组,对象头在32位JVM以及堆小于32GB的64位JVM上占16字节,其他情况是64字节 2.不可变对象:基本的数据类型Double,Boolean,以及一些基于数值的类型,BigDeciaml,String,像这类不可变对象的单一化表示,就被称为标准化(canonical)版本,类似有String.intern 例如: 创建一个Map来保存该对象的标准化版本,为防止内存泄漏,采用WeakHashMap class ImmutableObject{ WeakHashMap<ImmutableObject,ImmutableObject> map = new WeakHashMap<>(); public ImmutableObject canonicalVersion(ImmutableObject io){ synchronized (map){ ImmutableObject cv = map.get(io); if(cv == null){ map.put(io,io); cv = io; } return cv; } } } String提供了自己的标准化方法,intern()方法.保留字符串的表是保留在原生内存中的,他是一个大小固定的HashTable,在Java 7u40之前默认是1009个桶,之后的版本中,默认改为60013个 可以通过-XX:StringTableSize=N设置,输出信息: -XX:+PrintStringTableStatistics(默认false) 对象重用的方式: 对象池和ThreadLocals,注意:被重用的对象会在堆中停留很长时间,如果有大量对象存于堆中,那用来创建新对象的空间就少了.并且会通过Eden S0 S1最终才会进入Old区,执行一次Full GC所化的时间与老年代中仍然存活的对象数量成正比,存活对象的数量甚至比堆的大小更重要. 线程池: 线程初始化成本高 JDBC池: 数据库连接初始化的成本高 EJB池: EJB初始化成本高 大数组:java要求,一个数组在分配的时候,其中的每个元素都必须初始化为某个默认初始值(null,0,false) 原生NIO缓冲区:不管缓冲区多大,分配一个直接java.nio.Buffer(即调用allocateDirector()方法返回的缓冲区) 安全相关的类: MessageDigest,Signature以及其他安全算法的实例 字符串编解码对象,大多数都是软引用 StringBuilder协助者:BigDecimal类在计算中间结果时会重用一个StringBuilder对象 随机数生成器: Random和SecureRandom类,生成这些类代价较高 从DNS查询到的名字:网络查询代价很高 ZIP编解码器:初始化开销不是特别高,但是释放成本很高,因为这些对象要依赖对象终结操作(finalization)来确保释放掉所用的原生内存. 对象池: (1)GC影响,降低GC效率 (2)同步: 对象池必然是同步 (3)限流(Throttling):对于稀缺的资源访问,线程池可以起到限流的作用.同时也意味着,超出的部分会等待资源. 线程局部变量:(1)生命周期管理 (2)基数性(Cardinality):线程局部变量通常会伴生线程数与保存的可重用对象数之间一一对应的关系.(3)不需要同步 注意: 初始化一个Random对象的开销非常大,而且持续创建这个类的实例,与再多个线程间共享一个类实例的同步瓶颈相比,性能可能更差.使用TreadLocalRandom类性能会更好. -XX:+PrintReferenceGC(默认false),可以输出调试信息 软引用的释放: (1):所引用的对象不能有其它的强引用,如果软引用是指向其所引用对象的唯一引用,而且该引用最近没有被访问过,则所引用对象会在下一次GC周期前释放. long ms = SoftRefLRUPolicyMSPerMB * AmountOfFreeMemoryInMb if(now - last_access_to_reference > ms) free the reference (2) 堆空间空闲内存的数量,例如堆空间4GB,再一次Full GC之后,堆可能被占用了50%,因此空闲堆是2GB,SoftRefLRUPolicyMSPerMB的默认值1000,意味着 过去的 2048s内没有访问到的任何软引用都会被清理. 如果4GB的堆占了75%,则过去的1024s没有访问到的软引用会被回收. log ms = 2048000;//2048*1000 if(System.currentTimeMillis()- last_access_to_reference_in_ms ms) free the reference 注意: 对于长期运行的应用,如果满足以下2个条件,可以考虑增加SoftRefLRUPolicyMSPerMB的值: (1)有很多空闲堆可用 (2)软引用会频繁访问 ,(不过情况罕见,增加软引用的策略值就是告诉JVM不到万不得已不要释放软引用) 软引用:当问题中的所引用对象会同时被几个线程使用时,考虑弱引用,否则入弱引用很可能会被GC掉,只有弱引用的对象在每个GC周期都可以回收 原生内存的使用 1.从Java8开始: -XX:NativeMemoryTracking=off|summary|detail 标志来跟踪JVM如何分配原生内存. 也可以使用-XX:+PrintNMTStatistics(默认false)启动 ,前提需要设置-XX:+UnlockDiagnosticVMOptions 2: 开启压缩指针: -XX:+UseCompressedOops(默认启用的) Ordinary object pointer tables Area Cool cold 2 is right $1800 col is 2 left $0099

优秀的个人博客,低调大师

Java基础巩固——反射

什么是反射 反射机制就是指程序运行时能够获取自身的信息。在Java中,只要给出类的名字,就可以通过反射机制来获取类的信息 哪里用的到反射机制 在jdbc中就是使用的反射来实例化对象,比如:Class.forName("com.mysql.jdbc.Driver.class").newInstance(); 框架都用到反射机制,spring,hibernate、struts都是用反射机制实现的。 反射机制的优点和缺点 为什么要用反射机制?直接创建对象不就可以了吗,这就涉及到了动态与静态的概念, 静态编译:在编译时确定类型,绑定对象,即通过。 动态编译:运行时确定类型,绑定对象。动态编译最大限度发挥了java的灵活性,体现了多 态的应用,有以降低类之间的藕合性。 一句话,反射机制的优点就是可以实现动态创建对象和编译,体现出很大的灵活性,特别是在J2EE的开发中. 它的灵活性就表现的十分明显。比如,一个大型的软件,不可能一次就把把它设计的很完美,当这个程序编译后,发布了,当发现需要更新某些功能时,我们不可能要用户把以前的卸载,再重新安装新的版本,假如这样的话,这个软件肯定是没有多少人用的。采用静态的话,需要把整个程序重新编译一次才可以实现功能的更新,而采用反射机制的话,它就可以不用卸载,只需要在运行时才动态的创建和编译,就可以实现该功 能。 它的缺点是对性能有影响。使用反射基本上是一种解释操作,我们可以告诉JVM,我们希望做什么并且它 满足我们的要求。这类操作总是慢于只直接执行相同的操作。 利用反射机制能干什么 Class c=Class.forName("className");注明:className必须为全名,也就是得包含包名,比如,cn.netjava.pojo.UserInfo; Object obj=c.newInstance();//创建对象的实例 获取构造器 Constructor getConstructor(Class[] params)//根据指定参数获得public构造器 Constructor[] getConstructors()//获得public的所有构造器 Constructor getDeclaredConstructor(Class[] params)//根据指定参数获得public和非public的构造器 Constructor[] getDeclaredConstructors()//获得public的所有构造器 获取类的方法 Method getMethod(String name, Class[] params),根据方法名,参数类型获得方法 Method[] getMethods()//获得所有的public方法 Method getDeclaredMethod(String name, Class[] params)//根据方法名和参数类型,获得public和非public的方法 Method[] getDeclaredMethods()//获得所以的public和非public方法 获取类的属性 Field getField(String name)//根据变量名得到相应的public变量 Field[] getFields()//获得类中所以public的方法 Field getDeclaredField(String name)//根据方法名获得public和非public变量 Field[] getDeclaredFields()//获得类中所有的public和非public方法 使用实例 获取类属性: public class TestGetField extends Object { private static final long serialVersionUID = -2862585049955236662L; public static void main(String args[]) throws Exception { Class<?> clazz = Class.forName("reflect.TestGetField"); System.out.println("===============本类属性==============="); // 取得本类属性 Field[] fields = clazz.getDeclaredFields(); getField(fields); System.out.println("==========实现的接口或者父类的属性=========="); // 取得实现的接口或者父类的属性 Field[] fatherField = clazz.getFields(); getField(fatherField); } public static void getField(Field[] fields) { for (Field field : fields) { // 权限修饰符 int mo = field.getModifiers(); String priv = Modifier.toString(mo); Class<?> type = field.getType(); System.out.println(priv + " " + type.getName() + " " + field.getName() + ";"); } } } 获取类的方法: public class TestGetMethod implements Serializable{ private static final String testString= "hello"; public static void main(String args[]) throws Exception{ Class<?> clazz = Class.forName("reflect.TestGetMethod"); Method[] methods = clazz.getMethods(); for (Method method :methods){ Class<?> returnType = method.getReturnType(); Class<?> para[] = method.getParameterTypes(); int temp = method.getModifiers(); System.out.print(Modifier.toString(temp)); System.out.print(returnType.getName()); System.out.print(method.getName()); for (Class par:para){ System.out.println(par.getName()); } } } } 实例化类: public class TestNewInstance { public static void main(String[] args) throws Exception{ Class<?> class1 = null; class1 = Class.forName("reflect.User"); // 第一种方法,实例化默认构造方法,调用set赋值 User user = (User)class1.newInstance(); user.setAge(20); user.setName("adf"); System.out.println(user); // 第二种 取得全部的构造函数 使用构造函数赋值 } } class User { private int age; private String name; public User() { super(); } public User(String name) { super(); this.name = name; } public User(int age, String name) { super(); this.age = age; this.name = name; } public int getAge() { return age; } public void setAge(int age) { this.age = age; } public String getName() { return name; } public void setName(String name) { this.name = name; } @Override public String toString() { return "User [age=" + age + ", name=" + name + "]"; } } 使用类的方法: public class TestUseMethod { public static void main(String[] args)throws Exception{ Class<?> clazz = Class.forName("reflect.TestUseMethod"); // 调用reflect1方法 Method method = clazz.getMethod("reflect1"); method.invoke(clazz.newInstance()); // 调用reflect2方法 method = clazz.getMethod("reflect2", int.class, String.class); method.invoke(clazz.newInstance(),20,"test"); } public void reflect1() { System.out.println("Java 反射机制 - 调用某个类的方法1."); } public void reflect2(int age, String name) { System.out.println("Java 反射机制 - 调用某个类的方法2."); System.out.println("age -> " + age + ". name -> " + name); } } 动态代理: public class TestProxy { public static void main(String args[]) throws Exception{ MyInvocationHandler demo = new MyInvocationHandler(); Subject subject = (Subject) demo.bind(new RealSubject()); System.out.println(subject.say("janti",20)); } } interface Subject{ public String say(String name, int age); } // 定义真实项目 class RealSubject implements Subject { public String say(String name, int age) { return name + " " + age; } } //如果想要完成动态代理,首先需要定义一个InvocationHandler接口的子类,已完成代理的具体操作。 class MyInvocationHandler implements InvocationHandler{ private Object object = null; public Object bind(Object obj){ this.object = obj; return Proxy.newProxyInstance(obj.getClass().getClassLoader(),obj.getClass().getInterfaces(),this); } @Override public Object invoke(Object proxy, Method method, Object[] args) throws Throwable { Object temp = method.invoke(this.object,args); return temp; } } 个人博客网站 http://www.janti.cn

优秀的个人博客,低调大师

QTQuick控件基础(2)

import QtQuick 2.2import QtQuick.Controls 1.2import QtQuick.Window 2.1ApplicationWindow { visible: true width: 640 height: 480 title: qsTr("Hello World") menuBar: MenuBar{ Menu{ title: qsTr("File") MenuItem{ text: qsTr("EXIT") onTriggered: Qt.quit() } } } Column{ spacing: 10 //button Button{ x:10;y:10;width: 140 text:qsTr("Button with menu") menu:Menu{ MenuItem{text:qsTr("Item1")} MenuItem{text:qsTr("Item2")} } } //radiobutton ExclusiveGroup{id:group} RadioButton{ text:qsTr("from top") exclusiveGroup: group checked: true } RadioButton{ text:qsTr("from cursor") exclusiveGroup: group } //switch Switch{checked: true} Switch{checked: false} //combobox ComboBox{ id:editableCombo editable: true model: ListModel{ id:model ListElement{ text:"Banana";color:"Yellow"} ListElement{ text:"Apple";color:"Green"} ListElement{ text:"Cocont";color:"Brown"} } onAccepted: { if(editableCombo.find(currentText) === -1){ model.append({text:editText}) currentIndex = editableCombo.find(editText) } } } //spinbox SpinBox{ minimumValue: -5;maximumValue: 10 prefix: "today";suffix: "degree" decimals: 1;stepSize: 1 } //TextField TextField{ width: 200 placeholderText: "写字写字" echoMode: TextInput.PasswordEchoOnEdit } TextField{width: 200} //TextArea TextArea{ width: 240 textFormat: TextEdit.RichText font.pointSize: 13 text: "<b>Hello</b><i>world!</i>" } TextArea{ width: 240 textFormat: TextEdit.PlainText font.pointSize: 13 text: "<b>Hello</b><i>world!</i>" } //BusyIndicator BusyIndicator{ running: true } //ProgressBar ProgressBar{ id:progressBar minimumValue: 0 maximumValue: 100 } Timer{ interval: 100 running: true repeat: true onTriggered: progressBar.value++ } }} 同样的道理,它在android上也有很好的实现 来自为知笔记(Wiz) 附件列表 目前方向:图像拼接融合、图像识别 联系方式:jsxyhelu@foxmail.com

优秀的个人博客,低调大师

QTQuick控件基础(1)

一、Item QtQuick所有的可视项目都继承自Item,它定义了可视化项目所有通用特性(x\y\width\height\anchors等)具体包括 1、作为容器 2、不透明性 没有设置opacity属性 设置了opacity属性为0.5 当然也可以这样写 3、visible属性用来设置项目是否可见。如果visible属性为false,则不接受鼠标键盘事件;同理还有enable属性; 4、堆叠顺序,简单的说,就是z越大,越在顶层。当然前提是要保证是在并集的情况下。 通过z的设置,将原本在上面的蓝色矩形变换到底层,同时将两个矩形的结构由嵌套改编成并行。 或者可以通过将z设置为负值直接达到这个目标 5、定位子项目和坐标映射 包含childAt来返回在点x,y处的子项目,以及item的mapFromItem返回item坐标系统中点映射在该项目坐标系统的结果。 二、Rectangle Rectangle主要是使用纯色或者渐变填充一个矩形区域,并提供一个边框。 1、渐变,使用了GradientStop表明渐变的头和尾 2、边框,我们实现一个圆角矩形 三、Text 可以按照常用的方式,也可以以html的方式 1、颜色,有两种表示颜色的方法 2、文本裁剪,如果clip为true则裁剪,否则通过设置文本换行或者文本省略。这个截图已经可以说明 3、超链接 四、TextInput TextInput用来显示单行可编辑纯文本。以及相关的现实策略。比如intvalidator/DoubleValidator以及RegExpoValidator等 按下回车后读取数据 当然我们推荐使用qtcontrols中的textbox 四、定位器 column/row/grid/flow是四种定位器 五、repeater和positioner用来创建大量的项目并且获得特定的数据 注意其中的index是直接委托获得的。 六、anchor锚定位 一般来说,锚都是相对于父控件的,所以记录这幅图最为重要: 七、MouseArea 其最为重要的是 onClicked事件 八、timer 实时获得当前时间 来自为知笔记(Wiz) 目前方向:图像拼接融合、图像识别 联系方式:jsxyhelu@foxmail.com

优秀的个人博客,低调大师

Python基础学习笔记

---------2018.1.24------------ round是向上取整,引用方式为round(number[,ndigits]) 而floor是向下取整,floor函数通过import math导入,引用方式为math.floor(number) str函数,它会把值转换成合理形式的字符串,函数原型为str(object)//字符串要用双引 号引起来,数字不需要 repr函数,它会创建一个字符串.以合法的Python表达式的形式来表示值,函数原型为repr (object) 如果你希望打印一个包含数字的句子,加上``(反引号)可以很方便的输出 input()与raw_input()区别 input()会假设用户输入的是合法的python表达式,例如字符串一定要用引号引起来 而raw_input()会把所有的输入当作原始数据将其放入字符串中 如果你需要写一个非常长的字符串,需要跨越多行,可以使用三个引号(单引号和双引号均 可)代替. 如果一行中最后一个字符是反斜杠\,那么换行符本身就"转义"了,也就是被忽略了. 原始字符串r'x'或者r"x",几乎可以输出任何字符,唯一不行的就是原始字符串最后的一个 字符不能是反斜杠,要输出反斜杠\,只有对原反斜杠\进行转义,形式为'\\' pow(x,y[,z]) 返回x的y次幂(所得结果对z取模) ---------2018.2.6------------ 利用切片操作,实现一个trim()函数,去除字符串首尾的空格,注意不要调用str的strip()方法 1 # -*- coding: utf-8 -*- 2 def trim(s): 3 if s[:1] != ' ' and s[-1:] != ' ': 4 return s 5 elif s[:1] == ' ': 6 return trim(s[1:]) 7 else: 8 return trim(s[:-1]) 9 # 测试: 10 if trim('hello ') != 'hello': 11 print('测试失败!') 12 elif trim(' hello') != 'hello': 13 print('测试失败!') 14 elif trim(' hello ') != 'hello': 15 print('测试失败!') 16 elif trim(' hello world ') != 'hello world': 17 print('测试失败!') 18 elif trim('') != '': 19 print('测试失败!') 20 elif trim(' ') != '': 21 print('测试失败!') 22 else: 23 print('测试成功!') 汉诺塔的移动可以用递归函数非常简单地实现。 请编写move(n, a, b, c)函数,它接收参数n,表示3个柱子A、B、C中第1个柱子A的盘子数量,然后打印出把所有盘子从A借助B移动到C的方法,例如: 1 def move(n,a,b,c): 2 if(n==1): 3 print(a,'-->',c) 4 else: 5 move(n-1, a, c, b) 6 move(1, a, b, c) 7 move(n-1, b, a, c) 8 move(3, 'A' , 'B', 'C') 请使用迭代查找一个list中最小和最大值,并返回一个tuple: 1 # -*- coding: utf-8 -*- 2 def findMinAndMax(L): 3 length=len(L) 4 if(length==0): 5 return (None,None) 6 elif(length==1): 7 return (L[0],L[0]) 8 else: 9 minn=L[0] 10 maxn=L[0] 11 for x in L: 12 if(x>=maxn): 13 maxn=x 14 if(x<=minn): 15 minn=x 16 return (minn,maxn) 17 # 测试 18 if findMinAndMax([]) != (None, None): 19 print('测试失败!') 20 elif findMinAndMax([7]) != (7, 7): 21 print('测试失败!') 22 elif findMinAndMax([7, 1]) != (1, 7): 23 print('测试失败!') 24 elif findMinAndMax([7, 1, 3, 9, 5]) != (1, 9): 25 print('测试失败!') 26 else: 27 print('测试成功!') 杨辉三角定义如下: 1 / \ 1 1 / \ / \ 1 2 1 / \ / \ / \ 1 3 3 1 / \ / \ / \ / \ 1 4 6 4 1 / \ / \ / \ / \ / \ 1 5 10 10 5 1 把每一行看做一个list,试写一个generator,不断输出下一行的list: 1 # -*- coding: utf-8 -*- 2 def triangles(): 3 a = [1] 4 while True: 5 yield a 6 a = [sum(i) for i in zip([0] + a, a + [0])] 7 8 # 期待输出: 9 # [1] 10 # [1, 1] 11 # [1, 2, 1] 12 # [1, 3, 3, 1] 13 # [1, 4, 6, 4, 1] 14 # [1, 5, 10, 10, 5, 1] 15 # [1, 6, 15, 20, 15, 6, 1] 16 # [1, 7, 21, 35, 35, 21, 7, 1] 17 # [1, 8, 28, 56, 70, 56, 28, 8, 1] 18 # [1, 9, 36, 84, 126, 126, 84, 36, 9, 1] 19 n = 0 20 results = [] 21 for t in triangles(): 22 print(t) 23 results.append(t) 24 n = n + 1 25 if n == 10: 26 break 27 if results == [ 28 [1], 29 [1, 1], 30 [1, 2, 1], 31 [1, 3, 3, 1], 32 [1, 4, 6, 4, 1], 33 [1, 5, 10, 10, 5, 1], 34 [1, 6, 15, 20, 15, 6, 1], 35 [1, 7, 21, 35, 35, 21, 7, 1], 36 [1, 8, 28, 56, 70, 56, 28, 8, 1], 37 [1, 9, 36, 84, 126, 126, 84, 36, 9, 1] 38 ]: 39 print('测试通过!') 40 else: 41 print('测试失败!') 1 # -*- coding: utf-8 -*- 2 L1 = ['Hello', 'World', 18, 'Apple', None] 3 L2 = [s.lower() for s in L1 if isinstance(s,str)==True] 4 # 测试: 5 print(L2) 6 if L2 == ['hello', 'world', 'apple']: 7 print('测试通过!') 8 else: 9 print('测试失败!') split翻译为分裂。 split()就是将一个字符串分裂成多个字符串组成的列表。 split()当不带参数时以空格进行分割,当代参数时,以该参数进行分割。 //---当不带参数时 example: st0= ' song huan gong ' print(st0.split()) 结果为: ['song', 'huan', 'gong'] 结论:当不带参数时,默认是以空格作为参数,不管空格在哪,或者有几个 全部被镐掉了! //---当带参数时 这种情况就不能按照上面的方式去理解了 example: st0= 'iisongiiihuaniiiigongi' print(st0.split('i')) 结果为: ['', '', 'song', '', '', 'huan', '', '', '', 'gong', ''] 分析: 这个结果可能就有点出乎意料了并不是想象中的['song', 'huan', 'gong'] 而是多了很多空字符串元素'',这个怎么理解呢? 我的理解方式是,当带参数时,我们得把字符串想象成一块五花肉,我们要做 一件奇葩的事情,就是将肥肉丢到垃圾桶,把瘦肉留下。 比如'iisongiiihuaniiiigongi'这串五花肉,'i'就是要丢掉的肥肉,每次还只能切 'i'这么多。 切的时候是从左到右,一刀下去肥肉'i'丢掉,刀刃左边的部分拿走作为list的一个元素, 刀刃右边的就是剩下的,那么继续切剩下的部分,直到切完。 'iisongiiihuaniiiigongi'这块肉比较特殊: 其一、他的开始和结尾都有i,而且i还不止一个!这样按照上述的方法就会切出 空气,就是列表中我们看到的'', 空字符串元素。 如'iisongiiihuaniiiigongi',当第一刀下去的时候,第一个i被丢到了垃圾桶, 而刀刃的左边什么都没有,所以列表的第一个元素就是'',空字符串元素。 一刀下去之后,就剩下'isongiiihuaniiiigongi'。 所以第二刀下去之后,又得到一个空字符串元素,目前“肉”就剩下'songiiihuaniiiigongi'。 第三刀又切掉一个i,那么刀刃左边的就是song,所以第三个元素就是'song'。 直到切到最后,整坨肉就只剩下一个i了,使用最后一刀下去i被切掉了,刀刃的左边此时也 什么都没有了,所以最后一个元素任然是空字符串。 一个超级好的例子: 1 >>> str="hello boy<[www.doiido.com]>byebye" 2 >>> str.split("[")[1].split("]")[0] 3 'www.doiido.com' 4 >>> str.split("[")[1].split("]")[0].split(".") 5 ['www', 'doiido', 'com'] 利用map和reduce编写一个str2float函数,把字符串'123.456'转换成浮点数123.456: 1 # -*- coding: utf-8 -*- 2 from functools import reduce 3 DIGITS = {'0': 0, '1': 1, '2': 2, '3': 3, '4': 4, '5': 5, '6': 6, '7': 7, '8': 8, '9': 9} 4 def char2num(s): 5 return DIGITS[s] 6 def str2float(s): 7 s=s.split('.') 8 if len(s[0])==0: 9 s[0]='0' 10 return reduce(lambda x,y:x*10+y,map(char2num,s[0]))+reduce(lambda x,y:x*10+y,map(char2num,s[1]))*pow(0.1,len(s[1])) 11 print('str2float(\'123.456\') =', str2float('123.456')) 12 if abs(str2float('123.456') - 123.456) < 0.00001: 13 print('测试成功!') 14 else: 15 print('测试失败!') Python提供的sum()函数可以接受一个list并求和,请编写一个prod()函数,可以接受一个list并利用reduce()求积: 1 # -*- coding: utf-8 -*- 2 from functools import reduce 3 def prod(L): 4 return reduce(lambda x,y:x*y,L) 5 print('3 * 5 * 7 * 9 =', prod([3, 5, 7, 9])) 6 if prod([3, 5, 7, 9]) == 945: 7 print('测试成功!') 8 else: 9 print('测试失败!') 利用map()函数,把用户输入的不规范的英文名字,变为首字母大写,其他小写的规范名字。输入:['adam', 'LISA', 'barT'],输出:['Adam', 'Lisa', 'Bart']: 1 # -*- coding: utf-8 -*- 2 def normalize(name): 3 name=name[0].upper()+name[1:].lower() 4 return name 5 # 测试: 6 L1 = ['adam', 'LISA', 'barT'] 7 L2 = list(map(normalize, L1)) 8 print(L2) 回数是指从左向右读和从右向左读都是一样的数,例如12321,909。请利用filter()筛选出回数: 1 # -*- coding: utf-8 -*- 2 def is_palindrome(n): 3 nn = str(n) #转成字符串 4 return nn == nn[::-1] #反转字符串并对比原字符串返回true/false 5 # 测试: 6 output = filter(is_palindrome, range(1, 1000)) 7 print('1~1000:', list(output)) 8 if list(filter(is_palindrome, range(1, 200))) == [1, 2, 3, 4, 5, 6, 7, 8, 9, 11, 22, 33, 44, 55, 66, 77, 88, 99, 101, 111, 121, 131, 141, 151, 161, 171, 181, 191]: 9 print('测试成功!') 10 else: 11 print('测试失败!') ---------2018.2.7------------ 请把下面的Student对象的gender字段对外隐藏起来,用get_gender()和set_gender()代替,并检查参数有效性: 1 # -*- coding: utf-8 -*- 2 class Student(object): 3 def __init__(self, name, gender): 4 self.name = name 5 self.gender = gender 6 def get_gender(self): 7 return self.gender 8 def set_gender(self,gender): 9 if gender=='male' or gender=='female': 10 self.gender=gender 11 else: 12 raise ValueError('gender error') 13 # 测试: 14 bart = Student('Bart', 'male') 15 if bart.get_gender() != 'male': 16 print('测试失败!') 17 else: 18 bart.set_gender('female') 19 if bart.get_gender() != 'female': 20 print('测试失败!') 21 else: 22 print('测试成功!') 2018/3/5 ubuntu16.04自带python的环境,不用进行python环境安装,在安装好环境的虚拟机中,提供了py2,py3,django_py2,tornado_py2,spider_py2,django_py3的虚拟环境 mysql安装sudo apt-get install mysql-serversudo apt-get install libmysqlclient-dev注意安装server端的时候会提示输入密码,记住这个密码。然后通过命令登入数据库 redis安装sudo apt-get install redis-server通过redis-cli登入mongoDB安装详情请参考 http://blog.csdn.net/zgf19930504/article/details/52045600postgresql安装sudo apt-get install postgresqlsudo apt-get install libpq-develasticsearch安装(django项目使用)sudo apt-get install elasticsearch其它依赖包sudo apt-get install python-dev 3.django环境安装我们将虚拟环境所需的包全部放在install.txt,以下是django_py3项目所需环境:django==1.7.4jsonfieldPillow==2.8.2celeryamqp==1.4.9anyjson==0.3.3billiard==3.3.0.23celery==3.1.23decorator==4.0.10Django==1.7.8django-haystack==2.5.0django-redis-sessions==0.5.6ipdb==0.8.1ipython-genutils==0.1.0jsonfield==1.0.3kombu==3.0.35psycopg2==2.6.2pytz==2016.6.1redis==2.10.5setuptools==25.1.0wheel==0.29.0执行pip3 install -r instal.txt命令即可 4.tornado环境安装在tornado_py2虚拟环境中安装:ipython==4.2.0ipython-genutils==0.1.0pingpp==2.0.11pycrypto==2.6.1qiniu==7.0.7redis==2.10.5requests==2.10.0tornado==4.3MySQL-python==1.2.5SQLAlchemy==1.0.14 5.spider环境安装在spider_py2虚拟环境中安装:attrs==16.0.0backports-abc==0.4backports.ssl-match-hostname==3.5.0.1BeautifulSoup==3.2.1beautifulsoup4==4.4.1boto==2.38.0certifi==2016.2.28cffi==1.7.0chardet==2.3.0CherryPy==3.5.0click==6.6cryptography==1.4cssselect==0.9.2cssutils==1.0Cython==0.24decorator==4.0.6Django==1.8.7dnspython==1.12.0easydict==1.6enum34==1.1.6feedparser==5.1.3greenlet==0.4.10html5lib==0.999idna==2.1ipaddress==1.0.16ipython==2.4.1jieba==0.38jsonpath==0.54lxml==3.5.0Markdown==2.6.6mechanize==0.2.5motor==0.2motorengine==0.9.0mysqlclient==1.3.7ndg-httpsclient==0.4.0netifaces==0.10.4nltk==3.2.1parsel==1.0.2pbr==1.9.1pexpect==4.0.1Pillow==3.3.0pip==8.1.2pkg-resources==0.0.0poster==0.8.1ptyprocess==0.5pyasn1==0.1.9pyasn1-modules==0.0.8pybloomfilter==1.0pybloomfiltermmap==0.3.12pycparser==2.14pycrypto==2.6.1PyDispatcher==2.0.5Pygments==2.1pymongo==2.7pyOpenSSL==16.0.0python-dateutil==2.4.2pytz==2014.10PyYAML==3.11queuelib==1.4.2redis==2.10.5repoze.lru==0.6requests==2.10.0Routes==2.2rq==0.6.0Scrapy==1.1.0scrapy-redis==0.6.3scrapyd==1.1.0scrapyd-client==1.0.1selenium==2.53.6service-identity==16.0.0setuptools==25.1.0simplegeneric==0.8.1singledispatch==3.4.0.3six==1.10.0sqlparse==0.1.18stevedore==1.13.0tornado==4.3Twisted==16.2.0urllib3==1.13.1w3lib==1.14.2WebOb==1.5.1wheel==0.29.0zope.interface==4.2.0 编译C语言代码(基于Vim编辑器) vi 1.ci插入代码 上下左右还是可以使用HJKL或者up down left right(建议使用HJKL)写完保存退出ESC+:xgcc 1.c编译 会生成a.out文件运行a.out文件命令:./a.out python3支持中文编码,python2不支持中文编码要解决python2不支持中文编码的操作为:# -*- coding=utf-8 -*- 特别注意:python2中input的意思是把交互式输入的东西当成代码去执行,而python3中默认当作字符串去输入而如果要让python2中输入的东西当作字符串,我们需要用到raw_input() 比如a=input("请输入你的名字:")请输入你的名字:laowangpython2中会报错,python3则不会请输入你的名字:1+2print(a)python2中打印结果为3 python3中打印结果为'1+2'而python2中要实现打印字符串,用raw_input函数a=raw_input("请输入你的名字:")请输入你的名字:1+2print(a)'1+2' 由于在python3中默认input类型为字符串类型,如果我们需要获取int类型,我们需要设置一个变量去存储字符串类型例如age_num=int(age) 变量名不能使用关键字 import keyword keyword.kwlist显示当前版本的所有关键字 print("%d%s%f"%(a,b,c)) 不等于在python2和python3中通用写法是!=但是在python2中还有一种写法是<>,这个意思也是表示不等于 vi编辑代码的时候,如果之前有定义的变量,敲完该变量的一部分,再敲上Ctrl+n自动补全 if not (条件):print(xxx) 意思是不在条件范围内if not (x>0 and x<50):print("hello") 逻辑运算符:and 且or 或not 非 if 条件1: print(a)elif 条件2: print(aa)......else: print(aaa) while 条件: a=b+c print(c)打印不换行:print("xxx(打印信息)",end="")打印换行:print("") 复合赋值运算符:+=-=*=/=%=**=//=而不能使用j++之类的,这是错误的语法,只能写成j+=1 在进行复合赋值运算时,=后面的数字不管进行什么运算,切记加上小括号 举个例子:a=2a*=3+2答案是10,计算方式是a=a*(3+2)=2*5=10,而并不是a=2*3+2=8 import randomrandom.randint(0,2)意思是导入一个random的库,random.randint(0,2)意思是随机生成0-2中的整数 切片:name[2:6]取的是从第二个位置开始(下标从0开始),到小于第六个位置为止(第五个位置) name[2:]取的是从第二个位置开始(下标从0开始),取到最后一个 name[2:-1:2]取的是从第二个位置开始(下标从0开始),取到最后一个的前面一个,步长为2,就是每两个位置取一个 切片:[起始位置:终止位置:步长](针对字符串而言) 起始位置取大于等于号,终止位置取小于号 步长可以为负数 步长为负数时是倒着取值,反向,相当于取逆序数 find函数,意思是找到我们需要的字符串的首字符的下标,找不到输出-1 str="hello world"str.find("world")>>6 str.find("Hello")>>-1 index函数 和find查找函数一样 找到了返回 只不过find没找到返回-1 index没有找到直接返回异常 rindex 返回子字符串 str 在字符串中最后出现的位置 如果没有匹配的字符串会报异常 rfind 返回字符串最后一次出现的位置,如果没有匹配项则返回-1 count 用于统计字符串里某个字符出现的次数。可选参数为在字符串搜索的开始与结束位置。 replace 把字符串中的 old(旧字符串) 替换成 new(新字符串),如果指定第三个参数max,则替换不超过 max 次。 split 通过指定分隔符对字符串进行切片,如果参数num 有指定值,则仅分隔 num 个子字符串str.split(str="", num=string.count(str)).str -- 分隔符,默认为所有的空字符,包括空格、换行(\n)、制表符(\t)等num -- 分割次数 str = "Line1-abcdef \nLine2-abc \nLine4-abcd";print str.split( );>>['Line1-abcdef', 'Line2-abc', 'Line4-abcd'] capitalize 将字符串的第一个字母变成大写,其他字母变小写。对于 8 位字节编码需要根据本地环境。 s = ' a, B' # a 前面有空格s.capitalize()>>' a, b' title 所有单词都是以大写开始,其余字母均为小写str.title() startswith 用于检查字符串是否是以指定子字符串开头,如果是则返回 True,否则返回 False。如果参数 beg 和 end 指定值,则在指定范围内检查。 endswith 用于判断字符串是否以指定后缀结尾,如果以指定后缀结尾返回True,否则返回False。可选参数"start"与"end"为检索字符串的开始与结束位置。 lower 转换字符串中所有大写字符为小写str.lower() upper 将字符串中的小写字母转为大写字母str.upper() rjust 返回一个原字符串右对齐,并使用空格填充至长度 width 的新字符串。如果指定的长度小于字符串的长度则返回原字符串。 ljust 返回一个原字符串左对齐,并使用空格填充至指定长度的新字符串。如果指定的长度小于原字符串的长度则返回原字符串。 center 返回一个原字符串居中,并使用空格填充至长度 width 的新字符串。默认填充字符为空格。 lstrip 用于截掉字符串左边的空格或指定字符 rstrip 删除 string 字符串末尾的指定字符(默认为空格) strip 用于移除字符串头尾指定的字符(默认为空格) partition 用来根据指定的分隔符将字符串进行分割。 rpartition 从后往前查找,返回包含字符串中分隔符之前、分隔符、分隔符之后的子字符串的tuple;如果没找到分隔符,返回字符串和两个空字符串 splitlines 字符串以换行符为分隔符拆分,去掉换行符;如果keepends为True,保留换行符 isalpha 检测字符串是否只由字母组成 isdigit 检测字符串是否只由数字组成 join 用于将序列中的元素以指定的字符连接生成一个新的字符串 str = "-";seq = ("a", "b", "c"); # 字符串序列print str.join( seq );>>a-b-c append 用于在列表末尾添加新的对象 如果添加的对象是列表 则会整体添加list.append(obj) ps:a=[1,2]b=[3,4]a.extend(b)>>[1,2,3,4]a.append(b)>>[1,2,[3,4]] insert 用于将指定对象插入列表的指定位置 list.insert(index, obj) extend 用于在列表末尾一次性追加另一个序列中的多个值(用新列表扩展原来的列表) list.extend(seq) pop 用于移除列表中的一个元素(默认最后一个元素),并且返回该元素的值 删除最后一个list.pop(obj=list[-1]) remove 用于移除列表中某个值的第一个匹配项 根据内容来删除 list.remove(obj) del xxx[下标] 根据下标来删除 in 操作符用于判断键是否存在于列表/字典中,如果键在列表/字典里返回true,否则返回false not in 如果在指定的序列中没有找到值返回 True,否则返回 False。 字典通过键来查找 info={键1:值1,键2:值2,......} 添加 xxx[新的key] = value 删除 del xxx[key] 修改 xxx[已存在的key] = new_value 查询 xxxx.get(key) for...else结构: 如果for循环里面有break,不触发else如果for循环里面没有break 一定会触发else append 注意点:a=[1,2]b=[3,4] a=a.append(b)进行这一步操作后,a的值为None了 原因是进行a.append(b)操作后,b的值已经添加到a里面去了 结果已经发生变化了 但是我们单独敲a.append(b)这句话时,并没有任何输出 这就说明a.append(b)这步操作的值为空 a.append(b)整体结果为没有 没有输出就没有结果 反而你把这个传入a a的值只能保存为空 即为None 在python2中 keys 以列表返回一个字典所有的键 ps:dict.keys() values 以列表返回字典中的所有值 ps:dict.values() items 以列表返回可遍历的(键, 值) 元组数组 ps:dict.items() 而python3中 会返回一个生成器 一个对象 内容是列表的形式 example: 在python2中:info={"name":"laowang","age":18}info.keys()>>['name','age'] 而在python3中info={"name":"laowang","age":18}info.keys()>>dict_keys(['name','age']) 拆包 举个例子就知道了:下面是元组拆包a=(11,22)c,d=ac>>11d>>22 在items中取值时,两种取值方式 一种是用数组下标 一种是元组拆包 举个例子:info={"name":"laowang","age":18}for temp in info.items(): print("key=%s,value=%s"%(temp[0],temp[1])) info={"name":"laowang","age":18}for A,B in info.items(): print("key=%s,value=%s"%(A,B)) 以上两种方式得出的结果相同 元组:(小括号) 字典:很多信息描述一个物体(大括号)列表:存储不同物体的相同信息(中括号) 元组类型的数据不能修改里面的值,相当于一个只读文件而列表可以修改值 函数:def 函数名: ... 一个函数想要返回多个数值,可以将其打包成元组或者列表 return a,b,c 相当于封装成元组返回 写代码规范:写函数时,先写结构,再去考虑里面内容 代码能够重复使用 全局变量与局部变量注意点: 1.如果全局变量中定义了某个量 如果还想在函数中对这个变量进行修改的话 在函数中使用global对全局变量进行一个声明那么这个函数中的变量就不是定义一个局部变量 而是对全局变量进行修改 2.全局变量定义得放在函数调用之前 #注释会被忽略文档字符串(doctoring)"""XXX"""可以被调用(不影响程序的执行) def main 完成对整个程序的控制 main函数需要定义 main()调用主函数 python代码一般格式:# -*-coding=utf-8-*-import xxxdef xxx(aa): ...xxx(aa) 列表 字典的注意事项: 如果列表 字典当作全局变量 可以不需要在函数中定义global,加了也没事 但是单纯的变量在函数中一定需要加上global 缺省参数:在函数中传入默认值 在调用函数时可以不传入那个变量值 那个参数称为缺省参数 example:def test(a,b=22): result = a+b print("result=%d"%result)test(11)test(22,33)test(44) >>33>>55>>66 而像test(11,b=22)b=22为命名参数 不定长参数 如果我们需要调用一个传入任意个参数的函数 怎么办呢 我们这时候采用传入*args 函数的形参 告诉python解释器 传入的实参个数如果大于形参真正的个数 剩下的统统扔给args比如我们有10个苹果要分给三个人 有个人是你的亲属 需要你照顾他 每个人发完一个后 剩余的都给需要照顾的人 输出的结果为元组 example:def sum(a,b,*args): print(a) print(b) print(args) sum(1,2,3,4,5,6,7,8)>>1>>2>>(3,4,5,6,7,8) 对于上面这个例子 如果传入的实参只有2个 也不会错 args的值为空 输出的时候会输出一个()(空的元组) **kwargs以字典的形式保存 输出结果为字典形式 多余参数不带变量名的 统统给args 多余参数带变量名的 统统给kwargs def sum(a,b,*args,**kwargs): print(a) print(b) print(args) print(kwargs) sum(1,2,3,4,5,6,task=88,done=78) 12(3, 4, 5, 6){'task': 88, 'done': 78} 拆包: 就是在实参上加上*/** 把一个列表/字典拆成一个一个值 元组/列表拆成一个一个元素 字典拆成 key value 这个过程就是拆包 用法:如下例子 def sum(a,b,*args,**kwargs): print(a) print(b) print(args) print(kwargs) A=(44,55,66)/[44,55,66] B={"name":"laowang","age":18} sum(11,22,*A,**B) 在实参上写了*/** 意思是拆包 >>1122(44, 55, 66){'name': 'laowang', 'age': 18} id 用于获取对象的内存地址id([object]) a=1 意思并不是说定义了一个变量 而是贴了个标签,这个标签是内存地址 b=a 这个意思也是把a的内存地址给b 所以id查看会发现a,b的内存地址相同 而C语言不是 C语言是定义变量 只是值相等 地址不同 只要a的值改变了 b的值也会改变 python有自动回收垃圾机制 数字是不可变类型 字符串也是不可变类型 元组也是个不可变类型 举个例子a="hello"a[0]>>'h'a[0]='H'报错。。。 说明字符串不允许修改 列表和字典属于可变类型 在定义时不允许当key用 infors.sort(key=lambda x:x['name']) 匿名函数 lambda eval 用来执行一个字符串表达式,并返回表达式的值 eval(expression[, globals[, locals]]) 交换两个数 a=a+bb=a-ba=a-b 任何语言都适用 a,b=b,a python独特写法 两数交换 列表加上列表 等于 列表的合并 误区: python里面不是值赋值,而是引用赋值 例子: num+=num与num=num+num的区别 由于python里面时引用赋值 假设num=100传入一个求解两个数的和的函数 num+=num 传入的实参num指向100这个值 所以做修改时直接修改的是num本身的值 修改的是全局变量 而num = num + num传入参数时 num定义的是临时变量 此时num指向的是100+100=200 文件的读入 f = oepn("test.py","r") 意味着通过open打开文件 用f进行操作文件的读写 r 文件必须存在w 文件如果不存在 就创建新文件a 打开一个文件 从文件的末尾写 rbwbab有b结尾说明是二进制文件 文本文件与二进制文件区别 r+w+a++表示你可以读写文件 rb+wb+ab+ open默认以读入的方式打开 所以可以不写"r" seek 用于移动文件读取指针到指定位置 fileObject.seek(offset[, whence]) f.seek(2,0) 0表示文件的开头 2表示跳过开头两个位置开始读 如果我已经读完了一个文件 想要重新读取该文件 我们应该用f.seek(0,0)拉回来 让该文件还能调用f.read()重新读取 f.tell() 返回文件的当前位置,即文件指针当前位置 fileObject.tell(offset[, whence]) open 支持相对路径和绝对路径 面向过程 考虑要面面俱到 强调的是过程而面向对象则不需要 找个有这样能力的人去做 强调的是对象 形象的解释对象 看的见摸得着 实实在在的东西 类是模型 一个概念 类由三部分组成 类的名称:类名 类的属性:一组数据 类的方法:允许对进行操作的方法(行为) 比如: 类名:Tank属性:重量 速度 材料方法:开炮 移动 转弯 在类中定义方法的时候参数位置要写上self 执行 Cat() 在内存中申请了空间 返回对象的引用 而执行 tom = Cat() tom是创建的对象的引用 指向那个对象 添加属性 tom.name="xxx" 给tom添加属性name tom.age=xx 给tom添加属性age 例子: 类Cat tom=Cat() tom.调用方法 tom.添加属性 class Cat: #属性 #方法 def eat(self): print("猫在吃鱼....") def drink(self): print("猫正在喝kele.....") def introduce(self): #print("%s的年龄是:%d"%(tom.name, tom.age)) print("%s的年龄是:%d"%(self.name, self.age)) #创建一个对象tom = Cat() #调用tom指向的对象中的 方法tom.eat()tom.drink() #给tom指向的对象添加2个属性tom.name = "汤姆"tom.age = 40 #获取属性的第1种方式#print("%s的年龄是:%d"%(tom.name, tom.age)) tom.introduce()#相当于 tom.introduce(tom) lanmao = Cat()lanmao.name = "蓝猫"lanmao.age = 10lanmao.introduce() self的作用:你通过哪个对象去调用方法 self就指向哪个对象 tom.introduce() 相当于tom.introduce(tom) 而如果class中函数的形参不写入self 直接调用tom.introduce() 结果会显示多传入了一个参数 这个就是原因所在 还有 不一定要传入形参的时候传self a b c等任何数都行 只是我们约定俗成 用self 魔法方法1:__init__ 方法:初始化对象def __init__(self): pass 初始化对象 创建对象的过程:1.创建一个对象2.python会自动的调用__init__方法3.返回创建的对象的引用给tom __init__也称为魔法方法 class Cat: """定义了一个Cat类""" #初始化对象 def __init__(self, new_name, new_age): self.name = new_name self.age = new_age #方法 def eat(self): print("猫在吃鱼....") def drink(self): print("猫正在喝kele.....") def introduce(self): print("%s的年龄是:%d"%(self.name, self.age)) #创建一个对象tom = Cat("汤姆", 40)tom.eat()tom.drink()#tom.name = "汤姆"#tom.age = 40tom.introduce() lanmao = Cat("蓝猫", 10)#lanmao.name = "蓝猫"#lanmao.age = 10lanmao.introduce() 1.创建对象name = "汤姆"age = 40 2.调用__init__方法3.返回这个对象的引用 1.创建对象name = "蓝猫"age = 102.调用__init__方法3.返回这个对象的引用 魔法方法2:__str__ 用来获取对象描述信息 def __self__(self): return xxx print(tom) 打印出xxx(调用tom的信息) class Cat: """定义了一个Cat类""" #初始化对象 def __init__(self, new_name, new_age): self.name = new_name self.age = new_age def __str__(self): return "%s的年龄是:%d"%(self.name, self.age) #方法 def eat(self): print("猫在吃鱼....") def drink(self): print("猫正在喝kele.....") def introduce(self): print("%s的年龄是:%d"%(self.name, self.age)) #创建一个对象tom = Cat("汤姆", 40) lanmao = Cat("蓝猫", 10) print(tom)print(lanmao) 打印结果为:汤姆的年龄是40蓝猫的年龄是10 通过全局变量 通过属性 来进行数据的共享 把函数的功能封装起来 def __test(self): pass 这种方式是方法私有化 del不是真正删除了 而是删除了引用 def __del__(self): pass python解释器调用 class Dog: def __del__(self): print("-----英雄over------") dog1 = Dog()dog2 = dog1 del dog1#不会调用 __del__方法,因为这个对象 还有其他的变量指向它,即 引用计算不是0del dog2#此时会调用__del__方法,因为没有变量指向它了print("====================") #如果在程序结束时,有些对象还存在,那么python解释器会自动调用它们的__del__方法来完成清理工作 测量一个对象引用的计数方式: 使用sys模块中的getrefcount函数 import sysclass T: pass t = T() sys.getrefcount(t)>>2 tt = tsys.getrefcount(tt)>>3 del ttsys.getrefcount(t)>>2 父类/基类 继承 子类/派生类 我们定义了一个Animal类 父类/基类 下面有个Dog Cat的子类 Dog下面定义了一个wangcai的方法 tom的方法 wangcai只能使用Dog Animal类中的方法tom只能使用Cat Animal类中的方法 不允许出现tom使用Dog中的方法或者是wangcai使用Cat中的方法 重写 在子类中重写父类的方法 调用的时候只会调用子类的方法 super().bark() super调用被重写的父类的方法 私有方法 私有的属性并不会被继承 如果调用的是继承的父类中的共有方法 可以在这个公有方法中访问父类中的私有属性和私有方法 但是如果在子类中实现了一个公有方法 那么这个方法是不能够调用继承的父类中的私有方法 class Base(object): pass class Base(object): def test(self): print("----Base") class A(Base): def test(self): print("-----A") class B(Base): def test(self): print("-----B") class C(A,B): pass #def test(self): # print("-----C") c = C()c.test() print(C.__mro__) 类名.__mro__决定调用一个方法的时候 搜索的顺序 如果在某个类中找到了方法 那么就停止搜索 定义的时候对象不确定 调用的时候确定对象 这个方法叫多态 python既支持面向过程 也支持面向对象 python面向对象的三个基本要素是 封装 继承 多态 一个特殊的属性 能够知道这个对象的class 类在程序里面也是一个对象 称为类对象 由类创建出的对象为实例对象 实例对象的属性为实例属性 实例属性和对象有关系 类对象中的属性为类属性 类属性和类有关系 类属性是共享的 实例属性:和具体的某个实例对象有关系并且 一个实例对象和另外一个实例对象是不共享属性的 类属性:类属性所属于类对象并且多个实例对象之间共享同一个 类属性 class Tool(object): #类属性 num = 0 #方法 def __init__(self, new_name): #实例属性 self.name = new_name #对类属性+=1 Tool.num += 1 tool1 = Tool("铁锹")tool2 = Tool("工兵铲")tool3 = Tool("水桶") print(Tool.num) 实例方法 类方法 静态方法 class Game(object): #类属性 num = 0 #实例方法 def __init__(self): #实例属性 self.name = "laowang" #类方法 @classmethod def add_num(cls): cls.num = 100 #静态方法 @staticmethod def print_menu(): print("----------------------") print(" 穿越火线V11.1") print(" 1. 开始游戏") print(" 2. 结束游戏") print("----------------------") game = Game()#Game.add_num()#可以通过类的名字调用类方法game.add_num()#还可以通过这个类创建出来的对象 去调用这个类方法print(Game.num) #Game.print_menu()#通过类 去调用静态方法game.print_menu()#通过实例对象 去调用静态方法 @classmethod 装饰器 固定写法 通过一个类进行分离解耦 在父类中不去实现 在子类中实现 这就是工厂方法模式 def __new__(cls): pass 当你继承一些不可变的class时(比如int, str, tuple), 提供给你一个自定义这些类的实例化过程的途径 class Dog(object): def __init__(self): print("----init方法-----") def __del__(self): print("----del方法-----") def __str__(self): print("----str方法-----") return "对象的描述信息" def __new__(cls):#cls此时是Dog指向的那个类对象 #print(id(cls)) print("----new方法-----") return object.__new__(cls) #print(id(Dog)) xtq = Dog() 1.创建一个对象2.调用__init__方法3.返回对象的引用 而__new__方法就是重写父类的new方法 1.调用__new__方法来创建对象,然后找了个变量来接受__new__返回值,这个返回值表示 创建出来的对象的引用 2.__init__(刚刚创建出来的对象的引用) 初始化 3.返回对象的引用 而构造方法是既创建对象 又初始化 和__init__方法不等价 __new__只负责创建对象 __init__只负责初始化 class Dog(object): __instance = None def __new__(cls): if cls.__instance == None: cls.__instance = object.__new__(cls) return cls.__instance else: #return 上一次创建的对象的引用 return cls.__instance a = Dog()print(id(a))b = Dog()print(id(b)) class Dog(object): __instance = None __init_flag = False def __new__(cls, name): if cls.__instance == None: cls.__instance = object.__new__(cls) return cls.__instance else: #return 上一次创建的对象的引用 return cls.__instance def __init__(self, name): if Dog.__init_flag == False: self.name = name Dog.__init_flag = True a = Dog("旺财")print(id(a))print(a.name) b = Dog("哮天犬")print(id(b))print(b.name) 异常处理: try: except 出现异常的名字: try:print(num)except NameError:print(111) Exception 如果用了Exception,那么意味着只要上面的except没有捕获到异常 这个except一定会捕获到 Exception 不管产生什么异常 都会捕获到 就不需要去写许多异常了 异常方面很多 as 预处理方案 会给出产生该异常的原因 #coding=utf-8 try: num = input("xxx:") int(num) #11/0 #open("xxx.txt") #print(num) print("-----1----") except (NameError,FileNotFoundError): print("如果捕获到异常后做的 处理....")except Exception as ret: print("如果用了Exception,那么意味着只要上面的except没有捕获到异常,这个except一定会捕获到") print(ret)else: print("没有异常才会执行的功能")finally: print("------finally-----") print("-----2----") Ctrl + C也是一个异常 自定义异常类 raise引发一个自定义的异常 log日志 会记录发生的异常 *.py文件就是模块 .pyc 字节码的后缀 翻译后的python代码 from 模块名 import 功能名1,功能名2,.....从模块中导入功能1,功能2,等等 from 模块名 import * 从模块中导入所有功能 这种方式缺陷:如果导入的模块的功能名相同 后面导入的会覆盖前面导入的 import msgmsg.text1() 通过模块名.功能名调用 import time as tt 导入time模块 给它取个名字 叫tttt.sleep(3) 不取和模块名相同的名字 import xxx class ClassName(object): def __init__(self,arg): pass def xxx(): pass def main(): pass if __name == '__main__': main() __all__ = ["功能名1","功能名2",...../或者类名也行] 定义的作用:放上将来你想要用的功能/类名,如果没放进去 调用import仍不能用 把模块有关联的放在一个文件夹中 在python2中调用文件夹名会直接失败在python3中调用会成功,但是调用不能成功 解决办法是: 在该文件夹下加入空文件__init__.py python2会把该文件夹整体当成一个包 然后编辑__init__.py 加入__all__ = ["功能名1","功能名2",...../或者类名也行] 再通过from 模块名 import *通用写法是:from . import 模块名 这样就可以调用包中那些模块功能了 #如果导入这个模块的方式是 from 模块名 import * ,那么仅仅会导入__all__的列表中包含的名字 setup.py from distutils.core import setup setup(name="dongGe", version="1.0", description="dongGe's module", author="dongGe", py_modules=['TestMsg.sendmsg', 'TestMsg.recvmsg']) 模块的发布过程:1.创建文件setup.py 传入模块.功能2.python3 setup.py build3.python3 setup.py dist4.生成压缩包,然后可以发布到github.com上 系统安装包sudo python3 setup.py install python2中range(10)返回值是一个列表[0,...,9]而在python3中返回值是range(0,10) range(0,10)在python2中返回是一个列表[0,...,9]而在python3中返回值是range(0,10) range有风险 如果将来你需要一个很大的值 因为需要占用很大的空间 所以不给你 如果python3中想要返回值是一个列表 使用a = [i for i in range(1,18)] 这样可以返回一个列表 在python2中这种写法也适合 (参数1,参数2,参数3,.....) for 参数1 in range(第1个数) for 参数2 in range(第2个数) 。。。。。。。 set 字典 list 列表 while True:1.检测事件,如果有时间就控制相应的图片移动2.把所有的图片重新画一遍 1/60s --> 动画效果 列表循环删除的时候不能删除循环的那个列表 我们可以申请一个新的列表去存 您可以考虑给博主来个小小的打赏以资鼓励,您的肯定将是我最大的动力。thx. 微信打赏 支付宝打赏 作 者: Angel_Kitty 出 处:http://www.cnblogs.com/ECJTUACM-873284962/ 关于作者:潜心机器学习以及信息安全的综合研究。如有问题或建议,请多多赐教! 版权声明:本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文链接。 特此声明:所有评论和私信都会在第一时间回复。也欢迎园子的大大们指正错误,共同进步。或者直接私信我 声援博主:如果您觉得文章对您有帮助,可以点击右下角【推荐】推荐一下该博文。您的鼓励是作者坚持原创和持续写作的最大动力!

优秀的个人博客,低调大师

Spark基础 --RDD详解

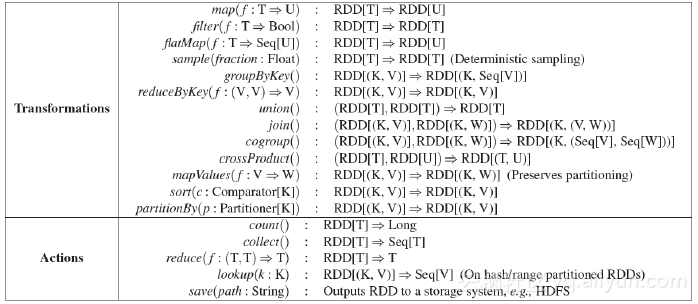
RDD算子分为两类:Transformation和Action,如下图,记住这张图,走遍天下都不怕。 Transformation:将一个RDD通过一种规则映射为另外一个RDD。 Action:返回结果或保存结果。 注意:只有action才触发程序的执行,transformation不触发执行。 RDD的操作种类有多个,分为: 单指RDD操作、Key/Value RDD操作、多个RDD联合操作,其他操作。 单值RDD 1. Map map (f: T => U) : RDD[U] ,其中f定义了类型为T的元素到类型为U 的元素的映射,RDD[T] => RDD[U]的变换 举例: var rdd=sc.makeRDD(1 to 7,3) 简写为 rdd.map(_+1) //rdd.map(x=>x+1) 2. collect collect(): Array[T],T是RDD中元素类型,将RDD转化为数组。 举例: val rdd = sc.makeRDD(1 to 7, 3) rdd.collect() 注意:此算子非常危险,他会将所有RDD中的数据汇总到Drive端的JVM内存中,对Drive端压力很大。 3. take take(num: Int): Array[T] ,其中k是整数,T是RDD中元素类型,返回RDD中前k个元素,并保存成数组 举例: val rdd = sc.makeRDD(1 to 7, 3) rdd.take(2) 4. glom glom() : RDD[Array[T]],将RDD中每个partition中元素转换为数组 举例: val rdd = sc.makeRDD(1 to 7, 3) rdd.glom.collect 5. coalesce coalesce(numPartitions: Int) : RDD[T],将RDD中的partition个数合并为numPartitions个 举例: val rdd = sc.makeRDD(1 to 7,7) rdd.coalesce(3) // 生成新的RDD,它包含三个Partition 6. repartition repartition(numPartitions: Int) :RDD[T],将RDD中的partition个数均匀合并为numPartitions个 举例: val list = Seq(Seq(),Seq(),Seq(),Seq(),Seq(),Seq(), Seq(1,2,3,4,5,6,7)) val rdd = sc.makeRDD(list, 7).flatMap(x => x) rdd.repartition(3) // 生成新的RDD,它包含三个Partition 7. filter filter(f: T => Boolean): RDD[T] ,其中f定义了类型为T的元素是否留下,过滤输入RDD中的元素,将f返回true的元素留下 举例: var rdd=sc.makeRDD(1 to 7,7) rdd.filter(_%3==0) 8. count count(): Long,统计RDD中元素个数,并返回Long类型 val rdd = sc.makeRDD(1 to 7, 3) rdd.count() // 统计RDD中元素总数 9. flatMap flatMap(f: T =>TraversableOnce[U]): RDD[U],将函数f作用在RDD中每个元素上,并展开(flatten) 输出的每个结果, flatMap = flatten + map,先映射(map),再拍扁(flatten ) 举例: val rdd = sc.makeRDD(1 to 3, 3) rdd.flatMap( x => 1 to x) // 将x映射成1~x 10. reduce reduce(f: (T, T) => T): T, 按照函数f对RDD中元素,进行规约 举例: val rdd = sc.makeRDD(1 to 7, 3) rdd.reduce((x, y) => x + y) 简写为:rdd.reduce(_ + _) 11. foreach foreach(f: T => Unit):Unit,对RDD中每个元素,调用函数f 举例: val rdd = sc.makeRDD(1 to 7, 3) rdd.foreach( x => println(x)) 简写为:rdd.foreach(println) Key/Value RDD 首先先来看下如何创建一个Key/Value的rdd var seq=Seq((A,1),(B,1),(C,1)) var rdd=sc.makeRDD(seq) 1.mapValues 对vaule做map操作 举例: val pairs = Seq((A,1), (B,2), (A,2), (C, 4), (B, 1), (B, 1), (D, 1)) val rdd = sc.makeRDD(pairs, 3) rdd.mapValues(_ + 1) 2.reduceByKey 对Key相同的value做计算 举例: val pairs = Seq(('A',1), ('B',2), ('A',2), ('C', 4), ('B', 1), ('B', 1), ('D', 1)) val rdd = sc.makeRDD(pairs, 3) rdd.reduceByKey(_ + _) 3.groupByKey 将RDD[key,value] 按照相同的key进行分组,形成RDD[key,Iterable[value]]的形式, 有点类似于sql中的groupby 举例: val pairs = Seq((A,1), (B,2), (A,2), (C, 4), (B, 1), (B, 1), (D, 1)) val rdd = sc.makeRDD(pairs, 3) rdd.groupByKey() 注意:能用reducebykey代替就不用groupbykey,groupbykey会将所有的元素进行聚合,消耗大量内存。 多RDD 1. union 将多个RDD合并为一个RDD 举例: val pairs1 = Seq((A,1), (B,1), (C,1), (D, 1), (A, 2), (C, 3)) val rdd1 = sc.makeRDD(pairs1, 3) val pairs2 = Seq((A,4), (D,1), (E, 1)) val rdd2 = sc.makeRDD(pairs2, 2) rdd1.union(rdd2) 2. zip zip函数用于将两个RDD组合成Key/Value形式的RDD,如果两个rdd中的partition数量不一致,会报错。 举例: val s1 = Seq(A, B, C, D, E) val rdd1 = sc.makeRDD(s1) val s2 = Seq(1, 2, 3, 4, 5) val rdd2 = sc.makeRDD(s2) rdd1.zip(rdd2) 3. join join相当于SQL中的内关联join,只返回两个RDD根据K可以关联上的结果,join只能用于两个RDD之间的关联, 如果要多个RDD关联,多关联几次即可 举例: val pairs1 = Seq((A,1), (B,1), (C,1), (D, 1), (A, 2), (C, 3)) val rdd1 = sc.makeRDD(pairs1, 3) val pairs2 = Seq((A,4), (D,1), (C,1), (E, 1)) val rdd2 = sc.makeRDD(pairs2, 2) rdd1.join(rdd2) 还有些是是其他rdd操作符,这里就不讲解了,上述所写如有不对之处,还请各位前辈赐教。

优秀的个人博客,低调大师

JAVA多线程基础

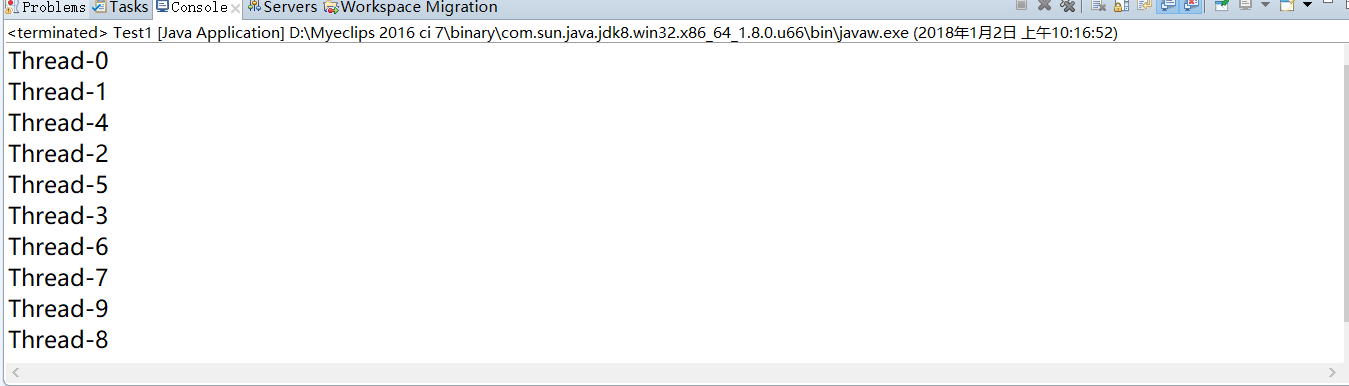
一:线程与进程 1 线程:进程中负责程序执行的执行单元 线程本身依靠程序进行运行 线程是程序中的顺序控制流,只能使用分配给程序的资源和环境 2 进程:执行中的程序 一个进程至少包含一个线程 3 单线程:程序中只存在一个线程,实际上主方法就是一个主线程 4 多线程:在一个程序中运行多个任务 目的是更好地使用CPU资源 二:线程的实现 1:继承Thread类 1 package Threads; 2 3 public class Thread_one extends Thread{ 4 5 @Override 6 public void run() { 7 // TODO Auto-generated method stub 8 System.out.println(Thread.currentThread().getName()); 9 } 10 } 我们继承Thread类,然后重写run()方法,写入你要执行的操作; 线程了类是创建好了,下面就是使用这个线程类: 1 package Threads; 2 3 public class Test1 { 4 public static void main(String[] args) { 5 for (int i = 0; i < 10; i++) { 6 new Thread_one().start(); 7 } 8 } 9 } 正确的启动线程的方法是start()方法,而不是使用run()方法,下面具体说明 ; 运行的结果: 我们可以发现多次运行结果是不一样的: 下面我们把启动改为run()试一试; 1 package Threads; 2 3 public class Test1 { 4 public static void main(String[] args) { 5 for (int i = 0; i < 10; i++) { 6 new Thread_one().run(); 7 } 8 } 9 } 多次运行发现结果都是一样的,发现运行的都是main这个主线程,而没有创建新的线程: 总结 run()和start()的区别: ①:首次正确启动一个线程是使用start()方法; ②:run()方法中只是定义需要执行的任务,如果调用run方法,即相当于在主线程中执行run方法,跟普通的方法调用没有任何区别,此时并不会创建一个新的线程来执行定义的任务。 ③:start()在调用start()方法后,线程就进入了就绪的状态,其实也就是一个可运行的状态,什么时候运行是根据cpu的调度的,看这个线程是否抢到了cpu的资源,所以说我们执行多个线程多次执行的顺序结果是不一样的; 2:实现Runnable 1 package Threads; 2 3 public class Thread_two implements Runnable{ 4 5 @Override 6 public void run() { 7 // TODO Auto-generated method stub 8 System.out.println(Thread.currentThread().getName()); 9 } 10 11 } 继承Thread和实现Runnable实现一个线程过程都差不多; 调用启动有些区别: 1 package Threads; 2 3 public class Test2 { 4 5 public static void main(String[] args) { 6 // TODO Auto-generated method stub 7 for (int i = 0; i < 10; i++) { 8 new Thread(new Thread_two()).start(); 9 } 10 } 11 } 我们查看Thread源码发现,他需要一个Runnable类型的对象; 我们附给他我们实现Runnable接口的对象 运行发现实现了效果: 总结: 实现Runnable接口比继承Thread类所具有的优势: 1):可以避免java中的单继承的限制 四:线程的不同状态及转换: 1、新建状态(New):新创建了一个线程对象。 2、就绪状态(Runnable):线程对象创建后,其他线程调用了该对象的start()方法。该状态的线程位于可运行线程池中,变得可运行,等待获取CPU的使用权。 3、运行状态(Running):就绪状态的线程获取了CPU,执行程序代码。 4、阻塞状态(Blocked):阻塞状态是线程因为某种原因放弃CPU使用权,暂时停止运行。直到线程进入就绪状态,才有机会转到运行状态。阻塞的情况分三种: (一)、等待阻塞:运行的线程执行wait()方法,JVM会把该线程放入等待池中。 (二)、同步阻塞:运行的线程在获取对象的同步锁时,若该同步锁被别的线程占用,则JVM会把该线程放入锁池中。 (三)、其他阻塞:运行的线程执行sleep()或join()方法,或者发出了I/O请求时,JVM会把该线程置为阻塞状态。当sleep()状态超时、join()等待线程终止或者超时、或者I/O处理完毕时,线程重新转入就绪状态。 5、死亡状态(Dead):线程执行完了或者因异常退出了run()方法,该线程结束生命周期。 解析: 新建状态: 只是创建了这个线程对象。 就绪状态: 该状态的线程位于可运行线程池中,变得可运行,等争抢到cpu资源后就才会真正的进入到可运行的状态; 运行状态:就绪状态的线程获取了CPU,执行程序代码。 阻塞状态: ①:wait(); 只能用 notify唤醒 或者notifyall ②:sleep 定义毫秒数,到时间自动唤醒,继续执行任务; ③:yield 线程的礼让,让正在执行的线程变成可运行状态,然后在重新争抢cpu。 yield()应该做的是让当前运行线程回到可运行状态,以允许具有相同优先级的其他线程获得运行机会。因此,使用yield()的目的是让相同优先级的线程之间能适当的轮转执行。但是,实际中无法保证yield()达到让步目的,因为让步的线程还有可能被线程调度程序再次选中。 ④:join加入主线程; 让正在运行的主线程停止,然后先运行这个线程。 1 package Threads; 2 3 public class Test3 { 4 public static void main(String[] args) { 5 System.out.println("开始:"); 6 Thread3 t2=new Thread3(); 7 Thread t=new Thread(t2); 8 t.start(); 9 System.out.println("结束:"); 10 } 11 } 这明显不是我们想要的结果: 使用join加入主线程: 1 package Threads; 2 3 public class Test3 { 4 public static void main(String[] args) throws InterruptedException { 5 System.out.println("开始:"); 6 Thread3 t2=new Thread3(); 7 Thread t=new Thread(t2); 8 t.start(); 9 t.join(); 10 System.out.println("结束:"); 11 } 12 } 在很多情况下,主线程生成并起动了子线程,如果子线程里要进行大量的耗时的运算,主线程往往将于子线程之前结束,但是如果主线程处理完其他的事务后,需要用到子线程的处理结果,也就是主线程需要等待子线程执行完成之后再结束,这个时候就要用到join()方法了。 总结: sleep和wait的区别: 1. 所属的层面不同:Thread类的方法:sleep() Object的方法:wait()。 2.wait停止的线程则需要使用notifyall()和notifi()唤醒;3. 每个对象都有一个锁来控制同步访问。Synchronized关键字可以和对象的锁交互,来实现线程的同步。 sleep方法没有释放锁,而wait方法释放了锁,使得其他线程可以使用同步控制块或者方法。4. wait,notify和notifyAll只能在同步控制方法或者同步控制块里面使用,而sleep可以在任何地方使用 ;5. sleep必须捕获异常,而wait,notify和notifyAll不需要捕获异常 五:线程常用的方法: sleep(): 强迫一个线程睡眠N毫秒。 isAlive(): 判断一个线程是否存活。 join(): 等待线程终止。 activeCount(): 程序中活跃的线程数。 enumerate(): 枚举程序中的线程。 currentThread(): 得到当前线程。 isDaemon(): 一个线程是否为守护线程。 setDaemon(): 设置一个线程为守护线程。(用户线程和守护线程的区别在于,是否等待主线程依赖于主线程结束而结束) setName(): 为线程设置一个名称。 wait(): 强迫一个线程等待。 notify(): 通知一个线程继续运行。 setPriority(): 设置一个线程的优先级。 六:线程的同步: 常用的同步方法就是使用synchronized关键字 为什么要使用线程同步,因为当一个资源可能会有多个线程访问的时候,当第一个线程进来之后对资源进行了修改,但是在修改的过程中第二个线程也进来了,那第二个线程取到的数据就不是最新的数据,是个虚假的数据,那么这个线程所执行的操作都没有意义了; 看个小例子: 1 package Threads; 2 3 public class Thread3 implements Runnable{ 4 private static int a=10; 5 @Override 6 public void run() { 7 // TODO Auto-generated method stub 8 try { 9 Tong(); 10 } catch (InterruptedException e) { 11 // TODO Auto-generated catch block 12 e.printStackTrace(); 13 } 14 } 15 public static void Tong() throws InterruptedException{ 16 for (int i = 0; i < 10; i++) { 17 System.out.println(Thread.currentThread().getName()+"||||"+(--a)); 18 Thread.sleep(1000); 19 } 20 } 21 } 22 23 24 25 26 package Threads; 27 28 public class Test3 { 29 public static void main(String[] args) throws InterruptedException { 30 System.out.println("开始:"); 31 Thread3 t2=new Thread3(); 32 Thread t=new Thread(t2); 33 Thread t3=new Thread(t2); 34 t.start(); 35 t3.start(); 36 t.join(); 37 t3.join(); 38 System.out.println("结束:"); 39 } 40 } 里面的sleep就是模拟让两个线程同时访问一个资源 运行结果为: 我们可以看到是有重复数据的,也就是虚假的数据 thread-0和thread-1同时访问了count:7这个数据; 解决办法就是使用同步方法: 1 package Threads; 2 3 public class Thread3 implements Runnable{ 4 private static int a=10; 5 @Override 6 public void run() { 7 // TODO Auto-generated method stub 8 try { 9 Tong(); 10 } catch (InterruptedException e) { 11 // TODO Auto-generated catch block 12 e.printStackTrace(); 13 } 14 } 15 public static synchronized void Tong() throws InterruptedException{ 16 for (int i = 0; i < 10; i++) { 17 System.out.println(Thread.currentThread().getName()+"||||"+(--a)); 18 Thread.sleep(1000); 19 } 20 } 21 } 加上synchronized 关键字 总结:其实同步就是对这个资源对象就行加锁,只能同时有一个线程能操作这个资源,如果有第二个线程要访问,那只有等第一个线程执行结束之后才能进行访问; 七:实现经典多线程例子生产者,消费者: 首先创建商品类 1 package Threads; 2 3 public class Piao { 4 private int count=5; 5 6 public synchronized void sheng() throws InterruptedException{ 7 if(count>=10){ 8 System.out.println("商品过多:"+count); 9 wait(); 10 }else{ 11 System.out.println("商品生产成功:"+(++count)); 12 notify(); 13 } 14 } 15 public synchronized void mai() throws InterruptedException{ 16 if(count<=0){ 17 System.out.println("商品库存不够:"+count); 18 wait(); 19 }else{ 20 System.out.println("商品卖出成功:"+(--count)); 21 notify(); 22 } 23 } 24 } 在创建生产者和消费者: 1 package Threads; 2 3 public class Sheng implements Runnable{ 4 private Piao p; 5 6 public Sheng(Piao p) { 7 super(); 8 this.p = p; 9 } 10 @Override 11 public void run() { 12 // TODO Auto-generated method stub 13 for (int i = 0; i < 10; i++) { 14 try { 15 p.sheng(); 16 } catch (InterruptedException e) { 17 // TODO Auto-generated catch block 18 e.printStackTrace(); 19 } 20 } 21 } 22 } 23 24 25 26 27 package Threads; 28 29 public class Mai implements Runnable{ 30 private Piao p; 31 32 public Mai(Piao p) { 33 super(); 34 this.p = p; 35 } 36 @Override 37 public void run() { 38 // TODO Auto-generated method stub 39 for (int i = 0; i < 10; i++) { 40 try { 41 p.mai(); 42 } catch (InterruptedException e) { 43 // TODO Auto-generated catch block 44 e.printStackTrace(); 45 } 46 } 47 } 48 } 测试类: 1 package Threads; 2 3 public class Test4 { 4 5 public static void main(String[] args) { 6 // TODO Auto-generated method stub 7 Piao p=new Piao(); 8 new Thread(new Mai(p)).start(); 9 new Thread(new Sheng(p)).start(); 10 } 11 12 } 运行结果为: 欢迎大家一起说出自己的想法。

优秀的个人博客,低调大师

dubbo之基础应用

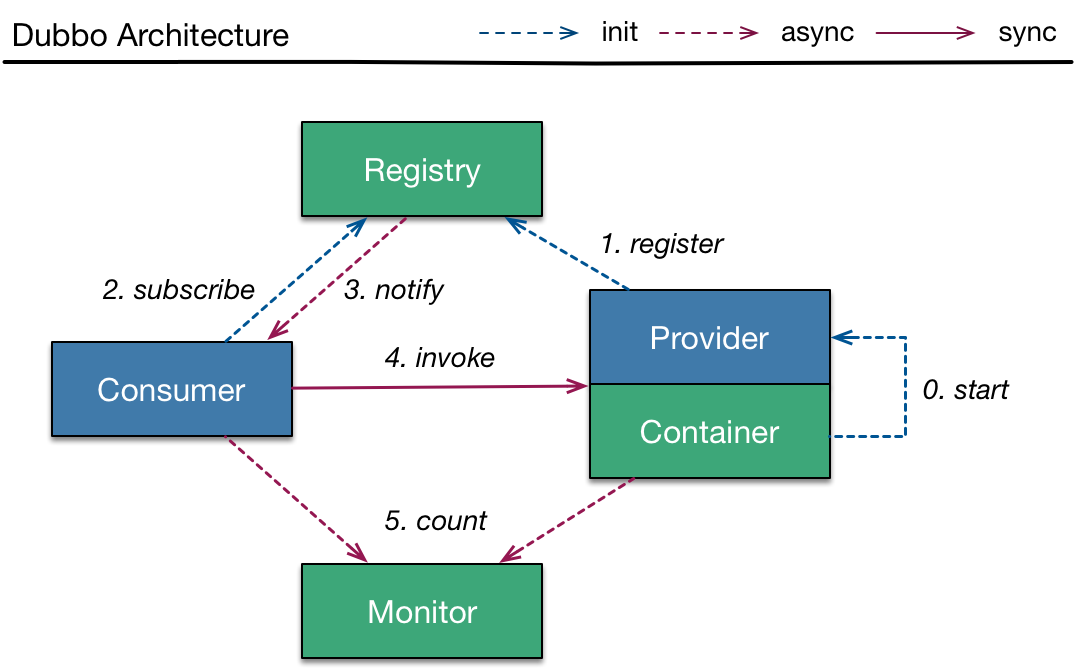
一、Dubbo是Alibaba开源的分布式服务框架,它最大的特点是按照分层的方式来架构,使用这种方式可以使各个层之间解耦合(或者最大限度地松耦合)。从服务模型的角度来看,Dubbo采用的是一种非常简单的模型,要么是提供方提供服务,要么是消费方消费服务,所以基于这一点可以抽象出服务提供方(Provider)和服务消费方(Consumer)两个角色。关于注册中心、协议支持、服务监控等内容,详见后面描述。 二、dubbo的基本原理(这个是用于dubbo的工作原理比较重要的一个环节) 这是图中的几个节点的意义 Provider:暴露服务的服务提供方,或者直白点说就是服务生产者 Consumer:调用远程服务的服务消费方,也就是服务消费者 Registry:服务注册与发现的注册中心 Monitor:统计服务的调用次数和调用时间的监控中心 Container:服务(生产者)运行容器 具体的调用步骤 0:服务容器负责启动、加载、运行服务提供者(生产者) 1:服务提供者(生产者)在启动时,向注册中心注册自己提供的服务 2:服务消费者在启动时,向注册中心订阅自己所需的服务 3:注册中心返回服务提供者地址列表给消费者,如果有变更,注册中细腻将基于长连接推送变更数据给消费者 4:服务消费者从服务生产者地址列表中,基于软负载均衡算法,选择一台提供者(生产者)进行调用,如果调用失败,再选另一台调用 5:服务消费者和提供者(生产者),在内存中累计调用次数和调用时间,定时每分钟发送一次统计数据到监控中心 三、下面我会通过一个例子来说明具体的实现过程,以及配置 1)说明:dubbo是用来做分布式工程而提出来的一个框架。相对于原来的单体工程来说,dubbo的灵活性,以及调整的方式都更加灵活。dubbo的方式是将service一下的单独提出来做成一个项目,也就是我们提到的SOA模式,面向服务的框架。在设计中,web端只看得到对应的接口,而不需要知道实现过程。具体的实现过程在另外一个项目实现。中间的通行通过zookeeper来实现传输。 2)我这里写了一个简单的例子来说明这个服务提供的过程,和相对应用独立使用的过程。(目录) 1、do-parent用来加载公用的jar包,没有实际代码 a、pom.xml <?xml version="1.0" encoding="UTF-8"?> <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"> <modelVersion>4.0.0</modelVersion> <groupId>com.troy</groupId> <artifactId>do-parent</artifactId> <version>1.0-SNAPSHOT</version> <modules> <module>do-interface</module> <module>do-service</module> <module>do-web</module> </modules> <parent> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-parent</artifactId> <version>1.5.9.RELEASE</version> </parent> <dependencies> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> <version>1.5.9.RELEASE</version> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-jpa</artifactId> <version>1.5.9.RELEASE</version> </dependency> <dependency> <groupId>com.alibaba</groupId> <artifactId>dubbo</artifactId> <version>2.5.7</version> </dependency> <dependency> <groupId>mysql</groupId> <artifactId>mysql-connector-java</artifactId> <version>5.1.9</version> </dependency> <dependency> <groupId>org.apache.zookeeper</groupId> <artifactId>zookeeper</artifactId> <version>3.4.9</version> </dependency> <dependency> <groupId>com.101tec</groupId> <artifactId>zkclient</artifactId> <version>0.10</version> </dependency> </dependencies> </project> 2、do-interface用来提供暴露的接口,提供给do-web和do-service。共同的调用方法 a、目录结构 b、User共同使用的实体类 package com.troy.domain; import javax.persistence.*; import java.io.Serializable; @Entity @Table(name = "USER") public class User implements Serializable{ @Id @GeneratedValue(strategy = GenerationType.AUTO) private Long id; private String name; private Integer age; public Long getId() { return id; } public void setId(Long id) { this.id = id; } public String getName() { return name; } public void setName(String name) { this.name = name; } public Integer getAge() { return age; } public void setAge(Integer age) { this.age = age; } } c、IUserService只用来提供接口,不做任何实现 package com.troy.service; import com.troy.domain.User; import java.util.List; public interface IUserService { public List<User> findAll(); } d、application-dao.yml的配置用来连接数据库,这个因为我用的是一套数据库,所以公用的数据库配置 spring: datasource: driver-class-name: com.mysql.jdbc.Driver url: jdbc:mysql://localhost:3306/model?useUnicode=true&amp;characterEncoding=UTF-8 password: root username: root 3、do-service用来提供具体的接口实现 a、目录结构 b、repository用来,设置基本的数据库访问层 package com.troy.repository; import org.springframework.data.jpa.repository.JpaSpecificationExecutor; import org.springframework.data.repository.NoRepositoryBean; import org.springframework.data.repository.PagingAndSortingRepository; import java.io.Serializable; @NoRepositoryBean public interface BaseRepository<T,I extends Serializable> extends PagingAndSortingRepository<T,I>,JpaSpecificationExecutor<T> { } package com.troy.repository; import com.troy.domain.User; public interface UserRepository extends BaseRepository<User,Long> { } c、service用来写具体的实现过程 package com.troy.service; import com.troy.domain.User; import com.troy.repository.UserRepository; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.stereotype.Service; import javax.transaction.Transactional; import java.util.ArrayList; import java.util.Iterator; import java.util.List; @Service(value = "userService") @Transactional public class UserServiceImpl implements IUserService { @Autowired private UserRepository userRepository; public List<User> findAll() { List<User> users = new ArrayList<User>(); Iterator<User> iterator = this.userRepository.findAll().iterator(); while (iterator.hasNext()) { users.add(iterator.next()); } return users; } } d、config下面是进行相关的配置,对于服务提供者 package com.troy.config; import org.springframework.context.annotation.Configuration; import org.springframework.context.annotation.ImportResource; @Configuration @ImportResource("classpath:dubbo/*.xml") public class DubboProvider { } dubbo-provider.xml的具体配置 <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:dubbo="http://code.alibabatech.com/schema/dubbo" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://code.alibabatech.com/schema/dubbo http://code.alibabatech.com/schema/dubbo/dubbo.xsd"> <!-- 提供方应用信息,用于计算依赖关系 --> <dubbo:application name="dubbo-provider" /> <!-- 使用zookeeper注册中心暴露服务地址 --> <dubbo:registry protocol="zookeeper" address="192.168.5.10:2181" /> <!-- 用dubbo协议在20880端口暴露服务 --> <dubbo:protocol name="dubbo" port="20880" /> <!-- 用户服务接口 --> <dubbo:service interface="com.troy.service.IUserService" ref="userService" /> </beans> e、具体的启动过程 package com.troy; import org.springframework.boot.SpringApplication; import org.springframework.boot.autoconfigure.SpringBootApplication; import java.util.HashMap; import java.util.Map; @SpringBootApplication public class ApplicationService { public static void main(String[] args) { SpringApplication application = new SpringApplication(ApplicationService.class); Map<String,Object> map = new HashMap<String, Object>(); //这里的目的是加入相关配置 map.put("spring.profiles.default","service,dao"); application.setDefaultProperties(map); application.run(args); } } 4、do-web的目的是用来获取数据,提供数据,当然也可以用来具体页面的呈现 a、目录接口 b、web,具体的数据提供者 package com.troy.web; import com.troy.service.IUserService; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.context.annotation.Scope; import org.springframework.web.bind.annotation.RequestMapping; import org.springframework.web.bind.annotation.RequestMethod; import org.springframework.web.bind.annotation.RestController; @RestController @RequestMapping("/api/user") @Scope("prototype") public class UserResource { @Autowired private IUserService userService; @RequestMapping(value = "/findAll") public Object findAll() { return this.userService.findAll(); } } c、config消费者配置 package com.troy.config; import org.springframework.context.annotation.Configuration; import org.springframework.context.annotation.ImportResource; @Configuration @ImportResource("classpath:dubbo/*.xml") public class DubboConsumer { } dubbo-consumer.xml <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:dubbo="http://code.alibabatech.com/schema/dubbo" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://code.alibabatech.com/schema/dubbo http://code.alibabatech.com/schema/dubbo/dubbo.xsd"> <!-- 消费方应用名,用于计算依赖关系,不是匹配条件,不要与提供方一样 --> <dubbo:application name="dubbo-consumer" /> <!-- 使用zookeeper注册中心暴露服务地址 --> <!-- 注册中心地址 --> <dubbo:registry protocol="zookeeper" address="192.168.5.10:2181" /> <!-- 用户服务接口 --> <dubbo:reference interface="com.troy.service.IUserService" id="userService" check="false" /> </beans> d、启动配置 package com.troy; import org.springframework.boot.SpringApplication; import org.springframework.boot.autoconfigure.SpringBootApplication; import java.util.HashMap; import java.util.Map; @SpringBootApplication public class Application { public static void main(String[] args) { SpringApplication application = new SpringApplication(Application.class); Map<String,Object> map = new HashMap<String, Object>(); map.put("spring.profiles.default","web,dao"); application.setDefaultProperties(map); application.run(args); } } 四、中间需要用到zookeeper,来做注册中心。 zookeeper的安装部署:http://www.cnblogs.com/ll409546297/p/7526953.html zookeeper的展示界面:http://www.cnblogs.com/ll409546297/p/7814564.html 五、dubbo的方式,目前各大网站上面应用的非常普遍。当然我这边只是做的一个例子用来,了解dubbo的分布式实现过程,和具体的应用方式。 代码层面存在不理想的地方,请见谅!!! 源码下载:https://pan.baidu.com/s/1c1SUnFa

优秀的个人博客,低调大师

Linux常用基础命令

一、系统目录结构 约定俗成: bin (binaries)存放二进制可执行文件 sbin (super user binaries)存放二进制可执行文件,只有root才能访问 etc (etcetera)存放系统配置文件 usr (unix shared resources)用于存放共享的系统资源 home 存放用户文件的根目录 root 超级用户目录 dev(devices)用于存放设备文件 lib (library)存放跟文件系统中的程序运行所需要的共享库及内核模块 mnt (mount)系统管理员安装临时文件系统的安装点 boot 存放用于系统引导时使用的各种文件 tmp (temporary)用于存放各种临时文件 var (variable)用于存放运行时需要改变数据的文件 二、基本命令 1.目录操作 相对路径和绝对路径说明: 现在在/home/dijia478/下 ./a/b.txt和a/b.txt都表示相对路径,当前目录下的a文件夹下的b.txt文件 /home/dijia478/a/b.txt表示绝对路径,根目录下的home文件夹下的dijia478文件夹下的a文件夹下的b.txt文件 cd ./a 切换到当前目录的a文件夹 cd .. 切换到上一层目录 cd / 切换到系统根目录 cd ~ 切换到用户主目录 cd - 切换到上一个所在目录 pwd 显示当前所在目录的绝对路径 2.查看文件列表 ls /path/显示该目录所有文件或文件夹名 ls -a 显示所有文件或文件夹名(包含隐藏的) ls -l 按列表显示所有文件或文件夹,缩写成ll ll -h 友好的显示文件大小(显示成K,MB,GB) 3.创建和删除文件夹 mkdir app 创建app文件夹 mkdir –p app2/test 级联创建aap2以及test文件夹 rmdir app 删除app目文件夹(需要是空文件夹) 4.文件操作 rm a.txt 删除a.txt文件,删除需要用户确认,y/n rm -f a.txt 不询问,直接删除a.txt文件 rm -r a 递归删除a文件夹(无论是否有内容) rm -rf a 不询问递归删除a文件夹(慎用) rm -rf * 删除当前目录下所有内容(最好别用) rm -rf /* no 作 no die(Linux系统就玩完了) cp a.txt b.txt 将a.txt复制为b.txt文件 cp a.txt ../ 将a.txt文件复制到上一层目录中 mv a.txt ../ 将a.txt文件移动到上一层目录中 mv a.txt b.txt 将a.txt文件重命名为b.txt touch a.txt 创建一个空的a.txt文件 echo "good good study" > a.txt 把">"左边的输出内容放到右边的文件里去,如果存在就覆盖,如果不存在就创建 vi a.txt 用文本编辑器编辑一个文件,如果不存在就创建 5.文件打包归档和压缩 tar -cvf file.tar dirpath filepath 将dir文件夹和file文件在当前目录下打包成file.tar tar –xvf file.tar 解包到当前目录 gzip file.tar 压缩文件或文件夹 gzip –d file.tar.gz 解压文件或文件夹 tar -czvf file.tar.gz dirpath filepath 将dir文件夹和file文件在当前目录下打包并压缩成file.tar.gz tar -xzvf file.tar.gz 解压并解包到当前目录下 tar -xzvf file.tar.gz -C /home/dijia478/ 解压并解包到/home/dijia478/目录下 常用参数: -c:创建一个新tar文件 -v:显示运行过程的信息 -f:指定文件名 -z:调用gzip压缩命令进行压缩 -t:查看压缩文件的内容 -x:解开tar文件 zip test.txt.zip test.txt 也是打包并压缩 unzip test.txt.zip 解包并解包 6.查看文本文件 cat a.txt 一次性显示整个文件内容 more a.txt 可以分页看(翻页:空格,往回翻:b ,退出: q或者 Ctrl+C) less a.txt 不仅可以分页,还可以方便地搜索,回翻等操作(翻页:空格,往回翻:↑,往下翻:↓,退出:q或者 Ctrl+C) tail -10 a.txt 查看文件的尾部的10行 tail -f user.log 实时刷新显示文件的尾部,这条命令对于观察调试程序的运行非常重要 head -20 a.txt 查看文件的头部20行 注:ctrl+c 结束查看 7.搜索查找命令 grep‘haha’./* 打印当前目录下所有文件中含有'haha'的地方(支持正则表达式) grep -c‘haha’./* 显示匹配到的行数 grep -r‘haha’./* 对子目录也进行遍历搜索 grep -l‘haha’./* 只显示命中的文件名 grep -n‘haha’./* 显示命中的行号 grep -ld skip‘haha’./* 显示命中的文件名,不要搜索子目录 参数含义: -r 递归搜索子目录 -l 只列出有匹配行的文件名 -n 列出匹配行的行号 -d skip 不搜索子文件夹 常用grep跟其他命令组合使用来查找我们关心的信息(管道) 示例: service --status-all | grep 'httpd' 在当前系统所有服务中查找'httpd' netstat -nltp | grep '22' 查找监听'22'端口的服务程序 ps –ef | grep java 查找系统中当前运行的java进程 find ./ -name '*.txt' 查找以.txt结尾的文件(会遍历当前目录) find ./ -name ‘install*’ 查找以install开头的文件或文件夹 find ./ -type f 查找普通文件 find ./ -type l 查找连接文件(快捷方式) 8.文本命令 > 重定向输出,覆盖原有内容; >> 重定向输出,又追加功能; cat /etc/passwd > a.txt 将密码文件输出定向到a.txt中 cat /etc/passwd >> a.txt 输出并且追加 ifconfig > ifconfig.txt 保存ip信息到文件中 wc -l a.txt 统计文本行数 wc -w a.txt 统计文本单词数 wc -m a.txt 统计文本字符数 wc -c a.txt 统计文本字节数 vi编辑器 vi filepath 打开文件 按Esc键 切换到命令行模式 切换到插入模式: i 在当前位置生前插入 I 在当前行首插入 a 在当前位置后插入 A 在当前行尾插入 o 在当前行之后插入一行 O 在当前行之前插入一行 dd 删除整行 7 dd 向上删除7行 U 回退(类似于windows 中 ctrl + z) R 替换 :(冒号) 切换到底行模式 :q 退出 :wq 保存并退出(shift + zz也可以保存) :q! 不保存退出 9.其他常用命令 echo $JAVA_HOME 输出变量JAVA_HOME的值 whoami 查询当前登陆的用户名 which ls 查询ls命令的$PATH路径 mkdir test && cd test 只有在 && 左边的命令返回真(命令返回值 $? == 0),&& 右边的命令才会被执行。 只要有一个命令返回假(命令返回值 $? == 1),后面的命令就不会被执行。 三、用户管理命令 1.添加用户 基本示例: useradd user001 passwd 123456 需要设置密码 参数手册: -u 指定组ID(uid) -g 指定所属的组名(gid) -G 指定多个组,用逗号“,”分开(Groups) -c 用户描述(comment) -d 指定用户目录 -e 失效时间(expire date) 2.删除用户 userdel user002 这样删除的时候,用户的主目录会被保留 userdel -r user002 删除用户的同时删除用户的主目录 3.修改用户属性 指令:usermod 参数: -l 修改用户名 (login)usermod -l a b(b改为a) -g 修改组 usermod -g sys tom -d 修改用户的宿主目录 -G 添加多个组 usermod -G sys,root tom -L 锁定用户账号密码(Lock) -U 解锁用户账号(Unlock) 示例: usermod -l user002 user001 将user001的登陆名改为user002 usermod -g root user002 将user002的组改为root组 usermod -G hello1,hello2 user002 给user002添加两个组hello1,hello2 usermod -d /home/dijia478 user002 将user002的主目录改成/home/dijia478 (要事先创建dijia478目录,并且拷入环境变量文件) 4.用户组管理 用户组相关属性: 每个用户至少属于一个用户组 (创建新用户时如果不指定所属组,则会自动创建并归属到一个跟用户名同名的组) 每个用户组可以包含多个用户 同一个用户组的用户享有该组共有的权限 用户组管理操作命令: groupadd java 创建用户组 groupdel hello2 删除用户组 groupmod –n newname oldname 修改用户组名称 groups user002 查看用所属的组 5.用户及用户组相关配置文件 用户配置信息存放位置: 保存用户信息的文件:/etc/passwd 保存密码的文件:/etc/shadow passwd文件示例: user002:x:500:500:user002:/home/user002:/bin/bash passwd文件各字段含义: account:password:UID:GID:GECOS:directory:shell shadow文件示例: user002:$1$vRug41$UUxYzdP0i6s6wtUPieGDQ/:18617:0:99999:7::: shadow文件各字段含义: 用户名 登陆系统的用户名 密码 加密密码 最后一次修改时间 用户最后一次修改密码距现在的天数,从1970-1-1起 最小时间间隔 两次修改密码之间的最小天数 最大时间间隔 密码有效天数 警告时间 从系统警告到密码失效的天数 账号闲置时间 账号闲置时间 失效时间 密码失效的天数 标志 标志 用户组配置信息存放位置: 保存用户组的文件:/etc/group 保存用户组密码的文件:/etc/gshadow(设置组管理员时才有用) 6.其他的用户管理命令 id user002 查看一个用户的UID和GID su user001 切换到user001用户 su - user001 切换到user001用户,并且将环境也切换到user001用户的环境(推荐使用) exis 退出当前shell(会退出当前登录用户) 四、网络配置管理 1.网卡地址配置 检查网络连通性: ping 要测试的ip 查看ip地址 ifconfig 查看所有网络设备的地址信息 ifconfig eth0 查看指定的eth0以太网卡的地址信息 修改ip地址 ifconfig eth0 192.168.2.150 netmask 255.255.255.0 通过setup修改网络配置 在root权限下执行setup指令可以打开一个带菜单的伪图形界面来修改网络配置 通过配置文件修改ip地址 vi /etc/sysconfig/network-scripts/ifcfg-eth0 修改该配置文件即可改ip地址 [root@localhost ~]# vi /etc/sysconfig/network-scripts/ifcfg-eth0 DEVICE=eth0 BOOTPROTO=none HWADDR=00:0c:29:f1:b2:e8#网卡物理地址 IPV6INIT=yes NM_CONTROLLED=yes ONBOOT=yes TYPE=Ethernet UUID="b3cd1ac3-aecf-4845-9812-9337135c072b" IPADDR=192.168.2.199# IP地址 NETMASK=255.255.255.0#子网掩码 DNS2=8.8.8.8#域名服务器2 GATEWAY=192.168.2.1#网关 DNS1=192.168.2.1#域名服务器1 USERCTL=no 2.主机名配置管理 查看主机名 在shell提示符的@后有显示 或者用hostname指令打印出主机名 修改主机名 vi /etc/sysconfig/network 修改其中的hostname配置项: HOSTNAME=newname 修改完成之后要重启服务器才能生效 要想立即生效,可以执行指令 hostname newname,然后注销重登陆 主机名-IP映射,服务器本地映射 服务器网络寻址时默认是现在本地的hosts文件中查找IP映射,通过修改hosts来映射局域网内部的主机名非常方便 实现方法,将局域网内的每一台主机的“hostnamip”写入每一台主机的hosts文件中: vi /etc/hosts 192.168.2.150 user001-server-01 192.168.2.151 user001-server-02 192.168.2.152 user001-server-03 3.网络服务启动与停止 列出系统所有应用服务状态: service --status-all 查看指定服务运行状态: service servicename status 启动服务: service servicename start 停止服务: service servicename stop 列出所有服务的随机自起配置: chkconfig --list 关闭服务的随机自起: chkconfig servicename off 开启服务的随机自起: chkconfig servicename on 常用示例: 重启网络服务:service network restart 停止httpd:service httpd stop 启动httpd:service httpd start 关闭防火墙服务:service iptables stop 关闭防火墙自动启动:chkconfig iptables off 4.查看网络连接信息 指令:netstat netstat常用示例: netstat -natp netstat -nltp netstat -naup netstat -an | grep 3306 查询3306端口占用情况 常用参数解释: -a 显示所有连接和监听端口 -l 只显示监听进程 -t (tcp)仅显示tcp相关选项 -u (udp)仅显示udp相关选项 -n 拒绝显示别名,能显示数字的全部转化成数字。 -p 显示建立相关链接的程序名 五、常用系统管理命令 1.磁盘/内存使用信息查看 df -h 查看磁盘空间状态信息 du -sh * 查看指定目录下所有子目录和文件的汇总大小 free 查看内存使用状况 2.进程管理 top 查看实时刷新的系统进程信息 ps -ef 查看系统中当前瞬间的进程信息快照 ps -ef | grep myshell.sh 搜索myshell进程的信息 kill -9 pid 杀掉进程(-9 表示强制杀死) 3.sudo权限的配置 root用户因为具有不受限制的权限,使用不慎可能对系统造成不可估量的损害,因而,生产实际中,轻易不要使用su去切换到root的身份 如果普通用户需要使用一些系统级管理命令,可以使用sudo来执行,比如 sudo vi /etc/profile 给普通用户赋予sudo权限,配置方法如下: 例如,要给hadoop用户赋予sudo任何指令(或某条指定的命令)的权利,则编辑sudoers文件vi /etc/sudoers 在其中加入需要赋予权限的用户(红色标识) …… root ALL=(ALL) ALL #让hadoop用户可以用root身份执行所有指令 hadoopALL=(ALL) ALL #让user002用户可以用root身份执行所有指令 ItcastALL=(root)/usr/sbin/useradd, /usr/bin/passwd …… 检查是否生效: [root@user001-server-01 user002]# sudo -lU user002 User user002 is not allowed to run sudo on user001-server-01. 4.修改系统的默认启动级别 vi /etc/inittab # 0 - halt (Do NOT set initdefault to this) # 1 - Single user mode # 2 - Multiuser, without NFS (The same as 3, if you do not have networking) # 3 - Full multiuser mode # 4 - unused # 5 - X11 # 6 - reboot (Do NOT set initdefault to this) # id:3:initdefault: ~ 用level 3 就启动全功能状态的命令行界面,5是图形界面。不要设置其他的,容易作死。 在命令行模式下,用startx可以手动启动图形界面(在服务器上操作) 5.文件权限管理 Linux三种文件类型: 普通文件: 包括文本文件、数据文件、可执行的二进制程序文件等。 目录文件: Linux系统把目录看成是一种特殊的文件,利用它构成文件系统的树型结构。 设备文件: Linux系统把每一个设备都看成是一个文件 文件类型标识: 普通文件(-) 目录(d) 符号链接(l) * 进入etc可以查看,相当于快捷方式 字符设备文件(c) 块设备文件(s) 套接字(s) 命名管道(p) 文件权限管理: chmod u+rwx a.txt 为a.txt添加所属用户的rwx权限 chmod 755 a.txt 为a.txt设置所属用户rwx权限,所属组rx权限,其他用户rx权限(r-4,w-2,x-1) chmod u=rwx,g=rx,o=rx a.txt (u代表所属用户 g代表所属组的成员用户 o代表其他用户) chown user001:hello1 a.txt 将a.txt的所有者改成user001用户,所属组改成hello1组(需要root权限) chown -R user001:hello1 dir 将dir文件夹的所有者改成user001用户,所属组改成hello1组(需要root权限) 6.其他系统管理命令 date "+%Y%m%d" 按格式显示当前系统时间 date -s "2020-01-01 10:10:10" 设置系统时间 clear 清屏幕(只是滚到上面看不到了) uname 显示系统信息。 uname -a 显示本机详细信息。 依次为:内核名称(类别),主机名,内核版本号,内核版本,内核编译日期,硬件名,处理器类型,硬件平台类型,操作系统名称

优秀的个人博客,低调大师

elk组件 基础语法

1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 Shipper->Broker->Indexer->ES 1.input input{stdin{}} output{ stdout{codec=>rubydebug} } file { codec=>multiline{ pattern=> "^\s" what=> "previous" } path=>[ "xx" , "xx" ] exclude=> "1.log" add_field=>[ "log_ip" , "xx" ] tags=> "tag1" #设置新事件的标志 delimiter=> "\n" #设置多长时间扫描目录,发现新文件 discover_interval=>15 #设置多长时间检测文件是否修改 stat_interval=>1 #监听文件的起始位置,默认是end start_position=>beginning #监听文件读取信息记录的位置 sincedb_path=> "E:/software/logstash-1.5.4/logstash-1.5.4/test.txt" #设置多长时间会写入读取的位置信息 sincedb_write_interval=>15 } 2.filter filter{ multiline{ #指定合并规则——所有不是以数字开头的行需要被合并 pattern=> "^[^\d]" #合并到哪里——上一行 what=> "previous" } filter{ multiline{ type => "type" #类型,不多说 pattern=> "pattern,aregexp" #参数,也可以认为是字符,有点像grep,如果符合什么字符就交给下面的what去处理 negate=>boolean what=> "previous" or "next" #这个是符合上面pattern的要求后具体怎么处理,处理方法有两种,合并到上面一条日志或者下面的日志 } } filter{ grep { match=>[ "@message" , "PHPFatalerror" ] drop=> false add_tag=>[fatal_error] } grep { tags=>[fatal_error] match=>[ "@message" , ".*(xbox\.com|xbox\.mib\.com\.cn|supports\.game\.mib\.com\.cn)" ] drop=> false add_tag=>[xboxerror] } } #过滤掉内容包含5.3.3与down以外日志 filter{ if [message]!~ "5.3.3|down" { ruby{ code=> "event.cancel" } } } #使用自带的过滤规则显示更多的字段 filter{ grok{ match=>{ "message" => "%{COMBINEDAPACHELOG}" } } } #合并不是以[开头的日志 filter{ multiline{ pattern=> "^[^[]" negate=> true what=> "previous" } } filter{ if [path]=~ "error" { mutate{replace=>{ "type" => "apache_error" }} grok{ match=>{ "message" => "%{COMBINEDAPACHELOG}" } } } date { match=>[ "timestamp" , "dd/MMM/yyyy:HH:mm:ssZ" ] } } filter{ if [path]=~ "access" { mutate{replace=>{ type => "apache_access" }} grok{ match=>{ "message" => "%{COMBINEDAPACHELOG}" } } date { match=>[ "timestamp" , "dd/MMM/yyyy:HH:mm:ssZ" ] } } else if [path]=~ "error" { mutate{replace=>{ type => "apache_error" }} } else { mutate{replace=>{ type => "random_logs" }} } } 3.output 发邮件 output{ email{ match=>[ "@message" , "aaaaa" ] to=> "storyskya@gmail.com" from=> "monitor@mib.com.cn" options=>[ "smtpIporHost" , "smtp.mibnet.com" , "port" , "25" , "userName" , "monitor@mib.com.cn" , "starttls" , "true" , "password" , "opmonitor" , "authenticationType" , "login" ] subject=> "123" body=> '123' via=>smtp } } output{ if [ type ]== "syslog" { elasticsearch{ hosts=> "172.16.0.102:9200" index=> "syslog-%{+YYYY.MM.dd}" } } if [ type ]== "nginx" { elasticsearch{ hosts=> "172.16.0.102:9200" index=> "nglog-%{+YYYY.MM.dd}" } } #匹配内容包含paramiko与simplejson的日志通邮件发送 if [message]=~ /paramiko |simplejson/{ email{ to=> "12222222@wo.cn" from=> "good_zabbix@163.com" contenttype=> "text/plain;charset=UTF-8" address=> "smtp.163.com" username=> "test@163.com" password=> "12344" subject=> "服务器%{host}日志异常" body=> "%{@timestamp}%{type}:%{message}" } } } output{ stdout{codec=>rubydebug} redis{ host=> '192.168.1.104' data_type=> 'list' key=> 'logstash:redis' } } output{ elasticsearch{host=>localhost} stdout{codec=>rubydebug} } 替换 mutate{ type => "phplog" gsub=>[ "@message" , "'" , "\"" ] } 调试 #/usr/local/logstash-1.5.2/bin/logstash-e'input{stdin{}}output{stdout{}}' curl' logstash-e 'input{stdin{}}output{stdout{codec=>rubydebug}}' # logstash agent -f logstash-simple.conf --verbose //开启debug模式 本文转自 liqius 51CTO博客,原文链接:http://blog.51cto.com/szgb17/1865408,如需转载请自行联系原作者

优秀的个人博客,低调大师

Docker 基础命令介绍

Docker是一种C/S结构,所以就会有客户端和服务端。Docker支持很多子命令,例如我们在命令行docker然后tab键会出来很多命令 当然docker工具很多,除了docker命令行工具,用户也可以通过 REST API 与服务器通信 Docker daemon是服务器组件,以 Linux 后台服务的方式运行。可以通过命令:systemctl status docker.service看到 Docker daemon 运行在 Docker host 上,负责创建、运行、监控容器,构建、存储镜像。 监听地址的配置: 默认docker daemon只能监听本地host,如果远程要访问,需要打开tcp监听,如下: 1 /etc/systemd/system/multi-user .target.wants /docker .service 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 [Unit] Description=DockerApplicationContainerEngine Documentation=https: //docs .docker.com After=network.targetdocker.socketfirewalld.service Requires=docker.socket [Service] Type=notify #thedefaultisnottousesystemdforcgroupsbecausethedelegateissuesstill #existsandsystemdcurrentlydoesnotsupportthecgroupfeaturesetrequired #forcontainersrunbydocker ExecStart= /usr/bin/dockerd -Hfd: // #上面这里如果改成这样就开启了监听远程所有端口:ExecStart=/usr/bin/dockerd-Hfd://-Htcp://0.0.0.0 ExecReload= /bin/kill -sHUP$MAINPID LimitNOFILE=1048576 #Havingnon-zeroLimit*scausesperformanceproblemsduetoaccountingoverhead #inthekernel.Werecommendusingcgroupstodocontainer-localaccounting. LimitNPROC=infinity LimitCORE=infinity #UncommentTasksMaxifyoursystemdversionsupportsit. #Onlysystemd226andabovesupportthisversion. TasksMax=infinity TimeoutStartSec=0 #setdelegateyessothatsystemddoesnotresetthecgroupsofdockercontainers Delegate= yes #killonlythedockerprocess,notallprocessesinthecgroup KillMode=process [Install] WantedBy=multi-user.target 重启服务端docker 1 2 systemctldaemon-reload systemctlrestartdocker.service 调试 可以通过在客户端通过H参数来指定服务器和info子命令来查看服务端信息 这里可以看到哦啊服务端运行情况 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 root@d1: /etc/apt #docker-H192.168.56.132info Containers:1 Running:0 Paused:0 Stopped:1 Images:1 ServerVersion:17.03.1-ce StorageDriver:aufs RootDir: /var/lib/docker/aufs BackingFilesystem:extfs Dirs:9 Dirperm1Supported: true LoggingDriver:json- file CgroupDriver:cgroupfs Plugins: Volume: local Network:bridgehostmacvlannulloverlay Swarm:inactive Runtimes:runc DefaultRuntime:runc InitBinary:docker-init containerdversion:4ab9917febca54791c5f071a9d1f404867857fcc runcversion:54296cf40ad8143b62dbcaa1d90e520a2136ddfe initversion:949e6fa SecurityOptions: apparmor seccomp Profile:default KernelVersion:4.4.0-31-generic OperatingSystem:Ubuntu16.04.1LTS OSType:linux Architecture:x86_64 CPUs:2 TotalMemory:3.842GiB Name:d1 ID:SQ7Y:TBJA:LS5G:IQNB:CIHC:6T2D:J22X:F3QK:7AS2:7KLN:NIIQ:JLXY DockerRootDir: /var/lib/docker DebugMode(client): false DebugMode(server): false Registry:https: //index .docker.io /v1/ WARNING:Noswaplimitsupport Experimental: false InsecureRegistries: 127.0.0.0 /8 RegistryMirrors: http: //febb9aec .m.daocloud.io LiveRestoreEnabled: false 本文转自 kesungang 51CTO博客,原文链接:http://blog.51cto.com/sgk2011/1923361,如需转载请自行联系原作者

优秀的个人博客,低调大师

Mongodb基础实践(二)

在前面的文章里面主要介绍了MongoDB的文档,集合,数据库等操作和对文档的增、删、改相关知识,接下来会总结一点有关查询的相关知识。 在MySQL中,我们知道数据查询是优化的主要内容,读写分离等技术都是可以用来处理数据库查询优化的,足以见数据库查询是每个系统中很重要的一部分,之前介绍了find的简单使用,下面会介绍一些相对比较复杂一点的查询。 一、数据查询 MySQL数据库中主要是用select 结合where子句实现数据的查询,功能特别强大,例如多表联合查询、支持正则表达式等。不在这里做过多的相关介绍。这里主要介绍MongoDB的相关查询,MongoDB中主要用find()实现数据的查询,同时也可以使用一些条件限制。 1.1显示单条数据 在上篇文章中提到了find()的使用,但是每次查询数据,都是查询所有的,显示其中的一部分,可以用it迭代。有时候我们想要查询其中的一条数据,具体操作要根据具体需求实现。 MongoDB 查询数据的语法 1 db.collection. find (query,projection) query :可选,使用查询操作符指定查询条件 projection :可选,使用投影操作符指定返回的键。查询时返回文档中所有键值, 只需省略该参数即可(默认省略)。可以使用 pretty() 方法以易读的方式来读取数据,,语法格式如下 1 >db.col. find ().pretty() pretty() 方法以格式化的方式来显示所有文档。 例如: 1 2 3 4 5 6 7 8 9 10 11 db.winner. find ().pretty() { "_id" :ObjectId( "592e7d1caaa464fa8a557e95" ), "winne" :1955} { "_id" :ObjectId( "592e7d1eaaa464fa8a557e96" ), "winne" :1955} { "_id" :ObjectId( "592e7d1faaa464fa8a557e97" ), "winne" :1955} { "_id" :ObjectId( "592e7d1faaa464fa8a557e98" ), "winne" :1955} { "_id" :ObjectId( "592e7d21aaa464fa8a557e99" ), "winne" :1955} { "_id" :ObjectId( "592e7d22aaa464fa8a557e9a" ), "winne" :1955} { "_id" :ObjectId( "592e7e14aaa464fa8a557ec4" ), "winne" :41} { "_id" :ObjectId( "592e7e14aaa464fa8a557ec5" ), "winne" :42} { "_id" :ObjectId( "592e7e14aaa464fa8a557ec6" ), "winne" :43} { "_id" :ObjectId( "592e7e14aaa464fa8a557ec7" ), "winne" :44} 1、查询某个集合中的所有数据 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 db.winner. find () { "_id" :ObjectId( "592e7d1caaa464fa8a557e95" ), "winne" :1955} { "_id" :ObjectId( "592e7d1eaaa464fa8a557e96" ), "winne" :1955} { "_id" :ObjectId( "592e7d1faaa464fa8a557e97" ), "winne" :1955} { "_id" :ObjectId( "592e7d1faaa464fa8a557e98" ), "winne" :1955} { "_id" :ObjectId( "592e7d21aaa464fa8a557e99" ), "winne" :1955} { "_id" :ObjectId( "592e7d22aaa464fa8a557e9a" ), "winne" :1955} { "_id" :ObjectId( "592e7e14aaa464fa8a557ec4" ), "winne" :41} { "_id" :ObjectId( "592e7e14aaa464fa8a557ec5" ), "winne" :42} { "_id" :ObjectId( "592e7e14aaa464fa8a557ec6" ), "winne" :43} { "_id" :ObjectId( "592e7e14aaa464fa8a557ec7" ), "winne" :44} { "_id" :ObjectId( "592e7e14aaa464fa8a557ec8" ), "winne" :45} { "_id" :ObjectId( "592e7e14aaa464fa8a557ec9" ), "winne" :46} { "_id" :ObjectId( "592e7e14aaa464fa8a557eca" ), "winne" :47} { "_id" :ObjectId( "592e7e14aaa464fa8a557ecb" ), "winne" :48} { "_id" :ObjectId( "592e7e14aaa464fa8a557ecc" ), "winne" :49} { "_id" :ObjectId( "592e7e14aaa464fa8a557ecd" ), "winne" :50} { "_id" :ObjectId( "592e7e14aaa464fa8a557ece" ), "winne" :51} { "_id" :ObjectId( "592e7e14aaa464fa8a557ecf" ), "winne" :52} { "_id" :ObjectId( "592e7e14aaa464fa8a557ed0" ), "winne" :53} { "_id" :ObjectId( "592e7e14aaa464fa8a557ed1" ), "winne" :54} Type "it" for more 默认显示20条数据,其他数据可以输入it迭代。 2、显示一条数据 find()是输出所有结果,里面可能有些文档内容相同,但是“_id”肯定是不一样的,这时我们可以使用findOne()方法查询,或者可以使用db.winner.find({winne:1955}).limit(1)。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 db.winner. find ({winne:1955}) { "_id" :ObjectId( "592e7d1caaa464fa8a557e95" ), "winne" :1955} { "_id" :ObjectId( "592e7d1eaaa464fa8a557e96" ), "winne" :1955} { "_id" :ObjectId( "592e7d1faaa464fa8a557e97" ), "winne" :1955} { "_id" :ObjectId( "592e7d1faaa464fa8a557e98" ), "winne" :1955} { "_id" :ObjectId( "592e7d21aaa464fa8a557e99" ), "winne" :1955} { "_id" :ObjectId( "592e7d22aaa464fa8a557e9a" ), "winne" :1955} 假如要查询winner集合中winne=1955的一条数据,而用 find ()查询出所有的数据,这时就可以使用findOne() db.winner.findOne({winne:1955}) { "_id" :ObjectId( "592e7d1caaa464fa8a557e95" ), "winne" :1955} 或者可以使用 db.winner. find ({winne:1955}).limit(1) { "_id" :ObjectId( "592e7d1caaa464fa8a557e95" ), "winne" :1955} 两者的区别 findOne()有点类似MySQL里面的distinct,会返回查询的第一条结果,如果搜索不到想要的数据就会 返回NULL, db.winner.findOne({winne:200888}) null db.winner. find ({winne:1955}).limit(1)方法就和MySQL里面的limit是一样的,主要是限制查询结果的条数。 3、查询满足一定条件的数据 在MySQL中查询时,可以结合where以及字段等信息查询数据,而MongoDB中也是可以的,同样可以支持一些条件判断语句。 格式 范例 RDBMS中的类似语句 等于 {<key>:<value>} db.col.find({"winne":"1995"}).pretty() wherewinne= '50' 小于 {<key>:{$lt:<value>}} db.col.find({"winne":{$lt:50}}).pretty() wherewinne< 50 小于或等于 {<key>:{$lte:<value>}} db.col.find({"winne":{$lte:50}}).pretty() wherewinne<= 50 大于 {<key>:{$gt:<value>}} db.col.find({"winne":{$gt:50}}).pretty() wherewinne> 50 大于或等于 {<key>:{$gte:<value>}} db.col.find({"winne":{$gte:50}}).pretty() wherewinne>= 50 不等于 {<key>:{$ne:<value>}} db.col.find({"winne":{$ne:50}}).pretty() wherewinne!= 50 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 $gt--------greaterthan$gte---------gtequal $lt-------- less than$lte---------ltequal $ ne -----------notequal 1、查询winner集合中winne<50的相关数据 db.winner. find ({winne:{$lt:50}}) { "_id" :ObjectId( "592e7e14aaa464fa8a557ec4" ), "winne" :41} { "_id" :ObjectId( "592e7e14aaa464fa8a557ec5" ), "winne" :42} { "_id" :ObjectId( "592e7e14aaa464fa8a557ec6" ), "winne" :43} { "_id" :ObjectId( "592e7e14aaa464fa8a557ec7" ), "winne" :44} { "_id" :ObjectId( "592e7e14aaa464fa8a557ec8" ), "winne" :45} { "_id" :ObjectId( "592e7e14aaa464fa8a557ec9" ), "winne" :46} { "_id" :ObjectId( "592e7e14aaa464fa8a557eca" ), "winne" :47} { "_id" :ObjectId( "592e7e14aaa464fa8a557ecb" ), "winne" :48} { "_id" :ObjectId( "592e7e14aaa464fa8a557ecc" ), "winne" :49} { "_id" :ObjectId( "592e7e17aaa464fa8a557f28" ), "winne" :41} { "_id" :ObjectId( "592e7e17aaa464fa8a557f29" ), "winne" :42} { "_id" :ObjectId( "592e7e17aaa464fa8a557f2a" ), "winne" :43} { "_id" :ObjectId( "592e7e17aaa464fa8a557f2b" ), "winne" :44} 2、查询winner集合中40=<winne<50的相关数据 db.winner. find ({winne:{$gte:40,$lt:45}}) { "_id" :ObjectId( "592e7e14aaa464fa8a557ec4" ), "winne" :41} { "_id" :ObjectId( "592e7e14aaa464fa8a557ec5" ), "winne" :42} { "_id" :ObjectId( "592e7e14aaa464fa8a557ec6" ), "winne" :43} { "_id" :ObjectId( "592e7e14aaa464fa8a557ec7" ), "winne" :44} { "_id" :ObjectId( "592e7e17aaa464fa8a557f28" ), "winne" :41} { "_id" :ObjectId( "592e7e17aaa464fa8a557f29" ), "winne" :42} { "_id" :ObjectId( "592e7e17aaa464fa8a557f2a" ), "winne" :43} { "_id" :ObjectId( "592e7e17aaa464fa8a557f2b" ), "winne" :44} { "_id" :ObjectId( "592e7e18aaa464fa8a557f8c" ), "winne" :41} { "_id" :ObjectId( "592e7e18aaa464fa8a557f8d" ), "winne" :42} { "_id" :ObjectId( "592e7e18aaa464fa8a557f8e" ), "winne" :43} { "_id" :ObjectId( "592e7e18aaa464fa8a557f8f" ), "winne" :44} 4、MongoDB AND 条件 MongoDB 的 find() 方法可以传入多个键(key),每个键(key)以逗号隔开,语法格式如下: >db.winner.find({key1:value1, key2:value2}).pretty() 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 #插入测试数据 for (i=0;i<20;i++)db.info2.insert({name: "linux" , object: "SA" , company: "docker" , phone:i}) for (i=0;i<20;i++)db.info2.insert({name: "openstack" , object: "DBA" , company: "could" , phone:i}) #检查测试数据 >db.info2. find () db.info2. find () { "_id" :ObjectId( "592f838dd276944818f7edb4" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :0} { "_id" :ObjectId( "592f838dd276944818f7edb5" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :1} { "_id" :ObjectId( "592f838dd276944818f7edb6" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :2} { "_id" :ObjectId( "592f838dd276944818f7edb7" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :3} { "_id" :ObjectId( "592f838dd276944818f7edb8" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :4} { "_id" :ObjectId( "592f838dd276944818f7edb9" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :5} { "_id" :ObjectId( "592f838dd276944818f7edba" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :6} { "_id" :ObjectId( "592f838dd276944818f7edbb" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :7} { "_id" :ObjectId( "592f838dd276944818f7edbc" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :8} { "_id" :ObjectId( "592f838dd276944818f7edbd" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :9} { "_id" :ObjectId( "592f838dd276944818f7edbe" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :10} { "_id" :ObjectId( "592f838dd276944818f7edbf" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :11} { "_id" :ObjectId( "592f838dd276944818f7edc0" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :12} { "_id" :ObjectId( "592f838dd276944818f7edc1" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :13} { "_id" :ObjectId( "592f838dd276944818f7edc2" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :14} { "_id" :ObjectId( "592f838dd276944818f7edc3" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :15} { "_id" :ObjectId( "592f838dd276944818f7edc4" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :16} { "_id" :ObjectId( "592f838dd276944818f7edc5" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :17} { "_id" :ObjectId( "592f838dd276944818f7edc6" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :18} { "_id" :ObjectId( "592f838dd276944818f7edc7" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :19} >db.info2. find ().count() #检查数据的条数 40 #筛选name=linuxobject=SAphone<5 db.info2. find ({name: "linux" ,object: "SA" ,phone:{$lt:5}}) 执行 db.info2. find ({name: "linux" ,object: "SA" ,phone:{$lt:5}}) { "_id" :ObjectId( "592f838dd276944818f7edb4" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :0} { "_id" :ObjectId( "592f838dd276944818f7edb5" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :1} { "_id" :ObjectId( "592f838dd276944818f7edb6" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :2} { "_id" :ObjectId( "592f838dd276944818f7edb7" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :3} { "_id" :ObjectId( "592f838dd276944818f7edb8" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :4} 筛选name=linuxobject=SA5<phone<=10 db.info2. find ({name: "linux" ,object: "SA" ,phone:{ "$gt" :5, "$lte" :10}}) db.info2. find ({name: "linux" ,object: "SA" ,phone:{ "$gt" :5, "$lte" :10}}) { "_id" :ObjectId( "592f838dd276944818f7edba" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :6} { "_id" :ObjectId( "592f838dd276944818f7edbb" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :7} { "_id" :ObjectId( "592f838dd276944818f7edbc" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :8} { "_id" :ObjectId( "592f838dd276944818f7edbd" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :9} { "_id" :ObjectId( "592f838dd276944818f7edbe" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :10} 筛选5<phone<=10 db.info2. find ({phone:{ "$gt" :5, "$lte" :10}}) { "_id" :ObjectId( "592f838dd276944818f7edba" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :6} { "_id" :ObjectId( "592f838dd276944818f7edbb" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :7} { "_id" :ObjectId( "592f838dd276944818f7edbc" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :8} { "_id" :ObjectId( "592f838dd276944818f7edbd" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :9} { "_id" :ObjectId( "592f838dd276944818f7edbe" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :10} { "_id" :ObjectId( "592f838fd276944818f7edce" ), "name" : "openstack" , "object" : "DBA" , "company" : "could" , "phone" :6} { "_id" :ObjectId( "592f838fd276944818f7edcf" ), "name" : "openstack" , "object" : "DBA" , "company" : "could" , "phone" :7} { "_id" :ObjectId( "592f838fd276944818f7edd0" ), "name" : "openstack" , "object" : "DBA" , "company" : "could" , "phone" :8} { "_id" :ObjectId( "592f838fd276944818f7edd1" ), "name" : "openstack" , "object" : "DBA" , "company" : "could" , "phone" :9} { "_id" :ObjectId( "592f838fd276944818f7edd2" ), "name" : "openstack" , "object" : "DBA" , "company" : "could" , "phone" :10} 5 MongoDB OR 条件 MongoDB 除了有类似MySQL的AND条件语句外,还有OR 条件语句,OR 条件语句使用了关键字 $or,语法格式如下: >db.collections.find( { $or: [ {key1: value1}, {key2:value2} ] } ).pretty() 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 #查name=linux或者object=redis db.info2. find ( {$or:[{name: "linux" },{object: "redis" }] } ) db.info2. find (db.info2. find ( ...{$or:[{name: "linux" },{object: "redis" }]{$or:[{name: "linux" },{object: "redis" }] ... ...}} ...)) { "_id" :ObjectId( "592f838dd276944818f7edb4" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :0} { "_id" :ObjectId( "592f838dd276944818f7edb5" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :1} { "_id" :ObjectId( "592f838dd276944818f7edb6" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :2} { "_id" :ObjectId( "592f838dd276944818f7edb7" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :3} { "_id" :ObjectId( "592f838dd276944818f7edb8" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :4} { "_id" :ObjectId( "592f838dd276944818f7edb9" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :5} { "_id" :ObjectId( "592f838dd276944818f7edba" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :6} { "_id" :ObjectId( "592f838dd276944818f7edbb" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :7} { "_id" :ObjectId( "592f838dd276944818f7edbc" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :8} { "_id" :ObjectId( "592f838dd276944818f7edbd" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :9} { "_id" :ObjectId( "592f838dd276944818f7edbe" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :10} { "_id" :ObjectId( "592f838dd276944818f7edbf" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :11} { "_id" :ObjectId( "592f838dd276944818f7edc0" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :12} { "_id" :ObjectId( "592f838dd276944818f7edc1" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :13} { "_id" :ObjectId( "592f838dd276944818f7edc2" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :14} { "_id" :ObjectId( "592f838dd276944818f7edc3" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :15} { "_id" :ObjectId( "592f838dd276944818f7edc4" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :16} { "_id" :ObjectId( "592f838dd276944818f7edc5" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :17} { "_id" :ObjectId( "592f838dd276944818f7edc6" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :18} { "_id" :ObjectId( "592f838dd276944818f7edc7" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :19} Type "it" for more >itit { "_id" :ObjectId( "592f8964d276944818f7eddc" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :0} { "_id" :ObjectId( "592f8964d276944818f7eddd" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :1} { "_id" :ObjectId( "592f8964d276944818f7edde" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :2} { "_id" :ObjectId( "592f8964d276944818f7eddf" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :3} { "_id" :ObjectId( "592f8964d276944818f7ede0" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :4} { "_id" :ObjectId( "592f8964d276944818f7ede1" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :5} { "_id" :ObjectId( "592f8964d276944818f7ede2" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :6} { "_id" :ObjectId( "592f8964d276944818f7ede3" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :7} { "_id" :ObjectId( "592f8964d276944818f7ede4" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :8} { "_id" :ObjectId( "592f8964d276944818f7ede5" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :9} 6、AND和OR综合使用 查询phone<5,name=MongoDB或者name=linux 1 2 3 4 5 6 7 8 9 10 11 12 db.info2. find ({phone:{$lt:5},$or:[{name: "MongoDB" },{name: "linux" }]}) db.info2. find ({phone:{$lt:5},$or:[{name: "MongoDB" },{name: "linux" }]}) { "_id" :ObjectId( "592f838dd276944818f7edb4" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :0} { "_id" :ObjectId( "592f838dd276944818f7edb5" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :1} { "_id" :ObjectId( "592f838dd276944818f7edb6" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :2} { "_id" :ObjectId( "592f838dd276944818f7edb7" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :3} { "_id" :ObjectId( "592f838dd276944818f7edb8" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :4} { "_id" :ObjectId( "592f8964d276944818f7eddc" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :0} { "_id" :ObjectId( "592f8964d276944818f7eddd" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :1} { "_id" :ObjectId( "592f8964d276944818f7edde" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :2} { "_id" :ObjectId( "592f8964d276944818f7eddf" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :3} { "_id" :ObjectId( "592f8964d276944818f7ede0" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :4} 7、查询结果排序 在MySQL中是有order by条件,可以根据desc或者asc进行升序或者降序操作,而MongoDB中是可以利用sort()方法实现排序的,例如对6中的结果处理,根据phone排序。 基本语法 db.info2.find().sort({phone:1})#这里phone表示根据该key排序,1表示升序,-1表示降序。 1 2 3 4 5 6 7 8 9 10 11 db.info2. find ({phone:{$lt:5},$or:[{name: "MongoDB" },{name: "linux" }]}). sort ({phone:1}) { "_id" :ObjectId( "592f838dd276944818f7edb4" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :0} { "_id" :ObjectId( "592f8964d276944818f7eddc" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :0} { "_id" :ObjectId( "592f838dd276944818f7edb5" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :1} { "_id" :ObjectId( "592f8964d276944818f7eddd" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :1} { "_id" :ObjectId( "592f838dd276944818f7edb6" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :2} { "_id" :ObjectId( "592f8964d276944818f7edde" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :2} { "_id" :ObjectId( "592f838dd276944818f7edb7" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :3} { "_id" :ObjectId( "592f8964d276944818f7eddf" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :3} { "_id" :ObjectId( "592f838dd276944818f7edb8" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :4} { "_id" :ObjectId( "592f8964d276944818f7ede0" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :4} 8、MongoDB Skip() 方法 在前面介绍了limit(),sort(),count()等方法,接下来要介绍一个比较有趣的skip()方法,在使用limit()的时候可以显示你要求的几条,而skip()方法是跳过几条。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 db.info2. find ({phone:{$lt:5},$or:[{name: "MongoDB" },{name: "linux" }]}). sort ({phone:1}) { "_id" :ObjectId( "592f838dd276944818f7edb4" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :0} { "_id" :ObjectId( "592f8964d276944818f7eddc" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :0} { "_id" :ObjectId( "592f838dd276944818f7edb5" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :1} { "_id" :ObjectId( "592f8964d276944818f7eddd" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :1} { "_id" :ObjectId( "592f838dd276944818f7edb6" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :2} { "_id" :ObjectId( "592f8964d276944818f7edde" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :2} { "_id" :ObjectId( "592f838dd276944818f7edb7" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :3} { "_id" :ObjectId( "592f8964d276944818f7eddf" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :3} { "_id" :ObjectId( "592f838dd276944818f7edb8" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :4} { "_id" :ObjectId( "592f8964d276944818f7ede0" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :4} 使用skip()方法 db.info2. find ({phone:{$lt:5},$or:[{name: "MongoDB" },{name: "linux" }]}). sort ({phone:1}).skip(3) { "_id" :ObjectId( "592f8964d276944818f7eddd" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :1} { "_id" :ObjectId( "592f838dd276944818f7edb6" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :2} { "_id" :ObjectId( "592f8964d276944818f7edde" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :2} { "_id" :ObjectId( "592f838dd276944818f7edb7" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :3} { "_id" :ObjectId( "592f8964d276944818f7eddf" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :3} { "_id" :ObjectId( "592f838dd276944818f7edb8" ), "name" : "linux" , "object" : "SA" , "company" : "docker" , "phone" :4} { "_id" :ObjectId( "592f8964d276944818f7ede0" ), "name" : "MongoDB" , "object" : "redis" , "company" : "winner" , "phone" :4} skip方法有点类似于MySQL里面的limit之间间隔情况。 这里介绍了有关查询的问题,在数据库中,查询是非常重要的一部分,所以介绍的篇幅也是比较多的,后期遇到其他问题也会继续总结输出。 本文转自 tianya1993 51CTO博客,原文链接:http://blog.51cto.com/dreamlinux/1931384,如需转载请自行联系原作者

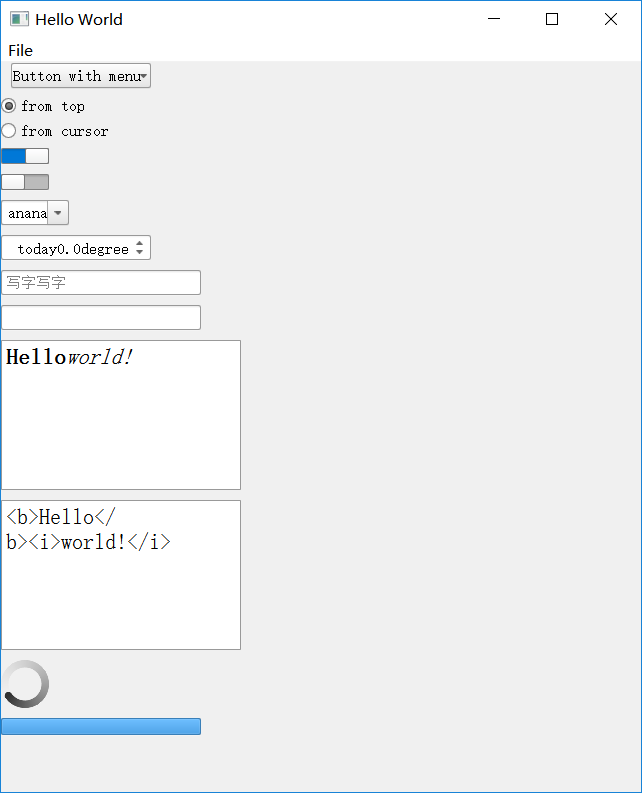
资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册