首页 文章 精选 留言 我的

精选列表

搜索[手脑一体],共10000篇文章
优秀的个人博客,低调大师

Hudi 在 vivo 湖仓一体的落地实践

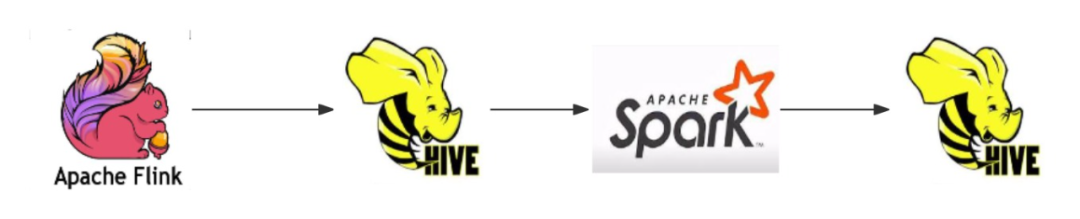
作者:vivo 互联网大数据团队 - Xu Yu 在增效降本的大背景下,vivo大数据基础团队引入Hudi组件为公司业务部门湖仓加速的场景进行赋能。主要应用在流批同源、实时链路优化及宽表拼接等业务场景。 一、Hudi 基础能力及相关概念介绍 1.1 流批同源能力 与Hive不同,Hudi数据在Spark/Flink写入后,下游可以继续使用Spark/Flink引擎以流读的形式实时读取数据。同一份Hudi数据源既可以批读也支持流读。 Flink、Hive、Spark的流转批架构: Hudi流批同源架构: 1.2 COW和MOR的概念 Hudi支持COW(Copy On Write)和MOR(Merge On Read)两种类型: (1)COW写时拷贝: 每次更新的数据都会拷贝一份新的数据版本出来,用户通过最新或者指定version的可以进行数据查询。缺点是写入的时候往往会有写内存放大的情况,优点是查询不需要合并,直接读取效率相对比较高。JDK中的CopyOnWriteArrayList/ CopyOnWriteArraySet 容器正是采用了 COW 思想。 COW表的数据组织格式如下: (2)MOR读时合并: 每次更新或者插入新的数据时,并写入parquet文件,而是写入Avro格式的log文件中,数据按照FileGroup进行分组,每个FileGroup由base文件(parquet文件)和若干log文件组成,每个FileGroup有单独的FileGroupID;在读取的时候会在内存中将base文件和log文件进行合并,进而返回查询的数据。缺点是合并需要花费额外的合并时间,查询的效率受到影响;优点是写入的时候效率相较于COW快很多,一般用于要求数据快速写入的场景。 MOR数据组织格式如下: 1.3 Hudi的小文件治理方案 Hudi表会针对COW和MOR表制定不同的文件合并方案,分别对应Clustering和Compaction。 Clustering顾名思义,就是将COW表中多个FileGroup下的parquet根据指定的数据大小重新编排合并为新的且文件体积更大的文件块。如下图所示: Compaction即base parquet文件与相同FileGroup下的其余log文件进行合并,生成最新版本的base文件。如下图所示: 1.4 周边引擎查询Hudi的原理 当前主流的OLAP引擎等都是从HMS中获取Hudi的分区元数据信息,从InputFormat属性中判断需要启动HiveCatalog还是HudiCatalog,然后生成查询计划最终执行。当前StarRocks、Presto等引擎都支持以外表的形式对Hudi表进行查询。 1.5 Procedure介绍 Hudi 支持多种Procedure,即过程处理程序,用户可以通过这些Procedure方便快速的处理Hudi表的相关逻辑,比如Compaction、Clustering、Clean等相关处理逻辑,不需要进行编码,直接通过sparksql的语句来执行。 1.6 项目架构 1. 按时效性要求进行分类 秒级延迟: 分钟级延迟: 当前Hudi主要还是应用在准实时场景: 上游从Kafka以append模式接入ods的cow表,下游部分dw层业务根据流量大小选择不同类型的索引表,比如bucket index的mor表,在数据去重后进行dw构建,从而提供统一数据服务层给下游的实时和离线的业务,同时ods层和dw层统一以insert overwrite的方式进行分区级别的容灾保障,Timeline上写入一个replacecommit的instant,不会引发下游流量骤增,如下图所示: 1.7 线上达成能力 实时场景: 支持1亿条/min量级准实时写入;流读延迟稳定在分钟级 离线场景: 支持千亿级别数据单批次离线写入;查询性能与查询Hive持平(部分线上任务较查询Hive提高20%以上) 小文件治理: 95%以上的合并任务单次执行控制在10min内完成 二、组件能力优化 2.1 组件版本 当前线上所有Hudi的版本已从0.12 升级到 0.14,主要考虑到0.14版本的组件能力更加完备,且与社区前沿动态保持一致。 2.2 流计算场景 1. 限流 数据积压严重的情况下,默认情况会消费所有未消费的commits,往往因消费的commits数目过大,导致任务频繁OOM,影响任务稳定性;优化后每次用户可以摄取指定数目的commits,很大程度上避免任务OOM,提高了任务稳定性。 2. 外置clean算子 避免单并行度的clean算子最终阶段影响数据实时写入的性能;将clean单独剥离到 compaction/clustering执行。这样的好处是单个clean算子,不会因为其生成clean计划和执行导致局部某些Taskmanager出现热点的问题,极大程度提升了实时任务稳定性。 3. JM内存优化 部分大流量场景中,尽管已经对Hudi进行了最大程度的调优,但是JM的内存仍然在较高水位波动,还是会间隔性出现内存溢出影响稳定性。这种情况下我们尝试对 state.backend.fs.memory-threshold 参数进行调整;从默认的20KB调整到1KB,JM内存显著下降;同时运行至今state相关数据未产生小文件影响。 2.3 批计算场景 1. Bucket index下的BulkInsert优化 0.14版本后支持了bucket表的bulkinsert,实际使用过程中发现分区数很大的情况下,写入延迟耗时与计算资源消耗较高;分析后主要是打开的句柄数较多,不断CPU IO 频繁切换影响写入性能。 因此在hudi内核进行了优化,主要是基于partition path和bucket id组合进行预排序,并提前关闭空闲写入句柄,进而优化cpu资源使用率。 这样原先50分钟的任务能降低到30分钟以内,数据写入性能提高约30% ~ 40%。 优化前: 优化后: 2. 查询优化 0.14版本中,部分情况下分区裁剪会失效,从而导致条件查询往往会扫描不相关的分区,在分区数庞大的情况下,会导致driver OOM,对此问题进行了修复,提高了查询任务的速度和稳定性。 eg:select * from `hudi_test`.`tmp_hudi_test` where day='2023-11-20' and hour=23; (其中tmp_hudi_test是一张按日期和小时二级分区的表) 修复前: 修复后: 优化后不仅包括减少分区的扫描数目,也减少了一些无效文件RPC的stage。 3. 多种OLAP引擎支持 此外,为了提高MOR表管理的效率,我们禁止了RO/RT表的生成;同时修复了原表的元数据不能正常同步到HMS的缺陷(这种情况下,OLAP引擎例如Presto、StarRocks查询原表数据默认仅支持对RO/RT表的查询,原表查询为空结果)。 2.4 小文件合并 1. 序列化问题修复 0.14版本Hudi在文件合并场景中,Compaction的性能相较0.12版本有30%左右的资源优化,比如:原先0.12需要6G资源才能正常启动单个executor的场景下,0.14版本 4G就可以启动并稳定执行任务;但是clustering存在因TypedProperties重复序列化导致的性能缺陷。完善后,clustering的性能得到30%以上的提升。 可以从executor的修复前后的火焰图进行比对。 修复前: 修复后: 2. 分批compaction/clustering compaction/clustering默认不支持按commits数分批次执行,为了更好的兼容平台调度能力,对compaction/clustering相关procedure进行了改进,支持按批次执行。 同时对其他部分procedure也进行了优化,比如copy_to_table支持了列裁剪拷贝、 delete_procedures支持了批量执行等,降低sparksql的执行时间。 3. clean优化 Hudi0.14 在多分区表的场景下clean的时候很容易OOM,主要是因为构建 HoodieTableFileSystemView的时候需要频繁访问TimelineServer,因产生大量分区信息请求对象导致内存溢出。具体情况如下: 对此我们对partition request Job做了相关优化,将多个task分为多个batch来执行,降低对TimelineSever的内存压力,同时增加了请求前的缓存判断,如果已经缓存的将不会发起请求。 改造后如下: 此外实际情况下还可以在FileSystemViewManager构建过程中将 remoteview 和 secondview 的顺序互调,绝大部分场景下也能避免clean oom的问题,直接优先从secondview中获取分区信息即可。 2.5 生命周期管理 当前计算平台支持用户表级别生命周期设置,为了提高删除的效率,我们设计实现了直接从目录对数据进行删除的方案,这样的收益有: 降低了元数据交互时间,执行时间快; 无须加锁、无须停止任务; 不会影响后续compaction/clustering 相关任务执行(比如执行合并的时候不会报文件不存在等异常)。 删除前会对compaction/clustering等instants的元数据信息进行扫描,经过合法性判断后区分用户需要删除的目录是否存在其中,如果有就保存;否则直接删除。流程如下: 三、总结 我们分别在流批场景、小文件治理、生命周期管理等方向做了相关优化,上线后的收益主要体现这四个方向: 部分实时链路可以进行合并,降低了计算和存储资源成本; 基于watermark有效识别分区写入的完成度,接入湖仓的后续离线任务平均SLA提前时间不低于60分钟; 部分流转批后的任务上线后执行时间减少约40%(比如原先执行需要150秒的任务可以缩短到100秒左右完成 ; 离线增量更新场景,部分任务相较于原先Hive任务可以下降30%以上的计算资源。 同时跟进用户实际使用情况,发现了一些有待优化的问题: Hudi生成文件的体积相较于原先Hive,体积偏大(平均有1.3 ~ 1.4的比例); 流读的指标不够准确; Hive—>Hudi迁移需要有一定的学习成本; 针对上述问题,我们也做了如下后续计划: 对hoodie parquet索引文件进行精简优化,此外业务上对主键的重新设计也会直接影响到文件体积大小; 部分流读的指标不准,我们已经完成初步的指标修复,后续需要补充更多实时的任务指标来提高用户体验; 完善Hudi迁移流程,提供更快更简洁的迁移工具,此外也会向更多的业务推广Hudi组件,进一步挖掘Hudi组件的潜在使用价值。 END 猜你喜欢 RocksDB 在 vivo 消息推送系统中的实践 线上ES集群参数配置引起的业务异常案例分析 vivo 网络端口安全建设技术实践 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

大数据架构如何做到流批一体?

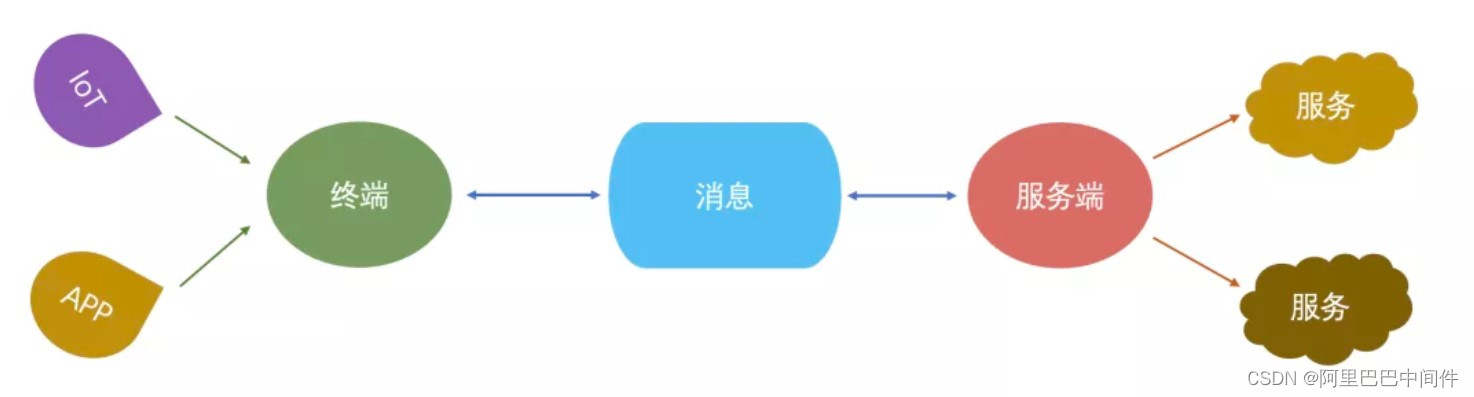
阿里妹导读:大数据与现有的科技手段结合,对大多数产业而言都能产生巨大的经济及社会价值。这也是当下许多企业,在大数据上深耕的原因。大数据分析场景需要解决哪些技术挑战?目前,有哪些主流大数据架构模式及其发展?今天,我们都会一一解读,并介绍如何结合云上存储、计算组件,实现更优的通用大数据架构模式,以及该模式可以涵盖的典型数据处理场景。 大数据处理的挑战 现在已经有越来越多的行业和技术领域需求大数据分析系统,例如金融行业需要使用大数据系统结合 VaR(value at risk) 或者机器学习方案进行信贷风控,零售、餐饮行业需要大数据系统实现辅助销售决策,各种 IOT 场景需要大数据系统持续聚合和分析时序数据,各大科技公司需要建立大数据分析中台等等。 抽象来看,支撑这些场景需求的分析系统,面临大致相同的技术挑战: 业务分析的数据范围横跨实时数据和

优秀的个人博客,低调大师

EMR:一体化Hadoop云上工作平台

Hadoop生态体系日臻完善,如何利用Hadoop生态各项技术与阿里云更好的服务于企业。EMR最新发布的工作流管理、弹性伸缩、异构计算多项功能,更好的助力用户在阿里云上利用Hadoop、Spark生态体系解决企业大数据问题。 EMR数据开发工作台EMR数据开发工作台集成了作业编辑、工作编辑和临时查询等功能,能更好的满足用户云上离线数据处理、数据分析和探索挖掘等场景。主要特点在于: 支持多样化的大数据作业,支持shell,Hive,MapReduce,Spark,SparkStreaming等多种离线,实时类型作业,企业数据开发人员可在线编辑,调试。 更低的数据开发门槛,用户通过拖拽式的大数据开发完成数据的接入,相较于Oozie、Azkaban等开源解决方案,运营人员,数据科学家可以更直观的进行大数据开发。 交互式数据探索,为用户提供交互式

优秀的个人博客,低调大师

.NET之全平台一体化的体验

一、前言 近来利用空闲时间研究了一下Xamarin的技术,想想既然提供了如此好的支持,就该尝试一切可能,来一个”大小通吃“。 何为全平台:APP包括Android、IOS、WP,WEB可在Window和Linux部署运行(进可攻,退可守) 二、简单实现 先来看张图吧 这个是本人实现项目的截图,比较简单。 app那块的话,目前仅实现了Android,IOS的话,没有机器,不想在虚拟机装(已经装了3个Linux了,再装估计要卡爆了) UWP也是机子问题(还未升级到win 10 10568,界面不能实时看到调起来很蛋疼,所以暂时现放着,过段时间补上) 对于我这种情况来说,标题说成是全平台是夸大了一点,但是却是完全可行!!不是弄虚作假的。 下面来说说“进可攻,退可守” 这个问题主要是针对web端的。 先来说说“进可攻”,可以在linux下部署我们的后台网站和数据服务,主要的话还是Jexus(免安装mono版)和TinyFox 不是我不用ASP.NET Core,而是用的我好揪心所以就没用了。 "退可守",我们还有win server 的IIS 看,我真的没有装mono喔!!! 然后简单说说一些细节上的东西 目前有14个子项目分在5个项目文件夹里面(包含几个测试项目) 01-APP 是app相关的 02-Website 是后台管理的网站,基于NancyFx,身份验证用了自带的Forms Authentication 03-DataService 主要用于给app提供数据服务,或者可以说是接口,这里我写了两套,一套基于MVC,一套基于NancyFx(使用OWIN) 04-Core 是数据访问和模型,用到了Dapper 05-Logic 逻辑层 里面用到Nancy和app的简单使用,都可以在我前面的博客找到相应的用法 其中包含了几个测试项目,用到的是xUnit,不过前三个项目文件夹的测试还没有做,对app的UI测试还是懵懂状态 evolve 2016上看到Test Cloud Live 很开心,不过到处找不到,最后发邮件去问,得到的回复如下 “Keep a look out on our blog for more information on when Test Cloud Live is available to everyone. But yes, at this time, it's not open for general use.” 有点小小的失望。 最后来看看部分运行图吧(界面很丑,很丑,很丑,不要吐槽) 上面是Android端的 下面是Web端的(server是jexus/5.8.1.3 Linux) 本文转自xsster51CTO博客,原文链接:http://blog.51cto.com/12945177/1929803,如需转载请自行联系原作者

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册