首页 文章 精选 留言 我的

精选列表

搜索[手脑一体],共10000篇文章
优秀的个人博客,低调大师

用 PHP 手搓 WHIP/WHEP:一个无扩展依赖的 WebRTC 直播方案

# WebRTC SDK for PHP 一个基于 PHP >= 7.3.9 原生 socket 实现的轻量级 WebRTC SFU(Selective Forwarding Unit)服务器。 采用单进程异步事件循环,内置 WebSocket 信令、STUN、DTLS、SCTP(DataChannel)和 SRTP 音视频转发;不依赖第三方 Composer 运行时包。 支持通过事件回调无侵入扩展业务逻辑,无需修改 SDK 核心代码即可实现多房间、鉴权、计费、聊天广播、自定义信令等能力。 --- ## 特性 | 能力 | 说明 | |---|---------------------------------------------------------------------------------------------------| | WebSocket 信令服务 | 内置独立的 HTTP/WS 服务 (默认 8088 端口),自带静态文件托管 | | STUN / ICE | 独立 STUN Binding 服务默认监听 3478;WebRTC 媒体端口上的 ICE Binding Response 包含 MESSAGE-INTEGRITY 和 FINGERPRINT | | DTLS 握手 | RFC 6347 / RFC 5764(DTLS-SRTP),内置证书,SRTP 主密钥自动协商派生 | | SRTP 协议 | AES-128-ICM 加密、HMAC-SHA1-80 认证、ROC 和重复包防护 | | SCTP DataChannel | PPID=51 文本 / 53 二进制 / 56/57 部分可靠流 (onmessage 回调) | | SFU 媒体转发 | SSRC 自动重写 + 多订阅者分发,push 端一路推流 -> 多路 play 端观看 | | 事件驱动接口 | 提供连接、信令、Publisher、Subscriber、RTP 和 DataChannel 等回调;部分前置事件可通过 `&$handled` 接管默认处理 | | 元数据管理 | Client 级 KV metadata,房间 / 角色 / 并发限制等业务字段自由扩展 | | 无第三方运行时包 | 使用 PHP 的 `openssl`、`json`、 `sockets` 扩展 | --- ## 环境要求 - PHP **>= 7.3.9** - PHP 扩展: - `openssl` - `json` - `sockets` - Composer - 操作系统:Windows / Linux / macOS 安装依赖: ```bash composer require xiaosongshu/webrtc ``` --- ## 端口与网络模型 | 端口 | 协议 | 作用 | 公网部署方式 | |---|---|---|---| | `8088` | TCP (HTTP/WS) | 页面、WebSocket 信令、WHIP/WHEP HTTP API | 服务当前绑定 `0.0.0.0`;公网部署时用防火墙限制,仅允许 Nginx 访问 | | `8089` | UDP | ICE、DTLS、SRTP/SRTCP、RTP/RTCP 媒体 | 必须让客户端直接访问,普通 Nginx HTTP 代理不能转发 | | `3478` | UDP | 可选的独立 STUN Binding 服务 | 使用该服务时直接开放 | 浏览器或 OBS 首先通过 HTTP/WebSocket 完成信令和 SDP 协商,随后根据 SDP candidate 直接连接 `服务器IP:8089/UDP`。HTTPS 代理成功并不代表媒体端口已经连通。 --- ## 本地部署 源码仓库根目录提供 `start.php` 以及 `index.html`、`push.html`、`play.html`、`whip.html`、`whep.html` 示例页面。通过 Composer 安装时,可参考仓库中的 `start.php` 在业务项目创建启动入口;服务器默认读取 SDK 包根目录中的示例静态文件,仅复制 `start.php` 不会改变静态文件目录。 ### 1. 启动服务 ```bash php start.php ``` 启动成功后会看到类似输出: ```text Using certificate: .../src/Core/certs/server.crt WebSocket signaling server listening on ws://0.0.0.0:8088/ UDP media server listening on udp://0.0.0.0:8089 STUN server listening on udp://0.0.0.0:3478 ``` ### 2. 本地推流和拉流 | 页面/API | 地址 | 用途 | |------------|-----------------------------------------|---------------------| | WebSocket 推流 | `http://127.0.0.1:8088/index.html` | 浏览器datachannel演示 | | WebSocket 推流 | `http://127.0.0.1:8088/push.html` | 浏览器屏幕/窗口推流 | | WebSocket 拉流 | `http://127.0.0.1:8088/play.html` | 播放相同 `streamId` 的媒体 | | WHIP 推流 | `http://127.0.0.1:8088/whip.html` | 浏览器通过 WHIP 推流 | | WHEP 拉流 | `http://127.0.0.1:8088/whep.html` | 浏览器通过 WHEP 拉流 | | OBS WHIP | `http://127.0.0.1:8088/whip/stream_001` | OBS 的 WHIP 服务地址 | 推流端与拉流端必须使用相同的 `streamId`。示例默认使用 `stream_001`。 `push.html`、`play.html` 和首页会根据当前页面地址自动选择 `ws://`;`whip.html`、`whep.html` 会自动使用当前页面的同源 HTTP 地址,因此本地运行无需修改页面配置。 --- ## WHIP / WHEP HTTP 接口 项目提供 WHIP/WHEP 风格的 SDP POST 和资源删除接口,已配套仓库示例页面,并可供 OBS 使用 WHIP 推流。当前 Trickle ICE 候选接口采用项目自定义的 JSON POST 路径,并非 IETF 标准的 SDP fragment PATCH;接入其他客户端前请核对其请求格式。 ### WHIP 推流 **创建请求**: ```http POST /whip/ HTTP/1.1 Content-Type: application/sdp ``` **成功响应**: ```http HTTP/1.1 201 Created Location: /whip/ Content-Type: application/sdp ``` - `streamId` 是业务定义的流标识,例如 `stream_001`。 - 当前 `resourceId` 是服务端生成的数字 clientId。 - 停止推流时向响应中的相对 `Location` 发送 `DELETE`,成功返回 `204 No Content`: ```http DELETE /whip/ HTTP/1.1 ``` ### WHEP 拉流 **创建请求**: ```http POST /whep/ HTTP/1.1 Content-Type: application/sdp ``` **成功响应**: ```http HTTP/1.1 201 Created Location: /whep/ Content-Type: application/sdp ``` 必须先存在相同 `streamId` 的 Publisher;否则立即返回 `404 Not Found`,响应正文为 `Stream not available`。停止拉流使用: ```http DELETE /whep/ HTTP/1.1 ``` ### Trickle ICE 候选 当前候选接口接受以下项目自定义请求,成功返回 `204 No Content`: ```http POST /whip//candidate HTTP/1.1 Content-Type: application/json {"candidate":"candidate:..."} ``` WHEP 对应路径为 `/whep//candidate`;服务端也接受将最后一段 `candidate` 写为 `ice`。仓库中的 `whip.html` 使用上述 JSON POST 接口。 ## 公网线上部署(推荐 Nginx) 生产环境建议保持职责分离: - **Nginx**:域名、HTTPS 证书、WSS、静态页面及 WHIP/WHEP HTTP 反向代理。 - **WebRTCServer**:SDP、ICE/STUN、DTLS、SRTP/SRTCP 和 RTP/RTCP 转发。 - **UDP 8089**:客户端直接连接 WebRTCServer,不经过普通 Nginx `proxy_pass`。 ### 1. 设置 SDP 对外公布的公网 IP SDP candidate 使用 `WebRTCServer::getLocalIP()` 返回的地址。服务器网卡直接绑定公网 IPv4 时通常无需处理;云主机通过 NAT 使用公网 IP 时,在业务启动文件中继承服务器类即可,无需修改 SDK 核心: ```php publicIp = '127.0.0.1'; // 是否开启调试模式 ,生成环境建议关闭 $server->isDev = false; // 启动服务,后面的代码将不会执行 $server->start(); ``` 公网 NAT 必须把 `8089/UDP` 映射到服务器同一端口。当前 SDP 默认公布端口 `8089`,如果公网端口与内网端口不同,需要同步调整服务端 UDP 端口配置。 ### 2. 配置域名和 HTTPS 证书 不要求购买商业证书,可以使用 Let's Encrypt 或其他受浏览器信任的 CA 证书。公网浏览器采集摄像头、麦克风或屏幕通常要求 HTTPS 安全上下文。 以下配置放在 Nginx `http` 配置范围内: ```nginx map $http_upgrade $connection_upgrade { default upgrade; '' close; } server { listen 80; server_name webrtc.example.com; return 301 https://$host$request_uri; } server { listen 443 ssl http2; server_name webrtc.example.com; ssl_certificate /etc/letsencrypt/live/webrtc.example.com/fullchain.pem; ssl_certificate_key /etc/letsencrypt/live/webrtc.example.com/privkey.pem; location / { proxy_pass http://127.0.0.1:8088; proxy_http_version 1.1; proxy_set_header Host $host; proxy_set_header X-Real-IP $remote_addr; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; proxy_set_header Upgrade $http_upgrade; proxy_set_header Connection $connection_upgrade; proxy_buffering off; proxy_request_buffering off; proxy_read_timeout 3600s; proxy_send_timeout 3600s; } } ``` 该配置将页面、WebSocket、WHIP 和 WHEP 都代理到本机 `8088/TCP`。示例页面会自动使用: ```text wss://webrtc.example.com https://webrtc.example.com/whip/stream_001 https://webrtc.example.com/whep/stream_001 ``` OBS 的服务类型选择 WHIP,服务地址填写: ```text https://webrtc.example.com/whip/stream_001 ``` WHIP/WHEP 返回的资源 `Location` 使用相对 URL,可继续通过同一域名访问和删除。 ### 3. 配置防火墙和云安全组 至少放行: | 规则 | 来源 | 说明 | |---|---|---| | `80/TCP` | 公网 | 可选,仅用于跳转 HTTPS | | `443/TCP` | 公网 | HTTPS、WSS、WHIP、WHEP | | `8089/UDP` | 公网 | WebRTC 媒体,必须开放 | | `3478/UDP` | 公网 | 仅在使用内置独立 STUN 时开放 | | `8088/TCP` | 本机 | Nginx 到 PHP 服务;不建议直接向公网开放 | 如果服务器位于路由器、容器或云 NAT 后面,还必须配置 `8089/UDP` 端口映射,并确保 `getLocalIP()` 返回外部客户端实际可达的 IPv4。 ### 4. HTTPS 证书与 DTLS 证书的区别 Nginx HTTPS 证书用于保护页面、WebSocket 和 WHIP/WHEP HTTP 请求;项目内置 DTLS 证书用于 WebRTC 媒体密钥协商。服务端将该证书的 SHA-256 fingerprint 写入 SDP,由 WebRTC 客户端验证服务端证书。两者用途不同,使用 Nginx 后仍需保留项目的 DTLS 证书和指纹逻辑。 ### 5. TURN 说明 Nginx 不是 TURN 服务。服务器拥有公网可达的 `8089/UDP` 时,多数客户端可以直接建立连接;如果客户端处于严格企业防火墙、对称 NAT 或禁止 UDP 的网络,需要另行部署 TURN,并在客户端 `RTCPeerConnection` 的 `iceServers` 中配置,不能依靠 Nginx HTTP 代理解决。 --- ## 推流 / 拉流默认信令协议 `push.html` 与 `play.html` 均通过 WebSocket 发送 JSON 文本消息与服务端通信。 ### 1) join(进入房间) 推流端: ```json { "type": "join", "role": "push", "streamId": "ROOM123" } ``` 拉流端: ```json { "type": "join", "role": "play", "streamId": "ROOM123" } ``` 服务端默认回: ```json { "type": "joined" } ``` ### 2) offer(SDP 协商) - **push.html(推流端)**:浏览器 offerer → 服务端 answerer - **play.html(拉流端)**:服务端 offerer → 浏览器 answerer(缺省 SFU 自动由 `makeSfuOfferForSubscriber()` 生成) ### 3) candidate(ICE 候选地址) 服务端缺省:把 push 端的 candidate 转发给同 streamId 的所有 play 端;play 端的 candidate 只转发给对应的 push 端,无需额外业务代码。 当前 WebSocket 信令没有固定 path;`8088` 上任意 URL 的有效 WebSocket Upgrade 都进入同一信令处理器。 --- ## 事件接口(无侵入扩展) **核心设计思想**:通过回调扩展业务;其中部分信令前置事件支持可选的 `&$handled` 引用参数,具体以事件表为准: - 支持 `&$handled` 的回调中不设置 `true` → 继续执行 SDK 的缺省处理 - 设置 `$handled=true` → 跳过该事件对应的缺省处理,由业务代码接管 ### 事件总览 | 事件属性 | 触发时机 | 签名 | 是否支持 &$handled | |---|---|---|---| | `$onOpen` | TCP/HTTP 连接 accept 时触发;收到 DataChannel CHANNEL_OPEN 后还会以 channel label 再次触发 | `fn(mixed $label, int $clientId, WebRTCServer $srv):void` | 否 | | `$onSignaling` | 任何 WebSocket 信令到达,全局前置钩子 | `fn(int $id, array $msg, WebRTCServer $srv, &$handled):void` | **是** | | `$onJoin` | 收到 `join` 信令 | `fn(int $id, array $msg, WebRTCServer $srv, &$handled):void` | **是** | | `$onOffer` | Offer 已生成 Answer;WS 流程中已回发,HTTP 流程中尚未写出响应 | `fn(int $id, string $offerSdp, string $answerSdp, WebRTCServer $srv):void` | 否 | | `$onPublisher` | onOffer 后若 metadata.role==='push',Publisher 就绪 | `fn(int $id, array $ctx, WebRTCServer $srv):void` | 否 | | `$onSubscriber` | WebSocket `role=play` 客户端 join 且已找到同流 Publisher 后触发;HTTP WHEP 不触发 | `fn(int $id, array $ctx, WebRTCServer $srv):void` | 否 | | `$onAnswer` | 客户端发来 answer(通常 play 端) | `fn(int $id, string $answerSdp, WebRTCServer $srv, &$handled):void` | **是** | | `$onCandidate` | ICE candidate 到达 | `fn(int $id, array $msg, WebRTCServer $srv, &$handled):void` | **是** | | `$onMediaConnected` | 首个 SRTP RTP 包成功 unprotect(媒体首帧落地) | `fn(int $id, array $rtpHeader, WebRTCServer $srv):void` | 否 | | `$onRtp` | 收到并成功解密明文 RTP;注册后由业务处理该包 | `fn(int $id, string $plainRtp, array $header, WebRTCServer $srv):void` | 否 | | `$onmessage` | 收到 SCTP DataChannel 文本或二进制消息 | `fn(string $data, int $clientId, WebRTCServer $srv):void` | 否 | | `$onLeave` | `removeClient()` 中的业务离开回调 | `fn(int $clientId, WebRTCServer $srv):void` | 否 | | `$onClose` | 底层连接关闭回调 | `fn(int $clientId, WebRTCServer $srv):void` | 否 | ### 上下文 $ctx 字段说明 - **onPublisher** `$ctx`: ```php [ 'streamId' => (string), 'localSsrc' => ['video' => int, 'audio' => int], // SDK 发给远端的 SSRC 'videoPTs' => [int => array], // PT => rtpmap/codec/clock/fmtp 等信息 'audioPTs' => [int => array], ] ``` - **onSubscriber** `$ctx`: ```php [ 'streamId' => (string), 'pushClientId' => int // 同 streamId 当前 push 端 clientId;不存在时不触发回调 ] ``` - **onMediaConnected** `$rtpHeader`: ```php [ 'pt' => int, // RTP Payload Type 'seq' => int, // 序列号 'ts' => int, // RTP timestamp 'ssrc' => int, // 同步源 'payloadLen' => int, // RTP 载荷长度 (不含头) ] ``` ### 使用示例:加入房间前鉴权 `onJoin` 支持通过 `$handled` 阻止默认 join 流程,适合在写入 role、streamId 和生成 Subscriber Offer 前完成鉴权: ```php $verifyToken = function (string $token): bool { // 替换为业务自己的数据库、Redis 或 JWT 校验。 return $token !== ''; }; $server->onJoin = function ( int $clientId, array $msg, WebRTCServer $srv, &$handled ) use ($verifyToken) { if ($verifyToken((string)($msg['token'] ?? ''))) { return; } $handled = true; $srv->sendSignaling($clientId, [ 'type' => 'error', 'msg' => '鉴权失败', ]); }; ``` 并发上限应由业务根据压测结果配置;仓库不对固定订阅者数量作容量承诺。 ### 使用示例:私有加密信令 ```php $server->onSignaling = function (int $id, array $msg, WebRTCServer $srv, &$handled) { $raw = $msg['_enc'] ?? null; if ($raw === null) return; // 不是私有加密消息 → 走默认 JSON 协议 $secret = my_get_secret_for_client($id); // 业务自行实现 $plain = my_aes_decrypt(base64_decode($raw), $secret); $realMsg = json_decode($plain, true); // 业务自己处理 → 告诉 SDK 跳过默认 $handled = true; my_business_dispatch($id, $realMsg, $srv); }; ``` --- ## 常用公共 API ### 客户端元数据 | 方法 | 作用 | |---|---| | `getClientIds(): array` | 返回当前所有 clientId | | `&getClientMeta(int $clientId, ?string $key=null, $default=null)` | 读取字段;`$key=null` 时按引用返回整个 metadata 数组 | | `setClientMeta(int $clientId, string $key, $value): bool` | 写入业务字段;clientId 不存在时返回 `false` | | `getClientsByMeta(string $key, $value=null): array` | 根据 metadata 筛选 clientId | | `getPublisherIdByStreamId(string $streamId): ?int` | 查找指定 streamId 下 role=push 的 clientId | | `getClientTrackInfo(int $clientId): array` | 获取客户端 PT 和本地 SSRC 映射 | ### 信令和 DataChannel | 方法 | 作用 | |---|---| | `sendSignaling(int $clientId, array $msg): bool` | WebSocket 发送 JSON 信令给一个客户端 | | `broadcastSignaling(array $clientIds, array $msg): int` | WebSocket 广播给多个客户端,返回成功数 | | `sendDataChannel(int $clientId, string $message, int $ppid=51, int $sid=0)` | 发送 DataChannel 消息;当前实现返回 bool,但未声明返回类型 | | `getClientsWithDataChannel(array $excludeIds=[]): array` | 返回 SCTP 已建立的客户端列表 | | `broadcastDataChannel(array $clientIds, string $message, int $ppid=51, int $sid=0): int` | 批量发送 DataChannel 消息,返回成功数 | ### SFU 订阅者 Offer 和媒体转发 | 方法 | 作用 | |---|---| | `makeSfuOfferForSubscriber(int $subscriberId, int $publisherId, string $setup='passive'): ?string` | 基于 Publisher Offer 生成 Subscriber 的 SFU Offer,默认让服务器作为 DTLS passive 端 | | `forwardRtpToClient(int $targetClientId, string $plainRtp, bool $ssrcRewrite=true): bool` | 将明文 RTP 重写并加密后发给指定客户端 | | `forwardRtpToAllSubscribers(string $streamId, string $plainRtp, int $excludeClientId=-1): int` | 给同 streamId 的所有 role=play 客户端分发,返回成功数 | --- ## 缺省 SFU 工作流程(零代码自动跑通) 1. **push.html** 发送 `join(role=push, streamId=X)` → 服务端存 metadata 2. **push.html** → `createOffer()` → `setLocalDescription(offer)` → 发送 `{"type":"offer","sdp":...}` 3. **服务端 handleOffer()** - 提取远端 `ice-ufrag / ice-pwd / setup` - 调 `generateAnswerSDP()` 生成 answer,填好 `serverVideoSsrc / serverAudioSsrc / PT 表` - 回发 answer → 触发 `onOffer` → 若 role=push → 触发 `onPublisher` 4. **play.html** 发送 `join(role=play, streamId=X)` → `_fireSubscriberIfReady()` - 若已有 pushClientId → **自动**调 `makeSfuOfferForSubscriber()` 生成 SFU offer - `sendSignaling(['type'=>'offer','sdp'=>...])` 发送给 play.html 5. **play.html** 收到 offer → `setRemoteDescription` → `createAnswer` → 回发 answer 6. **服务端 handle answer** → 提取 play 的 `ice-ufrag/pwd` 给 STUN / DTLS 7. **两端 ICE 连通 → DTLS 握手 → SRTP keys 导出** 8. **push 端 UDP 收 RTP**:unprotect 成功 → `onMediaConnected` 触发 → `forwardRtpToAllSubscribers(streamId)` → 对每个 play 端: - 按 play 端 PT 重写 SSRC 为 `serverVideoSsrc / serverAudioSsrc`(与步骤 4 发的 offer 中的 SSRC 严格一致) - 用 play 端的 srtpTx protect → UDP send 9. **play 端 SRTP 解密** → 浏览器 video/audio tag 自动渲染 --- ## 常见问题 ### Q1. 浏览器 `setRemoteDescription` 报错 "Failed to set remote offer sdp: Session error code: ERROR_CONTENT" 先检查浏览器控制台中的 Offer/Answer 和 `debug.log`。当前 SFU Subscriber Offer 使用服务端固定支持的 H264/Opus 和 PT 映射;如果业务需要其他编解码器,应先扩展 SDP 生成与 RTP PT 转换逻辑,而不是只改页面 SDP。 ### Q2. 推流正常,观众端黑屏 / 一直 "协商媒体中" 按以下步骤排查: 1. 看 `debug.log` 是否有 `SRTP-IN ok` 日志(= push 端媒体已到服务端) 2. 看是否有 `SFU forward streamId=xxx -> N subscriber(s)`(= 订阅者转发) 3. 看浏览器 play.html console 是否有 SDP offer / answer 日志,以及 ICE 连接状态是否变成 `connected` 4. play.html 若未收到 offer → 检查 join 时 `streamId` 是否与 push 端一致,`role` 是否为 `play` ### Q3. 如何用 HTTPS 部署? 参见前文“公网线上部署(推荐 Nginx)”。示例页面已经根据当前页面协议自动选择同源 `ws://` 或 `wss://`,不需要手动修改 JavaScript 地址。需要特别注意:Nginx 只代理 `8088/TCP`,媒体 `8089/UDP` 仍须直接对公网开放。 --- ## 已知的问题 - **编解码器固定为 H.264 + Opus** 为了最大化兼容主流浏览器、OBS 及常见移动设备,服务器目前仅支持 H.264 视频与 Opus 音频。 若业务侧需引入 VP8、VP9 或 H.265 等编码格式,需自行扩展 SDP 协商逻辑及 RTP 转发规则。 - **OBS 推流偶发自动断开** 在高动态画面或网络波动场景下,OBS 推流可能意外终止。 该问题与 libwebrtc 对 ICE consent、RTCP 反馈及带宽估计的严格要求有关,后续版本将持续优化 ICE 保活机制与 RTCP REMB 反馈以提升稳定性。 **临时缓解建议**:在 OBS 输出设置中启用 **CBR** 码率控制,并适当降低视频码率与分辨率。 - **OBS 编码器兼容性限制** 当前已验证可正常推流的 OBS H.264 编码器: - `x264` - `QuickSync H.264` - `AMD HW H.264 (AVC)` 这些编码器在 `baseline`、`main` 和 `high` 三个 Profile 下均可成功播放。 **不兼容的编码器**:`H264/AVC Encoder (AMD Advanced Media Framework)` —— 使用该编码器可能导致推流失败或画面异常。 如遇其他编码器问题,建议优先切换至上述已支持的编码器。 ## 开源协议 & 免责声明 本项目基于 [Apache License 2.0](http://www.apache.org/licenses/LICENSE-2.0) 开源,可自由使用、修改、分发(含商业用途)。 代码按“现状”(AS IS)提供,不提供任何明示或暗示的担保。作者不对因使用本软件而产生的任何损害承担责任。 ## License Apache License 2.0

优秀的个人博客,低调大师

我基于TikZ语言手搓了一个「科研绘图外挂」Skill

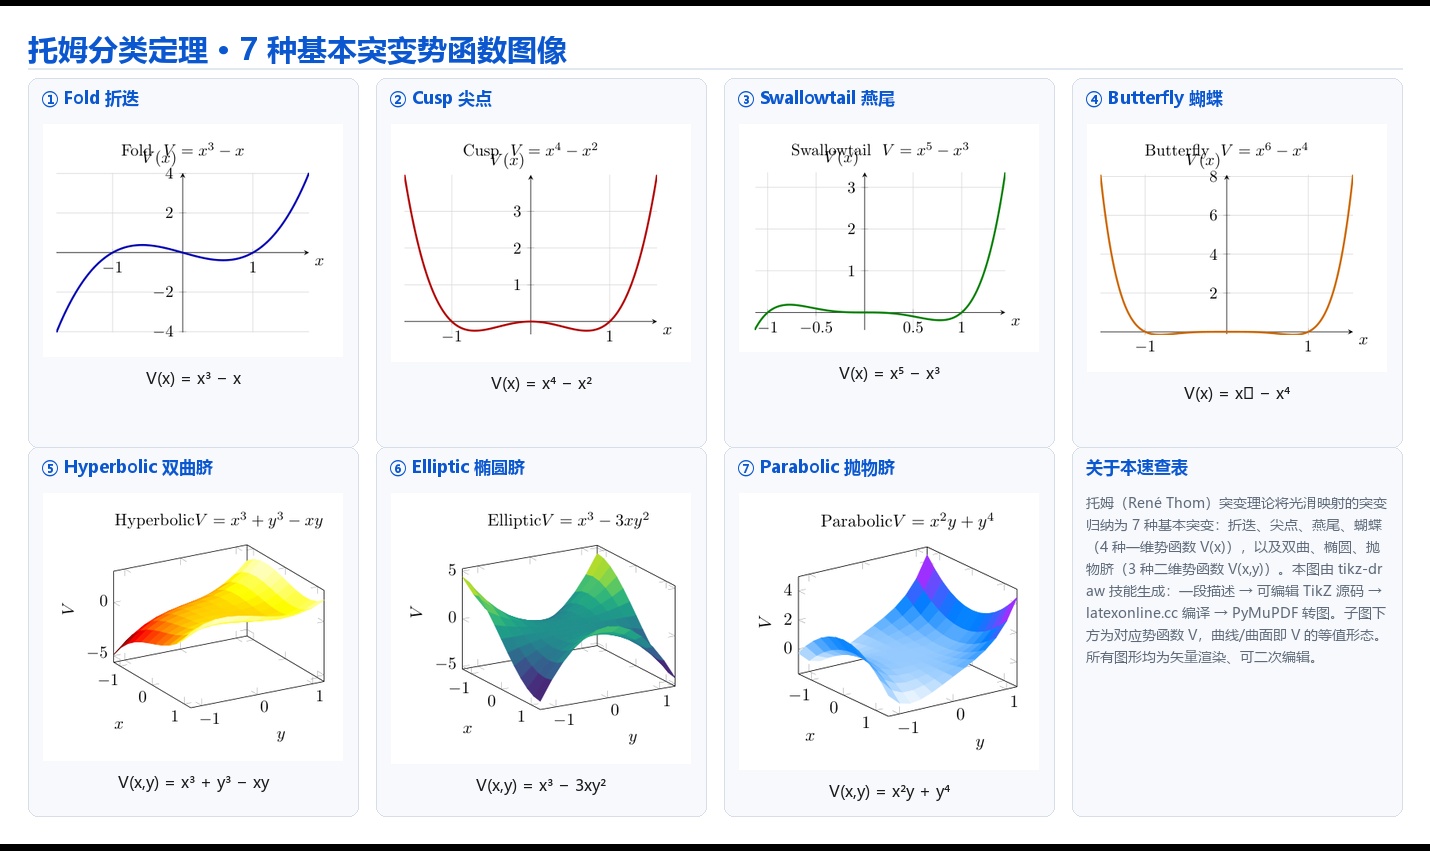
## 写在前面 做科研绘图的人,大抵都经历过这样的循环:在 PPT 里拖了半小时的曲线,导出 PNG 一放大就糊;用 Python 画了个函数图,老板说"这个配色和坐标轴不符合论文规范";想画一个带控制流的神经网络结构图,Visio 摆了半天还是歪的。 我自己长期在教育和医疗信息化的项目里做技术规划,也做学术内容生产,对"高质量、可编辑、可复现"的科研图需求非常刚性。这篇文章想分享我最近做的一个小工具:**一个把"一段描述"或"一张参考图"直接变成可编辑 TikZ 科研矢量图的 Skill(技能)**。 刚好想试试**腾讯混元3(以下简称 hy3)的多模态和长任务能力**——本文会讲清楚我的整体思路、怎么进行规划设计、架构与依赖是什么、最终怎么验证的,以及我用它生成托姆(Thom)突变理论中 7 种基本突变势函数图像、并成功跑通的全过程。 --- ## 一、科研绘图的痛点:我们要的到底是什么? 科研/工程场景里的"图",和日常配图不是一回事。它有几个硬要求: 1. **矢量优先**。论文投稿、slides 投影、海报印刷,放大到任意尺寸都不能糊。PNG 终归是位图,放大就崩。 2. **可编辑、可复现**。审稿人让你把坐标轴刻度改一下、把某条曲线换个颜色,你最好能改源码重新编译,而不是在像素图上拿画笔涂。 3. **数学语义正确**。函数曲线、拓扑结构、网络层连接,不是"画得像",而是"画得对"——坐标、比例、符号都得经得起推敲。 4. **风格统一、可批量化**。一个项目里几十张图,字体、线宽、配色要一致,且最好能由数据/公式驱动自动生成。 ::: center ![example-neuralnet.png](https://developer.qcloudimg.com/http-save/yehe-4862070/3a86ac87816608b440e01510c1997e80.png) ::: ::: center ![example-resnet.png](https://developer.qcloudimg.com/http-save/yehe-4862070/8ee8e41d167903146f3a0a2bac7efe3a.png) ::: 市面上的工具,往往只满足其中一两条: - **PPT / Visio / draw.io**:上手快,但本质是位图思维,精细数学图很难"画对",且难以批量、难以复现。 - **Python(matplotlib / Plotly)**:能画函数图、数据图,矢量导出也行,但画"结构图、示意图、拓扑图"很别扭,且样式调教成本高。 - **Illustrator / Inkscape**:矢量、可编辑,但纯手工,数学正确性靠人肉保证,不可复现。 - **专业科学绘图软件(Origin、SigmaPlot)**:功能强,但贵、重、且图的本质仍是"产物"而非"源码"。 结论很清楚:**要同时满足"矢量 + 可编辑 + 数学正确 + 可批量化"** --- ## 二、主流答案:TikZ —— LaTeX 的绘图扩展语言 说到"用代码画科研图",绕不开 **TikZ**(准确说是 `TikZ` / `PGF`,全称 *TikZ ist kein Zeichenprogramm*,"TikZ 不是绘图程序")。它是 LaTeX 生态里最主流的绘图宏包,由 Till Tantau 开发。 为什么 TikZ 是科研绘图的"终局"候选: - **它是 LaTeX 的原生延伸**。图里的公式、符号、字体和正文完全一致,publication-ready。 - **矢量 + 源码即产物**。`.tex` 就是图,编译出 PDF(矢量),改一行重编译即可,天然可复现。 - **数学/几何表达力强**。从函数曲线(`pgfplots`)、流程图、电路图(`circuitikz`)、交换图(`tikz-cd`)、到几何作图(`tkz-euclide`)、神经网络结构图,几乎覆盖科研绘图全谱系。 - **生态成熟**。大量现成库和模板,社区积累了几十年。 比如画一条势函数曲线,TikZ + pgfplots 就这么几行: ```latex \begin{tikzpicture} \begin{axis}[xlabel=$x$, ylabel=$V(x)$, domain=-1.6:1.6, samples=80, grid=major, axis lines=middle] \addplot[very thick, red!70!black] {x^4 - x^2}; \end{axis} \end{tikzpicture} ``` 一眼能看出画的是 `V(x)=x⁴−x²`,改个公式重编译就是新图——这正是我们要的"数学语义正确 + 可编辑"。 --- ## 三、TikZ 的门槛:文档庞大、学习曲线陡峭 讲到这里,痛点似乎解决了:用 TikZ 不就完了? 现实是:**TikZ 很强,但也很难**。我自己踩过、也见过别人踩的坑: 1. **文档规模恐怖**。`pgfmanual` 一份主文档就上千页,加上 `pgfplots`、`circuitikz`、`tikz-cd`、`tkz-euclide` 各自的手册,合计数千页。新人想画个稍微复杂点的图,光查坐标、样式、库的语法就劝退。 2. **学习曲线陡峭**。TikZ 有自己的坐标系统、作用域(`scope`)、节点(`node`)、路径(`path`)、装饰(`decoration`)……概念密度高。一个"箭头样式不对"可能要翻半天手册。 3. **报错不友好**。编译错时常常是一长串底层 TeX 错误,定位到具体哪一行 TikZ 写错,对新手极不友好。 4. **环境门槛**。要本地跑通,得装完整的 TeX Live(数 GB),且不同平台包版本差异还会踩坑(比如 `pgfplots` 的 `compat` 版本兼容性)。 换句话说:**TikZ 是最好的锤子,但大多数人卡在"学会用锤子"之前。** "把意图翻译成 TikZ 语法"这步,才是真正的门槛。 --- ## 四、对腾讯HY3的一次长任务实践:多模态 + 长任务能力 上文说到正在对HY3进行实践,我这次刚好想认真试试**腾讯混元3(hy3)**。选它是这个任务恰好卡在两个能力点上: **1. 多模态能力 → 支撑"参考图 → TikZ"** 这个 Skill 的第二种输入模式是"一张参考图"。用户拍一张手绘草图、截一张论文里的示意图,希望模型**看懂图里的结构**(节点、连线、层级、标注),再落成 TikZ。这要求模型具备图像理解的多模态能力,而不是只能吃纯文本。hy3 的多模态正好匹配这个入口。 **2. 长任务能力 → 支撑"从 0 规划并落地一个多文件 Skill"** 这不是"调一次 API 出张图"的 demo。它是一个完整的工程:需求拆解 → 技术调研 → 架构设计 → 写渲染脚本 → 做 8 个模板 → 写参考图提取清单 → 出示例 → 批量验证。跨度几十轮、涉及十几个文件。这种**长链路、多步骤、需保持上下文一致性**的任务,正是"长任务能力"要解决的——模型得记得前面定的架构约束,不能在第十步把第一步的目录结构搞乱。 **3. 中文语境友好** 科研描述多为中文("画托姆分类的 7 种基本突变"),hy3 对中文意图的理解更贴合,生成的 TikZ 注释、公式也更自然。 **多模态解决"输入多样性",长任务解决"工程落地可靠性",两者叠加,才让"自然语言/参考图 → 可维护的 TikZ 工程"变得可行。** --- ## 五、规划设计Skill 选定引擎后,我让 hy3 牵头做规划设计,而不是我拍脑袋写。整体规划链路是这样的: **Step 1 · 技术调研** 先让 hy3 检索并梳理可行方案,结论收敛到几条主线: - TikZ 相关的 MCP Server 有多个(`tikz-mcp`、`tikz-http-mcp-server`、`tikzserver`、`MCP-for-Tikz`),但大多要求本地有 `pdflatex` + `poppler`,本机没有。 - AI 生成 TikZ 的专用工具:`DeTikZify` / `TikZero`(图→TikZ、文→TikZ)、`AutomaTikZ`(Python 库)等,但要么要本地环境,要么要额外依赖。 - 涌现科学(Emergence Science)Render API:专为 Agent 设计的 TikZ/Mermaid/Graphviz 渲染服务,无需本地 LaTeX,质量高——作为"高质量可选后端"。 **Step 2 · 确定零安装渲染链路** 关键约束:**本机没有 LaTeX 引擎,但已经预装了 `PyMuPDF`**。于是链路定为:在线把 TikZ 编译成 PDF(latexonline.cc),再用本机 `PyMuPDF` 转成 PNG/SVG。零安装、零 key,先跑通;有 key / 有本地 TeX 时再自动升级质量。 **Step 3 · 架构决策** - **生成与渲染解耦**:模型只负责产出 TikZ 草稿,渲染管道负责编译/校验/兜底。换模型不影响渲染。 - **引擎可插拔**:生成侧可以接 hy3,也可以接其它能写代码的大模型;渲染侧三级后端自动降级。 - **自愈循环(规划中)**:编译失败时把 latexonline 返回的 400 错误日志自动喂回模型迭代,直到编译通过。 ![tikz_draw_pipeline.png](https://developer.qcloudimg.com/http-save/yehe-4862070/a98f65a9504013ac3c12df1a6eb772b5.png) 这套"解耦 + 可插拔"的架构,便于快速验证、且不会被某一家服务绑架。 --- ## 六、工具架构与依赖 > 这一节是全文的"工程骨架"。架构还考虑到:不是把功能写死,而是预留清晰的扩展缝,让后端、模板、输入模式、生成引擎都能按需替换或新增,而核心工作流不变。 ### 6.1 整体架构(三层管道 + 四个扩展缝) ![image.png](https://developer.qcloudimg.com/http-save/yehe-4862070/19dbc5e3481454261e9ae5767b4d2238.png) 整条管道的稳定中间格式是 **TikZ 源码**:生成层和渲染层只通过它耦合,互不绑架——换引擎不影响渲染,换后端不影响生成。四个扩展缝(输入/引擎/后端/交付)彼此独立,任一处升级都不会波及其它层,这是后面能快速迭代、且不被某一家服务锁死的根本原因。 ### 6.2 依赖清单(完整) **A. 运行依赖(本机)** | 依赖 | 版本 / 形态 | 用途 | 状态 | |------|------------|------|------| | Python | 3.13 / 3.14(隔离 venv 的 `python.exe`) | 跑 `render.py` 与自愈脚本 | 已就绪 | | `PyMuPDF`(`fitz`) | 1.27.2.3 | 把后端返回的 PDF 转 PNG / SVG | 预装,零安装 | | `urllib`(标准库) | 内置 | HTTP 调用在线编译服务 | 内置 | | 在线服务 `latexonline.cc` | SaaS(仅 GET,返 PDF) | 默认渲染后端,把 TikZ 编译成 PDF | 默认启用 | | `EMERGENCE_API_KEY` | 环境变量(可选) | Emergence Science Render API(支持 tikz/mermaid/graphviz/d2,多引擎高容错) | 可选升级 | | 本地 TeX Live | 可选 | `pdflatex` + `pdftoppm`,离线高保真 | 可选升级 | **B. LaTeX 宏包(由后端服务端提供,无需本机安装)** | 宏包 | 用途 | 备注 | |------|------|------| | `tikz` | 核心绘图语言 | 必需 | | `pgfplots` | 函数曲线 / 3D 曲面 | **`compat=1.14`**(latexonline 上限,写高必败) | | `circuitikz` | 电路图 | 较重,已验证可编译 | | `tikz-cd` | 交换图(范畴论 / 代数拓扑) | 已验证 | | `tkz-euclide` | 欧氏几何作图 | ⚠️ latexonline 版本部分命令未定义,改为纯 TikZ 绕开 | | `amsmath` / `amssymb` | 数学符号 | 已纳入默认 preamble | | `arrows.meta` / `calc` / `decorations.*` / `patterns` 等 | TikZ 子库(箭头、坐标运算、装饰、图案填充) | 已纳入默认 `usetikzlibrary` | **C. Skill 文件结构** ```txt tikz-draw/ ├── SKILL.md # 工作流说明:输入(描述/参考图)→TikZ→渲染→交付;触发词与三级后端优先级 ├── scripts/ │ └── render.py # 核心渲染脚本(三级后端 + 重试 + 自愈错误捕获 + standalone 包装) ├── templates/ # 8 个可复用模板(约定优于配置,丢 .tex 即用) │ ├── neural_net.tex # 多层感知机(\foreach 批量) │ ├── cnn_cube.tex # CNN 立方体块(\newcommand{\convblock}) │ ├── function_plot.tex # 函数曲线(pgfplots) │ ├── flowchart.tex # 决策流程图 │ ├── circuit.tex # 分压电路(circuitikz) │ ├── tikzcd.tex # 交换图 │ ├── feynman.tex # 费曼图(纯 TikZ,不依赖 tikz-feynman) │ └── geometry.tex # 几何作图(纯 TikZ,绕开 tkz-euclide) ├── references/ │ └── reference_image_prompt.md # 参考图 → TikZ 结构化提取清单(多模态入口规范) └── examples/ # 端到端示例(含 .tex 源码 + PNG/SVG 产物) ``` ### 6.3 render.py 的关键逻辑(节选) 三段逻辑决定了渲染层的可靠性:(1) **standalone 包装**——若输入只是一段 `tikzpicture` 而非完整文档,自动包成 `\documentclass{standalone}...`;(2) **三级后端选择**——有 key 走 Emergence,否则走 latexonline,探测到本地 TeX 时走离线;(3) **重试 + 错误分流**——编译错误(HTTP 400,确定性失败)直接抛日志用于自愈,网络抖动(含 `RemoteDisconnected`/`ConnectionError`)自动重试。 ```python def render_latexonline(tex, retries=3, timeout=150): url = "https://latexonline.cc/compile?" + urlencode({"text": tex}) for attempt in range(1, retries + 1): try: with urllib.request.urlopen(req, timeout=timeout) as r: resp = r.read() if resp[:4] != b"%PDF": raise RuntimeError("未返回 PDF(可能编译失败)") return resp except HTTPError as e: # 编译错误:确定性失败,直接抛日志(用于自愈),不重试 raise RuntimeError("编译失败:\n" + e.read().decode()) except (URLError, RemoteDisconnected, timeout, ConnectionError) as e: # 网络抖动:可重试 if attempt _source.tex`(或 `_standalone.tex`),绝不覆盖用户的输入文件——这是早期踩过"双层 document 污染输入"坑后加的硬约束。 ### 6.4 可扩展性设计 "可扩展"不是口号,而是这条管道在每个缝上都留了口子。具体 Extension Points 如下: ![image.png](https://developer.qcloudimg.com/http-save/yehe-4862070/ba70eafa7bea553509452d921f1d19f1.png) **① 渲染后端可扩展(三级 → N 级)** 后端是函数式注册的:`render_emergence()` / `render_latexonline()` 各自独立,优先级在 `main()` 里以一个降级链表达。要加第 4 个后端(比如自建 TeX 服务),只需:a) 新增一个 `render_xxx(tex)` 函数返回 PDF 字节;b) 在降级链里插入对应分支(通常带一个"可用性探测"守卫,如检测环境变量或本地二进制是否存在)。核心编译/转图逻辑不动。 **② 模板可扩展(约定优于配置)** 新增一个图类型,不需要改代码——在 `templates/` 丢一个 `.tex`(含完整 `\begin{document}` 或纯 `tikzpicture` 片段均可,`build_standalone` 会自动判别),SKILL.md 里补一行说明即可。模板库因此能像"素材抽屉"一样无限扩张,而渲染脚本零改动。 **③ 输入模式可扩展(描述/参考图/预留)** 当前两种输入:文本描述走"意图理解",参考图走"多模态结构化提取"(`references/reference_image_prompt.md` 定义了提取规范)。架构上为更多模式留了位:数据驱动(CSV/JSON → 批量图)、代码片段(AST → 架构图)都可以在输入层加适配器,向下仍统一产出 TikZ 源码。 **④ 生成引擎可插拔** 生成层只约定"产出合法 TikZ 源码"这一契约,不绑定具体模型。hy3 是默认设计与验证对象;换任意能写代码的大模型、甚至本地模型,只需替换生成侧,"渲染层 + 交付层"完全复用。这也是"自愈循环"能插进来的前提——自愈本质上是把渲染层的编译错误日志回灌给生成层迭代,与引擎无关。 **⑤ 配置可覆盖** `DEFAULT_PREAMBLE`、`compat` 版本、`dpi`、`format`、`samples`、域名参数等都可作参数传入,`render.py` 的 CLI 已暴露 `--format / --dpi / --api-key / --preamble`。这意味着同一套代码可服务不同质量档位(草稿 dpi=100 / 出版 dpi=300)。 **扩展矩阵一览** | 扩展缝 | 当前实现 | 如何新增 | 改动范围 | |--------|---------|---------|---------| | 渲染后端 | Emergence /latexonline /本地 TeX | 加 `render_xxx()` + 降级链分支 | 仅 `render.py` | | 模板库 | 8 个 | 丢 `.tex` 进 `templates/` | 零代码 | | 输入模式 | 描述 / 参考图 | 加输入适配器,统一产出 TikZ | 输入层 | | 生成引擎 | hy3(默认) | 替换生成侧,契约不变 | 生成层 | | 交付格式 | PNG / SVG / PDF / .tex | 加转码 / 拼版逻辑 | 交付层 | | 质量档位 | dpi / compat 参数化 | 传参 | 仅参数 | 一句话总结可扩展性的设计哲学:**核心管道(生成→渲染→交付)保持稳定,所有"供应商"与"素材"都做成可替换的零件。** 这让你的工作不被任何一家模型、任何一家服务绑架,也让你能随着需求增长持续堆功能而不重写。 ### 6.5 关键模块职责一览 | 模块 | 职责 | 扩展契约 | |------|------|---------| | `SKILL.md` | 定义触发词、工作流、后端优先级;人机接口 | 改说明即可 | | `render.py::build_standalone` | 把片段包成可编译文档,辨别完整/片段 | 入参:tikz 代码 | | `render.py::render_emergence` | 调 Emergence API(有 key) | 出参:PDF 字节 | | `render.py::render_latexonline` | 调 latexonline + 重试兜底 | 出参:PDF 字节 | | `render.py::pdf_to_png / pdf_to_svg` | PyMuPDF 转图 | 入参:PDF 字节 | | `templates/*.tex` | 可复用图模板(约定优于配置) | 丢文件即用 | | `references/reference_image_prompt.md` | 多模态入口的提取规范 | 改规范即可 | --- ## 七、验证:突变论中托姆定理的七种基础突变势函数绘制 验证分两步: ### 干测试:关键功能单元通过测试 **① 模板 QA(8/8 通过)** 逐个渲染 8 个模板,确认 latexonline + PyMuPDF 链路对各类 TikZ(含 `circuitikz` 重包)都稳。这一步踩到第一个坑:`tkz-euclide` 的某些命令在 latexonline 的版本未定义 → 把 `geometry.tex` 改写为**纯 TikZ**(coordinate + draw + arc 标注角),绕过依赖。 **② 端到端(描述驱动)** 不给模板,只给一句话"ResNet bottleneck 残差块",让 hy3 从零写 TikZ 并渲染——成功产出 PNG + SVG。证明"自然语言 → 可编辑矢量图"闭环成立。 **③ 3D 曲面 de-risk** 托姆的 3 种二维突变要画 `V(x,y)` 曲面(`\addplot3[surf]`)。之前没验证过 3D 能否在 latexonline 编译,先单独测:确认 `samples=12~13`、`domain=±1.2~1.4` 下可编译,输出 PDF ~25–28KB → PyMuPDF 转 PNG 正常。 ### 湿测试: 实操7 种基本突变势函数绘制** 让 Skill 生成托姆分类定理的 7 种基本突变势函数图像—— >提示词为:用 tikz-draw​ 绘制托姆分类定理中的7种基本突变模型的势函数图像 - 一维势函数 `V(x)`:Fold 折迭 `x³−x`、Cusp 尖点 `x⁴−x²`、Swallowtail 燕尾 `x⁵−x³`、Butterfly 蝴蝶 `x⁶−x⁴` - 二维势函数 `V(x,y)`(3D 曲面):Hyperbolic 双曲脐 `x³+y³−xy`、Elliptic 椭圆脐 `x³−3xy²`、Parabolic 抛物脐 `x²y+y⁴` 7 张图全部成功渲染(一维用 `pgfplots` 的 `\addplot`,二维用 `\addplot3[surf]`),并拼成一张带公式和物理含义的速查表: ![catastrophe-cheatsheet.png](https://developer.qcloudimg.com/http-save/yehe-4862070/a5e1b04a70618398fdf5a5c5bc429976.png) ![image.png](https://developer.qcloudimg.com/http-save/yehe-4862070/a73d0d5ba451ba009c7ea6232b0465fd.png) 最终交付物:7 张矢量图(PNG)+ 速查表(HTML)+ 7 个可独立修改重编译的 `.tex` 源码。审稿人说"把椭圆脐视角换一下",改一行 `view={...}` 重编译即可——**当初定义的四个刚性需求全部满足**。 --- ## 八、总结与展望 这个技能主要解决了: - **门槛问题**:用户只需"说清楚要画什么"(中文描述或参考图),TikZ 语法门槛消除。 - **环境问题**:渲染走在线编译 + 本机 PyMuPDF,零安装即可出图;有 key / 有本地 TeX 时自动升级质量。 - **可编辑性**:交付的不只是图,更是 `.tex` 源码——科研绘图最稀缺的"可复现"拿到了。 - **可插拔**:生成引擎与渲染管道解耦,换 hy3 之外的模型也不影响整体。 这次实践也印证了:**腾讯混元3 的多模态(吃得进参考图)和长任务能力(扛得住从规划到落地的多文件工程),是OK的。** 如果你也在被科研绘图折磨,或者想试试"大模型 + TikZ"这条路径,欢迎在评论区交流。

优秀的个人博客,低调大师

用且慢 MCP 手搓你的专属金融 AI 智能体

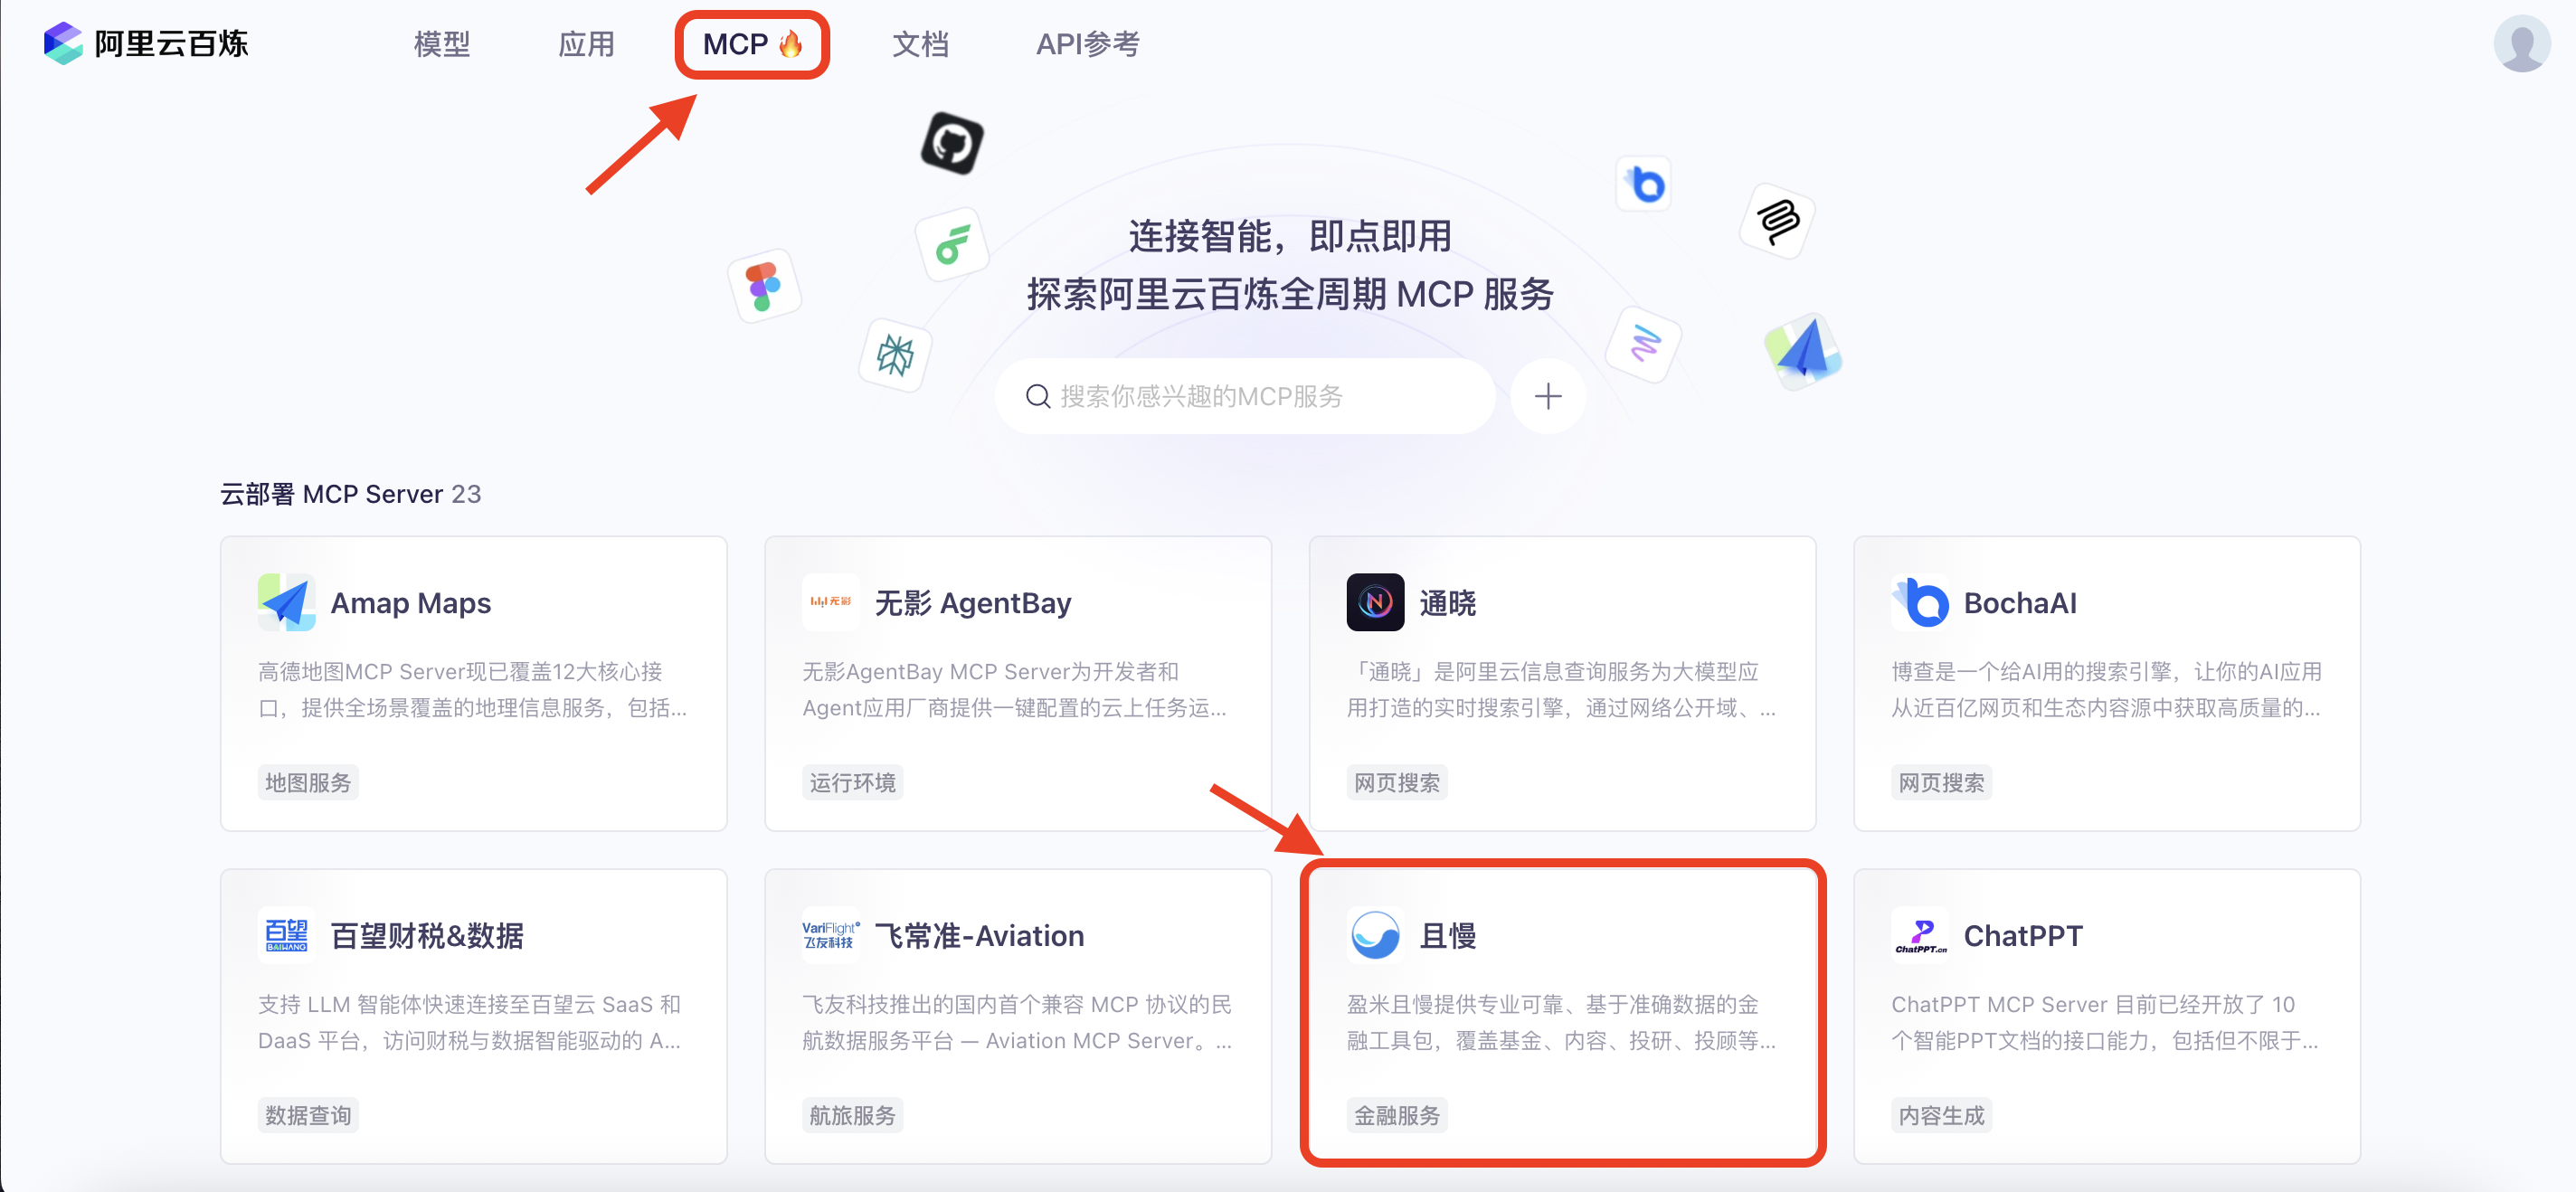
AI变革的浪潮汹涌而至!当下 MCP协议(全称:模型上下文协议)正在席卷全球,这一浪潮必将彻底改变AI大模型的应用方式。不仅Open AI、谷歌、微软等科技巨头都在加速布局MCP生态,而且阿里云、腾讯云、百度等国内大厂也纷纷入局。MCP的核心价值在于统一标准,它给AI大模型应用搭建了一套标准的“接口”和“工具箱”,可以让不同的“工具”能够更高效、更便捷地与大模型协同工作。 就在这个关键时刻,盈米基金再次走在了行业前沿! 盈米基金在4月8日重磅推出了业界首个聚焦金融、财富管理领域的盈米且慢MCP Server(以下简称:且慢MCP),并开放试用服务,获得了超过100名机构用户及个人用户的积极响应。 经过两周的用户体验反馈与工具打磨,且慢MCP在4月25日上线「正式版AI金融工具包」,提供首批29个专业金融工具(后续还将持续推出更多实用工具),并在阿里云百炼平台进行同步首发。作为平台的首个金融服务MCP,该服务开放给所有机构和用户免费调用,助力行业伙伴和投资者更高效搭建自己的金融服务智能体。 图|且慢MCP在阿里云百炼平台上线 在使用金融大模型的应用中有哪些痛点? 目前我们在使用金融大模型的应用中,存在非常多的挑战,其中最常见的是: ● 数据“不干净”?底层金融数据的结构性缺失,数据“张冠李戴”,甚至会让模型“不专业”,服务变得不可靠,使用户的体验自然大打折扣。 ● 表现“不稳定”? 面对复杂多变的金融市场环境,大模型有时会“犯迷糊”,难以给出持续稳定的专业输出。 ● 容易“胡说八道”? 大模型可能会产生“幻觉”,生成与事实不符的错误信息,误导投资决策。 ● 反应“慢半拍”? 金融市场瞬息万变,大模型缺乏对市场时效性的准确把握,难以及时适应快速变化的金融市场动态和趋势。 ● 专业知识“不够硬”? 金融领域有大量的专业术语和知识,如果大模型理解不深,就难以提供具有专业水准的分析和建议。 五大核心AI能力,帮你解决痛点! 为解决以上这些问题,此次上线阿里云百炼平台,且慢MCP将为大家带来五大核心AI能力: ● 金融数据 Server 整合了盈米自身丰富的财富管理数据体系,为金融大模型提供准确、及时的数据基础。 ● 投顾内容 Server 盈米研究院的专业市场分析以及盈米且慢平台的优质投教资源。 ● 投研服务 Server 各类资产研究、投研观点、产品对比分析与基金组合模拟测算等。 ● 投顾服务 Server 提供资金规划与资产配置引擎、持仓诊断与优化模型等。 ● 通用服务 Server 提供生成PDF报告、金融图表数据可视化工具等。 基于以上5大AI能力的支持,金融大模型可以调用且慢MCP来获取实时准确的金融数据,避免大模型幻觉;整合金融专业人士的最新观点与总结资讯,从而提升信息的服务质量;调用专业的投顾测算工具与各类资产分析能力,构建自身金融服务能力;此外,在完成MCP的配置后,后续的工具和服务能力还会自动迭代升级,从而让你持续获得最新的金融工具服务包。 只需要一次接入且慢 MCP,智能体搭建就能用,而且使用超便捷!那么问题来了,该如何接入且慢MCP来搭建一个自己专属定制的金融智能体呢? 简单5步!助你轻松搭建专属金融智能体 无论你使用的是本地部署的大模型,还是像阿里云百炼、扣子、Dify、Cursor、CherryStudio这样的第三方平台,只需要简单的配置,无需管理资源、开发部署和工程运维,就能快速构建出高质量的专属MCP Agent。我们目前提供了MCP和OpenAPI两种接入方式,你可以根据自己的需求选择。 下面,我们以阿里云百炼平台为例,只需要通过简单5步就能接入且慢MCP,轻松构建专属的投顾智能体: 1、选择一个支持MCP的AI平台:阿里云百炼 登陆访问阿里云百炼平台的MCP服务专区,点击【且慢MCP】 2、获取且慢MCP的专属 API Key,并在百炼输入后立即确认开通。 注:访问且慢MCP官网,可快速申请并免费获取API Key: 点击阅读原文或直接复制到浏览器打开👇 https://qieman.com/mcp/landing 且慢MCP服务的APIKey,只需要申请一次,后续便能在所有支持MCP服务的AI应用、Agent平台接入使用最新的且慢MCP金融工具包。 3、创建智能体应用。在平台快速创建一个自己的专属AI应用(Agent),并添加已开通的且慢MCP工具。 4、选择合适的AI模型,(可选)根据自身需求场景进行简单的prompt编排。 这里选择你要用的AI大模型(为了提升大模型自主调用工具来提供服务的全流程体验,我们推荐使用:通义千问- MAX 或 通义千问-Plus),提示词部分可以根据自己的需求设计填写。 5、输入提问,开始使用这些强大的“工具”!你还可以根据自己的需求,自由组合和调整参数,打造独一无二的智能解决方案。 除阿里云百炼外,且慢MCP还支持 Cursor、Dify 、扣子等主流 AI 平台,实现 “一处接入,多端复用”。其它平台接入方式和操作指南,可在这里获取。直接复制到浏览器打开👇 https://qieman.com/mcp/how-to-use 带你玩转且慢MCP! 下面让我们一起来看看如何玩转且慢MCP,假设你设计了一个投资规划智能体,你可以参考下面这样直接提问。 提问:我现在手边有十万闲钱,给我个三年可以有10%收益的投资方案。 效果如何呢?我们来看一下: (注意:以下仅作为用户操作调用且慢MCP的场景范例,非正式官方服务。问答内容由AI大模型生成,请自行甄别。) 基于且慢MCP提供的专业工具,AI能快速根据用户提供的关键参数了解需求,制定规划方案,包括资产配置类型和比例、收益模拟分析、资产配置方案、测算收益可视化展示和具体的选品细节说明,并生成一份清晰、可操作的投资规划方案书(PDF格式),让你告别繁琐的信息收集和数据对比,让投资决策变得轻松高效。在整个运行过程中,AI大模型能够自主判断并调用且慢MCP里合适的“工具”,无需人工操作,效率和质量都能得到大幅提升!

优秀的个人博客,低调大师

朝鲜黑客利用关键零日漏洞对Windows 10下手:微软正面解决

微软终于出手,封掉了Windows 10上的一个零日漏洞,要知道这个漏洞之前被朝鲜黑客疯狂利用。 微软在周二修补了该漏洞,其编号为CVE-2021-26411, 该安全漏洞被评为危急,只需要低复杂度的攻击代码即可利用。 微软表示,他们是Zinc的一部分,Zinc是微软对一个威胁组织的称呼,而这个威胁组织更出名的名称是Lazarus。在过去的十年中,Lazarus已经从一个零散的黑客团体转变为一个强大的威胁行为者。 据报道,联合国2019年的一份报告估计,Lazarus和相关团体为该国的大规模杀伤性武器项目创造了20亿美元。Lazarus还与关闭全球电脑的Wannacry蠕虫、无文件的Mac恶意软件、针对ATM的恶意软件以及针对叛逃者的恶意Google Play应用有关。 除了使用利用IE的水洞攻击,针对研究人员的Lazarus黑客还向目标发送了一个Visual Studio项目,据称其中包含验证漏洞的源代码。项目里面藏着定制的恶意软件,可以联系攻击者的控制服务器。 虽然微软将CVE-2021-26411描述为 "Internet Explorer内存破坏漏洞",但周一的公告称,该漏洞也会影响Edge,这是微软从头开始打造的浏览器,比IE安全得多,但没有报告称漏洞已经主动针对该浏览器的用户。 该补丁作为微软周二更新的一部分。微软总共发布了89个补丁。除了IE漏洞外,Win32k组件中的一个单独的升级权限漏洞也在被主动利用中。补丁将在未来一两天内自动安装。想要立即更新的用户应该进入开始>设置(齿轮图标)>更新与安全>Windows更新安装这些安全补丁。

优秀的个人博客,低调大师

手撸一个在线css三角形生成器

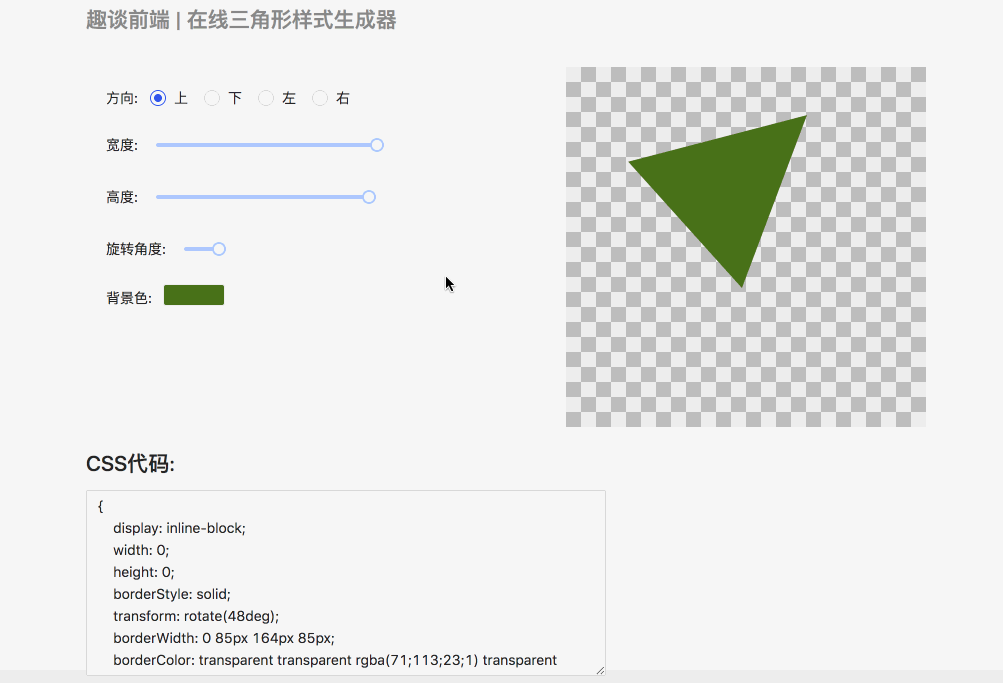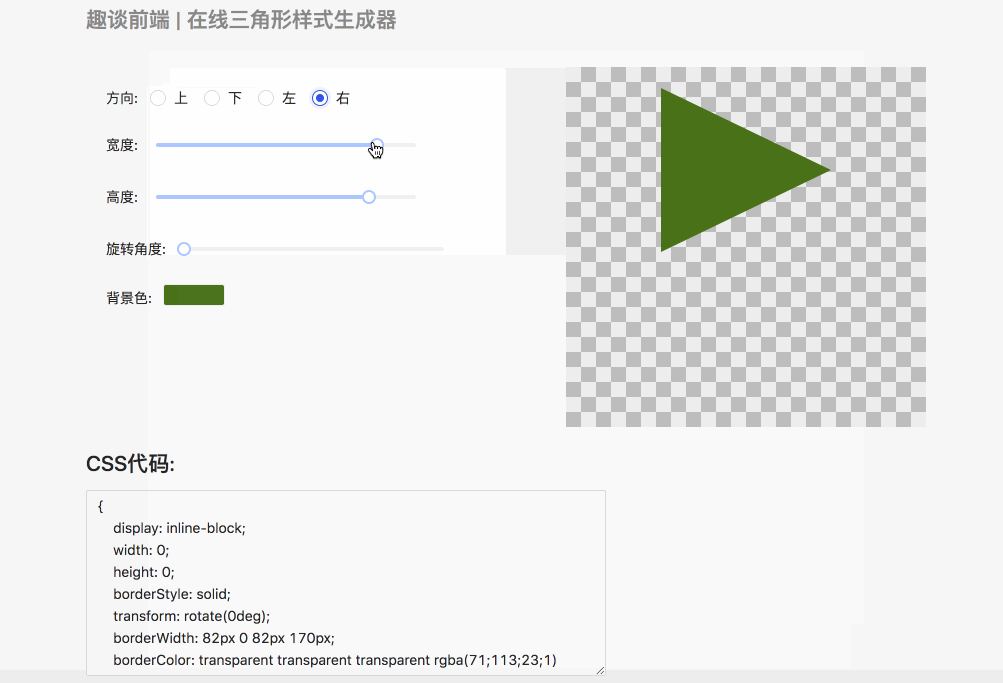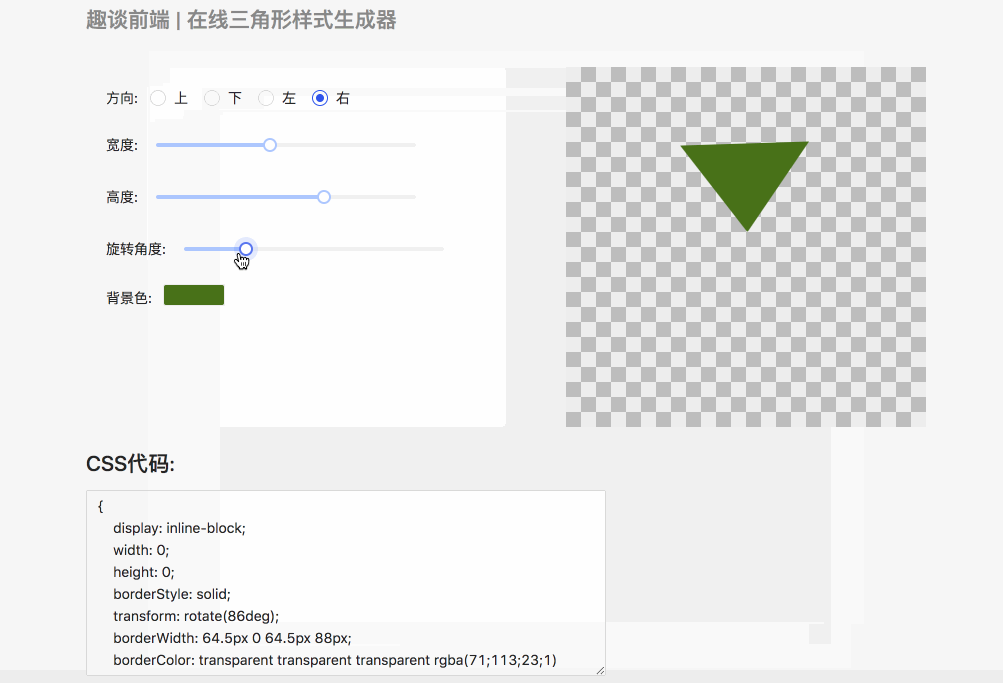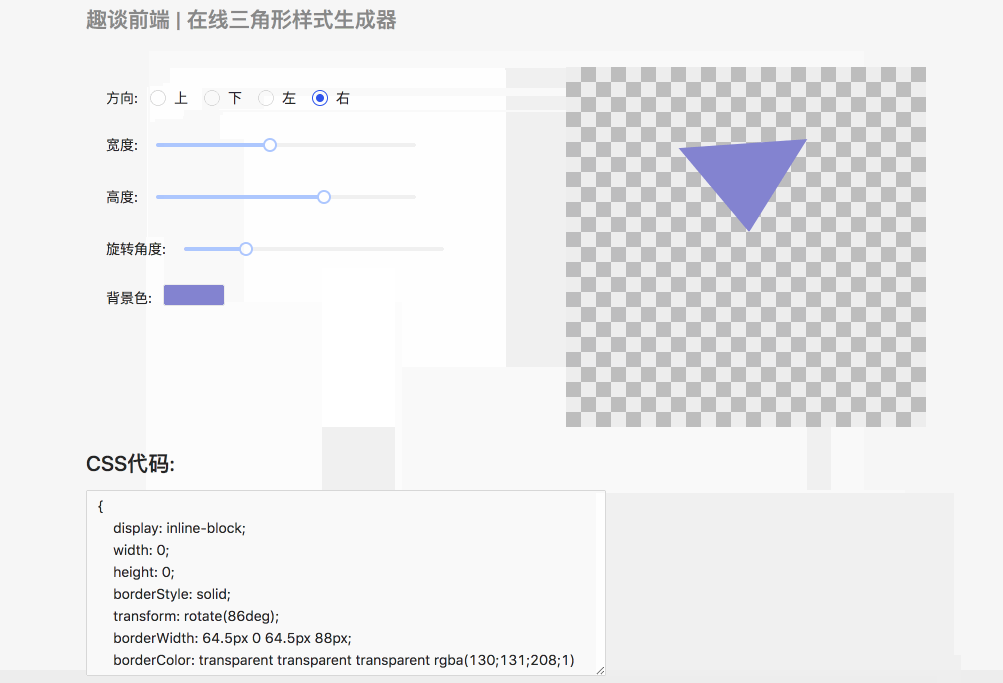
为了提高 前端开发效率, 笔者先后写了上百个前端工具, 有些是给公司内部使用的, 有些单纯是因为自己太“ 懒”, 不想写代码, 所以才“ 被迫”做的. 接下来介绍的一款工具—— css三角形生成器也是因为之前想要解放设计师的生产力, 自己又懒得切图或者写 css代码, 所以想来想去还是自己做一个 能自动生成css三角形代码的工具吧. 接下来笔者就来带大家介绍一下这个工具的用途和实现方案, 方便大家后续可以扩展出更多的“ 懒人工具”. 在线css三角形生成器预览 由预览动画我们可以看到通过在线工具我们可以轻松配置各种想要的三角形, 并且能实时查看 css代码. 开发完这个工具之后笔者再也不用担心还需要手写三角形代码了. (上班摸鱼也成了可能, 确实很多时候就是不想写代码还想要有钱拿) 在文末笔者会附上 css工具的在线地址, 接下来我们来看看具体实现流程. 实现css三角形生成器 因为这个工具的需求来自于前端, 所以肯定是要对 css和 js编程有一定的基础, 比如css3的 transform, transition, 布局, 盒模型, border边界特性等. 和笔者之前写的任何一个开源工具一样, 在开发项目前一定要明确需求和目标, 这里笔者简单整理一下需求: 生成任何大小的三角形(size) 生成不同位置的三角形(direction) 生成不同角度的三角形(rotate) 生成不同背景色的三角形(color, 其实这个实不实现无所谓, 主要是笔者连这个代码都懒的写) 了解需求之后我们可以大致画一个简单的原型图来代表我们的 css生成器界面, 如下: 有了原型图, 我们可以得到如下的任务细分图: 这里笔者要提的一点是其实以上流程对于任何项目都适用, 包括你遇到的难解的问题, 都可以一步步把思路先理清楚, 把大目标拆解为一块块的小目标, 然后逐个击破, 这样大难题也就解决了. 接下来我们先分析一下用 css实现三角形的原理. 1.css画三角形的原理 其实笔者在之前的文章中也分享过3种以上的使用 css实现三角形的方案, 这里笔者介绍一个通用的方法, 也就是用 border来实现三角形, 我们先来看下面的图示: 以上是展示了当box元素的 width小于自身 border宽度时的样子以及当box宽度为零而 border-width不为零时的样子. 通过图形一分析是不是很容易联想到如果我只要一个边有颜色,其他都为透明面是不是就能变成三角形了呢? 的确也是这么实现的, 知道这个原理之后我们来继续往下实现所见即所得的“三角形”. 2.编辑器实现 编辑器实现也是前端老生长谈的话题了, 笔者在 H5-Dooring项目中写过一个非常复杂的编辑器, 但是这里我们只要需要一个静态且简单的编辑器就够了. 如下图的界面: 我们可以用任何我们擅长的框架和组件库来实现, 比如· vue3+ element plus, react + antd4.0, 笔者这里采用 react方案实现, 颜色选择器采用社区比较有名的 react-color. 编辑器界面的代码笔者就不一一介绍了, 相信大家都能实现, 我们这里来说一下样式数据共享逻辑: 我们要想保证预览区域和css代码预览区域能随表单值变化而实时变化, 这里一定要将表单数据共享出来, 我们可以用 react组件的 state或者 vue的 vuex(虽然不用vuex也可以将data提升)来共享状态. 3. 预览区域实现 预览区域实现其实有了以上的分析其实很好实现了, 只需要利用共享的 form数据来绑定到三角形元素的样式上即可. 画布的背景这里笔者也是用 css实现的, 如下图: 感兴趣可以cv一下, 这代码如下: .previewArea{display:inline-block;width:360px;height:360px;background:#eee;background-image:linear-gradient(45deg,rgba(0,0,0,.2)25%,transparent0,transparent75%,rgba(0,0,0,.2)0),linear-gradient(45deg,rgba(0,0,0,.2)25%,transparent0,transparent75%,rgba(0,0,0,.2)0);background-size:30px30px;background-position:00,15px15px;} 还有一个比较关键的一点是如何实现切换三角形的方向的问题, 我们都知道切换方向后 css的 border的几个方向属性都会变, 比如三角形的方向向上时, 我们的 css如下: {border-width:060px60px100px;border-color:transparenttransparent#06ctransparent;} 三角形的方向向下时, 我们的 css如下: {border-width:100px60px060px;border-color:#06ctransparenttransparenttransparent;} 同样左右也是类似的, 所以我们要维护4中样式, 如果后期想加一下左上, 右上, 左下, 右下, 这样代码会非常难以维护(不是 if else就是 switch, 说实话 switch只适合8个条件一下的判断), 所以笔者这里用对象法来解决它, 并将其封装成一个函数: constgetBorderWidthAndColor=(direction:string,w:number,h:number,color:string)=>{constborderWidthAndColor:any={'1':{borderWidth:`0${w/2}px${h}px${w/2}px`,borderColor:`transparenttransparent${color}transparent`},'2':{borderWidth:`${h}px${w/2}px0${w/2}px`,borderColor:`${color}transparenttransparenttransparent`},'3':{borderWidth:`${h/2}px${w}px${h/2}px0`,borderColor:`transparent${color}transparenttransparent`},'4':{borderWidth:`${h/2}px0${h/2}px${w}px`,borderColor:`transparenttransparenttransparent${color}`}}returnborderWidthAndColor[direction]} 其实属性预览比如宽度, 高度, 背景色这些都好处理, 笔者这里就不一一介绍了. 预览如下: 4. 代码实时展示实现 至于代码实时展示在文本框中, 这个也是很容易实现, 我们只要要把拿到的数据实时展示到文本框里即可. 由于笔者采用的css module 和react方式实现的, 所以需要对css进行额外处理, 比如将对象格式转化为css规范的格式, 所以需要加如下步骤: JSON.stringify(triangleCss,null,4).replaceAll(/"/g,'').replaceAll(/,/g,';') 这样, 一个css三角形生成器就做好了, 大家还可以在此基础上继续扩展, 比如支持多边形, 六角形, ⭐五角形等, 也是完全没问题的. 在线体验地址:在线css三角形生成器 最近H5编辑器 H5-Dooring也做了大量更新和优化, 感兴趣的也可以学习研究. 轻松一刻 觉得有用 ?喜欢就收藏,顺便点个赞吧,你的支持是我最大的鼓励!微信搜 “ 趣谈前端”,发现更多有趣的H5游戏, webpack,node,gulp,css3,javascript,nodeJS,canvas数据可视化等前端知识和实战. 本文分享自微信公众号 - 趣谈前端(beautifulFront)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

手淘 App 如何落地 Swift ?一边探索实践,一边“打怪升级”

嘉宾|姜沂(倾寒)出品|InfoQ&阿里巴巴新零售淘系技术部 嘉宾简介:姜沂(花名:倾寒),阿里巴巴淘系技术部 iOS 端架构高级无线开发工程师,曾在链家网、美团点评从事 iOS 相关开发,目前就职于淘宝-淘系技术部。在链家网架构组主要工作有:组件化工程、构建合理开发链路、基础库开发和客户端稳定性相关工作。在美团点评架构组所做工作主要有响应式架构设计落地、性能优化和基础库开发。目前在淘宝客户端架构组,具体负责的工作有基础库开发、性能优化、淘宝灰度能力、开发工具升级,以及 Swift 语言落地。 前言 自从 2014 年苹果发布 Swift 至今,历经多次迭代,Swift 终于迎来了 ABI 稳定,SwiftUI 的发布也引起无数 Apple 平台开发者的欢呼。 多年来广受关注而又备受争议的 Swift,终于开始被很多大型 App

优秀的个人博客,低调大师

下一代技术革命的物联网中,谁将扮演“冲锋手”?

物联网(IoT)被业界普遍认为是互联网之后的下一次技术革命,号称是可穿戴设备、智能家居、自动驾驶骑车、智能工厂、智慧城市等等新时代的曙光。 物联网意味着互联网和可接入设备的万物互联,它结合了业界的潜在优势:便宜且可广泛使用的带宽、低能耗的微处理器、大数据分析工具。物联网的发展壮大与两大关键技术息息相关:边缘计算和机器学习。 边缘计算的不断发展 连接设备、传感器、网关等物联网接入端点正在呈指数级增长,IT行业分析公司Gartner预计物联网终端的增长速度约为30%,到2020年物联网接入设备的总数将会高达200亿。接入设备的爆发为数据分析和数据处理带来了新的挑战,这些终端设备将生成大量的数据。如果将这些数据传输到云计算中进行数据管理、分析和决策不仅费用高昂且效率低下,还可能阻碍网络基础设施的发展,从而导致网络延迟问题。 因此,边缘计算和边缘分析在大型的IoT部署中作用越来越突出。在边缘计算中,计算能力是分散的,无限接近传感器、设备,设备的数据来自网络边缘,并且在网络边缘完成数据的分析和处理工作,而不是在集中式服务器或云端。 其优势包括:能够有效支持实时应用程序,基础设施的负担降低,因为大部分数据都是在边缘网络进行处理,只需要将必要的数据发送到云端实现进一步的处理和存储。 这并不意味着边缘计算和传统的数据中心以及云计算会产生冲突,相反,边缘计算更可能会与云计算共存,以将计算能力和工作负载分布到最有意义的地方。传感器数据将会在边缘网关上进行收集和处理,边缘分析可以使用基于规则的算法。可以将过滤之后的数据发送到云端,与其他来源的数据进行聚合,然后将其反馈到云端的分析引擎,以生成可发送回到边缘分析的模型。 机器学习 随着物联网的兴起,能够对边缘计算形成良好补充的技术是机器学习。机器学习通常与人工智能一起出现,机器学习是指生成不需要由人类明确编程的自动分析模型的方法。虽然几十年前可以使用机器学习的知识,但直到近些年,计算能力的发展才能满足机器学习的需求。 随着计算能力越来越好,机器学习将越来越多地融入到IT架构中,尤其是在云端和边缘计算中。机器学习不仅可以集中云端的分析功能,还可以大大提高边缘分析的效率。 随着物联网的采用的发展和数据大爆炸,边缘计算和机器学习将在未来的物联网架构中发挥关键作用。三大公有云服务提供商AWS、微软和谷歌都在致力于将边缘计算和机器学习融入其产品中,分别在其云平台上提供机器学习即服务。目前AWS和微软已经推出了相关的边缘计算软件,可以在芯片商的系统(SOC)运行,也可以在边缘网关上运行。 与所有新技术一样,只有时间才能证明这些技术将如何发挥作用,但非常明确的一点是物联网的时代即将到来,边缘计算和机器学习是物联网时代必不可少的两大主角。 本文作者:佚名 来源:51CTO

优秀的个人博客,低调大师

第一次参加就甩开IBM 阿里云成为国际顶级竞技手

6月16日,国际知名调研机构Gartner公布了2017年全球云计算IaaS魔力象限,阿里云强势崛起成为这一核心领域的前四名。这也是中国云计算厂商首次进入Gartner的IaaS魔力象限。排在阿里云之前的是,AWS、微软和Google。Gartner成立于1979年,是世界领先的研究和咨询公司。该公司为商界领袖了解相关行业而提供客观见解,帮助他们作出正确决定。其发布的行业魔力象限被认为是产业风向标。 Gartner报告显示,阿里云处于魔力象限的Visionaries(有远见者、愿景者)区域。此次评估针对的是其国际业务能力。这是Gartner首次将中国云计算厂商的国际业务列入评比范畴。 在国际市场上,阿里云提供弹性计算服务、对象存储、CDN、容器等各种服务,包括一系列数据库产品。该公司在中国市场提供功能和服务会比国际市场更多。 Visionaries(有远见者、愿景者)区域表示该公司具备良好前瞻性、了解未来市场发展。通常非常有希望进入领导者(Leaders)区域。 “阿里云是中国Iaas市场份额的领先者,尤其在进行云端转型的企业和政务机构相关市场中表现出色。” 分析师在报告中写道,“此外,阿里巴巴集团持续在新的地区投资技术和业务板块,也为阿里云的业务拓展提供了新的市场。”在中国,阿里巴巴建立了一个由管理服务提供商和独立软件供应商组成的生态系统,众多国际化产品正在融入其中。 Gartner同时指出,阿里云是中国市场的领导者,也是国际市场的有力竞争者。“随着时间的推移。阿里云计算不仅具有多样化的功能——今天已经堪比其他超大规模提供商的服务组合 ——而且也已经开始打造出了一个广泛的全球数据中心。” 据公开资料,阿里云目前在美国西部、美国东部、澳大利亚、日本、新加坡、迪拜、德国、香港等14个区域设有数十个飞天数据中心,形成全球一张网覆盖。此外,即将新增的印度、印尼和马来西亚数据中心,将使该公司全球区域达到17个。 根据阿里巴巴今年5月的财报显示,自2016财年第一季度以来,阿里云已经连续8个季度保持着超过100%的高速增长。 本文转自d1net(转载)

优秀的个人博客,低调大师

阿里宣布手淘安卓客户端容器化框架Atlas正式开源

继Weex之后,阿里在移动技术领域又有开源大动作。 3月13日,手机淘宝安卓客户端容器化框架Atlas正式宣布开源(https://github.com/alibaba/atlas)。Atlas由阿里巴巴移动团队自研,以容器化思路解决大规模团队协作问题,实现并行开发、快速迭代和动态部署,适用于Android 4.x以上系统版本的大小型App开发。 Atlas特别适用于大规模团队的协同开发。通过提供组件化、动态性、解耦化的支持,Atlas能够实现每个业务在开发阶段独立编译、独立调试、独立运行,最后再以一个组件的形式集成到客户端中,每个业务之间并行开发互不影响。此外,还具备客户端动态发版和快速修复的能力。 目前,手机淘宝20个协作团队开发的60+业务组件,数百万行代码都运行在Atlas上。。快速迭代让应用真正实现了随时更新,有效降低了版本频

优秀的个人博客,低调大师

当 PDF 不再一股脑丢给 OCR:认识一下 pdf-inspector

很多 PDF 处理流程里,最贵的那一步,往往不是 “读文件”,而是 “看不清就全送去 OCR”。 这件事听上去很自然,做起来也很省心:PDF 来了,扔进 OCR,等结果出来。但问题也很明显 —— 有些 PDF 根本不是扫描件,它本来就带着清清楚楚的文本层;如果还是按同样的重型流程处理,时间和成本都会被悄悄放大。 `pdf-inspector` 想解决的,正是这个环节里的 “误伤”。 项目地址:/firecrawl/pdf-inspector 它是一个用 Rust 编写的 PDF 检查与提取库,核心目标很直接:**先判断 PDF 到底是什么类型,再决定后续该怎么走**。README 对它的描述非常清楚 —— 它可以做 PDF 分类、文本提取,并且能智能识别一个 PDF 是扫描件还是文本型文档,从而帮助上层流程做更聪明的路由决策。 ## **它不是在 “读取 PDF”,它更像是在 “打量 PDF”** 如果把普通 PDF 处理工具比作一位埋头苦干的搬运工,那 `pdf-inspector` 更像是站在门口先看一眼局势的人。 它先问的不是 “怎么提取”,而是: - ・这是文本型 PDF 吗 - ・这是扫描件吗 - ・这是纯图像型文档吗 - ・还是一份混合型 PDF README 里给出的分类结果包括: - • `TextBased` - • `Scanned` - • `ImageBased` - • `Mixed` 而且这个判断不是一句模糊的 “像不像”,它还会返回 **confidence score**,也就是 0.0 到 1.0 的置信度分数;同时还能给出 **按页的 OCR 路由信息**,指出哪些页面缺少文本、需要 OCR 介入。 这就很有意思了。因为现实里的 PDF 从来不是整齐划一的:有的文档前几页是正文,后几页是扫描附录;有的报告主体是文字,但夹着几页图片;有的材料明明能直接提文本,却总被整个送进 OCR。`pdf-inspector` 在这里做的事情,不是粗暴地把整份文档贴上一个标签,而是尽可能把判断拆细,把决策交给真正需要决策的地方。 ## **一个很务实的出发点:不该做 OCR 的,就别做 OCR** README 里对这个项目的定位非常鲜明:它由 Firecrawl 构建,用来在本地处理文本型 PDF,并跳过昂贵的 OCR 服务。 甚至连使用场景都写得很直白 —— 针对大规模 PDF 处理流程,不是把每份 PDF 都送去 OCR,而是先分类: ``` PDF arrives → pdf-inspector classifies it (~20ms) → TextBased + high confidence? YES → extract locally (~150ms), done NO → send to OCR service (2-10s) ``` 这个流程图的价值在于,它没有把工具包装成 “万能 PDF 魔法盒”,而是非常诚实地告诉你:**它特别适合做前置判断与本地提取**。当文档本身已经具备良好的文本结构时,就本地快速完成;当文档缺少可用文本层,再转去 OCR。 README 还提到,之所以这么做,是为了节省大多数本来就是文本型 PDF 所带来的成本与延迟。这一点很朴素,但也很关键。很多工程优化最后都不是更复杂,而是更会分流。 ## **这份 README 的关键词只有两个:快,且知道自己在做什么** `pdf-inspector` 的 “快” 不是一句空泛宣传,README 里把它拆成了多个具体层面。 ### **1. 分类很快** 项目说明中写到,它通过采样内容流来检测 PDF 类型,分类大约在 **10 到 50 毫秒**之间完成。对于 300 页以上的 PDF,也能在毫秒级完成检测。 README 还解释了分类思路: 1. 1. 解析 xref table 和 page tree,而不是完整加载所有对象 1. 2. 根据 `ScanStrategy` 选择页面,默认扫描全部页面并支持提前退出 1. 3. 在内容流里查找 `Tj` / `TJ` 这样的文本操作符,以及 `Do` 这样的图像操作符 1. 4. 根据采样页中的文本操作符情况进行分类 这套思路很像一个经验老到的检查员:不急着把整栋楼拆开重装,而是先看结构、查关键线索,再决定判断。 ### **2. 提取也快** README 里提到,这个库可以在本地 **200ms 以内**处理文本型 PDF。与此同时,它还有一个重要的架构设计:**文档只加载一次**。 也就是说,检测和提取共享同一个已解析文档,不会为了 “先判断、再提取” 而重复做 I / O 和重复解析。这个细节非常工程化,也很能说明作者在意的不是孤立功能点,而是整条处理链的效率。 ## **它提取的不只是 “字”,而是尽量保留 “文档的样子”** 如果一个 PDF 工具只能把文字抠出来,那它离 “可用” 还差一步;真正难的是,把文本顺序、结构层级、列表、表格这些信息尽量保留下来。 `pdf-inspector` 在 README 里把这一块写得相当完整,它支持的并不是单纯文本输出,而是 **带位置感知的提取**,并进一步转换为 **干净的 Markdown**。 ### **文本提取:位置意识很强** 项目支持带有以下信息的文本提取: - ・字体信息 - ・X / Y 坐标 - ・自动多栏阅读顺序 这意味着它不是在 “把字符拼一遍”,而是在尽可能理解页面布局。尤其面对报纸式、多栏式排版时,这一点很重要。很多文档如果只按原始顺序硬拼,最后读起来会像把两条河流拧在了一起;而 `pdf-inspector` 明确支持 **自动检测多栏布局**,并按顺序组织阅读结果。 ### **Markdown 转换:不是简化,而是整理** README 里列出了 Markdown 输出阶段会处理的内容,包括: - ・标题 H1 到 H4,通过字体大小层级识别 - ・粗体和斜体,通过字体名称模式识别 - ・项目符号列表 - ・编号列表 - ・字母列表 - ・代码块,通过等宽字体和关键字检测 - ・表格 - ・财务表格中的数字拆分 - ・图表说明文字 - ・上标和下标 - ・URL 转换为 Markdown 链接 - ・断行连字符恢复 - ・页码过滤 - ・首字下沉合并 - ・目录式点线压缩 看起来像是一长串细节,但这些细节组合起来,其实是在回答同一个问题:**导出的 Markdown 到底能不能直接读、直接用。** 一份好的结构化提取,不是把页面 “打散”,而是把它 “翻译” 成另一种仍然有秩序的表达方式。`pdf-inspector` 做的就是这件事。 ## **表格这件麻烦事,它没有回避** PDF 里的表格,向来是文档处理里的硬骨头。`pdf-inspector` 在 README 中把表格检测单独拿出来写,也说明这部分是它的重要能力之一。 它采用的是 **双模式表格检测**: - ・基于 PDF 绘图操作中的矩形进行检测 - ・基于文本对齐关系进行启发式检测 随后再做: - ・列与行分配 - ・单元格组织 - ・最终格式化为 Markdown 表格 README 还特别提到,它可以处理: - • financial tables - • footnotes - • continuation tables across pages 也就是说,它考虑的不是 “有没有一张最标准的表”,而是现实里那些经常不那么整齐、甚至会跨页延续的表格。 这是一种很实在的设计态度:PDF 不是给解析器准备的,它原本是给人看的,所以所有结构化提取都天然带着一点 “逆向理解” 的意味。表格做得越认真,越说明项目没有停留在 “能跑通” 这个层面。 ## **对字体编码问题,它保持警觉** 不少 PDF 处理问题,看起来像 “提取失败”,实际上根源常常藏在字体编码里。 README 里提到,`pdf-inspector` 支持: - ・ToUnicode CMap 解码 - ・Type0 / Identity-H 字体 - • UTF-16BE - • UTF-8 - ・Latin-1 编码 同时,它还会自动检测 **broken font encodings**,并在发现问题时提示调用方回退到 OCR。 这一点很重要,因为 “错误地提取出一堆乱码” 往往比 “明确告诉你这里不可靠” 更糟糕。一个靠谱的系统,不只是会成功,也知道什么时候该承认自己不该继续硬提。 ## **同一套核心,不只活在 Rust 里** 虽然它的核心是 Rust,但这个项目并没有把自己困在单一语言生态里。README 展示了它在多个环境里的使用方式: - • Python - • Node.js - • Browser WebAssembly - • Rust - • CLI 这不是 “顺手做了几个绑定”,而是让同一个 PDF 能力,在不同上下文里都能被调用。 ### **Python:直接处理文件** ``` import pdf_inspector result = pdf_inspector.process_pdf("document.pdf") print(result.pdf_type) # "text_based", "scanned", "image_based", "mixed" print(result.markdown) # Markdown string or None ``` ### **Node.js:直接读取 Buffer 处理** ``` import { readFileSync } from 'fs'; import { processPdf, classifyPdf } from '@firecrawl/pdf-inspector'; const result = processPdf(readFileSync('document.pdf')); console.log(result.pdfType); // "TextBased", "Scanned", "ImageBased", "Mixed" console.log(result.markdown); // Markdown string or null ``` ### **浏览器 WebAssembly:本地跑,不走服务端** ``` import init, { processPdf } from '@firecrawl/pdf-inspector-wasm'; await init(); const response = await fetch('/document.pdf'); const pdf = new Uint8Array(await response.arrayBuffer()); const result = processPdf(pdf); console.log(result.pdfType); console.log(result.markdown); ``` ### **Rust:最原生的一种方式** ``` use pdf_inspector::process_pdf; let result = process_pdf("document.pdf")?; println!("Type: {:?}", result.pdf_type); if let Some(markdown) = &result.markdown { println!("{}", markdown); } ``` ### **CLI:给命令行工作流留足空间** ``` # Install the CLI tools cargo install pdf-inspector # Convert PDF to Markdown pdf2md document.pdf # JSON output (for piping) pdf2md document.pdf --json # Positioned TextItem JSON, including is_underline metadata pdf2md document.pdf --items-json # Raw markdown only (no headers) pdf2md document.pdf --raw # Token-efficient output (collapses long dot leaders and similar source padding) pdf2md document.pdf --compact # Insert page break markers () pdf2md document.pdf --pages # Process only specific pages pdf2md document.pdf --select-pages 1,3,5-10 # Detection only (no extraction) detect-pdf document.pdf detect-pdf document.pdf --json # Detection + layout analysis (tables, columns) detect-pdf document.pdf --analyze --json ``` 从这些入口能看出来,`pdf-inspector` 的姿态很明确:它不只想成为一个库,也想成为一块可嵌入、可集成、可组合的基础能力。 ## **浏览器侧的 WASM 版本,有一种 “把事情留在本地” 的克制** WASM 版本在 README 里有几个很值得注意的点: - ・解析在本地运行 - ・PDF bytes 不会上传 - ・构建是单线程的 - ・不要求 cross-origin isolation - ・CMaps 已内嵌 - • `init()` 之后提取是同步的 - ・大文档建议放到 Web Worker 里执行 - ・纯图片文档依然需要单独 OCR 这几条信息拼起来,勾勒出了一个很清晰的浏览器侧能力边界:**它能在浏览器里本地做分类和结构化提取,但不会假装自己能替代图像 OCR。** 这种边界感很可贵。很多工具最容易让人失望的地方,是宣传成 “全能型”,实际遇到复杂文档就沉默;而这里的说明方式更像一个稳重的工程组件 —— 能做什么,说清楚;不能替代什么,也说清楚。 ## **Node.js 绑定里,还有一项很实用的能力:区域提取** `napi/README.md` 里提到一个主 README 没有重点展开、但非常实用的能力:**按区域提取文本**。 也就是: ``` extractTextInRegions(buffer: Buffer, pageRegions: PageRegions[]): PageRegionTexts[] ``` 它的设计目标也写得很明白:适用于 **混合 OCR 流程**。先由页面图像上的布局模型识别区域,再由这个函数从 PDF 结构层里提取对应区域的文本。 示例里每个区域结果都带有 `needsOcr` 标记;如果文本不可靠,比如: - ・提取结果为空 - ・字体是 GID 编码 - ・出现垃圾文本 - ・编码异常 那就把这个区域继续送 OCR。 这种能力很像是把 “整份 PDF 是否 OCR” 进一步细化成 “某一页、某一块区域是否 OCR”。对于复杂文档来说,这种粒度显然更灵活。 ## **它的内部结构,读起来很像一条分工明确的流水线** README 给了一张很完整的架构图,从原始 PDF bytes 开始,分成 detector 和 extractor 两条主线。 提取链路里又包括: - • fonts - • content_stream - • xobjects - • links - • layout 然后布局再进入: - • tables - • markdown 最后经过分析、预处理、转换、分类和后处理,产出最终 Markdown。 这种结构感带来的最大好处,是让人一眼看出项目不是 “功能堆在一起”,而是按职责拆开的。README 还列出了源代码目录结构,例如: - • `lib.rs` 负责公共 API、`PdfOptions` builder 和便捷函数 - • `python.rs` 负责 PyO3 Python 绑定 - • `types.rs` 定义共享类型 - • `text_utils.rs` 处理字符与文本辅助逻辑 - • `process_mode.rs` 定义处理模式 - • `detector.rs` 负责快速 PDF 类型检测 - • `glyph_names.rs` 提供 Adobe Glyph List 到 Unicode 的映射 - • `tounicode.rs` 处理 ToUnicode CMap 解析 - • `extractor/` 是文本提取流水线 - • `tables/` 负责表格检测与格式化 - • `markdown/` 负责 Markdown 转换与结构识别 - • `bin/` 放置 CLI 工具 - • `napi/` 是 Node.js / Bun 绑定 - • `wasm/` 是浏览器绑定 如果你喜欢看项目 “骨架”,这一部分会很有阅读价值。它没有试图用很多抽象术语把自己说得高深,反而是把模块划分摆在你面前,让你知道这套能力是怎么层层拼起来的。 ## **扫描策略也不是只有一种** 在分类环节里,README 还给出了 `ScanStrategy` 的几种策略: - • `EarlyExit`:扫描所有页面,遇到第一个非文本页就停止 - • `Full`:扫描所有页面,不提前退出 - • `Sample(n)`:均匀采样若干页 - • `Pages(vec)`:只扫描指定页面 这意味着项目并不是只有一种固定的 “检测姿势”,而是把速度和精度之间的权衡显式交给调用方。 如果你的场景更看重快速路由,可以用更偏速度的策略;如果你需要更准确地区分 `Mixed` 和 `Scanned`,也有对应选择。这样的设计很适合真实系统接入,因为不同业务场景对 “快” 和 “准” 的容忍度并不相同。 ## **从 Benchmark 看,它想证明的不只是能用,而是有竞争力** README 提供了一组基于 `opendataloader-bench` 语料库的 benchmark 结果,测试集包含 200 份 PDF,只展示本地引擎且关闭 OCR。 结果表里,`pdf-inspector` 的成绩是: - • Overall:0.875 - • Reading Order (NID):0.915 - • Tables (TEDS):0.814 - • Headings (MHS):0.788 - • Speed (200 docs):0.470s README 还写到,这组结果在 **2026 年 7 月 31 日**于 **Apple M4 Pro** 上刷新;速度统计是去掉预热后的五次完整跑分中位数。 项目还明确写出一条 “Best fit” 总结:它适合 **native-text PDFs**,尤其是在速度、阅读顺序和表格结构都重要的场景里。在这次对比中,它拿到了更高的整体分、阅读顺序分和表格分,同时也是最快的。 这段 benchmark 信息的价值,不只是 “我更强”,而是它把 “适合什么场景” 说清楚了:**文本型 PDF、重视结构质量、同时在意速度**。这和它前面的整体定位是连贯的。 ## **安装方式很直接,门槛并不高** 如果你想从 README 给出的路径快速上手,不同环境的入口都非常明确。 ### **Python** ``` pip install maturin maturin develop --release ``` ### **Node.js** ``` npm install @firecrawl/pdf-inspector ``` ### **Browser WebAssembly** ``` npm install @firecrawl/pdf-inspector-wasm ``` ### **Rust** ``` cargo add pdf-inspector ``` 或者手动添加依赖: ``` [dependencies] pdf-inspector = "0.1" ``` ### **从源码构建 WASM** ``` cargo install wasm-pack --version 0.15.0 --locked wasm-pack build wasm --target web --scope firecrawl --release ``` Node.js 绑定的 README 里还特别提到,它提供预构建二进制,覆盖 Linux x64 / ARM64、macOS ARM64 和 Windows x64,npm 安装时只会安装与你平台匹配的那个包,而且 **不需要 Rust toolchain**。这对使用者来说非常友好,尤其是在只想集成能力、不想处理本地编译链路的时候。 ## **一个很有 “工程气” 的 PDF 工具** 读完 README 和 description,会很明显地感受到 `pdf-inspector` 的气质:它不是那种试图在文案里包办一切的项目,而是一块边界清楚、能力扎实、特别适合接进处理流水线的基础组件。 它关心的不是 “把 PDF 这件事说得多宏大”,而是几个很具体的问题: - ・这份 PDF 是文本型还是扫描型 - ・哪些页需要 OCR - ・能不能本地快速提取文本 - ・能不能尽量保住阅读顺序和结构 - ・能不能把结果整理成更干净的 Markdown - ・遇到编码问题时,能不能及时识别并让上层回退 这种专注会让一个工具显得很可靠。因为它不是对所有问题都说 “我能”,而是把自己最擅长的那一段路打磨得很深。 如果说 OCR 像重型机械,适合啃最硬的文档;那么 `pdf-inspector` 更像是一位懂分流、会判断、下手快的前场指挥。它先看看眼前这份 PDF 究竟是什么,再决定是轻快地本地处理,还是把真正难啃的部分交给后面的流程。 在 PDF 处理这条链路里,这样的角色,往往比想象中更重要。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册