首页 文章 精选 留言 我的

精选列表

搜索[轻量化模型],共10000篇文章
优秀的个人博客,低调大师

Spark(六) -- Spark计算模型

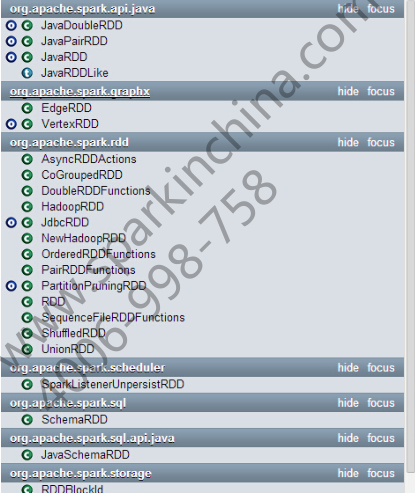
版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq1010885678/article/details/45788083 整个Spark框架都是基于RDD算子来进行计算的。 What is RDD? Resilient Distributed Dataset(RDD),分布式弹性数据集,是Spark上的一个核心抽象 表示用于并行计算的,不可修改的,对数据集合进行分片的数据结构 简单地,可以将RDD看成是Spark平台上的通用货币 在Spark上,针对各种各样的计算场景存在着各种各种的RDD,这些RDD拥有一些共同的操作,例如map,filter,persist等,就好像RDDs都是一个总RDD的子类一样,拥有所有RDD的共同特性 同时RDDs也拥有能表达自己特性的操作,例如PairRDDR有groupByKey,join等操作,而DoubleRDD有Doubles操作 所有的RDD都有以下特性: 可以表示数据分片的列表集合。将原始数据经过某些分片处理生成RDDs,这些RDD将用于并行计算 通用的算子来计算每个数据分片 包括transformation和action两大算子类别。 RDD之间拥有依赖关系 transformation只对数据进行处理而不计算,处理过程会被画成一个DAG有向无循环图,只有当action操作要获取结果时,才根据DAG图来进行并行计算。 DAG图会根据RDD之间的依赖关系被分解成一个个stage之后提交 形成DAG图的过程中也会根据RDD之间的依赖关系形成Lineage 这是Spark上一个重要的容错机制 当某个节点计算错误时,只需要根据Lineage重新计算相关的操作而不必回滚整个程序 以下两张图是来源自网络的 Spark中部分RDD类的截图 transformation和action操作的Function截图 除了transformation和action两大类算子之外,RDD还有一个比较特殊的算子 如persist和checkpoint,它们既不属于transformation也不属于action 但是都会触发Job的运行 persist将RDD结果持久化,修改了RDD中meta info的存储级别 checkpoint在持久化RDD的同时还切断了RDD之间的依赖血缘关系。除了修改了存储级别,还修改了meta info中RDD的lineage依赖关系 两者返回的均是修改后的RDD而不是产生的RDD(transformation是产生新的RDD,action是对RDD取结果) RDD之间的依赖关系可以分为Narrow,Wide:窄依赖和宽依赖两种 窄依赖:子RDD中的每个数据块只依赖于父RDD中对应的有限个固定的数据块,可以理解成父子RDD是一对一或者多对一的关系,例如:map变换,前后的数据都是一行对一行的。一个子RDD可以根据其父RDD直接计算得出,因而子RDD出现计算错误的时候,只需要重新计算对应的父RDD即可 宽依赖:子RDD中的一个数据块可以依赖于父RDD中的所有数据块。即一对多的情况,例如:groupByKey变换,子RDD中的数据块会依赖于多个父RDD中的数据块,因为一个key可能存在于父RDD的任何一个数据块中 。宽依赖中的子RDD要等到所有的父RDD计算完成之后才能进行计算,当数据丢失时需要对所有祖先RDD进行重新计算 依赖关系图: 其中,宽依赖是会触发shuffle行为的 而shuffle操作可以减小集群之间网络传输的压力,对数据进行一定的提前处理工作,对于提高整个集群的处理性能是十分重要的 在Spark中shuffle操作会是将DAG图划分成一个个stage的起点 如图所示: map和union是属于transformation操作的。这里会涉及到一个pipeline的概念,对数据切片之后并行协同计算,从图中我们可以看到,map和union的时候Task之间的处理是并行的,而协同体现在当某个Task计算缓慢的时候,集群会启动一个新的节点来计算该Task,哪个节点先处理完毕就采用哪个节点的结果 groupBy和join操作是产生RDD之间的宽依赖的,这是一个shuffle过程,也是触发划分stages的起点,如上图中的三个stage 从物理的角度看RDD其实是一个元数据结构,存储着Block和Node之间的映射关系 关于Spark的transformation,action和划分stage等过程都是怎么处理的,整个作业的处理流程是什么,请看: Spark(四) – Spark内核作业调度机制

优秀的个人博客,低调大师

深度学习在语音识别中的声学模型以及语言模型的应用

过去 3 年,深度学习在各个领域取得较大突破,比如计算机视觉领域的物体识别、场景分类,语音分析等,并且其技术推广和应用的速度超过人们预期,比如 Google 的广告系统已经开始使用深度学习盈利,Twitter 也通过深度学习改善App 图片及视频内容服务体验。那具体何为深度学习呢?深度学习是怎么应用在上述的各个领域呢,下面结合自身在语音识别的若干年经验,谈谈深度学习在语音识别中的具体应用。 0. 背景 “深度学习”的概念在上个世纪便被提出,但Hinton、Lecun等人在2006年发表的论文让“深度学习”重新焕发光彩,并使得相关的学术成果在实际应用中表现良好。它的灵感来自对人脑神经的研究,因此也称为深度神经网络“DNN”。这里的“深度”并非指算法有内涵,而是指神经网络层数多,因此也称为多层结构学习

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册