首页 文章 精选 留言 我的

精选列表

搜索[Excel导题],共7114篇文章
优秀的个人博客,低调大师

Android CoordinatorLayout 导文

之前写了一篇seekbar做滑动验证,想不到会有人支持,其实我自己觉得写得不是很好,包括做的也不是很好,但是还是有人给我点赞,真的感觉很开心,之后也会更用心的去写文章。你们的支持就是我努力的理由,如果有什么地方写得不好或者有BUG之类的也希望大家能提出指正。 CoordinatorLayout 接下来我会用一个系列的文章来说一下我所认识的CoordinatorLayout 。 这个系列我暂时先发布六章,因为CoordinatorLayout 存在卡顿的BUG,所以我有时间找到代替它的控件或者解决BUG后会接着发。 1. 初探CoordinatorLayout2 .CoordinatorLayout的组合使用3. CoordinatorLayout的组合使用4. CoordinatorLayout的常用属性5. CoordinatorLayout严重的卡顿BUG6. CoordinatorLayout加入下拉功能 这个系列前三章讲CoordinatorLayout的一些基本用法,第4章讲的是使用过程中一些经常出现的属性,第五章讲的是CoordinatorLayout的BUG,这个卡顿BUG很影响用户的体验效果,如果没法解决建议不要使用这个控件,最后讲CoordinatorLayout怎么加入下拉刷新的功能。 项目地址 https://github.com/994866755/CoordinatorLayoutDemo 建议如果要看文章的话,建议对着APP去看效果,因为我在文章中没有加入GIF图。

优秀的个人博客,低调大师

卷积神经网络导览

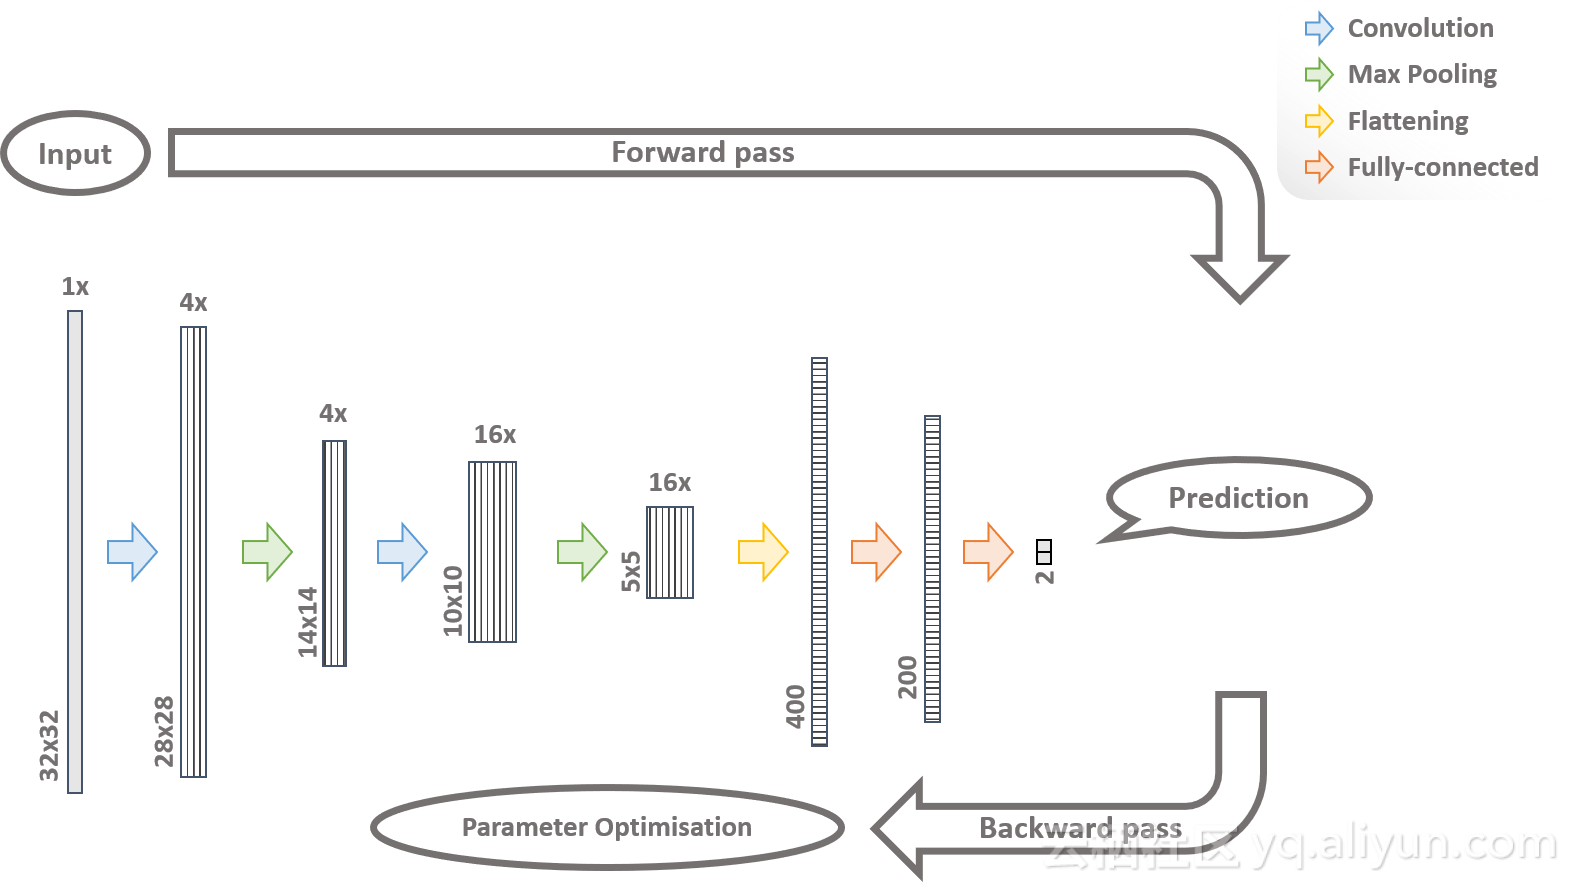
介绍 这篇文章旨在以全面和简洁的方式介绍卷积神经网络(CNN),目标是建立对这些算法的内部工作的直观理解。因此,这项工作对于刚从这个主题开始的非数学、非计算机科学背景的读者来说意味着特别有价值。 我写这篇文章的灵感来自于我正在参加的Fast.ai课程'Code Deeprs For Coders v3',导师Jeremy Howard鼓励我们在博客上讲述我们学到的东西。我在这里分享的知识来自于阅读各种材料和参加不同的课程的成果,目的是在以医学影像的学生研究项目。这些帖子的主要部分取自我最近完成的这篇论文。 在旅程开始之前,必须采取一些预防措施来对卷积神经网络进行透视。机器学习(ML)是计算机科学的子领域,通过具有学习能力的算法解决问题。“学习”通过内部组件的自动优化一个称为参数的权重。适用于ML的问题是两种形式的预测:回归-连续值的预测以及分类-通过类成员预测将对象细分为不同的组。 深度学习(DL)又是ML的子域,通过将具有特定架构的算法(称为神经网络)应用于机器学习问题来区分。这种架构的灵感来自于自然界中的神经网络,并且包括-稍微简化-表示连接不同神经元的计算单元和边缘以及确保信息流动的神经元。其中存在多种不同类型的神经网络:人工神经网络(ANN),专门用于处理表格数据;用于时间序列数据的递归神经网络(RNN),如语音和卷积神经网络(CNN),特别适用于图像数据。有了这些基础知识,我们就可以开始研究后一种类型了。 “解剖”CNN 图1.示例图 图1是网络的循环示例图,它的灵感来自LeNet(LeCun等,1998)第一个CNN架构。虽然CNN之间的特定架构不同,但它们的特征在于都有该示例网络所涵盖的规定元素。该算法旨在解决二元分类问题,例如猫与狗之间的区别。 在这一点上,重要的是该图和紧接着的用于为演练创建框架。因此,不需要完全理解和熟悉所有术语。这些更深入的理解在即将到来的部分中逐渐形成,图1将作为便于读者大致的参考。 从图1中可以看出,网络被细分为前向和后向传递。在前向传递期间,数据通过不同的层(图1:彩色箭头)。由二维阵列表示的输入图像(图1:左空矩形)被提供给给出名称的卷积层。该层识别输入数据上的轮廓和形状,并输出一组特征图(图1:垂直条纹矩形)。最大池层成为卷积层的成功之处,它成功的消除了无关紧要的部分,从而缩小了数据。 此后,数据通过平均池化操作,将图像数据转换为矢量,进入完全连接的层(图1:水平条纹矩形)。这些图层在此向量中标识特定于类的模式,并在此基础上预测输入数据的类成员资格。 到目前为止,还没有学习过,因为这是在向后传递中完成的。首先,通过损失函数量化分类误差,基于损失函数的结果,通过反向传播和梯度下降来优化前述层中的参数。很明显更高的迭代次数,即输入更多训练样本图像,是实现正确分类结果所必需的。完整训练数据集通过模型的点称为epoch。 卷积,线性整流函数和最大池化 图2卷积操作 术语“卷积”描述了特定类型的矩阵计算,其中称为滤波器的特殊目的矩阵应用于输入图像,如图2所示。滤波器(3x3矩阵)通常是较小的矩阵,在卷积运算中,它被放置在图像的子部分上:(图2中的3x3青色图像子集)。每对相应值的元素乘法和随后对所有乘积的进行求和,产生单个输出值。换句话说,图像子集的左上角值与滤波器的左上角值相乘,顶部中间值与相应的顶部中间值相乘,最后所有乘积都相加。之后,滤波器以滑动窗口的方式在输入图像的每个拟合子集上执行上述计算的图像上移动。得到的输出值被收集在称为特征图的输出矩阵中,其中特征图中的输出值的位置(图2:青色顶部中间值)对应于计算中涉及的输入图像子集的位置。 过滤器在图像上的移动方式取决于步幅和填充。一个步骤描述了每个卷积运算将滤波器移动一个像素,从而产生更小的特征图(图2:步幅s=1)。通过向图像的外边界添加零像素来抵消特征图的尺寸减小,称为填充(图2:填充=0)。在卷积操作期间,大多数单独的滤波器应用于输入图像,从而产生每个滤波器的特征图(图2:滤波器和特征图后面的多个silhouttes)。换句话说,卷积层输出与其滤波器计数对应的一叠特征映射。 图3.卷积操作 可以将滤波器视为专用轮廓检测​​器,并且得到的特征图报告检测位置。如果过滤器放置在包含边缘的图像子部件上,它会将其转换为特征图中的高值。换句话说,高特征映射值表示特定位置处的输入图像中的轮廓检测。该过程如图3所示:如果过滤器到达由黄色和绿色框标记的子部分,则识别基础轮廓。因此,特征图也可以被视为图像并相应地可视化。 图4.卷积操作示例结果 图4显示出了对输入图像应用滤波器(图4:底行)以进行垂直或水平边缘检测的结果。 图5.学习后的过滤器,来自Zeiler和Fergus,2014年 过滤器值是权重、是学习的参数。它们在后向传递期间不断优化,同时更多的数据通过网络。通过这种方式,实现了调整过程:过滤器学习识别输入图像中可用的特定元素,并且可以将其可视化为图片本身。而早期图层中的过滤器(图5:左)将学习基本像素,如轮廓,后期图层中的过滤器(图5:右)将连接上游特征,并学习更复杂的构造,例如眼睛甚至脸部( Zeiler和Fergus,2014)。因此,可以小心地将滤波器与视觉皮层神经元的感受野进行比较。 图6.整流线性单元(ReLU) 这个被称为线性整流单元(ReLU)的函数应用于输出特征图(图6)。在令人生畏的名称下隐藏了一个简单的阈值步骤:零以下的所有值都归零。 图7.最大池 阈值化的特征图被移交给最大池化层(图7)。这里,虽然类似于卷积,但实际上发生了更简单的矩阵计算。过滤器再次以滑动窗口方式放置在要素图子集上,并提取子集的最高值,将它们保留在精简输出要素图中。目的是丢弃多余的数据:没有表示任何轮廓检测的值被划掉,而空间信息大致保留,这导致较低的计算成本。 灵感和参考 Jeremy Howard和Fast.ai深入学习编码器; Andrew Ng和deeplearning.ai的神经网络和深度学习; LeCun,Y.,Bottou,L.,Bengio,Y.,Haffner,P.,1998。基于梯度的学习应用于文档识别; Zeiler,MD,Fergus,R.,2014。可视化和理解卷积网络; 本文由 阿里云云栖社区 组织翻译。 文章原标题《a-guided-tour-through-a-convolutional-neural-network》 作者:marvin petersen 译者:虎说八道,审校:。 文章为简译,更为详细的内容,请查看 原文 。

优秀的个人博客,低调大师

Java基础题

List和Set比较,各自的子类比较 对比一:Arraylist与LinkedList的比较 1、ArrayList是实现了基于动态数组的数据结构,因为地址连续,一旦数据存储好了,查询操作效率会比较高(在内存里是连着放的)。 2、因为地址连续, ArrayList要移动数据,所以插入和删除操作效率比较低。 3、LinkedList基于链表的数据结构,地址是任意的,所以在开辟内存空间的时候不需要等一个连续的地址,对于新增和删除操作add和remove,LinedList比较占优势。 4、因为LinkedList要移动指针,所以查询操作性能比较低。 适用场景分析: 当需要对数据进行对此访问的情况下选用ArrayList,当需要对数据进行多次增加删除修改时采用LinkedList。 对比二:ArrayList与Vector的比较 1、Vector的方法都是同步的,是线程安全的,而ArrayList的方法不是,由于线程的同步必然要影响性能。因此,ArrayList的性能比Vector好。 2、当Vector或ArrayList中的元素超过它的初始大小时,Vector会将它的容量翻倍,而ArrayList只增加50%的大小,这样。ArrayList就有利于节约内存空间。 3、大多数情况不使用Vector,因为性能不好,但是它支持线程的同步,即某一时刻只有一个线程能够写Vector,避免多线程同时写而引起的不一致性。 4、Vector可以设置增长因子,而ArrayList不可以。 适用场景分析: 1、Vector是线程同步的,所以它也是线程安全的,而ArrayList是线程异步的,是不安全的。如果不考虑到线程的安全因素,一般用ArrayList效率比较高。 2、如果集合中的元素的数目大于目前集合数组的长度时,在集合中使用数据量比较大的数据,用Vector有一定的优势。 对比三:HashSet与TreeSet的比较 1.TreeSet 是二叉树实现的,Treeset中的数据是自动排好序的,不允许放入null值 。 2.HashSet 是哈希表实现的,HashSet中的数据是无序的,可以放入null,但只能放入一个null,两者中的值都不能重复,就如数据库中唯一约束 。 3.HashSet要求放入的对象必须实现HashCode()方法,放入的对象,是以hashcode码作为标识的,而具有相同内容的String对象,hashcode是一样,所以放入的内容不能重复。但是同一个类的对象可以放入不同的实例。 适用场景分析: HashSet是基于Hash算法实现的,其性能通常都优于TreeSet。我们通常都应该使用HashSet,在我们需要排序的功能时,我们才使用TreeSet。 大体回答如上,类似文章请移驾: List,Set和Map详解及其区别和他们分别适用的场景 HashMap和ConcurrentHashMap的区别 1、HashMap不是线程安全的,而ConcurrentHashMap是线程安全的。 2、ConcurrentHashMap采用锁分段技术,将整个Hash桶进行了分段segment,也就是将这个大的数组分成了几个小的片段segment,而且每个小的片段segment上面都有锁存在,那么在插入元素的时候就需要先找到应该插入到哪一个片段segment,然后再在这个片段上面进行插入,而且这里还需要获取segment锁。 3、ConcurrentHashMap让锁的粒度更精细一些,并发性能更好。 大体回答如上,类似文章请移驾: HashMap详解 至于两者的底层实现,你如果想通过一篇文章就理解了,那就too young了,好好找些博文+看源码去吧。 HashTable和ConcurrentHashMap的区别 它们都可以用于多线程的环境,但是当Hashtable的大小增加到一定的时候,性能会急剧下降,因为迭代时需要被锁定很长的时间。因为ConcurrentHashMap引入了分割(segmentation),不论它变得多么大,仅仅需要锁定map的某个部分,而其它的线程不需要等到迭代完成才能访问map。简而言之,在迭代的过程中,ConcurrentHashMap仅仅锁定map的某个部分,而Hashtable则会锁定整个map。 大体回答如上,类似文章请移驾: HashMap和HashTable到底哪不同? String,StringBuffer和StringBuilder的区别 1、运行速度,或者说是执行速度,在这方面运行速度快慢为:StringBuilder > StringBuffer > String。 2、线程安全上,StringBuilder是线程不安全的,而StringBuffer是线程安全的。 适用场景分析: String:适用于少量的字符串操作的情况 StringBuilder:适用于单线程下在字符缓冲区进行大量操作的情况 StringBuffer:适用多线程下在字符缓冲区进行大量操作的情况 大体回答如上,类似文章请移驾: String、StringBuffer与StringBuilder介绍 wait和sleep的区别 1、sleep()方法是属于Thread类中的,而wait()方法,则是属于Object类中的。 2、sleep()方法导致了程序暂停执行指定的时间,让出cpu给其他线程,但是他的监控状态依然保持着,当指定的时间到了又会自动恢复运行状态。所以在调用sleep()方法的过程中,线程不会释放对象锁。 3、调用wait()方法的时候,线程会放弃对象锁,进入等待此对象的等待锁定池,只有针对此对象调用notify()方法后本线程才进入对象锁定池准备获取对象锁进入运行状态。 转载:阿木侠芋道源码 https://mp.weixin.qq.com/s?__biz=MzUzMTA2NTU2Ng==&mid=2247484399&idx=1&sn=498a9f0151541d7c3bad2ebccb9aaa2f&chksm=fa497c5ecd3ef5488e6c4cddb24df96725b6147b99bbd485aa1f2c0ddb5d5604ef30026fad0d&key=de1ccb5f17d36506c921d919664438825a1235a753e24a11b1ce3a031c7b378e28090b3fdcffd4b73edbaaeb6562b6f280d4bc67a57e6cb626ac516e2eb54ccf7e5aef241c5043778c8fc78b26d0d479&ascene=0&uin=MTE1MDEyOTYwMA%3D%3D&devicetype=iMac+MacBookPro13%2C1+OSX+OSX+10.12.4+build(16E195)&version=12020810&nettype=WIFI&lang=zh_CN&fontScale=100&pass_ticket=8hfanWIrVdtZ6JsIT2zjCOessVLBtelL6wU308J%2FGjCOe3Il9eKp%2BWWn70JiqUCX

优秀的个人博客,低调大师

linux实战题

在配置Apache时,执行了./configure --prefix=/application/apache2.2.17来编译Apache,在make install完成后,需要用户的访问路径更加简单,需要给/application/apache2.2.17目录做一个软链接/application/apache,是得内部人员可以通过/application/apache就可以访问到Apache的安装目录/application/apache2.2.17下的内容,请给出实现命令。(安装时有版本号,后面使用希望能更方便)ln -s/application/apache2.2.17/application/apache 已知Apache服务的访问日志按天记录在服务器本地目录/app/logs下,由于磁盘空间紧张,现要求只能保留最近7天的访问日志,请问如何解决? 方法1:按周循环覆盖。本周天的日志,会覆盖掉上周天的日志。 CustomLog "|/usr/local/sbin/cronolog /app/logs/access_www_%w.log" combined 方法2:用find方法删除,查找七天前的,删掉 find /app/logs/ -type -name "*.log" -mtime +7|xargs rm -f find /app/logs/ -type f-mtime +7 -exec rm { } \; +7表示7天以前 3. 调试系统服务时,希望能实时查看系统日志/var/log/messages的更新,如何实现? tail -f/var/log/messages tail -f = tailf 查看一个文件末尾的变化 4. 打印配置文件nginx.conf内容的行号及内容,改如何实现?nginx和Apache是不同的网页服务软件 查看文件(带行号) cat -n /etc/hosts 或者vi编辑 输入:set nu也可以显示行号 5. 装完系统后,希望让网络文件共享服务NFS,仅在3级别上开机自启动,如何实现? chkconfig --list sshd 查看sshd服务各个运行级别上的启动情况 chkconfig --level 245 sshd off 在245级别上关闭sshd服务 6.linux启动过程 7.linux运行级别 8.linux系统查看中文乱码,请问如何解决乱码问题 字符集:一套文字符号及其编码。GBK 定长 双字节,不是国际标准,支持系统不少。UTF-8 非定长,1-4个字节,广泛支持。 9.打包/etc目录下的文件。打包命令 tar zcvf 创建打包文件并压缩后面目录下的文件 tar zcvf etc.tar.gz /etc 要打包/etc/,打包最好先cd到/etc(/etc/上级目录) 解压命令tar zxvf(tar xf) tar zxvfetc.tar.gz -C /tem/kkk 指定/tem/kkk路径解压 10. 已知需要充文件flyfly.txt文件中过滤出flyfly 和is 字符串 命令:cut -d" " -f3,6 flyfly.txt -f表示第几行 [root@mode mode]# cut -c 6-11,21- flyfly.txt -c表示按字符查询 6到11 21过后的字符 flyfly 731652084 如果内容里加一个逗号,依旧想去除flyfly 731650284 多了个逗号,难度增加。用awk可以实现 11 查看/etc/services文件有多少行 wc 查看问价行数 字节数等 wc -l/etc/services cat -n/etc/services|tali -1 sed awk grep都能实现,我们要注意自己的思维,重在思想。

优秀的个人博客,低调大师

用nifi把hdfs数据导到hive

全景图: 1. ListHDFS & FetchHDFS: ListHDFS: FetchHDFS: 2. EvaluateJsonPath: {"status": {"code":500,"message":"FAILED","detail":"DTU ID not exists"}} 如果json里有数组,需要先用SplitJson分隔: 3. RouteOnContent: 4. ReplaceText: 先在hive里创建一个表: create table tb_test( register string, register_url string ); 1 1 insert into yongli.tb_test(register, register_url)values( '${register}' , '${register_url}' ) 1 1 下面介绍一种效率更高的方式: 1 还是用ReplaceText: 1 1 再用MergeContent: 1 insert into yongli.tb_dtu(dtuid, addr, value, time)values 5. PutHiveQL: 创建一个HiveConnectionPool 设置Database Connection URL, User, Password: 本文转自疯吻IT博客园博客,原文链接:http://www.cnblogs.com/fengwenit/p/5823177.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

阿里云智能语音交互服务导览

阿里云智能语音交互 产品介绍 & 接口文档 阿里云iDST的智能语音交互服务主要有以下几个大类: 语音识别服务ASR :将语音转换成文字的能力快速集成,打造出“能听”的应用。 语音合成服务TTS :将文字转换为声音的能力快速集成,打造出“会说”的应用。 自然语音处理NLU :集语义解析、智能问答、意图识别等功能于一体,让应用具备理解能力。 语音识别服务ASR: **在线 实时 短语音识别:一句话识别 支持流式和非流式的语音识别模式 应用模式: 语音输入法、语音搜索、语音助手等 应用领域:YunOS、支付宝语音搜索、天猫魔盒、手机淘宝、聚划算等 在线 实时 长语音识别:实时长语音识别 应用领域:直播实时转写、会议记录、语音笔记 在线 非实时 长语音文件识别:录音文件识别服务 支持单轨/双轨的wav格式、MP3格式的语音文件识别 目前只支持8k和16k的采样率; 支持普通话识别 应用领域:客服质检领域等 语音合成服务TTS: 在线 实时 语音合成: 语音合成 实时播报 应用领域:钉钉语音电话、菜鸟物流信息播报、新闻播报 在线 实时 语音合成 批量工具: TTS批量合成工具 语音合成测试、批量处理 应用领域:有声小说 智能对话平台 智能对话平台: 智能对话平台 智能对话平台,能够让您在这上面快速搭建自己的对话机器人。 应用领域:智能客服、教育、医疗等 自然语音处理NLU: 在线 语音识别+自然语音处理: 自然语音理解 聊天对话:语音助手就像一个聊天机器人,能和用户直接对话 获取信息:根据用户不同的需要,可以通过语音助手来了解信息,要知天下百事,就问语音助手。 操控手机:能用语音控制手机的操作,打电话、发短信,直接说“打电话给XX”或者“发短信给XX” 非常简便 通过语法、语义、语用的分析,获取自然语言的语义表示。 领域列表:应用、餐厅、休闲娱乐、地图、火车票、飞机票、影院、美食团购、酒店、汽车限行、导航、实时路况、天气、公交站点、地铁站点、热映电影、股票、快递、违章、视频、音乐、优惠券、体育赛事、闹钟、提醒、电视频道

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册