首页 文章 精选 留言 我的

精选列表

搜索[Excel导题],共7114篇文章
优秀的个人博客,低调大师

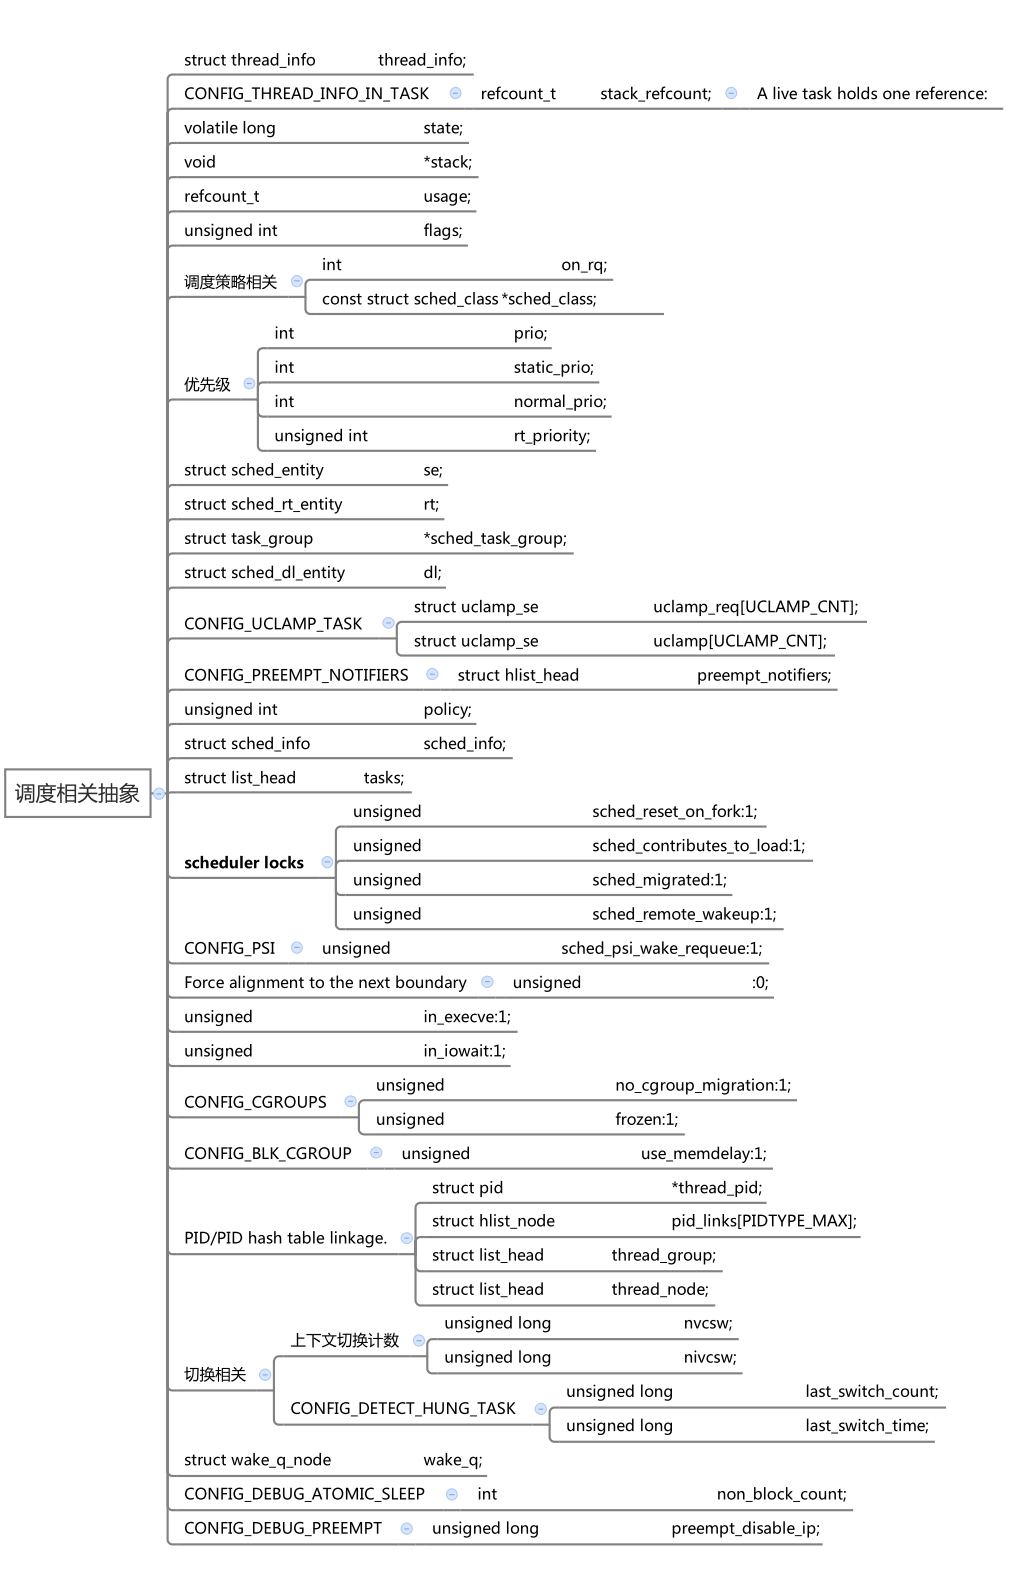
思维导图整理Linux进程描述符

[导读] 内核是怎么工作的,首先要理解进程管理,进程调度,本文开始阅读进程管理部分,首先从进程的抽象描述开始。抽象是软件工程的灵魂,而对于Linux操作系统而言,更是将抽象思想体现的淋漓尽致。本文从抽象建模的角度来对Linux进程描述符进行个人解读,同时也参考了内核文档,一些网络信息。 注:代码基于linux-5.4.31,是一个最新的长期支持稳定版本。 整理匆忙,限于水平,文章中错误一定很多,真诚恳请有这方面擅长的朋友帮忙指出,不甚感激! 进程的基本概念 进程 or 线程 or 任务? 进程:进程是一个正在运行的程序实例,由可执行的目标代码组成,通常从某些硬媒介(如磁盘,闪存等)读取并加载到内存中。 但是,从内核的角度来看,涉及很多相关的工作内容。 操作系统存储和管理有关任何当前正在运行的程序的其他信息:地址空间,内存映射,用于读/写操作的打开文件,进程状态,线程等。 进程是正在执行的计算机程序的实例。它包含程序代码及其当前活动。取决于操作系统(OS),进程可能由同时执行指令的多个执行线程组成。基于进程的多任务处理使您可以在使用文本编辑器的同时运行Java编译器。在单个CPU中采用多个进程时,使用了各种内存上下文之间的上下文切换。每个过程都有其自己的变量的完整集合。 但是,在Linux中,如果不讨论线程(有时称为轻量级进程),进程的抽象是不完整的。 根据定义,线程是流程中的执行上下文或执行流; 因此,每个进程至少包含一个线程。 包含多个执行线程的进程被称为多线程进程。 一个进程中有多个线程可以进行当前编程,并且在多处理器系统上可以实现真正的并行性。 线程:则是某一进程中一路单独运行的程序,也就是说,线程存在于进程之中。一个进程由一个或多个线程构成,各线程共享相同的代码和全局数据,但各有其自己的堆栈。由于堆栈是每个线程一个,所以局部变量对每一线程来说是私有的。由于所有线程共享同样的代码和全局数据,它们比进程更紧密,比单独的进程间更趋向于相互作用,线程间的相互作用更容易些,因为它们本身就有某些供通信用的共享内存:进程的全局数据。 线程是CPU利用率的基本单位,由程序计数器,堆栈和一组寄存器组成。执行线程是由计算机程序的分支分解为两个或多个同时运行的任务而产生的。线程和进程的实现因一个操作系统而异,但在大多数情况下,线程包含在进程内部。多个线程可以存在于同一进程中并共享资源(例如内存),而不同进程则不共享这些资源。同一进程中的线程示例是自动拼写检查和写入时自动保存文件。线程基本上是在相同内存上下文中运行的进程。线程在执行时可能共享相同的数据。线程图,即单线程与多线程 任务:是最抽象的,是一个一般性的术语,指由软件完成的一个活动。一个任务既可以是一个进程,也可以是一个线程。简而言之,它指的是一系列共同达到某一目的的操作。与线程非常相似,不同之处在于它们通常不直接与OS交互。 像线程池一样,任务不会创建自己的OS线程。 一个任务内部可能有一个线程,也可能没有。例如,读取数据并将数据放入内存中。这个任务可以作为一个进程来实现,也可以作为一个线程(或作为一个中断任务)来实现。在RTOS中,一般会将调度的基本单元称为任务,比如freeRTOS,ucos,embOS等,在RTOS中没有进程的概念。 进程 线程 进程是重量级的操作 线程是轻量级操作 每个进程都有自己的内存空间 线程共享它们所属的进程的内存空间 进程间的通信速度很慢,因为进程具有不同的内存地址 线程间通信可能比进程间通信快,因为同一进程的线程与其所属的进程共享内存 进程之间的上下文切换开销大 在同一进程的线程之间进行上下文切换的开销较低 进程不与其他进程共享内存 线程与同一进程的其他线程共享内存 进程间通讯机制: 管道(Pipe)及有名管道(named pipe):管道可用于具有亲缘关系进程间的通信,有名管道克服了管道没有名字的限制,因此,除具有管道所具有的功能外,它还允许无亲缘关系进程间的通信; 信号(Signal):信号是比较复杂的通信方式,用于通知接受进程有某种事件发生,除了用于进程间通信外,进程还可以发送信号给进程本身;linux除了支持Unix早期信号语义函数sigal外,还支持语义符合Posix.1标准的信号函数 sigaction(实际上,该函数是基于BSD的,BSD为了实现可靠信号机制,又能够统一对外接口,用sigaction函数重新实现了signal 函数); 报文(Message)队列(消息队列):消息队列是消息的链接表,包括Posix消息队列system V消息队列。有足够权限的进程可以向队列中添加消息,被赋予读权限的进程则可以读走队列中的消息。消息队列克服了信号承载信息量少,管道只能承载无格式字节流以及缓冲区大小受限等缺点。 共享内存:使得多个进程可以访问同一块内存空间,是最快的可用IPC形式。是针对其他通信机制运行效率较低而设计的。往往与其它通信机制,如信号量结合使用,来达到进程间的同步及互斥。 信号量(semaphore):主要作为进程间以及同一进程不同线程之间的同步手段。 套接字(Socket):更为一般的进程间通信机制,可用于不同机器之间的进程间通信。起初是由Unix系统的BSD分支开发出来的,但现在一般可以移植到其它类Unix系统上:Linux和System V的变种都支持套接字。 线程间的同步机制:为啥线程间没有讨论通讯机制?因为同一进程内的线程共享进程的资源。那么资源共享,则需要处理资源共享时的同步问题。 互斥锁(mutex):通过锁机制实现线程间的同步。同一时刻只允许一个线程执行一个关键部分的代码。这部分代码常称为临界区。哪些可能是临界区呢?简言之,多个线程可能竞争访问的资源。以下一些函数是互斥锁的API函数。 int pthread_mutex_init(pthread_mutex_t *mutex,const pthread_mutex_attr_t *mutexattr); int pthread_mutex_lock(pthread_mutex *mutex); int pthread_mutex_destroy(pthread_mutex *mutex); int pthread_mutex_unlock(pthread_mutex * 全局条件变量(condition variable): 创建一些全局条件变量进行互斥访问控制。以下是其操作的基本接口函数: int pthread_cond_init(pthread_cond_t *cond,pthread_condattr_t *cond_attr); int pthread_cond_wait(pthread_cond_t *cond,pthread_mutex_t *mutex); int pthread_cond_timewait(pthread_cond_t *cond,pthread_mutex *mutex,const timespec *abstime); int pthread_cond_destroy(pthread_cond_t *cond); int pthread_cond_signal(pthread_cond_t *cond); int pthread_cond_broadcast(pthread_cond_t *cond); 信号量(semaphore):如同进程一样,线程也可以通过信号量来实现通信,其基本操作接口API: int sem_init (sem_t *sem , int pshared, unsigned int value); int sem_wait(sem_t *sem); int sem_post(sem_t *sem); int sem_destroy(sem_t *sem); 进程在内核中如何描述? Linux中进程描述在./include/linux/sched.h中定义: struct task_struct { #ifdef CONFIG_THREAD_INFO_IN_TASK /* 必须是首个元素 */ struct thread_info thread_info; #endif /* -1 unrunnable, 0 runnable, >0 stopped: */ volatile long state; /* 前面是与调度密切相关的信息添加在这之前 */ randomized_struct_fields_start void *stack; refcount_t usage; /* Per task flags (PF_*), defined further below: */ unsigned int flags; unsigned int ptrace; ......... }; 该结构非常大,集总抽象了进程的所有信息,包括进程ID,状态,父进程,子进程,同级,处理器寄存器,打开的文件,地址空间等。系统使用循环双向链接列表进行存储 所有过程描述符。 像这样的大型结构肯定会占用大量内存空间。 为每个进程提供较小的内核堆栈大小(可以使用编译时选项进行配置,但默认情况下限制为一页,即对于32位体系结构严格为4KB(一个页),对于64位体系结构严格为8KB(两个页) –内核堆栈不具备增长或收缩),以这种浪费的方式使用资源并不是很方便。 因此,决定在堆栈中放置一个更简单的结构,并带有指向实际task_struct的指针,从而引申出thread_info。 抽象建模思想看进程描述符 进程首先是操作系统对底层进行抽象而提供面向应用接口的一种抽象,而进程描述符则将底层资源、进程本身的调度从以下几个大的方面进行高级别的抽象封装: 应用程序信息抽象 操作系统资源抽象 调度接口抽象 内存管理抽象 账户信息抽象 ...... 通过预读进程描述符,个人将进程描述相关信息大致分为以下几个大类抽象: 涉及thread_info、优先级、栈、上下文切换、调度相关链表等关键数据。 CPU相关抽象 涉及SMP多核处理抽象、CPUSET子系统相关、当前CPU等相关数据抽象。 保护机制抽象 内存管理抽象 缓存相关抽象 信号通信抽象 接口相关抽象 调试跟踪抽象 安全机制抽象 资源管理抽象 杂项信息抽象 最后附上些整理搜集到数据域的一些较详细的介绍。 thread_info 该字段保存特定于处理器的状态信息,并且是进程描述符的关键元素。具体定义在./arch/xxx/include/asm/thread_info.h中。 entry.S需要立即访问此结构的低级任务数据应完全适合一个缓存行,此结构共享主管堆栈页面 如果更改此结构的内容,则还必须更改汇编代码。 因为thread_info包含了当前进程的指针,存储在栈底或栈顶,取决于不同体系架构栈的增长方向,利用thread_info可以快速的访问当前进程的信息,而不必依次遍历。 ARM32的定义: struct thread_info { unsigned long flags; /* low level flags */ int preempt_count; /* 0 => preemptable, <0 => bug */ mm_segment_t addr_limit; /* address limit */ struct task_struct *task; /* main task structure */ __u32 cpu; /* cpu */ __u32 cpu_domain; /* cpu domain */ #ifdef CONFIG_STACKPROTECTOR_PER_TASK unsigned long stack_canary; #endif struct cpu_context_save cpu_context; /* cpu context */ __u32 syscall; /* syscall number */ __u8 used_cp[16]; /* thread used copro */ unsigned long tp_value[2]; /* TLS registers */ #ifdef CONFIG_CRUNCH struct crunch_state crunchstate; #endif union fp_state fpstate __attribute__((aligned(8))); union vfp_state vfpstate; #ifdef CONFIG_ARM_THUMBEE unsigned long thumbee_state; /* ThumbEE Handler Base register */ #endif }; 从书上和网上看到都是前面这样描述的,但是对于ARM64的却没有当前进程指针,这是为何呢?没弄明白,有谁知道告诉下我呗。 struct thread_info { unsigned long flags; /* low level flags */ mm_segment_t addr_limit; /* address limit */ #ifdef CONFIG_ARM64_SW_TTBR0_PAN u64 ttbr0; /* saved TTBR0_EL1 */ #endif union { u64 preempt_count; /* 0 => preemptible, <0 => bug */ struct { #ifdef CONFIG_CPU_BIG_ENDIAN u32 need_resched; u32 count; #else u32 count; u32 need_resched; #endif } preempt; }; }; 利用如下的几种方式,可以获取thread_info信息: static inline struct thread_info *current_thread_info(void) define GET_THREAD_INFO(reg) ... SLUB 分配器 thread_info实现了进程存储对描述符的引用以及如何访问它们。 但是,如果task_struct不是在内核堆栈内部,则task_struct到底位于内存中的什么位置? 为此,Linux提供了一种特殊的内存管理机制,称为SLUB层。SLUB动态生成task_struct,并把thread_info存在栈底或栈顶。 volatile long state 进程状态,可取的进程状态: TASK_RUNNING: 可执行态 TASK_INTERRUPTIBLE:可中断 TASK_UNINTERRUPTIBLE:不可中断 __TASK_STOPPED:停止态 __TASK_TRACED:被其他进程跟踪的进程 为何用volatile修饰。 由于内核经常需要从不同位置更改进程的状态,例如,如果在单个CPU硬件上同时将两个进程设置为RUNNABLE。熟悉单片机编程的朋友一定知道,当在中断函数中需要修改以及在中断外部也会被修改的变量,就会使用到volatile修饰变量。 randomized_struct_fields_start 这是gcc的一个插件(插件来自于Grsecurity),其作用就是这之后的变量不会按照声明顺序存储在内存中,而会按照一定的随机顺序存放,这样做是基于安全考虑,比如应用程序的进程描述符被劫持,如果按顺序存放,则容易篡改其内容。 文章出自微信公众号:嵌入式客栈,更多更新内容请关注,版权所有,严禁商用

优秀的个人博客,低调大师

算法题丨Next Permutation

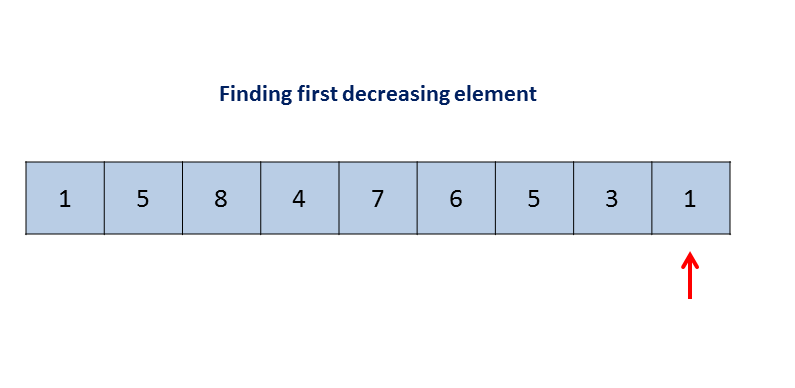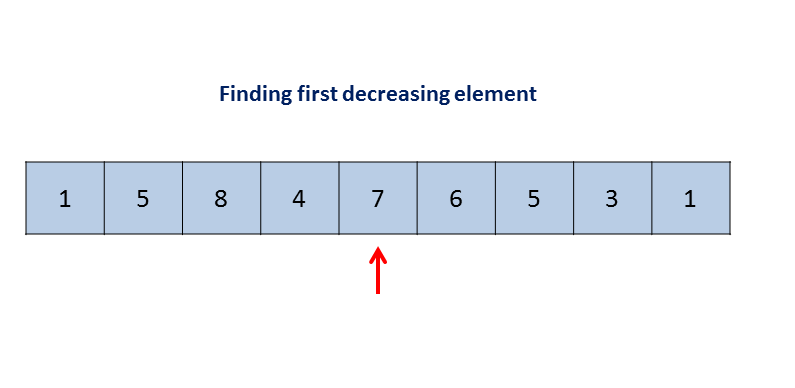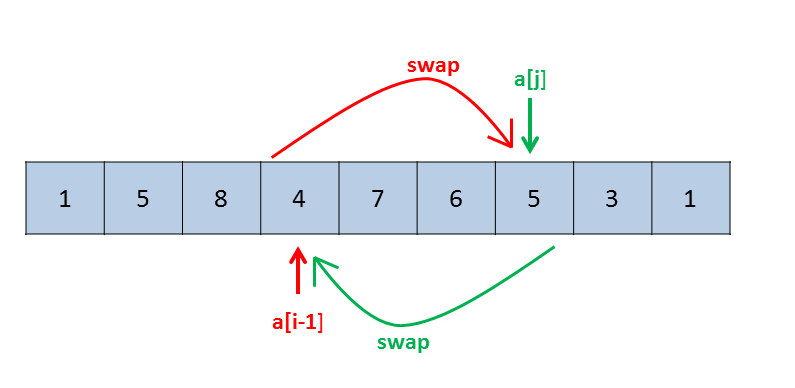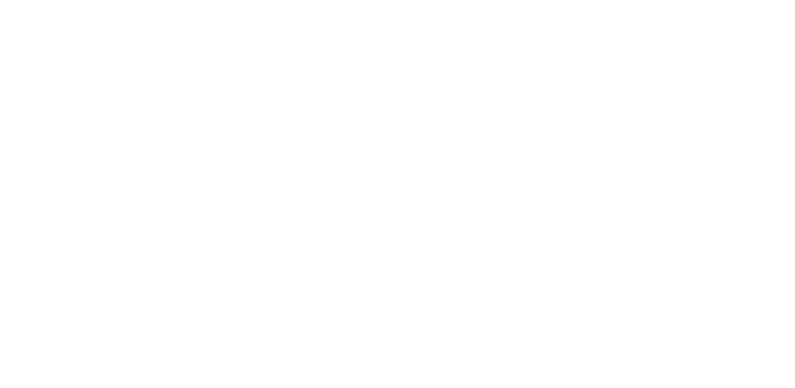
描述 Implement next permutation, which rearranges numbers into the lexicographically next greater permutation of numbers. If such arrangement is not possible, it must rearrange it as the lowest possible order (ie, sorted in ascending order). The replacement must be in-place, do not allocate extra memory. 示例 Here are some examples. Inputs are in the left-hand column and its corresponding outputs are in the right-hand column. 1,2,3 → 1,3,2 3,2,1 → 1,2,3 1,1,5 → 1,5,1 算法分析 难度:中分析:这里需要跟大家介绍一下相关的几个概念: 排列(Arrangement),简单讲是从N个不同元素中取出M个,按照一定顺序排成一列,通常用A(M,N)表示。当M=N时,称为全排列(Permutation)。 例如对于一个集合A={1,2,3},首先获取全排列a1: 1,2,3;然后获取下一个排列a2: 1,3,2; 按此顺序,A的全排列如下,共6种: a1: 1,2,3; a2: 1,3,2; a3: 2,1,3; a4: 2,3,1; a5: 3,1,2; a6: 3,2,1; 从数学角度讲,全排列的个数A(N,N)=(N)*(N-1)*...*2*1=N!,但从编程角度,如何获取所有排列?那么就必须按照某种顺序逐个获得下一个排列,通常按照升序顺序(字典序lexicographically)获得下一个排列。 对于给定的任意一种全排列,如果能求出下一个全排列的情况,那么求得所有全排列情况就容易了,也就是题目要求实现的下一个全排列算法(Next Permutation)。 思路: 设目前有一个集合的一种全排列情况A : 1,5,8,4,7,6,5,3,1,求取下一个排列的步骤如下: /** Tips: next permuation based on the ascending order sort * sketch : * current: 1 5 8 4 7 6 5 3 1 * | | | * find i----+ j +----end * swap i and j : * 1 5 8 5 7 6 4 3 1 * | | | * j----+ i +----end * reverse j+1 to end : * 1 5 8 5 1 3 4 6 7 * | | * find j----+ +----end * */ 具体方法为: a)从后向前查找第一个相邻元素对(i,i+1),并且满足A[i] < A[i+1]。 易知,此时从j到end必然是降序。可以用反证法证明,请自行证明。 b)在[i+1,end)中寻找一个最小的j使其满足A[i]<A[j]。 由于[j,end)是降序的,所以必然存在一个j满足上面条件;并且可以从后向前查找第一个满足A[i]<A[j]关系的j,此时的j必是待找的j。 c)将i与j交换。 此时,i处变成比i大的最小元素,因为下一个全排列必须是与当前排列按照升序排序相邻的排列,故选择最小的元素替代i。 易知,交换后的[j,end)仍然满足降序排序。 d)逆置[j,end) 由于此时[j,end)是降序的,故将其逆置。最终获得下一全排序。 注意:如果在步骤a)找不到符合的相邻元素对,即此时i=begin,则说明当前[begin,end)为一个降序顺序,即无下一个全排列,于是将其逆置成升序。 代码示例(C#) public void NextPermutation(int[] nums) { int i = nums.Length - 2; //末尾向前查找,找到第一个i,使得A[i] < A[i+1] while (i >= 0 && nums[i + 1] <= nums[i]) { i--; } if (i >= 0) { //从i下标向后找第一个j,使得A[i]<A[j] int j = nums.Length - 1; while (j >= 0 && nums[j] <= nums[i]) { j--; } //交换i,j Swap(nums, i, j); } //逆置j之后的元素 Reverse(nums, i + 1, nums.Length); } //逆置排序 private void Reverse(int[] nums, int start, int end) { int i = start, j = end - 1; while (i < j) { Swap(nums, i, j); i++; j--; } } //交换 private void Swap(int[] nums, int i, int j) { int temp = nums[i]; nums[i] = nums[j]; nums[j] = temp; } 复杂度 时间复杂度:O (n). 空间复杂度:O (1). 附录 系列目录索引 代码实现(C#版) 相关算法: Permutation Sequence 文章作者:原子蛋 文章出处:https://www.cnblogs.com/lizzie-xhu/ 个人网站:https://www.lancel0t.cn/ 个人博客:https://blog.lancel0t.cn/ 微信公众号:原子蛋Live+ 扫一扫左侧的二维码(或者长按识别二维码),关注本人微信公共号,获取更多资源。 本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,否则保留追究法律责任的权利。

优秀的个人博客,低调大师

算法题丨Move Zeroes

描述 Given an array nums, write a function to move all 0's to the end of it while maintaining the relative order of the non-zero elements. Note: 1.You must do this in-place without making a copy of the array. 2.Minimize the total number of operations. 示例 Given nums = [0, 1, 0, 3, 12], after calling your function, nums should be [1, 3, 12, 0, 0]. 算法分析 难度:低分析:给定一个数组,将所有为0的元素都移动到数组的末尾,并保持非0的元素排序保持不变。思路:首先,思考满足第1个条件很简单,就是遍历数组,判断当前元素是否为0,如果是0,将0跟当前元素互换一下,遍历完数组就可以了。但是这样处理的话,并不能保证非0元素排序不变,所以,我们放弃这种思路。 那怎么保持非0元素的排序呢?我们考虑记录当前非0的个数索引index,遍历的时候,如果是非0元素,将数组[index]记录该元素,非0的个数索引index加1,下一个非0的就会记录在数组[index+1]中,依次类推,这样其实实现了非0元素顺序保存。最终数组[0,index)即为保持排序的非0元素。剩下的就很简单了,将数组[index]之后的元素全部置0就可以了。 代码示例(C#) public void MoveZeroes(int[] nums) { int index = 0; for (int i = 0; i < nums.Length; ++i) { if (nums[i] != 0) { //非0元素,记录排序 nums[index++] = nums[i]; } } //非0元素之后的元素全置0 for (int i = index; i < nums.Length; ++i) { nums[i] = 0; } } 复杂度 时间复杂度:O (n). 空间复杂度:O (1). 附录 系列目录索引 代码实现(C#版) 相关算法:Remove Element 文章作者:原子蛋 文章出处:https://www.cnblogs.com/lizzie-xhu/ 个人网站:https://www.lancel0t.cn/ 个人博客:https://blog.lancel0t.cn/ 微信公众号:原子蛋Live+ 扫一扫左侧的二维码(或者长按识别二维码),关注本人微信公共号,获取更多资源。 本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,否则保留追究法律责任的权利。

优秀的个人博客,低调大师

算法题丨Remove Element

描述 Given an array and a value, remove all instances of that value in-place and return the new length. Do not allocate extra space for another array, you must do this by modifying the input array in-place with O(1) extra memory. The order of elements can be changed. It doesn't matter what you leave beyond the new length. 示例 Given nums = [3,2,2,3], val = 3, Your function should return length = 2, with the first two elements of nums being 2. 算法分析 难度:低分析:给定数组和指定一个目标值,从数组中移除所有跟目标值相等的元素,返回最终元素的长度,注意不要另外分配内存空间。思路:题目很简单,直接遍历数组元素,判断当前元素是否跟目标值相等,如果不相等,证明当前元素应该留在数组中,有效数组长度自增1,否则为无效元素,因为只需返回有效数组长度,所以不用删除元素,跳过此循环即可。 代码示例(C#) public int RemoveElement(int[] nums, int val) { int i = 0; for (int j = 0; j < nums.Length; j++) { //如果不相等,有效长度自增1 if (nums[j] != val) { nums[i] = nums[j]; i++; } } return i; } 复杂度 时间复杂度:O (n). 空间复杂度:O (1). 附录 系列目录索引 代码实现(C#版) 相关算法:Move Zeroes 文章作者:原子蛋 文章出处:https://www.cnblogs.com/lizzie-xhu/ 个人网站:https://www.lancel0t.cn/ 个人博客:https://blog.lancel0t.cn/ 微信公众号:原子蛋Live+ 扫一扫左侧的二维码(或者长按识别二维码),关注本人微信公共号,获取更多资源。 本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,否则保留追究法律责任的权利。

优秀的个人博客,低调大师

算法题丨Two Sum

描述 Given an array of integers, return indices of the two numbers such that they add up to a specific target. You may assume that each input would have exactly one solution, and you may not use the same element twice. 示例 Given nums = [2, 7, 11, 15], target = 9, Because nums[0] + nums[1] = 2 + 7 = 9, return [0, 1]. 算法分析 难度:低分析:要求给定的数组,查找其中2个元素,满足这2个元素的相加等于给定目标target的值。思路:一般的思路,我们遍历数组元素,假设当前遍历的数组元素x,再次遍历x之后的数组元素,假设当前再次遍历的数组元素y,判断x+y是否满足target,如果满足,则返回x,y下标,否则继续遍历,直至循环结束。考虑这种算法的时间复杂度是O (n²),不是最优的解法。 跟前面几章类似,我们可以考虑用哈希表来存储数据,这里用C#提供的Hashtable来存储下标-对应值(key-value)键值对; 接着遍历数组元素,如果目标值-当前元素值存在当前的Hashtable中,则表明找到了满足条件的2个元素,返回对应的下标; 如果Hashtable没有满足的目标值-当前元素值的元素,将当前元素添加到Hashtable,进入下一轮遍历,直到满足上一条的条件。 代码示例(C#) public int[] TwoSum(int[] nums, int target) { var map = new Hashtable(); ; for (int i = 0; i < nums.Length; i++) { int complement = target - nums[i]; //匹配成功,返回结果 if (map.ContainsKey(complement)) { return new int[] { (int)map[complement], i }; } map.Add(nums[i], i); } return null; } 复杂度 时间复杂度:O (n). 空间复杂度:O (1). 附录 系列目录索引 代码实现(C#版) 相关算法 3Sum 3Sum Closest 4Sum 文章作者:原子蛋 文章出处:https://www.cnblogs.com/lizzie-xhu/ 个人网站:https://www.lancel0t.cn/ 个人博客:https://blog.lancel0t.cn/ 微信公众号:原子蛋Live+ 扫一扫左侧的二维码(或者长按识别二维码),关注本人微信公共号,获取更多资源。 本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,否则保留追究法律责任的权利。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册