首页 文章 精选 留言 我的

精选列表

搜索[自我进化],共7148篇文章
优秀的个人博客,低调大师

【征文】WorkBuddy:让 AI 从"会聊天"进化到"会干活"

一句话结论:WorkBuddy 是腾讯出品的桌面级 AI 智能体工作台,和编程助手 CodeBuddy 共用同一套底座。它把"大模型 + 工具调用 + 本地执行"这套 Agent 能力从写代码搬到了办公场景——你用一句话下达任务,它自己拆解、规划、动手,直接交付可用的报告 PPT 表格,而不是只给你一段建议。本文面向工程同学,重点讲清它的原理、能力边界和优势局限。为了好理解,后面会不断拿大家熟悉的 Claude Code / Cursor 这类 agentic 工具来类比——某种程度上,WorkBuddy 就是"办公版的 Claude Code"。

优秀的个人博客,低调大师

AI 网关这一年,成了 AI 进化的缩影

(一) 回顾即将过去的2025年 是 Qwen、DeepSeek 等国产大模型 迈过拐点的一年 模型以外的工程技术 也正以波澜壮阔之势 加速演进和落地 我们做的 AI 网关 从一个听起来有点新的概念 变成了很多客户落地 AI 时 离不开的基础设施 (二) 记得年初 DeepSeek R1 发布 我们连夜拉会 帮助企业快速 从 OpenAI 切换到国产大模型上 若干天后,Qwen2.5-Max 发布 我们再次快速响应 不是为了抢热点 而是让那些敢于冲的 AI 企业知道 我们在和他们并肩前行 (三) 那会儿我们也在想 光支持模型切换还不够 大模型要真正有用 得能联网、能控权限 能防滥用、能观测效果等 于是我们以插件方式 在业内率先支持联网搜索 帮助大模型获取搜索全文 并把自己服务早期客户的实战经验 一条条梳理出来 总结出 AI 网关的八大典型场景 说实话 当时并没想到 这会成为行业里 第一份完整的 AI 网关能力图谱 但对我们来说 它就是一张用户痛点地图 每一块都是真实业务里打磨出来的 (四) 我们在开源的路上 持续扩展 AI 网关的能力范畴 例如开放了 专为大模型优化的负载均衡算法 首 Token 延迟直接砍掉50% (五) 开源了子项目HiMarket 基于阿里巴巴内部的 AI 开放平台 IdeaLAB 让每一家企业都能拥有 一个专属的 模型、应用和接口的统一管理平台 既方便架构师和运维同学 也方便了 程序员、运营、设计师等 AI 工具的使用者 再加上 AgentScope、AgentRun 就是比较完整的 AI 开发工具链了 (六) MCP 爆火那一阵 很多人被存量 API 转 MCP 这事难住了 我们把低代码的转换工具开源了出来 还搭建了一个 MCP 市场 帮助开发者 快速接入 50 多个高质量 MCP (七) 一个多月后 Higress 入选 MCPMarket MCP Server 全球 Top 100 排行榜 主流的 Agent 开源客户端 都开始接入 Higress 阿里的淘天业务也通过 Higress 把内部 HSF 服务 快速转成 MCP Server 这是继 通义千问、百炼、PAI、高德、饿了么后 再一次被集团客户使用 (八) 这一年 我们也服务了很多外部客户 携程旅游在中国可信云大会分享 他们是如何通过 Higress 解决大模型上线的真实难题 成为众多客户落地 AI 网关的 参考样例 蚂蚁数科 SOFA 团队 基于 Higress 发布了 SOFA Higress 看到自己的开源项目 被金融级的客户深度采用 是我们持续引领 AI 网关的强心剂 还有我们的天使用户 Sealos 在 Reddit 分享 他们从 Nginx Ingress 迁移到 Higress 的经历 以及性能提升近百倍的完整历程 引发国外开发者的好评 Higress,正在被世界看见 (九) 除了服务企业客户 我们始终重视开发者关系 通过多样化的方式和开发者进行互动 比如参与了 KubeCon、浙大太乙平台、中科院开源之夏 我们还在开放原子基金会的支持下 举办了首届 Higress AI 网关开发者挑战赛 11 支队伍进入决赛 围绕 AI Agent、RAG、智能路比拼技术和创意 (十) 但并不是每一个开源项目发展都会非常顺利 11月,我们看到一则非常遗憾的消息 Ingress NGINX 宣布退役 K8s 社区把 Higress 等开源项目 及其云产品 列为官方推荐的替代方案 欣慰之余,我们也在反思 开源无法只靠热情来发电 必须有可持续的商业支撑 才能走得更远 (十一) 我们上线 Higress 企业版的 Serverless 实例 不到十分之一的资源成本 就能搭起一套高可用的 AI 网关 有客户跟我们说 原来 AI 工程化 真的可以这么简单 例如森马 就通过 Higress 企业版 实现了多模型、多 MCP 的统一管理 整体效率提升 30% 快速成为行业里的 AI 落地标杆 (十二) 荣誉来自于积累 在乌镇世界互联网大会获得 开源优秀社区奖 社区贡献者邢国富获得 最具价值贡献者奖 AI 网关基于飞天企业版 在 AI 云产业发展大会上获得 三大创新实践奖项之一 还有 InfoQ 的年度 AI 开源项目 参与起草信通院牵头制定的 AI 网关行业标准 携程、国泰财产保险、君润数智 三家客户案例,入选最佳实践 (十三) 这些来自业内的认可 都会是珍贵的记忆 回头看这一年 没有哪个月是轻松的 但每一步都踩在了实处 写代码、做开源、扛需求、跑客户 我们始终相信 开源 是我们对行业的承诺 商业 是我们对长期主义的负责 未来 让每一个想用 AI 的企业 都能稳稳地迈出第一步 👣 👣 漫画视频制作教程:《👨‍🏫 自制漫画视频|详细教程 ✍️》

优秀的个人博客,低调大师

微软:Windows 11 正在进化为“AI 原生”操作系统

微软近日表示,Windows 11 正在从“具备 AI 功能的系统”迈向真正的 AI 原生(AI-native)操作系统。微软副总裁 Stefan Kinnestrand 称,下一阶段的 Windows 将以安全、可扩展的架构为基础,为“代理式”(agentic)工作方式而生——也就是让系统能理解用户意图并主动执行任务。 在微软的规划中,AI 将成为 Windows 的核心能力,而非额外附加的功能。未来的系统级功能(如开始菜单、任务栏、设置中心)都将深度融合 Copilot 等智能组件。用户可在记事本、画图、Word、PowerPoint 等应用中直接与 AI 协作,形成跨应用的自动化工作流。 比如你有一个 Excel 文件、然后想做图表、再生成 Word,再到 PowerPoint。如果是传统方式你得自己做。但在“代理式”时代,系统可能能理解你流程,让 AI 代理自动执行这一串任务。 微软称,这一转变将与 “Copilot+ PC” 等新硬件共同推进,使 Windows 拥有更强的本地推理与上下文理解能力。官方强调,这不仅是一次功能更新,而是为 AI 时代重新定义操作系统的根本结构。

优秀的个人博客,低调大师

每日一博 | 算法 AB 实验平台进化历程和挑战

1 AB平台简介 AB实验平台这几年在互联网公司得到了越来越广泛的应用,采用AB实验来评估产品和技术迭代效果也成为主流的业务新功能效果评估方式,数据驱动的文化在这几年得到了不少公司的广泛的认同,通过数据和指标来说明产品效果也得到了越来越多的公司的认可和应用。 AB实验在其中就是一种很常见的产品效果数据评估工具,在各大公司的产品迭代过程中也得到了越来越广泛的应用。 2 1.0时代 从无到有 在AB实验刚开始的时候,需要解决的问题很简单: 通过某种用户流量分组方式,将不同的用户划分到不同的流量组,在不同的流量组通过控制变量的方式应用不同的产品策略,随后观察两个组的产品效果差别。 这种非常朴素的实验思路就是最基本的AB实验的分流,需要注意的是在过程中需要保证控制变量和稳定的流量比例。 2.1 一个基本AB实验实例 一个基本的AB实验需要有以下要素: 1.实验目标和实验假设 a.实验目标决定到达到什么样的效果实验才算成功,举个例子,我希望付款率提升5%,这就是目标,其中的实验指标是付款率,做实验之前一定要有实验目标,没有实验目标没办法确定实验是否成功,实验目标包含指标和变化幅度两个要素。 b.实验假设是猜想通过控制哪些因素来达到实验目标,比如我们假设付款按钮的颜色会影响用户的付款意愿进而影响付款率,那这里的实验假设就是付款按钮颜色会影响用户付款意愿。 2.实验对象 (实验对象是可以用来应用策略的用户或者请求或者其他对象) a.实验对象并不是仅仅指用户,用户的每一次请求也可以单独做实验,甚至每一次用户请求的每一个曝光位置都可以看做一个实验流量,这个对象取决于具体的业务。 3.对照组和实验组 (AB实验的核心要求是控制变量做效果对照,所以至少有一个或多个对照组策略和实验组策略) a.对照组:一般是没有任何策略的组,代表了现在的实验效果。 b.实验组:一般是应用了新策略的组,代表了新策略的实验效果。 c.统计功效:在进行实验组和对照组的流量分配的时候要注意,因为我们的AB实验是从整体用户中取一部分进行实验,然后采用统计学方式进行效果评估,所以无论是实验组还是对照组样本量要满足最基本的统计功效,后续的实验才有意义,而统计功效无法在实验之后计算,需要我们在实验进行之前就做充足的调研。 2.2 算法的AB1.0主要功能 1.通过控制变量的方式进行AB分流实验,并通过离线的模拟分流规则提供用户实验分组信息,使得数据分析可以计算实验的指标报表。 2.打通基本的工程实验链路,可以让算法通过实验配置自主的控制实验流量和实验策略。 2.3 1.0 AB实验的策略生效流程 在早期的实验过程有以下链路: 1.通过配置中心配置约定好的AB实验配置信息,线上的服务通过配置中心的变更信息,实时变更实验配置,从下次分流开始应用新的分流策略,同时记录实验日志。 2.报表计算方式,将实验配置信息同步到ODPS,第二天用前一天的实验配置对昨天的用户进行重新分流计算,获得昨天的用户实验分流信息(之所以这样是因为实验变更是以天为单位,离线计算可以比较方面的支撑后续的实验分析)。 算法和普通业务的AB分流由于业务特性原因有较多的需求不同的地方,针对两者区别我们也进行了一些特殊的算法实验优化设计。具体如下: 早期的AB实验设计解决了基本的实验分流问题也提供了一套配套的实验指标和实验置信度计算方案,支撑了早期的简单业务可以通过AB实验的方式比较科学的观测算法模型效果。 3 2.0 时代 从有到全,支持复杂业务功能 3.1 新的业务需求 随着公司业务发展和各个系统迭代优化,用户对于基础的AB实验系统开始衍生出了一些新的,更细化更复杂的业务需求,用户也希望AB系统可以帮助支撑更高效的实验迭代。 1.流量饥渴,更丰富的流量需求:在1.0版本的AB实验中已经解决了基本的实验分流和配置的问题,但是由于一个场景中总用户流量有限,可能会有多种业务实验同时进行,实际实验运行时需要在同时运行的实验数量和每个实验的流量大小之间做一个取舍,业务高速发展时期经常会有用户希望提高同时运行的实验数量,同时保证每个实验有充足的流量,于是我们扩展了原来的实验流量分流模型设计,采用分层分域的正交的业务实验划分方式来支撑上述的流量需求。 2.更实时更准确的实验报表:在早期的实验中通过第二天的配置重算的方式得到前一天的用户实验分组数据,这种方法可以支撑非常巨大的用户和实验数量,但是时效性上比较难以保证。随着业务快速迭代,算法的实时实验效果监控的需求也逐渐增加,离线的实验报表计算反馈需要等到至少1天后才能观测,实验反馈周期太长。于是我们调整了实验分流和报表的计算链路,采用实时实验日志埋点通过flink等实时计算平台实时计算实验效果,这种做法可以实时捕捉实验流量的变化情况,对于验证实验分流效果有较大的效率提升。 3.复杂实验形式:联合实,多集群实验, 指定用户实验需求:随着算法工程链路的规范化,业务链路中的一些业务层之间开始进行联合调优实验,催生出了多参数跨层联合实验的需求,需要在分层实验的基础上支持联合参数的生效机制,这在一般的分层实验设计中是很难支撑的。随着工程链路稳定性项目的进展,大部分业务同时都具有多个不同集群,此时又需要AB系统也可以针对不同集群提供同场景不同实验配置的功能支撑。还有随着精细化运营的展开,越来越多的实验只针对更精准的特定用户群才能生效,这给原来的实验分流和实验分析都带来了不小的需求和挑战。 3.2 更大更通用的分流模型 为了满足更丰富的流量分配需求,我们设计了一套比较灵活通用的实验分流模型, 这套模型经过多个公司的业务验证,可以确保在未来较长的一段时间内,充分支撑我们所有业务的个各种AB实验分流需求。同时根据我们自己的业务发展需求,也支持了条件层,自定义分流机制等为更复杂业务设计的一些分流机制。 多层正交的实验流量模型 上述的分流模型将一个场景流量分为层和域两种嵌套结构,通过层来隔离不同业务配置,通过域来隔离不同用户群。用户在该模型进行分流的过程采用从外到内,从上到下的逐步命中,每一次进入一个业务层都会触发一次选桶逻辑,命中桶以后,读取桶上的配置,如果桶内还有层配置继续依次命中层,触发内部的选桶逻辑。 该模型可以支持如下主要特点: 1.分层分域,互相嵌套的流量设计,支持业务域分层的正交流量,每一层都是一个单独的业务,解决流量饥渴问题,同时支持自由的流量域划分,流量域和流量层可以互相嵌套,实现极其灵活的流量划分方式。 2.每一个流量层采用hash模板+流量槽,层内实验通过圈槽的形式决定实验在该层的流量比例,允许算法用户自定义实验分流的规则,支持根据用户的用户特征信息进行分流,同时支持灵活的跨层流量对齐机制。这种方式可以实现极为灵活的分流方式,支持各种对象和分流方式(比如用户分流,请求分流,设备分流,作者分流,按地区分流等)。 3.支持白名单,允许用户绕开分流机制,指定用户的固定实验链路,用于在线上进行特殊用户的实验验证。 4.支持条件层,允许符合某种条件的用户单独进行特定实验,比如只针对新用户进行的实验。 从该模型上线以来,2年多的时间内已经完美支撑了算法300多个场景的AB流量分配需求,经过了充分的业务验证,从分流层面解决了许多有特殊需求的分流业务遇到的问题。 具体层中的分流规则如下: 每一个流量层根据层中的分流配置信息和用户信息计算命中的流量槽,然后根据流量槽命中圈选了流量槽的实验,实验通过拥有的流量槽数量决定实验流量比例。 3.3标准实验的工程链路 通过AB实验的后台改造,我们重新思考并调整了整个实验链路的工程设计,在新的工程设计中,相对于上一个版本主要有以下几个方面需要改进: 1.采用实验分流日志而不是离线的实验配置来计算用户的实验分组信息。 a.实验日志可以捕获每一个时刻的用户的实验分流情况,可以较为敏感的捕捉到实验变更的情况。 b.实验日志可观测性强,用户配置完实验以后可以立刻通过日志观测实验的命中情况。 c.可以在日志中附加更多的实验环境相关信息,做更丰富的实验分析,可以简化离线的实验分组计算逻辑。 2.线上应用增加实验信息的具体埋点信息, 埋点分为两部分: a.一部分透传给客户端,其中包含用户命中的实验信息,称之为ACM埋点,客户端在用户进行点击曝光等操作时上报信息中回传服务端下发的ACM字段,这样我们可以通过神策上报的行为日志,清楚的知道每个实验曝光几次,被点击几次,可以及时得到实验的线上表现,这部分行为日志还可以帮助我们实时的计算实验策略效果报表。 b.另一部分作为应用的后台日志记录,记录了每一次请求中用户命中的实验相关信息,用于计算实验分组信息。 3.设计了AB实验的后台操作管理界面,不用再通过手动修改配置中心的配置来进行实验配置。并将实验发布,实验修改,实验配置回滚等功能做成具体的按钮功能,极大地提高了用户的实验操作使用体验。 4.拆分了实验参数和代码执行链路,抽象出了AB参数和代码链路运行方案两种概念,将AB变成一个弱依赖,降低实验参数配置错误对线上业务的影响。 Ps: 为什么要同时采用两种实验信息反馈链路,原因是第一种ACM上报的用户实验信息依赖于用户上报,如果用户遇到应用crash或者延迟上报,或者网络情况突然不好,我们没办法获得未上报的这部分信息,第二种很明显,没办法知道发放下来的带有实验信息的内容的后续反馈情况。两种链路都没办法完全的覆盖全部用户,只有互相配合才能完整的覆盖全量用户,至于为什么采用离线日志来做实验报表,ACM来做实时报表纯粹是工程效率方面的考虑。 ACM通用埋点标准 为了解决实验的实时效果观测问题, 我们需要想办法将后台的实验命中标识信息传递给客户端。考虑到其他业务场景也会有类似的埋点需求,为了埋点通用性考虑,我们规划了一个算法的埋点标准,主要想简化算法埋点流程和对算法的埋点信息进行统一的治理。 ACM埋点主要是通过算法与客户端约定一个固定的埋点内容字段ACM,后端算法在开发时候,通过提供的SDK工具,将需要埋点的信息和内容通过SDK采用特定的规范形成一串可识别的字符串内容,客户端同学对ACM这个约定好的字段进行事件(曝光,点击等)上报,后端就可以根据上报的用户行为日志通过实时计算工具快速的获得某个实验的后续用户反馈信息。 ACM埋点规范例子: 版本.业务域.内容资源类型.资源位.实验.自定义值 版本:标记本条ACM的遵循的规范版本,不同版本具有不同的解析规则,方便udf解析。 业务域:业务系统代称,尽量简短,比如 搜索srh。 内容资源类型:内容类型或资源,比如 user_10098, cspu_1020,spu_771等。 资源位:广告位,榜单位。 实验:资源本次采用的AB实验策略,多个实验用-隔开。 自定义值: 允许应用方进行扩展的字段,比如 chan_latest-pos_3 代表channel为latest,pos为3。 特殊要求:自定义字段中不能出现 ".","-","_"等字段,其他部分无此要求。 埋点示例: acm: 1.srh.spu_1009.sh.kka3b.10089-1929-100.channel_hot-position_2 acm: 2.srh.spu:1009.sh.kka3b.10089;1929;100.channel:hot;position:2 埋点场景: request维度,覆盖所有搜索和推荐场景 埋点动作: request维度 下面是一个带有acm信息的后端返回示例: { "code": 200, "data": { "total": 3730, "start": 0, "hits": 10, "searchId": "161113175619737242413163", "searchTime": 0.024447, "items":[ { "spuId":"xxx", "acm": "1.ms.prd-10092.v1ss.exp-1.kka.12", } ], "facet":[], "cache": false }, "requestId": "f2ca7c08693acd54", "cost": 0, "time": 1611131759 } 3.4 实时的实验指标监控 实时实验指标的计算流程 1.后台服务日志实验分流信息需要透传给客户端; 2.客户端用户行为及时上报; 3.行为日志被flink等实时计算平台及时处理; 4.制定明确且可计算的实时指标规范。 有了上面四个基础流程,就可以计算实时的实验反馈指标,但是要注意实时的指标计算往往只能反映一段时间的实验趋势变化,在部分复杂指标上很难实现精确的实验指标计算,所以一般用来观察实验指标变化趋势,不作为最终决策依据。 实时数据处理链路 打通了数据链路并且在用户的行为日志中包含了ACM埋点以后,算法就可以基于行为日志,通过flink等工具实时算计算用户的各种指标信息。 具体的监控链路流程如下图绿色链路所示: 具体实时实验监控效果 最终可以达到秒级的实验效果反馈,极大的加快了算法对实验策略的反馈效率,具体效果如下图,用户可以自己选择关注的实验信息对比不同实验在同一时间区间内的指标变化情况。可以非常迅速的得到线上的新实验的效果反馈信息,极大地缩短了算法对实验指标的策略调整反馈周期。 4 3.0 时代 从全到优,提升用户体验和实验效率 2.0 时代主要是从各种机制和功能方面尽量满足业务需要,业务功能满足以后,我们进行了业务与扩展,将算法的推荐业务场景也囊括进来,推荐业务接入以后,虽然在基本功能上也可以满足需求,但是推荐和搜索的业务特点还是有点不同,于是我们针对实验平台的实验操作用户体验和稳定性方面进行了较多的优化。 4.1 实验操作易用性的建设 业务场景铺开以后,使用的业务团队和人员也变得更为复杂,于是我们在针对特定场景的使用和业务人员使用习惯方面做了不少的功能改进和优化。根据我们收集的算法人员的参数配置,白名单配置,流量调整等功能使用痛点,我们进行了针对性的优化。 实验参数的易用性工具 实验参数配置是AB实验的最主要的功能,为了优化用户体验在实验参数使用方面的体验,我们收集了一些常见的用户在使用参数配置时候经常遇到的问题,并针对性做了功能和体验的优化。 场景1:随着业务发展,算法配置的业务层越来越多,由于约定的参数规范是同一层的可配置实验参数应该一致,同一个实验参数配置也应该出现在同一层,但是随着层数增多和部分参数使用不规范,估算某个实验参数的实际生效流量就变得很困难(参数有后覆盖前面的规则)。有可能出现你给a实验配置了 10%流量的 recallSize = 20 但是后续该参数被别人的同名参数覆盖导致实际参数生效流量不符合预期的情况。 参数流量着色分析 使用参数流量的着色分析可以清楚的知道某个实验参数都在哪些实验中有配置,这些实验如果同属于一个业务层则无流量覆盖,如果有些实验不属于同一个业务层,有可能出现参数覆盖的情况。流量着色就是通过程序,一键计算某个参数最终的流量结果分布情况,可以方便的看到某个参数最终的线上真实流量比例。 包含某参数配置的所有实验查询: 某参数的实际生效流量分布 场景2:实验参数越来越复杂,同一个参数往往有多个不同的版本需要同时观测实验的效果,这种时候可能由于时间久远或者实验变更频繁,或者参数过多,很多时候在进行实验观测和调整的时候需要确认实验中的参数配置信息,特地为这些需要对比参数的场景制作了便捷的实验参数对比的功能。 实验参数对比:可以比较清晰的对比同一个实验参数在同一层其他实验中分别是什么值,可以大幅度提高实验流量调整期间需要进行的实验信息核对工作效率。 实验布局的操作和展示优化 为了满足灵活的实验流量划分,我们设计了一套通用的实验流量模型,但是该流量模型的可视化方面一直是一个不小的难题,最基本的我们希望能直观的展示层与层,层与桶(用户域)之间的布局结构和用户流量的命中顺序关系。 我们进行了一些更能直观体现实验布局的探索,目前我们采用一个标准的树状结构来表示个实验分流模型。实验模型中的业务层和用户桶我们都会用图标进行区分,由于层桶结构可以嵌套多次,我们通过将结构关系进行拆分,将桶页面主视图和层页面主视图进行了分别设计。 层页面主视图:可以便捷的观察到当前层内的不同流量桶和子桶内的其他子业务层,主要是用于寻找自己的业务层位于某一个用户桶内,观察某些桶的流量比例和参数等。子业务层内的流量桶信息不予显示。 桶页面主视图:桶页面的主视图可以同时观察到该桶内的各个子业务层和业务层内部的子实验桶信息,可以用来直观的对照具体的实验命中链路从上往下核对实验命中路径。 界面显示如下(测试数据): 通过将层桶结构进行主要的功能拆分,可以在复杂场景的视图布局清晰度和易用性上达到一个比较好的平衡。 实验信息的完善 算法的实验在进行实验分析报表的时候往往需要对比多个指标综合观察实验效果,之前都是算法人员跟分析人工对齐某个实验什么时候开始什么时候结束,需要观察哪些指标等信息。为了方便后续自动化的进行实验效果分析,我们完善了实验的实验时长,核心指标,辅助指标等功能,方便用户进行实验的分析信息管理,后续通过自动化功能依赖这种信息可以实现实验报表指标流程的自动化计算。 4.2 服务稳定性的改进 1.动态白名单功能优化 白名单操作是一个使用频次较高的AB实验操作功能, 实验参数配置好以后往往需要通过白名单来小范围的验证策略效果。但是早期的白名单设计时候考虑到白名单会影响用户的分流,所以白名单信息和实验布局配置信息一起被用户感知,这也导致每一次的白名单变更都需要重新发布实验配置,给线上的配置稳定性造成了威胁。 解决方案: 基于白名单的设计和生效流程,我们尝试通过流程和配置格式改进优化,使得白名单的配置可以实时生效同时又不影响原来的实验配置,如下图所示: 动态白名单功能改动相当于将白名单的配置信息独立出来,在白名单有修改的时候独立加载,同时不触发配置信息本身的更新。但是考虑到兼容性问题,我们每次配置信息改动也会额外触发白名单的重新更新,描述配置更新相当于一次全量更新,配置和白名单都会更新。白名单更新相当于实时只更新新增的白名单信息。 2.并发操作Ark发布实验的优化 由于AB实验的配置下发方式是通过Ark配置中心提供的配置通知功能实现的,目前后台操作Ark进行配置发布的时候是通过http接口进行了,使用接口同时操作同一个Ark配置集的时候,大量操作容易产生并发,并发问题会导致Ark操作直接失败,这种情况极大地阻碍了实验配置发布过程的流畅性。 解决的办法有如下方案: 经过仔细评估和方案选择,我们决定方案2,3,4同步进行,最终完全解决了实验操作时候的并发问题。 4.3 实验效果分析的探索和优化 在过去2年的AB实验的实践和改进过程中,我们也十分注重实验效果方面的分析和问题归因,根据遇到的实际实验分析问题和情况,总结了一部分常见的实验分析相关经验文档,其中涉及实验流程标准化,实验指标选取,实验指标的统计功效分析,实验指标的p值和置信度分析,以及常见的实验中遇到的问题等。 常见的实验分析问题 我们总结了一些实验效果分析中常见的问题和可能的原因,可以帮助排查AB实验中遇到的常见问题。具体如下表: 实验中的辛普森悖论 辛普森悖论(英语:Simpson's paradox),是概率和统计中的一种现象,其中趋势出现在几组数据中,但当这些组被合并后趋势消失或反转。这个结果在社会科学和医学科学统计中经常遇到,当频率数据被不恰当地给出因果解释时尤其成问题。当干扰变量和因果关系在统计建模中得到适当处理时,这个悖论就可以得到解决。辛普森悖论已被用来说明统计误用可能产生的误导性结果。 落实到我们的AB实验中就是 如果一个实验A在一个较长的实验周期内每天指标都高于实验B,实验A的整体周期指标未必高于实验B。 本图想说明一个问题,如果一个实验周期跨很多天,每天观测实验效果的情况下,如果某个实验组用户数量(或者某个指标)长期每天稳定高于另一个实验组,不能说明分流不均匀。 第一天 因为刚刚重新分流,所以所有用户对实验来说都是新用户,a组 505万,b组 495万 ,1%的正常误差。 第二天 因为老用户要保持分流一致,组内用户=新用户+次留老用户, 新用户会重新分组,老用户沿用之前的分组,此时有两种情况: 情况1 (合理) 老用户按原来的分流, 新用户分流误差 1%。 情况2 (不合理) 老用户按原来的分流,新用户必须要保证误差 2%,才能逆转第二天的分组误差情况,但是此种情况下第二天的新老用户比例会严重不均匀,同时没办法保持分流策略的一致性,理论上不可能实现。 5 未来改进的方向 未来我们会希望借助数仓部门的AB平台的指标计算和可视化通用能力,希望可以逐步增强AB平台的数据可视化能力,在实验分流情况的可视化分析,实验的用户特征的分布可视化分析,实验的指标变化原因排查等方面与分析同学一起合作,提升AB实验的指标报表问题分析效率。 在AB实验平台本身的实验信息操作和性能,稳定性方面我们也有一些新的想法,希望将来可以打通开发环境,测试环境,生产环境,实现一个界面可以跨环境操作,降低算法同学使用不同环境AB需要在不同系统切换的问题,同时在将来还希望借助sidecard的形式增强AB实验的分流能力和分流稳定性,兼顾分流性能和分流平台功能迭代效率。 *文 / 开阳 本文属得物技术原创,更多精彩文章请看:得物技术官网 未经得物技术许可严禁转载,否则依法追究法律责任!
优秀的个人博客,低调大师

分布式事务的华丽进化 | 京东物流技术团队

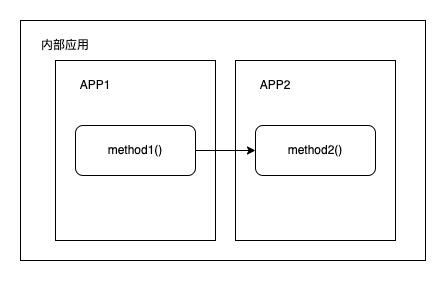
说到分布式事务,大家并不陌生。在实际工作中,用得比较多的还是柔性分布式事务,今天主要把在工作中运用到的几种柔性分布式事务的场景及实现方式做一个简单介绍,也可以看做是柔性分布式事务的一个演进过程。 一、调用方保证 这种方式适合业务内自己使用,当方法内的任务一个逻辑发生异常时,整个方法都异常,由调用方进行重试。该方法不太适合于外部系统的交互,否则,这就是把自己的命运交到别人的手里,是比较危险的做法。 在上述调用示意图中,内部应用APP1和APP2之间,APP1的方法method1调用APP2里的method2方法,method2里有分布式事务逻辑,当分布式事务中的逻辑异常后,method2方法都失败或抛出异常,method1收到返回值是失败或异常后,都需要重试调用method2,确保method2执行成功。method2本身则需要确保逻辑中已经成功的逻辑再次被调用时处理也要正确。 @DistributedTransaction method2(){ //write DB //send msg //RPC invoke } 该方法不建议大家在工作中使用,仅从保证分布式事务的正确性看是可以使用的,但从Java的规范上看,这种方法属于用异常控制流程,并不是很规范。同时,如果分布式事务中的逻辑是写本地库,发消息或RPC远程调用,则一般不建议把事务和发消息或RPC调用放到事务方法内,避免大事务。 二、定时任务扫描业务表 该场景主要运用于流量小、业务场景较单一的场景,或是业务处于验证阶段,为了快速验证业务是否有价值阶段,直接用业务表来做任务表,避免建多张表。在用本地事务写完业务表后,事务正常提交即可。通过一个定时任务查询业务表的增量数据,在定时任务中处理其他业务逻辑。  @Transaction void method1(){ //write DB1 Bueiness Table //other business Logic } void method2(){ //查询DB1中的Bueiness Table,时间从上次任务开始执行的时间开始 //处理自身的业务逻辑 } 该方案一般作为过渡方案,最终业务量上来后,会升级到下面的本地任务表的方案。 三、本地任务表 这是比较典型的分布式事务的解决方案,即:在业务库中,同步建一个任务表。业务表和任务表在本地事务中同时写入,再由一个定时任务定时查询任务表,把任务读取到后根据业务逻辑要求进行处理。 业务表和任务表在一个数据库中,由数据库的一个事务控制器实现事务。在应用中,另起一个定时任务,由定时任务去查询任务表,把任务表中新进的任务抓取后执行该定时任务需要执行的业务逻辑。 @Transaction void method1(){ //write DB1 Bueiness Table //write DB1 Task Table } void method2(){ //定时查询DB1中的Task Table //任务抓取后执行自身的业务逻辑 } 该方案实际运用时,定时任务的稳定性需要我们特别关注,定时任务的稳定性决定我们该方案的可用性。建议把定时任务的执行情况监控起来,确保有问题时能第一时间处理,避免影响业务。 四、组件抽取 目前,对于Java语言开发的团队,其框架大部分都以Spring为主,故可基于SpringEvent异步事件做一个小的组件封装。主要思路为在事务中,发送Event异步事件,当异步事件发送成功则事务提交结束,当异步事件发送失败则异步任务落本地数据库后事务再提交结束,然后通过定时任务从任务表中抓取任务执行。 该方案以SpringEvent异步事件为主做了一个组件,当SpringEvent异步事件发送异常后,降级到本地任务表,确保异步任务的可靠性。即使没有封装为组件,在实际工作中,还是比较推荐大家使用该方案。  @Transaction void method1(){ //业务数据写入DB成功 try{ //发送SpringEvent事件 }catch(Exception ex){ //写入本地任务表 } } void method2(){ //接收事件或定时任务的数据执行业务逻辑 } 当然,如果项目中没有使用Spring框架也没问题,有了上述的思想,可以根据自身使用的框架情况进行调整。正所谓“只要思想不滑坡,办法总比困难多”。 作者:京东物流 廖宗雄 来源:京东云开发者社区 自猿其说Tech 转载请注明出处

优秀的个人博客,低调大师

中通大数据平台在大促中的进化

一年一度的双十一又双叒叕来了,给技术人最好的礼物就是大促技术指南! 而经过这些年的发展,大促早已不仅仅局限于电商行业,现在各行各业其实都会采用类似方式做运营活动,汽车界有 818,电商有 618 、11.11 等等,各种各样的大促场景,对包括数据库在内的基础软件提出了很多新挑战,同时也积累了诸多最佳实践。 在双十一到来前,PingCAP 与汽车之家、易车网、京东、中通等用户展开一系列深入探讨,希望为大家揭秘逐年飙升的销量背后隐藏着什么样的技术难题?用什么技术架构才能平稳地扛住流量洪峰? 点击此处观看完整采访参与互动,有机会获得 TiDB 定制周边! 大促中,大家买买买后最期盼的事情就是收到快递。成立于 2002 年的中通快递,是一家以快递为主体,以国际、快运、云仓、商业、冷链、金融、智能、星联、传媒为辅的综合物流服务品牌。2020年,中通完成业务量 170 亿件,市场占有份额达到 20.4%。 整个快递的生命周期、转运周期可以用五个字来概括——收、发、到、派、签: 而支撑整个快递生命周期的平台就是中通大数据平台。中通从离线到实时的数据兼容再到数仓,有着一套比较完善的大数据平台体系。ETL 建模也会依托该大数据平台,最终通过大数据平台对外提供数据应用的支持以及基于离线 OLAP 分析的支持,整个数据建模的频率可以支持到半小时级别。在这个完善的大数据平台基础上,中通开始更多地思考如何增强实时多维分析能力。 中通与 TiDB 的结缘是在 2017 年调研分库分表场景时开始的。当时中通分库分表达到 16000 张表,业务上已经无法再继续扩展下去。2018 年底,中通开始测试 TiDB 2.0,主要关注的是大数据量的存储,以及分析性能。2019 年年初,中通上线了生产应用的支持。目前生产上稳定的版本是 TiDB 3.0.14 。2020 年底,中通开始测试 TiFlash,目标期望有两点:一是提高时效,二是降低硬件使用情况。 1.0 时代——满足需求 1.0 是满足需求的时代,业务需求主要包含以下几点: 业务发展非常快,数据量非常大,每笔订单更新有 5-6 次,操作有峰值; 做过调研的技术方案,很难支撑多维分析的需求; 业务方对数据分析的周期要求比较长; 对分析时效要求也很高; 单机性能瓶颈,包括单点故障、风险高,这些也是在业务上不能忍受的; 除此之外,QPS 也很高,应用要求毫秒级响应。 技术需求方面,中通需要打通多个业务场景 + 多个业务指标;需要强一致的分布式事务,在原有业务模式下切换的代价很小;还需要对整个分析计算工程化,下线原来的存储过程;能够支持高并发的读写、更新;能够支持在线的维护,保证单点的故障对业务是没有影响;同时,还要与现有的大数据技术生态紧密结合在一起,做到分钟级的统计分析;最后是中通一直在探索的,即要建立 100 + 列以上的大宽表,基于这张宽表,要做到多维度的查询分析。 目前 TiDB 在中通应用的一些落地场景 时效系统应用场景 其中,时效系统是中通原有的一套系统,现在已经进行了重构。这套系统原来的存储和计算主要是依赖 Oracle 设计的,计算依赖存储过程。这套架构也比较简单,一边是消息的接入,一边是负载。 随着业务体量的增长,这一套架构的性能已经逐渐出现瓶颈。在对这套系统进行架构升级时,中通把整个存储迁移到 TiDB 上,整个计算迁移到 TiSpark。消息接入依赖于 Spark Link,通过消息队列最终到 TiDB。TiSpark 会提供分钟级的一些计算,轻度汇总会到 Hive,中度汇总会到 MySQL。基于 Hive,通过 Presto 对外提供应用的服务。相较原来关系型数据库的分表,无论是 OLTP 还是 OLAP 都极大地降低了开发的工作量,并且和现有的大数据生态技术栈相融合。 1.0 时代中通的数据库系统架构 迁移带来的收益有很多:第一是容量的增长,原来的数据中心有三倍的富余,已有系统数据存储周期增加到三倍以上;第二,在可扩展性方面,支持在线横向扩展,运维可以随时上下计算和存储节点,应用的感知很小;第三,满足了高性能的 OLTP 业务需求,查询性能虽略有降低的,但是符合业务需求;第四,数据库单点压力没有了,OLTP 和 OLAP 实现“分离”,互不干扰;第五,支持了更多维度的分析需求;第六,整体架构看起来比原来更清晰,可维护性增强,系统的可扩展性也增强了许多。 大宽表应用场景 另一个场景是中通一直在做的宽表的建设与摸索。其实之前中通测过很多系统,包括 Hbase、Kudu。Kudu 的写入性能还是很不错的,但是其社区活跃度在国内一般。同时,中通使用 impala 作为 OLAP 查询引擎,但主流使用的是 Presto,兼容性有待考虑,也很难满足所有业务场景需求。此外,中通的业务特性要求系统能够快速地计算分析几十亿的数据,并能同步到离线的集群里与 T+1 数据做融合,还要能提供给数据产品和数据服务直连拉取明细数据。最后是海量数据的处理,中通有很多消息源的接入,需要针对每一票进行全链路路由和时效的预测,定位到每一票的转运环节,数据量很大,对时效的要求也很高。 中通的大宽表建设 目前,宽表已经建设有 150 多个字段。数据来源于 10 多个 Topic 。主要的项目接入是通过 Flink 和 Spark ,打通了各个业务产生的数据,汇总到 TiDB 形成业务宽表。额外一部分,依赖于 TiSpark,从业务宽表输出分析结果,同步 3 亿条数据到 Hive。此外,还提供了十分钟级别的实时数据建设和离线 T+1 的整合。 中通目前的集群规模在使用过程中,中通也遇到了一些问题,总结起来就是量变引起质变。第一,热点问题。索引热点在目前情况下表现较为突出,因为中通的业务量规模十分大,操作存在高峰,在大时候该热点问题表现特别明显。第二,内存碎片化问题。在之前的低版本里,在稳定运行了一段时间后,因为有业务特性和大量的更新和删除,导致内存碎片化比较严重,这个在反馈给了 TiDB 后,已经修复了这个问题。第三,着重介绍一个参数——TiFlash 读取 index 的参数。通过测试,当读取的数据量/总数据量大于 1/10 的时候,建议该参数关闭。为什么这么说?因为 Test 数可能会变少,但是单位 Test 过渡的时间会变长。 运维监控 使用 TiDB 后会发现它的监控指标特别丰富,使用了流行的 Prometheus + Grafana ,多而全。之前,中通因为在支持线上业务的同时,还会有开发人员来查数据,遇到了 SQL 把 TiKV Server 拉挂的情况。针对这个问题以及监控的问题,中通进行了一些开发定制。第一,兼容线上特殊帐号的慢 SQL,会自动杀掉,并通知到相应的应用负责人。第二,中通开发了支持 Spark SQL 去查询 TiDB 的工具,并发和安全性在开发的过程中得到一些保障。此外,中通还会把一些额外的核心指标,接入到自研的监控体系。核心的告警会电话通知到相关的值班人员。 去年双十一期间,中通订单量突破 8.2 亿,整个业务规模突破 7.6 亿,双十一当天的 QPS 峰值达到 35 万 +。整个双十一期间,数据的更新体量达到了数千亿级别,整个集群上运行的 TiSpark 任务是 100 多个,支持的在线应用 7 个。整个分析的时效在 10 分钟以下达到了 98% ,整个分析的数据周期达到 7-15 天。 2.0 时代——HTAP 提升 2.0 时代的主要特点是 HTAP 的提升。中通应用 HTAP 主要来自于业务方需求的升级: 基于业务方的需求,中通在 2.0 时代进行了一次架构再升级。首先,**引入了 TiFlash 和 TiCDC **。这带来的收益其实是增强了时效,部分分析进入了分钟级级别,降低了 Spark 集群资源的使用情况。 2.0 时代中通的数据系统架构 下图是 TiSpark 和 TiFlash 的对比,中通线上有两套集群,一个基于 3.0,一个基于 5.0。简单地对比一下 3.0 和 5.0 的情况:3.0 主要的分析是基于 TiSpark,5.0 是基于 TiFlash 。目前 3.0 集群有 137 个物理节点, 5.0 有 97 个节点。整个运行的周期中,3.0 是 5 - 15 分钟,基于 5.0 的 TiFlash 已经做到 1-2 分钟,整个 TiKV 的负载降低是比较明显的。另外, 在 3.0 上 Spark 的资源大概有 60 台,而在 5.0 上,线上的加上在测试的,大概有 10 台就足够了。 在整个测试周期中,生产的集群是 3.0 ,4.0 的测试周期其实是非常短的。在测试时,业务的场景有一些维表 Join 的情况,当时 4.0 对 MPP 没有支持,对一些函数的支持可能也不是那么完善,测试结果不是很理想。对 HTAP 的测试主要是在 5.0 阶段,5.0 已经支持 MPP ,对函数的支持也越来越丰富。目前中通生产上应用的版本是 TiDB 5.1 。 上图右侧是整个 5.0 集群在 618 期间的负载情况。在刚刚结束的 618 中, 5.0 上线的一些任务已经在支持 618 移动端的大促看板。中通有 6 个核心的指标是基于 TiFlash 计算的。集群响应整体平稳,报表达到了分钟级以内的时效。整体的数据体量在 40 亿 - 50 亿 +,报表分析数据达到 10 亿 +。 3.0 时代——展望未来 第一是监控。提到监控,由于中通的集群比较大,所以面临的问题和遇到的问题可能会多一点。大集群的实例多,指标加载慢,排查问题的效率得不到保障。监控虽然很全,但是出了问题的时候无法快速定位到问题; 第二是解决执行计划偶发不准的问题。这种偶发不准有时候会影响到一些线上的负载相互影响,拉高集群的指标,导致业务相互影响。 第三是实现自动清理。目前中通数据的清理是通过自己写成 SQL 清理的,但是过期数据清理比较麻烦。希望之后可以支持旧数据自动 TTL。 第四,随着 5.0 列式存储的引入,中通计划把 TiSpark 的任务逐渐全部切到 TiFlash 上面,期望达成提高时效和降低硬件成本的目标。 大促对于企业而言,除了支持业务创新,也是一次对自身技术架构的大练兵和全链路演练。通过大促的极致考验,企业的 IT 架构、组织流程、人才技能都获得了大幅提升。而在大促中的经验和思考,也会加速企业日常的业务创新节奏,提升技术驱动的创新效率,打造增长新引擎。

优秀的个人博客,低调大师

Swift 5.3的进化:语法、标准库、调试能力大幅提升

Swift 从 5.0 的 ABI 稳定到5.1 的模块稳定,Swift 终于不是《Swift 入门到重学》了。本次 WWDC2020,Swift 5.3 正式发布,Swift 依旧朝着安全、高效、易读的方向持续发力,不断的在改进语法,增强代码的表达能力和易用性。因为 Swift 的模块稳定,SPM 现在也支持了二进制模块的分发,逐渐完善的社区生态也在不断拓宽 Swift 可以涉足的领域,而不仅仅是在 Apple 平台之上。 Swift 发展里程碑 下图展示了 WWDC2020 中 Swift 相关内容的脑图,希望可以帮助大家快速了解。 语言环境的完善和拓展 一门完善编程语言有三个最基本的要素:语法、标准库、调试能力。语法设计决定了语言的编程范式;标准库决定了语言的基本能力;调试能力决定了开发者的体验和语言的稳定性。 苹果在 Swift 的迭代过程中不断的强化这几点,我们可以来看看 Swift 又得到了哪些提升。 语法特性 Swift 的语法设计核心还是 OOP,但是这不妨碍 Swift 的语法在支持 POP 和函数式编程甚至 DSL 得到的强化。Swift 也因为 SDL 特性的加入,开始逐渐的适应声明式编程的方向发展,比如后文提到的 @main 等等。 ▐ Multiple trailing closure 这个改进解决了当函数最后几个参数为闭包的情况下,导致的括号嵌套的问题,API 更加简洁也更加具有表达性。SwiftUI 利用这个语言特性,也变得更加简洁易懂。 ▐ KeyPath as Function KeyPath<Target, Value> --隐式转换--> (Target) -> Value 现在 KeyPath 可以当做函数来使用了。这个语法糖解决的问题当我们使用类似 map 一样的函数时,只需要取出对应数据模型中的某一个属性,为此我们不得不写类似 map { $0.property } 的代码,有了这个语法糖,事情就可以简化成了 map(.property)。 ▐ Type-based program entry point (@main) 引入了新的修饰符 @main,可以标记在带有 public static func main() 函数实现的所有类型,无论 main 函数时从拓展来得还是继承来的。添加这个特性的意义在与维持声明式的语义,将声明式语义进行到底。YES! ▐ Increase availability of implicit self in closures 以前我们写逃逸闭包时如果捕获了 self,我们需要在跟 self 有关的地方写上 self. 以警示我们注意循环引用。 如果在闭包的捕获列表中显示声明捕获 self,在闭包中对 self 相关的访问可以省略。如果是在不可变的函数中访问,self 可以直接省略(为了 SwiftUI)。 其实这一点改进有用但是覆盖面并不是很广,因为在实际的应用中,我们都是尽量先弱引用 self 后再强引用 self,来保证 self 的可访问性。在如下场景就得不到此项优化: requestDataAsync { [weak self] in guard let self = self else {return} self.property // ✅ property // ❎ 需要显式声明 self } ▐ Multi-pattern catch clauses 这种写法可以自动实现错误匹配,进入到对应的错误处理中,而不需要使用 switch,增强语言的可读性。 ▐ Enum enhancements 自动符合 Comparable 编译器现在可以自动为你生成 Comparable 的相关方法,实现 Enum 的比较。 Enum case 可以用来适配 protocol 这个特性看引用场景需要吧,官方给了一个比较好的例子。具体相关内容可以参考 SE-0280。 ▐ DSL 新增对 switch 的支持 现在可以在 SwiftUI 等 Swift DSL 中使用 switch-case 来进行模式匹配,之前只有对 if-else 的支持。某种程度上也是为 SwiftUI 而生的能力。 标准库 其实这里说标准库是广义的标准库,其中包括了开发者随语言分发的标准库,如标准 I/O 库等,运行时环境,编译环境,一方库等等。苹果今年在这部分下足了功夫,因为标准库、各种各样的一方三方库才是展现一门语言能力的地方,否则再好的语法也不会有人用,语言终究还是工具,能解决问题才是关键。 Swift 5.3 在代码尺寸和运行时都有不小的提升。Swift Package Manager(SPM)增加对二进制和资源的支持,深度集成 Xcode,亲儿子的优势逐渐显示了出来。Swift 本来设计的初衷本来就是一门 General Purpose 的语言,今年苹果正式宣布 Swift 支持了 Apple platform,Ubuntu/CentOS/Amazon Linux,不久的将来也会支持 Windows,正式成为一门优秀的跨平台语言。 ▐ 标准库更新 Float16 的支持,具有更好的运算性能 Apple Archive 一种功能类似 zip 的压缩文件,苹果就是用这种格式来更新系统 Swift System 对操作系统基础 API 的包装,让 API 更健壮易用 OSLog 推荐使用的 logging system 从这些更新可以看出,苹果对 Swift 的底层操作非常关心,Swift System 的出现让使用 Swift 底层开发者脱离 OS C API 的折磨,获得更一致更健壮的代码体验。 ▐ 新的一方库 Numerics 解决 Swift 中数学计算相关问题 ArgumentParser 为 Swift 编写脚本提供了强力的工具 StandardLibraryPreview 预览标准库中的新功能 ▐ Code Size and Runtime 在使用 UIKit 的情况下,Swift 4.1 时生成的二进制代码已经从 OC 的两倍还多,但是在 Swift 5.3 中,这个差距已经缩小到小于 1.5 倍了。也就是说之前大量使用 Swift app 会自动得到二进制大小的优化,而对于担忧 Swift 会造成包大小问题的 App,现在已经不算是很大的问题了。因为只需要付出可以接受的代价,就能获得 Swift 带来的安全性能和开发体验。 如果 App 使用了纯 SwiftUI,二进制代码甚至可以缩小 43% 之多。可见苹果优化 Swift 的功底之深,而且这些优化,只需要从新编译一次即可享受,何乐而不为。 因为 Swift 更紧凑的值类型,运行时的内存,分配相同的对象所需的空间自然比 OC 更小。Swift 5.3 相较 5.1,运行时的必要额外信息存储要少非常多,甚至做到了比 OC 还要少,大大减小了 Swift 的运行时内存。这对低内存的设备是非常有帮助的,同时,更少的系统内存意味着更多的用户内存。而这一切,只需要重新编译即可。 Swift 底层的不断优化也让其成为一门高效的语言,降低运行时的要求,就可以提升其应用的场景。 ▐ Swift Package Manager SPM 作为 Swift 生态非常重要的一环,也迎来了更新。 SPM 支持二进制包分发 SPM 支持了资源的打包 这两点更新已经表明了 SPM 的能力已经足够完善了。目前具有一定规模 App 的内部模块都开始使用 Cocoapods 做二进制组件化的集成,这样可以明确对代码解耦,提高打包的效率。在这样的背景之下,SPM 对这两点关键特性的支持已经可以覆盖住大型 App 需求了,而且 SPM 不单单只跟 Swift 玩,C Family 它都可以支持。 在 SPM 与 Cocoapods 的对比中,亲儿子 SPM 跟 Xcode 深入整合,Xcode 可以直接打开编辑 swift package,Xcode 因为 SPM 设计了对应的操作界面,降低了开发和使用的门槛。成熟的工具链也让联调 Swift Package 轻而易举。而 Cocoapods 由社区维护,每一次 Xcode 更新其响应也不算很及时,在针对大型 App 时因为 Podfile 与 podspec 的分离导致了许多不一致,使用 ruby 还有一定的门槛。 现在也许是拥抱 SPM 的好时机。 ▐ 跨平台 现在官方支持的操作系统列表如下: Apple platform Ubuntu 16.04, 18.04, 20.04 CentOS 8 Amazon Linux 2 Windows (coming soon) 真正做到的跨平台,并且 Swift 官方支持 AWS Lambda。AWS Lambda Runtime 已经开源,支持了 AWS 的 FaaS 编程,进一步的拓宽了 Swift 涉足的领域。 调试能力(开发者体验) 调试和开发者体验也是一门语言非常重要的一环,因为没有人会写出没有错误的代码,检查错误的能力和工具对一门语言来说十分重要。苹果也十分注重这一方面,在开发者体验上下足了功夫。 ▐ 更加智能的诊断信息 刚开始使用 Swift 的开发者可能经常会对 Xcode 的报错信息不知所云,在引入 SwiftUI 后,这个问题尤为明显。笔者第一次编写 SwiftUI 时,只要 body 中某个地方出错,报出来的错误都是不正确的,只能通过肉眼检查和推断才能明白自己的错误,十分痛苦。 现在苹果重制了诊断能力,现在 Swift 的错误诊断比之前准确了许多,错误没有乱报并且错误提示也变得很好理解,特别是 SwiftUI,很容易知道错在哪了。在 Swift 中,编译通过就是对正确性的一个很好的证明,除非你用不安全的方式让编译器闭嘴。 ▐ 自动补全 经过强化的类型推断系统,也增强了 Swift 的代码补全能力。这个估计升级到 Xcode 12 就可以顺利体验了。同时代码缩进能力也得到了加强。 ▐ LLDB 积极拥抱 Swift 看了这么多年 WWDC,每次看时大家应该都有一种心态 只支持最新版本,我们才支持 iOS X (低版本),这些东西跟我没关系 感觉 Swift 真香,但是现实只让我使用 OC(叹口气) 什么语言不是用,OC 这么多年肯定够用了 ▐ 危机 然而如果不及时做出改变,保持能用就行,在前进的路上,背上的担子就会越来越重。当发现快走不动时,又回过头来看 WWDC,就会发现,原来解决方案很久以前就已经给出来了,只是当时不觉得是个问题,这不支持那不合适,但是现在想拿出来使用的时候,面对背上那一团团的乱码,却又束手无策。 做出改变是痛苦的,但是当以前觉得痒就挠挠就解决了的事情,逐渐变成现在的痛点时,要做出改变也许会更痛苦。 Swift 的出现就是为了替代并且超越 Objective-C 的语言,虽然说苹果因为历史原因还在使用 OC,但是种种迹象表明,苹果正在做积极的工作,逐渐通过 Swift 降低 OC 在整个系统的比重。 社区也在积极的转变,许多著名的第三方库都已经迁移至 Swift,OC 版本已经不再维护,例如 Lottie 已经在 Swift 版本上出现了 OC 版本不存在的特性,并且 OC 版本不再维护。这种现象慢慢会越来越多。 ▐ 改变 我们也在积极探索 Swift 在手淘的落地,取得了 Swift 5.1 能模块在手淘中正确运行起来的阶段性成就。 现在时机已经成熟,语言特性,SPM,工具链,标准库都已经足够强大,是时候做出改变了。 Swift 虽然看起来很简单,但其实它是一种下限低,上限高的语言,集团内部的 Swift 环境,需要大家来一起维护。我们未来也要加强 Swift 语言相关的培训,让开发者真正理解 Swift,上手 Swift,成为一名 Swifter 而不是 OSwifter。 参考: SwiftUI 背后那些事儿 WWDC20 What's new in Swift WWDC19 What's new in Swift WWDC18 What's new in Swift WWDC17 What's new in Swift WWDC16 What's new in Swift WWDC20 Swift packages: Resources and localization WWDC20 What's new in SwiftUI Swift 5 时代的机遇与挑战到底在哪里? Swift Evolution 手淘客户端团队 淘宝基础平台团队正在进行社招招聘,岗位有iOS Android客户端开发工程师、欢迎 转岗推荐。简历投递:junzhan.yzw@taobao.com 关注「淘系技术」微信公众号,一个有温度有内容的技术社区~

优秀的个人博客,低调大师

云与开源:技术食物链的进化史

编者注:本文原作者Charles Fitzgerald是西雅图地区的天使投资人,主要关注企业平台和战略投资,曾在微软和VMware工作过。 Marc Andresseesssen的“软件正在吞噬世界”已经催生了一个完整的技术食物链,包括“开源正在吞噬软件”、“云正在吞噬开源”以及“多重云正在吞噬云”等一系列说法。 并不是每个人都对自己在食物链中的地位感到满意。谁不想成为顶级掠食者或关键物种呢?特别是,有一些人反对上面的顺位排序,坚持开源实际上是在“吞噬”云。 我不明白“开源吞噬云”的说法,但还是会经常听到。不可否认,“吞噬”并不是一个很精确的术语,它允许有不同的解释。尽管如此,试图理解开源的倡导者们是如何在这场竞赛中获得如此高分数的,很快就变得模糊不清,甚至形而上了。当然,云可能占据了大部分的收入,但这对开源来说是一场道德上的胜利。 公共云正在采用开源软件,并将其作为一种服务来操作。可以说,公共云是由开源提供动力的,但云似乎仍然是消耗资源的一方。从经济的角度来看,云似乎比围绕特定项目建立的公司更适合开源业务。如果你仔细观察,你会发现开源可以被看作是对这个星球上一些最大和最富有的公司非常慷慨的慈善捐赠。 我们的食物链二分法源于本质上完全不同的开源和云。开源爱好者和公司关注的是软件的特定部分以及制作方法。公共云则超越了软件,并在一个非常广阔的生存层面上运作,软件是服务的重要组成部分,而不是唯一的组成部分。 公共云将跨洋电缆、混凝土板、可靠的电子流、数百万个CPU、数兆字节的磁盘、大量的软件运行时间、合法的地位和提供24*7操作及支持的一大群人结合在一起,将所有的这些都集成到一个可交易的实用程序中,任何人只要有信用卡就可以访问该实用程序。软件开发人员常常没有意识到,云服务不仅仅是软件的一个实例,操作本身就是它的能力。 云价值的很大一部分与底层软件是正交的:它允许客户摆脱低价值/高复杂度的操作(这一属性同样适用于神圣的开源软件和有害的私有软件)。开源软件常常是偏向于复杂的,有时甚至是非常复杂的,这使得打包和交付服务变得更有吸引力。 来自云端的出乎意料的不对称竞争让开源公司感到困惑,他们必须正视这样一个事实:比任何人都更了解自己的软件竞争优势,并不是他们所希望的那道不可逾越的护城河。醒来后发现你的产品现在只是更广泛产品的一个特征而已,这一点也不好玩,但这就是软件的现状。声称开源正在吞噬云,就像那些声称自己在吞噬星巴克的咖啡豆农一样:它有意(或只是出于错觉)忽视了消费者购买的绝大多数东西。 关于开源赢得食物链竞赛的争论似乎可以归结为一种不断重复的断言:“在一天结束的时候,胜利是不可避免的,因为开源不证自明的光荣属性!” 我写这篇文章的灵感来自于一位年轻的IBM员工,他勇敢地为雇主夸张的论点辩护,即混合云“改变了云市场的一切”。没有多少IBM员工会去为他们的公司加油,尤其是在不上班的时候,所以我不得不为他的努力鼓掌(不管这项任务多么无望)。但他的论点只是简单地重复“开源将吞噬云”的咒语,本质上是一种对开源固有的正义感和优越性的信仰,而不考虑更广泛的客户问题、各自的价值主张、在价值链中的地位或潜在的经济学。 因此,在这篇文章中,我收集了来自四面八方的恶意攻击(并期望——实际上甚至是希望——同样地激怒开源纯粹主义者、开源但并非真正开源的改革者,以及本文中提到的每一家公司),以便更好地理解这场争论。(透露一下:在私有许可软件的鼎盛时期,我曾在微软工作,所以可能根本无法理解开源软件最基本的规则)。 AWS与开源 目前的争论主要集中在亚马逊和一些开源公司,它们就像是热带草原上的瞪羚,尤其是Elastic和MongoDB。尽管AWS一直以“客户告诉我们…”作为其消息传递的首选,但它正在提供自己的服务,这些服务是基于(Elastic)或与MongoDB兼容的流行开源项目,从而与那些同这些项目相关的相对成功的商业开源公司竞争。在Elastic的例子中,AWS慷慨地创建了一个新的开源发行版,其中的特性是Elastic作为专有软件保留下来的。 这些“猎物”的回应既有大胆挑衅的博客文章,也有疯狂的许可证工程,以阻碍AWS使用其表面上开源软件的能力。其他的一些公司,像Cockroach Labs和Redis Labs,也纷纷推出了自己的新许可证。这重新引发了一场关于开源存在主义和哲学的争论:它是关于言论自由的,还是也包括对关键项目贡献者的免费护城河的权利?最后,开源的权威人士似乎并不赞同“开放,除非是那些与我们竞争的人”的方法。 而且,让开源软件发挥作用的不只是AWS。谷歌和微软都有许多建立在开源软件上的服务(并且正在开源他们自己的一些软件)。他们的一些努力只是为了与AWS形成对比,AWS承担了新的开源反基督者的角色(这让前反基督者微软感到很有趣,同时,微软正通过与开源公司Databricks和Hashicorp等建立深度合作伙伴关系来创建服务)。 云的出现也迫使许多开源公司更加认真地对待自己的服务。Elastic和MongoDB都有运行在大型公共云上的成功云服务,在这些云服务中,他们有机会畅所欲言:即没有人比他们更擅长操作自己的软件。甚至有人认为,AWS的加入为这些公司的服务带来了好处。 但最根本的问题是,客户是更喜欢创建特定软件的OSS公司提供的“更好”个性化服务,还是来自公共云的“足够好”版本?公共云可能没有编写原始软件,但它们可以在全球范围内提供服务,再配备一个屏幕来管理你所有的服务。为所有服务提供一张账单,与补充服务更深入、更容易地进行集成,以及更低的客户获取成本。正如我之前所提出的,问题是“商业开源公司是否能够承受和/或值得承受公共云巨大的、具有破坏性的引力”。关于这个话题有很多严肃的讨论,有些人的文章甚至比我的还长。 “完全取代” A16Z的Peter Levine认为我们在这个话题上有点过度紧张了:“我还认为,我们过度关注了来自公共云供应商的威胁。尽管这些供应商可能会托管开源项目,但迄今为止,据我所知,没有一家开源公司完全被云提供商取代。” “完全取代”是一种委婉的说法,它终于引导我参与了这场讨论。与其关注目前在多重云的大草原上被追捕猎物的可能命运,继续与David Attenborough进行讨论,不如让我们看看记分牌,看看在一些开源和云之间的游戏中发生了什么。其他的游戏还没有结束,但是结果看起来越来越清晰。 事实上,一些最大的OSS公司最近已经失去了销售动力、相关性、估值和/或独立性。从它们身上咬痕的大小和形状判断,它看起来就像是新的顶端捕食者——云的杰作。 OSS的支持者赢得了这场食物链竞赛,他们需要对这些公司前景黯淡的原因做出解释,尤其是在软件公司繁荣时期以及股市创下历史新高之际。他们还没有被“完全取代”,但是值得关注的是Hadoop公司Pivotal的困境,以及直到最近才成为最大开源公司的Red Hat。 Hadoop工业综合体 不久前,Hadoop和它的商业旗手还是一件大事。Cloudera、HortonWorks和MapR总共筹集了超过15亿美元的资本(分别为10亿美元、2.48亿美元和2.8亿美元)。这包括英特尔在Cloudera上惊人的二次投资。 Cloudera和Hortonworks都通过IPO筹集了3.35亿美元。然而,令人失望的财务业绩迫使两家公司搬到了一起。今年早些时候,两家公司悄无声息地合并了,而它们的创始人则悄悄离开了公司。两家公司的总市值从宣布合并时的52亿美元降至本文撰写时的25亿美元左右。尽管如此,仍然是私人的MapR后来还是以废品的价格卖给了惠普,后者吹嘘说他们得到了“一个非常好的交易”。 Hadoop留下了一堆客户的眼泪,他们花了大笔资金建造“数据湖”,却难以成功部署和管理这些数据湖,更不用说在这些湖中寻找业务回报了。与此同时,大数据业务已经转向云计算,因为云计算既便宜又方便。正如Mathew Lodge所说:“具有讽刺意味的是,Cloudera没有云时代。” 另一种假设(也就是说,这并不是云吞噬开源):Hadoop只是被夸大了。有人声称它将取代各种专注的、成熟的数据库技术,这是TAM的一个好故事,但Hadoop最终证明是所有数据交易的集大成者,却一事无成。把你有价值的数据扔到湖里也不是一个很好的比喻。Hadoop给我们的教训是,我们应该再次警惕那些关于“下一个大事件”的宏大技术承诺。 Pivotal Pivotal是Pivotal Labs、SpringSource和Greenplum等收购项目的混合体,加上VMware对这些业务的投资,以及从头开始打造Cloud Foundry。Pivotal在2018年4月的IPO中以每股15美元的价格融资5.55亿美元。它的峰值是74亿美元,随后由于“销售执行”问题和“复杂的技术前景”而错过了几个季度。当它收到VMware的收购要约时,其市值已经跌至22.5亿美元。具有讽刺意味的是,Cloud Foundry最初是作为一种服务来设计的,但却发现自己陷入了向那些必须部署和管理自己服务的企业销售产品的复杂境地。相反,他们选择了云。 另一种假设是:Pivotal被“Dockernetes”也就是容器吞噬掉了,这当然也是开源的,所以云与公司短暂的上市没有任何关系。这种另类的故事得到了高级管理层的认可,他们本应销售云服务,却忙于销售咨询服务。 Red Hat 最后是Red Hat,它是开放源码的长期代言人。Red Hat是最初的(并且是很长一段时间)唯一的证据,证明你可以在开源网站上建立一个很好的业务,也是最成功的。然而,这一“模范”已经离开了我们的讨论,很快将成为IBM中间件博物馆的另一个注脚。为什么?因为云。 Red Hat拥有数十亿的收入、丰厚的利润、数十亿的银行存款、两位数的增长率,直到去年,Red Hat还拥有一只高速增长股票的估值。IBM斥资340亿美元收购了Red Hat,这是有史以来最大的软件收购案。我认为IBM支付过高(Watson可能帮助设定了价格),但Red Hat管理层和股东拿走了IBM的钱,这一事实突显出他们不相信该公司在云时代有未来。他们乐于以六个月前创下历史新高的股价脱身,这表明他们对恢复估值的能力信心不足,更不用说超越估值了。他们拿了现金,排除了参与Red Hat式复兴的可能性,这一复兴扭转了IBM持续的、不可阻挡的衰退(可能是一个明智的举动)。 正如我以前所说,Red Hat也有自己的挑战(在收购价格上,它找到了一个让IBM及其股东们手握大权的完美解决方案)。对于IBM来说,Red Hat可能看起来像一块宝石,但它们也有一个与云相关的问题。Red Hat是商业开源的典型代表,这是一个无关紧要的事实。Red Hat面临着一个非常传统的技术产业问题:代际淘汰。他们的大部分收入来自“基础设施相关产品”,即Red Hat Enterprise Linux(RHEL)服务器操作系统。随着计算从客户数据中心转移到公共云,RHEL并没有随之移动。你可能听说过云在Linux上运行。是的,只是没有在RHEL上运行。AWS、Azure和谷歌并不会为Linux支付Red Hat(如果需要的话,他们确实允许客户将RHEL作为客户操作系统运行,但是支付的理由变得越来越渺茫——如果超大规模的云不需要它,你为什么要这样做呢?)。随着Red Hat核心增长放缓,他们连续两个季度未达到华尔街的预期,这种不断萎缩的TAM终于在2018年开始出现问题,这被认为是成长型股票的问题,三分之一的估值正在消失就是明证。这些失误加上他们未来的可见度,可能促使Red Hat决定是时候给IBM打个电话了。 另一种假设是:Red Hat管理层告诉所有愿意倾听的人,他们有一个很好的云战略,他们环顾整个行业,看看可以与谁合作,以增强他们真正强大的云战略,并选择了IBM。 历史的终结 “成功是一个糟糕的老师”这句话被很多人认为是正确的,包括比尔·盖茨。当前的开源情况与微软在21世纪早期的情况惊人地相似。这家公司经营得很好,很享受现状。但随着开源软件和软件即服务(SaaS)撼动了这个舒适的世界,该公司拒绝做出改变,而是更喜欢以前的世界秩序。 对于云的兴起,一些开源软件的反应惊人地相似。当你认为有一个完美的模型时,它就会被颠覆。开源并不是软件历史的终结。关于历史终结的争论是非常令人不满的,尤其是对技术而言,因为他们几乎总是紧跟潮流。事实上,开源是一种脆弱的商业策略,依赖于项目和软件公司之间松散的关系,而不是一种商业模式。 正如微软和上一代软件开发人员最终不得不接受和拥抱变化一样,有些人成功了,有些人失败了,商业开源世界也是如此。在面对相反的证据时,坚持你认为的理想和永恒的模式不是一个好策略。要么适应,要么死亡。 开源是作为一种开发模型而存在的。很难想象有任何一种基础设施或开发人员软件不是开源的,但在相应的商业战略上还有很多工作要做。下一个伟大的开源努力可能是使多重云成为现实,至少对于关键的工作负载是这样。但是,新的关联业务模型必须将服务作为主要交付模型,并对云服务的特征——集成级别做出严肃的承诺。

优秀的个人博客,低调大师

大数据存储的进化史 --从 RAID 到 Hdfs

我们都知道现在大数据存储用的基本都是 Hdfs ,但在 Hadoop 诞生之前,我们都是如何存储大量数据的呢?这次我们不聊技术架构什么的,而是从技术演化的角度来看看 Hadoop Hdfs。 我们先来思考两个问题。 在 Hdfs 出现以前,计算机是通过什么手段来存储“大数据” 的呢? 为什么会有 Hadoop Hdfs 出现呢? 在 Hdfs 出现以前,计算机是通过什么手段来存储“大数据” 要知道,存储大量数据有三个最重要的指标,那就是速度,容量,容错性。速度和容量的重要性毋庸置疑,如果容量不够大,或者读取的速度不够快,那么海量数据存储也就无从谈起了。而磁盘又是计算机中很容易损坏的零件,当磁盘损坏的时候怎么办?放任数据的丢失吗,那可不行,这就有了容错性的需求。 在没有分布式存储的时代,单个磁盘容量不够怎么办?加磁盘呗。磁盘容易坏怎么办,同时用其他磁盘备份呗。就这样,独立磁盘冗余阵列( Redundant Array of Independent Disks ),简称 RAID,诞生了。 在 2000 年以前,磁盘还是很珍贵的资源,不像现在,磁盘是 PC 机中最廉价的部件。一开始 RAID 技术是为了将多个廉价的容量较小的磁盘组合起来充当一个大磁盘以节约成本,但后来人们发现这项技术也可以用在单台机器磁盘扩容上了,于是 RAID 技术开始被广泛使用。 RAID 技术将多个磁盘组合成一个逻辑扇区,对计算机而言,它会将 RAID 当作一个磁盘来处理。使用 RAID 的好处有:增强数据集成度,增强容错功能,增加处理量或容量。 另外 RAID 也有分为多个档次,标准的分法,分别是 RAID0 , RAID1 , RAID2 ,RAID3 ,RAID4 ,RAID5 , RAID6 ,每个档次都有对应的优缺点。这里就不详细介绍,这些 RAID 等级的不同主要是对 上述说到的三个数据存储要素(速度,容量,容错性)的不同取舍,各有各的应用场景。我们从上述的三个指标来看 RAID 技术。 速度: RAID通过在多个磁盘上同时存储和读取数据来大幅提高存储系统的数据吞吐量。在RAID中,可以让很多磁盘驱动器同时传输数据,而这些磁盘驱动器在逻辑上又是一个磁盘驱动器,所以使用RAID可以达到单个磁盘驱动器几倍、几十倍甚至上百倍的速率。 容量: 可以将多个磁盘连接起来,对比以前的单个磁盘存储,RAID 将存储的量级拔高了一个台阶。但依旧有其局限性,因为 RAID 始终是放在单台机器上,机器的磁盘卡槽不可能无限增加,磁盘也不可能一直增大。 容错性: 不同等级的 RAID 使用不同的数据冗余策略,保证数据的容错性。比如最简单的 RAID1 就是数据在写入磁盘时,将一份数据同时写入两块磁盘,这样任何一块磁盘损坏都不会导致数据丢失,而插入一块新磁盘就可以通过复制数据的方式自动修复,具有极高的可靠性。 为什么会有 Hadoop Hdfs 出现 最直接是原因是 Google 三篇大数据论文的发表,这直接导致了 Hadoop 的问世。 但更深层的原因其实还是因为传统的但节点磁盘容量达到了极限,即便是用上述的 RAID 技术,但单个台服务器的容量始终有一个边界值。而且随着互联网的普及,在 2000 年后,数据的积累呈指数式增长,这时候单台服务器显然已经放不下这海量的数据了。但是就像 RAID 的改革思想一样,既然单台服务器不够,那我们就加服务器呗。 最早是 Google ,他们在自己的系统上实现了 Google File System(GFS) 这么一个分布式存储系统,并在 03 年的时候将它的实现论文发表了出来。 但要将多台服务器联合在一起进行分布式存储,显然不是那么容易。Hadoop1.0 的时候,Hdfs 还是有一些隐患的。举个例子,用分布式进行数据存储,那就需要一个来记录元数据的服务器,也就是记录数据存储位置的服务器。Hadoop1.0 时候的 Hdfs 是用一个 namenode 管理元数据的,但显然,只有一个 namenode 来存储元数据有极大的风险,那就是 namenode 的可靠性无法保证,一旦这个 namenode 挂掉,整个集群就完蛋了。 好在这些问题及时得到修复,Hadoop2.0 横空出世,架构升级,解决了大部分的问题,Hdfs 这才算是坐稳了大数据存储王者的宝座。 在这里我们就先不说 Hdfs 的架构如何,依旧是从上面说到的大数据存储的三个指标速度,容量,容错性这几个方面来看 Hdfs。 速度: 速度方面的优势源于 Hdfs 合理的设计理念。它默认用到 Hdfs 处理的是大的数据(TB,PB 级的数据),并且摒弃了传统文件系统中的 Update 操作,只有 Append 操作。在这个基础上,Hdfs 将一个文件分割成若干个块(Block),每个块分布在不同的机器中。。和 RAID 利用多个磁盘并发 IO 提高速度一样,每次操作一个文件的时候,实际上是多个机器在并发读取,这样无疑是进一步提高读取速度。 容量: 容量这个问题自不必说,理论上是可以无限制得扩容。但实际上由于它的元数据存储在一台 namenode 中,所以它的大小还是会收到元数据存储的这个限制。不过在 Hadoop2.0 后,在机器条件允许的情况下,一个 Hdfs 支撑起 PB 级别的存储还是绰绰有余的。 容错性: 在容错性这个方面,从以前到现在基本都是通过数据冗余来实现的。只不过数据冗余的一些策略会根据不同的应用场景而做出一些改变。由于 Hadoop 本身就是假设部署在多台廉价机器上,所以它会倾向于将存储数据的节点当作不可靠的节点。出于这个因素,Hdfs 的默认冗余备份数是 3份 ,就是说当你向 Hdfs 写入一份数据的时候,同时会在其他三台机器上也写入相同的内容。 我们可以发现,其实 Hdfs 和 RAID 在思想上是有一些相似之处的。都是通过水平拓展,比如 RAID 水平拓展磁盘,Hdfs 则是水平拓展机器。 铁打的营盘流水的兵。数据就是那些兵,大数据计算框架,比如 Spark,Hive 是将军。而营盘就是 Hdfs 了。兵进进出出,将军换了一个又一个,唯独营盘不会变, Hdfs 无疑是大数据体系中最基础也是最重要的那一环。 这里给出一个有意思的问题: 当下一次互联网革命到来,数据又呈指数增长的时候,数据存储的模式会怎样演化呢?会是简单的增加集群吗,比方说让多个 hdfs 集群相互连通?欢迎在评论中写下你的思考。 欢迎关注公众号,有数据,代码和深度的思考。PS:关注后回复“数据挖掘一”可获得数据挖掘思维导图

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册