首页 文章 精选 留言 我的

精选列表

搜索[集成测试],共10018篇文章
优秀的个人博客,低调大师

Spring Boot项目集成 UidGenerator

前言 UidGenerator 基于snowflake算法实现 UidGenerator 由百度开发,基于SnowFlake算法的唯一ID生成器。UidGenerator 已组件的形式工作在应用项目中,支持自定义workeid位数和初始化策略,从而适用docker等虚拟化环境下实例自动重启等场景。 准备一个maven项目,构建两个模块。分别作为使用方和提供方。(建两个模块主要是为了“造轮子”,其他模块或项目可以直接引用,无需关心uid配置,如果没有分模块,可以忽略构建两个模块) 下载uid源码,放在项目中,开源地址https://github.com/baidu/uid-generator 数据库建表 DROP TABLE IF EXISTS WORKER_NODE;CREATE TABLE WORKER_NODE ( ID BIGINT NOT NULL AUTO_INCREMENT COMMENT 'auto increment id', HOST_NAME VARCHAR(64) NOT NULL COMMENT 'host name', PORT VARCHAR(64) NOT NULL COMMENT 'port',TYPE INT NOT NULL COMMENT 'node type: ACTUAL or CONTAINER', LAUNCH_DATE DATE NOT NULL COMMENT 'launch date', MODIFIED TIMESTAMP NOT NULL COMMENT 'modified time', CREATED TIMESTAMP NOT NULL COMMENT 'created time',PRIMARY KEY(ID)) COMMENT='DB WorkerID Assigner for UID Generator',ENGINE = INNODB; Spring 配置 CachedUidGennerator: UidGenerator 有两个具体的实现类,分别是 DefaultUidGenerator 和 CachedUidGenerator, 官方推荐使用性能较强的 CachedUidGenerator。 我们直接引用 UdiGenerator源码中的 cached-uid-spring.xml文件,使用默认配置 <?xml version="1.0" encoding="UTF-8"?><beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation=" http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans-3.1.xsd"> <!-- UID generator --> <bean id="disposableWorkerIdAssigner" class="com.baidu.fsg.uid.worker.DisposableWorkerIdAssigner" /> <bean id="cachedUidGenerator" class="com.baidu.fsg.uid.impl.CachedUidGenerator"> <property name="workerIdAssigner" ref="disposableWorkerIdAssigner" /> <!-- 以下为可选配置, 如未指定将采用默认值 --> <!-- RingBuffer size扩容参数, 可提高UID生成的吞吐量. --> <!-- 默认:3, 原bufferSize=8192, 扩容后bufferSize= 8192 << 3 = 65536 --> <!--<property name="boostPower" value="3"></property>--> <!-- 指定何时向RingBuffer中填充UID, 取值为百分比(0, 100), 默认为50 --> <!-- 举例: bufferSize=1024, paddingFactor=50 -> threshold=1024 * 50 / 100 = 512. --> <!-- 当环上可用UID数量 < 512时, 将自动对RingBuffer进行填充补全 --> <!--<property name="paddingFactor" value="50"></property>--> <!-- 另外一种RingBuffer填充时机, 在Schedule线程中, 周期性检查填充 --> <!-- 默认:不配置此项, 即不实用Schedule线程. 如需使用, 请指定Schedule线程时间间隔, 单位:秒 --> <!--<property name="scheduleInterval" value="60"></property>--> <!-- 拒绝策略: 当环已满, 无法继续填充时 --> <!-- 默认无需指定, 将丢弃Put操作, 仅日志记录. 如有特殊需求, 请实现RejectedPutBufferHandler接口(支持Lambda表达式) --> <!--<property name="rejectedPutBufferHandler" ref="XxxxYourPutRejectPolicy"></property>--> <!-- 拒绝策略: 当环已空, 无法继续获取时 --> <!-- 默认无需指定, 将记录日志, 并抛出UidGenerateException异常. 如有特殊需求, 请实现RejectedTakeBufferHandler接口(支持Lambda表达式) --> <!--<property name="rejectedPutBufferHandler" ref="XxxxYourPutRejectPolicy"></property>--> </bean> </beans> 引入cached-uid-spring.xml配置文件,在我们自己新建的 UidConfig中 package com.xxx.uid.config; import org.springframework.context.annotation.Configuration; import org.springframework.context.annotation.ImportResource; /** * @author lishuzhen * @date 2020/8/11 16:10 */ @Configuration @ImportResource(locations = {"classpath:/uid/cached-uid-spring.xml"}) public class UidConfig { } 在另一个模块中maven引入,创建一个UidGenUtils工具类,方便使用 package com.xxxx.utils; import com.xxx.uid.UidGenerator; import org.springframework.stereotype.Component; import javax.annotation.Resource; /** * @author lishuzhen * @date 2020/8/11 16:13 */ @Component public class UidGenUtils { @Resource private UidGenerator uidGenerator; public long getUid() { return uidGenerator.getUID(); } public String getUidStr() { return String.valueOf(uidGenerator.getUID()); } }

优秀的个人博客,低调大师

EFK实战二 - 日志集成

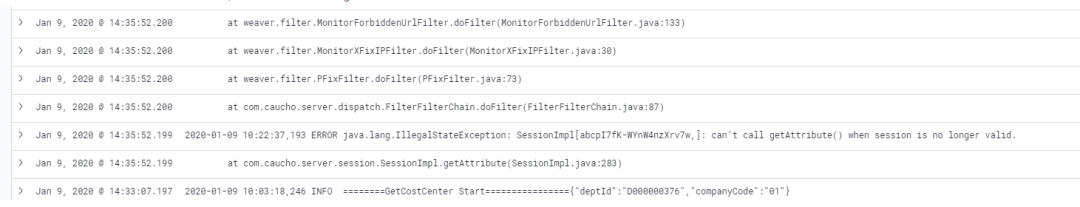
前言 在EFK基础架构中,我们需要在客户端部署Filebeat,通过Filebeat将日志收集并传到LogStash中。在LogStash中对日志进行解析后再将日志传输到ElasticSearch中,最后通过Kibana查看日志。 上文已经搭建好了EFK的基础环境,本文我们通过真实案例打通三者之间的数据传输以及解决EFK在使用过程中的一些常见问题。 首先看一下实际的业务日志 2020-01-0910:03:26,719INFO========GetCostCenterStart=============== 2020-01-09 10:03:44,267 WARN 成本中心编码少于10位!{"deptId":"D000004345","companyCode":"01"} 2020-01-0910:22:37,193ERRORjava.lang.IllegalStateException:SessionImpl[abcpI7fK-WYnW4nzXrv7w,]:can'tcallgetAttribute()whensessionisnolongervalid. atcom.caucho.server.session.SessionImpl.getAttribute(SessionImpl.java:283) atweaver.filter.PFixFilter.doFilter(PFixFilter.java:73) atcom.caucho.server.dispatch.FilterFilterChain.doFilter(FilterFilterChain.java:87) atweaver.filter.MonitorXFixIPFilter.doFilter(MonitorXFixIPFilter.java:30) atweaver.filter.MonitorForbiddenUrlFilter.doFilter(MonitorForbiddenUrlFilter.java:133) 「日志组成格式为:」 时间 日志级别 日志详情 那么我们的主要任务就是将这段日志正常写入EFK中。 filebeat安装配置 下载filebeat7.5.1 将下载后的文件上传至服务器并解压tar -zxvf filebeat-7.5.1-linux-x86_64.tar.gz 修改filebeat.yml, filebeat.inputs: -type:log enabled:true paths: -/app/weaver/Resin/log/xxx.log 此段配置日志输入,指定日志存储路径 output.logstash: #TheLogstashhosts hosts:["172.31.0.207:5044"] 此段配置日志输出,指定Logstash存储路径 启动filebeat ./filebeat -e -c filebeat.yml 如果需要静默启动,则使用 nohup ./filebeat -e -c filebeat.yml & 命令启动即可。 logstash配置 logstash的配置主要分为三段 input,filter,output。input用于指定输入,主要是开放端口给Filebeat用于接收日志filter用于指定过滤,对日志内容进行解析过滤。output用于指定输出,直接配置ES的地址即可 input{ beats{ port=>5044 } } output{ elasticsearch{ hosts=>["http://172.31.0.127:9200"] index=>"myindex-%{+YYYY.MM.dd}" user=>"elastic" password=>"xxxxxx" } } 我们配置好logstash后通过命令重启logstash docker-compose -f elk.yml restart logstash 经过上述两步配置后应用程序往日志文件写入日志,filebeat会将日志写入logstash。在kibana查看写入的日志结果如下: 日志显示有2个问题: 由于错误日志堆栈信息有多行,在kibana中展示成了多行,数据查看很乱。需要将堆栈异常整理成一行显示。 需要对日志进行解析,拆成“时间 日志级别 日志详情”的显示格式。 优化升级 在filebeat中设置合并行 filebeat默认是行传输的,但是我们的日志肯定是多行一个日志,我们要把多行合并到一起就要找到日志的规律。比如我们的日志格式全都是以时间格式开头,所以我们在filebeat中 filebeat.inputs区域添加如下几行配置 #以日期作为前缀 multiline.pattern:^\d{4}-\d{1,2}-\d{1,2} #开启多行合并 multiline.negate:true #合并到上一行之后 multiline.match:after 在logstash中设置对日志的解析 将日志解析成“时间 日志级别 日志详情”的展示格式,所以我们需要在logstash配置文件中添加filter段 filter { grok{ match => { "message" => "(?<date>\d{4}-\d{2}-\d{2}\s\d{2}:\d{2}:\d{2}),\d{3} %{LOGLEVEL:loglevel} (?<des>.*)" } } } 这里主要是使用grok语法对日志进行解析,通过正则表达式对日志进行过滤。大家可以通过kibana里的grok调试工具进行调试 配置完成后我们重新打开kibana Discover界面查看日志,符合预期,完美! 常见问题 kibana 乱码 这个主要原因还是客户端日志文件格式有问题,大家可以通过 file xxx.log查看日志文件的编码格式,如果是ISO8859的编码基本都会乱码,我们可以在filebeat配置文件中通过encoding指定日志编码进行传输。 filebeat.inputs: -type:log enabled:true paths: -/app/weaver/Resin/log/xxx.log encoding:GB2312 kibana 提取字段出错 如上所示,打开kibana Discover面板时出现此异常,大家只要删除ES中的 .kibana_1索引然后重新访问Kibana即可。 查看周围文件 我们在终端查看日志某关键字时一般会查上下文信息便于排查问题,如经常用到的指令 cat xxx.log | grep -C50 keyword,那么在Kibana中如何实现这功能呢。 在Kibana中搜索关键字,然后找到具体日志记录,点击左边向下箭头,然后再点击“查看周围文档”即可实现。 动态索引 我们日志平台可能需要对接多个业务系统,需要根据业务系统建立不同的索引。 在filebeat中给日志打上标记 -type:log ...... fields: logType:oabusiness 在logstash中根据标记生成索引 input { beats { port => 5044 } } filter { if [fields][logType] == "oabusiness" { grok{ match => { "message" => "(?<date>\d{4}-\d{2}-\d{2}\s\d{2}:\d{2}:\d{2}),\d{3} %{LOGLEVEL:loglevel} (?<des>.*)" } } } } output { elasticsearch { hosts => ["http://172.31.0.207:9200"] index => "%{[fields][logType]}-%{+YYYY.MM.dd}" user => "elastic" password => "elastic" } } 如果本文对你有帮助, 别忘记来个三连: 点赞,转发,评论 本文分享自微信公众号 - JAVA日知录(javadaily)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

阿里云AMQP Springboot集成

概述 本文主要介绍如何通过 Spring boot 连接阿里云AMQP服务。 操作步骤 1、示例程序下载,下载地址。 2、参数配置,AMQP管理控制台获取。 resources -> application.properties spring.application.name=rabbitmq-demo spring.rabbitmq.host=18********617278.mq-amqp.cn-hangzhou-a.aliyuncs.com spring.rabbitmq.port=5672 spring.rabbitmq.username=****** spring.rabbitmq.password=****** spring.rabbitmq.virtual-host=****** spring.rabbitmq.temp

优秀的个人博客,低调大师

MyEclipse离线集成Maven插件

MyEclipse自带有Maven4MyEclipse插件,如果没有可以在线和离线安装的方式,在线安装由于网络问题或者插件下载地址的问题导致安装失败,现在给大家介绍离线安装的方式。 1、Maven插件下载地址:http://pan.baidu.com/s/1mi94Efe 2、在MyEclipse 安装目录下新建maven文件夹,比如我的安装目录为:C:\MyEclipseSpr10.6\MyEclipse for Spring 10\dropins\目录下新建maven文件夹,然后解压下载到Maven插件,把目录下的features文件夹和plugins文件夹拷贝到新建的maven目录下。 3、在MyEclipse安装目录下的dropins目录新建txt文本,并重命名为maven.link。 4、编辑maven.link文件,输入path=C:\MyEclipseSpr10.6\MyEclipse for Spring 10\dropins\maven。 5、重启MyEclipse,查看MyEclipse工具栏Window/Preferences下就会出现Maven的选项,到此为止你已成功安装maven插件。

优秀的个人博客,低调大师

C#接口,类,集成

using System;using System.Collections.Generic;using System.Linq;using System.Text;using System.Threading.Tasks; namespace Demo{ public abstract class MyBase { } internal class MyClass : MyBase { } public interface IMyBaseInterface { } internal interface IMyBaseInterface2 { } internal interface IMyInterface : IMyBaseInterface,IMyBaseInterface2 { } internal sealed class MyComplexClass : MyClass,IMyInterface { } class Program { static void Main(string[] args) { MyComplexClass myObj = new MyComplexClass(); Console.WriteLine(myObj.ToString()); Console.ReadKey(); } } }一个namespace可以定义多种类与接口,有意思。本文转自TBHacker博客园博客,原文链接:http://www.cnblogs.com/jiqing9006/p/6758409.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册