首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10007篇文章
优秀的个人博客,低调大师

深度解析ThreadLocal原理

今天呢,和大家聊一下ThreadLocal。 1. 是什么? JDK1.2提供的的一个线程绑定变量的类。 他的思想就是:给每一个使用到这个资源的线程都克隆一份,实现了不同线程使用不同的资源,且该资源之间相互独立 2. 为什么用? 思考一个场景:数据库连接的时候,我们会创建一个Connection连接,让不同的线程使用。这个时候就会出现多个线程争抢同一个资源的情况。 这种多个线程争抢同一个资源的情况,很常见,我们常用的解决办法也就两种:空间换时间,时间换空间 没有办法,鱼与熊掌不可兼得也。就如我们的CAP理论,也是牺牲其中一项,保证其他两项。 而针对上面的场景我们的解决办法如下: 空间换时间:为每一个线程创建一个连接。 直接在线程工作中,创建一个连接。(重复代码太多) 使用ThreadLocal,为每一个线程绑定一个连接。 时间换空间:对当前资源加锁,每一次仅仅存在一个线程可以使用这个连接。 通过ThreadLocal为每一个线程绑定一个指定类型的变量,相当于线程私有化 3. 怎么用? ThreadLocal<Integer> threadLocal = new ThreadLocal<>(); threadLocal.get(); threadLocal.set(1); threadLocal.remove(); 没错,这四行代码已经把ThreadLocal的使用方法表现得明明白白。 get从ThreadLocal拿出一个当前线程所拥有得对象 set给当前线程绑定一个对象 remove将当前线程绑定的当前对象移除 记住在使用的以后,一定要remove,一定要remove,一定要remove 为什么要remove。相信不少小伙伴听到过ThreadLocal会导致内存泄漏问题。 没错,所以为了解决这种情况,所以你懂吧,用完就移除,别浪费空间(渣男欣慰) 看到这,脑袋上有好多问号出现了(小朋友你是否有很多问号?) 为啥会引发内存泄漏? 为啥不remove就内存泄漏了 它是怎么讲对象和线程绑定的 为啥get的时候拿到的就是当前线程的而不是其他线程的 它怎么实现的??? 来吧,开淦,源码来 4. 源码解读 先来说一个思路:如果我们自己写一个ThreadLocal会咋写? 线程绑定一个对象。**这难道不是我们熟知的map映射?**有了Map我们就可以以线程为Key,对象为value添加到一个集合中,然后各种get,set,remove操作,想怎么玩就怎么玩,搞定。😀 这个时候,有兄弟说了。你这思路不对啊,你这一个线程仅仅只能存放一个类型的变量,那我想存多个呢? 摸摸自己充盈的发量,你说出了一句至理名言:万般问题,皆系于源头和结果之中。 从结果考虑,让开发者自己搞线程私有(估计被会开发者骂死) 来吧,从源头考虑。现在我们的需求是:线程可以绑定多个值,而不仅仅是一个。嗯,没错,兄弟们把你们的想法说出来。 让线程自己维护一个Map,将这个ThreadLocal作为Key,对象作为Value不就搞定了 兄弟,牛掰旮旯四 此时,又有兄弟说了。按照你这样的做法,将ThreadLocal扔到线程本身的的Map里,那岂不是这个ThreadLocal一直被线程对象引用,所以在线程销毁之前都是可达的,都无法GC呀,有BUG啊??? **好,问题。**这样想,既然由于线程和ThreadLocal对象存在引用,导致无法GC,那我将你和线程之间的引用搞成弱引用或者软引用不就成了。一GC你就没了。 啥,你不知道啥是弱引用和软引用??? 前面讲过的东西,算啦再给你们复习一波。 JDK中存在四种类型引用,默认是强引用,也就是我们经常干的事情。疯狂new,new,new。这个时候创建的对象都是强引用。 强引用。直接new 软引用。通过SoftReference创建,在内存空间不足的时候直接销毁,即它可能最后的销毁地点是在老年区 弱引用。通过WeakReference创建,在GC的时候直接销毁。即其销毁地点必定为伊甸区 虚引用。通过PhantomReference创建,它和不存也一样,非常虚,只能通过引用队列在进行一些操作,主要用于堆外内存回收 好了,回到正题,上面的引用里最适合我们当前的场景的就是弱引用了,为什么这个样子说: 在以往我们使用完对象以后等着GC清理,但是对于ThreadLocal来说,即使我们使用结束,也会因为线程本身存在该对象的引用,处于对象可达状态,垃圾回收器无法回收。这个时候当ThreadLocal太多的时候就会出现内存泄漏的问题。 而我们将ThreadLocal对象的引用作为弱引用,那么就很好的解决了这个问题。当我们自己使用完ThreadLocal以后,当GC的时候就会将我们创建的强引用直接干掉,而这个时候我们完全可以将线程Map中的引用干掉,于是使用了弱引用,这个时候大家应该懂了为啥不使用软引用了吧 还有一个问题:为什么会引发内存泄漏呢? 了解Map结构的兄弟们应该清楚,内部实际就一个节点数组,对于ThreadLocalMap而言,内部是一个Entity,它将Key作为弱引用,Value还是强引用。如果我们在使用完ThreadLocal以后,没有对Entity进行移除,会引发内存泄漏问题。 ThreadLocalMap提供了一个方法expungeStaleEntry方法用来排除无效的Entity(Key为空的实体) 说到这里,有一个问题我思考了蛮久的,value为啥不搞成弱引用,用完直接扔了多好 最后思考出来得答案(按照源码推了一下): 不设置为弱引用,是因为不清楚这个Value除了map的引用还是否还存在其他引用,如果不存在其他引用,当GC的时候就会直接将这个Value干掉了,而此时我们的ThreadLocal还处于使用期间,就会造成Value为null的错误,所以将其设置为强引用。 而为了解决这个强引用的问题,它提供了一种机制就是上面我们说的将Key为Null的Entity直接清除 到这里,这个类的设计已经很清楚了。接下来我们看一下源码吧! 需要注意的一个点是:ThreadLocalMap解决哈希冲突的方式是线性探测法。 人话就是:如果当前数组位有值,则判断下一个数组位是否有值,如果有值继续向下寻找,直到一个为空的数组位 Set方法 class ThreadLocal public void set(T value) { //拿到当前线程 Thread t = Thread.currentThread(); //获取当前线程的ThreadLocalMap ThreadLocalMap map = getMap(t); if (map != null) //如果当前线程的Map已经创建,直接set map.set(this, value); else //没有创建,则创建Map createMap(t, value); } private void set(ThreadLocal<?> key, Object value) { Entry[] tab = table; int len = tab.length; int i = key.threadLocalHashCode & (len-1); //拿到当前数组位,当前数组位是否位null,如果为null,直接赋值,如果不为null,则线性查找一个null,赋值 for (Entry e = tab[i]; e != null; e = tab[i = nextIndex(i, len)]) { ThreadLocal<?> k = e.get(); if (k == key) { e.value = value; return; } if (k == null) { replaceStaleEntry(key, value, i); return; } } tab[i] = new Entry(key, value); int sz = ++size; //清除一些失效的Entity if (!cleanSomeSlots(i, sz) && sz >= threshold) rehash(); } ThreadLocalMap getMap(Thread t) { //获取当前线程的ThreadLocalMap return t.threadLocals; } void createMap(Thread t, T firstValue) { //当前对象作为Key,和我们的设想一样 t.threadLocals = new ThreadLocalMap(this, firstValue); } Get方法 public T get() { //获取当前线程 Thread t = Thread.currentThread(); //拿到当前线程的Map ThreadLocalMap map = getMap(t); if (map != null) { //获取这个实体 ThreadLocalMap.Entry e = map.getEntry(this); if (e != null) { @SuppressWarnings("unchecked") T result = (T)e.value; //返回 return result; } } return setInitialValue(); } private Entry getEntry(ThreadLocal<?> key) { //计算数组位 int i = key.threadLocalHashCode & (table.length - 1); Entry e = table[i]; //如果当前数组有值,且数组位的key相同,则返回value if (e != null && e.get() == key) return e; else //线性探测寻找对应的Key return getEntryAfterMiss(key, i, e); } private Entry getEntryAfterMiss(ThreadLocal<?> key, int i, Entry e) { Entry[] tab = table; int len = tab.length; while (e != null) { ThreadLocal<?> k = e.get(); if (k == key) return e; if (k == null) //排除当前为空的Entity expungeStaleEntry(i); else //获取下一个数组位 i = nextIndex(i, len); e = tab[i]; } //如果没有找到直接返回空 return null; } remove public void remove() { ThreadLocalMap m = getMap(Thread.currentThread()); if (m != null) m.remove(this); } private void remove(ThreadLocal<?> key) { Entry[] tab = table; int len = tab.length; int i = key.threadLocalHashCode & (len-1); //拿到当前的数组,判断是否为需要的数组位,如果不是线性查找 for (Entry e = tab[i]; e != null; e = tab[i = nextIndex(i, len)]) { if (e.get() == key) { e.clear(); //清空位NUll的实体 expungeStaleEntry(i); return; } } } 我们可以看到一个现象:在set,get,remove的时候都调用了expungeStaleEntry来将所有失效的Entity移除 看一下这个方法做了什么 private int expungeStaleEntry(int staleSlot) { Entry[] tab = table; int len = tab.length; // 删除实体的Value tab[staleSlot].value = null; //置空这个数组位 tab[staleSlot] = null; //数量减一 size--; // 重新计算一次哈希,如果当前数组位不为null,线性查找直到一个null Entry e; int i; for (i = nextIndex(staleSlot, len); (e = tab[i]) != null; i = nextIndex(i, len)) { ThreadLocal<?> k = e.get(); if (k == null) { e.value = null; tab[i] = null; size--; } else { int h = k.threadLocalHashCode & (len - 1); if (h != i) { tab[i] = null; // Unlike Knuth 6.4 Algorithm R, we must scan until // null because multiple entries could have been stale. while (tab[h] != null) h = nextIndex(h, len); tab[h] = e; } } } return i; } 更多原创内容请关注博主

优秀的个人博客,低调大师

AOP编程全解析

AOP是一种编程思想,一套规范。 软件开发经历了面向过程编程时代,以C语言为代表,之后是面向对象编程时代,以Java语言为代表。 在21世纪大牛们又提出了一种新的编程思想面向方面编程,即AOP理念,全称Aspect-Oriented Programming。 AOP是第三代编程思想,到哪免不了都要问下。 发展历史 1997年在面向对象编程大会上Gregor Kiczales等人首次提出了AOP的概念,之后各大公司等分别加入研究。2001年Palo Alto研究中心发布了首个支持AOP的语言AspectJ,同时也是一个规范。 目标定位 在对真实世界抽象的面向对象编程过程中,始终伴随着某写操作的代码无法实现模块化封装,会散落在各个对象中存在,特别是非功能性代码。对于一般的功能开发采取面向对象方式进行抽象是能够很好应付的,但是面向方面(切面)给了一种新的思维方式来考虑编程,能更好的进行全局结构化思考。 所以AOP主要解决两个问题: 代码分散问题,特别是那些非功能性代码。 作为面向对象编程思维的一种补充和完善。 核心知识点 连接点 连接点:join point,程序的一个执行点,如类中的一个方法,方法里面一个代码块。 切入点 切入点:point cut,是一个捕获连接点的代码结构,就是定义一个代码逻辑用来捕获某个连接点的代码。 方面 方面;aspect,是具体被执行的切面逻辑代码,类似于一个类。 通知 通知:advice,是point cut执行的代码,定义在连接点什么时机来执行aspect。 主要运用场景 场景分为2类: 一类是非功能性需求,如日志、异常、安全、事务都可以使用AOP思想编程。 另一类是功能性需求,在原来对象抽象的思维中添加AOP思维,这里是一种结构化思维,在定义类时考虑多个类的切面共性。 主流AOP语言实现 对AOP实现除了AspectJ外,已知的还有JBoss AOP、Spring AOP等。 这里只介绍AspectJ和SpringAOP,重点是他们不同点。 AspcetJ AspectJ采用静态织入方式进行切面织入原代码,提供独立的编译器把切面和原代码的java文件编织成一个新的class文件。提供了详细的编译日志和调试工具,编译时间长但是运行效率高。 连接点的支持范围: 方法和构造器调用 方法和构造器执行 属性访问 异常处理 类初始化,是static代码块 语法结构 控制流 对象及参数类型 条件测试 关联连接点通知方式: before,连接点执行前运行 after,连接点执行后运行 around,连接点的整个外侧,整个包住,能够绝的连接点执行和修改上下文环境 Spring AOP Spring AOP没有完全实现AspectJ语言,它更多的是对Spring framwork进行Aop能力的扩展实现,补全Spring framework的不足并让Aop与Spring framwork融合。 连接点只支持方法拦截调用。 连接点通知方式在aspect的before、after、around的基础上增加throw对异常的触发的拦截。 Spring AOP与Spring IoC体系融合,对于aspect类统一交由Spring beans管理,并且提供ProxyFactoryBean的AOP代理工厂类,还有自动代理的BeanNameAutoProxyCreator和DefaultAdvisorAutoProxyCreator的强大工具。 Spring AOP是动态织入,在运行时完成AOP的aspect代码织入原代码逻辑中。其底层默认采用JDK的动态代理实现AOP代理,当对象没有实现接口时,CGLIB会默认使用。 优缺点 优点:解决代码散乱问题、代码逻辑解偶、易于维护、提供扩展性和可重用性。 缺点:切面越多系统越复杂难懂、工程师学习成本增加(业务不再是线型,变成了跳跃式) AOP编程要慎重使用,作为面向对象编程的一种补充。 作者:Owen Jia 关注他的博客:https://blog.shareworld.vip

优秀的个人博客,低调大师

ReentrantLock 核心源码解析

学习完 AQS,本文我们就来研究第一个 AQS 的实现类:ReentrantLock。 1 基本设计 ReentrantLock 可重入锁,可重入表示同一个线程可以对同一个共享资源重复的加锁或释放锁。 具有与使用 synchronized 方法和语句访问的隐式监视器锁相同的基本行为和语义的可重入互斥锁,但具有扩展功能。 ReentrantLock 由最后成功锁定但尚未解锁的线程所拥有。当另一个线程不拥有该锁时,调用该锁的线程将成功返回该锁。如果当前线程已经拥有该锁,则该方法将立即返回。可以使用 isHeldByCurrentThread 和getHoldCount 方法进行检查。 此类的构造函数接受一个可选的 fairness 参数。设置为true时,在争用下,锁倾向于授予给等待时间最长的线程。否则,此锁不能保证任何特定的访问顺序。使用多线程访问的公平锁的程序可能会比使用默认设置的程序呈现较低的总吞吐量(即较慢;通常要慢得多),但获得锁并保证没有饥饿的时间差异较小。但是请注意,锁的公平性不能保证线程调度的公平性。因此,使用公平锁的多个线程之一可能会连续多次获得它,而其他活动线程没有进行且当前未持有该锁。还要注意,未定时的 tryLock 方法不支持公平性设置。如果锁可用,即使其他线程正在等待,它将成功。 建议的做法是始终立即在调用后使用try块进行锁定,最常见的是在构造之前/之后,例如: class X { private final ReentrantLock lock = new ReentrantLock(); // ... public void m() { lock.lock(); // block until condition holds try { // ... method body } finally { lock.unlock() } } } 除了实现Lock接口之外,此类还定义了许多用于检查锁状态的 public 方法和 protected 方法。 其中一些方法仅对检测和监视有用。 此类的序列化与内置锁的行为相同:反序列化的锁处于解锁状态,而不管序列化时的状态如何。 此锁通过同一线程最多支持2147483647个递归锁。 尝试超过此限制会导致锁定方法引发错误。 2 类架构 ReentrantLock 本身不继承 AQS,而是实现了 Lock 接口 Lock 接口定义了各种加锁,释放锁的方法,比如 lock() 这种不响应中断获取锁,在ReentrantLock 中实现的 lock 方法是通过调用自定义的同步器 Sync 中的的同名抽象方法,再由两种模式的子类具体实现此抽象方法来获取锁。 ReentrantLock 就负责实现这些接口,使用时,直接调用的也是这些方法,这些方法的底层实现都是交给 Sync 实现。 3 构造方法 无参数构造方法相当于 ReentrantLock(false),默认为非公平的锁 有参构造方法,可以选择锁的公平性 可以看出 公平锁依靠 FairSync 实现 非公平锁依靠 NonfairSync 实现 4 Sync 同步器 结构图 继承体系 可见是ReentrantLock的抽象静态内部类 Sync 继承了 AbstractQueuedSynchronizer ,所以ReentrantLock依靠 Sync 就持有了锁的框架,只需要 Sync 实现 AQS 规定的非 final 方法即可,只交给子类 NonfairSync 和 FairSync 实现 lock 和 tryAcquire 方法 4.1 NonfairSync - 非公平锁 Sync 对象的非公平锁 4.1.1 lock 非公平模式的 lock 方法 若 CAS(已经定义并实现在 AQS 中的 final 方法)state 成功,即获取锁成功并将当前线程设置为独占线程 若 CAS state 失败,即获取锁失败,则进入 AQS 中已经定义并实现的 Acquire 方法善后 这里的 lock 方法并没有直接调用 AQS 提供的 acquire 方法,而是先试探地使用 CAS 获取了一下锁,CAS 操作失败再调用 acquire 方法。这样设计可以提升性能。因为可能很多时候我们能在第一次试探获取时成功,而不需要再经过 acquire => tryAcquire => nonfairAcquire 的调用链。 4.1.2 tryAcquire 其中真正的实现 nonfairTryAcquire 就定义在其父类 Sync 中。下一节分析。 4.2 FairSync - 公平锁 只实现 lock 和 tryAcquire 两个方法 4.2.1 lock 公平模式的 lock 直接调用 acquire,而没有像非公平模式先试图获取,因为这样可能导致违反“公平”的语义:在已等待在队列中的线程之前获取了锁。acquire 是 AQS 的方法,表示先尝试获得锁,失败之后进入同步队列阻塞等待,详情见本专栏的上一文 4.2.2 tryAcquire 公平模式的 tryAcquire。不要授予访问权限,除非递归调用或没有等待线程或是第一个调用的。 该方法是 AQS 在 acquire 方法中留给子类去具体实现的 话不多说,看源码: protected final boolean tryAcquire(int acquires) { // 获取当前的线程 final Thread current = Thread.currentThread(); // 获取 state 锁的状态 int c = getState(); // state == 0 => 尚无线程获取锁 if (c == 0) { // 判断 AQS 的同步对列里是否有线程等待,若没有则直接 CAS 获取锁 if (!hasQueuedPredecessors() && compareAndSetState(0, acquires)) { // 获取锁成功,设置独占线程 setExclusiveOwnerThread(current); return true; } } // 判断已经获取锁是否为当前的线程 else if (current == getExclusiveOwnerThread()) { // 锁的重入, 即 state 加 1 int nextc = c + acquires; if (nextc < 0) throw new Error("Maximum lock count exceeded"); setState(nextc); return true; } return false; } 和 Sync 的 nonfairTryAcquire 方法实现类似,唯一不同的是当发现锁未被占用时,使用 hasQueuedPredecessors 确保了公平性。 hasQueuedPredecessors 会判断当前线程是不是属于同步队列的头节点的下一个节点(头节点是释放锁的节点) 如果是(返回false),符合FIFO,可以获得锁 如果不是(返回true),则继续等待 public final boolean hasQueuedPredecessors() { // 这种方法的正确性取决于头在尾之前初始化和头初始化。如果当前线程是队列中的第一个线程,则next是精确的 Node t = tail; // 按反初始化顺序读取字段 Node h = head; Node s; return h != t && ((s = h.next) == null || s.thread != Thread.currentThread()); } 5 nonfairTryAcquire 执行非公平的 tryLock。 tryAcquire 是在子类中实现的,但是都需要对trylock 方法进行非公平的尝试。 final boolean nonfairTryAcquire(int acquires) { // 获取当前的线程 final Thread current = Thread.currentThread(); // 获取 AQS 中的 state 字段 int c = getState(); // state 为 0,表示同步器的锁尚未被持有 if (c == 0) { // CAS state 获取锁(这里可能有竞争,所以可能失败) if (compareAndSetState(0, acquires)) { // 获取锁成功, 设置获取独占锁的线程 setExclusiveOwnerThread(current); // 直接返回 true return true; } } // 判断现在获取独占锁的线程是否为当前线程(可重入锁的体现) else if (current == getExclusiveOwnerThread()) { // state 计数加1(重入获取锁) int nextc = c + acquires; if (nextc < 0) // 整型溢出 throw new Error("Maximum lock count exceeded"); // 已经获取 lock,所以这里不考虑并发 setState(nextc); return true; } return false; } 无参的 tryLock 调用的就是此方法 6 tryLock 6.1 无参 Lock 接口中定义的方法。 仅当锁在调用时未被其他线程持有时,才获取锁 如果锁未被其他线程持有,则获取锁,并立即返回值 true,将锁持有计数设置为1。即使这个锁被设置为使用公平的排序策略,如果锁可用,调用 tryLock() 也会立即获得锁,不管其他线程是否正在等待锁。这种妥协行为在某些情况下是有用的,虽然它破坏了公平。如果想为这个锁执行公平设置,那么使用 tryLock(0, TimeUnit.SECONDS),这几乎是等价的(它还可以检测到中断)。 如果当前线程已经持有该锁,那么持有计数将增加1,方法返回true。如果锁被另一个线程持有,那么这个方法将立即返回值false。 典型的使用方法 Lock lock = ...; if (lock.tryLock()) { try { // manipulate protected state } finally { lock.unlock(); } } else { // 执行可选的操作 } 6.2 有参 提供了超时时间的入参,在时间内,仍没有得到锁,会返回 false 其中的 doAcquireNanos 已经实现好在 AQS 中。 7 tryRelease 释放锁,对于公平和非公平锁都适用 protected final boolean tryRelease(int releases) { // 释放 releases (由于可重入,这里的 c 不一定直接为 0) int c = getState() - releases; // 判断当前线程是否是获取独占锁的线程 if (Thread.currentThread() != getExclusiveOwnerThread()) throw new IllegalMonitorStateException(); boolean free = false; // 锁已被完全释放 if (c == 0) { free = true; // 无线程持有独占锁,所以置 null setExclusiveOwnerThread(null); } setState(c); return free; } 8 总结 AQS 搭建了整个锁架构,子类锁的实现只需要根据场景,实现 AQS 对应的方法即可。

优秀的个人博客,低调大师

ThreadLocal 核心源码解析

# 1 前言 此类提供线程本地变量。这些变量与普通变量不同,因为每个访问一个变量(通过其get或set方法)的线程都有其自己的,独立初始化的变量副本。 ThreadLocal 实例通常是期望将状态与线程(例如,用户ID或事务ID)关联的类中的 private static 字段。 例如,下面的类生成每个线程本地的唯一标识符。线程的ID是在第一次调用ThreadId.get() 时赋值的,并且在以后的调用中保持不变。 ![](https://uploadfiles.nowcoder.com/images/20200324/5088755_1585021172479_C478AA1A06FECA1567F29CCF948C1245 "图片标题") 只要线程是活跃的并且 ThreadLocal 实例是可访问的,则每个线程都对其线程本地变量的副本持有隐式的引用。线程消失后,线程本地实例的所有副本都会被 GC(除非存在对这些副本的其他引用)。 # 2 继续体系 - 继承?不存在的,这其实也是 java.lang 包下的工具类 ![](https://uploadfiles.nowcoder.com/images/20200324/5088755_1585033878314_CBF921C0352B45E6E7BDDA2A13D174F9 "图片标题") - 但是 ThreadLocal 定义带有泛型,说明可以储存任意格式的数据. ![](https://uploadfiles.nowcoder.com/images/20200324/5088755_1585030744135_9E087D203EA7418ACDD0B8DB51B48F4B "图片标题") # 3 属性 - ThreadLocal 依赖于附加到每个线程(Thread.threadLocals和InheritableThreadLocals)的线程线性探测哈希表. ThreadLocal 对象充当键,通过 threadLocalHashCode 进行搜索。这是一个自定义哈希码(仅在ThreadLocalMaps 中有用),它消除了在相同线程使用连续构造的threadlocal的常见情况下的冲突,而在不太常见的情况下仍然表现良好。 一句话总结: ThreadLocal 通过这样的 hashCode,计算当前 ThreadLocal 在 ThreadLocalMap 中的索引 ![](https://uploadfiles.nowcoder.com/images/20200324/5088755_1585033954555_EC15B568153F5227211EFE4BE8EA269C "图片标题") ![](https://uploadfiles.nowcoder.com/images/20200324/5088755_1585037145014_6433D86909F472C44933A277CB24F5E1 "图片标题") - 连续生成的哈希码之间的差值,关于该值的设定,可参考文章[ThreadLocal的hash算法(关于 0x61c88647)](https://juejin.im/post/5cced289f265da03804380f2) ![](https://uploadfiles.nowcoder.com/images/20200324/5088755_1585037195533_D4EDF4BB15420CD3CD0A413647C49E23 "图片标题") - 注意 static 修饰,ThreadLocalMap 会被 set 多个 ThreadLocal ,而多个 ThreadLocal 就根据 threadLocalHashCode 区分 ![](https://uploadfiles.nowcoder.com/images/20200324/5088755_1585039473385_011B3B54168C0B11A7CEF11FFAA4B4A8 "图片标题") # 4 ThreadLocalMap ThreadLocalMap 是自定义的哈希表,仅适用于维护线程本地的值。没有操作导出到ThreadLocal类之外。 该类是包私有的,允许在 Thread 类中的字段声明。为了帮助处理非常长的使用寿命,哈希表节点使用 WeakReferences 作为键。但是,由于不使用引用队列,因此仅在表空间不足时,才保证删除过时的节点。 ```java static class ThreadLocalMap { /** * 此哈希表中的节点使用其主引用字段作为键(始终是一个 ThreadLocal 对象) * 继承了 WeakReference。 * 请注意,空键(即entry.get()== null)意味着不再引用该键,因此可以从表中删除该节点。 * 在下面的代码中,此类节点称为 "stale entries" */ static class Entry extends WeakReference> { /** 与此 ThreadLocal 关联的值 */ Object value; Entry(ThreadLocal<?> k, Object v) { super(k); value = v; } } /** * 初始容量 -- 必须是 2 的幂 */ private static final int INITIAL_CAPACITY = 16; /** * table 数组,必要时扩容 * table.length 必须是 2 的幂 */ private Entry[] table; /** * table 中的节点个数 */ private int size = 0; /** * 下一次扩容的阈值 */ private int threshold; // 默认为 0 ``` ## 特点 - key 是 ThreadLocal 的引用 - value 是 ThreadLocal 保存的值 - 数组的数据结构 # 5 set ## 5.1 ThreadLocal#set 将此线程本地变量的当前线程副本设置为指定值。大多数子类将不需要重写此方法,而仅依靠initialValue方法来设置线程本地变量的值。 ![](https://uploadfiles.nowcoder.com/images/20200324/5088755_1585042632088_456A49E4B894B791C01A12C128A2B662 "图片标题") ### 执行流程 1. 获取当前线程 2. 获取线程所对应的ThreadLocalMap,从这可以看出每个线程都是独立的,所以此方法天然线程安全 3. 判断 map 是否为 null - 否,则 K.V 对赋值,k 为this,即当前的 ThreaLocal 对象 - 是,则初始化一个 ThreadLocalMap 来维护 K.V 对 来具体看看ThreadLocalMap中的 set ## 5.2 ThreadLocalMap#set ```java private void set(ThreadLocal<?> key, Object value) { // 新引用指向 table Entry[] tab = table; int len = tab.length; // 获取对应 ThreadLocal 在table 中的索引,注意这里是 hashCode 与 2 幂次长度-1(想起来为什么这样计算更好了吗?) int i = key.threadLocalHashCode & (len-1); /** * 从该下标开始循环遍历 * 1、如遇相同key,则直接替换value * 2、如果该key已经被回收失效,则替换该失效的key */ for (Entry e = tab[i]; e != null; e = tab[i = nextIndex(i, len)]) { ThreadLocal<?> k = e.get(); // 找到内存地址一样的 ThreadLocal,直接替换 if (k == key) { e.value = value; return; } // 若 k 为 null,说明 ThreadLocal 被清理了,则替换当前失效的 k if (k == null) { replaceStaleEntry(key, value, i); return; } } // 找到空位,创建节点并插入 tab[i] = new Entry(key, value); // table内元素size自增 int sz = ++size; // 达到阈值(数组大小的三分之二)时,执行扩容 if (!cleanSomeSlots(i, sz) && sz >= threshold) rehash(); } ``` 注意通过 hashCode 计算的索引位置 i 处如果已经有值了,会从 i 开始,通过 +1 不断的往后寻找,直到找到索引位置为空的地方,把当前 ThreadLocal 作为 key 放进去。 # 6 get ```java public T get() { // 获取当前线程 Thread t = Thread.currentThread(); // 获取当前线程对应的ThreadLocalMap ThreadLocalMap map = getMap(t); // 如果map不为空 if (map != null) { // 取得当前ThreadLocal对象对应的Entry ThreadLocalMap.Entry e = map.getEntry(this); // 如果不为空,读取当前 ThreadLocal 中保存的值 if (e != null) { @SuppressWarnings("unchecked") T result = (T)e.value; return result; } } // 否则都执行 setInitialValue return setInitialValue(); } ``` ### ```java private T setInitialValue() { // 获取初始值,一般是子类重写 T value = initialValue(); // 获取当前线程 Thread t = Thread.currentThread(); // 获取当前线程对应的ThreadLocalMap ThreadLocalMap map = getMap(t); // 如果map不为null if (map != null) // 调用ThreadLocalMap的set方法进行赋值 map.set(this, value); // 否则创建个ThreadLocalMap进行赋值 else createMap(t, value); return value; } ``` 接着我们来看下 ## ThreadLocalMap#getEntry ```java // 得到当前 thradLocal 对应的值,值的类型是由 thradLocal 的泛型决定的 // 由于 thradLocalMap set 时解决数组索引位置冲突的逻辑,导致 thradLocalMap get 时的逻辑也是对应的 // 首先尝试根据 hashcode 取模数组大小-1 = 索引位置 i 寻找,找不到的话,自旋把 i+1,直到找到索引位置不为空为止 private Entry getEntry(ThreadLocal<?> key) { // 计算索引位置:ThreadLocal 的 hashCode 取模数组大小-1 int i = key.threadLocalHashCode & (table.length - 1); Entry e = table[i]; // e 不为空,并且 e 的 ThreadLocal 的内存地址和 key 相同,直接返回,否则就是没有找到,继续通过 getEntryAfterMiss 方法找 if (e != null && e.get() == key) return e; else // 这个取数据的逻辑,是因为 set 时数组索引位置冲突造成的 return getEntryAfterMiss(key, i, e); } // 自旋 i+1,直到找到为止 private Entry getEntryAfterMiss(ThreadLocal<?> key, int i, Entry e) { Entry[] tab = table; int len = tab.length; // 在大量使用不同 key 的 ThreadLocal 时,其实还蛮耗性能的 while (e != null) { ThreadLocal<?> k = e.get(); // 内存地址一样,表示找到了 if (k == key) return e; // 删除没用的 key if (k == null) expungeStaleEntry(i); // 继续使索引位置 + 1 else i = nextIndex(i, len); e = tab[i]; } return null; } ``` # 6 扩容 ThreadLocalMap 中的 ThreadLocal 的个数超过阈值时,ThreadLocalMap 就要开始扩容了,我们一起来看下扩容的逻辑: ```java private void resize() { // 拿出旧的数组 Entry[] oldTab = table; int oldLen = oldTab.length; // 新数组的大小为老数组的两倍 int newLen = oldLen * 2; // 初始化新数组 Entry[] newTab = new Entry[newLen]; int count = 0; // 老数组的值拷贝到新数组上 for (int j = 0; j < oldLen; ++j) { Entry e = oldTab[j]; if (e != null) { ThreadLocal<?> k = e.get(); if (k == null) { e.value = null; // Help the GC } else { // 计算 ThreadLocal 在新数组中的位置 int h = k.threadLocalHashCode & (newLen - 1); // 如果索引 h 的位置值不为空,往后+1,直到找到值为空的索引位置 while (newTab[h] != null) h = nextIndex(h, newLen); // 给新数组赋值 newTab[h] = e; count++; } } } // 给新数组初始化下次扩容阈值,为数组长度的三分之二 setThreshold(newLen); size = count; table = newTab; } ``` 源码注解也比较清晰,我们注意两点: 扩容后数组大小是原来数组的两倍; 扩容时是绝对没有线程安全问题的,因为 ThreadLocalMap 是线程的一个属性,一个线程同一时刻只能对 ThreadLocalMap 进行操作,因为同一个线程执行业务逻辑必然是串行的,那么操作 ThreadLocalMap 必然也是串行的。 # 7 总结 ThreadLocal 是非常重要的 API,我们在写一个中间件的时候经常会用到,比如说流程引擎中上下文的传递,调用链ID的传递等等,非常好用,但坑也很多。

优秀的个人博客,低调大师

HashMap 源码解析(二)

上篇文章介绍了hashMap 的基本数据结构和put() get() resize()流程 传送门 现在我们来介绍 hashmap 剩下的一些方法hashMap 有些情况下会进行遍历操作,hashMap 支持提供了三种遍历方法 1 keySet() 官方注释是@return a set view of the keys contained in this map(返回map的key set) public Set<K> keySet() { Set<K> ks = keySet; if (ks == null) { ks = new KeySet(); keySet = ks; } return ks; } 这个方法反回了一个KeySet类 看看这个KetSet是个什么啥 final class KeySet extends AbstractSet<K> { public final int size() { return size; } public final void clear() { HashMap.this.clear(); } public final Iterator<K> iterator() { return new KeyIterator(); } public final boolean contains(Object o) { return containsKey(o); } public final boolean remove(Object key) { return removeNode(hash(key), key, null, false, true) != null; } public final Spliterator<K> spliterator() { return new KeySpliterator<>(HashMap.this, 0, -1, 0, 0); } public final void forEach(Consumer<? super K> action) { Node<K,V>[] tab; if (action == null) throw new NullPointerException(); if (size > 0 && (tab = table) != null) { int mc = modCount; for (int i = 0; i < tab.length; ++i) { for (Node<K,V> e = tab[i]; e != null; e = e.next) action.accept(e.key); } if (modCount != mc) throw new ConcurrentModificationException(); } } } KeySet是hashMap的内部类,没有没有写任何逻辑,如何去遍历这个KeySet的关键在于iterator() 不管是使用迭代器还是使用for加强循环,核心的东西都是这个迭代器下面继续看KeyIterator.class 是个什么东西 final class KeyIterator extends HashIterator implements Iterator<K> { public final K next() { return nextNode().key; } } 可以看到 这个迭代器继承于HashIterator ,仅重写了next() 方法,结合HashIterator代码一起分析 abstract class HashIterator { Node<K,V> next; // next entry to return Node<K,V> current; // current entry int expectedModCount; // for fast-fail int index; } 首先在迭代器初始化时 HashIterator() { expectedModCount = modCount; //将hashMap操作次数赋值给expectedModCount, //在其他线程操作该hashMap后 预期值和实际值不同直接抛出异常,类似于cas Node<K,V>[] t = table; //将hashMap的数据集赋值给 t current = next = null; //设置迭代器的当前节点和下一个节点为空 index = 0; //hashMap table 游标设置为0 if (t != null && size > 0) { // advance to first entry 判断是不是空map //获取table数组中第一个不为空的链表头节点 do {} while (index < t.length && (next = t[index++]) == null); } } ok,现在迭代器初始化完成,迭代器的两大核心方法为hasNext() 判断是否存在下一条数据 和next() 获取下一条数据并将next指向下一条数据1 hashNext(),很简单,判断next是不是为空就可以 public final boolean hasNext() { return next != null; } 2 next():抽象类HashIterator 没有定义该方法,是因为next() 有返回值,需要子类去自己定义返回值,HashIterator 将公用操作定义为nextNode方法 KeySet的迭代器KeyIterator 定义的方法为 public final K next() { return nextNode().key; } HashIterator.nextNode()方法如下,方法很短,但是操作很多 final Node<K,V> nextNode() { Node<K,V>[] t; Node<K,V> e = next; //获取next if (modCount != expectedModCount) //判断 hashMap是否被其他线程修改过 throw new ConcurrentModificationException(); if (e == null)//判断下一个节点是不是为空 throw new NoSuchElementException(); // 下面的操作比较复杂我们拆成多步操作 /** current = e;// 将current next = current.next; //next赋值为current的下一个节点 t=table; if(next == null&&t != null){//如果next为链表最后一个节点 do {} while (index < t.length && (next = t[index++]) == null); // 数组游标++ 一直找到数组的下一个有数据的节点的头节点,假如是最后一个节点则跳出循环,next =null }**/ if ((next = (current = e).next) == null && (t = table) != null) { do {} while (index < t.length && (next = t[index++]) == null); } return e; } 2 values() values().iterator() 返回了一个ValueIterator() final class ValueIterator extends HashIterator implements Iterator<V> { public final V next() { return nextNode().value; } } next() 方法也是调用HashIterator.nextNode()方法,只不过是去的value; 3 entrySet() 上代码 final class EntryIterator extends HashIterator implements Iterator<Map.Entry<K,V>> { public final Map.Entry<K,V> next() { return nextNode(); } } 直接返回了整个node节点 hashMap遍历顺序 从nextNode()方法可以看出,hashMap在通过上述三种方法遍历时,都是从table数组 从小下标到大下标,如果发生hash冲突导致链表的,优先遍历链表,因此hashMap的遍历和插入顺序是不同的,和hashCode()有关 ,按照插入顺序遍历hashMap可以使用LinkedHashMap ,具体用法后面会继续写

优秀的个人博客,低调大师

python Kmeans算法解析

一. 概述 首先需要先介绍一下无监督学习,所谓无监督学习,就是训练样本中的标记信息是位置的,目标是通过对无标记训练样本的学习来揭示数据的内在性质以及规律。通俗得说,就是根据数据的一些内在性质,找出其内在的规律。而这一类算法,应用最为广泛的就是“聚类”。 聚类算法可以对数据进行数据归约,即在尽可能保证数据完整的前提下,减少数据的量级,以便后续处理。也可以对聚类数据结果直接应用或分析。 而Kmeans 算法可以说是聚类算法里面较为基础的一种算法。 二. 从样例开始 我们现在在二维平面上有这样一些点 x y 1.658985 4.285136 -3.453687 3.424321 4.838138 -1.151539 -5.379713 -3.362104 0.972564 2.924086 -3.567919 1.531611 0.450614 -3.302219 -3.487105 -1.724432 2.668759 1.594842 -3.156485 3.191137 3.165506 -3.999838 -2.786837 -3.099354 4.208187 2.984927 -2.123337 2.943366 0.704199 -0.479481 -0.392370 -3.963704 2.831667 1.574018 -0.790153 3.343144 2.943496 -3.357075 ... 它在二维平面上的分布大概是这样的: 好,这些点看起来隐约分成4个“簇”,那么我们可以假定它就是要分成4个“簇”。(虽然我们可以“看”出来是要分成4个“簇”,但实际上也可以分成其他个,比如说5个。)这里分成“4个簇“是我们看出来的。而在实际应用中其实应该由机器算得,下面也会有介绍的。 找出4个”簇”之后,就要找出每个“簇”的中心了,我们可以“看出”大概的中心点,但机器不知道啊。那么机器是如何知道的呢?答案是通过向量距离,也叫向量相似性。这个相似性计算有多种方法,比如欧式距离,曼哈顿距离,切比雪夫距离等等。 我们这里使用的是欧式距离,欧式距离其实就是反应空间中两点的直线距离。 知道这些后,我们就可以开始让机器计算出4个“簇”了。 主要做法是这样,先随机生成4个点,假设这4个点就是4个“簇”的中心。计算平面中每个点到4个中心点的距离,平面中每个点选取距离最近的那个中心作为自己的中心。 此时我们就完成第一步,将平面中所有点分成4个”簇“。但是刚刚那几个中心都是随机的,这样分成的4个簇明显不是我们想要的结果。怎么办呢?做法如下: 现在有4个簇,根据每个簇中所有点计算出每个簇的新中心点。这个新中心点就会比上一个旧的中心点更优,因为它更加中心。然后使用新中心点重复第一步的步骤。即再对平面中所有点算距离,然后分发到4个新簇中。不断迭代,直到误差较小。 这就是 Kmeans 算法的过程了。 三. 知识点浅析 3.1 确定“簇”的个数 上面所说的分成 4 个簇,这个 4 其实就是 Kmeans 中的K。要使用 Kmeans 首先就是要选取一个 K 作为聚类个数。而上面的例子其实是我们主观”看“出来的,但多数情况下我们是无法直观”看“出分多少个 K 比较好。那怎么办呢? 我们可以从较低的 K 值开始。使用较简单的 Kmeans 算法的结果(即较少的迭代次数,不求最佳结果,但求最快)。计算每个点到其归属的“簇”的中心点的距离,然后求和,求和结果就是误差值。然后再增加 K 值,再计算误差值。比如上面的例子,我们可以从 K=2 开始,计算 K 值从 2 到 7 的 Kmeans 算法的误差值。这样会得到类似这样一张图: 里面的 Error 可以理解未 Kmeans 的误差,而当分成越多“簇”的适合,误差肯定是越来越小。 但是不是“簇”越多越好呢?答案是否定的,有时候“簇”过多的话是不利于我们得到想要的结果或是做下一步操作的。 所以我们通常会选择误差减小速度比较平缓的那个临界点,比如上图中的 4。 可以发现,在分成 4 个簇之后,再增加簇的数量,误差也不会有很大的减少。而取 4 个簇也和我们所看到的相符。 3.2 欧式距离 3.2 欧式距离 欧氏距离是一个通常采用的距离定义,指在m维空间中两个点之间的真实距离,计算公式如下: 而本例种的是在二维空间种,故而本例的计算公式如下: 四. 代码和结果 加载数据的代码,使用了 numpy ,先是将代码加载成 matrix 类型。 import numpy as np def loadDataSet(fileName): ''' 加载数据集 :param fileName: :return: ''' # 初始化一个空列表 dataSet = [] # 读取文件 fr = open(fileName) # 循环遍历文件所有行 for line in fr.readlines(): # 切割每一行的数据 curLine = line.strip().split('\t') # 将数据转换为浮点类型,便于后面的计算 # fltLine = [float(x) for x in curLine] # 将数据追加到dataMat fltLine = list(map(float,curLine)) # 映射所有的元素为 float(浮点数)类型 dataSet.append(fltLine) # 返回dataMat return np.matrix(dataSet) 接下来需要生成 K 个初始的质点,即中心点。这里采用随机生成的方法生成 k 个“簇”。 def randCent(dataMat, k): ''' 为给定数据集构建一个包含K个随机质心的集合, 随机质心必须要在整个数据集的边界之内,这可以通过找到数据集每一维的最小和最大值来完成 然后生成0到1.0之间的随机数并通过取值范围和最小值,以便确保随机点在数据的边界之内 :param dataMat: :param k: :return: ''' # 获取样本数与特征值 m, n = np.shape(dataMat) # 初始化质心,创建(k,n)个以零填充的矩阵 centroids = np.mat(np.zeros((k, n))) # 循环遍历特征值 for j in range(n): # 计算每一列的最小值 minJ = min(dataMat[:, j]) # 计算每一列的范围值 rangeJ = float(max(dataMat[:, j]) - minJ) # 计算每一列的质心,并将值赋给centroids centroids[:, j] = np.mat(minJ + rangeJ * np.random.rand(k, 1)) # 返回质心 return centroids 欧式距离计算 def distEclud(vecA, vecB): ''' 欧氏距离计算函数 :param vecA: :param vecB: :return: ''' return np.sqrt(sum(np.power(vecA - vecB, 2))) cost 方法将执行一个简化的 kMeans ,即较少次数的迭代,计算出其中的误差(即当前点到簇质心的距离,后面会使用该误差来评价聚类的效果) def cost(dataMat, k, distMeas=distEclud, createCent=randCent,iterNum=300): ''' 计算误差的多少,通过这个方法来确定 k 为多少比较合适,这个其实就是一个简化版的 kMeans :param dataMat: 数据集 :param k: 簇的数目 :param distMeans: 计算距离 :param createCent: 创建初始质心 :param iterNum:默认迭代次数 :return: ''' # 获取样本数和特征数 m, n = np.shape(dataMat) # 初始化一个矩阵来存储每个点的簇分配结果 # clusterAssment包含两个列:一列记录簇索引值,第二列存储误差(误差是指当前点到簇质心的距离,后面会使用该误差来评价聚类的效果) clusterAssment = np.mat(np.zeros((m, 2))) # 创建质心,随机K个质心 centroids = createCent(dataMat, k) clusterChanged = True while iterNum > 0: clusterChanged = False # 遍历所有数据找到距离每个点最近的质心, # 可以通过对每个点遍历所有质心并计算点到每个质心的距离来完成 for i in range(m): minDist = np.inf minIndex = -1 for j in range(k): # 计算数据点到质心的距离 # 计算距离是使用distMeas参数给出的距离公式,默认距离函数是distEclud distJI = distMeas(centroids[j, :], dataMat[i, :]) # print(distJI) # 如果距离比minDist(最小距离)还小,更新minDist(最小距离)和最小质心的index(索引) if distJI < minDist: minDist = distJI minIndex = j # 更新簇分配结果为最小质心的index(索引),minDist(最小距离)的平方 clusterAssment[i, :] = minIndex, minDist ** 2 iterNum -= 1; # print(centroids) # 遍历所有质心并更新它们的取值 for cent in range(k): # 通过数据过滤来获得给定簇的所有点 ptsInClust = dataMat[np.nonzero(clusterAssment[:, 0].A == cent)[0]] # 计算所有点的均值,axis=0表示沿矩阵的列方向进行均值计算 centroids[cent, :] = np.mean(ptsInClust, axis=0) # 返回给定迭代次数后误差的值 return np.mat(clusterAssment[:,1].sum(0))[0,0] 最后可以调用 Kmeans 算法来进行计算。 def kMeans(dataMat, k, distMeas=distEclud, createCent=randCent): ''' 创建K个质心,然后将每个店分配到最近的质心,再重新计算质心。 这个过程重复数次,直到数据点的簇分配结果不再改变为止 :param dataMat: 数据集 :param k: 簇的数目 :param distMeans: 计算距离 :param createCent: 创建初始质心 :return: ''' # 获取样本数和特征数 m, n = np.shape(dataMat) # 初始化一个矩阵来存储每个点的簇分配结果 # clusterAssment包含两个列:一列记录簇索引值,第二列存储误差(误差是指当前点到簇质心的距离,后面会使用该误差来评价聚类的效果) clusterAssment = np.mat(np.zeros((m, 2))) # 创建质心,随机K个质心 centroids = createCent(dataMat, k) # 初始化标志变量,用于判断迭代是否继续,如果True,则继续迭代 clusterChanged = True while clusterChanged: clusterChanged = False # 遍历所有数据找到距离每个点最近的质心, # 可以通过对每个点遍历所有质心并计算点到每个质心的距离来完成 for i in range(m): minDist = np.inf minIndex = -1 for j in range(k): # 计算数据点到质心的距离 # 计算距离是使用distMeas参数给出的距离公式,默认距离函数是distEclud distJI = distMeas(centroids[j, :], dataMat[i, :]) # 如果距离比minDist(最小距离)还小,更新minDist(最小距离)和最小质心的index(索引) if distJI < minDist: minDist = distJI minIndex = j # 如果任一点的簇分配结果发生改变,则更新clusterChanged标志 if clusterAssment[i, 0] != minIndex: clusterChanged = True # 更新簇分配结果为最小质心的index(索引),minDist(最小距离)的平方 clusterAssment[i, :] = minIndex, minDist ** 2 # print(centroids) # 遍历所有质心并更新它们的取值 for cent in range(k): # 通过数据过滤来获得给定簇的所有点 ptsInClust = dataMat[np.nonzero(clusterAssment[:, 0].A == cent)[0]] # 计算所有点的均值,axis=0表示沿矩阵的列方向进行均值计算 centroids[cent, :] = np.mean(ptsInClust, axis=0) # 返回所有的类质心与点分配结果 return centroids, clusterAssment 选取不同的 k 值对结果影响有多大呢?我们来看看就知道了,下面给出的是 k 值为 2 到 6 的效果。图中红色方块即为“簇”的中心点,每个“簇”所属的点用不同的颜色表示。K = 2 K = 3 K = 4 K = 5 K = 6

优秀的个人博客,低调大师

NGINX配置PHP解析

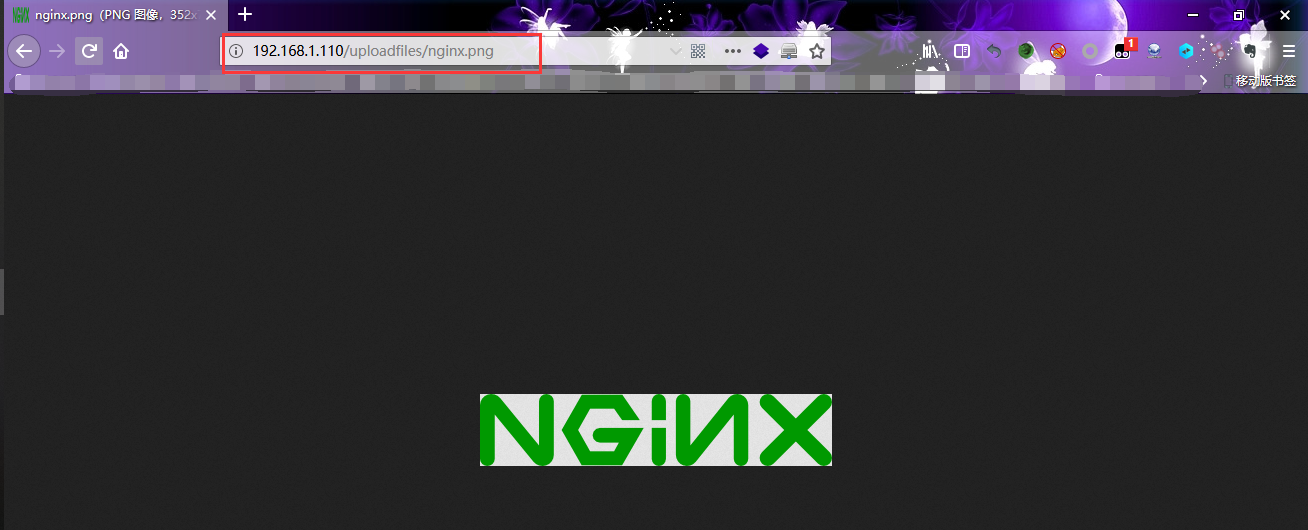
<?php phpinfo(); ?> location ~ \.php$ { root html; fastcgi_pass 127.0.0.1:9000; fastcgi_index index.php; fastcgi_param SCRIPT_FILENAME usr/local/nginx/html$fastcgi_script_name; include fastcgi_params; } ------------------------------------------------------------- 作者: 罗穆瑞 出处: http://www.cnblogs.com/kazihuo/ 转载请保留此段声明,且在文章页面明显位置给出原文链接,谢谢! ------------------------------------------------------------------------------ 如果觉得这篇文章对你有小小的帮助的话,记得在右下角点个“推荐”哦,博主在此感谢! ------------------------------------------------------------------------------

优秀的个人博客,低调大师

springboot源码解析(一)

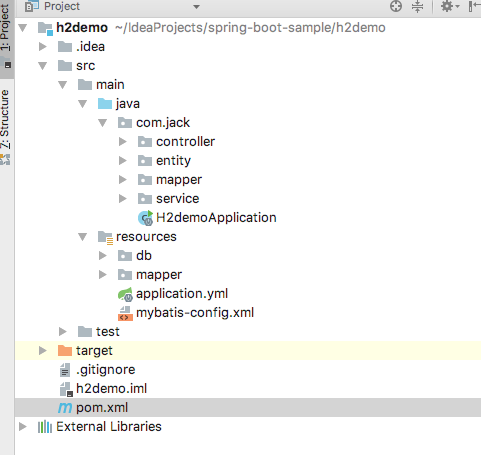
SpringBoot应用基础结构 我们每创建一个springboot应用就会发现,其目录结构中都会有一个以应用名为首的Application类(下文中都直接称为Application类),而其他包都是在这个类的同级或子级下面,结构如图: Application类作为应用的启动类,位于项目源码的根目录中,至于为什么结构会这么安排,我们下面会说。 Application类的结构 如上图所示,我们可以看到,最关键的地方有两个: @SpringBootApplication注解 SpringApplication.run()方法 任何的springboot应用都会由这两个部分组成。接下来我就来就这两个地方分析源码。 @SpringBootApplication注解 打开注解的源码我们可以看到,主要由以下几个注解组成: @SpringBootConfiguration @EnableAutoConfiguration @ComponentScan @SpringBootConfiguration @SpringBootConfiguration注解是由@Configuration来注解的,因此也就表示Application类本身就是一个bean。虽然@SpringBootConfiguration注释中说该注解一个应用中只能用一次,但是配置多个也不会报错,只是建议在一个应用中只用一次,并且该注解也可以与@Configuration互换。 @ComponentScan @ComponentScan注解的功能与我们之前在xml文件配置的的功能是一样的,而上面也提到Application类放在源码的根目录下,其实就是与这个注解有关。@ComponentScan在没有指明basePackages忏属性的时候,默认会扫描该注解所在的类的包及其子包下的所有@Component注解过的类,包括@Controller,@Service,@Configuration这些注解。这也就是为什么我们不用做任何配置,就可以将springboot应用中的类扫描为bean。 @EnableAutoConfiguration @EnableAutoConfiguration注解,从名字我们也可以看出,是开启自配置配置的。从源码中我们可以看到,该注解中有一个@Import(AutoConfigurationImportSelector.class),而其中发挥自动配置作用就是AutoConfigurationImportSelector类。 从AutoConfigurationImportSelector的源码中可以知道,该类是通过SpringFactoriesLoader来加载自动配置的类的,从而进一步通过这些自动配置的类来完成默认配置。从而这也就解决了,为什么我们使用springboot的时候压根就不需要配置太多,原因就是因为SpringBoot通过自动配置将已经封装在jar包中的自动配置类加载进来生成了bean。而对于SpringFactoriesLoader的原理我们下面会说。 SpringApplication类 Application类是通过SpringApplication类的静态run方法来启动应用的。打开这个静态方法,该表态方法真正执行的是两部分: new SpringApplication() 执行对象run()方法 在SpringApplication的构造方法中,我们可以看到有如下几个步骤: 推断当前的环境是否是web环境,其中springboot2.0中又添加了reactive环境。 初始化ApplicationContextInitilizer,其中的原理也是通过SpringFactoriesLoader来实现的。 初始化ApplicationListener,原理同上。 推断当前启动的main方法所在的类。 推断当前应用环境 springboot在启动时需要推断当前的应用环境,springboot2.0当中一共定义了三种环境:none, servlet, reactive。none表示当前的应用即不是一个web应用也不是一个reactive应用,是一个纯后台的应用。servlet表示当前应用是一个标准的web应用。reactive是spring5当中的新特性,表示是一个响应式的web应用。而判断的依据就是根据Classloader中加载的类。如果是servlet,则表示是web,如果是DispatcherHandler,则表示是一个reactive应用,如果两者都不存在,则表示是一个非web环境的应用。 初始化ApplicationContextInitializer 在介绍初始化之前,先介绍一下SpringFactoiesLoader的原理。 SpringFactoiesLoader会扫描所有jar包中的META-INF/spring.factoies文件,该文件的格式都是key=value的格式。key是一个接口的名字,value是实现类的名字,如果value有多个值,则用逗号分隔。而我们上面提到的@EnableAutoConfiguration也是利用这个原理去扫描所有的自动配置类,以该注解的全限定类名作为key,所有的默认配置类为值。SpringFactoiesLoader内部有一个静态的双层ConcurrentMap,用来存储这些key-value,第一层map的key是classloader,springboot默认的classloader是appClassLoader,value则是一个MultiValueMap,是spring自己实现的一个hashmap。而这个MultiValueMap的key就是spring.factoies文件中的key,value是一个list,即spring.factoies文件中的value。SpringFactoiesLoader利用缓存机制,只在第一次扫描所有的META-INF/spring.factoies文件时,就把所有的key-value都加载到这个map中,后面再进从中获取值时,直接从map中取就可以了,就不需要再重新扫描了。 把ApplicationContextInitializer都加载了之后,还要进行一项工作就是会对所有的ApplicationContextInitializer实现类生成对象,SpringApplication中有一个属性,List类型的initializers,用来存储这些实例化后的对象,这些对象存储之后,会在后面的启动过程中初始化ApplicationContext。 初始化ApplicationListener ApplicationListener的过程与ApplicationContextInitializer是一样的,不过因为SpringFactoiesLoader已经扫描过一次了,所以这次执行的时候,就会直接从SpringFactoiesLoader中的静态map中取出值即可。同样的,也需要将所有的实现类生成对象,并保存在SpringApplication对象的listener list属性中。 注:springboot初始化过程中主要是扫描两个spring.factoies文件,其中定义的key-value中的类,是整个启动过程中要用到的。一个是spring-boot-2.0.3.RELEASE中的,一个是spring-boot-autoconfigure包中的。这两个jar包中的文件定义整个启动流程中要执行的所有默认配置好的类。 推断整个应用的main方法所在的类 其实我们已经从main方法中启动了,为什么后面还要再推断一下呢?其实这样做的目的,主要是为了将该类的对象存储在SpringApplication的对象中,创建日志Logger和打印日志用的。我们在启动时会看到主类的类名以及其他的打印信息,都是通过该对象来创建logger和打印日志的。 总结:从上面几个步骤中我们可以看出,前期的new SpringApplication()方法中主要是起到了一个预加载的功能,将前期的环境判断,后面要用到的对象都准备好,到run执行的时候就直接拿出来用就好了,也是大大方便了后面run方法执行的过程。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册