首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10007篇文章
优秀的个人博客,低调大师

HBase架构解析

Hbase组件  客户端Client 整个HBase集群的入口 使用HBase RPC机制与HMaster和HRegionserver通信 与HMaster通信进行管理类的操作 与HRegionserver通信进行读写类操作 包含访问HBase的接口,并维护cache来加快对HBase的访问,与HRegionserver交互 程序协调服务Zookeeper 保证任何时候,集群中只有一个Master 存贮所有Region的寻址入口 实时监控Region server的上线和下线信息。并实时通知给Master 存储HBase的schema和table元数据 HBase主节点Master 管理用户对Table的增删改查操作 管理HRegionServer的负载均衡,调整Region分布 在Region Split后,负责新Region的分配 在HRegionServer停机后,负责失效HRegionServer上的Region迁移 HMaster失效仅会导致所有元数据无法被修改,表的数据读写还是可以正常运行 HBase与Zookeeper HBase元数据存储在Zookeeper中 默认情况下,HBase管理Zookeeper示例,比如,启动或停止Zookeeper Zookeeper解决HBase单节点故障问题 HMaster与HRegionserver启动时回向Zookeeper注册 寻找RegionServer过程详解  - Zookeeper(读取Zookeeper找到-ROOT-表的位置) - -ROOT-(-ROOT-表包含.META.表所在的region列表,该表只会有一个Region;Zookeeper中记录了-ROOT-表的location) - .META(这个表包含所有的用户空间region列表,已经RegionServer的服务器地址) - 用户表 - Client第一次操作后,会将-ROOT-和.META.缓存到本地,不需要再访问zookeeper (PS:0.96之后的版本,ZK不再存储ROOT表信息,直接存储META表信息) HBase容错性 Master容错:Zookeeper重新选择一个新的Master 无Master过程中,数据读取仍然照常进行; 无Master中,region切分,负载均衡无法进行; RegionServer容错:定时向Zookeeper汇报心跳,如果一段时间内未出现心跳,master将该RegioinServer上的Region重新分配到其他RegionServer上;失效服务器上“预写”日志由服务器进行分割并派送给新的ReginServer zookeeper容错:Zookeeper高可靠的服务,不存在单点故障

优秀的个人博客,低调大师

柱面模型解析

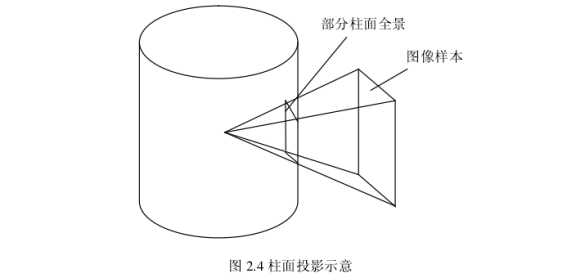
柱面全景是最为简单的全景虚拟。所谓柱面全景,可以理解为以节点为中心的具有一定高度的圆柱形的平面,平面外部的景物投影在这个平面上。如图所示。 用户可以在全景图像中 360 度的范围内任意切换视线,也可以在一个视线上改变视角,来取得接近或远离的效果,也可以认为是球面全景图的一种简化。用户在水平方向上有 360度的视角,在垂直方向上也可以做一定的视角变化,但是角度范围则受到限制。由于柱面模型的图像质量均匀,细节真实程度更高,应用范围比较广泛。 柱面全景图像也较为容易处理,因为可以将圆柱面沿轴向切开并展开在一个平面上,传统的图像处理方法常常可以直接使用。柱面全景图像并不要求照相机的标定十分准确。所以将柱面全景图显著优点归纳为以下两点: 1)它的单幅照片的获取方式比立方体形式和球面形式的获取方式简单。所需的设备只有普通的相机和一个允许连续“转动”的三角架。 2)柱面全景图容易展开为一个矩形图像,可直接用计算机常用的图像格式进行存储和访问。虽然柱面形式的全景图在垂直方向允许参与者视线的转动角度小于 180 度,但是在绝大多数应用中,水平方向的 360 度环视场景已足以表达空间信息。//ConsoleApplication.cpp:定义控制台应用程序的入口点。 //#include"stdafx.h"usingnamespacestd;usingnamespacecv;#definePI3.14159int_tmain(intargc,_TCHAR*argv[]){Matsrc=imread("e:/template/Univ4.jpg");Matresult=src.clone();for(inti=0;i<result.rows;i++){for(intj=0;j<result.cols;j++)result.at<Vec3b>(i,j)=0;}intW=src.cols;intH=src.rows;floatr=W/(2*tan(PI/6));floatk=0;floatfx=0;floatfy=0;for(inti=0;i<src.rows;i++){for(intj=0;j<src.cols;j++){k=sqrt((float)(r*r+(W/2-j)*(W/2-j)));fx=r*sin(PI/6)+r*sin(atan((j-W/2)/r));fy=H/2+r*(i-H/2)/k;intix=(int)fx;intiy=(int)fy;if(ix<W&&ix>=0&&iy<H&&iy>=0)result.at<Vec3b>(iy,ix)=src.at<Vec3b>(i,j);}}imshow("src",src);imshow("result",result);waitKey();return0;} 来自为知笔记(Wiz) 目前方向:图像拼接融合、图像识别 联系方式:jsxyhelu@foxmail.com

优秀的个人博客,低调大师

PaaS架构解析

一、PaaS的发展简史 PaaS作为新一代的云计算平台,目前在业界得到了广泛的关注与讨论。诸多大公司也纷纷推出自己的PaaS平台,比如Pivotal的CloudFoundry, IBM的Bluemix和Redhat的OpenShift等。其实在此之前, PaaS已经有很长一段时间的发展历程。在2007年,Salesforce最早发布force.com,其目的是支持第三方客户在Salesforce.com上开发和部署定制软件,它基本使用的元数据驱动的方式来开发和管理应用。在2008年4月的时候,技术巨头Google发布GAE(Google AppEngine),其目的是争夺独立开发者和创业公司的市场。GAE在发布之时就得到了业界的广泛关注,在很多方面都突破了原有的技术思路,比如使用容器来部署应用,简化的用户体验等。但是,我们也看到,GAE在业务上并没有获得巨大的成功,后面的发展也证明AWS的策略更加成功。一年之后,新浪SAE也发布,其命名、发展思路与架构模式和GAE非常类似,当然,业务上也同样不太成功。 AWS也看到了PaaS平台的潜力,与2011年发布其官方PaaS平台Beanstalk。在Beanstalk之前,几乎所有的PaaS平台都是基于Linux容器技术LXC。AWS提供了另外一种打造PaaS平台的思路,即基于虚拟机完成应用的自动部署和运维,同时Beanstalk也提供了自动弹性伸缩的功能。容器和虚拟机主要是在资源利用率、安全性和隔离性上有所差别。 CloudFoundry是另外一个里程碑式的PaaS产品,在推出之日就吸引了诸多的焦点,甚至带动了PaaS搜索关键字在Google趋势里面搜索量的飚升。CloudFoundry的成功有这样几个原因:首先它是开源的和免费的。开放源代码意味着全球所有的开发者都能非常简单的部署自己的PaaS平台,同时也意味着让所有的开发者看到打造一个PaaS平台需要哪些关键的技术;其次,CloudFoundry是开放的,它能够支持多种编程语言和开发框架,也能够提供多种服务类型,虽然CloudFoundry的架构经过了几次重构,但是开放性这个关键的特性一直都保留;第三,CloudFoundry提供了一个极简的用户体验,开发人员只需要简单的几个命令就能部署自己的应用系统,彻底颠覆了之前的用户体验。当然,这种用户体验最早是来自于Heroku。 最后值得一提的是大热的Docker。Linux容器技术已经出现了很多很多年,在各大互联网巨头公司也使用了很多很多年,但是Docker利用AUFS技术第一次将容器实例镜像化,这一突破性的创新能够让容器实例可复制、可迁移、可重用。该思路彻底打破了以前只有使用虚拟机才能迁移实例的局限,所以迅速在业界得到追捧。Docker的东家DotCloud甚至把自己的PaaS平台卖掉以专心发展该项技术。 目前来看,PaaS平台技术还处于群雄逐鹿的状态,诸多技术巨头都在不遗余力的发展自己的PaaS平台以跟上技术发展的脚步。以此同时,独立的PaaS提供商(如Heroku、AppFog)等也纷纷被技术巨头收购,这带来了一种质疑的声音是PaaS是否真的能够成为一项独立可持续发展的业务模式。下文将会对此做一些简单的探讨。 二、PaaS架构比较 大致来看,PaaS的实现分为两种:以虚拟机为基础或是以容器为基础。前者的代表是AWS,后者的代表则是GAE, CloudFoundry和Heroku。前文已经提到,AWS是基于虚拟机技术来打造自己的PaaS平台,其架构模式大致如下图所示: 具体而言,AWS基于如下构件打造了Beanstalk:首先是负载均衡层(ELB),该层需要将用户的请求投射到对应的服务器实例,同时,负载均衡层还需要。当应用实例出现扩容时,需要动态将调整的服务器实例注册到对应的域名上,以完成分流;中间是Web服务器层,目前ElasticBean支持Java、Python和PHP等多种编程语言,尽量为编程人员提供多样性的选择,开放性基本是所有PaaS平台的标配。在服务后端,Beanstalk基本依托于AWS本身的服务生态系统为应用提供服务,比如RDS、S3、DynamoDB等。 CloudFoundry等平台则是基于容器技术打造。相比于虚拟机,容器带来的系统开销非常低,如果一台虚拟机的操作系统需要占用2G的内存,则7个虚拟机所组成的集群只是操作系统就需要14G的内存占用。基于容器的技术如果一台16G的裸机除去2G的操作系统开销,还能够部署7个容器进程。所以,从经济性来说,容器的技术远远好于虚拟机。另外一个比较的标准是性能,容器的性能相对而言更好一些,具体的比较参数可以参见IBM研究院刚刚出的报告【1】。但是,从安全性和隔离型来说,虚拟机是远远好于容器的。 CloudFoundry的架构设计如下图所示。首先,CF也提供了一个路由模块(Router),该模块基本是基于ngnix打造,只是在ngnix技术上提供了动态注册的功能。在部署时,由于CF会同时部署非常多的应用实例,所以需要一个router集群来满足应用的需要;其次,CF的应用容器基于自己开发的warden技术,warden也是基于LXC技术,但是使用c和ruby作了一层简单的封装。Docker的大热让CloudFoundry很纠结;第三,CF使用service broker来集成各种资源服务,如mongo、mysql、rabbitmq和redis等。最后,CF使用消息总线NATS/GNATS来完成应用之间的通讯。 其他基于容器的PaaS平台(如Heroku、OpenShift、DotCloud)的平台架构和上面所描述的模式基本一致,我在附件中提供了若干链接,大家如果有兴趣可以仔细研究。 三、PaaS的参考架构模式 根据上面讨论的两种架构模式,我们可以看到PaaS平台的实现基本需要如下的构件: 路由模块:该模块的基本功能是将终端用户请求路由到对应的服务器实例,并提供应用动态注册等功能。目前绝大多数的实现是基于ngnix,同时也需要使用简单的lua脚本完成应用注册和路由查询等基本功能; 服务管理模块:该模块会为开发人员和运维人员提供管理接口,其基本功能包括创建应用实例、配置应用运行参数、启停应用、发布应用程序、扩容或缩容等。服务管理模块也需要提供相应的客户端被用户使用,如命令行或是用户界面等; 应用容器模块:应用容器是PaaS平台的核心,其主要功能是管理应用实例的生命周期,汇报应用的运行状态等。目前来看,应用容器可以基于虚拟机来实现(如AWS),也可以使用Linux容器技术来实现,最早使用的是LXC,CloudFoundry使用的是自己的warden,同样也是基于cgroup,现在最新的是docker; 应用部署模块:应用部署模块需要将应用程序打包成为可直接部署的发布包。该模块是实现PaaS平台开发性的关键。由于现有通用的PaaS平台需要支持多种编程语言和框架,如Java, Python, Ruby和PHP等,当应用发布时,PaaS平台需要根据不同的编程语言将应用打包成为通用的发布包,然后传递给容器模块部署。应用部署模块是实现这一过程的关键,目前来看起源于Heroku的buildpack已经被大家广发接受; 块存储模块:该模块主要用于存储应用的发布包,需要保证程序包的长久存储和。目前AWS的Beanstalk直接使用S3,CF可以使用网络文件系统NFS或是其他任何分布式文件存储系统(如HBase); 数据存储模块:该模块需要保存应用和服务的基本信息,可以基于任何现有的数据库技术实现,如MYSQL或是MONGODB等; 监控模块:该模块的作用是持续监控应用的运行状态,比如健康状态(是否存活)、资源使用率(CPU、内存、硬盘、网络等)和可用性等。这些指标会成为整个PaaS平台运维的关键,也为自动弹性伸缩奠定基础; 用户认证模块:该模块需要保证应用程序的安全性和隔离性,通常而言,公有云的提供商会使用OAuth等技术集成现有的用户认证服务; 消息总线模块:该模块也是最重要的模块,由于PaaS平台所搭建的是一个大规模分布式环境,通常而言,规模在数百台到上千台的机器数量,所有模块之间的通讯会变成一个核心的问题。所以消息总线会变成系统之间通讯的基础,通常需要支持pub/sub模式。 基于该架构,应用实例的弹性伸缩也能够非常容易的实现。首先需要监控服务来不断获取实时的应用状态,当某些指标超出预先定义的阈值时,平台会启动伸缩服务,首先从应用容器模块预留资源,然后调用应用部署模块打包应用并部署,最后将应用节点注册到路由模块完成整个伸缩的过程。 四、PaaS未来发展的趋势 PaaS通过开放性的设计,能够支持多种不同的编程语言、技术框架和服务,从而为应用开发人员提供了广泛的选择,能够大大提供开发人员的效率。同时,PaaS也从运维层面为企业提供了强大的支持,将以前很难实现的技术场景(如应用弹性伸缩等)转化为可能。最后,基于容器技术实现的PaaS平台也带来了经济性的优势。所以,相比于现有纯资源型的IaaS平台,PaaS确实将云计算平台提升到一个新的高度,距离应用开发更近了一步。

优秀的个人博客,低调大师

Paint类解析

在自定义组件中,Paint类是一个很重要的类,主要包含颜色、文本、图形样式、位图模式、滤镜等几个方面。Paint类的相关方法如下: 1、颜色是指绘图时使用的颜色,在 Android 中颜色可以指定透明度,使用 16 进制来表示颜色 时,格式通常为#AARRGGBB,其中,AA 表示透明度、RR 表示红色、GG 表示绿色、BB 表示蓝色, Color 类定义了颜色信息,内置了常用颜色的 int 型常量,比如 Color.RED 是红色,Color.BLUE 是 蓝色……如果您习惯了 16 进制的颜色, Color 类的静态方法 parseColor(String colorString)可以将 16进制颜色转换成 Color 类型。需要注意的是,Android 的颜色都是 int 类型的,Color 类只负责颜色的管理而不是代表某种颜色。 Paint 类中与颜色相关的方法有: public native void setColor(int color);//设置颜色 public native void setAlpha(int a);//设置透明度,a 的范围取 0~255 之间的整数 public void setARGB(int a,int r,int g,int b);//指定透明度、红、绿、蓝定义一种颜色 2、绘制文本时,可以指定文本的大小、对齐方式、文本样式等属性,文本样式主要是为文本指定粗体、下划线、删除线等修饰性属性,主要说明下设置字体大小这个: public native void setTextSize(float textSize);// 设置文本大小,单位是 px,这个和我们平时使用的字体单位 sp 不同,所以最好进行转换,这个要注意。 比较麻烦的是绘制文字时,我们还要考虑字体的基本结构,字体的信息使用 Paint.FontMetrics 类来表示,该类源码如下: public static class FontMetrics { public float ascent; public float bottom; public float descent; public float leading; public float top; } 从文字上理解可能比较晦涩,看下示意图也许很容易找到答案: 简单来说,常用字符的高度是 ascent 和 descent 的和,但是,一些特殊字符比如拼音的音调等则会延伸到 top 的位置。 baseline:基准点(绿色虚线所指); ascent:baseline 之上至字符最高处的距离; descent:baseline 之下至字符最低处的距离; top:字符可达最高处到 baseline 的值,即 ascent 的最大值; bottom:字符可达最低处到 baseline 的值,即 descent 的最大值。 leading:行间距,表示上一行字符的descent到该行字符的ascent之间的距离 根据世界范围内已入案的使用语言中能够标注在字符上方或者下方的除了类似的符号肯定是数不胜数的,一般情况下我们极少使用到类似的符号所以往往会忽略掉这些符号的存在,但是Android依然会在绘制文本的时候在文本外层留出一定的边距,这就是为什么 top和bottom总会比ascent和descent大一点的原因。而在TextView中我们可以通过xml设置其属性 android:includeFontPadding="false"去掉一定的边距值但是不能完全去掉。 要获取 FontMetrics 对象,调用 Paint 类的 getFontMetrics()即可,而在 drawText()方法中,参数 y 就是 baseline 的值,因为 FontMetrics 类并没有声明 baseline 属性,所以,我们需要通过下面的公式计算出来: int baseline=(int) (viewHeight - fontMetrics.descent - fontMetrics.ascent) /2; 其中,viewHeight 是文字所在区域的高度。 下面自定义一个文本绘制的View public class TextView1 extends View { private static final String TEXT = "Android自定义"; private Paint paint; public TextView1(Context context) { super(context); } public TextView1(Context context, AttributeSet attrs) { super(context, attrs); paint = new Paint(Paint.ANTI_ALIAS_FLAG); paint.setColor(Color.RED); FontMetrics fontMetrics = paint.getFontMetrics(); Log.d("xmr", "ascent:" + fontMetrics.ascent); Log.d("xmr", "top:" + fontMetrics.top); Log.d("xmr", "leading:" + fontMetrics.leading); Log.d("xmr", "descent:" + fontMetrics.descent); Log.d("xmr", "bottom:" + fontMetrics.bottom); } public TextView1(Context context, AttributeSet attrs, int defStyleAttr) { super(context, attrs, defStyleAttr); } @Override protected void onDraw(Canvas canvas) { super.onDraw(canvas); // 将文字放在正中间 Rect textRect = this.getTextRect(); int viewWidth = getMeasuredWidth(); int viewHeight = getMeasuredHeight(); Paint.FontMetrics fontMetrics = paint.getFontMetrics(); int x = (viewWidth - textRect.width()) / 2; int y = (int) (viewHeight - fontMetrics.descent - fontMetrics.ascent) / 2; canvas.drawText(TEXT, x, y, paint); } @Override protected void onMeasure(int widthMeasureSpec, int heightMeasureSpec) { Rect rect = getTextRect(); int textWidth = rect.width(); int textHeight = rect.height(); int width = measureWidth(widthMeasureSpec, textWidth); int height = measureHeight(heightMeasureSpec, textHeight); setMeasuredDimension(width, height); } /** * 获取文字所占的尺寸 * * @return */ private Rect getTextRect() { // 根据 Paint 设置的绘制参数计算文字所占的宽度 Rect rect = new Rect(); // 文字所占的区域大小保存在 rect 中 paint.getTextBounds(TEXT, 0, TEXT.length(), rect); return rect; } /** * 测量组件宽度 * * @param widthMeasureSpec * @param textWidth * 文字所占宽度 * @return */ private int measureWidth(int widthMeasureSpec, int textWidth) { int mode = MeasureSpec.getMode(widthMeasureSpec); int size = MeasureSpec.getSize(widthMeasureSpec); int width = 0; if (mode == MeasureSpec.EXACTLY) { // 宽度为 match_parent 和具体值时,直接将 size 作为组件的宽度 width = size; } else if (mode == MeasureSpec.AT_MOST) { // 宽度为 wrap_content,宽度需要计算,此处为文字宽度 width = textWidth; } return width; } /** * 测量组件高度 * * @param heightMeasureSpec * @param textHeight * 文字所占高度 * @return */ private int measureHeight(int heightMeasureSpec, int textHeight) { int mode = MeasureSpec.getMode(heightMeasureSpec); int size = MeasureSpec.getSize(heightMeasureSpec); int height = 0; if (mode == MeasureSpec.EXACTLY) { // 宽度为 match_parent 和具体值时,直接将 size 作为组件的高度 height = size; } else if (mode == MeasureSpec.AT_MOST) { // 高度为 wrap_content,高度需要计算,此处为文字高度 height = textHeight; } return height; } } 效果如下: logcat输出如下: 如图我们得到了top,ascent,descent,bottom和leading的值,因为只有一行文本所以leading恒为0。 从代码中可以发现在我们绘制文本之前我们便可以获取文本的FontMetrics属性值,也就是说我们FontMetrics的这些值跟我们要绘制什么文本是无关的,而仅与绘制文本Paint的size和typeface有关,我们来分别更改这两个值看看效果: paint.setTextSize(36); 如图所示所有值都改变了,我们再为Paint设置一个typeface: paint.setTypeface(Typeface.defaultFromStyle(Typeface.ITALIC)); 3、图形样式包含绘制的图形是空心样式还是实心样式,同时还能指定落笔和收笔时的笔触效 果。绘制直线或折线时,图形样式能影响到一些绘制细节。 Paint 类与图形样式相关的方法有: public void setStyle(Paint.Style style);//设置绘制的图形是空心样式还是实心样式,默认为实心样式,style 的可选值有: public static enum Style{ FILL, FILL_AND_STROKE, STROKE } 其中,FILL 表示实心样式,对于闭合图形来说,会用指定的颜色进行填充;STROKE 表 示空心样式,绘制时只有线条而无填充效果;FILL_AND_STROKE 表示同时使用实心样 式和空心样式。 public void setStrokeJoin(Paint.Join join) 当绘图样式为 STROKE 时,该方法用于指定线条连接处的拐角样式,能使绘制的图形 更加平滑。可选值如下: public static enum Join { BEVEL, MITER, ROUND } 我们通过下图来区别上面三个枚举值(比较右上角即可) ,默认值为 MITER: public void setStrokeCap(Paint.Cap cap) 该方法用于设置落笔时的样式,控制我们的画笔在离开画板时留下的最后一点图形,可选值如下: public static enum Cap { BUTT, ROUND, SQUARE } 我们通过下图来区别上面三个枚举值,默认值为 BUTT: public native void setStrokeWidth(float width) 设置线条的宽度,注意是 float 类型,在 Android 中最细的线条不是 1,可以比 1 更小更细。 参考:http://blog.csdn.net/abcdef314159/article/details/51720686

优秀的个人博客,低调大师

Metric模块源码解析

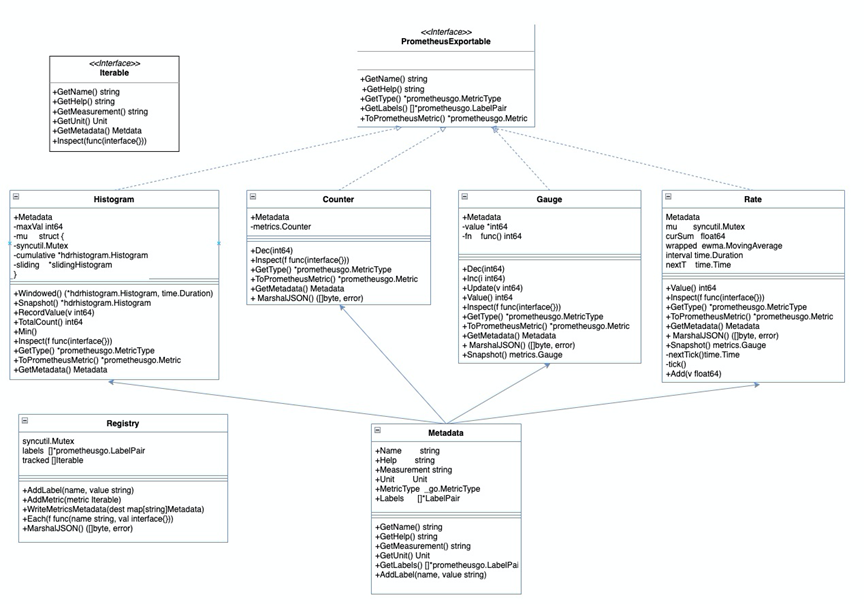
分布式系统的监控告警及运维服务离不开指标监控,开务作为浪潮自主研发的一款分布式数据库自然也不例外。在兼顾强一致性、高可用分布式架构、在线水平扩展、企业级安全等特性下,开务的metric模块可提供监控指标,实现预先定义指标的周期性采集。同时,可以提供兼容 Prometheus 标准格式的 API 接口,方便与外部的 Prometheus 服务进行集成。 开务数据库metric 模块收集各模块相关统计的metric 信息,并将其作为 Prometheus 格式的指标储存起来用于进一步查阅,对判断开务数据库的运行情况有着重要作用,同时也是开务数据库adminUI 指标的数据来源。本期内容将围绕下图展示的metric模块基本框架,带领大家深入了解开务数据库metric 模块的源码,图中各模块的详细介绍将持续为大家更新。 1、定义接口介绍 1.IterableIterable:提供了一个同步访问内部对象的方法。方法如下: GetName() string 返回指标名 GetHelp() string 返回指标帮助文本 GetMeasurement() string 返回指标的lable GetUnit() Unit 返回指标使用的单位 GetMetadata() Metdata 返回指标的Metadata Inspect(func(interface{})) Inspect对每个包含的项调用给定的闭包 2.PrometheusExportable:是标准独立指标接口,可供指标导入 Prometheus。方法如下: GetName() string 返回指标名 GetHelp() string 返回指标帮助文本 GetType() *prometheusgo.MetricType 返回指标的Prometheus类型 GetLables() []*prometheusgo.LabelPair Metadata中的一个方法,返回指标的标签 ToPrometheusMetric() *prometheusgo.Metric 返回一个完成值填充的Prometheus指标 3.PrometheusIterable:是 PrometheusExportable 的扩展,用于指示该指标由增加父标签值的子指标组成。包含成员:PrometheusExportable。方法如下: Each([]*prometheusgo.LabelPair, func(metric *prometheusgo.Metric)) “Each”获取与父指标相关联的标签对切片,并使用每个子指标调用所传递的函数 2、Metric Metadata介绍 Metadata 包含关于指标的元数据,它必须嵌入到每个 metric object 中。它用于将有关指标的信息导出到 Promethues 和 adminUI 图表。 type Metadata struct { Name string Help string Measurement string Unit Unit MetricType _go.MetricType Labels []*LabelPair } // 方法 GetName() string GetHelp() string GetMeasurement() string GetUnit() Unit GetLabels() []*prometheusgo.LabelPair Addlabel(name value string)//给一个指标添加标签/值映射 3、指标类型介绍 1.Histogram:在一段时间范围内对数据进行采样(通常是请求持续时间、响应大小等),并将其计入可配置的存储桶(bucket)中,后续可通过指定区间筛选样本,也可以统计样本总数,最后一般将数据展示为直方图。 Prometheus 的 Histogram 是一种累积直方图,与上面的区间划分方式是有差别的。它的划分方式如下:假设每个 bucket 的宽度是0.2s,那么第一个 bucket 表示响应时间小于等于0.2s 的请求数量,第二个 bucket 表示响应时间小于等于0.4s 的请求数量,以此类推。也就是说,每一个 bucket 的样本包含了之前所有 bucket 的样本,所以叫累积直方图。 type Histogram { Metadata maxVal int64 mu struct { syncutil.Mutex cumulative *hdrhistogram.Histogram sliding *slidingHistogram } //hdrhistogram.Histogram type Histogram struct { lowestTrackableValue int64 highestTrackableValue int64 unitMagnitude int64 significantFigures int64 subBucketHalfCountMagnitude int32 subBucketHalfCount int32 subBucketMask int64 subBucketCount int32 bucketCount int32 countsLen int32 totalCount int64 counts []int64 } //slidingHistogram type slidingHistogram struct { windowed *hdrhistogram.WindowedHistogram nextT time.Time duration time.Duration } type WindowedHistogram struct { idx int h []Histogram m *Histogram Current *Histogram } //相关方法介绍 func (h *Histogram) Windowed() (*hdrhistogram.Histogram, time.Duration) 返回一份当前的窗口化直方图的数据和其中的时间间隔 func (h *Histogram) Snapshot() *hdrhistogram.Histogram 返回累积(即所有样本)直方图数据的副本 func (h *Histogram) RecordValue(v int64) RecordValue将给定的值添加到直方图。记录超过该直方图配置最大值使用方法 func (h *Histogram) TotalCount() int64 TotalCount返回样本的(累计)数量 func (h *Histogram) Min() int64 返回最小值 func (h *Histogram) Inspect(f func(interface{})) 调用带有空字符串和接收方的闭包 func (h *Histogram) GetType() *prometheusgo.MetricType 返回此指标的Prometheus类型enum func (h *Histogram) ToPrometheusMetric() *prometheusgo.Metric 返回正确类型的已填充的Prometheus度量值 func (h *Histogram) GetMetadata() Metadata 返回指标的元数据,包括Prometheus MetricType func NewHistogram(metadata Metadata, duration time.Duration, maxVal int64, sigFigs int) (*Histogram) 实例化一个新histogram func NewLatency(metadata Metadata, histogramWindow time.Duration) *Histogram NewLatency 返回一个带有适当默认值的直方图来跟踪延迟。数值以ns表示,截断为间隔[0,MaxLatency],并以1位精度记录(即误差在100ms时<10ms,在60s时<6s) 2.Counter:代表一种样本数据单调递增的指标,即只增不减,除非监控系统发生了重置。例如,你可以使用 Counter 类型的指标来表示服务的请求数、已完成的任务数、错误发生的次数等。 type Counter struct { Metadata metrics.Counter } type Counter interface { Clear() Count() int64 Dec(int64) Inc(int64) Snapshot() Counter } //相关方法介绍 func (c *Counter) Dec(int64) Dec重载了metric.Counter的方法。不能使用这种方法,它只用于防止误用metric类型 func (c *Counter) GetType() *prometheusgo.MetricType 返回此指标的Prometheus类型enum func (c *Counter) Inspect(f func(interface{})) 调用带有空字符串和接收方的闭包,即返回自己c func (c *Counter) MarshalJSON() ([]byte, error) MarshalJSON将数据封装到JSON func (c *Counter) GetMetadata() Metadata 返回指标的元数据,包括Prometheus MetricType 3.Gauge:代表一种样本数据可以任意变化的指标,即可增可减。Guage 通常用于像温度或者内存使用率这种指标数据,也可以表示能随时增加或减少的“总数”,例如:当前并发请求的数量。 type Gauge struct { Metadata value *int64 fn func() int64 } //相关方法介绍 func (g *Gauge) Snapshot() metrics.Gauge Snapshot返回Gauge的只读副本 func (g *Gauge) Update(v int64) 更新Gauge的值 func (g *Gauge) Inc(i int64) 增加Gauge的当前值 func (g *Gauge) Dec(i int64) 减少Gauge的当前值 func (g *Gauge) Value() int64 Value返回Gauge的当前值 func (g *Gauge) GetType() *prometheusgo.MetricType 返回此指标的Prometheus类型enum func (g *Gauge) ToPrometheusMetric() *prometheusgo.Metric 返回此指标的Prometheus类型enum func (g *Gauge) GetMetadata() Metadata 返回指标的元数据,包括Prometheus MetricType 4.Rate:用来计算某个指标在最近一个区间时间内的变化率。 type Rate struct { Metadata mu syncutil.Mutex // protects fields below curSum float64 wrapped ewma.MovingAverage interval time.Duration nextT time.Time } //相关方法介绍 func (e *Rate) GetType() *prometheusgo.MetricType GetType返回该指标的Prometheus类型enum func (e *Rate) Inspect(f func(interface{})) Inspect用自身调用给定的闭包 func (e *Rate) ToPrometheusMetric() *prometheusgo.Metric 返回此指标的Prometheus类型enum func (c *Counter) MarshalJSON() ([]byte, error) MarshalJSON将数据封装到JSON func (e *Rate) GetMetadata() Metadata GetMetadata返回指标的元数据,包括Prometheus MetricType func (e *Rate) Value() float64 Value返回Rate的当前值 func (e *Rate) tick() Rate时间前进 func (e *Rate) nextTick() time.Time 返回Rate的当前时间。 func (e *Rate) Add(v float64) 添加将给定的测量值添加到Rate 4、注册器Registry介绍 Registry 是 metric 的列表,它提供了一种处理指标的方法,可以将 metric 编组成 JSON,并生成 Prometheus 格式的 metric。同时可以给注册的指标打上标签,当导出到 Prometheus 时,这些标签将应用于它的所有指标。 type Registry struct { syncutil.Mutex labels []*prometheusgo.LabelPair tracked []Iterable } //相关方法介绍 func (r *Registry) AddLabel(name, value string) AddLabel为这个注册表添加一个标签/值对 func (r *Registry) AddMetric(metric Iterable) AddMetric将传入的metric添加到注册表 func (r *Registry) WriteMetricsMetadata(dest map[string]Metadata) WriteMetricsMetadata将所有跟踪metric的元数据写入参数映射 func (r *Registry) Each(f func(name string, val interface{})) 每个函数对所有metric调用给定的闭包 func (r *Registry) MarshalJSON() ([]byte, error) 格式化到JSON格式 5、注册新Registry步骤 // 以txnMetric说明 //txn_metric.go //声明定义的指标结构体类型 type TxnMetrics struct { Commits *metric.Counter ... } //定义指标的metadata var( metaCommitsRates = metric.Metadata{ Name: "txn.commits", Help: "Number of committed KV transactions (including 1PC)", Measurement: "KV Transactions", Unit: metric.Unit_COUNT, } ... ) //将定义的指标类型和metadata相关联 func MakeTxnMetrics(histogramWindow time.Duration) TxnMetrics { return TxnMetrics{ Commits: metric.NewCounter(metaCommitsRates), } //server.go: //注册进Registry txnMetrics := kvcoord.MakeTxnMetrics(cfg.HistogramWindowInterval()) registry.AddMetricStruct(txnMetrics) 开务数据库是一款浪潮集团核心研发的先进、安全的云原生分布式数据库;具备云原生、多中心、高可用、事务强一致等特性,满足 HTAP 场景需求。业务范围覆盖能源、工业互联网、政务、教育、金融等多行业。我们是一支平均年龄 30 岁的年轻团队,在短短不到三年的时间里,我们已取得近 300 项发明专利受理,10 项自有产品软著授权。热烈欢迎广大伙伴加入我们的团队,热门岗位火热招聘中,简历投递邮箱: zhoubeili@inspur.com / bixueting@inspur.com 数据库存储内核研发工程师 工作职责: 1、负责存储子系统的研发路线规划、架构设计和关键技术问题攻关; 2、负责编写功能测试用例,测试工具进行系统验证; 3、负责数据库的系统性能诊断与调优; 4、负责数据库相关关键技术的预研和在团队中的引导; 5、深入理解业务场景的数据库存储需求,针对性的为不同业务场景提供最合适的存储方案。 任职要求: 1、学历:本科或者本科以上学历; 2、专业:计算机或相关专业; 3、专业知识: — 3 年及以上 GO/C++ 开发经验; — 精通 C/C++/GO 语言,Linux 系统编程。熟悉无锁数据结构,熟悉现代硬件体系结构 (CPU/Cache/Memory/Storage), 熟悉并发编程; — 熟练使用 MySQL、PostgeSQL 等主流数据库; — 熟悉数据库存储系统的基本理论,熟悉事务处理,日志与恢复策略,多版本并发控制技术的实现,对数据库的基本理论和内部实现机制有深刻的理解; — 技术视野开阔,有一定的系统性能优化经验,掌握各种性能诊断工具和各种优化方法; — 熟悉时序数据库,有实际的时序数据库开发经验优先; — 熟悉 RocksDB、Arrow、Parquet 等开源存储项目源码者优先。 Base 地: 上海 / 天津 / 济南 / 北京 数据库方案工程师 工作职责: 1、负责分布式数据库,或其相关工具、平台等产品的梳理、规划、设计和推进工作; 2、进行解决方案的调研、设计和验证; 3、设计、撰写和维护产品红皮书; 4、跨部门沟通,协调各类资源以确保产品顺利上线,推进产品迭代。 任职要求: 1、5 年以上的数据库运维及方案设计经验(ORACLE/Mysql/PostgreSQL 任意一种),对部署,优化,灾备,恢复,高可用有实际经验; 2、1 年左右的分布式数据库经验,了解国内任意一款分布式数据库,有部署,POC,问题处理经验; 3、对 OLTP 和 OLAP 系统或其中一种有实际运维设计经验; 4、对数据库灾备,同步方案有实际项目经验; 5、会一种数据库 benchmark 工具,设计相应场景进行测试并结合已有经验给与相应调整优化; 6、有基本的编程能力,如 go,shell,python 其中一项,可以写简单程序对数据库进行并发测试,功能验证; 7、有项目管理能力,很好的沟通能力,可以与开发人员顺畅沟通,并于合作高校学生完成实验及文档编写; 8、扎实的技术,linux 和数据库方面有一定积累,能对开发人员及学生进行一定指导,促使相关工作顺利推进; 9、较强的文档编写组织能力,根据实验文档及相关手册,编写用户解决方案手册; 10、有一定语言表达能力,能做数据库相关功能培训。 Base 地: 上海 / 天津 / 济南 / 北京

优秀的个人博客,低调大师

深度解析ThreadLocal原理

今天呢,和大家聊一下ThreadLocal。 1. 是什么? JDK1.2提供的的一个线程绑定变量的类。 他的思想就是:给每一个使用到这个资源的线程都克隆一份,实现了不同线程使用不同的资源,且该资源之间相互独立 2. 为什么用? 思考一个场景:数据库连接的时候,我们会创建一个Connection连接,让不同的线程使用。这个时候就会出现多个线程争抢同一个资源的情况。 这种多个线程争抢同一个资源的情况,很常见,我们常用的解决办法也就两种:空间换时间,时间换空间 没有办法,鱼与熊掌不可兼得也。就如我们的CAP理论,也是牺牲其中一项,保证其他两项。 而针对上面的场景我们的解决办法如下: 空间换时间:为每一个线程创建一个连接。 直接在线程工作中,创建一个连接。(重复代码太多) 使用ThreadLocal,为每一个线程绑定一个连接。 时间换空间:对当前资源加锁,每一次仅仅存在一个线程可以使用这个连接。 通过ThreadLocal为每一个线程绑定一个指定类型的变量,相当于线程私有化 3. 怎么用? ThreadLocal<Integer> threadLocal = new ThreadLocal<>(); threadLocal.get(); threadLocal.set(1); threadLocal.remove(); 没错,这四行代码已经把ThreadLocal的使用方法表现得明明白白。 get从ThreadLocal拿出一个当前线程所拥有得对象 set给当前线程绑定一个对象 remove将当前线程绑定的当前对象移除 记住在使用的以后,一定要remove,一定要remove,一定要remove 为什么要remove。相信不少小伙伴听到过ThreadLocal会导致内存泄漏问题。 没错,所以为了解决这种情况,所以你懂吧,用完就移除,别浪费空间(渣男欣慰) 看到这,脑袋上有好多问号出现了(小朋友你是否有很多问号?) 为啥会引发内存泄漏? 为啥不remove就内存泄漏了 它是怎么讲对象和线程绑定的 为啥get的时候拿到的就是当前线程的而不是其他线程的 它怎么实现的??? 来吧,开淦,源码来 4. 源码解读 先来说一个思路:如果我们自己写一个ThreadLocal会咋写? 线程绑定一个对象。**这难道不是我们熟知的map映射?**有了Map我们就可以以线程为Key,对象为value添加到一个集合中,然后各种get,set,remove操作,想怎么玩就怎么玩,搞定。😀 这个时候,有兄弟说了。你这思路不对啊,你这一个线程仅仅只能存放一个类型的变量,那我想存多个呢? 摸摸自己充盈的发量,你说出了一句至理名言:万般问题,皆系于源头和结果之中。 从结果考虑,让开发者自己搞线程私有(估计被会开发者骂死) 来吧,从源头考虑。现在我们的需求是:线程可以绑定多个值,而不仅仅是一个。嗯,没错,兄弟们把你们的想法说出来。 让线程自己维护一个Map,将这个ThreadLocal作为Key,对象作为Value不就搞定了 兄弟,牛掰旮旯四 此时,又有兄弟说了。按照你这样的做法,将ThreadLocal扔到线程本身的的Map里,那岂不是这个ThreadLocal一直被线程对象引用,所以在线程销毁之前都是可达的,都无法GC呀,有BUG啊??? **好,问题。**这样想,既然由于线程和ThreadLocal对象存在引用,导致无法GC,那我将你和线程之间的引用搞成弱引用或者软引用不就成了。一GC你就没了。 啥,你不知道啥是弱引用和软引用??? 前面讲过的东西,算啦再给你们复习一波。 JDK中存在四种类型引用,默认是强引用,也就是我们经常干的事情。疯狂new,new,new。这个时候创建的对象都是强引用。 强引用。直接new 软引用。通过SoftReference创建,在内存空间不足的时候直接销毁,即它可能最后的销毁地点是在老年区 弱引用。通过WeakReference创建,在GC的时候直接销毁。即其销毁地点必定为伊甸区 虚引用。通过PhantomReference创建,它和不存也一样,非常虚,只能通过引用队列在进行一些操作,主要用于堆外内存回收 好了,回到正题,上面的引用里最适合我们当前的场景的就是弱引用了,为什么这个样子说: 在以往我们使用完对象以后等着GC清理,但是对于ThreadLocal来说,即使我们使用结束,也会因为线程本身存在该对象的引用,处于对象可达状态,垃圾回收器无法回收。这个时候当ThreadLocal太多的时候就会出现内存泄漏的问题。 而我们将ThreadLocal对象的引用作为弱引用,那么就很好的解决了这个问题。当我们自己使用完ThreadLocal以后,当GC的时候就会将我们创建的强引用直接干掉,而这个时候我们完全可以将线程Map中的引用干掉,于是使用了弱引用,这个时候大家应该懂了为啥不使用软引用了吧 还有一个问题:为什么会引发内存泄漏呢? 了解Map结构的兄弟们应该清楚,内部实际就一个节点数组,对于ThreadLocalMap而言,内部是一个Entity,它将Key作为弱引用,Value还是强引用。如果我们在使用完ThreadLocal以后,没有对Entity进行移除,会引发内存泄漏问题。 ThreadLocalMap提供了一个方法expungeStaleEntry方法用来排除无效的Entity(Key为空的实体) 说到这里,有一个问题我思考了蛮久的,value为啥不搞成弱引用,用完直接扔了多好 最后思考出来得答案(按照源码推了一下): 不设置为弱引用,是因为不清楚这个Value除了map的引用还是否还存在其他引用,如果不存在其他引用,当GC的时候就会直接将这个Value干掉了,而此时我们的ThreadLocal还处于使用期间,就会造成Value为null的错误,所以将其设置为强引用。 而为了解决这个强引用的问题,它提供了一种机制就是上面我们说的将Key为Null的Entity直接清除 到这里,这个类的设计已经很清楚了。接下来我们看一下源码吧! 需要注意的一个点是:ThreadLocalMap解决哈希冲突的方式是线性探测法。 人话就是:如果当前数组位有值,则判断下一个数组位是否有值,如果有值继续向下寻找,直到一个为空的数组位 Set方法 class ThreadLocal public void set(T value) { //拿到当前线程 Thread t = Thread.currentThread(); //获取当前线程的ThreadLocalMap ThreadLocalMap map = getMap(t); if (map != null) //如果当前线程的Map已经创建,直接set map.set(this, value); else //没有创建,则创建Map createMap(t, value); } private void set(ThreadLocal<?> key, Object value) { Entry[] tab = table; int len = tab.length; int i = key.threadLocalHashCode & (len-1); //拿到当前数组位,当前数组位是否位null,如果为null,直接赋值,如果不为null,则线性查找一个null,赋值 for (Entry e = tab[i]; e != null; e = tab[i = nextIndex(i, len)]) { ThreadLocal<?> k = e.get(); if (k == key) { e.value = value; return; } if (k == null) { replaceStaleEntry(key, value, i); return; } } tab[i] = new Entry(key, value); int sz = ++size; //清除一些失效的Entity if (!cleanSomeSlots(i, sz) && sz >= threshold) rehash(); } ThreadLocalMap getMap(Thread t) { //获取当前线程的ThreadLocalMap return t.threadLocals; } void createMap(Thread t, T firstValue) { //当前对象作为Key,和我们的设想一样 t.threadLocals = new ThreadLocalMap(this, firstValue); } Get方法 public T get() { //获取当前线程 Thread t = Thread.currentThread(); //拿到当前线程的Map ThreadLocalMap map = getMap(t); if (map != null) { //获取这个实体 ThreadLocalMap.Entry e = map.getEntry(this); if (e != null) { @SuppressWarnings("unchecked") T result = (T)e.value; //返回 return result; } } return setInitialValue(); } private Entry getEntry(ThreadLocal<?> key) { //计算数组位 int i = key.threadLocalHashCode & (table.length - 1); Entry e = table[i]; //如果当前数组有值,且数组位的key相同,则返回value if (e != null && e.get() == key) return e; else //线性探测寻找对应的Key return getEntryAfterMiss(key, i, e); } private Entry getEntryAfterMiss(ThreadLocal<?> key, int i, Entry e) { Entry[] tab = table; int len = tab.length; while (e != null) { ThreadLocal<?> k = e.get(); if (k == key) return e; if (k == null) //排除当前为空的Entity expungeStaleEntry(i); else //获取下一个数组位 i = nextIndex(i, len); e = tab[i]; } //如果没有找到直接返回空 return null; } remove public void remove() { ThreadLocalMap m = getMap(Thread.currentThread()); if (m != null) m.remove(this); } private void remove(ThreadLocal<?> key) { Entry[] tab = table; int len = tab.length; int i = key.threadLocalHashCode & (len-1); //拿到当前的数组,判断是否为需要的数组位,如果不是线性查找 for (Entry e = tab[i]; e != null; e = tab[i = nextIndex(i, len)]) { if (e.get() == key) { e.clear(); //清空位NUll的实体 expungeStaleEntry(i); return; } } } 我们可以看到一个现象:在set,get,remove的时候都调用了expungeStaleEntry来将所有失效的Entity移除 看一下这个方法做了什么 private int expungeStaleEntry(int staleSlot) { Entry[] tab = table; int len = tab.length; // 删除实体的Value tab[staleSlot].value = null; //置空这个数组位 tab[staleSlot] = null; //数量减一 size--; // 重新计算一次哈希,如果当前数组位不为null,线性查找直到一个null Entry e; int i; for (i = nextIndex(staleSlot, len); (e = tab[i]) != null; i = nextIndex(i, len)) { ThreadLocal<?> k = e.get(); if (k == null) { e.value = null; tab[i] = null; size--; } else { int h = k.threadLocalHashCode & (len - 1); if (h != i) { tab[i] = null; // Unlike Knuth 6.4 Algorithm R, we must scan until // null because multiple entries could have been stale. while (tab[h] != null) h = nextIndex(h, len); tab[h] = e; } } } return i; } 更多原创内容请关注博主

优秀的个人博客,低调大师

AOP编程全解析

AOP是一种编程思想,一套规范。 软件开发经历了面向过程编程时代,以C语言为代表,之后是面向对象编程时代,以Java语言为代表。 在21世纪大牛们又提出了一种新的编程思想面向方面编程,即AOP理念,全称Aspect-Oriented Programming。 AOP是第三代编程思想,到哪免不了都要问下。 发展历史 1997年在面向对象编程大会上Gregor Kiczales等人首次提出了AOP的概念,之后各大公司等分别加入研究。2001年Palo Alto研究中心发布了首个支持AOP的语言AspectJ,同时也是一个规范。 目标定位 在对真实世界抽象的面向对象编程过程中,始终伴随着某写操作的代码无法实现模块化封装,会散落在各个对象中存在,特别是非功能性代码。对于一般的功能开发采取面向对象方式进行抽象是能够很好应付的,但是面向方面(切面)给了一种新的思维方式来考虑编程,能更好的进行全局结构化思考。 所以AOP主要解决两个问题: 代码分散问题,特别是那些非功能性代码。 作为面向对象编程思维的一种补充和完善。 核心知识点 连接点 连接点:join point,程序的一个执行点,如类中的一个方法,方法里面一个代码块。 切入点 切入点:point cut,是一个捕获连接点的代码结构,就是定义一个代码逻辑用来捕获某个连接点的代码。 方面 方面;aspect,是具体被执行的切面逻辑代码,类似于一个类。 通知 通知:advice,是point cut执行的代码,定义在连接点什么时机来执行aspect。 主要运用场景 场景分为2类: 一类是非功能性需求,如日志、异常、安全、事务都可以使用AOP思想编程。 另一类是功能性需求,在原来对象抽象的思维中添加AOP思维,这里是一种结构化思维,在定义类时考虑多个类的切面共性。 主流AOP语言实现 对AOP实现除了AspectJ外,已知的还有JBoss AOP、Spring AOP等。 这里只介绍AspectJ和SpringAOP,重点是他们不同点。 AspcetJ AspectJ采用静态织入方式进行切面织入原代码,提供独立的编译器把切面和原代码的java文件编织成一个新的class文件。提供了详细的编译日志和调试工具,编译时间长但是运行效率高。 连接点的支持范围: 方法和构造器调用 方法和构造器执行 属性访问 异常处理 类初始化,是static代码块 语法结构 控制流 对象及参数类型 条件测试 关联连接点通知方式: before,连接点执行前运行 after,连接点执行后运行 around,连接点的整个外侧,整个包住,能够绝的连接点执行和修改上下文环境 Spring AOP Spring AOP没有完全实现AspectJ语言,它更多的是对Spring framwork进行Aop能力的扩展实现,补全Spring framework的不足并让Aop与Spring framwork融合。 连接点只支持方法拦截调用。 连接点通知方式在aspect的before、after、around的基础上增加throw对异常的触发的拦截。 Spring AOP与Spring IoC体系融合,对于aspect类统一交由Spring beans管理,并且提供ProxyFactoryBean的AOP代理工厂类,还有自动代理的BeanNameAutoProxyCreator和DefaultAdvisorAutoProxyCreator的强大工具。 Spring AOP是动态织入,在运行时完成AOP的aspect代码织入原代码逻辑中。其底层默认采用JDK的动态代理实现AOP代理,当对象没有实现接口时,CGLIB会默认使用。 优缺点 优点:解决代码散乱问题、代码逻辑解偶、易于维护、提供扩展性和可重用性。 缺点:切面越多系统越复杂难懂、工程师学习成本增加(业务不再是线型,变成了跳跃式) AOP编程要慎重使用,作为面向对象编程的一种补充。 作者:Owen Jia 关注他的博客:https://blog.shareworld.vip

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册