首页 文章 精选 留言 我的

精选列表

搜索[搭建],共10000篇文章
优秀的个人博客,低调大师

无忌过招:手把手教你搭建自己的GitLab库

01 前言 本文Gitlab的安装为主机方式, 获取其他安装方式请点击https://git.lug.ustc.edu.cn/help/install/README.md 02 架构 架构概述: Unicorn: Handles requests for the web interface and API, 一般gitlab站点,多数是因为这个服务有问题导致的 Sidekiq: Background jobs processor Redis: Caching service PostgreSQL: Database 03 安装 1. 设置repo [gitlab-ce] name=Gitlab CE Repository baseurl=https://mirrors.tuna.tsinghua.edu.cn/gitlab-ce/yum/el$releasever/ gpgcheck=0 enabled=1 EOF 2. 安装GitLab $ yum makecache $ yum install gitlab-ce 3. 修改配置 配置文件/etc/gitlab/gitlab.rb注: 你可根据注释修改配置文件,一般修改如下external_url 'http://gitlab.xxxxxx.com' #改域名,修改成你自己的域名,如果你用的https,改成https://gitlab.xxxxxx.com 4. 启动服务 $ gitlab-ctl reconfigure ## 使配置生效 $ gitlab-ctl status ## 确认服务状态 04 如何备份 1. 设置备份目录 先打开/etc/gitlab/gitlab.rb配置文件,查看一个和备份相关的配置项:gitlab_rails['backup_path'] = "/var/opt/gitlab/backups"该项定义了默认备份出文件的路径,可以通过修改该配置,并执行 gitlab-ctl reconfigure 或者 gitlab-ctl restart 重启服务生效。 2. 执行备份 备份执行一条命令就搞定:/opt/gitlab/bin/gitlab-rake gitlab:backup:create ,也可以加到crontab中定时执行: 0 2 * * * /opt/gitlab/bin/gitlab-rake gitlab:backup:create 可以到 /var/opt/gitlab/backups找到备份包,解压查看,会发现备份的还是比较全面的,数据库、repositories、build、upload等分类还是比较清晰的。 3. 备份参数注释 每天执行备份,肯定有目录被爆满的风险,我们可以立马想到的可以通过find 查找一定的时间前的文件,配合rm进行删除。不过不需要这么麻烦,gitlab-ce自身集成的有自动删除配置。同样打开/etc/gitlab/gitlab.rb配置文件,可以找到如下配置:gitlab_rails['backup_keep_time'] = 604800这里是设置备份保留7天(7360024=604800),秒为单位,如果想增大或减小,可以直接在该处配置,并通过gitlab-ctl restart 重启服务生效。 05 GitLab迁移或数据恢复 1. 恢复前需要先停掉数据连接服务: gitlab-ctl stop unicorn gitlab-ctl stop sidekiq 如果是台空主机,没有任何操作,理论上不停这两个服务也可以。停这两个服务是为了保证数据一致性。 2. 迁移数据 如果你没修改过默认备份目录的话,将老服务器/var/opt/gitlab/backups目录下的备份文件拷贝到新服务器上的/var/opt/gitlab/backups [root@localhost gitlab]# scp 1530773117_2018_07_05_gitlab_backup.tar 10.0.3.111:/var/opt/gitlab/backups/ ## 600权限是无权恢复的。--- 这里改成了777 [root@localhost backups]# pwd /var/opt/gitlab/backups [root@localhost backups]# chmod 777 1530773117_2018_07_05_gitlab_backup.tar [root@localhost backups]# ll total 17328900 -rwxrwxrwx 1 git git 17744793600 Jul 5 14:47 1530773117_2018_07_05_gitlab_backup.tar 3. 执行数据恢复 执行下面的命令进行恢复:后面再输入两次yes就完成恢复了。 gitlab-rake gitlab:backup:restore BACKUP=1530773117_2018_07_05_gitlab_backup.tar PS:根据版本不同恢复时可能有点小区别 06 附录1 常用命令 # 默认的log主目录为 /var/log/gitlab/ # 检查redis的日志 sudo gitlab-ctl tail redis # 检查postgresql的日志 sudo gitlab-ctl tail postgresql # 检查gitlab-workhorse的日志 sudo gitlab-ctl tail gitlab-workhorse # 检查logrotate的日志 sudo gitlab-ctl tail logrotate # 检查nginx的日志 sudo gitlab-ctl tail nginx # 检查sidekiq的日志 sudo gitlab-ctl tail sidekiq # 检查unicorn的日志 sudo gitlab-ctl tail unicorn sudo gitlab-ctl status //检查所依赖的服务是否运行 sudo gitlab-ctl tail //检查gitlab所依赖的服务是否在运行时出错 sudo gitlab-rake gitlab:check //检查的配置是否正确,如果有错误,请根据提示解决它 07 FAQ 错误1 error: proxyRoundTripper: GET "/" failed with: "dial unix /var/opt/gitlab/gitlab-rails/sockets/gitlab.socket: connect: no such file or directory" 原因:unicorn 没有正常启动解决:查看unicorn的日志, /var/log/gitlab/unicorn/*.log, 一般为端口冲突或是权限问题。依赖相应的日志,希望你可以很好的解决,enjoy it. 08 参考文档 https://docs.gitlab.com/ee/development/architecture.html

优秀的个人博客,低调大师

挪森留学只用3天自助轻松搭建完美官网

网站名称:挪森留学官网公司行业:赴日留学公司规模:10-50人建站目的:建设留学网站及业务推广网站地址:www.xgdlx.com预览地址:c1553214164.qrx.hzx.imzhanlang.com建站产品:站狼美站--阿里云云市场建站产品 企业介绍: 在2008年,来自日本几位在留学生出于对春上村树《挪威的森林》的喜爱创办了挪森文学社,在当时大学里引起很多人的关注。同时,希望赴日留学的诉求也越来越多。那时也正式启动了一个目的:链接中国与日本的渠道,为帮助更多的人实现日本留学。 客户痛点: 客户想要一个方便后期管理,最好不需要什么自己技术层面过多要求的,并且可以从0到1都可以自己方便独立完成的智能建站产品。 面临挑战: 客户完全是小白,但是经过简单在线旺旺指导,其学习相关的能力很强,几乎都是完全独立完成自己的留学官网,这样漂亮的官网

优秀的个人博客,低调大师

Mac下Android Studio 3.x的NDK开发环境搭建

目录 前言 CMake 用CMake向已有AS项目添加C/C++代码 ndk-build 最后 前言 mac上安装软件真的很简单, 一路下一步就可以安装好android studio. 这里有一篇旧文-Mac下安装配置Android Studio 2.x和3.x并配置使用adb可供参考.而写这篇的目的, 主要是我发现之前的ndk开发方式已经过时了, 需要更新一下新的流程. CMake CMake的方式是官方默认的ndk构建方式, 先从默认栗子开始看吧. 新建一个项目, 勾选C++ support: 你会发现初始的Activity就只能是基础或者空的类型了, 其他的都没了. 这里默认C++标准即可: C++ Standard: 选择哪一种C++标准, 默认选择Toolchain Default选项, 其会使用默认的CMake配置 Exceptions Support: 是否启用对C++异常处理的支持, 如果选中, AS会将-fexceptions标志添加到模块级build.grade文件的cppFlags中 Runtime Type Information Support: 是否支持RTTI, 如果选中, AS会将-frtti标志添加到模块级build.gradle文件的cppFlags中 来看看项目都多了什么, 先切换到Android标签下, 多了cpp目录(ps: 注意, 这里就算切换到Project标签, 依旧是cpp哈), 一些头文件, 和native-lib.cpp, 不用说, 这个cpp里面肯定是jni代码了, 我贴出来: #include <jni.h> #include <string> extern "C" JNIEXPORT jstring JNICALL Java_com_so_testcmake_MainActivity_stringFromJNI( JNIEnv *env, jobject /* this */) { std::string hello = "Hello from C++"; return env->NewStringUTF(hello.c_str()); } 然后切换到Project标签, 这个CMakeLists.txt就特别惹眼了, 我把里面大段注释都去掉, 然后贴出代码. .externalNativeBuild文件夹: 用于存放cmake编译好的文件, 包括支持的各种硬件等信息. 其实看到前面的.也知道是系统管理的了. cmake_minimum_required(VERSION 3.4.1) add_library( # Sets the name of the library. native-lib # Sets the library as a shared library. SHARED # Provides a relative path to your source file(s). src/main/cpp/native-lib.cpp) find_library( # Sets the name of the path variable. log-lib # Specifies the name of the NDK library that # you want CMake to locate. log) target_link_libraries( # Specifies the target library. native-lib # Links the target library to the log library # included in the NDK. ${log-lib}) 很明显, 关键在于add_library这一段 第一个参数生成函数库的名称, 即libnative-lib.so或libnative-lib.a(lib和.so/.a默认缺省) 第二个参数生成库类型: 动态库为SHARED, 静态库为STATIC 第三个参数依赖的c/cpp文件(相对路径) 最后回到Activity类来看看, 操作还是一样的, 加载库, 声明native函数. public class MainActivity extends AppCompatActivity { // Used to load the 'native-lib' library on application startup. static { System.loadLibrary("native-lib"); } @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.activity_main); // Example of a call to a native method TextView tv = (TextView) findViewById(R.id.sample_text); tv.setText(stringFromJNI()); } /** * A native method that is implemented by the 'native-lib' native library, * which is packaged with this application. */ public native String stringFromJNI(); } 再来到build.gradle文件, 发现多出来了两个标签段, 也就是说, 如果我们自己要建CMake环境, 是要加这两段的. 用CMake向已有AS项目添加C/C++代码 新建一个空项目, 不含C++ support, 刚才的项目不要关, 之后会大段复制黏贴: 新建JNI目录, 发现在Android标签下是cpp, 到了Project标签下又是jni, 我一直很想知道谷歌是怎么实现这一点的. 创建一个Java类, 将之前项目的代码复制过来, 如下: public class MyJNI { // Used to load the 'native-lib' library on application startup. static { System.loadLibrary("native-lib"); } /** * A native method that is implemented by the 'native-lib' native library, * which is packaged with this application. */ public native String stringFromJNI(); } 然后在jni目录下创建cpp文件, 复制之前项目的代码, 注意包名的变动: #include <jni.h> #include <string> extern "C" JNIEXPORT jstring JNICALL Java_com_so_addcmake_MyJNI_stringFromJNI( JNIEnv *env, jobject /* this */) { std::string hello = "Hello from C++"; return env->NewStringUTF(hello.c_str()); } 然后将之前项目的CMakeLists.txt复制到这个项目的app目录下, 修改相对路径, 即将cpp变成jni, 然后文件名也可以更改, 但是注意对应. 接下来在build.gradle中加入代码, 之后同步: ndk { abiFilters 'x86', 'x86_64', 'armeabi-v7a', 'arm64-v8a' } externalNativeBuild { cmake { path "CMakeLists.txt" } } 当然, 你可以手动操作进行关联, 右击app目录, 点击Link C++ Project with Gradle, 选择之前的CMakeLists.txt文件. 最后回到Activity, 设置组件显示从cpp函数返回的字符串, 编译运行: TextView tvTest = (TextView) findViewById(R.id.tv_test); tvTest.setText(new MyJNI().stringFromJNI()); 最后来自效果图: ndk-build 这是个有些过时的方式, 但是依旧是可以用的, 同样, 新建空项目. 然后和之前一样, 建一个cpp/jni目录. 复用之前的JNI类, 也就是加载了C++库和声明了本地函数的Java类. 创建Android.mk, Application.mk, helloNDK.cpp文件, 代码依次贴出: LOCAL_PATH := $(call my-dir) include $(CLEAR_VARS) LOCAL_MODULE := HelloNDK LOCAL_SRC_FILES := helloNDK.cpp include $(BUILD_SHARED_LIBRARY) APP_MODULES := HelloNDK APP_ABI := all // // Created by 杨骁 on 2019/2/2. // #include <jni.h> #include <stdio.h> #ifdef __cplusplus extern "C" { #endif /** * 函数名规则: Java_包名_类名_方法名 * @param env 表示一个指向JNI环境的指针, 可以通过它来方位JNI提供的接口方法 * @param thiz 表示Java对象中的this * @return */ jstring Java_com_so_addndk_HelloNDK_get(JNIEnv *env, jobject thiz) { printf("invoke get in c++\n"); return env->NewStringUTF("Hello from JNI in helloJni.so !"); } void Java_com_so_addndk_HelloNDK_set(JNIEnv *env, jobject thiz, jstring string) { printf("invoke set from C++\n"); char* str = (char*)env->GetStringUTFChars(string,NULL); printf("%s\n", str); env->ReleaseStringUTFChars(string, str); } #ifdef __cplusplus } #endif 然后打开终端, 进入到jni目录, 使用ndk-build指令生成.so文件, 接着把生成的.so文件拷贝到app目录下的libs目录: 最后在Activity中调用就大功告成了: 最后 要说操作上这两种的复杂度感觉差不多, 但是我依旧推荐CMake方案, 至少这种是短时间不会过时的方案.


优秀的个人博客,低调大师

甲方大人来了之运维数据分析平台搭建实战

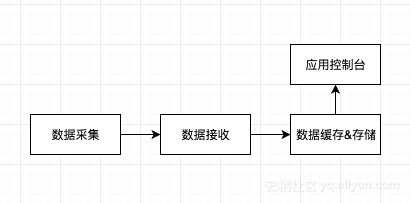
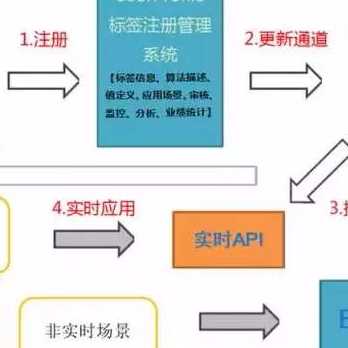
前段时间某甲方大人(富得流油)说他们日常运维人员天天忙的不行,每天穿梭于好几套性能监控系统,问我们能不能给想想办法,在不铲掉现有几套性能监控系统的情况下,让他们不用切换系统就能搞定日常运维需求。这个需求从项目经理那传到了产品经理那、又从产品经理那传到研发经理那、然后就传到我这,我记得我说有(做)点(不)麻(到)烦(阿)呢;再然后合同就下来了。 两个字,干活。 先说下甲方大人的需求和痛点,甲方大人说平日的系统运维工作主要围绕应用、主机、数据库和业务四个方面。 (1)应用发布平台是IBM的WebSphere Application Server(简称WAS),应用的性能监控基于WAS自带监控模块; (2)主机监控基于IBM Tivoli Monitoring System,业务监控则通过分析应用日志的方式实现。 (3)数据库监控依赖一个古老的oracle性能监控工具; (4)应用日志需要登陆到AIX业务机器上查看; “每当出现一个问题,先登陆was看下业务进程性能趋势,再登陆Tivoli查看主机性能趋势,然后登陆数据库监控查看数据库性能趋势,再然后登陆AIX主机查看日志。一套下来肚子就饿了,到食堂发现好吃的饭菜已经被别人抢光了,希望你们能帮我们改善改善伙食“。嗯,听上去影响蛮大的,不过他们怎么知道我烧菜的手艺的,上周末做的清蒸鲈鱼味道还不错... 四个字,干活干活。 在了解了甲方大人的需求和痛点后,经过一番苦思冥想,设计了上面的看上去有点复杂的架构图,超过20个字怕甲方大人看不懂。大道至简,借鉴老子的一段话附和一下这张图, “人法地、地法天、天法道、道法自然”, 老子 用了十三个字,将天、地、人乃至整个宇宙的生命 规律 精辟涵括、阐述出来。 菜谱准备好了,小葱拌豆腐,开始下锅。 数据采集上,针对WAS、Tivoli、Oracle和AIX应用主机的采集需求,需要coding了(没有什么需求是一坨代码解决不了的,如果有那就两坨): (1)开发一个WAS进程性能采集器,参考 https://github.com/alexivkin/WebSphere-Performance-Monitor,万能的python,哦no,这个是Jython,看起来跟python一样嘛,无非就是python里面用java,java里面跑python。由于是三年前的版本,加上没有IBM WAS的测试环境,花掉一个上午时间脑补调试,什么是脑补调试法,答按行过目代码、眼睛输入,大脑跑跑(非专业人士请勿模仿); (2)开发一个Tivoli数据收集器,又花掉一个晚上,Tivoli支持Soap方式拉取新能数据,我不会告诉你可以用一个CURL拉取所有主机性能所有数据的,想知道的留言处扣666; (3)开发一个Oracle数据库性能采集器,还好elastic 大佬开源了beats https://github.com/elastic/beats,坑爹的是竟然不支持oracle,莫非oracle大佬的开发人员都休眠了么;花了两个晚上捣鼓捣鼓,支持个tps、qps、物理读、逻辑度、吞吐量还是可以的,小算一下支持200多个指标吧,oracle采集beat依赖oracle client( https://www.oracle.com/technetwork/topics/intel-macsoft-096467.html)不是一般的麻烦; (4)开发一个AIX日志文件采集器,我们公司有大佬开发了一个,拿过来直接集成( https://github.com/DTStack/jfilebeat); 感兴趣的猴子们可以试试走一遍上面的过程,一个上午+两个晚上+几杯咖啡的事情,咖啡给大家推荐一款来自的马来半岛的OWL,俗名猫头鹰,非常适合晚上睁大眼睛看屏幕用,香甜可口纵享丝滑。。。 数据接收和解析组件,我们公司大佬自研了java版本的logstash,参考( https://github.com/DTStack/jlogstash),日志接收和解析性能是ruby版本性能5倍以上,关键是配置简单,分钟内上手,同事出门上个厕所的时间回来我就配置好了(大笑); 数据存储方面,最近一周的日志数据全部投递到elasticsearch里,以防哪天甲方大人心血来潮想搜个日志啥的;结构化的应用进程数据、主机性能数据、数据库性能数据和业务日志数据投递到clickhouse里,通过clickhouse强大的聚合计算能力(多表数据关联,sum/avg等聚合计算),计算出同一时间线上的业务和进程、主机以及数据库性能的关联趋势图。一句话总结下ck吧,在sql里计算我只服ck( https://clickhouse-docs.readthedocs.io/en/latest/functions/),源码请见 https://github.com/yandex/ClickHouse。 坚持看到这里就是真爱了,贴上一张系统架构图,图中左方是数据采集层,easymanager是公司自研的自动部署神器(不用想了,没有开源),右边是数据展示端,把应用、主机、数据库、日志数据统一展示在一张大屏上,废话不说了,上菜! (谢幕要另起两行) 验收会上,项目验收会上, 甲方大人面无表情,我们的项目经理滔滔不绝黄河之水, 项目经理:“was 进程性能数据、主机性能数据和数据库数性能据数据趋势图,高业务量对应高负载、高性能消耗和高数据库读写,关联估算出业务量和性能数据之间的比例关系,实现关联分析;同时通过业务闲时异常性能数据趋势(如异常持续高负载,异常持续高内存消耗,异常持续高数据库读写)情况定位应用程序的故障,辅助故障定位及时对故障应用程序进行处理。在业务高峰期,持续的业务高峰和持续的性能负载趋势会触发告警,及时对性能故障和业务高峰压力进行预警,辅助故障预警和决策...“。 甲方大人:“哦,吃饭“。

优秀的个人博客,低调大师

Flume + Solr + log4j搭建web日志采集系统【转】

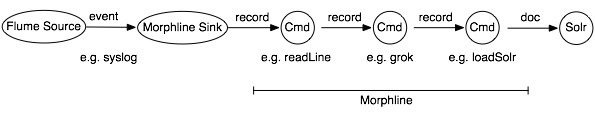
前言 很多web应用会选择ELK来做日志采集系统,这里选用Flume,一方面是因为熟悉整个Hadoop框架,另一方面,Flume也有很多的优点。 关于Apache Hadoop Ecosystem 请点击这里。 Cloudera 官方的教程也是基于这个例子开始的,get-started-with-hadoop-tutorial 并且假设我们已经了解Flume(agent, Source, Channel, Sink) , Morphline (ETL), Solr (全文检索),如果都没有了解,请自行百度。 Scenario (需求) 首先我们有多个web 应用,每个web应用每天都有不断的日志产生,这些日志文件现在以文件的形式存储在服务器当中,我们需要收集这些日志,并对日志进行查询。 所以整个流程就是,Flume agent 收集日志 -> Morphline 进行过滤 -> 对结果进行索引然后在Solr中进行搜索。 Flume 收集日志 1、使用 Spooling Directory Source 就是监视指定目录是否有新文件移入,如果有,就会读取这些Event, 但是文件一旦被移到该目录之后,就不应该被写入,目录 下的文件名也不可重复,这样的情况就是需要定期将文件移动到指定的目录,不能实现实时的读取。 2、使用 Exec Source 就是通过下面的命令行产生的结果作为源,在agent 死亡或或者机器重启的过程可能会存在数据丢失 agent.sources.execSrc.type = exec agent.sources.execSrc.shell=/bin/bash -c agent.sources.execSrc.command= tail -F /var/log/flume/flume.log | grep "error: " 1、使用消息中间件JMS或者KAFKA 请参考: 基于Flume+Log4j+Kafka的日志采集架构方案 客户端直接发送至kafaka queue , 用 log4j KafkaAppender 2、使用Flume Appender 对于Java web 应用,我们就最简单直接采取这种方式。 Flume Appender 我们这里就直接采用log4j2 , 关于日志框架的这些说 明,请看另一片博客 spring boot use log4j log4j 关于flume Appender 的配置 The Flume Appender supports three modes of operation. 1、It can act as a remote Flume client which sends Flume events via Avro to a Flume Agent configured with an Avro Source.(同 步,Avro协议) 2、It can act as an embedded Flume Agent where Flume events pass directly into Flume for processing.(异步,需要维护客户端 flume) 3、It can persist events to a local BerkeleyDB data store and then asynchronously send the events to Flume, similar to the embedded Flume Agent but without most of the Flume dependencies.(先写数据库,再异步发送) Usage as an embedded agent will cause the messages to be directly passed to the Flume Channel and then control will be immediately returned to the application. All interaction with remote agents will occur asynchronously. Setting the "type" attribute to "Embedded" will force the use of the embedded agent. In addition, configuring agent properties in the appender configuration will also cause the embedded agent to be used. 我们下面就简单的用第一种方式 客户端配置 log4j.xml <?xml version="1.0" encoding="UTF-8"?> <Configuration status="warn" name="MyApp" packages=""> <Appenders> <Flume name="eventLogger" compress="true"> <Agent host="192.168.10.101" port="8800"/> <Agent host="192.168.10.102" port="8800"/> <RFC5424Layout enterpriseNumber="18060" includeMDC="true" appName="MyApp"/> </Flume> </Appenders> <Loggers> <Root level="error"> <AppenderRef ref="eventLogger"/> </Root> </Loggers> </Configuration> 服务端配置 参考:flume log4j appender config 下载 flume, 在conf 目录下,配置example.conf : # example.conf: A single-node Flume configuration # Name the components on this agent a1.sources = r1 a1.sinks = k1 a1.channels = c1 # Describe/configure the source a1.sources.r1.type = org.apache.flume.clients.log4jappender.Log4jAppender a1.sources.r1.bind = localhost a1.sources.r1.port = 44444 # Describe the sink a1.sinks.k1.type = logger # Use a channel which buffers events in memory a1.channels.c1.type = memory a1.channels.c1.capacity = 1000 a1.channels.c1.transactionCapacity = 100 # Bind the source and sink to the channel a1.sources.r1.channels = c1 a1.sinks.k1.channel = c1 启动 flume bin/flume-ng agent --conf conf --conf-file example.conf --name a1 -Dflume.root.logger=INFO,console 查看日志,是否成功。 Solr 配置 关于solr的介绍 这里 solr的数据也是需要存储到 hdfs中的,另外solr 是通过zookeeper 来管理的 以下配置,这里用的cloudera manager 安装,所以自动配好了,但是需要检验,如果是手动安装也有对应的文档可以直接查看, 另外这里省略Solr Authentication。 配置 zookeeper service $ cat /etc/solr/conf/solr-env.sh export SOLR_ZK_ENSEMBLE=zk01.example.com:2181,zk02.example.com:2181,zk03.example.com:2181/solr 配置 solr use hdfs $ cat /etc/default/solr //地址nn01.example.com:8020 是hdfs name node的地址 SOLR_HDFS_HOME=hdfs://nn01.example.com:8020/solr //To create the /solr directory in HDFS,需要创建/solr hdfs目录: $ sudo -u hdfs hdfs dfs -mkdir /solr $ sudo -u hdfs hdfs dfs -chown solr /solr initializing the ZooKeeper Namespace $ sudo service solr-server restart 启动solr $ sudo service solr-server restart solr collection 配置 solr 通过 collection 来组织逻辑数据,所以你需要创建collection,每个collection有自己的配置,文档上已经讲的比较清楚了,而且也不多,这里不再赘述 Generating Collection Configuration 下面是的collection是用来存储上面收集到的日志: // 使用默认模版创建instancedir $ solrctl instancedir --generate $HOME/weblogs_config // upload instancedir to zookeeper,上传配置 $ solrctl instancedir --create weblogs_config $HOME/weblogs_config //verify instance $ solrctl instancedir --list // create collection -s shard_count, collection 和config 关联 $ solrctl collection --create weblogs_collection -s 2 -c weblogs_config A SolrCloud collection is the top-level object for indexing documents and providing a query interface. Each collection must be associated with an instance directory. Different collections can use the same instance directory. Each collection is typically replicated among several SolrCloud instances. Each replica is called a core and is assigned to an individual Solr service. The assignment process is managed automatically, although you can apply fine-grained control over each individual core using the solrctl core command . 这是 collection 和instance之间关系的介绍 成功创建之后如何修改和扩展,请参考这里solectl usage Morphline (ETL) 创建好 collection 之后,我们就需要将日志解析存储到solr里,方便检索。Morphline 就是这个中间过程的ETL工具(extracting, transforming and loading data), Flume 提供了Morphlion Solr Sink, 从 log flume的source中读取event,经过ETL导入到solr中。 配置flume 继续上面的flume,中 example.conf 的配置 a1.sources = r1 a1.sinks = k1 a1.channels = c1 # Describe/configure the source a1.sources.r1.type = avro a1.sources.r1.bind = 0.0.0.0 a1.sources.r1.port = 4444 # Describe the sink a1.sinks.k1.type = org.apache.flume.sink.solr.morphline.MorphlineSolrSink a1.sinks.k1.morphlineFile=morphlines.conf a1.sinks.k1.morphlineId = morphline_log4j2 # Use a channel which buffers events in memory a1.channels.c1.type = memory a1.channels.c1.capacity = 1000 a1.channels.c1.transactionCapacity = 1000 # Bind the source and sink to the channel a1.sources.r1.channels = c1 a1.sinks.k1.channel = c1 配置Morphline 我们的日志格式文件如下: [INFO ] 2017-07-14 11:40:51.556 [main] RequestMappingHandlerAdapter - Detected ResponseBodyAdvice bean in apiResponseAdvice 需要解析成: level: INFO create_time: 2017-07-14 11:40:51.556 thread: main class: RequestMappingHandlerAdapter - //这里有个短横线 message: Detected ResponseBodyAdvice bean in apiResponseAdvice 所以我们使用grok 在线调试工具online tools # grok get data from unstructured line { grok { dictionaryFiles : [grok-dictionary.conf] expressions : { message : """\[%{LOGLEVEL:level} \] %{SC_LOGDATETIME:create_time} \[%{DATA:thread}\] %{WORD:class} [-] %{GREEDYDATA:message}""" } } } # Consume the output record of the previous command and pipe another # record downstream. # # convert timestamp field to native Solr timestamp format # e.g. 2017-07-14 11:40:52.512 to 2012-09-06T07:14:34.000Z { convertTimestamp { field : create_time inputFormats : ["yyyy-MM-dd HH:mm:ss.SSS", "yyyy-MM-dd"] inputTimezone : America/Los_Angeles outputFormat : "yyyy-MM-dd'T'HH:mm:ss.SSS'Z'" outputTimezone : UTC } } 配置 schema.xml 在上一节,配置solr的时候,我们生成了默认的模版,我们需要根据实际的需求修改schema.xml,在$HOME/weblogs/conf 下 The schema.xml file contains all of the details about which fields your documents can contain, and how those fields should be dealt with when adding documents to the index, or when querying those fields. schema.xml solrconfig.xml <field name="level" type="text_general" indexed="true" stored="true" multiValued="true"/> <field name="create_time" type="date" indexed="true" stored="true"/> <field name="thread" type="text_general" indexed="true" stored="true"/> <field name="class" type="text_general" indexed="true" stored="true"/> <field name="message" type="text_general" indexed="true" stored="true"/> 重新上传配置到zookeeper $ solrctl instancedir --update weblogs_config $HOME/weblogs_config $ solrctl collection --reload weblogs_collection 总结 到此为止,我们完成了日志的收集,解析,索引,你可以通过 Hue来进行搜索和查询了,或者自己定义UI。这个教程比较基础也相对简单,但是可以完成基本的需求,也把日志处理流程走了一遍,剩下的大家自定义即可。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册