首页 文章 精选 留言 我的

精选列表

搜索[AI编程],共10000篇文章
优秀的个人博客,低调大师

Java并发编程(2) AbstractQueuedSynchronizer的内部结构

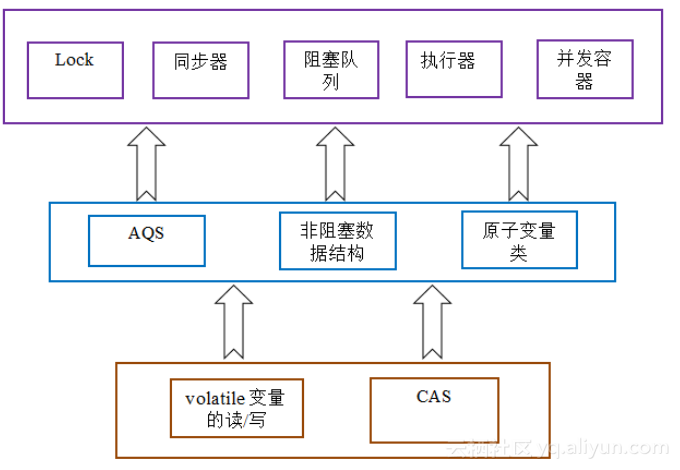
一 前言 虽然已经有很多前辈已经分析过AbstractQueuedSynchronizer(简称AQS,也叫队列同步器)类,但是感觉那些点始终是别人的,看一遍甚至几遍终不会印象深刻。所以还是记录下来印象更深刻,还能和大家一起探讨(这就是重复造轮子的好处,另外也主要是这篇篇幅太长了,犹豫了好久才决定写作)。既然有很多前辈都分析过这个类说明它是多么的重要,下面我们看下concurrent包的实现示意图就清楚AQS的所占有的地位了。 二 什么是AQS AbstractQueuedSynchronizer,中文简称队列同步器,英文简称AQS。它是用来构建锁或者其他同步组件的基础框架,它使用了一个int成员变量表示同步状态,通过内置的FIFO队列来完成资源获取线程的排队工作。从上面图可以看出AQS是实现锁或任意同步组件的关键,通过继承同步器并实现它的抽象方法来管理同步状态等。 三 AQS的内部结构 个人习惯喜欢先看其内部结构,因为内部结果是一个类实现的核心。经过分析得知:AQS类底层的数据结构是使用双向链表,包括head结点和tail结点,head结点主要用作后续的调度。另外还包含一个单向链表,只有当使用Condition时,才会存在此单向链表。并且可能会有多个Condition 链表(其中链表是队列的一种具体表现,所以也可称作队列)。如下图: 四 内部结构源码解析 3.1 类的继承关系 1、说明它是一个抽象类,就说明它可能存在抽象方法需要子类去重写实现(具体有哪些方法需要重写后续会说明)。 2、它还继承了AbstractOwnableSynchronizer(简称AOS)类可以设置独占资源线程和获取独占资源线程(独占锁会涉及到,AOS的源码自己可以进去看看)。 另外建议各位多看看类上的注释,其实还蛮有作用的。 3.2 类的内部类 先分析内部类中的结构再看AQS是怎么引用它的。下面先看Node.class,主要分析都在注释上了。 /** * Wait queue node class. * 注意看类上的注释,上面是原注释的第一行,表示等待队列节点类(虽然实际上是一个双向链表)。 */ static final class Node { /** * 总共分为两者模式:共享和独占 */ /** 在共享模式中等待的节点 */ static final Node SHARED = new Node(); /** 在独占模式中等待的节点 */ static final Node EXCLUSIVE = null; /** * 下面几个表示节点状态,也就是waitStatus所具有可能的值。 */ /** * 标记线程处于取消状态 * 节点进入该状态就不会变化。 * / static final int CANCELLED = 1; /** * 标记后继节点的线程处于等待状态,需要被取消停放(即被唤醒unpark)。 * 变化情况:当当前节点的线程如果释放了同步状态或者被取消,将会通知后继节点,使后继节点的线程得以运行。 */ static final int SIGNAL = -1; /** * 标记线程正在等待条件(Condition),也就是该节点处于等待队列中。 * 变化情况:当其他线程对Condition调用了signal()方法后,该节点将会从等待队列中转移到同步队列中,加入到同步状态的获取中。 */ static final int CONDITION = -2; /** * 表示下一次共享式同步状态获取将会无条件的被传播下去。 */ static final int PROPAGATE = -3; /** * 节点状态,包含上面四种状态(另外还有一种初始化状态0) * 特别注意:它是volatile关键字修饰的,保证对其线程可见性,但是不保证原子性。 * 所以更新状态时,采用CAS方式去更新, 如:compareAndSetWaitStatus */ volatile int waitStatus; /** * 前驱节点,比如当前节点被取消,那就需要前驱节点和后继节点来完成连接。 */ volatile Node prev; /** * 后继节点。 */ volatile Node next; /** * 入队列时的当前线程。 */ volatile Thread thread; /** * 存储condition队列中的后继节点。 */ Node nextWaiter; /** * 判断是否共享模式 */ final boolean isShared() { return nextWaiter == SHARED; } /** * 获取前置节点,如果前置节点为空就抛出异常 */ final Node predecessor() throws NullPointerException { Node p = prev; if (p == null) throw new NullPointerException(); else return p; } // 省略三个构造函数 } 总结下:当每个线程被阻塞时都会封装成一个Node节点,放入队列中。每个节点都包含了当前节点对应的线程、状态、前置节点引用、后继节点引用以及下一个等待者。 其中还需要注意的是waitStatus对应的各个状态代表着什么意思,另外不清楚volatile关键字作用的请前去阅读下。 接下来简单看看ConditionObject的源码,后续我们会单独分析下这个类的作用。 /** * 实现Condition接口 */ public class ConditionObject implements Condition, java.io.Serializable { private static final long serialVersionUID = 1173984872572414699L; /** * 条件队列的第一个节点。 */ private transient AbstractQueuedSynchronizer.Node firstWaiter; /** * 条件队列的最后一个节点。 */ private transient AbstractQueuedSynchronizer.Node lastWaiter; } 从中可以看它还是实现了Condition接口,而Condition接口又定义了什么规范呢?自己去看:),你会不会发现有点跟Object中的几个方法类似呢。 3.3 主要内部成员 // 头结点 private transient volatile Node head; // 尾结点 private transient volatile Node tail; // 同步状态 private volatile int state; 五 总结 通过上述分析就很清楚其内部结构是什么了吧。总结下: 节点(Node)是成为sync队列和condition队列构建的基础,在同步器中就包含了sync队列(Node双向链表)。同步器拥有三个成员变量:sync队列的头结点head、sync队列的尾节点tail和状态state。对于锁的获取,请求形成节点,将其挂载在尾部,而锁资源的转移(释放再获取)是从头部开始向后进行。对于同步器维护的状态state,多个线程对其的获取将会产生一个链式的结构。 文章来源:https://www.cnblogs.com/yuanfy008/p/9608666.html 推荐阅读:https://www.roncoo.com/course/list.html?courseName=%E5%B9%B6%E5%8F%91%E7%BC%96%E7%A8%8B

优秀的个人博客,低调大师

Java编程架构深入解析-RPC 消息协议设计

本节我们开始讲解 RPC 的消息协议设计背后的基本原理,了解 RPC 的协议开发背后有哪些需要考虑的基本点。在通晓原理之后,我们就可以自己设计一套协议来开发属于自己的 RPC 系统。 本节主要涉及的知识点和它们之见的关系如下图: 对于一串消息流,我们必须能确定消息边界,提取出单条消息的字节流片段,然后对这个片段按照一定的规则进行反序列化来生成相应的消息对象。 消息表示指的是序列化后的消息字节流在直观上的表现形式,它看起来是对人类友好还是对计算机友好。文本形式对人类友好,二进制形式对计算机友好。 每个消息都有其内部字段结构,结构构成了消息内部的逻辑规则,程序要按照结构规则来决定字段序列化的顺序。 接下来,我们初步详细拆解。 消息边界 RPC 需要在一条 TCP 链接上进行多次消息传递。在连续的两条消息之间必须有明确的分割规则,以便接收端可以将消息分割开来,这里的接收端可以是 RPC 服务器接收请求,也可以是 RPC 客户端接收响应。 基于 TCP 链接之上的单条消息如果过大,就会被网络协议栈拆分为多个数据包进行传送。如果消息过小,网络协议栈可能会将多个消息组合成一个数据包进行发送。对于接收端来说它看到的只是一串串的字节数组,如果没有明确的消息边界规则,接收端是无从知道这一串字节数组究竟是包含多条消息还是只是某条消息的一部分。 比较常用的两种分割方式是特殊分割符法和长度前缀法。 消息发送端在每条消息的末尾追加一个特殊的分割符,并且保证消息中间的数据不能包含特殊分割符。比如最为常见的分割符是 。当接收端遍历字节数组时发现了 ,就立即可以断定 之前的字节数组是一条完整的消息,可以传递到上层逻辑继续进行处理。HTTP 和 Redis 协议就大量使用了 分割符。此种消息一般要求消息体的内容是文本消息。 消息发送端在每条消息的开头增加一个 4 字节长度的整数值,标记消息体的长度。这样消息接受者首先读取到长度信息,然后再读取相应长度的字节数组就可以将一个完整的消息分离出来。此种消息比较常用于二进制消息。 基于特殊分割符法的优点在于消息的可读性比较强,可以直接看到消息的文本内容,缺点是不适合传递二进制消息,因为二进制的字节数组里面很容易就冒出连续的两个字节内容正好就是 分割符的 ascii 值。如果需要传递的话,一般是对二进制进行 base64 编码转变成普通文本消息再进行传送。 基于长度前缀法的优点和缺点同特殊分割符法正好是相反的。长度前缀法因为适用于二进制协议,所以可读性很差。但是对传递的内容本身没有特殊限制,文本和内容皆可以传输,不需要进行特殊处理。HTTP 协议的 Content-Length 头信息用来标记消息体的长度,这个也可以看成是长度前缀法的一种应用。 HTTP 协议是一种基于特殊分割符和长度前缀法的混合型协议。比如 HTTP 的消息头采用的是纯文本外加 分割符,而消息体则是通过消息头中的 Content-Type 的值来决定长度。HTTP 协议虽然被称之为文本传输协议,但是也可以在消息体中传输二进制数据数据的,例如音视频图像,所以 HTTP 协议被称之为「超文本」传输协议。 消息的结构 每条消息都有它包含的语义结构信息,有些消息协议的结构信息是显式的,还有些是隐式的。比如 json 消息,它的结构就可以直接通过它的内容体现出来,所以它是一种显式结构的消息协议。 json 这种直观的消息协议的可读性非常棒,但是它的缺点也很明显,有太多的冗余信息。比如每个字符串都使用双引号来界定边界,key/value 之间必须有冒号分割,对象之间必须使用大括号分割等等。这些还只是冗余的小头,最大的冗余还在于连续的多条 json 消息即使结构完全一样,仅仅只是 value 的值不一样,也需要发送同样的 key 字符串信息。 消息的结构在同一条消息通道上是可以复用的,比如在建立链接的开始 RPC 客户端和服务器之间先交流协商一下消息的结构,后续发送消息时只需要发送一系列消息的 value 值,接收端会自动将 value 值和相应位置的 key 关联起来,形成一个完成的结构消息。在 Hadoop 系统中广泛使用的 avro 消息协议就是通过这种方式实现的,在 RPC 链接建立之处就开始交流消息的结构,后续消息的传递就可以节省很多流量。 消息的隐式结构一般是指那些结构信息由代码来约定的消息协议,在 RPC 交互的消息数据中只是纯粹的二进制数据,由代码来确定相应位置的二进制是属于哪个字段。比如下面的这段代码 如果纯粹看消息内容是无法知道节点消息内容中的哪些字节的含义,它的消息结构是通过代码的结构顺序来确定的。这种隐式的消息的优点就在于节省传输流量,它完全不需要传输结构信息。 消息压缩 如果消息的内容太大,就要考虑对消息进行压缩处理,这可以减轻网络带宽压力。但是这同时也会加重 CPU 的负担,因为压缩算法是 CPU 计算密集型操作,会导致操作系统的负载加重。所以,最终是否进行消息压缩,一定要根据业务情况加以权衡。 如果确定压缩,那么在选择压缩算法包时,务必挑选那些底层用 C 语言实现的算法库,因为 Python 的字节码执行起来太慢了。比较流行的消息压缩算法有 Google 的 snappy 算法,它的运行性能非常好,压缩比例虽然不是最优的,但是离最优的差距已经不是很大。阿里的 SOFA RPC 就使用了 snappy 作为协议层压缩算法。 流量的极致优化 开源的流行 RPC 消息协议往往对消息流量优化到了极致,它们通过这种方式来打动用户,吸引用户来使用它们。比如对于一个整形数字,一般使用 4 个字节来表示一个整数值。 但是经过研究发现,消息传递中大部分使用的整数值都是很小的非负整数,如果全部使用 4 个字节来表示一个整数会很浪费。所以就发明了一个类型叫变长整数varint。数值非常小时,只需要使用一个字节来存储,数值稍微大一点可以使用 2 个字节,再大一点就是 3 个字节,它还可以超过 4 个字节用来表达长整形数字。 其原理也很简单,就是保留每个字节的最高位的 bit 来标识是否后面还有字节,1 表示还有字节需要继续读,0 表示到读到当前字节就结束。 那如果是负数该怎么办呢?-1 的 16 进制数是 0xFFFFFFFF,如果要按照这个编码那岂不是要 6 个字节才能存的下。-1 也是非常常见的整数啊。 于是 zigzag 编码来了,专门用来解决负数问题。zigzag 编码将整数范围一一映射到自然数范围,然后再进行 varint 编码。 zigzag 将负数编码成正奇数,正数编码成偶数。解码的时候遇到偶数直接除 2 就是原值,遇到奇数就加 1 除 2 再取负就是原值。 小结 现在我们知道了 RPC 消息结构的设计原理,遵循这些基本方法,就可以创造出一个又一个不同的消息协议。 感谢阅读, 迎工作一到五年的Java程序员朋友们加入Java架构开发:468947140 点击链接加入群聊【Java-BATJ企业级资深架构】:https://jq.qq.com/?_wv=1027&k=57Uu0p5 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导

优秀的个人博客,低调大师

Python网络编程(进程池、进程间的通信)

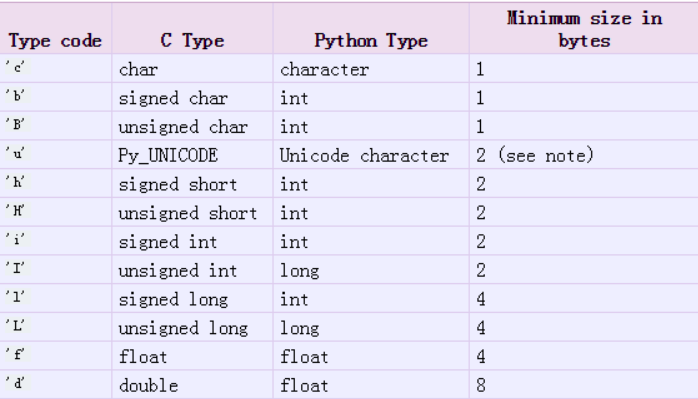
线程池的原理: 线程池是预先创建线程的一种技术。线程池在还没有任务到来之前, 创建一定数量的线程,放入空闲队列中。这些线程都是处于睡眠状态, 即均为启动,不消耗CPU,而只是占用较小的内存空间。当请求到来之后, 缓冲池给这次请求分配一个空闲线程,把请求传入此线程中运行,进行处理。 当预先创建的线程都处于运行状态,即预制线程不够,线程池可以自由创建一定数量的新线程, 用于处理更多的请求。当系统比较闲的时候,也可以通过移除一部分一直处于停用状态的线程。 进程间的通信原理: OS提供了沟通的媒介供进程之间“对话”用。既然要沟通,如同人类社会的沟通一样, 沟通要付出时间和金钱,计算机中也一样,必然有沟通需要付出的成本。 出于所解决问题的特性,OS提供了多种沟通的方式,每种方式的沟通成本也不尽相同, 使用成本和沟通效率也有所不同。我们经常听到的 管道、消息队列、共享内存都是OS提供的供进程之间对话的方式。 Process(target, name, args, kwargs) name: 给 进程取 名字 默认为 Process-1,Process-2..... p.name 查看进程名 args: 以 元组的形式 给target函数传参 kwargs: 以 字典的形式 给对应键的值传参 进程对象的其他 常用属性方法: p.name p.start() p.join() p.pid: 获取创建进程的 pid号 p.is_alive(): 判断进程是处于alive状态 p.daemon: 默认为Flase 如果 设置为True 主进程结束时 杀死所有子进程 daemon属性 一定要在start()前设置 设置daemon 为True 一般 不需要加join() daemon不是真正意义上的守护进程 守护进程: 不受终端控制 后台自动运行 生命周期长 多进程copy一个文件拆分为两个进行保存 import os from multiprocessing import Process from time import sleep #获取文件的大小 size = os.path.getsize("./timg.jpeg") # 获取文件的字节数 # f = open("timg.jpeg",'rb') #复制前半部分 def copy1(img): f = open(img,'rb') # 二进制读取要复制的文件 n = size // 2 fw = open('1.jpeg','wb') # 二进制创建文件 while True: if n < 1024: # 判断文件大小是否大于1024字节 如果小于则直接读取写入 data = f.read(n) fw.write(data) break data = f.read(1024) # 否则每次循环读取1024字节并写入 fw.write(data) n -= 1024 f.close() fw.close() #复制后半部分 def copy2(img): f = open(img,'rb') # 读取文件必须要每次读取 如果在父进程中打开文件流对像 # 子进程会通同时调用一个文件流对像 由于文件流对象特性会记录游标 # 如若先执行后半部复制这前半部会导致读取不到数据 fw = open('2.jpeg','wb') f.seek(size // 2,0) while True: data = f.read(1024) if not data: break fw.write(data) fw.close() f.close() p1 = Process(target = copy1,args = ('timg.jpeg',)) # 创建子进程并让子进程分别同时复制 p2 = Process(target = copy2,args = ('timg.jpeg',)) p1.start() p2.start() p1.join() p2.join() os.path.getsize('./1.txt'): 读取文件大小 注: 1.如果 多个子进程拷贝同一个 父进程的对象则多个 子进程 使用的是同一个对象(如文件队形,套接字,队列,管道。。。) 2.如果在 创建子进程后单独创建的对象,则多个 子进程各不相同 创建子自定义进程类 1.编写类 继承Process 2.在自定义类中 加载父类__init__以获取父类属性, 同时可以 自定义新的属性 3 .重写run方法 在调用start时自动执行该方法 示例: from multiprocessing import Process import time class ClockProcess(Process): def __init__(self,value): #调用父类init super().__init__() self.value = value #重写run方法 def run(self): for i in range(5): time.sleep(self.value) print("The time is {}".format(time.ctime())) p = ClockProcess(2) #自动执行run p.start() p.join() 进程的缺点: 进程在 创建和销毁的过程中 消耗的 资源相对 较多 进程池技术: 产生原因: 如果有大量的任务需要多进程完成,而调用周期比较短且需要频繁创建 此时可能产生大量进程频繁创建销毁的情况 消耗计算机资源较大 使用方法: 1. 创建进程池, 在池内放入适当数量的进程 2. 将事件封装成函数。 放入到 进程池 3.事件不断运行, 直到所有放入进程池事件运行完成 4. 关闭进程池, 回收进程 from multiprocessing import pool pool(Process) 功能: 创建进程池对象 参数:进程数量 返回值:进程池对象 pool = pool() pool.apply_async(fun, args, kwds)(异步执行) 功能: 将事件放入进程池内 参数: fun:要执行的 函数 args:以 元组形式为fun 传参 kwds:以 字典形式为fun 传参 返回值: 返回一个事件对象,通过p. get()函数可以获取fun的返回值 pool.close(): 功能: 关闭进程池,无法再加入新的事件,并等待已有事件结束执行 pool.join() 功能: 回收进程池 pool.apply(fun, args, kwds)(同步执行) 功能:将事件放入进程池内 参数: fun:要执行的函数 args:以元组形式为fun传参 kwds:以字典形式为fun传参 没有返回值 示例: from multiprocessing import Pool from time import sleep,ctime def worker(msg): sleep(2) print(msg) return ctime() #创建进程池对象 pool = Pool(processes = 4) result = [] for i in range(10): msg = "hello %d"%i #将事件放入进程池 r = pool.apply_async(func = worker,args = (msg,)) result.append(r) #同步执行 # pool.apply(func = worker,args = (msg,)) #关闭进程池 pool.close() #回收 pool.join() #获取事件函数返回值 for i in result: print(i.get()) pool.map(func, iter) 功能: 将要执行的 事件放入进程池 参数: func 要执行的 函数 iter 可迭代对象 示例: from multiprocessing import Pool import time def fun(n): time.sleep(1) print("执行 pool map事件",n) return n ** 2 pool = Pool(4) #在进程池放入6个事件 r = pool.map(fun,range(6)) # map高阶函数 fun和iter执行6次 print("返回值列表:",r) pool.close() pool.join() 进程间的通信(IPC) 由于进程 空间独立, 资源无法共享, 此时在 进程间通讯就 需要专门的通讯方法 通信方法: 管道、消息队列、共享内存 信号、信号量、套接字 管道通信: 在内存中 开辟一块内存空间, 形成管道结构 多个进程使用同一个管道,即可通过 对管道的 读写操作进行通讯 multiprocessing --> Pipe fd1,fd2 = Pipe(duplex=True) 功能: 创建管道 参数: 默认表示 双向管道 如果设置为 False则为 单向管道 返回值: 俩个管道对象的,分别表示管道的两端 如果是 双向管道则均可读写 如果是 单向管道则 fd1只读, fd2只写 fd.recv() 功能:从管道 读取信息 返回值:读取到的内容 当 管道为空则阻塞 fd.send(data) 功能: 向管道写入内容 参数:要写入的内容 当 管道满时会阻塞 可以 写入几乎所有 Python所有数据类型 队列通信: 在 内存中 开辟队列结构空间,多个进程可见, 多个进程操作同一个队列对象可以 实现消息存取工作 在取出时 必须按照存入 顺序取出( 先进先出) q = Queue(maxsize=0) 功能: 创建队列对象 参数: maxsize 默认表示根据系统分配空间 储存消息 如果 传入一个正整数则 表示最多 存放多少条消息 返回值:队列对象 q.put(data,[block,timeout]) 功能:向队列 存入消息 参数: data:存入消息( 支持Python数据类型) block:默认 True表示当队 满时阻塞 设置为 False 则为 非阻塞 timeout:当 block为True是表示 超时检测 data = q.get([block,timeout]) 功能:取出消息 参数: block:设置为 True 当队列为 空时阻塞 设置为 False表示 非阻塞 timeout: 当 block为True是表示 超时检测 q.full() 判断队列是否为满 q.empty() 判断队列 是否为空 q.qsize() 获取队列中 消息的数量 q.close() 关闭队列 共享内存通信: 在 内存中开辟一段空间存储数据对多个进程可见, 每次写入共享内存中的内容 都会覆盖之前内容 对内存的 读操作不会改变内存中的内容 form multiprocessing import Value,Array shm = Value(ctype,obj) 功能: 共享内存共享 空间 参数: ctype:字符串 要转换的c语言的数据类型 obj:共享内存的 初始数据 返回值:返回共享内存对象 shm.value: 表示共享内存 的值 示例: from multiprocessing import Process,Value import time import random #创建共享内存 money = Value('i',6000) #存钱 def deposite(): for i in range(100): time.sleep(0.05) #对value的修改就是对共享内存的修改 money.value += random.randint(1,200) #花销 def withdraw(): for i in range(100): time.sleep(0.04) #对value的修改就是对共享内存的修改 money.value -= random.randint(1,200) d = Process(target = deposite) w = Process(target = withdraw) d.start() w.start() d.join() w.join() print(money.value) shm = Array(ctype,obj) 功能: 开辟共享内存 空间 参数: ctype:要转换的数据类型 obj: 要存入共享内容的的数据( 结构化数据) 列表、字符串 表示要存入得内容 要求 数据结构内的 类型相同 整数 表示要 开辟几个单元的空间 返回值: 返回共享内存对象 可迭代对象 示例: from multiprocessing import Process,Array import time #创建共享内存 shm = Array('c',b"hello") #字符类型要求是bytes #开辟5个整形单元的共享内存空间 # shm = Array('i',5) def fun(): for i in shm: print(i) shm[0] = b"H" p = Process(target = fun) p.start() p.join() print(shm.value) #从首地址打印字符串 # for i in shm: # print(i) 三种进程间通信区别: 管道通信: 消息队列: 共享内存: 开辟空间: 内存 内存 内存 读写方式: 两端读写 先进先出 每次覆盖上次内容 单向/双向 效率: 一般 一般 较快 应用: 多用于父子进程 应用灵活广泛 复杂,需要同步互斥

优秀的个人博客,低调大师

java编程细节——你所要知道的Redis

1. 使用Redis有哪些好处? (1) 速度快,因为数据存在内存中,类似于HashMap,HashMap的优势就是查找和操作的时间复杂度都是O(1) (2) 支持丰富数据类型,支持string,list,set,sorted set,hash (3) 支持事务,操作都是原子性,所谓的原子性就是对数据的更改要么全部执行,要么全部不执行 (4) 丰富的特性:可用于缓存,消息,按key设置过期时间,过期后将会自动删除 2. redis相比memcached有哪些优势? (1) memcached所有的值均是简单的字符串,redis作为其替代者,支持更为丰富的数据类型 (2) redis的速度比memcached快很多 (3) redis可以持久化其数据 3. redis常见性能问题和解决方案: (1) Master最好不要做任何持久化工作,如RDB内存快照和AOF日志文件 (2) 如果数据比较重要,某个Slave开启AOF备份数据,策略设置为每秒同步一次 (3) 为了主从复制的速度和连接的稳定性,Master和Slave最好在同一个局域网内 (4) 尽量避免在压力很大的主库上增加从库 (5) 主从复制不要用图状结构,用单向链表结构更为稳定,即:Master <- Slave1 <- Slave2 <- Slave3… 这样的结构方便解决单点故障问题,实现Slave对Master的替换。如果Master挂了,可以立刻启用Slave1做Master,其他不变。 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:468947140 点击链接加入群聊【Java-BATJ企业级资深架构】:https://jq.qq.com/?_wv=1027&k=5zMN6JB 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导 欢迎关注笔者,笔者持续更新。

优秀的个人博客,低调大师

Java编程——重构-你为什么要对参数赋值?

对于学过多门语言的开发者来说,应该都明白在不同语言中对参数赋值有着不同的意义, 总的来说参数有值传递和引用传递两种, 而在Java中只有值传递的概念。 这意味着在方法内对参数赋值是没有意义的。 而且还很容易引起代码的误解。 对于初学者来说这一点比较重要,可能不是很容易理解,我们用例子来说明。 修改参数 我们来看个简单的例子,在这个例子里面我们在方法内对参数进行了修改, 这段代码的输出还不至于让人糊涂, 但如果修改的是对象的话,代码可能就有误导性了 修改参数对象 为了说明这个问题,我写了一个demo代码,当然代码是完全跑不通的。。只是为了让代码更容易理解,所以才这么写, 这段代码理解上来就是,实例化了一个日期对象是4月1日,然后在方法内对日期加了一天, 然后再对这个日期(应该变成了4月2日)换车一个5月2日的对象, 这时候就可以验证对参数赋值和对参数修改的区别所在。 如果这代码运行正常的话,输出应该是下面这样 你看,在方法内对参数赋值是没有意义的,因为Java它传递的是值,而不是引用,所以并不能够修改原引用的数值。 这对于从 C 这种可以传引用的语言转过来的开发者来说其实有点别扭, 当然他们也可能会被这种代码误导。 总结 Java是一门传值语言,在coding中其实应该尽量避免对参数赋值的行为, 如果你看到代码中有这样的代码, 请尽情重构了它吧! 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:468947140 点击链接加入群聊【Java-BATJ企业级资深架构】:https://jq.qq.com/?_wv=1027&k=5zMN6JB 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导 对本文感兴趣、喜欢的欢迎关注小编,小编持续更新

优秀的个人博客,低调大师

Java并发编程笔记之ThreadLocal内存泄漏探究

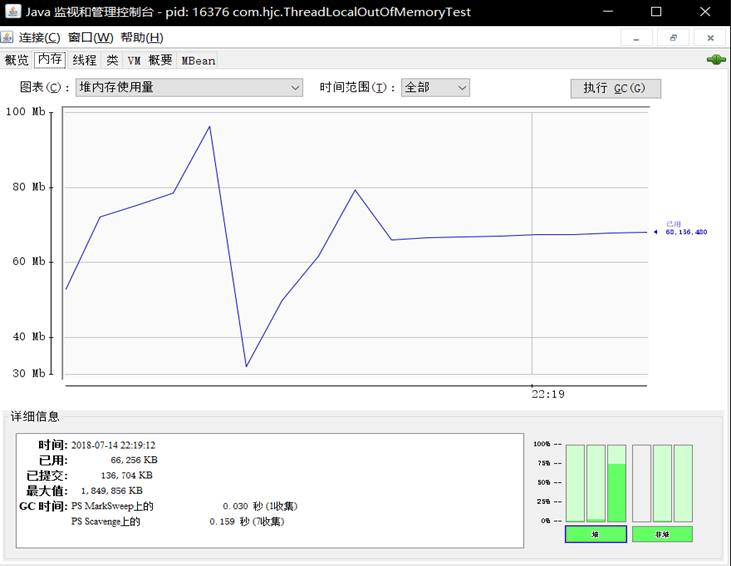
使用 ThreadLocal 不当可能会导致内存泄露,是什么原因导致的内存泄漏呢? 我们首先看一个例子,代码如下: /** * Created by cong on 2018/7/14. */ public class ThreadLocalOutOfMemoryTest { static class LocalVariable { private Long[] a = new Long[1024*1024]; } // (1) final static ThreadPoolExecutor poolExecutor = new ThreadPoolExecutor(6,6,1,TimeUnit.MINUTES, new LinkedBlockingQueue<>()); // (2) final static ThreadLocal<LocalVariable> localVariable = new ThreadLocal<LocalVariable>(); public static void main(String[] args) throws InterruptedException { // (3) for (int i = 0; i < 50; ++i) { poolExecutor.execute(new Runnable() { public void run() { // (4) localVariable.set(new LocalVariable()); // (5) System.out.println("use local varaible"); // localVariable.remove(); } }); Thread.sleep(1000); } // (6) System.out.println("pool execute over"); } } 代码(1)创建了一个核心线程数和最大线程数为 6 的线程池,这个保证了线程池里面随时都有 6 个线程在运行。 代码(2)创建了一个 ThreadLocal 的变量,泛型参数为 LocalVariable,LocalVariable 内部是一个 Long 数组。 代码(3)向线程池里面放入 50 个任务。 代码(4)设置当前线程的 localVariable 变量,也就是把 new 的 LocalVariable 变量放入当前线程的 threadLocals 变量。 由于没有调用线程池的 shutdown 或者 shutdownNow 方法所以线程池里面的用户线程不会退出,进而 JVM 进程也不会退出。 运行后,我们立即打开jconsole监控堆内存变化,如下图: 接着,让我们打开 localVariable.remove() 注释,然后在运行,观察堆内存变化如下: 从第一次运行结果可知,当主线程处于休眠时候进程占用了大概 75M 内存,打开 localVariable.remove() 注释后第二次运行则占用了大概 25M 内存,可知没有写 localVariable.remove()时候内存发生了泄露,下面分析下泄露的原因,如下: 第一次运行的代码,在设置线程的 localVariable 变量后没有调用localVariable.remove()方法,导致线程池里面的 5 个线程的 threadLocals 变量里面的new LocalVariable()实例没有被释放,虽然线程池里面的任务执行完毕了,但是线程池里面的 5 个线程会一直存在直到 JVM 退出。这里需要注意的是由于 localVariable 被声明了 static,虽然线程的 ThreadLocalMap 里面是对 localVariable 的弱引用,localVariable 也不会被回收。运行结果二的代码由于线程在设置 localVariable 变量后即使调用了localVariable.remove()方法进行了清理,所以不会存在内存泄露。 接下来我们要想清楚的知道内存泄漏的根本原因,那么我们就要进入源码去看了。 我们知道ThreadLocal 只是一个工具类,具体存放变量的是在线程的 threadLocals 变量里面,threadLocals 是一个 ThreadLocalMap 类型的,我们首先一览ThreadLocalMap的类图结构,类图结构如下图: 如上图 ThreadLocalMap 内部是一个 Entry 数组, Entry 继承自 WeakReference,Entry 内部的 value 用来存放通过 ThreadLocal 的 set 方法传递的值,那么 ThreadLocal 对象本身存放到哪里了吗? 下面看看 Entry 的构造函数,如下所示: Entry(ThreadLocal<?> k, Object v) { super(k); value = v; } 接着我们再接着看Entry的父类WeakReference的构造函数super(k),如下所示: public WeakReference(T referent) { super(referent); } 接着我们再看WeakReference的父类Reference的构造函数super(referent),如下所示: Reference(T referent) { this(referent, null); } 接着我们再看WeakReference的父类Reference的另外一个构造函数this(referent , null),如下所示: Reference(T referent, ReferenceQueue<? super T> queue) { this.referent = referent; this.queue = (queue == null) ? ReferenceQueue.NULL : queue; } 可知 k 被传递到了 WeakReference 的构造函数里面,也就是说 ThreadLocalMap 里面的 key 为 ThreadLocal 对象的弱引用,具体是 referent 变量引用了 ThreadLocal 对象,value 为具体调用 ThreadLocal 的 set 方法传递的值。 当一个线程调用 ThreadLocal 的 set 方法设置变量时候,当前线程的 ThreadLocalMap 里面就会存放一个记录,这个记录的 key 为 ThreadLocal 的引用,value 则为设置的值。 但是考虑如果这个 ThreadLocal 变量没有了其他强依赖,而当前线程还存在的情况下,由于线程的 ThreadLocalMap 里面的 key 是弱依赖,则当前线程的 ThreadLocalMap 里面的 ThreadLocal 变量的弱引用会被在 gc 的时候回收,但是对应 value 还是会造成内存泄露,这时候 ThreadLocalMap 里面就会存在 key 为 null 但是 value 不为 null 的 entry 项。 其实在 ThreadLocal 的 set 和 get 和 remove 方法里面有一些时机是会对这些 key 为 null 的 entry 进行清理的,但是这些清理不是必须发生的,下面简单讲解ThreadLocalMap 的 remove 方法的清理过程,remove 的源码,如下所示: private void remove(ThreadLocal<?> key) { //(1)计算当前ThreadLocal变量所在table数组位置,尝试使用快速定位方法 Entry[] tab = table; int len = tab.length; int i = key.threadLocalHashCode & (len-1); //(2)这里使用循环是防止快速定位失效后,变量table数组 for (Entry e = tab[i]; e != null; e = tab[i = nextIndex(i, len)]) { //(3)找到 if (e.get() == key) { //(4)找到则调用WeakReference的clear方法清除对ThreadLocal的弱引用 e.clear(); //(5)清理key为null的元素 expungeStaleEntry(i); return; } } } private int expungeStaleEntry(int staleSlot) { Entry[] tab = table; int len = tab.length; //(6)去掉去value的引用 tab[staleSlot].value = null; tab[staleSlot] = null; size--; Entry e; int i; for (i = nextIndex(staleSlot, len); (e = tab[i]) != null; i = nextIndex(i, len)) { ThreadLocal<?> k = e.get(); //(7)如果key为null,则去掉对value的引用。 if (k == null) { e.value = null; tab[i] = null; size--; } else { int h = k.threadLocalHashCode & (len - 1); if (h != i) { tab[i] = null; while (tab[h] != null) h = nextIndex(h, len); tab[h] = e; } } } return i; } 代码(4)调用了 Entry 的 clear 方法,实际调用的是父类 WeakReference 的 clear 方法,作用是去掉对 ThreadLocal 的弱引用。 代码(6)是去掉对 value 的引用,到这里当前线程里面的当前 ThreadLocal 对象的信息被清理完毕了。 代码(7)从当前元素的下标开始看 table 数组里面的其他元素是否有 key 为 null 的,有则清理。循环退出的条件是遇到 table 里面有 null 的元素。所以这里知道 null 元素后面的 Entry 里面 key 为 null 的元素不会被清理。 总结: 1.ThreadLocalMap 内部 Entry 中 key 使用的是对 ThreadLocal 对象的弱引用,这为避免内存泄露是一个进步,因为如果是强引用,那么即使其他地方没有对 ThreadLocal 对象的引用,ThreadLocalMap 中的 ThreadLocal 对象还是不会被回收,而如果是弱引用则这时候 ThreadLocal 引用是会被回收掉的。 2.但是对于的 value 还是不能被回收,这时候 ThreadLocalMap 里面就会存在 key 为 null 但是 value 不为 null 的 entry 项,虽然 ThreadLocalMap 提供了 set,get,remove 方法在一些时机下会对这些 Entry 项进行清理,但是这是不及时的,也不是每次都会执行的,所以一些情况下还是会发生内存泄露,所以在使用完毕后即使调用 remove 方法才是解决内存泄露的最好办法。 3.线程池里面设置了 ThreadLocal 变量一定要记得及时清理,因为线程池里面的核心线程是一直存在的,如果不清理,那么线程池的核心线程的 threadLocals 变量一直会持有 ThreadLocal 变量。

优秀的个人博客,低调大师

Java并发编程笔记之StampedLock锁源码探究

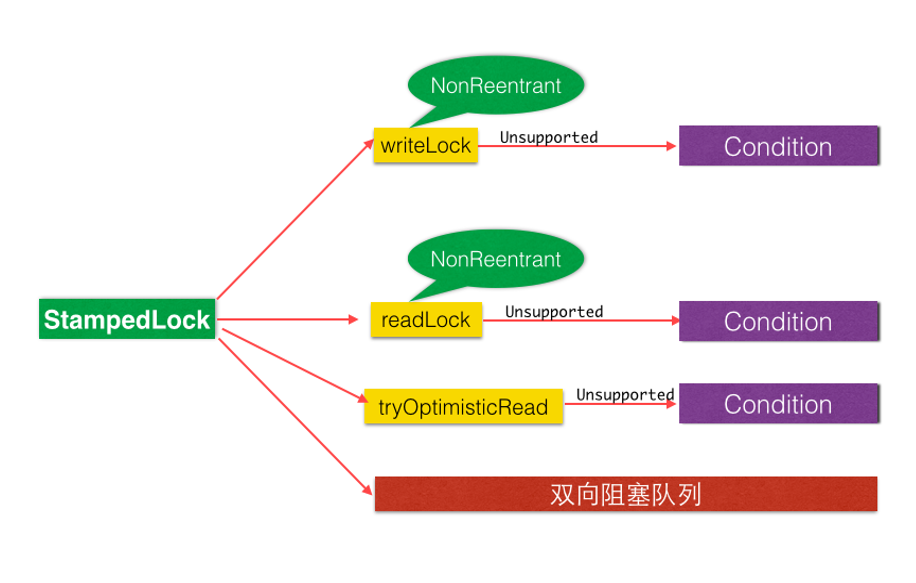
StampedLock是JUC并发包里面JDK1.8版本新增的一个锁,该锁提供了三种模式的读写控制,当调用获取锁的系列函数的时候,会返回一个long 型的变量,该变量被称为戳记(stamp),这个戳记代表了锁的状态。 try系列获取锁的函数,当获取锁失败后会返回为0的stamp值。当调用释放锁和转换锁的方法时候需要传入获取锁时候返回的stamp值。 StampedLockd的内部实现是基于CLH锁的,CLH锁原理:锁维护着一个等待线程队列,所有申请锁且失败的线程都记录在队列。一个节点代表一个线程,保存着一个标记位locked,用以判断当前线程是否已经释放锁。当一个线程试图获取锁时,从队列尾节点作为前序节点,循环判断所有的前序节点是否已经成功释放锁。 如下图所示: 我们首先看Stampedlock有哪些属性先,源码如下: private static final long serialVersionUID = -6001602636862214147L; /** 获取服务器CPU核数 */ private static final int NCPU = Runtime.getRuntime().availableProcessors(); /** 线程入队列前自旋次数 */ private static final int SPINS = (NCPU > 1) ? 1 << 6 : 0; /** 队列头结点自旋获取锁最大失败次数后再次进入队列 */ private static final int HEAD_SPINS = (NCPU > 1) ? 1 << 10 : 0; /** 重新阻塞前的最大重试次数 */ private static final int MAX_HEAD_SPINS = (NCPU > 1) ? 1 << 16 : 0; /** The period for yielding when waiting for overflow spinlock */ private static final int OVERFLOW_YIELD_RATE = 7; // must be power 2 - 1 /** 溢出之前用于阅读器计数的位数 */ private static final int LG_READERS = 7; // 锁定状态和stamp操作的值 private static final long RUNIT = 1L; private static final long WBIT = 1L << LG_READERS; private static final long RBITS = WBIT - 1L; private static final long RFULL = RBITS - 1L; private static final long ABITS = RBITS | WBIT; //前8位都为1 private static final long SBITS = ~RBITS; // 1 1000 0000 //锁state初始值,第9位为1,避免算术时和0冲突 private static final long ORIGIN = WBIT << 1; // 来自取消获取方法的特殊值,因此调用者可以抛出IE private static final long INTERRUPTED = 1L; // WNode节点的status值 private static final int WAITING = -1; private static final int CANCELLED = 1; // WNode节点的读写模式 private static final int RMODE = 0; private static final int WMODE = 1; /** Wait nodes */ static final class WNode { volatile WNode prev; volatile WNode next; volatile WNode cowait; // 读模式使用该节点形成栈 volatile Thread thread; // non-null while possibly parked volatile int status; // 0, WAITING, or CANCELLED final int mode; // RMODE or WMODE WNode(int m, WNode p) { mode = m; prev = p; } } /** CLH队头节点 */ private transient volatile WNode whead; /** CLH队尾节点 */ private transient volatile WNode wtail; // views transient ReadLockView readLockView; transient WriteLockView writeLockView; transient ReadWriteLockView readWriteLockView; /** 锁队列状态, 当处于写模式时第8位为1,读模式时前7为为1-126(附加的readerOverflow用于当读者超过126时) */ private transient volatile long state; /** 将state超过 RFULL=126的值放到readerOverflow字段中 */ private transient int readerOverflow; StampedLockd源码中的WNote就是等待链表队列,每一个WNode标识一个等待线程,whead为CLH队列头,wtail为CLH队列尾,state为锁的状态。long型即64位,倒数第八位标识写锁状态,如果为1,标识写锁占用!下面围绕这个state来讲述锁操作。 首先是常量标识: WBIT=1000 0000(即-128) RBIT =0111 1111(即127) SBIT =1000 0000(后7位表示当前正在读取的线程数量,清0) StampedLock 给我们提供了3种读写模式的锁,如下: 1.写锁writeLock是一个独占锁,同时只有一个线程可以获取该锁,当一个线程获取该锁后,其他请求读锁和写锁的线程必须等待,这跟ReentrantReadWriteLock 的写锁很相似,不过要注意的是StampedLock的写锁是不可重入锁, 当目前没有线程持有读锁或者写锁的时候才可以获取到该锁,请求该锁成功后会返回一个stamp 票据变量来表示该锁的版本,如下源码所示: /** * *获取写锁,获取失败会一直阻塞,直到获得锁成功 * @return 可以用来解锁或转换模式的戳记(128的整数) */ public long writeLock() { long s, next; return ((((s = state) & ABITS) == 0L && // 完全没有任何锁(没有读锁和写锁)的时候可以通过 U.compareAndSwapLong(this, STATE, s, next = s + WBIT)) ? //第8位置为1 next : acquireWrite(false, 0L)); } writeLock():典型的cas操作,如果STATE等于s,设置写锁位为1(s+WBIT)。acquireWrite跟acquireRead逻辑类似,先自旋尝试、加入等待队列、直至最终Unsafe.park()挂起线程。 private long acquireWrite(boolean interruptible, long deadline) { WNode node = null, p; for (int spins = -1;;) { // 入队时自旋 long m, s, ns; //无锁 if ((m = (s = state) & ABITS) == 0L) { if (U.compareAndSwapLong(this, STATE, s, ns = s + WBIT)) return ns; } else if (spins < 0) //持有写锁,并且队列为空 spins = (m == WBIT && wtail == whead) ? SPINS : 0; else if (spins > 0) { //恒成立 if (LockSupport.nextSecondarySeed() >= 0) --spins; } else if ((p = wtail) == null) { //初始化队列,写锁入队列 WNode hd = new WNode(WMODE, null); if (U.compareAndSwapObject(this, WHEAD, null, hd)) wtail = hd; } else if (node == null) //不为空,写锁入队列 node = new WNode(WMODE, p); else if (node.prev != p) node.prev = p; else if (U.compareAndSwapObject(this, WTAIL, p, node)) { p.next = node; break;//入队列成功退出循环 } } for (int spins = -1;;) { WNode h, np, pp; int ps; //前驱节点为头节点 if ((h = whead) == p) { if (spins < 0) spins = HEAD_SPINS; else if (spins < MAX_HEAD_SPINS) spins <<= 1; for (int k = spins;;) { // spin at head long s, ns; //无锁 if (((s = state) & ABITS) == 0L) { if (U.compareAndSwapLong(this, STATE, s, ns = s + WBIT)) { //当前节点设置为头结点 whead = node; node.prev = null; return ns; } } else if (LockSupport.nextSecondarySeed() >= 0 && --k <= 0) break; } } else if (h != null) { // help release stale waiters WNode c; Thread w; //头结点为读锁将栈中所有读锁线程唤醒 while ((c = h.cowait) != null) { if (U.compareAndSwapObject(h, WCOWAIT, c, c.cowait) && (w = c.thread) != null) U.unpark(w); } } // if (whead == h) { if ((np = node.prev) != p) { if (np != null) (p = np).next = node; // stale } else if ((ps = p.status) == 0) //前驱节点置为等待状态 U.compareAndSwapInt(p, WSTATUS, 0, WAITING); else if (ps == CANCELLED) { if ((pp = p.prev) != null) { node.prev = pp; pp.next = node; } } else { long time; // 0 argument to park means no timeout if (deadline == 0L) time = 0L; else if ((time = deadline - System.nanoTime()) <= 0L) return cancelWaiter(node, node, false); Thread wt = Thread.currentThread(); U.putObject(wt, PARKBLOCKER, this); node.thread = wt; if (p.status < 0 && (p != h || (state & ABITS) != 0L) && whead == h && node.prev == p) U.park(false, time); // emulate LockSupport.park node.thread = null; U.putObject(wt, PARKBLOCKER, null); if (interruptible && Thread.interrupted()) return cancelWaiter(node, node, true); } } } } 并且StampedLock还提供了非阻塞tryWriteLock方法,源码如下: /** * 没有任何锁时则获取写锁,否则返回0 * * @return 可以用来解锁或转换模式的戳记(128的整数),获取失败返回0 */ public long tryWriteLock() { long s, next; return ((((s = state) & ABITS) == 0L && U.compareAndSwapLong(this, STATE, s, next = s + WBIT)) ? next : 0L); } /** * unit时间内获得写锁成功返回状态值,失败返回0,或抛出InterruptedException * @return 0:获得锁失败 * @throws InterruptedException 线程获得锁之前调用interrupt()方法抛出的异常 */ public long tryWriteLock(long time, TimeUnit unit) throws InterruptedException { long nanos = unit.toNanos(time); if (!Thread.interrupted()) { long next, deadline; if ((next = tryWriteLock()) != 0L) //获得锁成功 return next; if (nanos <= 0L) //超时返回0 return 0L; if ((deadline = System.nanoTime() + nanos) == 0L) deadline = 1L; if ((next = acquireWrite(true, deadline)) != INTERRUPTED) //规定时间内获得锁结果 return next; } throw new InterruptedException(); } 当释放该锁的时候需要调用unlockWrite方法并传递获取锁的时候的stamp参数。源码如下: /** * state匹配stamp则释放写锁, * @throws IllegalMonitorStateException 不匹配则抛出异常 */ public void unlockWrite(long stamp) { WNode h; //state不匹配stamp 或者 没有写锁 if (state != stamp || (stamp & WBIT) == 0L) throw new IllegalMonitorStateException(); //state += WBIT, 第8位置为0,但state & SBITS 会循环,一共有4个值 state = (stamp += WBIT) == 0L ? ORIGIN : stamp; if ((h = whead) != null && h.status != 0) //唤醒继承者节点线程 release(h); } unlockWrite():释放锁与加锁动作相反。将写标记位清零,如果state溢出,则退回到初始值; 2.悲观锁readLock,是个共享锁,在没有线程获取独占写锁的情况下,同时多个线程可以获取该锁;如果已经有线程持有写锁,其他线程请求获取该锁会被阻塞,这类似ReentrantReadWriteLock 的读锁(不同在于这里的读锁是不可重入锁)。 这里说的悲观是指在具体操作数据前,悲观的认为其他线程可能要对自己操作的数据进行修改,所以需要先对数据加锁,这是在读少写多的情况下的一种考虑,请求该锁成功后会返回一个stamp票据变量来表示该锁的版本,源码如下: /** * 悲观读锁,非独占锁,为获得锁一直处于阻塞状态,直到获得锁为止 */ public long readLock() { long s = state, next; // 队列为空 && 没有写锁同时读锁数小于126 && CAS修改状态成功 则状态加1并返回,否则自旋获取读锁 return ((whead == wtail && (s & ABITS) < RFULL && U.compareAndSwapLong(this, STATE, s, next = s + RUNIT)) ? next : acquireRead(false, 0L)); } 乐观锁失败后锁升级为readLock():尝试state+1,用于统计读线程的数量,如果失败,进入acquireRead()进行自旋,通过CAS获取锁。 如果自旋失败,入CLH队列,然后再自旋,如果成功获得读锁,则激活cowait队列中的读线程Unsafe.unpark(),如果最终依然失败,则Unsafe().park()挂起当前线程。 /** * @param interruptible 是否允许中断 * @param 标识超时限时(0代表不限时),然后进入循环。 * @return next state, or INTERRUPTED */ private long acquireRead(boolean interruptible, long deadline) { WNode node = null, p; //自旋 for (int spins = -1;;) { WNode h; //判断队列为空 if ((h = whead) == (p = wtail)) { //定义 long m,s,ns,并循环 for (long m, s, ns;;) { //将state超过 RFULL=126的值放到readerOverflow字段中 if ((m = (s = state) & ABITS) < RFULL ? U.compareAndSwapLong(this, STATE, s, ns = s + RUNIT) : (m < WBIT && (ns = tryIncReaderOverflow(s)) != 0L)) //获取锁成功返回 return ns; //state高8位大于0,那么说明当前锁已经被写锁独占,那么我们尝试自旋 + 随机的方式来探测状态 else if (m >= WBIT) { if (spins > 0) { if (LockSupport.nextSecondarySeed() >= 0) --spins; } else { if (spins == 0) { WNode nh = whead, np = wtail; //一直获取锁失败,或者有线程入队列了退出内循环自旋,后续进入队列 if ((nh == h && np == p) || (h = nh) != (p = np)) break; } //自旋 SPINS 次 spins = SPINS; } } } } if (p == null) { //初始队列 WNode hd = new WNode(WMODE, null); if (U.compareAndSwapObject(this, WHEAD, null, hd)) wtail = hd; } //当前节点为空则构建当前节点,模式为RMODE,前驱节点为p即尾节点。 else if (node == null) node = new WNode(RMODE, p); //当前队列为空即只有一个节点(whead=wtail)或者当前尾节点的模式不是RMODE,那么我们会尝试在尾节点后面添加该节点作为尾节点,然后跳出外层循环 else if (h == p || p.mode != RMODE) { if (node.prev != p) node.prev = p; else if (U.compareAndSwapObject(this, WTAIL, p, node)) { p.next = node; //入队列成功,退出自旋 break; } } //队列不为空并且是RMODE模式, 添加该节点到尾节点的cowait链(实际上构成一个读线程stack)中 else if (!U.compareAndSwapObject(p, WCOWAIT, node.cowait = p.cowait, node)) //失败处理 node.cowait = null; else { //通过CAS方法将该节点node添加至尾节点的cowait链中,node成为cowait中的顶元素,cowait构成了一个LIFO队列。 //循环 for (;;) { WNode pp, c; Thread w; //尝试unpark头元素(whead)的cowait中的第一个元素,假如是读锁会通过循环释放cowait链 if ((h = whead) != null && (c = h.cowait) != null && U.compareAndSwapObject(h, WCOWAIT, c, c.cowait) && (w = c.thread) != null) U.unpark(w); //node所在的根节点p的前驱就是whead或者p已经是whead或者p的前驱为null if (h == (pp = p.prev) || h == p || pp == null) { long m, s, ns; do { //根据state再次积极的尝试获取锁 if ((m = (s = state) & ABITS) < RFULL ? U.compareAndSwapLong(this, STATE, s, ns = s + RUNIT) : (m < WBIT && (ns = tryIncReaderOverflow(s)) != 0L)) return ns; } while (m < WBIT);//条件为读模式 } if (whead == h && p.prev == pp) { long time; if (pp == null || h == p || p.status > 0) { //这样做的原因是被其他线程闯入夺取了锁,或者p已经被取消 node = null; // throw away break; } if (deadline == 0L) time = 0L; else if ((time = deadline - System.nanoTime()) <= 0L) return cancelWaiter(node, p, false); Thread wt = Thread.currentThread(); U.putObject(wt, PARKBLOCKER, this); node.thread = wt; if ((h != pp || (state & ABITS) == WBIT) && whead == h && p.prev == pp) U.park(false, time); node.thread = null; U.putObject(wt, PARKBLOCKER, null); //出现的中断情况下取消当前节点的cancelWaiter操作 if (interruptible && Thread.interrupted()) return cancelWaiter(node, p, true); } } } } for (int spins = -1;;) { //......都是类似的代码 } } 并且StampedLock还提供了非阻塞tryReadLock方法,源码如下: /** * 可以立即获得锁,则获取读锁,否则返回0 */ public long tryReadLock() { for (;;) { long s, m, next; //持有写锁返回0 if ((m = (s = state) & ABITS) == WBIT) return 0L; //读线程数 < RFULL,CAS变更状态 else if (m < RFULL) { if (U.compareAndSwapLong(this, STATE, s, next = s + RUNIT)) return next; } //将state超过 RFULL的值放到readerOverflow字段 else if ((next = tryIncReaderOverflow(s)) != 0L) return next; } } /** * unit时间内获得读锁成功返回状态值,失败返回0,或抛出InterruptedException */ public long tryReadLock(long time, TimeUnit unit) throws InterruptedException { long s, m, next, deadline; long nanos = unit.toNanos(time); if (!Thread.interrupted()) { if ((m = (s = state) & ABITS) != WBIT) { if (m < RFULL) { if (U.compareAndSwapLong(this, STATE, s, next = s + RUNIT)) return next; } else if ((next = tryIncReaderOverflow(s)) != 0L) return next; } if (nanos <= 0L) return 0L; if ((deadline = System.nanoTime() + nanos) == 0L) deadline = 1L; if ((next = acquireRead(true, deadline)) != INTERRUPTED) return next; } throw new InterruptedException(); } StampedLock的悲观读锁readLock 当释放该锁时候需要 unlockRead 并传递参数 stamp。源码如下: /** * state匹配stamp则释放读锁, */ public void unlockRead(long stamp) { long s, m; WNode h; for (;;) { //不匹配抛出异常 if (((s = state) & SBITS) != (stamp & SBITS) || (stamp & ABITS) == 0L || (m = s & ABITS) == 0L || m == WBIT) throw new IllegalMonitorStateException(); //小于最大记录数值 if (m < RFULL) { if (U.compareAndSwapLong(this, STATE, s, s - RUNIT)) { if (m == RUNIT && (h = whead) != null && h.status != 0) release(h); break; } } //否则readerOverflow减一 else if (tryDecReaderOverflow(s) != 0L) break; } } 3.乐观读锁 tryOptimisticRead,是相对于悲观锁来说的,在操作数据前并没有通过 CAS 设置锁的状态,仅仅是通过位运算测试;如果当前没有线程持有写锁,则简单的返回一个非 0 的 stamp 版本信息, 获取该 stamp 后在具体操作数据前还需要调用 validate 验证下该 stamp 是否已经不可用,也就是看当调用 tryOptimisticRead 返回 stamp 后,到当前时间是否有其它线程持有了写锁,如果是那么 validate 会返回 0, 否者就可以使用该 stamp 版本的锁对数据进行操作。由于 tryOptimisticRead 并没有使用 CAS 设置锁状态,所以不需要显示的释放该锁。 该锁的一个特点是适用于读多写少的场景,因为获取读锁只是使用位操作进行检验,不涉及 CAS 操作,所以效率会高很多,但是同时由于没有使用真正的锁,在保证数据一致性上需要拷贝一份要操作的变量到方法栈,并且在操作数据时候可能其它写线程已经修改了数据, 而我们操作的是方法栈里面的数据,也就是一个快照,所以最多返回的不是最新的数据,但是一致性还是得到保障的。源码如下: /** * 获取乐观读锁,返回邮票stamp */ public long tryOptimisticRead() { long s; //有写锁返回0. 否则返回256 return (((s = state) & WBIT) == 0L) ? (s & SBITS) : 0L; } /** * 验证从调用tryOptimisticRead开始到现在这段时间内有无写锁占用过锁资源,有写锁获得过锁资源则返回false. stamp为0返回false. * @return 从返回stamp开始,没有写锁获得过锁资源返回true,否则返回false */ public boolean validate(long stamp) { //强制读取操作和验证操作在一些情况下的内存排序问题 U.loadFence(); //当持有写锁后再释放写锁,该校验也不成立,返回false return (stamp & SBITS) == (state & SBITS); } StamedLock还支持这三种锁在一定条件下进行相互转换,例如long tryConvertToWriteLock(long stamp)期望把stamp标示的锁升级为写锁,这个函数会在下面几种情况下返回一个有效的 stamp(也就是晋升写锁成功): 1.当前锁已经是写锁模式了。 2.当前锁处于读锁模式,并且没有其他线程是读锁模式 3.当前处于乐观读模式,并且当前写锁可用。 源码如下: /** * state匹配stamp时, 执行下列操作之一. * 1、stamp 已经持有写锁,直接返回. * 2、读模式,但是没有更多的读取者,并返回一个写锁stamp. * 3、有一个乐观读锁,只在即时可用的前提下返回一个写锁stamp * 4、其他情况都返回0 */ public long tryConvertToWriteLock(long stamp) { long a = stamp & ABITS, m, s, next; //state匹配stamp while (((s = state) & SBITS) == (stamp & SBITS)) { //没有锁 if ((m = s & ABITS) == 0L) { if (a != 0L) break; //CAS修改状态为持有写锁,并返回 if (U.compareAndSwapLong(this, STATE, s, next = s + WBIT)) return next; } //持有写锁 else if (m == WBIT) { if (a != m) //其他线程持有写锁 break; //当前线程已经持有写锁 return stamp; } //有一个读锁 else if (m == RUNIT && a != 0L) { //释放读锁,并尝试持有写锁 if (U.compareAndSwapLong(this, STATE, s, next = s - RUNIT + WBIT)) return next; } else break; } return 0L; } /** * state匹配stamp时, 执行下列操作之一. 1、stamp 表示持有写锁,释放写锁,并持有读锁 2 stamp 表示持有读锁 ,返回该读锁 3 有一个乐观读锁,只在即时可用的前提下返回一个读锁stamp 4、其他情况都返回0,表示失败 * */ public long tryConvertToReadLock(long stamp) { long a = stamp & ABITS, m, s, next; WNode h; //state匹配stamp while (((s = state) & SBITS) == (stamp & SBITS)) { //没有锁 if ((m = s & ABITS) == 0L) { if (a != 0L) break; else if (m < RFULL) { if (U.compareAndSwapLong(this, STATE, s, next = s + RUNIT)) return next; } else if ((next = tryIncReaderOverflow(s)) != 0L) return next; } //写锁 else if (m == WBIT) { //非当前线程持有写锁 if (a != m) break; //释放写锁持有读锁 state = next = s + (WBIT + RUNIT); if ((h = whead) != null && h.status != 0) release(h); return next; } //持有读锁 else if (a != 0L && a < WBIT) return stamp; else break; } return 0L; } 还有一个转换成乐观锁tryConvertToOptimisticRead(long stamp) ,这里就不讲了,道理都差不多。 另外StampedLock 的读写锁都是不可重入锁,所以当获取锁后释放锁前,不应该再调用会获取锁的操作,以避免产生死锁。 当多个线程同时尝试获取读锁和写锁的时候,谁先获取锁没有一定的规则,完全都是尽力而为,是随机的,并且该锁不是直接实现 Lock 或 ReadWriteLock 接口,而是内部自己维护了一个双向阻塞队列。 下面通过 JDK8 里面提供的一个管理二维点的例子讲解来加深对上面讲解的理解。代码如下所示: package com.hjc; import java.util.concurrent.locks.StampedLock; /** * Created by cong on 2018/6/16. */ public class Point { // 成员变量 private double x, y; // 锁实例 private final StampedLock sl = new StampedLock(); // 排它锁-写锁(writeLock) void move(double deltaX, double deltaY) { long stamp = sl.writeLock(); try { x += deltaX; y += deltaY; } finally { sl.unlockWrite(stamp); } } // 乐观读锁(tryOptimisticRead) double distanceFromOrigin() { // 尝试获取乐观读锁(1) long stamp = sl.tryOptimisticRead(); // 将全部变量拷贝到方法体栈内(2) double currentX = x, currentY = y; // 检查在(1)获取到读锁票据后,锁有没被其它写线程排它性抢占(3) if (!sl.validate(stamp)) { // 如果被抢占则获取一个共享读锁(悲观获取)(4) stamp = sl.readLock(); try { // 将全部变量拷贝到方法体栈内(5) currentX = x; currentY = y; } finally { // 释放共享读锁(6) sl.unlockRead(stamp); } } // 返回计算结果(7) return Math.sqrt(currentX * currentX + currentY * currentY); } // 使用悲观锁获取读锁,并尝试转换为写锁 void moveIfAtOrigin(double newX, double newY) { // 这里可以使用乐观读锁替换(1) long stamp = sl.readLock(); try { // 如果当前点在原点则移动(2) while (x == 0.0 && y == 0.0) { // 尝试将获取的读锁升级为写锁(3) long ws = sl.tryConvertToWriteLock(stamp); // 升级成功,则更新票据,并设置坐标值,然后退出循环(4) if (ws != 0L) { stamp = ws; x = newX; y = newY; break; } else { // 读锁升级写锁失败则释放读锁,显示获取独占写锁,然后循环重试(5) sl.unlockRead(stamp); stamp = sl.writeLock(); } } } finally { // 释放锁(6) sl.unlock(stamp); } } } 如上代码 Point 类里面有两个成员变量(x,y) 来标示一个点的二维坐标,和三个操作坐标变量的方法,另外实例化了一个 StampedLock 对象用来保证操作的原子性。 首先分析下 move 方法,该函数作用是使用参数的增量值,改变当前 point 坐标的位置;代码先获取到了写锁,然后对 point 坐标进行修改,然后释放锁。 该锁是排它锁,这保证了其它线程调用 move 函数时候会被阻塞,也保证了其它线程不能获取读锁,读取坐标的值,直到当前线程显示释放了写锁, 也就是保证了对变量 x,y 操作的原子性和数据一致性。 接下来再看 distanceFromOrigin 方法,该方法作用是计算当前位置到原点(坐标为 0,0)的距离,代码(1)首先尝试获取乐观读锁,如果当前没有其它线程获取到了写锁,那么(1)会返回一个非 0 的 stamp 用来表示版本信息,代码(2)拷贝坐标变量到本地方法栈里面。 代码(3)检查在(1)获取到的 stamp 值是否还有效,之所以还要在此校验是因为代码(1)获取读锁时候并没有通过 CAS 操作修改锁的状态,而是简单的通过与或操作返回了一个版本信息,这里校验是看在在获取版本信息到现在的时间段里面是否有其它线程持有了写锁,如果有则之前获取的版本信息就无效了。 这里如果校验成功则执行(7)使用本地方法栈里面的值进行计算然后返回。需要注意的是在代码(3) 校验成功后,代码(7)计算期间,其它线程可能获取到了写锁并且修改了 x,y 的值,而当前线程执行代码(7)进行计算时候采用的还是修改前值的拷贝,也就是操作的值是对之前值的一个拷贝,一个快照,并不是最新的值。 也许我们会想,代码(2) 和(3)能否互换?。 答案是明显不能的,如果位置换了,那么首先执行validate ,假设验证通过了,要拷贝x,y 值到本地方法栈,而在拷贝的过程中很有可能其他线程已经修改过了x,y 中的一个,这就造成了数据的不一致性了。 那么你可能还会这样会想,即使不交换代码 (2) 和(3),在拷贝 x,y 值到本地方法栈里面时,也会存在其他线程修改了x,y中的一个值,这不也会存在问题吗? 这个确实会存在,但是别忘记了拷贝后还有一道validate,如果这时候有线程修改了x,y 中的值,那么肯定是有线程在调用 validate 前,调用 sl.tryOptimisticRead 后获取了写锁,那么进行 validate 时候就会失败。 好了知道这么多原理后,我们就会惊叹这也是乐观读设计的精妙之处也是使用时候容易出问题的地方。下面继续分析 validate 失败后会执行代码(4)获取悲观读锁,如果这时候其他线程持有写锁则代码(4)会导致的当前线程阻塞直到其它线程释放了写锁。 如果这时候没有其他线程获取到写锁,那么当前线程就可以获取到读锁,然后执行代码(5)重新拷贝新的坐标值到本地方法栈,然后就是代码(6)释放了锁,拷贝的时候由于加了读锁,所以拷贝期间其它线程获取写锁时候会被阻塞, 这保证了数据的一致性,另外这里 x,y 没有被声明为 volatie,会不会存在内存不可见性问题那?答案是不会,因为加锁的语义保证了内存可见性, 最后代码(7)使用方法栈里面数据计算返回,同理这里在计算时候使用的数据也可能不是最新的,其它写线程可能已经修改过原来的 x,y 值了。 最后一个方法 moveIfAtOrigin 作用是如果当前坐标为原点则移动到指定的位置。代码(1)获取悲观读锁,保证其它线程不能获取写锁修改 x,y 值,然后代码(2)判断如果当前点在原点则更新坐标, 代码(3) 尝试升级读锁为写锁,这里升级不一定成功,因为多个线程都可以同时获取悲观读锁,当多个线程都执行到(3)时候只有一个可以升级成功,升级成功则返回非 0 的 stamp,否非返回 0。 这里假设当前线程升级成功,然后执行步骤(4)更新 stamp 值和坐标值,然后退出循环。如果升级失败则执行步骤(5)首先释放读锁然后申请写锁,获取到写锁后在循环重新设置坐标值。最后步骤(6) 释放锁。 使用乐观读锁还是很容易犯错误的,必须要严谨,必须要保证如下的使用顺序,用伪代码作为讲解,如下: long stamp = lock.tryOptimisticRead(); //非阻塞获取版本信息 copyVaraibale2ThreadMemory();//拷贝变量到线程本地堆栈 if(!lock.validate(stamp)){ // 校验 long stamp = lock.readLock();//获取读锁 try { copyVaraibale2ThreadMemory();//拷贝变量到线程本地堆栈 } finally { lock.unlock(stamp);//释放悲观锁 } } useThreadMemoryVarables();//使用线程本地堆栈里面的数据进行操作 总结:StampedLock 提供的读写锁与 ReentrantReadWriteLock 类似,只是前者的都是不可重入锁。但是前者通过提供乐观读锁在多线程多读的情况下提供更好的性能,这是因为获取乐观读锁时候不需要进行 CAS 操作设置锁的状态,而只是简单的测试状态。

优秀的个人博客,低调大师

京东2018秋招笔试编程题集合

1.括号匹配方案 合法的括号匹配序列被定义为: 空串""是合法的括号序列 如果"X"和"Y"是合法的序列,那么"XY"也是一个合法的括号序列 如果"X"是一个合法的序列,那么"(X)"也是一个合法的括号序列 每个合法的括号序列都可以由上面的规则生成 例如"", "()", "()()()", "(()())", "(((())))"都是合法的。 东东现在有一个合法的括号序列s,一次移除操作分为两步: 移除序列s中第一个左括号 移除序列s中任意一个右括号.保证操作之后s还是一个合法的括号序列 东东现在想知道使用上述的移除操作有多少种方案可以把序列s变为空 如果两个方案中有一次移除操作移除的是不同的右括号就认为是不同的方案。 例如: s = "()()()()()",输出1, 因为每次都只能选择被移除的左括号所相邻的右括号. s = "(((())))",输出24, 第一次有4种情况, 第二次有3种情况, ... ,依次类推, 4 * 3 * 2 * 1 = 24 输入描述: 输入包括一行,一个合法的括号序列s,序列长度length(2 ≤ length ≤ 20). 输出描述: 输出一个整数,表示方案数 输入例子1: (((()))) 输出例子1: 24 思路: 遍历字符串,每次把左括号都压入栈,每次遇到右括号,先统计栈中有几个左括号,统计数与上次统计数相乘 接着弹出栈中的一个左括号 直到遍历结束,结果即为方案数 代码: import java.util.Scanner; import java.util.Stack; public class BracketMatch { public static void main(String[] args) { Scanner sc = new Scanner(System.in); String s = sc.next(); Stack<Character> stack = new Stack<>(); int result = 1; char c; for (int i = 0; i < s.length(); i++) { c = s.charAt(i); if (c == '(') { stack.push(c); } if (c == ')') { int size = stack.size(); result *= size; stack.pop(); } } System.out.println(result); } } 2.神奇数 东东在一本古籍上看到有一种神奇数,如果能够将一个数的数字分成两组,其中一组数字的和等于另一组数字的和,我们就将这个数称为神奇数。例如242就是一个神奇数,我们能够将这个数的数字分成两组,分别是{2,2}以及{4},而且这两组数的和都是4.东东现在需要统计给定区间中有多少个神奇数,即给定区间[l, r],统计这个区间中有多少个神奇数,请你来帮助他。 输入描述: 输入包括一行,一行中两个整数l和r(1 ≤ l, r ≤ 10^9, 0 ≤ r - l ≤ 10^6),以空格分割 输出描述: 输出一个整数,即区间内的神奇数个数 输入例子1: 1 50 输出例子1: 4 思路: 首先判断数组能否被平分,即数组分割问题, dp[i][j]表示数组前i个数字能否求和得到 j 则dp[i][j]=dp[i−1][j]||dp[i−1][j−array[i]],其中||是逻辑或运算。 优化: 1、若sum(array)为奇数,直接返回false 2、使用逆序循环将dp数组简化为一维数组 代码: import java.util.Arrays; import java.util.Scanner; public class MagicNumber { public static boolean isMagic(int[] nums, int sum) { int len = nums.length; if (sum % 2 != 0) return false; int mid = sum / 2; int[] dp = new int[mid + 1]; dp[0] = 1; for (int i = 0; i < len; i++) { for (int j = mid; j > 0; j--) { if (j >= nums[i] && nums[i] != -1) dp[j] = Math.max(dp[j], dp[j - nums[i]]); } } if (dp[mid] > 0) return true; else return false; } public static void main(String[] args) { Scanner sc = new Scanner(System.in); int l = sc.nextInt(); int r = sc.nextInt(); int result = 0; for (int i = l; i <= r; i++) { int num = I; int[] nums = new int[10]; int sum = 0; Arrays.fill(nums, -1); int index = 0; while (num > 0) { int temp = num % 10; nums[index++] = temp; sum += temp; num = num / 10; } if (isMagic(nums, sum)) { result++; } } System.out.println(result); } }

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册