首页 文章 精选 留言 我的

精选列表

搜索[AI编程],共10000篇文章
优秀的个人博客,低调大师

Java并发编程的艺术(十)——线程池(1)

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/79612287 线程池的作用 减少资源的开销减少了每次创建线程、销毁线程的开销。 提高响应速度每次请求到来时,由于线程的创建已经完成,故可以直接执行任务,因此提高了响应速度。 提高线程的可管理性线程是一种稀缺资源,若不加以限制,不仅会占用大量资源,而且会影响系统的稳定性。因此,线程池可以对线程的创建与停止、线程数量等等因素加以控制,使得线程在一种可控的范围内运行,不仅能保证系统稳定运行,而且方便性能调优。 线程池的实现原理 线程池一般由两种角色构成:多个工作线程 和 一个阻塞队列。 工作线程工作线程是一组已经处在运行中的线程,它们不断地向阻塞队列中领取任务执行。 阻塞队列阻塞队列用于存储工作线程来不及处理的任务。当工作线程都在执行任务时,到来的新任务就只能暂时在阻塞队列中存储。 ThreadPoolExecutor的使用 创建线程池 通过如下代码即可创建一个线程池: new ThreadPoolExecutor(corePoolSize, maximumPoolSize, keepAliveTime, timeUnit, runnableTaskQueue, handler); 1 corePoolSize:基本线程数量它表示你希望线程池达到的一个值。线程池会尽量把实际线程数量保持在这个值上下。 maximumPoolSize:最大线程数量这是线程数量的上界。如果实际线程数量达到这个值: 阻塞队列未满:任务存入阻塞队列等待执行 阻塞队列已满:调用饱和策略 keepAliveTime:空闲线程的存活时间当实际线程数量超过corePoolSize时,若线程空闲的时间超过该值,就会被停止。PS:当任务很多,且任务执行时间很短的情况下,可以将该值调大,提高线程利用率。 timeUnit:keepAliveTime的单位 runnableTaskQueue:任务队列这是一个存放任务的阻塞队列,可以有如下几种选择: ArrayBlockingQueue它是一个由数组实现的阻塞队列,FIFO。 LinkedBlockingQueue它是一个由链表实现的阻塞队列,FIFO。吞吐量通常要高于ArrayBlockingQueue。fixedThreadPool使用的阻塞队列就是它。它是一个无界队列。 SynchronousQueue它是一个没有存储空间的阻塞队列,任务提交给它之后必须要交给一条工作线程处理;如果当前没有空闲的工作线程,则立即创建一条新的工作线程。cachedThreadPool用的阻塞队列就是它。它是一个无界队列。 PriorityBlockingQueue它是一个优先权阻塞队列。 handler:饱和策略当实际线程数达到maximumPoolSize,并且阻塞队列已满时,就会调用饱和策略。JDK1.5由四种饱和策略: AbortPolicy默认。直接抛异常。 CallerRunsPolicy只用调用者所在的线程执行任务。 DiscardOldestPolicy丢弃任务队列中最久的任务。 DiscardPolicy丢弃当前任务。 提交任务 可以向ThreadPoolExecutor提交两种任务:Callable和Runnable。 Callable该类任务有返回结果,可以抛出异常。通过submit函数提交,返回Future对象。可通过get获取执行结果。 Runnable该类任务只执行,无法获取返回结果,并在执行过程中无法抛异常。通过execute提交。 关闭线程池 关闭线程池有两种方式:shutdown和shutdownNow,关闭时,会遍历所有的线程,调用它们的interrupt函数中断线程。但这两种方式对于正在执行的线程处理方式不同。 shutdown()仅停止阻塞队列中等待的线程,那些正在执行的线程就会让他们执行结束。 shutdownNow()不仅会停止阻塞队列中的线程,而且会停止正在执行的线程。 ThreadPoolExecutor运行机制 当有请求到来时: 若当前实际线程数量少于corePoolSize,即使有空闲线程,也会创建一个新的工作线程; 若当前实际线程数量处于corePoolSize和maximumPoolSize之间,并且阻塞队列没满,则任务将被放入阻塞队列中等待执行; 若当前实际线程数量小于maximumPoolSize,但阻塞队列已满,则直接创建新线程处理任务; 若当前实际线程数量已经达到maximumPoolSize,并且阻塞队列已满,则使用饱和策略。 设置合理的线程池大小 任务一般可分为:CPU密集型、IO密集型、混合型,对于不同类型的任务需要分配不同大小的线程池。 CPU密集型任务尽量使用较小的线程池,一般为CPU核心数+1。因为CPU密集型任务使得CPU使用率很高,若开过多的线程数,只能增加上下文切换的次数,因此会带来额外的开销。 IO密集型任务可以使用稍大的线程池,一般为2*CPU核心数。IO密集型任务CPU使用率并不高,因此可以让CPU在等待IO的时候去处理别的任务,充分利用CPU时间。 混合型任务可以将任务分成IO密集型和CPU密集型任务,然后分别用不同的线程池去处理。只要分完之后两个任务的执行时间相差不大,那么就会比串行执行来的高效。因为如果划分之后两个任务执行时间相差甚远,那么先执行完的任务就要等后执行完的任务,最终的时间仍然取决于后执行完的任务,而且还要加上任务拆分与合并的开销,得不偿失。

优秀的个人博客,低调大师

java面试- Java并发编程(十)——线程池(1)

线程池的作用 减少资源的开销减少了每次创建线程、销毁线程的开销。 提高响应速度每次请求到来时,由于线程的创建已经完成,故可以直接执行任务,因此提高了响应速度。 提高线程的可管理性线程是一种稀缺资源,若不加以限制,不仅会占用大量资源,而且会影响系统的稳定性。因此,线程池可以对线程的创建与停止、线程数量等等因素加以控制,使得线程在一种可控的范围内运行,不仅能保证系统稳定运行,而且方便性能调优。 线程池的实现原理 线程池一般由两种角色构成:多个工作线程 和 一个阻塞队列。 工作线程工作线程是一组已经处在运行中的线程,它们不断地向阻塞队列中领取任务执行。 阻塞队列阻塞队列用于存储工作线程来不及处理的任务。当工作线程都在执行任务时,到来的新任务就只能暂时在阻塞队列中存储。 ThreadPoolExecutor的使用 创建线程池 通过如下代码即可创建一个线程池: new ThreadPoolExecutor(corePoolSize, maximumPoolSize, keepAliveTime, timeUnit, runnableTaskQueue, handler); 1 corePoolSize:基本线程数量它表示你希望线程池达到的一个值。线程池会尽量把实际线程数量保持在这个值上下。 maximumPoolSize:最大线程数量这是线程数量的上界。如果实际线程数量达到这个值: 阻塞队列未满:任务存入阻塞队列等待执行 阻塞队列已满:调用饱和策略 keepAliveTime:空闲线程的存活时间当实际线程数量超过corePoolSize时,若线程空闲的时间超过该值,就会被停止。PS:当任务很多,且任务执行时间很短的情况下,可以将该值调大,提高线程利用率。 timeUnit:keepAliveTime的单位 runnableTaskQueue:任务队列这是一个存放任务的阻塞队列,可以有如下几种选择: ArrayBlockingQueue它是一个由数组实现的阻塞队列,FIFO。 LinkedBlockingQueue它是一个由链表实现的阻塞队列,FIFO。吞吐量通常要高于ArrayBlockingQueue。fixedThreadPool使用的阻塞队列就是它。它是一个无界队列。 SynchronousQueue它是一个没有存储空间的阻塞队列,任务提交给它之后必须要交给一条工作线程处理;如果当前没有空闲的工作线程,则立即创建一条新的工作线程。cachedThreadPool用的阻塞队列就是它。它是一个无界队列。 PriorityBlockingQueue它是一个优先权阻塞队列。 handler:饱和策略当实际线程数达到maximumPoolSize,并且阻塞队列已满时,就会调用饱和策略。JDK1.5由四种饱和策略: AbortPolicy默认。直接抛异常。 CallerRunsPolicy只用调用者所在的线程执行任务。 DiscardOldestPolicy丢弃任务队列中最久的任务。 DiscardPolicy丢弃当前任务。 提交任务 可以向ThreadPoolExecutor提交两种任务:Callable和Runnable。 Callable该类任务有返回结果,可以抛出异常。通过submit函数提交,返回Future对象。可通过get获取执行结果。 Runnable该类任务只执行,无法获取返回结果,并在执行过程中无法抛异常。通过execute提交。 关闭线程池 关闭线程池有两种方式:shutdown和shutdownNow,关闭时,会遍历所有的线程,调用它们的interrupt函数中断线程。但这两种方式对于正在执行的线程处理方式不同。 shutdown()仅停止阻塞队列中等待的线程,那些正在执行的线程就会让他们执行结束。 shutdownNow()不仅会停止阻塞队列中的线程,而且会停止正在执行的线程。 ThreadPoolExecutor运行机制 当有请求到来时: 若当前实际线程数量少于corePoolSize,即使有空闲线程,也会创建一个新的工作线程; 若当前实际线程数量处于corePoolSize和maximumPoolSize之间,并且阻塞队列没满,则任务将被放入阻塞队列中等待执行; 若当前实际线程数量小于maximumPoolSize,但阻塞队列已满,则直接创建新线程处理任务; 若当前实际线程数量已经达到maximumPoolSize,并且阻塞队列已满,则使用饱和策略。 设置合理的线程池大小 任务一般可分为:CPU密集型、IO密集型、混合型,对于不同类型的任务需要分配不同大小的线程池。 CPU密集型任务尽量使用较小的线程池,一般为CPU核心数+1。因为CPU密集型任务使得CPU使用率很高,若开过多的线程数,只能增加上下文切换的次数,因此会带来额外的开销。 IO密集型任务可以使用稍大的线程池,一般为2*CPU核心数。IO密集型任务CPU使用率并不高,因此可以让CPU在等待IO的时候去处理别的任务,充分利用CPU时间。 混合型任务可以将任务分成IO密集型和CPU密集型任务,然后分别用不同的线程池去处理。只要分完之后两个任务的执行时间相差不大,那么就会比串行执行来的高效。因为如果划分之后两个任务执行时间相差甚远,那么先执行完的任务就要等后执行完的任务,最终的时间仍然取决于后执行完的任务,而且还要加上任务拆分与合并的开销,得不偿失。

优秀的个人博客,低调大师

Java并发编程的艺术(十一)——线程池(2)

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/79612326 Executor两级调度模型 在HotSpot虚拟机中,Java中的线程将会被一一映射为操作系统的线程。在Java虚拟机层面,用户将多个任务提交给Executor框架,Executor负责分配线程执行它们;在操作系统层面,操作系统再将这些线程分配给处理器执行。 Executor结构 Executor框架中的所有类可以分成三类: 任务任务有两种类型:Runnable和Callable。 任务执行器Executor框架最核心的接口是Executor,它表示任务的执行器。Executor的子接口为ExecutorService。ExecutorService有两大实现类:ThreadPoolExecutor和ScheduledThreadPoolExecutor。 执行结果Future接口表示异步的执行结果,它的实现类为FutureTask。 线程池 Executors工厂类可以创建四种类型的线程池,通过Executors.newXXX即可创建。 1. FixedThreadPool public static ExecutorService newFixedThreadPool(int nThreads){ return new ThreadPoolExecutor(nThreads,nThreads,0L,TimeUnit.MILLISECONDS,new LinkedBlockingQueue<Runnable>()); } 1 2 3 它是一种固定大小的线程池; corePoolSize和maximunPoolSize都为用户设定的线程数量nThreads; keepAliveTime为0,意味着一旦有多余的空闲线程,就会被立即停止掉;但这里keepAliveTime无效; 阻塞队列采用了LinkedBlockingQueue,它是一个无界队列; 由于阻塞队列是一个无界队列,因此永远不可能拒绝任务; 由于采用了无界队列,实际线程数量将永远维持在nThreads,因此maximumPoolSize和keepAliveTime将无效。 2. CachedThreadPool public static ExecutorService newCachedThreadPool(){ return new ThreadPoolExecutor(0,Integer.MAX_VALUE,60L,TimeUnit.MILLISECONDS,new SynchronousQueue<Runnable>()); } 1 2 3 它是一个可以无限扩大的线程池; 它比较适合处理执行时间比较小的任务; corePoolSize为0,maximumPoolSize为无限大,意味着线程数量可以无限大; keepAliveTime为60S,意味着线程空闲时间超过60S就会被杀死; 采用SynchronousQueue装等待的任务,这个阻塞队列没有存储空间,这意味着只要有请求到来,就必须要找到一条工作线程处理他,如果当前没有空闲的线程,那么就会再创建一条新的线程。 3. SingleThreadExecutor public static ExecutorService newSingleThreadExecutor(){ return new ThreadPoolExecutor(1,1,0L,TimeUnit.MILLISECONDS,new LinkedBlockingQueue<Runnable>()); } 1 2 3 它只会创建一条工作线程处理任务; 采用的阻塞队列为LinkedBlockingQueue; 4. ScheduledThreadPool 它用来处理延时任务或定时任务。 它接收SchduledFutureTask类型的任务,有两种提交任务的方式: scheduledAtFixedRate scheduledWithFixedDelay SchduledFutureTask接收的参数: time:任务开始的时间 sequenceNumber:任务的序号 period:任务执行的时间间隔 它采用DelayQueue存储等待的任务 DelayQueue内部封装了一个PriorityQueue,它会根据time的先后时间排序,若time相同则根据sequenceNumber排序; DelayQueue也是一个无界队列; 工作线程的执行过程: 工作线程会从DelayQueue取已经到期的任务去执行; 执行结束后重新设置任务的到期时间,再次放回DelayQueue

优秀的个人博客,低调大师

11.Linux shell编程(常用命令)

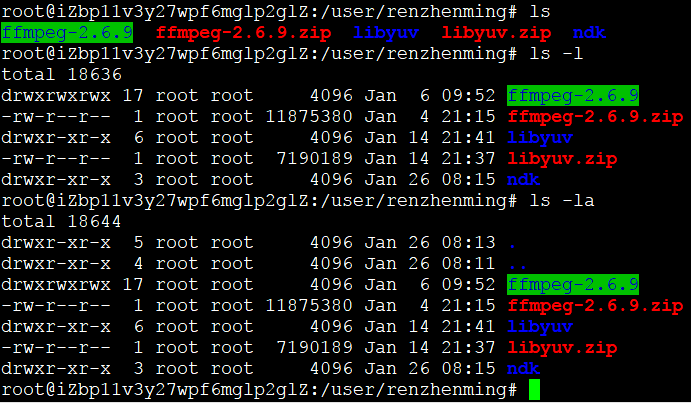
(创建于2018/1/31) 文件操作 1.显示列表 ls -l 以列表的形式显示 ls -la 以列表的形式显示所有,包括隐藏文件 ls -l ja* 通配符查找,查找的如果是文件夹结果是以列表形式显示文件夹下第一层的所有文件和文件夹 ls -l ja? ?表示一个字符,查找ja后边只有一个字符的,显示的结果同上 ls -l 和 ls -la的区别,ls -la可以显示隐藏文件 611949796.png s -l xx*通配符查找的是 满足条件的目录下的所有文件列表 612113484.png 2.创建文件 touch ren.txt 在当前目录创建ren.txt文件 3.复制文件 cp src.txt dest.txt 将src.txt文件复制到当前目录下,文件名为dest.txt cp -i src.txt dest.txt 复制前询问是否复制,有一个确认的过程(我在linux云主机上尝试的没有提示,效果同上边的命令) cp /xxx/xxx . 复制某一目录下某一文件到当前目录下,注意如果要复制本目录下到当前目录也就是本目录是不行的,会有提示 cp -R src dest 复制整个目录src到dest 目录下 (R有的地方区分大小写) 4.删除 rm -rf ndk/ rm:删除命令 -r开关:递归地删除子目录和子目录中的文件 -f开关:强制删除,不再一一向用户提示确认 * 所有文件和文件夹 rm file 删除文件file echo "ren" 输出ren 6.查看文件类型 file 文件名 7.查看文件内容 cat 文件名 功能跟vim差不多,不过cat打开只能读,不能编辑(more命令也可以查看) cat -b 文件名 查看文件,显示行号 tail -n 10 文件名 查看文件最后十行 head -n 10 文件名 查看文件最前边十行 8.创建用户 useradd -m renzhenming 创建用户renzhenming,同时创建renzhenming用户的home目录 userdel -r renzhenming 删除用户 9.创建组 groupadd 组名 10.分配用户到组 usermod -G 组名 用户名 12.文件权限 704394750.png 如上截图 r:读 w:写 x:执行 d:目录 以上边user目录权限为例 d后边第一个三位表示文件所属用户具备的权限(rwx 具备读写执行的最高权限) d后边第二个三位表示文件所属用户的所属组具备的权限(r-x具备读执行的权限)-表示0 d后边最后一个三位表示系统的其他用户具备的权限(r-x具备读执行的权限) 以往简单粗暴的赋权方式chmod 777 file不安全,我们需要根据需要设置root用户以及组和其他用户的权限 数字对应关系如下: 权限 二进制 八进制 --- 000 0 --x 001 1 -w- 010 2 -wx 011 3 r-- 100 4 r-x 101 5 rw- 110 6 rwx 111 7 rwx必须是固定顺序 修改文件权限 chmod 644 file 给用户加上执行权限 chmod u+x file //(chmod是权限管理命令change the permissions mode of a file的缩写。。u代表所有者,x代表执行权限。 + 表示增加权限。chmod u+x file.sh 就表示对当前目录下的file.sh文件的所有者增加可执行权限) tar命令的详细解释 参数: -c: 建立压缩档案 -x:解压 -t:查看内容 -r:向压缩归档文件末尾追加文件 -u:更新原压缩包中的文件 这五个是独立的命令,压缩解压都要用到其中一个,可以和别的命令连用但只能用其中一个。下面的参数是根据需要在压缩或解压档案时可选的。 -z:有gzip属性的 -j:有bz2属性的 -Z:有compress属性的 -v:显示所有过程 -O:将文件解开到标准输出 --delete从存档中删除 注意是两个减号。 下面的参数-f是必须的 -f: 使用档案名字,切记,这个参数是最后一个参数,后面只能接档案名。 下面是例子 1.压缩一个目录 eg: tar -cvzf test.tar.gz tar #压缩当前目录下的tar目录,压缩包的名字叫test.tar.gz 2.压缩其中某一类型的文件 eg: tar -cvzf test.tar.gz ./*.c #压缩当前目录下的.c为后缀的文件。但是不能压缩以.开头的文件 3.查看一个压缩文件的内容 eg: tar -tvf test.tar.gz #查看当前目录下test.tar.gz压缩文件中的文件 4.解压一个文件 eg. tar -xvzf test.tar.gz #解压test.tar.gz到当前目录下面 5.文件夹做一个归档文件、备份一个目录、 eg: tar -cvf test.tar tar #将tar文件夹下的文件生成一个test.tar归档文件 6.将某一类型的文件做成归档文件、备份某一类型的文件 eg:tar -cvf test.tar ./tar/*.c # 将tar文件夹下所有以.c结尾的文件放到test.tar 文件中,但是以.开头的文件不行 7.向归档文件中添加一个文件夹 eg: tar -rf test.tar ./test1 #将test1文件夹中的所有文件,添加到test.tar 归档文件中 8.删除归档文件中的文件 eg: tar -f test.tar --delete a.c #删除test.tar文件中的 a.c文件 9.删除归档文件中的某一类的文件 eg: tar -f test.tar --delete *.c #删除test.tar文件中的 以.c结尾的文件 10.释放归档文件 eg: tar -xvf test.tar #释放test.tar归档文件中的内容到 当前目录下 11.查看归档文件中的内容 eg: tar -tvf test.tar 总结 1、*.tar 用 tar –xvf 解压 2、*.gz 用 gzip -d或者gunzip 解压 3、*.tar.gz和*.tgz 用 tar –xzf 解压 4、*.bz2 用 bzip2 -d或者用bunzip2 解压 5、*.tar.bz2用tar –xjf 解压 6、*.Z 用 uncompress 解压 7、*.tar.Z 用tar –xZf 解压 8、*.rar 用 unrar e解压 9、*.zip 用 unzip 解压

优秀的个人博客,低调大师

Python(七)Socket编程、IO多路复用、SocketServer

本章内容: Socket IO多路复用(select) SocketServer 模块(ThreadingTCPServer源码剖析) Socket socket通常也称作"套接字",用于描述IP地址和端口,是一个通信链的句柄,应用程序通常通过"套接字"向网络发出请求或者应答网络请求。 功能: sk = socket.socket(socket.AF_INET,socket.SOCK_STREAM,0) 参数一:地址簇 socket.AF_INET IPv4(默认) socket.AF_INET6 IPv6 socket.AF_UNIX 只能够用于单一的Unix系统进程间通信 参数二:类型 socket.SOCK_STREAM 流式socket , for TCP (默认) socket.SOCK_DGRAM 数据报式socket , for UDP socket.SOCK_RAW 原始套接字,普通的套接字无法处理ICMP、IGMP等网络报文,而SOCK_RAW可以;其次,SOCK_RAW也可以处理特殊的IPv4报文;此外,利用原始套接字,可以通过IP_HDRINCL套接字选项由用户构造IP头。 socket.SOCK_RDM 是一种可靠的UDP形式,即保证交付数据报但不保证顺序。SOCK_RAM用来提供对原始协议的低级访问,在需要执行某些特殊操作时使用,如发送ICMP报文。SOCK_RAM通常仅限于高级用户或管理员运行的程序使用。 socket.SOCK_SEQPACKET 可靠的连续数据包服务 参数三:协议 0 (默认)与特定的地址家族相关的协议,如果是 0 ,则系统就会根据地址格式和套接类别,自动选择一个合适的协议 UDP Demo sk.bind(address) s.bind(address) 将套接字绑定到地址。address地址的格式取决于地址族。在AF_INET下,以元组(host,port)的形式表示地址。 sk.listen(backlog) 开始监听传入连接。backlog指定在拒绝连接之前,可以挂起的最大连接数量。 backlog等于5,表示内核已经接到了连接请求,但服务器还没有调用accept进行处理的连接个数最大为5 这个值不能无限大,因为要在内核中维护连接队列 sk.setblocking(bool) 是否阻塞(默认True),如果设置False,那么accept和recv时一旦无数据,则报错。 sk.accept() 接受连接并返回(conn,address),其中conn是新的套接字对象,可以用来接收和发送数据。address是连接客户端的地址。 接收TCP 客户的连接(阻塞式)等待连接的到来 sk.connect(address) 连接到address处的套接字。一般,address的格式为元组(hostname,port),如果连接出错,返回socket.error错误。 sk.connect_ex(address) 同上,只不过会有返回值,连接成功时返回 0 ,连接失败时候返回编码,例如:10061 sk.close() 关闭套接字 sk.recv(bufsize[,flag]) 接受套接字的数据。数据以字符串形式返回,bufsize指定最多可以接收的数量。flag提供有关消息的其他信息,通常可以忽略。 sk.recvfrom(bufsize[.flag]) 与recv()类似,但返回值是(data,address)。其中data是包含接收数据的字符串,address是发送数据的套接字地址。 sk.send(string[,flag]) 将string中的数据发送到连接的套接字。返回值是要发送的字节数量,该数量可能小于string的字节大小。即:可能未将指定内容全部发送。 sk.sendall(string[,flag]) 将string中的数据发送到连接的套接字,但在返回之前会尝试发送所有数据。成功返回None,失败则抛出异常。 内部通过递归调用send,将所有内容发送出去。 sk.sendto(string[,flag],address) 将数据发送到套接字,address是形式为(ipaddr,port)的元组,指定远程地址。返回值是发送的字节数。该函数主要用于UDP协议。 sk.settimeout(timeout) 设置套接字操作的超时期,timeout是一个浮点数,单位是秒。值为None表示没有超时期。一般,超时期应该在刚创建套接字时设置,因为它们可能用于连接的操作(如 client 连接最多等待5s ) sk.getpeername() 返回连接套接字的远程地址。返回值通常是元组(ipaddr,port)。 sk.getsockname() 返回套接字自己的地址。通常是一个元组(ipaddr,port) sk.fileno() 套接字的文件描述符 IO 多路复用 I/O多路复用指:通过一种机制,可以监视多个描述符,一旦某个描述符就绪(一般是读就绪或者写就绪),能够通知程序进行相应的读写操作。 Linux中的select,poll,epoll 都是IO多路复用的机制。 + View Code Python中有一个select模块,其中提供了:select、poll、epoll三个方法,分别调用系统的select,poll,epoll 从而实现IO多路复用。 1 2 3 4 5 6 Windows Python: 提供: select Mac Python: 提供: select Linux Python: 提供: select、poll、epoll 注意:网络操作、文件操作、终端操作等均属于IO操作,对于windows只支持Socket操作,其他系统支持其他IO操作,但是无法检测 普通文件操作 自动上次读取是否已经变化。 对于select方法: 1 2 3 4 5 6 7 8 9 10 11 句柄列表 11 , 句柄列表 22 , 句柄列表 33 = select.select(句柄序列 1 , 句柄序列 2 , 句柄序列 3 , 超时时间) 参数: 可接受四个参数(前三个必须) 返回值:三个列表 select方法用来监视文件句柄,如果句柄发生变化,则获取该句柄。 1 、当 参数 1 序列中的句柄发生可读时(accetp和read),则获取发生变化的句柄并添加到 返回值 1 序列中 2 、当 参数 2 序列中含有句柄时,则将该序列中所有的句柄添加到 返回值 2 序列中 3 、当 参数 3 序列中的句柄发生错误时,则将该发生错误的句柄添加到 返回值 3 序列中 4 、当 超时时间 未设置,则select会一直阻塞,直到监听的句柄发生变化 当 超时时间 = 1 时,那么如果监听的句柄均无任何变化,则select会阻塞 1 秒,之后返回三个空列表,如果监听的句柄有变化,则直接执行。 利用select监听终端操作实例 利用select实现伪同时处理多个Socket客户端请求:服务端 利用select实现伪同时处理多个Socket客户端请求:客户端 此处的Socket服务端相比与原生的Socket,他支持当某一个请求不再发送数据时,服务器端不会等待而是可以去处理其他请求的数据。但是,如果每个请求的耗时比较长时,select版本的服务器端也无法完成同时操作。 基于select实现socket服务端 SocketServer 模块 SocketServer内部使用 IO多路复用 以及 “多线程” 和 “多进程” ,从而实现并发处理多个客户端请求的Socket服务端。 +------------+ | BaseServer | +------------+ | v +-----------+ +------------------+ | TCPServer |------->| UnixStreamServer | +-----------+ +------------------+ | v +-----------+ +--------------------+ | UDPServer |------->| UnixDatagramServer | +-----------+ +--------------------+SocketServer简化了网络服务器的编写。它有4个类:TCPServer,UDPServer,UnixStreamServer,UnixDatagramServer。这4个类是同步进行处理的,另外通过ForkingMixIn和ThreadingMixIn类来支持异步。ThreadingTCPServer ThreadingTCPServer实现的Soket服务器内部会为每个client创建一个 “线程”,该线程用来和客户端进行交互。 1、ThreadingTCPServer基础 使用ThreadingTCPServer: 创建一个继承自 SocketServer.BaseRequestHandler 的类 类中必须定义一个名称为 handle 的方法 启动ThreadingTCPServer #!/usr/bin/env python # -*- coding:utf-8 -*- import SocketServer class MyServer(SocketServer.BaseRequestHandler): def handle(self): pass if __name__ == '__main__': server = SocketServer.ThreadingTCPServer(('127.0.0.1',8766), MyServer) server.serve_forever() 2、ThreadingTCPServer源码剖析 ThreadingTCPServer的类图关系如下: 内部调用流程为: 启动服务端程序 执行 TCPServer.__init__ 方法,创建服务端Socket对象并绑定 IP 和 端口 执行 BaseServer.__init__ 方法,将自定义的继承自SocketServer.BaseRequestHandler 的类 MyRequestHandle赋值给self.RequestHandlerClass 执行 BaseServer.server_forever 方法,While 循环一直监听是否有客户端请求到达 ... 当客户端连接到达服务器 执行 ThreadingMixIn.process_request 方法,创建一个 “线程” 用来处理请求 执行ThreadingMixIn.process_request_thread 方法 执行 BaseServer.finish_request 方法,执行self.RequestHandlerClass() 即:执行 自定义 MyRequestHandler 的构造方法(自动调用基类BaseRequestHandler的构造方法,在该构造方法中又会调用 MyRequestHandler的handle方法) ThreadingTCPServer相关源码: BaseServer TCPServer ThreadingMixIn ThreadingTCPServer RequestHandler相关源码 SocketServer.BaseRequestHandler SocketServer的ThreadingTCPServer之所以可以同时处理请求得益于select和Threading两个东西,其实本质上就是在服务器端为每一个客户端创建一个线程,当前线程用来处理对应客户端的请求,所以,可以支持同时n个客户端链接(长连接)。 ForkingTCPServer ForkingTCPServer和ThreadingTCPServer的使用和执行流程基本一致,只不过在内部分别为请求者建立 “线程” 和 “进程”。 基本使用: #!/usr/bin/env python # -*- coding:utf-8 -*- import SocketServer class MyServer(SocketServer.BaseRequestHandler): def handle(self): pass if __name__ == '__main__': server = SocketServer.ForkingTCPServer(('127.0.0.1',8009),MyServer) server.serve_forever()


优秀的个人博客,低调大师

Java并发编程 -- 深入剖析volatile关键字

1.volatile关键字的两层语义 一旦一个共享变量(类的成员变量、类的静态成员变量)被volatile修饰之后,那么就具备了两层语义: 保证了不同线程对这个变量进行操作时的可见性,即一个线程修改了某个变量的值,这新值对其他线程来说是立即可见的。 禁止进行指令重排序。 我们来看一段代码: 假如线程1先执行,线程2后执行: //线程1 boolean stop = false; while(!stop){ //doSomething(); } //线程2 stop = true; 事实上,这段代码会真的先执行线程1,然后再执行2吗,答案是肯定的:不是。两个线程各干各的事情,没有绝对的先后问题,所以会出现两种答案(一个线程用stop=false跑线程1,一个线程用stop=true跑线程二,互不相关)。 但是用volatile修饰之后就变得不一样了: 第一:使用volatile关键字会强制将修改的值立即写入主存; 第二:使用volatile关键字的话,当线程2进行修改时,会导致线程1的工作内存中缓存变量stop的缓存行无效(反映到硬件层的话,就是CPU的L1或者L2缓存中对应的缓存行无效); 第三:由于线程1的工作内存中缓存变量stop的缓存行无效,所以线程1再次读取变量stop的值时会去主存读取。 所以肯定能保证不管 多少个线程跑的时候,stop的值是相同的。这是利用了volatile的线程可见性原理。 2.volatile保证原子性吗? 从上面知道volatile关键字保证了操作的可见性,但是volatile能保证对变量的操作是原子性吗?看一段代码: public class Test { public volatile int inc = 0; public void increase() { inc++; } public static void main(String[] args) { final Test test = new Test(); for(int i=0;i<10;i++){ new Thread(){ public void run() { for(int j=0;j<1000;j++) test.increase(); }; }.start(); } while(Thread.activeCount()>1) //保证前面的线程都执行完 Thread.yield(); System.out.println(test.inc); } } 经过上面的介绍volatile的可见性,我想大家能很快的得出这段代码的答案10000。然而事实上打印出来的数字总比10000小。这就涉及到了volatile与原子性操作的联系。 原因:自增操作不是原子性操作,而且volatile也无法保证对变量的任何操作都是原子性的。 自增操作是不具备原子性的,它包括读取变量的原始值、进行加1操作、写入工作内存。那么就是说自增操作的三个子操作可能会分割开执行 假如线程1从住内存中获取到变量值,在执行自增的时候是阻塞性质的,这时候线程2也拿到一个相同的值,然后也进行自增,那么这两个线程最终写入的值是一样的。 那如何修改呢?有三种方式 给自增方法加上同步锁synchronized public class Test { public int inc = 0; public synchronized void increase() { inc++; } public static void main(String[] args) { final Test test = new Test(); for(int i=0;i<10;i++){ new Thread(){ public void run() { for(int j=0;j<1000;j++) test.increase(); }; }.start(); } while(Thread.activeCount()>1) //保证前面的线程都执行完 Thread.yield(); System.out.println(test.inc); } } 采用Lock public class Test { public int inc = 0; Lock lock = new ReentrantLock(); public void increase() { lock.lock(); try { inc++; } finally{ lock.unlock(); } } public static void main(String[] args) { final Test test = new Test(); for(int i=0;i<10;i++){ new Thread(){ public void run() { for(int j=0;j<1000;j++) test.increase(); }; }.start(); } while(Thread.activeCount()>1) //保证前面的线程都执行完 Thread.yield(); System.out.println(test.inc); } } 采用AtomicInteger public class Test { public AtomicInteger inc = new AtomicInteger(); public void increase() { inc.getAndIncrement(); } public static void main(String[] args) { final Test test = new Test(); for(int i=0;i<10;i++){ new Thread(){ public void run() { for(int j=0;j<1000;j++) test.increase(); }; }.start(); } while(Thread.activeCount()>1) //保证前面的线程都执行完 Thread.yield(); System.out.println(test.inc); } } 在java 1.5的java.util.concurrent.atomic包下提供了一些原子操作类,即对基本数据类型的 自增(加1操作),自减(减1操作)、以及加法操作(加一个数),减法操作(减一个数)进行了封装,保证这些操作是原子性操作。atomic是利用CAS来实现原子性操作的(Compare And Swap),CAS实际上是利用处理器提供的CMPXCHG指令实现的,而处理器执行CMPXCHG指令是一个原子性操作。 3.volatile能保证有序性吗? 在前面提到volatile关键字能禁止指令重排序,所以volatile能在一定程度上保证有序性。 4.volatile的原理和实现机制 前面讲述了源于volatile关键字的一些使用,下面我们来探讨一下volatile到底如何保证可见性和禁止指令重排序的。 下面这段话摘自《深入理解Java虚拟机》: “观察加入volatile关键字和没有加入volatile关键字时所生成的汇编代码发现,加入volatile关键字时,会多出一个lock前缀指令” lock前缀指令实际上相当于一个内存屏障(也成内存栅栏),内存屏障会提供3个功能: 它确保指令重排序时不会把其后面的指令排到内存屏障之前的位置,也不会把前面的指令排到内存屏障的后面;即在执行到内存屏障这句指令时,在它前面的操作已经全部完成; 它会强制将对缓存的修改操作立即写入主存; 如果是写操作,它会导致其他CPU中对应的缓存行无效。

优秀的个人博客,低调大师

Java并发编程 -- 线程安全、优先级设定

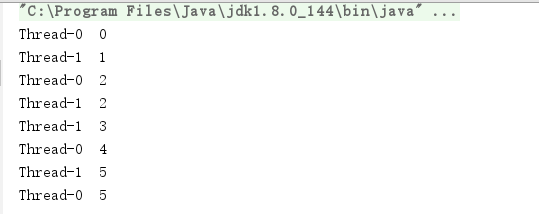
优先级设定 一个合理的优先级可以在一定条件下避免一些活跃性问题,比如死锁、饥饿等 public class Task implements Runnable{ @Override public void run() { while (true) { System.out.println(Thread.currentThread().getName() + "线程执行了..."); } } } public class PriorityTest { public static void main(String[] args) { Thread t1 = new Thread(new Task()); Thread t2 = new Thread(new Task()); /** * 设置优先级 * MAX_PRIORITY=10 * MIN_PRIORITY=1 * NORM_PRIORITY=5 */ t1.setPriority(Thread.NORM_PRIORITY); t2.setPriority(Thread.MAX_PRIORITY); t1.start(); t2.start(); } } 线程安全问题解决 当多个线程在非原子处理下操作相同的资源时,难免出现资源的混乱。 我在这里举个value++的例子。 无线程安全时 public class Task{ public int value = 0; // 没有处理线程安全 public int getValue() { return value++; } public static void main(String[] args) { Task task = new Task(); new Thread(){ @Override public void run() { while (true) { System.out.println(Thread.currentThread().getName() + " " + task.getValue()); try { Thread.sleep(500); } catch (InterruptedException e) { e.printStackTrace(); } } } }.start(); new Thread(){ @Override public void run() { while (true) { System.out.println(Thread.currentThread().getName() + " " + task.getValue()); try { Thread.sleep(500); } catch (InterruptedException e) { e.printStackTrace(); } } } }.start(); } } image.png 我们会发现2和5有重复。这是jvm底层的问题,我在后文有分析。 处理线程安全 如果我们给线程加锁,将其变成原子处理,就会解决该问题。 public synchronized int getValue() { return value++; } 既在修饰符后加上synchronized关键字。 image.png 但是又有一个问题,这样的话,其实原理上是串行处理的,那我们该如果解决这个问题呢。

优秀的个人博客,低调大师

Java并发编程(一)线程的各种创建方式

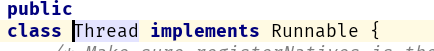
方法一:继承Thread类,作为线程对象存在(继承Thread对象) public class CreatThreadDemo1 extends Thread{ /** * 构造方法: 继承父类方法的Thread(String name);方法 * @param name */ public CreatThreadDemo1(String name){ super(name); } @Override public void run() { while (!interrupted()){ System.out.println(getName()+"线程执行了..."); try { Thread.sleep(200); } catch (InterruptedException e) { e.printStackTrace(); } } } public static void main(String[] args) { CreatThreadDemo1 d1 = new CreatThreadDemo1("first"); CreatThreadDemo1 d2 = new CreatThreadDemo1("second"); d1.start(); d2.start(); d1.interrupt(); //中断第一个线程 } } 常规方法,不多做介绍了,interrupted方法,是来判断该线程是否被中断。(终止线程不允许用stop方法,该方法不会施放占用的资源。所以我们在设计程序的时候,要按照中断线程的思维去设计,就像上面的代码一样)。 让线程等待的方法 Thread.sleep(200); //线程休息2ms Object.wait(); //让线程进入等待,直到调用Object的notify或者notifyAll时,线程停止休眠 方法二:实现runnable接口,作为线程任务存在 public class CreatThreadDemo2 implements Runnable { @Override public void run() { while (true){ System.out.println("线程执行了..."); } } public static void main(String[] args) { //将线程任务传给线程对象 Thread thread = new Thread(new CreatThreadDemo2()); //启动线程 thread.start(); } } Runnable 只是来修饰线程所执行的任务,它不是一个线程对象。想要启动Runnable对象,必须将它放到一个线程对象里。 方法三:匿名内部类创建线程对象 public class CreatThreadDemo3 extends Thread{ public static void main(String[] args) { //创建无参线程对象 new Thread(){ @Override public void run() { System.out.println("线程执行了..."); } }.start(); //创建带线程任务的线程对象 new Thread(new Runnable() { @Override public void run() { System.out.println("线程执行了..."); } }).start(); //创建带线程任务并且重写run方法的线程对象 new Thread(new Runnable() { @Override public void run() { System.out.println("runnable run 线程执行了..."); } }){ @Override public void run() { System.out.println("override run 线程执行了..."); } }.start(); } } 创建带线程任务并且重写run方法的线程对象中,为什么只运行了Thread的run方法。我们看看Thread类的源码, image.png ,我们可以看到Thread实现了Runnable接口,而Runnable接口里有一个run方法。 所以,我们最终调用的重写的方法应该是Thread类的run方法。而不是Runnable接口的run方法。 方法四:创建带返回值的线程 public class CreatThreadDemo4 implements Callable { public static void main(String[] args) throws ExecutionException, InterruptedException { CreatThreadDemo4 demo4 = new CreatThreadDemo4(); FutureTask<Integer> task = new FutureTask<Integer>(demo4); //FutureTask最终实现的是runnable接口 Thread thread = new Thread(task); thread.start(); System.out.println("我可以在这里做点别的业务逻辑...因为FutureTask是提前完成任务"); //拿出线程执行的返回值 Integer result = task.get(); System.out.println("线程中运算的结果为:"+result); } //重写Callable接口的call方法 @Override public Object call() throws Exception { int result = 1; System.out.println("业务逻辑计算中..."); Thread.sleep(3000); return result; } } Callable接口介绍: public interface Callable<V> { /** * Computes a result, or throws an exception if unable to do so. * * @return computed result * @throws Exception if unable to compute a result */ V call() throws Exception; } 返回指定泛型的call方法。然后调用FutureTask对象的get方法得道call方法的返回值。 方法五:定时器Timer public class CreatThreadDemo5 { public static void main(String[] args) { Timer timer = new Timer(); timer.schedule(new TimerTask() { @Override public void run() { System.out.println("定时器线程执行了..."); } },0,1000); //延迟0,周期1s } } 方法六:线程池创建线程 public class CreatThreadDemo6 { public static void main(String[] args) { //创建一个具有10个线程的线程池 ExecutorService threadPool = Executors.newFixedThreadPool(10); long threadpoolUseTime = System.currentTimeMillis(); for (int i = 0;i<10;i++){ threadPool.execute(new Runnable() { @Override public void run() { System.out.println(Thread.currentThread().getName()+"线程执行了..."); } }); } long threadpoolUseTime1 = System.currentTimeMillis(); System.out.println("多线程用时"+(threadpoolUseTime1-threadpoolUseTime)); //销毁线程池 threadPool.shutdown(); threadpoolUseTime = System.currentTimeMillis(); } } 方法七:利用java8新特性 stream 实现并发 lambda表达式不懂的,可以看看我的java8新特性文章: java8-lambda:https://www.jianshu.com/p/3a08dc78a05f java8-stream:https://www.jianshu.com/p/ea16d6712a00 public class CreatThreadDemo7 { public static void main(String[] args) { List<Integer> values = Arrays.asList(10,20,30,40); //parallel 平行的,并行的 int result = values.parallelStream().mapToInt(p -> p*2).sum(); System.out.println(result); //怎么证明它是并发处理呢 values.parallelStream().forEach(p-> System.out.println(p)); } } 200 40 10 20 30 怎么证明它是并发处理呢,他们并不是按照顺序输出的 。

优秀的个人博客,低调大师

JAVA 并发编程学习(1)之基本概念

1,为什么需要并发? 在早期计算机中没有操作系统,一台计算机从头到尾只执行一个程序,如果这个程序的任务是先进行CPU计算再把计算结果写入文件。那么,在进行CPU计算时,这台计算机的IO模块是空闲的,把计算结果写入文件中时,这台计算机的CPU是空闲的。 为此,引入了操作系统。这样,在一台计算机中可以运行多个程序了。由操作系统来管理多个程序的运行,一个程序在进行CPU计算的同时,另一个程序可以进行IO操作。提高了计算机的利用率(CPU和IO操作 可以同时在发生了) 引入操作系统之后,不可避免地出现了进程这个概念。因为操作系统管理若干个程序了,而每个运行中的程序可以用进程来表示(进程的动态性)。 那为什么还需要线程呢? ①进程之间需要通信、需要共享一些数据,需要协作……这些用线程来“表示”更方便。因为,不同进程的地址空间是相互独立的,一个进程不能直接访问另一个进程的地址空间。一个进程内部的多个线程共享这个进程状态空间,如果把数据的共享放到线程这个层次来实现,就方便多了。 ②进一步提高资源利用率---这个有点类似于:从没有操作系统的计算机到有操作系统的计算机转变---这里是从没有线程到有线程转变。 2,我们就是因为方便数据共享……一些原因引入了线程,那么多个线程同时访问一个可变的变量时,这个变量到底处理哪一个状态?这就存在一种线程安全性问题。 3,什么是线程安全性 讨论线程安全性针对的是 类。核心就是正确性。即,某个类的行为和其规范完全一致:即,我写了一个类,这个类具有哪些功能,需要完成哪些操作……这些是类的规范;而多个线程运行这个类的代码时,其执行效果和规范描述的要一致。 当多个线程访问某个类时,不管运行时环境采用何种调度方式或者这些线程将如何交替执行,并且在主调代码中不需要任何额外的同步或协调,这个类都能表现出正确的行为,那么就称这个类是线程安全的。 4,无状态对象 5,Race Condition 竞态条件 ①读--修改--写入 ②check--then--act 本文转自hapjin博客园博客,原文链接:http://www.cnblogs.com/hapjin/,如需转载请自行联系原作者

优秀的个人博客,低调大师

C++并发编程中static变量的问题

在C++中,static表示的是“静态初始化”,由其声明的变量因此也叫作“静态变量”,他们从完成初始化后就一直存在于程序运行空间中(确切地说位于静态变量区),直至程序退出或销毁。 如果按照变量的作用域来划分,静态变量可以分为3类: global variable,即全局变量 static variable with file scope static variable with block scope 前两种不必多说,重点说一下第三种里的“block scope”,它可以表示类内部、函数内部,或者仅仅是由“{}”包括起来的一个code block。 同时,按照静态变量初始化的时机,初始化过程可分为:编译时初始化和加载(运行)时初始化,前者主要发生在静态常量的编译过程中,如程序中“static int a = 3”因为此处3为常量,编译时就能确定,因此这里就发生的是编译时初始化,反之,如果不是编译时初始化,那就必定进行的是加载时初始化。 static变量经常被用来实现单例模式。在设计模式中,单例模式广为人知,即使没有系统学习过设计模式的人很可能也对单例模式不会陌生。设计实现一个单例模式并非难事,但在多线程并发环境下这个问题就貌似不那么简单了。通常来说,一个单例模式的类中都包含一个指向static类实例的指针,并提供一个公共接口返回这个指针以实现对这个实例的调用。因为在程序整个执行周期中,static变量只加载一次,保证了“仅此一个”的事实,如下代码所示: #1 class A { #2 public: #3 static A* getInstance() { #4 if (instance_ == NULL) #5 instance_ = new A(); #6 return instance_; #7 } #8 private: #9 static A* instance_; #10 } #11 //static变量在类外定义 #12 A* A::instance_ = NULL; 如上代码就实现了一个简单的C++单例模式。在单线程程序中,这个单例类没有任何问题,但是在多线程环境下,很容易就能发现方法getInstance中存在race condition,如果线程A运行到了#4,此时instance_为NULL,这时线程B也运行到了这里,instance_此时还未进行构造,它的值还是NULL,那么接下来两个线程将分别执行new A()的操作,本为单例的类实际上并非单例。为了克服这个race condition,人们尝试用加锁、双阶段加锁等方法来解决它,虽然可以实现线程安全性,但毕竟增加了代码量以及复杂性,性能也受到了一定的影响。因此又有了另一种方法来实现单例类,如下代码所示: #1 class A { #2 public: #3 static A* getInstance() { #4 static A instance_; #5 return &instance_; #6 } #7 } 根据static的语义,其只在程序对类A加载时进行一次初始化,全局只有这一个实例。看起来很美好,而且代码更少了。但是这实际上是不对的,对于在编译时进行初始化的static变量,它一定是线程安全的,但是对于这种加载时进行初始化的变量,编译器生成的代码实际上类似这样: static bool initialized = false; static A instance_; if (initialized == false) { initialized = true; instance_ = A(); } return &instance_; 看到了吗?实际上还是会有race condition。那么如何在不加锁、不引入复杂设计的情况下实现单例模式呢?还是要感谢C++的发展,上述代码是在C++11以前的标准中得到的,而在C++11标准中,static的语义实际上已经是线程安全的了。引用C++11标准中的内容: If control enters the declaration concurrently while the variable is being initialized,the concurrent execution shall wait for completion of the initialization. 在网站cppreference中,也有类似的描述: If multiple threads attempt to initialize the same static local variable concurrently,the initialization occurs exactly once(since c++11) 因此,我认为在C++11中,以上代码是可以实现一个线程安全的单例类的。

优秀的个人博客,低调大师

Android 编程下获得应用程序的签名

说明:应用程序的签名被封装在packageInfo 中,所以我们要获得应用程序的签名就需要获得PackageManager 来获得包含有签名信息的packageInfo,再通过packageInfo 获得Signature数组,循环遍历将签名进行拼接。 try { /** 通过包管理器获得指定包名包含签名的包信息 **/ PackageInfo packageInfo = getPackageManager().getPackageInfo( pkgname, PackageManager.GET_SIGNATURES); /******* 通过返回的包信息获得签名数组 *******/ Signature[] signatures = packageInfo.signatures; StringBuilder builder = new StringBuilder(); /******* 循环遍历签名数组拼接应用签名 *******/ for (Signature signature : signatures) { builder.append(signature.toCharsString()); } /************** 得到应用签名 **************/ String signature = builder.toString(); Logger.d("tag", "getSignature:" + signature); } catch (NameNotFoundException e) { 本文转自农夫山泉别墅博客园博客,原文链接:http://www.cnblogs.com/yaowen/p/5476894.html,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册