首页 文章 精选 留言 我的

精选列表

搜索[AIOps最佳实践],共10001篇文章
优秀的个人博客,低调大师

Cassandra 最佳实践系列(1) - CQL QuickStart

简易搭建单节点C* 本文介绍如何简单的搭建一个Cassandra的单节点,以后会介绍如何构建多节点的Cassandra集群;为了搭建一个单节点我们需要做下面几件事情: 1.节点部署JAVA 基本环境;2.获取需要的Cassandra二进制包:可以编译源码获取也可以直接官网下载3.11.5的bin包;3.tar xf apache-cassandra-3.11.5-bin.tar.gz4.cd apache-cassandra-3.11.5/bin目录; 5.执行./cassandra 启动单节点C*; 接下来你在bin目录下面通过执行./nodetool status 如果观测到下面的状态,就证明单节点的Cassandra已经正确启动。 注意: 因为我们没有修改Cassandra的配置文件,这里单节点的进程都是使用默认配置,比如使用默认256的vnode,使用/var/lib/cassandra/data做数据存储目录,使用/var/lib/cassandra/commitlog做commitlog存储目录等, 默认绑定localhost,默认没有账户密码认证。 访问C* 通过cqlsh bin目录下面的cqlsh类似于访问Cassandra的一个client,默认情况指定one级别去访问Cassandra,由于我们此处设置是sever绑定localhost,且cqlsh默认访问localhost,所以直接bin目录下面./cqlsh既可以访问到上面部署的单节点Cassandra,如下图: 我们可以通过cqlsh执行常见的Cassandra DDL、DML操作,比如这里我建一个keyspace ks以及在keyspace里面建一个table tb。分别使用如下cql: CREATE KEYSPACE ks WITH replication = {'class': 'SimpleStrategy', 'replication_factor': 1}; use ks; CREATE TABLE tb ( name text PRIMARY KEY ,age int); 我们可以在Cassandra里面通过执行: DESCRIBE ks; 获取得到该keyspace下面的所有相关的keyspace、table、index、mv的定义;如下图: 我们也可以在这个表 tb里面执行insert操作以及select操作,如下图: 通过java driver 当然我们实际业务开发的时候很难通过cql去执行一些常见的dml操作,我们这里使用datastax 公司开源的java-driver进行常见的cassandra访问,当然也有其他版本以及语言的driver(见这里). 使用java driver的时候,只需要新建maven项目,然后pom.xml里面添加如下配置(我们这里使用3.8.0的java driver做演示): <dependency> <groupId>com.datastax.cassandra</groupId> <artifactId>cassandra-driver-core</artifactId> <version>3.8.0</version> </dependency> 然后我们的演示代码如下: package com.aliyun.cstar.driver.test; import com.datastax.driver.core.Cluster; import com.datastax.driver.core.ResultSet; import com.datastax.driver.core.Row; import com.datastax.driver.core.Session; public class Test { static String[] CONTACT_POINTS = {"127.0.0.1"}; static int PORT = 9042; public static void main(String[] args) { Cluster cluster = null; try { System.out.println("CLUSTER CONNECT !"); //cluster operation cluster = Cluster.builder().addContactPoints(CONTACT_POINTS).withPort(PORT).build(); Session session = cluster.connect(); System.out.println("CREATE KEYSPACE AND TABLE !"); //DDL:keyspace and table operation session.execute("CREATE KEYSPACE IF NOT EXISTS newks WITH replication " + "= {'class':'SimpleStrategy', 'replication_factor':1};"); session.execute("CREATE TABLE IF NOT EXISTS newks.newtb (name text PRIMARY KEY, age int)"); System.out.println("INSERT INTO TABLE AND SELECT TABLE !"); //DML:insert and select session.execute("INSERT INTO newks.newtb (name, age) VALUES('xla', 22)"); session.execute("INSERT INTO newks.newtb (name, age) VALUES('xlb', 22)"); session.execute("INSERT INTO newks.newtb (name, age) VALUES('xlc', 22)"); ResultSet results = session.execute("SELECT * FROM newks.newtb"); System.out.println(results.all()); results = session.execute("SELECT name from newks.newtb"); System.out.println(results.all()); results = session.execute("SELECT count(*) from newks.newtb"); System.out.println(results.all()); System.out.println("FINISHED OPERATION !"); } finally { if (cluster != null) cluster.close(); } } } 最后的结果如图: CQL使用 这里简单介绍下常见的CQL的使用,主要分2类:DDL以及DML。 DDL : CREATE KEYSPACE: CREATE KEYSPACE ksname WITH replication = {'class': 'SimpleStrategy', 'replication_factor' : 3}; 如果是多DC的话可以如下建表,保证使用NetworkTopologyStrategy: CREATE KEYSPACE ksname WITH replication = {'class': 'NetworkTopologyStrategy', 'DC1' : 3, 'DC2' : 3}; ALTER KEYSPACE : ALTER KEYSPACE ksname WITH replication = {'class': 'SimpleStrategy', 'replication_factor' : 4}; 修改了副本数从3变成4. CREATE TABLE : CREATE TABLE t ( pk text, v1 int, v2 text, v3 text , PRIMARY KEY (pk, v1) ); 必须指定primary key,用来唯一确定数据在集群的唯一id。当然TABLE还有很多别的属性,这里使用默认的,其他的以后再详细介绍。 这里主要介绍我们常见的使用方式,还有drop keyspace,truncate table等等可以见这里。 DML: 我们列举我们常见的SELECT 、INSERT、UPDATE 、DELETE、BATCH操作: INSERT : INSERT INTO t (pk, v1, v2, v3) VALUES ( 'pk1', 1, 'v2', 'v3'); 一定要提供我们的PRIMARY KEY的数据; SELECT : SELECT pk, v1, v2, v3 FROM t; UPDATE: UPDATE t SET v2 = 'vv2' WHERE pk = 'pk1' AND v1 =1; DELETE: DELETE FROM t WHERE pk = 'pk1' AND v1 =1; BATCH: BEGIN BATCH ... INSERT INTO t (pk, v1, v2, v3) VALUES ( 'pk1', 1, 'v2', 'vV3'); ... APPLY BATCH ;

优秀的个人博客,低调大师

Cassandra 最佳实践系列(2) - 选型篇

本文会从cassandra的选型,机器基本配置,节点数,基本使用介绍方面进行基本的介绍; 机器基本配置选择 Cassandra的性能使用可以随着机器的硬件配置,以及集群的节点数的横向和纵向的升级而相应的有所提升。 CPU Cassandra内部会有很多地方使用多线程进行处理,一般配置里面对于读写而言,写操作是CPU bound,所以如果系统的写操作会相对多一点,对cpu的要求也会相对配置要好一点,一般至少是2c起步,如果是生产环境对写要求更高,相对的cpu核数应该更好。 内存 Cassandra使用java 语言编写,会用到jvm-on heap内存以及offheap内存,其中jvm预先想操作系统申请的内存大小是系统大小的1/2, 其中off-heap会使用于压缩元数据,bloom filter等等。官方建议生产环境内存不低于8G,但是具体可以视自己的需求再说,对于gc算法来说: 堆内存小于12G,推荐cms算法; 大于12G堆内存的话,可以使用G1 算法; 磁盘 对于cassandra而言有几个地方需要使用到磁盘,commitlog、hint、cache-file、sstable-file。其中对我们来说,我们需要重点关注commitlog的文件以及sstable的文件,因为写操作会先写commitlog,然后把数据丢到memtable,然后memtable会异步的dump到磁盘成为sstable的文件,而且sstable后台会进行异步的compaction操作合并成新文件。那么这里commitlog的会影响我们的写性能,常见的建议是commitlog的配置 磁盘与放置sstable的data 目录分开配置,commitlog单独配置一块盘,因为写commitlog的速度直接影响写操作的速度,所以建议commitlog的配置磁盘需要稍微好一点,但是容量不需要很大,因为commitlog的数据在相关memtable数据dump到磁盘以后就会删除。只有存留在memtable的数据在commitlog里面以做节点crash以后做replay使用。 存放sstable的磁盘可以使用HDD/SSD磁盘,相关cassandra有优化配置,那么这里的话可以使用多块磁盘组合使用Raid0或者cassandra所谓的JBOD方式,使用其他的Raid1-Raid5不是最优的使用推荐,因为在节点层面有多数据副本冗余。具体磁盘容量视集群业务需求以及其他配置来定。 节点数 Cassandra可以是单节点(需要设置replicat factor 为1),2个节点(replicat factor最多是2),3个节点,…..个节点,理论上的扩容是线性的,无上限的扩容,可以从1 到很大。但是常见一般300个物理节点基本是可以了。

优秀的个人博客,低调大师

云存储网关的缓存最佳实践

前言 云存储网关支持通过传统的文件协议(SMB/NFS)来访问OSS Bucket里面的数据,并能够通过缓存技术将用户频繁访问的热点数据保留在网关侧的缓存盘里,从而提供给用户更好的访问体验。使得用户在享受云上海量OSS存储空间的同时,还兼具本地的高速访问性能。下面是阿里云文件网关的架构图。 用户在使用阿里云云存储网关时,经常会碰到一些缓存相关的问题,比如在创建共享时如何选择缓存盘的容量和类型,比如缓存的数据淘汰策略是什么等。本文接下来的内容将结合缓存盘的工作原理来解开这些困惑。云存储网关根据支持的协议的不同,分为支持NFS/SMB文件协议的文件网关和支持iSCSI协议的块网关。它们两者的缓存工作机制是不一样的,本文主要针对的文件网关。 工作原理 文件网关支持缓存模式和复制模式两种模式,绝大部分用户使用的应该都是缓存模式。缓存模式是指缓存盘的数据到一定比例之后,文件网关会自动淘汰那些访问不频繁的数据。在这种模式下,固定容量的缓存盘可以管理远远大于缓存盘实际容量的OSS Bucket。复制模式则不同,数据在网关侧和OSS Bucket里面是1:1的,所以网关不会去做数据的淘汰,一定容量的缓存盘理论上只能管理对应于缓存盘容量的OSS Bucket。复制模式针对的场景主要是OSS Bucket总数据量基本不会增长且总数据量不是特别大,同时希望将所有数据都保持在网关共享里加速访问。不过这种场景毕竟在少数,绝大多数用户会选择缓存模式以应对日后OSS Bucket里面的数据增长。 在缓存模式下,缓存盘的数据会在60%满的时候触发淘汰直到实际数据量落到60%以下,从而保证永远有足够的缓存容量面对新的数据写入。那么淘汰的策略是如何的呢,如何决定哪些数据是可以淘汰的呢?文件网关淘汰的实际上是已经同步到OSS Bucket里面的文件,也就是说对某个文件的最后一次修改应用到网关的SMB或者NFS共享之后,并且网关已经将这个文件上传到OSS Bucket里面,那么这个文件就是可以淘汰的。如果用户还在持续的对某个文件进行写入,这个文件是不会被选为一个淘汰的对象的。所以用户如果同时打开多个文件进行写入,缓存盘的容量就应该比同时在写的所有文件的总容量要大,否则就有可能导致数据来不及淘汰而造成写入错误!!! 在复制模式下,因为数据不会发生淘汰,相对来说就简单很多。缓存盘的容量比OSS Bucket里面的总数据大就可以,这种模式注定它不可能管理特别大的数据量,因为当前支持的缓存盘的最大容量32TB。所以除非对复制模式有强需求,还是推荐使用缓存模式,相对来说更加灵活。 另外文件网关会预留一部分缓存盘空间存储元数据,一般会预留20%。这部分元数据主要是用来存储单个文件的元数据,包括大小,修改时间等等。所以即使某个文件的数据被淘汰之后,网关还是存储了一个桩文件在元数据里,这样用户从客户端进行文件夹浏览的时候,还是能够看到数据被淘汰掉的这个文件,给用户一致的体验。用户如果试图读取这个文件内容,网关会负责将数据再次从OSS Bucket里获取到缓存盘里面。这部分元数据空间关系到当前共享可以支持的最大文件数目,毕竟40GB的缓存盘的元数据空间肯定低于50GB的缓存盘的元数据空间。一般来说100G的缓存盘已经可以支持到1000万文件了。 注意事项 了解缓存的工作原理之后,下面这些其实都比较好理解了。 如果你的业务对带宽和IOPS的要求比较高,比如跑的数据库之类的对时延要求比较高的业务,那么可能SSD类型的缓存盘更适合,因为它拥有更好的带宽和IOPS。SSD类型的缓存盘的带宽和IOPS都会比高效云盘更优秀,SSD缓存的最高IOPS可以到25000,高效云盘缓存是5000,带宽方面SSD缓存最高可以到300MB,高效云盘缓存的带宽最高可以到140MB。 容量的选择主要和并发数和最大文件大小有关。缓存盘的可用容量(需要扣除元数据空间)需要大于并发数和最大文件大小的乘积,这样才不会造成数据写入错误。当然越大的缓存盘本地能够缓存的热数据量也就越多,总体来说性能会更好。所以如果希望能够获得比较好的性能,缓存盘还是要设置的稍微大一些。 云存储网关的控制台现在也提供了非常方便的计算器,根据用户输入的IOPS和带宽需求等可以作出合适的缓存容量和类型的推荐。结合我们前面讲的对照看下图中每一个条目,相信很好理解。 小结 本文介绍了云存储网关文件网关的缓存工作原理,包括缓存盘元数据空间管理,数据淘汰策略等,旨在解答用户在选择和使用缓存盘时遇到的一些问题。

优秀的个人博客,低调大师

Android 组件化最佳实践 ARetrofit 原理

本文首发于 vivo互联网技术 微信公众号 https://mp.weixin.qq.com/s/TXFt7ymgQXLJyBOJL8F6xg 作者:朱壹飞 ARetrofit 是一款针对Android组件之间通信的路由框架,实现快速组件化开发的利器。本文主要讲述 ARetrofit 实现的原理。 简介 ARetrofit 是一款针对Android组件之间通信的路由框架,实现快速组件化开发的利器。 源码链接:https://github.com/yifei8/ARetrofit 组件化架构 APP Demo, ARetrofit 使用实例:https://github.com/yifei8/HappyNote 组件化 Android组件化已经不是一个新鲜的概念了,出来了已经有很长一段时间了,大家可以自行Google,可以看到一堆相关的文章。 简单的来说,所谓的组件就是Android Studio中的Module,每一个Module都遵循高内聚的原则,通过ARetrofit 来实现无耦合的代码结构,如下图: 每一个 Module 可单独作为一个 project 运行,而打包到整体时 Module 之间的通信通过 ARetrofit 完成。 ARetrofit 原理 讲原理之前,我想先说说为什么要ARetrofit。开发ARetrofit 这个项目的思路来源其实是 Retrofit,Retrofit 是Square公司开发的一款针对 Android 网络请求的框架,这里不对Retrofit展开来讲。主要是 Retrofit 框架使用非常多的设计模式,可以说 Retrofit 这个开源项目将Java的设计模式运用到了极致,当然最终提供的API也是非常简洁的。如此简洁的API,使得我们APP中的网络模块实现变得非常轻松,并且维护起来也很舒服。因此我觉得有必要将Android组件之间的通信也变得轻松,使用者可以优雅的通过简洁的API就可以实现通信,更重要的是维护起来也非常的舒服。 ARetrofit 基本原理可以简化为下图所示: 1.通过注解声明需要通信的Activity/Fragment或者Class 2.每一个module通过annotationProcessor在编译时生成待注入的RouteInject的实现类和AInterceptorInject的实现类。 这一步在执行app[build]时会输出日志,可以直观的看到,如下图所示: 注: AInjecton::Compiler >>> Apt interceptor Processor start... <<< 注: AInjecton::Compiler enclosindClass = null 注: AInjecton::Compiler value = 3 注: AInjecton::Compiler auto generate class = com $$ sjtu $$ yifei $$ eCGVmTMvXG $$ AInterceptorInject 注: AInjecton::Compiler add path= 3 and class= LoginInterceptor .... 注: AInjecton::Compiler >>> Apt route Processor start... <<< 注: AInjecton::Compiler enclosindClass = null 注: AInjecton::Compiler value = /login-module/ILoginProviderImpl 注: AInjecton::Compiler enclosindClass = null 注: AInjecton::Compiler value = /login-module/LoginActivity 注: AInjecton::Compiler enclosindClass = null 注: AInjecton::Compiler value = /login-module/Test2Activity 注: AInjecton::Compiler enclosindClass = null 注: AInjecton::Compiler value = /login-module/TestFragment 注: AInjecton::Compiler auto generate class = com $$ sjtu $$ yifei $$ VWpdxWEuUx $$ RouteInject 注: AInjecton::Compiler add path= /login-module/TestFragment and class= null 注: AInjecton::Compiler add path= /login-module/LoginActivity and class= null 注: AInjecton::Compiler add path= /login-module/Test2Activity and class= null 注: AInjecton::Compiler add path= /login-module/ILoginProviderImpl and class= null 注: AInjecton::Compiler >>> Apt route Processor succeed <<< 3.将编译时生成的类注入到RouterRegister中,这个类主要用于维护路由表和拦截器,对应的[build]日志如下: TransformPluginLaunch >>> ========== Transform scan start =========== TransformPluginLaunch >>> ========== Transform scan end cost 0.238 secs and start inserting =========== TransformPluginLaunch >>> Inserting code to jar >> /Users/yifei/as_workspace/ARetrofit/app/build/intermediates/transforms/TransformPluginLaunch/release/8.jar TransformPluginLaunch >>> to class >> com/sjtu/yifei/route/RouteRegister.class InjectClassVisitor >>> inject to class: InjectClassVisitor >>> com/sjtu/yifei/route/RouteRegister{ InjectClassVisitor >>> public *** init() { InjectClassVisitor >>> register("com.sjtu.yifei.FBQWNfbTpY.com $$ sjtu $$ yifei $$ FBQWNfbTpY $$ RouteInject") InjectClassVisitor >>> register("com.sjtu.yifei.klBxerzbYV.com $$ sjtu $$ yifei $$ klBxerzbYV $$ RouteInject") InjectClassVisitor >>> register("com.sjtu.yifei.JmhcMMUhkR.com $$ sjtu $$ yifei $$ JmhcMMUhkR $$ RouteInject") InjectClassVisitor >>> register("com.sjtu.yifei.fpyxYyTCRm.com $$ sjtu $$ yifei $$ fpyxYyTCRm $$ AInterceptorInject") InjectClassVisitor >>> } InjectClassVisitor >>> } TransformPluginLaunch >>> ========== Transform insert cost 0.017 secs end =========== 4.Routerfit.register(Class service) 这一步主要是通过动态代理模式实现接口中声明的服务。 前面讲的是整体的框架设计思想,便于读者从全局的觉得来理解ARetrofit的框架的架构。接下来,将待大家个个击破上面提到的annotationProcessor、 transform在项目中如何使用,以及动态代理、拦截器功能的实现等细节。 一、annotationProcessor生成代码 annotationProcessor(注解处理器)是javac内置的一个用于编译时扫描和处理注解(Annotation)的工具。简单的说,在源代码编译阶段,通过注解处理器,我们可以获取源文件内注解(Annotation)相关内容。Android Gradle 2.2 及以上版本提供annotationProcessor的插件。 在ARetrofit中annotationProcessor对应的module是auto-complier,在使用annotationProcessor之前首先需要声明好注解。关于注解不太了解或者遗忘的同学可直接参考我之前写的Java注解这篇文章,本项目中声明的注解在auto-annotation这个module中,主要有: @Extra 路由参数 @Flags intent flags @Go 路由路径key @Interceptor 声明自定义拦截器 @RequestCode 路由参数 @Route路由 @Uri @IMethod 用于标记注册代码将插入到此方法中(transform中使用) @Inject 用于标记需要被注入类,最近都将插入到标记了#com.sjtu.yifei.annotation.IMethod的方法中(transform中使用) 创建自定义的注解处理器,具体使用方法可参考利用注解动态生成代码,本项目中的注解处理器如下所示: //这是用来注册注解处理器要处理的源代码版本。 @SupportedSourceVersion(SourceVersion.RELEASE_8) //这个注解用来注册注解处理器要处理的注解类型。有效值为完全限定名(就是带所在包名和路径的类全名 @SupportedAnnotationTypes({ANNOTATION_ROUTE, ANNOTATION_GO}) //来注解这个处理器,可以自动生成配置信息 @AutoService(Processor.class) public class IProcessor extends AbstractProcessor { } 生成代码的关键部分在GenerateAInterceptorInjectImpl 和GenerateRouteInjectImpl中,以下贴出关键代码: public void generateAInterceptorInjectImpl(String pkName) { try { String name = pkName.replace(".",DECOLLATOR) + SUFFIX; logger.info(String.format("auto generate class = %s", name)); TypeSpec.Builder builder = TypeSpec.classBuilder(name) .addModifiers(Modifier.PUBLIC) .addAnnotation(Inject.class) .addSuperinterface(AInterceptorInject.class); ClassName hashMap = ClassName.get("java.util", "HashMap"); //Map<String, Class<?>> TypeName wildcard = WildcardTypeName.subtypeOf(Object.class); TypeName classOfAny = ParameterizedTypeName.get(ClassName.get(Class.class), wildcard); TypeName string = ClassName.get(Integer.class); TypeName map = ParameterizedTypeName.get(ClassName.get(Map.class), string, classOfAny); MethodSpec.Builder injectBuilder = MethodSpec.methodBuilder("getAInterceptors") .addModifiers(Modifier.PUBLIC) .addAnnotation(Override.class) .returns(map) .addStatement("$T interceptorMap = new $T<>()", map, hashMap); for (Map.Entry<Integer, ClassName> entry : interceptorMap.entrySet()) { logger.info("add path= " + entry.getKey() + " and class= " + entry.getValue().simpleName()); injectBuilder.addStatement("interceptorMap.put($L, $T.class)", entry.getKey(), entry.getValue()); } injectBuilder.addStatement("return interceptorMap"); builder.addMethod(injectBuilder.build()); JavaFile javaFile = JavaFile.builder(pkName, builder.build()) .build(); javaFile.writeTo(filer); } catch (Exception e) { e.printStackTrace(); } } public void generateRouteInjectImpl(String pkName) { try { String name = pkName.replace(".",DECOLLATOR) + SUFFIX; logger.info(String.format("auto generate class = %s", name)); TypeSpec.Builder builder = TypeSpec.classBuilder(name) .addModifiers(Modifier.PUBLIC) .addAnnotation(Inject.class) .addSuperinterface(RouteInject.class); ClassName hashMap = ClassName.get("java.util", "HashMap"); //Map<String, String> TypeName wildcard = WildcardTypeName.subtypeOf(Object.class); TypeName classOfAny = ParameterizedTypeName.get(ClassName.get(Class.class), wildcard); TypeName string = ClassName.get(String.class); TypeName map = ParameterizedTypeName.get(ClassName.get(Map.class), string, classOfAny); MethodSpec.Builder injectBuilder = MethodSpec.methodBuilder("getRouteMap") .addModifiers(Modifier.PUBLIC) .addAnnotation(Override.class) .returns(map) .addStatement("$T routMap = new $T<>()", map, hashMap); for (Map.Entry<String, ClassName> entry : routMap.entrySet()) { logger.info("add path= " + entry.getKey() + " and class= " + entry.getValue().enclosingClassName()); injectBuilder.addStatement("routMap.put($S, $T.class)", entry.getKey(), entry.getValue()); } injectBuilder.addStatement("return routMap"); builder.addMethod(injectBuilder.build()); JavaFile javaFile = JavaFile.builder(pkName, builder.build()) .build(); javaFile.writeTo(filer); } catch (Exception e) { e.printStackTrace(); } } 二、Transform Android Gradle 工具在 1.5.0 版本后提供了 Transfrom API, 允许第三方 Plugin在打包dex文件之前的编译过程中操作 .class 文件。这一部分面向高级Android工程师的,面向字节码编程,普通工程师可不做了解。 写到这里也许有人会有这样一个疑问,既然annotationProcessor这么好用为什么还有Transform面向字节码注入呢?这里需要解释以下,annotationProcessor具有局限性,annotationProcessor只能扫描当前module下的代码,且对于第三方的jar、aar文件都扫描不到。而Transform就没有这样的局限性,在打包dex文件之前的编译过程中操作.class 文件。 关于Transfrom API在Android Studio中如何使用可以参考Transform API — a real world example,顺便提供一下字节码指令方便我们读懂ASM。 本项目中的Transform插件在AInject中,实现源码TransformPluginLaunch如下,贴出关键部分: /** * * 标准transform的格式,一般实现transform可以直接拷贝一份重命名即可 * * 两处todo实现自己的字节码增强/优化操作 */ class TransformPluginLaunch extends Transform implements Plugin<Project> { @Override void transform(TransformInvocation transformInvocation) throws TransformException, InterruptedException, IOException { super.transform(transformInvocation) //todo step1: 先扫描 transformInvocation.inputs.each { TransformInput input -> input.jarInputs.each { JarInput jarInput -> ... } input.directoryInputs.each { DirectoryInput directoryInput -> //处理完输入文件之后,要把输出给下一个任务 ... } } //todo step2: ...完成代码注入 if (InjectInfo.get().injectToClass != null) { ... } } /** * 扫描jar包 * @param jarFile */ static void scanJar(File jarFile, File destFile) { } /** * 扫描文件 * @param file */ static void scanFile(File file, File dest) { ... } } 注入代码一般分为两个步骤: 第一步:扫描 这一部分主要是扫描的内容有: 注入类和方法的信息,是AutoRegisterContract的实现类和其中@IMethod,@Inject的方法。 待注入类的和方法信息,是RouteInject 和 AInterceptorInject实现类且被@Inject注解的。 第二步:注入 以上扫描的结果,将待注入类注入到注入类的过程。这一过程面向ASM操作,可参考字节码指令来读懂以下的关键注入代码: class InjectClassVisitor extends ClassVisitor { ... class InjectMethodAdapter extends MethodVisitor { InjectMethodAdapter(MethodVisitor mv) { super(Opcodes.ASM5, mv) } @Override void visitInsn(int opcode) { Log.e(TAG, "inject to class:") Log.e(TAG, own + "{") Log.e(TAG, " public *** " + InjectInfo.get().injectToMethodName + "() {") if (opcode >= Opcodes.IRETURN && opcode <= Opcodes.RETURN) { InjectInfo.get().injectClasses.each { injectClass -> injectClass = injectClass.replace('/', '.') Log.e(TAG, " " + method + "(\"" + injectClass + "\")") mv.visitVarInsn(Opcodes.ALOAD, 0) mv.visitLdcInsn(injectClass) mv.visitMethodInsn(Opcodes.INVOKEVIRTUAL, own, method, "(Ljava/lang/String;)V", false) } } Log.e(TAG, " }") Log.e(TAG, "}") super.visitInsn(opcode) } ... } ... } 三、动态代理 定义:为其它对象提供一种代理以控制对这个对象的访问控制;在某些情况下,客户不想或者不能直接引用另一个对象,这时候代理对象可以在客户端和目标对象之间起到中介的作用。 Routerfit.register(Class service) 这里就是采用动态代理的模式,使得ARetrofit的API非常简洁,使用者可以优雅定义出路由接口。关于动态代理的学习难度相对来说还比较小,想了解的同学可以参考这篇文章java动态代理。 本项目相关源码: public final class Routerfit { ... private <T> T create(final Class<T> service) { RouterUtil.validateServiceInterface(service); return (T) Proxy.newProxyInstance(service.getClassLoader(), new Class<?>[]{service}, new InvocationHandler() { @Override public Object invoke(Object proxy, Method method, @Nullable Object[] args) throws Throwable { // If the method is a method from Object then defer to normal invocation. if (method.getDeclaringClass() == Object.class) { return method.invoke(this, args); } ServiceMethod<Object> serviceMethod = (ServiceMethod<Object>) loadServiceMethod(method, args); if (!TextUtils.isEmpty(serviceMethod.uristring)) { Call<T> call = (Call<T>) new ActivityCall(serviceMethod); return call.execute(); } try { if (serviceMethod.clazz == null) { throw new RouteNotFoundException("There is no route match the path \"" + serviceMethod.routerPath + "\""); } } catch (RouteNotFoundException e) { Toast.makeText(ActivityLifecycleMonitor.getApp(), e.getMessage(), Toast.LENGTH_SHORT).show(); e.printStackTrace(); } if (RouterUtil.isSpecificClass(serviceMethod.clazz, Activity.class)) { Call<T> call = (Call<T>) new ActivityCall(serviceMethod); return call.execute(); } else if (RouterUtil.isSpecificClass(serviceMethod.clazz, Fragment.class) || RouterUtil.isSpecificClass(serviceMethod.clazz, android.app.Fragment.class)) { Call<T> call = new FragmentCall(serviceMethod); return call.execute(); } else if (serviceMethod.clazz != null) { Call<T> call = new IProviderCall<>(serviceMethod); return call.execute(); } if (serviceMethod.returnType != null) { if (serviceMethod.returnType == Integer.TYPE) { return -1; } else if (serviceMethod.returnType == Boolean.TYPE) { return false; } else if (serviceMethod.returnType == Long.TYPE) { return 0L; } else if (serviceMethod.returnType == Double.TYPE) { return 0.0d; } else if (serviceMethod.returnType == Float.TYPE) { return 0.0f; } else if (serviceMethod.returnType == Void.TYPE) { return null; } else if (serviceMethod.returnType == Byte.TYPE) { return (byte)0; } else if (serviceMethod.returnType == Short.TYPE) { return (short)0; } else if (serviceMethod.returnType == Character.TYPE) { return null; } } return null; } }); } ... } 这里ServiceMethod是一个非常重要的类,使用了外观模式,主要用于解析方法中的被注解所有信息并保存起来。 四、拦截器链实现 本项目中的拦截器链设计,使得使用者可以非常优雅的处理业务逻辑。如下: @Interceptor(priority = 3) public class LoginInterceptor implements AInterceptor { private static final String TAG = "LoginInterceptor"; @Override public void intercept(final Chain chain) { //Test2Activity 需要登录 if ("/login-module/Test2Activity".equalsIgnoreCase(chain.path())) { Routerfit.register(RouteService.class).launchLoginActivity(new ActivityCallback() { @Override public void onActivityResult(int i, Object data) { if (i == Routerfit.RESULT_OK) {//登录成功后继续执行 Toast.makeText(ActivityLifecycleMonitor.getTopActivityOrApp(), "登录成功", Toast.LENGTH_LONG).show(); chain.proceed(); } else { Toast.makeText(ActivityLifecycleMonitor.getTopActivityOrApp(), "登录取消/失败", Toast.LENGTH_LONG).show(); } } }); } else { chain.proceed(); } } } 这一部分实现的思想是参考了okhttp中的拦截器,这里使用了java设计模式责任链模式,具体实现欢迎阅读源码。 总结 基本上读完本文可以对 ARetrofit 的核心原理有了很清晰的理解.简单来说 ARetrofit 通过 annotationProcessor 在编译时获取路由相关内容,通过 ASM 实现了可跨模块获取对象,最终通过动态代理实现面向切面编程(AOP)。 ARetrofit 相对于其他同类型的路由框架来说,其优点是提供了更加简洁的 API,其中高阶用法对开发者提供了更加灵活扩展方式,开发者还可以结合 RxJava 完成复杂的业务场景。具体可以参考 ARetrofit 的基本用法,以及 Issues。 ———— 参考资料 ———— Java注解:https://www.jianshu.com/p/ef1146a771b5 利用注解动态生成代码:https://blog.csdn.net/Gaugamela/article/details/79694302 Transform API — a real world example:https://medium.com/grandcentrix/transform-api-a-real-world-example-cfd49990d3e1
优秀的个人博客,低调大师

分析网络超时问题的最佳实践

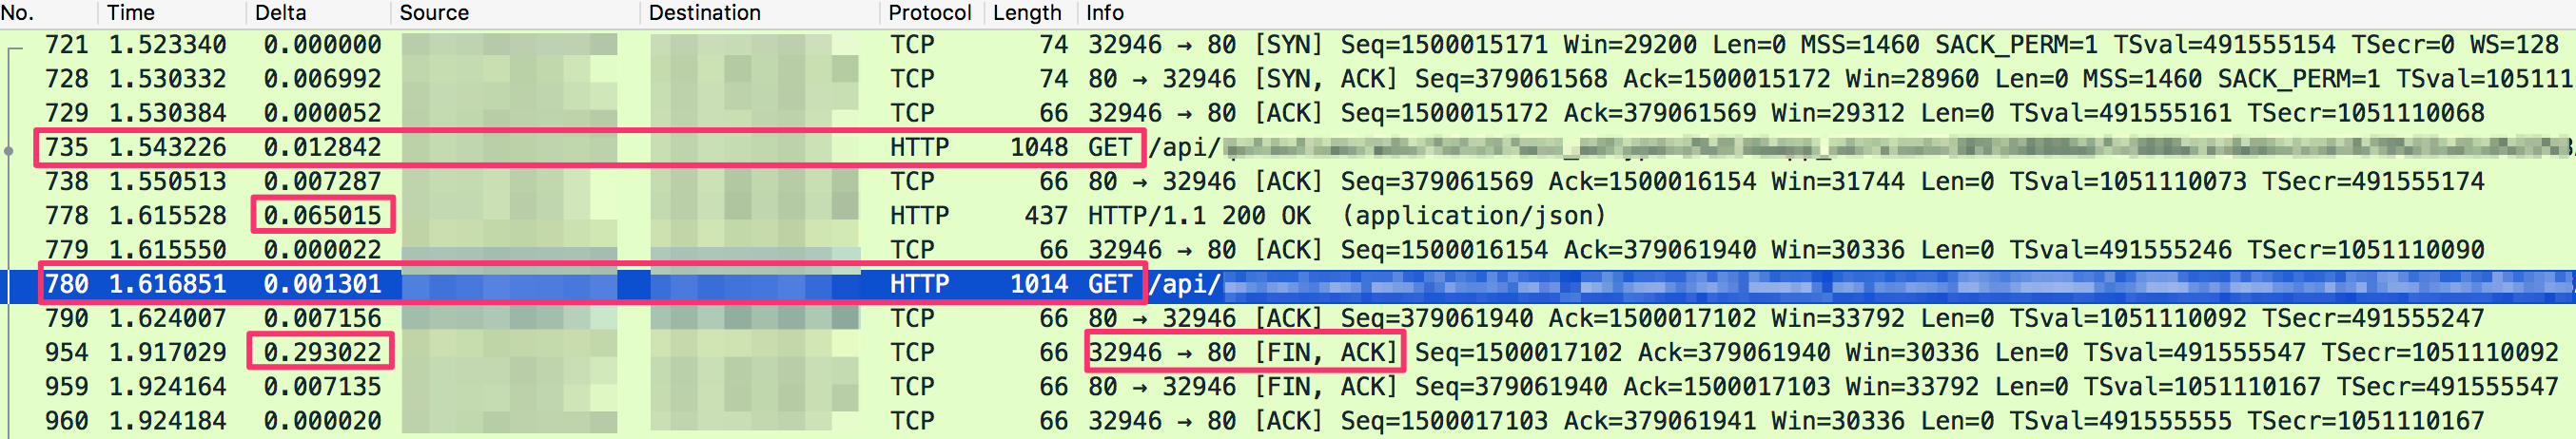
对于云上的用户来说,业务日志里面报超时问题处理起来往往比价棘手,因为1) 问题点可能在云基础设施层,也有可能在业务软件层,需要排查的范围非常广;2) 这类问题往往是不可复现问题,抓到现场比较难。在本文里就分析下如何来分辨和排查这类问题的根本原因。 业务超时 != 网络丢包 由于业务的形态不同,软件实现语言和框架的不同,业务日志中打印出的信息可能是各不相同,比如如下关键字: "SocketTimeOut", "Read timed out", "Request timeout" 等 从形式看都属于网络超时这一类,但是需要明确一个概念:这类问题是发生的原因是请求超过了设定的timeout时间,这个设置有可能来自客户端,服务器端或者网络中间节点,这是直接原因。网络丢包可能会导致超时,但是并不是充分条件。总结业务超时和网络丢包的关系如下: 网络丢包

优秀的个人博客,低调大师

车联网上云最佳实践(七)

使用阿里云带来的价值1、 节约成本自建机房往往需要投入的大量人力成本,时间成本,资金成本。而且传统IDC不仅成本很高,而且网络还不稳定,数据存储安全性低,需要投入大量运维人员维护。如果随着用户量不断增加,带宽和服务器存储都需要扩容,严重制约了产品迭代速度。阿里云不但帮助企业减少IT基础设施的投入,还提升了业务部署效率。从前面的云数据库RDS和自建数据库成本对比可以看出同样的数据库服务能力(IOPS为600),自够服务器搭建数据库成本要比云数据库的成本高的多。而且云数据库方面提供了完善的容灾、备份、恢复、监控、迁移的解决方案。不但保证了数据读写的准确性,而且彻底解决了数据库运维的烦恼。 构建智能车联网平台涉及的云产品、作用及价格 2、 弹性扩展随着公司业务不断壮大,面对如此大规模的汽车用户增长,系统需要应对高并发的访问量,给

优秀的个人博客,低调大师

车联网上云最佳实践(六)

尽管阿里云产品已经很多很强大了,但是在某些功能和需求上也不能满足每一位用户的要求,阿里云的云市场作为阿里云平台的扩展,为百万阿里云用户提供更加定制化的需求和赋能。云市场目前有八大集市,包括基础软件、服务、安全、企业应用、建站、解决方案和数据市场,截至目前,入驻云市场的服务商达1000余家,商品达3000余种。这里为车联网企业推荐一些比较实用的云市场。1、 基础软件市场基础软件市场主要是帮助企业用户快速高效的完成基础架构搭建而提供的一些定制服务或者应用工具。例如运行环境,通常情况运维人员需要安装好操作系统,然后安装好相应的应用软件,还要对系统参数进行调优,最后将这个环境打包成镜像方便日后使用,这个过程通常费时费力,现在可以直接在阿里云的云市场直接购买的相关运行环境的镜像用于创建ECS实例即可。省时省力,安全放心。推荐一些车联网

优秀的个人博客,低调大师

转载:Futurice-Android 开发最佳实践

转载至:https://github.com/futurice/android-best-practices 从Futurice公司Android开发者中学到的经验。 遵循以下准则,避免重复发明轮子。若你对开发iOS或Windows Phone 有兴趣, 请看iOS Good Practices 和 Windows client Good Practices 这两篇文章。 摘要 使用 Gradle 和它推荐的工程结构 把密码和敏感数据放在gradle.properties 不要自己写 HTTP 客户端,使用Volley或OkHttp库 使用Jackson库解析JSON数据 避免使用Guava同时使用一些类库来避免65k method limit(一个Android程序中最多能执行65536个方法) 使用 Fragments来呈现UI视图 使用 Activities 只是为了管理 Fragments Layout 布局是 XMLs代码,组织好它们 在layoutout XMLs布局时,使用styles文件来避免使用重复的属性 使用多个style文件来避免单一的一个大style文件 保持你的colors.xml 简短DRY(不要重复自己),只是定义调色板 总是使用dimens.xml DRY(不要重复自己),定义通用常数 不要做一个深层次的ViewGroup 在使用WebViews时避免在客户端做处理,当心内存泄露 使用Robolectric单元测试,Robotium 做UI测试 使用Genymotion 作为你的模拟器 总是使用ProGuard 和 DexGuard混淆来项目 Android SDK 将你的Android SDK放在你的home目录或其他应用程序无关的位置。 当安装有些包含SDK的IDE的时候,可能会将SDK放在IDE同一目录下,当你需要升级(或重新安装)IDE或更换的IDE时,会非常麻烦。 此外,如果你的IDE是在普通用户下运行,而不是在root下运行,还要避免把SDK放到一下需要sudo权限的系统级别目录下。 构建系统 你的默认编译环境应该是Gradle. Ant 有很多限制,也很冗余。使用Gradle,完成以下工作很方便: 构建APP不同版本的变种 制作简单类似脚本的任务 管理和下载依赖 自定义秘钥 更多 同时,Android Gradle插件作为新标准的构建系统正在被Google积极的开发。 工程结构 有两种流行的结构:老的Ant & Eclipse ADT 工程结构,和新的Gradle & Android Studio 工程结构, 你应该选择新的工程结构,如果你的工程还在使用老的结构,考虑放弃吧,将工程移植到新的结构。 老的结构: old-structure ├─ assets ├─ libs ├─ res ├─ src │ └─ com/futurice/project ├─ AndroidManifest.xml ├─ build.gradle ├─ project.properties └─ proguard-rules.pro 新的结构 new-structure ├─ library-foobar ├─ app │ ├─ libs │ ├─ src │ │ ├─ androidTest │ │ │ └─ java │ │ │ └─ com/futurice/project │ │ └─ main │ │ ├─ java │ │ │ └─ com/futurice/project │ │ ├─ res │ │ └─ AndroidManifest.xml │ ├─ build.gradle │ └─ proguard-rules.pro ├─ build.gradle └─ settings.gradle 主要的区别在于,新的结构明确的分开了'source sets' (main,androidTest),这是Gradle的一个理念。 通过这个你可以做到,例如,添加源组‘paid’和‘free’在src中,让你的应用程序具有付费和免费的两种模式的源代码。 你的项目引用第三方项目库时(例如,library-foobar),拥有一个顶级包名app从第三方库项目区分你的应用程序是非常有用的。 然后settings.gradle不断引用这些库项目,其中app/build.gradle可以引用。 Gradle 配置 常用结构 参考Google's guide on Gradle for Android 小任务 除了(shell, Python, Perl, etc)这些脚本语言,你也可以使用Gradle 制作任务。 更多信息请参考Gradle's documentation。 密码 在做版本release时你app的 build.gradle你需要定义 signingConfigs.此时你应该避免以下内容: 不要做这个 . 这会出现在版本控制中。 signingConfigs { release { storeFile file("myapp.keystore") storePassword "password123" keyAlias "thekey" keyPassword "password789" } } 而是,建立一个不加入版本控制系统的gradle.properties文件。 KEYSTORE_PASSWORD=password123 KEY_PASSWORD=password789 那个文件是gradle自动引入的,你可以在buld.gradle文件中使用,例如: signingConfigs { release { try { storeFile file("myapp.keystore") storePassword KEYSTORE_PASSWORD keyAlias "thekey" keyPassword KEY_PASSWORD } catch (ex) { throw new InvalidUserDataException("You should define KEYSTORE_PASSWORD and KEY_PASSWORD in gradle.properties.") } } } 使用 Maven 依赖方案代替使用导入jar包方案 如果在你的项目中你明确使用某些 jar文件,那么它们可能成为固定的版本,如2.1.1.下载jar包更新他们是很繁琐的, 这个问题Maven很好的解决了,这在Android Gradle构建中也是推荐的方法。你可 以指定版本的一个范围,如2.1.+,然后Maven会自动升级到制定的最新版本,例如: dependencies { compile 'com.netflix.rxjava:rxjava-core:0.19.+' compile 'com.netflix.rxjava:rxjava-android:0.19.+' compile 'com.fasterxml.jackson.core:jackson-databind:2.4.+' compile 'com.fasterxml.jackson.core:jackson-core:2.4.+' compile 'com.fasterxml.jackson.core:jackson-annotations:2.4.+' compile 'com.squareup.okhttp:okhttp:2.0.+' compile 'com.squareup.okhttp:okhttp-urlconnection:2.0.+' } IDEs and text editors IDE集成开发环境和文本编辑器 无论使用什么编辑器,一定要构建一个良好的工程结构。 编辑器每个人都有自己的 选择,让你的编辑器根据工程结构和构建系统运作,那是你自己的责任。 当下首推Android Studio,因为他是由谷歌开发,很好地支持Gradle,包含很多有用的检测和分析工具,默认使用最新的工程结构,它就是为Android开发定制的。 你也可以使用纯文版编辑器如Vim,Sublime Text,或者Emacs。如果那样的话,你需要使用Gradle和adb命令行。 不再推荐使用Eclipse和ADT开发,因为谷歌在2015年年末结束了对ADT的支持,并呼吁开发者尽快迁移到Android Studio。 无论你使用何种开发工具,避免将你的编辑器配置文件(比如Android Studio的iml文件)加入到版本控制,因为这些文件通常包含与本地机器有关的配置,可能会影响你的同事。 最后,善待其他开发者,不要强制改变他们的开发工具和偏好。 类库 Jackson 是一个将java对象转换成JSON与JSON转化java类的类库。Gson 是解决这个问题的流行方案,然而我们发现Jackson更高效,因为它支持替代的方法处理JSON:流、内存树模型,和传统JSON-POJO数据绑定。不过,请记住, Jsonkson库比起GSON更大,所以根据你的情况选择,你可能选择GSON来避免APP 65k个方法的限制。其它选择: Json-smart and Boon JSON 网络请求,缓存,图片 执行请求后端服务器,有几种交互的解决方案,你应该考虑实现你自己的网络客户端。使用 Volley 或Retrofit。Volley 同时提供图片缓存类。如果你选择使用Retrofit,那么考虑使用Picasso 来加载图片和缓存,同时使用OkHttp作为高效的网络请求。Retrofit,Picasso和OkHttp都是同一家公司开发(注: 是由Square 公司开发),所以它们能很好的在一起运行。OkHttp 同样可以和Volley在一起使用 Volley. RxJava 是函数式反应性的一个类库,换句话说,能处理异步的事件。 这是一个强大的和有前途的模式,同时也可能会造成混淆,因为它是如此的不同。 我们建议在使用这个库架构整个应用程序之前要谨慎考虑。 有一些项目是使用RxJava完成的,如果你需要帮助可以跟这些人取得联系: Timo Tuominen, Olli Salonen, Andre Medeiros, Mark Voit, Antti Lammi, Vera Izrailit, Juha Ristolainen. 我们也写了一些博客:[1], [2],[3],[4]. 如若你之前有使用过Rx的经历,开始从API响应应用它。 另外,从简单的UI事件处理开始运用,如单击事件或在搜索栏输入事件。 若对你的Rx技术有信心,同时想要将它应用到你的整体架构中,那么请在复杂的部分写好Javadocs文档。 请记住其他不熟悉RxJava的开发人员,可能会非常难理解整个项目。 尽你的的全力帮助他们理解你的代码和Rx。 Retrolambda 是一个在Android和预JDK8平台上的使用Lambda表达式语法的Java类库。 它有助于保持你代码的紧凑性和可读性,特别当你使用如RxJava函数风格编程时。 使用它时先安装JDK8,在Android Studio工程结构对话框中把它设置成为SDK路径,同时设置JAVA8_HOME和JAVA7_HOME环境变量, 然后在工程根目录下配置 build.gradle: dependencies { classpath 'me.tatarka:gradle-retrolambda:2.4.+' } 同时在每个module 的build.gradle中添加 apply plugin: 'retrolambda' android { compileOptions { sourceCompatibility JavaVersion.VERSION_1_8 targetCompatibility JavaVersion.VERSION_1_8 } retrolambda { jdk System.getenv("JAVA8_HOME") oldJdk System.getenv("JAVA7_HOME") javaVersion JavaVersion.VERSION_1_7 } Android Studio 提供Java8 lambdas表带是代码提示支持。如果你对lambdas不熟悉,只需参照以下开始学习吧: 任何只包含一个接口的方法都是"lambda friendly"同时代码可以被折叠成更紧凑的语法 如果对参数或类似有疑问,就写一个普通的匿名内部类,然后让Android Studio 为你生成一个lambda。 当心dex方法数限制,同时避免使用过多的类库 Android apps,当打包成一个dex文件时,有一个65535个应用方法强硬限制[1] [2] [3]。 当你突破65k限制之后你会看到一个致命错误。因此,使用一个正常范围的类库文件,同时使用dex-method-counts 工具来决定哪些类库可以再65k限制之下使用,特别的避免使用Guava类库,因为它包含超过13k个方法。 Activities and Fragments Fragments应该作为你实现UI界面默认选择。你可以重复使用Fragments用户接口来 组合成你的应用。我们强烈推荐使用Fragments而不是activity来呈现UI界面,理由如下: 提供多窗格布局解决方案 Fragments 的引入主要将手机应用延伸到平板电脑,所以在平板电脑上你可能有A、B两个窗格,但是在手机应用上A、B可能分别充满 整个屏幕。如果你的应用在最初就使用了fragments,那么以后将你的应用适配到其他不同尺寸屏幕就会非常简单。 屏幕间数据通信 从一个Activity发送复杂数据(例如Java对象)到另外一个Activity,Android的API并没有提供合适的方法。不过使用Fragment,你可以使用 一个activity实例作为这个activity子fragments的通信通道。即使这样比Activity与Activity间的通信好,你也想考虑使用Event Bus架构,使用如Otto 或者 greenrobot EventBus作为更简洁的实现。 如果你希望避免添加另外一个类库,RxJava同样可以实现一个Event Bus。 Fragments 一般通用的不只有UI 你可以有一个没有界面的fragment作为Activity提供后台工作。 进一步你可以使用这个特性来创建一个fragment 包含改变其它fragment的逻辑 而不是把这个逻辑放在activity中。 甚至ActionBar 都可以使用内部fragment来管理 你可以选择使用一个没有UI界面的fragment来专门管理ActionBar,或者你可以选择使用在每个Fragment中 添加它自己的action 来作为父Activity的ActionBar.参考. 很不幸,我们不建议广泛的使用嵌套的fragments,因为 有时会引起matryoshka bugs。我们只有当它有意义(例如,在水平滑动的ViewPager在 像屏幕一样fragment中)或者他的确是一个明智的选择的时候才广泛的使用fragment。 在一个架构级别,你的APP应该有一个顶级的activity来包含绝大部分业务相关的fragment。你也可能还有一些辅助的activity ,这些辅助的activity与主activity 通信很简单限制在这两种方法Intent.setData() 或 Intent.setAction()或类似的方法。 Java 包结构 Android 应用程序在架构上大致是Java中的Model-View-Controller结构。 在Android 中 Fragment和Activity通常上是控制器类(http://www.informit.com/articles/article.aspx?p=2126865). 换句话说,他们是用户接口的部分,同样也是Views视图的部分。 正是因为如此,才很难严格的将fragments (或者 activities) 严格的划分成 控制器controlloers还是视图 views。 最还是将它们放在自己单独的 fragments 包中。只要你遵循之前提到的建议,Activities 则可以放在顶级目录下。 如果你规划有2到3个以上的activity,那么还是同样新建一个activities包吧。 然而,这种架构可以看做是另一种形式的MVC, 包含要被解析API响应的JSON数据,来填充的POJO的models包中。 和一个views包来包含你的自定义视图、通知、导航视图,widgets等等。 适配器Adapter是在数据和视图之间。然而他们通常需要通过getView()方法来导出一些视图, 所以你可以将adapters包放在views包里面。 一些控制器角色的类是应用程序级别的,同时是接近系统的。 这些类放在managers包下面。 一些繁杂的数据处理类,比如说"DateUtils",放在utils包下面。 与后端交互负责网络处理类,放在network包下面。 总而言之,以最接近用户而不是最接近后端去安排他们。 com.futurice.project ├─ network ├─ models ├─ managers ├─ utils ├─ fragments └─ views ├─ adapters ├─ actionbar ├─ widgets └─ notifications 资源文件 Resources 命名 遵循前缀表明类型的习惯,形如type_foo_bar.xml。例如:fragment_contact_details.xml,view_primary_button.xml,activity_main.xml. 组织布局文件 如果你不确定如何排版一个布局文件,遵循一下规则可能会有帮助。 每一个属性一行,缩进4个空格 android:id 总是作为第一个属性 android:layout_**** 属性在上边 style 属性在底部 关闭标签/>单独起一行,有助于调整和添加新的属性 考虑使用Designtime attributes 设计时布局属性,Android Studio已经提供支持,而不是硬编码android:text (译者注:墙内也可以参考stormzhang的这篇博客链接)。 <?xml version="1.0" encoding="utf-8"?> <LinearLayout xmlns:android="http://schemas.android.com/apk/res/android" xmlns:tools="http://schemas.android.com/tools" android:layout_width="match_parent" android:layout_height="match_parent" android:orientation="vertical" > <TextView android:id="@+id/name" android:layout_width="match_parent" android:layout_height="wrap_content" android:layout_alignParentRight="true" android:text="@string/name" style="@style/FancyText" /> <include layout="@layout/reusable_part" /> </LinearLayout> 作为一个经验法则,android:layout_****属性应该在 layout XML 中定义,同时其它属性android:**** 应放在 styler XML中。此规则也有例外,不过大体工作 的很好。这个思想整体是保持layout属性(positioning, margin, sizing) 和content属性在布局文件中,同时将所有的外观细节属性(colors, padding, font)放 在style文件中。 例外有以下这些: android:id 明显应该在layout文件中 layout文件中android:orientation对于一个LinearLayout布局通常更有意义 android:text 由于是定义内容,应该放在layout文件中 有时候将android:layout_width 和 android:layout_height属性放到一个style中作为一个通用的风格中更有意义,但是默认情况下这些应该放到layout文件中。 使用styles 几乎每个项目都需要适当的使用style文件,因为对于一个视图来说有一个重复的外观是很常见的。 在应用中对于大多数文本内容,最起码你应该有一个通用的style文件,例如: <style name="ContentText"> <item name="android:textSize">@dimen/font_normal</item> <item name="android:textColor">@color/basic_black</item> </style> 应用到TextView 中: <TextView android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="@string/price" style="@style/ContentText" /> 你或许需要为按钮控件做同样的事情,不要停止在那里。将一组相关的和重复android:****的属性放到一个通用的style中。 将一个大的style文件分割成多个文件 你可以有多个styles.xml 文件。Android SDK支持其它文件,styles这个文件名称并没有作用,起作用的是在文件 里xml的<style>标签。因此你可以有多个style文件styles.xml,style_home.xml,style_item_details.xml,styles_forms.xml。 不用于资源文件路径需要为系统构建起的有意义,在res/values目录下的文件可以任意命名。 colors.xml是一个调色板 在你的colors.xml文件中应该只是映射颜色的名称一个RGBA值,而没有其它的。不要使用它为不同的按钮来定义RGBA值。 不要这样做 <resources> <color name="button_foreground">#FFFFFF</color> <color name="button_background">#2A91BD</color> <color name="comment_background_inactive">#5F5F5F</color> <color name="comment_background_active">#939393</color> <color name="comment_foreground">#FFFFFF</color> <color name="comment_foreground_important">#FF9D2F</color> ... <color name="comment_shadow">#323232</color> 使用这种格式,你会非常容易的开始重复定义RGBA值,这使如果需要改变基本色变的很复杂。同时,这些定义是跟一些环境关联起来的,如button或者comment, 应该放到一个按钮风格中,而不是在color.xml文件中。 相反,这样做: <resources> <!-- grayscale --> <color name="white" >#FFFFFF</color> <color name="gray_light">#DBDBDB</color> <color name="gray" >#939393</color> <color name="gray_dark" >#5F5F5F</color> <color name="black" >#323232</color> <!-- basic colors --> <color name="green">#27D34D</color> <color name="blue">#2A91BD</color> <color name="orange">#FF9D2F</color> <color name="red">#FF432F</color> </resources> 向应用设计者那里要这个调色板,名称不需要跟"green", "blue", 等等相同。 "brand_primary", "brand_secondary", "brand_negative" 这样的名字也是完全可以接受的。 像这样规范的颜色很容易修改或重构,会使应用一共使用了多少种不同的颜色变得非常清晰。 通常一个具有审美价值的UI来说,减少使用颜色的种类是非常重要的。 像对待colors.xml一样对待dimens.xml文件 与定义颜色调色板一样,你同时也应该定义一个空隙间隔和字体大小的“调色板”。 一个好的例子,如下所示: <resources> <!-- font sizes --> <dimen name="font_larger">22sp</dimen> <dimen name="font_large">18sp</dimen> <dimen name="font_normal">15sp</dimen> <dimen name="font_small">12sp</dimen> <!-- typical spacing between two views --> <dimen name="spacing_huge">40dp</dimen> <dimen name="spacing_large">24dp</dimen> <dimen name="spacing_normal">14dp</dimen> <dimen name="spacing_small">10dp</dimen> <dimen name="spacing_tiny">4dp</dimen> <!-- typical sizes of views --> <dimen name="button_height_tall">60dp</dimen> <dimen name="button_height_normal">40dp</dimen> <dimen name="button_height_short">32dp</dimen> </resources> 布局时在写 margins 和 paddings 时,你应该使用spacing_****尺寸格式来布局,而不是像对待String字符串一样直接写值。 这样写会非常有感觉,会使组织和改变风格或布局是非常容易。 避免深层次的视图结构 有时候为了摆放一个视图,你可能尝试添加另一个LinearLayout。你可能使用这种方法解决: <LinearLayout android:layout_width="match_parent" android:layout_height="match_parent" android:orientation="vertical" > <RelativeLayout ... > <LinearLayout ... > <LinearLayout ... > <LinearLayout ... > </LinearLayout> </LinearLayout> </LinearLayout> </RelativeLayout> </LinearLayout> 即使你没有非常明确的在一个layout布局文件中这样使用,如果你在Java文件中从一个view inflate(这个inflate翻译不过去,大家理解就行) 到其他views当中,也是可能会发生的。 可能会导致一系列的问题。你可能会遇到性能问题,因为处理起需要处理一个复杂的UI树结构。 还可能会导致以下更严重的问题StackOverflowError. 因此尽量保持你的视图tree:学习如何使用RelativeLayout, 如何 optimize 你的布局 和如何使用<merge> 标签. 小心关于WebViews的问题. 如果你必须显示一个web视图, 比如说对于一个新闻文章,避免做客户端处理HTML的工作, 最好让后端工程师协助,让他返回一个 "纯" HTML。 当绑定WebViews到引用它的Activity,而不是绑定到ApplicationContext时。WebViews 也能导致内存泄露。 当使用简单的文字或按钮时,避免使用WebView,这时使用TextView或Buttons更好。 测试框架 Android SDK的测试框架还处于初级阶段,特别是关于UI测试方面。Android Gradle 目前实现了一个叫connectedAndroidTest的测试, 它使用一个JUnit 为Android提供的扩展插件 extension of JUnit with helpers for Android.可以跑你生成的JUnit测试, 只当做单元测试时使用 Robolectric ,views 不用 它是一个最求提供"不连接设备的"为了加速开发的测试, 非常时候做 models 和 view models 的单元测试。 然而,使用Robolectric测试时不精确的,也不完全对UI测试。 当你对有关动画的UI元素、对话框等,测试时会有问题, 这主要是因为你是在 “在黑暗中工作”(在没有可控的界面情况下测试) **Robotium 使写UI测试非常简单。 ** 对于UI测试你不需 Robotium 跑与设备连接的测试。 但它可能会对你有益,是因为它有许多来帮助类的获得和分析视图,控制屏幕。 测试用例看起来像这样简单: solo.sendKey(Solo.MENU); solo.clickOnText("More"); // searches for the first occurence of "More" and clicks on it solo.clickOnText("Preferences"); solo.clickOnText("Edit File Extensions"); Assert.assertTrue(solo.searchText("rtf")); 模拟器 如果你全职开发Android App,那么买一个Genymotion emulatorlicense吧。 Genymotion 模拟器运行更快的秒帧的速度,比起典型的AVD模拟器。他有演示你APP的工具,高质量的模拟网络连接,GPS位置,等等。它同时还有理想的连接测试。 你若涉及适配使用很多不同的设备,买一个Genymotion 版权是比你买很多真设备便宜多的。 注意:Genymotion模拟器没有装载所有的Google服务,如Google Play Store和Maps。你也可能需 要测试Samsung指定的API,若这样的话你还是需要购买一个真实的Samsung设备。 混淆配置 ProGuard 是一个在Android项目中广泛使用的压缩和混淆打包的源码的工具。 你是否使用ProGuard取决你项目的配置,当你构建一个release版本的apk时,通常你应该配置gradle文件。 buildTypes { debug { minifyEnabled false } release { signingConfig signingConfigs.release minifyEnabled true proguardFiles 'proguard-rules.pro' } } 为了决定哪些代码应该被保留,哪些代码应该被混淆,你不得不指定一个或多个实体类在你的代码中。 这些实体应该是指定的类包含main方法,applets,midlets,activities,等等。 Android framework 使用一个默认的配置文件,可以在SDK_HOME/tools/proguard/proguard-android.txt 目录下找到。自定义的工程指定的 project-specific 混淆规则,如在my-project/app/proguard-rules.pro中定义, 会被添加到默认的配置中。 关于 ProGuard 一个普遍的问题,是看应用程序是否崩溃并报ClassNotFoundException 或者 NoSuchFieldException 或类似的异常, 即使编译是没有警告并运行成功。 这意味着以下两种可能: ProGuard 已经移除了类,枚举,方法,成员变量或注解,考虑是否是必要的。 ProGuard 混淆了类,枚举,成员变量的名称,但是这些名字又被拿原始名称使用了,比如通过Java的反射。 检查app/build/outputs/proguard/release/usage.txt文件看有问题的对象是否被移除了。 检查 app/build/outputs/proguard/release/mapping.txt 文件看有问题的对象是否被混淆了。 In order to prevent ProGuard from stripping away needed classes or class members, add a keep options to your proguard config: 以防 ProGuard 剥离 需要的类和类成员,添加一个 keep选项在你的 proguard 配置文件中: -keep class com.futurice.project.MyClass { *; } 防止 ProGuard 混淆 一些类和成员,添加 keepnames: -keepnames class com.futurice.project.MyClass { *; } 更多例子请参考Proguard。 在构建项目之初,发布一个版本 来检查ProGuard规则是否正确的保持了重要的部分。 同时无论何时你添加了新的类库,做一个发布版本,同时apk在设备上跑起来测试一下。 不要等到你的app要发布 "1.0"版本了才做版本发布,那时候你可能会碰到好多意想不到的异常,需要一些时间去修复他们。 Tips每次发布新版本都要写 mapping.txt。每发布一个版本,如果用户遇到一个bug,同时提交了一个混淆过的堆栈跟踪。 通过保留mapping.txt文件,来确定你可以调试的问题。 DexGuard 如果你需要核心工具来优化,和专门混淆的发布代码,考虑使用DexGuard, 一个商业软件,ProGuard 也是有他们团队开发的。 它会很容易将Dex文件分割,来解决65K个方法限制问题。 数据存储 SharedPreferences 如果你只是需要持久化存储简单的标记位,并且你的应用运行在单一进程,那么SharedPreferences可能就满足了你的需求。它是一个非常好的选择。 这里有两个使你可能不使用SharedPreferences的原因: Performance: Your data is complex or there is a lot of it 性能问题:你的很多数据结构负责的数据需要存储。 Multiple processes accessing the data: You have widgets or remote services that run in their own processes and require synchronized data 多线程访问数据:你有多个控件或者运行在各自线程上的远程的服务需要同步数据。 ContentProviders 如果SharedPreferences不足以满足你的需求,那么你可以使用平台标准的ContentProviders,它不仅快速,并且线程安全。 使用ContentProviders的唯一问题是建立他们需要大量的模板代码,并且少有高质量的教程。如果可以,我们可以通过使用第三方库Schematic,极大降低了冗余操作,去生成ContentProviders. 你可能仍然需要亲自写一些解析代码去从Sqlite读取数据对象,或者进行相反的操作。如果可以序列化数据对象,例如通过Gson,只持久化存储最终是字符串。通过这种方式虽然会降低性能,但是从另一个角度来讲,你不需要为每一个数据结构声明表结构。 使用ORM我们通常不推荐使用对象关系映射第三方库除非你有非常复杂的数据结构,并且你确定你真的需要它。他们通常比较复杂,并且需要时间去学习。如果你决定了在你的应用中使用ORM,你应该注意它是否是线程安全的,而对于目前大多数ORM解决方案都是非线程安全的。 使用StethoStetho 是一个Facebook 开源的Android调试工具,它是Chrome Developer Tools的扩展。通过它可以检测应用的网络情况。它也允许你可以检测应用的数据库,shared preferences。但是,你应该确保Stetho只有在Debug状态下得以开启,而不是在正式发布版本中。 使用LeakCanaryLeakCanary 是可以在应用运行中检测,定位内存泄露的Java库。使用它应是你开发应用过程中的一部分。更多详细的配置和使用情况请参照wiki。你只需要记得它在你的正式版本中你是不需要配置的。 致谢 感谢Antti Lammi, Joni Karppinen, Peter Tackage, Timo Tuominen, Vera Izrailit, Vihtori Mäntylä, Mark Voit, Andre Medeiros, Paul Houghton 这些人和Futurice 开发者分享他们的Android开发经验。 License Futurice Oy Creative Commons Attribution 4.0 International (CC BY 4.0) Translation Translated to Chinese by andyiac

优秀的个人博客,低调大师

车联网上云最佳实践(二)

云上对标架构及技术详解我们对传统IDC应用架构进行分析之后,我们发现之前的系统架构存在一些不合理的地方导致了很多的痛点,为了解决这些痛点我们最终考虑上云。开始思考怎样利用云上产品来解决目前遇到的痛点。例如  为了解决我们自建IDC底层基础设施可靠性差的问题,我们改用云计算服务,基础设施可靠性,异地容灾,数据备份,数据安全等问题再也不用担心;  为了解决存储性能瓶颈以及用户访问体验问题,我们改用云上对象存储OSS服务+CDN;  为了解决单台数据库性能扩展瓶颈,我们改用云上的DRDS分布式关系数据库;  为了解决大规模的车机上报而导致数据写入延迟问题我们改用云上IOT套件+HiTSDB;  为了解决日常以及节假日流量高峰的问题,我们改用云上弹性伸缩服务+按量付费,以最低的成本完美解决日常及节假日流量高峰

优秀的个人博客,低调大师

车联网上云最佳实践(四)

云上关键业务测试及性能调优1、 负载均衡选型及性能指标负载均衡推荐使用性能保障性实例,它于性能共享型实例相比较,共享型负载均衡的资源是共享的,所以不能保障实例的性能指标。因为车联网的行业特点就是高并发场景推荐使用性能保障性实例。性能保障型实例的三个关键指标如下:• 最大连接数-Max Connection最大连接数定义了一个负载均衡实例能够承载的最大连接数量。当实例上的连接超过规格定义的最大连接数时,新建连接请求将被丢弃。• 每秒新建连接数-Connection Per Second (CPS)每秒新建连接数定义了新建连接的速率。当新建连接的速率超过规格定义的每秒新建连接数时,新建连接请求将被丢弃。• 每秒查询数-Query Per Second (QPS)每秒请求数是七层监听特有的概念,指的是每秒可以完成

优秀的个人博客,低调大师

Spring Boot 最佳实践(一)快速入门

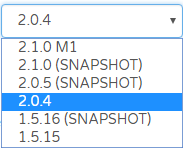
一、关于Spring Boot 在开始了解Spring Boot之前,我们需要先了解一下Spring,因为Spring Boot的诞生和Spring是息息相关的,Spring Boot是Spring发展到一定程度的一个产物,但并不是Spring的替代品,Spring Boot是为了让程序员更好的使用Spring。说到这里可能有些人会迷糊,那到底Spring和Spring Boot有着什么样的联系呢? 1.Spring发展史 在开始之前我们先了解一下Spring,Spring的前身是interface21,这个框架最初是为了解决EJB开发笨重臃肿的问题,为J2EE提供了另一种简单又实用的解决方案,并在2004年3月发布了Spring 1.0正式版之后,就引起了Java界广泛的关注和热评,从此Spring在Java界势如破竹迅速走红,一路成为Java界一颗璀璨夺目的明星,至今无可替代,也一度成为J2EE开发中真正意义上的标准了,而他的创始人Rod Johnson也在之后声名大噪,名利双收,现在是一名优秀的天使投资人,走上了人生的巅峰。 2.Spring Boot诞生 那既然Spring已经这么优秀了,为什么还有了之后Spring Boot? 因为随着Spring发展的越来越火,Spring也慢慢从一个小而精的框架变成了,一个覆盖面广大而全的框架,另一方面随着新技术的发展,比如nodejs、golang、Ruby的兴起,让Spring逐渐看着笨重起来,大量繁琐的XML配置和第三方整合配置,让Spring使用者痛苦不已,这个时候急需一个解决方案,来解决这些问题。 就在这个节骨眼上Spring Boot应运而生,2013年Spring Boot开始研发,2014年4月Spring Boot 1.0正式发布,Spring Boot诞生之初就受到业界的广泛关注,很多个人和企业陆续开始尝试,随着Spring Boot 2.0的发布,又一次把Spring Boot推向了公众的视野,也有越来越多了的中大型企业把Spring Boot使用到正式的生产环境了。值得一提的是Spring官方也把Spring Boot作为首要的推广项目,放到了官网的首位。 3.Spring Boot介绍 Spring Boot是由Pivotal团队提供的全新框架,其设计目的是用来简化Spring应用初始搭建以及开发过程。该框架使用了特定的方式来进行配置,从而使开发人员不再需要定义样板化的配置。Spring Boot其实就是一个整合很多可插拔的组件(框架),内嵌了使用工具(比如内嵌了Tomcat、Jetty等),方便开发人员快速搭建和开发的一个框架。 4.Spring Boot特点 搭建项目快,几秒钟就可以搭建完成; 让测试变的简单,内置了JUnit、Spring Boot Test等多种测试框架,方便测试; Spring Boot让配置变的简单,Spring Boot的核心理念:约定大约配置,约定了某种命名规范,可以不用配置,就可以完成功能开发,比如模型和表名一致就可以不用配置,直接进行CRUD(增删改查)的操作,只有表名和模型不一致的时候,配置名称即可; 内嵌容器,省去了配置Tomcat的繁琐; 方便监控,使用Spring Boot Actuator组件提供了应用的系统监控,可以查看应用配置的详细信息; 二、开发环境 Spring Boot 2.0.4 JDK 1.8 IDE:IntelliJ IDEA 2018.2 注意:Spring Boot 2.x 要求Java8及以上版本,不再支持Java6、Java7. 三、开发工具 IntelliJ IDEA Vs MyEclipse 开发工具的选择是每一个人入门人员要经历和选择的,如果你是老手可以忽略本节。 曾几何时Eclipse和MyEclipse统治了Java使用者,而如今,年复一年,毫不客气的说,十年前我用MyEclipse 6.0到现在的MyEclipse 2017 我没有感觉有任何的变化,还是一样的皮肤,一样的布局,一样卡的起飞使用感受,即使按照Google的指引,优化了一堆配置之后,你也会发现收效甚微。 这让我想起了曾经辉煌一时的诺基亚,到今天为止它依然不知道自己做错了什么,但时过境迁当一个事物跟不上时代变化的节奏,它就会被新来更适合的事物所代替。不得不说我曾经也是MyEclipse的忠实热爱者,并且对一个人来说一旦接受了某种事物,出于习惯的作用,通常改变也是很难的。 然而,到今天,我不得不承认IntelliJ IDEA从外观到运行速度上要比MyEclipse好太多,尤其是对Spring Boot的支持上,更好天作之合,所以IntelliJ IDEA是最好的选择。 四、Spring Boot版本号说明 Spring Boot的版本选择一般是这样的,如下图: 那版本号后面的英文代表什么含义呢? 具体含义,如下文所示: SNAPSHOT:快照版,表示开发版本,随时可能修改; M1(Mn):M是milestone的缩写,也就是里程碑版本; RC1(RCn):RC是release candidates的缩写,也就是发布预览版; Release:正式版,也可能没有任何后缀也表示正式版; 五、Spring Boot项目创建 Spring Boot项目创建,有两种方式: 方式一:访问网站构建项目,下载到本地导入开发工具 方式二:使用IDEA(IntelliJ IDEA的简称)工具使用Spring Initializr创建初始化(推荐使用) 说明:根据上面的“开发工具”章节得出,使用IDEA是最合适Spring Boot开发的语言,所以本节的所有内容都是使用IDEA完成的。 方式一:访问网站创建项目 访问网址:https://start.spring.io/ 配置项目信息,点击Generate Project按钮生成项目,如下图: 其中,Group表示组织标识符,对应了Java包目录的结构;Arifact表示项目标识符,对应项目名称,也就是根目录名称。 解压文件夹,点击IDEA File => New => Project from Existing Sources... => 选择你解压项目文件夹目录 => 点击Ok => 选择Import project from external model => 选中Maven => 一路点击Next直到项目导入成功。 方式二:使用IDEA Spring Initializr创建(推荐使用) 点击File => New => Project => 选择Spring Initializr,按引导操作即可,如下图: 最终的项目目录,如下图: 目录说明 如上图所示,整个项目的目录划分还是挺清晰的,其中有几个重要的文件需要单独说一下: pom.xml => Maven的构建文件,里面有关于组建的引用信息 src/main/java => 项目的源码类都在此目录下 com.hellospringboot.hellospringboot/HelloSpringBootApplication.java => 其中前半部分为包名,后半部分为项目的启动文件 src/main/resources => 项目的资源文件目录 src/main/resources/application.properties => 空的属性配置文件 六、项目运行 为了演示方便,我们在HelloSpringBootApplication.java直接添加一个访问方法index,返回一个Hello信息,右键Run运行项目。 注意: 标识类注解,我们在访问之前,处理添加方法之后,还需要给类HelloSpringBootApplication.java设置@RestController注解,@RestController是@Controller和@ResponseBody的集合,如果只是使用@RestController注解,则Controller中的方法无法返回jsp页面,或者html,配置的视图解析器 InternalResourceViewResolver不起作用,返回的内容就是Return 里的内容,为了便于演示,我们就直接给类标注@RestController注解; 标识访问方法注解,只要标识了方法注解,我们访问才能映射到相应的方法,如下图我们映射了访问地址“sayhi”,使用“sayhi2”是访问不到的 使用进阶 如果我们需要传递参数,返回JSON格式的数据,应该这样操作:重复上一步的操作,给类标识@RestController注解,即可返回JSON格式的信息,如果有参数直接在方法上添加参数的名称,方法的参数名称和url参数名称必须是一一对应的相同的,不然获取的参数值为null,如图所示: 总结:如图所示,参数的传递顺序是没有关系的,不影响取值。 七、热部署 根据上面的提示,我们已经完成了Spring Boot项目的创建和运行,但是有一个问题就是,每次修改代码之后都需要重新启动调试,代码才能生效,比较麻烦,那有没有一种简单的方式呢? 答案是有的,那就是接下来要说的热部署。 热部署的配置如下: 第一步: 设置IDEA开启项目自动编译 File => Settings => Build,Execut,Deployment => Compiler 勾中右侧Build Project automatically 如下图: 第二步: 开启项目运行时自动生成 ctrl + shift + a(windows系统),command+shift+alt+/(mac系统) 搜索命令:registry => 勾选compiler.automake.allow.when.app.running 如下图: 最终的效果如下图: 八、总结 Spring框架从小到大的发展,和新技术的兴起让Spring开发看起来变的臃肿,人们需要一种简单而高效的方法,于是Spring Boot应运而生; 本文介绍了Spring Boot版本号的含义,以及开发工具使用IDEA最合适; 本文介绍了Spring Boot项目创建的两种方式,比较推荐使用IDEA的Spring Initializr创建; 本文介绍了Spring Boot目录的含义,以及项目的启动和运行,并且介绍了多参数传递的使用,以及JSON格式的输出示例; 本文介绍了Spring Boot的热部署配置流程,方便了Spring Boot的开发和调试。 撩起来,扫描加入圈子 如果本文对你有所帮助,请打赏——1元就足够感动我:) 联系邮箱:intdb@qq.com 我的GitHub: https://github.com/vipstone 关注公众号: 作者: 王磊 出处: http://vipstone.cnblogs.com/ 本文版权归作者和博客园共有,欢迎转载,请标明出处。

优秀的个人博客,低调大师

车联网上云最佳实践(三)

三、云上对标架构及技术详解 我们对传统IDC应用架构进行分析之后,我们发现之前的系统架构存在一些不合理的地方导致了很多的痛点,为了解决这些痛点我们最终考虑上云。开始思考怎样利用云上产品来解决目前遇到的痛点。例如 为了解决我们自建IDC底层基础设施可靠性差的问题,我们改用云计算服务,基础设施可靠性,异地容灾,数据备份,数据安全等问题再也不用担心 为了解决存储性能瓶颈以及用户访问体验问题,我们改用云上对象存储OSS服务+CDN; 为了解决单台数据库性能扩展瓶颈,我们改用云上的DRDS分布式关系数据库; 为了解决大规模的车机上报而导致数据写入延迟问题我们改用云上IOT套件+HiTSDB; 为了解决日常以及节假日流量高峰的问题,我们改用云上弹性伸缩服务+按量付费,以最低的成本完美解决日常及节假日流量高峰; 为了解决大数据存储瓶颈以及降低大数

优秀的个人博客,低调大师

车联网上云最佳实践(一)

一、车联网行业特性讲解 最近两年车联网发展受到政府部门、科研院以及各大互联网巨头的广泛关注和积极推动。从应用来看,主要包括两种模式:一是前装模式(即车辆出厂前安装),是乘用车厂主导或者与有相关能力的公司合作,例如上汽和阿里巴巴的合作。另一种就是后装模式(通常是将车机设备安装在汽车的OBD接口上例如各类汽车盒子等等。原理是利用智能终端(即车机)采集汽车OBD接口CAN总线上的所有原始数据进行诊断,数据分析,记录行车信息,并将数据解析出其具体意义(汽车内部电控系统的各项传感器数值)后通过串口输出,供用户读取、解析、开发等使用。将读取到的汽车内部运行数据通过手机APP软件直观展现。 首先大致梳理下车联网行业的特性有哪些: 1、 月活非常高,在线时间长 车联网行业用户的月活是非常高的,这个很好理解,因为汽车现在人们出行的必备交通工具,基本上只要

优秀的个人博客,低调大师

FTP Server Over 阿里云 最佳实践

概述 作为非常古老的协议(1971年首次提出,1980年首次应用),FTP在目前依然占有一席之地,但是由于目前IT业发展的非常迅猛,它和现在的基础架构产生了一些水土不服,本文旨在通过日常常见的案例,来介绍如何在阿里云上搭建FTP Server和FTP Client。 本文结构 本文先从FTP的协议分析,重点阐述了其中控制通道的两种连接模式,进而说明在阿里云上搭建FTP服务器可能遇到的问题,如被动模式下服务器公网IP无法获取、主动模式下无法连接等情况。 FTP协议摘选 控制通道与数据通道 在FTP协议中,通常有两个通道:控制通道和数据通道,前者用来传输控制命令,如协议握手、获得当前目录等操作,而数据通道顾名思义,就是用来传输文件数据之用,另外ls命令的结果通常也会通过数据通道来传输。 被动模式与主动模式 而被动模式和主动模式是针对如何建立数据通道而

优秀的个人博客,低调大师

OSS高速通道跨国复制最佳实践

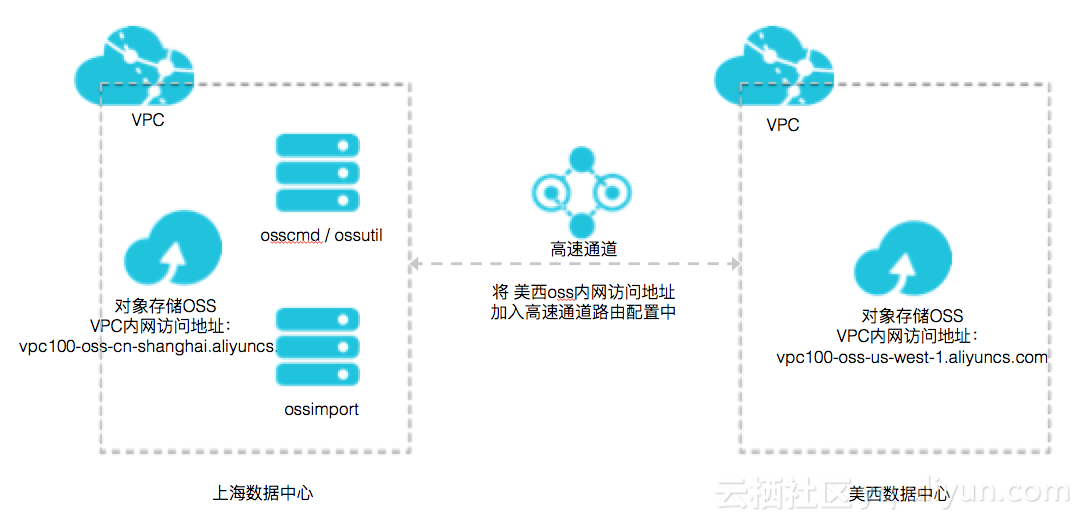
部署步骤: 1、在上海region部署VPC1,VPC下部署ECS作为代理机器 2、在ECS上部署 ossimport,或者osscmd/ossutil 3、开通上海至美西的高速通道,将美西的OSS VPC内网访问地址 加入到高速通道的路由配置中 4、配置ossimport ,详细步骤参照:https://help.aliyun.com/document_detail/32201.html?spm=5176.doc44075.6.1037.T83MB2 ,其中目标端oss endpoint 填写OSS VPC内网访问endpoint,参见 https://help.aliyun.com/document_detail/31837.html 架构图: 注意事项: 1、ossimport适合大量多个文件传输,如果仅为单个文件同步,单线程无法将高速通

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册