首页 文章 精选 留言 我的

精选列表

搜索[AIOps最佳实践],共10001篇文章
优秀的个人博客,低调大师

【OSS 最佳实践】OSS 操作权限控制

用户操作 OSS 时是需要根据账号的 AccessKeyId 和 AccessKeySecret (后续简称 AK 和 SK )进行权限验证的,这里的 AK 和 SK 包括有多种类型:主账号的 AK 和 SK 、子账号的 AK 和 SK 以及 STS 生成的临时 AK 、 SK 和 Token 。那么他们之间有什么区别呢?具体应该如何配置使用呢?本文将带大家一起认识相关概念。 1. 概念区别 主账号的 AK 和 SK 是主账号对应的权限标识,也就是说主账号的每对 AK和 SK 是拥有账号下的所有权限的,不仅仅可以操作 OSS,还包括 ECS 、 RDS 等其他产品都是可以操作的。因此该对 AK 和 SK 是必须要安全保管的,是不能随便泄露出去的;并且主账号的 AK 和 SK 尽量避免所有账号使用者均知道,建议仅极少数的账号管理者进行控

优秀的个人博客,低调大师

Android自定义BaseAdapter最佳实践

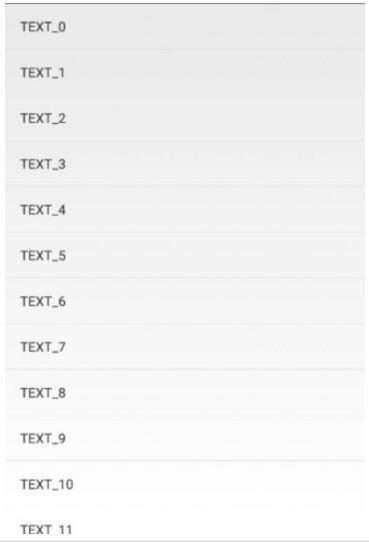
虽然现在很多新的项目都在使用RecyclerView,但是很多开发者在一些场景中还是倾向使用ListView或者GridView,然后就是需要写许多的Adapter。一次项目组在新启动一个新项目的时候,有个同事拿来了一个网上说的万能Adapter,在使用的时候发现即使在单个视图类型一旦逻辑判断比较复杂情况下非常不方便,更不用说在适配器Adapter中使用多视图类型了,这里仅是个人观点,也许没有掌握到精华,这是有关万能适配器Adapter的一片博文 Android 快速开发系列 打造万能的ListView GridView 适配器 。 当然了随着RecyclerView的使用,网上也有很多有关对RecyclerView多视图类型Adapter封装的博客,MultiType 3.0是一个大神写的比较全面的Adapter,这篇博客Android 复杂的多类型列表视图新写法:MultiType 3.0有详细的用法。万能适配器Adapter自己使用不是很方便,于是就参看RecyclerView中Adapter的实现方式进行对BaseAdapter进行了简单的封装,封装的目一是为了少写代码,另外一个就是让逻辑看上去更清晰一些。我们知道在RecyclerView的Adapter实现中它将视图创建与数据绑定进行了分离,同时将对View的查找创建也剥离开来了,本文就主要介绍如何将BaseAdapter的使用封装为跟RecyclerView的Adapter使用方式一致。由于很多时候在Adapter中我们都是使用的简单的视图类型,即单类型视图,因此本文将单视图类型的Adapter单独封装了一下,比使用多视图类型的Adapter使用了更严格的数据类型检查,同时在使用上也方便了许多。 RecyclerView中Adapter的使用 在使用RecyclerView的Adapter的时候我们首先需要继承RecyclerView的一个静态内部类Adapter,然后重写三个方法,实际上下面三个方法是必须要重写的,因为都是抽象方法。 getItemCount() onBindViewHolder(VH holder, int position) onCreateViewHolder(ViewGroup parent, int viewType) 一般情况下重写上面三个方法就可以,但是如果存在多视图类型,在第三个方法 onCreateViewHolder()方法中我们也可以看到有一个参数是viewType,该参数作用就是针对不同的viewType需要创建不同的ViewHolder,因此还需要重写一个方法getItemViewType(int position),针对多视图类型同BaseAdapter实现方式倒是很像,在BaseAdapter中这是需要除此之外还要重写一个方法getViewTypeCount(),但是在RecyclerView的Adapter中不需要该方法。 简单类型Adapter privateclassMyAdapterextendsRecyclerView.Adapter<MyViewHolder>{ @Override publicintgetItemCount(){ returnCOUNT; } @Override publicvoidonBindViewHolder(MyViewHolderholder,intposition){ holder.textView.setText("TEXT_"+position); } @Override publicMyViewHolderonCreateViewHolder(ViewGroupparent,intviewType){ Viewview=LayoutInflater.from(getApplicationContext()).inflate(R.layout.item_text,parent,false); MyViewHolderholder=newMyViewHolder(view); returnholder; } } privatestaticclassMyViewHolderextendsRecyclerView.ViewHolder{ privateTextViewtextView; publicMyViewHolder(ViewitemView){ super(itemView); textView=(TextView)itemView.findViewById(R.id.textView); } } 复杂类型Adapter privateclassMyAdapterextendsRecyclerView.Adapter<ViewHolder>{ @Override publicintgetItemCount(){ returnCOUNT; } @Override publicintgetItemViewType(intposition){ returnposition%2==0?TYPE_IMAGE:TYPE_TEXT; } @Override publicvoidonBindViewHolder(ViewHolderholder,intposition){ inttype=getItemViewType(position); switch(type){ caseTYPE_TEXT: ((MyTextHolder)holder).textView.setText("TEXT_"+position); break; caseTYPE_IMAGE: ((MyImageHolder)holder).imageView.setImageResource(R.drawable.image); break; } } @Override publicViewHolderonCreateViewHolder(ViewGroupparent,intviewType){ Viewview; ViewHolderholder=null; switch(viewType){ caseTYPE_TEXT: view=LayoutInflater.from(getApplicationContext()).inflate(R.layout.item_text,parent,false); holder=newMyTextHolder(view); break; caseTYPE_IMAGE: view=LayoutInflater.from(getApplicationContext()).inflate(R.layout.item_image,parent,false); holder=newMyImageHolder(view); break; } returnholder; } } privateclassMyTextHolderextendsRecyclerView.ViewHolder{ privateTextViewtextView; publicMyTextHolder(ViewitemView){ super(itemView); textView=(TextView)itemView.findViewById(R.id.textView); } } privateclassMyImageHolderextendsViewHolder{ privateImageViewimageView; publicMyImageHolder(ViewitemView){ super(itemView); imageView=(ImageView)itemView.findViewById(R.id.imageView); } } 自定义BaseAdapter 在自定义基类之前,先简单分析一下,我们需要自定义一个支持单种视图的Adapter,还要自定义一个支持多种视图类型的Adapter,两个类都要继承BaseAdapter,先将两个类都公用的部分抽取出来定义为MyAdapter。 publicabstractclassMyAdapter<T>extendsBaseAdapter{ protectedList<T>dataList=newArrayList<>(); protectedContextcontext; protectedLayoutInflaterinflater; publicMyAdapter(Contextcontext){ this.context=context; inflater=LayoutInflater.from(context); } publicvoidsetDataList(List<T>dataList){ this.dataList=dataList; notifyDataSetChanged(); } @Override publicintgetCount(){ if(null==dataList){ return0; } returndataList.size(); } @Override publicTgetItem(intposition){ returndataList.get(position); } @Override publiclonggetItemId(intposition){ returnposition; } } 在RecyclerView的Adapter实现中是没有getView()方法的,下面我们就分析一下getView()方法如何拆分,一般情况下我们在实现getView()方法都是如下流程。 publicViewgetView(intposition,ViewconvertView,ViewGroupparent){ ViewHolderholder=null; if(null==convertView){ //填充布局 convertView=inflater.inflate(R.layout.item_layout,parent,false); holder=newViewHolder(); //通过ID查询控件 holder.textView=(TextView)convertView.findViewById(R.id.textView); holder.imageView=(ImageView)convertView.findViewById(R.id.imageView); convertView.setTag(holder); }else{ holder=(ViewHolder)convertView.getTag(); } //赋值逻辑 returnconvertView; } //一个空的ViewHolder publicstaticclassViewHolder{ TextViewtextView; ImageViewimageView; } Java编程比较流行的一种编程方式不是说面向接口编程吗,在Android开发中也有一个开发方式叫做面向Holder的编程,上面代码是传统的实现ViewHolder的方式,说句实现话就没做什么事,就是作为一个载体承载着我们需要的控件。我们让ViewHolder多做一些事情,让它在convertView==null情况下需要做的多数逻辑都放到ViewHolder中去。 publicclassViewHolder{ privatefinalViewitemView; publicViewHolder(ViewitemView){ if(null==itemView){ thrownewIllegalArgumentException("itemViewmustnotbenull"); }else{ this.itemView=itemView; itemView.setTag(this); } } publicViewgetItemView(){ returnitemView; } } 在ViewHolder中的itemView就是getView()方法中的convertView,这里刚好是条目的根View,类似RecyclerView中ViewHolder构造方法中itemView。由于不同的视图需要创建不同的ViewHolder,因此我们可以将创建ViewHolder的方法设置为抽象的方法暴露出去,另外赋值的时候我们也需要根据具体的业务进行赋值,同样设置一个抽象方法。 publicabstractclassSimpleAdapter<T,VHextendsViewHolder>extendsMyAdapter<T>{ publicSimpleAdapter(Contextcontext){ super(context); } publicViewgetView(intposition,ViewconvertView,ViewGroupparent){ VHholder=null; if(null==convertView){ holder=onCreateViewHolder(parent); convertView=holder.getItemView(); }else{ holder=(VH)convertView.getTag(); } onBindViewHolder(holder,position); returnconvertView; } publicabstractvoidonBindViewHolder(VHholder,intposition); publicabstractVHonCreateViewHolder(ViewGroupparent); } 在设置多视图类型的Adapter的时候只需要在创建ViewHolder的时候多传入一个viewType的参数即可。 publicabstractclassMultiAdapter<T>extendsMyAdapter<T>{ publicMultiAdapter(Contextcontext){ super(context); } @Override publicViewgetView(intposition,ViewconvertView,ViewGroupparent){ ViewHolderholder=null; if(null==convertView){ holder=onCreateViewHolder(parent,getItemViewType(position)); convertView=holder.getItemView(); }else{ holder=(ViewHolder)convertView.getTag(); } onBindViewHolder(holder,position); returnconvertView; } publicabstractvoidonBindViewHolder(ViewHolderholder,intposition); publicabstractViewHolderonCreateViewHolder(ViewGroupparent,intviewType); } 自定义BaseAdapter的使用 单视图类型SimpleAdapter使用 publicclassTextAdapterextendsSimpleAdapter<String,TextAdapter.TextHolder>{ publicTextAdapter(Contextcontext){ super(context); } @Override publicvoidonBindViewHolder(TextHolderholder,intposition){ holder.textView.setText(getItem(position)); } @Override publicTextHolderonCreateViewHolder(ViewGroupparent){ ViewconvertView=inflater.inflate(R.layout.item_text,parent,false); returnnewTextHolder(convertView); } staticclassTextHolderextendsViewHolder{ publicTextViewtextView; publicTextHolder(ViewitemView){ super(itemView); textView=(TextView)itemView.findViewById(R.id.textView); } } } 这里我们使用了两个泛型,一个是ViewHolder中支持的数据类型String,另外一个就是我们需要创建的ViewHolder,这样在onCreateViewHolder方法的返回值就会自动返回我们自定义的ViewHolder,有关泛型更多的知识可以参看Java泛型使用解析,单视图类型Adapter的使用比RecyclerView的Adapter还要方便许多。 多视图类型的使用 publicclassRichAdapterextendsMultiAdapter<String>{ privatestaticfinalintTEXT=0; privatestaticfinalintPIC=1; publicRichAdapter(Contextcontext){ super(context); } @Override publicintgetViewTypeCount(){ return2; } @Override publicintgetItemViewType(intposition){ if(position%3==0){ returnPIC; }else{ returnTEXT; } } @Override publicvoidonBindViewHolder(ViewHolderholder,intposition){ switch(getItemViewType(position)){ caseTEXT: TextHoldertextHolder=(TextHolder)holder; textHolder.textView.setText(getItem(position)); break; casePIC: ImageHolderimageHolder=(ImageHolder)holder; imageHolder.imageView.setImageResource(R.drawable.image); break; } } @Override publicViewHolderonCreateViewHolder(ViewGroupparent,intviewType){ ViewitemView=null; ViewHolderholder=null; switch(viewType){ caseTEXT: itemView=inflater.inflate(R.layout.item_text,parent,false); holder=newTextHolder(itemView); break; casePIC: itemView=inflater.inflate(R.layout.item_image,parent,false); holder=newImageHolder(itemView); break; } returnholder; } privatestaticclassTextHolderextendsViewHolder{ TextViewtextView; publicTextHolder(ViewitemView){ super(itemView); textView=(TextView)itemView.findViewById(R.id.textView); } } privatestaticclassImageHolderextendsViewHolder{ ImageViewimageView; publicImageHolder(ViewitemView){ super(itemView); imageView=(ImageView)itemView.findViewById(R.id.imageView); } } } 这里的使用情况跟RecyclerView的使用几乎是一模一样,唯一不一样的地方就是多写了一个getViewTypeCount()方法,在ListView或者GridView使用BaseAdapter实现多种类型视图的时候该方法必须要重写。 本文作者:佚名 来源:51CTO

优秀的个人博客,低调大师

HBase最佳实践-读性能优化策略

任何系统都会有各种各样的问题,有些是系统本身设计问题,有些却是使用姿势问题。HBase也一样,在真实生产线上大家或多或少都会遇到很多问题,有些是HBase还需要完善的,有些是我们确实对它了解太少。总结起来,大家遇到的主要问题无非是Full GC异常导致宕机问题、RIT问题、写吞吐量太低以及读延迟较大。 Full GC问题之前在一些文章里面已经讲过它的来龙去脉,主要的解决方案目前主要有两方面需要注意,一方面需要查看GC日志确认是哪种Full GC,根据Full GC类型对JVM参数进行调优,另一方面需要确认是否开启了BucketCache的offheap模式,建议使用LRUBlockCache的童鞋尽快转移到BucketCache来。当然我们还是很期待官方2.0.0版本发布的更多offheap模块。 RIT问题,我相信更多是因为我们对其不了解,具体原理可以戳这里,解决方案目前有两个,优先是使用官方提供的HBCK进行修复(HBCK本人一直想拿出来分享,但是目前案例还不多,等后面有更多案例的话再拿出来说),使用之后还是解决不了的话就需要手动修复文件或者元数据表。 而对于写吞吐量太低以及读延迟太大的优化问题,笔者也和很多朋友进行过探讨,这篇文章就以读延迟优化为核心内容展开,具体分析HBase进行读延迟优化的那些套路,以及这些套路之后的具体原理。希望大家在看完之后能够结合这些套路剖析自己的系统。 一般情况下,读请求延迟较大通常存在三种场景,分别为: 1. 仅有某业务延迟较大,集群其他业务都正常 2. 整个集群所有业务都反映延迟较大 3. 某个业务起来之后集群其他部分业务延迟较大 这三种场景是表象,通常某业务反应延迟异常,首先需要明确具体是哪种场景,然后针对性解决问题。下图是对读优化思路的一点总结,主要分为四个方面:客户端优化、服务器端优化、列族设计优化以及HDFS相关优化,下面每一个小点都会按照场景分类,文章最后进行归纳总结。下面分别进行详细讲解: HBase客户端优化 和大多数系统一样,客户端作为业务读写的入口,姿势使用不正确通常会导致本业务读延迟较高实际上存在一些使用姿势的推荐用法,这里一般需要关注四个问题: 1. scan缓存是否设置合理? 优化原理:在解释这个问题之前,首先需要解释什么是scan缓存,通常来讲一次scan会返回大量数据,因此客户端发起一次scan请求,实际并不会一次就将所有数据加载到本地,而是分成多次RPC请求进行加载,这样设计一方面是因为大量数据请求可能会导致网络带宽严重消耗进而影响其他业务,另一方面也有可能因为数据量太大导致本地客户端发生OOM。在这样的设计体系下用户会首先加载一部分数据到本地,然后遍历处理,再加载下一部分数据到本地处理,如此往复,直至所有数据都加载完成。数据加载到本地就存放在scan缓存中,默认100条数据大小。 通常情况下,默认的scan缓存设置就可以正常工作的。但是在一些大scan(一次scan可能需要查询几万甚至几十万行数据)来说,每次请求100条数据意味着一次scan需要几百甚至几千次RPC请求,这种交互的代价无疑是很大的。因此可以考虑将scan缓存设置增大,比如设为500或者1000就可能更加合适。笔者之前做过一次试验,在一次scan扫描10w+条数据量的条件下,将scan缓存从100增加到1000,可以有效降低scan请求的总体延迟,延迟基本降低了25%左右。 优化建议:大scan场景下将scan缓存从100增大到500或者1000,用以减少RPC次数 2. get请求是否可以使用批量请求? 优化原理:HBase分别提供了单条get以及批量get的API接口,使用批量get接口可以减少客户端到RegionServer之间的RPC连接数,提高读取性能。另外需要注意的是,批量get请求要么成功返回所有请求数据,要么抛出异常。 优化建议:使用批量get进行读取请求 3. 请求是否可以显示指定列族或者列? 优化原理:HBase是典型的列族数据库,意味着同一列族的数据存储在一起,不同列族的数据分开存储在不同的目录下。如果一个表有多个列族,只是根据Rowkey而不指定列族进行检索的话不同列族的数据需要独立进行检索,性能必然会比指定列族的查询差很多,很多情况下甚至会有2倍~3倍的性能损失。 优化建议:可以指定列族或者列进行精确查找的尽量指定查找 4. 离线批量读取请求是否设置禁止缓存? 优化原理:通常离线批量读取数据会进行一次性全表扫描,一方面数据量很大,另一方面请求只会执行一次。这种场景下如果使用scan默认设置,就会将数据从HDFS加载出来之后放到缓存。可想而知,大量数据进入缓存必将其他实时业务热点数据挤出,其他业务不得不从HDFS加载,进而会造成明显的读延迟毛刺 优化建议:离线批量读取请求设置禁用缓存,scan.setBlockCache(false) HBase服务器端优化 一般服务端端问题一旦导致业务读请求延迟较大的话,通常是集群级别的,即整个集群的业务都会反映读延迟较大。可以从4个方面入手: 5. 读请求是否均衡? 优化原理:极端情况下假如所有的读请求都落在一台RegionServer的某几个Region上,这一方面不能发挥整个集群的并发处理能力,另一方面势必造成此台RegionServer资源严重消耗(比如IO耗尽、handler耗尽等),落在该台RegionServer上的其他业务会因此受到很大的波及。可见,读请求不均衡不仅会造成本身业务性能很差,还会严重影响其他业务。当然,写请求不均衡也会造成类似的问题,可见负载不均衡是HBase的大忌。 观察确认:观察所有RegionServer的读请求QPS曲线,确认是否存在读请求不均衡现象 优化建议:RowKey必须进行散列化处理(比如MD5散列),同时建表必须进行预分区处理 6. BlockCache是否设置合理? 优化原理:BlockCache作为读缓存,对于读性能来说至关重要。默认情况下BlockCache和Memstore的配置相对比较均衡(各占40%),可以根据集群业务进行修正,比如读多写少业务可以将BlockCache占比调大。另一方面,BlockCache的策略选择也很重要,不同策略对读性能来说影响并不是很大,但是对GC的影响却相当显著,尤其BucketCache的offheap模式下GC表现很优越。另外,HBase 2.0对offheap的改造(HBASE-11425)将会使HBase的读性能得到2~4倍的提升,同时GC表现会更好! 观察确认:观察所有RegionServer的缓存未命中率、配置文件相关配置项一级GC日志,确认BlockCache是否可以优化 优化建议:JVM内存配置量 < 20G,BlockCache策略选择LRUBlockCache;否则选择BucketCache策略的offheap模式;期待HBase 2.0的到来! 7. HFile文件是否太多? 优化原理:HBase读取数据通常首先会到Memstore和BlockCache中检索(读取最近写入数据&热点数据),如果查找不到就会到文件中检索。HBase的类LSM结构会导致每个store包含多数HFile文件,文件越多,检索所需的IO次数必然越多,读取延迟也就越高。文件数量通常取决于Compaction的执行策略,一般和两个配置参数有关:hbase.hstore.compactionThreshold和hbase.hstore.compaction.max.size,前者表示一个store中的文件数超过多少就应该进行合并,后者表示参数合并的文件大小最大是多少,超过此大小的文件不能参与合并。这两个参数不能设置太’松’(前者不能设置太大,后者不能设置太小),导致Compaction合并文件的实际效果不明显,进而很多文件得不到合并。这样就会导致HFile文件数变多。 观察确认:观察RegionServer级别以及Region级别的storefile数,确认HFile文件是否过多 优化建议:hbase.hstore.compactionThreshold设置不能太大,默认是3个;设置需要根据Region大小确定,通常可以简单的认为hbase.hstore.compaction.max.size = RegionSize / hbase.hstore.compactionThreshold 8. Compaction是否消耗系统资源过多? 优化原理:Compaction是将小文件合并为大文件,提高后续业务随机读性能,但是也会带来IO放大以及带宽消耗问题(数据远程读取以及三副本写入都会消耗系统带宽)。正常配置情况下Minor Compaction并不会带来很大的系统资源消耗,除非因为配置不合理导致Minor Compaction太过频繁,或者Region设置太大情况下发生Major Compaction。 观察确认:观察系统IO资源以及带宽资源使用情况,再观察Compaction队列长度,确认是否由于Compaction导致系统资源消耗过多 优化建议: (1)Minor Compaction设置:hbase.hstore.compactionThreshold设置不能太小,又不能设置太大,因此建议设置为5~6;hbase.hstore.compaction.max.size = RegionSize / hbase.hstore.compactionThreshold (2)Major Compaction设置:大Region读延迟敏感业务( 100G以上)通常不建议开启自动Major Compaction,手动低峰期触发。小Region或者延迟不敏感业务可以开启Major Compaction,但建议限制流量; (3)期待更多的优秀Compaction策略,类似于stripe-compaction尽早提供稳定服务 HBase列族设计优化 HBase列族设计对读性能影响也至关重要,其特点是只影响单个业务,并不会对整个集群产生太大影响。列族设计主要从两个方面检查: 9. Bloomfilter是否设置?是否设置合理? 优化原理:Bloomfilter主要用来过滤不存在待检索RowKey或者Row-Col的HFile文件,避免无用的IO操作。它会告诉你在这个HFile文件中是否可能存在待检索的KV,如果不存在,就可以不用消耗IO打开文件进行seek。很显然,通过设置Bloomfilter可以提升随机读写的性能。 Bloomfilter取值有两个,row以及rowcol,需要根据业务来确定具体使用哪种。如果业务大多数随机查询仅仅使用row作为查询条件,Bloomfilter一定要设置为row,否则如果大多数随机查询使用row+cf作为查询条件,Bloomfilter需要设置为rowcol。如果不确定业务查询类型,设置为row。 优化建议:任何业务都应该设置Bloomfilter,通常设置为row就可以,除非确认业务随机查询类型为row+cf,可以设置为rowcol HDFS相关优化 HDFS作为HBase最终数据存储系统,通常会使用三副本策略存储HBase数据文件以及日志文件。从HDFS的角度望上层看,HBase即是它的客户端,HBase通过调用它的客户端进行数据读写操作,因此HDFS的相关优化也会影响HBase的读写性能。这里主要关注如下三个方面: 10. Short-Circuit Local Read功能是否开启? 优化原理:当前HDFS读取数据都需要经过DataNode,客户端会向DataNode发送读取数据的请求,DataNode接受到请求之后从硬盘中将文件读出来,再通过TPC发送给客户端。Short Circuit策略允许客户端绕过DataNode直接读取本地数据。(具体原理参考此处) 优化建议:开启Short Circuit Local Read功能,具体配置戳这里 11. Hedged Read功能是否开启? 优化原理:HBase数据在HDFS中一般都会存储三份,而且优先会通过Short-Circuit Local Read功能尝试本地读。但是在某些特殊情况下,有可能会出现因为磁盘问题或者网络问题引起的短时间本地读取失败,为了应对这类问题,社区开发者提出了补偿重试机制 – Hedged Read。该机制基本工作原理为:客户端发起一个本地读,一旦一段时间之后还没有返回,客户端将会向其他DataNode发送相同数据的请求。哪一个请求先返回,另一个就会被丢弃。 优化建议:开启Hedged Read功能,具体配置参考这里 12. 数据本地率是否太低? 数据本地率:HDFS数据通常存储三份,假如当前RegionA处于Node1上,数据a写入的时候三副本为(Node1,Node2,Node3),数据b写入三副本是(Node1,Node4,Node5),数据c写入三副本(Node1,Node3,Node5),可以看出来所有数据写入本地Node1肯定会写一份,数据都在本地可以读到,因此数据本地率是100%。现在假设RegionA被迁移到了Node2上,只有数据a在该节点上,其他数据(b和c)读取只能远程跨节点读,本地率就为33%(假设a,b和c的数据大小相同)。 优化原理:数据本地率太低很显然会产生大量的跨网络IO请求,必然会导致读请求延迟较高,因此提高数据本地率可以有效优化随机读性能。数据本地率低的原因一般是因为Region迁移(自动balance开启、RegionServer宕机迁移、手动迁移等),因此一方面可以通过避免Region无故迁移来保持数据本地率,另一方面如果数据本地率很低,也可以通过执行major_compact提升数据本地率到100%。 优化建议:避免Region无故迁移,比如关闭自动balance、RS宕机及时拉起并迁回飘走的Region等;在业务低峰期执行major_compact提升数据本地率 HBase读性能优化归纳 在本文开始的时候提到读延迟较大无非三种常见的表象,单个业务慢、集群随机读慢以及某个业务随机读之后其他业务受到影响导致随机读延迟很大。了解完常见的可能导致读延迟较大的一些问题之后,我们将这些问题进行如下归类,读者可以在看到现象之后在对应的问题列表中进行具体定位: HBase读性能优化总结 性能优化是任何一个系统都会遇到的话题,每个系统也都有自己的优化方式。 HBase作为分布式KV数据库,优化点又格外不同,更多得融入了分布式特性以及存储系统优化特性。文中总结了读优化的基本突破点,有什么不对的地方还望指正,有补充的也可以一起探讨交流! 本文转载自:http://hbasefly.com 原文链接

优秀的个人博客,低调大师

HBase最佳实践-写性能优化策略

上一篇文章主要介绍了HBase读性能优化的基本套路,本篇文章来说道说道如何诊断HBase写数据的异常问题以及优化写性能。和读相比,HBase写数据流程倒是显得很简单:数据先顺序写入HLog,再写入对应的缓存Memstore,当Memstore中数据大小达到一定阈值(128M)之后,系统会异步将Memstore中数据flush到HDFS形成小文件。 HBase数据写入通常会遇到两类问题,一类是写性能较差,另一类是数据根本写不进去。这两类问题的切入点也不尽相同,如下图所示: 写性能优化切入点 1. 是否需要写WAL?WAL是否需要同步写入? 优化原理:数据写入流程可以理解为一次顺序写WAL+一次写缓存,通常情况下写缓存延迟很低,因此提升写性能就只能从WAL入手。WAL机制一方面是为了确保数据即使写入缓存丢失也可以恢复,另一方面是为了集群之间异步复制。默认WAL机制开启且使用同步机制写入WAL。首先考虑业务是否需要写WAL,通常情况下大多数业务都会开启WAL机制(默认),但是对于部分业务可能并不特别关心异常情况下部分数据的丢失,而更关心数据写入吞吐量,比如某些推荐业务,这类业务即使丢失一部分用户行为数据可能对推荐结果并不构成很大影响,但是对于写入吞吐量要求很高,不能造成数据队列阻塞。这种场景下可以考虑关闭WAL写入,写入吞吐量可以提升2x~3x。退而求其次,有些业务不能接受不写WAL,但可以接受WAL异步写入,也是可以考虑优化的,通常也会带来1x~2x的性能提升。 优化推荐:根据业务关注点在WAL机制与写入吞吐量之间做出选择 其他注意点:对于使用Increment操作的业务,WAL可以设置关闭,也可以设置异步写入,方法同Put类似。相信大多数Increment操作业务对WAL可能都不是那么敏感~ 2. Put是否可以同步批量提交? 优化原理:HBase分别提供了单条put以及批量put的API接口,使用批量put接口可以减少客户端到RegionServer之间的RPC连接数,提高写入性能。另外需要注意的是,批量put请求要么全部成功返回,要么抛出异常。 优化建议:使用批量put进行写入请求 3. Put是否可以异步批量提交? 优化原理:业务如果可以接受异常情况下少量数据丢失的话,还可以使用异步批量提交的方式提交请求。提交分为两阶段执行:用户提交写请求之后,数据会写入客户端缓存,并返回用户写入成功;当客户端缓存达到阈值(默认2M)之后批量提交给RegionServer。需要注意的是,在某些情况下客户端异常的情况下缓存数据有可能丢失。 优化建议:在业务可以接受的情况下开启异步批量提交 使用方式:setAutoFlush(false) 4. Region是否太少? 优化原理:当前集群中表的Region个数如果小于RegionServer个数,即Num(Region of Table) < Num(RegionServer),可以考虑切分Region并尽可能分布到不同RegionServer来提高系统请求并发度,如果Num(Region of Table) > Num(RegionServer),再增加Region个数效果并不明显。 优化建议:在Num(Region of Table) < Num(RegionServer)的场景下切分部分请求负载高的Region并迁移到其他RegionServer; 5.写入请求是否不均衡? 优化原理:另一个需要考虑的问题是写入请求是否均衡,如果不均衡,一方面会导致系统并发度较低,另一方面也有可能造成部分节点负载很高,进而影响其他业务。分布式系统中特别害怕一个节点负载很高的情况,一个节点负载很高可能会拖慢整个集群,这是因为很多业务会使用Mutli批量提交读写请求,一旦其中一部分请求落到该节点无法得到及时响应,就会导致整个批量请求超时。因此不怕节点宕掉,就怕节点奄奄一息! 优化建议:检查RowKey设计以及预分区策略,保证写入请求均衡。 6. 写入KeyValue数据是否太大? KeyValue大小对写入性能的影响巨大,一旦遇到写入性能比较差的情况,需要考虑是否由于写入KeyValue数据太大导致。KeyValue大小对写入性能影响曲线图如下: 图中横坐标是写入的一行数据(每行数据10列)大小,左纵坐标是写入吞吐量,右坐标是写入平均延迟(ms)。可以看出随着单行数据大小不断变大,写入吞吐量急剧下降,写入延迟在100K之后急剧增大。 说到这里,有必要和大家分享两起在生产线环境因为业务KeyValue较大导致的严重问题,一起是因为大字段业务写入导致其他业务吞吐量急剧下降,另一起是因为大字段业务scan导致RegionServer宕机。 案件一:大字段写入导致其他业务吞吐量急剧下降 部分业务反馈集群写入忽然变慢、数据开始堆积的情况,查看集群表级别的数据读写QPS监控,发现问题的第一个关键点:业务A开始写入之后整个集群其他部分业务写入QPS都几乎断崖式下跌,初步怀疑黑手就是业务A。 下图是当时业务A的写入QPS(事后发现脑残忘了截取其他表QPS断崖式下跌的惨象),但是第一感觉是QPS并不高啊,凭什么去影响别人! 于是就继续查看其他监控信息,首先确认系统资源(主要是IO)并没有到达瓶颈,其次确认了写入的均衡性,直至看到下图,才追踪到影响其他业务写入的第二个关键点:RegionServer的handler(配置150)被残暴耗尽: 对比上面两张图,是不是发现出奇的一致,那就可以基本确认是由于该业务写入导致这台RegionServer的handler被耗尽,进而其他业务拿不到handler,自然写不进去。那问题来了,为什么会这样?正常情况下handler在处理完客户端请求之后会立马释放,唯一的解释是这些请求的延迟实在太大。 试想,我们去汉堡店排队买汉堡,有150个窗口服务,正常情况下大家买一个很快,这样150个窗口可能只需要50个服务。假设忽然来了一批大汉,要定制超大汉堡,好了,所有的窗口都工作起来,而且因为大汉堡不好制作导致服务很慢,这样必然会导致其他排队的用户长时间等待,直至超时。 可回头一想这可是写请求啊,怎么会有这么大的请求延迟!和业务方沟通之后确认该表主要存储语料库文档信息,都是平均100K左右的数据,是不是已经猜到了结果,没错,就是因为这个业务KeyValue太大导致。KeyValue太大会导致HLog文件写入频繁切换、flush以及compaction频繁触发,写入性能急剧下降。 目前针对这种较大KeyValue写入性能较差的问题还没有直接的解决方案,好在社区已经意识到这个问题,在接下来即将发布的下一个大版本HBase 2.0.0版本会针对该问题进行深入优化,详见HBase MOB,优化后用户使用HBase存储文档、图片等二进制数据都会有极佳的性能体验。 案件二:大字段scan导致RegionServer宕机 案件现场:有段时间有个0.98集群的RegionServer经常频繁宕机,查看日志是由于”java.lang.OutOfMemoryError: Requested array size exceeds VM limit”,如下图所示: 原因分析:通过查看源码以及相关文档,确认该异常发生在scan结果数据回传给客户端时由于数据量太大导致申请的array大小超过JVM规定的最大值( Interge.Max_Value-2)。造成该异常的两种最常见原因分别是: 表列太宽(几十万列或者上百万列),并且scan返回没有对列数量做任何限制,导致一行数据就可能因为包含大量列而数据超过array大小阈值 KeyValue太大,并且scan返回没有对返回结果大小做任何限制,导致返回数据结果大小超过array大小阈值 有的童鞋就要提问啦,说如果已经对返回结果大小做了限制,在表列太宽的情况下是不是就可以不对列数量做限制呢。这里需要澄清一下,如果不对列数据做限制,数据总是一行一行返回的,即使一行数据大小大于设置的返回结果限制大小,也会返回完整的一行数据。在这种情况下,如果这一行数据已经超过array大小阈值,也会触发OOM异常。 解决方案:目前针对该异常有两种解决方案,其一是升级集群到1.0,问题都解决了。其二是要求客户端访问的时候对返回结果大小做限制(scan.setMaxResultSize(2*1024*1024))、并且对列数量做限制(scan.setBatch(100)),当然,0.98.13版本以后也可以对返回结果大小在服务器端进行限制,设置参数hbase.server.scanner.max.result.size即可 写异常问题检查点 上述几点主要针对写性能优化进行了介绍,除此之外,在一些情况下还会出现写异常,一旦发生需要考虑下面两种情况(GC引起的不做介绍): Memstore设置是否会触发Region级别或者RegionServer级别flush操作? 问题解析:以RegionServer级别flush进行解析,HBase设定一旦整个RegionServer上所有Memstore占用内存大小总和大于配置文件中upperlimit时,系统就会执行RegionServer级别flush,flush算法会首先按照Region大小进行排序,再按照该顺序依次进行flush,直至总Memstore大小低至lowerlimit。这种flush通常会block较长时间,在日志中会发现“Memstore is above high water mark and block 7452 ms”,表示这次flush将会阻塞7s左右。 问题检查点: Region规模与Memstore总大小设置是否合理?如果RegionServer上Region较多,而Memstore总大小设置的很小(JVM设置较小或者upper.limit设置较小),就会触发RegionServer级别flush。集群规划相关内容可以参考文章《》 列族是否设置过多,通常情况下表列族建议设置在1~3个之间,最好一个。如果设置过多,会导致一个Region中包含很多Memstore,导致更容易触到高水位upperlimit Store中HFile数量是否大于配置参数blockingStoreFile? 问题解析:对于数据写入很快的集群,还需要特别关注一个参数:hbase.hstore.blockingStoreFiles,此参数表示如果当前hstore中文件数大于该值,系统将会强制执行compaction操作进行文件合并,合并的过程会阻塞整个hstore的写入。通常情况下该场景发生在数据写入很快的情况下,在日志中可以发现”Waited 3722ms on a compaction to clean up ‘too many store files“ 问题检查点: 参数设置是否合理?hbase.hstore.compactionThreshold表示启动compaction的最低阈值,该值不能太大,否则会积累太多文件,一般建议设置为5~8左右。hbase.hstore.blockingStoreFiles默认设置为7,可以适当调大一些。 写性能还能再提高么? 上文已经从写性能优化以及写异常诊断两个方面对HBase中数据写入可能的问题进行了详细的解释,相信在0.98版本的基础上对写入来说已经是最好的解决方案了。但是有些业务可能依然觉得不够快,毕竟”更快”是所有存储系统活着的动力,那还有提高空间吗?当然,接下来简单介绍HBase之后版本对写性能优化的两点核心改进: Utilize Flash storage for WAL(HBASE-12848) 这个特性意味着可以将WAL单独置于SSD上,这样即使在默认情况下(WALSync),写性能也会有很大的提升。需要注意的是,该特性建立在HDFS 2.6.0+的基础上,HDFS以前版本不支持该特性。具体可以参考官方jira:https://issues.apache.org/jira/browse/HBASE-12848 Multiple WALs(HBASE-14457) 该特性也是对WAL进行改造,当前WAL设计为一个RegionServer上所有Region共享一个WAL,可以想象在写入吞吐量较高的时候必然存在资源竞争,降低整体性能。针对这个问题,社区小伙伴(阿里巴巴大神)提出Multiple WALs机制,管理员可以为每个Namespace下的所有表设置一个共享WAL,通过这种方式,写性能大约可以提升20%~40%左右。具体可以参考官方jira:https://issues.apache.org/jira/browse/HBASE-14457 好了,这篇文章和大家一起分享了个人对HBase写入性能优化以及写入异常问题的一些理解,如有纰漏,还望指正!另外,如果大家有任何关于此话题的案例也很欢迎一起讨论~ 本文转载自:http://hbasefly.com 原文链接

优秀的个人博客,低调大师

HBase最佳实践-CMS GC调优

HBase发展到当下,对其进行的各种优化从未停止,而GC优化更是其中的重中之重。从0.94版本提出MemStoreLAB策略、Memstore Chuck Pool策略对写缓存Memstore进行优化开始,到0.96版本提出BucketCache以及堆外内存方案对读缓存BlockCache进行优化,再到后续2.0版本宣称会引入更多堆外内存,可见HBase会将堆外内存的使用作为优化GC的一个战略方向。然而无论引入多少堆外内存,都无法避免读写全路径使用JVM内存,就拿BucketCache中offheap模式来讲,即使HBase数据块是缓存在堆外内存的,但是在读取的时候还是会首先将堆外内存中的block加载到JVM内存中,再返回给用户。可见,无论使用多少堆外内存,对JVM内存的使用终究是绕不过去,既然绕不过去,就还是需要落脚于GC本身,对GC本身进行优化。本文就将会介绍HBase应用场景下CMS GC策略的调优技巧,后续还会针对另一业界开始使用的GC策略-G1GC策略在HBase应用场景下进行调优介绍。 CMS GC工作原理 如果看官已经对CMS GC工作原理比较熟悉,完全可以跳过本节内容,直接进入下节。如果看官还对CMS GC不是很了解,可以参考笔者之前的另一篇文章《HBase GC的前生今生-身世篇》,文中对JVM的内存结构以及CMS GC进行了相当详细的介绍。为了下文介绍方便,在此还是对其中的一些重要知识点进行提炼: 1. 整个JVM内存由Young区、Tenured区和Perm区三部分组成,其中Young区又分为一个Eden区和两个Survivor区 2. 整个对象生命周期简要说明(一定要烂熟于心,下文会一直用到): (1)Young区:一个对象初始化之后,首先会进入Eden区,当Eden区满之后会触发一次Minor GC,Minor GC会检查Eden区所有对象是否依旧存活(是否有其他对象引用),如果存活,会将其从Eden区拷贝到Survivor区,并将这些存活对象的age加一,而死亡的对象会被作为垃圾回收。此时Eden区又空闲出来,等新对象填充,填充满之后再会触发Minor GC,如此往复。需要注意的是,每执行一次Minor GC,存活对象的age就会加一。 (2)Tenured区:一旦存活对象的age超多一定阈值就会晋升到Tenured区,因此可以理解为Tenured区一般存放长寿对象。很显然,随着时间流逝,Tenured区也会被填充满,此时就会触发CMS GC(old gc),这种GC相对比较复杂,由5个步骤组成,详见参考文章。 3. 无论是Minor GC还是CMS GC,都会’Stop-The-World’,即停止用户的一切线程,只留下gc线程回收垃圾对象。其中Minor GC的STW时间主要耗费在复制阶段,CMS GC的STW时间主要耗费在标示垃圾对象阶段。 GC调优目标 上节简单介绍了Java虚拟机的内存结构以及Java GC的基本知识,接下来会在此基础上介绍HBase集群中GC的几种参数调优技巧。在介绍具体的调优技巧之前,有必要先来看看GC调优的最终目标和基本原则: 1. 平均Minor GC时间尽可能短。因为整个Minor GC都处于STW,因此短时间Minor GC会使用户读写更加平稳,延迟可控。 2. CMS GC次数越少越好。时间越短越好。一方面是因为一次CMS GC一般都会引起至少秒级的应用暂停,对用户读写影响较大;另一方面频繁的CMS GC会产生大量的内存碎片,严重的时候会引起Full GC,导致RegionServer宕机。 下面对参数的调优技巧都谨遵以上原则,尤其对于HBase这类延迟敏感性项目而言,在尽量避免严重影响用户读写的情况下使得GC更加平稳、暂停时间更短! CMS GC优化技巧 本节会针对HBase这一应用场景对JVM的各种GC参数进行分析,主要分三个阶段进行。第一阶段会介绍适用于所有场景下的GC参数配置,这些参数不需要太多解释读者就可以轻松理解;第二阶段和第三阶段分别就两组参数进行调优讲解,这两组参数一般会根据不同的应用场景进行设置才能使得GC效果最好,鉴于这两组参数的复杂性,我们会通过理论+实验的方式一一进行说明; 阶段一:默认推荐配置 在介绍具体的调优技巧之前,先来看看CMS GC涉及到的所有相关参数及其对应的意义,下面是最常见的参数: -Xmx -Xms -Xmn -Xss -XX:MaxPermSize= M -XX:SurvivorRatio=S -XX:+UseConcMarkSweepGC -XX:+UseParNewGC -XX:+CMSParallelRemarkEnabled -XX:MaxTenuringThreshold=N -XX:+UseCMSCompactAtFullCollection -XX:+UseCMSInitiatingOccupancyOnly -XX:CMSInitiatingOccupancyFraction=C -XX:-DisableExplicitGC 通过上文对各个GC参数的说明,可以轻松得出第一阶段推荐的参数设置如下,这样的设置基本适用于所有的场景: -XX:+UseConcMarkSweepGC -XX:+UseParNewGC -XX:+CMSParallelRemarkEnabled -XX:+UseCMSCompactAtFullCollection -XX:+UseCMSInitiatingOccupancyOnly -XX:CMSInitiatingOccupancyFraction=75% -XX:-DisableExplicitGC 调优预准备 上文通过解释各个GC参数意义给出了基本的推荐设置,同时也提到几个对性能影响重大的参数:Xmn、SurvivorRatio以及MaxTenuringThreshold,下面会通过理论推理+实验验证的方式对这几个参数在HBase系统的设置进行调优。在深入介绍调优技巧之前,需要额外针对三个相关部分预先做下讲解,这样可以更好地理解下文的实验数据分析。这三部分分别是:测试环境+测试基本条件,GC日志解释,HBase场景内存分析; 测试环境 首先就下文中实验测试的硬件拓扑、软件配置以及相关测试数据情况进行说明: 需要强调的是HBase全部配置为BucketCache模式,而不是LruBlockCache。使用了大量堆外内存作为读缓存,在很大程度上优化了GC,如下图: 上图是在两种缓存策略下GC表现情况,可见BucketCache模式比LruBlockCache模式GC表现好很多,强烈建议线上配置BucketCache模式。可能很多童鞋都测试过这两种模式下的GC、吞吐量、读写延迟等指标,看到测试结果都会很疑惑,BucketCache模式下的各项性能指标都比LruBlockCache差了好多,笔者也疑惑过,后来才明白:测试肯定是在基本全内存场景下进行的,这种情况下确实会是如此。读者可以想想为什么会如此,实在不明白可以参考之前一篇博文《BlockCache方案性能对比测试报告》。但是话又说回来,在大数据场景下又有多少业务会是全内存操作呢? GC日志分析 介绍完实验基本条件后,再对GC日志进行简单的解释,方便下文对日志进行分析。需要注意只有在添加参数-XX:+PrintTenuringDistribution才能打印对应日志,强烈建议线上集群开启该参数,日志片段如下: 2016-07-26T10:37:16.933+0800: 227753.150: [GC2016-07-26T10:37:16.933+0800: 227753.150: [ParNew Desired survivor size 268435456 bytes, new threshold 5 (max 15) - age 1: 57523184 bytes, 57523184 total - age 2: 80236520 bytes, 137759704 total - age 3: 73226496 bytes, 210986200 total - age 4: 50318392 bytes, 261304592 total - age 5: 63166384 bytes, 324470976 total - age 6: 240 bytes, 324471216 total : 1268903K->305311K(1572864K), 0.0840620 secs] 26598675K->25635082K(66584576K), 0.0844700 secs] [Times: user=1.82 sys=0.08, real=0.08 secs] 上述日志片段分三部分进行解释: 第一部分:基本信息区,主要有两点需要重点关注,其一是Desiredsurvivorsize268435456bytes,该值通过SurvivorSize * TargetSurvivorRatio计算而来,默认TargetSurvivorRatio为50%,如果xmn为5g,SurvivorRatio为8的话,Desired Survivor Size 就等于256M;其二是newthreshold5(max15),括号中max 15表示对象晋级老生代的最大阈值为15,new threshold 5表示调整后的threshold为5,可见,threshold在整个过程中会不断调整,调整后的threshold表示不大于该值的所有age的对象大小总和刚好大于Desired Survivor Size,否则为最大threshold(15)。 第二部分:不同age对象分布区,第一列表示该Young区共分布有age在1~6的对象;第二列表示所在age含有的对象集所占内存大小,比如age为2的所有对象总大小为80236520bytes;第三列表示小于对应age的所有对象占用内存的累加值,比如age2对应第二列137759704total表示age为1和age为2的所有对象总大小; 第三部分:内存回收信息区,第一列表示Young区的内存回收情况,1268903K->305311K表示Young区回收前内存为1268903K,回收后变为305311K;第二列表示Jvm Heap的内存回收情况,26598675K->25635082K(66584576K) 表示当前Jvm总分配内存为66584576K,回收前对象占用内存为26598675K,回收后对象占用内存为25635082K;第三列表示回收时间,其中real表示本次gc所消耗的STW时间,即用户业务暂停时间。 HBase场景内存分析 通常来讲,每种应用都会有自己的内存对象特性,分类来说无非就两种:一种是短寿对象(指存活对象较短的对象,比如临时变量等)居多工程,比如大多数纯HTTP请求处理工程,短寿对象可能占到所有对象的70%左右;另一种是长寿对象(指存活对象较长的对象,比如TTL设置较长的缓存对象)居多工程,比如类似于HBase、Spark等这类大内存工程。具体以HBase为例,来看看具体的内存对象: 1. RPC请求对象,比如Request对象和Response对象,一般这些对象会随着短连接RPC的销毁而消亡,这些对象可以认为是短寿对象; 2. Memstore对象,HBase中Memstore中对象一般会持续存活较长时间,用户写入数据到Memstore中之后对象就一直存在,直至Memstore写满之后flush到HDFS。一般在写入QPS较高的情况下写满memstore也通常需要一个小时左右,可见Memstore对象肯定是长寿对象。另外,Memstore对象默认比较大,2M大小。 3. BlockCache对象,和Memstore对象一样,BlockCache对象一般也会在内存存活较长时间,属于长寿对象。这种对象默认64K大小。 因此可以看出,HBase系统属于长寿对象居多的工程,因此GC的时候只需要将RPC这类短寿对象在Young区淘汰掉就可以达到最好的GC效果。 阶段二:NewParSize调优 理论分析 NewParSize表示young区大小,而young区大小直接决定minor gc的频率。minor gc频率一方面决定单次minor gc的时间长短,gc越频繁,gc时间就越短;一方面决定对象晋升到老年代的量,gc越频繁,晋升到老年代的对象量就越大。解释起来就是: 1. 增大young区大小,minor gc频率降低,单次gc时间会较长(young区设置更大,一次gc就需要复制更多对象,耗时必然比较长),业务读写操作延迟抖动较大。反之,业务读写操作延迟抖动较小,比较平稳。 2. 减小young区大小,minor gc频率增快,但会加快晋升到老年代的对象总量(每gc一次,对象age就会加一,当age超过阈值就会晋升到老年代,因此gc频率越高,age就增加越快),潜在增加old gc风险。 因此设置NewParSize需要进行一定的平衡,不能设置太大,也不能设置太小。 实验结果 实验条件:分为独立对照试验,三台RegionServer分别设置Xmn为512m、2g、5g,Xmn越大,分配的Young区越大;SurvivorRatio和MaxTenuringThreshold取默认值; 实验结果曲线图: 结果分析 1. 图一是Xmn不同场景下总体的GC耗时曲线图,其中横坐标表示GC次数,纵坐标表示GC耗时(STW),单位ms。需要特别说明的是,这3条曲线是在相同时间段统计的,也就是说在这段时间内Xmn为512m的情况下GC次数最多,而相应的Xmn为5的情况下GC次数最少。 2. 图一整体上来看绿线尖峰很多而且很高,表示CMS GC较频繁,但绿线主体部分处于红线与蓝线之下,表示平均Minor GC耗时更短;蓝线GC次数最少,尖峰也比较突出,另外Minor GC相比红线和绿线耗时更长;红线的Minor GC耗时介于蓝线和绿线之间,尖峰比较平稳,表示CMS GC相对比较短暂;因此总体来看,红线代表的Xmn为2的场景下CMS GC更加合理,平均Minor GC相对不高,而相比之下,另外两种场景都有特别明显的缺陷,Xmn=2是一个最优的选择;图一只能直观上看出这么多,更加精确结果需要接着看图二和图三。 3. 图二主要统计Minor GC的主要指标:总GC次数以及平均单次Minor GC耗时。两者来看,更关注后者,因为后者决定了业务读写的延迟以及稳定度;由图中可以看出,Xmn512m的平均单次Minor GC耗时最少,其次是Xmn2g,最差是Xmn5g,达到了130ms左右,意味着在其Minor GC过程中所有业务读写延迟至少为130ms;这个也很好理解,Young区越小,Minor GC频率越高,单次Minor GC需要复制的对象数就越少,耗时越少; 4. 图三主要统计CMS GC(老年代GC)的主要指标:CMS GC次数以及平均单次老年代GC耗时(只算STW耗时);由图中可以看出,Xmn2g无论是GC次数还是GC耗时都更加优秀,相比之下Xmn512m就是最差的选择;解释起来也很简单,因为Young区设置太小,Minor GC频率高,对象age增加很快,很多对象就有可能因为age超过阈值(默认6)晋升到老年代,相对而言会更有可能引入大量短寿对象晋升老年代。而短寿对象相对而言会比较小,比如request、response等,大量小对象一旦进入老年代,就会导致CMS GC的时候需要标注更多对象,必然比较耗时; 实验结论 可见,测试结果基本和理论分析一致,Xmn设置过小会导致CMS GC性能较差,而设置过大会导致Minor GC性能较差,因此建议在JVM Heap为64g以上的情况下设置Xmn在1~3g之间,在32g之下设置为512m~1g;具体最好经过简单的线上调试;需要特别强调的是,笔者在很多场合都看到很多HBase线上集群会把Xmn设置的很大,比如有些集群Xmx为48g,Xmn为10g,查看日志发现GC性能极差:单次Minor GC基本都在300ms~500ms之间,CMS GC更是很多超过1s。在此强烈建议,将Xmn调大对GC(无论Minor GC还是CMS GC)没有任何好处,不要设置太大。 阶段三:增大Survivor区大小(减小SurvivorRatio) & 增大MaxTenuringThreshold 理论分析 上文讲过,一次Minor GC会将存活对象从Eden区(以及survivor from区)复制到Survivor区(to区),因此增大Survivor区可以容纳更多的存活对象。这样就会防止因为Survivor区太小导致很对存活对象还没有达到MaxTenuringThreshold阈值就直接进入老生代,潜在增大old gc的触发频率;但是Survivor区设置太大也会有一定的问题,Survivor设置较大会使得对象可以在Young区’待’的时间很长,但是对于一些长寿对象较多的场景下(比如HBase),大量长寿对象长时间待在Young区做很多’无谓’的复制,一定程度上增加Minor GC开销。 另外,增加MaxTenuringThreshold相当于提高了进入老年代的门槛,可以有效限制进入老年代的对象数。和Survivor设置相似,调整MaxTenuringThreshold也需要做一个取舍,设置太小会增加CMS GC的触发频率以及耗时,而设置太大则会在长寿对象较多场景下增加Minor GC开销。一般情况下,默认MaxTenuringThreshold=15已经相对比较大,不需要做任何调整。 实验结果 实验条件:分为独立对照试验,三台RegionServer分别设置SurvivorRatio为2、8、15,SurvivorRatio越大,Survivor区大小越小;MaxTenuringThreshold取默认值;其他:-Xmx64g,-Xmn2g; 实验结果曲线: 结果分析 1. 图一是SurvivorRatio在三种不同场景下对应的GC性能曲线图,大体可以看出蓝线Minor GC次数最多,绿线尖峰太多,即CMS GC性能最差;具体细节再来看图二和图三。 2. 图二主要统计Minor GC主要指标:平均单次Minor GC耗时三者基本相当,SurvivorRatio:2场景下稍微较高,这是因为SurvivorRatio=2对应的Survivor区较大,可以使得对象在Young区’待’的时间很长,在HBase这种长寿对象较多的情况下,可能会增加一些无谓的‘复制’开销(下文会通过日志分析详细解释)。另外,SurvivorRatio=2场景下Minor GC频率也比较高,可能的原因是因为在总Young大小确定的情况下,Survivor越大,Eden自然越小,Minor GC频率就会增大。可见,SurvivorRatio=2场景下Minor GC性能相对稍微较差。 3. 图三主要统计CMS GC主要指标:三者CMS GC次数基本相当,SurvivorRatio=2场景下单次CMS GC耗时最少,相比SurvivorRatio=8的场景耗时减少30%左右,性能最好;而相比之下SurvivorRatio=15场景下耗时最长,性能相当差;这是因为SurvivorRatio=2场景下存活对象可以长时间待在Young区,可以得到充分的淘汰,晋升到老生代的短寿小对象会比较少,因而CMS GC性能较好;相比SurvivorRatio=15会因为Survivor区设置太小,很多短寿小对象因为得不到充分的淘汰就会‘溢出’到老生代,导致CMS性能很差。 实验结论 可见,测试结果基本和理论分析也基本一致,对于Minor GC来说,SurvivorRatio设置对其影响不是很大。而对于CMS GC来说,将SurvivorRatio设置过大简直就是灾难,性能极其差。而和默认值SurvivorRatio=8相比,将SurvivorRatio调小有利于短寿小对象更充分地淘汰,因此建议将SurvivorRatio=2 CMS调优结论 1. 缓存模式采用BucketCache策略Offheap模式 2. 对于大内存(大于64G),采用如下配置: -Xmx64g -Xms64g -Xmn2g -Xss256k -XX:MaxPermSize=256m -XX:SurvivorRatio=2 -XX:+UseConcMarkSweepGC -XX:+UseParNewGC -XX:+CMSParallelRemarkEnabled -XX:MaxTenuringThreshold=15 -XX:+UseCMSCompactAtFullCollection -XX:+UseCMSInitiatingOccupancyOnly -XX:CMSInitiatingOccupancyFraction=75 -XX:-DisableExplicitGC 其中Xmn可以随着Java分配堆内存增大而适度增大,但是不能大于4g,取值范围在1~3g范围;SurvivorRatio一般建议选择为2;MaxTenuringThreshold设置为15; 3 对于小内存(小于64G),只需要将上述配置中Xmn改为512m-1g即可 总结 本文首先比较系统的介绍了CMS GC的相关知识,之后分三个阶段层层推进对HBase集群中相关重要参数的调优进行了详细说明,尤其后面两阶段通过理论推理以及实验验证的方式对两组核心参数进行了针对性调整,最终得出一个较为完整的CMS GC参数配置。读者可以参考该参数配置对集群进行调整,再通过日志查看调整效果~ 本文转载自:http://hbasefly.com 原文链接

优秀的个人博客,低调大师

HBase最佳实践-列族设计优化

随着大数据的越来越普及,HBase也变得越来越流行。会用HBase现在已经变的并不困难,然而,怎么把它用的更好却并不简单。那怎么定义‘用的好’呢?很简单,在保证系统稳定性、可用性的基础上能够用最少的系统资源(CPU,IO等)获得最好的性能(吞吐量,读写延迟)就是’用的好’。HBase是一个庞大的体系,涉及到很多方面,很多因素都会影响到系统性能和系统资源使用率,根据场景对这些配置进行优化会很大程度上提升系统的性能。笔者总结至少有如下几个方面:HDFS相关配置优化,HBase服务器端优化(GC优化、Compaction优化、硬件配置优化),列族设计优化,客户端优化等,其中客户端优化在前面已经通过超时机制、重试机制讲过,后面笔者会继续分别介绍其他三个优化重点。 本节重点介绍列族设计优化,HBase中基本属性都是以列族为单位进行设置的,如下示例,用户创建了一张称为‘ NewsClickFeedback’的表,表中只有一个列族’Toutiao’,紧接着的属性都是对此列族进行的设置。这些属性基本都会或多或少地影响该表的读写性能,但有些属性用户只需要理解其意义就知道如何设置,而有些属性却需要根据场景、根据业务来设置,比如BLOCKSIZE属性在不同场景下应该如何设置?还有COMPRESSION属性和DATA_BLOCK_ENCODING属性,两者都可以提供压缩功能,那到底应该选择哪个,还是两个都需要进行设置?本文就重点介绍这三个属性的设计原则。 create 'NewsClickFeedback',{NAME=>'Toutiao',VERSIONS=>1,BLOCKCACHE=>true,BLOOMFILTER=>'ROW',COMPRESSION=>'SNAPPY',TTL => '259200', DATA_BLOCK_ENCODING => 'PREFIX_TREE', BLOCKSIZE => '65536'},{SPLITS => ['1','2','3','4','5','6','7','8','9','a','b','c','d','e','f']} BlockSize设置 块大小是HBase的一个重要配置选项,默认块大小为64K。对于不同的业务数据,块大小的合理设置对读写性能有很大的影响。而对块大小的调整,主要取决于两点: 1. 用户平均读取数据的大小。理论上讲,如果用户平均读取数据的大小较小,建议将块大小设置较小,这样可以使得内存可以缓存更多block,读性能自然会更好。相反,建议将块大小设置较大。 为了更好说明上述原理,笔者使用YCSB做了一个测试,分别在Get、Scan两种场景下测试不同BlockSize大小(16K,64K,128K)对性能的影响。测试结果分别如下面两图: 随着BlockSize的增大,系统随机读的吞吐量不断降低,延迟不断增大。64K大小比16K大小的吞吐量大约降低13%,延迟增大13%。同样的,128K大小比64K大小的吞吐量降低约22%,延迟增大27%。因此,对于以随机读为主的业务,可以适当调低BlockSize的大小,以获得更好的读性能。 随着BlockSize增大,scan的吞吐量逐渐增大,延迟不断降低。64K大小BlockSize比16K大小的吞吐量增加了33%,延迟降低了24%;128K大小比64K大小吞吐量增加了7%,延迟降低了7%;因此,对于以scan为主的业务,可以适当增大BlockSize的大小,以获得更好的读性能。 可见,如果业务请求以Get请求为主,可以考虑将块大小设置较小;如果以Scan请求为主,可以将块大小调大;默认的64K块大小是在Scan和Get之间取得的一个平衡。 2. 数据平均键值对规模。可以使用HFile命令查看平均键值对规模,如下: ./hbase org.apache.hadoop.hbase.io.hfile.HFile -m -f /hbase-sc/data/news/NewsClickFeedback/627b1d95153d4157351b65135ab701a3/Toutiao/011b41375e584530a24a3a203b9ce1a3 Block index size as per heapsize: 704 reader=/hbase-sc/data/news/NewsClickFeedback/627b1d95153d4157351b65135ab701a3/Toutiao/011b41375e584530a24a3a203b9ce1a3, compression=snappy, cacheConf=CacheConfig:disabled, firstKey=a0000000be3d27a5a11d203f798781a9/Toutiao:ClickViewTS/1465783628056/Put, lastKey=a80072cbf409d04542f272446d4b65a4/Toutiao:ClickViewTS/1465776679416/Put, avgKeyLen=62, avgValueLen=93, entries=6451829, length=698454846 ...... 从上面输出的信息可以看出,该HFile的平均键值对规模为62B + 93B = 155B,相对较小,在这种情况下可以适当将块大小调小(例如32KB)。这样可以使得一个block内不会有太多kv,kv太多会增大块内寻址的延迟时间,因为HBase在读数据时,一个block内部的查找是顺序查找。 注意:默认块大小适用于多种数据使用模式,调整块大小是比较高级的操作。配置错误将对性能产生负面影响。因此建议在调整之后进行测试,根据测试结果决定是否可以线上使用。 数据编码/压缩 Compress/DeCompress 数据压缩是HBase提供的另一个特性,HBase在写入数据块到HDFS之前会首先对数据块进行压缩,再落盘,从而可以减少磁盘空间使用量。而在读数据的时候首先从HDFS中加载出block块之后进行解压缩,然后再缓存到BlockCache,最后返回给用户。写路径和读路径分别如下: 结合上图,来看看数据压缩对资源使用情况以及读写性能的影响: (1) 资源使用情况:压缩最直接、最重要的作用即是减少数据硬盘容量,理论上snappy压缩率可以达到5:1,但是根据测试数据不同,压缩率可能并没有理论上理想;压缩/解压缩无疑需要大量计算,需要大量CPU资源;根据读路径来看,数据读取到缓存之前block块会先被解压,缓存到内存中的block是解压后的,因此和不压缩情况相比,内存前后基本没有任何影响。 (2) 读写性能:因为数据写入是先将kv数据值写到缓存,最后再统一flush的硬盘,而压缩是在flush这个阶段执行的,因此会影响flush的操作,对写性能本身并不会有太大影响;而数据读取如果是从HDFS中读取的话,首先需要解压缩,因此理论上读性能会有所下降;如果数据是从缓存中读取,因为缓存中的block块已经是解压后的,因此性能不会有任何影响;一般情况下大多数读都是热点读,缓存读占大部分比例,压缩并不会对读有太大影响。 可见,压缩特性就是使用CPU资源换取磁盘空间资源,对读写性能并不会有太大影响。HBase目前提供了三种常用的压缩方式:GZip | LZO | Snappy,下面表格是官方分别从压缩率,编解码速率三个方面对其进行对比: 综合来看,Snappy的压缩率最低,但是编解码速率最高,对CPU的消耗也最小,目前一般建议使用Snappy。 Encode/Decode 除了数据压缩之外,HBase还提供了数据编码功能。和压缩一样,数据在落盘之前首先会对KV数据进行编码;但又和压缩不同,数据块在缓存前并没有执行解码,因此即使后续命中缓存的查询也是编码的数据块,需要解码后才能获取到具体的KV数据。写路径和读路径分别如下: 同样,来看看数据编码对资源使用情况以及读写性能的影响: (1) 资源使用情况:和压缩一样,编码最直接、最重要的作用也是减少数据硬盘容量,但是数据编码压缩率一般没有数据压缩的压缩率高,理论上只有5:2;编码/解码一般也需要大量计算,需要大量CPU资源;根据读路径来看,数据读取到缓存之前block块并没有被解码,缓存到内存中的block是编码后的,因此和不编码情况相比,相同数据block快占用内存更少,即内存利用率更高。 (2) 读写性能:和数据压缩相同,数据编码也是在数据flush到hdfs阶段执行的,因此并不会直接影响写入过程;前面讲到,数据块是以编码形式缓存到blockcache中的,因此同样大小的blockcache可以缓存更多的数据块,这有利于读性能。另一方面,用户从缓存中加载出来数据块之后并不能直接获取KV,而需要先解码,这却不利于读性能。可见,数据编码在内存充足的情况下会降低读性能,而在内存不足的情况下需要经过测试才能得出具体结论。 HBase目前提供了四种常用的编码方式:Prefix | Diff | Fast_Diff | Prefix_Tree。下图是Prefix_Tree编码算法作者做的一个测试结果: 可见,prefix_tree压缩算法在不同的block size下性能都比较稳定,而另外两种压缩算法的查找性能会随着blocksize直线下降。对于我们默认的64K的block大小,性能相差40+倍。另外,阿里天梧大牛之前在一篇博文里面做过测试证明了PREFIX_TREE算法的优越性,见《HBase-0.96中新BlockEncoding算法-PREFIX_TREE压缩的初步探究及测试》,因此一般建议使用PREFIX_TREE编码压缩。 选择哪一个?Why? 综上上面分析,数据压缩和数据编码使命基本相同:消耗CPU资源压缩数据大小,可以认为是一种时间换空间的做法。但,同时开启两个功能会不会更好?如果只需要开启一个,优先选择哪一个? 为了更加深刻地认识数据压缩编码,回答上面两个问题,本人在测试环境使用YCSB做了一个简单的测试,分别在四种场景下(无压缩无编码、仅压缩、仅编码、既压缩既编码)对随机读以及扫描读的操作延时、CPU使用率以及对应的压缩率进行了测试。 测试条件: 数据:6000w条记录,一个列族,每个列族10个列,单条记录总共1K大小; 硬件:单RegionServer,3G BlockCache,CPU:32Intel(R)Xeon(R)CPUE5-2650v2@2.60GHz 测试结果: 结果分析: 1. 数据压缩率并没有理论上0.2那么高,只有0.7左右,这和数据结构有关系。其中压缩、编码、压缩+编码三种方式的压缩率基本相当。 2. 随机读场景:和默认配置相比,snappy压缩在性能上没有提升,CPU开销却上升了38%;prefix_tree性能上没有提升,CPU利用率也基本相当;snappy+prefix_tree性能没有提升,CPU开销上升了38%。 3. 区间扫描场景:和默认配置相比,snappy压缩在性能上略有10%的提升,但是CPU开销却上升了23%;prefix_tree性能上略有4%左右的下降,但是CPU开销也下降了5%; snappy+prefix_tree在性能上基本没有提升,CPU开销却上升了23%; 注意:虽然从压缩率、CPU利用率以及性能上来看,prefix_tree编码确实会比snappy压缩更加优秀。但本人在线上遇到了很大的坑:compaction一直卡住,详见HBASE-12959,后来查看相关问题,发现还可能造成scan miss,详见HBASE-12817。后来发现该功能目前还属于实验性质特性-experimental feature。鉴于安全考虑,prefix_tree功能建议不要设置。 到此为止,本文主要介绍了HBase的一个优化方向:列族设计优化。其中重点介绍了BlockSize在不同场景下对读写性能的影响,以及Compress与Data_Block_Encoding的设计原则。希望看官能够根据上述对HBase的列族优化有一个更好的认识,并且能够更多地通过测试来巩固认知。需要说明的是,这里的设计原则对大多数应用业务都是有效的,也有可能对于某些特殊场景并不适用,因此对于比较敏感的业务,还是以实际测试为准。后期笔者将会继续分析HBase优化这个专题,接着介绍HBase体系中另一个非常非常重要的概念-Compaction,敬请期待~ 本文转载自:http://hbasefly.com 原文链接

优秀的个人博客,低调大师

VPC最佳实践(一):网络规划篇

专有网络VPC(Virtual Private Cloud)是阿里云推荐的网络类型,越来越多的用户选择使用VPC,可以说VPC是现在用户上云第一个考虑的产品。使用VPC主要有两方面的核心优势。一是安全,即用户需要更安全的网络隔离,VPC基于隧道技术,实现数据链路层的隔离,为每个租户提供一张独立、隔离的安全网络。二是VPC让用户有了网络管理能力,比如IP规划,路由管理等等。在VPC出现之前,云上用户是缺乏网络管理能力的。 关于VPC详细信息可以访问:VPC产品 用户在考虑使用VPC的时候,首先遇到的一个问题就是,如何进行VPC网络规划?本文拆分成下面几个小问题进行分析。 问题一,应该使用几个VPC? 问题二,应该使用几个虚拟交换机? 问题三,应该选择什么网段? 问题四,考虑一个比较复杂的业务系统,云上存在多个VPC且需要和云下IDC互

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册