首页 文章 精选 留言 我的

精选列表

搜索[AIOps最佳实践],共10001篇文章
优秀的个人博客,低调大师

Docker镜像原理和最佳实践

镜像 传统企业是以交付应用的方式进行发布的,交付应用相当于可执行性程序,其整个应用与环境是分开维护的。随着容器技术的兴起,提出了交付环境的概念。交付环境与交付应用相比,交付的不仅是可执行程序,还交付可执行程序依赖的配置文件、类库甚至是整个文件系统。在Docker语境里面,环境就是镜像。从上图左下角镜像示例图可以看出,镜像本身的组织结构是分层的。其优点是,虽然它包含了所有的依赖,但是发布部署的时候不会显著增加信息的传输量。 镜像的表示分为四部分:红色的部分是镜像中心域名,黄色的部分是镜像命名空间,我们可以根据命名空间进行权限控制等操作,绿色是镜像的名称,每个镜像有一个版本(即标签)。Docker官方的镜像不需要镜像中心的域名,有一些镜像可以省略命名空间。 镜像基本操作 镜像制作——Dockerfile 第一行是一个FROM指令,使用了一个叫a

优秀的个人博客,低调大师

C++异步编程最佳实践

Mapreduce问题 多个数据,进行同类型计算,最后汇总结果,怎样用C++解锁此类问题? 这个最简单了,单线程循环处理每份数据好了。这有何难,创建一块地方,针对每份数据创建个线程执行计算,将结果写入先前创建的数据的对应地方,等各线程结束,完活。 上面的说法都对,只是不够好。对于单线程处理,在这个多核时代,未免大马拉小车,有点浪费CPU。当问题规模变大,你准备花多长时间计算。对于多线程这个说法,从策略上来说,没有问题。但问题是你不得不手动启动线程,把结果放到共享内存里,通过thread.join()等待结束。这点操作难度,对于我大C++开发来说算啥,分分钟就搞定了。但问题又来了,现在你的老板问你要针对单份数据的处理函数,返回结果。呵呵,原来的单份数据处理函数,十有八九长成这样: RetType deal(Indata t,Retdata&

优秀的个人博客,低调大师

【最佳实践】利用OpenNJet实现灰度发布

在应用的新版本测试发布过程中,经常需要先使用部分选定的账号进行验证,待验证完成后,再逐步将业务流量切换到新版本,直至所有流量均切换到新的集群。 测试账号的检测可以使用多种方式,如通过Header中字段,Cookie中的值,或者URL 中的参数等方式。 在之后章节的配置及场景中,将使用HTTP Header中的staffid 字段做为测试账号的判断依据,7xxxx 的账号将被认定为测试工号。 初始静态配置 初始配置中,将设置两组upstream: backendA , backendB , 并通过split_clients 指令设置使用header中的staffid值做为流量配比依据,并设置100%的流量将指向后端 backendA。 split_clients $http_staffid $backend { 100% backendA; * backendB; } 完整配置如下: njet.conf worker_processes auto; cluster_name app1; node_name node1; error_log logs/error.log info; load_module modules/njt_http_split_clients_2_module.so; load_module modules/njt_http_dyn_bwlist_module.so; load_module modules/njt_http_lua_module.so; load_module modules/njt_dyn_ssl_module.so; load_module modules/njt_agent_dynlog_module.so; load_module modules/njt_http_location_module.so; helper ctrl modules/njt_helper_ctrl_module.so njet_ctrl.conf; helper broker modules/njt_helper_broker_module.so ; events { worker_connections 1024; } http { split_clients $http_staffid $backend { 100% backendA; * backendB; } upstream backendA { server 192.168.1.4:18081; } upstream backendB { server 192.168.2.4:18081; } server { listen 18080 ssl; ssl_certificate cert/server.crt; ssl_certificate_key cert/server.key; server_name www.test.com; location / { proxy_pass http://${backend}; } } } njet_ctrl.conf load_module modules/njt_http_sendmsg_module.so; load_module modules/njt_ctrl_config_api_module.so; load_module modules/njt_helper_health_check_module.so; load_module modules/njt_http_upstream_api_module.so; load_module modules/njt_http_location_api_module.so; load_module modules/njt_doc_module.so; load_module modules/njt_http_vtsd_module.so; error_log logs/error_ctrl.log error; events { worker_connections 1024; } http { include mime.types; access_log off; server { listen 8081; location / { return 200 "njet control panel\n"; } location /hc { health_check_api; } location /api { api write=on; } location /kv { dyn_sendmsg_kv; } location /config { config_api; } location /doc { doc_api; } location /dyn_loc { dyn_location_api; } location /metrics { vhost_traffic_status_display; vhost_traffic_status_display_format html; } } } 灰度发布步骤 ​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​​动态添加location 当新版本已经部署到backendB 集群后, 通过动态location提供的API 添加一个条件location, location 中设置所有的 7xxxx 测试工号将访问到 backendB。Njet 提供的条件表达式中,可以使用$http_* 获取到请求header 中的值, $http_staffid ~* "7.*" 表达式将匹配所有header中staffid 为7xxxx 的请求。 使用测试工号测试 通过上一个步骤添加条件location 后, 所有非 7xxxx 的工号将继续访问到集群 backendA, 所有 7xxxx 做为测试工号,将访问到集群backendB。 ​​​​​​​删除表达式location 当测试完成后,可以使用动态API 删除条件location。 删除条件location后,所有的流量均指向backendA, 包括 7xxxx 的测试工号。 ​​​​​​​逐步调整分流比例直至100% 使用模块提供的动态配置API, 逐步调整分流比例。 如调整到 50:50 的比例时: 最后调整到 0:100 的比例, 所有的流量将指向 backendB 这时,应用的新版本已经完成部署和切换 (A => B ), 当下一个版本发布时,可以使用相同的步骤,完成 (B => A) 的切换。 OpenNJet 最早是基于 NGINX1.19 基础 fork 并独立演进,随着 NGINX 版本迭代,吸收上游 NGINX 的更新,已经同步更新到 NGINX1.23.1 版本,OpenNJet 具有高性能、稳定、易扩展的特点,同时也解决了 NGINX 长期存在的难于动态配置、管理功能影响业务等问题。 作为底层引擎,OpenNJet 利用动态加载机制可以实现不同的产品形态,如API网关、消息代理、出入向代理,负载均衡,WAF等等。在云原生架构中,OpenNJet 除了提供南北向通信网关的功能以外,还提供了服务网格中东西向通信、透明流量劫持、熔断、遥测与故障注入等新功能特性。 传送门:https://gitee.com/njet-rd

优秀的个人博客,低调大师

Rancher 全球化部署最佳实践

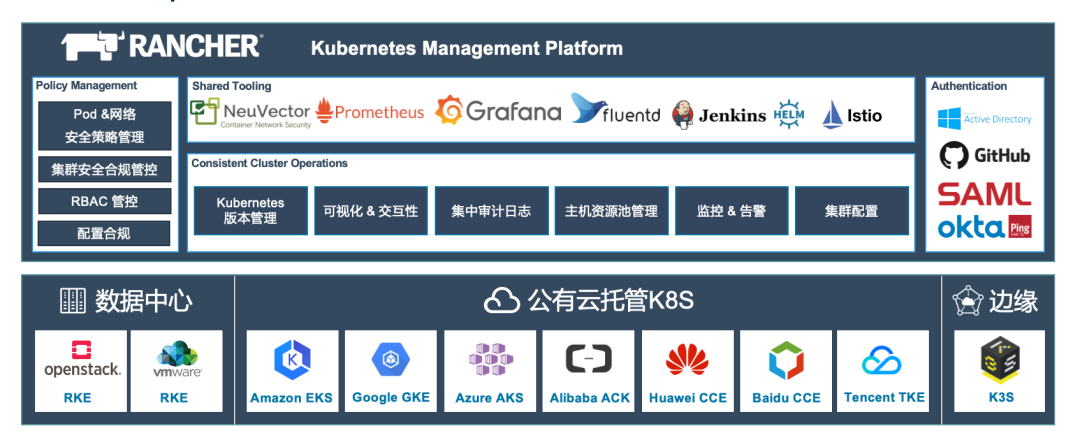
作者 万绍远,CNCF 基金会官方认证 Kubernetes CKA&CKS 工程师,云原生解决方案架构师。对 ceph、Openstack、Kubernetes、prometheus 技术和其他云原生相关技术有较深入的研究。参与设计并实施过多个金融、保险、制造业等多个行业 IaaS 和 PaaS 平台设计和应用云原生改造指导。 “大航海”时代,国内企业纷纷在出海赛道上扬帆起航。伴随着业务出海,系统也要做全球化部署,公有云成为了出海企业的首选。 但是,Kubernetes 在企业落地过程中仍然面临诸多挑战: 需要经验丰富的 IT 人员对 Kubernetes 集群进行部署、升级、监控, 确保系统可靠性。 多个 Kubernetes 集群如何进行统一策略管理、安全管控,实现集中式的可视化管控和一致性运维 ? 如何利用 Kubernetes 和周边生态技术栈,更高效地迭代和交付业务应用 ? Rancher 就是一款很好的工具,能够通过其多集群管理能力和 Kubernetes 生命周期安全支持,帮助出海业务提高部署效率,降低运维成本。 多集群统一纳管 业务出海需要重点评估平滑迁移成本。容器是非常好的应用载体,诸多企业考虑在海外公有云使用 Kubernetes。那么应该选择公有云的虚拟机自建 Kubernetes?还是直接使用公有云厂商的 Kubernetes 发行版,例如 AWS EKS 或者 Azure AKS 呢? 建议企业使用公有云的 Kubernetes 发行版,因为它直接与公有云的基础设施进行了集成,可以更好地利用云上资源,提高部署效率,降低运维成本。以 AWS EKS 为例,使用 EKS 创建 Loadblance 类型的 Service 会自动在 AWS 中创建 ELB 负载均衡器,存储自动对接了 EBS 和 EFS。相比自建 Kubernetes 来说,降低了手动对接的操作过程。 Rancher 支持国内外主流的公有云 Kubernetes 发行版,如 EKS、GKE、ACK、CCE、TKE、AKS……用户可通过 Rancher 一键创建并纳管这些云供应商的 Kubernetes 发行版。 以一个客户架构为例 1、在中国本地数据中心部署 Rancher,本地数据中心的 Kubernetes 使用 RKE 进行部署,并同时建设同城灾备环境。 2、海外业务集群使用 Rancher 对接 AWS,创建对应的 EKS 集群进行统一纳管,通过专线连接。 使用 Rancher 部署 EKS 集群示例 AWS 配置: 1、在 AWS 中提前创建 VPC 和安全组 2、添加 IAM 权限,创建策略:https://docs.ranchermanager.rancher.io/zh/reference-guides/amazon-eks-permissions/minimum-eks-permissions 3、创建用户关联此策略 Rancher 配置 1、创建集群 2、选择 EKS 3、选择对应的区域和配置信息 填写生成的账户 Access-key 和 Secret-key 4、配置 VPC 和子网 5、配置节点主机规格 6、集群创建完成 对应的 AWS 页面也能看见创建的集群。在 Rancher UI 创建负载均衡和创建 PVC 也会自动在 AWS 中创建 多集群统一发布 跨集群应用克隆 当实现多集群纳管后也带来一个问题:用户在测试集群部署服务验证可用以后,如何快速地将应用直接发布到生产集群?如果只能在生产集群中手动创建应用,在手动配置过程中容易出现参数丢失等问题。 为了解决这些问题,Rancher 企业版从设计之初就新增了跨集群应用克隆的功能,可以一键将某一集群的应用发布到其他集群,减少用户手动配置的工作量。 同时用户还可以通过跨集群应用克隆功能,提前将应用备份到其他集群,一旦有集群崩溃的情况出现,可以马上切换流量到其他集群提供服务,快速实现应用的恢复。 Gitops 统一发布 同时 Rancher 也内置了 Gitops 工具 Fleet,实现海量集群同步分发 将应用代码和构建 Docker 镜像的 Dockerfile 文件放置到 Gitlab 对应项目中 在 Gitlab 中创建用于专门用于存放部署 yaml 的项目 配置 CI 工具用于代码编译镜像构建和业务 yaml 文件修改 配置 Rancher-Fleet 检测存放部署 yaml 的项目,有更新后自动部署到对应环境中 点击持续交付功能创建 Fleet 规则 配置对接 git 仓库存放应用部署 yaml 的路径 可以选择部署到全部集群还是指定集群,或通过标签灵活定义的集群组中 完成后可以看见应用部署的状态,后续也会实时检测 git 仓库中的变化,进行自动部署 多集群监控 每个集群可以部署独立的 Prometheus,对单独集群进行监控,可支持对容器云平台以下维度的监控: 集群总体资源使用情况 节点资源使用情况 组件性能监控 应用容器 POD 资源使用监控 但在多集群场景下,单独集群监控需要一个一个点进去,并且人工分析数据,更大的作用是故障后的问题排查,并不能很好地提前发现问题。更好的处理方式是将纳管的全部集群监控数据进行汇总和分析展示。如:内存、CPU、网络流量最高的 top 10(集群、主机、POD);重启次数最多的 top 10 POD;全部集群 Error 事件统一展示;以便更好地帮助平台运维提前发现风险点。 全局监控主要通过 Thanos 实现,会在每个集群的 Prometheus 上通过 Thanos sidecar。对于单个集群的短期数据,Prometheus 通过 local-pv 存储到本地磁盘;而长期数据则通过 Thanos-sidecar 存储到 s3 协议的对象存储中。 安全 随着 Kubernetes 在业务中的广泛使用,容器安全问题正逐步受到重视。容器云平台的安全涉及到镜像安全、集群安全以及容器运行时安全,同时也涉及到租户网络隔离、用户及用户权限控制。Rancher 集成了容器安全平台 SUSE NeuVector,可以更好地保护用户的平台安全。 NeuVector 本身也支持多集群管理、策略统一下发和规则统一管理。 审计日志 为了满足我国本土用户需求,Rancher 企业版在 UI上集成了多维度审计日志展示功能(什么人在什么时间操作了什么资源对象,结果是什么)。通过审计日志,平台管理员可以快速查看到平台的操作记录,方便进行审计。 准入策略控制及网络微隔离 SUSE NeuVector 是业界首个 100% 开源的零信任容器安全平台,在 Rancher 新版本中已经进行了集成,可直接部署使用。NeuVector 可实现以下功能 1、准入策略控制 进入NeuVector进行配置 2、在准入控制菜单添加以下策略 由于容器运行期间会共享宿主机的内核、存储和端口,所以在实际生产环境中,误操作或平台被入侵将影响宿主机上其他应用 Pod 的正常运行,因此需要针对集群进行 Pod 的安全策略控制,以此来保证主机安全。 禁止使用特权容器 禁止从父进程获取更多权限 限制使用主机 IPC 限制只能只读根文件系统 限制 HostPath 路径 限制 HostPort 使用范围 3、网络动态微隔离 集群内 POD 间需要进行网络微隔离,提高安全性,避免 POD 被入侵后互相影响。NeuVector 将每个 workload 识别为一个组,通过对组进行策略控制,并且每个组默认会自动学习对应的网络连接规则和启动进程,并生成白名单。 NeuVector 的组支持 3 种模式:学习模式、监控模式和保护模式。各个模式实现作用如下。 学习模式:学习和记录容器、主机间网络连接情况和进程执行信息。自动构建网络规则白名单,保护应用网络正常行为。为每个服务的容器中运行的进程设定安全基线,并创建进程配置文件规则白名单。 监控模式:NeuVector 监视容器和主机的网络和进程运行情况,遇到非学习模式下记录的行为将在 NeuVector 中进行告警。监控模式不会消耗资源。 保护模式:NeuVector 监视容器和主机的网络和进程运行情况,遇到非学习模式下记录的行为直接拒绝。保护模式是直接拒绝非白名单的访问请求,执行器需要 CPU 和内存通过深度数据包检查来过滤连接,进行判断处理,所以会消耗更多的 CPU 资源。 新建的容器业务自动发现后默认为学习模式,也可以通过设置将默认模式设置为监控模式或保护模式。 总结 总之,Rancher 的多集群管理能力(多集群管理、多集群应用统一发布、多集群监控)和 Kubernetes 生命周期安全支持可以帮助企业提升部署效率,降低运维成本,是出海企业进行全球化部署的明智选择。

优秀的个人博客,低调大师

MySQL 中存储时间的最佳实践

平时开发中经常需要记录时间,比如用于记录某条记录的创建时间以及修改时间。在数据库中存储时间的方式有很多种,比如 MySQL 本身就提供了日期类型,比如 DATETIME,TIMESTAMEP 等,我们也可以直接存储时间戳为 INT 类型,也有人直接将时间存储为字符串类型。 那么到底哪种存储时间的方式更好呢? 不要使用字符串存储时间类型 这是初学者很容易犯的错误,容易直接将字段设置为 VARCHAR 类型,存储"2021-01-01 00:00:00"这样的字符串。当然这样做的优点是比较简单,上手快。 但是极力不推荐这样做,因为这样做有两个比较大的问题: 字符串占用的空间大 这样存储的字段比较效率太低,只能逐个字符比较,无法使用 MySQL 提供的日期API MySQL 中的日期类型 MySQL 数据库中常见的日期类型有 YEAR、DATE、TIME、DATETIME、TIMESTAMEP。因为一般都需要将日期精确到秒,其中比较合适的有DATETIME,TIMESTAMEP。 DATETIME DATETIME 在数据库中存储的形式为:YYYY-MM-DD HH:MM:SS,固定占用 8 个字节。 从 MySQL 5.6 版本开始,DATETIME 类型支持毫秒,DATETIME(N) 中的 N 表示毫秒的精度。例如,DATETIME(6) 表示可以存储 6 位的毫秒值。 TIMESTAMEP TIMESTAMP 实际存储的内容为‘1970-01-01 00:00:00’到现在的毫秒数。在 MySQL 中,由于类型 TIMESTAMP 占用 4 个字节,因此其存储的时间上限只能到‘2038-01-19 03:14:07’。 从 MySQL 5.6 版本开始,类型 TIMESTAMP 也能支持毫秒。与 DATETIME 不同的是,若带有毫秒时,类型 TIMESTAMP 占用 7 个字节,而 DATETIME 无论是否存储毫秒信息,都占用 8 个字节。 类型 TIMESTAMP 最大的优点是可以带有时区属性,因为它本质上是从毫秒转化而来。如果你的业务需要对应不同的国家时区,那么类型 TIMESTAMP 是一种不错的选择。比如新闻类的业务,通常用户想知道这篇新闻发布时对应的自己国家时间,那么 TIMESTAMP 是一种选择。Timestamp 类型字段的值会随着服务器时区的变化而变化,自动换算成相应的时间,说简单点就是在不同时区,查询到同一个条记录此字段的值会不一样。 TIMESTAMP 的性能问题 TIMESTAMP 还存在潜在的性能问题。 虽然从毫秒数转换到类型 TIMESTAMP 本身需要的 CPU 指令并不多,这并不会带来直接的性能问题。但是如果使用默认的操作系统时区,则每次通过时区计算时间时,要调用操作系统底层系统函数 __tz_convert(),而这个函数需要额外的加锁操作,以确保这时操作系统时区没有修改。所以,当大规模并发访问时,由于热点资源竞争,会产生两个问题: 性能不如 DATETIME:DATETIME 不存在时区转化问题。 性能抖动:海量并发时,存在性能抖动问题。 为了优化 TIMESTAMP 的使用,建议使用显式的时区,而不是操作系统时区。比如在配置文件中显示地设置时区,而不要使用系统时区: [mysqld] time_zone = "+08:00" 简单总结一下这两种数据类型的优缺点: DATETIME 没有存储的时间上限,而TIMESTAMP存储的时间上限只能到‘2038-01-19 03:14:07’ DATETIME 不带时区属性,需要前端或者服务端处理,但是仅从数据库保存数据和读取数据而言,性能更好 TIMESTAMP 带有时区属性,但是每次需要通过时区计算时间,并发访问时会有性能问题 存储 DATETIME 比 TIMESTAMEP 多占用一部分空间 数值型时间戳(INT) 很多时候,我们也会使用 int 或者 bigint 类型的数值也就是时间戳来表示时间。 这种存储方式的具有 Timestamp 类型的所具有一些优点,并且使用它的进行日期排序以及对比等操作的效率会更高,跨系统也很方便,毕竟只是存放的数值。缺点也很明显,就是数据的可读性太差了,你无法直观的看到具体时间。 如果需要查看某个时间段内的数据 select * from t where created_at > UNIX_TIMESTAMP('2021-01-01 00:00:00'); DATETIME vs TIMESTAMP vs INT,怎么选? 每种方式都有各自的优势,下面再对这三种方式做一个简单的对比: TIMESTAMP 与 INT 本质一样,但是相比而言虽然 INT 对开发友好,但是对 DBA 以及数据分析人员不友好,可读性差。所以《高性能 MySQL 》的作者推荐 TIMESTAMP 的原因就是它的数值表示时间更加直观。下面是原文: 至于时区问题,可以由前端或者服务这里做一次转化,不一定非要在数据库中解决。 总结 本文比较了几种最常使用的存储时间的方式,我最推荐的还是 DATETIME。理由如下: TIMESTAMP 比数值型时间戳可读性更好 DATETIME 的存储上限为 9999-12-31 23:59:59,如果使用 TIMESTAMP,则 2038 年需要考虑解决方案 DATETIME 由于不需要时区转换,所以性能比 TIMESTAMP 好 如果需要将时间存储到毫秒,TIMESTAMP 要 7 个字节,和 DATETIME 8 字节差不太多 推荐阅读 技术选型:为什么批处理我们却选择了Flink Redis 存储对象信息是用 Hash 还是 String

优秀的个人博客,低调大师

Doris 最佳实践-Compaction调优(2)

本文是 Compaction 调优系列文章的第二篇。在[前一篇文章]中我们介绍了Compaction的一些基本概念。这里我们回顾下两个重要概念: 每个 BE 节点上的 Compaction 操作都是独立进行的。Compaction 的对象是单个 BE 节点上的全部数据分片。 Compaction 分为 Base Compaction(BC) 和 Cumulative Compaction(CC),由Cumulative Point(CP) 划分,根据一定策略,选择一组rowset进行Compaction。 本文将继续从以下两个方面深入了解 Compaction Compaction 机制是如何挑选数据分片进行 Compaction 的。 对于一个数据分片,Compaction 机制是如何确定哪些数据版本参与 Compaction 的。 数据分片选择策略 Compaction 的目的是合并多个数据版本,一是避免在读取时大量的 Merge 操作,二是避免大量的数据版本导致的随机IO。因此,Compaction 策略的重点问题,就是如何选择合适的 tablet,以保证节点上不会出现数据版本过多的数据分片。 Compaction 分数 一个自然的想法,就是每次都选择数据版本最多的数据分片进行 Compaction。这个策略也是 Doris 的默认策略。这个策略在大部分场景下都能很好的工作。但是考虑到一种情况,就是版本多的分片,可能并不是最频繁访问的分片。而 Compaction 的目的就是优化读性能。那么有可能某一张 “写多读少” 表一直在 Compaction,而另一张 “读多写少”的表不能及时的 Compaction,导致读性能变差。 因此,Doris 在选择数据分片时还引入了 “读取频率” 的因素。“读取频率” 和 “版本数量”会根据各自的权重,综合计算出一个 Compaction 分数,分数越高的分片,优先做 Compaction。这两个因素的权重由以下 BE 参数控制(取值越大,权重越高): compaction_tablet_scan_frequency_factor:“读取频率” 的权重值,默认为 0。 compaction_tablet_compaction_score_factor:“版本数量” 的权重,默认为 1。 “读取频率” 的权重值默认为0,即默认仅考虑“版本数量” 这个因素。_ 生产者与消费者 Compaction 是一个 生产者-消费者模型。由一个生产者线程负责选择需要做 Compaction 的数据分片,而多个消费者负责执行 Compaction 操作。 生产者线程只有一个,会定期扫描所有 tablet 来选择合适的 compaction 对象。因为 Base Compaction 和 Cumulative Compaction 是不同类型的任务,因此目前的策略是每生成 9 个 CC 任务,生成一个 BC 任务。任务生成的频率由以下两个参数控制: cumulative_compaction_rounds_for_each_base_compaction_round:多少个CC任务后生成一个BC任务。 generate_compaction_tasks_min_interval_ms:任务生成的间隔。 这两个参数通常情况下不需要调整。_ 生产者线程产生的任务会被提交到消费者线程池。因为 Compaction 是一个IO密集型的任务,为了保证 Compaction 任务不会过多的占用IO资源,Doris 限制了每个磁盘上能够同时进行的 Compaction 任务数量,以及节点整体的任务数量,这些限制由以下参数控制: compaction_task_num_per_disk:每个磁盘上的任务数,默认为2。该参数必须大于等于2,以保证 BC 和 CC 任务各自至少有一个线程。 max_compaction_threads:消费者线程,即Compaction线程的总数。默认为 10。 举个例子,假设一个 BE 节点配置了3个数据目录(即3块磁盘),每个磁盘上的任务数配置为2,总线程数为5。则同一时间,最多有5个 Compaction 任务在进行,而每块磁盘上最多有2个任务在进行。并且最多有3个 BC 任务在进行,因为每块盘上会自动预留一个线程给CC任务。 另一方面,Compaction 任务同时也是一个内存密集型任务,因为其本质是一个多路归并排序的过程,每一路是一个数据版本。如果一个 Compaction 任务涉及的数据版本很多,则会占用更多的内存,如果仅限制任务数,而不考虑任务的内存开销,则有可能导致系统内存超限。因此,Doris 在上述任务个数限制之外,还增加了一个任务配额限制: total_permits_for_compaction_score:Compaction 任务配额,默认 10000。 每个 Compaction 任务都有一个配额,其数值就是任务涉及的数据版本数量。假设一个任务需要合并100个版本,则其配额为100。当正在运行的任务配额总和超过配置后,新的任务将被拒绝。 三个配置共同决定了节点所能承受的 Compaction 任务数量。 数据版本选择策略 一个 Compaction 任务对应的是一个数据分片(Tablet)。消费线程拿到一个 Compaction 任务后,会根据 Compaction 的任务类型,选择 tablet 中合适的数据版本(Rowset)进行数据合并。下面分别介绍 Base Compaction 和 Cumulative Compaction 的数据分片选择策略。 Base Compaction 前文说过,BC 任务是增量数据和基线数据的合并任务。并且只有比 Cumulative Point(CP) 小的数据版本才会参与 BC 任务。因此,BC 任务的数据版本选取策略比较简单。 首先,会选取所有版本在0 到 CP之间的 rowset。然后根据以下几个配置参数,判断是否启动一个 BC 任务: base_compaction_num_cumulative_deltas:一次 BC 任务最小版本数量限制。默认为5。该参数主要为了避免过多 BC 任务。当数据版本数量较少时,BC 是没有必要的。 base_compaction_interval_seconds_since_last_operation:第一个参数限制了当版本数量少时,不会进行 BC 任务。但我们需要避免另一种情况,即某些 tablet 可能仅会导入少量批次的数据,因此当 Doris 发现一个 tablet 长时间没有执行过 BC 任务时,也会触发 BC 任务。这个参数就是控制这个时间的,默认是 86400,单位是秒。 以上两个参数通常情况下不需要修改,在某些情况下如何需要想尽快合并基线数据,可以尝试改小 base_compaction_num_cumulative_deltas 参数。但这个参数只会影响到 “被选中的 tablet”。而 “被选中” 的前提是这个 tablet 的数据版本数量是最多的。_ Cumulative Compaction CC 任务只会选取版本比 CP 大的数据版本。其本身的选取策略也比较简单,即从 CP 版本开始,依次向后选取数据版本。最终的数据版本集合由以下参数控制: min_cumulative_compaction_num_singleton_deltas:一次 CC 任务最少的版本数量限制。这个配置是和 cumulative_size_based_compaction_lower_size_mbytes 配置同时判断的。即如果版本数量小于阈值,并且数据量也小于阈值,则不会触发 CC 任务。以避免躲过不比较的 CC 任务。默认是5。 max_cumulative_compaction_num_singleton_deltas:一次 CC 任务最大的版本数量限制。以防止一次 CC 任务合并的版本数量过多,占用过多资源。默认是1000。 cumulative_size_based_compaction_lower_size_mbytes:一次 CC 任务最少的数据量,和min_cumulative_compaction_num_singleton_delta 同时判断。默认是 64,单位是 MB。 简单来说,默认配置下,就是从 CP 版本开始往后选取 rowset。最少选5个,最多选 1000 个,然后判断数据量是否大于阈值即可。 CC 任务还有一个重要步骤,就是在合并任务结束后,设置新的 Cumulative Point。CC 任务合并完成后,会产生一个合并后的新的数据版本,而我们要做的就是判断这个新的数据版是 “晋升” 到 BC 任务区,还是依然保留在 CC 任务区。举个例子: 假设当前 CP 是 10。有一个 CC 任务合并了 [10-13] [14-14] [15-15] 后生成了 [10-15] 这个版本。如果决定将 [10-15] 版本移动到 BC 任务区,则需修改 CP 为 15,否则 CP 保持不变,依然为 10。 CP 只会增加,不会减少。以下参数决定了是否更新 CP: cumulative_size_based_promotion_ratio:晋升比率。默认 0.05。 cumulative_size_based_promotion_min_size_mbytes:最小晋升大小,默认 64,单位 MB。 cumulative_size_based_promotion_size_mbytes:最大晋升大小,默认 1024,单位 MB。 以上参数比较难理解,这里我们先解释下 “晋升” 的原则。一个 CC 任务生成的 rowset 的晋升原则,是其数据大小和基线数据的大小在 “同一量级”。这个类似 2048 小游戏,只有相同的数字才能合并形成更大的数字。而上面三个参数,就是用于判断一个新的rowset是否匹配基线数据的数量级。举例说明: 在默认配置下,假设当前基线数据(即所有 CP 之前的数据版本)的数据量为 10GB,则晋升量级为 (10GB * 0.05)512MB。这个数值大于 64 MB 小于 1024 MB,满足条件。所以如果 CC 任务生成的新的 rowset 的大小大于 512 MB,则可以晋升,即 CP 增加。而假设基线数据为 50GB,则晋升量级为(50GB * 0.05)2.5GB。这个数值大于 64 MB 也大于 1024 MB,因此晋升量级会被调整为 1024 MB。所以如果 CC 任务生成的新的 rowset 的大小大于 1024 MB,则可以晋升,即 CP 增加。 从上面的例子可以看出,cumulative_size_based_promotion_ratio 用于定义 “同一量级”,0.05 即表示数据量大于基线数据的 5% 的 rowset 都有晋升的可能,而 cumulative_size_based_promotion_min_size_mbytes 和 cumulative_size_based_promotion_size_mbytes 用于保证晋升不会过于频繁或过于严格。 >这三个参数会直接影响 BC 和 CC 任务的频率,尤其在高频导入场景下需要适当调整。我们会在后续文章中举例说明。 其他 Compaction 参数和注意事项 还有一些参数和 Compaction 相关,在某些情况下需要修改: disable_auto_compaction:默认为 false,修改为 true 则会禁止 Compaction 操作。该参数仅在一些调试情况,或者 compaction 异常需要临时关闭的情况下才需使用。 Delete灾难 通过 DELETE FROM 语句执行的数据删除操作,在 Doris 中也会生成一个数据版本用于标记删除。这种类型的数据版本比较特殊,我们成为 “删除版本”。删除版本只能通过 Base Compaction 任务处理。因此在在遇到删除版本时,Cumulative Point 会强制增加,将删除版本移动到 BC 任务区。因此数据导入和删除交替发生的场景通常会导致 Compaction 灾难。比如以下版本序列: [0-10] [11-11] 删除版本 [12-12] [13-13] 删除版本 [14-14] [15-15] 删除版本 [16-16] [17-17] 删除版本 .... 在这种情况下,CC 任务几乎不会 被触发(因为CC任务只能选择一个版本,而无法处理删除版本),所有版本都会交给 Base Compaction 处理,导致 Compaction 进度缓慢。目前Doris还无法很好的处理这种场景,因此需要在业务上尽量避免。 未完待续 本文介绍了 Doris Compaction 任务的生成逻辑和执行逻辑。并且介绍了相关控制参数。接下来的文章,将通过一些具体场景来介绍调整 Compaction 参数的思路,以满足业务需求。 【往期回顾】 【Doris Weekly】2020.05.25~2021.06.08 【Doris Weekly】2021.05.10~2021.05.24 【Doris Weekly】2021.04.26~2021.05.09 【精彩文章】 Apache Doris Roadmap 2021 【Doris功能介绍】proc系统 【Doris全面解析】Doris Compaction 机制解析

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册