首页 文章 精选 留言 我的

精选列表

搜索[解耦化],共10020篇文章
优秀的个人博客,低调大师

每日一博 | Android 资源溢出崩溃轻松解

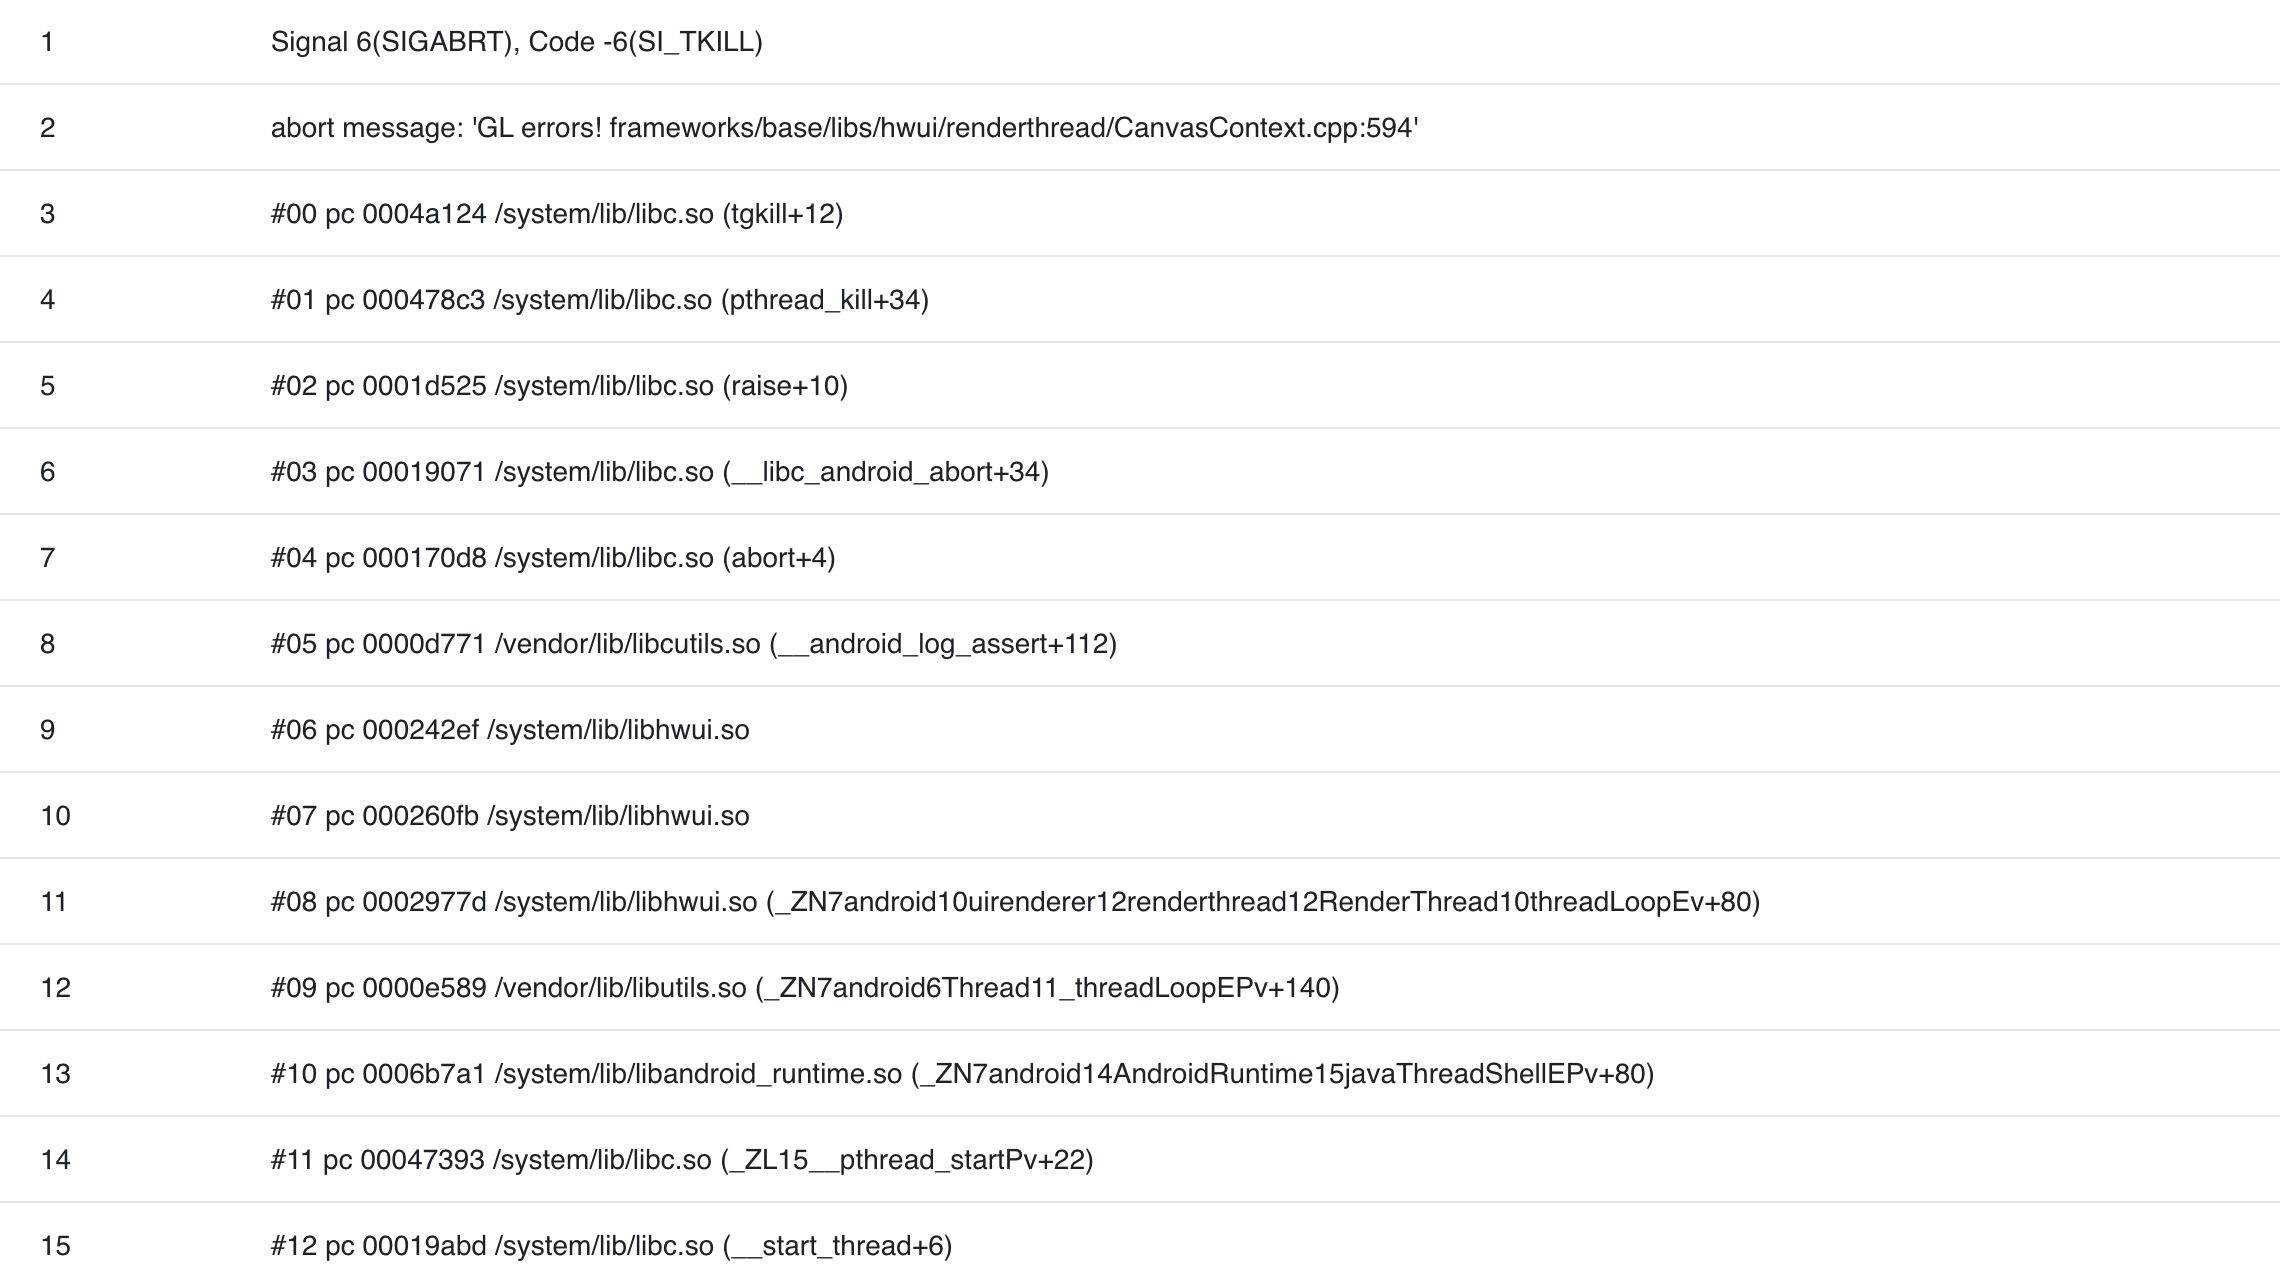
一、资源溢出是什么? 毫无疑问,应用的运行需要占用系统的资源。其中最为人所熟知的资源是内存,内存溢出便是耳熟能详的OOM。 常见的简单OOM一般可以通过堆栈来解决,如Java OOM,一部分可以直接从堆栈中看到哪里使用了多大内存导致了内存溢出,复杂一些的Java OOM,则可以使用其他分析工具来进行处理。但如果堆栈里看不出来呢?或者它不是Java崩溃呢? java.lang.OutOfMemoryError:Failedtoallocatea3237132byteallocationwith1612328freebytesand1574KBuntilOOM 比如下面这样的Native崩溃,堆栈全是系统堆栈,不花时间去研究就很难确定此崩溃的原因(事实上这个崩溃也是一个OOM)。尤其是,我们并不能说这是系统代码的问题。 接下来本文将会介绍,对于这类崩溃如何进行识别、以及解决。 二、内存溢出(俗称OOM) 如下case: Signal6(SIGABRT),Code-1(SI_QUEUE) #00pc000604de/apex/com.android.runtime/lib/bionic/libc.so(abort+165) #01pc0003606d/system/lib/libc++.so(abort_message+88) #02pc000361f1/system/lib/libc++.so(_ZL28demangling_terminate_handlerv+160) #03pc00045e4b/system/lib/libc++.so(_ZSt11__terminatePFvvE+2) #04pc00045653/system/lib/libc++.so(_ZN10__cxxabiv1L12failed_throwEPNS_15__cxa_exceptionE+12) #05pc000455b5/system/lib/libc++.so(__cxa_throw+72) #06pc00047c6d/system/lib/libc++.so(_Znwj+52) #07pc0000132b/system/lib/libbinderthreadstate.so(_ZNSt3__15dequeIN7android18IPCThreadStateBase9CallStateENS_9allocatorIS3_EEE19__add_back_capacityEv+186) #08pc0000120b/system/lib/libbinderthreadstate.so(_ZNSt3__15dequeIN7android18IPCThreadStateBase9CallStateENS_9allocatorIS3_EEE12emplace_backIJRS3_EEES8_DpOT_+52) #09pc0000115f/system/lib/libbinderthreadstate.so(_ZN7android18IPCThreadStateBase16pushCurrentStateENS0_9CallStateE+18) #10pc0003b901/system/lib/libbinder.so(_ZN7android14IPCThreadState14executeCommandEi+608) #11pc0003b5db/system/lib/libbinder.so(_ZN7android14IPCThreadState20getAndExecuteCommandEv+98) #12pc0003bb7b/system/lib/libbinder.so(_ZN7android14IPCThreadState14joinThreadPoolEb+38) #13pc00054de5/system/lib/libbinder.so(_ZN7android10PoolThread10threadLoopEv+12) #14pc0000d96f/system/lib/libutils.so(_ZN7android6Thread11_threadLoopEPv+210) #15pc00080eb5/system/lib/libandroid_runtime.so(_ZN7android14AndroidRuntime15javaThreadShellEPv+88) #16pc000ab3dd/apex/com.android.runtime/lib/bionic/libc.so(_ZL15__pthread_startPv+20) #17pc00061989/apex/com.android.runtime/lib/bionic/libc.so(__start_thread+30) 特征很明显,堆栈全是系统代码(/system/lib/xxx)。 这时候 无法一眼看出代码问题,那么就 可以怀疑下内存原因。 2.1 崩溃原因 众所周知,32位CPU寻址范围最大可以到2的32次方 = 4GB,其实就是 32位操作系统最大支持 4G内存。 如果你试图装过系统就会明白,32位操作系统下,内存不可能达到4G以上,一般会是3G左右。 为什么是3G?因为还有 1G被系统吃掉了(不一定真的是1G,可多可少但不会差的远),它们用于操作系统内核相关的运作,如下图。 这里直接 总结重点: 32位的App在 32位的手机操作系统上使用 超过3G的内存,极大概率会发生 Native崩溃; 32位的App在 64位的手机操作系统上使用 超过4G的内存,极大概率会发生 Native崩溃; 其中前者容易理解,1G被系统吃了,就剩下了3G;后者是因为64位手机上,系统是64位的,所以不需要跟App抢那4G空间。 至于64位App,可用内存已经突破天际(所以开发64位app将会减少大量Native崩溃)…… 几种主流内存占用类型,可以文末会给出一个总结。 需要注意,这里提到的内存,均为 虚拟内存(可以回忆回忆学校学的操作系统知识,网上搜索瞅瞅)。 2.2 定位解决 这里需要用到的工具为应用性能监控全链路版(APMPlus),APMPlus是字节跳动应用开发套件MARS下的性能监控产品,通过先进的数据采集与监控技术,为企业提供全链路的应用性能监控服务,解决企业对各端监控的需求。具备非侵入式监控、丰富的异常现场还原能力,助力企业提升异常问题排查与解决的效率、优化应用品质,以降低成本提高收入。 经过多年技术积累、亿级用户验证,APMPlus 集崩溃监控、上报、分析、归因于一体,可以轻松定位各种线上疑难杂症,更有超详细 性能、卡顿、打点等全流程监控处理工具,覆盖近乎一切线上问题的处理。并拥有多个外部客户的实践,如:虎扑、作业帮、甄云科技等,为企业和开发者提供 一站式APM服务。 我们直接在 A PMPlus 平台中查看崩溃,点击“ Native 信息 -> Maps详情”,查看 虚拟内存占用。 一眼看出,这个内存占用明显接近上一节中提到的 内存占满的阈值(32App在64位设备上最多使用4G内存)!此时基本可以确认,该崩溃为内存占满导致的Native崩溃,即Native OOM。 知道是Native OOM就完了? 再点一个按钮,直接告诉你怎么解决:“ Native 信息 -> Maps智能归类”,查看 虚拟内存占用分布。 我们可以看到,这里直接提示出三个地方占用的虚拟内存最多,分别是Java runtime、Thread、Files;其中 Thread占用最多,高达2.59GB! 直接根据提示,逐级展开内存占用最多的条目: 立即破案:doTestThread 线程过多导致虚拟内存占满!接下来只需要去代码里看,哪里创建的这个线程,便可进行问题解决。 类似的,一旦在崩溃中发现Maps智能归类中给出的任意一个条目过高,都可以确认出Native OOM的原因;假如发现Files条目占用内存达到了2G,那么只需根据内存名即可确认什么文件占用内存多,从而进行问题定位解决。 其中由于 “ Java runtime”条目占用起点较高,其内包含Java堆内存等虚拟机自用区域,基本上固定占用1G上下,且一般情况下其占用不会受我们的代码控制,所以需要注意不要被它混淆了视线, 优先关注其他条目即可。 另外,Thread内存占用过多且需要查看线程的详细信息时,可以在“Native信息 -> 线程状态”中查看。 注:不同App下,虚拟内存分布的结果都有不同,具体分析需联系自身App正常情况下的内存分布来确认问题。 2.3 内存类型简要解释 ApmInsight平台当前的内存分类方式: Java runtime:安卓系统Java虚拟机占用,一般App默认会占用1G以上,可降低关注优先级 Native Heap:C代码使用的堆内存大小,如malloc调用分配的内存等,都会在这里体现; Thread:线程使用的内存大小,默认情况下每个线程启动后(Java、Native均如此)便会占用1M内存 Files:映射入内存中的文件,一般由C代码中调用mmap直接加载文件到内存里,Java中使用FileInputStream不会在这里体现 Devices:设备相关内存使用 nameless:部分没有名字的未知内存使用 Other:其他未识别内存 三、FD溢出 如下case: Signal6(SIGABRT),Code-1(SI_QUEUE) abortmessage:'Couldnotmakewakeeventfd:Toomanyopenfiles' #00pc000604de/apex/com.android.runtime/lib/bionic/libc.so(abort+165) #01pc00005a95/system/lib/liblog.so(__android_log_assert+176) #02pc000100bf/system/lib/libutils.so(_ZN7android6LooperC2Eb+218) #03pc000d3c51/system/lib/libandroid_runtime.so(_ZN7android18NativeMessageQueueC1Ev+112) #04pc000d424d/system/lib/libandroid_runtime.so(_ZN7androidL34android_os_MessageQueue_nativeInitEP7_JNIEnvP7_jclass+12) #05pc002920e7/system/framework/arm/boot-framework.oat(art_jni_trampoline+94) #06pc000d7bc5/apex/com.android.runtime/lib/libart.so(art_quick_invoke_stub_internal+68) ...... #30pc003afb7f/apex/com.android.runtime/lib/libart.so(_ZN3art6Thread14CreateCallbackEPv+1018) #31pc000ab3dd/apex/com.android.runtime/lib/bionic/libc.so(_ZL15__pthread_startPv+20) #32pc00061989/apex/com.android.runtime/lib/bionic/libc.so(__start_thread+30) 同样的,堆栈基本无意义,但有一句看起来能看懂的“Too many open files”。 3.1 崩溃原因 FD即文件描述符(File Descriptor),打开一个文件就占用一个。 看起来没什么的,大家读写文件都是常规操作,一个App产生千八百个文件不过分吧。 但是,系统会 限制单个App打开的 FD 个数! 该数字在部分低版本安卓机上 一般为1024,也就是你打开1024个FD后,就不能再打开了,有时候就会因此 产生Native崩溃。 3.2 定位解决 直接点开“ Native 信息 -> FD 归类”,来确认是不是 FD 过多导致的崩溃。 很明显,确实可以看到使用的FD过多,达到了3万以上。向下滚动可以直接看到App在运行时到底打开了哪些文件,只要找到打开的文件名,便能轻松解决此类崩溃。 四、总结 本文提到的两种崩溃类型,本质上都是 系统、应用资源不足下产生的。 资源不足实际上并不会直接导致崩溃,但是会 使某些系统调用返回出错,如open打开文件失败返回无效值、malloc分配内存失败返回无效值等。这些返回的无效值如果在使用时未做合理容错判断,则会 引起如空指针等这样的代码错误。 更多的崩溃问题归类及解析,将在应用性能监控全链路版(APMPlus)上及后续的文章中进行补充。 如果还未接入使用 应用性能监控全链路版(APMPlus),也可以立刻开始进行免费试用,目前 APMPlus面向新用户提供 试用30 天的限时免费服务。其中包含 App 监控、Web 监控、Server 监控、小程序 监 控,App 监控和 Web 监控各500 万条事件量, Server 与小程序监控限时不限量。

优秀的个人博客,低调大师

解Bug之路-dubbo应用无法重连zookeeper

前言 dubbo是一个成熟且被广泛运用的框架。饶是如此,在某些极端条件下基于dubbo的应用还会出现无法重连zookeeper的问题。由于此问题容易导致比较大的故障,所以笔者费了一番功夫去定位,现将排查过程写成博文分享出来。 Bug现场 这是一起在测试环境出现的故障。起因是网工做交换机切换演练,可能由于姿势不对,使得断网的时间从预估的秒级达到了分钟级。等网络恢复后,测试环境就炸开了锅,基本上所有应用再也无法提供服务,在dubbo控制台上也看不到任何提供者,他们和zk的连接都断开而且似乎完全没有重连的迹象。如下图所示: 无法快速恢复 为了不影响测试的进度,运维同学紧急进行了重启,但坑爹的是大部分系统都有启动依赖,盲目的重启只会因为xxx provider不存在而无法启动。只能从最基础的服务开始重启,慢慢恢复。如下图所示: 还好只是测试环境,但为了不让产线出现这种问题,必须一查到底,把这个Bug揪出来。 着手排查 模拟zookeeper连接断开 测试环境的好处是我们可以用各种手段去模拟复现,而不用和处理产线一样到处寻找蛛丝马迹然后进行逻辑推理(推理是一个非常烧脑的过程)。于是笔者联系了SA同学,通过iptables进行线下的断网模拟。命令如下所示: // 禁用本机和zk三台机器的流量进出 iptables -A INPUT -s zk-1-ip/32 -j DROP iptables -A INPUT -s zk-2-ip/32 -j DROP iptables -A INPUT -s zk-3-ip/32 -j DROP iptables -A OUTPUT -s zk-1-ip/32 -j DROP iptables -A OUTPUT -s zk-2-ip/32 -j DROP iptables -A OUTPUT -s zk-3-ip/32 -j DROP 拓扑图如下: 发现在drop对zk的包之后,不管等待多长时间,只要连接一放开,立马就能重连zk! 看来dubbo对zookeeper的重连还是非常靠谱的。 同时模拟DNS断开 由于模拟zk断开不会导致无法重连的现象。于是笔者开始思考,是否交换机异常的时候导致了所有的包都无法发送/接收,而导致重连出问题的并不是对zookeeper发起连接。于是笔者看了看配置,是否还有其它和重连有关联的点,仔细观察下这个配置: // 这其中有一个不容易注意到的点,就是域名解析也需要网络包的交互 dubbo.registry.address=zookeeper://dubbo-1.com?back=dubbo-2.com,dubbo-3.com 难道是DNS访问不到导致了这一问题?反正测试环境,继续模拟一发,命令如下所示: // 禁用本机和zk三台机器的流量进出 iptables -A INPUT -s zk-1-ip/32 -j DROP iptables -A INPUT -s zk-2-ip/32 -j DROP iptables -A INPUT -s zk-3-ip/32 -j DROP iptables -A OUTPUT -s zk-1-ip/32 -j DROP iptables -A OUTPUT -s zk-2-ip/32 -j DROP iptables -A OUTPUT -s zk-3-ip/32 -j DROP // 禁用本机和DNS两台机器的流量进出 iptables -A INPUT -s dns-ip/32 -j DROP iptables -A INPUT -s dns-ip/32 -j DROP iptables -A OUTPUT -s dns-ip/32 -j DROP iptables -A OUTPUT -s dns-ip/32 -j DROP 网络拓扑如下: 这次我们在禁用流量后,故意先放开对zk的流量,再放开对DNS的流量,如下图所示: 看来在dubbo对zookeeper重连过程中,如果DNS也无法响应,是会出现网络恢复后也再也无法重连的现象。但是,我们并不能下判断交换机的故障导致的无法重连肯定是这个Bug引起。需要找到证据来证明这一点! 它山之石,可以攻玉 有了DNS这个信息后,先google一下,看看能否有其它人遇到过这个坑。于是找到了这个链接 https://github.com/sgroschupf/zkclient/issues/23 按照github上的描述,zkclient在UnknownHostException抛出之后再也无法重连zookeeper。不过他是在Kafka中遇到的,但他推断所有用低版本org.apache.zookeper的都会有这个问题。按照上面给出的Bug Fix链接 https://issues.apache.org/jira/browse/ZOOKEEPER-1576 笔者发现其在3.5.0修复 于是将对应的应用的org.apache.zookeeper版本升级到3.5.5版本,重新实验后,发现问题解决了! 这里有个小技巧,我们可以通过 zip -d xxx.jar WEB-INF/lib/zookeeper-3.4.8.jar zip -r 0 xxx.jar WEB-INF/lib/zookeeper-3.5.5.jar // 以及zip -r 其它zookeeper-3.5.5新依赖的包 使得不用重新编译打包的方式即可修改应用使用的jar包版本,这样在快速验证的时候就不需要通知对应的开发修改依赖了。 寻找支持jdk1.6的zookeeper jar包 由于笔者所在的产线环境有很多老系统用的jdk1.6,而zookeeper-3.5.5之支持1.8及以上版本,所以需要寻找能够给jdk1.6使用的包。此时,笔者的同事由于负责kafka,其对kafa做过混沌测试,坚信kafka没有这个问题,于是笔者就用kafka依赖的zookeeper-3.4.13包继续进行测试,发现zookeeper-3.4.13也是okay的,具体代码改动将会在下面讲到。 搜索日志寻找证据 由于可能是UnknownHostException导致了这一问题,笔者在出问题的应用里面寻找,确实发现了UnknownHostException。日志如下所示: // 下面过滤了一大堆disconnected连接断开日志,只列出核心有关的 2020-03-19 21:06:28.926 [DubboZkclientConnector-EventThread] zookeeper state changed (Disconnected) 2020-03-19 21:06:28.926 [ZkClient-EventThread-101-dubbo.com] Zookeeper失去连接 2020-03-19 21:06:49.758 [DubboZkclientConnector-EventThread] zookeeper state changed (Expired) 2020-03-19 21:06:49:759 [DubboZkclientConnecto-SendThread] Unable to reconnect to ZooKeeper sercice ,session 0xXXXXX has expired 2020-03-19 21:07:29.793 [DubboZkclientConnector-EventThread] ERROR ClientCxnn - Error while calling watcher java.lang.RuntimeException: Exception while restarting zk client ...... ...... Caused by: java.net.UnknownHostException: dubbo-1.com at...lookupAllHostAddr... ...... at...StaticHostProvier... ...... at...reconnect...[zookeeper-3.4.8.jar:3.4.8--1] 上面日志反应出在zookeeper session expired之后重新建立session的过程中如果抛出java.net.UnknownHostException后,zkclient对应的线程就再也不会有其它动作。 代码分析 旧版本代码逻辑 上面的证据再配合实验的结果基本就能确定这个DNS异常会导致dubbo无法重连zookeeper的现象。于是笔者开发翻阅代码,首先我们看下dubbo重连的逻辑: public class ZkclientZookeeperClient extends AbstractZookeeperClient<IZkChildListener> { ...... public ZkclientZookeeperClient(URL url) { super(url); client = new ZkClientWrapper(url.getBackupAddress(), 30000); client.addListener(new IZkStateListener() { public void handleStateChanged(KeeperState state) throws Exception { ZkclientZookeeperClient.this.state = state; if (state == KeeperState.Disconnected) { stateChanged(StateListener.DISCONNECTED); } else if (state == KeeperState.SyncConnected) { stateChanged(StateListener.CONNECTED); } } // 这边是session重建的过程 public void handleNewSession() throws Exception { stateChanged(StateListener.RECONNECTED); } }); client.start(); } ...... } // StateListener.RECONNECTED的处理在zookeeperResigry.java中 public class ZookeeperRegistry extends FailbackRegistry{ ...... zkClient.addStateListener(new StateListener() { // 在收到RECONNECTED事件后,进行recover也就是恢复的过程 public void stateChanged(int state) { if (state == RECONNECTED) { try { recover(); } catch (Exception e) { logger.error(e.getMessage(), e); } } } }); ...... } 由上面的代码我们可以得知,在session expired之后内部会重建session,在新建session之后,dubbo的Statelistener会发送reconnected事件从而执行恢复的过程,如下图所示: 那么我们看下UnknownHostException抛出后会导致什么现象,代码如下所示: public class ZkClient implements Watcher { ...... private void processStateChanged(WatchedEvent event) { // 这边对应于session expired日志 LOG.info("zookeeper state changed (" + event.getState() + ")"); setCurrentState(event.getState()); if (getShutdownTrigger()) { return; } try { fireStateChangedEvent(event.getState()); if (event.getState() == KeeperState.Expired) { // UnknownHostException就是在这抛出。 reconnect(); fireNewSessionEvents(); } } catch (final Exception e) { // 这边对应于Error while calling watcher日志 throw new RuntimeException("Exception while restarting zk client", e); } } ...... } 异常是在reconnect抛出的,异常抛出后,就不会运行fireNewSessionEvents这个逻辑,也就不会执行listener中的handleNewSession逻辑,进而不会recover,从而导致dubbo无法重连!如下图所示: 新版本如何修复 由于UnknownHostException是在StaticHostProviver中触发,在这边笔者给出了新旧版本的对应代码,旧版本zookeeper-3.4.8 public final class StaticHostProvider implements HostProvider{ ...... public StaticHostProvider(Collection<InetSocketAddress> serverAddresses) throws UnknownHostException { for (InetSocketAddress address : serverAddresses) { InetAddress ia = address.getAddress(); // 这边没有抓住UnknownHostException异常 InetAddress resolvedAddresses[] = InetAddress.getAllByName((ia!=null) ? ia.getHostAddress(): address.getHostName()); for (InetAddress resolvedAddress : resolvedAddresses) { ...... if (resolvedAddress.toString().startsWith("/") && resolvedAddress.getAddress() != null) { this.serverAddresses.add( new InetSocketAddress(InetAddress.getByAddress( address.getHostName(), resolvedAddress.getAddress()), address.getPort())); } else { this.serverAddresses.add(new InetSocketAddress(resolvedAddress.getHostAddress(), address.getPort())); } } } if (this.serverAddresses.isEmpty()) { throw new IllegalArgumentException( "A HostProvider may not be empty!"); } Collections.shuffle(this.serverAddresses); } ...... } 新版本zookeeper-3.4.13小小的重构了一下,将DNS的逻辑放到next函数里面并抓住了UnknownHostException异常。 public final class StaticHostProvider implements HostProvider{ ...... public InetSocketAddress next(long spinDelay) { currentIndex = ++currentIndex % serverAddresses.size(); if (currentIndex == lastIndex && spinDelay > 0) { try { Thread.sleep(spinDelay); } catch (InterruptedException e) { LOG.warn("Unexpected exception", e); } } else if (lastIndex == -1) { // We don't want to sleep on the first ever connect attempt. lastIndex = 0; } InetSocketAddress curAddr = serverAddresses.get(currentIndex); try { String curHostString = getHostString(curAddr); List<InetAddress> resolvedAddresses = new ArrayList<InetAddress>(Arrays.asList(this.resolver.getAllByName(curHostString))); if (resolvedAddresses.isEmpty()) { return curAddr; } Collections.shuffle(resolvedAddresses); return new InetSocketAddress(resolvedAddresses.get(0), curAddr.getPort()); } catch (UnknownHostException e) { // 就是这边抓住了UnknownHostException进而修复了这一问题 return curAddr; } } ...... } 我们可以看到新版zookeeper-3.4.13抓住了这个UnknownHostException进而修复了这一问题。 BUG触发条件复盘 在与zookeeper服务连接异常并session expired(默认30s),DNS缓存也超时(默认30s)同时用的低版本zookeeper jar包就很容易达成上述Bug的情况。而之前测试环境由于交换机切换的某些原因使得网络断开超过了30s从而诱发了这一问题。而且不仅仅是Dubbo,任何用zookeeper低版本jar包都有可能出现这个问题! 总结 海恩法则指出,每一起严重事故的背后,必然有29次轻微事故和300起未遂先兆以及1000起事故隐患。所以对测试环境的任何问题都要引起重视,从而把问题消灭在萌芽阶段。 公众号 关注笔者公众号,获取更多干货文章: 原文链接 https://my.oschina.net/alchemystar/blog/3222767

优秀的个人博客,低调大师

每日一博 | 解 Bug 之路-中间件

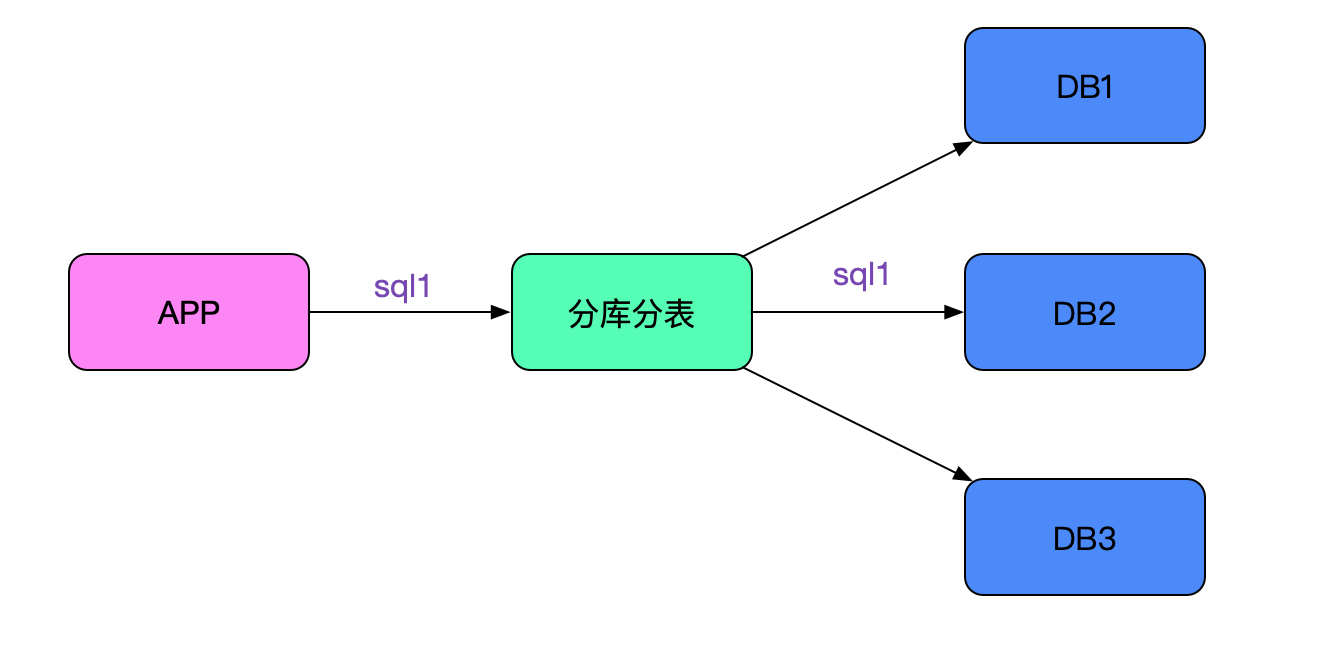
前言 我们的分库分表中间件在线上运行了两年多,到目前为止还算稳定。在笔者将精力放在处理各种灾难性事件(例如中间件物理机宕机/数据库宕机/网络隔离等突发事件)时。竟然发现还有一些奇怪的corner case。现在就将排查思路写成文章分享出来。 Bug现场 应用拓扑 应用通过中间件连后端多个数据库,sql会根据路由规则路由到指定的节点,如下图所示: 错误现象 应用在做某些数据库操作时,会发现有比较大的概率失败。他们的代码逻辑是这样: int count = updateSql(sql1); ... // 伪代码 int count = updateSql("update test set value =1 where id in ("100","200") and status = 1; if( 0 == count ){ throw new RuntimeException("更新失败"); } ...... int count = updateSql(sql3); ... 即每做一次update之后都检查下是否更新成功,如果不成功则回滚并抛异常。 在实际测试的过程中,发现经常报错,更新为0。而实际那条sql确实是可以更新到的(即报错回滚后,我们手动执行sql可以执行并update count>0)。 中间件日志 笔者根据sql去中间件日志里面搜索。发现了非常奇怪的结果,日志如下: 2020-03-13 11:21:01:440 [NIOREACTOR-20-RW] frontIP=>ip1;sqlID=>12345678;rows=>0;sql=>update test set value =1 where id in ("1","2") and status = 1;start=>11:21:01:403;time=>24266; 2020-03-13 11:21:01:440 [NIOREACTOR-20-RW] frontIP=>ip1;sqlID=>12345678;rows=>2;sql=>update test set value =1 where id in ("1","2") and status = 1;start=>11:21:01:403;time=>24591; 由于中间件对每条sql都标识了唯一的一个sqlID,在日志表现看来就好像sql执行了两遍!由于sql中有一个in,很容易想到是否被拆成了两条执行了。如下图所示: 这条思路很快被笔者否决了,因为笔者explain并手动执行了一下,这条sql确实只路由到了一个节点。真正完全否决掉这条思路的是笔者在日志里面还发现,同样的SQL会打印三遍!即看上去像执行了三次,这就和仅仅只in了两个id的sql在思路上相矛盾了。 数据库日志 那到底数据真正执行了多少条呢?找DBA去捞一下其中的sql日志,由于线下环境没有日志切割,日志量巨大,搜索时间太慢。没办法,就按照现有的数据进行分析吧。 日志如何被触发 由于当前没有任何思路,于是笔者翻看中间件的代码,发现在update语句执行后,中间件会在收到mysql okay包后打印上述日志。如下图所示: 注意到所有出问题的update出问题的时候都是同一个NIOREACTOR线程先后打印了两条日志,所以笔者推断这两个okay大概率是同一个后端连接返回的。 什么情况会返回多个okay? 这个问题笔者思索了很久,因为在笔者的实际重新执行出问题的sql并debug时,永远只有一个okay返回。于是笔者联想到,我们中间件有个状态同步的部分,而这些状态同步是将set auto_commit=0等sql拼接到应用发送的sql前面。即变成如下所示: sql可能为 set auto_commit=0;set charset=gbk;>update test set value =1 where id in ("1","2") and status = 1; 于是笔者细细读了这部分的代码,发现处理的很好。其通过计算出前面拼接出的sql数量,再在接收okay包的时候进行递减,最后将真正执行的那条sql处理返回。其处理如下图所示: 但这里确给了笔者一个灵感,即一条sql文本确实是有可能返回多个okay包的。 真相大白 在笔者发现(sql1;sql2;)这样的拼接sql会返回多个okay包后,就立刻联想到,该不会业务自己写了这样的sql发给中间件,造成中间件的sql处理逻辑错乱吧。因为我们的中间件只有在对自己拼接(同步状态)的sql做处理,明显是无法处理应用传过来即为拼接sql的情况。 由于看上去有问题的那条sql并没有拼接,于是笔者凭借这条sql打印所在的reactor线程往上搜索,发现其上面真的有拼接sql! 2020-03-1311:21:01:040[NIOREACTOR-20RW]frontIP=>ip1;sqlID=>12345678;rows=>1; sql=>update test_2 set value =1 where id=1 and status = 1;update test_2 set value =1 where id=2 and status = 1; 如上图所示,(update1;update2)中update1的okay返回被驱动认为是所有的返回。然后应用立即发送了update3。前脚刚发送,update2的okay返回就回来了而其刚好是0,应用就报错了(要不是0,这个错乱逻辑还不会提前暴露)。那三条"重复执行"也很好解释了,就是之前的拼接sql会有三条。 为何是概率出现 但奇怪的是,并不是每次拼接sql都会造成update3"重复执行"的现象,按照笔者的推断应该前面只要是多条拼接sql就会必现才对。于是笔者翻了下jdbc驱动源码,发现其在发送命令之前会清理下接收buffer,如下所示: MysqlIO.java final Buffer sendCommand(......){ ...... // 清理接收buffer,会将残存的okay包清除掉 clearInputStream(); ...... send(this.sendPacket, this.sendPacket.getPosition()); ...... } 正是由于clearInputStream()使得错误非必现(暴露),如果okay(update2)在应用发送第三条sql前先到jdbc驱动会被驱动忽略! 让我们再看一下不会让update3"重复执行"的时序图: 即根据okay(update2)返回的快慢来决定是否暴露这个问题,如下图所示: 同时笔者观察日志,确实这种情况下"update1;update2"这条语句在中间件里面日志有两条。 临时解决方案 让业务开发不用这些拼接sql的写法后,再也没出过问题。 为什么不连中间件是okay的 业务开发这些sql是就在线上运行了好久,用了中间件后才出现问题。 既然不连中间件是okay的,那么jdbc必然有这方面的完善处理,笔者去翻了下mysql-connect-java(5.1.46)。由于jdbc里面存在大量的兼容细节处理,笔者这边只列出一些关键代码路径: MySQL JDBC 源码 MySQLIO stack; executeUpdate |->executeUpdateInternel |->executeInternal |->execSQL |->sqlQueryDirect |->readAllResults (MysqlIO.java) readAllResults: //核心在这个函数的处理里面 ResultSetImpl readAllResults(......){ ...... while (moreRowSetsExist) { ...... // 在返回okay包的保中其serverStatus字段中如果SERVER_MORE_RESULTS_EXISTS置位 // 表明还有更多的okay packet moreRowSetsExist = (this.serverStatus & SERVER_MORE_RESULTS_EXISTS) != 0; } ...... } 正确的处理流程如下图所示: 而我们中间件的源码确实这么处理的: @Override public void okResponse(byte[] data, BackendConnection conn) { ...... // 这边仅仅处理了autocommit的状态,没有处理SERVER_MORE_RESULTS_EXISTS // 所以导致了不兼容拼接sql的现象 ok.serverStatus = source.isAutocommit() ? 2 : 1; ok.write(source); ...... } select也"重复执行"了 解决完上面的问题后,笔者在日志里竟然发现select尽然也有重复的,这边并不会牵涉到okay包的处理,难道还有问题?日志如下所示: 2020-03-13 12:21:01:040[NIOREACTOR-20RW]frontIP=>ip1;sqlID=>12345678;rows=>1;select abc; 2020-03-13 12:21:01:045[NIOREACTOR-21RW]frontIP=>ip2;sqlID=>12345678;rows=>1;select abc; 从不同的REACTOR线程号(20RW/21RW)和不同的frontIP(ip1,ip2)来看是两个连接执行了同样的sql,但为何sqlID是一样的?任何一个诡异的现象都必须一查到底。于是笔者登录到应用上看了下应用日志,确实应用有两个不同的线程运行了同一条sql。 那肯定是中间件日志打印的问题了,笔者很快就想通了其中的关窍,我们中间件有个对同样sql缓存其路由节点结构体的功能(这样下一次同样sql就不必解析,降低了CPU),而sqlID信息正好也在那个路由节点结构体里面。如下图所示: 这个缓存功能感觉没啥用(因为线上基本是没有相同sql的),于是笔者在笔者优化的闪电模式下(大幅度提高中间件性能)将这个功能禁用掉了,没想到为了排查问题而开启的详细日志碰巧将这个功能开启了。 总结 任何系统都不能说百分之百稳定可靠,尤其是不能立flag。在线上运行了好几年的系统也是如此。只有对所有预料外的现象进行细致的追查与深入的分析并解决,才能让我们的系统越来越可靠。 公众号 关注笔者公众号,获取更多干货文章: 原文链接 https://my.oschina.net/alchemystar/blog/3208851

优秀的个人博客,低调大师

解Bug之路-中间件"SQL重复执行"

前言 我们的分库分表中间件在线上运行了两年多,到目前为止还算稳定。在笔者将精力放在处理各种灾难性事件(例如中间件物理机宕机/数据库宕机/网络隔离等突发事件)时。竟然发现还有一些奇怪的corner case。现在就将排查思路写成文章分享出来。 Bug现场 应用拓扑 应用通过中间件连后端多个数据库,sql会根据路由规则路由到指定的节点,如下图所示: 错误现象 应用在做某些数据库操作时,会发现有比较大的概率失败。他们的代码逻辑是这样: int count = updateSql(sql1); ... // 伪代码 int count = updateSql("update test set value =1 where id in ("100","200") and status = 1; if( 0 == count ){ throw new RuntimeException("更新失败"); } ...... int count = updateSql(sql3); ... 即每做一次update之后都检查下是否更新成功,如果不成功则回滚并抛异常。在实际测试的过程中,发现经常报错,更新为0。而实际那条sql确实是可以更新到的(即报错回滚后,我们手动执行sql可以执行并update count>0)。 中间件日志 笔者根据sql去中间件日志里面搜索。发现了非常奇怪的结果,日志如下: 2020-03-13 11:21:01:440 [NIOREACTOR-20-RW] frontIP=>ip1;sqlID=>12345678;rows=>0;sql=>update test set value =1 where id in ("1","2") and status = 1;start=>11:21:01:403;time=>24266; 2020-03-13 11:21:01:440 [NIOREACTOR-20-RW] frontIP=>ip1;sqlID=>12345678;rows=>2;sql=>update test set value =1 where id in ("1","2") and status = 1;start=>11:21:01:403;time=>24591; 由于中间件对每条sql都标识了唯一的一个sqlID,在日志表现看来就好像sql执行了两遍!由于sql中有一个in,很容易想到是否被拆成了两条执行了。如下图所示:这条思路很快被笔者否决了,因为笔者explain并手动执行了一下,这条sql确实只路由到了一个节点。真正完全否决掉这条思路的是笔者在日志里面还发现,同样的SQL会打印三遍!即看上去像执行了三次,这就和仅仅只in了两个id的sql在思路上相矛盾了。 数据库日志 那到底数据真正执行了多少条呢?找DBA去捞一下其中的sql日志,由于线下环境没有日志切割,日志量巨大,搜索时间太慢。没办法,就按照现有的数据进行分析吧。 日志如何被触发 由于当前没有任何思路,于是笔者翻看中间件的代码,发现在update语句执行后,中间件会在收到mysql okay包后打印上述日志。如下图所示:注意到所有出问题的update出问题的时候都是同一个NIOREACTOR线程先后打印了两条日志,所以笔者推断这两个okay大概率是同一个后端连接返回的。 什么情况会返回多个okay? 这个问题笔者思索了很久,因为在笔者的实际重新执行出问题的sql并debug时,永远只有一个okay返回。于是笔者联想到,我们中间件有个状态同步的部分,而这些状态同步是将set auto_commit=0等sql拼接到应用发送的sql前面。即变成如下所示: sql可能为 set auto_commit=0;set charset=gbk;>update test set value =1 where id in ("1","2") and status = 1; 于是笔者细细读了这部分的代码,发现处理的很好。其通过计算出前面拼接出的sql数量,再在接收okay包的时候进行递减,最后将真正执行的那条sql处理返回。其处理如下图所示:但这里确给了笔者一个灵感,即一条sql文本确实是有可能返回多个okay包的。 真相大白 在笔者发现(sql1;sql2;)这样的拼接sql会返回多个okay包后,就立刻联想到,该不会业务自己写了这样的sql发给中间件,造成中间件的sql处理逻辑错乱吧。因为我们的中间件只有在对自己拼接(同步状态)的sql做处理,明显是无法处理应用传过来即为拼接sql的情况。 由于看上去有问题的那条sql并没有拼接,于是笔者凭借这条sql打印所在的reactor线程往上搜索,发现其上面真的有拼接sql! 2020-03-1311:21:01:040[NIOREACTOR-20RW]frontIP=>ip1;sqlID=>12345678;rows=>1; sql=>update test_2 set value =1 where id=1 and status = 1;update test_2 set value =1 where id=2 and status = 1; 如上图所示,(update1;update2)中update1的okay返回被驱动认为是所有的返回。然后应用立即发送了update3。前脚刚发送,update2的okay返回就回来了而其刚好是0,应用就报错了(要不是0,这个错乱逻辑还不会提前暴露)。那三条"重复执行"也很好解释了,就是之前的拼接sql会有三条。 为何是概率出现 但奇怪的是,并不是每次拼接sql都会造成update3"重复执行"的现象,按照笔者的推断应该前面只要是多条拼接sql就会必现才对。于是笔者翻了下jdbc驱动源码,发现其在发送命令之前会清理下接收buffer,如下所示: MysqlIO.java final Buffer sendCommand(......){ ...... // 清理接收buffer,会将残存的okay包清除掉 clearInputStream(); ...... send(this.sendPacket, this.sendPacket.getPosition()); ...... } 正是由于clearInputStream()使得错误非必现(暴露),如果okay(update2)在应用发送第三条sql前先到jdbc驱动会被驱动忽略!让我们再看一下不会让update3"重复执行"的时序图:即根据okay(update2)返回的快慢来决定是否暴露这个问题,如下图所示:同时笔者观察日志,确实这种情况下"update1;update2"这条语句在中间件里面日志有两条。 临时解决方案 让业务开发不用这些拼接sql的写法后,再也没出过问题。 为什么不连中间件是okay的 业务开发这些sql是就在线上运行了好久,用了中间件后才出现问题。 既然不连中间件是okay的,那么jdbc必然有这方面的完善处理,笔者去翻了下mysql-connect-java(5.1.46)。由于jdbc里面存在大量的兼容细节处理,笔者这边只列出一些关键代码路径: MySQL JDBC 源码 MySQLIO stack; executeUpdate |->executeUpdateInternel |->executeInternal |->execSQL |->sqlQueryDirect |->readAllResults (MysqlIO.java) readAllResults: //核心在这个函数的处理里面 ResultSetImpl readAllResults(......){ ...... while (moreRowSetsExist) { ...... // 在返回okay包的保中其serverStatus字段中如果SERVER_MORE_RESULTS_EXISTS置位 // 表明还有更多的okay packet moreRowSetsExist = (this.serverStatus & SERVER_MORE_RESULTS_EXISTS) != 0; } ...... } 正确的处理流程如下图所示:而我们中间件的源码确实这么处理的: @Override public void okResponse(byte[] data, BackendConnection conn) { ...... // 这边仅仅处理了autocommit的状态,没有处理SERVER_MORE_RESULTS_EXISTS // 所以导致了不兼容拼接sql的现象 ok.serverStatus = source.isAutocommit() ? 2 : 1; ok.write(source); ...... } select也"重复执行"了 解决完上面的问题后,笔者在日志里竟然发现select尽然也有重复的,这边并不会牵涉到okay包的处理,难道还有问题?日志如下所示: 2020-03-13 12:21:01:040[NIOREACTOR-20RW]frontIP=>ip1;sqlID=>12345678;rows=>1;select abc; 2020-03-13 12:21:01:045[NIOREACTOR-21RW]frontIP=>ip2;sqlID=>12345678;rows=>1;select abc; 从不同的REACTOR线程号(20RW/21RW)和不同的frontIP(ip1,ip2)来看是两个连接执行了同样的sql,但为何sqlID是一样的?任何一个诡异的现象都必须一查到底。于是笔者登录到应用上看了下应用日志,确实应用有两个不同的线程运行了同一条sql。 那肯定是中间件日志打印的问题了,笔者很快就想通了其中的关窍,我们中间件有个对同样sql缓存其路由节点结构体的功能(这样下一次同样sql就不必解析,降低了CPU),而sqlID信息正好也在那个路由节点结构体里面。如下图所示: 这个缓存功能感觉没啥用(因为线上基本是没有相同sql的),于是笔者在笔者优化的闪电模式下(大幅度提高中间件性能)将这个功能禁用掉了,没想到为了排查问题而开启的详细日志碰巧将这个功能开启了。 总结 任何系统都不能说百分之百稳定可靠,尤其是不能立flag。在线上运行了好几年的系统也是如此。只有对所有预料外的现象进行细致的追查与深入的分析并解决,才能让我们的系统越来越可靠。

优秀的个人博客,低调大师

网络唤醒(WOL)全解指南:原理篇

什么是网络唤醒 网络唤醒(Wake-on-LAN,WOL)是一种计算机局域网唤醒技术,使局域网内处于关机或休眠状态的计算机,将状态转换成引导(Boot Loader)或运行状态。无线唤醒(Wake-on-Wireless-LAN,WoWLAN)作为 WOL 的补充技术,使用无线网卡去唤醒计算机。网络唤醒在一般的局域网环境里使用有限广播地址(255.255.255.255)即可,由于路由器都不转发目的地址为有限广播地址的数据报,因此在复杂网络情况下通常使用子网定向广播地址。在局域网外唤醒局域网内特定计算机,可以使用路由器的 DDNS 与端口转发。 在1996年10月,英特尔和 IBM 成立了 Advanced Manageability Alliance。1997年4月,联盟提出了 WOL 技术。这是 WOL 技术的起源,随后各大厂商纷纷推出了自己的 WOL 技术标准。本文所讨论的 WOL 技术是由 AMD 公司提出的 Magic Packet(幻数据包,魔术包)唤醒方式,这里给出 AMD 关于此技术的白皮书。 幻数据包(Magic Packet) 幻数据包是一个广播帧,包含目标计算机的MAC地址。由于 MAC 地址的唯一性,使数据包可以在网络中被唯一的识别。幻数据包发送通常使用无连接的传输协议,如 UDP ,发送端口为 7 或 9 ,这只是通常做法,没有限制。 WOL 技术被提出了将近20年,绝大多数的现代网卡都支持在超低功耗下监听特定的报文,如 ARP。如果设备网卡接收到一个与自己 MAC 地址相同的幻数据包,则网卡会向计算机的电源或主板发出信号以唤醒计算机。大部分的幻数据包在数据链路层(OSI模型第2层)上发送,当发送时,使用广播地址广播到给定的网络上,不使用IP地址(OSI模型第3层)。当然这是绝大部分情况,幻数据包也可以使用特定的 IP 地址进行发送。 幻数据包最简单的构成是6字节的255(FF FF FF FF FF FF FF),紧接着为目标计算机的48位MAC地址,重复16次,数据包共计102字节。有时数据包内还会紧接着4-6字节的密码信息。这个帧片段可以包含在任何协议中,最常见的是包含在 UDP 中。 例如 MAC 地址为 11 22 33 44 55 66 的目标计算机,幻数据包的格式为: FFFFFFFFFFFF 112233445566 112233445566 112233445566 112233445566 112233445566 112233445566 112233445566 112233445566 112233445566 112233445566 112233445566 112233445566 112233445566 112233445566 112233445566 112233445566 [ABABABABABAB(这里为6个字节的密码)] 幻数据包还有一些基本限制条件: 需要知道目标计算机 MAC 地址 不提供送达确认 可能无法在局域网之外工作 需要硬件进行支持 创建幻数据包 项目地址:https://github.com/ZhangGaoxing/wake-on-lan 该项目为 Xamarin 跨平台项目,包含 Xamarin.Android 与 UWP 。支持自动扫描添加局域网设备。 关于 MAC 地址的扫描获取,这里只说一下思路,详细请查阅代码。第一种方式,也是我最开始想到的方式,使用 Ping 来 Ping 整个网段。开了四个线程,1-255大概需要30多秒,稍微有点慢,而且 .NET 的 Ping 类在 Android 上无法限制秒数。第二种方式,百度到的,直接向整个网段发送 UDP 消息,2秒解决战斗。扫描完成后获取 ARP 表就行。 下面给出的是发送幻数据包的方法: public static async void Wake(string broadcast, int port, byte[] mac) { using (UdpClient udp = new UdpClient()) { udp.EnableBroadcast = true; byte[] packet = new byte[6 + 16 * 6]; for (int i = 0; i < 6; i++) { packet[i] = 0xFF; } for (int i = 0; i < 16; i++) { for (int j = 0; j < 6; j++) { packet[6 + i * 6 + j] = mac[j]; } } await udp.SendAsync(packet, packet.Length, broadcast, port); } }

优秀的个人博客,低调大师

同一个问题有多个解

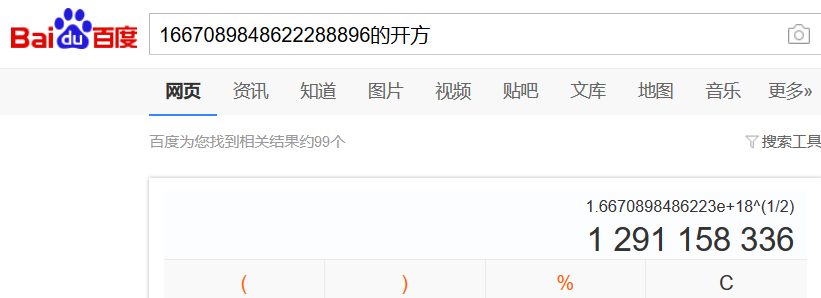
https://www.codewars.com/kata/5592e3bd57b64d00f3000047 做这道kata时,有个变量的比较运算符写错了,应该设置为< ,而我设置的 != ,(更正后↓完全正确) public static long findNb0(long m) { long n = 0;// 求得的n long sum = 0;// 累加值与m进行判定 long s = 0; boolean rightN = false; while (s < m) { sum += (s * s * s); if (sum == m) { rightN = true; n = s; break; } if (sum > m) { break; } s++; } if (rightN) { return n; } else { return -1; } } 它(this kata)求的是按照1的立方,2的立方,3的立方这样的累加一直到n的立方,是否等于传入的m. 返回数值n. 很简单的想法是可以使用递增, 将 n*n*n 去 ++ .就像上面的写法,看了下CW大神的解法: public static long findNb2(long m) { long mm = 0, n = 0; while (mm < m) mm += ++n * n * n; return mm == m ? n : -1; } 写法更加简练了,但其实还是一个道理,就是递增,我在想应该有更快速的方式(因为之前做类似的题时,使用递增这样做法会超时(也就是所说的算法的时间复杂度过高了)) 使用java自带的Math类方法:(但不完全正确,通过率98%),除了Math类计算失误(不支持大数值),之下的解答逻辑性应无误(98%确定) public static long findNb(long m) { double x = Math.sqrt(m); << 问题出在这里,应该为有小数的结果会可能返回正整数 if (x != (Math.round(x))) { return -1; } long n = (long) (Math.floor(Math.sqrt(x * 2))); return n; } 最后经过多方论证,规律寻找,觉得这个解法是可以的,但是大多数测试通过了,有几个是通过不了的,而且都是数值非常大的情况下, 最终经过计算,得出结论: java自带的算术式以及支持的数值大小不能做这道题,如果支持的数值大小可以满足时,这种做法是对的. 但是这还不是最终结论. 但对于18位数值是可以的.19位就不准了. 再次我验证: 使用 递增的方式 s*s*s. 使用有平方根的数值: long m = 1667089848622288897L; 这里很奇妙的是,使用百度的求平方根,对于这个数,以及这个数-1的数,结果是一样的.(问题就出在这个地方) 递增后查看结果: ...... ...... ...... 1666827415525457025 1666958628200550400 1667089848622288896 1667221076790977409 -1 最后当最后long值超过其本身后,返回了-1.(表示没有n) 那么这里的超过之前的数值1667089848622288896 是小于m (1) 个大小的. 这里的疑问是: >> 也许是java中的Math类计算失误(对于过大数值) >> 或者是计算机底层的相乘出错了?(相乘使用的其实是加法), >> 也许是我写的解答就是不对的?(对于有整型平方根的整数,其是有1³+2³+3³+......+n³的和一样的整数的这件事情,我觉得应该没问题,毕竟测试通过率为98%(当然除了这个数值和其它更大数值)) 那么究竟是long值相乘计算出错了还是Math.sqrt的求开方出错了,这个只能在更强有力的计算机上去尝试了.(完全没有谱了,要不然就拿张白纸挨个相乘...计算) 不太靠谱的百度,给出了不太靠谱的结论. (有病去医院不要问百度) 最后我觉得先放一下这个问题,或者有哪位使用C语言的大神看到这道题,麻烦帮忙证明一下结果正确性谢谢 待看 -> 实现超大整数(超过long长度范围)的加法运算 -------------------------------------------------------长长的分割线,记录下我对家的思念-------------------------------------------------------------- 将编程看作是一门艺术,而不单单是个技术。 敲打的英文字符是我的黑白琴键, 思维图纸画出的是我编写的五线谱。 当美妙的华章响起,现实通往二进制的大门即将被打开。


优秀的个人博客,低调大师

Android Design Support Library全解:Part 2 Snackbar

Android Design Support Library系列第2弹: Snackbar “Providing lightweight, quick feedback about an operation is a perfect opportunity to use a snackbar.” image.png SnackBar是Design Support Library中很实用的控件,它可以在屏幕的底部展示快速消息,功能类似于Toast,但更加灵活和强大: SnackBar会在交互或者超时之后自动消失; SnackBar可以包含一个Action动作,来触发事件; SnackBar所展示的信息是UI的界面的一部分,它将出现于所有页面元素的之下,而Toast的是覆盖UI界面; 统一时间内,只会显示一条SnackBar。 因为SnackBar和Toast的功能相近,所以SnackBar继承了很多Toast的属性和方法,比如标识显示时间长短的LENGTH_LONG and LENGTH_SHORT。 使用方法 SnackBar的使用方法大致如下: Snackbar.make(view, message, duration) .setAction(action message, click listener) .show(); 其中: make() – 创建SnackBar来显示信息; setAction() – 设置Action事件; show() – 显示SnackBar; 需要说明的参数: make方法的第一个参数view,代表着SnackBar所要依附的父视图(parent view); make方法的最后一个参数duration,代表着SnackBar出现的时间,超过该时间之后便会消失。 下面我们看一个实例: Snackbar.make(rootlayout, "Hello SnackBar!", Snackbar.LENGTH_SHORT) .setAction("Undo", new View.OnClickListener() { @Override public void onClick(View v) { // 点击事件 } }) .show(); 其中,rootlayout为上一节中,包含FAB的framelayout,点击悬浮按钮就会弹出Snackbar。 Snackbar-framelayout 虽然Snackbar出现了,但是和我们预期的还是有差距,我们希望Snarkbar出现在最下方时,FAB等控件可以随之上移,比如下面的效果: Snackbar-with-CoordinatorLayout 这就需要配合CoordinatorLayout 控件来使用,我们会在后续的篇章里介绍。 自定义Snackbar样式 虽然可以通过setActionTextColor方法来设置Action字体样式,但是在实际的使用中,往往需要让Snackbar显示出不同的样式(字体和颜色)来体现出不同的意义。 如何为Snackbar添加背景颜色 你可以通过getView() 方法获取Snackbar所在的View,然后就可以在对它采用任意的背景颜色:snackbar.getView().setBackgroundColor(colorId); 下面是ColoredSnackbar类,它利用装饰器模式封装了一些方法,可以根据用户指定的类型显示不同背景颜色。 //彩色 public class ColoredSnackbar { //红色 private static final int red = 0xfff44336; //绿色 private static final int green = 0xff4caf50; //蓝色 private static final int blue = 0xff2195f3; //橙色 private static final int orange = 0xffffc107; //获得当前SnackBar所在的View private static View getSnackBarLayout(Snackbar snackbar) { if (snackbar != null) { return snackbar.getView(); } return null; } //装饰器 private static Snackbar colorSnackBar(Snackbar snackbar, int colorId) { View snackBarView = getSnackBarLayout(snackbar); if (snackBarView != null) { snackBarView.setBackgroundColor(colorId); } return snackbar; } //使用蓝色表示一般信息 public static Snackbar info(Snackbar snackbar) { return colorSnackBar(snackbar, blue); } //使用橙色表示提醒信息 public static Snackbar warning(Snackbar snackbar) { return colorSnackBar(snackbar, orange); } //使用红色表示警告信息 public static Snackbar alert(Snackbar snackbar) { return colorSnackBar(snackbar, red); } //使用绿色表示确认信息 public static Snackbar confirm(Snackbar snackbar) { return colorSnackBar(snackbar, green); } } 其使用方式很简单,先构建正常的SnackBar,然后调用ColoredSnackBar进行装饰: Snackbar snackbar = Snackbar.make(getView(), R.string.hello_snackbar, Snackbar.LENGTH_SHORT); ColoredSnackBar.alert(snackbar).show(); 效果如下: ColoredSnackBar 更多关于Design Support Library中控件的讲解将会在持续更新,欢迎关注。

优秀的个人博客,低调大师

Spark与Hadoop两大技术趋势解

开源数据集如今深受开发者喜爱,比如谷歌的Images dataset数据集,YouTube-8M数据集等。通过对数据集里的数据进行分析,可以发现许多隐藏信息,比如客户喜好、未知相关性,市场趋势以及其他有用的商业信息。大数据分析对企业降低成本,准确掌握市场趋势,更快完成产品迭代十分有用。说到大数据分析,16年基本被Spark与Hadoop霸屏,到底是什么样的魔力让它们足以引起大数据世界的波动,未来又会如何发展呢? Apache Spark Apache Spark起源于加州大学伯克利分校,对于复杂分析来说是一个十分不错的开源处理引擎。Spark提供了一个全面、统一的框架用于管理各种有着不同性质(文本数据、图表数据等)的数据集和数据源(批量数据或实时的流数据)的大数据处理的需求。每一个Spark应用程序,都由一个驱动程序组成,运行用户的main函数,并且在一个集群上执行各种并行操作。 Spark提供的主要的抽象概念是具备容错能力的弹性分布式数据集,一个覆盖整个集群的只读多重数据项集。弹性分布式数据集(RDD)帮助实现交互式算法,通过多次访问数据集,实现交互式数据分析,应用延迟可以有不同程度上的减少,机器学习系统训练算法的交互性是使用Apache Spark的初始动力。以下是对Apache Spark的分析,看看是哪些特性使Apache Spark如此火热吧。 1、快速处理 大数据的处理速度至关重要,Apache Spark通过减少磁盘读写次数,降低磁盘I/O,使Hadoop集群上的应用程序操作比内存中快一百倍,比磁盘快十倍。 2、易用,支持多种语言 Spark允许使用Java,Sacla甚至Python进行快速编写。开发人员不仅可以使用熟悉的编程语言也可以运行这些应用程序。Spark本身自带了一个超过80个高阶操作符集合。而且还可以用它在shell中以交互式地查询数据。 3、支持复杂分析 除了Map和Reduce操作之外,Spark还支持SQL查询,流数据,机器学习和图表数据处理,此外,用户可以把所有这些功能都放在一个工作流中使用也可以单独使用。 4、实时流式处理 Apache Spark支持实时流式处理,它可以在进行数据操作的同时使用Spark Streaming。 5、与现有Hadoop及其上的数据整合 Spark可以在Hadoop Yarn集群管理器上独立操作,包括读取Hadoop上的数据。该特性使Spark十分适用于现有纯Hadoop应用程序的迁移。 6、基于Hadoop的多核服务器 大部分企业逐渐从昂贵的大型机和数据仓库平台向基于Hadoop的多核服务器转型。Hadoop是一个由java语言编写而成的开源分布式系统基础架构,其支持分布式环境中的大型数据集的存储和处理操作。很多公司都将Hadoop作为其大数据平台进行使用。 Hadoop Hadoop是由Apache基金会所开发的分布式系统基础架构。用户可以在不了解分布式底层细节的情况下,开发分布式程序。充分利用集群的威力进行高速运算和存储。 1、低成本的数据存储 与一体机、商用数据仓库以及QlikView、Yonghong Z-Suite等数据集市相比,Hadoop是开源的,项目的软件成本因此会大大降低。 2、高效 Hadoop可以运行分析算法,因为它被设计用来处理各种形式的大数据。在Hadoop上进行数据分析可以使分析更高效,Hadoop能够在节点之间动态地移动数据,并保证各个节点的动态平衡,因此处理速度非常快。 3、批量数据处理 Hadoop框架最核心的设计就是:HDFS和MapReduce。HDFS为海量的数据提供了存储,则MapReduce为海量的数据提供了计算。HDFS是Hadoop的一大创举,分布式存储使文件存放在众多节点上,只需要一个节点去记录文件的元数据信息(主要是文件的位置),访问文件时先访问元数据节点,获取文件所在的位置, 然后在获取文件即可。此外,MapReduce也可以做大数据处理,即以价值为导向,对大数据加工、挖掘和优化等各种处理。其思想就是“分而治之”,将大任务分成若干小任务处理。 4、与数据仓库相辅相成 有很多数据集被从数据仓库卸到Hadoop平台上,或者一些新的数据会直接到Hadoop中。企业无非就是希望有一个好的平台来存储、处理、分析数据,以支持可以被集成在不同级别的不同用例。 5、物联网和Hadoop 据预测,未来20年物联网对全球GDP的贡献将会增长10到15万亿美元左右。物联网的核心是流和大数据。Hadoop被用来进行多事务数据存储,数据,统计算法和机器学习指出基于历史数据分析得到未来趋势的可能性。对过去进行分析是了解未来很好的一个途径,通过预测分析,未来的物联网世界将更加纯粹。 未来怎么走? 技术的变革、更新换代,本身是好事,但很多时候,人才的培养跟不上技术变革的脚步。即便是最先进的学府可能都还未来得及更换教科书,这时对企业来说,新技术带来的超高性价比就显得毫无意义了,因为相应的人力成本在上升。 有些人很喜欢及时更新知识储备,认为新技术的出现会取代旧技术。但各有各的好,新欢不一定敌得过旧爱,要看需求,别跟风。不过,越是Spark、Hadoop炒得火热,理性思考的人就越少,很多人只是浮于表面,这对技术的发展十分不利。 本文作者:佚名 来源:51CTO

优秀的个人博客,低调大师

中间人攻击&防御方式全解

关于网络安全有一个非常有意思的事,就是随着技术的变化,古老的网络攻击方式还会再次被利用。正如中间人攻击(MiTM)。这种攻击的目的很简单,就是在有线或者无线连接的中间放置一个攻击者。但是,随着云计算、物联网(IoT)、BYOT等网络技术的发展,攻击者也开始寻找新的方式以使那些古老的攻击方式可以重新被利用。下面是每个专业的网络人员都应该知道的关于MiTM攻击的各种方式。 MiT-cloud (MiTC) 过去这几年,云计算越来越受欢迎,一个常见的云服务就是云存储,很多企业都在使用。这些云服务使得庞大的数据传输和存储工作变得很简单。这个领域的参与者有Dropbox、OneDrive以及Google Drive等等。通常情况下,这些服务不会要求你每次使用服务的时候都要重新登录,因为你验证后,它会在你的本地系统上保留会话令牌(token)。MiTC就是利用的会话管理。如果攻击者获取了你的token,他们就能访问你的账户,这样,他们就能窃取你的数据,更改文件信息,或是上传恶意软件使你的电脑感染病毒。 MiT-browser (MiTB) 你上一次写支票是什么时候?我是想说,如今大多数人都使用网上银行。MiTB攻击就发生在这个时候,攻击者会诱导你下载木马(Trojan)。一旦你访问特定的财务或银行网站的时候,恶意软件就会往你访问的页面注入新的HTML代码,然后诱导你输入SSN号、ATM PIN码或是银行路由代码。MiTB会把它自己直接集成到网页上,还能保持原有的域名和SSL设置,看起来和真正的网页一样。 MiT-mobile (MiTMO) 攻击者不光针对台式机和笔记本。很多用户可能更多的是在他们的智能手机上进行转账付款等操作,这就给攻击者创造了更多的机会。这也是为什么MiTMO越来越受到关注的原因。这种攻击关注移动交易验证码(mTANs)以及其它各种类型的交易验证码。这种类型的中间人攻击会拦截SMS流量,并且捕捉这些代码,然后把它们转发给攻击者。MiTMO给带外身份验证系统带来了很大的挑战。 MiT-app (MiTA) 不知道你是不是和我一样,还记得有智能手机以前的生活,那时你可能会有很多灵感,如今这些想法都已经被智能手机替代了。随着智能手机的发展,应用程序也迅速激增,如果应用程序没有执行有效的证书验证,那就给了MiTA攻击的机会。MiTA会让攻击者插入一个自签名的证书,来和应用程序通信。它的工作原理是利用应用程序处理信任的方式,扩展MiTM攻击模式。 MiT-IoT 随着越来越多的用户和企业都开始采用IoT(物联网),MiTM攻击也越来越受到关注。其中有一种类型的攻击就是MiT-IoT,这种攻击方式是利用传递信任和较差的证书验证。举个例子来说,一种能够显示用户的Google 日历的IoT冰箱就发现没有验证SSL证书。这会导致攻击者利用这种漏洞安装一个MiTM攻击,窃取用户的Google证书。 上面说的每种攻击都是对网络安全专业人士的挑战,但是,有一些方法可以减少这些攻击发生。具体方法如下: • 通过采用动态ARP检测、DHCP Snooping等控制操作来加强网络基础设施 • 采用传输加密:SSL和TLS可以阻止攻击者使用和分析网络流量。像Google等公司如今都有高级的网站搜索引擎优化,默认状态下都提供HTTPS。 • 使用CASBs(云访问安全代理):CASBs可以提供加密、访问控制、异常保护以及数据丢失保护等一系列功能。 • 创建RASP(实时应用程序自我保护):这是一个新概念,内置于应用程序中,用来防止实时攻击。 • 阻止自签名证书:自签名证书很容易伪造。但是目前还没有撤销它们的机制。所以,应该使用有效证书颁发机构提供的证书。 • 强制使用SSL pinning:这是对抗MiTM攻击的另一种方式。使用有效证书颁发机构提供的证书是第一步,它是通过返回的受信任的根证书以及是否与主机名匹配来验证该服务器提供的证书的有效性。通过SSL pinning可以验证客户端检查服务器证书的有效性。 • 安装DAM(数据库活动监控):DAM可以监控数据库活动,检测篡改数据。 MiTM攻击是一个很大的挑战,它是利用用户和用户连接的服务器之间的信任。这种攻击的危险之处在于,用户想当然的认为他们的连接很安全。只有我们开始意识到这种攻击的危险真正存在,并且花很多时间去进行适当的控制时,比如加密、适当的验证、强大的应用程序验证以及通过系统来检测篡改等,才可以防御MiTM攻击。 作者:Michael Gregg 翻译:周南 来源:51CTO

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册