首页 文章 精选 留言 我的

精选列表

搜索[解耦化],共10020篇文章
优秀的个人博客,低调大师

Docker-compose 使用全解

一、Compose安装 在安装compose之前,要确保已经安装了docker1.3或以上版本 在Linux64位系统上安装compose: curl-Lhttps://github.com/docker/compose/releases/download/1.1.0/docker-compose-`uname-s`-`uname-m`>/usr/local/bin/docker-compose chmod+x/usr/local/bin/docker-compose1212 注:当然可以选择安装command completion(见二) uname -s和uname -m中的两个引号是键盘上ESC下面的那个按键 此时,compose已经安装成功,使用命令docker-compose --version可以查看 如果是在OS X系统上,则需要执行如下步骤(未亲测): 二、Compose命令补全 安装命令补全 确保bash completion已经安装,如果当前使用非最小安装的Linux,bash completion已经OK了,如果是在MAC上,可以使用brew install bash-completion来安装 将completion脚本放在/etc/bash_completion.d/(在MAC上是/usr/local/etc/bash_completion.d/) curl-Lhttps://raw.githubusercontent.com/docker/compose/1.1.0/contrib/completion/bash/docker-compose>/etc/bash_completion.d/docker-compose11 在下次登录时,Completion功能已经可以使用 可用的补全取决于在命令行的输入,会补全: * 可用的Docker-compose命令 * 对于某一特别命令可用的选项 * 在一个给定的上下文条件(比如:具有运行或停止状态的实例的服务或者基于镜像的服务 VS 基于Dockerfile的服务)下,给出有可行的服务名称,对于docker-compose scale,补全服务名称时会自动有”=”附加上去 * 对于可选项的参数,比如:docker-compose kill -s会完成一些信号,比如SIGUP和SIGUSR1 拥有了这项功能以后,Compose更快更少输入了呢!Happy working! 三、Compose使用实例 在本例中将会实现启动nginx服务及一个数据卷容器,并将该数据卷容器作为nginx的静态文件 1.创建compose文件夹sudo mkdir composetestcd composetest 2.创建docker-compose.yml文件touch docker-compose.ymlvim docker-compose.yml 在docker-compose.yml中输入以下内容: dvc: image:debian:wheezy volumes: -/www:/usr/share/nginx/html:ronginx: image:nginx:latest volumes_from: -dvcports: -"8081:80"12345678910111234567891011 3.启动docker-compose up -d 注:使用命令docker-compose ps查看运行状况 四、CLI 说明(docker-compose 命令) 大多数Compose命令都是运行于一个或多个服务的,如果服务没有指定,该命令将会应用到所有服务,如果要获得所有可用信息,使用命令:docker-compose [COMMAND] --help,下面是命令(COMMAND)的说明: build 创建或者再建服务 服务被创建后会标记为project_service(比如composetest_db),如果改变了一个服务的Dockerfile或者构建目录的内容,可以使用docker-compose build来重建它 help 显示命令的帮助和使用信息 kill 通过发送SIGKILL的信号强制停止运行的容器,这个信号可以选择性的通过,比如:docker-compose kill -s SIGKINT logs 显示服务的日志输出 port 为端口绑定输出公共信息 ps 显示容器 pull 拉取服务镜像 rm 删除停止的容器 run 在服务上运行一个一次性命令,比如:docker-compose run webPythonmanage.py shell scale 设置为一个服务启动的容器数量,数量是以这样的参数形式指定的:service=num,比如:docker-compose scale web=2 worker=3 start 启动已经存在的容器作为一个服务 stop 停止运行的容器而不删除它们,它们可以使用命令docker-compose start重新启动起来 up 为一个服务构建、创建、启动、附加到容器 连接的服务会被启动,除非它们已经在运行了 默认情况下,docker-compose up会集中每个容器的输出,当存在时,所有的容器会停止,运行docker-compose up -d会在后台启动容器并使它们运行 默认情况下,如果服务存在容器的话,docker-compose up会停止并再创建它们(使用了volumes-from会保留已挂载的卷),如果不想使容器停止并再创建的话,使用docker-compose up --no-recreate,如果有需要的话,这会启动任何停止的容器 选项 –verbose 显示更多输出 –version 显示版本号并退出 -f,–file FILE 指定一个可选的Compose yaml文件(默认:docker-compose.yml) -p,–project-name NAME 指定可选的项目名称(默认:当前目录名称) 五、docker-compose.yml命令说明 每一个定义在docker-compose.yml中的服务必须明确指定一个image或者build选项,这与docker run命令行中输入的是对应相同的,对于docker run,在Dockerfile文件中指定的选项(比如CMD、EXPOSE、VOLUME、ENV)是默认的,因此不必在docker-compose.yml中再指定一次 image 标明image的ID,这个image ID可以是本地也可以是远程的,如果本地不存在,Compose会尝试去pull下来 image:ubuntuimage:orchardup/postgresqlimage:a4bc65fd123123 build 该参数指定Dockerfile文件的路径,该目录也是发送到守护进程的构建环境(这句有点),Compose将会以一个已存在的名称进行构建并标记,并随后使用这个image build:/path/to/build/dir11 command 重写默认的命令 command:bundleexecthin-p300011 links 连接到其他服务中的容器,可以指定服务名称和这个链接的别名,或者只指定服务名称 links: -db -db:database -redis12341234 此时,在容器内部,会在/etc/hosts文件中用别名创建一个条目,就像这样: 172.17.2.186db 172.17.2.186database 172.17.2.186redis123123 环境变量也会被创建,关于环境变量的参数,会在后面讲到 external_links 连接到在这个docker-compose.yml文件或者Compose外部启动的容器,特别是对于提供共享和公共服务的容器。在指定容器名称和别名时,external_links遵循着和links相同的语义用法 external_links: -redis_1 -project_db_1:mysql -project_db_1:postgresql12341234 ports 暴露端口,指定两者的端口(主机:容器),或者只是容器的端口(主机会被随机分配一个端口) 注:当以 主机:容器 的形式来映射端口时,如果使容器的端口小于60,那可能会出现错误,因为YAML会将 xx:yy这样格式的数据解析为六十进制的数据,基于这个原因,时刻记得要将端口映射明确指定为字符串 ports: -"3000"-"8000:8000"-"49100:22"-"127.0.0.1:8001:8001"1234512345 expose 暴露端口而不必向主机发布它们,而只是会向链接的服务(linked service)提供,只有内部端口可以被指定 expose: -"3000"-"8000"123123 volumes 挂载路径最为卷,可以选择性的指定一个主机上的路径(主机:容器),或是一种可使用的模式(主机:容器:ro) volumes_from: -service_name -container_name123123 environment 加入环境变量,可以使用数组或者字典,只有一个key的环境变量可以在运行Compose的机器上找到对应的值,这有助于加密的或者特殊主机的值 environment: RACK_ENV:development SESSION_SECRET: environments: -RACK_ENV=development -SESSION_SECRET123456123456 env_file 从一个文件中加入环境变量,该文件可以是一个单独的值或者一张列表,在environment中指定的环境变量将会重写这些值 env_file: -.envRACK_ENV:development1234512345 net 网络模式,可以在docker客户端的--net参数中指定这些值 net:"bridge"net:"none"net:"container:[nameorid]"net:"host"12341234 dns 自定义DNS服务,可以是一个单独的值或者一张列表 dns:8.8.8.8 dns: -8.8.8.8-9.9.9.912341234 cap_add,cap_drop 加入或者去掉容器能力,查看man 7 capabilities可以有一张完整的列表 cap_add: -ALLcap_drop: -NET_ADMIN-SYS_ADMIN123456123456 dns_search 自定义DNS搜索范围,可以是单独的值或者一张列表 dns_search:example.comdns_search: -dc1.example.com -dc2.example.com12341234 working_dir,entrypoint,user,hostname,domainname,mem_limit,privileged,restart,stdin_open,tty,cpu_shares 上述的每一个都只是一个单独的值,和docker run中对应的参数是一样的 cpu_shares:73working_dir:/codeentrypoint:/code/entrypoint.shuser:postgresqlhostname:foodomainname:foo.commem_limit:1000000000privileged:truerestart:alwaysstdin_open:truetty:true1234567891011121314151612345678910111213141516 六、Compose环境变量说明 环境变量已经不再是用来连接服务的推荐方法了,相反,应该使用链接名称(默认情况下是链接服务的名称)作为主机名称来连接,这可以查看docker-compose.yml的更多细节 Compose使用Docker links来暴露服务的容器给其他的。每一个链接的容器都使用了一组环境变量,这每一组环境变量都是以容器名称的大写字母开头的 要查看服务可用的环境变量,运行docker-compose run SERVICE env name_PORT 完整URL,如:DB_PORT=tcp//172.17.0.5:5432 name_PORT_num_protocol 完整URL,如:DB_PORT_5432_TCP=tcp://172.17.0.5:5432 name_PORT_num_protocol_ADDR 容器的IP地址,如:DB_PORT_5432_TCP_ADDR=172.17.0.5 name_PORT_num_protocol_PORT 暴露的端口号,如:DB_PORT_5432_TCP_PORT=5432 name_PORT_num_protocol_PROTO 协议(tcp或者udp),如:DB_PORT_5432_TCP_PROTO=tcp name_NAME 完全合格的容器名称,如:DB_1_NAME=/myapp_web_1/myapp_db_1 原文链接:http://blog.csdn.net/zhiaini06/article/details/45287663


优秀的个人博客,低调大师

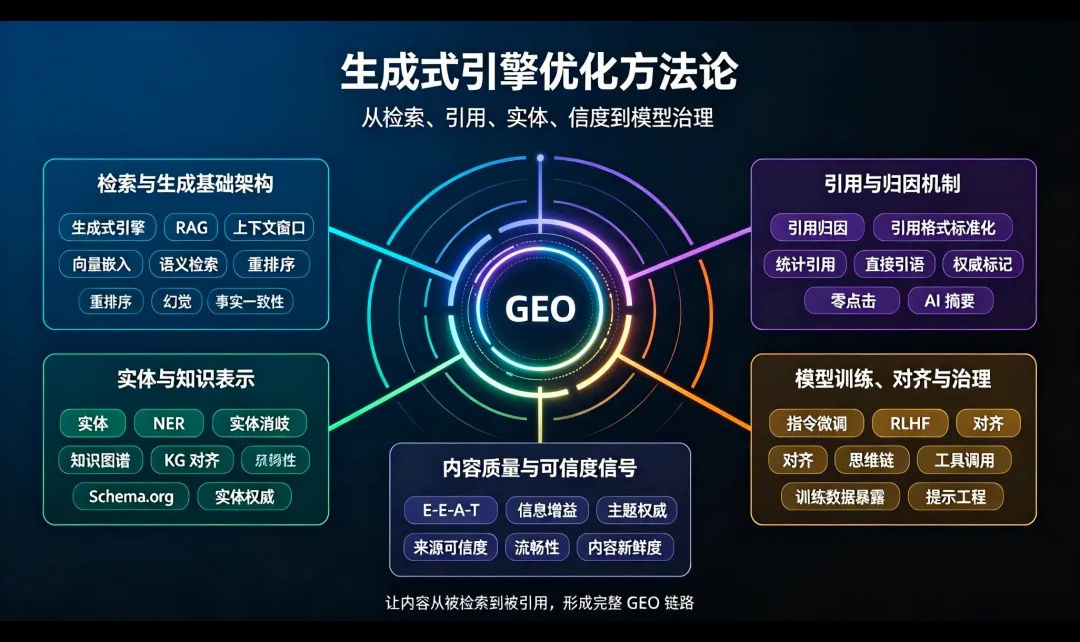
GEO 核心技术名词全解

生成式引擎正在重塑信息分发逻辑,内容被'看见'的方式从链接列表转向 AI 合成答案。本文穷尽梳理 GEO(Generative Engine Optimization,生成式引擎优化)领域的核心技术名词,按'检索与生成基础架构—引用与归因机制—实体与知识表示—内容质量与可信度信号—模型训练、对齐与治理'五条主线归类,每项给出定义、原理、GEO 意义与实操要点,供从业者建立完整的方法论框架。

优秀的个人博客,低调大师

数据库管理系统(知识解集)

一、数据库管理系统的基本功能数据库管理系统主要是实现对共享数据有效的组织、存储、管理和存取。围绕数据,数据库管理系统的功能为: 1、数据库定义和创建创建数据库主要是用数据定义语言定义和创建数据库模式、外模式、内模式等数据库对象。在关系数据库中就是建立数据库(或模式)、表、视图、索引等,还有创建用户、安全保密定义(如用户口令、级别、角色、存取权限)、数据库的完整性定义。这些定义存储在数据字典(亦称为系统目录)中,是数据库管理系统运行的基本依据。 2、数据组织、存储和管理数据库管理系统要分类组织、存储和管理各种数据,包括数据字典、用户数据、存取路径等。要确定以何种文件结构和存取方式在存储器上组织这些数据,以及如何实现数据之间的联系。数据组织和存储的基本目标是提高存储空间利用率和方式存取,提高多种存取方法(如索引查找、hash查找、顺序查找等)以提高存取效率。 3、数据库管理系统提供用户对数据的操作功能,实现对数据库数据的索引、插入、修改和删除。一个友好的关系数据库管理系统应该提供功能强且易学易用的数据操纵语言、方便的操作方式和较高的数据存取效率。数据操纵语言有两类:宿主型语言和自立(独立)型语言。 4 、数据库事务管理和运行管理数据库管理系统的运行控制和管理功能,包括多用户环境下的事务管理功能和安全性、完整性控制功能;数据库恢复、并发控制和死锁检测(或死锁防止)、安全性检查和存取控制、完整性检查和执行、运行日志的组织管理等。这些功能保证了数据库系统的正常运行,保证了事务的ACID特性。 5、数据库的建立和维护包括数据库的初始建立、数据的转换、数据库的转储和恢复、数据库的重组织和重构造以及性能检测分析等。 6、其他功能数据库管理系统包括与网络中其他软件的通信功能,一个数据库管理系统与另一个数据库管理系统或文件系统的数据转换功能;异构数据库之间的互访和互操作功能等。 和操作系统、编译系统等系统软件相比,数据库管理系统具有跨度大、功能多的特点。从最底层的存储管理、缓冲区管理、数据存取操作、语言处理到最外层的用户接口、数据表示、开发环境的支持都是它要实现的功能。 数据库管理系统的实现,既要充分利用计算机硬件、操作系统、编译系统和网络通信等技术,又要突出对海量数据存储、管理和处理的特点,还要保证其存取数据和运行事务的高效率。 二、数据库管理系统的系统结构1、数据库管理系统的层次结构和操作系统一样,可以将数据管理系统划分为若干层次。例如,IBM公司最早研制的著名的关系数据库管理系统实验系统SystemR,其核心分为底层的关系存储系统(RSS)和上层的关系数据系统(RDS)。RDS本质上是一个语言和执行层,包括语法检查与分析、优化、代码生成、视图实现、安全性完整性检查等功能。RSS则是一个存取方法层,其功能包括空间和设备管理、索引和存取路径管理、事务管理、并发控制、运行日志管理和恢复。按照处理对象的不同,依最高级到最低级的次序来划分的码具有普遍性。关系数据库管理系统的层次结构图示: 最上层是应用层,位于关系数据库管理系统的核心之外。应用层处理的对象是各种各样的数据库应用,如用开发工具开发的或用嵌入式SQL、存储过程等编写的应用程序,及终端用户通过应用程序接口发出的事务请求或各种查询要求等。该层是关系数据库管理系统与用户/应用程序的界面层。第二层是语言处理层。它处理的对象是数据库语言,如SQL;向上提供的数据接口是关系、视图,即元组的集合。该层的功能是对数据库语言的各类语句进行语法分析、视图转换、安全性检查、完整性检查、查询优化等;通过对下层基本模块的调用,生成可执行代码,这些代码的运行即可完成数据库语句的功能要求。第三层是数据存取层。该层处理的对象是单个元组,把上层的集合操作转换为单记录操作。该层执行扫描,排序,元组的增删改查,封锁等基本操作;完成数据记录的存取、存取路径维护、数据管理、并发控制和恢复等工作。第四层是数据存储层。该层处理的对象是数据页和系统缓冲区,执行文件的逻辑打开、关闭、读页、写页、缓冲区读和写、页面淘汰等操作,完成缓冲区管理、内外存交换、外存的数据管理等功能。操作系统是数据库管理系统的基础,它处理的对象是数据文件的物理块,执行物理文件的读写操作,保证数据管理系统对数据逻辑上的读写真实地映射到物理文件上。操作系统提供的存取原语和基本的存取方法通常作为数据库管理系统数据存储层的接口。2、关系数据库管理系统的运行过程示例关系数据库管理系统是一个复杂而有序的整体。如下图是应用程序/用户通过关系数据库管理系统读取数据库数据的过程:其中,数据字典是数据库的重要组成部分,存储元数据。 用户A通过应用程序A向关系数据库管理系统发出调用数据库数据的命令。关系数据库管理系统首先对命令进行进行语法检查,检查通过后进行语义检查和用户存取权限检查。具体做法是,关系数据库管理系统读取数据字典,检查是否存在该关系及相应的字段、该用户能否读取它们等,确认语义正确、存取权限合法后便决定指定该命令,否则拒绝执行,返回错误信息。关系数据库管理系统执行查询优化。优化器要根据数据字典中的信息进行优化,并把该命令转换成一串单记录的存取操作序列。关系数据库管理系统执行存取操作序列(反复执行以下各步,直至结束)。关系数据库管理系统首先在系统缓冲区查找记录,若找到满足条件的记录则转到10,否则转到6。关系数据库管理系统查看存储模式,决定从哪个文件、用什么方式读取哪个物理记录。关系数据库管理系统根据6的结果,向操作系统发出读取记录的命令。操作系统执行读取数据的相关操作。操作系统将数据从数据库的存储去送至系统缓冲区。关系数据库管理系统根据查询命令和数据字典的内容导出用户所要读取的记录格式。关系数据库管理系统将数据记录从系统缓冲区传送到应用程序A的用户工作区。关系数据库管理系统将执行状态信息。如成功读取或不成功的错误指示、例外状态信息等返回给应用程序A。根据数据库管理系统层次结构,可以将以上操作对应相应的层次:应用层: 1语言处理层:2、3数据存取层:4、10、11、12数据存储层:5、6、7操作系统:8、9 ———————————————— 2019年阿里云双11活动热门型号价格表 只要是新用户,就可以直接购买,无需拼团,没有任何门槛。(需要的同学可以考虑来一个确实便宜最低86元一年错过真要再等一年)

优秀的个人博客,低调大师

使用Kubectl管理Kubernetes的全解教程

kubectl主要用于与K8s API服务器通信,以在K8s中创建、更新和删除工作负载。不少IT人员通过kubectl与K8s交互。本文将介绍如何安装kubectl、与K8s环境进行通信以及一些常用命令,给您提供管理K8s的良好起点。 对不少IT人员来说,每天与Kubernetes交互的机制一般是通过kubectl——一种命令行工具。kubectl主要用于与Kubernetes API服务器通信,以在Kubernetes中创建、更新和删除工作负载。本教程的目的是概述您可以使用的一些常用命令,并提供管理Kubernetes的良好起点。 我们将介绍如何在您的计算机上安装kubectl,如何与您的Kubernetes环境进行通信并执行一些常见操作。大多数常见的kubectl命令会提供某特定的操作,如创建、删除等。此方法通常需要解释描述Kubernetes中的对象(如POD、服务、资源等)的文件(YAML或JSON)。这些文件通常被用作模板以及环境的持续文档,并有助于保留Kubernetes对声明性配置的关注。命令行上给出的操作将传递给API服务器,然后根据需要与Kubernetes中的后端服务进行通信。 我们将介绍一些最常见的kubectl命令并提供一些示例。有关每个命令的更多详细信息,包括所有支持的标志和子命令,请查看kubectl参考文档: https://kubernetes.io/docs/reference/generated/kubectl/kubectl-commands。 安装kubectl kubectl是一个独立的程序,因此不需要复杂的安装过程。它是一个需要位于操作系统PATH中的单个文件。有许多方法可以获得kubectl二进制文件,例如通过操作系统的本机包管理器或通过curl。下表中的一些示例就是如何为各种操作系统安装kubectl: 注意: 随着新版本的发布,最佳版本的kubectl for Windows将随着时间的推移而发生变化。要查找当前最佳二进制文件,请点击此链接查找最新的稳定版本,并根据需要调整上述URL: https://storage.googleapis.com/kubernetes-release/release/stable.txt 环境中使用的kubectl版本,需要与Kubernetes服务器的版本保持一致。您可以通过键入以下内容来查看正在使用的kubectl客户端的版本: kubectl在各方面都会保持与一个版本的兼容性。其中客户端版本会比服务器版本领先一步。这为服务器版本:v1.13.4中提供的功能和命令提供了支持。如果客户端版本不是服务器版本之后的各版本中的一个,那么在尝试访问相应服务器版本中可用的功能时,可能会遇到错误或不兼容。 kubectl语法 kubectl 的语法使用如下: Command(命令):指你想要执行的操作(创建、删除等等) Type(类别):指你正在执行命令的资源类型(Pod、Service等) Name(名称):对象的名称(需区分大小写)。如果未指定名称,则可以获取有关命令匹配的所有资源的信息(例如Pod) Flags(标志):这个可以按需选择(非必须),不过它在查找特定资源时非常有用。例如,--namespacespace可以让你指定要在哪个特定的命名空间中执行操作。 kubeconfig kubectl使用配置文件来访问Kubernetes集群。默认的kubectl配置文件位于〜/ .kube / config,称为kubeconfig文件。 kubeconfig文件组织有关集群、用户、命名空间和身份验证机制的信息。kubectl命令使用这些文件来查找它在选择集群并与之通信时所需要的信息。 加载顺序遵循以下规则: 如果设置了--kubeconfig标志,则仅加载给定文件。该标志只能设置一次,不会发生合并。 如果设置了$ KUBECONFIG环境变量,则根据系统的正常路径分隔规则,将其解析为文件系统路径列表。 否则,如果上述两项都未设置,则使用${HOME}/.kube/config 文件,不进行任何合并。 如果您看到类似于以下内容的消息,则意味着kubectl配置不正确或无法连接到Kubernetes集群 The connection to the server <server-name: port> was refused - did you specify the right host or port? 你可以通过多种方式创建配置文件,具体取决于你使用何种Kubernetes发行版。以下列出的是不同的K8S发行版及其位置: RKE 使用RKE创建Kubernetes集群时,RKE会在本地目录中创建一个kube_config_rancher-cluster.yml文件,该文件包含使用kubectl等工具连接到新集群所需的凭据。 您可以将此文件复制到$ HOME / .kube / config,或者,如果您正在使用多个Kubernetes集群,请将KUBECONFIG环境变量设置为kube_config_rancher-cluster.yml的路径,如下所示: Rancher统一管理的Kubernetes集群 在Rancher中,您可以通过Web UI下载kubeconfig文件,并使用它通过kubectl连接到Kubernetes环境。 在Rancher UI中,单击要通过kubectl连接的集群。在页面的右上角,单击Kubeconfig File按钮: 单击按钮以详细查看配置文件以及放置在~/.kube/config中的方向。 将配置复制到~/.kube/config后,你无需指定--kube-config文件位置,就可以运行kubectl命令: 一些基本命令的示例 以下我将重点介绍在典型环境中会用到的许多命令。我们将从概述集群开始,一直到探索Kubernetes环境中当前正在运行的内容的各种场景。 相信下文的内容将帮助您熟悉kubectl和典型输出的命令。 管理kubectl配置 kubectl命令包含一些不同的命令,可用来帮助查看和管理自己的配置。这些在初始设置期间,或在你需要处理的集群集发生变化时,将非常有用。 要查看当前配置,请键入: apiVersion: v1 clusters: - cluster: certificate-authority-data: DATA+OMITTED server: https://www.<yoururl>.com/k8s/clusters/<cluster> name: gcpcluster - cluster: certificate-authority-data: DATA+OMITTED server: https://10.240.0.41:6443 name: gcpcluster-k8s-1 - cluster: certificate-authority-data: DATA+OMITTED server: https://10.240.0.42:6443 name: gcpcluster-k8s-2 - cluster: certificate-authority-data: DATA+OMITTED server: https://10.240.0.43:6443 name: gcpcluster-k8s-3 contexts: - context: cluster: gcpcluster namespace: rancher user: user-qkvpz name: gcpcluster 你将能看到的输出内容汇总展现了你所配置的集群和及上下文。cluster键包含每个可用集群的列表,以及相关的连接和验证详细信息。contexts键将用户、集群和可选的命名空间组合在一起,以形成用于与集群交互的唯一标识和使用上下文。 要获得每个可用上下文的更简洁摘要,你可以键入: 输出的内容显示了每个已定义上下文的详细信息以及当前选定的上下文,由星号(*)表示。 要快速检查当前使用的上下文,请键入: 虽然我们不会在本摘要中介绍它,但除此之外你还可以使用kubectl set-cluster、kubectl set-credentials和kubectl set-context以及各种标志来定义集群和上下文,不过我们在本文中就不赘述了。 要更改要连接的上下文,请使用use-context命令: 检查集群组件的状态 为集群选择好适当的上下文后,可以使用get componentstatuses(缩写为get cs)命令检查核心主组件的状态: 输出的内容将显示调度程序、控制器管理器和etcd节点的状态以及从每个服务收集的最新消息和错误。如果你的集群运行不正常,这是一个很好的、进行第一次诊断检查的机会。 可以使用cluster-info命令收集其他连接和服务信息: Kubernetes master is running at https://www.<yoururl>.com/k8s/clusters/<cluster> KubeDNS is running at https://www.<yoururl>.com/k8s/clusters/<cluster>/api/v1/namespaces/kube-system/services/kube-dns:dns/proxy To further debug and diagnose cluster problems, use 'kubectl cluster-info dump'. 这里,输出显示了我们的Kubernetes master的端点以及KubeDNS服务端点的端点。 要查看有关作为集群成员的每个单个节点的信息,需使用get nodes命令: NAME STATUS ROLES AGE VERSION INTERNAL-IP EXTERNAL-IP OS-IMAGE KERNEL-VERSION CONTAINER-RUNTIME k8s-1 Ready controlplane,etcd,worker 34d v1.13.5 <IP> <none> Ubuntu 18.10 4.18.0-1011-gcp docker://18.9.5 k8s-2 Ready controlplane,etcd,worker 34d v1.13.5 <IP> <none> Ubuntu 18.10 4.18.0-1011-gcp docker://18.9.5 k8s-3 Ready controlplane,etcd,worker 34d v1.13.5 <IP> <none> Ubuntu 18.10 4.18.0-1011-gcp docker://18.9.5 这列出了在每个节点上运行的核心软件的状态、角色、连接信息和版本号。如果需要在集群节点上执行维护或登录以调试问题,此命令可以帮助您提供所需的信息。 查看资源和事件信息 要概述集群中可用的命名空间,请使用get namespaces命令: 这显示了当前集群中定义的命名空间分区。 要跨所有命名空间概述集群上运行的所有资源,使用以下命令: 输出的内容会显示部署了每个资源的命名空间信息,以及加上了资源类型前缀的资源名称(例如上面显示的示例中的pod)。之后,有关每个资源的就绪和运行状态的信息将有助于确定进程是否运行正常。 要查看与资源关联的事件,请使用get events命令: NAMESPACE LAST SEEN TYPE REASON KIND MESSAGE cattle-system 9m31s Normal BackOff Pod Back-off pulling image "miguelgt/k8s-demo:v2" cattle-system 24m Warning Failed Pod Error: ImagePullBackOff cattle-system 14m Normal BackOff Pod Back-off pulling image "miguelgt/k8s-demo:v2" cattle-system 9m30s Warning Failed Pod Error: ImagePullBackOff 输出内容将列出资源记录的最新事件,包括事件消息及其触发的原因。 示 例 为了更具体地演示您在使用kubectl时可能参与的工作流程,我们将在这一部分介绍将容器部署到集群的快速方案,并将其部署到非默认命名空间中。 默认情况下,如果在未指定命名空间的情况下部署集群,kubectl会将资源放在名为default的命名空间中。如果要部署到其他名称空间,则需要指定所需的替代项。 虽然我们可以为创建命令提供命名空间,但如果我们要使用命名空间来处理多个命令,更改上下文的方法会更为容易。更改与上下文关联的命名空间将自动将命名空间规范应用于任何其他命令,直到更改上下文。 要更改当前上下文的命名空间,请使用带有--currentand --namespace标志的set-context命令: 这将改变当前上下文,以自动将未来的操作应用于rancher命名空间。 接下来,我们可以创建一个名为nginx的部署,它基于默认的nginx容器镜像运行容器。因为我们改变了我们的上下文,所以它会在rancher命名空间中运行: 您可以通过列出当前部署的pod来检查部署是否成功: 在这里,我们可以看到Nginx部署正常运行。READY那一列显示容器已就绪,状态是“正在运行”,没有出现故障。 虽然我们已经验证了pod正在运行,但我们还没有得到关于它部署到了哪个命名空间的信息。但是,我们可以通过添加--all-namespaces标志来稍微改变输出: 这将显示在每个命名空间中运行的pod,并另外添加一个NAMESPACE列,列出每个资源部署到了哪个命名空间。在这里,我们看到Nginx pod已正确部署到我们的rancher命名空间而不是通常的default命名空间。 这表明我们的上下文操作和我们的部署都按预期工作了。 你还可以通过键入以下内容来清理已部署的资源: 其他参考信息 虽然本章中深入讨论这些内容可能超出了本文原意的范围,但我们还是为大家列出了一些非常有用的命令。 Pod 资源删除 服务 事件&指标 命名空间&安全 中级命令 其他资源 kubectl的官方概述: https://kubernetes.io/docs/reference/kubectl/overview/ kubectl的官方命令文档: https://kubernetes.io/docs/reference/kubectl/kubectl/ kubectl的官方备忘单: https://kubernetes.io/docs/reference/kubectl/cheatsheet/ Rancher kubeconfig文档: https://rancher.com/docs/rancher/v2.x/en/cluster-admin/kubeconfig/ 有关使用kubectl访问集群的Rancher文档: https://rancher.com/docs/rancher/v2.x/en/cluster-admin/kubectl/ kubectl配置命令: https://kubernetes.io/docs/reference/generated/kubectl/kubectl-commands#config 使用kubeconfig文件组织集群: https://kubernetes.io/docs/concepts/configuration/organize-cluster-access-kubeconfig/

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册