首页 文章 精选 留言 我的

精选列表

搜索[爬虫系统],共10021篇文章
优秀的个人博客,低调大师

爬虫实战——百度贴吧

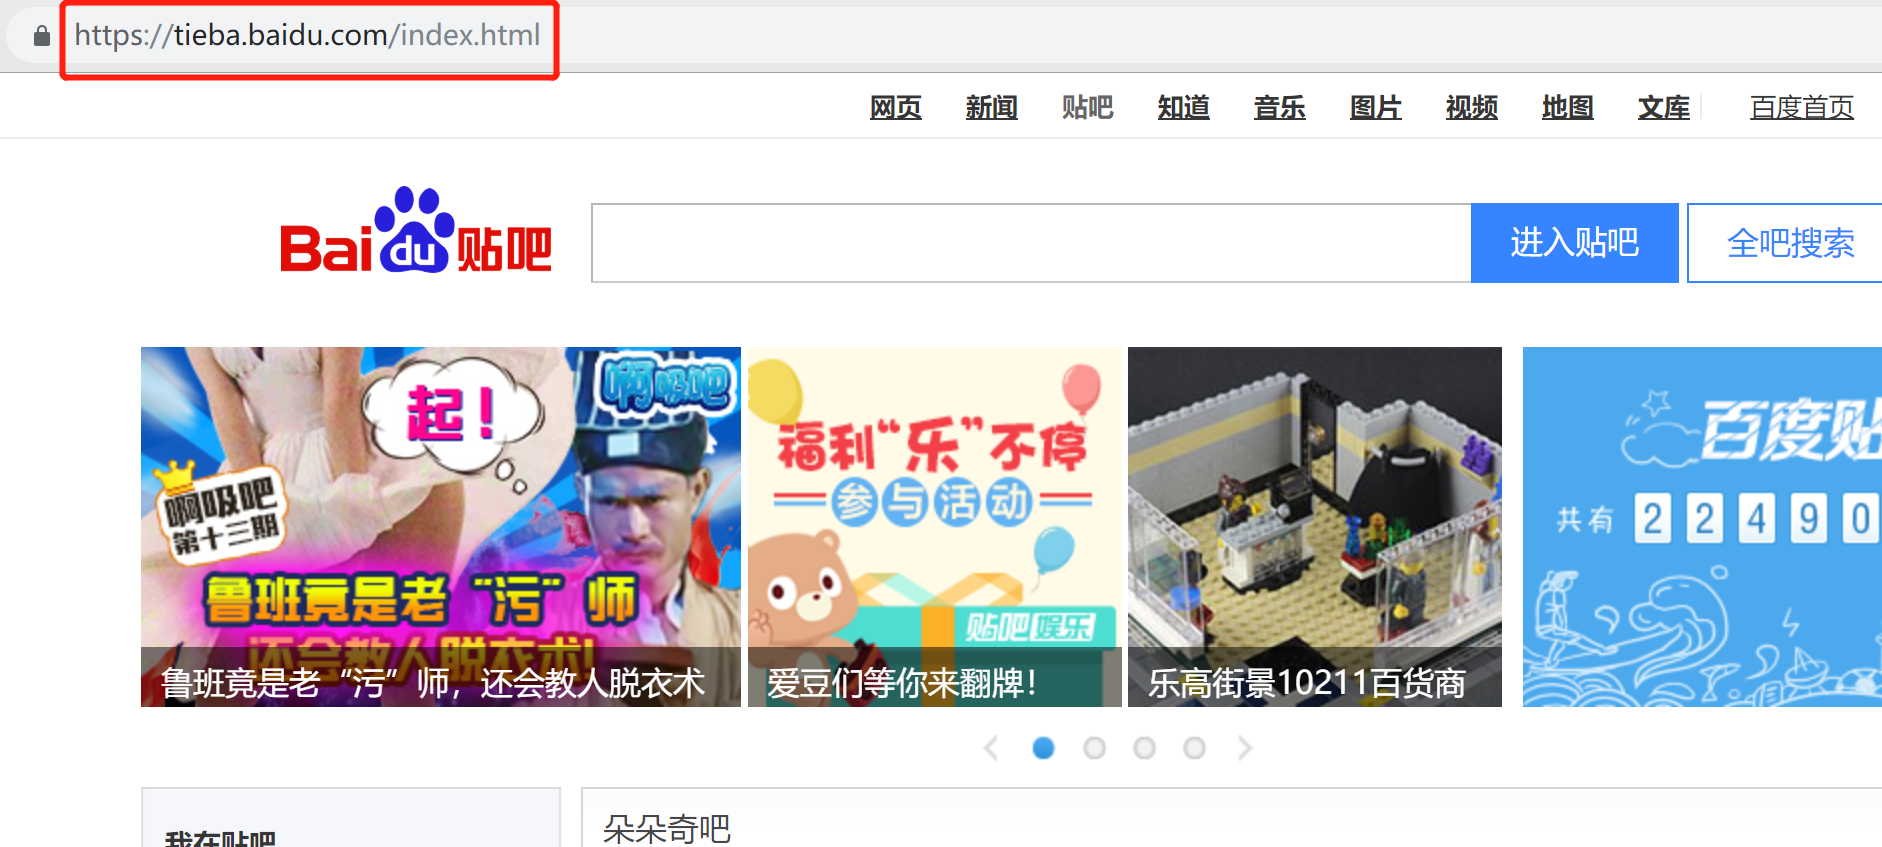
开始 首先使用chrome浏览器,进入百度贴吧 注意输入框中的url 分析 为了进行具体的url分析,我在搜索框中输入"Python",看一下url的变化 观察url变化 这时url变成了: http://tieba.baidu.com/f?ie=utf-8&kw=python&fr=search&red_tag=b2531475437 通过分析,做一个测试, 删除url一些东西: http://tieba.baidu.com/f?&kw=python 依旧可以得到正常的页面 下面进行翻页测试: 得到这样的一条url: http://tieba.baidu.com/f?kw=python&ie=utf-8&pn=50 通过分析,再进行一次测试,删除url中的一些东西: 得到下面的url http://tieba.baidu.com/f?kw=python&pn=50 依旧可以得到相应的页面,因此可以得出结论: kw 和 pn 是这个页面中最重要的关键词,kw控制关键词(其实就是keyword的缩写), pn(其实就是page_number的缩写)控制翻页,每翻一页,pn增加50,也就是说一页有50条数据。 分析结束,开始代码 初始url先用这个,之后再慢慢修改: http://tieba.baidu.com/f?kw=python&pn=50 直接上代码,注意看代码中的注释 # 爬取百度贴吧 import requests class BdTieba(): def __init__(self, name, pn): # 保存贴吧名 self.name = name # 初始url self.base_url = "http://tieba.baidu.com/f?kw={}&pn=".format(name) # 构造请求头 self.headers = { "User-Agent": "Mozilla / 5.0(Windows NT 10.0;Win64;x64)AppleWebKit/537.36(KHTML,likeGecko)Chrome/69.0.3497.100Safari/537.36" } # 2. 批量生成url # 使用列表推导式生成了url列表 self.url_list = [self.base_url + str(i*50) for i in range(pn)] # 打印测试 # print(self.url_list) # 3. 批量发送请求,封装发送请求 def get_data(self, url): response = requests.get(url, headers=self.headers) return response.content def save_data(self, data, index): filename = self.name + "_{}.html".format(index) with open(filename, "wb") as f: f.write(data) def run(self): # 1.请求初始url,测试使用 # response = requests.get(url=self.base_url, headers=self.headers) # 打印测试,测试成功返回结果 # print(response.text) # 2.批量生成url for url in self.url_list: data = self.get_data(url) # 3.批量发送请求 # 4.保存网页,为了保存的网页名字不重复,且有顺序,这里使用index进行区分 # 获取当前url的index index = self.url_list.index(url) # 保存 self.save_data(data, index) if __name__ == '__main__': bdspider = BdTieba("python", 10) bdspider.run() 这里我只通过批量生成url,并批量获取url响应,并保存了url响应数据,这里测试了10页数据,如果想要爬取每个url中的数据,还需要进行页面分析和提取,这里就需要使用xpath,作为新手入门的一个教程,后续我会拿这个项目继续改进,增加xpath解析,爬取每页的文字信息,这里就先到这了。 后面我会写一篇关于xpath的简单快速上手文章,然后再对这个实战进行下一步的更新 over~ peace~ 个人博客: www.limiao.tech 微信公众号:TechBoard

优秀的个人博客,低调大师

python-利用豆瓣爬虫发个动态

目前总的来说是失败了。原因可能是因为豆瓣验证码的问题,因为我看不到登录时候的界面,所以没法分析验证码的链接。(我用自己的浏览器登录都是默认不要验证码的,这就尴尬了),所以登录不上,后面的post也就没有意义了。把代码贴出来。 # -*- coding: utf-8 -*- """ Created on Sat Jan 6 14:45:40 2018 @author: xglc """ import requests import time session = requests.session() #创建request对象 def _login(iddata): url = 'https://www.douban.com/accounts/login' login_header = { 'User-Agent':'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36', 'Origin':'https://www.douban.com/accounts/login', } session.headers.update(login_header) session.post(url,data=iddata,headers=session.headers) #_login() #print(session.headers.items) def _saysth(say_data): url = 'https://www.douban.com/' add_headers = {'Cache-Control':'max-age=0', 'Content-Length':'20', 'Content-Type':'application/x-www-form-urlencoded' } session.headers.update(add_headers) session.post(url,data=say_data,headers=session.headers) if __name__ == '__main__': iddata = {'form_mail':'账号', 'form_password':'密码', 'redir':'https://www.douban.com', 'login':'登录', } _login(iddata) print ('_login') # print (session.headers.items) for i in range(5): print(5-i) time.sleep(1) say_data = {'ck':'OJop', 'comment':'vict', } _saysth(say_data) print('完成!') View Code 也不打算继续扣了,因为用的是自己平时用的账号,post 太多豆瓣别把我给封了?如果继续扣的话,大概方向有两点: 找出豆瓣验证码的链接(我手动登录完全看不到验证码,这是我的常用电脑,所以无法分析) 完善update一下headers的内容,那里还有一些需要修改的项。 这几天淮南雪都开始化了,零下5度,made,空调还给我偶尔出冷风,需要赶紧上班去办公室温暖一下。 手动分析豆瓣js查看: Python-关于豆瓣发布“说句话”,添加网页等的js行为分析

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册