首页 文章 精选 留言 我的

精选列表

搜索[爬虫系统],共10021篇文章
优秀的个人博客,低调大师

Java爬虫——微博热搜

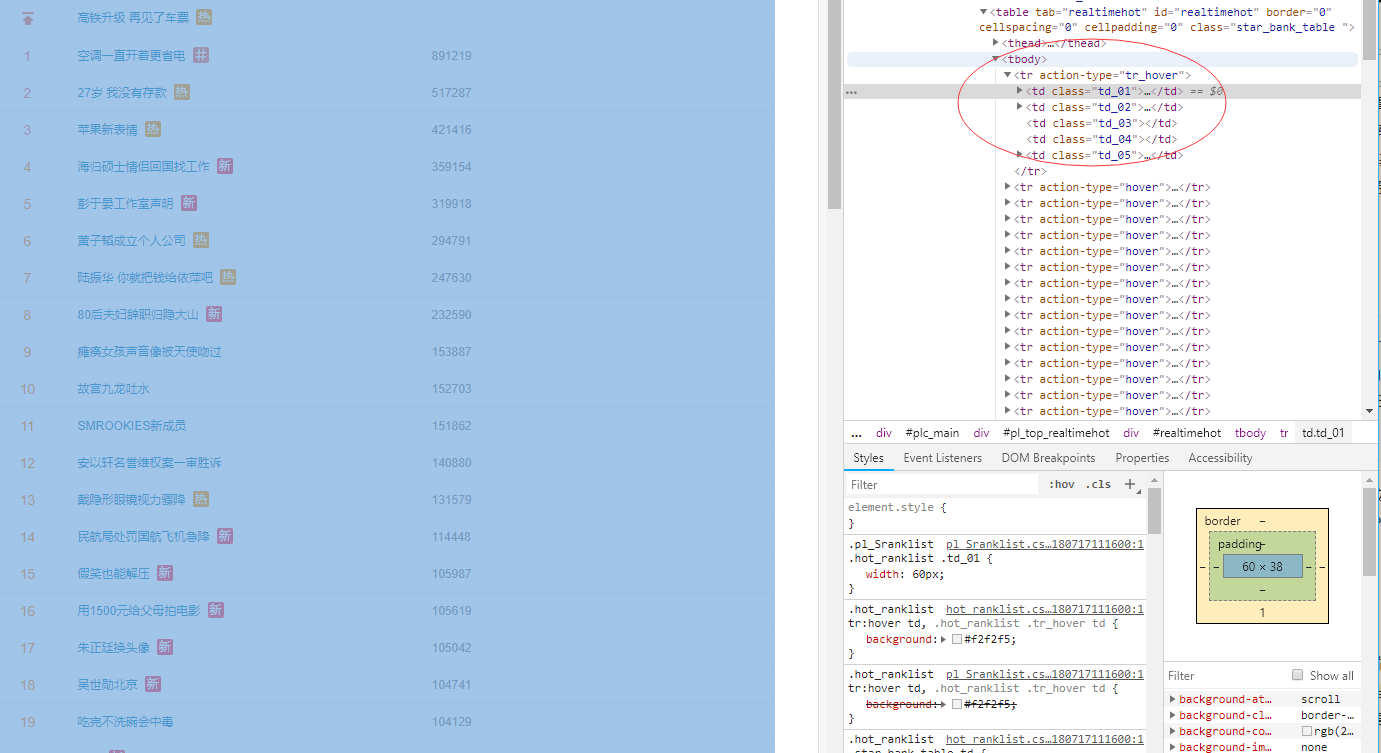
前言 自从写完关于Lifecycle的文章后就没有发现其他有兴趣的源码了,所以呢,我决定看看写写后台代码,尝试一波。经过大概一周的百度,SSM框架基本搭建完成。突发奇想,打算收集一下各种热搜。首先想到的那肯定是微博热搜了,so,我们来爬下微博热搜吧! 工具 Jsoup 是一款Java 的HTML解析器,可直接解析某个URL地址、HTML文本内容。它提供了一套非常省力的API,可通过DOM,CSS以及类似于jQuery的操作方法来取出和操作数据。 之前使用过Jsoup来抓取公交车实时到站信息,并且自己做了个简单的公交车到站查询APP。关于Jsoup的使用后面会讲到。 分析网页结构 在抓取数据的时候,首先要做的就是分析这个网页的结构,哪里是我们需要抓取的,哪些数据是我们需要的。我们先看下微博热搜,可以通过浏览器的开发者模式显示Html代码: 热搜html 我们可以看到,右边那<tbody>里面正是我们需要抓取的数据,话不多说,上码吧! 代码实现 先吐槽一波,微博在加载热搜的时候并没有直接用html加载,而是通过了一段js加载,如下图: 抓包结果 通过fiddler抓包可以看到,这里通过加载js来加载的热搜,而且里面有一段json,这段json就是我们需要的热搜数据(截图不好截图,后面再看吧)。 先写代码: 先根据json创建实体类: // 微博json对于的实体类 public class WeiboJsonEntity { private String pid; private List<String> js; private List<String> css; private String html; // get set } 真正热搜实体类: public class WeiboHotEntity { private Integer id = 0; private Integer sort = 0; private Integer num = 0; private String title; private String linkUrl; private String channel; private String date; // get set } 正式抓取网页: public static List<WeiboHotEntity> parseWeiboHot() { try { long currentTime = System.currentTimeMillis(); // 通过jsoup将对应url转为document Document doc = Jsoup.parse(new URL("http://s.weibo.com/top/summary?cate=realtimehot"), 10000); // 获取script标签对应的Element list Elements script = doc.select("script"); for (Element element : script) { String data = element.data(); // 这里是获取json开始的位置(最好的方式是正则匹配) int i = data.indexOf("("); if (i >= 0) { String substring = data.substring(i + 1, data.lastIndexOf(")")); try { // 通过Gson将json转成WeiboJsonEntity实体,出错肯定不是我们需要的 WeiboJsonEntity weiboJsonEneity = new Gson().fromJson(substring, WeiboJsonEntity.class); System.out.println(substring); // 热搜对应的部分 if (weiboJsonEneity.getPid().equals("pl_top_realtimehot")) { // 开始解析数据 return parseSearchTop(weiboJsonEneity, currentTime); } } catch (Exception e) { } } } } catch (IOException e) { e.printStackTrace(); } return null; } 获取到的热搜json: { "pid": "pl_top_realtimehot", "js": ["apps\/search_v6\/js\/pl\/top\/unLogin.js?version=20180717111600", "apps\/search_v6\/js\/pl\/searchHead.js?version=20180717111600", "apps\/search_v6\/js\/pl\/top\/realtimehot.js?version=20180717111600"], "css": ["appstyle\/searchV45\/css_v6\/pl\/pl_Sranklist.css?version=20180717111600", "appstyle\/searchV45\/css_v6\/pl\/pl_Srankbank.css?version=20180717111600", "appstyle\/searchV45\/css_v6\/patch\/Srank_hot.css?version=20180717111600"], "html": "<div class=\"hot_ranklist\">\n <table tab=\"realtimehot\" id=\"realtimehot\" border=\"0\" cellspacing=\"0\" cellpadding=\"0\" class=\"star_bank_table \">\n <thead>\n <tr class=\"thead_tr\">\n <th class=\"th_01\">序号<\/th>\n <th class=\"th_02\">关键词<\/th>\n <th class=\"th_03\">搜索热度<\/th>\n <th class=\"th_04\"><\/th>\n <th class=\"th_05\"><\/th>\n <\/tr>\n <\/thead>\n <tr action-type=\"tr_hover\">\n <td class=\"td_01\"><span class=\"icon_pinned\"><\/span><\/td>\n <td class=\"td_02\">\n <div class=\"rank_content\">\n <p class=\"star_name\">\n " } 可以看到我们需要的就是html里面的内容,这里面内容非为两部分: 中国特色主义推荐位,第一条: 推荐 普通热搜 剩下的那些 private static List<WeiboHotEntity> parseSearchTop(WeiboJsonEntity weiboJsonEneity, long currentTime) { List<WeiboHotEntity> weiboHotEntities = new ArrayList<>(); // 再次解析,将html代码转成document Document parse = Jsoup.parse(weiboJsonEneity.getHtml()); // 中国特色推荐!! Elements tbody = parse.getElementsByAttributeValue("action-type", "tr_hover"); for (Element element : tbody) { weiboHotEntities.add(parseDetail(element, currentTime)); } // 热搜 Elements hover = parse.getElementsByAttributeValue("action-type", "hover"); for (Element element : hover) { weiboHotEntities.add(parseDetail(element, currentTime)); } return weiboHotEntities; } 通过浏览器可以获取到其结构,我们需要提取action-type=tr_hover对应的元素 结构 之后,我们只需要根据需求获取td_01、td_02等里面的数据即可: private static WeiboHotEntity parseDetail(Element element, long currentTime) { WeiboHotEntity weiboHotEntity = new WeiboHotEntity(); Elements td01 = element.getElementsByClass("td_01"); // 排序 if (isListNotEmpty(td01)) { // 获取热度排名,如果没有的话,则是推荐设为0 Elements em = td01.get(0).getElementsByTag("em"); if (em != null && em.size() > 0) { // Integer integer = Integer.valueOf(em.get(0).text()); weiboHotEntity.setSort(integer); } else { weiboHotEntity.setSort(0); } } // 名称和链接 Elements td02 = element.getElementsByClass("td_02"); if (isListNotEmpty(td02)) { Elements a = td02.get(0).getElementsByTag("a"); if (isListNotEmpty(a)) { Element el = a.get(0); String href = el.attributes().get("href"); Elements i = td02.get(0).getElementsByTag("i"); if (isListNotEmpty(i)) { String text = i.get(0).text(); // 感觉就是个广告 if (text.equals("荐")) { weiboHotEntity.setLinkUrl(DOMAIN_WEIBO + "/weibo/" + el.text() + "&Refer=top"); } else { weiboHotEntity.setLinkUrl(DOMAIN_WEIBO + href); } } else { weiboHotEntity.setLinkUrl(DOMAIN_WEIBO + href); } weiboHotEntity.setTitle(el.text()); } } // 热度值 Elements td03 = element.getElementsByClass("td_03"); if (isListNotEmpty(td03)) { Elements span = td03.get(0).getElementsByTag("span"); if (isListNotEmpty(span)) { weiboHotEntity.setNum(Integer.valueOf(span.get(0).text())); } } weiboHotEntity.setChannel("微博"); weiboHotEntity.setDate(getDateStr(currentTime)); return weiboHotEntity; } 这里面都是比较简单的获取数据即可,比如获取排序,通过获取td_01里面的<em>标签的值即可。 排序 链接和名称以及热度值也是同理。这里说个比较有意思的,普通的热搜都是可以直接通过微博的域名+对应的链接跳转到相应的热搜,但是有一种标签,就是为 荐的标签需要配置特殊的跳转,这里已经处理了。 工具类: public static final String DOMAIN_WEIBO = "http://s.weibo.com"; public static boolean isListNotEmpty(List list) { return list != null && list.size() > 0; } public static String getDateStr(long currentTime) { Date time = new Date(currentTime); SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); return sdf.format(time); } 后记 写这个东西呢前面也说了,想做个热搜的整合,不过刚写没多少就没有了热度。最初是想爬取数据+百度搜索+爬取第一条图片+推送这种思路push到手机上,然后就可以开开心心看热搜了!(流产了,遂记于此,并没有后续)

优秀的个人博客,低调大师

python爬虫爬取豆瓣电影

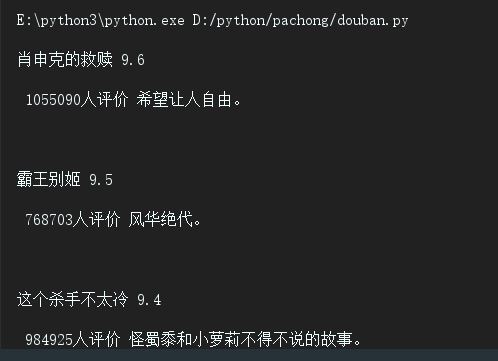
最近买了《python编程从入门到实践》,想之后写两篇文章,一篇数据可视化,一篇python web,今天这篇就当python入门吧。 一.前期准备: IDE准备:pycharm 导入的python库:requests用于请求,BeautifulSoup用于网页解析 二.实现步骤 1.传入url 2.解析返回的数据 3.筛选 4.遍历提取数据 三.代码实现 import requests # 导入网页请求库 from bs4 import BeautifulSoup # 导入网页解析库 # 传入URL r = requests.get("https://movie.douban.com/top250") # 解析返回的数据 soup=BeautifulSoup(r.content,"html.parser") #找到div中,class属性为item的div movie_list=soup.find_all("div",class_="item") #遍历提取数据 for movie in movie_list: title=movie.find("span",class_="title").text rating_num=movie.find("span",class_="rating_num").text inq=movie.find("span",class_="inq").text star = movie.find('div', class_='star') comment_num = star.find_all('span')[-1].text print(title, rating_num, '\n', comment_num, inq, '\n') 以title变量为例,我们找到了div中,class属性为item的div,然后在此div中,筛选出class名为title的span,获取文本内容,打印(comment_num比较特殊,因为其在star的div下,没有class属性,为div中最后一个span,所以我们取出star层级中最后一个span,变为文本),以下是输出结果。 豆瓣.JPG 四.对获取到的数据进行整合 1.整合成列表 2.整合成json文件 3.定义为函数形式 1.整合成列表 import requests # 导入网页请求库 from bs4 import BeautifulSoup # 导入网页解析库 import pprint # 规范显示列表的插件库 # 传入URL r = requests.get("https://movie.douban.com/top250") # 解析返回的数据 soup=BeautifulSoup(r.content,"html.parser") #找到div中,class属性为item的div movie_list=soup.find_all("div",class_="item") #创建存储结果的空列表 result_list=[] #遍历提取数据 for movie in movie_list: #创建字典 dict={} dict["title"]=movie.find("span",class_="title").text dict["dictrating_num"]=movie.find("span",class_="rating_num").text dict["inq"]=movie.find("span",class_="inq").text star = movie.find('div', class_='star') dict["comment_num"] = star.find_all('span')[-1].text result_list.append(dict) # 显示结果 pp = pprint.PrettyPrinter(indent=4) pp.pprint(result_list) 控制台显示的结果: 列表.JPG 2.整合成JSON文件 import requests # 导入网页请求库 import json# 用于将列表字典(json格式)转化为相同形式字符串,以便存入文件 from bs4 import BeautifulSoup # 导入网页解析库 # 传入URL r = requests.get("https://movie.douban.com/top250") # 解析返回的数据 soup=BeautifulSoup(r.content,"html.parser") #找到div中,class属性为item的div movie_list=soup.find_all("div",class_="item") #创建存储结果的空列表 result_list=[] #遍历提取数据 for movie in movie_list: #创建字典 dict={} dict["title"]=movie.find("span",class_="title").text dict["dictrating_num"]=movie.find("span",class_="rating_num").text dict["inq"]=movie.find("span",class_="inq").text star = movie.find('div', class_='star') dict["comment_num"] = star.find_all('span')[-1].text result_list.append(dict) # 显示结果 # 将result_list这个json格式的python对象转化为字符串 s = json.dumps(result_list, indent = 4, ensure_ascii=False) # 将字符串写入文件 with open('movies.json', 'w', encoding = 'utf-8') as f: f.write(s) 结果: json.JPG 3.定义成函数 import requests # 导入网页请求库 import json# 用于将列表字典(json格式)转化为相同形式字符串,以便存入文件 from bs4 import BeautifulSoup # 导入网页解析库 # 用于发送请求,获得网页源代码以供解析 def start_requests(url): r = requests.get(url) return r.content # 解析返回的数据 def parse(text): soup=BeautifulSoup(text,"html.parser") movie_list=soup.find_all("div",class_="item") result_list=[] for movie in movie_list: #创建字典 dict={} dict["title"]=movie.find("span",class_="title").text dict["dictrating_num"]=movie.find("span",class_="rating_num").text dict["inq"]=movie.find("span",class_="inq").text star = movie.find('div', class_='star') dict["comment_num"] = star.find_all('span')[-1].text result_list.append(dict) return result_list #将数据写入json文件 def write_json(result): s = json.dumps(result, indent = 4, ensure_ascii=False) with open('movies1.json', 'w', encoding = 'utf-8') as f: f.write(s) # 主运行函数,调用其他函数 def main(): url = 'https://movie.douban.com/top250' text = start_requests(url) result = parse(text) write_json(result) if __name__ == '__main__': main() 结果: 函数.JPG 觉得有用的话就给颗小吧~


优秀的个人博客,低调大师

学习了《python网络爬虫实战》第一个爬虫,爬取新浪新闻

请安装anaconda,其中附带的spyder方便运行完查看变量 1.进入cmd控制台, 输入 pip install BeautifulSoup4 pip install requests 2.编写代码,代码已经很清晰了,直接运行不会报错并有成功的结果 def getNewsDetail(newsUrl): import requests from bs4 import BeautifulSoup from datetime import datetime newsWeb = requests.get(newsUrl) newsWeb.encoding = 'utf-8' soup = BeautifulSoup(newsWeb.text,'lxml') result = {} result['title'] = soup.select('.main-title')[0].text result['newsSource'] = soup.select('.source')[0].text timeSource = soup.select('.date')[0].text result['datetime'] = datetime.strptime(timeSource,'%Y年%m月%d日 %H:%M') result['article'] = soup.select('.article')[0].text result['editor'] = soup.select('.show_author')[0].text.strip('责任编辑:') result['comment'] = soup.select('.num')[0].text return result def parseListLinks(url): import requests import json newsDetails = [] request = requests.get(url) jsonLoad = json.loads(request.text.lstrip(' newsloadercallback(').rstrip(');')) newsUrls = [] for item in jsonLoad['result']['data']: newsUrls.append(item['url']) for url in newsUrls: newsDetails.append(getNewsDetail(url)) return newsDetails if __name__ == '__main__': #获取单个新闻页面的信息 newsUrl = 'http://news.sina.com.cn/s/wh/2018-01-08/doc-ifyqkarr7830426.shtml' newsDetail = getNewsDetail(newsUrl) #获取整个列表各个新闻页面的信息 rollUrl='http://api.roll.news.sina.com.cn/zt_list?channel=news&cat_1=gnxw\ &cat_2==gdxw1||=gatxw||=zs-pl||=mtjj&level==1||=2&show_ext=1&show_all=1&\ show_num=22&tag=1&format=json&page=23&callback=newsloadercallback&_=1515911333929' newsDetails = parseListLinks(rollUrl)

优秀的个人博客,低调大师

Python爬虫入门教程 55-100 python爬虫高级技术之验证码篇

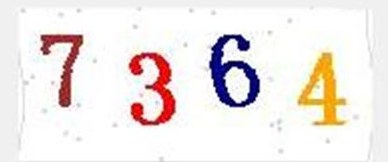
验证码探究 如果你是一个数据挖掘爱好者,那么验证码是你避免不过去的一个天坑,和各种验证码斗争,必然是你成长的一条道路,接下来的几篇文章,我会尽量的找到各种验证码,并且去尝试解决掉它,中间有些技术甚至我都没有见过,来吧,一起Coding吧 数字+字母的验证码 我随便在百度图片搜索了一个验证码,如下 今天要做的是验证码识别中最简单的一种办法,采用pytesseract解决,它属于Python当中比较简单的OCR识别库 库的安装 使用pytesseract之前,你需要通过pip 安装一下对应的模块 ,需要两个 pytesseract库还有图像处理的pillow库了 pip install pytesseract pip install pillow 如果你安装了这两个库之后,编写一个识别代码,一般情况下会报下面这个错误 pytesseract.pytes

优秀的个人博客,低调大师

Python爬虫入门教程 44-100 Charles的安装与使用-手机APP爬虫部分

1. 第二款抓包工具Charles安装与使用 Charles和Fiddler一样,也是一款抓包工具,比Fiddler界面更加清晰,支持多平台 1.1 官方网址 https://www.charlesproxy.com/ 1.2 下载地址 Charles工具下载地址:https://www.charlesproxy.com/download/ 自己去百度一款,我找了2个百度网盘的 链接挂了就不补了啊~ 链接: https://pan.baidu.com/s/1pMawsEv 密码:meuk 链接: https://pan.baidu.com/s/1kV3h0gf 密码: nqaa 下载之后,安装就比较简单了,常规操作即可 2. Charles基本操作 打开Charles在电脑上就可以使用了 2.1 PC设置抓包,包括HTTP和HTTPS 软件安装好了之

优秀的个人博客,低调大师

Python爬虫入门教程 51-100 Python3爬虫通过m3u8文件下载ts视频-Python爬虫6操作

什么是m3u8文件 M3U8文件是指UTF-8编码格式的M3U文件。M3U文件是记录了一个索引纯文本文件,打开它时播放软件并不是播放它,而是根据它的索引找到对应的音视频文件的网络地址进行在线播放。 原视频数据分割为很多个TS流,每个TS流的地址记录在m3u8文件列表中 比如我这里有一个m3u8文件,文件内容如下 #EXTM3U #EXT-X-VERSION:3 #EXT-X-MEDIA-SEQUENCE:0 #EXT-X-ALLOW-CACHE:YES #EXT-X-TARGETDURATION:15 #EXTINF:6.916667, out000.ts #EXTINF:10.416667, out001.ts #EXTINF:10.416667, out002.ts #EXTINF:1.375000, out003.ts #EXTIN

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册