首页 文章 精选 留言 我的

精选列表

搜索[Rust编程],共10000篇文章
优秀的个人博客,低调大师

Python Word 编程:插入、更新和管理域
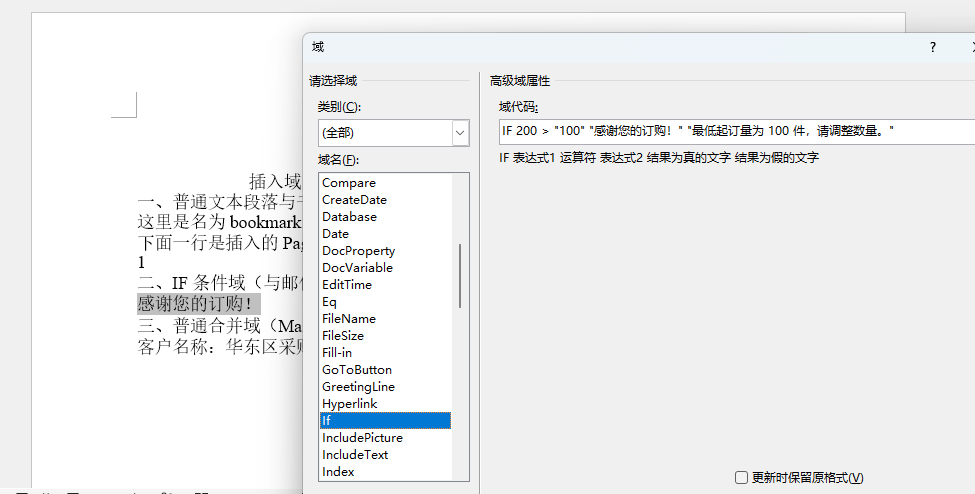
![使用 Python 在 Word 中插入和管理域](https://developer.qcloudimg.com/http-save/yehe-2596118/4cd5e48e5dde437edc635da24f2e98ab.png) 域(Field)是 Word 中的一种特殊元素,它的显示内容由域代码和域结果组成,可以根据环境或文档状态动态更新。例如页脚里的"第 X 页"、目录页码、章节引用,以及"如果数量大于 100 则显示某段文字"这种条件判断,都是通过域实现的。手动在 Word 中插入域需要熟悉域代码的写法,而且当一个文档里散落着几十个域时,逐个更新很麻烦。 用 Python 可以自动完成这些工作:批量插入不同类型的域、更新所有域的显示结果、读取域中的文本、删除不需要的域,甚至把域直接转换为普通文本。本文以 Spire.Doc for Python 为例演示这些操作。 ## 环境准备 安装 Spire.Doc 库: ```bash pip install Spire.Doc ``` 在脚本中引入模块: ```python from spire.doc import * from spire.doc.common import * ``` ## 在段落中插入一个简单的域 `Paragraph.AppendField()` 可以从现有文档中取出一个段落,在段落末尾插入指定类型的域。下面以页码引用(PageRef)域为例,域代码指定了要引用的书签名和显示格式: ```python document = Document() document.LoadFromFile("文档.docx") # 获取最后一个节并新建一个段落 section = document.LastSection par = section.AddParagraph() # 插入 PageRef 域并设置域代码 field = par.AppendField("pageRef", FieldType.FieldPageRef) field.Code = "PAGEREF bookmark1 \\# \"0\" \\* Arabic \\* MERGEFORMAT" # 更新域以获得正确的结果 document.IsUpdateFields = True document.SaveToFile("插入域.docx", FileFormat.Docx) document.Close() ``` `AppendField()` 的第一个参数是域的显示文本,第二个参数是 `FieldType` 枚举,用来声明域的类别。`FieldType.FieldNone` 表示空域,`FieldType.FieldPageRef`、`FieldType.FieldMergeField` 等则对应具体的域类型。插入后专门设置 `Code` 属性,相当于手动输入域代码。 ## 创建带条件的 IF 域 IF 域可以用来做条件判断,是动态文档生成中最常用的域之一。它比普通域复杂一些,需要先把 `IfField` 对象加入段落,再拼装条件、真值和假值三部分文本,最后补一个域结束标记: ```python def create_if_field(document, paragraph): if_field = IfField(document) if_field.Type = FieldType.FieldIf if_field.Code = "IF " paragraph.Items.Add(if_field) # 条件:合并字段 Count 的值大于 100 paragraph.AppendField("Count", FieldType.FieldMergeField) paragraph.AppendText(" > ") paragraph.AppendText("\"100\" ") # 真值和假值 paragraph.AppendText("\"Thanks\" ") paragraph.AppendText("\"The minimum order is 100 units\"") # 添加域结束标记 end = document.CreateParagraphItem(ParagraphItemType.FieldMark) end.Type = FieldMarkType.FieldEnd paragraph.Items.Add(end) if_field.End = end document = Document() section = document.AddSection() paragraph = section.AddParagraph() create_if_field(document, paragraph) # 用邮件合并数据填充 Count 字段 document.MailMerge.Execute(["Count"], ["2"]) # 更新所有域 document.IsUpdateFields = True document.SaveToFile("IF域.docx", FileFormat.Docx2013) document.Close() ``` `IfField` 是 `Field` 的子类,通过 `Items.Add()` 加入段落后再拼装内容。整个域以开始标记开始、以 `FieldMarkType.FieldEnd` 结束,`End` 属性用来把结束标记和域对象关联起来。配合 `MailMerge.Execute()` 把合并数据填进文档,IF 域就能根据实际数值显示不同的结果。 ## 结果演示 以下是上述两段代码生成的域: ![Python插入域到Word文档](https://developer.qcloudimg.com/http-save/yehe-2596118/33060456ac6741677b6f2b56fa3f19b3.png) ## 更新文档中的所有域 域显示的是"最后一次计算的结果"。如果文档是在程序里动态生成的,或者数据发生了变化,需要在保存前重新计算: ```python document = Document() document.LoadFromFile("文档.docx") # 保存前更新所有域 document.IsUpdateFields = True document.SaveToFile("更新域.docx", FileFormat.Docx) ``` `IsUpdateFields` 设置在 `SaveToFile()` 之前即可,保存时文档会重新计算所有域的结果。这是动态生成 Word 文档时经常要做的最后一步。 ## 读取域中的文本 `Document.Fields` 属性返回文档中全部域的集合,每个域通过 `FieldText` 属性暴露当前计算出的文本结果: ```python document = Document() document.LoadFromFile("文档.docx") fields = document.Fields for i in range(fields.Count): field = fields.get_Item(i) print(field.FieldText) document.Close() ``` 遍历集合可以在不了解文档结构的情况下,快速排查某个域是否生效、结果是否符合预期。`fields[0]` 可以直接按索引访问第一个域。 ## 将域转换为普通文本 有时文档定稿后不再需要动态更新,比如把生成的订单或合同导出给客户查看。这时可以把域转换为普通文本,避免接收方打开文件时域结果因环境差异而发生变化: ```python document = Document() document.LoadFromFile("文档.docx") fields = document.Fields count = fields.Count for i in range(0, count): field = fields[0] s = field.FieldText index = field.OwnerParagraph.ChildObjects.IndexOf(field) text_range = TextRange(document) text_range.Text = s text_range.CharacterFormat.FontSize = 24 # 用文本替换域的位置,再移除域 field.OwnerParagraph.ChildObjects.Insert(index, text_range) field.OwnerParagraph.ChildObjects.Remove(field) document.SaveToFile("域转文本.docx", FileFormat.Docx) document.Close() ``` 核心思路是:先读取域的当前文本,在域所在段落的位置插入一个 `TextRange`,再把原本的域对象移出段落。由于每次处理后 `fields.Count` 会相应变化,使用 `fields[0]` 循环处理即可把剩余域逐一清理干净。 ## 删除不需要的域 删除域比转换更简单——找到域所在的段落,按索引直接移除: ```python document = Document() document.LoadFromFile("文档.docx") # 获取第一个域及其所在段落 field = document.Fields[0] par = field.OwnerParagraph # 定位域在段落中的位置并删除 index = par.ChildObjects.IndexOf(field) par.ChildObjects.RemoveAt(index) document.SaveToFile("删除域.docx", FileFormat.Docx) document.Close() ``` `OwnerParagraph` 返回域所属的段落,`ChildObjects` 是段落内的对象集合,`IndexOf()` 找到域的下标后,`RemoveAt()` 即可把它删除。需要批量删除时,把这段逻辑放进循环即可。 ## 实用提示 - 域代码在 Word 中按 `Alt+F9` 可以切换显示,建议在生成后手动确认关键域的代码格式是否正确。 - `IsUpdateFields` 要在 `SaveToFile()` 之前设置,否则保存结果里域不会被重新计算。 - IF 域的条件部分要严格按"表达式 + 比较符 + 值"的顺序拼装,文本值必须用英文双引号包住。 - 域转文本会丢失域的动态特性,适合文档定稿或对外分发前的处理;文档内部流转时建议保留域。 - 处理完文档后调用 `document.Close()` 释放资源。 ## 总结 本文介绍了用 Python 在 Word 文档中操作域的常用方法:用 `AppendField()` 插入简单域、用 `IfField` 构造条件域、用 `IsUpdateFields` 统一更新所有域、借助 `Document.Fields` 读取域文本、把域转为普通文本,以及通过 `OwnerParagraph` 定位并删除域。掌握这些操作后,动态文档中的页码、条件和合并数据都可以交给脚本统一处理。
优秀的个人博客,低调大师

CUDA 编程:Tensor Core 与混合精度 GEMM

### 文章目录 - 1. 背景 - 2. Tensor Core 的核心思想 - 3. 实验环境 - 4. 实现方式 - FP32 SGEMM - Mixed Precision GEMM - 5. 实验结果 - 5.1 不同矩阵规模性能 - 5.2 GFLOPS 对比 - 6. Tensor Core 为什么越大矩阵越快? - 7. 矩阵尺寸对 Tensor Core 的影响 - 8. Tensor Core不是简单降低精度 - 9. 实验结论 > 从 cuBLAS SGEMM 到 Tensor Core GEMM,探索现代 GPU 矩阵计算的核心优化路径。 ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-6980195/e7fca35ec564b812fd341d6272573e90.png) # **1. 背景** 前一节,我们比较了: - CPU MatMul - CUDA Naive Kernel - Shared Memory Kernel - cuBLAS SGEMM 发现 cuBLAS 已经远超手写 CUDA Kernel。 但现代深度学习模型中的矩阵计算,还会进一步使用: > Tensor Core + Mixed Precision 例如: - Transformer Linear 层 - Attention Projection - MLP - CNN 卷积 大量采用 FP16/BF16 混合精度计算。 本节在 Tesla T4 上测试: ``` FP32 SGEMM vs FP16 Tensor Core GEMM ``` # **2. Tensor Core 的核心思想** 普通 CUDA Core: ``` 一个线程 | | 标量乘加 | ↓ a*b+c ``` Tensor Core: ``` Matrix A | | Tensor Core | | Matrix B ---------> Matrix C 一次完成矩阵块乘加 D = A × B + C ``` Tensor Core 针对矩阵计算进行了硬件优化: - 矩阵块运算 - 高吞吐 FP16 运算 - FP32 累加保证稳定性 # **3. 实验环境** GPU: ``` Tesla T4 Compute Capability: 7.5 ``` 测试: |项目|配置| | --- | --- | |输入类型|FP16| |累加类型|FP32| |输出类型|FP32| |计算库|cuBLAS| |GPU|Tesla T4| |矩阵规模|512~4096| # **4. 实现方式** ## **FP32 SGEMM** 计算流程: ``` FP32 Matrix A + FP32 Matrix B ↓ cuBLAS SGEMM ↓ FP32 Matrix C ``` ## **Mixed Precision GEMM** 流程: ``` FP32 数据 ↓ 转换 FP16 ↓ Tensor Core FP16 × FP16 ↓ FP32 accumulate ↓ FP32 Output ``` 关键代码: ``` cublasGemmEx( handle, ..., CUDA_R_16F, ..., CUDA_R_16F, ..., CUDA_R_32F, ..., CUBLAS_COMPUTE_32F, CUBLAS_GEMM_DEFAULT_TENSOR_OP ); ``` 含义: |配置|作用| | --- | --- | |CUDA_R_16F|输入 FP16| |CUDA_R_32F|输出 FP32| |CUBLAS_COMPUTE_32F|FP32累加| |Tensor_OP|启用Tensor Core| # **5. 实验结果** ## **5.1 不同矩阵规模性能** |矩阵规模|FP32(ms)|Tensor Core(ms)|加速| | --- | --- | --- | --- | |512×512|0.0492|0.0299|1.64×| |1024×1024|0.2475|0.0946|2.62×| |2048×2048|1.4601|0.5835|2.50×| |4096×4096|16.2076|4.7007|3.45×| 可以看到: 随着矩阵规模增加: ``` Tensor Core 优势逐渐扩大 ``` ## **5.2 GFLOPS 对比** |矩阵规模|FP32 SGEMM|Mixed GEMM| | --- | --- | --- | |512|5457 GFLOPS|8969 GFLOPS| |1024|8675 GFLOPS|22694 GFLOPS| |2048|11766 GFLOPS|29442 GFLOPS| |4096|8479 GFLOPS|29237 GFLOPS| 性能变化: 4096矩阵: ``` FP32: 8.5 TFLOPS Tensor Core: 29.2 TFLOPS ``` 接近: ``` 3.5倍提升 ``` # **6. Tensor Core 为什么越大矩阵越快?** 小矩阵: ``` 计算量较少 Kernel启动 调度 缓存 占比较高 ``` 大矩阵: ``` 更多矩阵Tile ↓ Tensor Core持续工作 ↓ 硬件利用率提高 ``` 因此: ``` N ↑ Tensor Core利用率 ↑ 加速比 ↑ ``` # **7. 矩阵尺寸对 Tensor Core 的影响** |Matrix Size|FP32 SGEMM(ms)|Tensor Core GEMM(ms)|Speedup| | --- | --- | --- | --- | |1024×1024|0.2636|0.1037|2.54×| |1023×1023|0.4504|0.1683|2.68×| |2048×2048|1.2328|0.4890|2.52×| |2047×2047|2.9654|1.1937|2.48×| |Matrix Size|FP32 SGEMM|Tensor Core GEMM| | --- | --- | --- | |1024|8147 GFLOPS|20711 GFLOPS| |1023|4754 GFLOPS|12723 GFLOPS| |2048|13935 GFLOPS|35132 GFLOPS| |2047|5784 GFLOPS|14371 GFLOPS| 非规则尺寸需要: ``` padding 边界处理 ``` GPU 高性能计算非常依赖规则的数据布局 # **8. Tensor Core不是简单降低精度** 很多人认为: ``` FP16 = 精度差 ``` 实际上: Tensor Core 混合精度: ``` 输入: FP16 计算: FP32 accumulate 输出: FP32 ``` 结构: ``` FP16 | | Tensor Core | | FP32 Accumulate | | FP32 ``` 兼顾: ``` 速度 + 精度 ``` # **9. 实验结论** 本次 Tesla T4 实验得到: 1. **Tensor Core 显著提高 GEMM 性能** 1. **矩阵越大,Tensor Core优势越明显** 1. **混合精度是AI推理的重要优化** > CUDA Kernel 可以让我们理解 GPU 工作方式,而 Tensor Core 代表现代 GPU 矩阵计算的极致性能。 对于深度学习推理和训练,合理使用 FP16/BF16 混合精度,是获得高吞吐的重要手段。

优秀的个人博客,低调大师

CUDA编程:Histogram 直方图统计与 Atomic 优化

### 文章目录 - 1. 本课目标 - 2. 什么是 Histogram? - 3. 为什么 Histogram 在 GPU 上有难点? - 4. 两种实现方式 - Global Atomic Histogram - Shared Memory 局部 Histogram - 5. 实验设计 - 6. CUDA C++ 代码 - 7. 编译与运行 - 8. 推荐实验组合 - 8.1 均匀分布 - 8.2 热点分布 - 8.3 数据规模变化 CUDA 第 12 课:Histogram 直方图统计与 Atomic 优化 第 10 课讲了 **Reduction:很多数归约成一个数**。 第 11 课讲了 **Prefix Scan:很多数生成前缀位置**。 第 12 课进入另一个非常常见的并行模式: > **❝Histogram:把大量数据按照类别/bin 统计频次。** 它在图像处理、推荐系统、日志统计、token 分布统计、排序预处理、采样分析中都非常常见。 # **1. 本课目标** 本节课重点掌握: ``` 1. 什么是 histogram 直方图 2. 为什么 histogram 容易产生 atomic 冲突 3. 掌握 global atomic histogram 的基础写法 4. 掌握 shared memory 局部 histogram 优化 5. 理解“先局部统计,再全局合并”的优化思想 6. 对比不同 bin 数量、数据分布下的性能差异 ``` # **2. 什么是 Histogram?** 假设输入数组是: ``` input = [1, 2, 1, 3, 2, 1, 0, 3] ``` 我们希望统计每个数字出现了多少次。 如果 bin 数量是 4,也就是统计 `0,1,2,3` 四类: ``` hist[0] = 1 hist[1] = 3 hist[2] = 2 hist[3] = 2 ``` 最终结果: ``` hist = [1, 3, 2, 2] ``` ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-6980195/d1c45930b905dcc56246ebfe84d5bcbe.png) 在这里插入图片描述 # **3. 为什么 Histogram 在 GPU 上有难点?** 如果每个线程处理一个元素: ``` int bin = input[idx]; atomicAdd(&hist[bin], 1); ``` 问题是:很多线程可能同时更新同一个 bin。 例如输入里大量元素都是 `1`: ``` input = [1, 1, 1, 1, 1, 1, ...] ``` 那么所有线程都执行: ``` atomicAdd(&hist[1], 1); ``` 这会造成严重竞争。 所以 histogram 的核心难点是: ``` 多个线程可能同时写同一个地址 必须用 atomic 保证正确性 但 atomic 冲突会影响性能 ``` # **4. 两种实现方式** ## **Global Atomic Histogram** 最简单写法: ``` atomicAdd(&global_hist[bin], 1); ``` 优点: ``` 代码简单 结果正确 适合 bin 多、冲突不严重的情况 ``` 缺点: ``` 所有 block 都直接竞争 global memory 当数据集中在少数 bin 时会很慢 ``` ## **Shared Memory 局部 Histogram** 优化思路: ``` 每个 block 先在 shared memory 中统计一个局部 hist 然后每个 block 再把局部 hist 合并到 global hist ``` 流程: ``` Global input ↓ 每个 block 建立 shared_hist ↓ block 内线程 atomicAdd(shared_hist[bin], 1) ↓ block 内统计完成 ↓ 把 shared_hist 合并到 global_hist ``` 这样可以把大量 global atomic 竞争变成: ``` block 内 shared atomic + 少量 global atomic ``` 通常会更快,尤其是 bin 数量不大时。 # **5. 实验设计** 我们实现并比较: ``` 1. CPU histogram 2. GPU global atomic histogram 3. GPU shared memory histogram ``` 测试维度: ``` 1. bin 数量:16、64、256 2. 数据规模:1M、16M、64M 3. 数据分布: - 均匀分布:冲突较平均 - 热点分布:大量数据集中在少数 bin ``` # **6. CUDA C++ 代码** 保存为: ``` lesson12_histogram.cu ``` 代码如下: ``` #include #include #include #include #include #include #include #include #define CUDA_CHECK(call) \ do { \ cudaError_t err = call; \ if (err != cudaSuccess) { \ std::cerr (blockIdx.x) * blockDim.x + threadIdx.x; if (idx (blockIdx.x) * blockDim.x + threadIdx.x; size_t stride = static_cast(blockDim.x) * gridDim.x; for (size_t i = global_tid; i 0) { atomicAdd(&global_hist[i], shared_hist[i]); } } } /* * 用 cudaEvent 计时一个 kernel。 */ template float time_kernel(LaunchFunc launch, int repeat) { /* * warmup */ launch(); CUDA_CHECK(cudaDeviceSynchronize()); cudaEvent_t start, stop; CUDA_CHECK(cudaEventCreate(&start)); CUDA_CHECK(cudaEventCreate(&stop)); float total_ms = 0.0f; for (int r = 0; r & a, const std::vector& b, int bins) { for (int i = 0; i & input, int bins, const std::string& mode) { std::mt19937 rng(12345); std::uniform_int_distribution uniform_dist(0, bins - 1); std::uniform_real_distribution prob(0.0f, 1.0f); for (size_t i = 0; i = 2) { n = static_cast(std::atoll(argv[1])); } if (argc >= 3) { bins = std::atoi(argv[2]); } if (argc >= 4) { block_size = std::atoi(argv[3]); } if (argc >= 5) { repeat = std::atoi(argv[4]); } if (argc >= 6) { mode = argv[5]; } if (bins 4096) { std::cerr 1024) { std::cerr (bins) * sizeof(int); std::cout h_input(n); std::vector h_cpu_hist(bins, 0); std::vector h_global_hist(bins, 0); std::vector h_shared_hist(bins, 0); generate_input(h_input, bins, mode); /* * CPU timing. */ auto cpu_start = std::chrono::high_resolution_clock::now(); histogram_cpu(h_input.data(), h_cpu_hist.data(), n, bins); auto cpu_end = std::chrono::high_resolution_clock::now(); double cpu_ms = std::chrono::duration( cpu_end - cpu_start ).count(); int* d_input = nullptr; int* d_global_hist = nullptr; int* d_shared_hist = nullptr; CUDA_CHECK(cudaMalloc(&d_input, input_bytes)); CUDA_CHECK(cudaMalloc(&d_global_hist, hist_bytes)); CUDA_CHECK(cudaMalloc(&d_shared_hist, hist_bytes)); CUDA_CHECK(cudaMemcpy(d_input, h_input.data(), input_bytes, cudaMemcpyHostToDevice)); /* * Global atomic kernel 配置。 */ int grid_global = static_cast((n + block_size - 1) / block_size); auto launch_global = [&]() { CUDA_CHECK(cudaMemset(d_global_hist, 0, hist_bytes)); histogram_global_atomic_kernel>>( d_input, d_global_hist, n ); CUDA_CHECK(cudaGetLastError()); }; /* * Shared histogram kernel 配置。 * * 使用固定 block 数量,配合 grid-stride loop。 * 不要让 block 数过大,否则每个 block 都要合并一次 hist,global atomic 次数也会上升。 */ int sm_count = 0; CUDA_CHECK(cudaDeviceGetAttribute(&sm_count, cudaDevAttrMultiProcessorCount, 0)); int grid_shared = sm_count * 4; size_t shared_bytes = hist_bytes; auto launch_shared = [&]() { CUDA_CHECK(cudaMemset(d_shared_hist, 0, hist_bytes)); histogram_shared_kernel>>( d_input, d_shared_hist, n, bins ); CUDA_CHECK(cudaGetLastError()); }; float global_ms = time_kernel(launch_global, repeat); float shared_ms = time_kernel(launch_shared, repeat); CUDA_CHECK(cudaMemcpy(h_global_hist.data(), d_global_hist, hist_bytes, cudaMemcpyDeviceToHost)); CUDA_CHECK(cudaMemcpy(h_shared_hist.data(), d_shared_hist, hist_bytes, cudaMemcpyDeviceToHost)); bool global_ok = check_hist(h_cpu_hist, h_global_hist, bins); bool shared_ok = check_hist(h_cpu_hist, h_shared_hist, bins); std::cout **❝Histogram 优化的本质,是把全局范围的大量写冲突,拆成 block 内局部冲突和少量全局合并。**

优秀的个人博客,低调大师

Flyde - 可视化后端逻辑编程工具

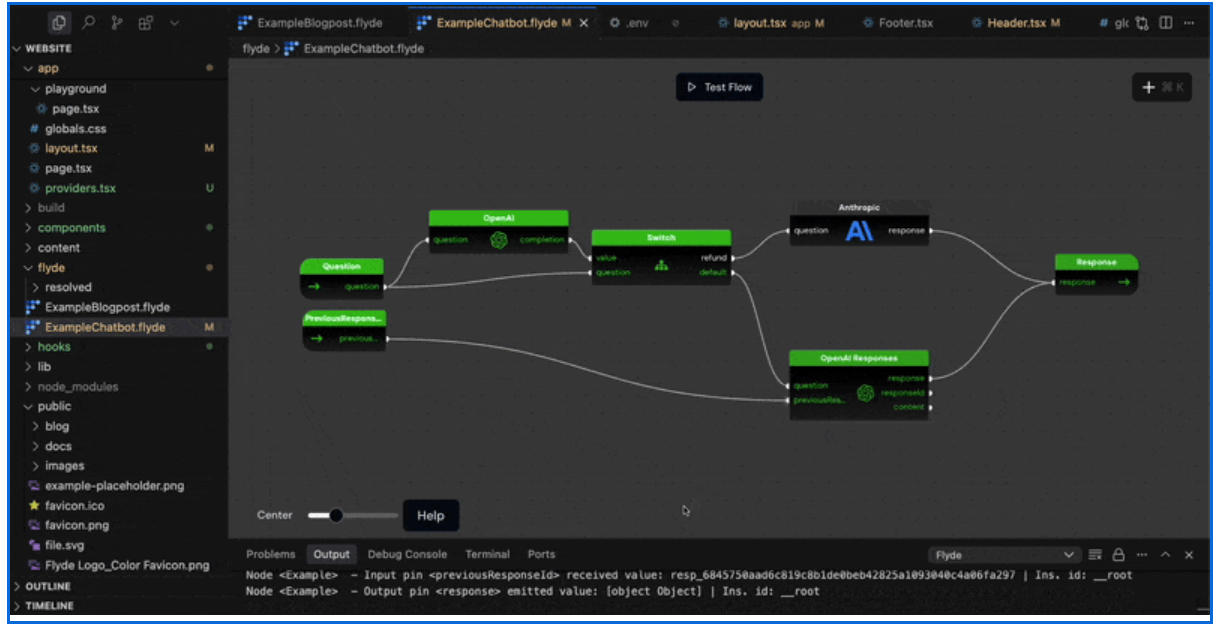
Flyde是一个用于原型设计、集成、评估和迭代 AI 密集型后端逻辑的整体解决方案。它是 TypeScript 的可视化扩展,可在代码库中运行,为从事后端 AI 工作流的开发人员和非开发人员之间提供缺失的链接。 Flyde 允许你为 AI 代理、提示链、API 编排和代理工作流等后端服务创建可视化流程,并直接与你现有的代码库集成。它包含一个VSCode 扩展,可与现有的 TypeScript/JavaScript 代码无缝集成。 优点: 代码库集成直接在你的代码库中运行,并可访问运行时代码和现有的后端框架。与独立工具不同,Flyde 以库的形式集成到你现有的工具和 CI/CD 流水线中。 可视化后端 AI 工作流程以可视化的方式对 AI 密集型后端逻辑进行原型设计、集成、评估和迭代。使用可视化界面构建后端 AI 代理、提示链和代理工作流,同时保持对代码的完全控制。 降低合作障碍TypeScript 的可视化扩展,弥合了开发人员和非开发人员之间的差距。使你的整个团队都能为后端 AI 工作流开发做出贡献。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册