首页 文章 精选 留言 我的

精选列表

搜索[编译原理],共10000篇文章
优秀的个人博客,低调大师

每日一博 | LangChain 原理学习笔记

最新越发觉得AI的发展,对未来是一场革命,LangChain已经在工程设计上有了最佳实践,类似于AI时代的编程模型或编程框架,有点Spring框架的意思。之前在LangChain上也有些最佳实践,所以在这里分享记录下。 LangChain解决什么问题 LangChain是基于LLM之上的,在应用层和底层LLM之前的一个很好的编程框架,如果把LLM比喻为各种类型的数据库、中间件等这些基础设施,应用层是各种业务逻辑的组合之外,那么LangChain就负责桥接与业务层和底层LLM模型,让开发者可以快速地实现对接各种底层模型和快速实现业务逻辑的软件开发框架。 那么LangChain是如何做到的呢?试想一下,现在底层有一个大模型的推理能力,除了在对话框手动输入跟他聊天之外。如何用计算机方式跟它互动呢?如果把一次LLM调用当作一个原子能力,如何编排这些原子能力来解决一些业务需求呢?Langchain就是来解决这个事情的。 LangChain的几个核心概念 ▐Model I/O 这里重点把背后的LLM模型做了一层封装,开发者可以通过更改配置的方式快速切换底层LLM模型,比如chatgpt,chatGLM、通义千问等模型。 同时还有些高阶功能:比如提供了缓存等功能,这样对于语义上类似的query,如果缓存有,那么langchain可以快速返回结果,而不需要调用大模型。 ▐Retriver 检索是为了解决大模型打通用户的本身数据,做一些面向业务属性的东西。这里的检索并非传统的关系型数据库,更多的是与大模型的本身逻辑相似的,比如向量数据库。 一个经典的结合LLM和外部用户的文档进行智能答疑的场景 文档->分词->embedding->向量数据库 query->向量数据库查询->TOP N->上下文+ 用户提问 + prompt -> LLM -> 返回结果 一个经典的图如下: 关键技术:文档如何拆分、embedding过程、 TOPN 向量距离的选择 embedding技术选型 embedding是将现实中的物体通过向量化的方法转化为高维向量,可被机器学习模型所识别。他是一种映射,同时也保证了能清晰地表达现实物体的特征。基于此,可以进行一些归类分析、回归分析等。 现在市面上常见的embedding方法有通义千问的embedding等方法。 向量数据库: 向量数据库底层存储的是一堆向量,它提供了根据向量相似度进行查询的能力,一般情况下,向量相似度代表了现实世界中物体的相似度。比如”我的名字是小明“ 和“我叫小明”这两句话所代表的含义几乎是相同的,那么在embedding之后,基于向量数据库进行查询的时候,它们俩的相似度就会很近。 ▐Chain 各种类型的chain,chain代表了各种业务类型的组合,类似于工作流的编排。 ▐Memory LLM本身提供了记忆的能力,同时提供了接口,开发者可以将历史的对话记录传入给LLM。LangChain需要使用外部存储保存这些历史的会话和记忆。可以使用数据库、缓存等进行保存。 ▐Agent 重点是代理工具 代理工具可以让应用程序基于大模型的推理能力,然后进行代理工具或代理服务的调用。因为LLM是没有“联网”的能力的,如果想解决特定的应用场景,代理工具是个完美的选择。 代理工具通常包含三个方面:用户输入、prompt编排LLM思考与路由代理的过程、背后的代理服务。其中难点可能就在于prompt设计了。通常的“套路”是这样的: ReAct 模型 输入:用户的问题 思考过程:如果是情况1(这个是需要LLM进行意图识别进行思考的),那么推理和提取出一些关键参数,调用agent1,如果是情况2,那么推理和提取出一些关键参数,调用agent2 Act:调用agent1对应一个JSON格式化的输入,调用function1,返回结果。 观察:观察调用后的结果,再结合推理的能力,再进行循环思考。 LangChain的在实际场景中的实践 集团内部开发了一个JAVA版本的LangChain框架,以下实践基于此框架与开源大模型chatGLM-6B进行。 ▐淘宝开放平台智能问答 淘宝开放平台对内托管了上万个API,每天在内部群里都会有开发者咨询API发布问题,之前我们是通过NLP来实现智能问答的,现将它升级为基于大模型的智能问答,以下是具体的技术实现过程。 知识库Embedding过程 由于之前已经沉淀好了很多知识库,都是Question-Answer的这种形式,这里我们对Question,也就是问题进行Embedding,此处采用通义千问提供的Embedding方法。 知识库embedding: TongYiEmbeddings embeddings = new TongYiEmbeddings();embeddings.setServerAccessId(ALINLP_EMBEDDINGS_ACCESSID);embeddings.setServerUrl(ALINLP_EMBEDDINGS_SERVER_URL);embeddings.setServerUuid(ALINLP_EMBEDDINGS_UUID);Document document = new Document();document.setPageContent(rawText);List<Document> documents = embeddings.embedDocument(Arrays.asList(document));Document vecDocument= documents.get(0);// 向量化知识String embeddingString = JSON.toJSONString(vecDocument.getEmbedding()).replaceAll("\\[", "{").replaceAll("\\]", "}");return embeddingString; 向量数据库存储和查询 此处采用hologres向量数据库,图中红框表示知识库问题与回答在数据库中具体的向量化存储数据。 向量距离数据库查询: select origin_content as originContent, origin_title as originTitle, pm_approx_squared_euclidean_distance(embedding_title, #{embeddingTitle}) as distancefrom vs_knowledgeorder by distance asclimit #{limit} 大模型问答链路 问答chain的基本实现: //1. 初始化ChatGLM的参数ChatGLMV2Internal chatGLMV2Internal = new ChatGLMV2Internal();chatGLMV2Internal.setTemperature(0.01d);chatGLMV2Internal.setMaxLength(2048);//2. 提示词编写PromptTemplate prompt = new PromptTemplate();String template = "已知信息:\n" +"{context} \n" +"\n" +"根据上述已知信息,简洁和专业的来回答用户的问题。如果无法从中得到答案,请说 “根据已知信息无法回答该问题” 或 “没有提供足够的相关信息”,不允许在答案中添加编造成分,答案请使用中文。问题是:{question}";prompt.setTemplate(template);//3. 向量数据库检索配置,比如最大向量距离RetrievalQA qa = new RetrievalQA();qa.setRecommend(5);qa.setMaxDistanceValue(10000.0d);qa.setLlm(chatGLMV2Internal);qa.setPrompt(prompt);qa.setRetriever(holoRetriver.asRetriever());qa.init();//4. LLM大模型问答Map<String, Object> inputs = new HashMap<>();inputs.put("question", question);inputs.put("input", question);Map<String, Object> outputs = qa.run(inputs);llmKonwledgeDO.setContent(String.valueOf(outputs.get("text")));// 补充 doclistreturn llmKonwledgeDO; ▐AI Agent实践 以下实现了一个网关API调用日志解析的agent。 Agent工具注册: this.setName("ApiLogTool");this.setDescription("这是一个调用日志查询接口,如果[{question}]中包含requestId关键字,你可以请求这个工具与日志系统进行交互,调用这个工具。\n" + "请先提取出requestId的值,将它赋值为value。调用参数:[{\"requestId\": \"value\", \"type\": \"String\", \"description\": \"调用请求id\"}]。"); 工具解析: Map<String,Object> parse = (Map<String,Object>)JSON.parse(toolInput);if(parse.get("requestId")==null){ return new ToolExecuteResult("");}String requestId = parse.get("requestId").toString();ApiLogSearchQuery apiLogSearchQuery = new ApiLogSearchQuery();//日志查询解析处理 思考决策逻辑: public static final String FORMAT_INSTRUCTIONS_CH ="用户提出了一个问题: {question} \n" +"你可以选择使用下面这些工具:\n"+"{tool_list_description}"+"\n"+"同时你的思考过程如下:"+"Thought: 每一次你需要首先思考你应该做什么\n" +"Action: 你需要决定是否使用工具,应该是[{tool_names}] 中的一个Action,格式为JSON。如果匹配不到工具,就不要思考了,直接返回结果,请不要把思考过程返回给用户。\n" +"Input: 如果匹配到工具,使用的工具的输入参数,赋值给params\n" +"Observation: 如果匹配到工具,工具的输出结果 格式为[]。\n" +"Answer: 每一步回答问题的答案,格式为JSON。你可以多次使用Thought/Action/Input/Observation/Answer来一步一步的思考如何回答问题。\n"; 个人小思考 未来微服务HSF这种形式会向上往 agent工厂或者agent服务框架这种形式演进,因为这个框架搭好了后,后面各个业务方快速集成到agent服务上,可被上层AI应用层调用 如果多个agent联动了,才是真正的智能 如何定义agent? Agent体系架构可以分为慎思型、反应型和混合型。 慎思型构建负责规划和推理行为,反应型构建处理需要快速响应的重要事件。 信念-期望-意图(Belief-Desire-ltension, BDI) 体系架构是混合型体系架构的一个重要类型。 Agent的表示形式,Agent的行为可以被描述成好像拥有信念、期望和意图等思维状态。信念表示Agent拥有的知识,期望描述Agent追求的目标,意图说明Agent选择计划以实现哪些目标。 openai提供的agent概念 团队介绍 我们是淘天集团商家与开放平台团队,目前主要围绕商家的日常经营场景,为中小商家提供高效易用的电商工具。 ¤ 拓展阅读 ¤ 3DXR技术| 终端技术| 音视频技术 服务端技术|技术质量|数据算法 本文分享自微信公众号 - 大淘宝技术(AlibabaMTT)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

BIRCH算法全解析:从原理到实战

本文全面解析了BIRCH(平衡迭代削减聚类层次)算法,一种用于大规模数据聚类的高效工具。文章从基础概念到技术细节,再到实战应用与最佳实践,提供了一系列具体的指导和例子。无论你是数据科学新手,还是有经验的实践者,这里都包含了深入理解和成功应用BIRCH算法所需的关键信息。 关注TechLead,分享AI全维度知识。作者拥有10+年互联网服务架构、AI产品研发经验、团队管理经验,同济本复旦硕,复旦机器人智能实验室成员,阿里云认证的资深架构师,项目管理专业人士,上亿营收AI产品研发负责人。 一、引言 什么是BIRCH算法 BIRCH(Balanced Iterative Reducing and Clustering using Hierarchies)是一种用于大规模数据集上的层次聚类算法。该算法于1996年首次提出,目的是在不牺牲聚类质量的前提下,减少大数据聚类问题的计算复杂性。 BIRCH算法的主要优点是其可以处理大规模的数据集,并且仅需要一次或少数几次的数据扫描。该算法通过引入一种特殊的数据结构——CF(Clustering Feature)树——来实现数据的压缩和聚类。CF树不仅捕捉了数据分布的结构,还提供了一种有效的方式来减少计算和存储需求。 BIRCH算法的应用场景 BIRCH算法在多个领域有广泛的应用,包括但不限于: 推荐系统:通过聚类用户行为和喜好,提供更个性化的推荐。 社交网络分析:在大规模社交网络数据中,通过BIRCH算法可以找出社群结构或者是关键影响者。 金融风控:用于检测异常交易行为或者是欺诈行为。 医疗研究:在基因序列、疾病发展等方面进行分群,以便进行更深入的研究。 文章目标和结构概述 本文的主要目标是深入解析BIRCH算法的内部工作机制,包括它如何构建CF树,以及如何进行聚类操作。除了理论解析,本文还将提供Python和PyTorch的实战代码,以帮助读者更好地理解并应用这一算法。 文章将按照以下结构组织: BIRCH算法基础:解释CF树的概念,以及BIRCH算法与其他聚类算法(如K-means)的比较。 BIRCH算法的技术细节:深入探讨构建和优化CF树的算法步骤。 实战应用:展示如何在实际问题中应用BIRCH算法,包括代码示例和应用案例分析。 结论与展望:总结BIRCH算法的优缺点,以及未来可能的研究方向。 通过以上结构,本文旨在为读者提供一个全面、深入、实用的指南,以掌握BIRCH算法的应用和优化。 二、BIRCH算法基础 在深入解析BIRCH算法的核心技术细节之前,了解其基础概念是非常必要的。本节将从CF(Clustering Feature)树的构成开始,解释算法的时间复杂度和空间复杂度,最后与其他流行的聚类算法进行比较。 CF(Clustering Feature)树的概念 数据点 在BIRCH算法中,每一个数据点用一个CF(Clustering Feature)向量来表示。一个CF向量通常由以下三个部分组成: (N): 数据点的数量。 (LS): 线性和(Linear Sum),即所有数据点的矢量和。 (SS): 平方和(Square Sum),即所有数据点的平方的矢量和。 簇 簇是一组相似的数据点的集合。在BIRCH算法中,每一个簇用一个CF向量进行描述。这个CF向量是簇中所有数据点的CF向量的和。 簇的合并和分裂 当一个新的数据点加入CF树时,会寻找距离最近的簇并尝试合并。如果合并后的簇满足一定的条件(例如,半径不超过某一阈值),则合并成功。否则,簇将分裂为两个或多个小簇。 BIRCH的时间复杂度和空间复杂度 BIRCH算法的一个主要优点是其高效性。通常情况下,BIRCH算法的时间复杂度为(O(n)),其中(n)是数据点的数量。这主要得益于CF树结构,它允许算法只扫描数据集一次或几次。 同样地,由于数据点被压缩存储在CF树中,因此BIRCH算法也有很好的空间复杂度。理论上,其空间复杂度可以达到(O(\sqrt{n}))。 BIRCH vs K-means和其他聚类算法 BIRCH算法与其他聚类算法(如K-means、DBSCAN等)相比有几个显著的优点: 高效性:如前所述,BIRCH算法通常只需要一次或几次数据扫描。 可扩展性:由于使用了CF树结构,BIRCH算法能有效地处理大规模数据集。 层次结构:不同于K-means的扁平聚类,BIRCH提供了一种层次聚类结构,这在某些应用场景中可能更有用。 但也有一些局限性和缺点: 球形假设:BIRCH算法假设簇是球形的,这在某些情况下可能不适用。 参数敏感性:需要合适的阈值和其他参数,否则算法的效果可能会受到影响。 三、BIRCH算法的技术细节 本节将详细探讨BIRCH算法的内部工作机制,包括CF树的构建、数据点的插入、簇的合并与分裂等。为了更好地理解这些概念,每一个定义后都会举出具体的例子。 CF树的构建 节点和叶节点 CF树由多个节点组成,其中最底层的节点被称为叶节点。每一个节点都包含一定数量的簇特征(CF向量)。 示例: 考虑一个包含三个簇的简单数据集。一个叶节点可能包含这三个簇的CF向量。 分支因子和阈值 分支因子(Branching Factor)定义了CF树中每个节点可以有的最大子节点数。阈值则用于控制簇的大小;新的数据点只能加入到半径小于阈值的簇中。 示例: 假设分支因子为4,阈值为10。这意味着每个节点最多可以有4个子节点,每个簇的半径不能超过10。 数据点的插入 最近簇查找(Nearest Cluster Search) 当一个新的数据点插入到CF树中时,算法会搜索距离该点最近的簇。 示例: 假设有一个新的数据点(x),它与CF树中的簇(C1)、(C2)和(C3)的距离分别为2、8和15。因此,(x)将被插入到(C1)这个簇中。 簇合并和分裂 如前所述,数据点插入后,可能需要合并或分裂簇以满足阈值约束。 示例: 继续上面的例子,如果(C1)的新半径超过了阈值10,那么(C1)可能会被分裂为两个新的簇。 簇的更新和维护 BIRCH算法不仅在数据点首次插入时进行操作,还能通过更新和维护CF树来适应数据的变化。 动态插入和删除 BIRCH算法允许动态地插入和删除数据点,这一点是通过更新相关簇的CF向量来实现的。 示例: 假设一个数据点从簇(C1)中被删除,那么(C1)的CF向量将会相应地更新。 四、实战应用 在这一节中,我们将通过一个实际的数据集来展示如何使用BIRCH算法进行聚类。我们将使用Python的Scikit-learn库来实现这一算法。我们将首先定义问题场景和数据集,然后进入代码实现。 问题场景和数据集 场景:用户行为聚类 假设我们拥有一个电子商务网站,我们想要通过用户的购买行为来将他们分成不同的组,以便进行更有效的市场营销。 数据集:用户购买记录 数据集包含每个用户购买的不同类别的商品数量。例如: 用户ID 电子产品 书籍 服装 1 5 0 2 2 0 2 8 3 3 1 0 代码实现 以下是用Python和Scikit-learn实现BIRCH算法的代码: from sklearn.cluster import Birch import numpy as np # 示例数据 data = np.array([ [5, 0, 2], [0, 2, 8], [3, 1, 0] ]) # 初始化BIRCH算法 brc = Birch(branching_factor=50, n_clusters=None, threshold=1.5) # 训练模型 brc.fit(data) # 获取标签 labels = brc.labels_ print(f"Cluster labels: {labels}") 输入和输出 输入:用户的购买记录作为Numpy数组提供。 输出:每个用户分配到的簇标签。 处理过程 数据准备:使用Numpy库将数据格式化为适用于Scikit-learn的数组。 模型初始化:使用Birch类从Scikit-learn库初始化BIRCH算法。 模型训练:使用fit方法训练模型。 获取结果:使用labels_属性获取每个数据点的簇标签。 示例: 在我们的示例中,假设用户1、2和3被分配到不同的簇中,他们的标签分别是0、1和2。 五、最佳实践 在使用BIRCH算法进行数据聚类时,有一些最佳实践可以帮助你获得更好的结果和性能。这一节将详细探讨这些最佳实践,并在每个定义后提供具体的例子。 数据预处理 标准化 对数据进行标准化是一种常见的预处理步骤,因为它能确保所有特征都在相同的量级上。 示例: 如果你的数据集包括收入和年龄,这两个特征的量级差异很大。标准化后,这两个特征将有相同的平均值和标准差。 缺失值处理 确保数据集没有缺失值,或者已经妥善处理了缺失值。 示例: 如果年龄数据有缺失,可以使用平均年龄或中位数年龄来填充。 参数选择 分支因子和阈值 正确选择分支因子和阈值可以显著影响BIRCH算法的效果。 示例: 分支因子过大,可能会导致内存不足。 阈值过小,可能会导致过度聚类。 n_clusters参数 虽然BIRCH算法可以自动决定簇的数量,但在某些应用中,预先设定簇的数量(n_clusters 参数)可能会有助于得到更好的结果。 示例: 在用户分群应用中,如果业务目标是将用户分为三个主要类别(高、中、低消费者),那么设置n_clusters=3可能是有意义的。 后处理 使用标签 BIRCH算法生成的标签可以用于多种后续分析,包括但不限于数据可视化、用户分群、推荐系统等。 示例: 将用户聚类结果用于个性化推荐系统,如:属于“高消费”群体的用户可能更喜欢高端产品。 性能评估 通过内部和外部有效性指标(如轮廓系数、Davies–Bouldin指数等)来评估聚类结果。 示例: 使用轮廓系数来评估每个簇内样本的相似度。高轮廓系数通常表示好的聚类。 六、总结 本文全面而深入地探讨了BIRCH(平衡迭代削减聚类层次)算法,一种用于大规模数据聚类的高效算法。从基础概念到技术细节,再到实战应用和最佳实践,我们尽量让每一部分都概念丰富、充满细节和定义完整。 数据预处理的重要性:BIRCH算法虽然适用于大规模数据,但如果数据没有经过适当的预处理,算法的性能和准确性可能会受到影响。 参数敏感性:BIRCH算法的表现高度依赖于其参数(如分支因子、阈值等)。这些参数需要根据具体的应用场景和数据特性来进行调整,而不是单一地依赖默认设置。 应用的广泛性与局限性:虽然BIRCH算法常用于文本挖掘、用户行为分析等领域,但它在处理非欧几里得空间数据或者需要更复杂的距离度量时可能会遇到困难。 算法与业务目标的对齐:成功应用BIRCH算法不仅仅是一个技术问题,还需要算法与特定业务目标和场景紧密对齐。例如,在电子商务用户分群中,选择合适的特征和参数能够显著影响营销活动的成功。 后续分析与评估:BIRCH算法的输出(簇标签)可以为后续的数据分析提供有力的支持,但也需要通过各种内外部指标来细致评估聚类的质量和有效性。 总体而言,BIRCH算法是一个极具潜力的工具,但要充分利用它的强大功能,需要一定的专业知识和实践经验。希望本文能为您提供这方面的有用信息和指导,进一步推动在实际应用中成功使用BIRCH算法。 关注TechLead,分享AI全维度知识。作者拥有10+年互联网服务架构、AI产品研发经验、团队管理经验,同济本复旦硕,复旦机器人智能实验室成员,阿里云认证的资深架构师,项目管理专业人士,上亿营收AI产品研发负责人。 如有帮助,请多关注 TeahLead KrisChang,10+年的互联网和人工智能从业经验,10年+技术和业务团队管理经验,同济软件工程本科,复旦工程管理硕士,阿里云认证云服务资深架构师,上亿营收AI产品业务负责人。

优秀的个人博客,低调大师

IPSec VPN原理介绍 | 京东物流技术团队

背景: 什么是VPN?他是干什么用的?有什么优势?解决我们什么问题? 1 VPN的概念 VPN定义 Virtual Private Network,中文名虚拟专用网络,意思是在公用网络上仿真建立一条点到点的专用网络,进行加密通讯,解决远程访问(个人和分支机构到总部)的问题。 要理解VPN,我们需要先弄了解一个概念——隧道协议,其实质是用一种协议来传输另一种协议,其基本功能是封装和加密。我们给大家列举几个隧道协议:GRE、IPSec、SSL/TLS、VPN(WebVPN)、PPTP、L2TP。 VPN解决的问题 VPN是企业分支机构、末端网络以及个人通告公共网络访问内部私网的一个解决方案。公网上存在的问题既是VPN需要面对和解决的问题。 广域网存在的隐患: 网上传输的数据有被窃听的风险; 网上传输的数据有被篡改的风险; 通信双方可能被冒充; VPN如何保护网络实体间的通信: 通过加密技术防止数据被窃听——数据的私密性; 通过哈希技术防止数据被篡改——数据的完整性; 通过认证机制确认身份,防止数据被截获、重传——数据的源认知; 通过增加序列号机制,防止数据的重放攻击——防重放攻击; VPN的优势 VPN作为一项成熟的技术,广泛应用于组织总部和分支机构之间的组网互联,其利用组织已有的互联网出口,虚拟出一条“专线”,将组织的分支机构和总部连接起来,组成一个大的局域网。 相比于传统专线,vpn具有安全、成本低、可靠、构建灵活等特点。 VPN的框架 VPN的两种框架: site-to-site VPN,也叫LAN-to-LAN。 remote-access VPN,即拨号VPN,一般通过软件进行拨号。 2 IPSec VPN 2.1 引入IPSec IP Security,IP层安全。工作在网络层,针对IP包提供如下功能:私密性、完整性、源认证和防重放攻击。 IPSec是一个开放的标准,与具体的算法没有关联。很多个RFC共同定义IPSec。 2.2 IPSec私密性保护 IPSec通过加密技术实现数据的私密性,加密就是把数据的明文格式通过具体的算法变成无法理解的密文格式。 加密算法的发展: 古典加密算法(算法都是保密不公开的,古典加密算法就是在研究各种算法) 现代加密算法:现代加密学的所有算法都是公开的,但是现代加密算法加入了一个key,主要在研究key,现代加密算法都是通过异或运算与数据难题在设计 现代加密算法分类: 对称加密学:加密解密使用相同的key,典型的对称算法:DES,3DES,AES 非对称加密学:又叫公共密钥系统,每种算法存在2个key:public key和private key。两个key都可以用来加密数据,但是解密必须非对称,公钥加密私钥解密,私钥加密公钥解密。典型的公共密钥算法有RSA(DSA)和DH。 对称加密算法的缺陷: 密钥的分发问题; key的数量与参与者的数量呈正比,密钥管理困难 对称加密算法的优点: 算法快,不需要消耗很多资源; 明文密文几乎等长,不需要浪费网络带宽 非对称加密算法缺点: 算法需要很长时间进行加解密,不可能通告非对称算法实现传输数据的加密; 算法冗长,密文远远大于明文; 非对称加密算法的优点: 非常安全,不可能被破解,非对称算法都是基于现有的属性南通设计的; 可用来支撑数字签名; 现有安全模型的操作规范: 实体间交换公钥 发送方通过公钥加密对称算法的key,得出密文,这个密文只有私钥持有者可以解密 接收方通过私钥解密密文,得到对称算法的key 通过这个key运行对称算法 2.3 IPSec的数据完整性保护 数据完整性指发送方到接收方的整个过程数据没有发生任何变化。IPSec通过哈希技术实现完整性校验,哈希是数据的指纹算法。 哈希的特征: 不可逆(哈希的结果不可能反推明文) 等长(不同的哈希算法,对不同大小的数据,得到哈希结果总是相同的) 雪崩(微小的变化会引起完全不一样的结果) 开销少 介绍两种哈希算法: MD5:哈希结果128bit; SHA:哈希结果256bit; 2.4 IPSec的数据源认证 源认证是用来对数据发送方进行合法性校验的方法。IPSec提供两种方式实现源认证: HMAC:在MD5的算法中,加入一个变量key,只有key相同才能导致MD5结果相同,通过这种方式可实现数据的源认证。IGP的认证中,都是HMAC; 数字签名:指发送方通过自己的私钥对数据的指纹进行加密,得出加密后的哈希,这个东西就是数据签名,数字签名只能使用发送方的公钥进行解密,这样发送方无法抵赖(最严谨的源认证)。 注意:在整个安全模型中,如果使用到私钥在进行加密,肯定是出现了数字签名 2.5 IPSec框架 前面提到,IPSec不是一个特定协议,而是一组操作流程,有多个组件构成: 封装协议(AH,ESP) 加密算法(RSA,DH,DES,3DES,AES) 认证协议(MD5,SHA) ESP封装为数据提供了如下功能:私密性、完整性、源认证和防重放攻击。 概念介绍:SA:Security Association,安全关联是指一组用来保护信息的策略和密钥。安全关联的概念是IPSec的基础。所有AH和ESP的实现都必须支持安全关联。 安全关联的两种模式:transport mode和tunnel mode。通过两种设备的位置,可以判断当前网络模式应该使用哪种封装模式: 通讯点设备:真正的数据发起和接收设备。 加密点设备:IPSec实施设备,可以是路由器、防火墙等。 transport mode:通讯点即为加密点,可以试试传输模式,有两种场景会使用:GRE over IPSec、内网设备间部署IPSec tunnel mode:通讯点不等于加密点一定使用隧道模式。因为通讯点位于网络内部,发出的数据包是私网地址,不可全局路由,所以必须实施新的IP头封装,让数据包全局可路由。 3 IPSec工作流程步骤 3.1 整体工作流程 流量触发IPSec; IKE阶段1,在VPN设备间协商IKE的安全策略,建立一个安全的channel——控制层面; IKE阶段2,在VPN设备间通过安全的channel去协商IPSec的策略,用来保护数据;——数据层面; 通过对感兴趣流设施安全保护,来转发数据; 隧道终结。 VPN设备对感兴趣流量的匹配:设备接口下存在一个map,用来定义感兴趣流的,如果数据撞上map则需要应用IPSec保护,否则bypass 概念穿插: IKE:internet KEY Exchange,因特网密钥交换,目前使用IKEv1版本,包括如下内容: ISAKMP:因特网安全管理和密钥管理协议,端口号500; OAKLEY:用来定义IKE的密钥交换方式,当前的定义是使用DH实现。 SKEME:用来定义IKE职场的加密算法。 IKE的两种模式:main mode(主模式)和积极模式(用于拨号vpn) IKE主模式操作过程: IKE协商——构建控制层面; IPSec协商——协商数据层面; 两个阶段需要进行9个包交换,第一个阶段6个包,3次交换,第二个阶段3个包,两次交换。 3.2 IKE阶段1 主要功能介绍: 协商IKE策略(第1,2两个包)——第一次交换; 交换DH组(第3,4两个包)——第二次交换; 验证peer的合法性(第5,6两个包)——第三次交换。 第一次交换:VPN device把本地所有的IKE policy打包,发起ike的proposal IPSec设备会进行策略比较,总是从policy-id小的开始match,如果存在可以match的policy则提议被通过,如果所有的policy无法match,则IKE协商失败,进入第二次交换。 因为加密算法没统一,没有加密key,所以第一次交换过程肯定是明文交换。 第二次交换:交换的是DH组信息,在这个交换过程中,设备不可能把本地的psk进行发送(psk严格本地保留),只是用来交互几个DH的公开值。 因为key还没协商,所有依然是明文交换。 在第二次交换后,VPN设备通过cookie+psk可以推导出三个密钥: SKEIDa:用来通过1,2个包协商出来的加密算法保护5,6包 SKEIDe:用来通过1,2个包交换出来的哈希算法对5,6包进行认证 SKEIDd:这个密钥是在第二个阶段用来衍生IPSec的key,如果这个密钥被攻破,所有IPSec就没有意义 第三次交换:第三次交换的主要功能是用来做peer的身份验证。 第三次交换是在建立了安全的channel下交换的,第五第六个包是加密的,也是被认证的。 在psk的验证中,其实vpn设备只是通过5,6包的源IP地址进行校验。psk的关键作用只是参与DH算法,用来做key衍生,如果psk不同key不同,协商失败。 IKE第一阶段协商结果,即产生IKE SA,也叫isakmp sa 3.2 IKE阶段2 本阶段涉及3个包,两次交换,也叫做快速模式。 快速模式下的所有包都是通过SKEIDa进行加密,SKEIDe进行认证,所有读取报文都是加密的数据。 此过程交换并匹配IPSec的安全参数(转换集),VPN设备把本地的所有转换集打包发送,match的时候与IKE的1,2包交换是相同的,同时只要转换集匹配则通过DH的第三个key-SKEIDd进行IPSec加密算法密钥的推导。 IKE第二阶段协商结果是IPSec sa。 SA的三要素: SPI(安全参数索引),用来描述一个SA,用于IPSec快速匹配,告诉对端通过这个SPI对应的SA对该数据进行解密,让加解密更加高效,占用4byte;对于一个对应的感兴趣流,一端的outbound SPI肯定是对端的inbound SPI(因为数据保护使用的是对称算法,必须保证加解密key相同) 安全协议标识:标识该SA是AH安全关联或ESP安全关联。 IP目的地址:只允许使用单一地址,表示SA的目的地址。 4 扩展话题 SA的切换探讨: SA的主要内容就是对称密钥的key与哈希算法的key,当一个SA使用的越频繁,就代表key越需要更新,SA的切换必须做到不丢包。 IKE在可以超时前就会重新推算新的SA,防止切换瞬间带来的丢包。 所有的IPSec SA都是通过IKE的SKEIDd在推算,如果这个SKEIDd被曝光,会导致所有的IPSec SA全部可推算 PFS(完美向前保护): 因为默认的IPsec key间存在互相推导关系,导致不够安全,PFS强制每一次重新计算SA需要重新通过DH推导SKEIDd。 RRI(反向路由注入): 如果策略1能够成功的协商SA,则往本地路由表注入一条远端通讯点的静态路由 DPD(dead peer detection): 如果对端失效,本端无法检测,导致数据层面转发黑洞,解决方案是必须让本端可以检测到对端失效,同时删除与对端的SA,重新寻找peer去建立SA DMVPN和NHRP(可自行了解) 作者:京东物流 陈旭辉 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

Android事件分发-基础原理和场景分析

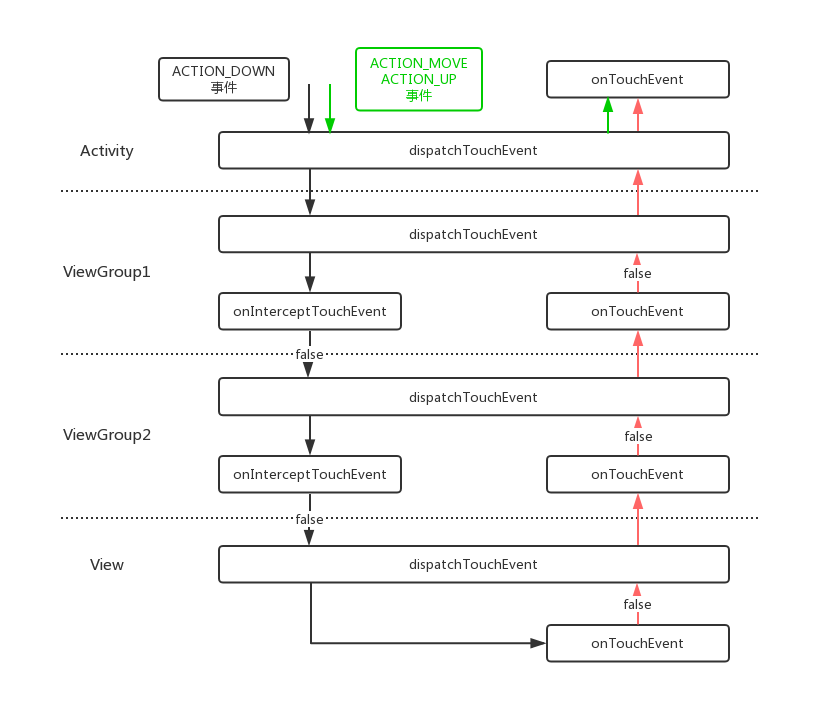
作者:京东零售郭旭锋 1 为什么需要事件分发 和其他平台类似,Android 中 View 的布局是一个树形结构,各个 ViewGroup 和 View 是按树形结构嵌套布局的,从而会出现用户触摸的位置坐标可能会落在多个 View 的范围内,这样就不知道哪个 View 来响应这个事件,为了解决这一问题,就出现了事件分发机制。 2 事件分发的关键方法 Android 中事件分发是从 Activity 开始的,可以看看各组件中事件分发的关键方法 组件 dispatchTouchEvent onInterceptTouchEvent onTouchEvent Activity √ × √ ViewGroup √ √ √ View √ × √ Activity:没有 onInterceptTouchEvent 方法,因为如果 Activity 拦截事件,将导致整个页面都没有响应,而 Activity 是系统应用和用户交互的媒介,不能响应事件显然不是系统想要的结果。所以 Activity 不需要拦截事件。 ViewGroup:三个方法都有,Android 中 ViewGroup 是一个布局容器,可以嵌套多个 ViewGroup 和 View,事件传递和拦截都由 ViewGroup 完成。 View:事件传递的最末端,要么消费事件,要么不消费把事件传递给父容器,所以也不需要拦截事件。 3 事件分发流程分析 3.1 事件分发流程概览 Activity 并不是一个 View,那么 Activity 是如何将事件分发到页面的 ViewGroup 和 View 的呢。我们先看看源码 # Activity public boolean dispatchTouchEvent(MotionEvent ev) { if (ev.getAction() == MotionEvent.ACTION_DOWN) { onUserInteraction(); } // 调用 Window 对象的方法,开始事件分发 if (getWindow().superDispatchTouchEvent(ev)) { return true; } // 如果事件分发返回 false,也即事件没被消费,则调用自己的 onTouchEvent 方法 return onTouchEvent(ev); } public boolean onTouchEvent(MotionEvent event) { if (mWindow.shouldCloseOnTouch(this, event)) { finish(); return true; } return false; } 可以看到,Activity 中的事件分发方法 dispatchTouchEvent 调用了 getWindow().superDispatchTouchEvent(ev) 方法,而这里的 WIndow 实际上是 PhoneWindow。 简单来说,Window 是一个抽象类,是所有视图的最顶层容器,视图的外观和行为都归他管,无论是背景显示、标题栏还是事件处理都是他管理的范畴,而 PhoneWindow 作为 Window的唯一亲儿子(唯一实现类),自然就是 View 界的皇帝了。 下来看看 PhoneWindow 的代码 # PhoneWindow @Override public boolean superDispatchTouchEvent(MotionEvent event) { return mDecor.superDispatchTouchEvent(event); } PhoneWindow 中又调用了 mDecor.superDispatchTouchEvent(event) 方法。mDecor 是 DecorView 对象,再看看 DecorView 的代码 # DecorView public class DecorView extends FrameLayout implements RootViewSurfaceTaker, WindowCallbacks { public boolean superDispatchTouchEvent(MotionEvent event) { return super.dispatchTouchEvent(event); } } # FrameLayout public class FrameLayout extends ViewGroup { } # ViewGroup public abstract class ViewGroup extends View implements ViewParent, ViewManager { public boolean dispatchTouchEvent(MotionEvent ev) { ...... } } # View public class View implements Drawable.Callback, KeyEvent.Callback, AccessibilityEventSource { public boolean dispatchTouchEvent(MotionEvent ev) { ...... } } 可以看到,DecorView 实际上就是 ViewGroup,事件分发方法最终调用到了 ViewGroup 的 dispatchTouchEvent(MotionEvent ev) 方法。 DecorView 是 PhoneWindow 的一个对象,其职位就是跟在 PhoneWindow 身边专业为 PhoneWindow 服务的,除了自己要干活之外,也负责消息的传递,PhoneWindow 的指示通过 DecorView 传递给下面的 View,而下面 View 的信息也通过 DecorView 回传给 PhoneWindow。 Android 中的事件分发是责任链模式的一种变形。事件由上往下传递,如果事件没有被消费则继续传递到下一层,如果事件被消费则停止传递,如果到最下层事件则没有被消费,则事件会层层传递给上一层处理。我们都知道事件分发的源头在 Activity 中的 dispatchTouchEvent 方法中,事件从这里开始,分发到布局中的各个 View 中,不断递归调用 ViewGroup/View 的 dispatchTouchEvent 方法。通过上面分析可以看到,Activity 在接受到上层派发来的事件后,会把事件传递到自己的 dispatchTouchEvent 方法中,然后Activity 会把触摸、点击事件传递给自己的 mWindow 对象,最终传递给 DecorView 的 dispatchTouchEvent 方法,实际调用的是 ViewGroup 的 dispatchTouchEvent 方法。 3.2 事件分发源码分析 经过分析,可以知道 Android 中事件分发的关键方法就是 ViewGroup 和 View 中的相关方法,如下 # View public class View implements Drawable.Callback, KeyEvent.Callback, AccessibilityEventSource { public boolean dispatchTouchEvent(MotionEvent event) { // ... 省略部分代码 boolean result = false; // ... 省略部分代码 if (onFilterTouchEventForSecurity(event)) { // ... 省略部分代码 // 1. 主要调用 onTouchEvent 方法,返回 true 说明事件被消费,否则没被消费 if (!result && onTouchEvent(event)) { result = true; } } // ... 省略部分代码 return result; } public boolean onTouchEvent(MotionEvent event) { // ... 省略部分代码 // 2. 默认可点击则返回 true,也就是消费事件。Button 或设置过 OnClickListener,则 View 可点击 if (clickable || (viewFlags & TOOLTIP) == TOOLTIP) { switch (action) { case MotionEvent.ACTION_UP: // ... 省略部分代码 break; case MotionEvent.ACTION_DOWN: // ... 省略部分代码 break; case MotionEvent.ACTION_CANCEL: // ... 省略部分代码 break; case MotionEvent.ACTION_MOVE: // ... 省略部分代码 break; } return true; } return false; } } View 中的方法逻辑比较简单,如备注 1 所示,dispatchTouchEvent 主要就是做一些安全检查,检查通过后会调用 onTouchEvent 方法。而 onTouchEvent 方法中逻辑如备注 2 所示,如果 View 是可点击的,则默认会认为消费事件,否则不消费,一般 Button 控件,或设置过 OnClickListener 的控件,View 会被默认设置为可点击。 下面看看 ViewGroup 代码 # ViewGroup public abstract class ViewGroup extends View implements ViewParent, ViewManager { public boolean dispatchTouchEvent(MotionEvent ev) { // ... 省略部分代码 boolean handled = false; if (onFilterTouchEventForSecurity(ev)) { final int action = ev.getAction(); final int actionMasked = action & MotionEvent.ACTION_MASK; // 1. 如果是 DOWN 事件,则重置事件状态 if (actionMasked == MotionEvent.ACTION_DOWN) { // Throw away all previous state when starting a new touch gesture. // The framework may have dropped the up or cancel event for the previous gesture // due to an app switch, ANR, or some other state change. cancelAndClearTouchTargets(ev); resetTouchState(); } final boolean intercepted; // 2. 如果是 DOWN 事件,会判断当前 ViewGroup 是否要拦截事件。这里受两个因素影响: // 一是 FLAG_DISALLOW_INTERCEPT,如果设置不拦截,则不会调用 onInterceptTouchEvent,直接设置为不拦截 // 二是没设置 FLAG_DISALLOW_INTERCEPT 标志,默认允许拦截,会调用 onInterceptTouchEvent 方法 // 3. 如果不是 DOWN 事件,可能是 MOVE 或 UP 事件,mFirstTouchTarget 是记录需要继续进行事件分发的下一级子 View,包括ViewGroup 或 View,这里也分为两种情况 // 如果 mFirstTouchTarget 不为空,说明需要继续向下一级子 View/ViewGroup 分发事件,这时说明上次 DOWN 事件找到了下级有消费事件的子 View,且无拦截事件 // 如果 mFirstTouchTarget 为空,说明没找到要消费事件的子 View,或事件被拦截了 if (actionMasked == MotionEvent.ACTION_DOWN || mFirstTouchTarget != null) { final boolean disallowIntercept = (mGroupFlags & FLAG_DISALLOW_INTERCEPT) != 0; if (!disallowIntercept) { intercepted = onInterceptTouchEvent(ev); ev.setAction(action); // restore action in case it was changed } else { intercepted = false; } } else { // There are no touch targets and this action is not an initial down // so this view group continues to intercept touches. intercepted = true; } // ... 省略部分代码 TouchTarget newTouchTarget = null; boolean alreadyDispatchedToNewTouchTarget = false; // 4. 下面逻辑主要就是遍历寻找能消费事件的 View,如果事件被拦截,则不需要再寻找 if (!canceled && !intercepted) { // ... 省略部分代码 // 5. 只有 DOWN 事件才需要寻找,其他事件时已经确定是否找到,都不需要再找消费事件的 View 了 if (actionMasked == MotionEvent.ACTION_DOWN || (split && actionMasked == MotionEvent.ACTION_POINTER_DOWN) || actionMasked == MotionEvent.ACTION_HOVER_MOVE) { // ... 省略部分代码 final int childrenCount = mChildrenCount; if (newTouchTarget == null && childrenCount != 0) { // ... 省略部分代码 final View[] children = mChildren; for (int i = childrenCount - 1; i >= 0; i--) { // ... 省略部分代码 final int childIndex = getAndVerifyPreorderedIndex(childrenCount, i, customOrder); final View child = getAndVerifyPreorderedView(preorderedList, children, childIndex); // 6. 这个方法是关键 // 如果 child 不为空,则会再调用 child.dispatchTouchEvent 方法,达到层层递归的效果 // 如果 child 为空,则会调用 super.dispatchTouchEvent 方法,super 是 View,实际上调用了 onTouchEvent 方法,自己判断是否消费事件 if (dispatchTransformedTouchEvent(ev, false, child, idBitsToAssign)) { // ... 省略部分代码 // 7. 返回 true,说明找到了消费事件的 View,下面方法会给 mFirstTouchTarget 赋值,下面 mFirstTouchTarget 将不为空 // 注:mFirstTouchTarget 并不是最终消费事件的 View,而是下一级包含消费事件 View 的链表对象,或是直接消费事件的 View 的链表对象 // 每一个 ViewGourp 都会记录一个 mFirstTouchTarget,mFirstTouchTarget.child 记录了下一层消费事件的 ViewGroup 或 View // 同时,alreadyDispatchedToNewTouchTarget 变量会设置为 true newTouchTarget = addTouchTarget(child, idBitsToAssign); alreadyDispatchedToNewTouchTarget = true; break; } // ... 省略部分代码 } // ... 省略部分代码 } // ... 省略部分代码 } } // Dispatch to touch targets. if (mFirstTouchTarget == null) { // 8. 当没有找到消费事件的 View,或事件被拦截,mFirstTouchTarget 都不会被赋值,这里 child 为空,会调用自己的 onTouchEvent 方法 handled = dispatchTransformedTouchEvent(ev, canceled, null, TouchTarget.ALL_POINTER_IDS); } else { // Dispatch to touch targets, excluding the new touch target if we already // dispatched to it. Cancel touch targets if necessary. TouchTarget predecessor = null; TouchTarget target = mFirstTouchTarget; while (target != null) { final TouchTarget next = target.next; // 9. 说明找到了消费事件的 View,并且已经分发,直接设置为已处理 if (alreadyDispatchedToNewTouchTarget && target == newTouchTarget) { handled = true; } else { final boolean cancelChild = resetCancelNextUpFlag(target.child) || intercepted; // 10. 此方法和备注 6 和 8 都一样,这里多了 cancel 的处理逻辑。如果事件被拦截,需要给原来消费事件的 View 发一个 CANCEL 事件 if (dispatchTransformedTouchEvent(ev, cancelChild, target.child, target.pointerIdBits)) { handled = true; } if (cancelChild) { if (predecessor == null) { mFirstTouchTarget = next; } else { predecessor.next = next; } target.recycle(); target = next; continue; } } predecessor = target; target = next; } } // ... 省略部分代码 } // ... 省略部分代码 return handled; } public boolean onInterceptTouchEvent(MotionEvent ev) { if (ev.isFromSource(InputDevice.SOURCE_MOUSE) && ev.getAction() == MotionEvent.ACTION_DOWN && ev.isButtonPressed(MotionEvent.BUTTON_PRIMARY) && isOnScrollbarThumb(ev.getX(), ev.getY())) { return true; } // 默认不拦截 return false; } // 没有覆写这个方法,实际调用的是 View 的 onTouchEvent 方法 public boolean onTouchEvent(MotionEvent event) { } } 可以看到,ViewGroup 中的事件分发逻辑还是比较复杂,但抓住关键点后则很容易能看清它的本来面貌 (1)分发的事件包括 DOWN、MOVE、UP、CANCEL 几种,用户一个完整的动作就是由这几个事件组合而成的 (2)只有 DOWN 事件中会寻找消费事件的目标 View,其他事件不会再寻找 (3)DOWN 事件寻找到目标 View 后,后续其他事件都会直接分发至目标 View (4)事件可以被拦截,拦截后原目标 View 会收到 CANCEL 事件,后续将不会再收到任何事件(这也是这套机制不支持丰富的嵌套滑动的原因) 3.3 事件分发情景分析 3.3.1 分发过程没有任何 View 拦截和消费  (1)事件返回时,为了简化理解,dispatchTouchEvent 直接指向了父 View 的 onTouchEvent ,实际上它仅仅是返回给父 View 的 dispatchTouchEvent 一个 false 值(影响了 mFirstTouchTarget 的值),父 View 根据返回值来调用自身的onTouchEvent 方法 (2)ViewGroup 是根据 onInterceptTouchEvent 的返回值(影响了 mFirstTouchTarget 的值)确定是调用子 View 的 dispatchTouchEvent 还是自身的 onTouchEvent 方法 (3)如果所有 View 都没有消费 DOWN 事件,后续 MOVE 和 UP 不会再往下传递,会直接传递给 Activity 的 onTouchEvent 方法 3.3.2 最底层View消费事件,且上层View没有拦截事件  (1)若没有 ViewGroup 对事件进行拦截,而最底层 View 消费了此事件,也就是接收到 DOWN 事件时 View 的 onTouchEvent 返回 true,事件将不会再向上传递给各个 ViewGroup 的 onTouchEvent 方法,而是直接返回,后续的 MOVE 和 UP 事件也将会直接交给 View 进行处理 3.3.3 最底层View没有消费事件,ViewGroup2消费了事件,且上层View没有拦截事件 (1)如果 View 没有消费事件,在层层调用父布局的 onTouchEvent 方法时,有 View 消费此事件,如 ViewGroup2 消费此事件,后续 MOVE 和 UP 事件将会传递给 ViewGroup2 的 onTouchEvent 方法,而且不会再调用 ViewGroup2 的 onInterceptTouchEvent 方法 (2)源码 if (actionMasked == MotionEvent.ACTION_DOWN || mFirstTouchTarget != null) {} 这个代码中主要调用 onInterceptTouchEvent() 方法和处理是否拦截 第一次是 DOWN 事件会进行判断,所以会调用 onInterceptTouchEvent 拦截方法 第二次非 DOWN 事件,不会再调用 onInterceptTouchEvent 方法。原因如下: ◦ 如果 DOWN 事件的时候进行过拦截,也就是 onInterceptTouchEvent() 方法返回 true,则 mFirstTouchTarget 必定为 null,不会调用 onInterceptTouchEvent 方法。因为后面不会对这个值赋值,会往下走逻辑,直接调用到此 View 或 ViewGroup 的 onTouchEvent() 方法 ◦ 如果 DOWN 事件没有拦截,但子 View 的 onTouchEvent 都返回 false,只有当前 ViewGroup 的 onTouchEvent 返回 true,mFirstTouchTarget 也同样为 null,也不会调用 onInterceptTouchEvent 方法。因为 mFirstTouchTarget 本质是找能接收事件的子 View,所有子 View 都不接收事件,mFirstTouchTarget 就必然为 null 3.3.4 ViewGroup2拦截了并消费了DOWN事件,其他View没有拦截事件  (1)ViewGroup2 拦截 DOWN 事件后,View 不会接收到任何事件。ViewGroup2 消费事件后,后续 MOVE 和 UP 事件会交给 ViewGroup2 的 onTouchEvent 方法进行处理,且不会再调用 ViewGroup2 的onInterceptTouchEvent 方法 3.3.5 View消费了DOWN事件,ViewGroup2拦截且消费了MOVE事件,其他View没有拦截事件  (1)View 中 DOWN 事件正常传递 (2)当 ViewGroup2 拦截 MOVE 事件后,当前 mFirstTouchTarget 不为空,首先 View 会收到转换后的 CANCEL 事件,mFirstTouchTarget 会置为空,下次 MOVE 事件由于 mFirstTouchTarget 为空,会调用到自己的 onTouchEvent 方法 3.3.6 View消费 DOWN 事件,ViewGroup2拦截且消费了MOVE事件,一定条件后,ViewGroup1再次拦截和消费MOVE事件,其他View没有拦截事件  3.4 事件分发总结 (1)整个分发过程中没有任何拦截和消费,DOWN 事件会层层往下分发,并层层往上返回 false,MOVE 和 UP 事件则会交给 Activity 的 onTouchEvent 方法进行处理,不再往下分发 (2)分发过程中没有任何拦截但有消费,DOWN 事件会层层往下分发,并层层往上返回false,直到有消费返回 true,MOVE 和 UP 事件则会层层往下分发,最后直接交给消费事件的 View 进行处理,然后层层返回 true (3)分发过程中有拦截且拦截后消费,DOWN 事件会层层往下分发,直到有拦截后直接交给消费的 View 进行处理,MOVE 和 UP 事件则会层层往下分发,最后直接交给消费事件的 View 进行处理,然后层层返回true (4)分发过程中不拦截 DOWN 事件,但拦截 MOVE 事件且拦截后消费,第一次拦截,之前收到 DOWN 事件的子 View 会收到 CANCEL 事件,并层层返回;后续 MOVE 和 UP 会层层往下分发,最后直接交给消费事件的 View 进行处理 (5)分发过程中不拦截 DOWN 事件,但拦截 MOVE 事件且拦截后不消费,第一次拦截,之前收到 DOWN 事件的子 View 会收到 CANCEL 事件,并层层返回;后续 MOVE 和 UP 会层层往下分发,最后交给拦截的 View 进行处理,此时由于拦截的 View 没有消费,会层层往上返回 false,最后会交给 Activity 的 onTouchEvent 方法进行处理 以上,是个人的一些分析和经验,欢迎有兴趣的小伙伴一起学习和探讨!
资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册