首页 文章 精选 留言 我的

精选列表

搜索[编译原理],共10000篇文章
优秀的个人博客,低调大师

数据平台与Flink任务运行原理介绍

本文将从5个方面详细介绍数据平台大数据任务开发的基础知识。包含数据平台的简介、如何在平台内创建Flink表、如何编写Flink大数据处理作业、Flink任务启动时的调用流程以及Flink web UI 任务监控页面。此外,将重点介绍数据平台内Flink任务开发相关的部分内容,包括Flink数据连接、Flink流作业、批作业和资源库。资源库为自定义的UDF,为了方便介绍后续将统一简称为平台。 云智慧AIOps社区是由云智慧发起,针对运维业务场景,提供算法、算力、数据集整体的服务体系及智能运维业务场景的解决方案交流社区。该社区致力于传播AIOps技术,旨在与各行业客户、用户、研究者和开发者们共同解决智能运维行业技术难题、推动AIOps技术在企业中落地、建设健康共赢的AIOps开发者生态。 数据平台 平台定义 平台基于Flink计算框架,集成Kafka、Clickhouse等大数据组件,具备数据采集、数据同步、数据存储、实时计算、离线计算、数据治理、数据服务等能力。实践平台化思维,充分利用数据,可实现复杂业务的数据开发任务,构建了一套完整的技术生态体系。 平台目标 定位为实时数仓、流批一体、湖仓一体的智能大数据平台,提升整体的IT运营服务能力。 Flink数据连接 Flink数据连接是Flink读取和写入到web系统数据库的一个接口。下图为Flink 数据连接的一个页面,左侧的为目录数,方便数据源的归类与查找。右侧列表化展示数据连接,可根据数据连接的名称、类型、标签等内容进行检索,支持导入、导出与复制,方便做迁移和备份编辑。右上角新建按钮可以点击新建Kafka、Redis以及Clickhouse 的原表和结果表。通过页面式、配置化操作,将各数据资源虚拟化成Flink表。 新建Kafka源表 命名数据连接名称:名称方便于在数据列表中进行查询。 地址和端口:用于读取集群上的topic; Kafka类型:Kafka类型分为Kafka和 upsert-Kafka; 数据格式:常用数据格式为json; 消费方式:分为从头开始消费(从最老的数据将Kafka topic完整的数据都消费到)、从当前位置,从group offset以及从指定时间开始消费; 最大读取记录数:一批次内读取的最大数据量; key格式与字段 动态表名称:后续在Flink SQL中写SQL时将会用到,即建表的表名 Kafka源表创建完成之后,将会得到该建表语句 支持数据连接类型 Kafka:支持Kafka连接器和upsert-Kafka连接器 Clickhouse:基于jdbc连接器开发,支持Clickhouse集群和多节点轮询数据写入 Redis:自主开发,支持单机、集群、哨兵和代理模式的Redis服务,提供写入和维表关联能力 逐步支持更多的数据连接 数据作业开发 数据作业开发页面与数据源页面类似,左边为目录,右边可以新建编辑作业。 编辑SQL页面支持以下操作: 支持勾选数据源表和数据结果表 选择数据表后,填充建表语句至编辑区,支持自定义修改 支持添加自定义算子 SQL编辑完成后可进行作业配置操作: 并行度:任务每个算子的线程数 插槽数:每个插槽独占CPU资源,但使用同一个执行器的JVM内存资源(同一个taskmanager的插槽),增加插槽数会获取更多的计算资源,但不利于内存资源的利用效率。 重启策略:可设置固定重启次数和失败比例策略 任务启动流程 Flink任务启动会运行起一个JobManager和一个或多个TaskManager。 JobManager:负责资源提供、回收、分配,任务调度、处理完成或失败的任务、协调 checkpoint、提供REST接口和WebUI展示作业执行信息。 TaskManager:执行作业任务并缓存和交换数据流,包含一个或多个task slot。TaskManager 中 task slot 的数量表示并发处理 task 的数量,一个 task slot 中可以执行多个算子。 TaskManager是一个JVM进程,所包含的多个Task Slot会均分JVM内存。 多个算子可共享一个Task Slot,有利于资源分配和资源利用,并行度设置为Task Slot数的整数倍,会均匀的分配到每个Task Slot。 Flink任务监控页面 平台内维护了任务状态、运行日志等内容,Flink自身也提供了详细的任务监控能力,Flink任务监控包含Flink任务运行状态、时长以及资源分配情况的监控。会展示算子DAG图,数据处理情况以及算子反压、异常日志、Checkpoint记录等。 下图为TaskManager、JobManager的内存占用、GC情况以及运行日志。 了解更多 云智慧已开源集轻量级、聚合型、智能运维为一体的综合运维管理平台OMP(Operation Management Platform) ,具备 纳管、部署、监控、巡检、自愈、备份、恢复 等功能,可为用户提供便捷的运维能力和业务管理,在提高运维人员等工作效率的同时,极大提升了业务的连续性和安全性。点击下方地址链接,欢迎大家给OMP点赞送star,了解更多相关内容~ GitHub地址:https://github.com/CloudWise-OpenSource/OMP Gitee地址:https://gitee.com/CloudWise/OMP 微信扫描识别下方二维码,备注【OMP】加入AIOps社区运维管理平台OMP开发者交流群,与OMP项目PMC面对面交流,和更多行业大佬一起学习~

优秀的个人博客,低调大师

高效动画实现原理-Jetpack Compose 初探索

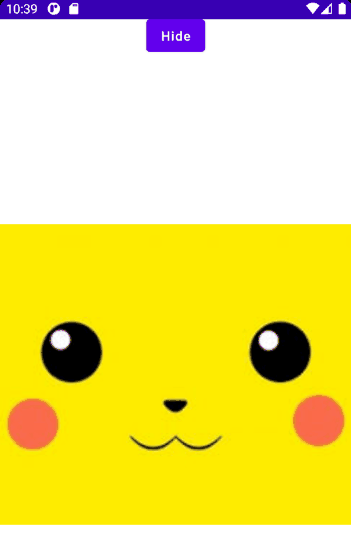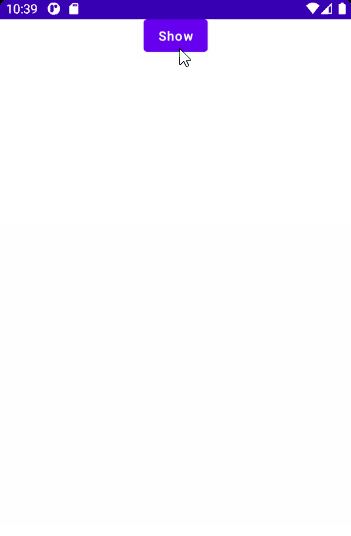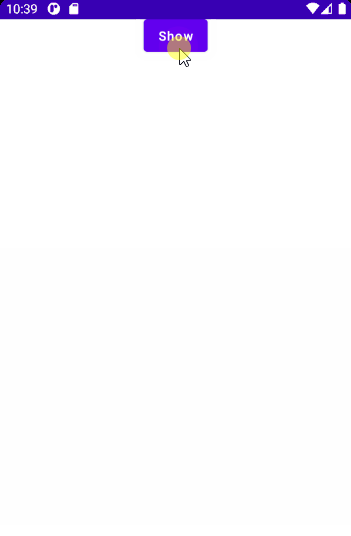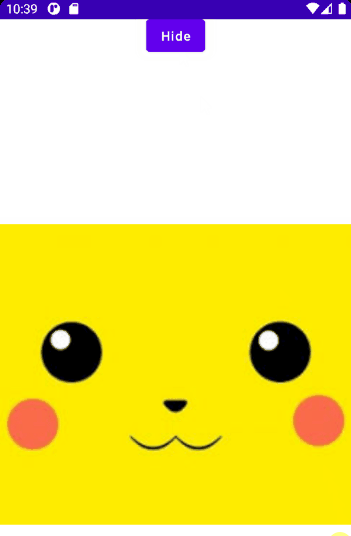
一、简介 Jetpack Compose是Google推出的用于构建原生界面的新Android 工具包,它可简化并加快 Android上的界面开发。Jetpack Compose是一个声明式的UI框架,随着该框架的推出,标志着Android 开始全面拥抱声明式UI开发。Jetpack Compose存在很多优点:代码更加简洁直观、应用开发效率显著提升、Kotlin API功能直观、预览工具强大等。 二、开发环境 为了获得更好的开发体验,笔者这里使用的是Android Studio Canary版本,这样可以无需配置一些设置和依赖。(下载地址) 打开工程,新建Empty Compose activity 模版,需要注意的是根目录下的build.gradle,相关的依赖com.android.tools.build和org.jetbrains.kotlin版本需要对应,否则可能出现出错的情形,这里使用的是: dependencies { classpath "com.android.tools.build:gradle:7.0.0-alpha15" classpath "org.jetbrains.kotlin:kotlin-gradle-plugin:1.4.30" } 这样就完成了项目的新建。 三、Jetpack Compose动画 Jetpack Compose提供了一些功能强大且可扩展的 API,可用于在应用界面中轻松实现各种动画效果。下文将会对Jetpack Compose Animations的常用方法进行介绍。 3.1 状态驱动动画:State Jetpack Compose动画是通过对状态的监听,即监听状态值的变化,使UI能实现自动更新。可组合函数可以使用 remember或者 mutableStateOf监听状态值的变化。如果状态值是不变的,remember函数会在每次重新组合中保持该值;如果状态是可变的,它会在值发生变化的时候触发重组,mutableStateOf将得到一个MutableState对象,它是一个可观察类型。 这种重组是创建状态驱动动画的关键。利用重组,它们会在可组合组件的状态发生任何变化时被触发。Compose动画是由State驱动的,动画相关的API也较容易上手,能比较容易创造出漂亮的声明式动画。 3.2 可见性动画: AnimatedVisibility 首先看下函数定义: @ExperimentalAnimationApi @Composable fun AnimatedVisibility( visible: Boolean, modifier: Modifier = Modifier, enter: EnterTransition = fadeIn() + expandIn(), exit: ExitTransition = shrinkOut() + fadeOut(), initiallyVisible: Boolean = visible, content: @Composable () -> Unit ) { AnimatedVisibilityImpl(visible, modifier, enter, exit, initiallyVisible, content) } 可以看出默认的动画是淡入放大、淡出收缩,实际中通过传入不同函数实现各种动效。 随着可见值的变化,AnimatedVisibility可为其内容的出现和消失设置动画。如下代码,可以通过点击Button,控制图片的出现和消失。 @Composable fun AinmationDemo() { //AnimatedVisibility 可见动画 var visible by remember { mutableStateOf(true) } Column( Modifier .fillMaxWidth() .fillMaxHeight(), Arrangement.Top, Alignment.CenterHorizontally ) { Button( onClick = { visible = !visible } ) { Text(text = if (visible) "Hide" else "Show") } Spacer(Modifier.height(16.dp)) AnimatedVisibility( visible = visible, enter = slideInVertically() + fadeIn(), exit = slideOutVertically() + fadeOut() ) { Image( painter = painterResource(id = R.drawable.pikaqiu), contentDescription = null, Modifier.fillMaxSize() ) } } } 通过监听visible的变化,可实现图片的可见性动画,效果如小图所示; 3.3 布局大小动画:AnimateContentSize 先看下函数的定义: fun Modifier.animateContentSize( animationSpec: FiniteAnimationSpec<IntSize> = spring(), finishedListener: ((initialValue: IntSize, targetValue: IntSize) -> Unit)? = null ) 可以为布局大小动画设置动画速度和监听值。 由函数的定义可以看出这个函数本质上就Modefier的一个扩展函数。可以通过变量size监听状态变化实现布局大小的动画效果,代码如下: //放大缩小动画 animateContentSize var size by remember { mutableStateOf(Size(300F, 300F)) } Column( Modifier .fillMaxWidth() .fillMaxHeight(), Arrangement.Top, Alignment.CenterHorizontally ) { Spacer(Modifier.height(16.dp)) Button( onClick = { size = if (size.height == 300F) { Size(500F, 500F) } else { Size(300F, 300F) } } ) { Text(if (size.height == 300F) "Shrink" else "Expand") } Spacer(Modifier.height(16.dp)) Box( Modifier .animateContentSize() ) { Image( painter = painterResource(id = R.drawable.pikaqiu), contentDescription = null, Modifier .animateContentSize() .size(size = size.height.dp) ) } } //放大缩小动画 animateContentSize var size by remember { mutableStateOf(Size(300F, 300F)) }​ Column( Modifier .fillMaxWidth() .fillMaxHeight(), Arrangement.Top, Alignment.CenterHorizontally ) { Spacer(Modifier.height(16.dp))​ Button( onClick = { size = if (size.height == 300F) { Size(500F, 500F) } else { Size(300F, 300F) } } ) { Text(if (size.height == 300F) "Shrink" else "Expand") } Spacer(Modifier.height(16.dp))​ Box( Modifier .animateContentSize() ) { Image( painter = painterResource(id = R.drawable.pikaqiu), contentDescription = null, Modifier .animateContentSize() .size(size = size.height.dp) ) }} 通过Button的点击,监听size值的变化,利用animateContentSize()实现动画效果,具体动效如下图所示: 3.4布局切换动画: Crossfade Crossfade可以通过监听状态值的变化,使用淡入淡出的动画在两个布局之间添加动画效果,函数自身就是一个Composable,代码如下: //Crossfade 淡入淡出动画 var fadeStatus by remember { mutableStateOf(true) } Column( Modifier .fillMaxWidth() .fillMaxHeight(), Arrangement.Top, Alignment.CenterHorizontally ) { Button( onClick = { fadeStatus = !fadeStatus } ) { Text(text = if (fadeStatus) "Fade In" else "Fade Out") } Spacer(Modifier.height(16.dp)) Crossfade(targetState = fadeStatus, animationSpec = tween(3000)) { screen -> when (screen) { true -> Image( painter = painterResource(id = R.drawable.pikaqiu), contentDescription = null, Modifier .animateContentSize() .size(300.dp) ) false -> Image( painter = painterResource(id = R.drawable.pikaqiu2), contentDescription = null, Modifier .animateContentSize() .size(300.dp) ) } } } 同样通过监听fadeStatus的值,实现布局切换的动画,具体的动效如图所示: 3.5单个值动画:animate*AsState 为单个值添加动画效果。只需提供结束值(或目标值),该 API 就会从当前值开始向指定值播放动画。 Jetpack Compose 提供了很多内置函数,可以为不同类型的数据制作动画,例如:animateColorAsState、animateDpAsState、animateOffsetAsState等,这里将介绍下animateFooAsState的使用,代码如下: //animate*AsState 单个值添加动画 var transparent by remember { mutableStateOf(true) } val alpha: Float by animateFloatAsState(if (transparent) 1f else 0.5f) Column( Modifier .fillMaxWidth() .fillMaxHeight(), Arrangement.Top, Alignment.CenterHorizontally ) { Button( onClick = { transparent = !transparent } ) { Text(if (transparent) "Light" else "Dark") } Spacer(Modifier.height(16.dp)) Box { Image( painter = painterResource(id = R.drawable.pikaqiu), contentDescription = null, Modifier .animateContentSize() .graphicsLayer(alpha = alpha) .size(300.dp) ) } } 动画效果如下图所示: 3.6 组合动画:updateTransition Transition 可同时追踪一个或多个动画,并在多个状态之间同步这些动画。具体的代码如下: var imagePosition by remember { mutableStateOf(ImagePosition.TopLeft) } Column( Modifier .fillMaxWidth() .fillMaxHeight(), Arrangement.Top, Alignment.CenterHorizontally ) { Spacer(Modifier.height(16.dp)) val transition = updateTransition(targetState = imagePosition, label = "") val boxOffset by transition.animateOffset(label = "") { position -> when (position) { ImagePosition.TopLeft -> Offset(-60F, 0F) ImagePosition.BottomRight -> Offset(60F, 120F) ImagePosition.TopRight -> Offset(60F, 0F) ImagePosition.BottomLeft -> Offset(-60F, 120F) } } Button(onClick = { imagePosition = ChangePosition(imagePosition) }) { Text("Change position") } Box { Image( painter = painterResource(id = R.drawable.pikaqiu), contentDescription = null, Modifier .offset(boxOffset.x.dp, boxOffset.y.dp) .animateContentSize() .size(300.dp) ) } } 其中,ImagePosition、ChangePosition分别为定义的枚举类、自定义函数。 enum class ImagePosition { TopRight, TopLeft, BottomRight, BottomLeft } fun ChangePosition(position: ImagePosition) = when (position) { ImagePosition.TopLeft -> ImagePosition.BottomRight ImagePosition.BottomRight -> ImagePosition.TopRight ImagePosition.TopRight -> ImagePosition.BottomLeft ImagePosition.BottomLeft -> ImagePosition.TopLeft } 动画的如下图所示: 四、结语 Jetpack Compose 已将动画简化到只需在我们的可组合函数中创建声明性代码的程度,只需编写希望 UI 动画的方式,其余部分由 Compose 管理。最后,这也是是 Jetpack Compose 的主要目标:创建一个声明式 UI 工具包来加速应用程序开发并提高代码可读性和逻辑性。 Jetpack Compose提供的声明式UI工具包,能做到使用更少的代码实现更多的功能,且代码的可读性和逻辑性也大大提高了。 作者:vivo互联网游戏客户端团队-Ke Jie

优秀的个人博客,低调大师

Android系统Bitmap内存分配原理与优化

# 一、前言 笔者最近致力于vivo游戏中心稳定性维护,在分析线上异常时,发现有相当一部分是由OutOfMemory引起。谈及OOM,我们一般都会想到内存泄漏,其实,往往还有另外一个因素——图片,如果对图片使用不当的话,很容易吃掉大量内存,从而导致异常。 尤其是游戏中心在2020末~2021初的几个重要版本,上线了很多内容相关的feature,引入大量图片、视频列表,从而导致线上OOM占比上升。 在这篇文章中,笔者将讲解一张看似普通的Bitmap对内存的占用,介绍Android Studio中帮助我们分析图片占用内存的工具,举例说明流行的两大图片加载框架:Glide、Picasso在加载图片时使用内存的不同方式,接着分析不同drawable目录下图片的显示策略,最后基于手机内存、版本,提出一种优化内存分配的方案。 # 二、查看图片内存占用 一张图片在内存占用的空间究竟有多少,普遍存在的一个误解是,图片本身在磁盘上/从网络下载下来是多大,就会占用多少的内存。这种说法是不正确的,图片占用内存的大小不取决于它本身的大小,而取决于图片库所采用的展示方式所申请的内存。 拿钢铁侠这张图片举例,它的尺寸是350*350,可以看到在电脑磁盘上,它只占36KB的空间。 ![](https://static001.geekbang.org/infoq/14/14e57769cd2c3c187bf635a6362924fa.jpeg) 我们创建一个简单的Demo,页面正中央是一个ImageView,用于显示这张钢铁侠图片。 ![](https://static001.geekbang.org/infoq/d7/d71766df61c3579ca07e7ed0a6fc9092.jpeg) 通过Android Studio进行heap dump,从而看图片所占用的内存。首先我们将显示图片时的内存快照保存下来。操作路径为Profiler->Memory->Heap Dump,这会生成一个dump文件,在其中可以看到当前堆的使用情况。 ![](https://static001.geekbang.org/infoq/01/013ea1970c9f032d18b3ed37bb7a2aa4.jpeg) 在下面这张图可以看到,程序运行时,“钢铁侠”这张图片占用的内存(Retained Size)是2560000bytes,约等于2.4MB内存。与它在磁盘上36KB的大小,相差了整整70倍! ![](https://static001.geekbang.org/infoq/57/577d2cc5b30edec69e28505ebaaa32d8.jpeg) **小技巧:如何查看dump文件中的图片** 在调试时,如果我们手头只有一个dump文件,往往需要还原图片内容,以帮助定位问题。有两种方式可以从dump文件里提取原图片。 **方式一:通过Android Studio直接查看** 如果dump文件来源自Android版本为7.1.1(Android N,API=25)及以下的设备,可以使用这种方法。选中Bitmap对象,直接在窗口的Bitmap Preview中查看图片内容(如上图),非常方便。 **方式二:通过MAT+GIMP查看** ![](https://static001.geekbang.org/infoq/38/38756f0ec29f8c58b01cdea00c643f9a.png) 这种方法适用于全部Android版本的设备,首先用[MAT](https://www.eclipse.org/mat/)打开dump文件,有时会发生下图的错误: ![](https://static001.geekbang.org/infoq/55/55f9118ce801b541b483b304f970b1ba.jpeg) 原因是Android Studio的Profiler生成的dump文件不是标准格式,我们可以使用位于路径SDK/platform-tools/hprof-conv.exe的工具将其转换为标准格式,转换命令为: ```java hprof-conv.exe ``` 将转换后的dump文件通过MAT打开,在其中找到Bitmap对象的byte\[\]属性,将其复制为image01.data文件。 ![](https://static001.geekbang.org/infoq/89/8912505bad9928701b735ebe1f4a2a37.jpeg) > Tip: 可以看到这里image01.data文件的尺寸是2.44MB,也正是在运行时图片所占用的内存。 然后用[GIMP](https://www.gimp.org/downloads/)工具打开该文件,在格式那里选择RGBA(大部分Bitmap都使用这种格式),宽与高可以在MAT中看到,笔者这里是800 * 800。设置好格式和宽高后,就可以看到图片的真实面目了。 ![](https://static001.geekbang.org/infoq/32/327dece8e1c11f3bcfe1c39aa064f6b6.jpeg) # 二、图片内存占用计算公式 在上一章节我们知道一个通过网络下载的36KB图片,在被加载到内存中时,需要2.4MB的空间。接下来解释这其中的换算关系,让我们记住一个公式: > 图片占用内存 = 图片质量 \* 宽 \* 高 这里面有“图片质量”、“宽”、“高”三个因素,它涉及到图片加载框架的实现,不同的框架,对于这三者的默认取值是不一样的,我们以当前最流行的Picasso和Glide为例。 **Picasso** 在Picasso中,图片默认显示的宽高与原始图片宽高一致。仍然以这张钢铁侠为例,图片本身是350px * 350px,当我们把它加载到200px * 200px的ImageView当中时,占用空间是**0.49MB**。 ![](https://static001.geekbang.org/infoq/0d/0daf64a596ad8272c220fafbc615cd9a.png) 因此,在目标ImageView小于图片尺寸的情况下,好的做法是使用不超过ImageView尺寸的图片源,一方面可以缩短图片下载时间,另一方面有助于优化内存占用。 **Glide** Glide则采用截然不同的处理方式,它最终使用的宽高是目标ImageView的宽高。如果我们把同样一张图片加载到200px * 200px的ImageView中,占用空间只有0.16MB。 ![](https://static001.geekbang.org/infoq/ce/ce2ec93e22d583df696cb848a936f6e0.png) **使Picasso达到与Glide同样的效果** Picasso的设计者也发现了这一缺点,提供一系列方法用来调整最终加载出来的图片尺寸,其一就是fit(),通过这个方法可以达到与Glide同样的效果。 ```java Picasso().get().load(IMAGE_URL).fit().into(imageVIEW) ``` **相反场景:小图加载到大ImageView中** 通常为了提供更清晰的界面,防止图片拉伸后失真模糊,设计师提供的图片都是高分辨率的,我们所面临的场景是将大图加载到小ImageView中。但也不排除相反的可能:将小图加载到大ImageView里面。这时Glide默认采用的内存策略是存在不足的:它采用目标ImageView的尺寸作为最终的宽和高。 举例说明,当把350 * 350的钢铁侠图片加载到600 * 600的ImageView中时,占用的内存高达1.41MB。 > 600 * 600 * 4bytes = 1.41MB 有没有一种方法,可以兼顾原图片与目标ImageView不同的大小关系呢?——有的,这就是centerInside()。 ```java Glide.with(this).load(IMAGE_URL).centerInside().into(imageView) ``` 借助centerInside()方法,可以达到“在原图片和目标ImageView中取最小宽高作为最终加载图片的尺寸”这样的效果。 # 三、图片质量 什么是“图片质量”?简单说就是用多少字节来表示一个像素点的颜色,它的学名叫做“**位深度**”,在图片属性当中可以看到。 图片位深度通常有1位、8位、16位、24位、32位。 ![](https://static001.geekbang.org/infoq/fa/faed08045fe303bde4deb0ce4a639f73.jpeg) PNG格式有8位、24位、32位三种形式,其中8位PNG支持两种不同 的透明形式(索引透明和alpha透明),24位PNG不支持透明,32位 PNG 在24位基础上增加了8位透明通道,因此可展现256级透明程度。 ![](https://static001.geekbang.org/infoq/af/af4b3784b242d039d9b7389348e695f6.png) Glide和Picasso默认采用的图片质量都是ARGB_8888、也就是带透明度的32位深度,一个像素点需要占用4bytes的内存,这也解释了为什么上文中的计算都是采用宽_高_4bytes的公式。 > 注:v4开始,Glide将ARGB\_8888作为默认配置。在那之前它一直默认使用RGB\_565。 对客户端使用的大部分图片来说,32位深度、16位深度的显示质量是肉眼较难分辨的,但它们在占用内存上相差了整整一倍。因此,笔者建议在大部分场景下,使用**RGB_565**作为加载图片的模式。以下两种场景除外: ![](https://static001.geekbang.org/infoq/08/0843f986c744659cf15e25380fa14eda.png) 1)含透明部分的图片:如果采用RGB_565图片格式来显示图片,是无法正常展现透明区域的。比如上方这个钢铁侠图片,原本透明的部分会被显示为黑色。 2)含渐变色并且对显示质量要求高的图片:32位比16位可以支持更多的颜色,在渐变的显示上呈现更加自然的过渡(如下图)。这时我们应当在显示质量和应用性能之间作取舍。对于低端设备,应用的稳定性比显示质量更加重要,笔者强烈建议采用16位深度来显示。 ![](https://static001.geekbang.org/infoq/2e/2e87ae0efc888a84159d6ca327ec0187.png) # 四、drawable目录下图片加载方式 项目的资源目录下,一般都有drawable-mdpi、drawable-hdpi、drawable-xhdpi、drawable-xxhdpi、drawable-xxxhdpi目录,它们是用来匹配不同显示密度的设备的,对应表格如下。 ![](https://static001.geekbang.org/infoq/c6/c6406aea63a02fe96cb71cdc20bf9570.png) 通过adb shell wm density可以获取当前设备的dpi,对Nexus 6P模拟器执行后,可以读取到它的dpi是560,属于xxxhdpi。 ```java $ adb shell wm densityPhysical density: 560 ``` 那么同一个图片放在不同目录下,对分配内存是否有影响呢?答案是有的,基于两步简单的推导: - 图片所在资源目录、设备密度两者决定图片最终显示在屏幕上的像素尺寸; - 像素尺寸、图片质量共同决定分配内存。 其中第2点已经在上文讲解过,这里主要分析第1点。使用图片编辑软件,将原本是350 * 350的钢铁侠图片放大至700 * 700,并分别放入xhdpi、xxxhdpi两个目录下。 为什么使用这样的组合呢?因为从上表得知,xhdpi与xxxhdpi的显示密度是1:2,意味着一台xxxhdpi的设备在显示drawable-xhdpi目录下的图片时,会将其放大为2倍进行展示。因此我们将350 * 350的骨片放入drawable-xhdpi,将700 * 700的图片放入drawable-xxxhdpi,预期它们最终在屏幕上显示的尺寸相同。 ![](https://static001.geekbang.org/infoq/48/4881926a543949d5906f23683b81cbe9.png) 在布局里创建两个ImageView,观察这两张图片最终的显示效果,以及分配内存情况。 ```java ​ ​ ​ ``` 显示效果以及内存分配如下: ![](https://static001.geekbang.org/infoq/e3/e3b699cb2b2ddb12dc0c7b08dcfbd2a2.jpeg) 可以分析得出以下结论: > 对于显示尺寸613 * 613的图片,其占据内存为613 * 613 * 4 = 1,503,076B ≈ 1.5MB,符合上文中我们对图片内存的分析; > > 决定图片占用内存的是其最终显示在屏幕上的尺寸,与图片本身分辨率、在哪个drawable目录下没有直接关系; > > 由于xxxhdpi密度是xhdpi密度的两倍,故在屏幕密度属于xxxhdpi的Nexus 6P设备上,drawable-xxxhdpi目录下的图片被以近似于原像素尺寸(700px)进行显示(显示为613px),而位于drawable-xhdpi目录下的图片被放大至2倍显示,最终显示尺寸同样是613px。 # 五、优化策略 在实际的开发中,我们希望中高端机型加载更清晰的图片(ARGB\_8888),以提升用户体验,对于低端机型则希望加载占用内存更小的图片(RGB\_565),以降低OOM发生的概率。可以在初始化Glide时进行这样的配置。需要留意的是不要对含透明区域的图片采用这种优化方案。 ```java @GlideModule class MyGlideModule : AppGlideModule() { ​ override fun applyOptions(context: Context, builder: GlideBuilder) { builder.setDefaultRequestOptions(RequestOptions().format(getBitmapQuality())) } ​ private fun getBitmapQuality(): DecodeFormat { return if (Build.VERSION.SDK_INT < Build.VERSION_CODES.N || hasLowRam()) { // 低端机型采用RGB_565以节约内存 DecodeFormat.PREFER_RGB_565 } else { DecodeFormat.PREFER_ARGB_8888 } } } ``` # 六、小结 借助一些开源工具,我们可以便捷地定位大图,如滴滴开源的[DoKit](https://github.com/didi/DoraemonKit),篇幅原因不进行详细介绍。最后,对于我们日常开发总结几点建议,希望大家的应用稳定性节节攀升。 - 在多图的场景(比如RecyclerView)注意及时释放图片资源; - 使用占据内存更小的图片格式; - 图片源文件尺寸应当与目标ImageView相近; - 优先满足xxhdpi、xxxhdpi的图片资源需求; - 根据设备性能,采用不同的图片加载策略。 > 作者:vivo互联网客户端团队-Li Lei

优秀的个人博客,低调大师

从基础使用来深挖HashMap底层原理

### HashMap定义 说的专业一点,HashMap是常用的用于存储key-value键值对数据的一个**集合**,底层是基于对**Map**的接口实现。每一个键值对又叫**Entry**,这些**Entry**分散的存储在一个由**数组和链表**组成的集合中。当然在Java8中,Entry变成了**Node**。 > 说的通俗一点,就像你去住酒店,你下单提供了你的手机号,然后到酒店了给你一个房卡,你知道了你的房号之后再根据这个房号去找对应的房间一样。 > > 房号就是key,房间里就是value。你通过手机号下单到酒店给你房号可以理解为对key哈希的过程。你找的过程就是HashMap根据key取到对应value的过程 ### HashMap底层结构 #### table数组 首先我们要知道,我们存在HashMap中的数据最终是存了什么地方,就是如下的结构。 ```bash transient HashMap.Node [] table; ``` 可能有人看到transient有些陌生,被这个关键字修饰的变量将不会被序列化。简单来说,就是序列化之后这个字段的值就会被干掉,用于一些不需要传递给第三方的字段。 > 例如一个矩形,在本地使用的时候,有长、宽和面积三个属性,但是你要把这个对象给第三方用,但是由于面积可以通过另外两个属性推导出来,这个key就不需要传递给第三方了。 > > 这种情况就可以用transient关键字修饰。总的来说就是,被transient修饰的变量将不再参与序列化。 #### Node节点 下面是Node节点的定义。 ```java static class Node implements Entry { final int hash; final K key; V value; Node next; Node(int hash, K key, V value, Node next) { this.hash = hash; this.key = key; this.value = value; this.next = next; } ...... public final V getValue() { return value; } public final V setValue(V newValue) { V oldValue = value; value = newValue; return oldValue; } ...... } ``` 上面的代码省略了一些**Getter**和**Setter**,结构还是非常清晰和简单。可以看到这个节点存储了下一个节点的对象的引用,形成了一个链表的结构。 为什么要用链表?用数组不行吗?刚刚上面提到过,这个集合是由链表和数组组成的。因为再完美的hash算法都有可能产生哈希冲突,所以两个不同key的元素可以被放在同一个地方。 而单用数组明显不能满足这个需求,而在数组的槽位上存一个链表就可以解决这个问题。 ### HashMap的使用 上面简单了解了HashMap的定义和基本的底层数据结构,接下来通过HashMap在平常开发中的使用来具体看看怎么实现的。 ```java Map map = new HashMap<>(); map.put("搜索关注公众号", "SH的全栈笔记"); // 设置值 map.get("搜索关注公众号"); // SH的全栈笔记 ``` ### 赋值 #### put函数 上面的Put方法,我们传入了两个参数,Key和Value,函数的定义如下。 ```java public V put(K key, V value) { return this.putVal(hash(key), key, value, false, true); } ``` 应该跟大多数人YY的put方法差不多,put方法再调用了`putVal` 方法。 首先经过了hash之后的key,是一个整型的hashcode,其次是我们传入的key和value。**最后两个布尔值,后面会提到。** 首先一进入putVal就会声明存放数据的table,如果这个HashMap是首次设置值,就会被初始化一个默认size的table,且所有元素的初始值都是NULL,下面是初始化这块的核心代码,我省略掉了一些无关的变量声明。 > 有趣的是,初始化调用的是`resize`方法。 ```java Node [] tab; int n; if ((tab = table) == null || (n = tab.length) == 0) { n = (tab = resize()).length; } newCap = 16; // 默认容量 newThr = 12; // 默认阈值 ``` #### 默认值为啥是16 上面初始化table的默认size给的是16,当然我们也可以自己定义,但是建议是最好是2的幂。有的朋(杠)友(精)就要问了,为什么是16呢?我13,14不他不香吗?我们接下来就要分析为什么不香。 当我们放元素进入map的时候,它是如何确定元素在table数组中的位置的呢?我们拿`搜索关注公众号`这个key举例。 ```java hash = (h = key.hashCode()) ^ h >>> 16 p = tab[i = n - 1 & hash] ``` 可以看到,是将hash之后key和数组的length-1做与运算得到了一个数组下标。而且,hash值的二进制的位数,大多数情况下都会比table的长度的二进制位数多。换句话说,与运算之后得到的数组下标index完全取决于hash值的后几位。 ```d 16 // n 10000 15 // n-1 1111 14 // 1110 13 // 1101 12 // 1100 11 // 1011 10 // 1010 ``` 从13、14的二进制值可以看出来,存在0和1在二进制位数上分布不均匀的情况,这样一来就会造成一个问题,那就是会存在某些**不同的hash值**经过与运算得到的值是**一样的**。这样就会导致hash到的index**不均匀**,换句话说有些index可能永远都不会被hash到,而有些index也被频繁的hash到。 本来hash算法是要求计算的结果要均匀分布的,但是上述的结果明显不符合均匀分布的要求。用n-1而不用n也是因为同样的道理。如果这个值是2的幂,那么2的幂的值-1的所有二进制位数都是1,这样有利于hash计算的均匀分布。 综上所述,不一定是16,**2的幂**都可以,16只是一个经验值。 #### 自动扩容 除了size,初始化的时候还会设定一个阈值,值为12,`newThr = 12`,这里需要提到一个概念**负载因子**,HashMap的实现里默认给的是0.75。 ```java public HashMap() { this.loadFactor = 0.75F; // 12/16=0.75 } ``` 负载因子是用来干嘛的呢?最开始我们提到了,最开始存储的数据结构是数组,这种基础结构是有size设定的。当我们不停的往map里存数据的时候,总会存满,当元素快存满的时候,我们就需要扩大map的容量,来容纳更多的元素,这就需要一个**自动扩容**的机制了。 > 不是扩容弹匣,想啥呢 在当数据量大于超过设定的阈值的时候(容量*负载因子),自动对map进行扩容,以存放更多的数据。 自动扩容做了什么事情呢?总结来说就是两件事。 - 创建新的数组,大小是原来数组的一倍。 - 将元素rehash到新的数组 为什么要**rehash**呢?上面我们提到过了,当元素被放进map时,确认下标的方法是**table的长度-1**和**hash值**做与运算,现在table的长度发生了变化,那么自然而然,元素获取下标的运算结果也就跟之前的不一样了, 所以需要将老的map中的元素再按照新的table长度**rehash**到扩容后的table中。 > 所以在当你对性能有一定要求,且你知道你创建map的时候size的时候,可以指定size,这样一来就不会因为数据量持续的增大而去频繁的自动扩容了 #### put的过程中到底发生了什么 了解了**底层数据结构**和**自动扩容机制**,接下来我们来看一下put过程中究竟发生了什么。我们上面说过了,会通过**数组的长度-1**和**hash值**与运算得到一个数组下标。 如果该位置没有元素,那么就很简单,直接新建一个节点即可然后放置在数据的具体位置即可。 ```java tab[i] = this.newNode(hash, key, value, (HashMap.Node)null); ``` 但是如果该下标已经有元素了,这种情况HashMap是怎么处理的呢?这也要看情况。 - 如果是跟当前槽位相同的key,就直接覆盖。这就是我们修改某个key的值会发生的情况。那HashMap怎么来判断是不是同一个key呢?就像下面这样。`p`就是当前槽位上已经有的元素,如果新、老元素的key的**hashCode**和**值**都相同**且key不为空**,那么就能证明这两个key是相同的,那么此时只需要**覆盖**即可。 `p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))` - 而如果p是`TreeNode`的实例,那么就代表当前槽位已经是一个**红黑树**了,此时只需要往这个树里`putTreeVal`即可。至于为什么是红黑树,哪儿来的红黑树,下面马上就要讲到了。 - 最后一种情况就是,既不是已经存在的元素也不是TreeNode的实例,也不是**红黑树**。这种情况下,它就是一个普通的Node。你可以理解为链表,如果hash冲突了,就把这个Node放到该位置的**链表末尾**。Java8之前采用的**头插法**,而Java8换成了**尾插法**,至于为什么要换,后面会讲。 当该位置的链表中的元素超过了`TREEIFY_THRESHOLD`所设置的数量时,就会触发树化,将其转化为**红黑树**。Java8里给的默认值是**8**,而当元素的数量低于6时又会 #### 为啥要转化成红黑树 首先我们要知道为什么要树化。当大量的数据放入Map中,Hash冲突会越来越多,某些位置就会出现一个很长的链表的情况。这种情况下,查询时间复杂度是O(n) ,删除的时间复杂度也是O(n),查询、删除的效率会大大降低。而同样的数据情况下,平衡二叉树的时间复杂度都是O(logn)。 > 有的朋(杠)友(精)看到这个小标题不乐意了,怎么就直接用红黑树了?我用**二叉查找树**它不香吗? 不了解二叉查找树的,我把它的特点列在了下面。 - 左子树上的所有节点的值都小于根节点的值 - 右子树上的所有节点的值都大于根节点的值 再精简一下就是,**左小右大** 但是,如果数据大量的趋近于有序,例如所有的节点都比根节点大,那这个时候**二叉查找树**就退化成了**链表**,查询效率就会急剧下降。看到这是不是觉得有点不对,我才从链表树化,你这又给我退化成了链表? > 朋友看到这又不乐意了,好好好,就算二叉查找树不行,那AVL树它也不行?用了AVL树就不会出现上面所描述的效率急剧退化的情况了不是吗? 的确是这样,AVL也可以叫**平衡二叉搜索树**。AVL树会在其有退化成链表的趋势的时候(左右子树的高度差超过某个阈值)调整树的结构,也就是通过左旋和右旋来使其左右子树的高度尽量平衡。 > OK,OK,就算你解释清楚了为什么要树化,那为什么一定要用**红黑树**? 具体的细节也就不在这里赘述,不知不觉已经写了这么多了,直接说结论吧。AVL树的查找速度更快,但是相应的插入和修改的速度较慢。而红黑树则在插入和修改操作较为密集的时候表现更好。 而总结我们日常的HashMap使用,大多数情况下插入和修改应该是比查找更频繁一些的。而在这种情况下,红黑树的综合表现会更好一些。 至于红黑树的相关细节,涉及的东西还是挺多,我之后会单独拿一个篇幅来讲。 #### 为什么要用尾插法 我们目前用的最多的是Java8,在Java8中采用的是**尾插法**,Java8之前采用的是头插法。 那为什么后面又变成了**尾插法**呢?放心,肯定不是设计者闲的蛋疼,没事来改个设计。这样做一定是有一定的道理的。在解释这个问题之前,我们先来看看,如果采取头插法在**多线程**下的情况下会出现什么问题。 我们讲过,假设数组中index=1的位置已经有了元素`A`,之后又有元素`B`被分配到了index=1的位置。那么在下标为1的槽位上的链表就变成了B -> A。 此时再分配了一个新元素`C`,链表又被更新成了C -> B -> A。这也是为什么叫**头插法**,新的元素会被放在链表的头节点,因为当时设计的时候考虑到后被放入map的元素被访问的可能性更大。 上面讲到了在当不停的往map中放置元素后,超过了设定的阈值,就会触发**自动扩容**。此时会触发两个操作,一是创建一个容量为之前两倍的底层数组,并且将老的数组中的元素**rehash**到新的数组中。 而由于数组的长度发生了变化,这就导致了元素的rehash结果跟之前在老数组中的位置不一样。 首先我们来模拟一下rehash的过程,假设新的数组中下标为2的槽位是空的。 - 首先元素C,被放置在了其他位置。 - 然后元素B,被rehash到了下标为2的槽位, 至此都没有问题。 - 最后元素A,同样被rehash到了下标为2的槽位,此时链表变成了A -> B。到这就有问题了,最开始B的next指向的是A节点。但是rehash之后A的next又指向B,看到这你应该就能明白发生了什么。 我看到很多的对JDK1.7版的HashMap在多线程的情况下扩容会出现死锁的解释都只到了环形链表。但是其实就算是环形链表,只要找到了对应的元素,就会直接退出循环的逻辑,也不会造成死循环。 实际情况是,当自动扩容形成了环形链表后,当你去Get了一个在entry链上**不存在的元素时**,就会出现死循环的情况。 ### 取值 上面聊了给HashMap赋值的大概过程,接下来聊一下从HashMap获取值会发生什么。get方法的开始,跟put一样很简单。 ```java public V get(Object key) { Node e; return (e = getNode(hash(key), key)) == null ? null : e.value; } ``` 可以看到,取值的核心操作是`getNode`来负责完成的。 首先第一件事就是去check的第一个元素是不是当前查找的元素。 如果不是,而且当前槽位已经被树化成了红黑树,就走红黑树的`getTreeNode`方法。 如果还没有被树化,只是普通的链表,则顺着next一路找下去。 由于get方法逻辑和实现都比较容易理解,就不贴太多源码了。 ### 结尾 如果有什么问题,欢迎大家在评论区讨论。 > 好了以上就是本篇博客的全部内容了,欢迎微信搜索关注【**SH的全栈笔记**】,回复【**队列**】获取MQ学习资料,包含基础概念解析和RocketMQ详细的源码解析,持续更新中。 > > > > 如果你觉得这篇文章对你有帮助,还麻烦**点个赞**,**关个注**,**分个享**,**留个言**。 ![](https://tva1.sinaimg.cn/large/008eGmZEgy1go0v5rrqp4j31eg0hcwhm.jpg)

优秀的个人博客,低调大师

【技术原理】网络IO模型分析介绍(下)

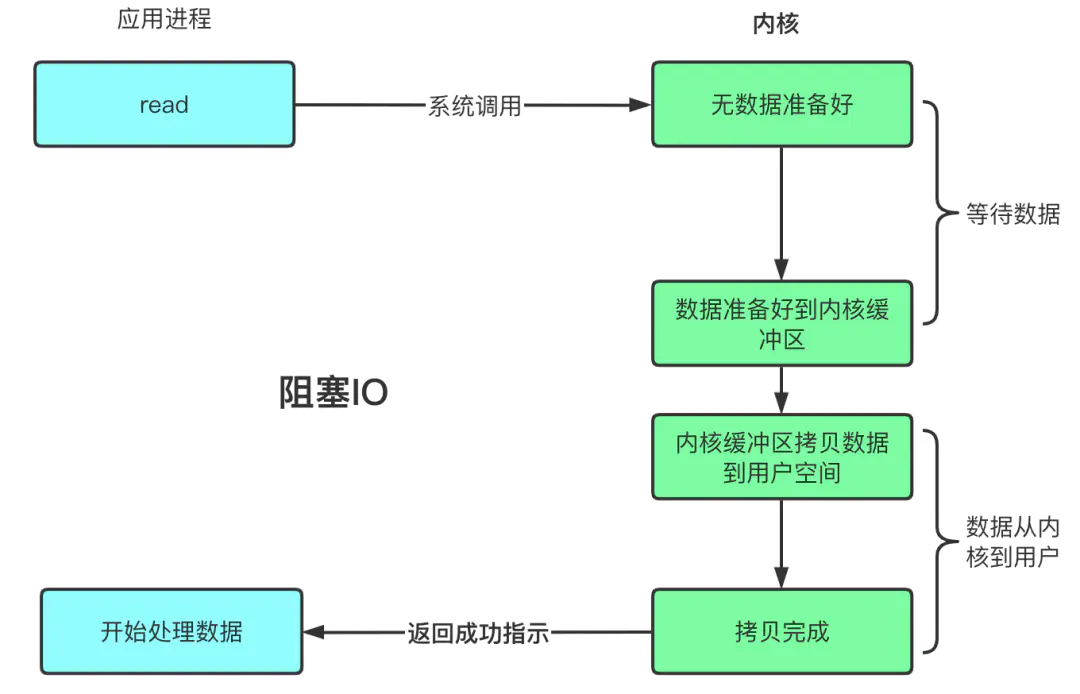
每日努力 请一定要有自信。你就是一道风景,没必要在别人风景里面仰视。 网络IO模型的分类 BIO 伪异步 NIO AIO BIO BIO是一个典型的网络编程模型,是通常我们实现一个服务端程序的过程。 步骤如下 主线程accept请求阻塞 请求到达,创建新的线程来处理这个套接字,完成对客户端的响应。 主线程继续accept下一个请求 这种模型有一个很大的问题是:当客户端连接增多时,服务端创建的线程也会暴涨,系统性能会急剧下降。 伪异步(线程池模式的BIO) 在BIO模型的基础上,类似于tomcat的bio connector,采用的是线程池来避免对于每一个客户端都创建一个线程:把请求抛到线程池中异步等待处理。 NIO(非阻塞机制) NIO API主要是三个部分:缓冲区(Buffers)、通道(Channels)和 Selector。 NIO基于事件驱动思想来实现的,它采用Reactor模式实现,主要用来解决BIO模型中一个服务端无法同时并发处理大量客户端连接的问题。 NIO基于Selector(事件循环器)进行轮训,当socket有数据可读、可写、连接完成、新的TCP请求接入事件时,操作系统内核会触发(通过JNI回调给Java线程栈中的方法栈帧),Selector返回准备就绪的SelectionKey集合,通过SelectableChannel进行读写操作。(通过SelectionKey作为事件的标志字段) 由于JDK的Selector底层基于epoll实现,理论可以同时处理操作系统最大文件句柄个数的连接。 SelectableChannel 的读写操作都是=非阻塞的,当由于数据没有就绪导致读半包时(数据准备阶段),立即返回,不会同步阻塞等待数据就绪,当TCP缓冲区数据就绪之后,会触发Selector的读事件,驱动下一次读操作。 因此,一个Reactor线程就可以同时处理N个客户端的连接,使得Java服务器的并发读写能力得到极大的提升。 JDK1.4开始引入了NIO类库,这里的NIO指的是Non-block IO,主要是使用Selector多路复用器来实现。Selector在Linux等主流操作系统上是通过epoll实现的。 NIO的实现流程,类似于select: 创建ServerSocketChannel监听客户端连接并绑定监听端口,设置为非阻塞模式。 创建Reactor线程,创建多路复用器(Selector)并启动线程。 将ServerSocketChannel注册到Reactor线程的Selector上。监听accept事件。 Selector在线程run方法中无线循环轮询准备就绪的Key。 Selector监听到新的客户端接入,处理新的请求,完成tcp三次握手,建立物理连接。 将新的客户端连接注册到Selector上,监听读操作。读取客户端发送的网络消息。 客户端发送的数据就绪则读取客户端请求,进行处理。 AIO JDK1.7引入NIO2.0,提供了异步文件通道和异步套接字通道的实现。其底层在windows上是通过IOCP,在Linux上是通过epoll来实现的 LinuxAsynchronousChannelProvider.java, UnixAsynchronousServerSocketChannelImpl.java 创建AsynchronousServerSocketChannel,绑定监听端口 调用AsynchronousServerSocketChannel的accept方法,传入自己实现的CompletionHandler。包括上一步,都是非阻塞的 连接传入,回调CompletionHandler的completed方法,在里面,调用AsynchronousSocketChannel的read方法,传入负责处理数据的CompletionHandler。 数据就绪,触发负责处理数据的CompletionHandler的completed方法。继续做下一步处理即可。写入操作类似,也需要传入CompletionHandler。 同步和异步 这两个概念与消息的通知机制 (synchronous communication/ asynchronous communication)有关。 同步 一个任务的完成需要依赖另外一个任务时,只有等待被依赖的任务完成后,依赖的任务才能算完成,这是一种可靠的任务序列。要么都成功,要么都失败,两个任务的状态可以保持一致。 在发出一个调用时,在没有得到结果之前,该调用就不返回。但是一旦调用返回,就得到返回值了。换句话说,就是由调用者主动等待这个调用的结果。 对于同步型的调用,应用层需要自己去向系统内核问询,如果数据还未读取完毕,那此时读取文件的任务还未完成。 应用层根据其阻塞和非阻塞的划分,或挂起或去做其他事情(所以同步和异步并不决定其等待数据返回时的状态); 如果数据已经读取完毕,那此时系统内核将数据返回给应用层,应用层即可以用取得的数据做其他相关的事情。 异步 不需要等到被依赖的任务完成,只是通知被依赖的任务要完成什么工作,依赖的任务也立即执行,只要自己完成了整个任务就算完成了。至于被依赖的任务最终是否真正完成,依赖它的任务无法确定,所以它是不可靠的任务序列。 调用在发出之后,这个调用就直接返回了,所以没有返回结果。 换句话说,当一个异步过程调用发出后,调用者不会立刻得到结果。 而是在调用发出后,被调用者通过状态、通知来通知调用者,或通过回调函数处理这个调用。 而对于异步型的调用,应用层无需主动向系统内核问询,在系统内核读取完文件数据之后,会主动通知应用层数据已经读取完毕,此时应用层即可以接收系统内核返回过来的数据,再做其他事情。也就是说,是否是同步还是异步,关注的是任务完成时消息通知的方式。由调用方盲目主动问询的方式是同步调用,由被调用方主动通知调用方任务已完成的方式是异步调用。 消息的三种通知机制:状态、通知和回调。 前者低效,后两者高效、类似。 阻塞与非阻塞 这两个概念与程序(线程)等待消息通知(无所谓同步或者异步)时的状态有关。 阻塞调用 调用结果返回之前,当前线程会被挂起,一直处于等待消息通知,不能够执行其他业务。函数只有在得到结果之后才会返回。 非阻塞调用 指在不能立刻得到结果之前,该函数不会阻塞当前线程,而会立刻返回去完成其他任务。 总结来说,是否是阻塞还是非阻塞,关注的是接口调用(发出请求)后等待数据返回时的状态。被挂起无法执行其他操作的则是阻塞型的,可以被立即「抽离」去完成其他「任务」的则是非阻塞型的。 阻塞和同步的讨论 有人也许会把阻塞调用和同步调用等同起来,实际上它们是不同的。 对于同步调用来说,很多时候当前线程可能还是激活的,只是从逻辑上当前函数没有返回而已,此时,这个线程可能也会处理其他的消息。还有一点,在这里先扩展下: 如果这个线程在等待当前函数返回时,仍在执行其他消息处理,那这种情况就叫做同步非阻塞; 如果这个线程在等待当前函数返回时,没有执行其他消息处理,而是处于挂起等待状态,那这种情况就叫做同步阻塞; 所以同步的实现方式会有两种:同步阻塞、同步非阻塞;同理,异步也会有两种实现:异步阻塞、异步非阻塞; 对于阻塞调用来说,则当前线程就会被挂起等待当前函数返回; 虽然表面上看非阻塞的方式可以明显的提高CPU的利用率,但是也带了另外一种后果就是系统的线程切换增加。增加的CPU执行时间能不能补偿系统的切换成本需要好好评估。 同步异步/阻塞非阻塞 在说明synchronous IO和asynchronous IO的区别之前,需要先给出两者的定义。Stevens给出的定义(其实是POSIX的定义)是这样子的: A synchronous I/O operation causes the requesting process to be blocked until that I/O operation completes; An asynchronous I/O operation does not cause the requesting process to be blocked; 两者的区别就在于synchronous IO做”IO operation”的时候会将process阻塞。按照这个定义,之前所述的blocking IO,non-blocking IO,IO multiplexing都属于synchronous IO。 有人可能会说,non-blocking IO并没有被block啊。这里有个非常“狡猾”的地方,定义中所指的”IO operation”是指真实的IO操作,就是例子中的recvfrom这个system call。 non-blocking IO在执行recvfrom这个system call的时候,如果kernel的数据没有准备好,这时候不会block进程。 但是,当kernel中数据准备好的时候,recvfrom会将数据从kernel拷贝到用户内存中,这个时候进程是被block了,在这段时间内,进程是被block的。 而asynchronous IO则不一样,当进程发起IO 操作之后,就直接返回再也不理睬了,直到kernel发送一个信号,告诉进程说IO完成。在这整个过程中,进程完全没有被block。 同步异步/阻塞非阻塞 "同步异步"和"阻塞非阻塞"是两个不同范围的概念。 synchronous / asynchronous is to describe the relation between two modules. blocking / non-blocking is to describe the situation of one module. An example: "I": a "bookstore" : b a asks b: do you have a book named "c++ primer"? blocking: before b answers a, a keeps waiting there for the answer. Now a (one module) is blocking. a and b are two threads or two processes or one thread or one process? we DON'T know. non-blocking: before b answers a, a just leaves there and every two minutes, a comes here for looking for the answer. Here a (one module) is non-blocking. a and b are two threads or two processes or one process? we DON'T know. BUT we are sure that a and b couldn't be one thread. synchronous: before b answers a, a keeps waiting there for the answer. It means that a can't continue until b finishes its job. Now we say: a and b (two modules) is synchronous. a and b are two threads or two processes or one thread or one process? we DON'T know. asynchronous: before b answers a, a leaves there and a can do other jobs. When b gets the answer, b will call a: hey! I have it! Then a will come to b to get the book when a is free. Now we say: a and b (two modules) is asynchronous. a and b are two threads or two processes or one process? we DON'T know. BUT we are sure that a and b couldn't be one thread. 同步异步/阻塞非阻塞 同步和异步是一个非常广的概念,它们的重点在于多个任务和事件发生时,一个事件的发生或执行是否会导致整个流程的暂时等待。 阻塞和非阻塞的区别关键在于当发出请求一个操作时,如果条件不满足,是会一直等待还是返回一个标志信息。 在讨论IO(硬盘、网络、外设)时,一个完整的IO读请求操作包括两个阶段: 1)查看数据是否就绪; 2)进行数据拷贝(内核将数据拷贝到用户线程) 阻塞(blocking IO)和非阻塞(non-blocking IO)的区别就在于第一个阶段,如果数据没有就绪,在查看数据是否就绪的过程中是一直等待,还是直接返回一个标志信息。 在《Unix网络编程》一书中对同步IO和异步IO的定义是这样的: 事实上,同步IO和异步IO模型是针对用户线程和内核的交互来说的: 同步IO:当用户发出IO请求操作之后,如果数据没有就绪,需要通过用户线程或者内核不断地去轮询数据是否就绪,当数据就绪时,再将数据从内核拷贝到用户线程; 异步IO:只有IO请求操作的发出是由用户线程来进行的,IO操作的两个阶段都是由内核自动完成,然后发送通知告知用户线程IO操作已经完成。也就是说在异步IO中,不会对用户线程产生任何阻塞。 这是同步IO和异步IO关键区别所在,同步IO和异步IO的关键区别反映在数据拷贝阶段是由用户线程完成还是内核完成。 所以说<u>异步IO必须要有操作系统的底层支持</u>。 注意同步IO和异步IO与阻塞IO和非阻塞IO是不同的两组概念。 阻塞IO和非阻塞IO是反映在当用户请求IO操作时,如果数据没有就绪,是用户线程一直等待数据就绪,还是会收到一个标志信息这一点上面的。也就是说,阻塞IO和非阻塞IO是反映在IO操作的第一个阶段,在查看数据是否就绪时是如何处理的。 同步/异步与阻塞/非阻塞 同步阻塞:效率是最低的。 异步阻塞:异步操作是可以被阻塞住的,只不过它不是在处理消息时阻塞,而是在等待消息通知时被阻塞。 同步非阻塞:实际上是效率低下的,这个程序需要在两种不同的行为之间来回的切换,效率可想而知是低下的。 异步非阻塞:效率更高。 用户空间与内核空间 现在操作系统都是采用虚拟存储器,对32位操作系统而言,它的寻址空间(虚拟存储空间)为4G(2的32次方)。 操作系统的核心是内核,独立于普通的应用程序,可以访问受保护的内存空间,也有访问底层硬件设备的所有权限。 为了保证用户进程不能直接操作内核(kernel),保证内核的安全,操作系统将虚拟空间划分为两部分,一部分为内核空间,一部分为用户空间。 针对linux操作系统而言,将最高的1G字节(从虚拟地址0xC0000000到0xFFFFFFFF),供内核使用,称为内核空间,而将较低的3G字节(从虚拟地址0x00000000到0xBFFFFFFF),供各个进程使用,称为用户空间。 进程切换 为了控制进程的执行,内核必须有能力挂起正在CPU上运行的进程,并恢复以前挂起的某个进程的执行。这种行为被称为进程切换/任务切换/上下文切换。因此可以说,任何进程都是在操作系统内核的支持下运行的,是与内核紧密相关的。 从一个进程的运行转到另一个进程上运行,这个过程中经过下面这些变化: 保存处理机上下文,包括程序计数器和其他寄存器。 更新PCB信息。 把进程的PCB移入相应的队列,如就绪、在某事件阻塞等队列。 选择另一个进程执行,并更新其PCB。 更新内存管理的数据结构。 恢复处理机上下文。 进程的阻塞 正在执行的进程,由于期待的某些事件未发生,如请求系统资源失败、等待某种操作的完成、新数据尚未到达或无新工作做等,则由系统自动执行阻塞原语(Block),使自己由运行状态变为阻塞状态。可见,进程的阻塞是进程自身的一种主动行为,也因此只有处于运行态的进程(获得CPU),才可能将其转为阻塞状态。当进程进入阻塞状态,是不占用CPU资源的。 文件描述符fd 文件描述符(File descriptor)是计算机科学中的一个术语,是一个用于表述指向文件的引用的抽象化概念。 文件描述符在形式上是一个非负整数。实际上,它是一个索引值,指向内核为每一个进程所维护的该进程打开文件的记录表。当程序打开一个现有文件或者创建一个新文件时,内核向进程返回一个文件描述符。在程序设计中,一些涉及底层的程序编写往往会围绕着文件描述符展开。但是文件描述符这一概念往往只适用于UNIX、Linux这样的操作系统。 缓存 IO 缓存 IO 又被称作标准 IO,大多数文件系统的默认 IO 操作都是缓存 IO。在 Linux 的缓存 IO 机制中,操作系统会将IO的数据缓存在文件系统的页缓存( page cache )中,也就是说,数据会先被拷贝到操作系统内核的缓冲区中,然后才会从操作系统内核的缓冲区拷贝到应用程序的地址空间。 缓存 IO 的缺点 数据在传输过程中需要在应用程序地址空间和内核进行多次数据拷贝操作,这些数据拷贝操作所带来的CPU 以及内存开销是非常大的。

优秀的个人博客,低调大师

基于循环队列的BFS原理及实现

1.故事起源 有一只蚂蚁出去寻找食物,无意中进入了一个迷宫。蚂蚁只能向上、下、左、右4个方向走,迷宫中有墙和水的地方都无法通行。这时蚂蚁犯难了,怎样才能找出到食物的最短路径呢? 2.思考 蚂蚁在起点时,有4个选择,可以向上、下、左、右某一个方向走1步。 如果蚂蚁走过了一段距离,此时也依然只有4个选择。 当然要排除之前走过的地方(不走回头路,走了也只会更长)和无法通过的墙和水。 蚂蚁想,还好我会影分身。如果每一步都分身成4个蚂蚁,向4个方向各走1步,这样最先找到食物的肯定就是最短的路径了(因为每一步都把能走的地方都走完了,肯定找不出更短的路径了)。 而且还能看出,第1步会到达所有到起点距离为1的地方,第2步也会到达所有距离为2的地方。 如此类推,第n步会覆盖所有到起点最短距离为n的地方。 3.问题建模 把迷宫地图放在二维数组中,能通行的地方为0,墙和水的地方为负数。 每一步向4个方向走,可以通过当前坐标(x,y)加上一个方向向量。 这个其实就是宽度优先搜索(BFS)的思想。 4.宽度优先搜索(BFS) 又称广度优先搜索,优先向四周扩展子节点,是最简便的图的搜索算法之一,一般通过队列来实现。 4.1 队列 是一种特殊的线性表,它只允许在表的前端进行删除操作,而在表的后端进行插入操作,即先进先出。 队列一般通过数组实现,对该数组增加一些操作上的限制。 但上面的实现有一些缺陷,当队列满时,也就是tail指针移动到队尾,这时就无法再插入数据,但前面的元素已经出队了,可能还有空缺的位置。 为了能高效利用空间,对该队列增加一点改进,也就是循环队列的产生。 4.2 循环队列 把队列想象成一个首尾相接的环形。 数组实现,需要多预留一个空间。如果head=tail时,无法判断是队空还是队满,所以占用一个空间,通过tail+1与head的关系来判断是否队满。 4.3 队列实现BFS 实现步骤如下: 将起点加入队列。 从队首取出一个节点,通过该节点向4个方向扩展子节点,并依次加入队尾。 重复以上步骤,直至队空或已找到目标位置。 回归迷宫问题,到起点的距离为1,2,3...的点会依次入队。 当head指针遍历到距离为2的点时,向4周扩展距离为3的节点,并继续入队。 5.代码实现 5.1 变量定义 //方向向量 constintdirection[4][2]={{0,1}, {-1,0}, {0,-1}, {1,0}}; constintMAXM=100,MAXN=100,QUEUE_LENGTH=5; //队列中的节点 structNode{ intx,y,distance; Node(){} Node(intxx,intyy,intd):x(xx),y(yy),distance(d){} }; intn,m,step=0,map[MAXM][MAXN],visit[MAXM][MAXN]; Nodestart,target; 5.2 BFS标准模板 voidbfs(){ Nodequeue[QUEUE_LENGTH]; inthead=0,tail=1; queue[0]=Node(start.x,start.y,0); visit[start.x][start.y]=0; while(head!=tail){ intx=queue[head].x; inty=queue[head].y; intdistance=queue[head].distance; head=(head+1)%QUEUE_LENGTH; for(inti=0;i<4;++i){ intdx=x+direction[i][0]; intdy=y+direction[i][1]; if(dx>=0&&dx<m&&dy>=0&&dy<n&&visit[dx][dy]==-1&&map[dx][dy]>=0){ //表示从i方向走过来的,方便后续回溯路径 visit[dx][dy]=i; if(dx==target.x&&dy==target.y){ cout<<"已到目标点,最短距离为"<<distance+1<<endl; step=distance+1; return; } if((tail+1)%QUEUE_LENGTH==head){ cout<<"队列满"<<endl; return; } //新坐标入队 queue[tail]=Node(dx,dy,distance+1); tail=(tail+1)%(QUEUE_LENGTH); } } } } 5.3 路径回溯 voidprintPath(){ intx,y,d,path[MAXM][MAXN]={0}; for(inti=0;i<m;++i){ for(intj=0;j<n;++j){ path[i][j]=-1; } } x=target.x; y=target.y; path[start.x][start.y]=0; //路径回溯 while(!(x==start.x&&y==start.y)){ path[x][y]=step--; d=visit[x][y]; x-=direction[d][0]; y-=direction[d][1]; } //路径打印 for(inti=0;i<m;++i){ for(intj=0;j<n;++j){ if(path[i][j]>=0){ cout<<path[i][j]; }else{ cout<<"-"; } } cout<<endl; } } 5.4 数据输入 intmain(){ cin>>m>>n; for(inti=0;i<m;++i){ for(intj=0;j<n;++j){ cin>>map[i][j]; visit[i][j]=-1; } } cin>>start.x>>start.y>>target.x>>target.y; bfs(); if(step>0)printPath(); return0; } 5.5 测试结果 输入数据: 55 00-100 0000-2 -10-200 000-10 0-2000 1143 输出: 已到目标点,最短距离为5 路径打印: ----- -0--- -1--- -23-- --45- 关注我,涨知识,微信公众号:几何思维 往期精彩回顾 老鼠与毒药 经典逻辑面试题,高楼扔鸡蛋 通过6人介绍可以认识世界上任何一个人?

资源下载

更多资源
Nacos

Nacos

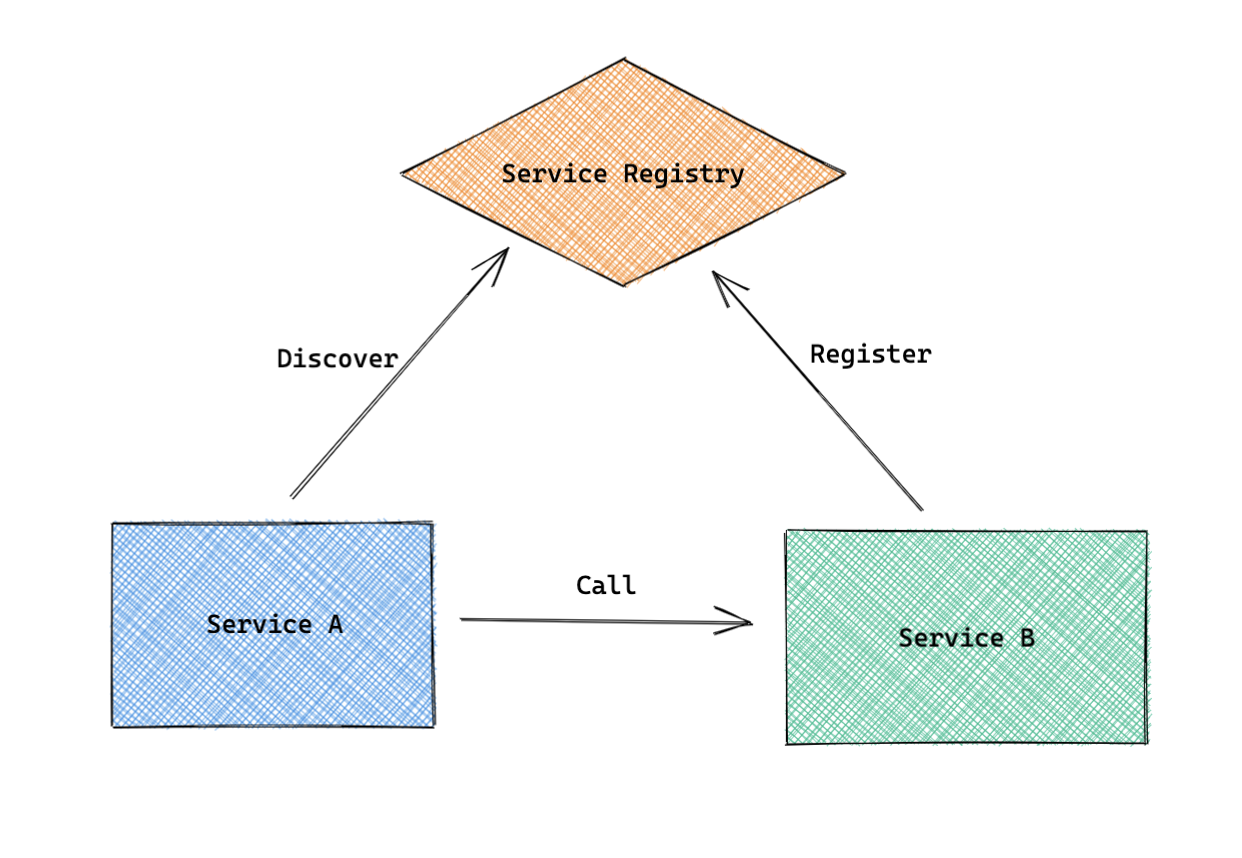
Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册