首页 文章 精选 留言 我的

精选列表

搜索[编译原理],共10000篇文章
优秀的个人博客,低调大师

kafka快速实战与原理了解(1)

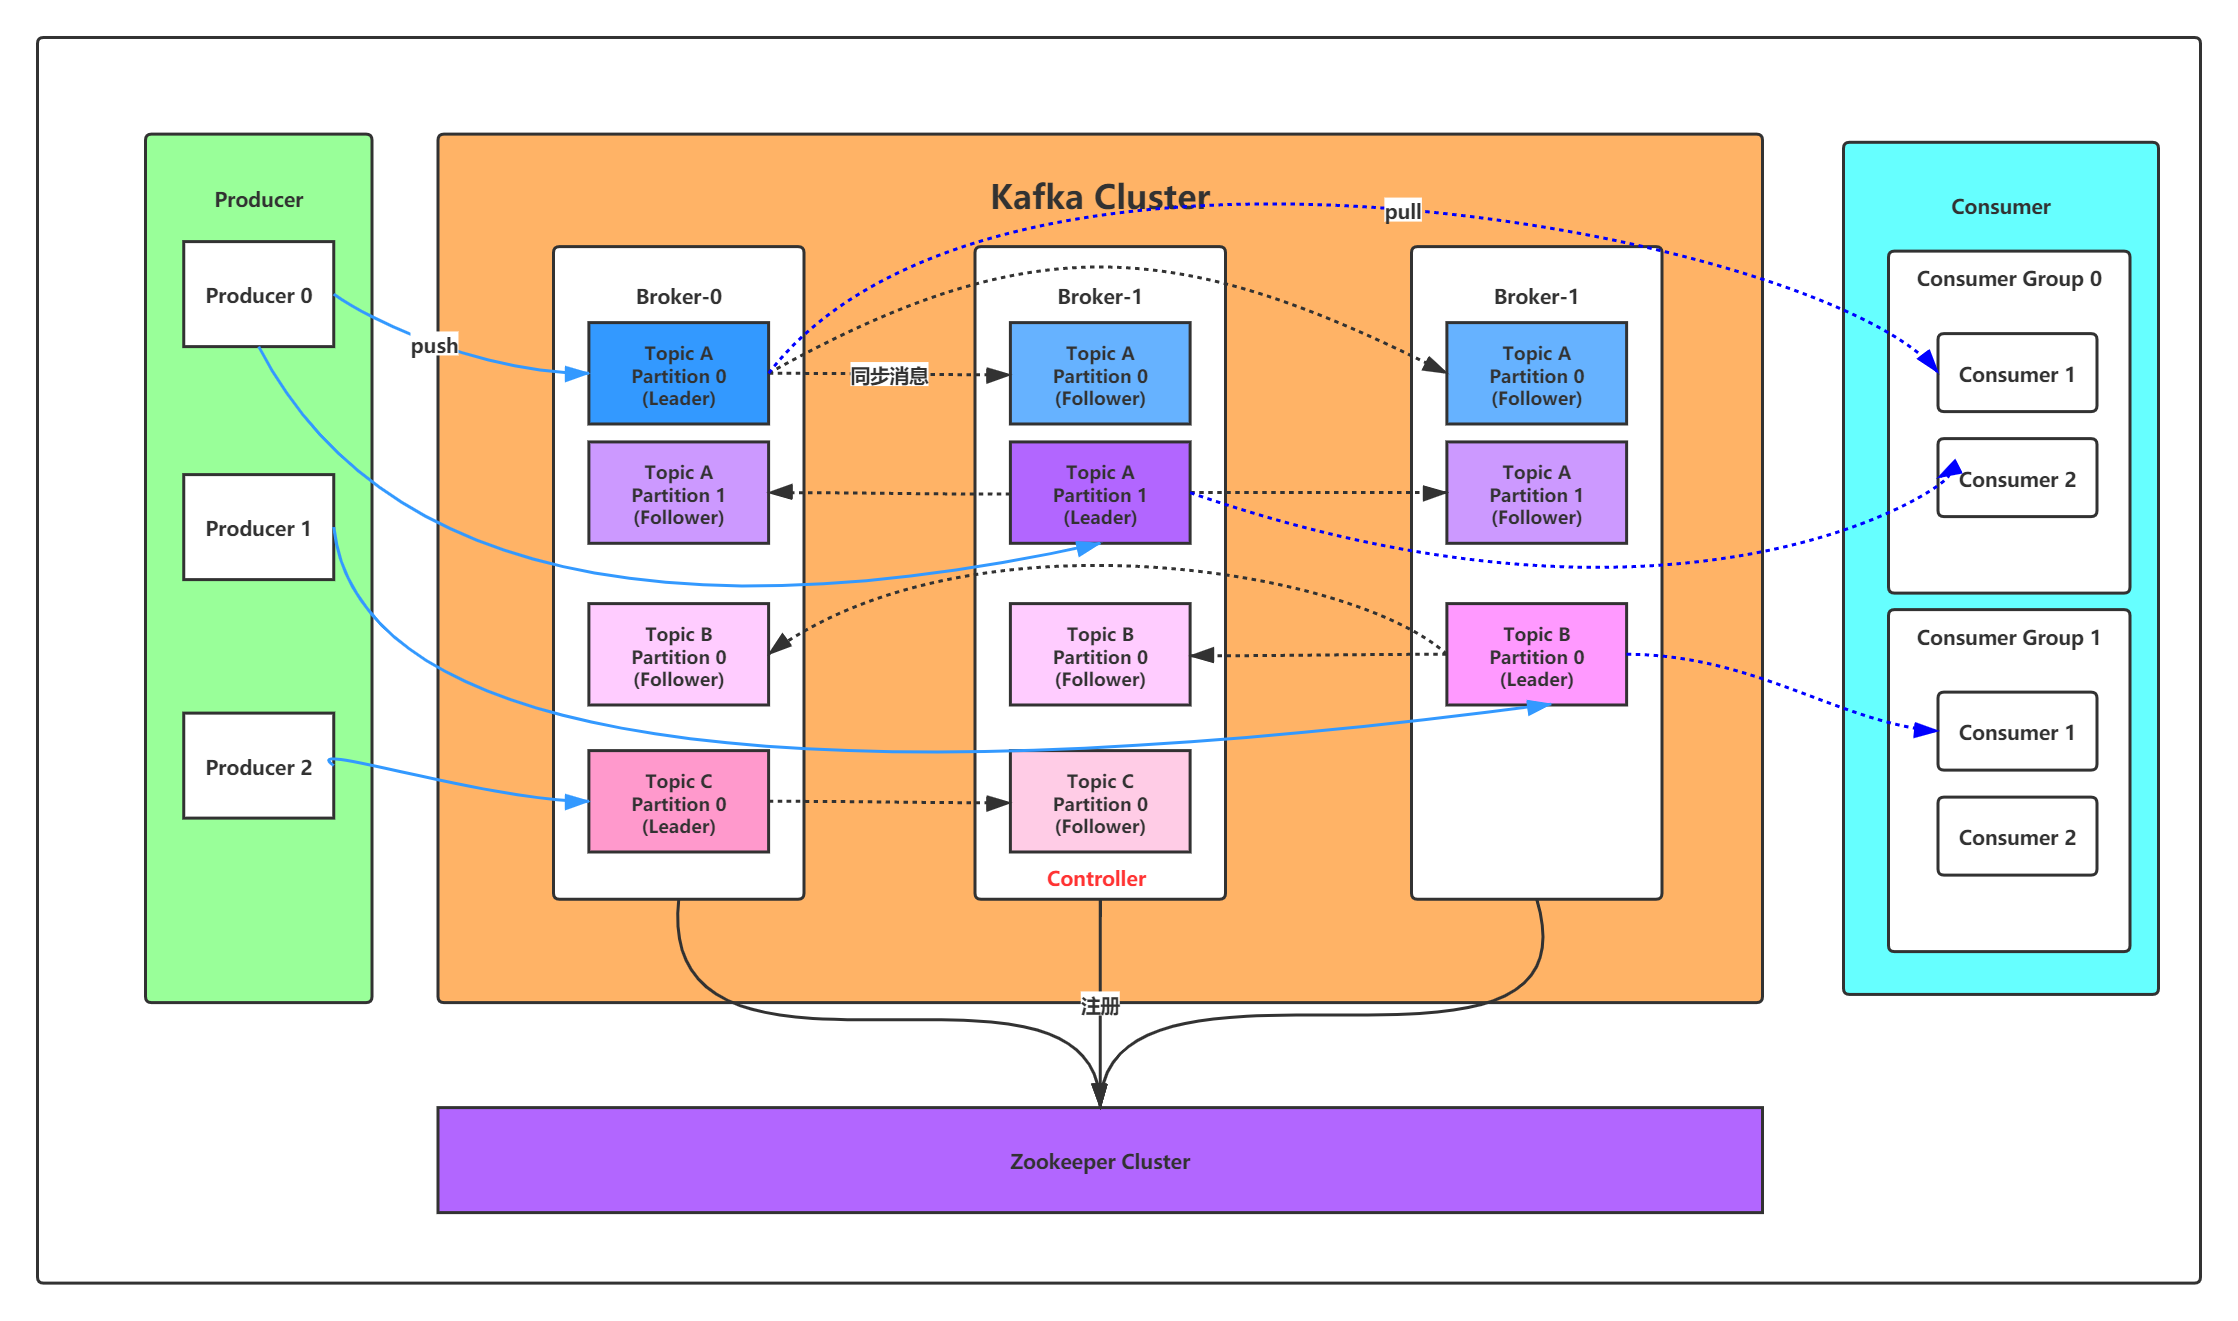
基本介绍 最初由Linkedin公司开发,2010捐给Apache 特性:分布式、分区、多副本 基于zk协调的分布式消息系统 可实时处理大数据量消息 应用场景:基于hadoop的批处理、Spark流失处理、web服务器日志、系统访问日志等 scala语言开发 业务应用场景 日志手机 消息系统 用户行为跟踪 运营指标监控 基本概念 Broker:消息处理节点,可理解为就是一个kafka节点 Topic:对消息进行归类 Producer/Consumer:生产者与消费者 ConsumerGroup:消费组,一条消息可被多个不同消费组消费,同一消费组内,只有一个消费者能消费某条消息 Partition:分区,物理概念,一个Topic可分为多个分区,每个分区内的消息是有序的;个人理解与RocketMQ中的Queue概念相似 基本使用 环境准备:kafka为Scala语言开发,需运行在jvm上,所以需准备JDK环境 kafka依赖zk做协调器,需安装zk 下载kafka,主要修改config/server.properties 关键属性: #broker.id属性在kafka集群中必须要是唯一 broker.id=0 #kafka部署的机器ip和提供服务的端口号 listeners=PLAINTEXT://192.168.65.60:9092 #kafka的消息存储文件 log.dir=/usr/local/data/kafka-logs #kafka连接zookeeper的地址,ZK集群以逗号隔开 zookeeper.connect=192.168.65.60:2181 启动脚本语法:kafka-server-start.sh [-daemon] server.properties 启动后可进入zk查看zk下的节点数据 停止:bin/kafka-server-stop.sh 创建主题 主题默认:分区数为1,副本数为1,最小写成功数为1 bin/kafka-topics.sh --create --zookeeper 192.168.65.60:2181 --replication-factor 1 --partitions 1 --topic test 主题在生产者发布消息时若不存在,则会自动创建 发送消息 自带bin/kafka-console-producer.sh命令客户端 bin/kafka-console-producer.sh --broker-list 192.168.65.60:9092 --topic test >this is a msg >this is a another msg 消费消息 自带消费消息命令终端:bin/kafka-console-consumer.sh bin/kafka-console-consumer.sh --bootstrap-server 192.168.65.60:9092 --topic test 带参数--from-beginning,表示可消费之前全部消息 带参数--whitelist "test|test-2" 同时消费多个主题 单播与多播 单播:一条消息只让一个消费者消费,类似Queue模式;我们让所有消费者在同一个消费者内即可实现; 多播:一条消息可让多个消费者同时都消费,类似发布订阅模式;我们让每个消费者存在不同消费组即可实现; 其他命令 // 查看消费组组名 bin/kafka-consumer-groups.sh --bootstrap-server 192.168.65.60:9092 --list // 查看消费组消费偏移量 bin/kafka-consumer-groups.sh --bootstrap-server 192.168.65.60:9092 --describe --group testGroup current-offset:当前消费组的已消费偏移量 log-end-offset:主题对应分区消息的结束偏移量(HW) lag:当前消费组未消费的消息数 Topic与Log Topic即为一个消息类别名称,同类消息一般发到同一Topic下 每个Topic下对应有多个分区日志文件 分区是一个有序的消息队列,消息被按序添加到commit log文件中 每个消息在一个分区中有唯一的标识,称为offset 不同分区中的消息,其offset可能相同 消息一般不会自动删除,默认被保留约最近7天 消费者基于自己在提交日志中消费的进度(offset)进行工作 offset由消费者自己维护 所以消费者可按序逐条消费commit log消息,也可指定offset来重复或跳过消费某些消息 // 创建2个分区的主题 bin/kafka-topics.sh --create --zookeeper 192.168.65.60:2181 --replication-factor 1 --partitions 2 --topic test1 查看下topic的情况 bin/kafka-topics.sh --describe --zookeeper 192.168.65.60:2181 --topic test1 leader节点:负责给定分区的所有读写请求 replicas节点:某分区存在的备份,不管是不是leader,甚至中途挂了都会列出 isr:是replicas的子集,只列存活且一同步备份了该分区的节点 消息日志主要存在分区文件夹以log结尾的文件 目前支持对topic分区数据量进行动态扩容,单不支持缩减 思考:为什么需要分区? 日志文件受到机器文件大小限制,分区后则可将不同分区放到集群中的不同机器上,相当于分布式存储;其次为了提高生产消息与消费消息的并行度;

优秀的个人博客,低调大师

ReentrantReadWriteLock读写锁简单原理案例证明

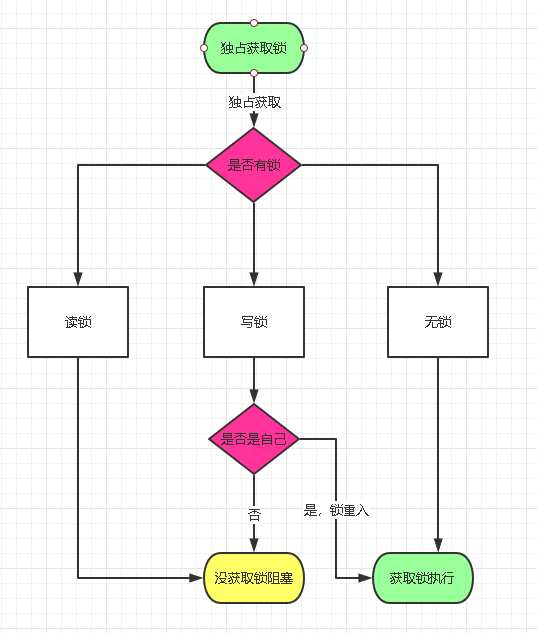
ReentrantReadWriteLock存在原因? 我们知道List的实现类ArrayList,LinkedList都是非线程安全的,Vector类通过用synchronized修饰方法保证了List的多线程非安全问题,但是有个缺点:读写同步,效率低下。于是就出现了CopyOnWriteArrayList,它通过写时复制数组实现了读写分离,提高了多线程对List读的效率,适合多读少些的情况。同理:我们知道ReentrantLock,它是一把独占的锁,是用来控制线程同步的,如果我们用ReentrantLock来实现ArrayList安全,能否达到CopyOnWriteArrayList同样的效果呢? importjava.util.ArrayList; importjava.util.List; importjava.util.concurrent.locks.ReentrantReadWriteLock; /** *@author:jiaolian *@date:Createdin2021-01-2615:49 *@description:ReentrantReadWriteLock多读少写的场景 *@modifiedBy: *公众号:叫练 */ publicclassMultReadTest{ privatestaticclassMyList{ privatefinalReentrantReadWriteLockREENTRANT_READ_WRITE_LOCK=newReentrantReadWriteLock(); privatefinalReentrantReadWriteLock.WriteLockWRITE_LOCK=REENTRANT_READ_WRITE_LOCK.writeLock(); privatefinalReentrantReadWriteLock.ReadLockREAD_LOCK=REENTRANT_READ_WRITE_LOCK.readLock(); privateList<String>list=newArrayList(); //读list publicvoidreadList(){ try{ READ_LOCK.lock(); Thread.sleep(1000); System.out.println(Thread.currentThread().getName()+":"+list.size()); }catch(InterruptedExceptione){ e.printStackTrace(); }finally{ READ_LOCK.unlock(); } } //写list publicvoidwriteList(){ try{ WRITE_LOCK.lock(); Thread.sleep(1000); System.out.println(Thread.currentThread().getName()+":新增1个元素"); list.add("叫练【公众号】"); }catch(InterruptedExceptione){ e.printStackTrace(); }finally{ WRITE_LOCK.unlock(); } } } publicstaticvoidmain(String[]args){ MyListmyList=newMyList(); //读写锁适合多读少写情况 //新建10个读线程,1个写线程 newThread(()->{myList.writeList();},"写线程").start(); for(inti=0;i<10;i++){ newThread(()->{myList.readList();},"读线程"+(i+1)).start(); } } } 上面案例我们用ReentrantReadWriteLock实现了CopyOnWriteArrayList,主线程新建了1个写线程写list,10个读线程读list,程序一共花费2执行完毕,如果用Vector需要花费11秒。在多线程的情况下,通过读写锁操作List,提高了List的读效率,在List读的部分,线程是共享的,在对List写的过程中,在对写的线程是同步的,因此我们可以得出一个结论:读写锁是读读共享,读写同步! 独占获取锁简单流程 如上图,我们简单的梳理下独占获取锁流程。 独占锁获取(上述例子中的WRITE_LOCK写锁),首先判断是否有线程获取了锁,是否有线程获取了锁的判断通过读写锁中通过32位int类型state可以获取,其中低16位表示读锁,高16表示写锁。 有读锁:直接排队阻塞。 有写锁:还需要判断写锁线程是否是自己,如果是自己就是锁重入了,如果不是自己说明已经有其他的线程获取锁正在执行,那么当前线程需要排队阻塞。 无锁:直接获取锁,其他抢占的独占锁线程需要排队阻塞,当前线程执行完毕后释放锁通知下一个排队线程获取锁。 共享获取锁简单流程 如上图,我们简单的梳理下共享锁获取锁流程。 独占锁获取(上述例子中的READ_LOCK读锁),首先判断是否有线程获取了锁。 有读锁:当前线程发现此时读锁状态被占用,说明有线程获取了读锁。该线程通过cas自旋【死循环】获取到读锁为止。 有写锁:还需要判断持有写锁的线程是否是自己,如果是自己而且此时是获取的是读锁会获取锁成功,我们称为锁降级,如果不是自己说明此时有其他线程获取了写锁,那么当前线程需要排队阻塞。 无锁:直接获取锁。 写锁降级 我们说读写互斥,但同一个线程中,先写后读也是允许的,我们称之为锁降级。在面试中共享锁面试频率也比较高,方便理解我们举个简单的案例说明下。 importjava.util.concurrent.locks.ReentrantReadWriteLock; /** *@author:jiaolian *@date:Createdin2021-01-2815:44 *@description:ReentrantReadWriteLock读写锁降级测试 *@modifiedBy: *公众号:叫练 */ publicclassWriteLockLowerTest{ privatestaticfinalReentrantReadWriteLockREENTRANT_READ_WRITE_LOCK=newReentrantReadWriteLock(); privatestaticfinalReentrantReadWriteLock.WriteLockWRITE_LOCK=REENTRANT_READ_WRITE_LOCK.writeLock(); privatestaticfinalReentrantReadWriteLock.ReadLockREAD_LOCK=REENTRANT_READ_WRITE_LOCK.readLock(); publicstaticvoidmain(String[]args){ try{ WRITE_LOCK.lock(); System.out.println("获取写锁"); READ_LOCK.lock(); System.out.println("获取读锁"); }finally{ READ_LOCK.unlock(); System.out.println("释放写锁"); WRITE_LOCK.unlock(); System.out.println("释放读锁"); } } } 如上述代码:程序可以运行完毕,说明锁可以降级。另外说一句,上面的程序先获取读锁再获取写锁,程序是会阻塞的,为什么呢?欢迎小伙伴在留言区写下评论! 总结 今天我们用通俗易懂的文字描述了ReentrantReadWriteLock读写锁。喜欢的请点赞加评论哦!点关注,不迷路,我是叫练【公众号】,边叫边练。期待我们下次再见!

优秀的个人博客,低调大师

Kafka 原理以及分区分配策略剖析

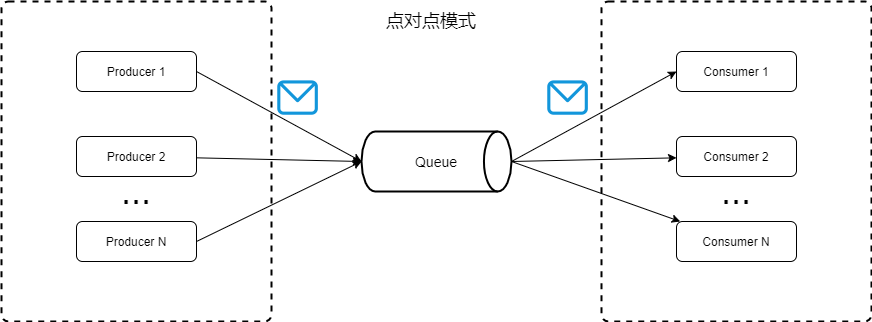
一、简介 Apache Kafka 是一个分布式的流处理平台(分布式的基于发布/订阅模式的消息队列【Message Queue】)。 流处理平台有以下3个特性: 可以让你发布和订阅流式的记录。这一方面与消息队列或者企业消息系统类似。 可以储存流式的记录,并且有较好的容错性。 可以在流式记录产生时就进行处理。 1.1 消息队列的两种模式 1.1.1 点对点模式 生产者将消息发送到queue中,然后消费者从queue中取出并且消费消息。消息被消费以后,queue中不再存储,所以消费者不可能消费到已经被消费的消息。Queue支持存在多个消费者,但是对一个消息而言,只能被一个消费者消费。 1.1.2 发布/订阅模式 生产者将消息发布到topic中,同时可以有多个消费者订阅该消息。和点对点方式不同,发布到topic的消息会被所有订阅者消费。 1.2 Kafka 适合什么样的场景 它可以用于两大类别的应用: 构造实时流数据管道,它可以在系统或应用之间可靠地获取数据。(相当于message queue)。 构建实时流式应用程序,对这些流数据进行转换或者影响。(就是流处理,通过kafka stream topic和topic之间内部进行变化)。 为了理解Kafka是如何做到以上所说的功能,从下面开始,我们将深入探索Kafka的特性。 首先是一些概念: Kafka作为一个集群,运行在一台或者多台服务器上。 Kafka 通过 topic 对存储的流数据进行分类。 每条记录中包含一个key,一个value和一个timestamp(时间戳)。 1.3 主题和分区 Kafka的消息通过主题(Topic)进行分类,就好比是数据库的表,或者是文件系统里的文件夹。主题可以被分为若干个分区(Partition),一个分区就是一个提交日志。消息以追加的方式写入分区,然后以先进先出的顺序读取。注意,由于一个主题一般包含几个分区,因此无法在整个主题范围内保证消息的顺序,但可以保证消息在单个分区内的顺序。主题是逻辑上的概念,在物理上,一个主题是横跨多个服务器的。 Kafka 集群保留所有发布的记录(无论他们是否已被消费),并通过一个可配置的参数——保留期限来控制(可以同时配置时间和消息大小,以较小的那个为准)。举个例子, 如果保留策略设置为2天,一条记录发布后两天内,可以随时被消费,两天过后这条记录会被抛弃并释放磁盘空间。 有时候我们需要增加分区的数量,比如为了扩展主题的容量、降低单个分区的吞吐量或者要在单个消费者组内运行更多的消费者(因为一个分区只能由消费者组里的一个消费者读取)。从消费者的角度来看,基于键的主题添加分区是很困难的,因为分区数量改变,键到分区的映射也会变化,所以对于基于键的主题来说,建议在一开始就设置好分区,避免以后对其进行调整。 (注意:不能减少分区的数量,因为如果删除了分区,分区里面的数据也一并删除了,导致数据不一致。如果一定要减少分区的数量,只能删除topic重建) 1.4 生产者和消费者 生产者(发布者)创建消息,一般情况下,一个消息会被发布到一个特定的主题上。生产者在默认情况下把消息均衡的分布到主题的所有分区上,而并不关心特定消息会被写入哪个分区。不过,生产者也可以把消息直接写到指定的分区。这通常通过消息键和分区器来实现,分区器为键生成一个散列值,并将其映射到指定的分区上。生产者也可以自定义分区器,根据不同的业务规则将消息映射到分区。 消费者(订阅者)读取消息,消费者可以订阅一个或者多个主题,并按照消息生成的顺序读取它们。消费者通过检查消息的偏移量来区分已经读取过的消息。偏移量是一种元数据,它是一个不断递增的整数值,在创建消息时,kafka会把它添加到消息里。在给定的分区里,每个消息的偏移量都是唯一的。消费者把每个分区最后读取的消息偏移量保存在zookeeper或者kafka上,如果消费者关闭或者重启,它的读取状态不会丢失。 消费者是消费者组的一部分,也就是说,会有一个或者多个消费共同读取一个主题。消费者组保证每个分区只能被同一个组内的一个消费者使用。如果一个消费者失效,群组里的其他消费者可以接管失效消费者的工作。 1.5 broker和集群 broker:一个独立的kafka服务器被称为broker。broker接收来自生产者的消息,为消息设置偏移量,并提交消息到磁盘保存。broker为消费者提供服务,对读取分区的请求作出相应,返回已经提交到磁盘上的消息。 集群:交给同一个zookeeper集群来管理的broker节点就组成了kafka的集群。 broker是集群的组成部分,每个集群都有一个broker同时充当集群控制器的角色。控制器负责管理工作,包括将分区分配给broker和监控broker。在broker中,一个分区从属于一个broker,该broker被称为分区的首领。一个分区可以分配给多个broker(Topic设置了多个副本的时候),这时会发生分区复制。如下图: broker如何处理请求:broker会在它所监听的每个端口上运行一个Acceptor线程,这个线程会创建一个连接并把它交给Processor线程去处理。Processor线程(也叫网络线程)的数量是可配的,Processor线程负责从客户端获取请求信息,把它们放进请求队列,然后从响应队列获取响应信息,并发送给客户端。如下图所示: 生产请求和获取请求都必须发送给分区的首领副本(分区Leader)。如果broker收到一个针对特定分区的请求,而该分区的首领在另外一个broker上,那么发送请求的客户端会收到一个“非分区首领”的错误响应。Kafka客户端要自己负责把生产请求和获取请求发送到正确的broker上。 客户端如何知道该往哪里发送请求呢?客户端使用了另外一种请求类型——元数据请求。这种请求包含了客户端感兴趣的主题列表,服务器的响应消息里指明了这些主题所包含的分区、每个分区都有哪些副本,以及哪个副本是首领。元数据请求可以发给任意一个broker,因为所有的broker都缓存了这些信息。客户端缓存这些元数据,并且会定时从broker请求刷新这些信息。此外如果客户端收到“非首领”错误,它会在尝试重新发送请求之前,先刷新元数据。 1.6 Kafka 基础架构 二、Kafka架构深入 2.1 Kafka工作流程及文件存储机制 2.1.1 工作流程 Kafka中消息是以topic进行分类的,生产者生产消息,消费者消费消息,都是面向topic的。 Topic是逻辑上的概念,而partition(分区)是物理上的概念,每个partition对应于一个log文件,该log文件中存储的就是producer生产的数据。Producer生产的数据会被不断追加到该log文件末端,且每条数据都有自己的offset。消费者组中的每个消费者,都会实时记录自己消费到哪个offset,以便出错恢复时,从上次的位置继续消费。 2.1.2 文件存储机制 由于生产者生产的消息会不断追加到log文件末尾,为防止log文件过大导致数据定位效率低下,Kafka采取了分片和索引的机制,将每个partition分为多个segment。(由log.segment.bytes决定,控制每个segment的大小,也可通过log.segment.ms控制,指定多长时间后日志片段会被关闭)每个segment对应两个文件——“.index”文件和“.log”文件。这些文件位于一个文件夹下,该文件夹的命名规则为:topic名称+分区序号。例如:bing这个topic有3个分区,则其对应的文件夹为:bing-0、bing-1和bing-2。 索引文件和日志文件命名规则:每个 LogSegment 都有一个基准偏移量,用来表示当前 LogSegment 中第一条消息的 offset。偏移量是一个 64位的长整形数,固定是20位数字,长度未达到,用 0 进行填补。如下图所示: index和log文件以当前segment的第一条消息的offset命名。index文件记录的是数据文件的offset和对应的物理位置,正是有了这个index文件,才能对任一数据写入和查看拥有O(1)的复杂度,index文件的粒度可以通过参数log.index.interval.bytes来控制,默认是是每过4096字节记录一条index。下图为index文件和log文件的结构示意图: 查找message的流程(比如要查找offset为170417的message): 首先用二分查找确定它是在哪个Segment文件中,其中0000000000000000000.index为最开始的文件,第二个文件为0000000000000170410.index(起始偏移为170410+1 = 170411),而第三个文件为0000000000000239430.index(起始偏移为239430+1 = 239431)。所以这个offset = 170417就落在第二个文件中。其他后续文件可以依此类推,以起始偏移量命名并排列这些文件,然后根据二分查找法就可以快速定位到具体文件位置。 用该offset减去索引文件的编号,即170417 - 170410 = 7,也用二分查找法找到索引文件中等于或者小于7的最大的那个编号。可以看出我们能够找到[4,476]这组数据,476即offset=170410 + 4 = 170414的消息在log文件中的偏移量。 打开数据文件(0000000000000170410.log),从位置为476的那个地方开始顺序扫描直到找到offset为170417的那条Message。 2.1.3 数据过期机制 当日志片段大小达到log.segment.bytes指定的上限(默认是1GB)或者日志片段打开时长达到log.segment.ms时,当前日志片段就会被关闭,一个新的日志片段被打开。如果一个日志片段被关闭,就开始等待过期。当前正在写入的片段叫做活跃片段,活跃片段永远不会被删除,所以如果你要保留数据1天,但是片段包含5天的数据,那么这些数据就会被保留5天,因为片段被关闭之前,这些数据无法被删除。 2.2 Kafka生产者 2.2.1 分区策略 多Partition分布式存储,利于集群数据的均衡。 并发读写,加快读写速度。 加快数据恢复的速率:当某台机器挂了,每个Topic仅需恢复一部分的数据,多机器并发。 分区的原则 指明partition的情况下,使用指定的partition; 没有指明partition,但是有key的情况下,将key的hash值与topic的partition数进行取余得到partition值; 既没有指定partition,也没有key的情况下,第一次调用时随机生成一个整数(后面每次调用在这个整数上自增),将这个值与topic可用的partition数取余得到partition值,也就是常说的round-robin算法。 public int partition(String topic, Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster) { List<PartitionInfo> partitions = cluster.partitionsForTopic(topic); int numPartitions = partitions.size(); if (keyBytes == null) { //key为空时,获取一个自增的计数,然后对分区做取模得到分区编号 int nextValue = nextValue(topic); List<PartitionInfo> availablePartitions = cluster.availablePartitionsForTopic(topic); if (availablePartitions.size() > 0) { int part = Utils.toPositive(nextValue) % availablePartitions.size(); return availablePartitions.get(part).partition(); } else { // no partitions are available, give a non-available partition return Utils.toPositive(nextValue) % numPartitions; } } else { // hash the keyBytes to choose a partition // key不为空时,通过key的hash对分区取模(疑问:为什么这里不像上面那样,使用availablePartitions呢?) // 根据《Kafka权威指南》Page45理解:为了保证相同的键,总是能路由到固定的分区,如果使用可用分区,那么因为分区数变化,会导致相同的key,路由到不同分区 // 所以如果要使用key来映射分区,最好在创建主题的时候就把分区规划好 return Utils.toPositive(Utils.murmur2(keyBytes)) % numPartitions; } } private int nextValue(String topic) { //为每个topic维护了一个AtomicInteger对象,每次获取时+1 AtomicInteger counter = topicCounterMap.get(topic); if (null == counter) { counter = new AtomicInteger(ThreadLocalRandom.current().nextInt()); AtomicInteger currentCounter = topicCounterMap.putIfAbsent(topic, counter); if (currentCounter != null) { counter = currentCounter; } } return counter.getAndIncrement(); } 2.2.2 数据可靠性保证 kafka提供了哪些方面的保证 kafka可以保证分区消息的顺序。如果使用同一个生产者往同一个分区写入消息,而且消息B在消息A之后写入,那么kafka可以保证消息B的偏移量比消息A的偏移量大,而且消费者会先读取到消息A再读取消息B。 只有当消息被写入分区的所有副本时,它才被认为是“已提交”的。生产者可以选择接收不同类型的确认,比如在消息被完全提交时的确认、在消息被写入分区首领时的确认,或者在消息被发送到网络时的确认。 只要还有一个副本是活跃的,那么已经提交的信息就不会丢失。 消费者只能读取到已经提交的消息。 复制 Kafka的复制机制和分区的多副本架构是kafka可靠性保证的核心。把消息写入多个副本可以使kafka在发生奔溃时仍能保证消息的持久性。 kafka的topic被分成多个分区,分区是基本的数据块。每个分区可以有多个副本,其中一个是首领。所有事件都是发给首领副本,或者直接从首领副本读取事件。其他副本只需要与首领副本保持同步,并及时复制最新的事件。 Leader维护了一个动态的in-sync replica set(ISR),意为和leader保持同步的follower集合。当ISR中的follower完成数据同步后,leader就会发送ack。如果follower长时间未向leader同步数据,则该follower将被踢出ISR,该时间阈值由replica.lag.time.max.ms参数设定。Leader不可用时,将会从ISR中选举新的leader。满足以下条件才能被认为是同步的: 与zookeeper之间有一个活跃的会话,也就是说,它在过去的6s(可配置)内向zookeeper发送过心跳。 在过去的10s(可配置)内从首领那里获取过最新的数据。 影响Kafka消息存储可靠性的配置 ack应答机制 对于某些不太重要的数据,对数据的可靠性要求不是很高,能够容忍数据的少量丢失,所以没有必要等ISR中的follower全部接收成功。所以Kafka提供了三种可靠性级别,用户可以根据对可靠性和延迟的要求进行权衡。acks: 0:producer不等待broker的ack,这一操作提供了一个最低的延迟,broker一接收到还没写入磁盘就已经返回,当broker故障时可能丢失数据; 1:producer等待leader的ack,partition的leader落盘成功后返回ack,如果在follower同步成功之前leader故障,那么将会丢失数据; -1(all):producer等待broker的ack,partition的leader和ISR里的follower全部落盘成功后才返回ack。但是如果在follower同步完成后,broker发送ack之前,leader发生故障,那么会造成重复数据。(极端情况下也有可能丢数据:ISR中只有一个Leader时,相当于1的情况)。 消费一致性保证 (1)follower故障 follower发生故障后会被临时踢出ISR,待该follower恢复后,follower会读取本地磁盘记录的上次的HW,并将log文件高于HW的部分截取掉,从HW开始向leader进行同步。 等该follower的LEO大于等于该Partition的HW,即follower追上leader之后,就可以重新加入ISR了。 (2)leader故障 leader发生故障后,会从ISR中选出一个新的leader,之后为了保证多个副本之间的数据一致性,其余的follower会先将各自的log文件高于HW的部分截掉,然后从新的leader同步数据。 注意:这只能保证副本之间的数据一致性,并不能保证数据不丢失或者不重复。 2.2.3 消息发送流程 Kafka 的producer 发送消息采用的是异步发送的方式。在消息发送过程中,涉及到了两个线程——main线程和sender线程,以及一个线程共享变量——RecordAccumulator。main线程将消息发送给RecordAccumulator,sender线程不断从RecordAccumulator中拉取消息发送到Kafka broker。 为了提高效率,消息被分批次写入kafka。批次就是一组消息,这些消息属于同一个主题和分区。(如果每一个消息都单独穿行于网络,会导致大量的网络开销,把消息分成批次传输可以减少网络开销。不过要在时间延迟和吞吐量之间做出权衡:批次越大,单位时间内处理的消息就越多,单个消息的传输时间就越长)。批次数据会被压缩,这样可以提升数据的传输和存储能力,但要做更多的计算处理。 相关参数: batch.size:只有数据积累到batch.size后,sender才会发送数据。(单位:字节,注意:不是消息个数)。 linger.ms:如果数据迟迟未达到batch.size,sender等待linger.ms之后也会发送数据。(单位:毫秒)。 client.id:该参数可以是任意字符串,服务器会用它来识别消息的来源,还可用用在日志和配额指标里。 max.in.flight.requests.per.connection:该参数指定了生产者在收到服务器响应之前可以发送多少个消息。它的值越高,就会占用越多的内存,不过也会提升吞吐量。把它设置为1可以保证消息时按发送的顺序写入服务器的,即使发生了重试。 2.3 Kafka消费者 2.3.1 消费方式 consumer采用pull(拉)的模式从broker中读取数据。 push(推)模式很难适应消费速率不同的消费者,因为消息发送速率是由broker决定的。它的目标是尽可能以最快的速度传递消息,但是这样容易造成consumer来不及处理消息,典型的表现就是拒绝服务以及网络拥塞。而pull模式可以根据consumer的消费能力以适当的速率消费消息。 pull模式的不足之处是,如果kafka没有数据,消费者可能会陷入循环中,一直返回空数据。针对这一点,kafka的消费者在消费数据时会传入一个时长参数timeout,如果当前没有数据可消费,consumer会等待一段时间后再返回。 2.3.2 分区分配策略 一个consumer group中有多个consumer,一个topic有多个partition,所以必然会涉及到partition的分配问题,即确定哪个partition由哪个consumer来消费。Kafka提供了3种消费者分区分配策略:RangeAssigor、RoundRobinAssignor、StickyAssignor。 PartitionAssignor接口用于用户定义实现分区分配算法,以实现Consumer之间的分区分配。消费组的成员订阅它们感兴趣的Topic并将这种订阅关系传递给作为订阅组协调者的Broker。协调者选择其中的一个消费者来执行这个消费组的分区分配并将分配结果转发给消费组内所有的消费者。Kafka默认采用RangeAssignor的分配算法。 2.3.2.1 RangeAssignor RangeAssignor对每个Topic进行独立的分区分配。对于每一个Topic,首先对分区按照分区ID进行排序,然后订阅这个Topic的消费组的消费者再进行排序,之后尽量均衡的将分区分配给消费者。这里只能是尽量均衡,因为分区数可能无法被消费者数量整除,那么有一些消费者就会多分配到一些分区。分配示意图如下: 分区分配的算法如下: @Override public Map<String, List<TopicPartition>> assign(Map<String, Integer> partitionsPerTopic, Map<String, Subscription> subscriptions) { Map<String, List<String>> consumersPerTopic = consumersPerTopic(subscriptions); Map<String, List<TopicPartition>> assignment = new HashMap<>(); for (String memberId : subscriptions.keySet()) assignment.put(memberId, new ArrayList<TopicPartition>()); //for循环对订阅的多个topic分别进行处理 for (Map.Entry<String, List<String>> topicEntry : consumersPerTopic.entrySet()) { String topic = topicEntry.getKey(); List<String> consumersForTopic = topicEntry.getValue(); Integer numPartitionsForTopic = partitionsPerTopic.get(topic); if (numPartitionsForTopic == null) continue; //对消费者进行排序 Collections.sort(consumersForTopic); //计算平均每个消费者分配的分区数 int numPartitionsPerConsumer = numPartitionsForTopic / consumersForTopic.size(); //计算平均分配后多出的分区数 int consumersWithExtraPartition = numPartitionsForTopic % consumersForTopic.size(); List<TopicPartition> partitions = AbstractPartitionAssignor.partitions(topic, numPartitionsForTopic); for (int i = 0, n = consumersForTopic.size(); i < n; i++) { //计算第i个消费者,分配分区的起始位置 int start = numPartitionsPerConsumer * i + Math.min(i, consumersWithExtraPartition); //计算第i个消费者,分配到的分区数量 int length = numPartitionsPerConsumer + (i + 1 > consumersWithExtraPartition ? 0 : 1); assignment.get(consumersForTopic.get(i)).addAll(partitions.subList(start, start + length)); } } return assignment; } 这种分配方式明显的一个问题是随着消费者订阅的Topic的数量的增加,不均衡的问题会越来越严重,比如上图中4个分区3个消费者的场景,C0会多分配一个分区。如果此时再订阅一个分区数为4的Topic,那么C0又会比C1、C2多分配一个分区,这样C0总共就比C1、C2多分配两个分区了,而且随着Topic的增加,这个情况会越来越严重。分配结果: 订阅2个Topic,每个Topic4个分区,共3个Consumer C0:[T0P0,T0P1,T1P0,T1P1] C1:[T0P2,T1P2] C2:[T0P3,T1P3] 2.3.2.2 RoundRobinAssignor RoundRobinAssignor的分配策略是将消费组内订阅的所有Topic的分区及所有消费者进行排序后尽量均衡的分配(RangeAssignor是针对单个Topic的分区进行排序分配的)。如果消费组内,消费者订阅的Topic列表是相同的(每个消费者都订阅了相同的Topic),那么分配结果是尽量均衡的(消费者之间分配到的分区数的差值不会超过1)。如果订阅的Topic列表是不同的,那么分配结果是不保证“尽量均衡”的,因为某些消费者不参与一些Topic的分配。 以上两个topic的情况,相比于之前RangeAssignor的分配策略,可以使分区分配的更均衡。不过考虑这种情况,假设有三个消费者分别为C0、C1、C2,有3个Topic T0、T1、T2,分别拥有1、2、3个分区,并且C0订阅T0,C1订阅T0和T1,C2订阅T0、T1、T2,那么RoundRobinAssignor的分配结果如下: 看上去分配已经尽量的保证均衡了,不过可以发现C2承担了4个分区的消费而C1订阅了T1,是不是把T1P1交给C1消费能更加的均衡呢? 2.3.2.3 StickyAssignor StickyAssignor分区分配算法,目的是在执行一次新的分配时,能在上一次分配的结果的基础上,尽量少的调整分区分配的变动,节省因分区分配变化带来的开销。Sticky是“粘性的”,可以理解为分配结果是带“粘性的”——每一次分配变更相对上一次分配做最少的变动。其目标有两点: 分区的分配尽量的均衡。 每一次重分配的结果尽量与上一次分配结果保持一致。 当这两个目标发生冲突时,优先保证第一个目标。第一个目标是每个分配算法都尽量尝试去完成的,而第二个目标才真正体现出StickyAssignor特性的。 StickyAssignor算法比较复杂,下面举例来说明分配的效果(对比RoundRobinAssignor),前提条件: 有4个Topic:T0、T1、T2、T3,每个Topic有2个分区。 有3个Consumer:C0、C1、C2,所有Consumer都订阅了这4个分区。 上面红色的箭头代表的是有变动的分区分配,可以看出,StickyAssignor的分配策略,变动较小。 2.3.3 offset的维护 由于Consumer在消费过程中可能会出现断电宕机等故障,Consumer恢复后,需要从故障前的位置继续消费,所以Consumer需要实时记录自己消费到哪个位置,以便故障恢复后继续消费。Kafka0.9版本之前,Consumer默认将offset保存在zookeeper中,从0.9版本开始,Consumer默认将offset保存在Kafka一个内置的名字叫_consumeroffsets的topic中。默认是无法读取的,可以通过设置consumer.properties中的exclude.internal.topics=false来读取。 2.3.4 kafka高效读写数据(了解) 顺序写磁盘 Kafka 的 producer生产数据,要写入到log文件中,写的过程是一直追加到文件末端,为顺序写。数据表明,同样的磁盘,顺序写能到600M/s,而随机写只有100K/s。这与磁盘的机械结构有关,顺序写之所以快,是因为其省去了大量磁头寻址的时间。 零拷贝技术 零拷贝主要的任务就是避免CPU将数据从一块存储拷贝到另外一块存储,主要就是利用各种零拷贝技术,避免让CPU做大量的数据拷贝任务,减少不必要的拷贝,或者让别的组件来做这一类简单的数据传输任务,让CPU解脱出来专注于别的任务。这样就可以让系统资源的利用更加有效。 参考文献 Kafka中文文档 [Kafka系列]之指定了一个offset,怎么查找到对应的消息? 尚硅谷 Kafka 教程( Kafka 框架快速入门) Kafka分区分配策略分析——重点:StickyAssignor Kafka 日志存储 浅析Linux中的零拷贝技术 《Kafka权威指南》 作者:Li Xiaobing,来自vivo互联网技术团队

优秀的个人博客,低调大师

MyBatis内置DataSource连接池实现原理

前言 MyBatis是一个流行的ORM框架,它简单易用,支持自定义SQL、存储过程以及高级映射。MyBatis免除了几乎所有的JDBC代码以及设置参数和获取结果集的工作。 作为一款优秀的持久层框架,连接池是必不可少的。本文将分析MyBatis内置的数据源是如何实现连接池功能的(源码基于MyBatis3.4.5)。 JDBC对数据库的操作 回忆一下,我们用原生的JDBC来操作数据库的一般流程: public class JDBCExample { // JDBC driver name and database URL / credentials static final String JDBC_DRIVER = "com.mysql.jdbc.Driver"; static final String DB_URL = "jdbc:mysql://localhost/EMP"; static final String USER = "username"; static final String PASS = "password"; public List<User> queryUsers() { Connection conn = null; Statement stmt = null; ResultSet rs = null; List<User> users = new ArrayList<>(); try { // STEP 1: 注册driver Class.forName(JDBC_DRIVER); // STEP 2: 打开连接 conn = DriverManager.getConnection(DB_URL,USER,PASS); // STEP 3: 执行query stmt = conn.createStatement(); String sql = "SELECT ID, NAME, AGE FROM USER"; rs = stmt.executeQuery(sql); // STEP 4: 获取变量 while(rs.next()) { User user = new User(); user.setId(rs.getInt("ID")); user.setAge(rs.getInt("AGE")); user.setName(rs.getString("NAME")); users.add(user); } return users; } catch(SQLException | ClassNotFoundException e) { e.printStackTrace(); } finally { // STEP 5: 关闭资源 try { if (rs != null) rs.close(); if (stmt != null) stmt.close(); if (conn != null) conn.close(); } catch(SQLException se) { se.printStackTrace(); } } return users; } } 主要的步骤包括: 加载数据库驱动 获取数据库连接 执行SQL语句 从ResultSet获取结果,给Entity赋值 关闭数据库连接等资源 不难发现,当中包含了大段的重复模版代码。而我们所关心的业务逻辑,只有寥寥几行。而且,每执行一次数据库操作都重新建立一个新的连接,用完之后关闭的做法,性能非常低。因为每次打开关闭连接,都会涉及到TCP的三次握手与四次挥手,以及数据库的验证操作。为了优化第二个问题,出现了数据库连接池。 数据库连接池 不管是Connection Pool,Thread Pool还是Channel Pool,所有池的思想都是一致的: 维护一个资源集合 消费者可以从集合中获取资源 消费者使用完资源后,将之放回池中 当然其中肯定会涉及到一些池的大小的维护,池满之后的处理等细节操作。接下来我们来分析一下MyBatis中的连接池是如何实现的。 MyBatis中的连接池实现 如果我们使用MyBatis内置的数据源的化,一般会在XML配置文件里面这样配置: <dataSource type="POOLED"> <property name="driver" value="${driver}"/> <property name="url" value="${url}"/> <property name="username" value="${username}"/> <property name="password" value="${password}"/> </dataSource> 其中dataSource的type配置为POOLED,则MyBatis会使用org.apache.ibatis.datasource.pooled.PooledDataSource作为数据源。下面是PooledDataSource的类变量: // PooledDataSource public class PooledDataSource implements DataSource { // 用来维护连接池的状态 private final PoolState state = new PoolState(this); // 这里用了组合模式,像driver,url,username,password // 之类的配置变量信息存在UnpooledDataSource中 private final UnpooledDataSource dataSource; // 连接池的信息,可定制化配置 protected int poolMaximumActiveConnections = 10; protected int poolMaximumIdleConnections = 5; protected int poolMaximumCheckoutTime = 20000; protected int poolTimeToWait = 20000; protected String poolPingQuery = "NO PING QUERY SET"; protected boolean poolPingEnabled = false; protected int poolPingConnectionsNotUsedFor = 0; private int expectedConnectionTypeCode; } 注意,PooledDataSource将一部分配置信息放在了UnpooledDataSource中,并用了一个PoolState来维护连接池的状态: // UnpooledDataSource // PooledDataSource可以看成是由UnpooledDataSource扩展而来的,所以复用了一些变量 public class UnpooledDataSource implements DataSource { // 包含了如username,password的】等配置信息 private ClassLoader driverClassLoader; private Properties driverProperties; private boolean driverInitialized; private String driver; private String url; private String username; private String password; private boolean autoCommit; private Integer defaultTransactionIsolationLevel; } // PoolState public class PoolState { protected PooledDataSource dataSource; // 空闲连接列表 protected final List<PooledConnection> idleConnections = new ArrayList<PooledConnection>(); // 活跃连接列表 protected final List<PooledConnection> activeConnections = new ArrayList<PooledConnection>(); // 从连接池中获取连接的次数 protected long requestCount = 0; // 请求连接总耗时(ms) protected long accumulatedRequestTime = 0; // 连接执行时间总耗时 protected long accumulatedCheckoutTime = 0; // 执行时间超时的连接数 protected long claimedOverdueConnectionCount = 0; // 总共超时时间 protected long accumulatedCheckoutTimeOfOverdueConnections = 0; // 总共等待时间 protected long accumulatedWaitTime = 0; // 等待次数 protected long hadToWaitCount = 0; // 无效连接数 protected long badConnectionCount = 0; } 获取连接 好了,对类的成员变量有了一个直观的概念之后,我们分析来看连接池是如何实现的。找到获取连接的主方法popConnection(): // PooledDataSource private PooledConnection popConnection(String username, String password) throws SQLException { boolean countedWait = false; PooledConnection conn = null; long t = System.currentTimeMillis(); int localBadConnectionCount = 0; // 需要不断尝试获取连接,所以放在循环里 while (conn == null) { // 为线程安全,加synchronized锁 synchronized (state) { // 检查空间连接列表是不是为空 if (!state.idleConnections.isEmpty()) { // 如果有空闲连接可用,那么直接获取列表第一个连接并将之从列表中删除 conn = state.idleConnections.remove(0); } else { // 无空闲连接可用时,走到这里 if (state.activeConnections.size() < poolMaximumActiveConnections) { // 如果活跃连接数未超出限制,则新建连接 // dataSource.getConnection()的逻辑是初始化driver,从DriverManager获取连接, // 设置autoCommit和IsolationLevel,比较简单,就不分析了 conn = new PooledConnection(dataSource.getConnection(), this); } else { // 连接池已满,取出运行时间最长的连接 // 列表中的连接是按照运行时间排序的,所以第一个元素就是运行时间最长的 PooledConnection oldestActiveConnection = state.activeConnections.get(0); long longestCheckoutTime = oldestActiveConnection.getCheckoutTime(); // 如果运行时间超过超时时间 if (longestCheckoutTime > poolMaximumCheckoutTime) { // 更新一些统计字段 state.claimedOverdueConnectionCount++; state.accumulatedCheckoutTimeOfOverdueConnections += longestCheckoutTime; state.accumulatedCheckoutTime += longestCheckoutTime; // 将超时连接移出 活跃连接列表 state.activeConnections.remove(oldestActiveConnection); // 如果未设置自动提交,则进行回滚操作 if (!oldestActiveConnection.getRealConnection().getAutoCommit()) { oldestActiveConnection.getRealConnection().rollback(); } // 创建一个新的连接,不过需要复用oldestActiveConnection的realConnection, // 实际上并没有创建新的数据库连接 conn = new PooledConnection(oldestActiveConnection.getRealConnection(), this); // 复用oldestActiveConnection 的一些信息,将oldestActiveConnection设置为无效 conn.setCreatedTimestamp(oldestActiveConnection.getCreatedTimestamp()); conn.setLastUsedTimestamp(oldestActiveConnection.getLastUsedTimestamp()); oldestActiveConnection.invalidate(); } else { // 未超时 try { // 记录统计信息 if (!countedWait) { state.hadToWaitCount++; countedWait = true; } long wt = System.currentTimeMillis(); // 调用Object.wait()方法进入等待状态 state.wait(poolTimeToWait); // 记录统计信息 state.accumulatedWaitTime += System.currentTimeMillis() - wt; } catch (InterruptedException e) { break; } } } } if (conn != null) { // 检测连接是否有效,主要会检测PooledConnection.valid字段, // 以及执行SQL ping的语句查看数据库状态,这里不做分析 if (conn.isValid()) { // 如果没有设置自动回滚,执行回滚操作 if (!conn.getRealConnection().getAutoCommit()) { conn.getRealConnection().rollback(); } // 更新一些统计字段 conn.setConnectionTypeCode(assembleConnectionTypeCode(dataSource.getUrl(), username, password)); conn.setCheckoutTimestamp(System.currentTimeMillis()); conn.setLastUsedTimestamp(System.currentTimeMillis()); state.activeConnections.add(conn); state.requestCount++; state.accumulatedRequestTime += System.currentTimeMillis() - t; } else { // 更新无效连接相关的统计字段 state.badConnectionCount++; localBadConnectionCount++; conn = null; if (localBadConnectionCount > (poolMaximumIdleConnections + 3)) { throw new SQLException("PooledDataSource: Could not get a good connection to the database."); } } } } } // 如果没有获取到连接,直接抛出异常 if (conn == null) { throw new SQLException("PooledDataSource: Unknown severe error condition. The connection pool returned a null connection."); } return conn; } 以上就是获取连接的主要逻辑,大致如下: 这里有个疑问,我们外部获取连接用的都是getConnection()方法,而不是popConnection()方法。那么让我们来看看getConnection()是如何实现的: public Connection getConnection() throws SQLException { return popConnection(dataSource.getUsername(), dataSource.getPassword()).getProxyConnection(); } 除了调用popConnection()方法之外,还调用了getProxyConnection(),看名字是包装了一层代理。为什么要这样做呢?这就需要看释放连接的逻辑了。 释放连接 MyBatis用代理模式(如果对此模式不了解的,推荐看一下这篇文章),将数据库连接包装在PooledConnection对象之中: // PooledConnection class PooledConnection implements InvocationHandler { // 关闭连接的方法close(),在代理中拦截此方法来做释放连接的操作 private static final String CLOSE = "close"; private static final Class<?>[] IFACES = new Class<?>[] { Connection.class }; private final int hashCode; // 数据源对象,这里即PooledDataSource private final PooledDataSource dataSource; // 真正的从DriverManager中获取出来的连接 private final Connection realConnection; // realConnection的代理对象 private final Connection proxyConnection; // 一些参数 private long checkoutTimestamp; private long createdTimestamp; private long lastUsedTimestamp; private int connectionTypeCode; private boolean valid; // 构造方法 public PooledConnection(Connection connection, PooledDataSource dataSource) { this.hashCode = connection.hashCode(); this.realConnection = connection; this.dataSource = dataSource; this.createdTimestamp = System.currentTimeMillis(); this.lastUsedTimestamp = System.currentTimeMillis(); this.valid = true; // proxyConnection使用了JDK的动态代理,并将自己(this)作为了InvocationHandler this.proxyConnection = (Connection) Proxy.newProxyInstance(Connection.class.getClassLoader(), IFACES, this); } public Connection getProxyConnection() { return proxyConnection; } } 注意最后的getProxyConnection()方法,发现它果然返回了一个Connection的代理对象。同时,由于PooledConnection实现了InvocationHandler接口,当外部调用代理对象方法时,都会转为调用InvocationHandler.invoke()方法。于是下面主要看invoke()方法是如何实现的: // PooledConnection public Object invoke(Object proxy, Method method, Object[] args) throws Throwable { String methodName = method.getName(); // 如果调用了close()方法,即调用方需要关闭连接 if (CLOSE.hashCode() == methodName.hashCode() && CLOSE.equals(methodName)) { // 转为调用pushConnection()方法 dataSource.pushConnection(this); return null; } else { try { // 如果不是调用的close()方法,则调用realConnection的同名方法 return method.invoke(realConnection, args); } catch (Throwable t) { throw ExceptionUtil.unwrapThrowable(t); } } } 看到这里,出现了闭环。调用方使用完连接之后,如果调用了close()方法,会被上述方法拦截,转为调用dataSource.pushConnection(this)方法,猜测这个方法是用来将连接放回连接池中的。我们来一探究竟: // PooledDataSource protected void pushConnection(PooledConnection conn) throws SQLException { // 与popConnection方法一样,同样也在state上加锁,用来做线程间协作 synchronized (state) { // 从活跃连接中移除此连接 state.activeConnections.remove(conn); if (conn.isValid()) { // 空闲连接未满 if (state.idleConnections.size() < poolMaximumIdleConnections && conn.getConnectionTypeCode() == expectedConnectionTypeCode) { state.accumulatedCheckoutTime += conn.getCheckoutTime(); // 若未设置autoCommit,执行回滚 if (!conn.getRealConnection().getAutoCommit()) { conn.getRealConnection().rollback(); } // 创建新的PooledConnection,并加入到idleConnections列表的末尾 PooledConnection newConn = new PooledConnection(conn.getRealConnection(), this); state.idleConnections.add(newConn); // 复用原连接的时间信息 newConn.setCreatedTimestamp(conn.getCreatedTimestamp()); newConn.setLastUsedTimestamp(conn.getLastUsedTimestamp()); // 将原连接置为无效状态 conn.invalidate(); // 唤醒等待连接的线程 state.notifyAll(); } else { // 空闲连接集合已满 state.accumulatedCheckoutTime += conn.getCheckoutTime(); // 回滚未提交的事务 if (!conn.getRealConnection().getAutoCommit()) { conn.getRealConnection().rollback(); } // 直接将数据库连接关闭 conn.getRealConnection().close(); conn.invalidate(); } } else { state.badConnectionCount++; } } } pushConnection()逻辑比较简单,主要做了两件事情: 将连接从活跃连接列表移除 如果空闲列表已满,则直接将此连接关闭;如果空闲列表未满,则新建PooledConnection并复用Connection对象(所以并没有新的TCP握手挥手的开销),并将此连接放入空闲列表。 到此,PooledDataSource的获取连接与释放连接的操作,在连接池中形成了一个闭环。 总结 本文分析了MyBatis内置的连接池的实现方式。当调用方拿连接时,首先会从池中获取。当调用方关闭连接时,MyBatis使用了代理模式拦截此方法,将该连接放回到池中。

优秀的个人博客,低调大师

dubbo系列之@Service注解解析原理(四)

欢迎关注公众号【sharedCode】致力于主流中间件的源码分析, 可以直接与我联系 前言 前面几篇文章,讲的是调试环境搭建,配置解析读取,本文讲的是dubbo如何解析@service注解的,了解这些东西对于真正使用dubbo来说,没有直接的东西,但是这个是我后面要写的dubbo核心功能源码解析的前提,前后连贯,这样才能了解的更加清晰一点。 解析入口 @service注解解析入口有两个地方,二者是二选一的 第一种 DubboAutoConfiguration 这个自动配置类中 @ConditionalOnMissingBean @Bean(name = ReferenceAnnotationBeanPostProcessor.BEAN_NAME) public ReferenceAnnotationBeanPostProcessor referenceAnnotationBeanPostProcessor() { return new ReferenceAnnotationBeanPostProcessor(); } @ConditionalOnProperty(name = BASE_PACKAGES_PROPERTY_NAME) @ConditionalOnClass(RelaxedPropertyResolver.class) @Bean public ServiceAnnotationBeanPostProcessor serviceAnnotationBeanPostProcessor(Environment environment) { RelaxedPropertyResolver resolver = new RelaxedPropertyResolver(environment); Set<String> packagesToScan = resolver.getProperty(BASE_PACKAGES_PROPERTY_NAME, Set.class, emptySet()); return new ServiceAnnotationBeanPostProcessor(packagesToScan); } 上面两个配置的作用,在上文中已经讲解过,此处不再赘述 第二种 @SpringBootApplication @DubboComponentScan("com.dubbo.consumer.service") public class ConsumerApplication { public static void main(String[] args) { SpringApplication.run(ConsumerApplication.class); } } 请求头上使用了@DubboComponentScan 注解,该注解是导入一个DubboComponentScanRegistrar这个类。 @Target(ElementType.TYPE) @Retention(RetentionPolicy.RUNTIME) @Documented @Import(DubboComponentScanRegistrar.class) public @interface DubboComponentScan { String[] value() default {}; String[] basePackages() default {}; Class<?>[] basePackageClasses() default {}; } DubboComponentScanRegistrar是一个实现了ImportBeanDefinitionRegistrar 接口的类,主要看registerBeanDefinitions 方法,该方法会实例化一些BeanDefinition进入spring容器 Override public void registerBeanDefinitions(AnnotationMetadata importingClassMetadata, BeanDefinitionRegistry registry) { // 获取扫描包路径 Set<String> packagesToScan = getPackagesToScan(importingClassMetadata); // 注册@service解析的类 registerServiceAnnotationBeanPostProcessor(packagesToScan, registry); // 注册解析@Reference注解的bean registerReferenceAnnotationBeanPostProcessor(registry); } 在我们的调试例子中,使用的是在启动类中添加注解进行@DubboComponentScan 启动的,所以这里就按照这个方式来,其实第一种和第二种的方式是差不多的,最终都是通过初始化ServiceAnnotationBeanPostProcessor 这个类来达到解析@Service 并生成bean的目的。 接着上面的代码讲,注册解析@@service的方法是 registerServiceAnnotationBeanPostProcessor , 下面看一下这个方法。 private void registerServiceAnnotationBeanPostProcessor(Set<String> packagesToScan, BeanDefinitionRegistry registry) { // 构建ServiceAnnotationBeanPostProcessor的 BeanDefinitionBuilder BeanDefinitionBuilder builder = rootBeanDefinition(ServiceAnnotationBeanPostProcessor.class); builder.addConstructorArgValue(packagesToScan); // 扫描的包 builder.setRole(BeanDefinition.ROLE_INFRASTRUCTURE); AbstractBeanDefinition beanDefinition = builder.getBeanDefinition(); // 创建BeanDefinition并注册到容器中。 BeanDefinitionReaderUtils.registerWithGeneratedName(beanDefinition, registry); } 这个方法就是这么简单,有些朋友可能觉得,就这几行代码,就能够解析@Service注解了? 完全没有看到解析的逻辑代码呢。其实主要的在于ServiceAnnotationBeanPostProcessor 这个类。 ServiceAnnotationBeanPostProcessor public class ServiceAnnotationBeanPostProcessor implements BeanDefinitionRegistryPostProcessor, EnvironmentAware, ResourceLoaderAware, BeanClassLoaderAware { // 代码省略 } 首先我们看一下这个类他实现的接口,实现了BeanDefinitionRegistryPostProcessor, EnvironmentAware, ResourceLoaderAware, BeanClassLoaderAware这四个接口, 主要看BeanDefinitionRegistryPostProcessor这个接口,看一下下面的官方解释 **官方解释 ** 允许在正常的BeanFactoryPostProcessor检测开始之前注册更多的自定义bean。特别是,BeanDefinitionRegistryPostProcessor 可以注册更多的bean定义,然后定义BeanFactoryPostProcessor实例。也就是说可以借此方法实现自定义的bean,通过重写postProcessBeanDefinitionRegistry方法来自定义bean 通过看上面的解释,我们直接找到postProcessBeanDefinitionRegistry方法 @Override public void postProcessBeanDefinitionRegistry(BeanDefinitionRegistry registry) throws BeansException { // 获取扫描包,扫描包可以是多个,所以这里使用了Set集合 Set<String> resolvedPackagesToScan = resolvePackagesToScan(packagesToScan); // 判断需要扫描的包是否为空 if (!CollectionUtils.isEmpty(resolvedPackagesToScan)) { // 不为空则调用方法进行解析 registerServiceBeans(resolvedPackagesToScan, registry); } else { if (logger.isWarnEnabled()) { logger.warn("packagesToScan is empty , ServiceBean registry will be ignored!"); } } } registerServiceBeans private void registerServiceBeans(Set<String> packagesToScan, BeanDefinitionRegistry registry) { // 定义扫描对象,该类继承了ClassPathBeanDefinitionScanner类 DubboClassPathBeanDefinitionScanner scanner = new DubboClassPathBeanDefinitionScanner(registry, environment, resourceLoader); // beanName解析器 BeanNameGenerator beanNameGenerator = resolveBeanNameGenerator(registry); scanner.setBeanNameGenerator(beanNameGenerator); // 这行代码很重要,添加了过滤器, 一个注解过滤器,用来过滤出来写了@Service注解的对象 scanner.addIncludeFilter(new AnnotationTypeFilter(Service.class)); // 扫描正式开始,遍历包 for (String packageToScan : packagesToScan) { // Registers @Service Bean first scanner.scan(packageToScan); // 开始查找添加了@Service注解的类 Set<BeanDefinitionHolder> beanDefinitionHolders = findServiceBeanDefinitionHolders(scanner, packageToScan, registry, beanNameGenerator); // 找到了则不为空 if (!CollectionUtils.isEmpty(beanDefinitionHolders)) { // 循环。 for (BeanDefinitionHolder beanDefinitionHolder : beanDefinitionHolders) { // 注册serviceBean registerServiceBean(beanDefinitionHolder, registry, scanner); } if (logger.isInfoEnabled()) { logger.info(beanDefinitionHolders.size() + " annotated Dubbo's @Service Components { " + beanDefinitionHolders + " } were scanned under package[" + packageToScan + "]"); } } else { if (logger.isWarnEnabled()) { logger.warn("No Spring Bean annotating Dubbo's @Service was found under package[" + packageToScan + "]"); } } } } 上面的代码,主要作用就是通过扫描过滤器,扫描包中添加了@Service注解的类。最后得到BeanDefinitionHolder对象,调用registerServiceBean来注册ServiceBean private void registerServiceBean(BeanDefinitionHolder beanDefinitionHolder, BeanDefinitionRegistry registry, DubboClassPathBeanDefinitionScanner scanner) { // 服务接口类对象 Class<?> beanClass = resolveClass(beanDefinitionHolder); // 找到@service注解 Service service = findAnnotation(beanClass, Service.class); // 接口服务的实现类对象 Class<?> interfaceClass = resolveServiceInterfaceClass(beanClass, service); // 得到bean的名称 String annotatedServiceBeanName = beanDefinitionHolder.getBeanName(); // 构建ServiceBean对象的BeanDefinition,通过Service注解对象,以及接口服务的实现类生成ServiceBean AbstractBeanDefinition serviceBeanDefinition = buildServiceBeanDefinition(service, interfaceClass, annotatedServiceBeanName); // 构建ServuceBean的名称 String beanName = generateServiceBeanName(service, interfaceClass, annotatedServiceBeanName); // 校验Bean是否重复 if (scanner.checkCandidate(beanName, serviceBeanDefinition)) { // check duplicated candidate bean // 调用BeanDefinitionRegistry注册。 registry.registerBeanDefinition(beanName, serviceBeanDefinition); if (logger.isInfoEnabled()) { logger.warn("The BeanDefinition[" + serviceBeanDefinition + "] of ServiceBean has been registered with name : " + beanName); } } else { if (logger.isWarnEnabled()) { logger.warn("The Duplicated BeanDefinition[" + serviceBeanDefinition + "] of ServiceBean[ bean name : " + beanName + "] was be found , Did @DubboComponentScan scan to same package in many times?"); } } } buildServiceBeanDefinition这个方法用来构建ServiceBean对象,每个暴露出的服务,最终都会构建成一个ServiceBean, private AbstractBeanDefinition buildServiceBeanDefinition(Service service, Class<?> interfaceClass, String annotatedServiceBeanName) { // 生成ServiceBean对象BeanDefinitionBuilder BeanDefinitionBuilder builder = rootBeanDefinition(ServiceBean.class); // 获取beanDefinition AbstractBeanDefinition beanDefinition = builder.getBeanDefinition(); // 属性集合 MutablePropertyValues propertyValues = beanDefinition.getPropertyValues(); // 忽略的属性,指的是AnnotationPropertyValuesAdapter中,不把以下属性放到PropertyValues中去 String[] ignoreAttributeNames = of("provider", "monitor", "application", "module", "registry", "protocol", "interface"); // propertyValues.addPropertyValues(new AnnotationPropertyValuesAdapter(service, environment, ignoreAttributeNames)); // 设置ref属性 addPropertyReference(builder, "ref", annotatedServiceBeanName); // 服务的接口 builder.addPropertyValue("interface", interfaceClass.getName()); /** * 获取注解中的provider属性 */ String providerConfigBeanName = service.provider(); if (StringUtils.hasText(providerConfigBeanName)) { addPropertyReference(builder, "provider", providerConfigBeanName); } /** * 获取注解中的monitor属性 */ String monitorConfigBeanName = service.monitor(); if (StringUtils.hasText(monitorConfigBeanName)) { addPropertyReference(builder, "monitor", monitorConfigBeanName); } /** * 获取注解中的application属性 */ String applicationConfigBeanName = service.application(); if (StringUtils.hasText(applicationConfigBeanName)) { addPropertyReference(builder, "application", applicationConfigBeanName); } /** * 获取注解中的模块属性 */ String moduleConfigBeanName = service.module(); if (StringUtils.hasText(moduleConfigBeanName)) { addPropertyReference(builder, "module", moduleConfigBeanName); } /** * 获取注解中的注册中心属性 */ String[] registryConfigBeanNames = service.registry(); List<RuntimeBeanReference> registryRuntimeBeanReferences = toRuntimeBeanReferences(registryConfigBeanNames); if (!registryRuntimeBeanReferences.isEmpty()) { builder.addPropertyValue("registries", registryRuntimeBeanReferences); } /** * 获取注解中的协议属性 */ String[] protocolConfigBeanNames = service.protocol(); List<RuntimeBeanReference> protocolRuntimeBeanReferences = toRuntimeBeanReferences(protocolConfigBeanNames); if (!protocolRuntimeBeanReferences.isEmpty()) { builder.addPropertyValue("protocols", protocolRuntimeBeanReferences); } return builder.getBeanDefinition(); } 最终dubbo解析出了ServiceBean对象的beandefinition放入了spring的容器。ServiceBean对于每个暴露的服务来说很重要,每个暴露的服务都拥有一个ServiceBean,这个类里面包含了服务发布,服务下线等操作,算是一个很核心的类,后面会讲到。 欢迎关注公众号【sharedCode】致力于主流中间件的源码分析, 可以直接与我联系

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册