首页 文章 精选 留言 我的

精选列表

搜索[监督学习],共10000篇文章
优秀的个人博客,低调大师

Java学习:反射的应用,依赖加载

使用反射实现从配置文件加载类以及根据配置文件解决特定依赖关系。 配置文件reflect.properties: 1AdminDao=reflect.AdminDao 1GuestDao=reflect.GuestDao 1Manager=reflect.Manager 2Manager:AdminDao 2Manager:GuestDao 对应类文件AdminDao: package reflect; public class AdminDao { public AdminDao(){ System.out.println("成功实例化AdminDao"); } } 对应类文件GuestDao: package reflect; public class GuestDao { public GuestDao(){ System.out.println("成功实例化GuestDao"); } } 对应类文件Manager: package reflect; public class Manager { private AdminDao adminDao = null; private GuestDao guestDao = null; public Manager() { System.out.println("Manage实例化成功"); } public void setAdminDao (Object o) { this.adminDao = (AdminDao)o; System.out.println("解决adminDao依赖"); } public void setGuestDao (Object o) { this.guestDao = (GuestDao)o; System.out.println("解决guestDao依赖"); } } 反射测试工厂类: package reflect; import java.io.BufferedReader; import java.io.FileReader; import java.io.IOException; import java.lang.reflect.Method; import java.util.HashMap; import java.util.Map; import java.util.Set; public class ObjectFactory { public static Map<String,Object> map = new HashMap<String,Object>(); static { BufferedReader br = null; try { br = new BufferedReader(new FileReader("src/reflect.properties")); String str = br.readLine(); while(str != null) { char c = str.charAt(0); switch (c) { case '1': String[] arr = str.substring(1).split("="); Object o = Class.forName(arr[1]).newInstance(); map.put(arr[0].trim().toLowerCase(), o); break; case '2': String[] arr2 = str.substring(1).split(":"); Object obj = map.get(arr2[0].trim().toLowerCase()); Object fieldObj = map.get(arr2[1].trim().toLowerCase()); String methodName = "set"+arr2[1].substring(0, 1).toUpperCase()+arr2[1].substring(1); Method method = obj.getClass().getDeclaredMethod(methodName, Object.class); method.invoke(obj, fieldObj); break; } str = br.readLine(); } } catch (Exception e) { e.printStackTrace(); } finally { try { br.close(); } catch (IOException e) { e.printStackTrace(); } } } public static void main(String[] args) { Set<String> set = map.keySet(); for (String string:set) { System.out.println(string+"--"+map.get(string)); } } } 跑起来结果: 成功实例化AdminDao 成功实例化GuestDao Manage实例化成功 解决adminDao依赖 解决guestDao依赖 admindao--reflect.AdminDao@10d1f30 manager--reflect.Manager@7aacc1 guestdao--reflect.GuestDao@1e3cabd

优秀的个人博客,低调大师

ElasticSearch学习笔记1-修改文档

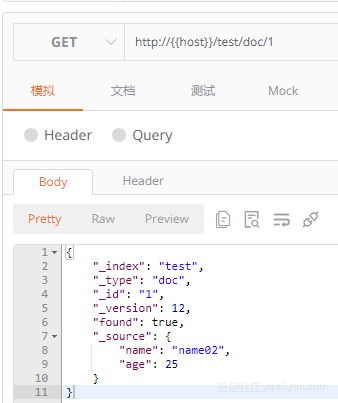
本文中所有用[]括起来的和xxx都是变量 基本操作:1、根据id修改文档,使用POST请求 POST /[index]/[type]/[id]/_update { "doc": {"[XXX]":"[xxxxx]"} } 举例: 上面这个图片中index为test,type为doc,id为1,我们将里面的name改为“name03” age改为20,请求如下: POST /test/doc/_update { "doc": { "name": "name03", "age": 20 } } 返回结果为: { "_index": "test", "_type": "doc", "_id": "1", "_version": 13, "result": "updated", "_shards": { "total": 2, "successful": 1, "failed": 0 }, "_seq_no": 13, "_primary_term": 1 } 对该id再进行一次查询,结果如图所示: 2、使用脚本修改 POST /[index]/[type]/[id]/_update { "script" : "ctx._source.[xxx] = [xxx]" } 继续使用上面的文档 POST /test/doc/1/_update { "script":"ctx._source.age+=5;ctx._source.name=\"name04\"" } 查询结果:修改成功。3、删除 DELETE /[index]/[type]/[id] 比较简单,不做举例4、批量创建批量创建和批量修改的请求都是一样的, 传的参数不一样请求: POST /[index]/[type]/_bulk 批量创建参数:{"index":{"_id":"xxx"}}{"xxx": "xxx" }{"index":{"_id":"xxx"}}{"xxx": "xxx" } 举例: POST /test01/doc01/_bulk {"index":{"_id":"1"}} {"name": "name01" } {"index":{"_id":"2"}} {"name": "name02","age":20 } {"index":{"_id":"3"}} {"name": "name03","age":20 } --------------1 这里有一点要注意:在图中1的位置,后面一定要换行,否则会报错,提示需要新的一行作为结束的标识,报错信息如下 { "error": { "root_cause": [ { "type": "illegal_argument_exception", "reason": "The bulk request must be terminated by a newline [\n]" } ], "type": "illegal_argument_exception", "reason": "The bulk request must be terminated by a newline [\n]" }, "status": 400 } 注意上面两张图片中最左边序号的不同,下面是正确的json数据,体会什么叫以新的一行作为结束的标识。 这种操作实际上是id存在就更新,不存在就创建,返回结果如下: { "took": 162, "errors": false, "items": [ { "index": { "_index": "test01", "_type": "doc01", "_id": "1", "_version": 6, "result": "updated", "_shards": { "total": 2, "successful": 1, "failed": 0 }, "_seq_no": 5, "_primary_term": 1, "status": 200 } }, { "index": { "_index": "test01", "_type": "doc01", "_id": "2", "_version": 2, "result": "updated", "_shards": { "total": 2, "successful": 1, "failed": 0 }, "_seq_no": 1, "_primary_term": 1, "status": 200 } }, { "index": { "_index": "test01", "_type": "doc01", "_id": "3", "_version": 1, "result": "created", "_shards": { "total": 2, "successful": 1, "failed": 0 }, "_seq_no": 0, "_primary_term": 1, "status": 201 } } ] } 查看下这三个id的具体内容: 5、批量修改参数: {"update":{"_id":"xxx"}} {"doc": { "XXX": "xxx" } } {"delete":{"_id":"xxx"}} 现在对上面创建的三条记录做批量修改: POST /test01/doc01/_bulk {"update":{"_id":"1"}} {"doc": { "name": "name011"}} {"delete":{"_id":"2"}} {"update":{"_id":"3"}} {"script": "ctx._source.age+=5;ctx._source.name=\"name033\""} -----------1 和批量创建一样,最后一行需要换行。查询索引test01的数据如下:数据全部修改成功!

优秀的个人博客,低调大师

"深度"学习让照片动起来

Facebook最近推出了“3D照片”功能,让普通的照片能有3D显示效果:可以随着手机姿态的变化显示照片的不同视角,打开链接即可体验 https://www.facebook.com/applealmondblog/posts/1922679287846447 (手机上陀螺仪控制,PC上鼠标控制) 可以看到虽然视角变化被限制在较小的范围,但是确实有3D的感觉,其实这样结合陀螺仪的简单3D效果也挺常见的,比如王者荣耀的启动界面: 晃动手机,前后景会随着手机姿态位移变化;一些H5页面也有这种效果,实现就更简单了,前后景两张或多张图片层叠,根据陀螺仪数据改变图片相对位置即可 可以看出,产生3D效果的关键在于z轴,即深度(depth),当图层或像素的深度有差别时,就可以在不同视角下计算出图层或像素新的位置,渲染出当前视角对应的图像。我们把每个像

优秀的个人博客,低调大师

java8学习:CompletableFuture方法使用

下面是自己总结的一部分的api的使用,当然下面有些方法后面加上Async就会变为异步的 /** * 变换:参数为Function接口 * thenApply:将上一个结果当做这次thenApply的参数传入,加以处理后,返回一个值 * 可以传入T返回T也可以传入T返回U */ public void thenApply() { CompletableFuture<String> future = CompletableFuture.supplyAsync(()-> 1).thenApply(i -> String.valueOf(i)); String i = future.join(); System.out.println(i); //1 } /** * 消费 * 参数为Consumer接口 * thenAccept:将上一个的结果当做这次的参数传入,但是无返回值 */ public void thenAccept() { CompletableFuture<Void> future = CompletableFuture.supplyAsync(() -> 1).thenAccept((integer -> System.out.println(integer))); future.join(); //1 } public void thenCompose() { CompletableFuture<Integer> future = CompletableFuture.supplyAsync(() -> 1) //提供第一个CompletableFuture结果值 .thenCompose((i) -> //将上一个结果值传入下一个CompletableFuture CompletableFuture.supplyAsync(() -> i + 2)); //对传入的结果值进行处理 Integer join = future.join(); System.out.println(join); } /** * 结合两个结果得到一个最终值 * 逻辑处理需要的是BiFunction接口 * 需要两个CompletableFuture结果,并且需要有处理两个结果的逻辑 * 两个CompletableFuture返回的结果不需要一致 */ public void thenCombine() { CompletableFuture<String> future = CompletableFuture.supplyAsync(() -> "Hello ") //第一个CompletableFuture返回结果 .thenCombine(CompletableFuture.supplyAsync(() -> 1), //第二个CompletableFuture返回结果 (future1, future2) -> future1 + future2); //处理两个结果的逻辑 String join = future.join(); System.out.println(join); //Hello World } /** * 跟上面的差不多,只不过这里处理逻辑需要的是一个BiConsumer接口,无返回值而已 */ public void thenAcceptBoth() { CompletableFuture<Void> both = CompletableFuture.supplyAsync(() -> "Hello ") //第一个CompletableFuture返回结果 .thenAcceptBoth(CompletableFuture.supplyAsync(() -> "World"), //第二个CompletableFuture返回结果 (future1, future2) -> System.out.println(future1 + future2));//处理两个结果的逻辑 both.join(); //Hello World } /** * 两个CompletableFuture一起执行,哪个先执行完就用哪个CompletableFuture的结果 * 处理逻辑需要的参数是一个Function接口 * 下面整体代码的逻辑是返回1的睡眠一秒,返回2的睡眠0.3秒,所以返回2的肯定比1要快,所以结果为2,然后应用到处理逻辑上 * 最终结果就是为 2 done * 两个CompletableFuture返回的参数需要一致 * 这适用于两种渠道完成同一个事情,就可以调用这个方法,找一个最快的结果进行处理,最终有返回值。 */ public void applyToEither() { CompletableFuture<String> apply = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } return "1"; }).applyToEither( CompletableFuture.supplyAsync(() -> { try { Thread.sleep(300); } catch (InterruptedException e) { e.printStackTrace(); } return "2"; }), (future) -> future + " done" //对于首先完成的CompletableFuture任务之后执行的逻辑 ); String join = apply.join(); System.out.println(join);//2 done } /** * 与上面使用方法一致,只是多加了一个选项 * 结果为3 three */ public void applyToEithers() { CompletableFuture<String> apply = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } return "1"; }).applyToEither( CompletableFuture.supplyAsync(() -> { try { Thread.sleep(800); } catch (InterruptedException e) { e.printStackTrace(); } return "2"; }),(future) -> future + " done" //对于首先完成的CompletableFuture任务之后执行的逻辑 ).applyToEither( CompletableFuture.supplyAsync(() -> { try { Thread.sleep(300); } catch (InterruptedException e) { e.printStackTrace(); } return "3"; }),(future -> future + " three") ); String join = apply.join(); System.out.println(join);//2 done } /** * 对于出错的处理过程进行补偿,即如果future出错,会运行exceptionally里的Function函数 * 当然没有错就不会运行后面指定的函数 */ @Test public void exceptionally() { CompletableFuture<String> exceptionally = CompletableFuture.supplyAsync(() -> { int i = 1 / 0 ; return "1"; }).exceptionally(ex -> { ex.printStackTrace(); return "error"; }); String join = exceptionally.join(); System.out.println(join); } /** * 输出 * error * java.util.concurrent.CompletionException: java.lang.ArithmeticException: / by zero * at java.util.concurrent.CompletableFuture.encodeThrowable(CompletableFuture.java:273) * at java.util.concurrent.CompletableFuture.completeThrowable(CompletableFuture.java:280) * at java.util.concurrent.CompletableFuture$AsyncSupply.run(CompletableFuture.java:1592) * at java.util.concurrent.CompletableFuture$AsyncSupply.exec(CompletableFuture.java:1582) * at java.util.concurrent.ForkJoinTask.doExec(ForkJoinTask.java:289) * at java.util.concurrent.ForkJoinPool$WorkQueue.runTask(ForkJoinPool.java:1056) * at java.util.concurrent.ForkJoinPool.runWorker(ForkJoinPool.java:1692) * at java.util.concurrent.ForkJoinWorkerThread.run(ForkJoinWorkerThread.java:157) * Caused by: java.lang.ArithmeticException: / by zero * at com.qidai.demotest.MyTestx.lambda$exceptionally$18(MyTestx.java:125) * at java.util.concurrent.CompletableFuture$AsyncSupply.run(CompletableFuture.java:1590) * ... 5 more */ /** * 与上面的thenAccept相比较,这个方法并不需要输入参数,相同点是都是无返回值 */ public void thenRun() { CompletableFuture<Void> runnable = CompletableFuture.supplyAsync(() -> "1").thenRun(() -> System.out.println("runnable")); runnable.join(); }

优秀的个人博客,低调大师

java8学习:使用流(1)

内容来自《 java8实战 》,本篇文章内容均为非盈利,旨为方便自己查询、总结备份、开源分享。如有侵权请告知,马上删除。书籍购买地址:java8实战 筛选和切片 filter方法 //取出是素菜的菜单 menu.stream() .filter(Dish::isVegetarian) //代表是否是素食,这里条件并不一定是方法调用,只要的你条件能够返回boolean就可以 .collect(Collectors.toList()); limit方法 //取出菜单的前三个 menu.stream().limit(3) //跟sql中limit一样,不过这个是短路limit,也就是说,它取出了三个后就不再遍历后面的元素了,直接返回 .collect(Collectors.toList()); distinct方法:去重 menu.stream() .distinct() //去重操作,根据元素的hashCode和equals方法判断是否相等 .collect(Collectors.toList()); skip方法:跳过指定数量的元素 //取菜单中第三个到第五个 menu.stream() .skip(2) //跳过开头两个元素 .limit(3) //然后截取第三个到第五个 .forEach(System.out::println); //如上可以看出skip和limit是互补的,因为limit没有这样的形式:limit(start,end) 映射 提到这个概念,就是把你stream里的每个元素都应用到自己指定的表达式之上然后返回,就比如 List<String> list = Arrays.asList("1","2","3"); list.stream() .映射方法(str -> str + "dada") .forEach(System.out::println); //以上为伪代码 //说明的意思就是list中的每个元素:1,2,3都会应用到表达式:str + "dada" //并返回表达式的值 //所以结果就是1dada,2dada,3dada map方法 //这里提到的map方法,完全可以替换上面的伪代码:映射方法,上面代码是传入A类型返回A类型的演示 //也就是传入字符串1,2,3返回的也是字符串 //map当然可以传入A类型返回B类型,比如 List<String> list = Arrays.asList("1","2","3"); list.stream() .map(Integer::parseInt) .forEach(System.out::println); //上面就是传入String,返回的是int //当然也可以是返回字符串的长度 考虑一个场景,把n个单词的里面的字母去重然后输出 就比如["abc","bce"],里面的字母就是["a","b","c","b","c","e"],去重后是:["a","b","c","e"],现在来实现它 List<String> list = Arrays.asList("abc","bce"); List<String[]> collect = list.stream() .map(str -> str.split("")) .distinct() .collect(Collectors.toList()); collect.forEach(System.out::println); 上面的感觉是对的,拆分,然后去重,但是一点需要注意,当lambda把第一个元素"abc"进行映射操作的时候,split方法返回的是一个String数组对象,这也就能解释为什么List的泛型是String数组了,数组跟数组distinct那肯定是去重不成功的。 流的过程是这样的["abc","bce"] -> [{"a","b","c"},{"b","c","e"}],然后拿{"a","b","c"}和{"b","c","e"}去重肯定行不通 现在遇到的问题就是:我们希望把abc和bce切分然后合并成一个流,然后进行去重,我们接着实验 Array::stream Array::stream可以接受一个数组并产生一个流,如下 String[] str = {"abc","bce"}; Stream<String> stream = Arrays.stream(str); stream.forEach(System.out::println); //abc //bce 我们在上面的split方法返回的就是数组,我们尝试将split返回的数组映射到此方法上,看看能不能合并成一条流 List<String> list = Arrays.asList("abc","bce"); List<Stream<String>> collect = list.stream() .map(str -> str.split("")) .map(Arrays::stream) .distinct() .collect(Collectors.toList()); //java.util.stream.ReferencePipeline$Head@2aae9190 //java.util.stream.ReferencePipeline$Head@2f333739 但是并不尽如人意,因为他返回的泛型是Stream,也就是说,Array::stream方法只是把一个数组转换为一个流,流中的元素是String所以这个流就是这样的Stream,这种情况类似上面遇到的返回的是两个数组,现在返回的List中装入的并不是String,而是两条流,流跟流做去重也是行不通的 解决方案 现在遇到的问题就是:他们都是将一个list元素单独转化为一条流或者一个数组,我们需要的是转换为流或者数组之后,再将这些返回的数组或者流接为一个流或者数组,就像接水管一样,让他们连起来 尝试方法:flatmap List<String> list = Arrays.asList("abc","bce"); List<String> collect = list.stream() .map(str -> str.split("")) .flatMap(Arrays::stream) .distinct() .collect(Collectors.toList()); collect.forEach(System.out::println); //a b c e 如上的代码终于是返回了一个LIst,所以结果也是我们期待的达到了去重的效果,那么它的流的处理过程是怎么样的呢?如下 传入"abc"->切分为["a","b","c"] --->flatMap合并["a","b","c","b","c","e"]->去重->ok 传入"bce"->切分为["b","c","e"] 上面能看懂吗...懒得画图了,第一行和第三行是flatMap前面的split过程,然后是第二行存入flatMap进行合并流 flatMap也就是把n个流合并为一个流 小实战 要求两个list:["123"],["456"],然后组成元组:(1,4),(1,5),(1,6),(2,4),(2,5)... List<String> first = Arrays.asList("123"); List<String> second = Arrays.asList("456"); first.stream() .map(str -> str.split("")) .forEach(strs -> { Arrays.stream(strs).forEach(f -> { second.stream() .map(sec -> sec.split("")) .forEach(secs -> Arrays.stream(secs).forEach(s -> System.out.println("("+f+","+s+")"))); }); }); //上面代码是直接输出的,那么下面的就是将元组组合成一个LIst返回了 List<String> first = Arrays.asList("123"); List<String> second = Arrays.asList("456"); List<String> collect = first.stream() .map(str -> str.split("")) .flatMap(strs -> //将strs后的表达式返回的stream都合并为一个 Arrays.stream(strs).flatMap(f -> second.stream() .map(sec -> sec.split("")) .flatMap(secs -> Arrays.stream(secs).map(s -> "(" + f + "," + s + ")"))) ).collect(Collectors.toList()); collect.forEach(System.out::println); //耐心看..... 查找和匹配 anyMatch:至少匹配一个 List<String> list = Arrays.asList("1","2","3","4"); boolean b = list.stream().anyMatch(s -> s.equals("1")); //true allMatch:全部匹配 List<String> list = Arrays.asList("1","2","3","4"); boolean b = list.stream().allMatch(s -> Integer.parseInt(s) < 5); //true noneMatch:全部不匹配 List<String> list = Arrays.asList("1","2","3","4"); boolean b = list.stream().noneMatch(s -> Integer.parseInt(s) > 5); //true 如上的方法都具有短路效果,意思就是主要遇到一个不匹配条件的元素就立刻返回true或者false findAny:找任意一个 List<String> list = Arrays.asList("1","2","3","4"); Optional<String> any = list.stream().findAny(); System.out.println(any.get()); //虽然书上说是任意一个,但是我一直返回的是1 //自己测试的将元素添加到十个,stream依旧是1,但是使用并行流parallelStream,将随机返回,但是依然是区间比较小 Option以后的帖子会说到的,你可以看一下我相关的帖子,只要记住Option是一个值的容器,因为findAny找的可能是个空列表,所以他可能会返回null,然后将返回的这个值包装在Option中,然后调用get方法就会出现返回的值,如果Option中没有值还get那么就会报错,现在只要知道这点就可以了 findFirst:找到第一个 List<String> list = Arrays.asList("1","2","3","4"); Optional<String> any = list.stream().findFirst(); System.out.println(any.get()); //1 归约reduce 上面的映射和这词提到的归约可以一起使用,类似hadoop中的mr模型 元素求和 int[] is = {1,2,3,4,5,6,7,8,9}; Arrays.stream(is).reduce(0,Integer::sum);//45 //以0为起始值,所以如果数组内没有元素,也不至于null,然后依次相加 //0+1=1 //1+2=3 //3+3=6 //6+4=10 .... int[] is = {1,2,3,4,5,6,7,8,9}; OptionalInt reduce = Arrays.stream(is).reduce(Integer::sum); System.out.println("reduce = " + reduce.getAsInt());//45 //OptionalInt的出现就是因为它没有初始值进行累加,所以如果数组为空,那么将返回null //OptionalInt使用方法和Optional一样,只是方法名变了一下,目前只知道这些就好了 元素最大值和最小值 //max int[] is = {1,2,3,4,5,6,7,8,9}; OptionalInt reduce = Arrays.stream(is).reduce(Integer::max); System.out.println("reduce = " + reduce.getAsInt()); //9 //求最小改为min方法即可,也可以自己实现 OptionalInt reduce = Arrays.stream(is).reduce((a,b) -> a > b ? a : b ); 归约方法的优势和并行化 求和方法:定义一个int变量,然后迭代去加。相比之下reduce将其转换为了内部迭代。而且迭代要去求和并且更新我们的一个int共享变量,这对于并行化来说并不容易实现,如果加入了同步,可能线程切换的开销就已经抵消了并行带来的性能提升。(可变的变量累计器对于并行来说并不好),如上的代码为了实现并行只需要把stream方法改为parallelStream()即可 int[] is = {1,2,3,4,5,6,7,8,9}; int sum = 0; //int共享变量 //这只是单线程的,如果是多线程的话,为了保证sum的正确肯定要sync。 //所以这就是说的共享变量并不适合于并行化 for (int i : is) { sum += i; //更新共享变量 } 流操作的有状态和无状态 如果你购买了书可以先去看看书的定义,下面是我自己的理解 int[] is = {1,2,3,4,5,6,7,8,9}; Arrays.stream(is) .filter(i -> i > 3) //无状态 .map(i -> i + 1) //无状态 .distinct() //有状态 .max(); //有状态 对于上面来说,filter和map只是接收一个元素然后过滤映射一个元素,这个元素处理完就交给下面的方法处理了,自己并不保留这个元素,这样的叫做无状态 那distinct和max来说,他不能接收一个处理一个然后再交给下面的方法处理,因为它需要拿到整个元素来去重和去最大值,如果拿到部分他肯定是不能做这些操作的,元素就暂时的保留在了方法中,所以这样的叫做有状态 接下来的东西下一篇讲

优秀的个人博客,低调大师

SQL数据库学习之路(八)

数据库介绍: 在网页上的主程序中进行注册操作,然后把数据发送给人,人传递这些数据到数据库当中。 为什么学ADO.NET:之前我们所学的只能在查询分析器中查看数据,操作数据。我们不能让一个普通用户使用SQL去操作,所以我们搭建一个界面(Web Winform)让用户方便地去使用数据库中的数据。 什么是ADO.NET:ADO.NET就是一组类库,这组类库可以让我们通过程序去访问数据库,就像System.IO下的类用类操作文件一样,System.Data这组类是用来操作数据库,它提供了统一的编程接口。 数据提供程序(常用类): 1.connection :用来连接数据库 2.command :用来执行SQL语句 3.datareader :只读、只进的结果集,一条一条读取数据。 4dataadapter :一个封装了上面三个对象的对象。 数据集(DataSet):临时数据库,断开式数据操作 VS中连接数据库 1.打开VS2015,在左上角文件中选择新建项目。选择C#中的控制台应用程序,自己定义命名,点击确定,出现如下界面。 2.打开服务器资源管理器,或者视图,服务器资源管器 。 右键数据连接,创建新连接后如图所示 。 .服务器名是你要连接的服务器名,可以是你自己的服务器也可以是别人的服务器,点击下拉框按钮会出现在局域网中所有的服务器。身份验证当你连接你自己的服务器可以是Windows身份验证,如果连接局域网的服务器必须是SQL server 验证,需提供登录名和密码。连接到数据库就是你自己想用的服务器的数据库。 3.点击在数据连接中出现的数据库,右键选择属性,在属性中复制连接字符串的内容。 Data Source=****;(这是指服务器的名字)Initial Catalog=Text;(这是要连接的数据库)Integrated Security=True(以Windows身份登录的) 4.在调用类时增加这一句using System.Data.SqlClient; main()函数代码: int r=0; //连接字符串 string str = "Data Source=********;Initial Catalog=Text;Integrated Security=True"; using (SqlConnection con=new SqlConnection(str)) //连接数据库 { string sql = " ";//输入需要使用的SQL语句 using (SqlCommand cmd =new SqlCommand(sql,con))//要执行的SQL语句 { con.Open(); //打开数据库 //增删改 r = cmd.ExecuteNonQuery(); } Console.WriteLine(r > 0 ? "操作成功" : "操作失败"); //如果r>0控制台显示操作成功,r<0控制台显示操作失败 Console.ReadKey(); }

优秀的个人博客,低调大师

Python高级知识点学习(九)

并发、并行,同步、异步,阻塞、非阻塞 并发、并行 并发是在一个时间段内,有几个程序在同一个cpu上运行,但是任意时刻只有一个程序在cpu上运行。 并行是任意时刻点上,有多个程序同时运行在多个cpu上。 同步、异步 同步是指代码调用IO操作时,必须等待IO操作完成才返回的调用方式。 异步是指代码调用IO操作时,不必等待IO操作完成就返回的调用方式。 阻塞、非阻塞 阻塞是指调用函数时候当前线程被挂起。 非阻塞是指调用函数时候当前线程不会被挂起,而是立即返回。 阻塞和非阻塞的概念和同步异步感觉很像,但是其实它们之间是有区别的。 区别: 同步和异步实际上是消息通信的一种机制,可以把IO操作看做一个消息,调用IO操作时,相当于发一个消息给另外一个线程(或者说另外一个协程),让它去执行某些操作,在提交数据之后立刻得到future,后边就可以通过future拿到结果,实际上是消息之间的通信机制。 阻塞和非阻塞是不同于同步异步的,它是函数调的一种机制。 IO 多路复用 (select、poll 和 epoll) unix中五种I/O模型 阻塞式I/O 非阻塞式I/O I/O复用 信号驱动式I/O (用的比较少) 异步I/O (POSIX的aio_系列函数) 以上五种是递进式的发展。 I/O多路复用: select方法也是阻塞的方法,select本身是阻塞式的,select可以监听多个文件句柄和socket,select在某一个文件句柄或者socket准备好的话就会返回,这时候立刻可以做业务逻辑处理。 I/O多路复用带来的好处是: 比如现在同时发起了100个非阻塞式的请求,这时候直接使用select去监听这100个socket,这样的话一旦有一个发生状态变化,我们就可以立马处理它。 I/O多路复用中,将数据从内核复制到用户空间这段时间消耗还是省不了。 异步IO: 这里的异步IO是真正意义上的异步IO(aio),我们现在接触到很多高并发框架实际上都没有使用异步IO,实际上在很大程度上使用的都是io多路复用技术,IO多路复用很成熟很稳定,异步IO对于IO多路复用性能提升并没有达到很明显的程度,但是编码难度有很大提升,所以当前情况下IO多路复用用的比较多。 异步IO节省掉了数据从内核拷贝到用户空间这一步骤。 select、poll、epoll: select、poll、epoll都是I/O多路复用的机制。 I/O多路复用就是通过一种机制,一个进程可以监视多个描述符,一旦某个描述符就绪(一般就是读就绪或写就绪),能够通知程序进行相应的读写操作。 但select、poll、epoll本质上都是同步I/O,因为它们都需要在读写事件就绪后自己负责进行读写(数据从内核拷贝到用户区),也就是说这个读写过程是阻塞的,而异步I/O则无需自己负责进行读写,异步I/O的实现会负责把数据从内核拷贝到用户空间。 select是什么? select 函数监视的文件描述符分三类,分别是writefds、readfds、exceptfds。调用select后会阻塞,直到有描述符就绪(有数据可读、可写、或者有except),或者超时(timeout指定等待时间,如果立即返回设为null即可),函数返回。当select函数返回后,可以通过遍历fdset来找到就绪的描述符。 select目前几乎在所有的平台上支持,其良好的跨平台也是它的一个优点。select的一个缺点在于单个进程监视的文件描述符的数量有最大限制,在linux上一般为1024,可以通过修改宏定义甚至重新编译内核的方式提升这一性质,但是这样也会造成效率的降低。 poll是什么? 不同于select使用三个位图来表示三个fdset的方式,poll使用一个pollfd的指针实现。pollfd结构包含了要监视的event和发生的event,不再使用select "参数-值" 传递的方式。同时,pollfd并没有最大数量限制(但是数量过大性能也会下降)。和select函数一样,poll返回后,需要轮询pollfd来获取就绪的描述符。 从上面看,select和poll都需要在返回后,通过遍历文件描述符来获取已经就绪的socket。事实上,同时连接的大量客户端在一时刻可能只有很少的处于就绪的状态,因此随着监视的描述符数量的增长,其效率也会线性下降。 epoll是什么? epoll是在2.6内核中提出的,epoll是之前的select和poll的增强版本。相对于select和poll来讲,epoll更加灵活,没有描述符限制。epoll使用一个文件描述符管理多个描述符,将用户关系的文件描述符的事件存放到内核的一个事件表中,这样在用户空间和内核空间的copy只需要一次。 epoll它的查询使用了数据结构中性能很高的一个:红黑树。 nginx就是使用了epoll。 epoll并不代表一定比select好: 在并发高的情况下,连接活跃度不是很高, epoll比select。 并发性不高,同时连接很活跃, select比epoll好。 非阻塞I/O实现http请求 上示例代码: import socket from urllib.parse import urlparse def get_url(url): # 通过socket请求html url = urlparse(url) host = url.netloc path = url.path if path == "": path = "/" # 建立socket连接 client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) # 这里会导致后边抛异常,但是连接请求已经发出去了 client.setblocking(False) # 捕获异常 try: client.connect((host, 80)) # 阻塞不会消耗cpu except BlockingIOError as e: pass # 不停的询问连接是否建立好, 需要while循环不停的去检查状态 # 做计算任务或者再次发起其他的连接请求 while True: try: client.send("GET {} HTTP/1.1\r\nHost:{}\r\nConnection:close\r\n\r\n".format(path, host).encode("utf8")) break except OSError as e: pass data = b"" while True: # 这里还会抛异常,读不到就继续读 try: d = client.recv(1024) except BlockingIOError as e: continue if d: data += d else: break data = data.decode("utf8") html_data = data.split("\r\n\r\n")[1] #打印返回的数据 print(html_data) client.close() if __name__ == "__main__": get_url("http://www.baidu.com") 非阻塞I/O整个过程依赖前后的监测,整个过程不停的做while循环检测状态,但是返回时间没有变,所以并没有提高并发。 select+回调+事件循环实现http请求 目前开源的高性能框架,一般都是使用这种方式实现并发。 使用select + 回调 + 事件循环实现下载网页,并发性高且是单线程。 select方法本尊是在import select这个包里边,但是有另外一个包把select基础上进行了封装,用起来更简单:from selectors import DefaultSelector,DefaultSelector一般使用DefaultSelector这个比较多。 看代码示例: import socket import time from urllib.parse import urlparse from selectors import DefaultSelector, EVENT_READ, EVENT_WRITE selector = DefaultSelector() urls = [] stop = False class Fetcher: def connected(self, key): selector.unregister(key.fd) self.client.send("GET {} HTTP/1.1\r\nHost:{}\r\nConnection:close\r\n\r\n".format(self.path, self.host).encode("utf8") selector.register(self.client.fileno(), EVENT_READ, self.readable) # 当socket可读时,读数据,全部都是cpu操作 def readable(self, key): d = self.client.recv(1024) if d: self.data += d else: # 数据读完为空 selector.unregister(key.fd) data = self.data.decode("utf8") html_data = data.split("\r\n\r\n")[1] print(html_data[:30]) self.client.close() urls.remove(self.spider_url) if not urls: global stop stop = True def get_url(self, url): self.spider_url = url url = urlparse(url) self.host = url.netloc self.path = url.path self.data = b"" if self.path == "": self.path = "/" # 建立 socket 连接 self.client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) self.client.setblocking(False) try: self.client.connect((self.host, 80)) # 阻塞不会消耗cpu except BlockingIOError as e: pass selector.register(self.client.fileno(), EVENT_WRITE, self.connected) # 驱动整个事件循环 def loop(): while not stop: ready = selector.select() for key, mask in ready: call_back = key.data call_back(key) if __name__ == "__main__": # 计时开始 start_time = time.time() for url in range(60): url = "http://www.baidu.com" urls.append(url) fetcher = Fetcher() fetcher.get_url(url) loop() print(time.time()-start_time) 上边代码中,Fetcher类包含三个方法,get_url简历socket连接,connected和readable是两个回调函数。 loop函数负责驱动整个事件循环。 回调的缺点 可读性差 共享状态异常处理 异常处理困难

优秀的个人博客,低调大师

Python高级知识点学习(八)

线程同步 - condition介绍 多线程中的另外一个重要点就是condition:条件变量。 condition是python多线程编程中用于复杂线程间通信的一个锁 叫做条件变量。 cond = threading.Condition() with self.cond: cond.notify() cond.wait() condition有两层锁, 一把底层锁会在线程调用了wait方法的时候释放, 上面的锁会在每次调用wait的时候分配一把并放入到cond的等待队列中,等到notify方法的唤醒。 有关condition的详情请查阅资料。(这里作者自己暂时还没理清楚原理,见谅) 线程同步 - Semaphore 介绍 信号量,Semaphore。 Semaphore 是用于控制进入数量的锁,控制进入某段代码的线程数。 文件, 读、写, 写一般只是用于一个线程写,读可以允许有多个。 ThreadPoolExecutor线程池 多线程和多进程对比 运算,耗cpu的操作,用多进程编程 对于io操作来说, 使用多线程编程 由于进程切换代价要高于线程,所以能使用线程就不用进程。 耗费cpu的操作: def fib(n): if n<=2: return 1 return fib(n-1)+fib(n-2) if __name__ == "__main__": with ThreadPoolExecutor(3) as executor: all_task = [executor.submit(fib, (num)) for num in range(1, 10)] start_time = time.time() for future in as_completed(all_task): data = future.result() print("exe result: {}".format(data)) print("last time is: {}".format(time.time()-start_time)) 模拟IO操作: def random_sleep(n): time.sleep(n) return n if __name__ == "__main__": with ProcessPoolExecutor(3) as executor: all_task = [executor.submit(random_sleep, (num)) for num in [2]*30] start_time = time.time() for future in as_completed(all_task): data = future.result() print("exe result: {}".format(data)) print("last time is: {}".format(time.time()-start_time)) multiprocessing 多进程 使用os.fork创建子进程,fork只能用于linux/unix中。 import os import time # fork新建子进程 fork只能用于linux/unix中 pid = os.fork() print("a") if pid == 0: print('子进程id:{} ,父进程id是: {}.' .format(os.getpid(), os.getppid())) else: print('我是父进程, 我fork出的子进程id是:{}.'.format(pid)) time.sleep(2) 运行结果: a 我是父进程, 我fork出的子进程id是:3093. a 子进程id:3093 ,父进程id是: 3092. 运行结果中,可以看到打印了两次a,因为在执行完pid = os.fork()这行代码后,就创建了一个子进程,且子进程把父进程中的数据原样拷贝了一份到自己的进程中,所以父进程中打印一次,子进程中又打印一次。 多进程编程: import multiprocessing # 多进程编程 import time def get_html(n): time.sleep(n) print("sub_progress success") return n if __name__ == "__main__": progress = multiprocessing.Process(target=get_html, args=(2,)) print(progress.pid) progress.start() print(progress.pid) progress.join() print("main progress end") 使用进程池: import multiprocessing # 多进程编程 import time def get_html(n): time.sleep(n) print("sub_progress success") return n if __name__ == "__main__": # 使用进程池 pool = multiprocessing.Pool(multiprocessing.cpu_count()) result = pool.apply_async(get_html, args=(3,)) # 等待所有任务完成 pool.close() pool.join() print(result.get()) 进程池另一种方法: import multiprocessing # 多进程编程 import time def get_html(n): time.sleep(n) print("sub_progress success") return n if __name__ == "__main__": # 使用进程池 pool = multiprocessing.Pool(multiprocessing.cpu_count()) for result in pool.imap_unordered(get_html, [1, 5, 3]): print("{} sleep success".format(result)) 进程间通信 Queue、Pipe,Manager 共享全局变量不能适用于多进程编程,可以适用于多线程。 进程间通信和线程间通信有相同也有不同,不同点是之前在多线程中用的线程间通信的类和线程间同步的锁在多进程中是不能用的。 使用multiprocessing中的Queue实现进程通信 import time from multiprocessing import Process, Queue, Pool, Manager, Pipe def producer(queue): queue.put("a") time.sleep(2) def consumer(queue): time.sleep(2) data = queue.get() print(data) if __name__ == "__main__": queue = Queue(10) my_producer = Process(target=producer, args=(queue,)) my_consumer = Process(target=consumer, args=(queue,)) my_producer.start() my_consumer.start() my_producer.join() my_consumer.join() 一定要使用multiprocessing中的Queue,如果使用import queue这个queue是不行的。 pool中的进程间通信需要使用manager中的queue multiprocessing中的queue不能用于pool进程池。 pool中的进程间通信需要使用manager中的queue def producer(queue): queue.put("a") time.sleep(2) def consumer(queue): time.sleep(2) data = queue.get() print(data) if __name__ == "__main__": queue = Manager().Queue(10) pool = Pool(2) pool.apply_async(producer, args=(queue,)) pool.apply_async(consumer, args=(queue,)) pool.close() pool.join() 使用Manager,多进程修改同一变量: def add_data(p_dict, key, value): p_dict[key] = value if __name__ == "__main__": progress_dict = Manager().dict() from queue import PriorityQueue first_progress = Process(target=add_data, args=(progress_dict, "a", 22)) second_progress = Process(target=add_data, args=(progress_dict, "b", 23)) first_progress.start() second_progress.start() first_progress.join() second_progress.join() print(progress_dict) 可以看到两个进程对一个dict变量做值得填充,最终主进程中打印出了最终的dict。 通过pipe实现进程间通信: pipe的性能高于queue。 pipe只能适用于两个进程。 def producer(pipe): pipe.send("a") def consumer(pipe): print(pipe.recv()) if __name__ == "__main__": recevie_pipe, send_pipe = Pipe() #pipe只能适用于两个进程 my_producer = Process(target=producer, args=(send_pipe, )) my_consumer = Process(target=consumer, args=(recevie_pipe,)) my_producer.start() my_consumer.start() my_producer.join() my_consumer.join() my_producer进程给my_consumer进程发送的a变量可以正常打印。

优秀的个人博客,低调大师

Python高级知识点学习(七)

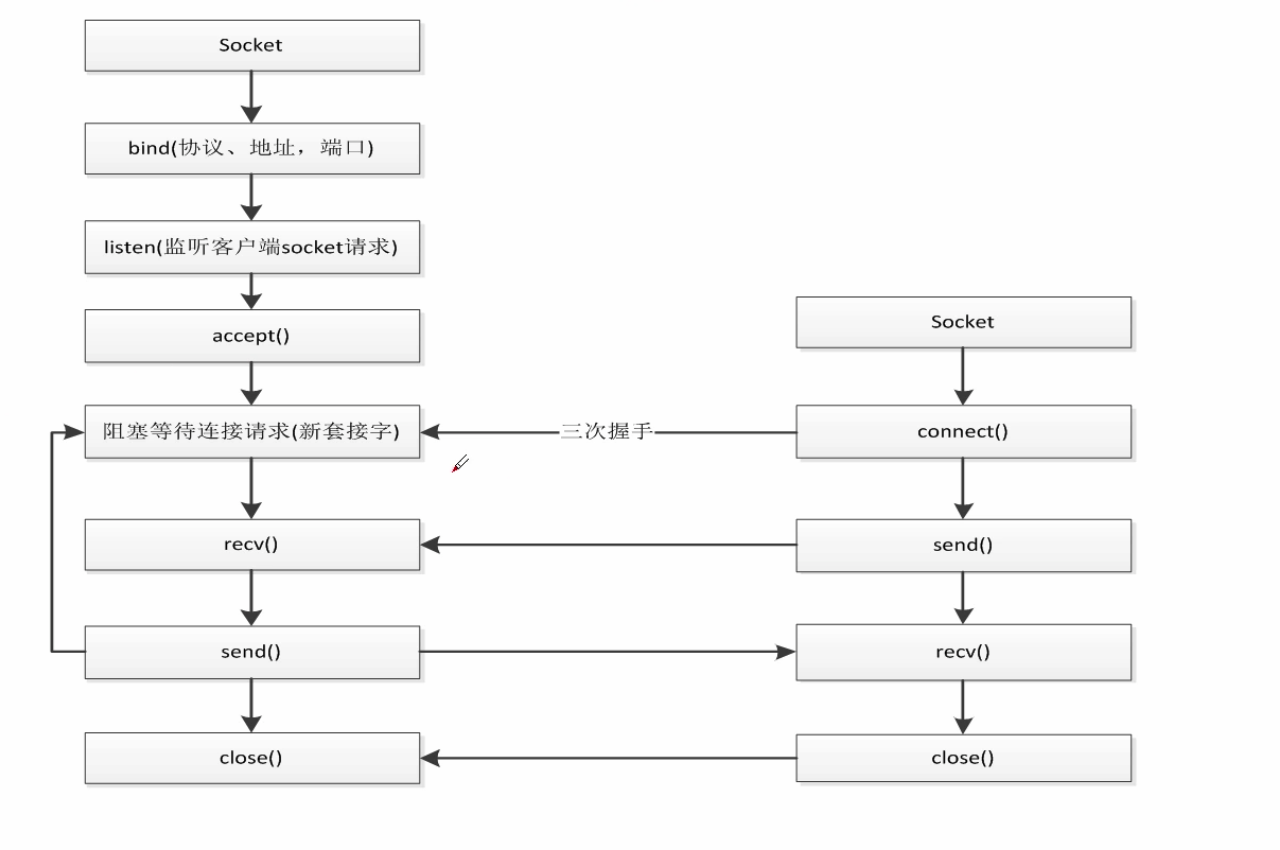
HTTP、Socket、TCP概念 socket属于常用的http协议之下的让我们可以使用tcp/ip协议的一个接口。 socket编程 image.png socket编程的模式其实是非常固定的。 上图: 左侧server端 右侧client端 server必须是随时处于一个监听的状态和服务的状态,因为不知道客户端什么时候会发送来请求。 绑定协议、地址、端口。 每一个应用程序只能占用一个端口,服务器a到服务器b发数据时,数据是不知道是由哪个应用程序接受的,这时候就需要端口机制,每一个应用程序提供一个端口。 socket连接后,只要不关闭连接,服务端可以一直给客户端发送请求,但是在http中,只完成一次发送数据就停止了。 编写测试代码: 新建文件sever.py import socket server = socket.socket(socket.AF_INET, socket.SOCK_STREAM) # 绑定ip 端口 server.bind(('0.0.0.0', 8000)) # 监听 server.listen() sock, addr = server.accept() # 接受client端发来的数据 data = sock.recv(1024) # 打印数据 print(data.decode('utf8')) # 给client发数据 sock.send("hello".encode("utf8")) # 关闭 server.close() sock.close() 新建文件client.py import socket client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) client.connect(('127.0.0.1', 8000)) # 给server端发数据 client.send("allen".encode("utf-8")) # 接受server端发来的数据 data = client.recv(1024) # 打印数据 print(data.decode('utf8')) # 关闭 client.close() 首先运行server.py,再运行client.py,观察打印结果,可以看到,数据发送接收已经是实现。 socket实现简单聊天 要实现双向交流,肯定不能做close操作,改为一直while循环, 代码: 修改srever.py import socket server = socket.socket(socket.AF_INET, socket.SOCK_STREAM) server.bind(("0.0.0.0", 8000)) server.listen() sock, addr = server.accept() while True: # 接受client端发来的数据 data = sock.recv(1024) # 打印数据 print(data.decode('utf8')) re_data = input() # 给client发数据 sock.send(re_data.encode("utf8")) 修改client.py: import socket client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) client.connect(('127.0.0.1', 8000)) while True: # 输入消息 re_data = input() client.send(re_data.encode("utf8")) # 接受client端发来的数据 data = client.recv(1024) # 打印数据 print(data.decode('utf8')) 运行server.py ,再运行client.py,在client.py中输入要发送的文字,在server.py中观察接收到的文字,再在server.py中发送文字,在client.py中查看。 以上就是实现了最初级的基本聊天过程。 如果要在网页上做一个聊天模块,一般都是需要用web socket来实现。 socket多用户聊天 所谓多用户聊天,其实平时我们也经常遇到。 假如你是一位线上客服人员,你需要接待的人员可能同时有多位,当你和A用户聊天时,并不妨碍和B用户C用户给你发消息,而你回消息,回给A用户的消息只有A用户可以看到,B用户是看不到的,接着看如何实现这种功能。 首先client.py的代码不用改动,只需修改server.py: import socket import threading server = socket.socket(socket.AF_INET, socket.SOCK_STREAM) server.bind(('0.0.0.0', 8000)) server.listen() def handle_sock(sock, addr): while True: data = sock.recv(1024) print(data.decode("utf8")) re_data = input() sock.send(re_data.encode("utf8")) while True: sock, addr = server.accept() #用线程去处理新接收的连接(用户) client_thread = threading.Thread(target=handle_sock, args=(sock, addr)) client_thread.start() 上边代码把接受处理逻辑放到了线程中,每一个线程存放一个不同的socket,主线程来查看有哪些线程进入。 运行server.py,再运行多个client.py,client.py给server发消息,测试可发现可实现上边的客服功能。 注:真正客服系统要比这个复杂得多,以上代码仅供测试。 socket模拟http请求 我们平常所用到的requests包,是基于 urllib,urllib实际上是基于socket上来完成的。 requests - urlib - socket 如何通过socket去完成类似urllib中http请求呢? http请求无非就是在tcp协议之上加了一些协议,只要按照这个协议发,就会返回数据。 看代码: import socket from urllib.parse import urlparse def request_demo(url): # url拆分 url = urlparse(url) host = url.netloc path = url.path if path == "": path = "/" # 建立socket连接 client = socket.socket(socket.AF_INET, socket.SOCK_STREAM) client.connect((host, 80)) client.send("GET {} HTTP/1.1\r\nHost:{}\r\nConnection:close\r\n\r\n".format(path, host).encode("utf8")) data = b"" # 每次读取1024大小,循环知道读取完毕 while True: d = client.recv(1024) if d: data += d else: break data = data.decode("utf8") print(data) client.close() if __name__ == "__main__": url = 'http://www.baidu.com' request_demo(url) 运行结果包含两部分: 第一部分request header 第二部分html源码 建立连接的过程是比较费时的,一般在使用socket编程都是为了解决长连接的问题,而不是说每发送一个请求数据返回就把它关掉。 很多时候我们需要一个交互的过程,这时候socket就派上用场了,有了socket后我们的代码灵活性高,它完全可以让我们将整个过程变得可以操控。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册